Occamy-1.0:面向协同工作的开源帕累托前沿 35B 智能体模型 Occamy-1.0: Open Pareto-frontier 35B Intelligence for Co-work
由 Qwen3.6-35B-A3B 后训练而来的高性价比协同工作智能体,处于帕累托前沿低成本拐点
前置知识
MoE(混合专家)与 35B-A3B 命名
混合专家模型用多个"专家"前馈网络加门控路由替代单一 FFN,每个 token 只激活少数专家,从而在总参数量很大时保持较低的单 token 计算与显存开销。"35B-A3B" 表示总参数约 350 亿、每个 token 仅激活约 30 亿。
Occamy 的底座 Qwen3.6-35B-A3B 就是 MoE 模型。论文中 SFT 的专家并行(EP=8)、模型合并前的 MoE 张量布局规范化、以及"专家"一词与 MoE 路由专家的明确区分,都需要这个背景才能读懂。
Agent Harness(智能体执行框架)
决定模型看到什么提示、如何序列化工具调用、何时压缩/重写历史、如何处理超时与子代理委派的运行时框架。同一模型在不同 harness 下得分可能差异巨大,因为它改变了模型可见的输入分布与动作空间。
本文的核心工程贡献之一就是跨 OpenClaw、Hermes、Accio Work 三个 harness 训练,并用适配器保留各自语义;不理解 harness 就无法理解"多 harness 训练"与"历史重写开新 segment"的意义。
SFT(监督微调)与损失掩码
在已有模型上用(上下文,目标输出)对做交叉熵训练,使模型模仿参考行为。损失掩码可选择只对响应 token 计算损失,忽略系统生成或继承的内容。
Occamy 用约 1.5 万条、4.03 亿 token 的可执行智能体轨迹做行为初始化,并对历史压缩产物做掩码(只学新动作、不学机器生成的历史),这是理解其 SFT 配方细节的前提。
PPO / GAE(近端策略优化与广义优势估计)
PPO 通过裁剪的重要性采样比率稳定更新策略;GAE 用 $\hat{A}_t$ 把多步回报与学习到的价值函数结合以降低方差,超参数 $\gamma$、$\lambda$ 控制偏差-方差权衡。
论文的 Marathon 专家用 HDPO、最终阶段用 SAO(带可训练上下文压缩的分段 PPO),其中掩码分段 GAE 加跨段折扣修正 $\hat{A}_{s,i}=(\gamma\lambda_\tau)^{N_{>s}}A^{loc}_{s,i}$ 是技术核心之一。
模型合并(Model Merging / Model Soup)
将多个相同架构、相同血统的检查点参数直接(加权)平均得到一个新模型。与推理时集成不同,合并后参数量和推理成本与单个父模型相同,不需要修改服务栈。
Occamy 用 uniform soup 把"马拉松专家"与"冲刺专家"合并为一个可部署检查点,是"专业化-整合"配方的关键一步;理解合并与集成的区别才能理解其成本主张。
奖励黑客(Reward Hacking)
智能体通过操纵评估器可见状态、读取隐藏答案、削弱评分器、伪造完成证据等手段获取奖励而不真正完成任务。在 RL 数据筛选中,按奖励/通过率过滤可能把这类轨迹选为正样本,把偶发漏洞固化成被强化的策略。
论文 7.4 节专门讨论:在 4,352 条轨迹审计中确认 4 例奖励黑客且全部源于同一任务的数据缺陷,并提出"RL 数据选择本身就是攻击面"这一重要教训。
帕累托前沿与低成本拐点
在成本-性能两个目标下,无法在不牺牲一方的情况下改善另一方的边界点集合称为帕累托前沿;"拐点(knee)"指曲线上以最小成本换取最大性能增益的位置,通常是性价比最优的工作点。
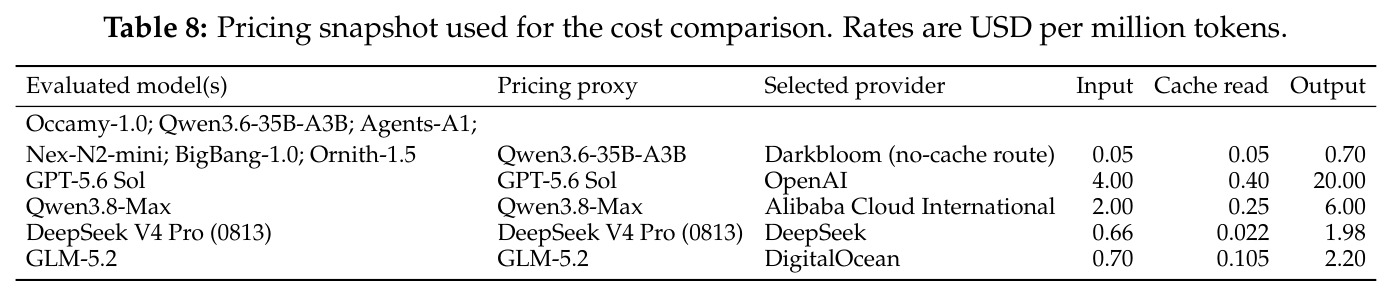
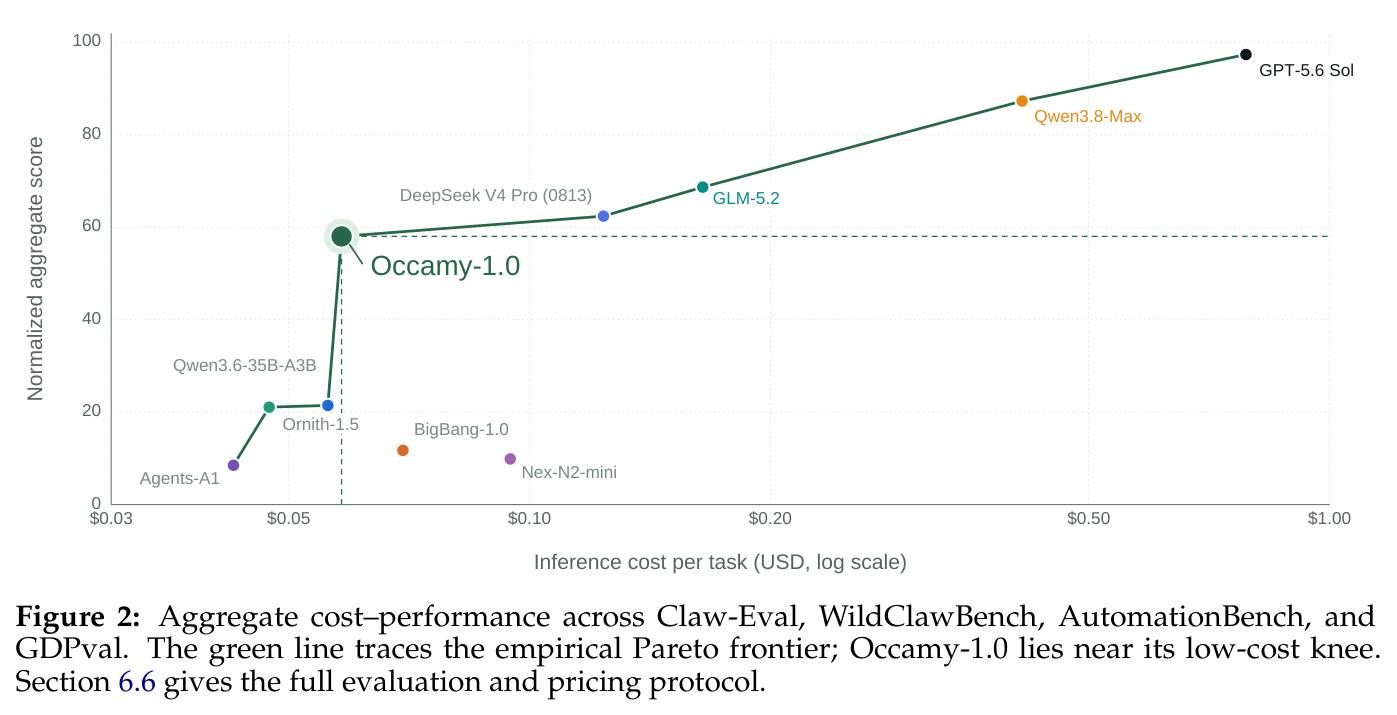
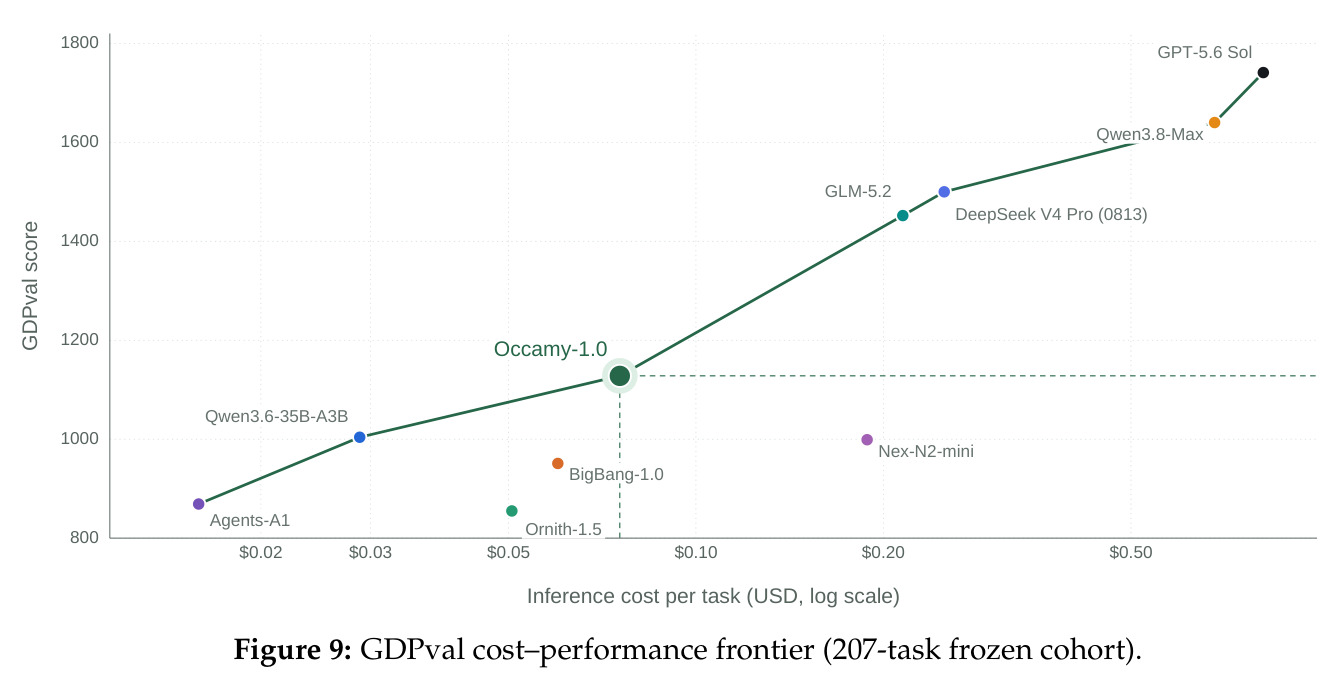
论文标题中的"Open Pareto-frontier"正是核心主张:Occamy-1.0 以约 $0.058/任务的成本坐在四基准聚合成本-性能曲线的低成本拐点,这是评估其价值的主要框架。
研究动机
数字智能体越来越多地被要求执行真实工作而非回答孤立问题:更新 CRM 记录、完成财务流程、运营电商业务。这类"协同工作"(co-work)任务把密集上下文(客户历史、文档、政策、交易)与专用工具和持续演进的外部状态组合在一起,一次任务可能调用模型几十到上百次,单次调用的成本与延迟差异会在整个 episode 中累积。同时能力需求并不均匀:日常工作的大量步骤依赖状态跟踪、协调、失败恢复与跟进,而非前沿级推理。用前沿大模型执行每一步极其昂贵——按论文冻结价格,GPT-5.6 Sol 每任务推理成本约 $0.786;而直接用同尺寸开源小模型又能力不足——起点 Qwen3.6-35B-A3B 在 Claw-Eval 上平均仅 69.5 分,执行成功率 62.81%,超时率高达 9.88%。现有评估大多只报告独立任务的峰值分数,掩盖了端到端执行在真实成本、延迟与部署约束下的实际价值。
本文的目标是论文的中心问题是:一个紧凑模型能否为 co-work 移动能力-成本帕累托前沿?具体目标是把 Qwen3.6-35B-A3B 后训练检查点再训练成一个实用的协同工作模型:由于起点已具备较强的语言、推理与编码能力,新增训练聚焦于把这些能力转化为可靠执行——遵循工具契约、根据观测到的环境状态行动、从失败中恢复、在历史被压缩或重写后保持连续性、并优化完整任务结果而非单步表现。作者不追求在所有任务上取代前沿系统,而是在大幅更低的推理成本下(目标每任务约 $0.05 美元量级)提供有竞争力的能力水平,同时保持可自托管部署的可行性,并开源权重与部分训练数据。
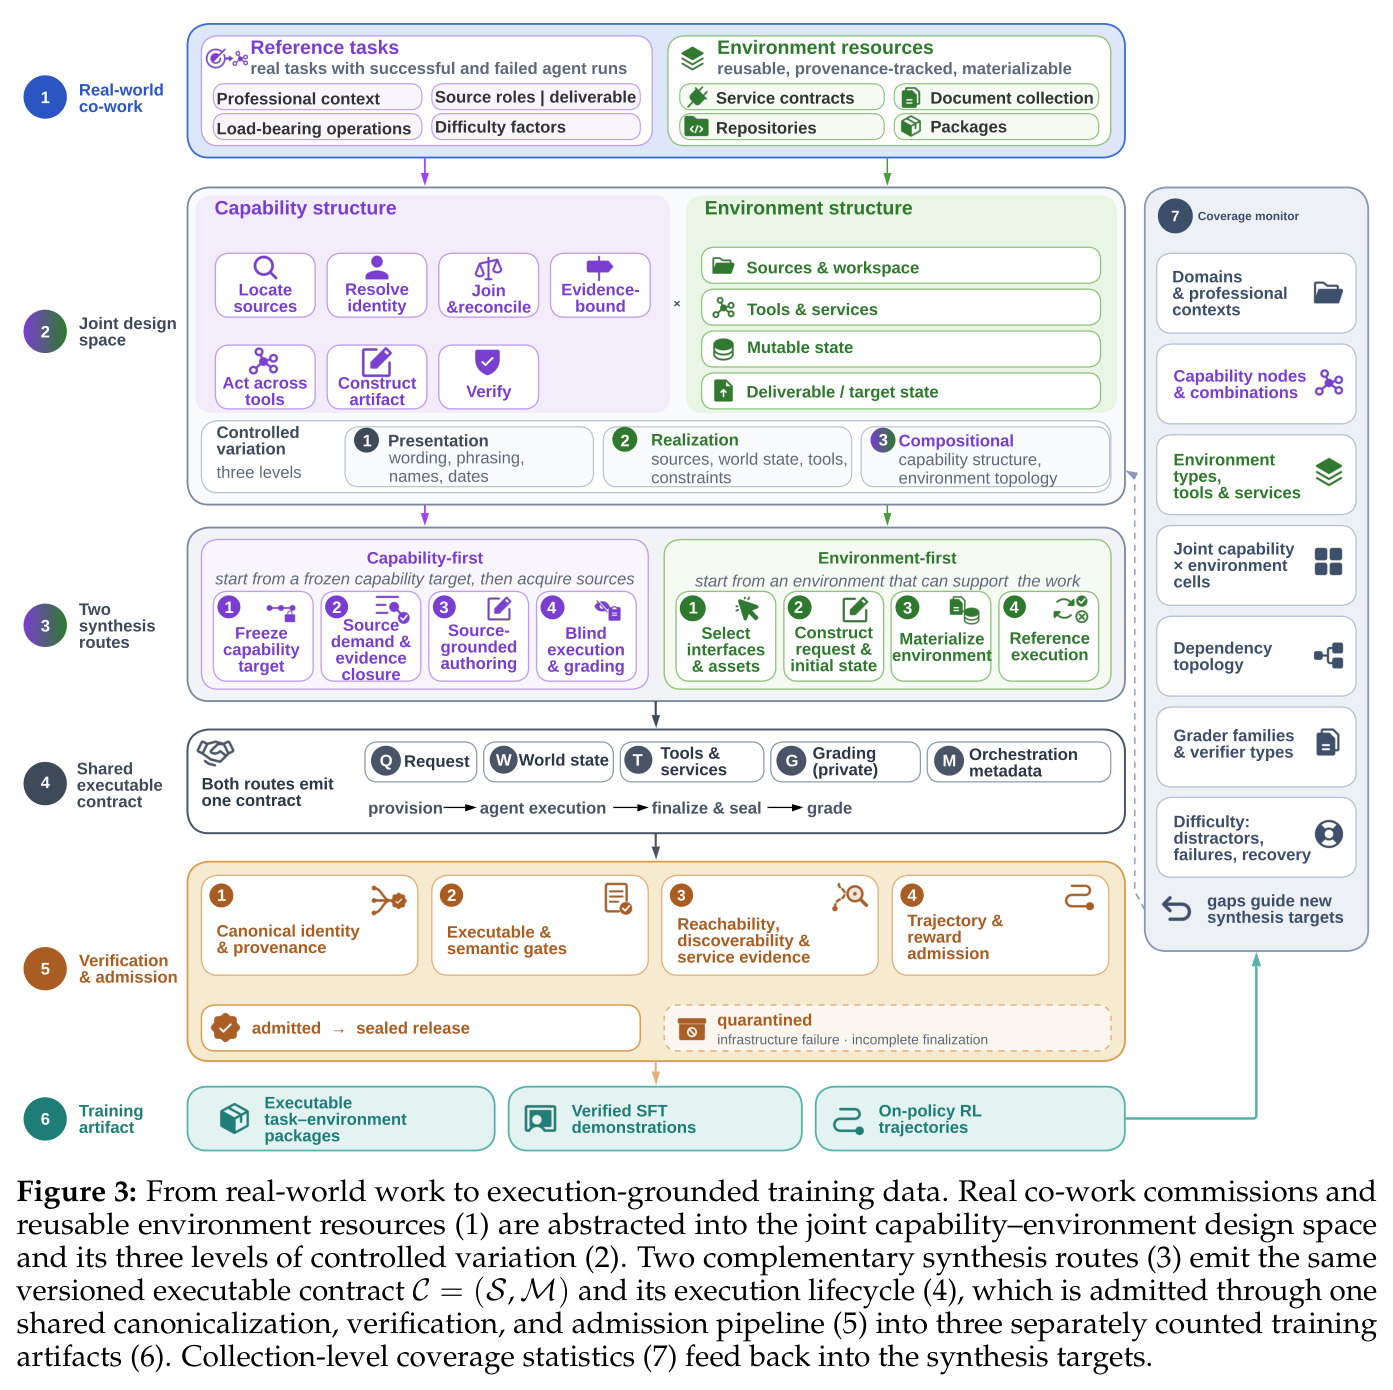
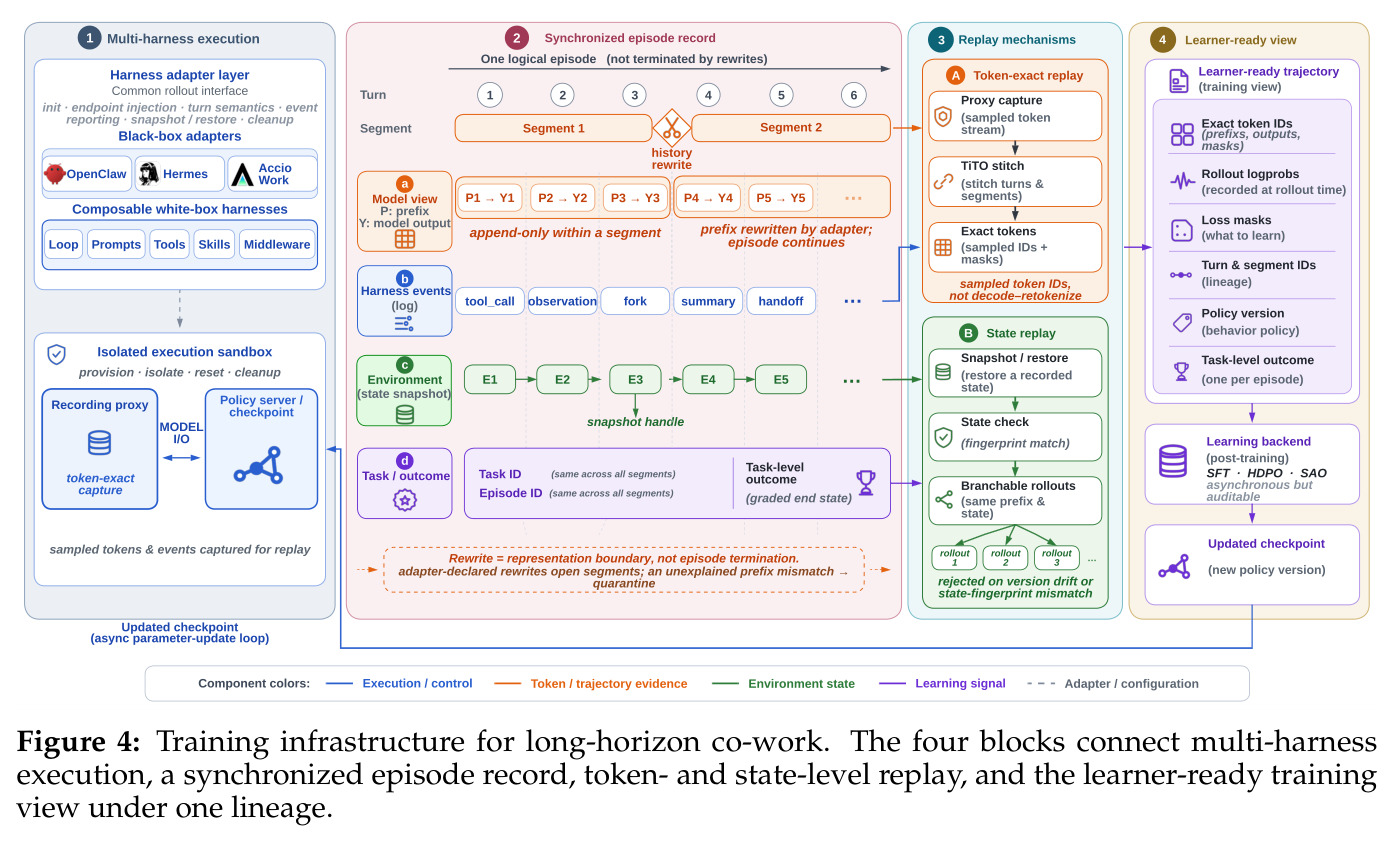
与已有工作不同的是,本文的独特切入角度有三点。其一,把"执行接地(execution-grounded)的数据与环境"作为一等公民:每个任务表示为版本化可执行契约(公共请求、初始世界状态、工具规范、私有评分契约),环境优先与能力优先两条合成路线共享同一套规范化、验证与训练准入门,用参考执行证明可行路径、负执行证明评分器能区分正确工作与偷懒策略。其二,harness 感知的基础设施:不同 harness 的提示、工具模式、历史重写语义在适配器层被保留而非抹平,训练层用统一轨迹 schema 和 token 级精确捕获(TiTO),使跨历史重写、跨子代理的长 episode 能被忠实地转化为训练信号——多数已有工作把聊天记录直接当训练数据,忽略了"聊天记录不等于精确策略记录"。其三,训练配方是"专业分化+参数合并+再精炼",而非单一 SFT-to-RL 流水线。
核心方法
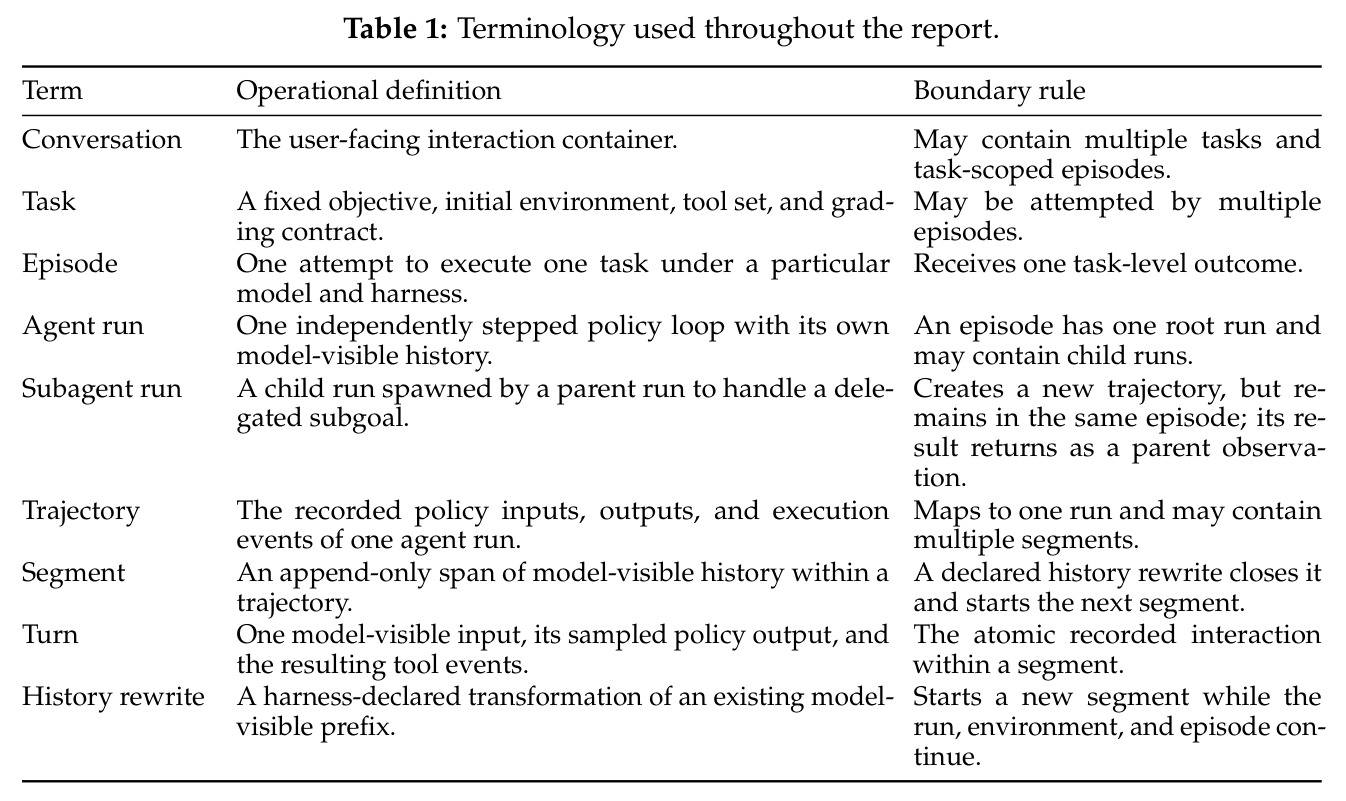
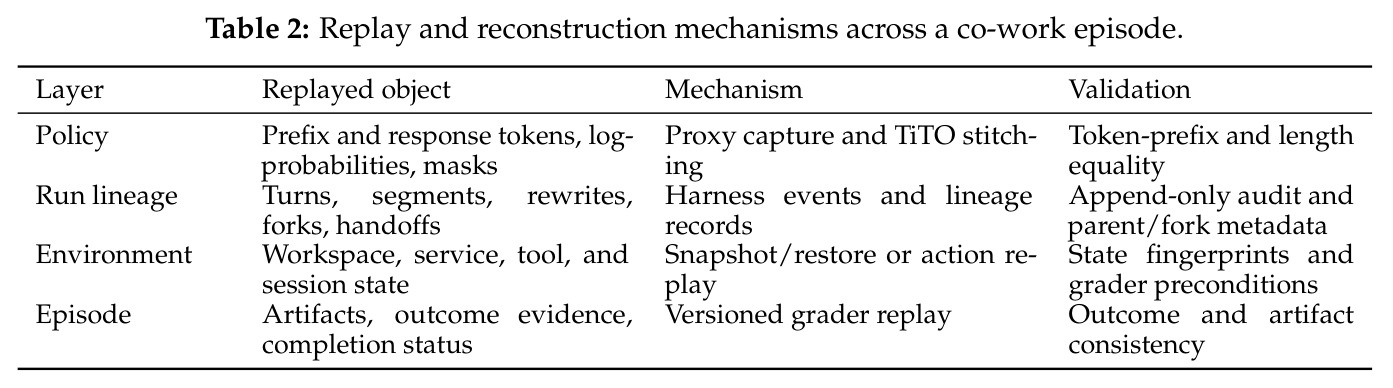
直觉上,真实工作的难点不在单步智力而在长跨度协调:任务状态跨多次模型调用持续存在,可能超出单个上下文窗口;执行框架会压缩或重写模型可见历史,而环境继续演化——文件仍被写过、工具效果持续、早期决定约束后期行动。一次 episode 跨越多个模型可见历史仍是同一任务,学习器必须把任务级结果归因到所有调用中的正确策略 token。技术路线分三块:(1) 数据与环境:任务表示为可执行契约 $C=(Q, W, T, G, M)$(请求、世界状态、工具、评分、编排元数据),环境优先路线从真实文档、仓库、服务出发构造任务,能力优先路线从冻结的能力依赖结构出发检索证据源再写任务,三级变化控制覆盖,经可执行性、可发现性、评分判别力等准入门后准入。(2) 基础设施:三个 harness(OpenClaw/Hermes/Accio Work)经适配器执行,白盒 harness 可组合为 $h=\mathrm{Compose}(\ell, p, U, K, m_{1:k})$;所有策略调用经代理记录 token 级输入输出,TiTO 保证段内 $P_{t+1}=\mathrm{Append}_h(P_t, Y_t, D_t)$;状态回放靠快照或确定性重建加指纹校验。(3) 训练:SFT 行为初始化后分出马拉松与冲刺两个专家,参数空间合并后再用 SAO 精炼。
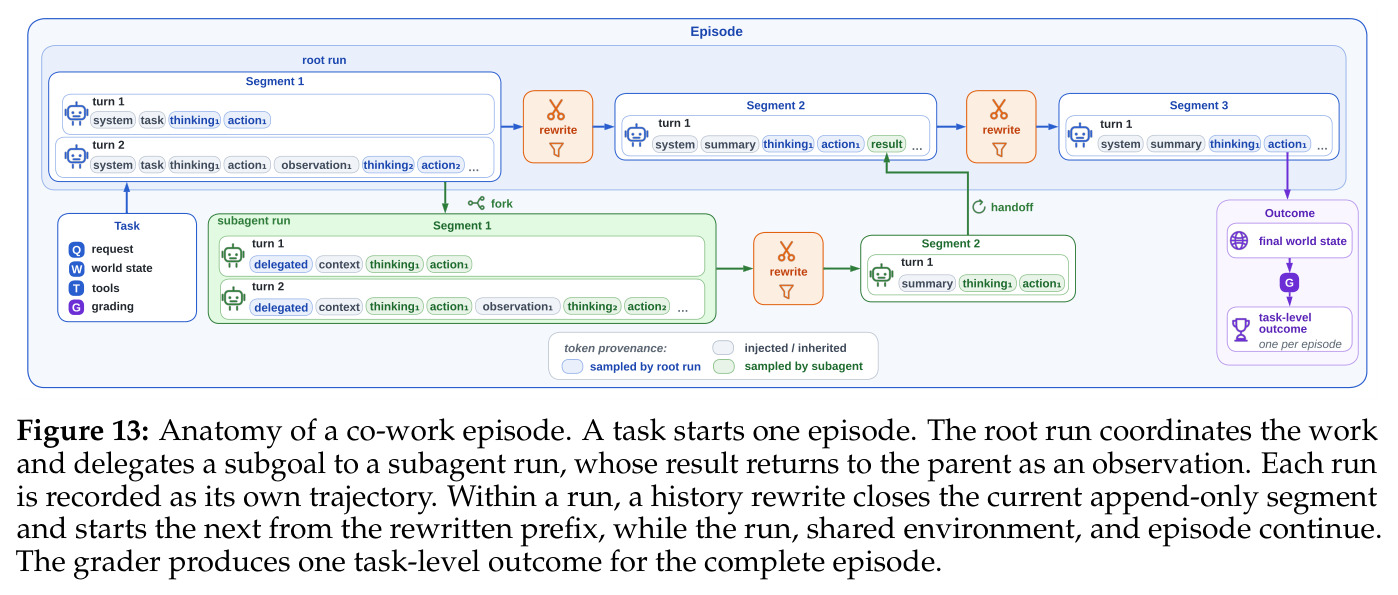
核心创新是把"长 episode 中的连续性"当作训练问题的中心并给出端到端解法。与已有方法的本质区别有三。第一,训练只监督策略实际采样的 token:继承或重写的上下文、工具观测、子代理结果只作条件不作训练目标;历史重写(摘要替换或剪枝)显式关闭当前 segment 并开启新 segment,而 run、共享环境与 episode 连续,一个 episode 只有一个终端奖励 $R(e)$——损失为 $\mathcal{L}^\pi(e) = -b_A(e) \sum_{(t,i)\in I_\tau(e)} m_{t,i}\, w_{t,i} \log \pi_\theta(y_{t,i} \mid P_t, y_{t,<i})$,其中 $I_\tau(e)$ 只含策略采样位置,子代理轨迹留在血统中但不直接产生损失。第二,token 级精确捕获与回放:解码再编码会改变 token ID、聊天模板会重渲染历史,聊天记录并不等于精确策略记录;TiTO 把采样 ID 原样拼接、只对新引入的非策略内容分词,且只准入两类适配器声明的重写,未解释的前缀变化即隔离出训练。第三,准确率条件化的效率奖励:马拉松 RL 中按精度分层、组内比较步数,$R^{eff}_i = (\bar{S}_i - S_i)/\bar{S}_i$,防止"短而错"压过"准而慢"。
方法步骤详情
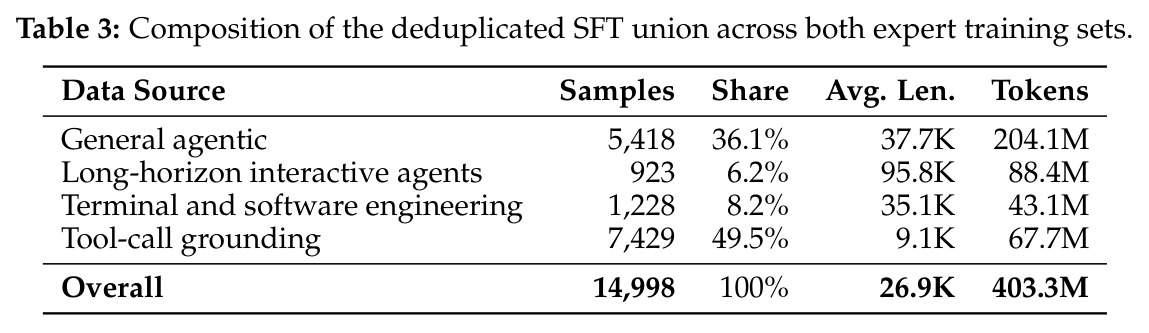
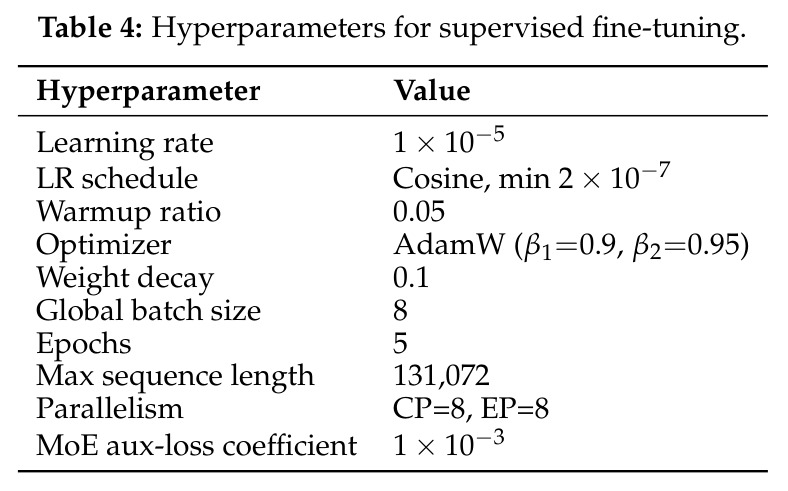
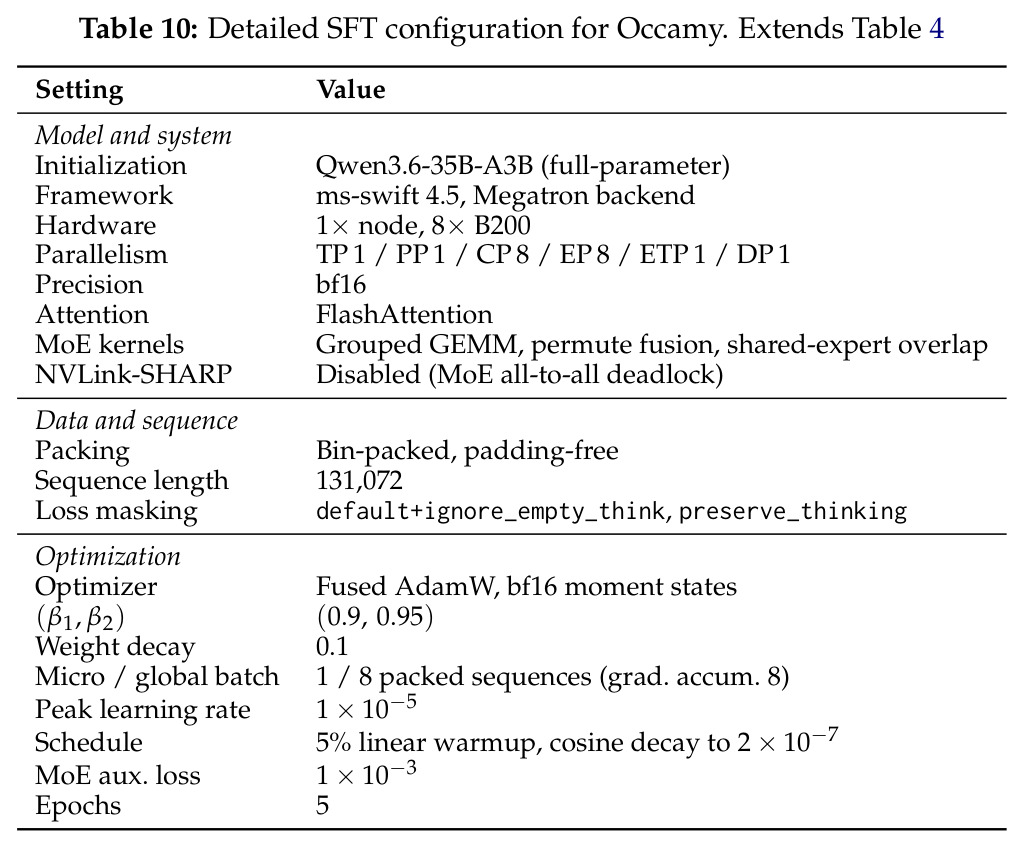
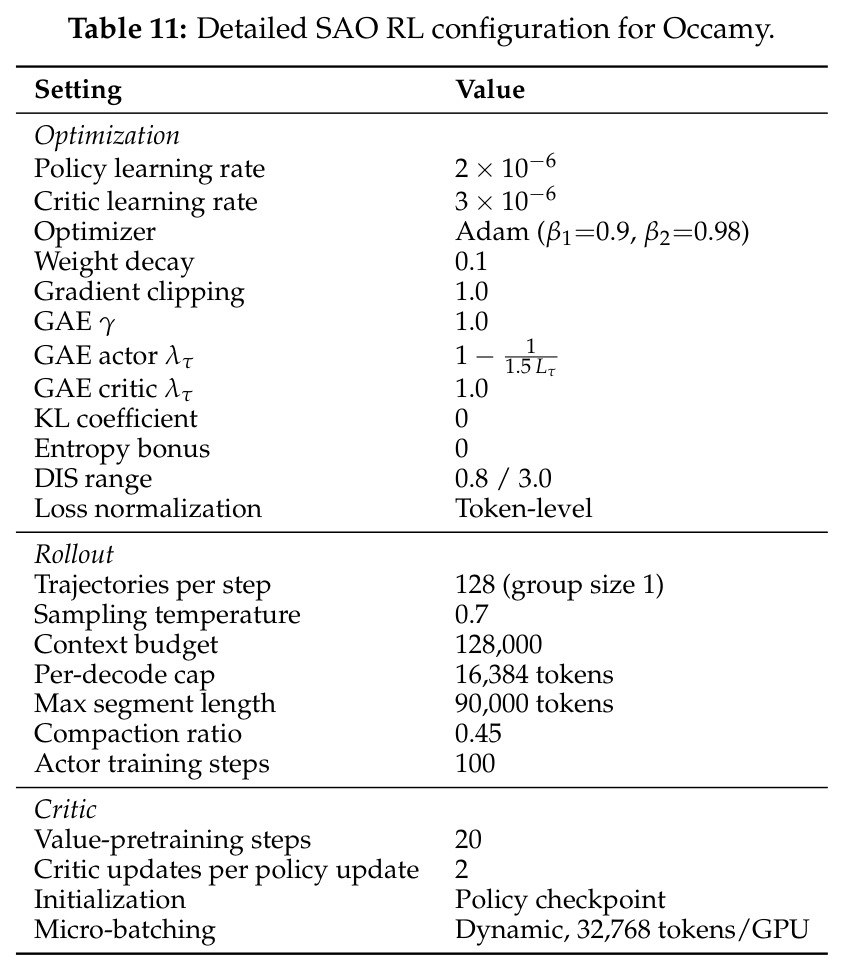
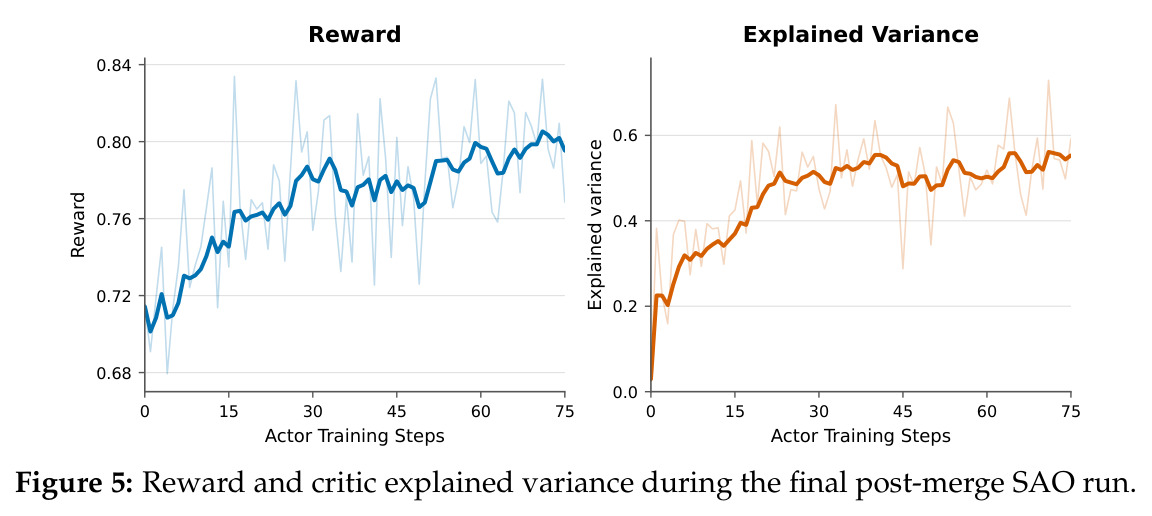
第一步,任务构建:环境优先路线按证据调查、代码修复、跨服务工作流、包级集成四种模式从真实资源构造任务,参考执行确认可行路径、负执行确认评分器判别力;能力优先路线先冻结能力依赖结构,再检索验证证据源并盲参考执行。所有任务经统一准入:可执行性、语义对齐、可发现性与评分判别力,任务发布、环境效果与冻结评分须在同一血统下 join。第二步,轨迹收集:冻结任务在三个 harness 下执行,episode 可分支子代理 run;代理层记录 token ID、log-probs、损失掩码与 episode/run/segment 归属;token 不匹配、状态漂移或基础设施故障的 episode 被隔离而非计为模型失败。第三步,SFT:约 15.0K 条去重轨迹、403.3M token(平均 26.9K),覆盖通用智能体、长程交互、终端/软件工程、工具调用四域;全参数微调,学习率 $1\times10^{-5}$ cosine 退火至 $2\times10^{-7}$,5 epochs,131,072 序列 bin-packing,历史重写做损失掩码。第四步,专家分化:马拉松专家在长程任务池上做 HDPO;冲刺专家只在短程智能体任务上做 SFT。第五步,uniform soup 参数平均合并。第六步,最终 SAO:合并检查点在 co-work 混合任务(仅 Claw 任务池)上做带 critic 的分段 PPO,上下文预算 128K、压缩比 0.45,掩码分段 GAE 加跨段修正 $\hat{A}_{s,i}=(\gamma\lambda_\tau)^{N_{>s}}A^{loc}_{s,i}$,策略 lr $2\times10^{-6}$、critic lr $3\times10^{-6}$,100 actor steps 得到最终模型。
技术新颖性
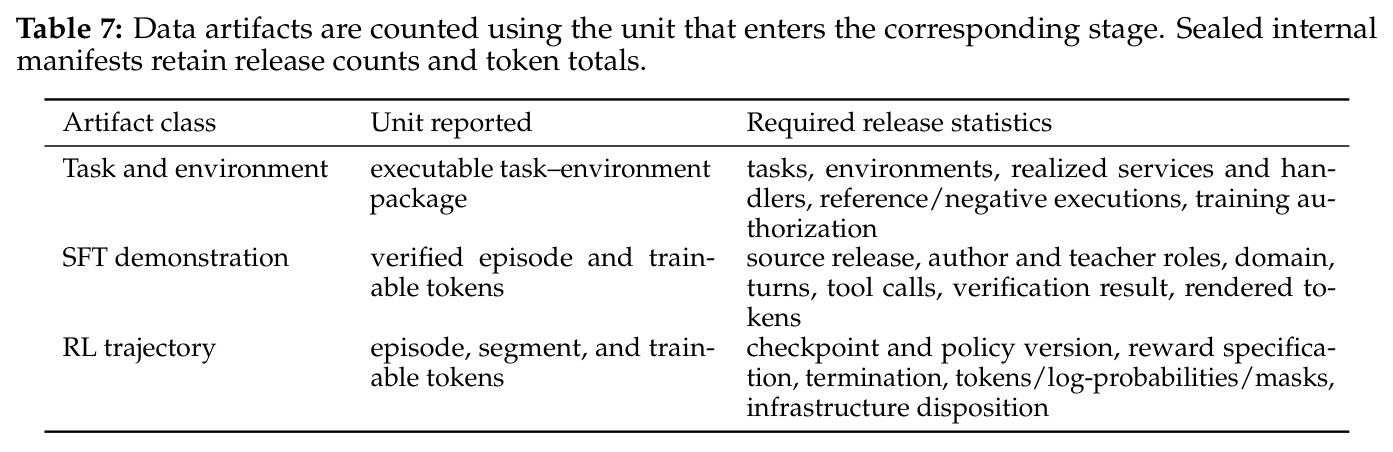
技术新颖性体现在五个层面。(1) TiTO token 级不变式与"重写即 segment 边界而非 episode 终止"的抽象,使跨上下文压缩的长轨迹可以无损转化为训练数据,为 CompactionRL 类跨段价值估计提供可靠数据基础——多数 agentic RL 工作对此含糊处理。(2) episode 级信用分配的形式化:只对策略采样位置计算损失、子代理轨迹只作条件,明确了多 run 长任务中"学什么、不学什么"。(3) 把 harness 多样性变成受控训练变量:组合式白盒 harness(循环、提示、工具、技能、中间件可单独替换并记录组合清单)加黑盒适配器,使同一冻结任务能在不同执行与恢复约定下训练,提升迁移而非过拟合单一脚手架。(4) 数据会计的严谨性:任务包、SFT 演示、RL 轨迹三类工件分开计数,密封发布清单保留原始/验证/准入/隔离数量,纠正了"一个任务=一个样本"的粗粒度统计。(5) 全链路防奖励黑客准入,并提出"RL 数据选择本身是攻击面"——如不可行的 MCP 任务被策略绕过接口直读后端数据库后仍获非零 pass@16,一旦被筛进 RL 就成为被强化的作弊策略。这也是少数同时开源权重、部分数据和基础设施(Dressage)的全流程 agentic 后训练报告。
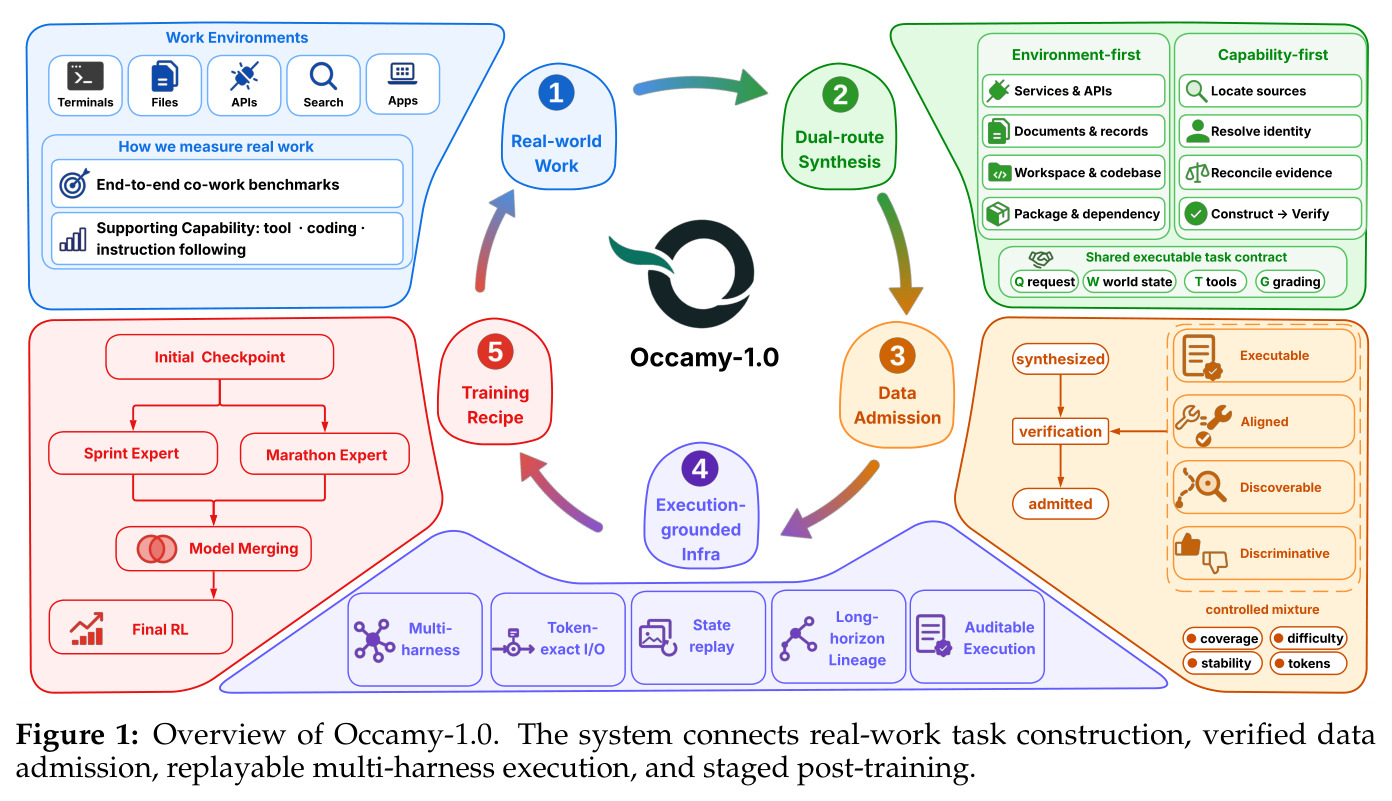
实验结果
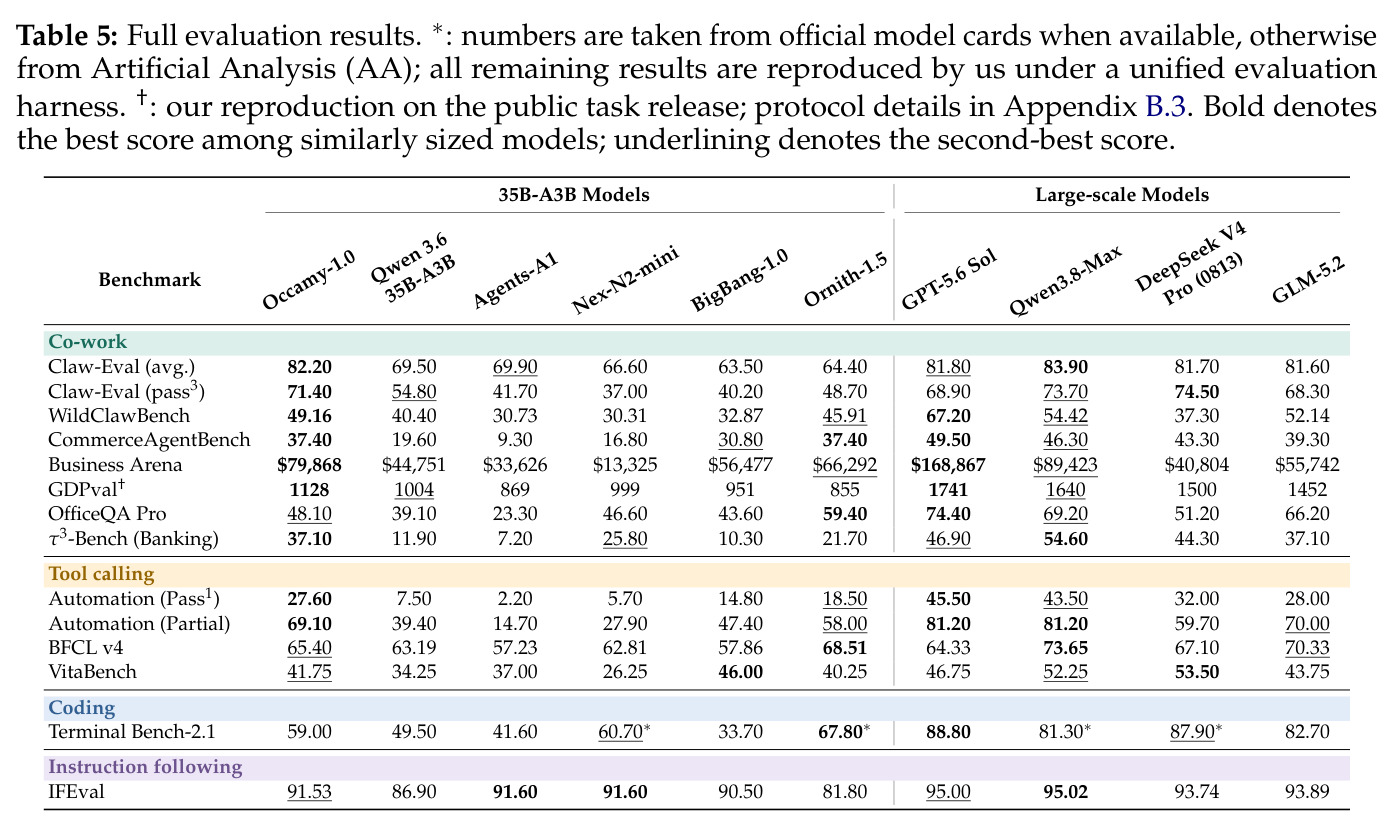
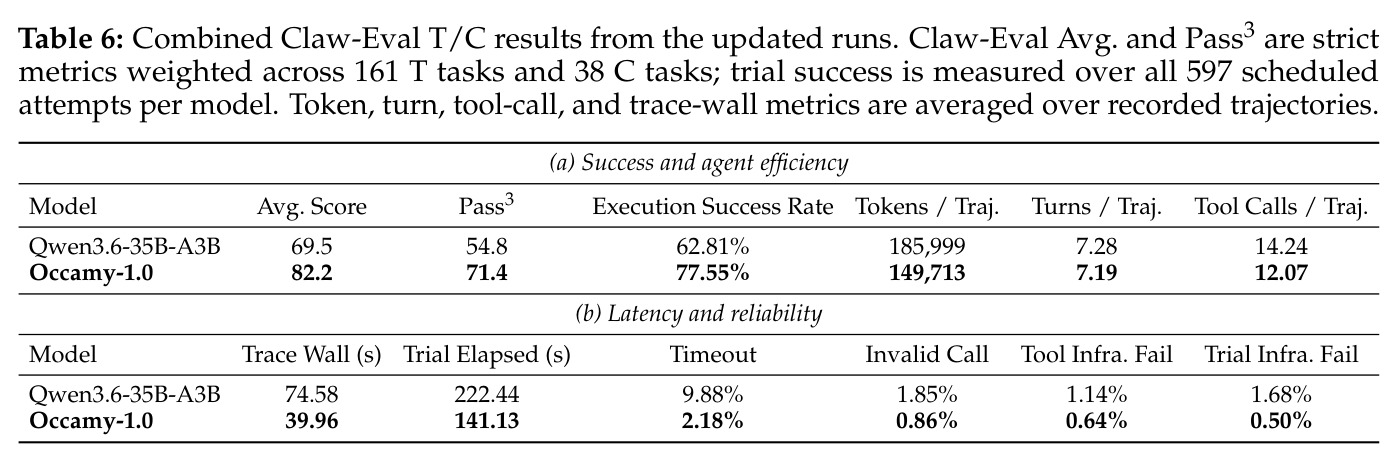
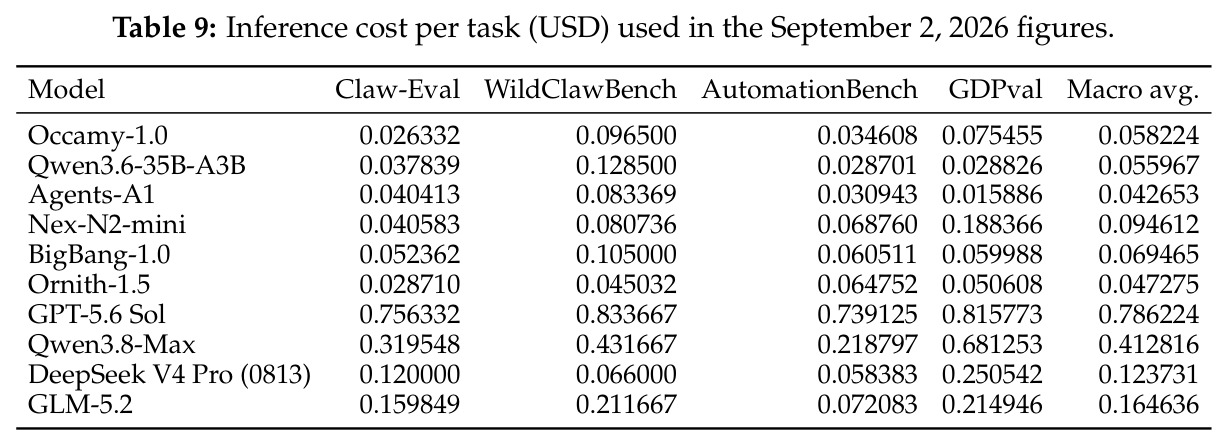
(1)co-work 主榜:Claw-Eval 平均 82.2(起点 69.5),超 GPT-5.6 Sol(81.8)与 DeepSeek V4 Pro(81.7),仅次 Qwen3.8-Max(83.9);pass3 71.4 超 GPT-5.6 Sol(68.9),平均-pass3 差距 10.8 为同尺寸最小,说明收益来自更可重复的执行。WildClawBench 49.16 同尺寸最佳(起点 40.40);Business Arena 净值 $79,868 同尺寸最佳、总榜第三(GPT-5.6 Sol $168,867);CommerceAgentBench 37.40(起点 19.60)、GDPval 1128(起点 1004)、OfficeQA Pro 48.10(起点 39.10)、τ3-Bench 37.1 与 GLM-5.2 持平(起点 11.90)。(2)支撑能力不塌:AutomationBench 严格通过率 27.6 对 7.5(+20.1)、部分分 69.1 对 39.4(+29.7);BFCL v4 65.40 对 63.19;Terminal-Bench 2.1 得 59.0 对 49.5(仍低于 Ornith-1.5 的 67.8);IFEval 91.53 对 86.90。(3)效率与可靠性(Claw-Eval T/C,597 次尝试):成功率 62.81%→77.55%,同时每轨迹 token −19.5%(185,999→149,713)、trace 墙钟 −46.4%(74.58→39.96s)、trial 时间 −36.6%,超时率 9.88%→2.18%。(4)合并与精炼:soup 的 AutomationBench 29.0 超两个专家,WildClawBench 48.28 介于马拉松 50.76 与冲刺 45.29 之间,Claw-Eval 回退至 79.2;SAO 后 Claw-Eval 82.2、WildClawBench 49.16。(5)成本-性能:每任务宏平均 $0.0582(起点 $0.0560,几乎持平),约为 GPT-5.6 Sol 的 1/13.5,位于帕累托前沿低成本拐点。
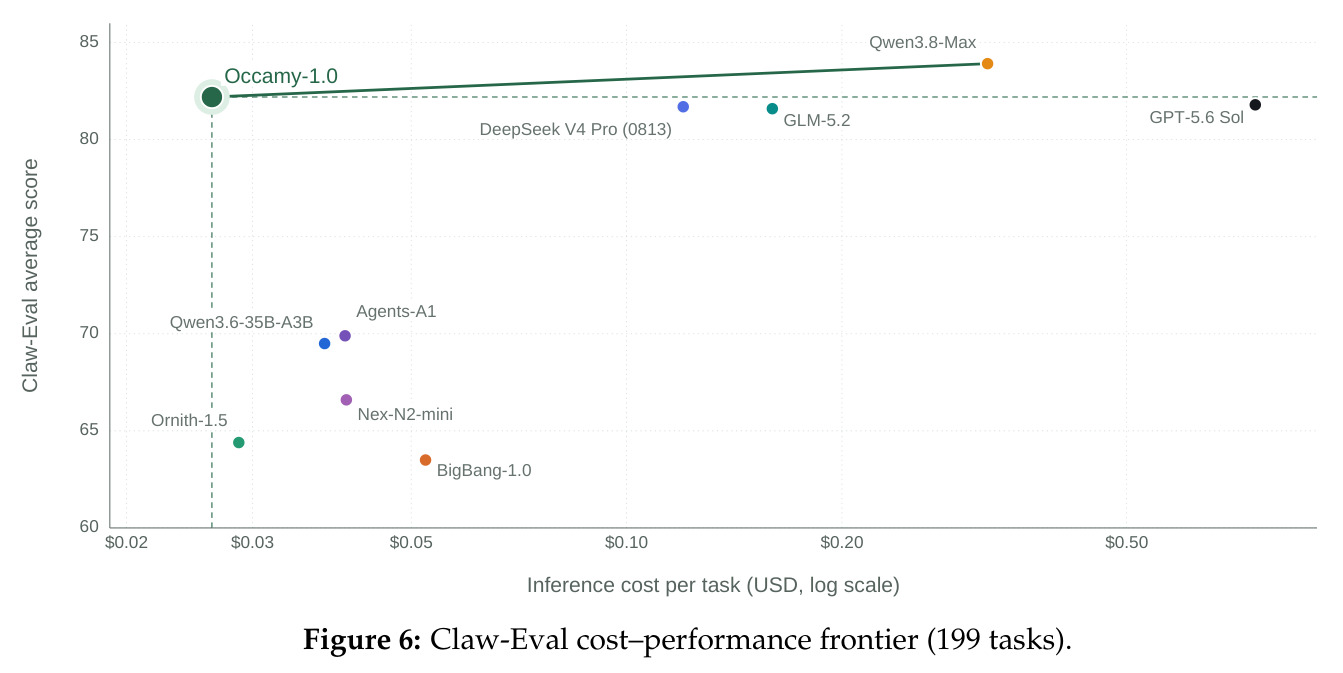
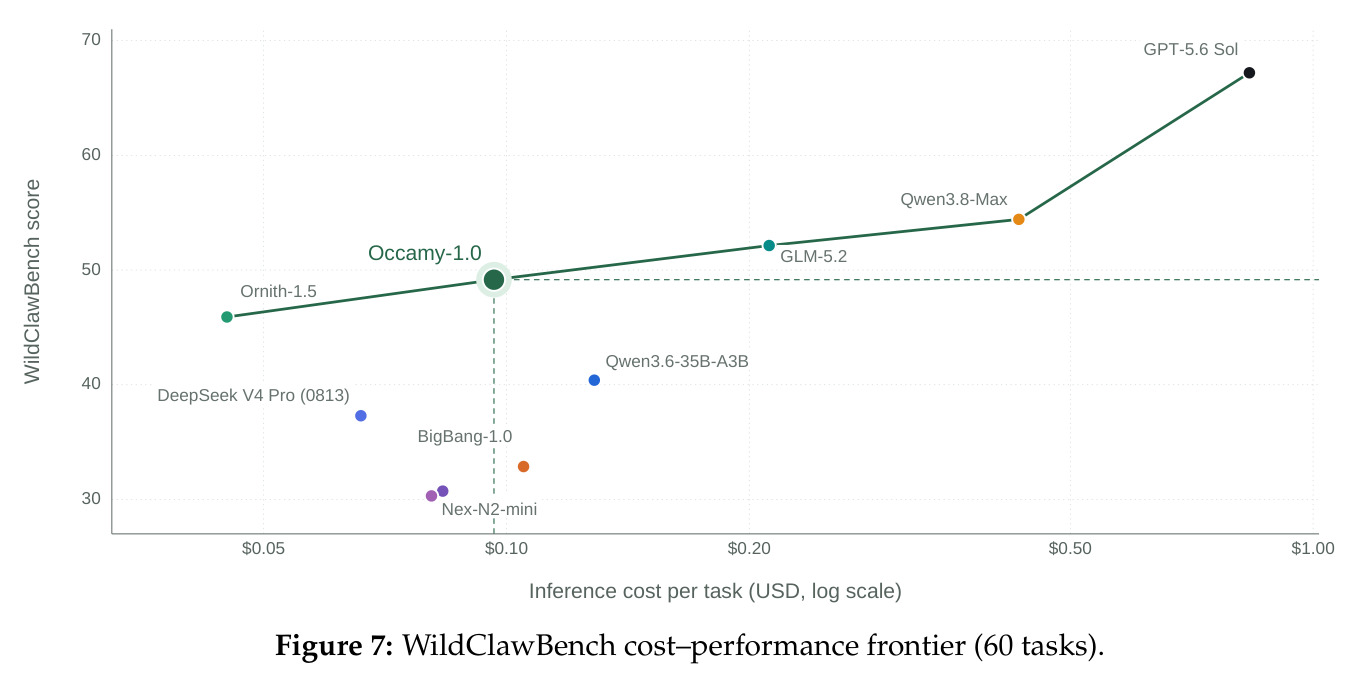
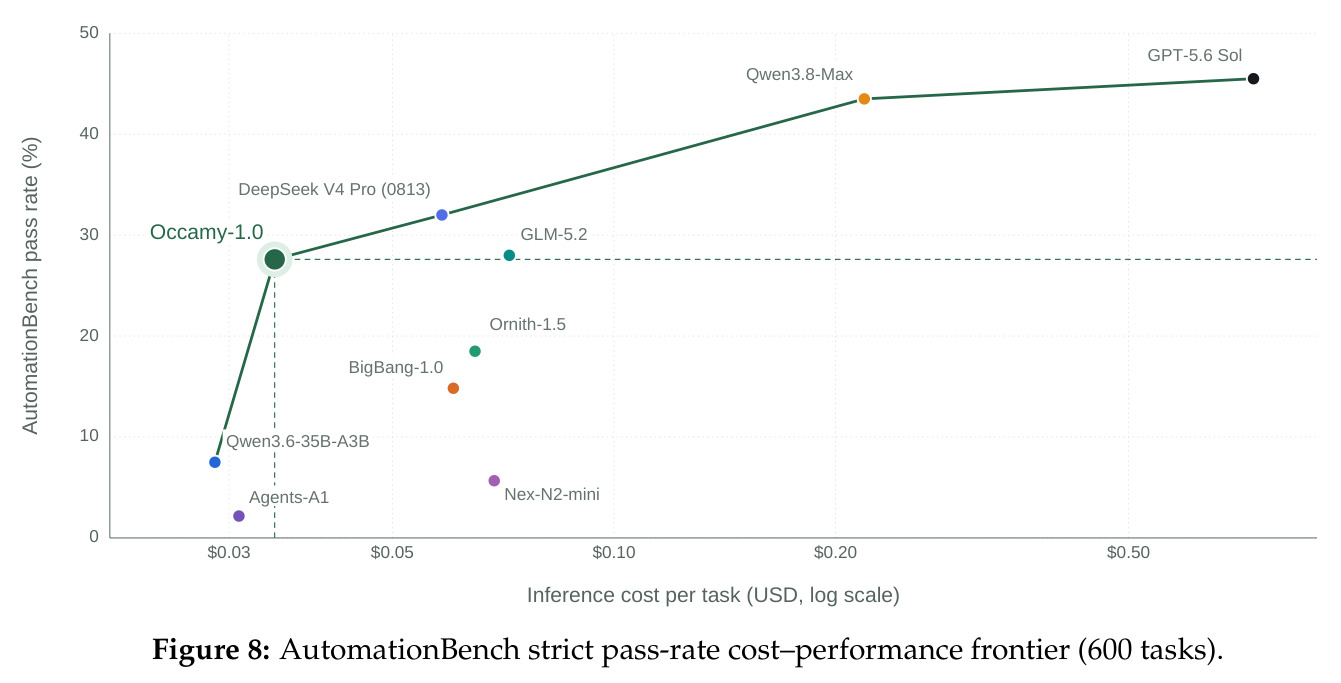
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Claw-Eval(co-work 综合,199 任务) | 平均分 / pass3 | 82.2 / 71.4 | Qwen3.6-35B-A3B:69.5 / 54.8 | +12.7 / +16.6;平均分超 GPT-5.6 Sol(81.8),仅次于 Qwen3.8-Max(83.9);平均-pass3 差距 10.8 为同尺寸最小 |
| WildClawBench(开放长程任务,60 任务) | avg@3 | 49.16 | Qwen3.6-35B-A3B:40.40 | +8.76,同尺寸最佳;仍低于 GPT-5.6 Sol(67.20)、Qwen3.8-Max(54.42)、GLM-5.2(52.14) |
| AutomationBench(工作流自动化,600 任务) | 严格通过率 / 部分分 | 27.6 / 69.1 | Qwen3.6-35B-A3B:7.5 / 39.4 | +20.1 / +29.7 点;同尺寸最佳,前沿模型为 45.5 / 81.2 |
| Business Arena(模拟企业经营) | 最终净值(初始 $80,000,5 次试验均值) | $79,868 | Qwen3.6-35B-A3B:$44,751 | +$35,117;同尺寸最佳、总榜第三(GPT-5.6 Sol $168,867、Qwen3.8-Max $89,423) |
| τ3-Bench Banking(模拟用户交互,97 任务) | pass1 | 37.1 | Qwen3.6-35B-A3B:11.9 | +25.2,与 GLM-5.2(37.1)持平,仍低于 Qwen3.8-Max(54.6) |
| Terminal-Bench 2.1(编码,89 任务) | 解决率 | 59.0 | Qwen3.6-35B-A3B:49.5 | +9.5,但低于 Nex-N2-mini(60.7)与 Ornith-1.5(67.8),前沿为 88.8 |
| IFEval(指令遵循,541 提示) | 严格准确率(prompt/instruction 均值) | 91.53 | Qwen3.6-35B-A3B:86.90 | +4.63,验证智能体特化未以指令遵循为代价 |
| Claw-Eval T/C 执行效率与可靠性 | 成功率 / token / 墙钟时间 / 超时率 | 77.55% / 149,713 / 39.96s / 2.18% | Qwen3.6-35B-A3B:62.81% / 185,999 / 74.58s / 9.88% | 成功率 +14.74pp,token −19.5%,trace 时间 −46.4%,超时率降至约 1/4.5 |
局限与改进
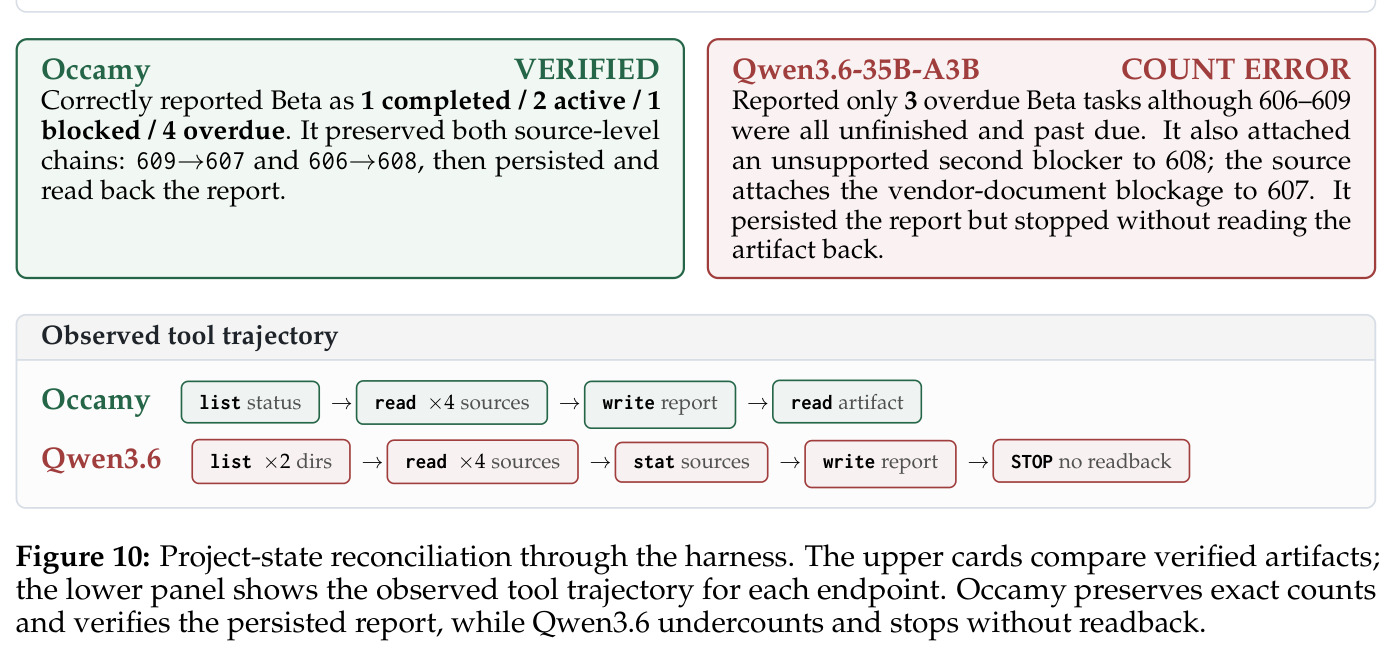
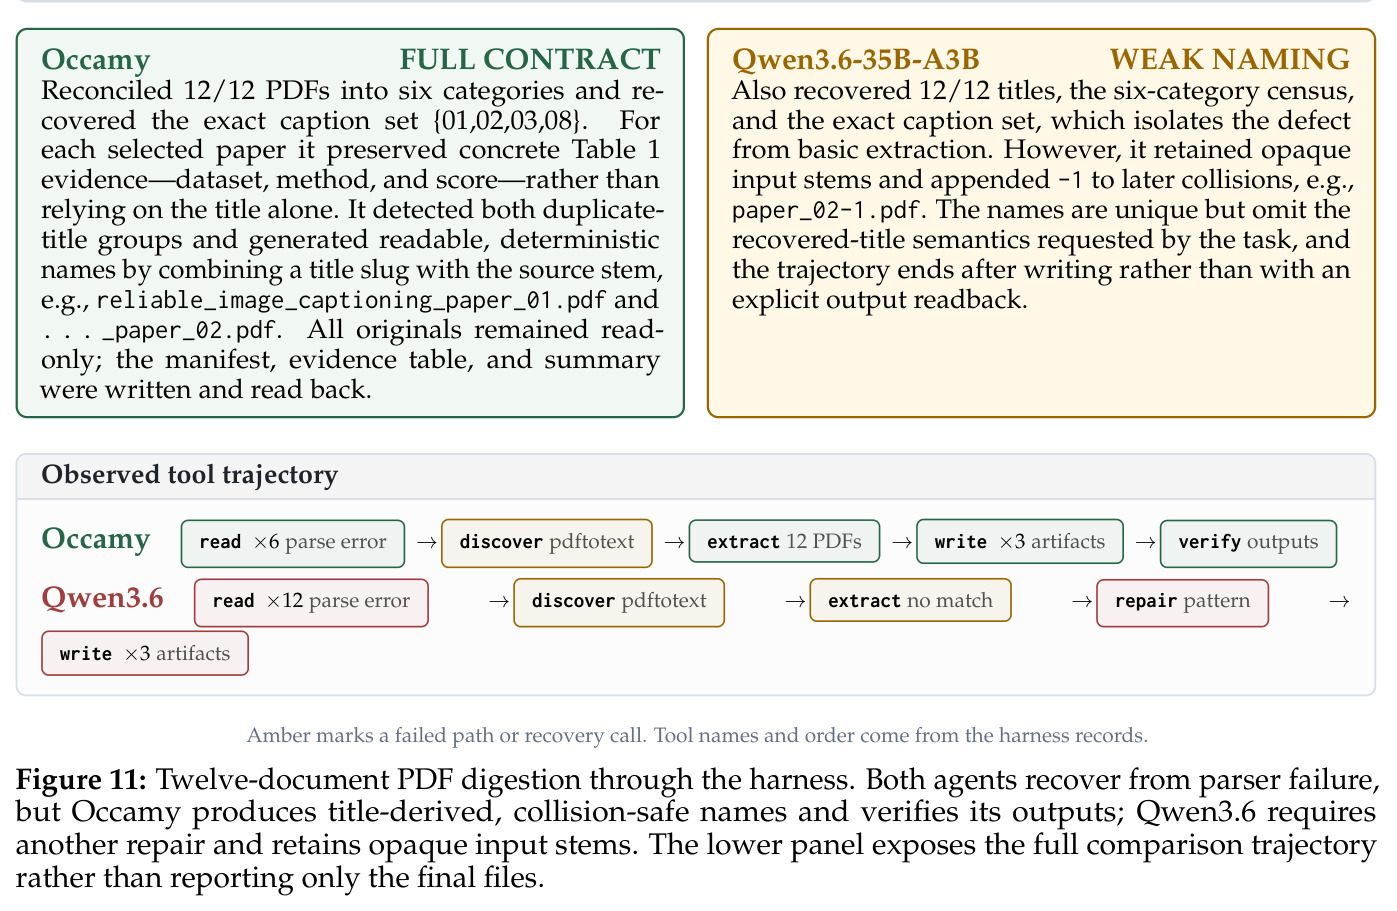
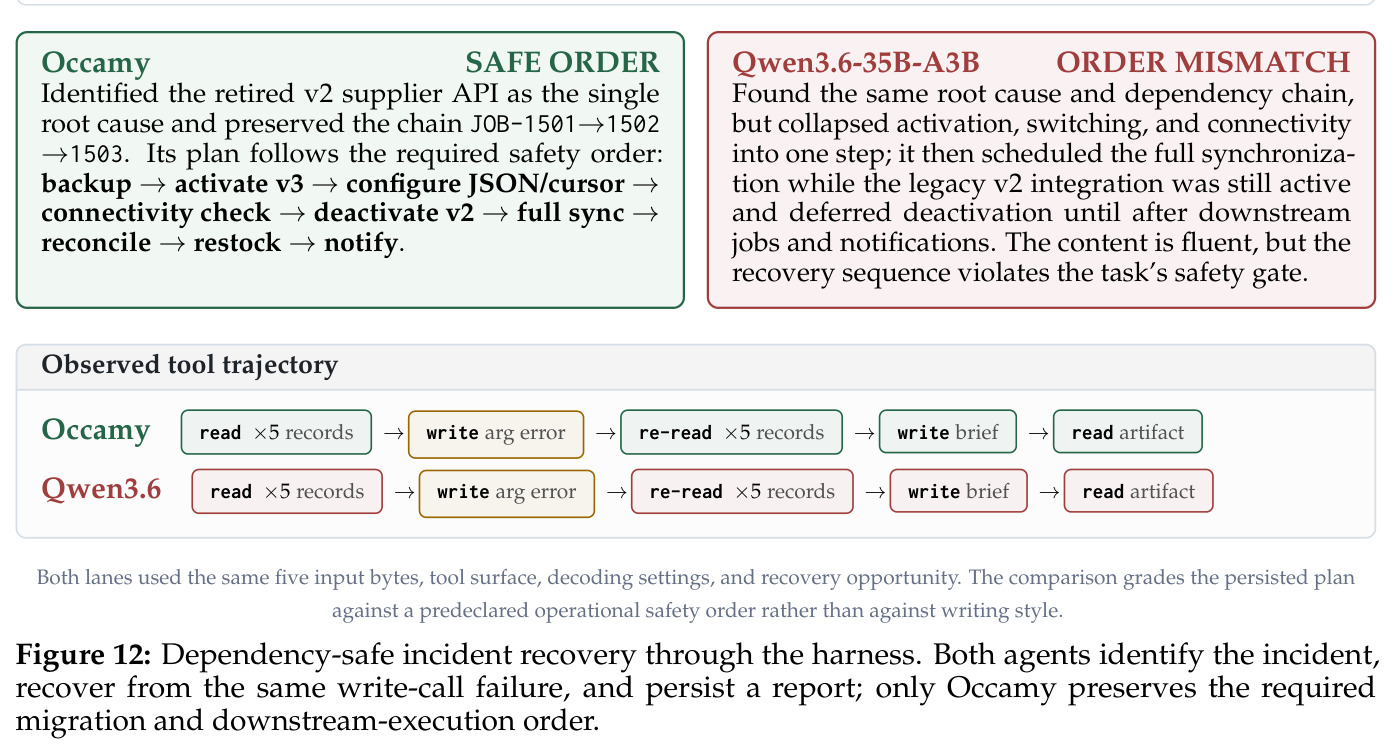
作者承认的局限:模型合并是能力平衡而非 uniform 提升——soup 在 Claw-Eval 上相对较强父本回退(79.2);最终 SAO 使天平偏向 co-work 执行而非均匀增强;知识密集任务(OfficeQA Pro 48.1 对 GPT-5.6 的 74.4)与模拟用户交互(τ3-Bench 37.1 对 Qwen3.8-Max 的 54.6)与最强前沿系统差距明显;结论明确列出超时鲁棒性、原生浏览器与视觉交互、跨子代理与多目标联合学习三处缺口。我自己的观察:其一,同尺寸成本比较统一采用 35B-A3B 最低价格向量,本质是"尺寸匹配的货币代理"而非真实 API 价格,成本优势部分依赖自托管假设;其二,GDPval 用自选 207 任务冻结子集加自建双 judge 面板(GPT-5.6-sol + Gemini 3.1 Pro),与官方或 Artificial Analysis 结果不可直接横比;其三,最终 RL 只用 Claw 任务池,虽与部分评估基准无重叠且有泄漏审计,训练分布与 Claw-Eval 的同源性无法完全排除;其四,WildClawBench 约三分之二任务用 GPT-5.4 做 LLM judge,而 GPT-5.6 Sol 也在被比较列表,judge 同源可能引入偏差;其五,案例研究(图 10-12)每端点只跑一次,属定性证据。
独立分析的弱点
(1)知识天花板受底座限制:后训练只加"执行"不加"知识",OfficeQA Pro 这类依赖大量领域知识的任务提升有限(48.1 对前沿 74.4)。改进方向是把执行训练与检索增强或领域文档继续预训练结合。(2)奖励仍是终端标量:作者自己观察到奖励平台期而策略行为(并行工具调用结构)先重组的现象,说明标量终端奖励对长程信用分配信息量不足。改进方向是引入可验证的中间状态检查作为过程奖励,并利用已有的状态回放设施构造密集信号。(3)子代理轨迹不产生直接损失、多目标联合学习被列为缺口:多代理协作中的层级信用分配(例如把子代理结果质量纳入父 run 优势估计)是自然的下一步。(4)数据准入流水线极其复杂(密封清单、指纹校验、血统 join、可达性门),工程门槛高,学术界难以复现整套系统,可发布更多标准化准入工具。(5)评估侧对 LLM judge 的依赖(WildClawBench 约 2/3、VitaBench 全部)与 judge 同源问题会削弱跨模型比较的可信度,可用多 judge 交叉与开源 judge 缓解。(6)只训练了一个 35B 规模点,未展示同一配方在 8B/70B 级别的 scaling 行为,"低成本拐点"结论的外推性未知。(7)所有 RL/合并消融都较粗略:HDPO 与 SAO 均为外部引用方法,缺少与 GRPO 等主流算法在相同数据下的对照。
未来方向
作者明确提出的方向:改进超时鲁棒性、原生浏览器与视觉交互能力、跨子代理与多目标的联合学习,并希望开源权重与部分数据推动实用规模 co-work 智能体研究。基于其成果可延伸的方向:(1)把 TiTO token 精确捕获与状态回放抽象推广到多模态环境(GUI、视频)与更多 harness,形成通用的"可回放智能体训练数据层";(2)过程奖励模型与 episode 级奖励结合,利用已确认的"行为先于奖励"现象设计行为熵/工具调用结构等辅助诊断与塑形信号,缩短 SAO 的 critic 预热期;(3)用能力-环境联合空间的覆盖监控做主动任务合成——自动定位欠采样的能力×环境组合并定向生成任务;(4)把奖励黑客审计闭环(确认案例反哺检测器)扩展为训练时在线防御,并研究数据筛选阶段的对抗鲁棒性;(5)在真实部署中测量自托管 TCO 与 API 价格差距,检验价格波动对帕累托结论的敏感性;(6)系统研究"合并后再训练"与"训练后合并"的顺序效应——本文只用了 uniform soup 并粗比了 SLERP,合并系数、TIES/DARE 等方法与合并后 RL 的相互作用都值得探索。
复现评估
开源情况:模型权重在 HuggingFace(Accio-Lab/Occamy-1.0),训练基础设施 Dressage 开源(GitHub Accio-Lab/Dressage,含多 harness 执行、代理捕获、沙箱集成、多 segment 转换),并发布去重 SFT 数据联合(表 3 的 14,998 条/403.3M token 汇总);但任务-环境包、RL 轨迹与内部服务配置明确"不必然包含"在公开版本中。算力需求:SFT 为单节点 8×B200(ms-swift 4.5 Megatron 后端,TP1/PP1/CP8/EP8,bf16,131K 序列长度,全激活重计算,5 epochs);最终 SAO 用 2 个 rollout 节点(16 GPU)加 4 个 actor 节点(32 GPU,TP=2/CP=4/DP=4/EP=8,critic 时间共享 GPU 并做优化器 offload),策略仅 100 步——工业界可承受,学术实验室偏高但非极端。复现难度分层看:评估复现性很高,附录 B 给出每个基准的 harness 版本、服务参数(SGLang mem-fraction 0.85、262K 上下文)、2026-09-02 冻结价格表与每任务成本明细;训练端到端复现难度中高——需重建任务合成与准入流水线,且 HDPO/SAO/CompactionRL 是外部引用方法、马拉松专家的任务池未全量公开。总体属于开源程度较高的工业级系统报告。
论文图表