AgentBaton:智能体任务中的高效模型接力协作 AgentBaton: Efficient Model Collaboration in Agentic Tasks
轻量检测器学会在最佳时机把智能体任务从强模型交给廉价模型,平均省65.9%成本
前置知识
长程智能体任务(long-horizon agentic tasks)
指语言模型智能体通过与环境的多次交互完成复杂任务:每回合先推理,再发起工具调用(如执行 shell 命令),观察工具返回结果,循环往复直到提交。任务中智能体的动作会修改工作区(workspace),环境反馈又改变后续所需能力,因此任务难度曲线是动态演化的,并非由初始查询一次性决定。本文实验载体 mini-SWE-agent 就是这样一个最小脚手架:线性交互历史加 shell 动作接口。
本文的核心前提是「所需能力随任务进展动态变化」,理解长程交互才能明白为什么静态的查询级路由不够用。
查询级路由与级联
现有异构模型省钱的主流范式。路由(如 RouteLLM、RouterDC)在请求到达时根据查询内容选一个模型执行;级联(如 FrugalGPT)先便宜后昂贵,便宜模型置信度不足时升级。这类方法隐含假设任务难度可以从初始查询静态判断,在单轮问答上有效;但在智能体场景,初始查询无法预测中途才会暴露的困难。
本文正是要论证这一静态决策假设在智能体任务中失效,并给出基于任务进展的替代方案。
模型交接与上下文传递
指在任务执行中途让一个模型接管另一个模型。交接时接收方继承工作区状态(文件、代码等产物),但还面临执行历史怎么给的问题:in-context transfer 直接把先前对话塞进接收方上下文,保留角色、工具调用与输出;logfile transfer 则把历史写成环境内的 .jsonl 日志文件,接收方按需用 cat/grep/sed 查看。前者推高 prefill 长度和后续每轮输入成本,还可能让接收方被前任思路带偏;后者省 token 但接收方要主动去读。
交接方向 × 传递方式是本文系统实验的两大设计维度,直接决定精度与成本的权衡结果。
推理力度(reasoning effort)
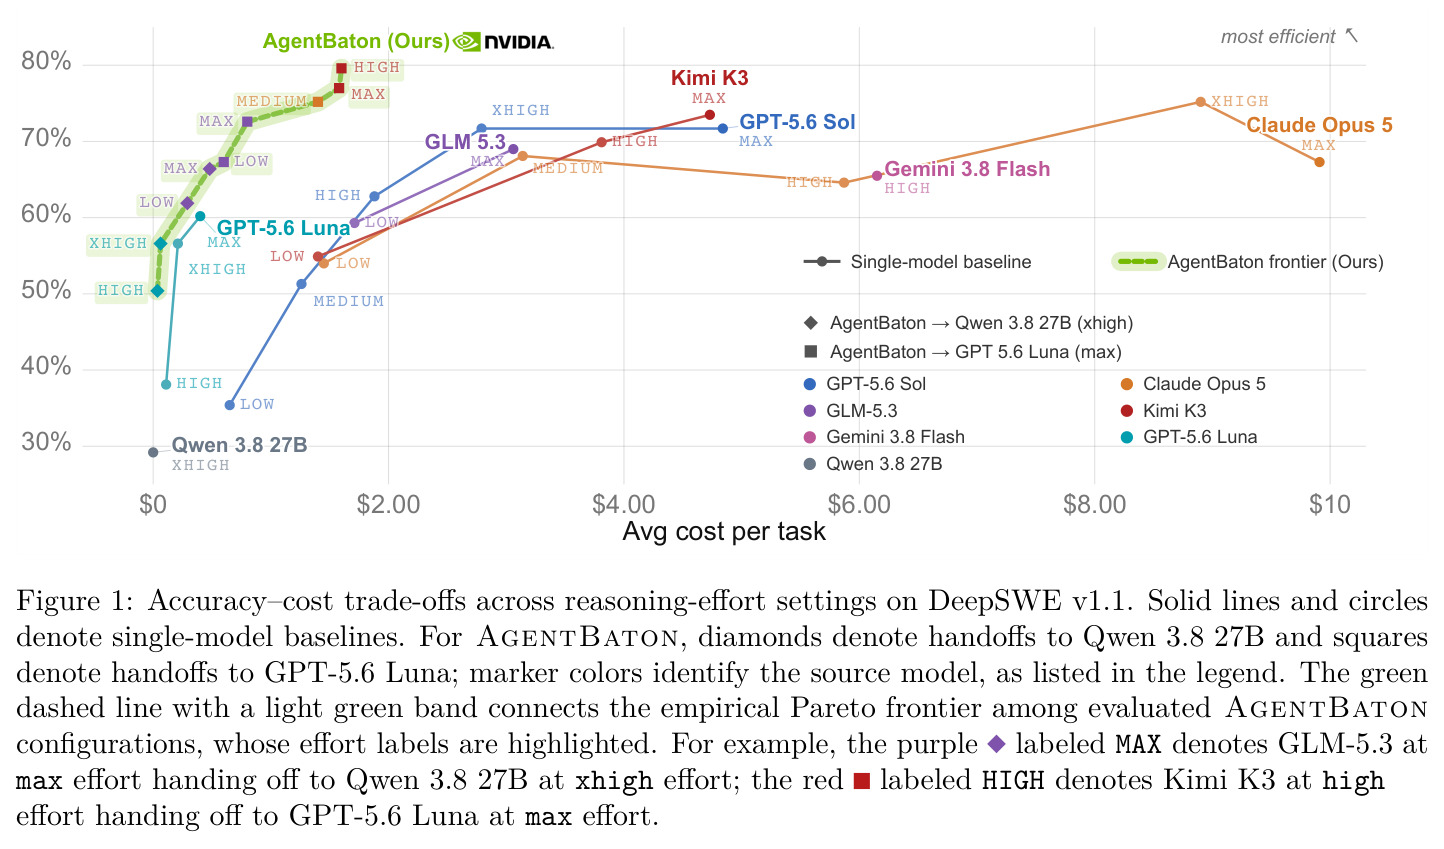
推理模型在思考阶段允许的 token 预算档位,常见档位如 low/medium/high/xhigh/max。力度越高模型思考越久、单次成本越高、精度通常越好。论文 Figure 1 中每个单模型基线点都对应一组 effort 配置,平均每任务成本可从约 $0 到 $10 以上不等,是除模型选择之外另一个重要的算力分配旋钮。
effort 扫描是本文 Pareto 前沿分析的对照系,理解它才能读懂「交接与调 effort 是互补的算力分配手段」这一结论。
轨迹回放(trajectory replay)
本文的关键实验技巧:先让源模型独立跑完任务并记录完整轨迹,之后在每个检查点(如轨迹的 30%、75% 处)把已记录的动作在任务容器中重放,恢复到该时刻的工作区状态,再让接收模型从这里继续。这样能在同一进度点上做受控对比,隔离「交接时机」这一变量,而不必每次都从头跑任务。
这是所有交接实验的方法论基础,理解它才能看懂 30%/45%/60% 这些进度数字从何而来。
研究动机
可靠完成长程智能体任务目前几乎等价于全程调用云端最强模型。以软件工程场景为例:智能体要在 Terminal-Bench 2.1 和 DeepSWE v1.1 上多轮执行 shell 命令、修改代码、根据环境反馈迭代,capable 模型(GPT-5.6 Sol、Claude Opus 5、Kimi K3、GLM-5.3)的单任务平均成本从约 $1 到 $10 不等,例如 Opus 5 在 DeepSWE 上高达 $9.91/任务。另一侧,efficient 模型便宜得多——可在 DGX Spark、Mac Studio 等本地硬件部署的 Qwen 3.8 27B(本文约定本地模型零成本),或低价云模型 GPT-5.6 Luna(DeepSWE 上 $0.40/任务)——但单独使用精度明显不足:Qwen-only 在 DeepSWE 仅 29.2%,远低于 GPT-5.6 Sol 的 68.1%。已有省钱手段以查询级路由和级联为主(FrugalGPT、RouteLLM 等),在请求到达时静态决策;但智能体任务中动作会修改工作区、反馈会改变剩余难度,「该用哪个模型」无法从初始查询预判。已有工作较少回答的问题是:能否让强弱模型在同一个长程任务内部协作,用时机恰当的一次交接大幅省钱而不掉精度。
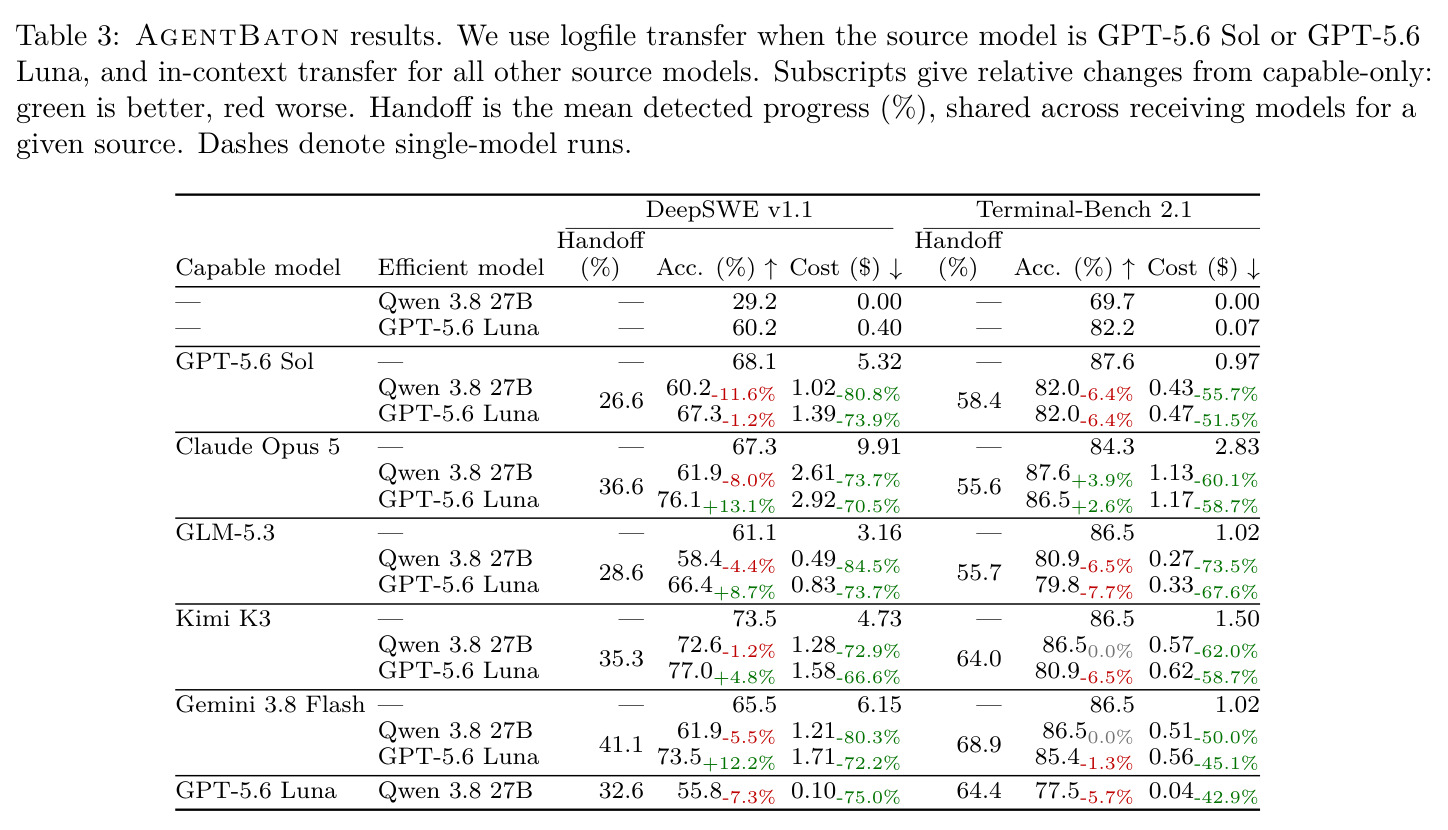
本文的目标是本文目标分两层。分析层:系统回答两个此前未被充分探索的设计问题——交接方向(efficient→capable 还是 capable→efficient)与上下文传递方式(in-context 直接进上下文,还是 logfile 写成日志文件按需查看)如何影响精度-成本权衡,并在源模型基线轨迹的 15%~90% 共六个进度点做受控交接实验,找出何时交接是安全的。系统层:把分析发现的交接就绪模式(已有实质实现、拿到任务相关反馈、剩余工作局部化)变成可在线运行的轻量检测器 AgentBaton,在强模型每个回合后判断是否交棒。量化目标非常明确:在 11 组模型对、两个基准上平均降低 API 成本 65.9% 且精度基本保持(部分配置提升最高 8.8 个百分点),并把精度-成本 Pareto 前沿推到所有被评测单模型配置(含各档推理力度)之外。
与已有工作不同的是,切入角度的独特性有三点。其一,把协作决策从「选哪个模型」转化为「何时交棒」:对给定强弱模型对固定模型选择,只学交接时机,把问题压缩成逐回合的轻量二分类,这与 Router-R1、ToolOrchestra、MTRouter 等每回合在候选模型间做选择的编排框架本质不同。其二,通过「较早检查点交接失败、下一检查点成功」的配对案例分析(Figure 4),归纳出交接就绪的三个可判别信号——实质产出、具体执行反馈、剩余工作局部化——使交接时机从拍脑袋的百分比阈值变成可学习的量。其三,实验上确立了交接方向的不对称性:efficient→capable 普遍不划算(常常精度更低甚至更贵),capable→efficient 在合适阶段几乎白赚;这一不对称直接否定了细粒度每回合路由在智能体场景的可行性——频繁切换会累积轨迹错误,强模型须反复花算力救火。与同期研究 Handoff Tax 用预设切换点做现象学分析不同,本文进一步训练了在线检测策略,完成了从「观察到方法」的闭环。
核心方法
直觉上是接力赛:让最强的选手起跑,跑出足够领先优势后把接力棒交给便宜但足够完成剩余冲刺的队友。技术路线分三步。第一步受控分析(Section 3):用 mini-SWE-agent v2.4.0 极简脚手架(线性历史加 shell 动作接口)让三个 capable 模型(GPT-5.6 Sol、Kimi K3、GLM-5.3,effort=max)与 efficient 模型 Qwen 3.8 27B(xhigh)独立跑完两个基准;先记录基线轨迹,再在 15%~90% 的进度点用轨迹回放恢复工作区,系统评测两种交接方向 × 两种上下文传递的精度与成本,发现 capable→efficient 在合适时点近乎无损地大幅省钱。第二步案例归纳(Figure 4):对比同一任务「早交失败、晚交成功」的配对轨迹,提炼交接就绪的三个重复出现模式。第三步训练检测器(Section 4.2):在 SWE-rebench V2 采样 2000 任务,每任务从五模型池随机选两个 capable 模型各跑一条轨迹共 4000 条,用 Codex 回溯标注最早合适交接回合 $h$,以 Qwen 3.5 2B 初始化做逐回合监督训练;推理时检测器挂在强模型每个回合后,输出 HANDOFF_READY 即把工作区与历史交给高效模型跑到底。
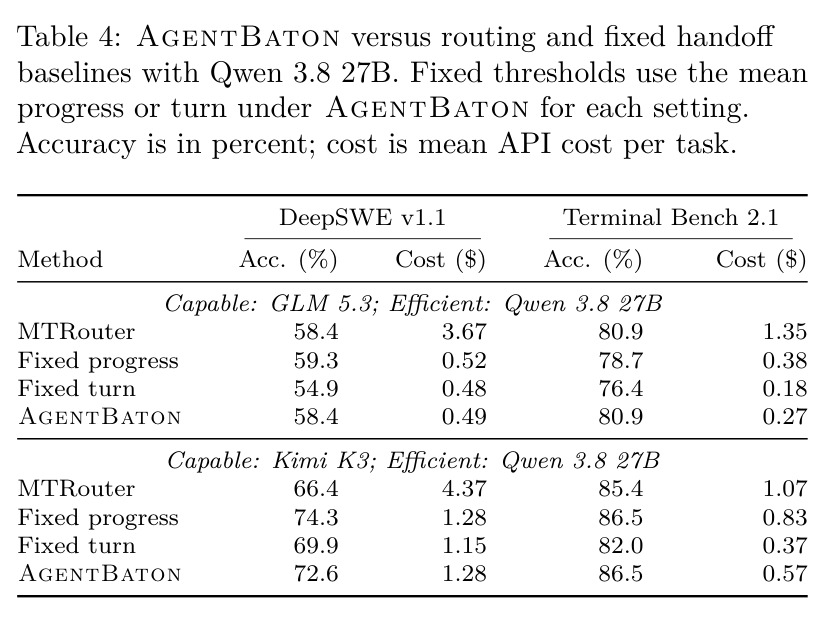
核心创新是把模型协作简化为一次性、时机由轻量检测器决定的交接。与已有工作有三点本质区别。第一,决策依据不是初始查询而是累积的任务进展:查询级路由在请求到达时静态选模型,而 AgentBaton 的 2B 检测器读取强模型已执行的动作和工具返回,逐回合评估剩余工作是否已收敛到弱模型可完成。第二,交接是一次性单向事件:READY 后 efficient 模型接管直到终止,不再切回,避免频繁切换累积轨迹错误、强模型反复救火的协调开销——基线对比给出实证:GLM 设置下 MTRouter 花 $3.67 才拿到 58.4% 精度,AgentBaton 同精度只花 $0.49。第三,监督信号设计:对标注交接点 $h$,之前每个回合监督输出 HANDOFF_NOT_READY、第 $h$ 回合监督 HANDOFF_READY,且把 $h$ 之后所有回合也作正例训练(前置决策置 NOT_READY 并排除在损失外),既平衡每条轨迹只有一个正标签的极端不平衡,又显式模拟「错过时机后晚一点交也可行」的容错行为。三点合起来,使每回合仅增加一次 2B 前向(中位 338ms)就换来平均 65.9% 的成本下降。
方法步骤详情
完整流程四步。第一步数据与标注:在 SWE-rebench V2 随机采样 2000 个任务,每任务从五模型池(GPT-6 Astra 用 medium effort,其余用 max)随机选两个 capable 模型,各用 mini-swe-agent 独立尝试,得 4000 条轨迹;用 Codex 回溯审查,按三条标准(已有实质实现或任务产物;执行/测试提供具体反馈;剩余工作收敛为局部诊断、修复、验证或收尾)定位最早合适交接回合 $h$,无清晰转换点打 no-clear-handoff 标签。第二步训练:以 Qwen 3.5 2B 初始化,输入为多轮对话(检测指令 + 原任务 + 强模型动作与工具观察 + 历史交接决策);第 $h$ 回合监督 HANDOFF_READY,之前回合监督 NOT_READY,$h$ 之后所有回合也作正例;2 个 epoch、最大序列 32K、打包填充,NeMo Automodel 在 16 张 H100 上用 FSDP2 + bf16 + 激活检查点,AdamW 学习率 $10^{-5}$、$\beta_1=0.9$、$\beta_2=0.95$、权重衰减 0.1;9B 版本无明显提升。第三步在线检测:强模型先做任务,每回合后检测器评估更新后的轨迹,上下文超限丢弃最旧一半历史;NOT_READY 继续,READY 交棒。第四步接棒:efficient 模型继承工作区,按源模型选定方式(GPT-5.6 Sol/Luna 用 logfile,其余 in-context)获取历史后执行到终止。360 次真实输入(2K~121K token)实测中位延迟 338ms、p95 1.11s。
技术新颖性
技术新颖性有四点。一是问题形式化:把智能体协作从「多模型逐回合选择」(组合空间大、易累积错误)重构为「单次交接时机检测」这一个时序二分类问题,2B 模型即可胜任,部署开销可忽略。二是监督构造:传统序列标注只在标记点训练正负例,本文把 $h$ 之后全部回合作为额外正例并屏蔽其前置决策的损失,显式建模「错过后的补交」,针对正标签极稀疏的现实做了务实的重加权。三是传递机制的系统性结论:logfile transfer(历史写入环境内 .jsonl,接收方用 cat/grep/sed 按需查看)在 efficient→capable 方向普遍优于 in-context;而 capable→efficient 的最优方式取决于源模型是否暴露完整思维链——GPT-5.6 Sol 因不给 CoT 导致 in-context 信息不足、logfile 反而常更好,这一发现对同行有独立参考价值。四是与推理力度的正交性:Figure 1 显示不同源模型、effort 档位、接收模型的组合共同外推 Pareto 前沿,说明交接是 effort 调档之外的另一维算力分配手段,二者互补而非替代。
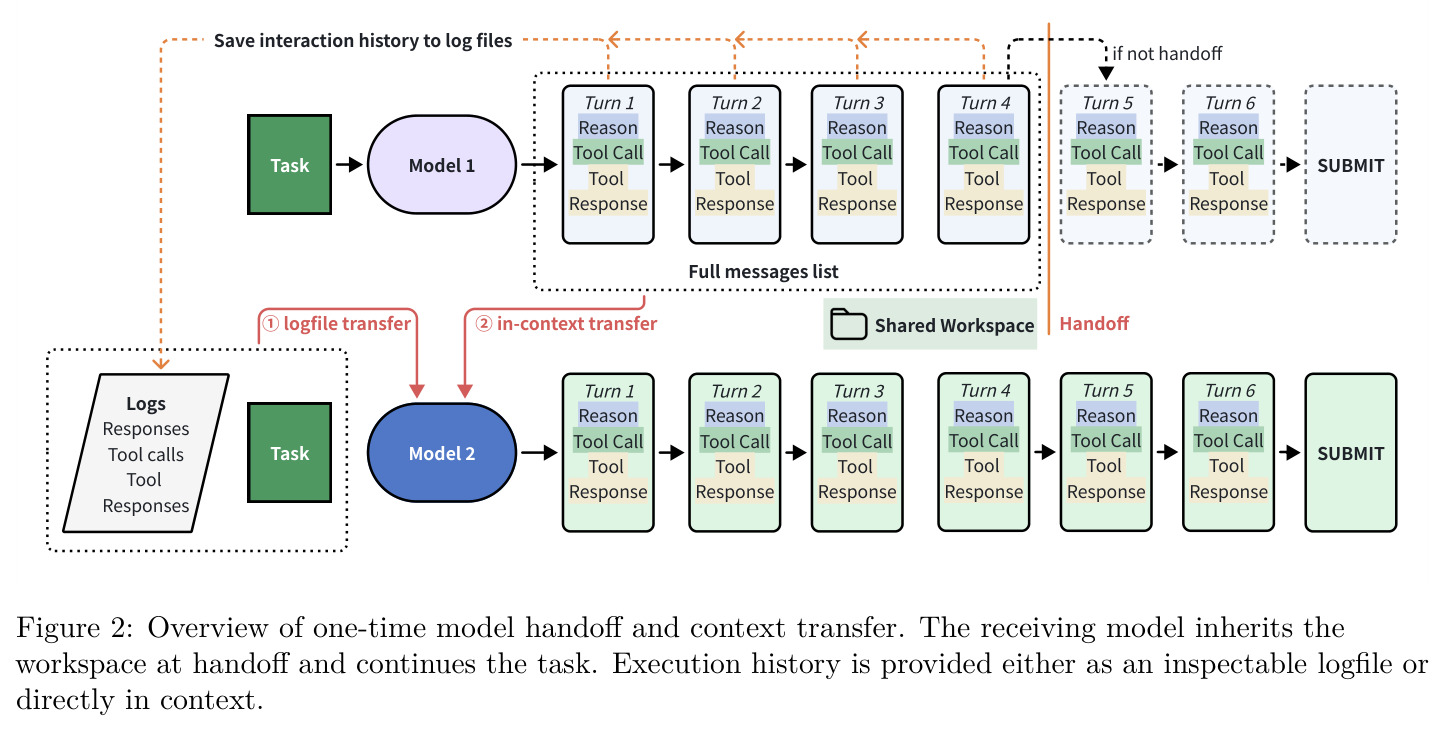
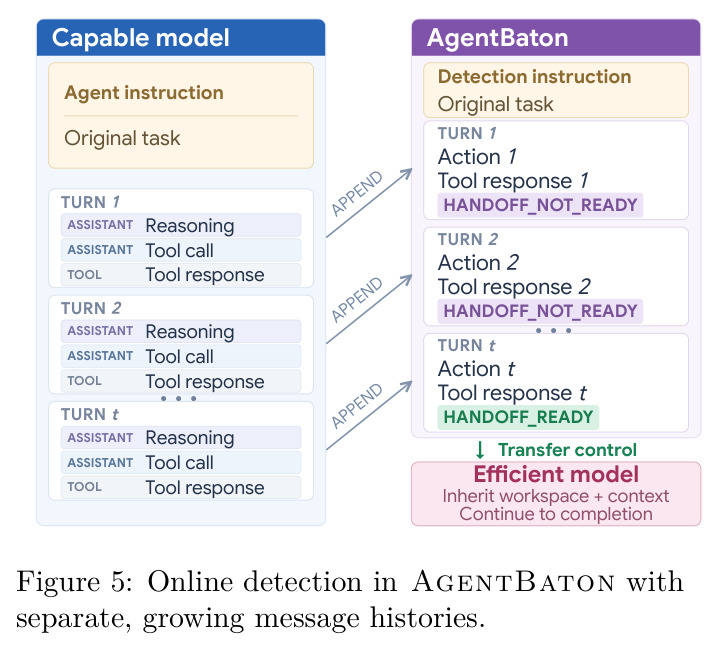
实验结果
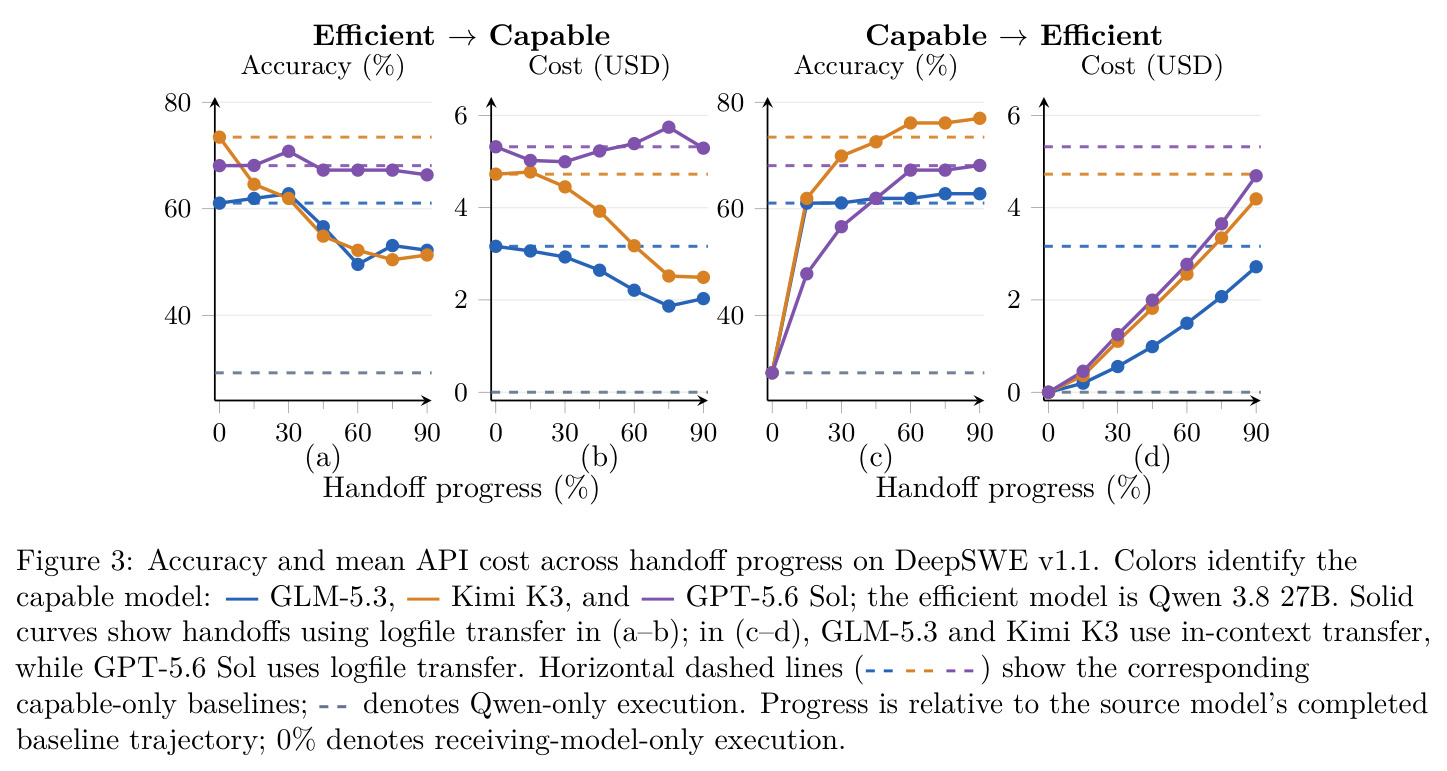
核心发现分四块。(1) 方向与传递分析(Table 1、Figure 3):efficient→capable 普遍不划算——Qwen→GPT 在 DeepSWE 30% 处精度 70.8% 略超 GPT-only 的 68.1%,成本只降 6.1%;capable→efficient 收益巨大:Kimi K3 在 45% 交接达 72.57%(基线 73.45%)省 61.5% 成本,GLM-5.3 在 30% 交接 61.1% 持平基线省 82.4%。(2) 提示词基线(Table 2):让强模型自己决定交接不可靠——Kimi K3 在 113 个任务中 0 次交接,GLM-5.3 仅 6 次,GPT-5.6 Sol 全交但平均成本仍 $3.75(单独跑 $5.32),必须外挂检测器。(3) 主结果(Table 3):11 组模型对、两基准平均省 65.9% API 成本,最高 +8.8 个百分点(Opus→Luna 在 DeepSWE 67.3%→76.1%,成本 -70.5%);检测点平均在源轨迹的 26.6%~41.1%(DeepSWE)与 55.6%~68.9%(Terminal-Bench);22 个设置中 12 个精度提升或相对损失小于 5%;Luna→Qwen 也能省 75.0% 成本。(4) 基线与 Pareto(Table 4、Figure 1):比 MTRouter 再省 46.7%~86.6% 成本且精度持平或更好;查询级路由器训练集准确率 99.55% 却几乎从不选 Qwen;Kimi→Luna(high) 达 79.6%@$1.60,超过最强单模型 Opus xhigh 的 75.2%@$8.90;Luna→Qwen(xhigh) 以约 $0.06 达到 Luna 单独的 56.6%。
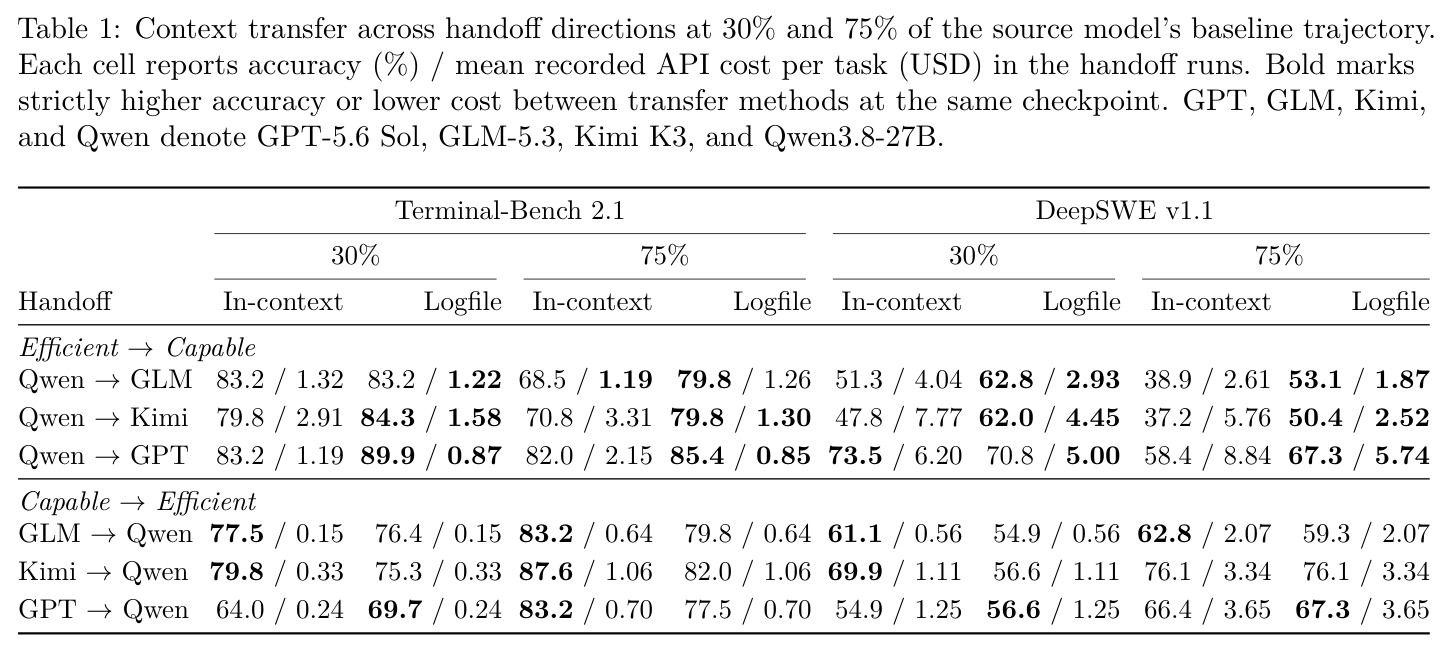
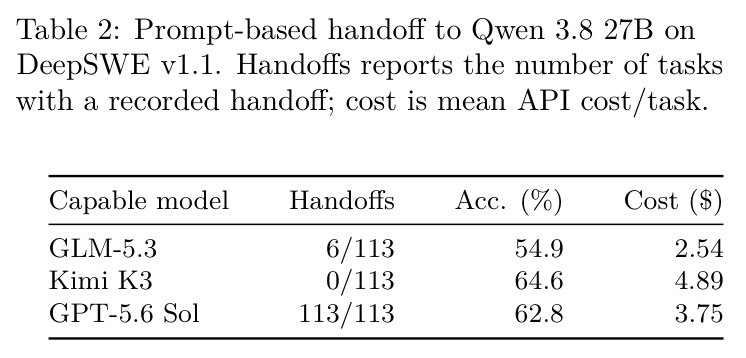
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSWE v1.1(Kimi K3 → Qwen 3.8 27B) | 任务精度 / 平均API成本 | 72.6% / $1.28 | Kimi K3 单模型:73.5% / $4.73 | 精度仅 -1.2%(相对),成本 -72.9% |
| DeepSWE v1.1(Claude Opus 5 → GPT-5.6 Luna) | 任务精度 / 成本 | 76.1% / $2.92 | Opus 5 单模型:67.3% / $9.91 | 精度 +8.8 个百分点(+13.1% 相对),成本 -70.5% |
| Terminal-Bench 2.1(Kimi K3 → Qwen 3.8 27B) | 任务精度 / 成本 | 86.5% / $0.57 | Kimi K3 单模型:86.5% / $1.50 | 精度持平,成本 -62.0% |
| DeepSWE v1.1(对 MTRouter,GLM 5.3 → Qwen) | 精度 / 成本 | 58.4% / $0.49 | MTRouter:58.4% / $3.67 | 精度持平,成本 -86.6% |
| DeepSWE v1.1 Pareto 扫描(Kimi K3 → GPT-5.6 Luna,high effort) | 精度 / 每任务成本 | 79.6% / $1.60 | 扫描中最强单模型 Opus 5 xhigh:75.2% / $8.90 | 精度 +4.4pp,成本约 -82% |
| DeepSWE v1.1 检查点交接(GLM-5.3 在 30% 进度 → Qwen) | 精度 / 成本降幅 | 61.1% | GLM-5.3 单模型:61.1% | 精度持平,成本 -82.4% |
局限与改进
作者承认的局限:实验基于 mini-SWE-agent 这一极简脚手架(线性历史、shell 接口),结论向复杂 harness 的外推未验证;只研究一次性单向交接,未探索切回或多次接力;成本核算把本地部署模型记为零成本,是会计约定而非真实经济成本。我的补充观察:(1) 训练数据全部来自 SWE-rebench V2 编码任务、标注由 Codex 完成,检测器在非编码域的泛化性未测;(2) 交接就绪三模式是从以 Qwen 3.8 27B 为接收方的案例归纳的,接收方更弱(如 7B)时安全交接点的定义可能变化,缺接收方规模消融;(3) 并非所有模型对都无损——GPT-5.6 Sol→Qwen 在 Terminal-Bench 相对降 6.4%,GLM→Luna 在 TB 降 7.7%,「基本保持精度」对部分配置不成立;(4) 基准仅两个且高度偏软件工程,任务谱窄使成本结论的普适性存疑;(5) 精度只报均值,未给方差或置信区间,交接点检测在重复运行下的稳定性未知;(6) 检测器每回合一次前向,超长任务中开销会累积,论文只报单次检测延迟 338ms,未报任务级累计成本。
独立分析的弱点
独立分析的弱点与改进方向。(1) 回溯标注的后见之明:Codex 在知道任务最终成败的前提下回溯定位最早交接点,而在线检测器没有未来信息,训练与推理存在分布错位;改进方向是用在线 rollout 的下游成败(交给 Qwen 后是否成功)作为回报信号做强化学习或偏好优化,让训练目标与部署对齐。(2) 一次性交接不可撤销:efficient 接棒后若陷入困境没有回退机制,其能力天花板(Qwen-only 仅 29.2%)直接决定下限;改进方向是加一个反向升级检测器,监控接收方进度停滞或反馈恶化时切回 capable 模型,形成双向接力。(3) 域窄:训练与评测都偏编码,检测器可能学到的是「代码项目接近完成」的表面信号而非通用任务就绪性;改进方向是混入数据分析、系统运维、科研计算等多域轨迹训练域不变检测器,并做跨域 zero-shot 评测。(4) 成本模型简化:本地零成本假设忽略硬件占用、电费与延迟,也未计入检测器自身每回合的 2B 前向成本;改进方向是引入真实硬件成本函数并报告端到端开销。(5) 统计报告不足:无置信区间、无交接点方差;改进方向是每个配置多次采样报告区间,并公开失败案例分析。
未来方向
未来方向。作者层面的暗示:Figure 1 的推理力度 × 交接二维扫描显示二者互补,自然延伸是用一个统一策略联合决定 effort 档位与交接时机;论文只测一次交接,多段接力(capable→中等→efficient)与条件性切回值得探索。基于成果可延伸的:(1) 把「任务可交接性」形式化——对接收方能力建模,预测任意强弱对的安全交接点,免去每对模型重新做检查点扫描的成本;(2) 检测器多任务化,同时输出交接判断与建议的上下文传递方式(logfile 还是 in-context),因为最优传递方式依赖源模型是否暴露思维链;(3) 与上下文压缩结合,交接时提供渐进式摘要而非全量历史,进一步压 prefill 成本;(4) 真实部署研究:在本地 DGX Spark/Mac Studio 与云混合拓扑下测端到端时延与真实省钱比例;(5) 摆脱对 Codex 离线标注的依赖,用任务成败信号在线更新检测器;(6) 把交接对象从「另一个 LM」推广到工具、检索器或多智能体编排,使交接判断成为通用的资源调度原语。
复现评估
复现评估:正文未给出开源代码或模型权重链接,这是最大门槛。分块看成本。数据:SWE-rebench V2 公开,2000 任务采样可复现;标注需调用 Codex 对 4000 条轨迹回溯审查并人工抽检,API 费用与人力不可忽略。训练:超参给得很全(Qwen 3.5 2B 初始化、2 epoch、32K 序列、打包 batch 16、AdamW 学习率 $10^{-5}$、$\beta_1=0.9$、$\beta_2=0.95$、权重衰减 0.1、FSDP2 + bf16 + 激活检查点),但配置为 16 张 H100,普通团队难承担;2B 规模理论上可降到 4~8 张 A100/H800。评测:mini-SWE-agent v2.4.0、Terminal-Bench 2.1、DeepSWE v1.1 均公开,但全量评测需调用约 8 个商业模型的多档 effort,11 组模型对 × 2 基准 × 多检查点,API 成本估计数千美元以上。建议路径:先复现 Table 1 的检查点交接分析(只需 3 个 capable + 1 个 efficient 模型),再微调开源 2B 模型做检测器,最后选 2~3 个代表性模型对验证主结论,可把预算压缩一个数量级。
论文图表
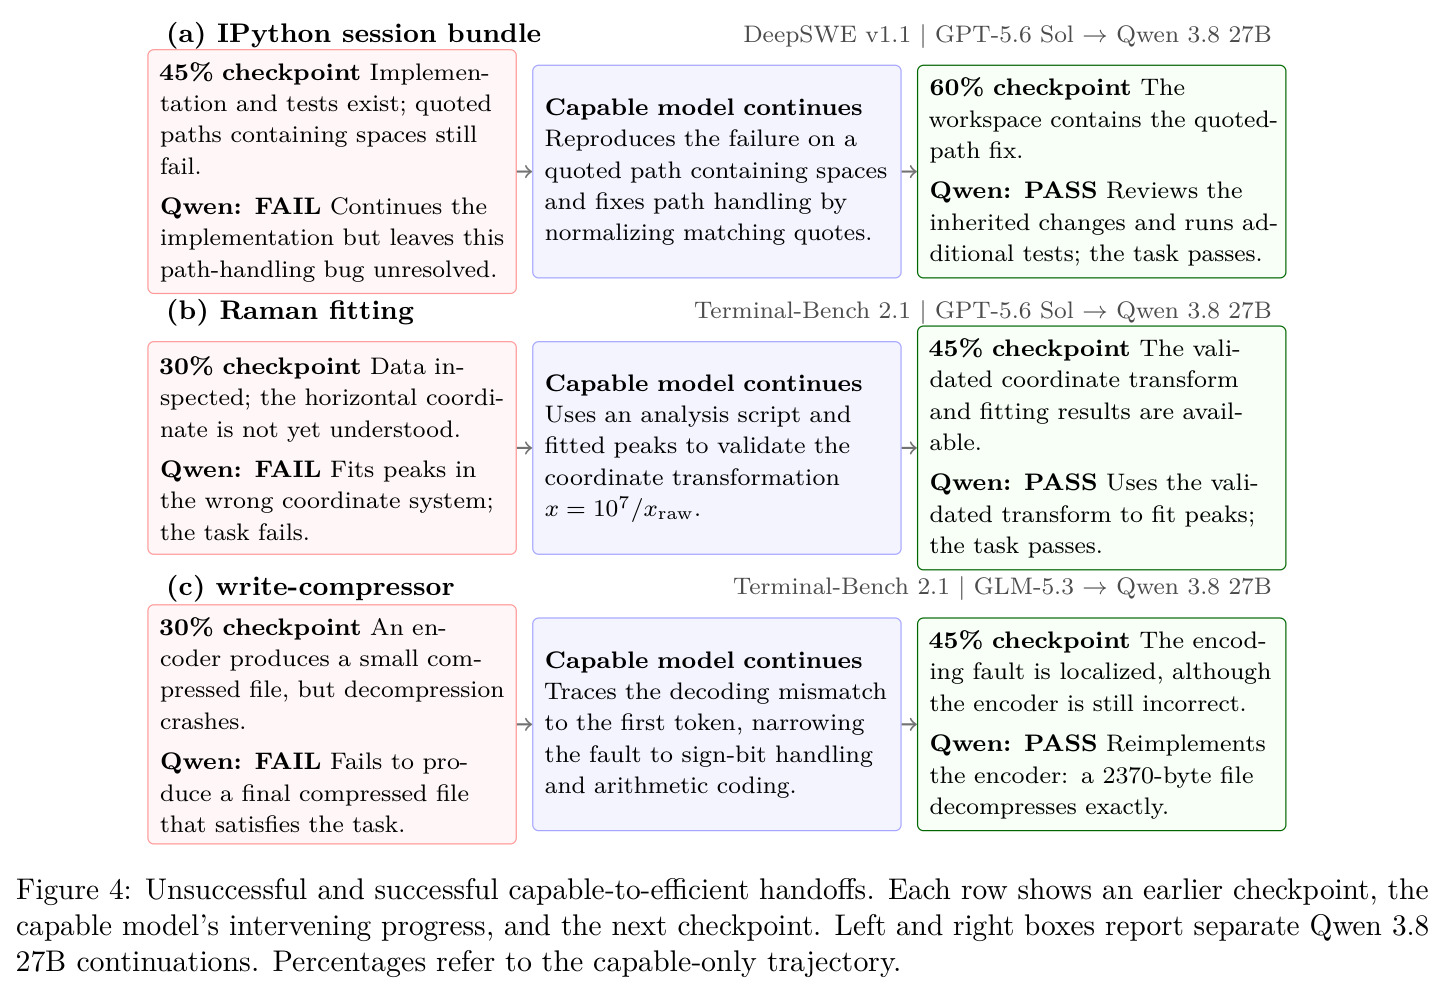
三个案例(IPython 会话包、拉曼拟合峰、write-compressor),每行展示较早检查点交接 Qwen 失败、强模型继续推进后的关键进展、下一检查点交接成功的前后对比,例如编码故障被定位到符号位处理后 Qwen 重写编码器即通过测试。
提出交接就绪模式的证据链:通过失败→成功配对对比归纳出实质产出、具体反馈、剩余工作局部化三个信号,是连接分析与方法的桥梁。