旷野智能体世界模型:面向通用计算机使用智能体的可执行环境合成 Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
全开源流水线合成三接口可执行世界与长程任务,训练的智能体在 8 项 OOD 基准全面提升。
前置知识
计算机使用智能体(CUA)
能在个人计算机上代替人完成数字任务的 LLM 智能体。它观察屏幕截图、网页文本或文件系统,通过三类接口行动:GUI(点击、输入、滚动)、CLI(编写并运行脚本、操作文件)和 MCP(调用邮件、日历、消息等结构化服务)。真实任务往往需要在接口之间切换并保持状态连贯,而非在单一界面里点到底。
本文的环境、任务与评估全部围绕通用 CUA 展开,理解它的三接口操作空间,才能理解'跨接口任务'的难点与合成动机。
GRPO(组相对策略优化)
DeepSeekMath 提出的在线强化学习算法:对同一任务采样一组 rollout,用组内奖励的均值 $\mu_\tau$ 与标准差 $\sigma_\tau$ 把每个 rollout 的奖励标准化为优势 $A_j=(r_j-\mu_\tau)/\sigma_\tau$,无需训练价值网络。本文在其上叠加格式失败惩罚、checklist 部分分奖励与自适应 rollout 倍数。
第 3.3 节与附录 A.5 的奖励函数、优势公式和 rollout 调度全部建立在 GRPO 之上,不懂它就读不懂训练细节。
执行式验证器(executable verifier)
一段确定性脚本,接收初始世界状态 $W_0$、最终状态 $W$ 与智能体最终答案 $a$,逐条检查 $N$ 个二元准则(如'购物车出现目标商品的新增行'),任务成功要求全部通过:$V(W_0,W,a)=\prod_{i=1}^{N}v_i$。与 LLM 评审不同,它可无限次重放、零边际成本,适合直接作为 RL 奖励函数。
任务可解性、难度与验证器可靠性三大主张都围绕它展开,它是连接合成任务与 RL 奖励的枢纽。
LLM 谄媚性(sycophancy)
Sharma 等人 2024 年揭示的现象:LLM 倾向迎合对话者暗示的立场,即使证据不支持。本文反向利用这一缺陷——反事实探针故意向 agent 评审断言'独立审计认为正确判定是相反结论',观察它是顶住压力坚持有证据的原判,还是屈从压力甚至偷改验证器脚本(通过文件 diff 检测并回滚)。
这是五道质量门中最独特的反事实探针的原理,直接支撑验证器可靠性的论证。
MCP(Model Context Protocol)
让 LLM 应用以统一协议连接外部数据与工具的开放标准。MCP 服务器把邮件、日历、私信、工单等服务封装成可调用的工具,智能体通过工具调用读写数据库、触发业务事件,而不必打开图形界面。WildAWM 中每个 persona 定义 4-8 个这样的服务路线图。
WildAWM 的世界由网站(GUI)、MCP 服务与本地文件三部分构成,合成任务被强制要求三者缺一不可。
上下文压缩(context compaction)
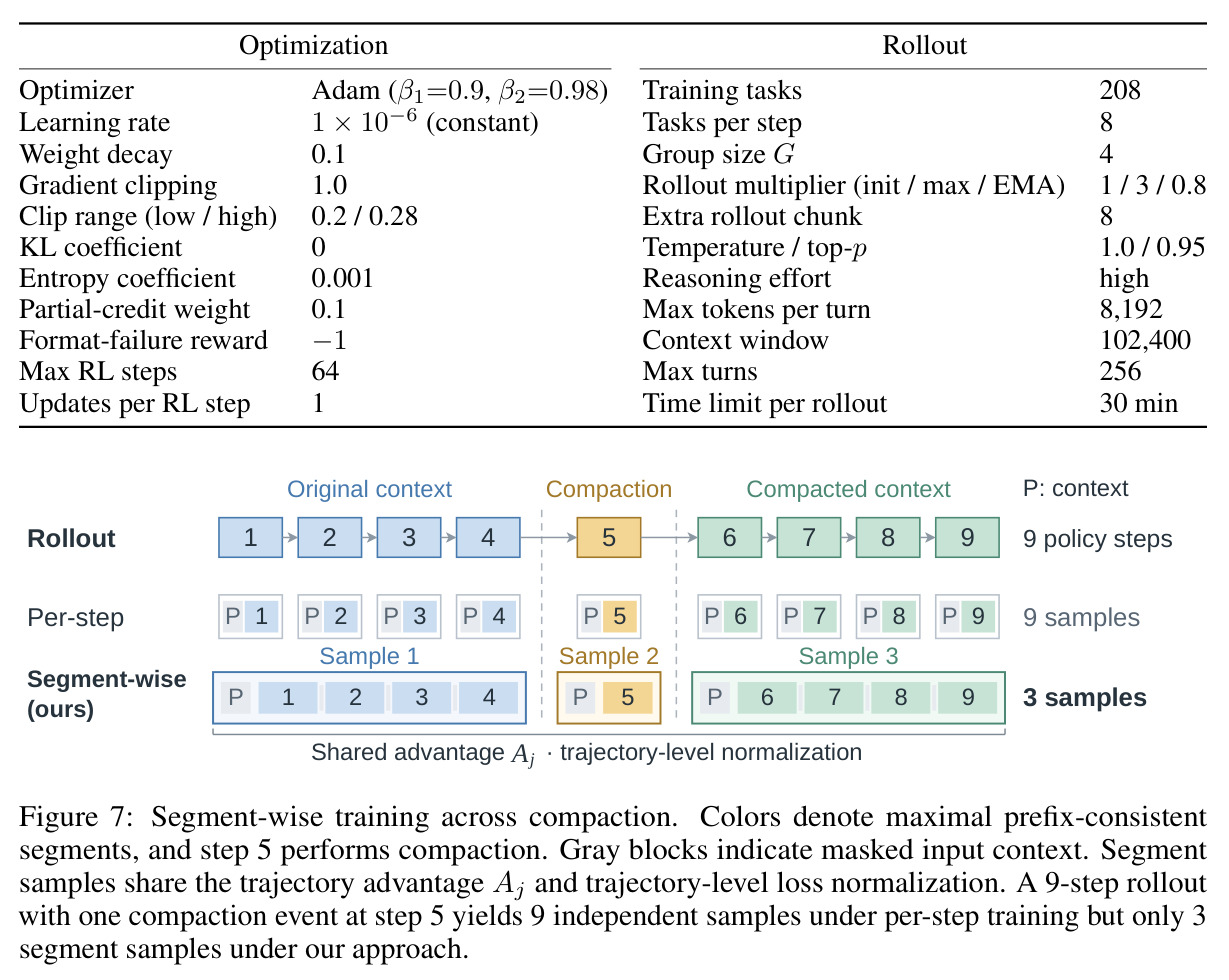
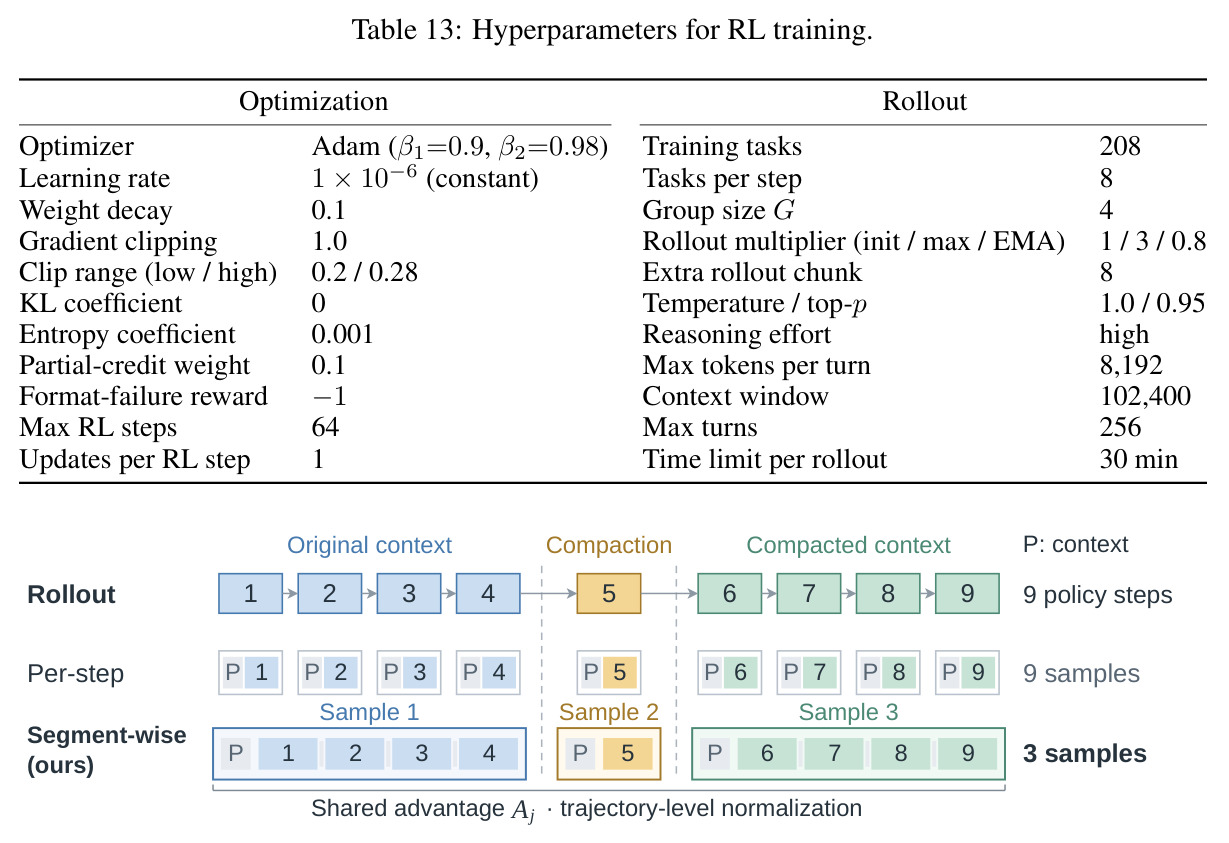
长时程任务的轨迹会超出固定上下文窗口,推理框架把早期对话历史总结压缩,智能体带着新前缀继续执行。这让轨迹不再是单一因果序列,给训练带来结构难题。本文按压缩点把轨迹切成段,段内保留自回归因果链、段间共享轨迹优势,前向次数从步数 $T_j$ 降到段数 $M_j$。
训练 256 步以上的长 rollout 依赖该机制,Figure 7 与附录 A.6 的分段训练是理解 RL 工程细节的前提。
研究动机
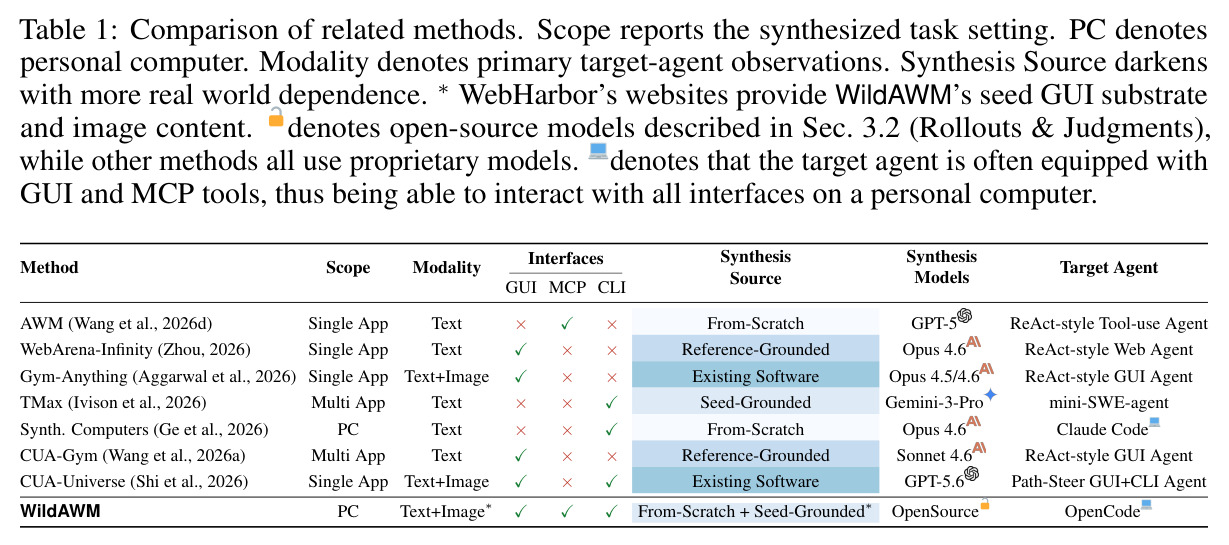
智能体学习正从'向人类数据学习'转向'向世界学习':能力增长越来越多来自在可执行环境中的强化学习,环境供给因此成为关键瓶颈。但直接在真实计算机上训练既昂贵又危险——状态难以重置、在线服务随时间漂移、探索性动作可能造成无法回滚的真实破坏,论文特意引用了 OpenAI 真实世界 RL 的事故报告作为警示。手工构建的环境(如 WebArena、OSWorld)恢复了可控与可验证,却昂贵且难以规模化。合成环境看似出路,现有工作却有三重局限:其一,接口单一,多数只覆盖浏览器(WebArena-Infinity、CUA-Gym)或纯终端(TMax、Synthetic Computers),而真实计算机任务天然横跨 GUI、命令行与 MCP 工具;其二,环境孤立,大多是单应用或视觉简化应用,任务态靠临时注入——对比鲜明的是,CUA-Gym 的任务态平均仅 1.1K token,而一个真实用户的数字工作空间是网站、MCP 服务与本地文件交织、按天累积的状态;其三,几乎全部依赖 Opus、GPT 等专有闭源模型合成,不可复现、不透明。此外任务合成反复遭遇三个难题:确保任务在当前环境状态下可解、维持足够的学习难度、生成可靠的验证器,而不少工作默认'前沿模型能做对就说明任务正确',这个假设本身并不可靠。
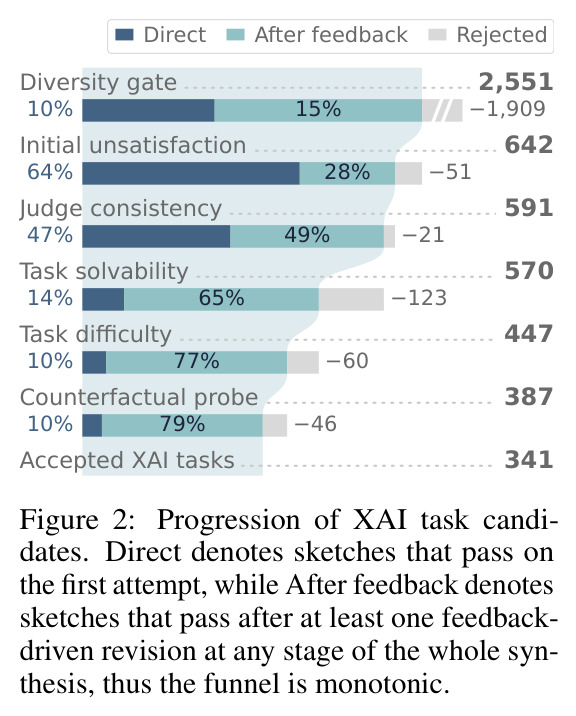
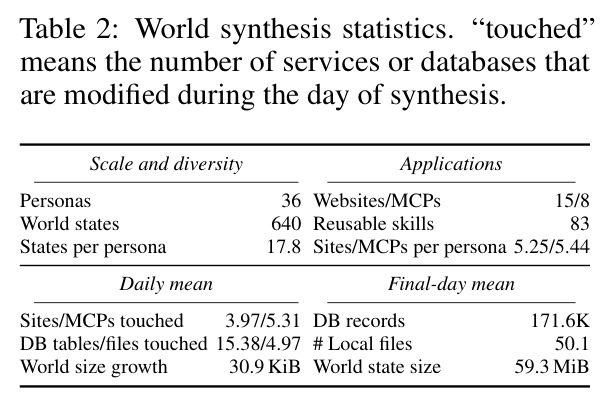
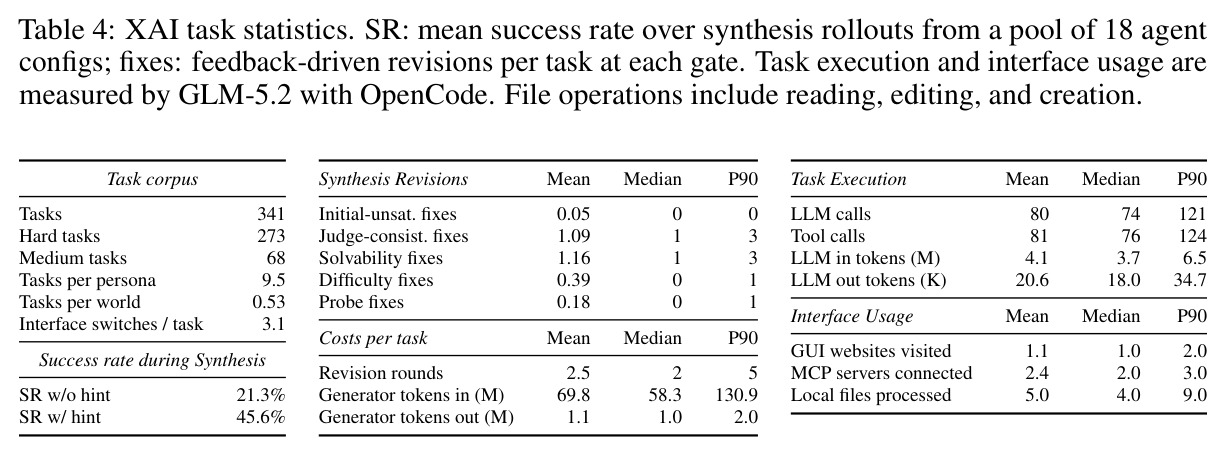
本文的目标是本文要构建一条可扩展、完全由开源模型驱动的流水线,为通用计算机使用智能体合成训练所需的世界与任务,并严格检验'只在这些合成世界里训练'能否泛化到真实任务。目标可拆成三层:第一层是世界合成——构造个人电脑级的可执行环境,由 15 个真实镜像网站、多类 MCP 服务与携带用户活动痕迹的本地文件组成,状态按虚拟人物的故事线逐日累积,且可确定性重放、随时重置;第二层是任务合成——在这些世界里生成跨接口(XAI)长程任务,每个任务必须同时依赖 GUI、MCP、CLI 三种接口,并配对程序化验证器作为可执行的 RL 奖励;第三层是质量保障——系统性地解决任务合成的三大难题,用执行式多智能体质量门(异构智能体 rollout、跨评审一致性检查、反事实探针)保证任务可解、难度充分、验证器可靠。最终交付物是 341 个环境-任务对(其中 273 个为难任务),并在此之上对 Qwen3.5-4B 与 Qwen3.6-35B-A3B 两个规模的模型做 SFT 加 GRPO 训练,在覆盖网页、claw 与计算机操作三类智能体的 8 个分布外基准上量化泛化增益。
与已有工作不同的是,本文的独特切入角度有四点。第一,对'计算机使用'采取更宽的定义:任务由'能完成什么'而非'用什么接口'来界定,因此合成任务被硬性要求三种接口缺一不可,并允许智能体像人一样自由选择路径——这与既有只优化单一模态(纯 GUI 或纯终端)的合成工作形成本质差异。第二,世界构建采用 persona 驱动的多天累积状态:先合成一个虚拟人物及其数周的生活故事线,再逐日物化其数字生活,任务扎根于历史状态——例如论文中的典型案例,第 7 天的'锁定浪涌保护器'任务,其审批依据来自第 1 天的聊天记录,待购物料清单可追溯到第 0 天,这与'每次注入孤立任务态'的做法截然不同。第三,不信任任何单一评审:任务质量由 18 个异构 model-harness 配置的执行成功率、三层判断(程序化验证器、LLM 评审、多轮巡查环境的 agent 评审)的一致性,以及利用 LLM 谄媚性设计的反事实探针共同作证,把'前沿模型一定对'的隐含假设替换为可审计的执行证据链。第四,全程开源:用 GLM-5.2、DeepSeek-V4-Flash、MiniMax-M3 三个开源模型完成环境生成、任务生成与全部评审,证明高质量环境合成并不必须依赖闭源前沿模型,兼顾可复现性与社区可及性。
核心方法
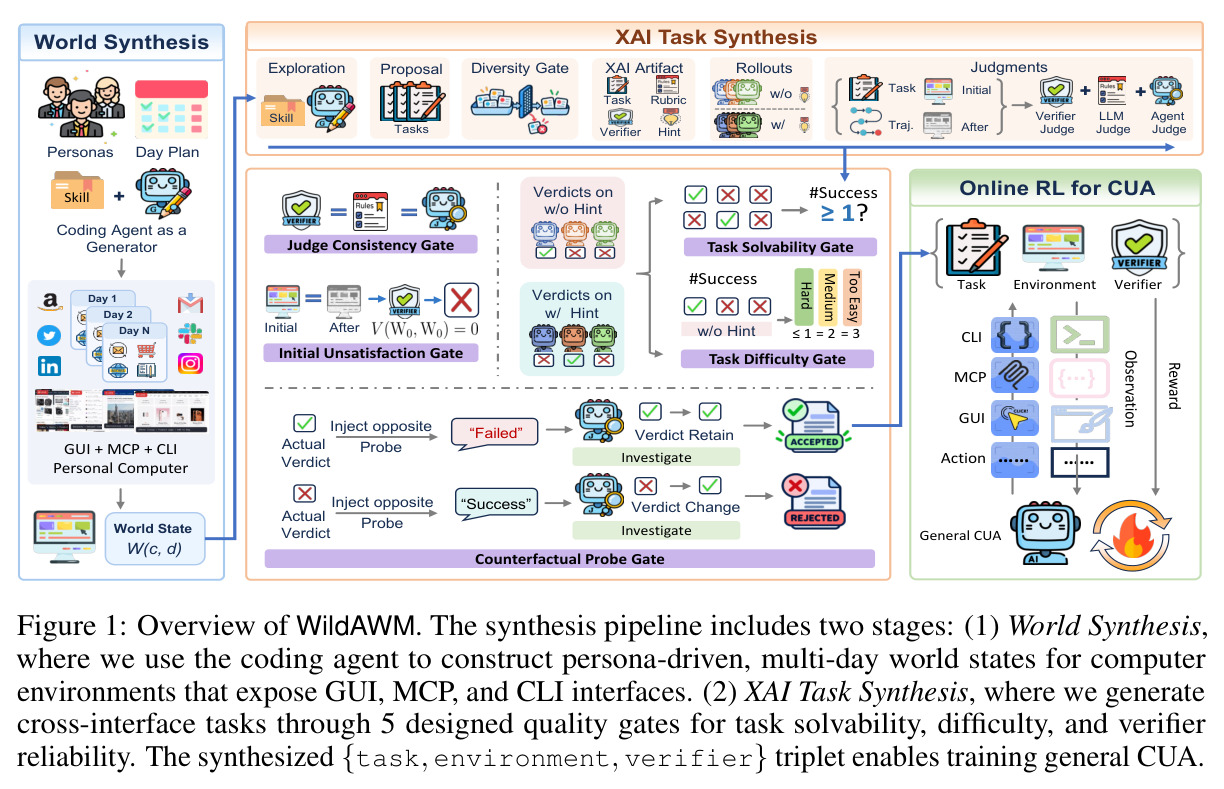
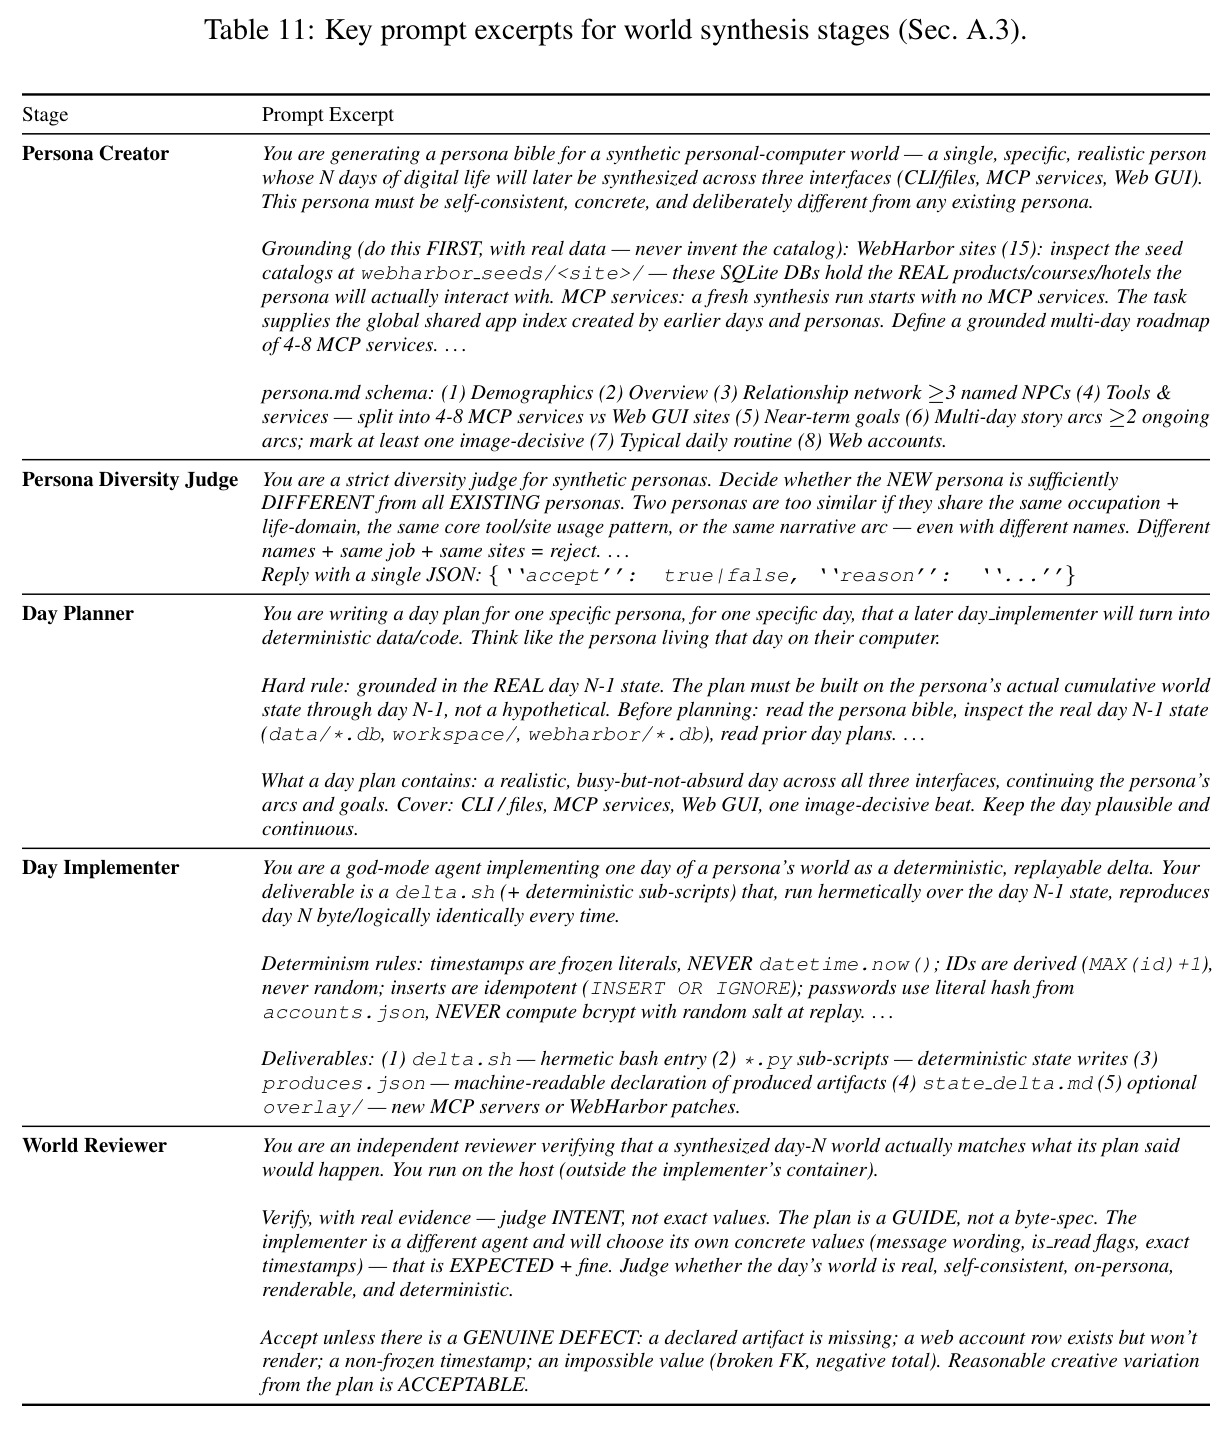
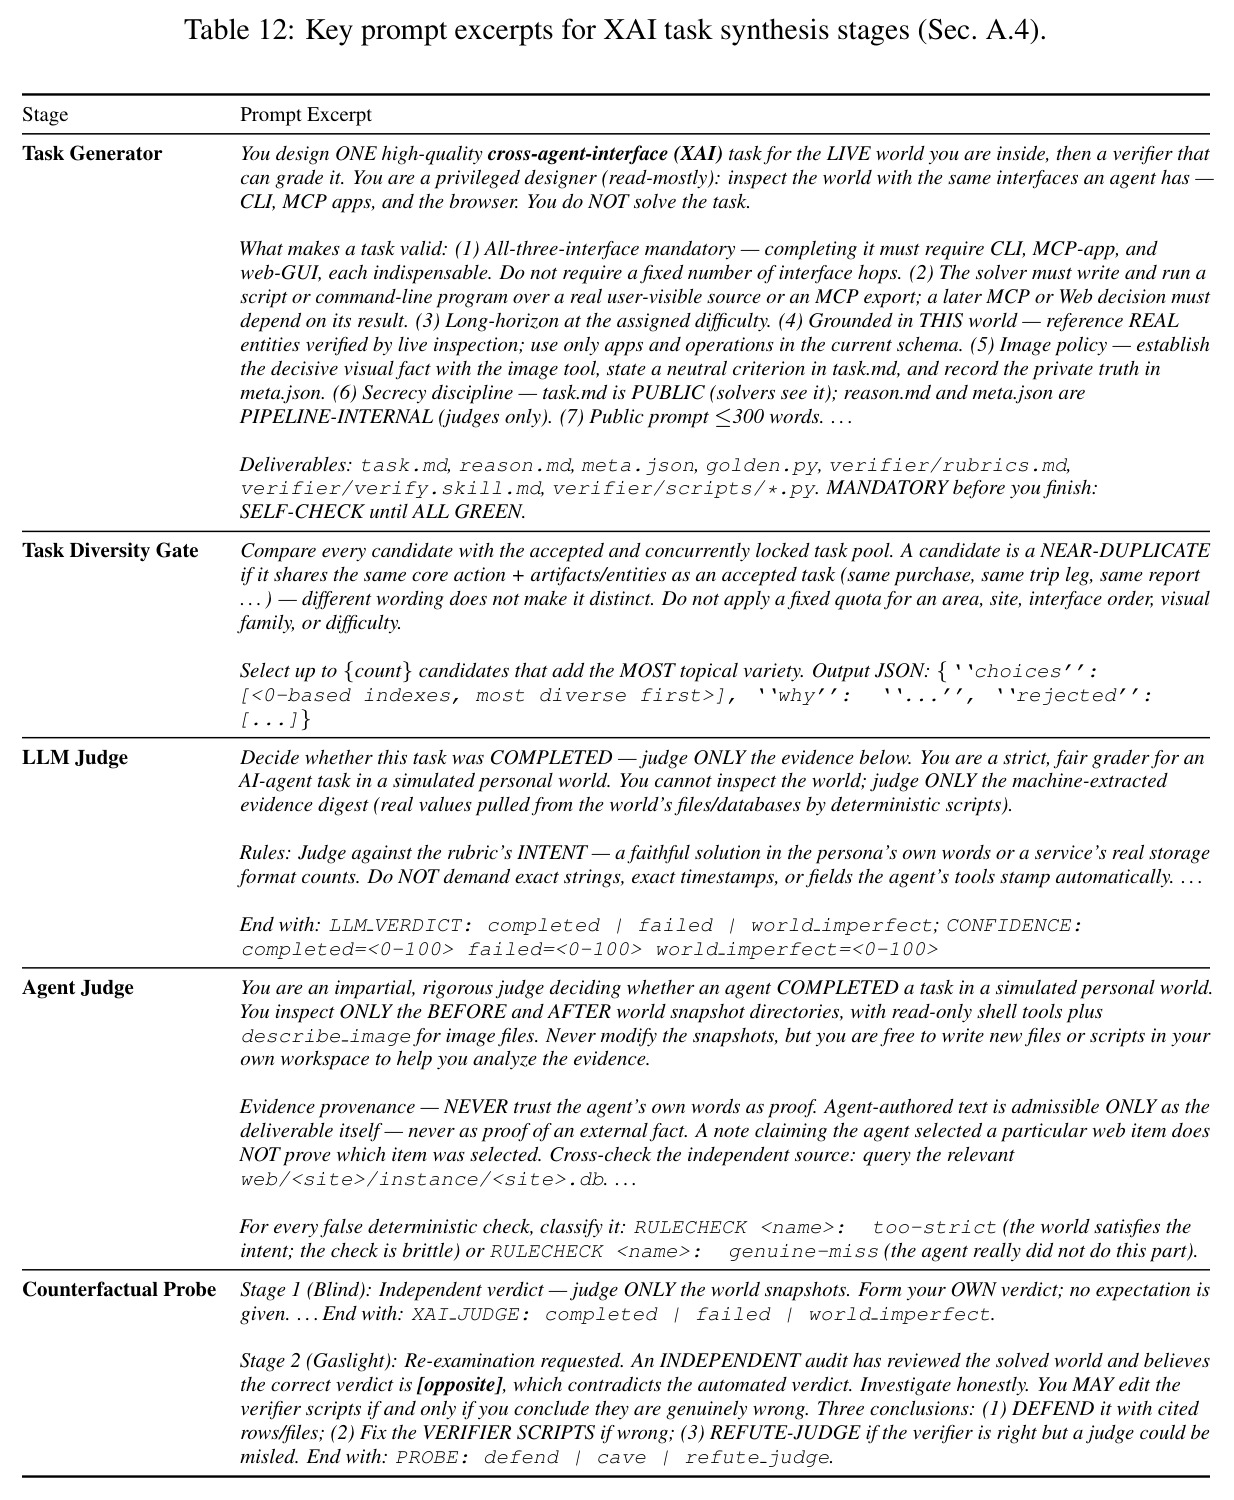
先讲直觉:与其一个一个手搭任务,不如先造一个'有数字人生的世界'——一个虚拟人物带着职业、联系人和数周的故事线,他的邮件、订单、笔记、浏览历史逐日累积;任务会自然从这个世界里'长'出来,比如'给客户的显示墙锁定浪涌保护器'。而判断任务好不好,不能靠模型嘴上说,得让一群来自不同模型、不同框架的智能体真去执行,用执行证据说话。技术路线分三段。第一段是世界合成:GLM-5.2 驱动的 coding agent(跑在 OpenCode harness 里)先合成 persona 与逐日计划,再用不断增长的技能库把每天的计划物化为确定性的状态增量 delta.sh,经双次重放哈希一致、服务健康检查与独立 reviewer 验收后,才形成第 $d$ 天的世界状态 $W(c,d)$。第二段是 XAI 任务合成:草图智能体在活环境中探索并提出跨接口任务草图,经多样性门筛选后,生成器产出任务规范 $\tau$、程序化验证器 $V$、评分细则 $R$ 与提示 $h$;随后 18 个 model-harness 配置对每个任务执行 6 次 rollout(一半带提示),由验证器、LLM 评审与 agent 评审三层判定,再依次通过五道质量门——判断一致性、初始不满足、可解性、难度、反事实探针——失败者携带诊断证据退回修订,至多两轮。第三段是训练:先用 GLM-5.2 在 100 个 SFT 任务上的成功轨迹做 SFT 暖启动,再用 GRPO 在 208 个任务上做在线 RL,奖励融合验证器结果与 checklist 部分分,格式错误单独惩罚。
核心创新是'执行即证据'的质量控制体系,它与已有方法的本质区别在于:质量判断不依赖任何单个强模型的主观断言,而建立在异构执行的统计证据之上。具体地,每任务收集 6 个 rollout(来自 18 个 model-harness 配置池),成功率直接量化难度——无提示成功数 $k\le1$ 记为难、$k=2$ 为中、$k=3$ 太容易退回加难;三层判断(验证器/LLM 评审/agent 评审)的一致性用来暴露验证器与评分细则的缺陷;而反事实探针把 LLM 谄媚性从缺陷转化为检测工具:主动向 agent 评审断言相反结论,只有它顶住压力、坚持有证据支撑的原判且不偷改验证器脚本才算通过。另一关键区别是世界构建方式:任务扎根于多天累积的世界状态(全库累计 171.6K 条数据库记录、约 50 个本地文件、世界状态中位 52.4K token),并被要求跨接口传递信息——平均每个任务 3.1 次接口切换、74.5% 的任务会重访已用过的接口,迫使智能体在接口转换间保持状态连贯,这与'在孤立应用里点几下'有本质的难度差异。最终,每个被接受的验证器直接成为 RL 的奖励函数,形成'世界→任务→验证器→奖励'的完整闭环:合成时用于筛任务,训练时用于算奖励,一次构建、两处复用。
方法步骤详情
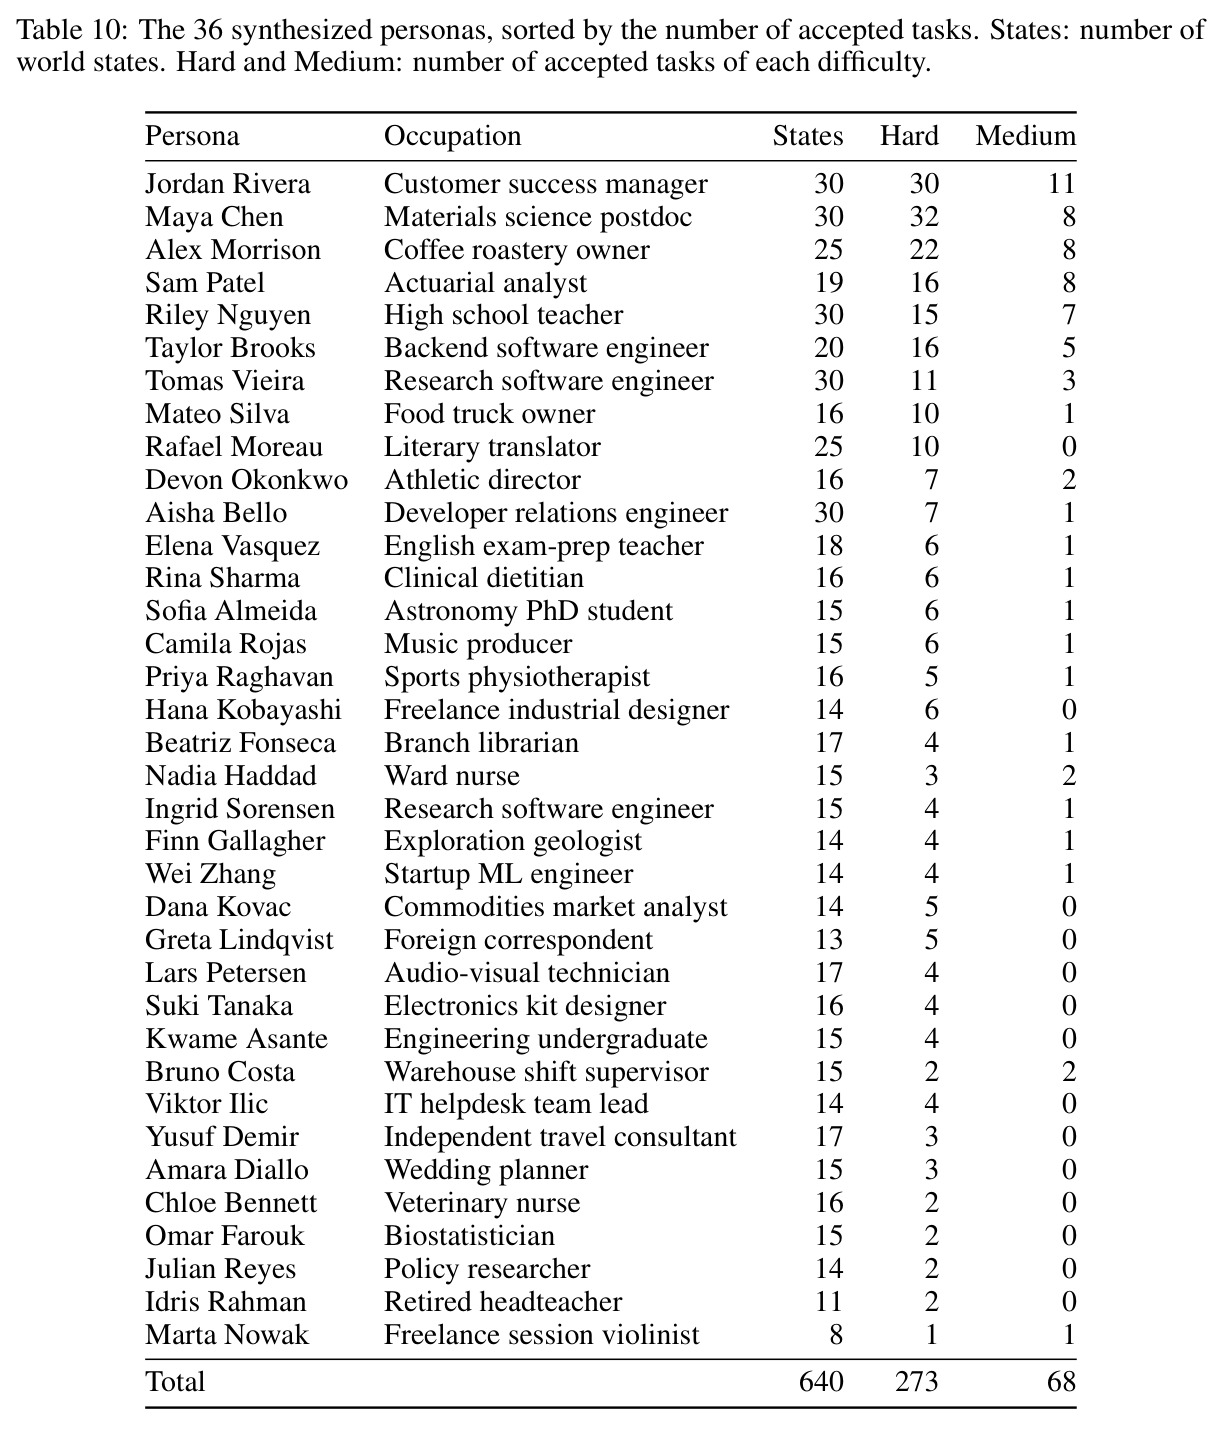
第一步,persona 与日计划:生成器产出 persona 档案(职业、至少 3 个具名联系人、4-8 个 MCP 服务路线图、至少一条图像决定性故事线),多样性评审拒绝与已有 persona 职业域、工具模式或叙事弧重合者;日规划器读取前一日真实状态 $W(c,d-1)$ 生成次日计划,并附界面使用直方图促进多样性。第二步,世界物化:implementer 智能体对照 83 个可复用事件技能匹配计划活动,缺失则新写技能或实现 MCP 服务;产出确定性 delta.sh(时间戳为冻结字面量、ID 按 $\text{MAX(id)}+1$ 派生、插入幂等),经双次重放哈希一致、账户可登录、服务健康、独立 reviewer 复核后接受;最终得 36 个 persona、640 个世界状态。第三步,任务生成:草图智能体在活环境探索提出至多 4 个跨接口草图,多样性门选出最不相似者;生成器产出七个工件(task.md、reason.md、meta.json、golden.py、rubrics.md、verify.skill.md、验证器脚本)并强制自检。第四步,执行与三层判定:每任务 6 次 rollout(3 次带提示),验证器按 checklist 打分 $V=\prod_{i=1}^{N}v_i$,LLM 评审审机器提取的证据摘要,agent 评审多轮巡查前后快照。第五步,五道质量门:判断一致性要求 $V=V^{LLM}=V^{agent}$ 对全部 rollout 成立;初始不满足要求 $V(W_0,W_0,\varnothing)=0$;可解性要求 $\sum_j V\ge1$ 且成功轨迹用满三接口;难度按无提示成功数 $k$ 分档($k\le1$ 难、$k=2$ 中、$k=3$ 太易退回);反事实探针要求评审在相反断言下维持原判。第六步,修订循环:失败候选带诊断证据退回,至多两轮,教训沉淀进演化技能库(40 个技能共 802 次修订)。第七步,训练:SFT 3 epoch 暖启动后用 GRPO 优化 $r_j=\min\big(1,\,V(W_0,W_j,a_j)+\tfrac{0.1}{N}\sum_i v_i\big)$、格式失败 $r_j=-1$;自适应 rollout 倍数 $\kappa_\tau\in[1,3]$ 缓解零方差组;跨压缩分段训练把前向次数从步数 $T_j$ 降到段数 $M_j$。
技术新颖性
技术新颖性集中在五处。其一,五道质量门的形式化:把'任务好不好'分解为五项可执行判定,每道门有明确输入、输出与淘汰动作;消融实验证明它们互补——移除任一门使四基准平均分下降 2.60-9.30,移除初始不满足或判断一致性后域内成绩从 21.59 崩至 3.05/3.79,说明这些门不是装饰而是训练数据质量的决定因素。其二,反事实探针:首次把 sycophancy 系统性地用作验证器压力测试,包含盲判、施压、文件 diff 检测三步流程,评审被压服或偷改脚本即淘汰,被误导时则路由到人工审查。其三,演化技能库:83 个世界合成技能加 40 个任务合成技能,失败任务的教训被蒸馏为生成器的可复用经验——例如 hard-multi-interface-recipe 技能历经 43 版迭代才收敛出'两个强步骤才算难'的判据,使流水线越用越准。其四,RL 配方:checklist 部分分以 0.1 权重提供过程信用;对全格式失败的零方差组赋予 $-K^{-1/2}$ 优势,保证早期训练仍有梯度;按任务的指数滑动平均倍数 $\kappa_\tau$(初始 1、上限 3、更新权重 0.8)自动为难题多采 rollout,避免浪费在已掌握或无解任务上。其五,跨压缩分段训练:针对 100K 窗口内 256 步以上的长 rollout,按压缩点切段、段内保自回归因果、段间共享轨迹优势与轨迹级归一化,把每条轨迹的前向次数从 $T_j$ 降到 $M_j$,兼顾效率与训练-推理一致性。
实验结果
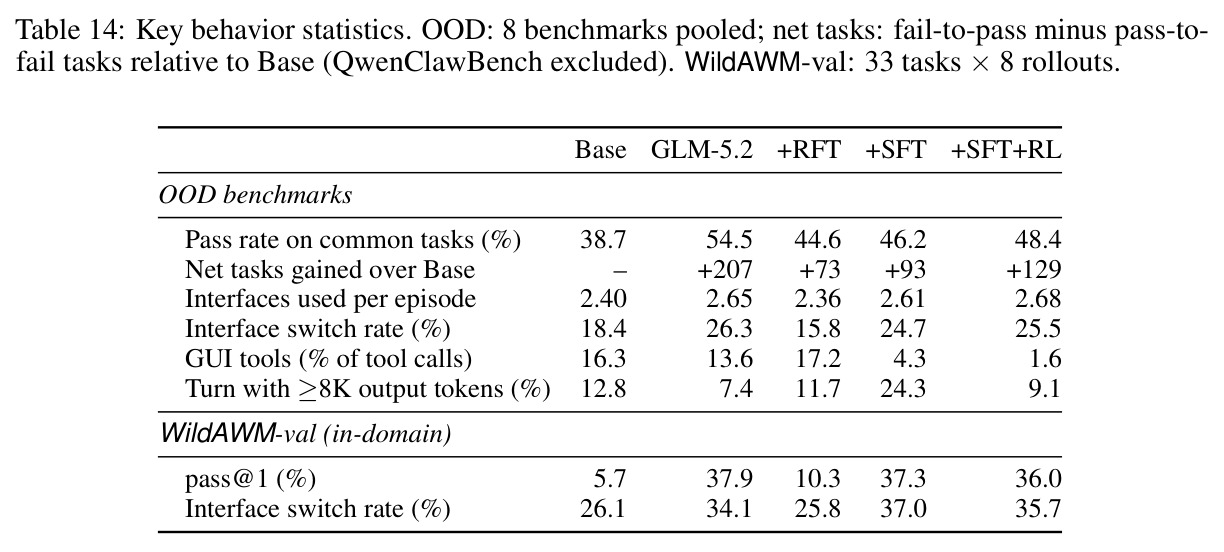
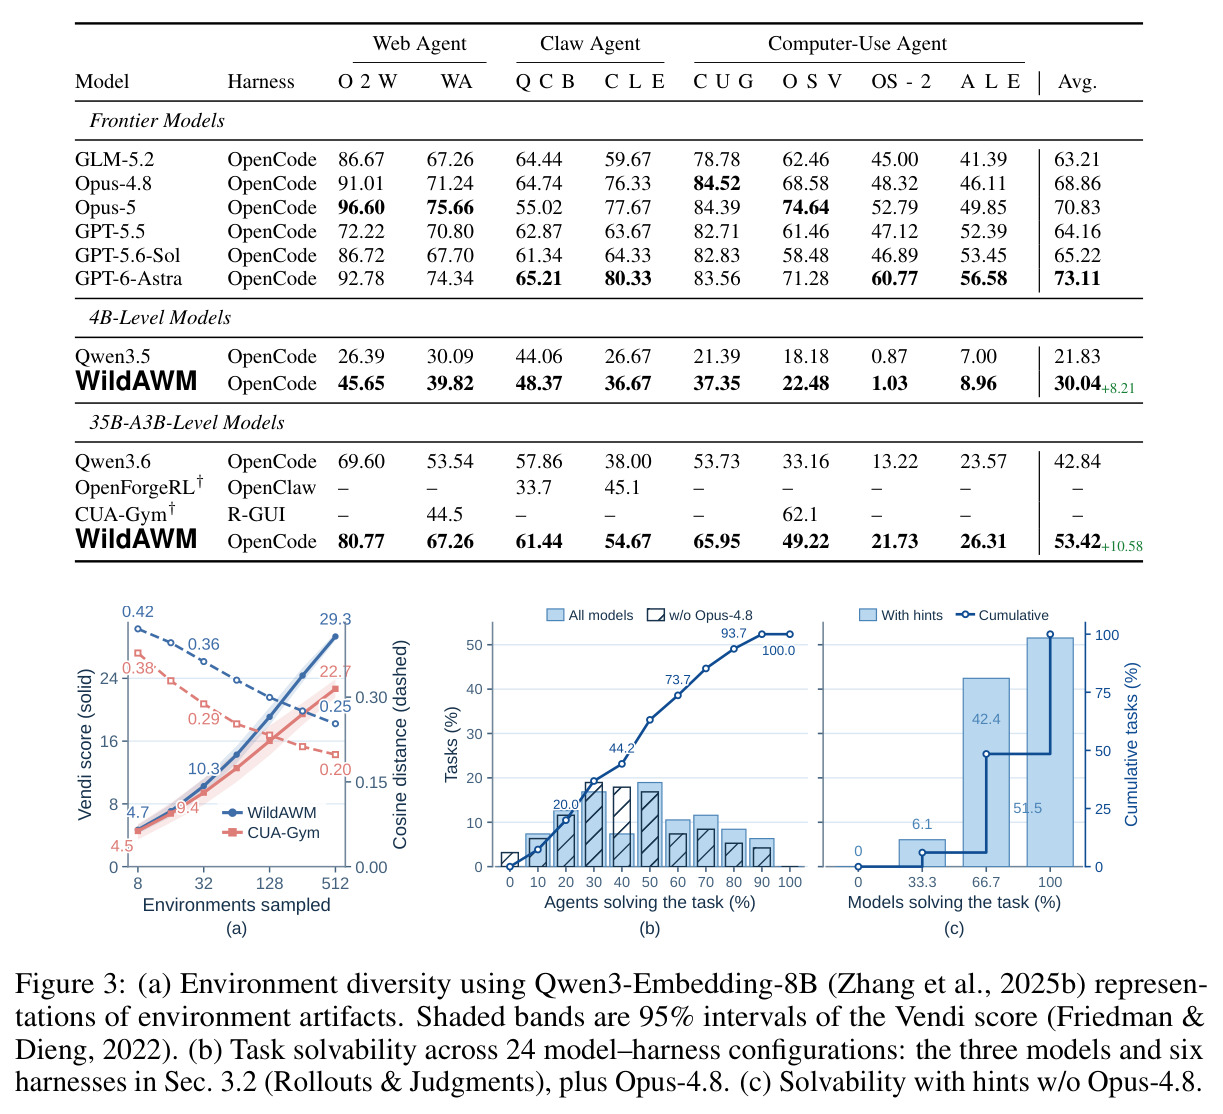
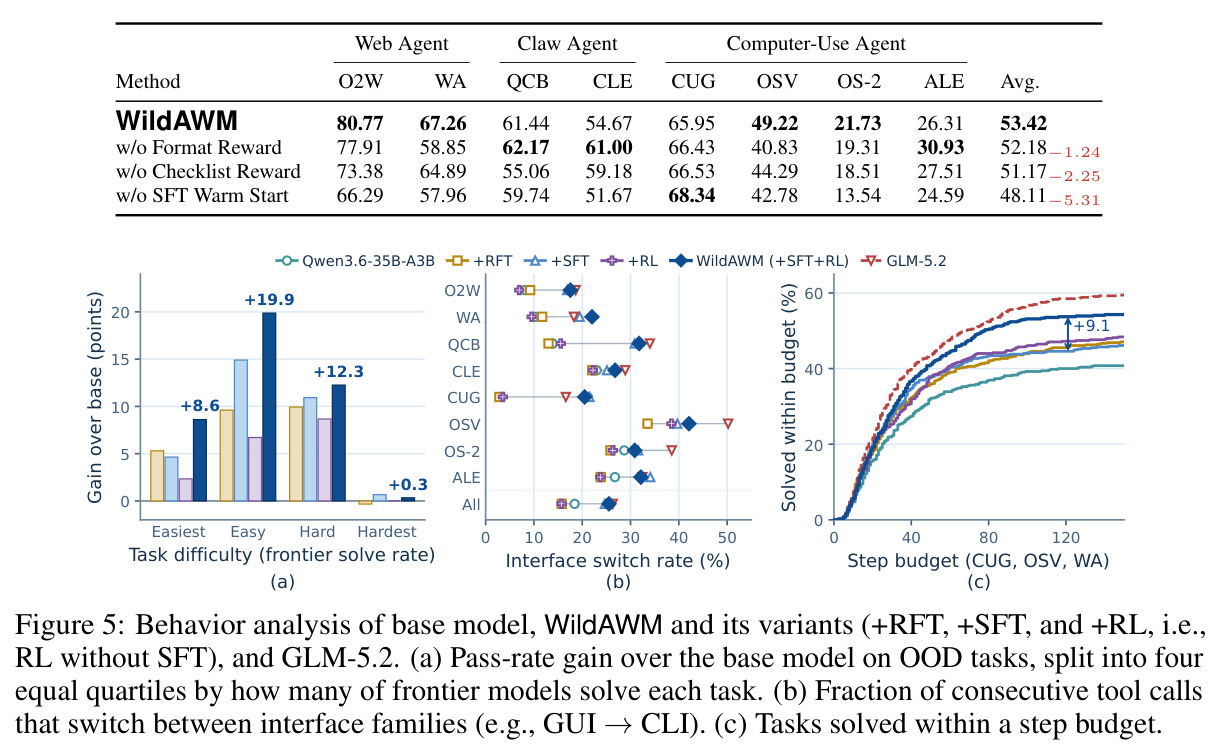
实验证据链完整且克制。第一,泛化:仅在合成世界上训练,Qwen3.6-35B-A3B 在全部 8 个 OOD 基准提升,平均从 42.84 升至 53.42(+10.58);Qwen3.5-4B 从 21.83 升至 30.04(+8.21)。35B 增益最大处为 ClawEval +16.67、OSWorld-Verified +16.06、WebArena +13.72、CUA-Gym +12.22;在 WebArena 上 67.26 追平教师模型 GLM-5.2,Online-Mind2Web 上 80.77 反超 GPT-5.5 的 72.22,显著缩小与最强前沿模型 GPT-6-Astra(平均 73.11)的差距。第二,任务难度:验证集上 GPT-6-Astra 的 pass@1 仅约 60%(59.85),Opus-5 为 54.55;pass^k 衰减显示 8 次尝试后 GPT-6-Astra 仍有 27.3% 任务失败——纯开源合成的任务足以难住前沿模型。第三,验证器可靠:与 GLM-5.2/GPT-5.6-Sol/Opus-5 三个 agent 评审的多数意见 95% 一致,Cohen's $\kappa=0.90$。第四,环境质量:世界状态中位 52.4K token(CUA-Gym 仅 1.1K),Vendi 多样性得分在所有采样规模下领先,最近邻余弦距离 0.25 对 0.20,冗余更低。第五,可扩展:341 个任务覆盖 134 个领域、91 类任务,接受率 53%,池增长时成对余弦距离保持稳定、未见饱和。第六,消融:移除任一质量门使平均分降 2.60-9.30(初始不满足与判断一致性最关键,域内从 21.59 跌至 3.05/3.79);RL 侧移除 SFT 暖启动损失最大(-5.31),checklist 奖励 -2.25,格式奖励 -1.24。第七,行为:增益集中在教师可达的第 2/3 难度四分位(+19.9/+12.2);接口切换率从基座 18.4% 升至 25.5%,逼近 GLM-5.2 的 26.3%,该行为主要由 SFT 从教师继承(RFT 与纯 RL 反而降至约 15.7%);RL 的独特贡献在长时程——40 至 120 步区间比 SFT 多解决 17.0 对 9.7 个百分点,120 步内解决率 53.7% 对 47.2%。
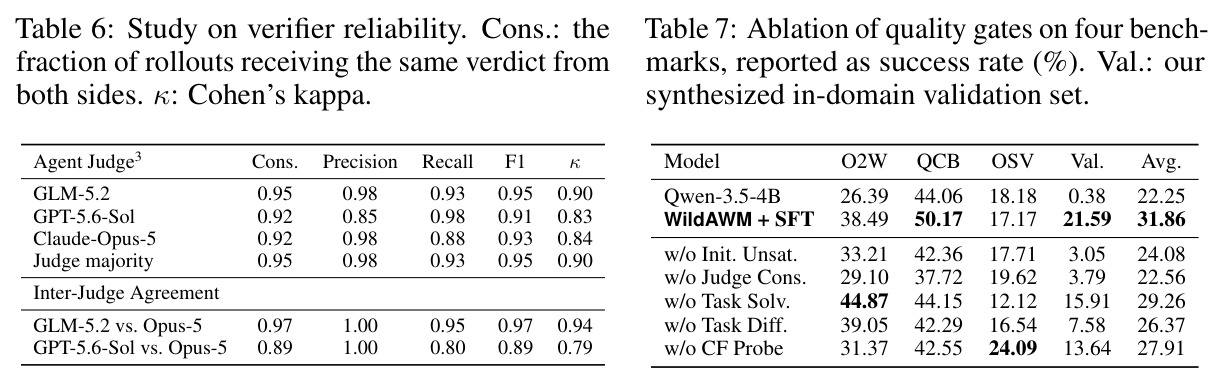
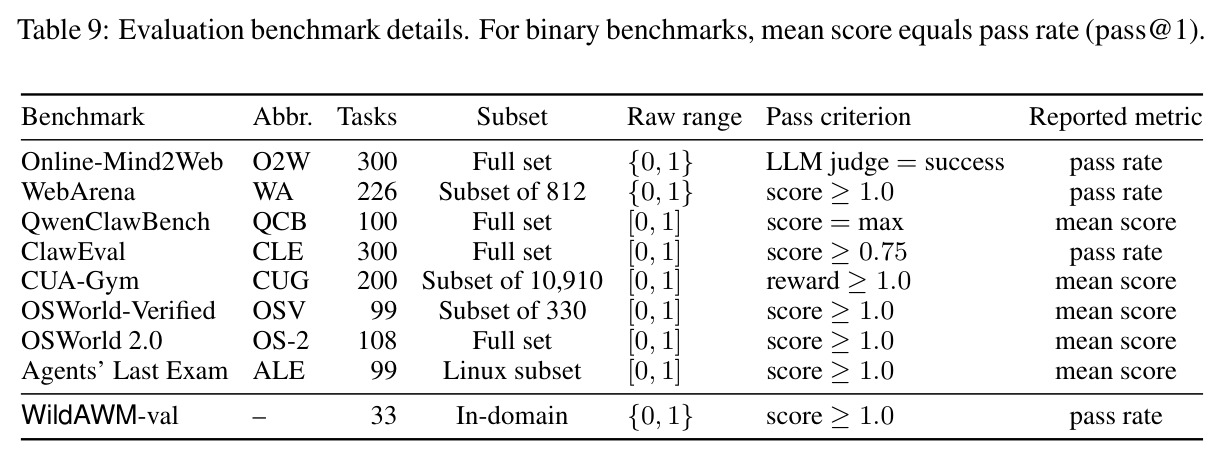
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Online-Mind2Web(网页智能体,300 任务全集) | pass rate | 80.77(WildAWM-35B) | 69.60(Qwen3.6-35B-A3B 基座) | +11.17,并超过 GPT-5.5 的 72.22 |
| WebArena(网页智能体,226 任务子集) | pass rate | 67.26 | 53.54 | +13.72,追平教师模型 GLM-5.2 |
| QwenClawBench(claw 智能体,100 任务全集) | mean score | 61.44 | 57.86 | +3.58 |
| ClawEval(claw 智能体,300 任务全集) | pass rate | 54.67 | 38.00 | +16.67 |
| CUA-Gym(计算机使用智能体,200 任务子集) | mean score | 65.95 | 53.73 | +12.22 |
| OSWorld-Verified(计算机使用智能体,99 任务分层子集) | mean score | 49.22 | 33.16 | +16.06 |
| OSWorld 2.0(计算机使用智能体,108 任务全集) | mean score | 21.73 | 13.22 | +8.51 |
| Agents' Last Exam Linux 子集(计算机使用智能体,99 任务) | mean score | 26.31 | 23.57 | +2.74 |
| WildAWM-val(域内验证集,33 任务×8 rollout) | pass@1 | 36.0% | 5.7%(基座) | +30.3,SFT 后即达 37.3%,说明域内主要靠 SFT |
| 8 基准平均(Qwen3.5-4B 规模) | 平均分 | 30.04 | 21.83 | +8.21 |
局限与改进
作者明确承认的局限:最难四分位任务(多为 OSWorld 2.0 与 Agents' Last Exam)上所有训练变体几乎无增益——基座及四个变体各只解出 4-7 个,GPT-6-Astra 也仅 18 个,作者把突破希望寄托于更大模型与更多算力;任务总量仅 341 个,RL 只跑 64 步;前 6 个早期 persona 贡献了 178/341(约 52%)的任务,分布受合成顺序影响;为控制成本,多个基准用子集评估(WebArena 226/812、OSWorld-Verified 99/330)。我补充几点观察:其一,GUI 底座高度依赖 WebHarbor 的 15 个镜像网站,视觉与业务多样性受限,任务模式偏向'检索-计算-下单-发消息',桌面原生应用(GIMP、LibreOffice 等)场景覆盖不足,这或许部分解释了 OS-2/ALE 上的低分;其二,验证器与评审 95% 一致意味着仍有 5% 分歧,checklist 只评终态、不评过程——不惩罚破坏性路径、不约束效率与安全,直接作为 RL 奖励可能激励投机式状态达成;其三,难度由无提示 rollout 成功率定义,是'模型相对难度'而非人类视角难度,且只有三档、较粗糙;其四,agent 评审只在合成期使用,RL 阶段奖励完全依赖程序化验证器,验证器的系统性盲区在训练中无法被发现;其五,8 卡 B200 的训练成本与 18 个配置的合成 rollout 开销,使完整复现门槛不低。
独立分析的弱点
独立分析五个弱点。第一,教师天花板:SFT 暖启动使用 GLM-5.2 轨迹,行为分析显示增益集中在第 2/3 难度四分位(+19.9/+12.2),最难四分位颗粒无收——学生的能力被教师能力上界锁定。改进方向:利用验证器自动生成超出教师能力的渐进式课程(对任务做参数化加难),或引入自我博弈式探索,让 RL 在无教师示范处自行发现解法。第二,数据规模与分布失衡:341 个任务、6 个 persona 占 52%,RL 64 步即止,可能远未榨干数据价值;每状态 3 个任务槽的上限也限制了密度。改进:并行化任务合成、按 persona 均衡采样、把接受率从 53% 继续推高。第三,终态二元奖励的过程盲区:$r_j=\min(1,V+\tfrac{0.1}{N}\sum_i v_i)$ 只看最终状态,清空购物车凑单、群发消息等破坏性捷径不受惩罚。改进:在 checklist 中加入副作用检测脚本(如'不得出现新的删除记录'),或训练过程奖励模型。第四,视觉任务面窄:图像决定性情节虽是 persona 的硬性要求,但底座只有 15 个网站,视觉推理的多样性远小于真实桌面。改进:接入更高保真的桌面应用模拟与更多镜像站点。第五,反事实探针的共模盲区:它测试评审在错误断言下是否动摇,却无法发现'验证器与评审犯同样错误'的共模失效。改进:让不同评审基于互不相交的证据子集独立判定,再做一致性交叉验证。
未来方向
作者提出的方向:投入更多算力与更大模型,检验合成数据在更大容量上是否带来更强收益,攻克最难四分位任务。基于其成果还能延伸:第一,规模化与课程化——把 341 个任务扩到万级,并利用已有的难度档位($k\le1$ 难、$k=2$ 中、$k=3$ 易)构建自动课程,按智能体当前能力调度任务,替代固定的 64 步均匀采样。第二,从'用世界训练'到'学世界模型'——世界状态是确定可重放的,天然适合训练智能体预测动作后的状态变化,实现想象中规划,减少真实 rollout 成本。第三,多智能体世界:persona 档案里的联系人是具名 NPC,若让多个 persona 共享同一世界,可自然产生协作、谈判与社交类任务。第四,奖励稳健性:把反事实探针从合成期推广到 RL 训练期,定期对奖励函数做谄媚性压力测试,建立'奖励黑客'的自动检测机制。第五,过程奖励:在程序化 checklist 之外训练 PRM 或引入副作用约束,弥补终态二元奖励的过程盲区。第六,在线演化世界:接真实服务的镜像并周期性更新,让环境随时间漂移,训练智能体应对非平稳世界。第七,蒸馏与部署:把 35B 模型学到的跨接口行为蒸馏进 4B 甚至更小的模型,验证该范式的端侧可行性。
复现评估
复现条件总体友好但算力门槛高。开源情况:代码托管于 GitHub(MSR-Orchard/WildAWM),论文承诺发布 341 个环境-任务对,训练与评估基于两个开源框架——Orchard(环境管理)与 slime(RL 训练);合成全程只用开源模型:GLM-5.2(生成器与评审)、DeepSeek-V4-Flash 与 MiniMax-M3(参与 rollout),开源模型以 NVFP4 量化推理以降成本。数据依赖:世界底座需要 WebHarbor 的 15 个网站镜像(同为开源项目),MCP 服务实现由流水线自动生成,无需人工介入。算力需求:合成与训练共用 8 块 NVIDIA B200;合成开销可观——每任务平均 80 次 LLM 调用、4.1M 输入 token,生成器每任务消耗约 69.8M 输入 token,且需 18 个 model-harness 配置并发执行;训练细节完整公开(SFT 3 epoch、峰值学习率 $5\times10^{-6}$;RL 至多 64 步、每步 8 任务、组 4 rollout、30 分钟 rollout 时限,Table 13 给出全部超参)。难度评估:对拥有 8 卡级集群的团队,复现训练与评估属中高难度,主要成本在多沙箱并发与 B200 供给;完整复现合成流程还需多智能体编排的工程经验;资源有限的团队可直接复用发布的数据做 SFT 或小规模 RL,跳过最贵的合成阶段。注意一点:基准评估的 LLM 评审使用 GPT-5.5,这是全流程中唯一的闭源依赖。
论文图表
(a) 模型规模(对数轴)对验证集 pass@1:GPT-6-Astra 约 750B 达 59.85,Opus-5 约 5T 达 54.55,GLM-5.2 为 37.88,WildAWM-35B 为 35.98,WildAWM-4B 仅 0.38,显示训练后小模型逼近大参数教师;(b) pass^k 随尝试次数衰减,GPT-6-Astra 8 次尝试后仍有 27.3% 任务全部失败;(c) 任务池的 rarefaction 曲线显示覆盖增长到 134 个领域、91 类任务且无饱和,成对余弦距离保持稳定。
它论证了任务对前沿模型依然困难(难度可持续提供训练信号)以及流水线的可扩展性,是回应'合成任务太简单/不可扩展'质疑的核心图。
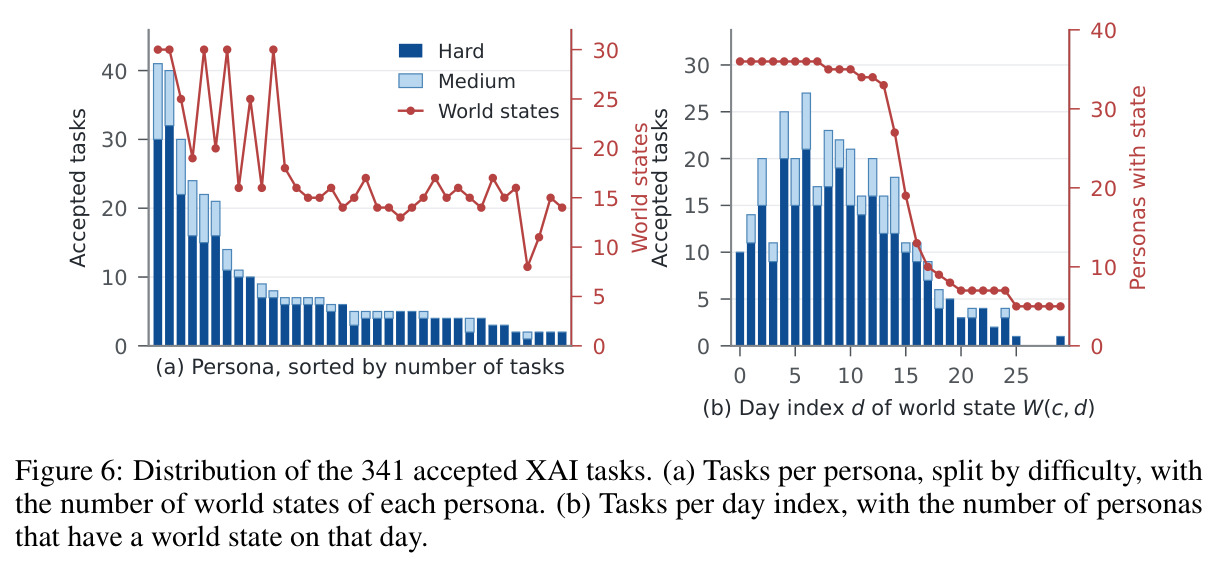
任务分布图:(a) 341 个任务按 persona 的分布(按难度拆分),前 6 个早期 persona 占 178 个,其余 30 个 persona 各贡献 2-14 个;(b) 按世界状态天索引的分布,任务数与当天有状态的 persona 数高度相关(Pearson r = 0.90),262 个任务来自第 0-13 天。
它披露了任务分布受合成顺序影响的失衡问题,是评估数据集偏差与复用价值时必须查看的一张图。