Cowork-Gym:大规模合成可执行的智能体协作工作环境 Cowork-Gym: Synthesizing Interactive Work Environments at Scale
用构建-执行-修订闭环批量合成带状态用户模拟器的协作环境,训练出的小模型比肩千亿参数模型。
前置知识
智能体环境与沙箱执行
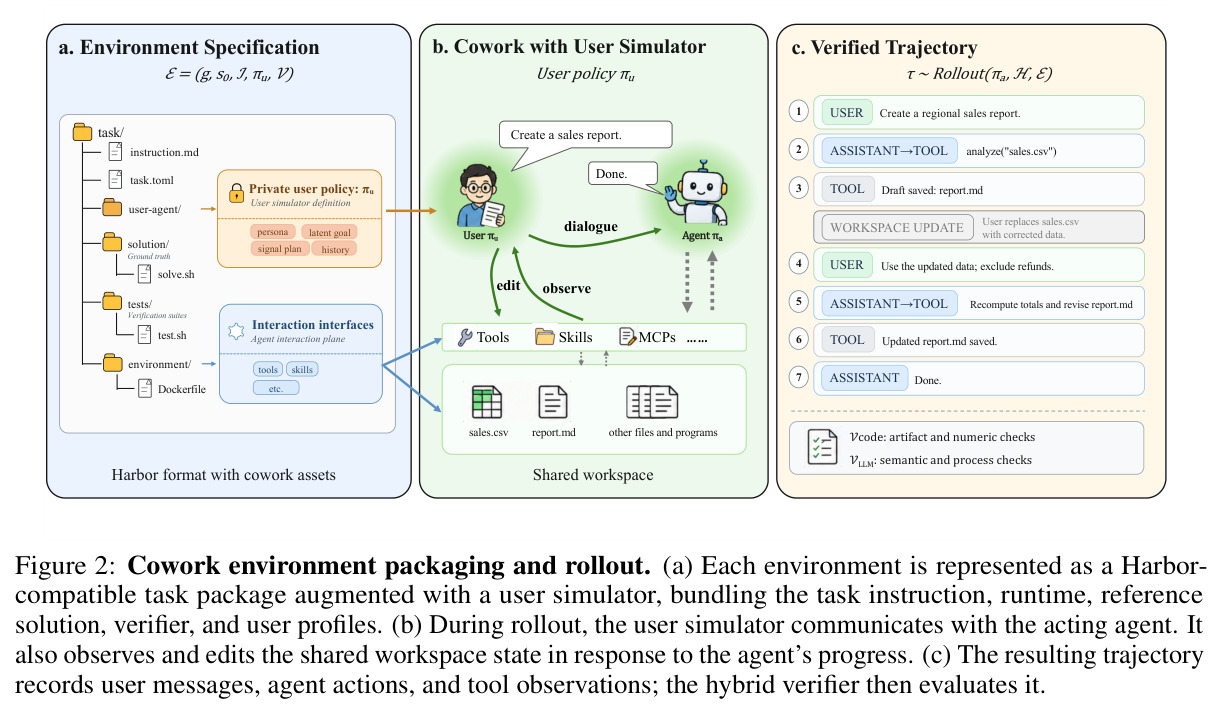
智能体环境指定义了任务目标、初始状态、可用接口与成功判据的可复现执行容器,通常运行在 Docker 沙箱中,保证智能体只能在允许边界内观察与修改状态,防止越权操作或取巧捷径。本文用五元组 $\mathcal{E}=(g, s_0, \mathcal{I}, \pi_U, \mathcal{V})$ 形式化:任务规范 $g$、初始工作区 $s_0$、接口集 $\mathcal{I}$、有状态用户策略 $\pi_U$、混合验证器 $\mathcal{V}$。
全文围绕『如何批量造出并验证这样的环境』展开,不理解五元组就无法理解 Builder、Verifier Constructor、Issue Detector 三个角色各管哪些组件、缺陷如何路由修复。
用户模拟器(User Simulator)与有状态策略
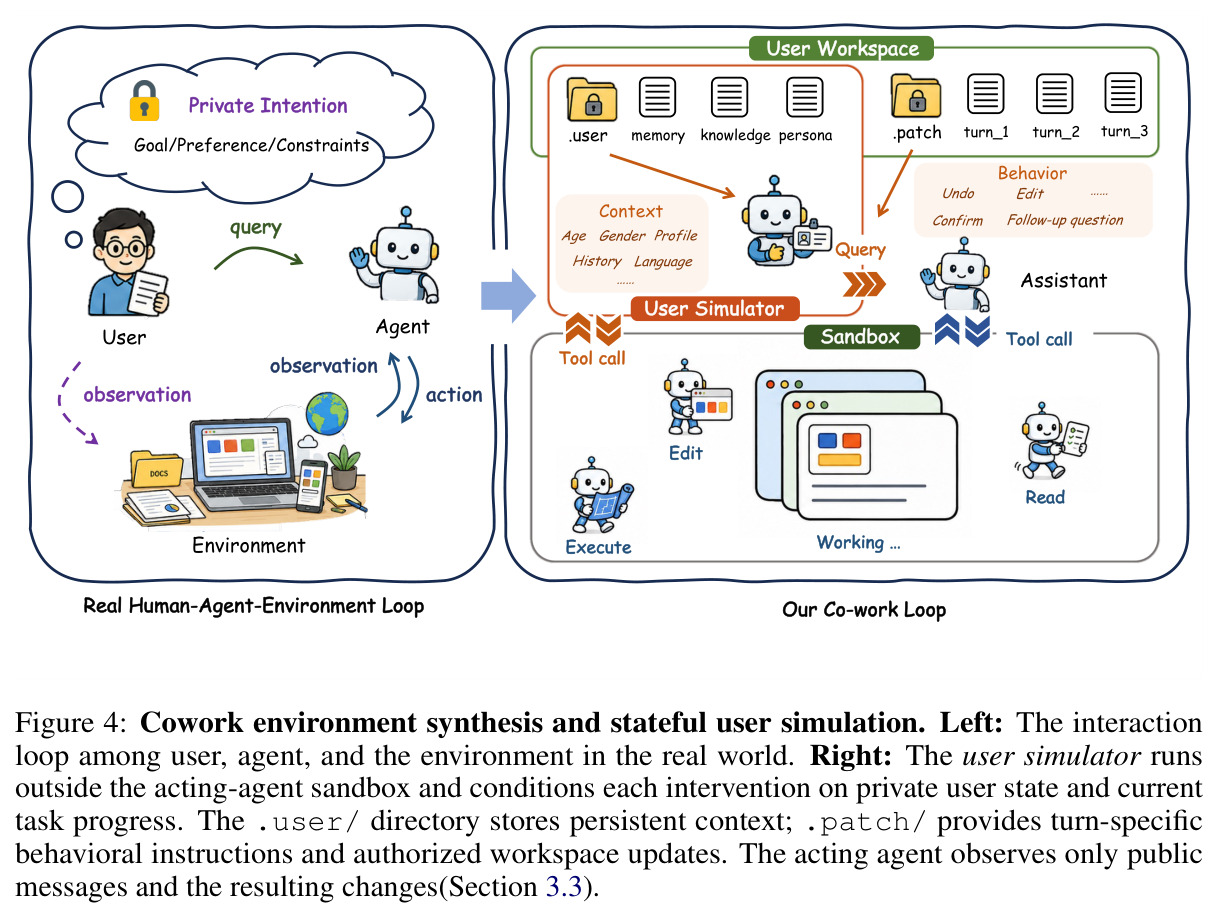
用语言模型扮演用户与被测智能体多轮对话,$\tau$-bench、ToolSandbox 首创了这一评测形态。本文进一步让模拟器持有私有状态(persona、潜在目标、知识边界、信号计划),存放于 .user/ 目录,并能依据智能体实际进度在对话之外直接编辑共享工作区(如替换源数据表、修改草稿),通过 .patch/ 目录按轮次触发。
这是 Cowork(人机协作办公)设定的核心:用户中途改需求、换输入。理解该机制才能看懂多轮训练数据如何产生、为什么同一初始问题能派生不同后续。
混合验证器 $\mathcal{V}=(V_{code}, V_{LLM})$
代码侧 $V_{code}$ 对最终工作区与工件做确定性检查(数值容差、JSON/CSV/XLSX 字段、schema、跨文件一致性),LLM 侧 $V_{LLM}$ 按参考答案 rubric 评语义正确性、覆盖度、矛盾与过程证据,两者以归一化权重合成,红线约束失败会封顶总分。验证器需在参考完成与受控失败用例上自校验。
它既是轨迹过滤的判据,又是 RL 奖励的来源,是整个数据质量与训练信号体系的枢纽,论文的限制章节也承认其误收/误拒风险。
GRPO(组相对策略优化)
一种基于结果监督的强化学习算法:对同一环境采样一组轨迹,用组内奖励归一化来估计相对优势,无需价值网络;奖励方差为零的组被剔除。本文奖励 $R_E(\tau_i)$ 取 $s_i$ 与 $c_i$ 的加权几何平均,权重比 $w_s:w_c$ 可调,任一分量为零则奖励为零。MoE 模型训练时冻结路由权重。
论文的 RL 阶段完全建立在 GRPO 与该几何平均奖励设计之上,几何平均相比算术平均更强惩罚『一条腿走路』的轨迹。
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型从基座检查点初始化,自己与环境交互产生轨迹;在每个智能体生成的 token 位置,由同规模的 SFT 或 SFT+RL 教师在相同交互前缀下给出下一 token 分布,学生通过最小化 $D_{KL}(\pi_T \| \pi_\theta)$ 学习。用户消息、工具观测只作上下文不作预测目标。
直接 SFT/RL 可能损伤训练分布之外的通用能力,OPD 是论文验证『迁移智能体能力同时保留通用能力』的关键手段(5.5 节)。
NLL 与 RSR 轨迹选择指标
对被评分 token 位置集合 $M_\tau$,$\mathrm{NLL}_\theta(\tau)=-\frac{1}{|M_\tau|}\sum_{t}\log \pi_\theta(y_t|h_t)$ 度量轨迹对学生有多『意外』;$\mathrm{RSR}_\theta(\tau)=\frac{\sum_t \min(r_{\theta,t}, r_{max})}{|M_\tau|\,\mathrm{NLL}_\theta(\tau)}$ 把被裁剪的 token 排名与 NLL 相除,综合相对偏好与困惑度,作为数据-学生适配度的代理。两者都在等频长度分箱内做选择以避免长度偏置。
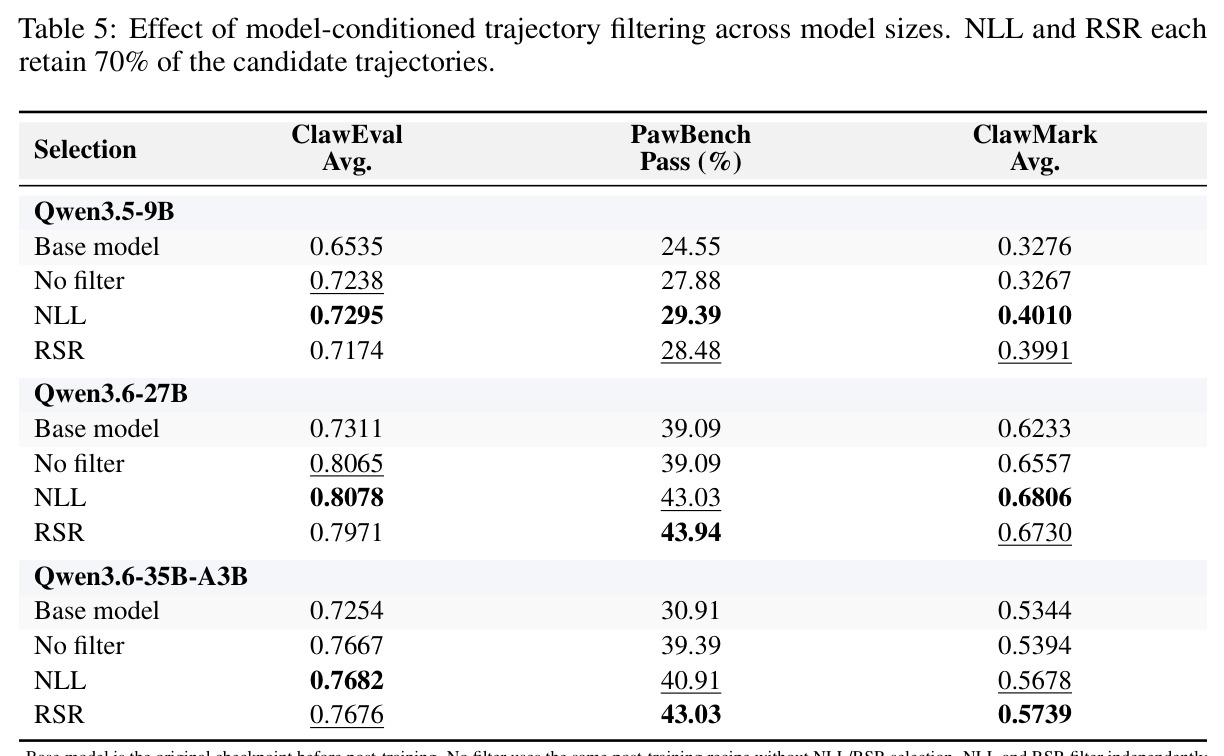
论文用它把 24,732 条有效轨迹筛到 17,312 条,消融显示比不过滤更好,且最优指标随模型规模反转,是『数据价值依赖学生模型』这一论点的证据。
Harness(智能体运行框架)与 Harbor 格式
Harness 负责观察格式化、工具 schema、执行调度、上下文管理与停止行为,同一环境在不同 harness 下会产生不同轨迹。Harbor 是容器化智能体任务包的标准格式,把任务指令、运行时、参考解、验证器、用户配置打包,使环境固定而策略与 harness 可替换。
论文把 harness 当作显式实验变量:用 QwenPaw/OpenClaw 采集、在未见过的 Hermes 上验证迁移,跨 harness 一致性是数据质量的重要证据。
研究动机
Claude Cowork、Codex、QwenPaw、OpenClaw 这类 cowork 智能体要在持久工作区中跨工具、跨文件完成多步工作,且用户会在任务进行中补充信息、修改约束、甚至替换输入文件,任务状态由双方共同塑造而非开局即固定。要训练这种行为,需要大规模环境,其中任务目标、可执行资源、用户行为与成功判据必须保持一致:每个『工作域 × 交付物 × 用户画像 × 交互模式』的组合都要落实为可执行的工作区、兼容的用户动作与可靠的结果检查,用户中途改需求时各组件还必须同步更新。手工构建成本极高,且存在隐蔽的打分陷阱——智能体的最终回复看起来正确,但必需工件缺失或工作区处于错误状态;环境错误会让任务不可解或评分错误,这些噪声会直接污染下游训练数据。
本文的目标是构建一个可扩展的自动化框架 Cowork-Gym:批量合成完整可执行的 Cowork 环境——任务指令、初始工作区、接口、有状态用户策略与混合验证器五组件耦合,并用沙箱执行证据与审查反馈自动校验、修复环境,而非依赖生成式自评;再在有状态用户模拟器参与下采集轨迹,对 Qwen3.5-9B、Qwen3.6-27B、Qwen3.6-35B-A3B 做 SFT、基于结果的 RL 与在线策略蒸馏,在六个智能体基准上验证合成数据的训练价值,并考察 OPD 相对直接 SFT 在通用能力保留上的优势。
与已有工作不同的是,本文的独特切入有四点。其一,把『cowork』定义为用户与智能体通过共享工作区协同推进目标的一般交互模式,环境五元组中显式包含有状态用户策略 $\pi_U$:用户不仅通过对话反馈,还会直接编辑共享工作区(如审阅初版分析后替换源数据表,迫使智能体重算重写),这超出了 $\tau$-bench/ToolSandbox 的纯对话式用户设定。其二,用 build–execute–revise 闭环以真实执行证据验证环境一致性,而非仅靠模型自评。其三,Builder 与 Verifier Constructor 角色分离、沙箱互不可写,配合泄漏审计,从工程上防止答案与验证器逻辑泄漏给执行智能体。其四,将 harness 显式视为 rollout 变量,用 Harbor 格式固定环境、跨 harness 采集并验证迁移。
核心方法
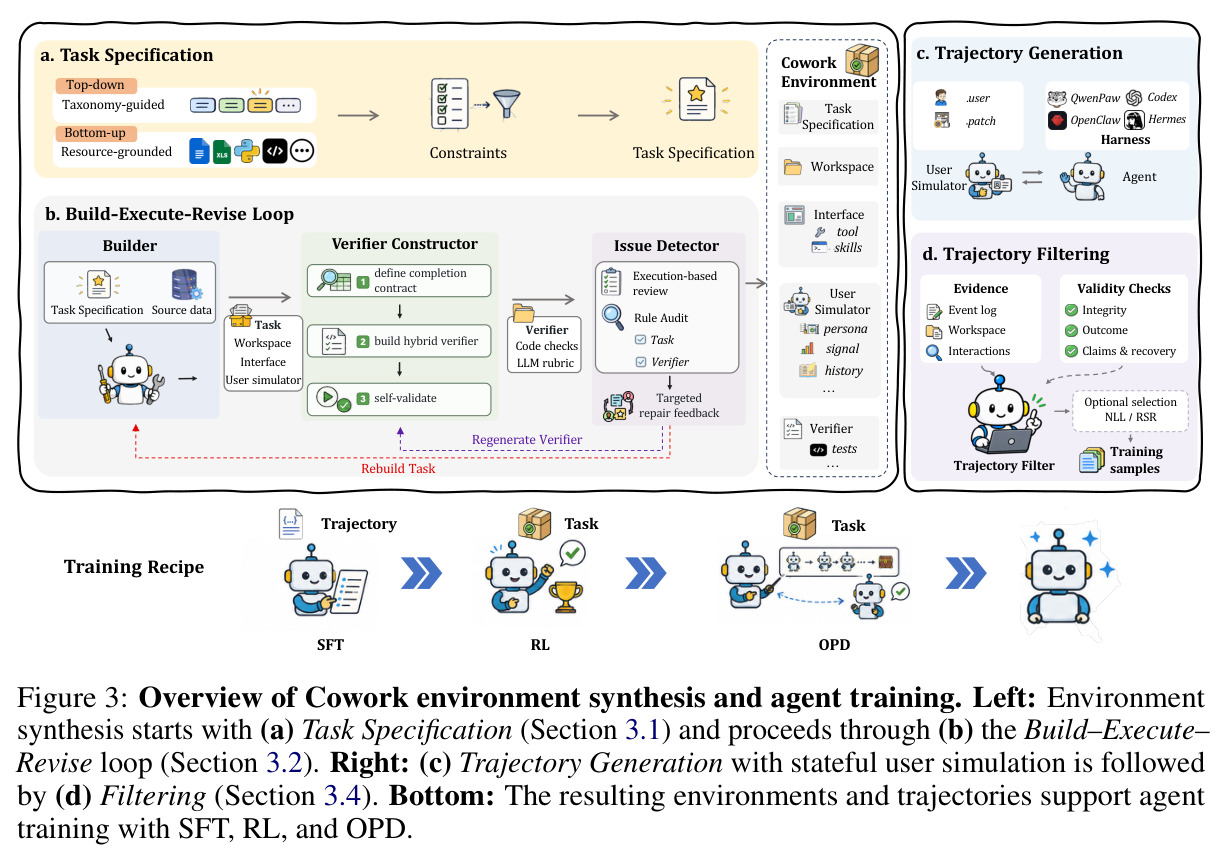
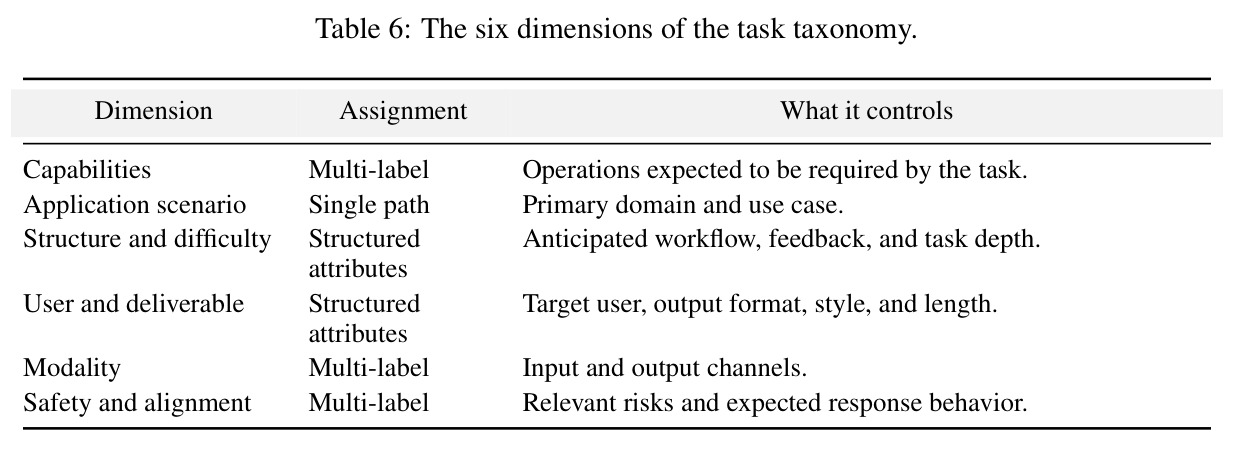
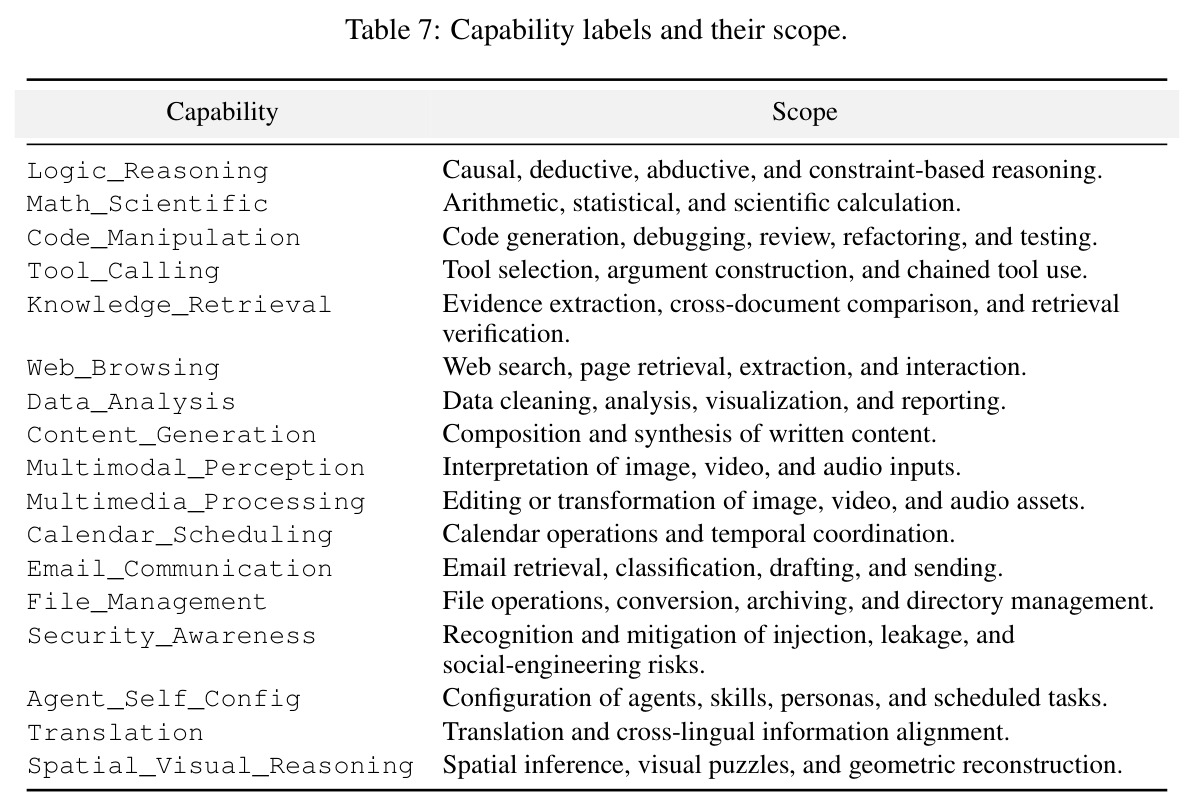
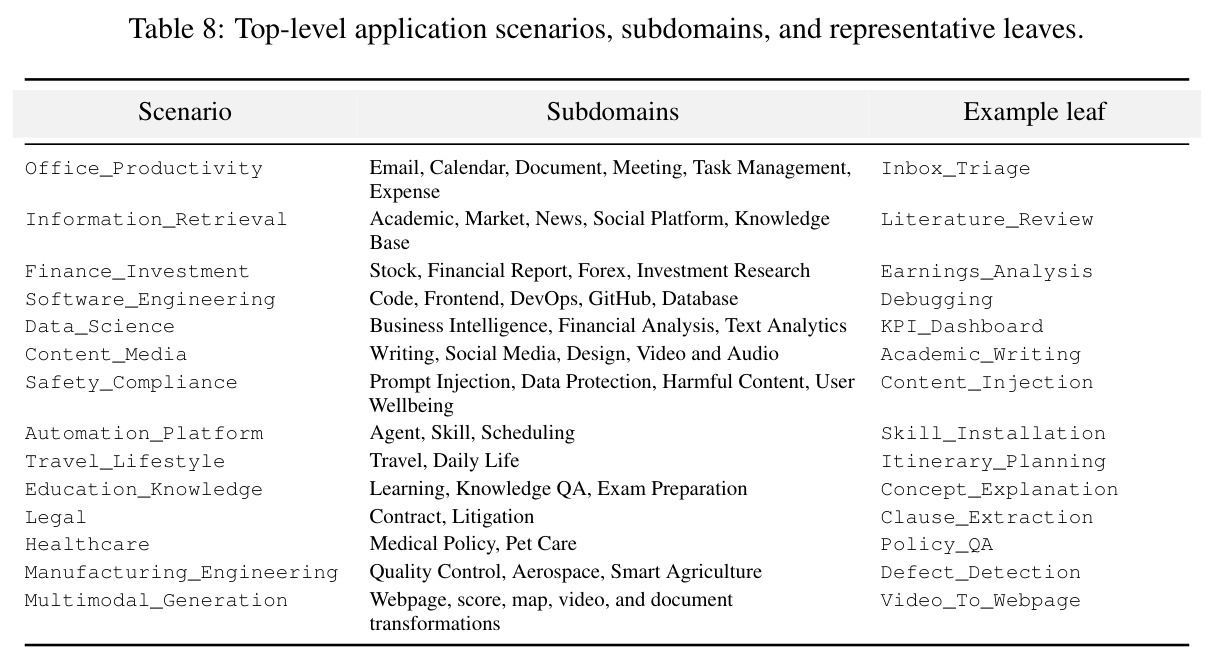
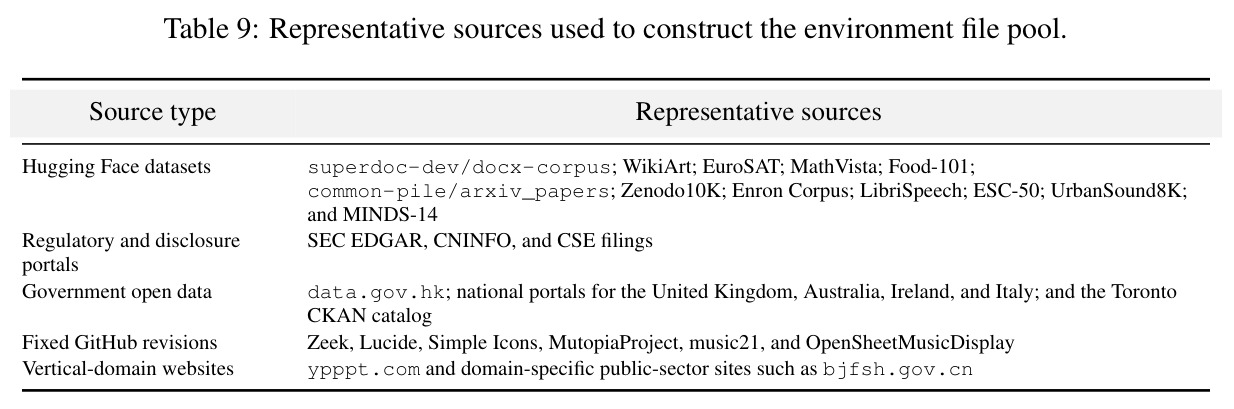
直觉上,作者不再人工出题,而是让『出题人(Builder)—阅卷人(Verifier Constructor)—质检员(Issue Detector)』三个角色分立的智能体在沙箱里互相制衡:Builder 造环境,Verifier Constructor 独立造验证器,Issue Detector 实际执行环境找缺陷,缺陷按所有权路由回去修复,循环至通过发布标准。技术路线分四步:(1) 任务规范 $g$ 由两条路线生成——taxonomy 引导用六维分类体系(17 能力标签×14 顶层场景)采样并剔除不兼容组合;资源接地从财报、法律文档、代码库等真实资源构造任务;(2) 在闭环中实例化 $\mathcal{E}=(g,s_0,\mathcal{I},\pi_U,\mathcal{V})$;(3) rollout 时有状态用户模拟器在智能体沙箱外执行 $\pi_U$,用 QwenPaw/OpenClaw 双 harness 采集轨迹;(4) 轨迹经有效性过滤与 NLL/RSR 选择后进入 SFT、GRPO RL 与 OPD 三段训练。
核心创新是把环境合成从『生成任务文本』推进到『生成并验证完整可执行环境包』。与已有自动环境合成方法相比,本质区别有三:(1) 五组件联合验证——不仅检查任务可解,还检查初始工作区、接口权限、用户策略与验证器四者一致,规则审计强制至少三个有意义的评分组件,并扫描答案、验证器逻辑、私有信息的泄漏;(2) 有状态用户模拟器——其私有状态(persona、潜在目标、知识边界、信号计划)决定它知道什么、何时披露、能改哪些文件,每次干预条件于智能体的真实进度,同一初始问题在不同 rollout 中产生不同后续,且能直接 patch 共享工作区使先前的中间结果失效,逼智能体重读输入、修正依赖工件;(3) Builder/Verifier 角色隔离——验证器在隔离沙箱中构建、对 Builder 产物只读,从制度上切断『造题人改答案』的通路,这是自动数据管线中少见的制衡设计。
方法步骤详情
第一步,任务规范:taxonomy 路线采样六维标签(能力多选、场景单路径、难度、用户与交付物、模态、安全),资源接地路线从真实资源构造任务,复杂度来自跨文件依赖、证据不全或工件转换。第二步 Build:Builder 构造初始工作区 $s_0$(记录资源依赖)、接口集 $\mathcal{I}$(只暴露任务所需操作,凭证留在沙箱外)与用户策略 $\pi_U$(.user/ 下 persona、profile、记忆,.patch/ 下逐轮指令与授权工作区更新);隔离沙箱中的 Verifier Constructor 把每条要求映射为『成功条件→可观察证据→检查器或 rubric 项→权重』并在受控失败用例上自校验。第三步 Execute:Issue Detector 执行环境,做基于执行的审查(测试验证器对有效完成与不完全、畸形、未触碰状态的区分度)加规则审计(包结构、白名单、泄漏检查、至少三个评分组件)。第四步 Revise:缺陷按所有权回 Builder 或 Verifier Constructor,重置沙箱复检至达标或耗尽预算。第五步 rollout 与过滤:双 harness 采集 77,729 条轨迹,按记录完整性、任务结果、声明与恢复过滤剩 24,732 条(31.82%),NLL/RSR 在等频长度分箱内保留 70% 得 17,312 条。第六步训练:SFT 仅对智能体生成的 token 计损失;GRPO 以加权几何平均奖励 $R_E$ 做结果监督、剔除零方差组、MoE 冻结路由;OPD 从基座初始化学生,在自采轨迹上以 $D_{KL}(\pi_T\|\pi_\theta)$ 对齐同规模教师。
技术新颖性
相对 WebArena、OSWorld 等人工构建基准,本文把可执行环境当作可扩展的『训练数据工厂』;相对 Agent-World、ClawEnvKit 等自动环境合成,其新颖性在于:(a) 联合构建异构工作区、接口、用户策略与验证器并做包级发布验证,而非只合成任务描述;(b) 用户模拟器获得对共享工作区的直接写权限,workspace patch 能使先前观察失效($\tau$-bench/ToolSandbox 只有对话用户,$\tau^2$-bench 是双方各有工具),形成真正的协作动力学;(c) Builder 与 Verifier 制度性隔离加答案泄漏审计,直接回应合成数据的捷径与泄漏风险;(d) 奖励取加权几何平均 $R_E$,任一分量为零即零奖励,比算术平均更强惩罚偏科轨迹;(e) 系统评估 OPD 的通用能力保留,并把 harness 作为显式变量给出跨 harness 迁移证据。NLL/RSR 选择则把『数据价值依赖学生模型』操作化进智能体数据管线。
实验结果
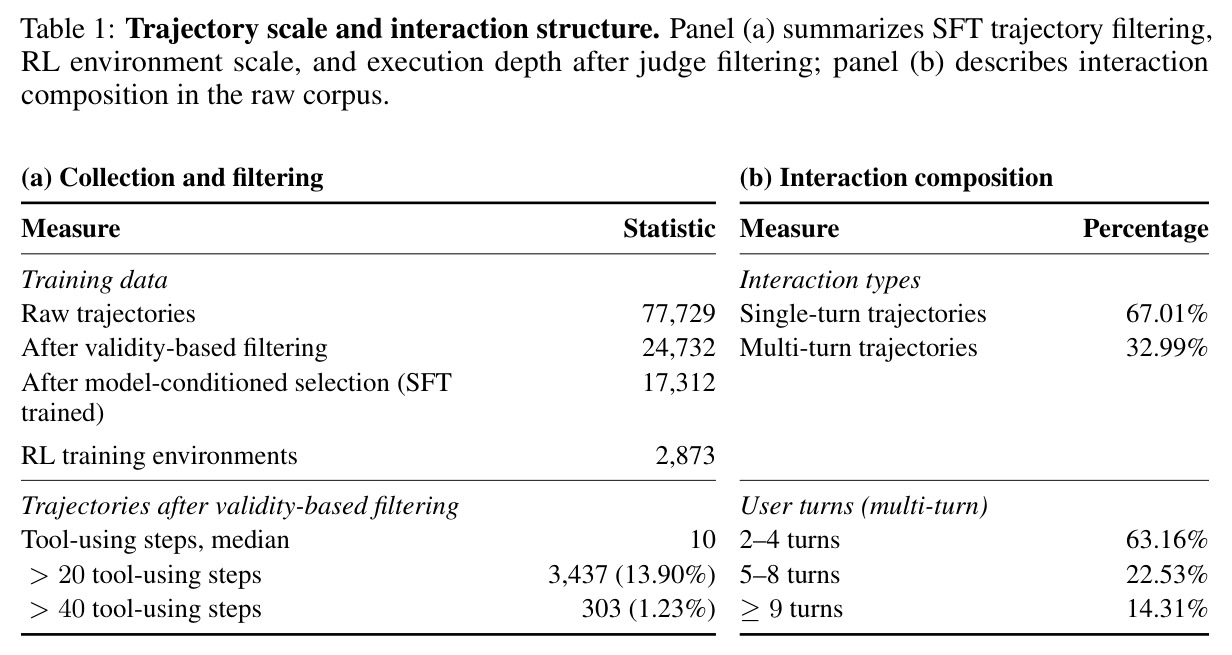
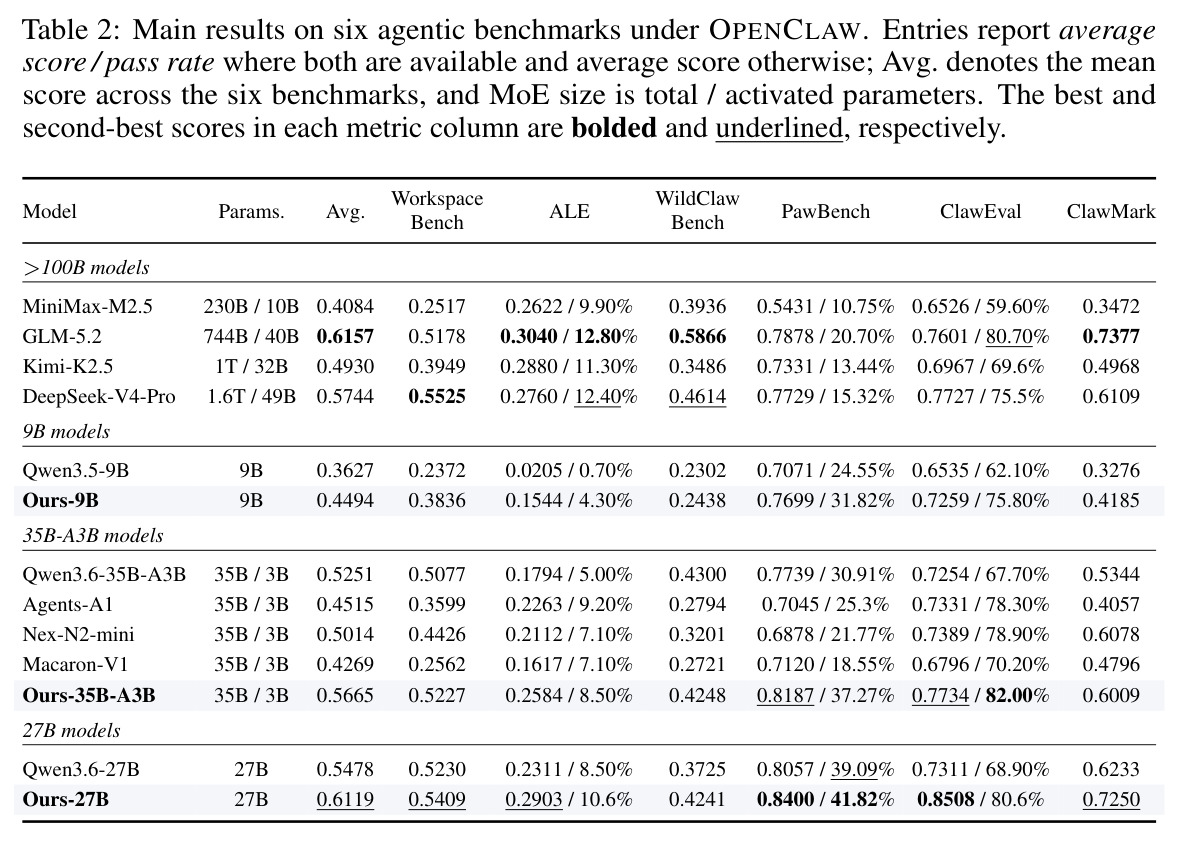
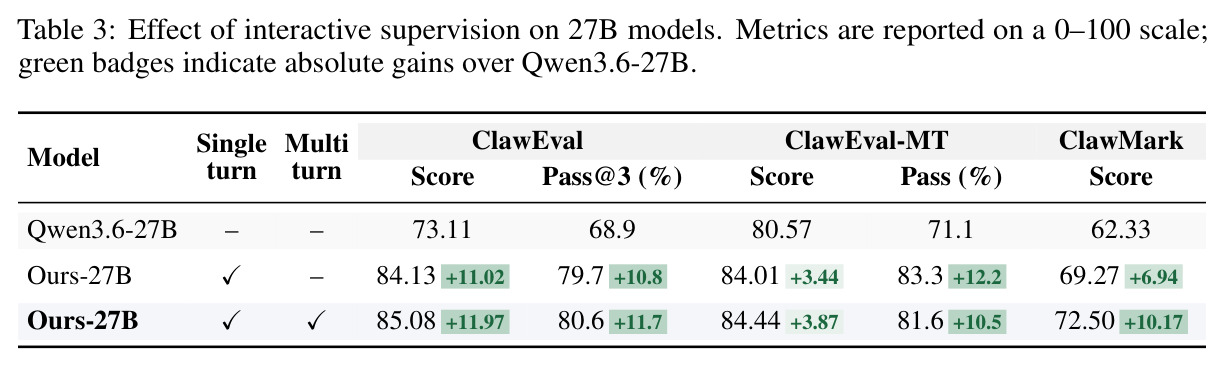
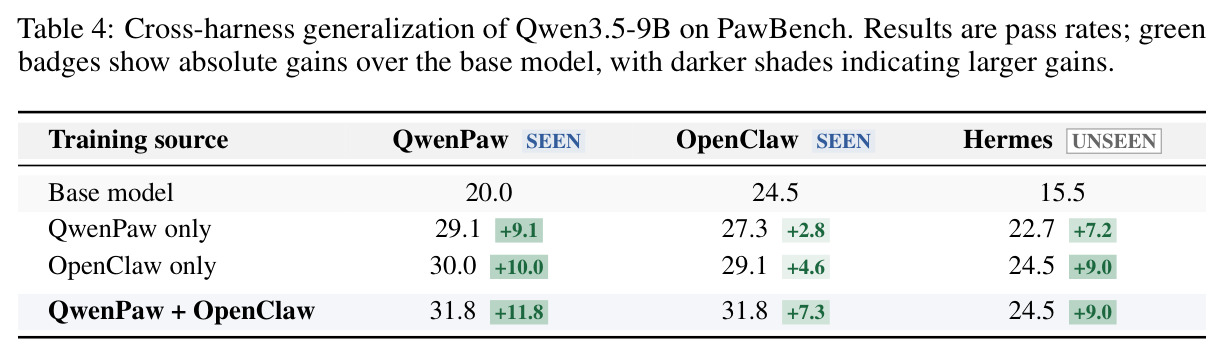
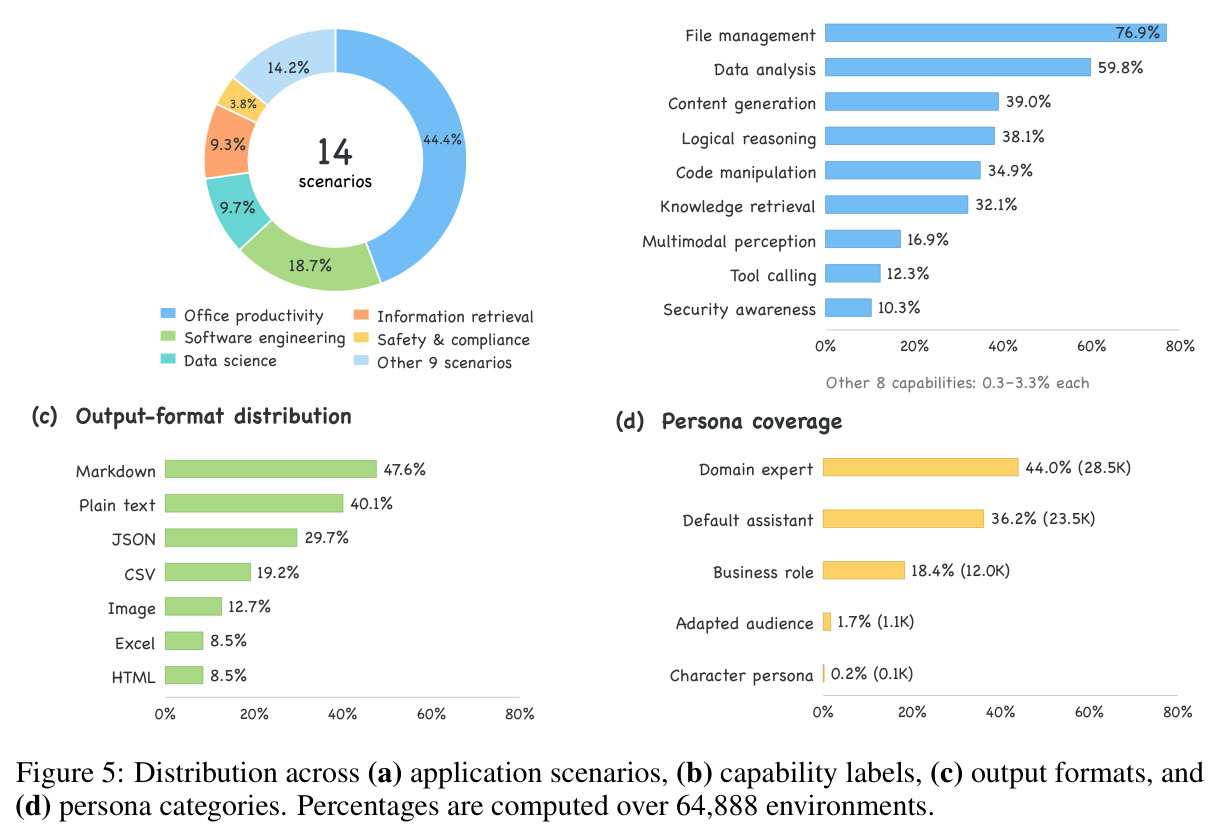
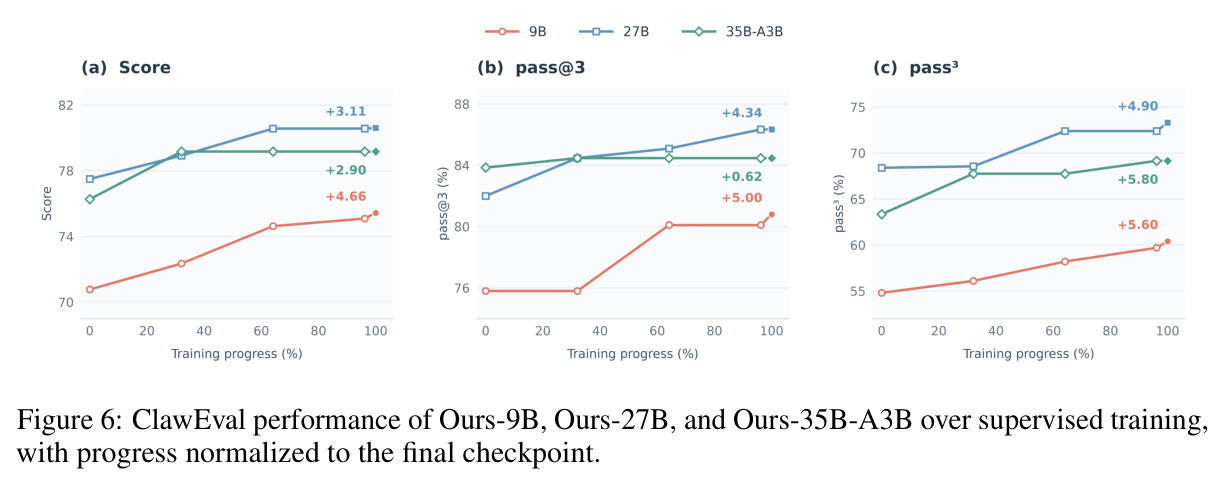
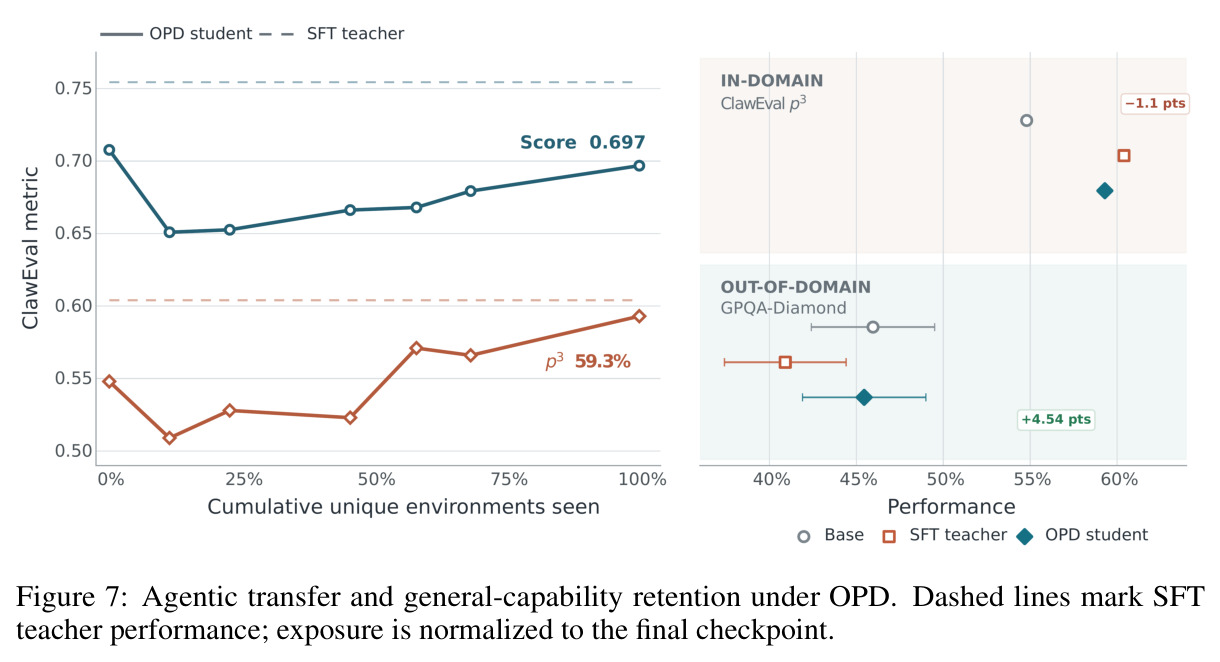
逐一分析四组实验。(Q1) 数据:合成 64,888 个环境,覆盖 14 场景、17 能力;办公生产力占 44.4%、软件工程 18.7%;文件管理 76.9%、数据分析 59.8%;8 个长尾能力各仅 0.3–3.3%。轨迹漏斗:77,729 条原始→24,732 条有效(31.82%)→17,312 条入选 SFT;RL 环境 2,873 个;工具步中位数 10;多轮占 32.99%,其中 32.69% 超过 20 个工具步(单轮仅 15.80%)。(Q2) 主结果:六基准平均 9B/27B/35B-A3B 分别提升 +8.7/+6.4/+4.1 分,18 组对比 17 组为正;Ours-27B 均值 0.6119 总排名第二(GLM-5.2 0.6157),并拿下 PawBench 0.8400/41.82% 与 ClawEval 0.8508/80.6% 全场最高,超过总参数 >100B 的模型;9B 最大增益在 Workspace-Bench +14.64 与 ALE +13.39,27B 在 ClawEval +11.97 与 ClawMark +10.17;边界在 WildClawBench:9B 仅 +1.36、35B-A3B -0.52,三家均大幅落后 GLM-5.2。(Q3) 消融:加入多轮使 27B ClawMark 从 +6.94 增至 +10.17(多轮增量 +3.23);仅 OpenClaw 训练让未见过的 Hermes 通过率 +9.0,双源组合在 QwenPaw/OpenClaw 均达 31.8%;NLL 在 9B/27B 最优(9B ClawMark 0.4010 vs 不过滤 0.3267),RSR 在 35B-A3B 多数指标最好,最优准则随规模反转。(Q4) OPD:ClawEval pass3 较基座 +4.5,恢复教师约 80% 增益(差 1.1 分);GPQA-Diamond 上接近基座且比 SFT 教师高 +4.54 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六大智能体基准平均(27B) | 六基准平均分 | Ours-27B 0.6119 | Qwen3.6-27B 0.5478;GLM-5.2 0.6157 | +6.4 分,总排名第二,仅次于 GLM-5.2(744B/40B) |
| PawBench(27B) | 平均分 / 通过率 | 0.8400 / 41.82% | Qwen3.6-27B 0.8057 / 39.09%;GLM-5.2 0.7878 / 20.70% | +3.4 分,所有参评模型(含 >100B)中最高 |
| ClawEval(27B) | 平均分 / 通过率 | 0.8508 / 80.6% | Qwen3.6-27B 0.7311 / 68.9%;DeepSeek-V4-Pro 0.7727 / 75.5% | +11.97 分,所有参评模型中最高 |
| Workspace-Bench(9B) | 平均分 | Ours-9B 0.3836 | Qwen3.5-9B 0.2372 | +14.64 分,9B 模型增益最大的基准 |
| ALE / Agents' Last Exam(9B) | 平均分 / 通过率 | 0.1544 / 4.30% | Qwen3.5-9B 0.0205 / 0.70% | +13.39 分 |
| 六大基准平均(35B-A3B) | 六基准平均分 | Ours-35B-A3B 0.5665 | Qwen3.6-35B-A3B 0.5251 | +4.1 分,35B-A3B 组内最高,但 WildClawBench -0.52 |
| 跨 harness 迁移(9B,PawBench 通过率) | 未见 Hermes harness 通过率 | OpenClaw-only 训练 24.5%;双源 24.5% | 基座 15.5% | +9.0 分(未参与采集的 harness 上) |
| 在线策略蒸馏(OPD) | ClawEval pass3 / GPQA-Diamond | pass3 较基座 +4.5,恢复教师约 80% 增益(差 1.1 分);GPQA-Diamond 高于 SFT 教师 +4.54 | 基座模型 / SFT 教师 | 以明显更小的通用能力损失获得大部分智能体增益 |
局限与改进
作者承认的局限有两类。任务覆盖:环境是个人工作的合成近似,taxonomy 可能遗漏某些任务、文化、语言、无障碍需求与失败模式;当前池偏重浏览器、文件、数据与办公流,复杂视觉界面、专业桌面软件、音视频任务代表性不足,64.9K 的规模不应被解读为有代表性的覆盖。验证器可靠性:程序化检查可能脆弱,LLM 评分者可能有偏或过于宽松,正例/负例/变异测试降低但不能消除风险,需要更大规模人工审计来量化误收与误拒率。我的补充观察:(1) 评测默认在自家 OpenClaw harness 上进行、对比模型为 API 模型,可能存在 harness 配置偏置——作者自己引用 Harness-Bench 说明 harness 影响巨大;(2) 合成数据与 ClawEval/PawBench/ClawMark 在任务风格上可能同源,存在训练-评测分布重叠风险,WildClawBench 上的停滞正是分布外信号;(3) 用户模拟器与真实用户的差距(sim2real gap)未被独立评估,只引用他人研究;(4) 多轮增量(ClawMark +3.23)未报告显著性;(5) 论文未披露训练算力与成本,难以评估性价比。
独立分析的弱点
第一,分布严重不均衡:办公生产力 44.4% 而其余 9 个场景合计仅 14.2%,8 个能力各 0.3–3.3%、安全意识仅 10.3%,模型可能在长尾场景与安全行为上偏科,改进方向是按『能力×场景』缺口做主动采样或课程配额。第二,验证器误收/误拒率未量化,RL 奖励直接依赖 $V_{LLM}$ rubric,存在 reward hacking 风险,改进方向是人工校准集、对抗性变异测试、把校准误差计入奖励塑形。第三,WildClawBench 上 35B-A3B 负增益 0.52、三家均落后 GLM-5.2,说明长视野真实任务迁移有限,应引入多天、多会话的长程任务与课程。第四,NLL/RSR 最优准则随规模反转(9B/27B 用 NLL、35B-A3B 用 RSR),每换学生都要重调选择策略,工程成本高,可改用学习型数据价值预测器。第五,用户信号计划由 Builder 一次性设计,用户行为的多样性与对抗性不足(如中途放弃、自相矛盾的指令),应用真实交互日志校准。第六,OPD 限于同规模师生,未利用更大教师的知识,可探索跨规模蒸馏。
未来方向
作者提出的方向:把合成任务分布与真实世界任务分布做对比研究;扩展多模态状态检查与验证能力;对验证器做更大规模人工审计与校准研究,量化误收/误拒率;让环境池随工具、工作区与用户需求的演化持续扩展,为新任务、新交互、新验证信号供血,走向自我进化的智能体。基于本文成果可延伸的方向:(1) 与 AgentEvolver、CuES 等课程化/好奇心驱动生成结合,按学生模型的学习前沿动态调整任务难度,替代当前静态的 taxonomy 配比;(2) 用户模拟器与智能体策略共进化——双控自我博弈,模拟器学会提出更难但合理的需求变更;(3) 把验证器校准做成一等公民:报告每类任务的误收/误拒曲线,并用其对 RL 奖励加权;(4) 将 Harbor 任务包标准化,形成社区共享的可执行任务市场,用真实使用统计反过来指导 taxonomy 演化;(5) 探索 OPD 与 RL 交替训练的调度,刻画『智能体增益 vs 通用能力保留』的帕累托前沿;(6) 扩展到多语言、多文化与无障碍场景,检验 64.9K 管线的跨语言泛化;(7) 引入多智能体协作环境,把『用户』从单人扩展为团队。
复现评估
模型与数据均已开源:模型在 HuggingFace 集合 agentscope-ai/qwenpaw-flash,数据集在 agentscope-ai/Cowork-Gym(64,888 环境 + 过滤轨迹),基座模型与六个评测基准均有公开出处。但环境合成管线依赖 Alibaba 内部的 Builder/Verifier Constructor/Issue Detector 三角色智能体,附录 C 只给出节选提示词,管线代码是否开源未明说;采集依赖 QwenPaw/OpenClaw harness,评测默认 OpenClaw,对比模型需 API。算力方面论文完全未披露 GPU 数量与训练时长,RL 需对 2,873 个环境做沙箱并行 rollout,OPD 需同时加载师生两份模型,门槛不低。综合判断:用开源数据复现 SFT 属中等难度(需自建 harness、沙箱与格式转换);复现完整 RL 与 OPD 需可观工程与算力;从头复现环境合成管线难度最高,需要强大的代码智能体底座。数据与模型的开放度是最大加分项。
论文图表
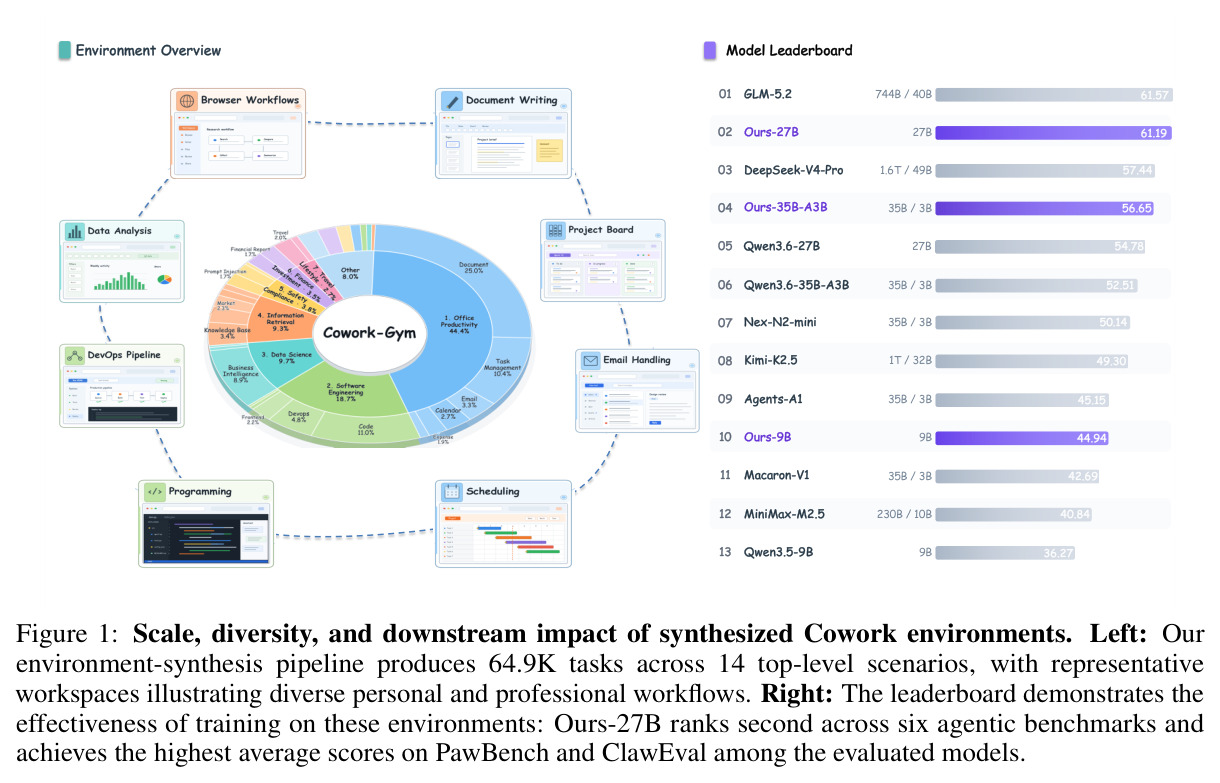
左侧展示环境合成管线产出 64.9K 任务、14 个顶层场景的规模与多样性,并配以办公、软件工程等代表性工作区示意;右侧是模型排行榜:GLM-5.2(744B/40B)61.57 第一,Ours-27B 61.19 第二,DeepSeek-V4-Pro(1.6T/49B)57.44 第三,Ours-35B-A3B 56.65 第四,Ours-9B 44.94 第十。
一张图同时呈现论文的两个核心主张——环境合成的规模与训练后的模型竞争力,是『合成环境 → 模型变强』这条证据链的入口。