人类打造的最后一个AI:迈向真正的递归自我改进 The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
提出B0–L5五级自主性框架,系统梳理递归自我改进的现状、挑战与产业实践
前置知识
递归自我改进(RSI)
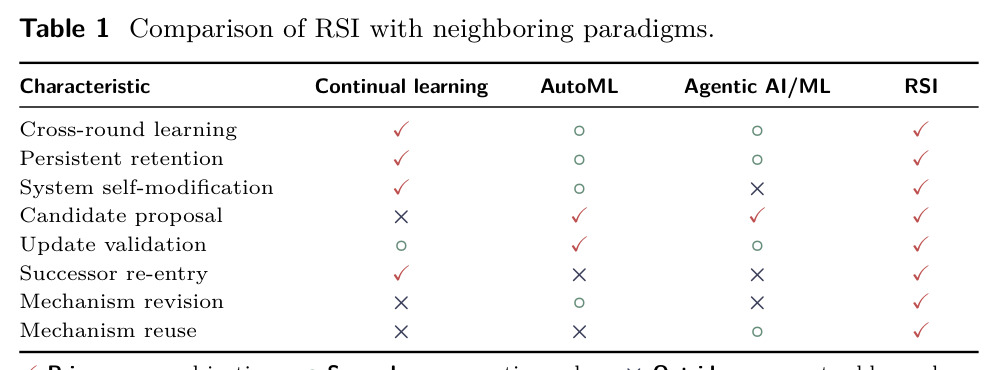
指智能系统在与任务、环境或其他智能体的持续交互中,自主地将获得的经验和反馈转化为自身的持久变化(如模型参数、智能体脚手架或改进策略),且这些变化能进一步影响后续自我改进的生成、评估、选择与巩固机制,从而形成'改进能力本身也被改进'的递归过程。
这是全文的核心研究对象,所有分级、案例与评估都围绕'改进是否持久、是否自主、是否递归'三个条件展开。
改进闭环(Improvement Loop)
本文的基本分析单元:AI系统利用经验对目标提出修改,在验收规则下评估候选,把通过的改变保留为系统状态,并从更新后的状态开始下一轮。包含AI系统、系统状态、经验、目标、改进器、策略、验证器、改进、后继者九个组件。
判断一个系统处于哪一级自主性,都要回答三个问题:闭环在哪里闭合、什么被保留继承、哪些决策仍由人类控制。
验证器与奖励破解(Verifier & Reward Hacking)
验证器是评估候选改进并执行验收规则的机制,可以是单元测试、奖励模型、LLM评审或形式化验证。当系统反复访问评估器时,可能利用其盲点而非真实提升能力,例如挑选随机种子、通过反复查询试图提取测试标签,这被称为评估器利用或奖励破解。
可靠验证是RSI三大挑战之一;RQGM按epoch冻结评估器并用独立锚点校验、Anthropic报告的作弊行为,都必须先理解这一概念。
智能体脚手架(Agent Harness)
包裹模型权重之外的可执行外围系统,包括提示词、工具循环、上下文组装、执行逻辑与停止规则等。修改脚手架可以改变智能体在整个任务中的行为方式,是DGM、Self-Harness、HarnessDev、ASPIRE等大量系统的改进对象。
本文许多案例改进的正是脚手架而非模型权重,理解它才能区分'改进产物'与'改进产生产物的系统'这两个RSI的关键层次。
结构递归与有效递归(Structural vs Effective L5)
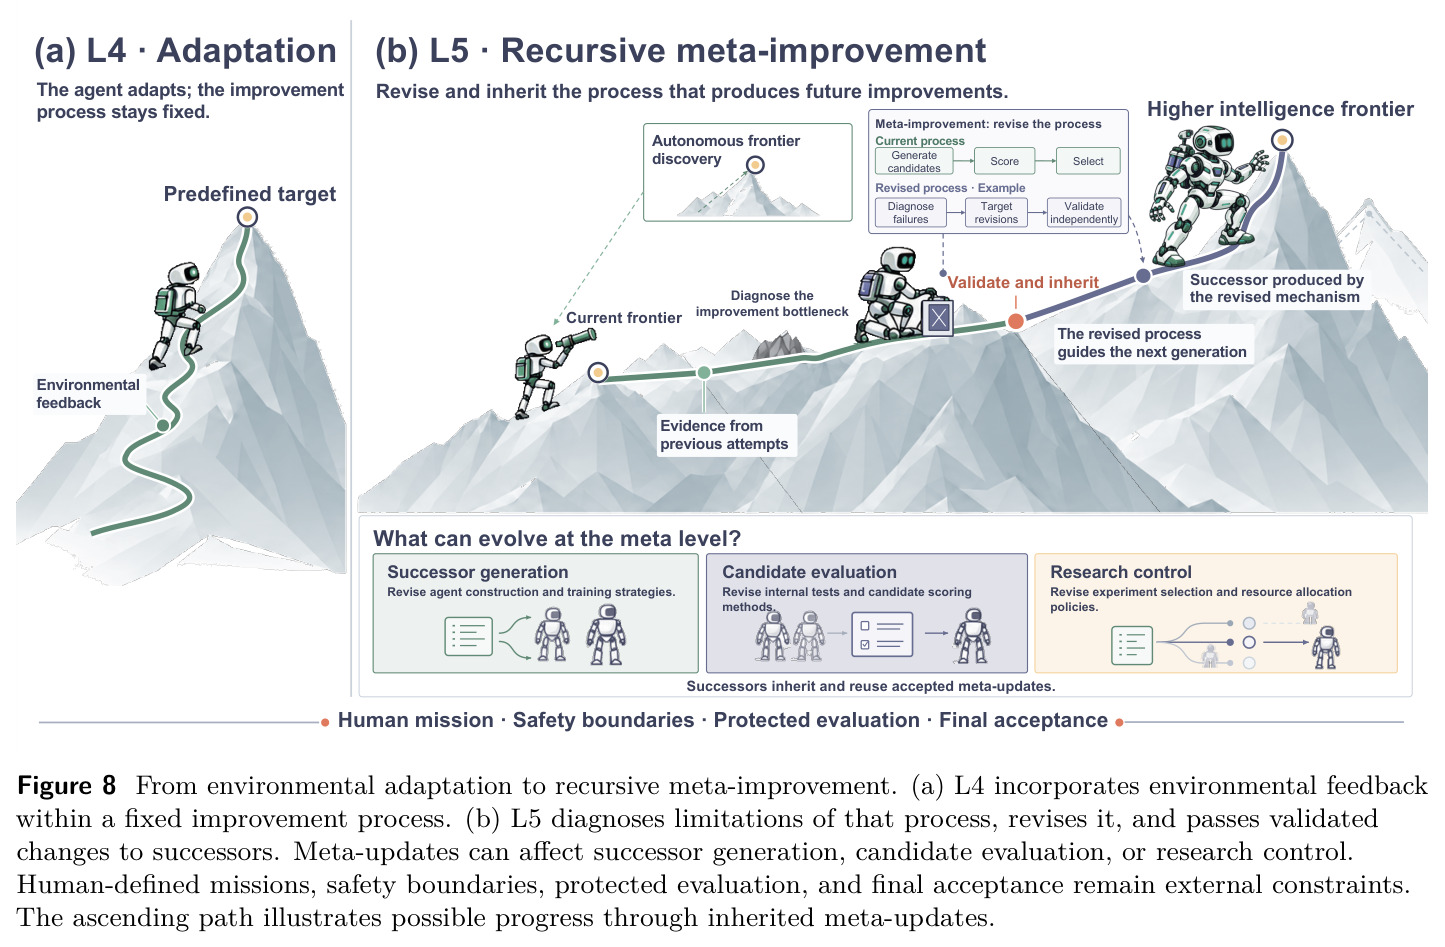
结构递归只要求AI主导的修改被持久保留并支配后续某轮改进;有效递归进一步要求被修改的机制在可比预算和独立评估下产生更强的后继者。仅自改任务代码而改进流程不变不足以证明递归;反之,进化了后继评估器也可构成结构L5。
这是论文评估L5声明的核心标准,用来区分'看起来在递归'与'真的越改越强',直接决定对STOP、DGM、AIDE2等系统证据强度的判断。
余量闭合指数(Headroom-Closed Index, HCI)
论文提出的归一化指标:$H_{m,b,h} = 100 \times \frac{\bar{s}_{m,b,h} - F_{b,0}}{100 - F_{b,0}}$,其中 $F_{b,0}$ 是基准进入数据集当年模型分数的90分位值。$H=0$ 表示入门年前沿水平,$H=100$ 表示满分,用于跨基准、跨领域地比较能力进步并度量剩余提升空间。
论文用2023–2026年393条模型-基准观测的HCI轨迹论证'交互式能力留白更大',这是RSI价值假设的经验起点,也引出三个关键观察。
研究动机
论文将前沿模型开发中的扩展负担归纳为三大挑战。其一,基础模型训练资源密集:Kimi K3 含 2.8 万亿参数、896 个专家中每 token 激活 16 个,Qwen3.8-Max 含 2.4 万亿参数、激活约 950 亿;OpenAI 报告 GPT-5.6 发布前六个月内研究算力中内部编码推理增长 100 倍、智能体 token 用量增长 22 倍;构建 GDPval 的 1,320 个专业任务耗费约 9,240 专家小时,Humanity's Last Exam 记录超 7 万次提交尝试才产出 3,000 题基准。其二,反馈与学习环境扩展困难:DeepSeek-V3.2 后训练算力超过预训练成本的 10%,NVIDIA AIMO-2 生成了 320 万条长推理解与 170 万条工具集成解、整理 54 万道题。其三,部署后需反复适配:Anthropic 报告智能体负载 token 约为普通聊天的 4 倍、多智能体系统达 15 倍;Meta 的 FBDetect 每周发现数千次基础设施回归,诊断一次约需 10 工程师小时。根本原因是模型改进仍是代价高昂、依赖外部协调的人工干预序列。
本文的目标是本文的目标是为递归自我改进(RSI)建立可操作的研究框架。首先给出严格定义:AI 自主地识别自身局限、开发并验证改进、再用所得能力改进改进过程本身的自主闭环过程,目标覆盖扩展能力前沿、提升资源效率、发现超越人类预设策略的新方案三个维度。其次提出以'改进闭环'为单元、以'责任转移'为标准的 B0–L5 五级自主性分级,即执行、策略、经验获取、环境适应、递归元改进五级。第三,在科学发现、具身智能、软件工程、医疗健康四个反馈机制迥异的应用域中检验框架的适用性。第四,纳入 Theseus、Lark、小红书、Humanlaya、ModelBest、腾讯混元、Agent-Native Research Lab、Frontis.AI 八个产业实践作为前沿证据,分析真实算力、反馈质量与人类介入约束如何塑造改进闭环。最后提炼安全继承、自主性归因、可靠验证三大挑战与八个未来方向,回答'当前系统能承担改进闭环的哪些部分、保留的改变如何影响后续轮次、有什么证据支持递归进步'。
与已有工作不同的是,与已有的自演化系统综述相比,本文有四个独特切入。第一,以改进闭环而非算法或组件为分析单元:既有分类多按自演化阶段、更新对象、更新时机或技术机制组织,无法区分'更新同一组件但决策权归属完全不同'的系统;本文则追踪完整闭环——什么触发改进、谁提出并验证改变、什么被持久化、哪些后续决策使用保留的改变。第二,用'责任'而非'能力'来操作化自主性:分级依据是从外部设计者转移到 AI 的改进决策(执行、策略、经验获取、环境适应、递归继承),而非模型能力或自动化组件数量,因此五个级别刻画的是责任划分而非能力高低。第三,把结构递归与有效递归分开举证:仅任务性能提升并不等于改进机制被修订、保留并复用,论文要求对递归声明做机制审计。第四,将技术报告、工程博客、开源仓库、模型文档等产业材料纳入证据体系,覆盖学术论文只部分记录的数据飞轮、评估流水线、智能体脚手架与部署反馈环,在真实工程约束下比较机制。
核心方法
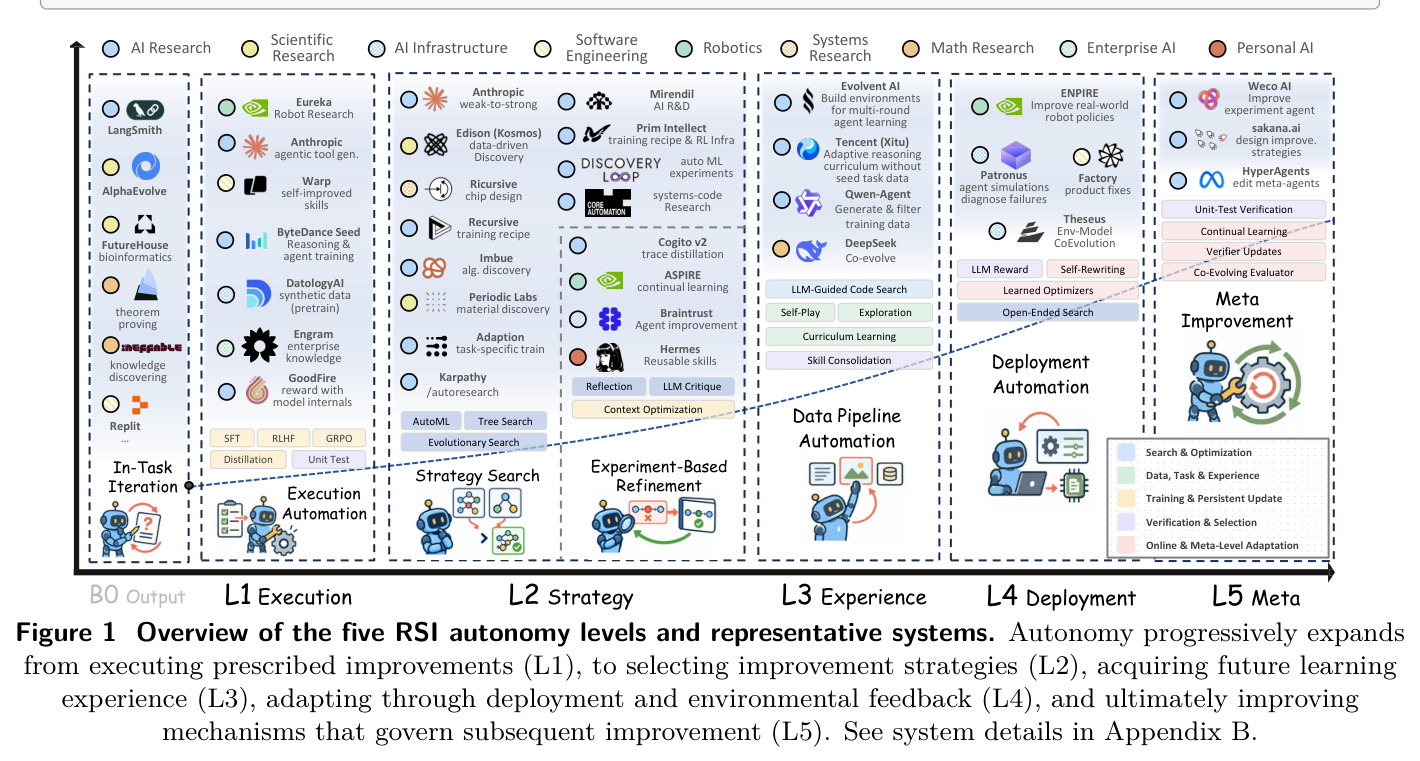
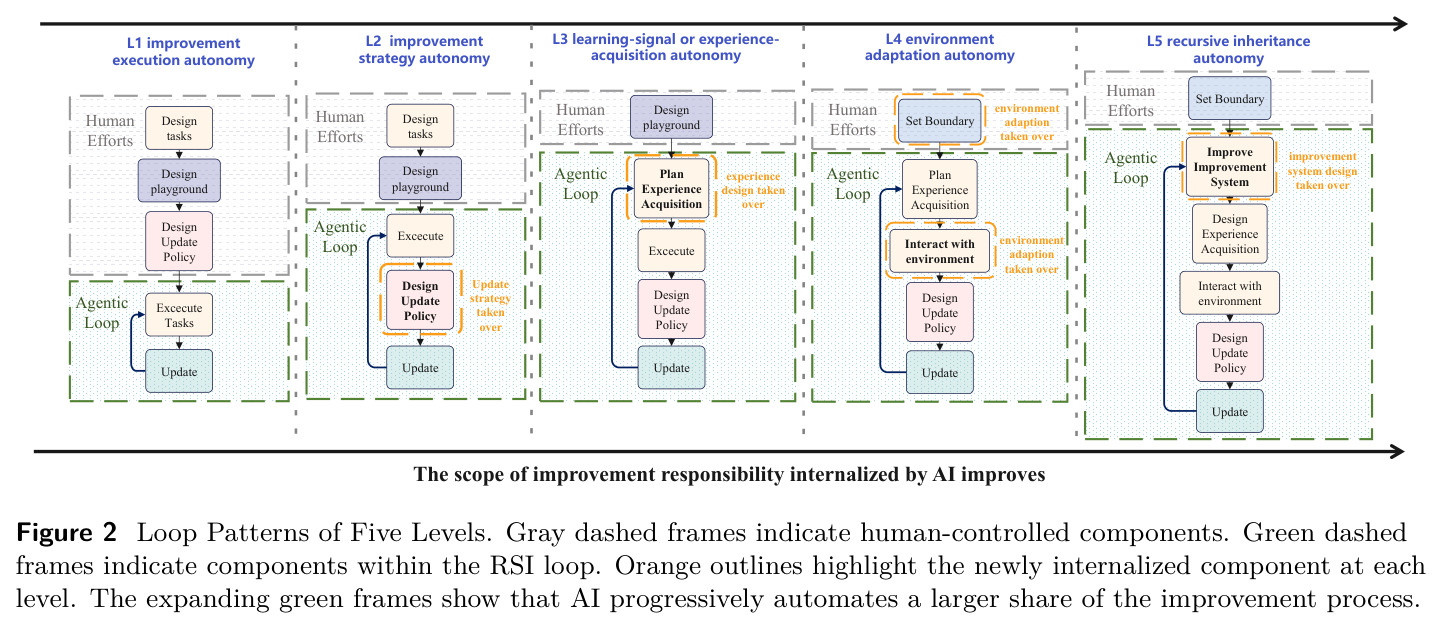
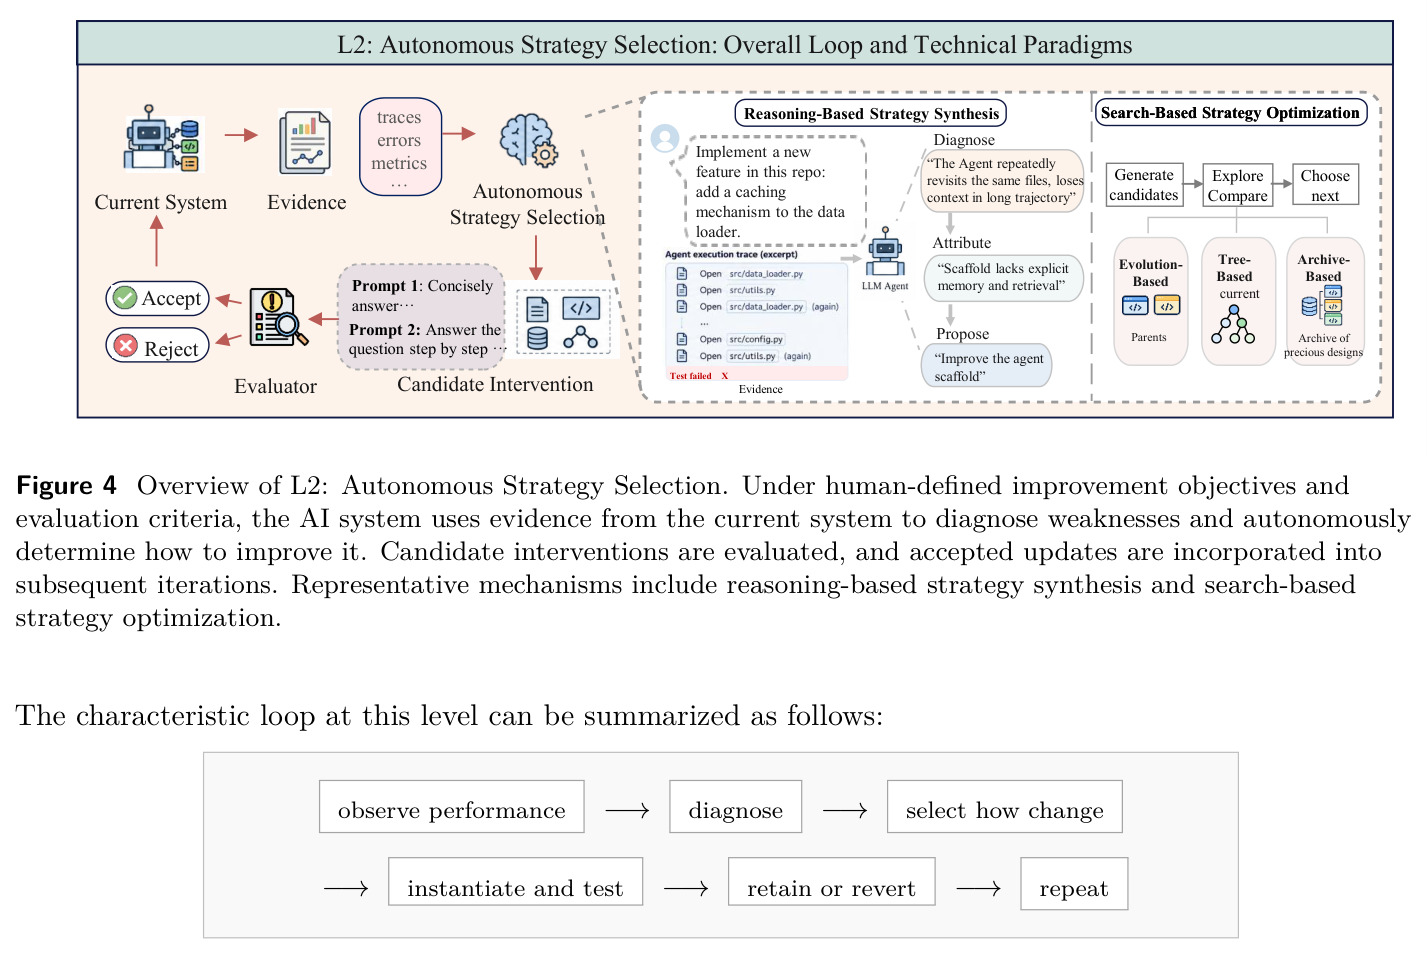
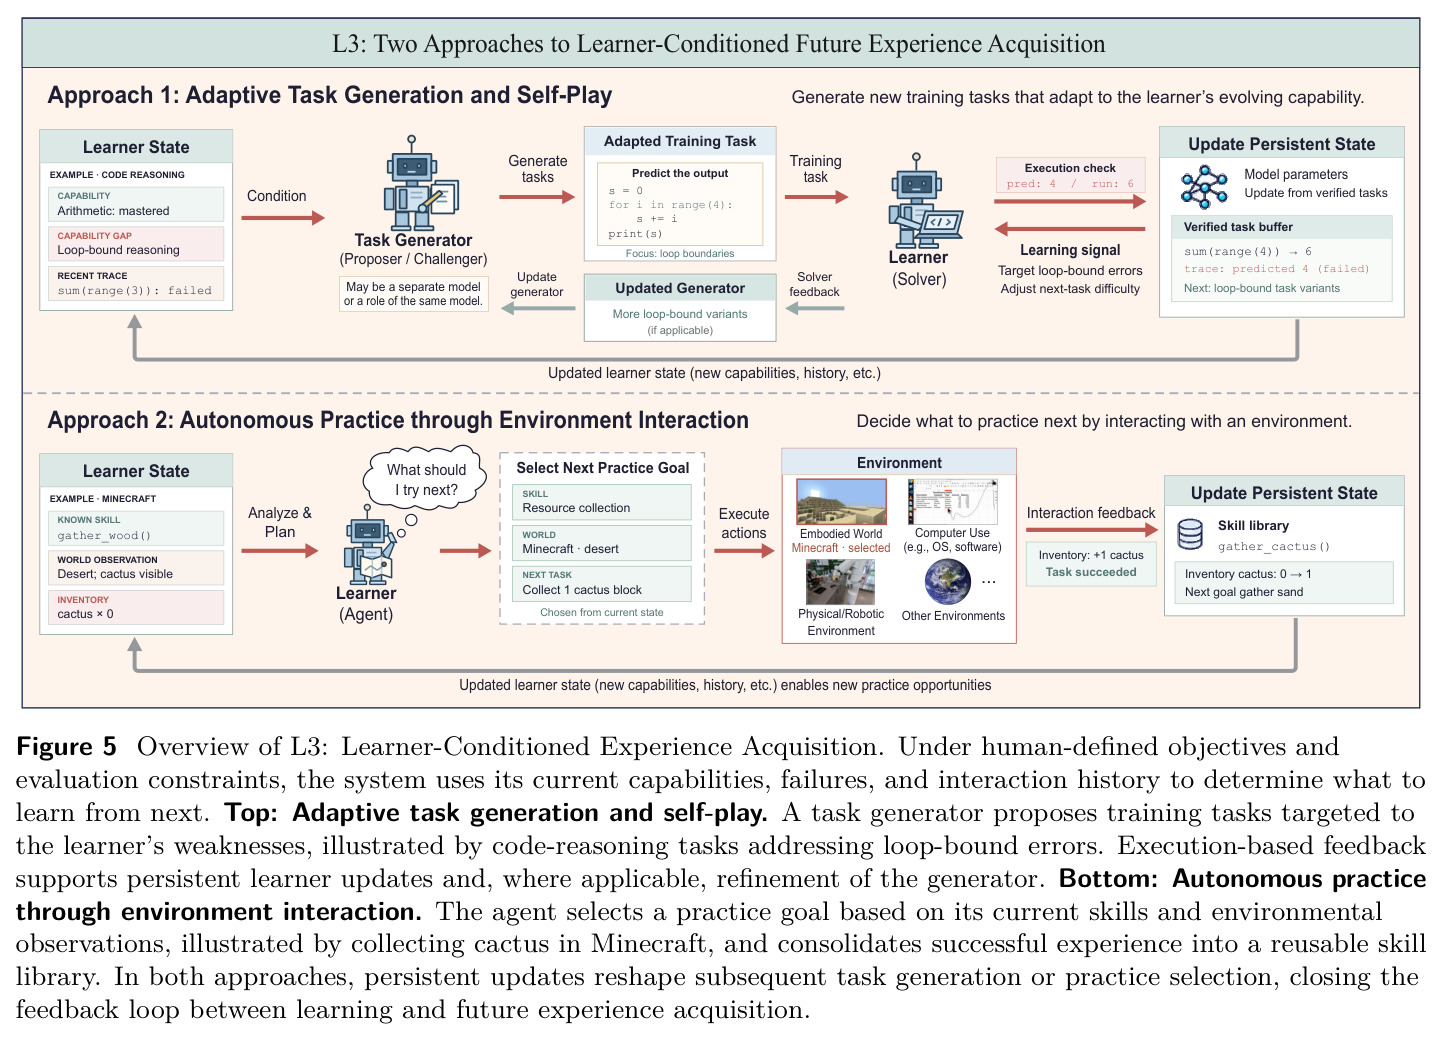
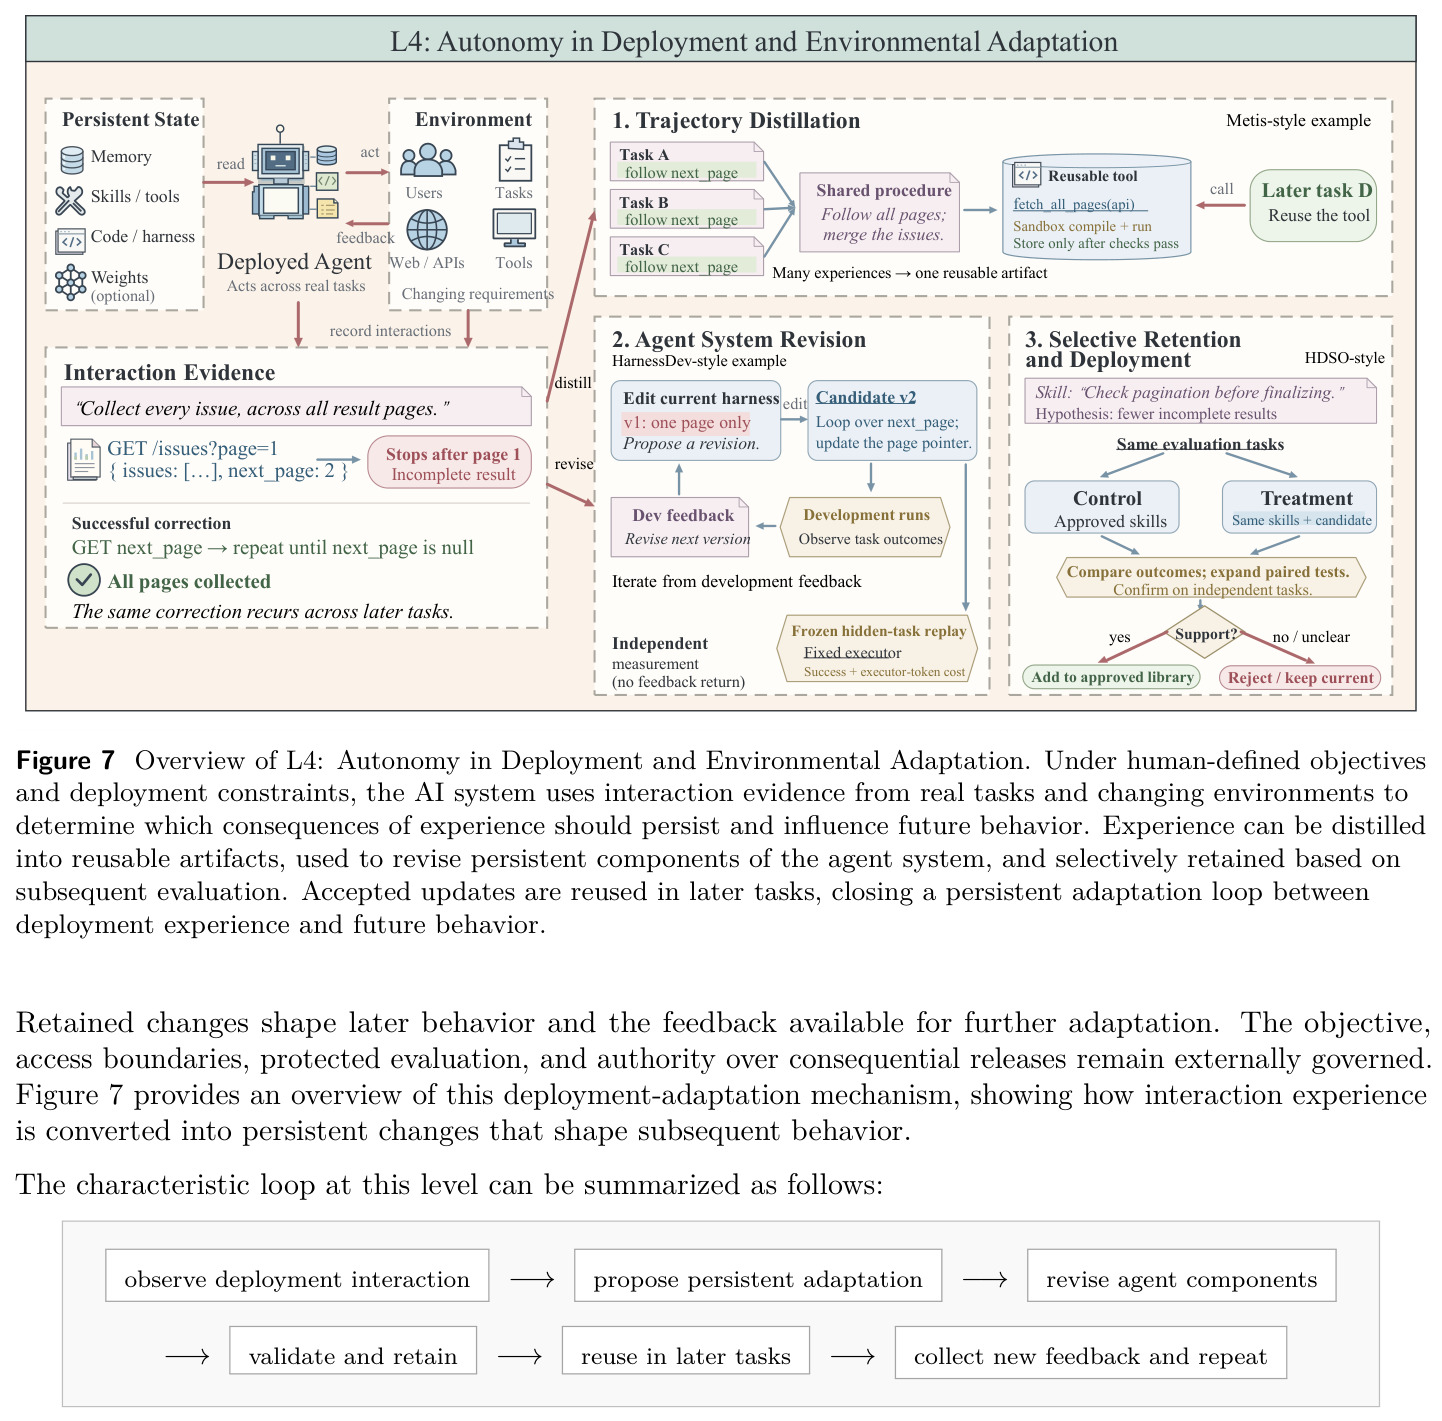
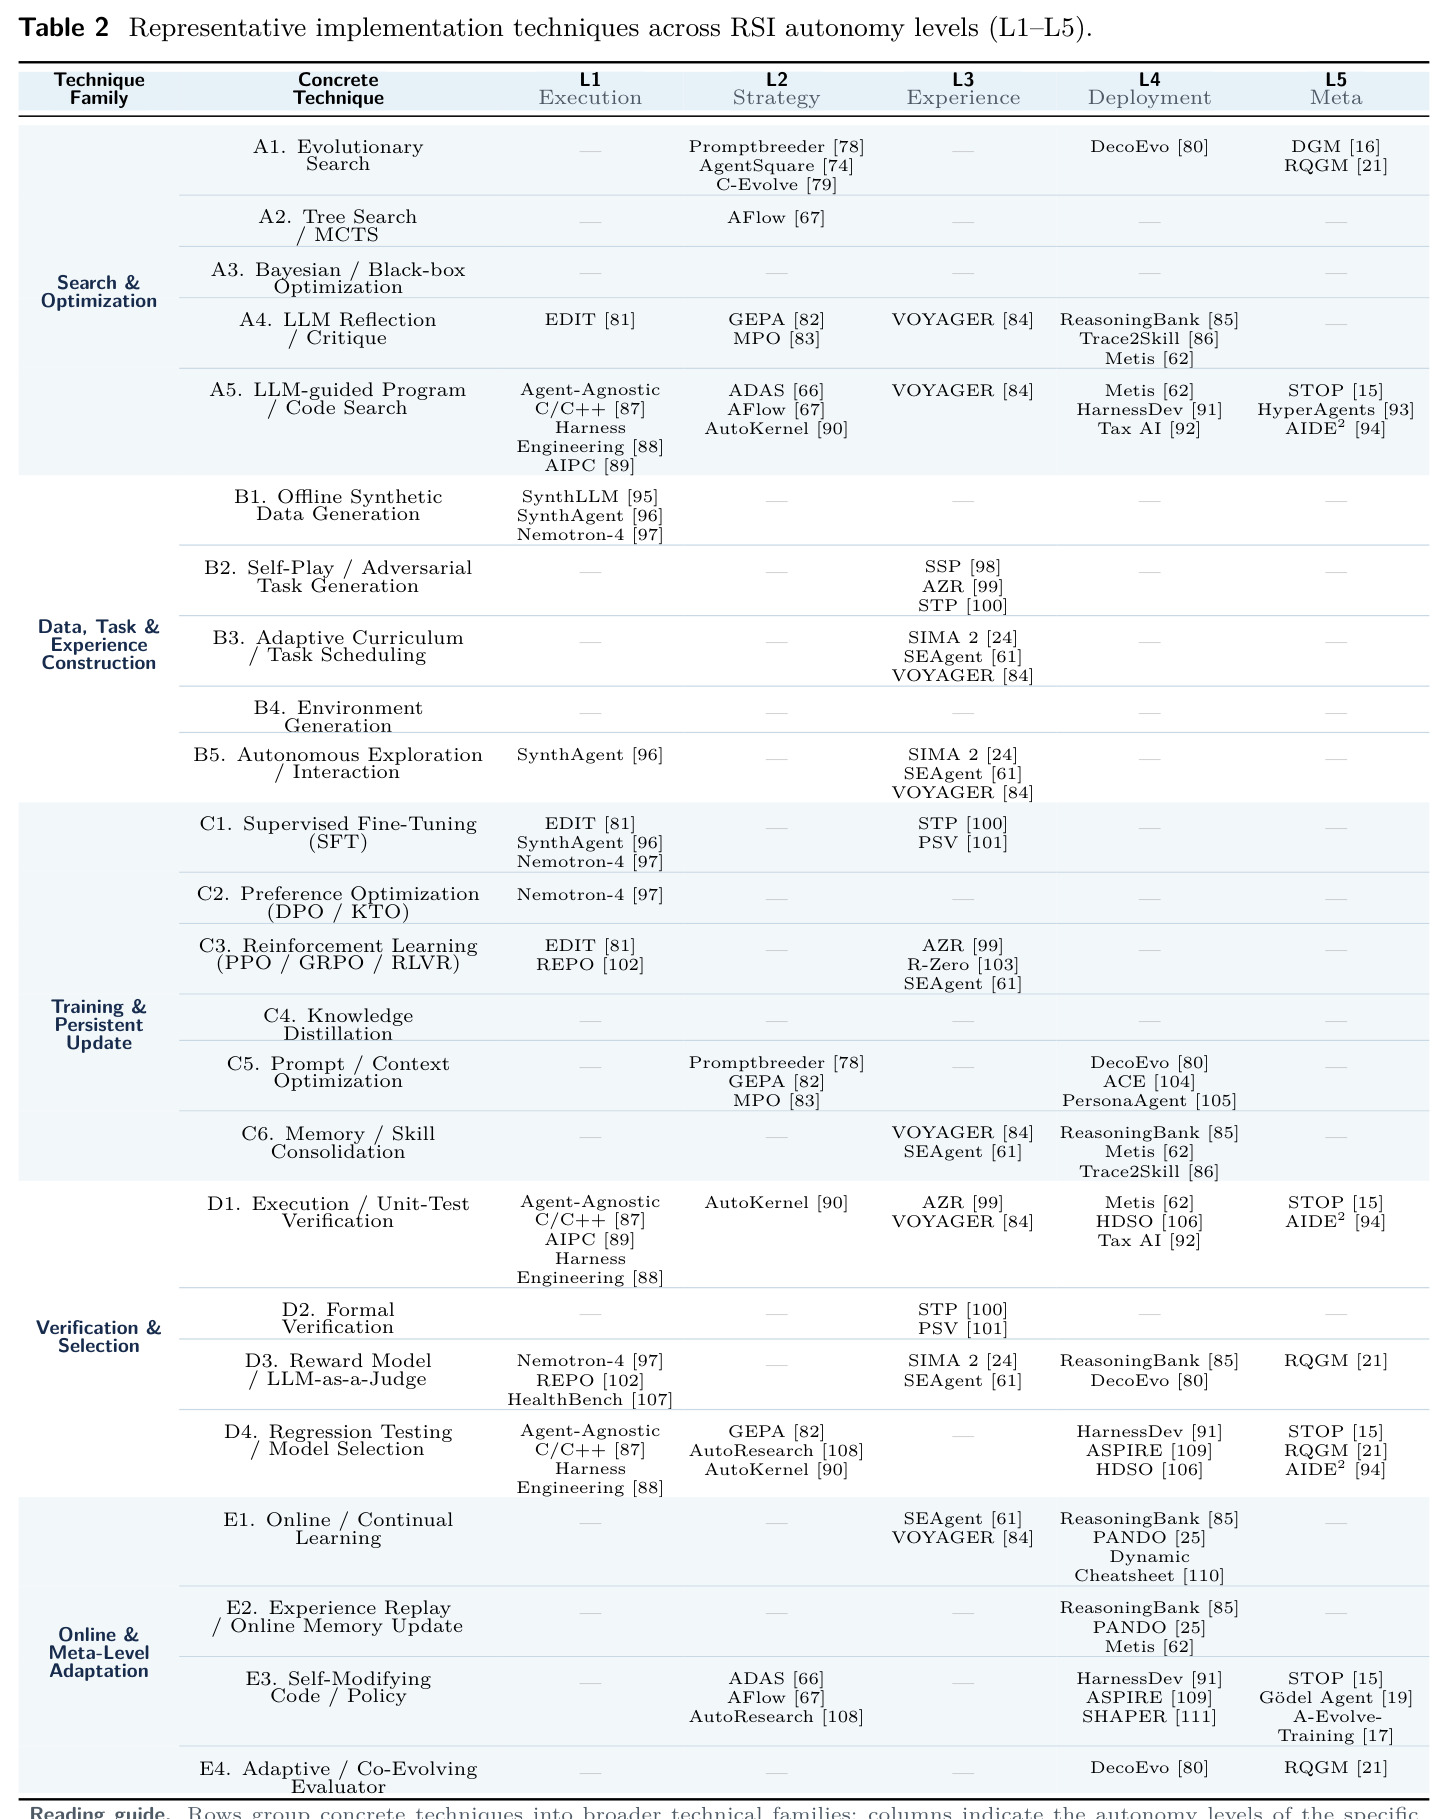
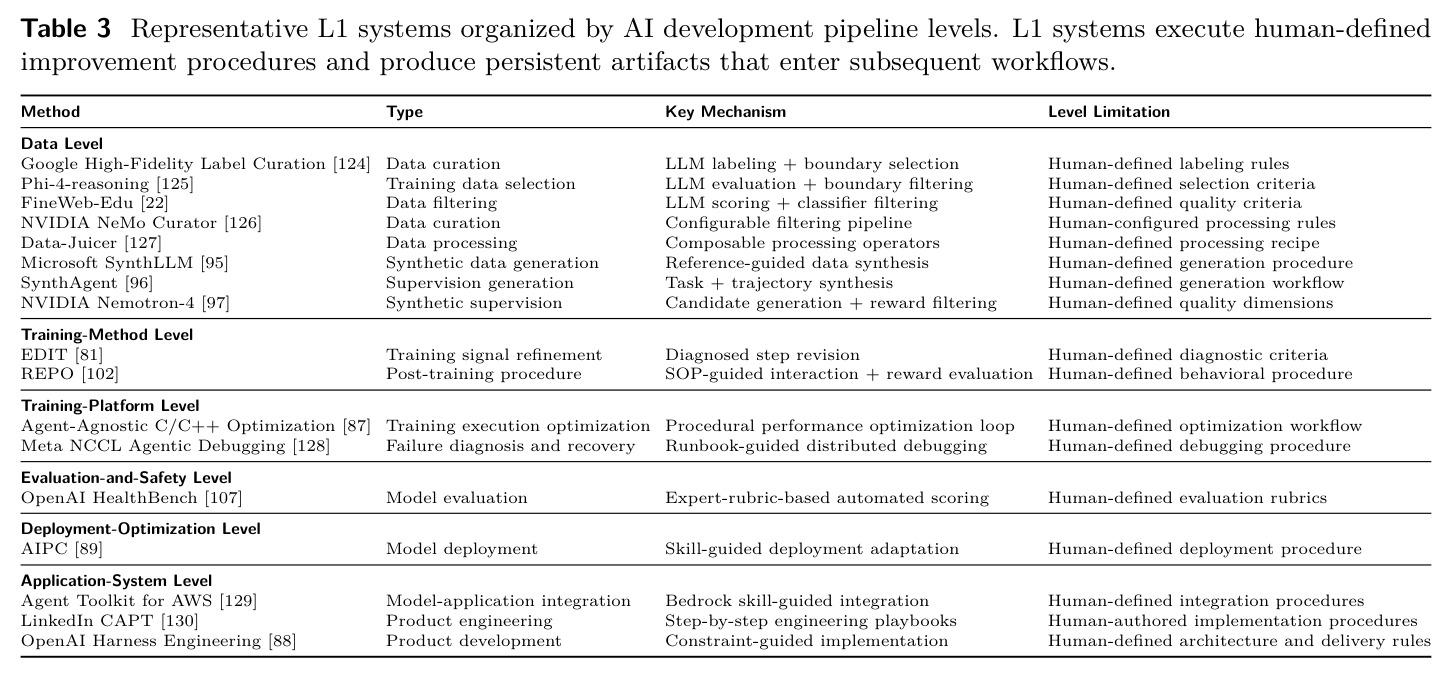
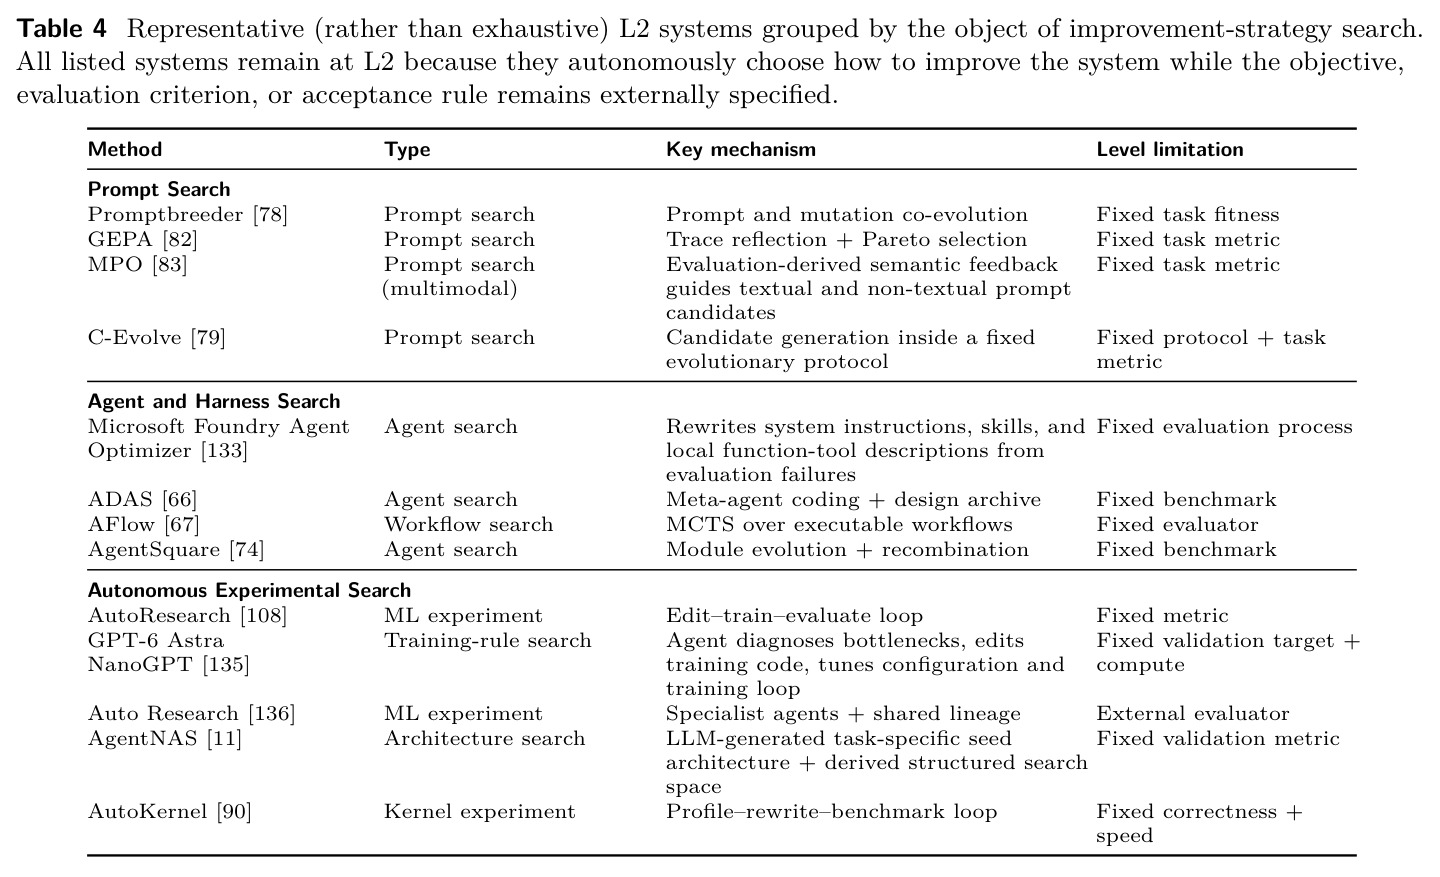
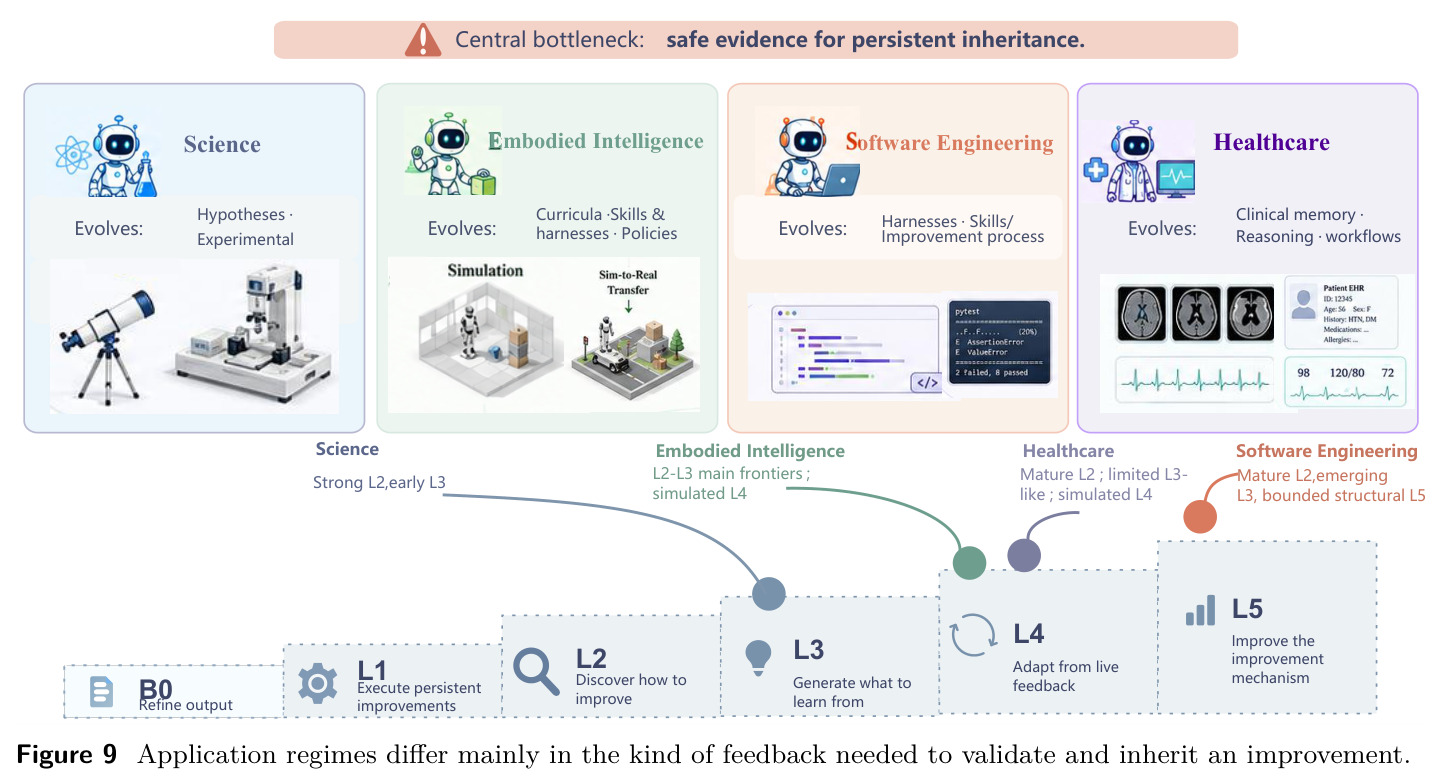
论文的核心方法是构建 B0–L5 五级自主性路线图,直觉是把'改进'这件事本身当作可被逐步移交、最终被自我改进的对象。B0 是会话内改进输出的参照级(Self-Refine、Reflexion),不留持久状态;L1 中 AI 执行人类定义的改进程序并持久化结果(如 FineWeb-Edu 按人工标准过滤数据、Meta 把调试经验固化为可复用修复技能);L2 中 AI 自主选择改进策略(如 GEPA 依执行轨迹改提示词、ADAS 进化智能体代码、AutoKernel 做'剖析-重写-基准'循环);L3 中 AI 决定下一轮学习什么经验(如 AZR 依求解者可学习性自我出题、VOYAGER 自选练习目标);L4 中部署反馈被转化为记忆、技能、脚手架或权重的持久适应(如 PANDO 在线准入/降级规则、Metis 双记忆、HDSO 配对准入测试);L5 中改进机制本身——改进器、后继评估器或研究策略——成为可改进并被后继继承的对象(如 STOP 自改改进器、RQGM 共进化评估器、A-Evolve-Training 修订研究策略)。每级用三个问题刻画:环在哪里闭合、什么被保留、哪些决策留在外面。
本质创新在于把自主性操作化为'改进责任的转移',并给出可判定的相邻级别边界:B0→L1 看持久性,被接受的改变必须活过当前任务、成为后继轮次的起点;L1→L2 转移策略选择权,AI 决定尝试哪个干预而非仅执行规定动作,瓶颈从'执行已知改进'变成'搜索可能改进';L2→L3 增加学习议程控制权,演化中的学习者状态影响下一份经验是什么,即'学习者条件化的经验获取';L3→L4 把该反馈过程延伸进持久部署与环境交互,改变须在变化的任务、环境与执行者下保持有用;L4→L5 引入递归继承,负责后续改进的机制(改进器、评估器、研究策略)本身成为被改进并被后继继承的对象。与已有方法的另一本质区别是:论文强调更高自主级别不等于更好的改进——更大的权限可能与低效搜索、不可靠反馈、能力回退、评估器利用或迁移失败并存,因此必须把'AI 内化了多少改进责任'与'改进过程的质量和效率'分开度量,并用结构递归/有效递归区分证据强度。
方法步骤详情
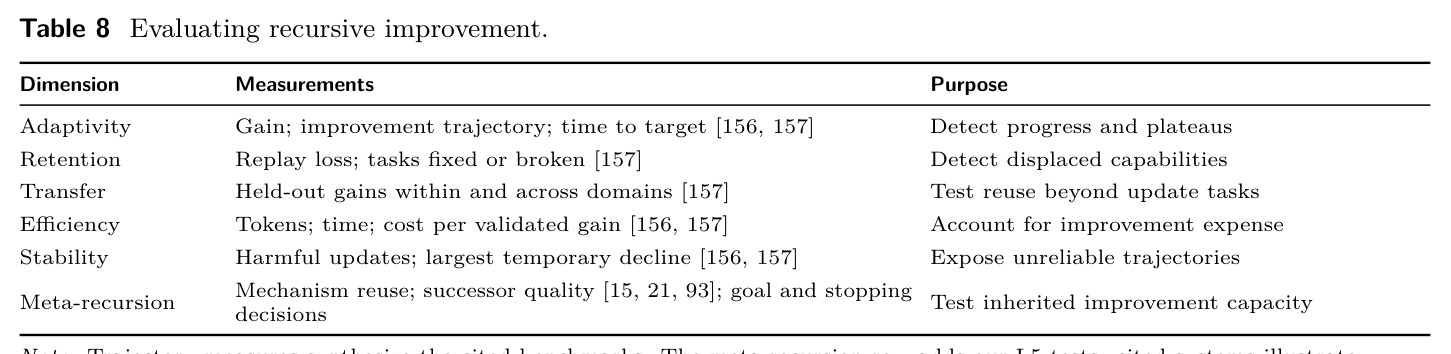
论文的论证分六步。第一步,用 HCI 指数量化 2023 年至 2026 年 9 月 393 条模型-基准观测的跨领域能力轨迹:对同协议族的多个来源做加权共识(四类来源基权重 3、2.5、2、1,第一方结果再乘 0.75),归一化后按年取 90 分位前沿、平方根加权合成领域轨迹,识别交互式工作流与有界可验证能力的差距。第二步,解剖改进闭环九组件,给出 RSI 定义并划清与持续学习、AutoML、智能体 ML 的边界(Table 1)。第三步,逐级综述 B0–L5:每级先给特征循环,再按改进对象组织代表技术(Table 2 汇总搜索优化、数据/经验构造、训练持久更新、验证选择、在线元适应五大技术族),并给出各级评估要点与 Finding。第四步,在科学、具身、软件、医疗四个应用域检验反馈机制如何塑造改进的验证与继承(Figure 9)。第五步,分析八个产业实践的改进闭环、保留工件与人类控制点,汇总定量结果。第六步,归纳三大挑战与八个研究方向,给出长时程评估协议(Table 8)。
技术新颖性
技术新颖性体现在四点。其一,五级自主性分类学本身:此前的自演化综述以'什么在变、怎么变'为主线,本文以'谁做决定'为主线,使机制迥异的系统可放入同一坐标系——例如同是改提示词,人定标准 AI 执行是 L1(FineWeb-Edu 式),AI 依据轨迹自选修改策略是 L2(GEPA 式),这解决了旧分类'同组件不同权'的混淆。其二,明确区分结构递归与有效递归,并给出机制审计协议:识别被改工件、记录动机证据、验证其在后续轮次被调用、在匹配预算下与原机制对照、保持机制固定做迁移测试,这为评估'真递归'提供了可操作清单(Table 8)。其三,以 HCI 指数作为经验基座,把'RSI 该往哪使力'变成可量化命题——剩余留白越大的域,假设中的 RSI 收益越大($R_d = 100 - 0.22(100 - T_{d,2026})$)。其四,系统地以产业证据补充学术文献,将八个工业案例映射回分级框架,形成学术-产业对照,并指明前沿改进环往往先出现在技术报告与工程博客而非论文中这一证据生态事实。
实验结果
核心发现有四组。其一,能力进步不均衡:393 条观测的 HCI 轨迹显示,2026 年高等数学达 86.4、研究生科学 85.8,而软件工程仅 52.6、工具智能体 39.9,分别比研究生科学低 33.2 与 45.9 分,且有界环境的进步未均匀迁移到长程有状态工作流;法律推理年增量从 2024 年的 48.2 收窄到 2026 年的 4.9。其二,层级证据不均:L1–L2 支撑广泛,L5 仅有界原型——STOP 第四代改进器在 5 个迁移任务全胜种子;Gödel Agent 100 次 MGSM 试验中 14 次低于初始策略;DGM 把 SWE-bench 子集从 20% 提到 50% 但归档与父代选择不可自改;RQGM 在 Polyglot 达 71.7% 对 69.9%;A-Evolve-Training 四轮自主后训练把 30B 模型外部分数从 0.80 提到 0.86(人类最佳 0.87);AIDE2 的加速未达统计显著。其三,产业实证:Theseus 重建环境使 rubric 分提升 18.65–39.67pp;Humanlaya 缺陷包率 9.0%→3.7%;ModelBest 约 8 小时从空目录匹敌 Megatron-LM;Frontis 76 个任务均分 5.25→5.87。其四,安全继承、自主性归因、可靠验证三大挑战贯穿所有层级;各实验逐项数字见 benchmarks 表。
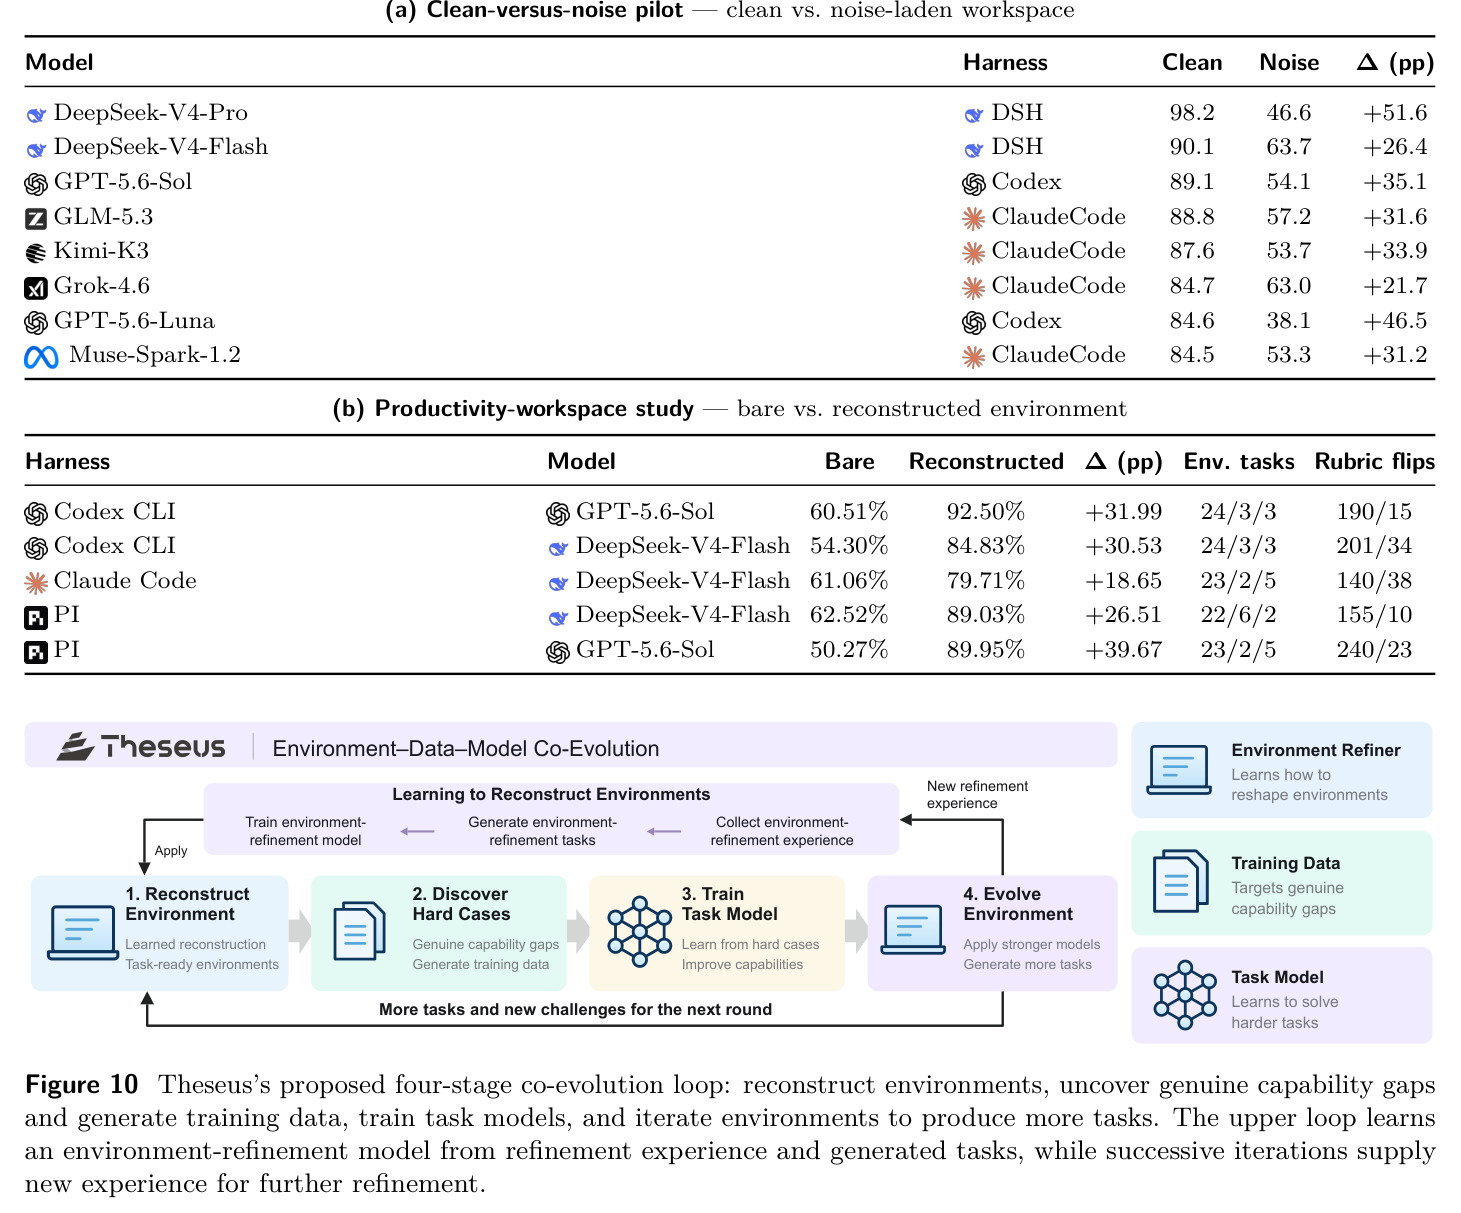
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Theseus 工作区环境重构(5 个固定配置,30 任务/547 rubrics) | rubric 总分提升 | +18.65~39.67 个百分点 | 裸工作区 | 全部配置提升,最高 +39.67pp(PI + GPT-5.6-Sol) |
| Theseus 干净 vs 噪声工作区试点(8 配置,30 任务/1,280 rubrics) | 任务通过率 | 干净工作区(如 DeepSeek-V4-Pro 98.2%) | 噪声工作区(46.6%) | 所有配置 +21.7~51.6pp,说明环境质量本身约束智能体表现 |
| Humanlaya 数据质量保障 V0→V4(600 个留出任务包) | 含关键缺陷任务包率 / 平均人工处理时长 | 3.7% / 27 分钟 | 9.0% / 48 分钟 | 缺陷率 -5.3pp,耗时约 -44% |
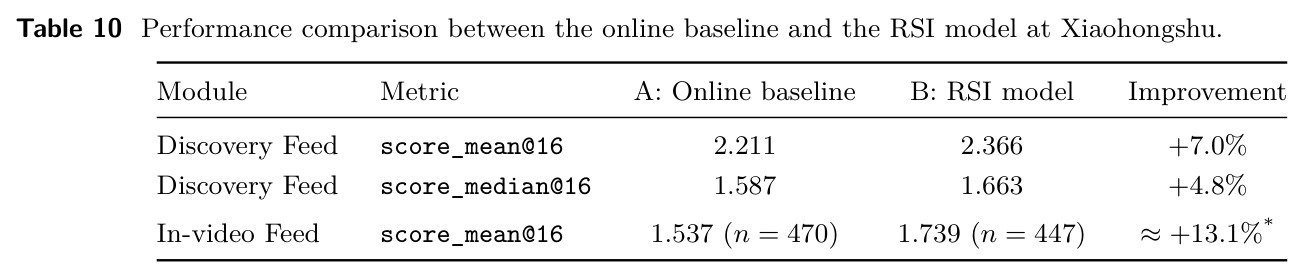
| 小红书推荐 Intent-Memory Agent(IMA) | Discovery Feed score_mean@16 | 2.366 | 2.211(在线基线) | +7.0%;另 score_median@16 +4.8%、视频内 feed 约 +13.1% |
| ModelBest ForgeTrain 预训练框架(从空目录生成,H100) | MFU(8B 模型) | 50.9% | 47.0%(Megatron-LM v0.15) | +3.9pp;0.5B 为 40.1%→44.1%;约 8 小时匹敌、1.5–2.5 天超过人工开发(估 3–5 工程师×6–12 月) |
| 腾讯混元 Hyra / nanochat AutoResearch | validation BPB(越低越好) | 0.9015 | 0.9109(此前最佳) | 另 nanoGPT Speedrun 76.4s vs 77.5s、SOL-ExecBench 0.771 vs 0.754 |
| Red Queen Gödel Machine(评估器共进化) | held-out Polyglot 编码通过率 | 71.7% | 69.9%(HGM-H) | +1.8pp 且搜索 token 更省 |
| A-Evolve-Training 四轮自主后训练(30B Nemotron) | 外部排行榜分数 | 0.86(起点 0.80) | 0.87(最佳人类提交) | 接近人类冠军,且策略与发现日志被跨轮继承 |
| Darwin Gödel Machine(自进化编码智能体) | SWE-bench 子集解决率 | 50% | 20% | +30pp,但归档维护与父代选择在自修改范围外 |
| Frontis-MA1(35B 权重内化改进能力) | MLE-Bench Lite | 60.61%(加搜索 71.21%) | 39.39%(固定脚手架) | +21.22pp(加搜索 +31.82pp) |
| Agent-Native Research Artifact(ARA) | 基于先前工作的问答准确率 | 93.7% | 72.4%(传统论文载体) | +21.3pp;RE-Bench 复现成功率 57.4%→64.4%;Chip-Bench CPU 比标准智能体基线快 2.7%、面积小 21.5%,通过全部 97 项定向测试与 350 个随机差分程序 |
局限与改进
作者明确承认的局限:产业结果几乎全部为公司自报(company-reported)、未经独立复现;AIDE2 将进化脚手架装回外层改进器的实验未发现统计显著的效率优势,说明'可靠加速 successive improver'尚未确立;长时程、跨分布的继承收益缺乏数据,多数评估只覆盖有界任务流;医疗域证据停留在仿真或回溯性设定;Hyra 式评估器共演化带来评估可比性风险,STOP 中弱模型运行平均退化且部分程序规避软预算。我自己的观察:其一,HCI 构造含主观选择——来源基权重 3/2.5/2/1、第一方结果乘 0.75、以 90 分位为入门年前沿、平方根加权等,不同选择会改变'交互能力留白更大'结论的强度,且 Cybench 虚线段提示子集变更已造成可比性问题;其二,分级判定依赖对系统内部决策权的自述与代码可审计性,对闭源产业系统实际只能做粗粒度归级;其三,标题'人类打造的最后一个 AI'的宏大叙事与正文克制的证据强度有落差,安全与治理虽被列为挑战但未设专门章节,对失控风险、提议者-评估器合谋、目标漂移的讨论较浅。
独立分析的弱点
独立分析有四个弱点。第一,证据基础薄弱:L3–L5 的许多结论建立在预印本、技术报告与公司自报数据上,缺少跨实验室复现与统一协议对照,改进收益常与额外算力、更强底座模型混杂。改进方向:把 Table 8 式机制审计加匹配预算对照立为社区标准,强制报告被拒更新与回归轨迹。第二,分级边界难以审计:判定系统是 L2 还是 L5 需知道'哪些决策真正由 AI 控制',对闭源工业系统只能依赖厂商描述,框架可能被营销性'RSI'标签滥用。改进方向:把可审计工件(版本化策略/评估器 diff、调用日志)作为分级申报的强制证据。第三,验证器可靠性仍是全局瓶颈:R-Zero 用答案一致性当难度代理、VisPlay 的置信奖励可能奖励歧义、PSV 自报不同难度档实际难度大量重叠,评估器利用已在 Anthropic 实验中出现。改进方向:研究提议者-评估器合谋检测与不可收买的外部评估接口。第四,对失败与安全继承的处理偏描述性:Gödel Agent 14% 退化、Library Drift 技能库退化、技能未被激活或未被忠实执行都被点名,但缺乏系统的回滚、隔离与影响面分析。改进方向:引入软件工程式的回滚、金丝雀发布与依赖追踪。
未来方向
论文第八节提出八个方向:跨组件诊断与协同改进——把诊断变成可检验的干预假设,用控制对照、组件冻结与依赖记录分离因果(Humanlaya 的'提取失败被误判为文档质量差'即典型);学习者条件化的经验获取与可靠学习信号——区分正确性、难度、学习收益,研究何时值得花昂贵验证;持久状态管理与可靠复用——为继承工件关联证据、适用条件与依赖,处理 Library Drift 与跨执行者复用;领域特异性反馈下的治理化适应——按四类反馈选择验证流程,人类保留最终发布权;改进机制的可信演化——区分可编辑内部反馈与独立验收标准,研究有害机制的无损回滚;继承改进能力的长时程评估——在结构 L5 之外证明有效 L5,报告含被拒更新的完整轨迹;资源感知改进与人机协作——核算全预算并研究自适应停止;跨轮继承的可复现基础设施——版本化数据/环境/评估器、确定性重抽取、形式化验证与 ARA 式可执行研究工件。在此之上可延伸:把 RSI 分级与安全等级绑定(L5 系统强制外部锚点评估)、研究跨模型技能可迁移性、用 RSI 方法改进 RSI 评估基准本身。
复现评估
作为综述,复现成本很低:论文随附 awesome-rsi 开源仓库(github.com/theseus-labs-rsi/awesome-rsi),正文给出完整的文献-级别-改进对象映射(Table 2–8)与 HCI 构造规则(来源权重 3/2.5/2/1、第一方×0.75、393 条观测的准入标准),有编程基础的研究者可在数天内重建其文献地图与指标计算;但 HCI 原始观测表是否随文发布未确认,部分结论依赖公开榜单快照。文中评述的学术系统多数开源(如 STOP、DGM、AFlow、R-Zero、VOYAGER、AZR),可在单卡到小集群规模复现核心循环,难点在于多轮长时程实验的评估成本与统计功效;八个产业实践(Theseus 工作区、Lark 知识图谱、小红书 IMA、Humanlaya 质检、ForgeTrain、Hyra、ARA、Frontis Horizon)均为内部系统,外部基本无法复现,只能作为定性证据。总体判断:复现这篇论文本身容易(难度低),复现它报告的实证结果则从'中等(学术系统)'到'基本不可能(工业系统)'不等。
论文图表
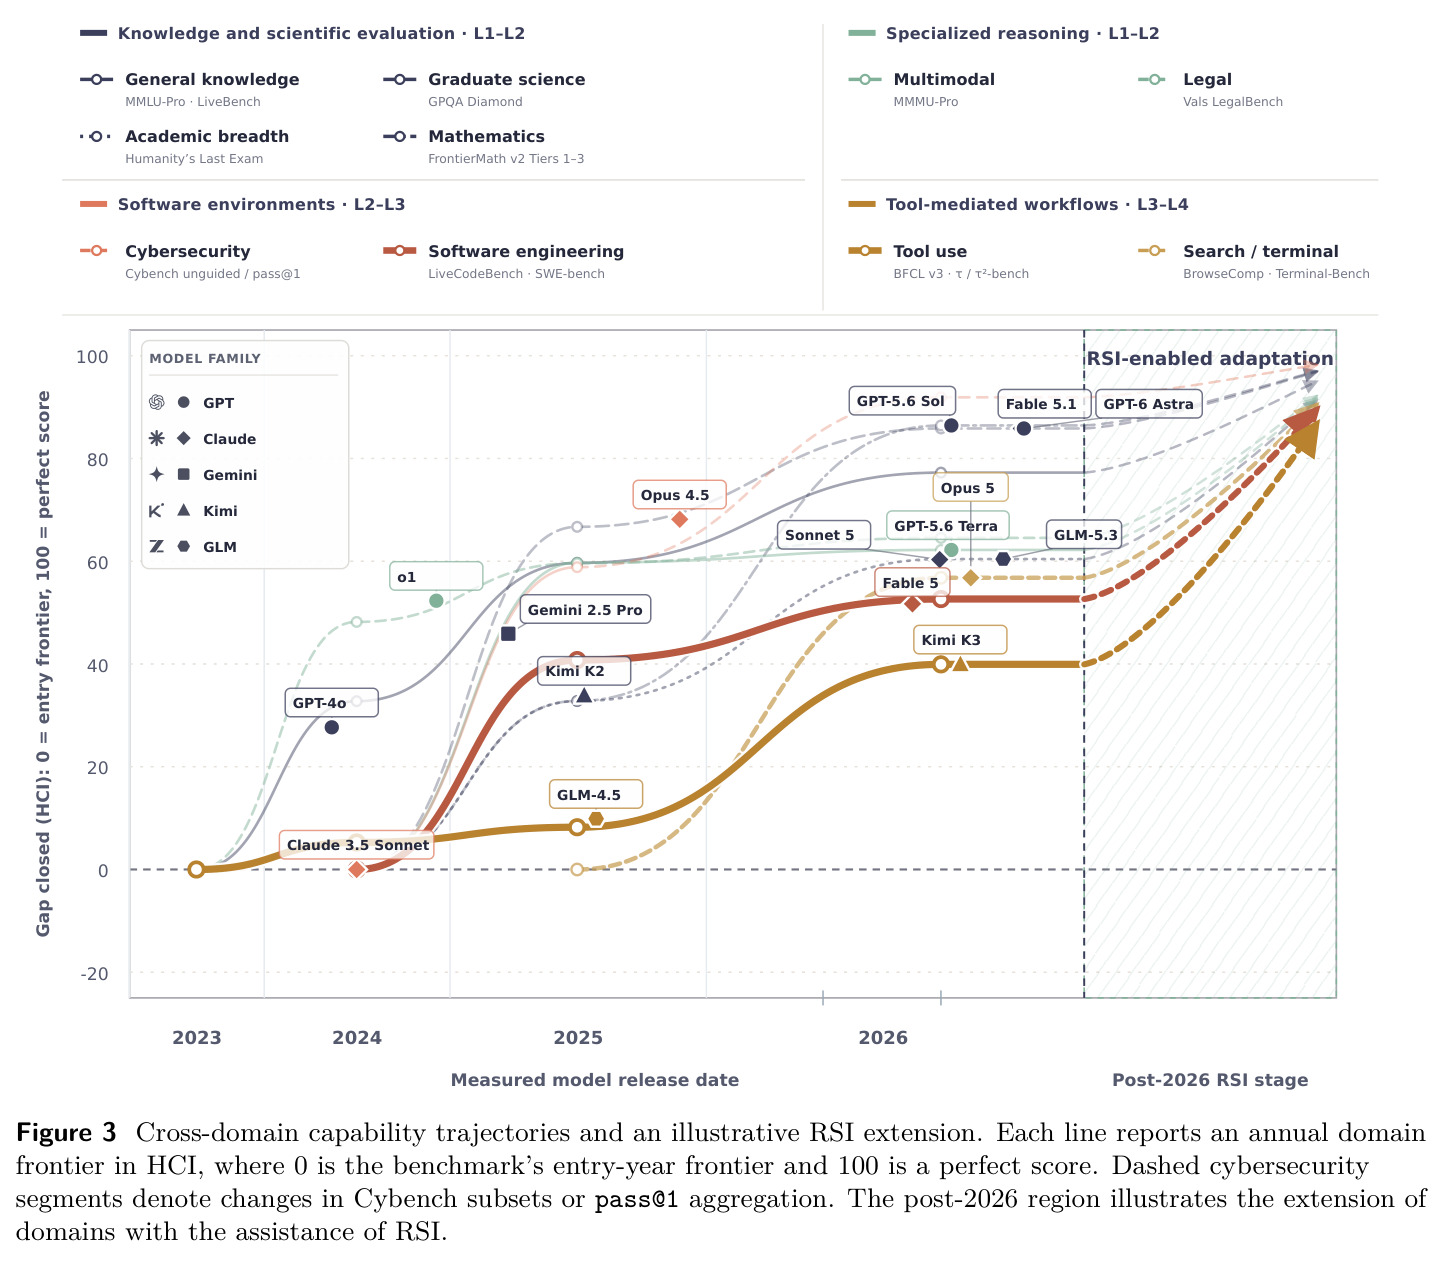
汇总 2023–2026 年 393 条模型-基准观测,按十个能力域绘制 HCI 年度前沿轨迹(0=基准入门年前沿,100=满分),右侧阴影区示意 RSI 假设下的扩展端点 $R_d = 100 - 0.22(100 - T_{d,2026})$:高等数学 86.4、研究生科学 85.8 领先,而工具智能体仅 39.9、软件工程 52.6 落后,网络安全智能体达 91.9(虚线提示子集变更)。
它是全文的经验动机:用数据证明交互式、有状态能力的留白最大,而假设中的 RSI 收益与剩余留白成正比,从而论证'软件工程与工具使用特别适合 RSI'的价值主张。