AI 自我改进的递归临界性 Recursive Criticality of AI Self-Improvement
提出递归复制数判据,界定 AI 研发反馈何时进入自我放大临界区
前置知识
递归自我改进(RSI)
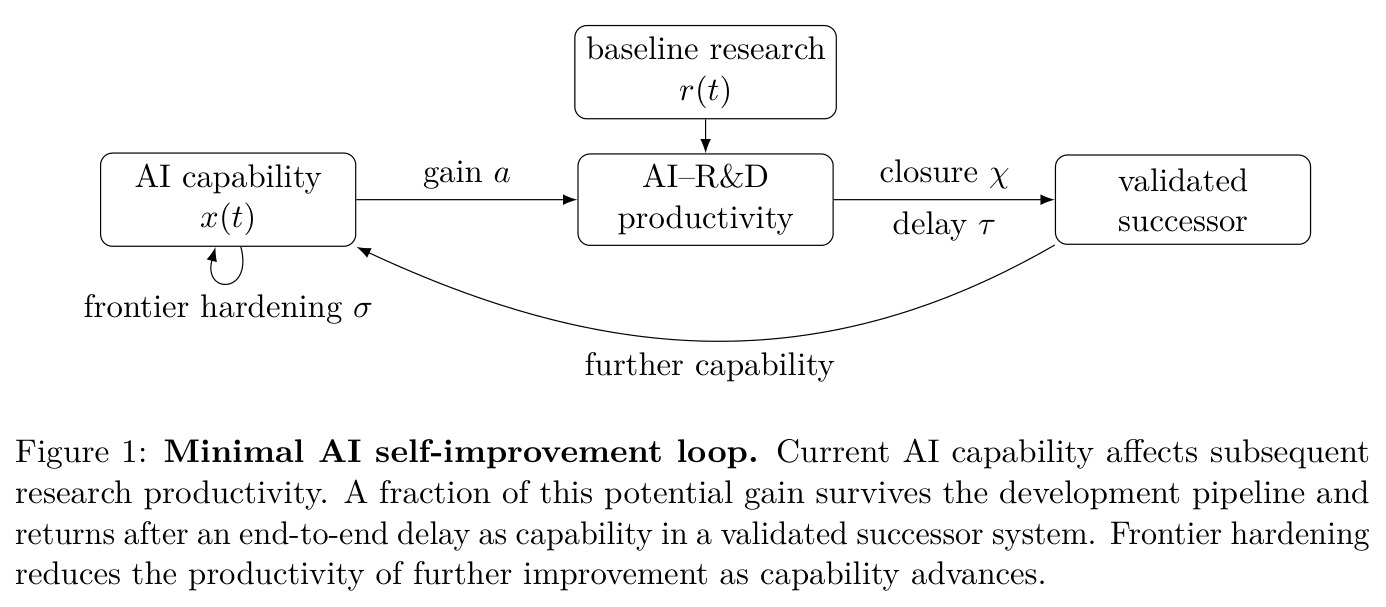
指 AI 系统参与研发下一代 AI,形成“能力→研发生产力→更强能力”的正反馈回路。本文强调 RSI 是 AI 研发系统(包含人类研究者、算力基础设施、评估流程与组织)的整体属性,而非孤立智能体的属性;回路中每个环节都存在损耗与延迟。
全文的建模对象就是这个回路,判据 $R_{\mathrm{AI}}$ 分子中的增益 $a$ 与闭合度 $\chi$ 正是回路的核心组件。
复制数与超临界/亚临界
源自流行病学的再生数 $R$:一个扰动平均能产生多少“后代”。$R>1$ 为超临界,扰动被指数放大;$R<1$ 为亚临界,扰动逐渐衰减。本文类比定义递归复制数,判定一次能力增量能否在后续开发周期中自我复制。
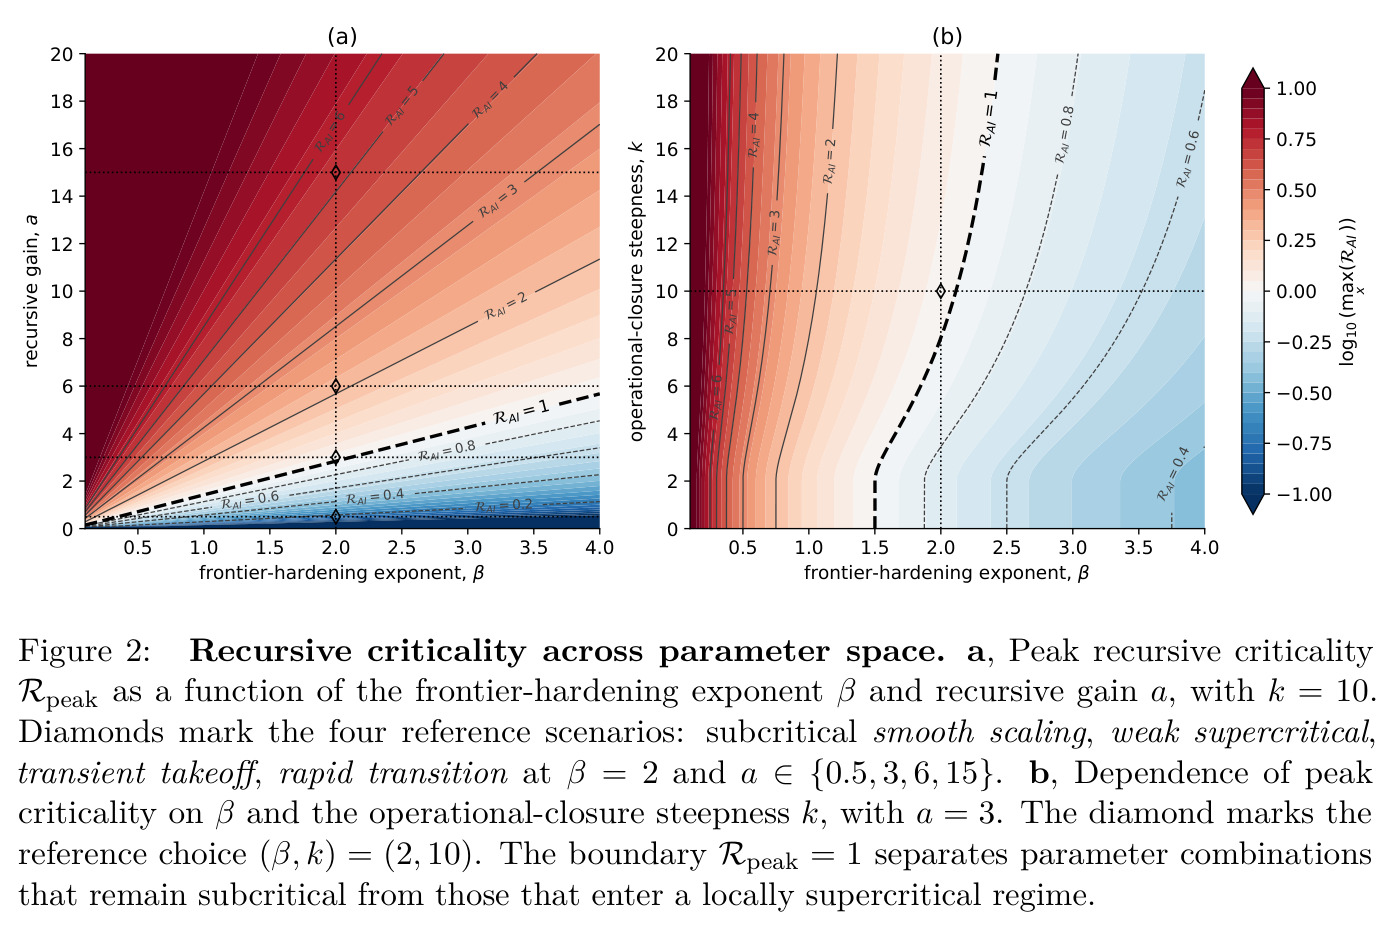
$R_{\mathrm{AI}}=\chi a/\sigma$ 是全文核心判据,所有命题和数值情景都围绕它是否大于 1 展开。
时滞微分方程与稳定性分析
形如 $\dot{x}(t)=F(x(t), x(t-\tau))$ 的方程,反馈需经过延迟 $\tau$ 才生效。对参考轨迹做线性扰动可得特征方程 $\lambda + v\sigma = vg e^{-\lambda\tau}$,特征根实部的符号决定扰动放大还是衰减,主根 $\lambda^*$ 决定放大速率。
论文的 Proposition 1(局部递归临界性)正是对该特征方程做稳定性分析得出的。
谱半径
非负矩阵 $K$ 的最大特征值 $\rho(K)$。在线性耦合系统中,$\rho(K)<1$ 意味着整个网络稳定,$\rho(K)>1$ 则出现集体放大。用于把单主体判据推广到多个实验室、公司或国家相互传播改进的研究生态。
多主体扩展(Proposition 3)的集体临界性完全由繁殖矩阵 $K$ 的谱半径决定。
前沿硬化(frontier hardening)
研究越接近既有范式的能力上限 $X$,直接改进的边际生产力越低。论文用 $f(x)=(1-x/X)^\beta$ 刻画,硬化率 $\sigma(x)=\beta/(X-x)$ 随逼近 $X$ 而发散,构成反馈回路中的阻尼项。
$\sigma$ 是 $R_{\mathrm{AI}}$ 的分母,决定递归增益能否覆盖研究难度的上升,也是超临界区间迟早终结的原因。
运营闭合度(operational closure)
$\chi(x)\in[0,1]$ 表示潜在递归增益中经评估、集成、训练、部署全管线后真正进入后继系统的比例。高自动化但产出过不了评估的系统闭合度可以很低;保留大量人工但整合高效的系统闭合度可以很高。参考情景用 logistic 函数 $\chi(x)=1/(1+e^{-kx})$。
$\chi$ 与 $a$ 的乘积才是实际递归增益 $g$,是 $R_{\mathrm{AI}}$ 分子的关键组成部分。
研究动机
关于 AI 递归自我改进(RSI)的讨论长期停留在两种不接地气的状态。思辨层面,从 Good 1965 年的“智能爆炸”以来,多数论述把 RSI 当作跨越某条智能阈值后必然发生的全有全无事件,无法说明它何时、因何发生。经济建模层面,近期把 AI 内生化进研发生产函数的工作给出了基于弹性条件的判据,但没有统一处理反馈延迟、研究前沿变难和跨组织传播这三个关键因素。实证层面的差距同样明显:MLE-bench、RE-Bench、PaperBench 等评测度量了 AI 做机器学习工程、做实验、复现论文的能力,却回答不了“AI 研究能力的一次提升因果地提高了多少下一代研发的生产力”这个问题。专家调查也只能给时间点:2023 年 ESPAI 调查了 2778 位作者,给出高水平机器智能 50% 中位日期 2047 年;后续一项 279 位专家的调查给出 50% 日期 2050 年,区间约 2039–2065 年——但都不区分快速进步的来源。结果是:我们观察到基准分数快速上涨,却无法判断这是普通加速还是自我放大的开端。
本文的目标是本文要回答三个问题:AI 辅助 AI 研发在什么条件下从普通加速跨入自我放大区?反馈延迟和研究前沿的日益变难如何决定这个区间产生的是短暂的短暂位移还是向 AGI/ASI 的显著压缩转变?物理资源限制、研究主体之间的竞争与协作又如何改变这些动力学?为此作者构造了一个最小但可扩展的动力学模型,推导出一个可测量、可估计的临界判据——递归复制数 $R_{\mathrm{AI}}$,把“是否自我放大”与“进步有多快”这两个长期被混淆的问题在数学上分开,并识别出应该测量哪些系统属性,才能在加速肉眼可见之前判断系统是否已经进入超临界区。
与已有工作不同的是,本文的独特切入是把 RSI 重新表述为 AI 研发系统的局部稳定性相变,而不是智能体达到某个能力等级的事件。作者借用流行病学复制数概念定义 $R_{\mathrm{AI}}=\chi a/\sigma$,其中 $\chi a$ 是经研发管线折扣后的实际递归增益,$\sigma$ 是前沿硬化率,临界点在 $R_{\mathrm{AI}}=1$。这个框架带来三个反直觉推论:临界性与基线研究吞吐量(算力、经费、人力)无关,因为吞吐量在阻尼项和反馈项中同比例出现;系统可以在加速变得可见之前就已超临界;快速进步既不是递归临界的充分条件也不是必要条件。此外,把多个研究主体表示为繁殖矩阵并用谱半径判定集体临界性,说明整个研究生态可以超临界而每个主体单独都亚临界,这是此前单主体模型完全无法表达的结论。
核心方法
直觉上,模型把 AI 研发画成一个闭环:当前能力 $x(t)$ 提升研发生产力(增益 $a$),经端到端延迟 $\tau$ 后,只有闭合度 $\chi$ 比例的增益以验证过的后继系统能力形式返回;同时能力越接近研究前沿 $X$,直接改进越难(硬化率 $\sigma$)。技术上用时滞微分方程 $\dot{x}(t)=r(t)f[x(t)]e^{\Phi(x[t-\tau],t)}$ 描述,其中 $\Phi'(x)=g(x,t)=\chi a$ 是实际递归增益,$\sigma=-d\ln f/dx$。对参考轨迹加小扰动线性化得 $\dot{\xi}=-v\sigma\,\xi(t)+vg\,\xi(t-\tau)$ 与特征方程 $\lambda+v\sigma=vg\,e^{-\lambda\tau}$,由此证明 Proposition 1:$R_{\mathrm{AI}}=\chi a/\sigma<1$ 时所有特征根实部为负(亚临界),$R_{\mathrm{AI}}=1$ 时出现零根,$R_{\mathrm{AI}}>1$ 时出现正实根(超临界),超临界即增量在开发周期间自我放大。数值上再对有限前沿、多主体网络与算力约束做情景模拟。
核心创新是临界判据本身的结构:$R_{\mathrm{AI}}=\chi a/\sigma$,分子是“一次能力增量经研发管线存活后能复制出多少研究生产力”,分母是“前沿变难吃掉多少生产力”,两者之比就是能力扰动跨开发周期的净繁殖率。由此得到三个与已有工作本质不同的结构性结论。第一,基线吞吐量 $v$(算力、经费、研究者时间)在扰动方程中同时缩放阻尼项 $-v\sigma$ 和反馈项 $vg$,因此完全不出现在阈值里——加算力只能让既有模式跑得更快,不能把亚临界系统变成超临界。第二,主根 $\lambda^* \simeq v\sigma(R_{\mathrm{AI}}-1)/(1+v\sigma R_{\mathrm{AI}}\tau)$ 显示超临界初期的增长率可以任意小,且受开发周期 $\tau$ 的硬限制:$v\sigma\tau\to\infty$ 时 $\lambda^*\to\ln(R_{\mathrm{AI}})/\tau$。第三,近临界点主根平滑过零,意味着超临界启动在数据上与普通加速难以区分,必须直接测量反馈量而不是看基准分数的斜率。
方法步骤详情
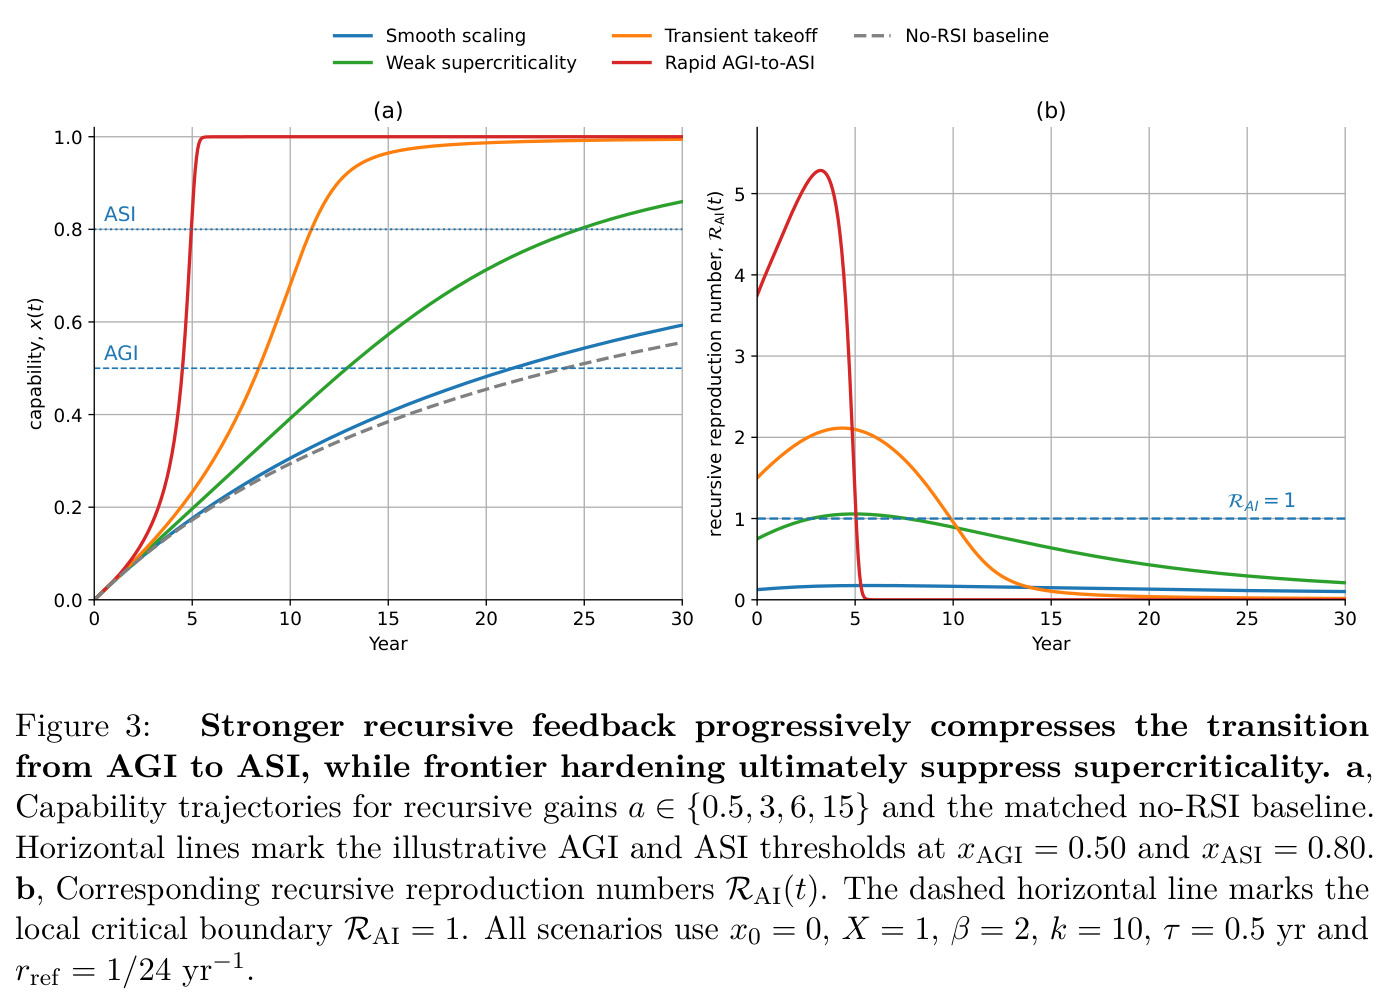
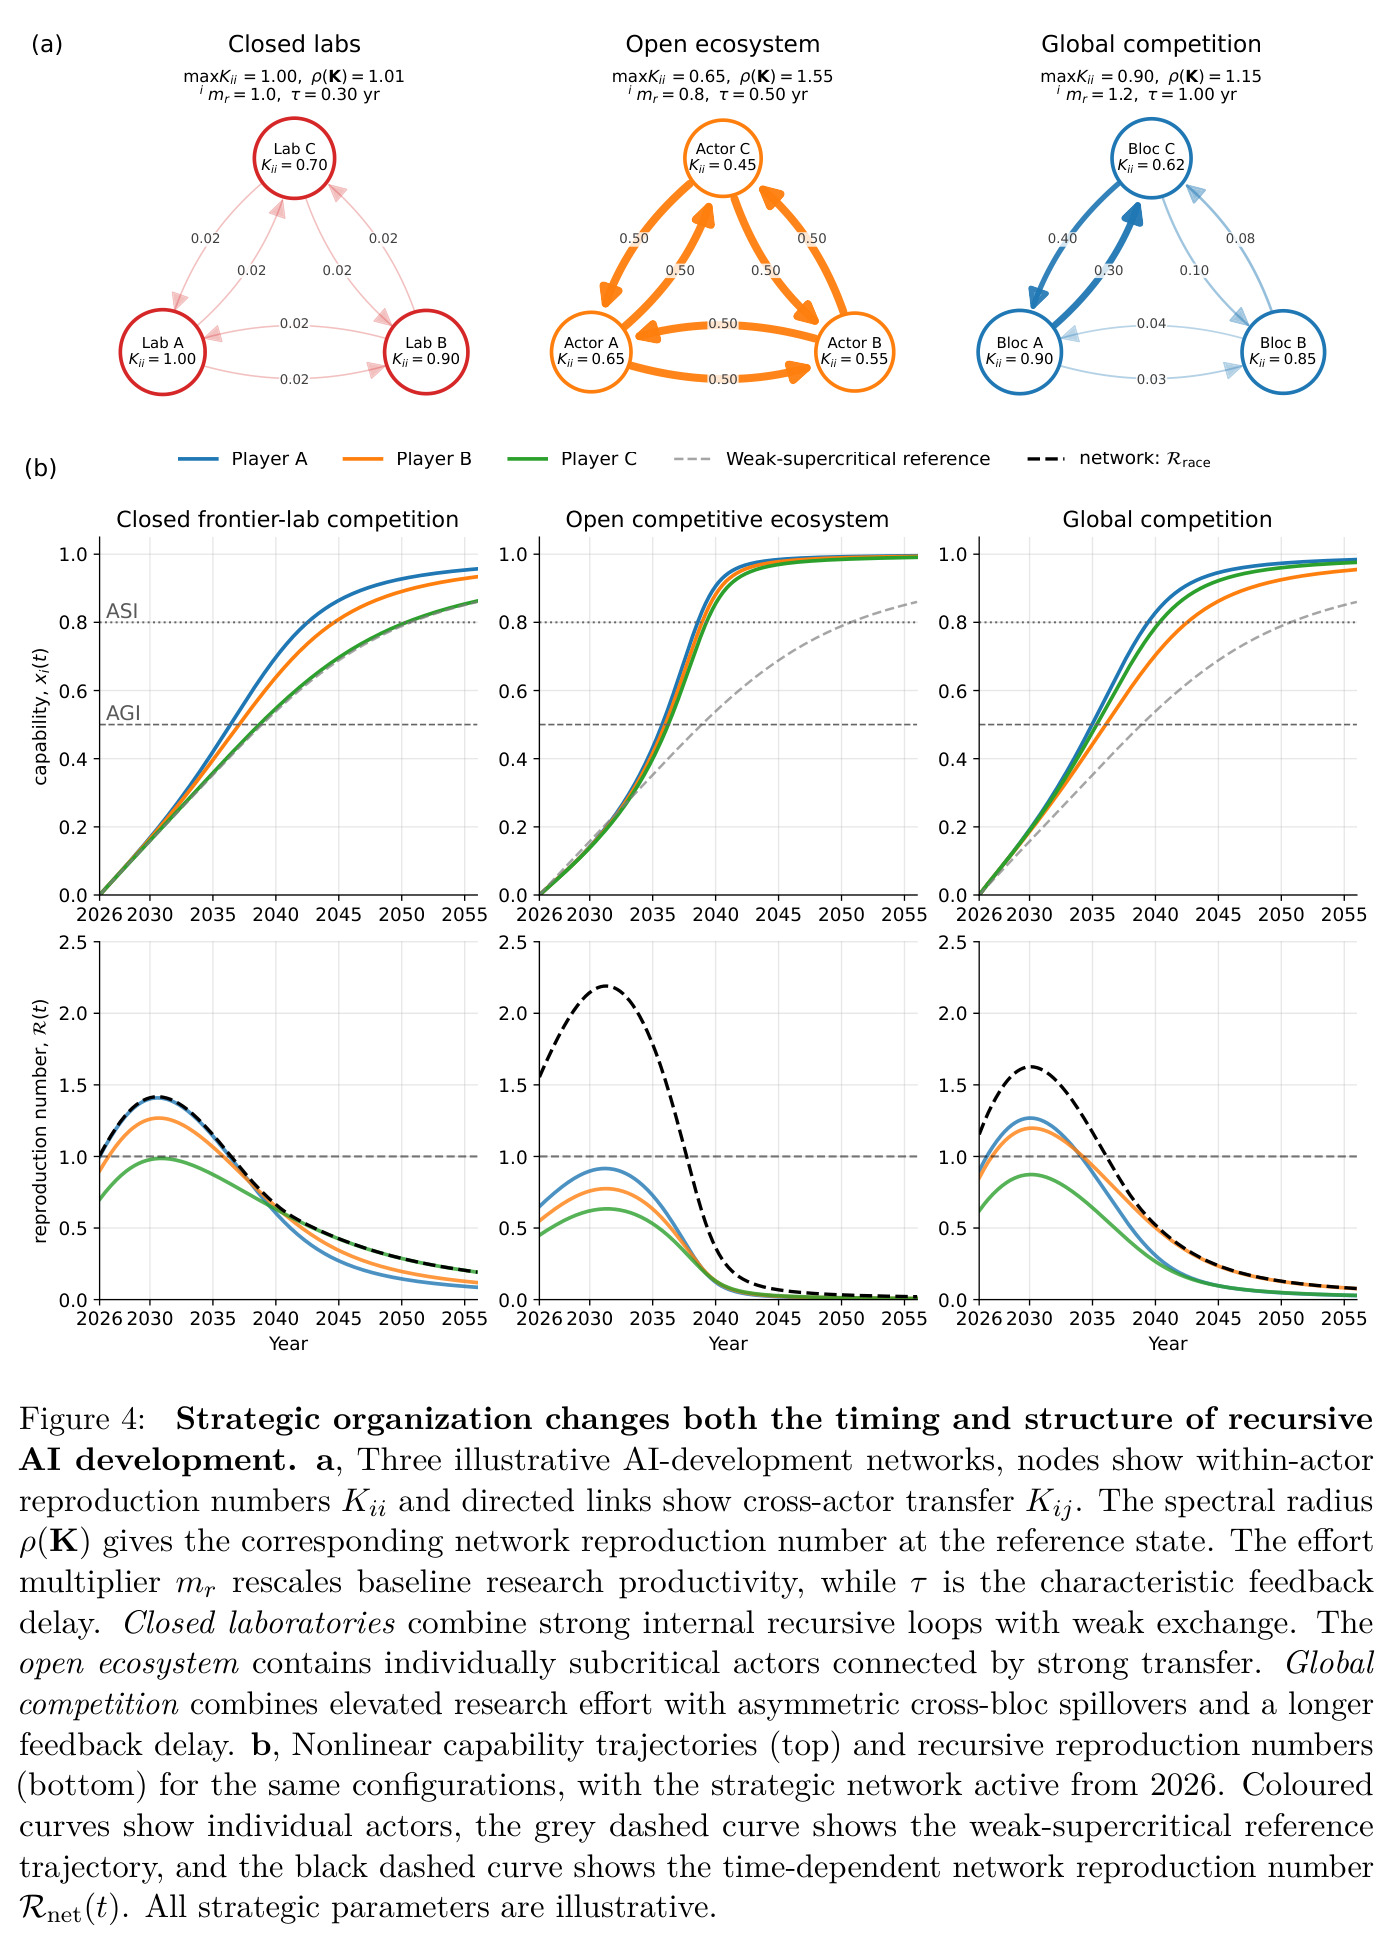
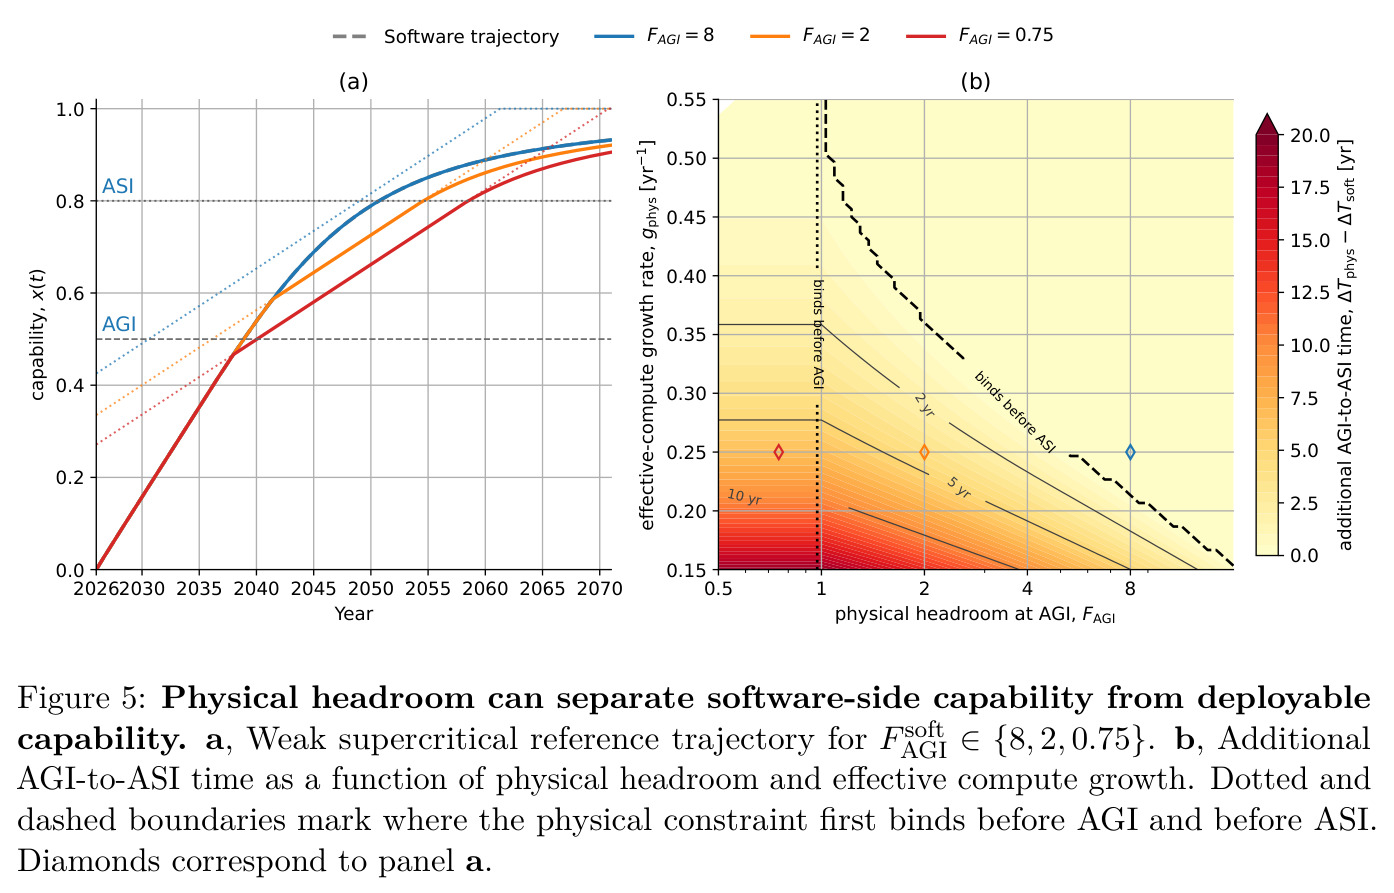
第一步,定义能力坐标:用固定任务面板上完成任务的资源成本比构造 $x(t)=\int_Q \varphi(q)\ln[c_t(q,\epsilon;p)/c_t'(q,\epsilon;p)]\,d\mu(q)$,即资源调整后的改进量。第二步,拆解回路四要素:基线生产力 $r(t)$、递归增益 $a$、运营闭合度 $\chi$、前沿硬化 $\sigma=-d\ln f/dx$,实际增益 $g=\chi a$。第三步,写出时滞动力学 $\dot{x}=r(t)f[x(t)]e^{\Phi(x[t-\tau],t)}$ 并线性化,解特征方程得判据 $R_{\mathrm{AI}}=g/\sigma$ 与主根 $\lambda^*$ 公式。第四步,引入有限前沿 $f(x)=(1-x/X)^\beta$,证明 Proposition 2:$x\to X$ 时 $R_{\mathrm{AI}}\to 0$,超临界区间必然终结。第五步,扩展到 $n$ 个耦合主体,按接收方硬化率归一化出繁殖矩阵 $K_{ij}=g_{ij}/\sigma_i$,Proposition 3 证明集体临界性由谱半径 $\rho(K)$ 决定。第六步,参数化参考情景($x_0=0$,$X=1$,$x_{\mathrm{AGI}}=0.50$,$x_{\mathrm{ASI}}=0.80$,$\beta=2$,$k=10$,$\tau=0.5$ 年,$r_{\mathrm{ref}}=1/24\ \mathrm{yr}^{-1}$),对 $a\in\{0.5,3,6,15\}$ 数值积分。第七步,叠加战略网络(三种 $K$、努力乘数 $m_r$、不同 $\tau$)与算力约束 $C_{\mathrm{req}}(x)=C_{\mathrm{req}}(x_{\mathrm{AGI}})e^{\kappa(x-x_{\mathrm{AGI}})}$ 做对照模拟。
技术新颖性
与已有文献相比有三层新颖性。相对 Good 以来的思辨传统:本文把“智能爆炸是否发生”改写成可检验的稳定性问题,给出带延迟的具体判据而非二值预言。相对 Cunningham 等人的经济弹性条件:本文的 $R_{\mathrm{AI}}$ 在概念上同构(作者也承认是标量情形的相关独立推导),但增加了延迟动力学、有限前沿瞬态性的证明,以及吞吐量不变性这一区分“速度干预”与“反馈干预”的结构性结论。相对评测文献:MLE-bench、RE-Bench、PaperBench 测的是回路组件的能力,本文指出缺失的一环是改进在管线中的传播率 $\chi$ 和跨开发周期的因果增益 $a$,并把它们变成待估参数。此外,把算力处理为部署约束 $C_{\mathrm{req}}\le C_{\mathrm{phys}}$ 而非递归变量也很干净:它限制可部署能力但并不直接改变 $R_{\mathrm{AI}}$,从而把基础设施政策与反馈动力学政策在概念上分离开来。
实验结果
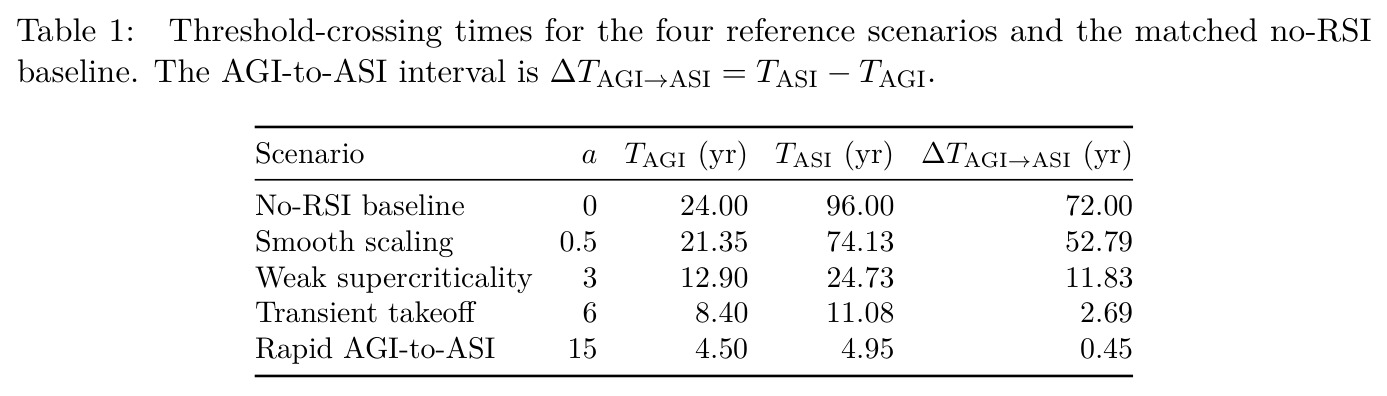
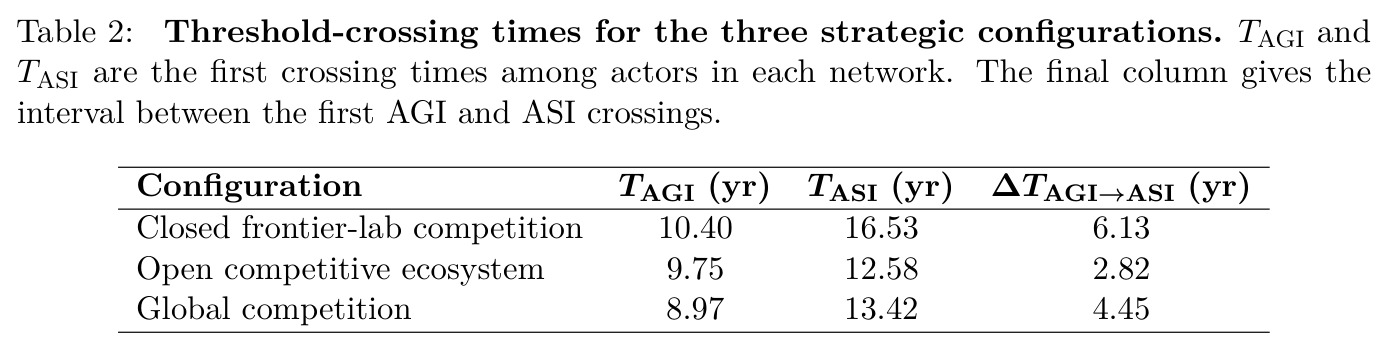
核心发现按三组数值展开。参考情景($\beta=2$,$k=10$,$\tau=0.5$ 年,$r_{\mathrm{ref}}=1/24\ \mathrm{yr}^{-1}$):无 RSI 基线 24 年过 AGI($x=0.50$)、96 年过 ASI($x=0.80$),间隔 72 年。亚临界平滑扩展($a=0.5$,$R_{\mathrm{AI}}$ 始终小于 1)仍把 AGI 提前到 21.35 年、ASI 到 74.13 年,间隔缩至 52.79 年——亚临界反馈也能实质加速。弱超临界($a=3$)AGI 提前到 12.90 年、间隔 11.83 年;瞬态起飞($a=6$)8.40 年过 AGI、间隔 2.69 年;快速转变($a=15$)4.50 年过 AGI、4.95 年过 ASI,间隔仅 0.45 年、压缩约 160 倍,随后 $\sigma$ 发散使 $R_{\mathrm{AI}}$ 回落,自我放大自我终结。战略情景(Table 2):封闭实验室($\rho(K)=1.01$,$m_r=1.0$,$\tau=0.30$ 年)AGI 在 10.40 年、间隔 6.13 年;开放生态(各 $K_{ii}\le 0.90$ 但 $\rho(K)=1.55$,$m_r=0.8$)间隔最短 2.82 年;全球竞争($\rho(K)=1.15$,$m_r=1.2$,$\tau=1.0$ 年)AGI 最早 8.97 年但间隔 4.45 年——集体超临界与加大投入是不同机制。硬件情景($Q=100$,$g_{\mathrm{phys}}=0.25\ \mathrm{yr}^{-1}$):$F=8$ 不受限;$F=2$ 约束在 AGI 与 ASI 之间生效并拉长转变;$F=0.75$ 约束在 AGI 前生效,两个阈值都被推迟。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AGI 到达时间(参考情景数值模拟) | $T_{\mathrm{AGI}}$(年,自 2026 年起) | $a=15$ 时 4.50 年 | 无 RSI 基线 24.00 年 | 提前约 19.5 年(约 81%) |
| AGI→ASI 转变时长(参考情景) | $\Delta T_{\mathrm{AGI}\to\mathrm{ASI}}$(年) | $a=15$ 时 0.45 年 | 无 RSI 基线 72.00 年 | 压缩约 160 倍 |
| 亚临界反馈的累积效应($a=0.5$,$R_{\mathrm{AI}}<1$) | $T_{\mathrm{AGI}}$(年) | 21.35 年 | 24.00 年 | 提前 2.65 年,证明亚临界不等于无影响 |
| 多主体网络临界性(战略情景) | $\Delta T_{\mathrm{AGI}\to\mathrm{ASI}}$(年) | 开放生态($\rho(K)=1.55$,$m_r=0.8$)2.82 年 | 封闭实验室($\rho(K)=1.01$,$m_r=1.0$)6.13 年 | 跨主体传播使转变缩短约 54%,尽管投入更低 |
局限与改进
作者明确承认:所有数值情景是条件性演示而非概率预测。$r_{\mathrm{ref}}$ 虽锚定专家调查(2050 年 AGI 对应 24 年基线),$\tau=0.5$ 年只是“可信”假设,而关键参数 $a$、$\beta$、$k$ 目前没有任何直接经验约束,只选来覆盖不同动力学机制,因此所有具体年份都不能当预测读。我补充几点:单标量能力坐标 $x$ 抹平了任务异质性,资源成本比定义从未用真实任务面板实例化;$\chi(x)$ 取 logistic 只是形状假设,评估算力、实验产能等管线瓶颈对规模的依赖被压缩进参数 $k$;估计 $R_{\mathrm{AI}}$ 需要因果识别“AI 研究能力→下一代研发生产力”,远比看基准分数难,论文只说了该测什么、没说怎么测;网络情景的三种 $K$ 矩阵与 $m_r$、$\tau$ 是手工示意,不对应真实实验室生态;前沿 $X$ 固定使模型无法内生处理范式革命,只能靠手动跳变 $X\to X+\Delta X$;模型还是确定性的,未纳入随机扰动,而近临界区恰恰对噪声最敏感。
独立分析的弱点
第一个弱点是判据的经验可操作性停留在清单层面:论文说应测量递归增益、闭合度、周期时长、前沿硬化率和跨主体转移,却没有设计哪怕一个可执行的最小估计方案,例如用历代模型在固定任务面板上的资源成本回归来估计 $\sigma$,或用版本间工具链贡献的消融实验估计 $a$。改进方向是把 $R_{\mathrm{AI}}$ 估计做成 MLE-bench 式的标准评测协议。第二个弱点是确定性框架:近临界点主根 $\lambda^*\to 0$,系统对噪声和参数漂移最敏感,而随机版本完全缺失;统计物理中的临界慢化现象反而可能提供早期预警信号,值得补上。第三个弱点是单一固定前沿:真实研发中 $X$ 随范式演化内生变化,建议把 $X(t)$ 建成依赖突破到达率的随机跳变过程,而不是在情景间手动移动。第四个弱点是网络静态性:$K$ 矩阵在情景内固定,但竞争本身会内生改变开放程度(如闭源权重政策、出口管制),动态网络与博弈论扩展是自然的下一步。第五个弱点是能力坐标对价格向量 $p$ 的敏感性:跨期比较需要固定价格并处理质量调整,论文没有讨论这个测量经济学问题。
未来方向
作者提出的方向集中在测量议程:估计 AI 研究能力对后续研发生产力的因果效应、增益传播进后继系统的比例 $\chi$、开发周期时长、资源调整后的研究生产力、前沿硬化率以及改进跨组织的转移率,并把这组量作为区分“递归放大”与“其他来源快速进步”的观测指标。在本文成果之上还可延伸:其一,用任务面板加成本数据做 $\sigma$ 的面板估计,把 $R_{\mathrm{AI}}$ 从概念变成可定期更新的指数;其二,构建随机与时变参数版本,研究近临界区的临界慢化能否作为可观测预警;其三,把范式突破建模为强度递减的泊松跳变,内生产生论文暗示的“多段分离的递归区间”;其四,把繁殖矩阵 $K$ 与组织行为联系起来——开源权重、API 接入、人才流动各对应不同的 $K_{ij}$,可做比较静态分析;其五,与算力治理结合:论文证明 $C_{\mathrm{phys}}$ 不改变 $R_{\mathrm{AI}}$,哪些政策能真正改变 $\chi$ 与 $a$ 值得系统分析。
复现评估
复现条件极好。作者在论文脚注给出代码与计算笔记本仓库(github.com/burtsev/recursive-criticality-ai),声称可复现全部数值结果与图表。模型是低维确定性时滞微分方程,不需要 GPU 或大数据,普通笔记本几秒钟即可完成积分;唯一“数据”是少数情景参数($r_{\mathrm{ref}}$、$\tau$、$\beta$、$k$、$a$、网络矩阵 $K$、物理余量 $F$),全部在正文给出,因此复现图表本身难度接近零。真正困难的是另一回事:这些参数没有经验标定,任何人无法用现实数据验证哪个情景更接近现实——复现容易,检验难。对想在此基础上工作的研究者,建议从官方仓库出发对 $a$、$\beta$、$k$ 做系统敏感性分析,并尝试用公开评测历史(如跨代模型在固定面板上的成本变化)做出第一个 $\sigma$ 的粗略经验估计。
论文图表