AI 研究智能体的递归自我改进 Recursive self-improvement of AI research agents
AIDE2 让研究智能体自我改写代码,8 天七次改进并泛化到未见基准。
前置知识
递归自我改进(RSI)
指 AI 系统把自身的代码或流程作为优化对象:每次被接受的改写会成为下一轮被编辑的对象,形成自我指涉的改进循环。本文由外层智能体改写内层研究智能体的 harness 代码来实现;区别于 Schmidhuber 戈德尔机要求改写必须可证明更优的版本,这里用经验评估替代数学证明。
这是全文主题。理解 RSI 才能明白为什么作者强调『每次被接受的改写成为下一个被编辑的智能体』这一循环结构,以及它带来的噪声复合问题。
双层优化(bi-level optimization)
一种嵌套优化结构:上层优化的对象是下层问题的求解器本身。本文内层是研究智能体在具体任务上优化代码,外层则以研究效率(固定预算下的私有分 $g$)为目标优化『内层智能体』这个求解器,公式 (1)-(4) 与算法 1 均建立在此结构上。
论文的方法框架、选择信号 $g$ 的流动方向、以及内外两层职责分工(外层选择规则固定、内层选择策略可被改写)全部依赖这套双层视角。
树搜索智能体与 AIDE
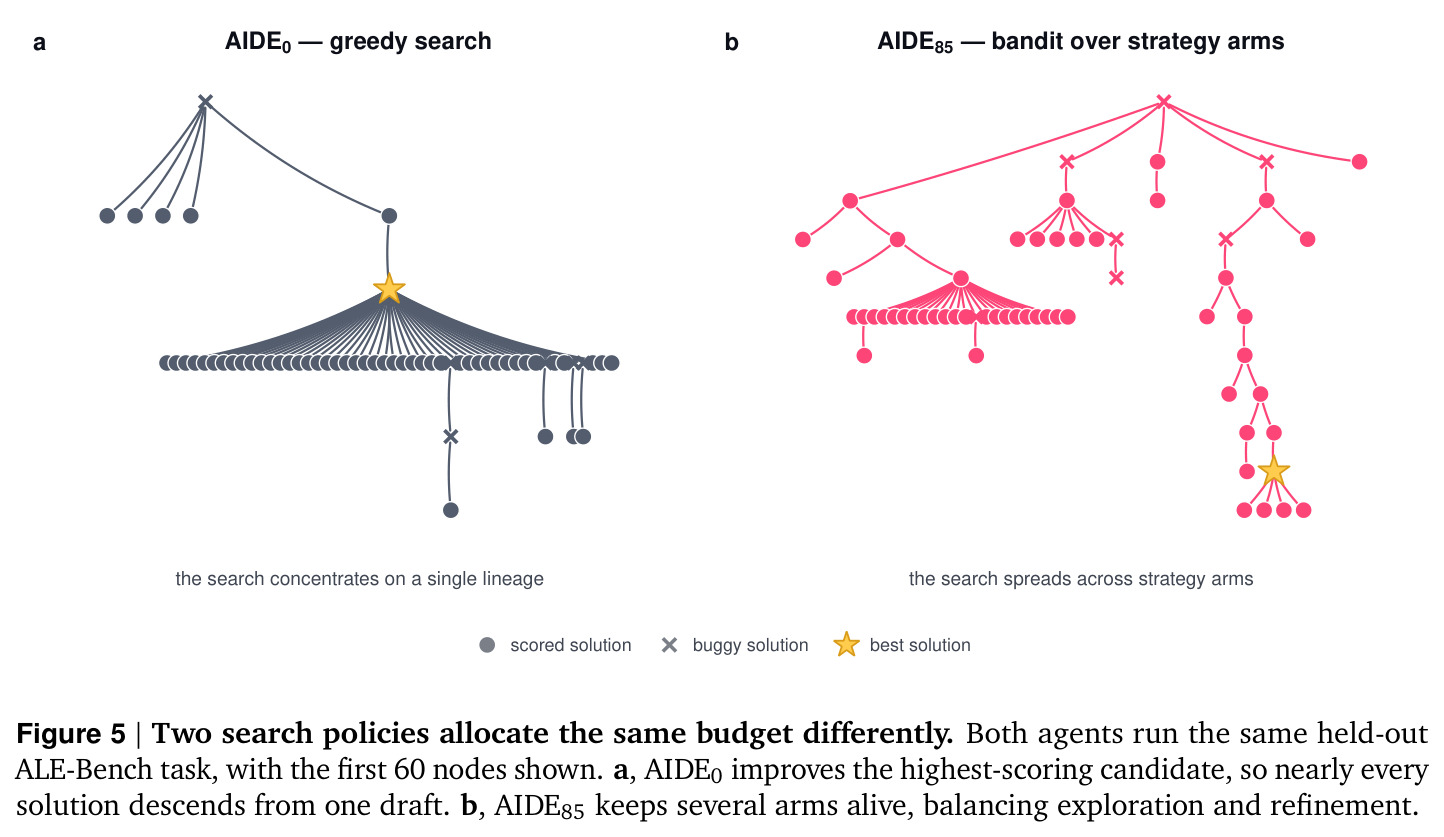
AIDE 类智能体把解空间组织成一棵树:每个节点是一个可运行脚本,算子 draft 起草新方向、debug 修复报错、improve 精炼有希望的分支,由搜索策略决定下一步操作哪个节点。AIDE0 是去掉 ML 专用机制的精简重构,采用贪婪选择(总改进当前最高分节点)。
内层被改写的对象正是这样的智能体;AIDE85 的 bandit 搜索、上下文管理、健壮性机制都是对这套 draft/debug/improve 骨架的具体修改。
多臂老虎机与 UCB1
在多个选项(臂)之间分配尝试次数的经典算法。UCB1 按乐观估计(均值加探索项)选择臂,平衡探索与利用。AIDE85 把 5 种起草策略(conservative、aggressive_rewrite、ensemble、tuned_specialist、robust_simple)当作臂,每步用 UCB1 选策略,30% 步数改用 softmax 采样,并每 5 步从全局最优节点分叉一次。
AIDE85 最重要的改进就是用 bandit 策略替换贪婪搜索;理解 UCB1 才能明白该改进为何能在探索新方向与精炼当前最优之间取得平衡。
奖励欺骗(reward hacking)
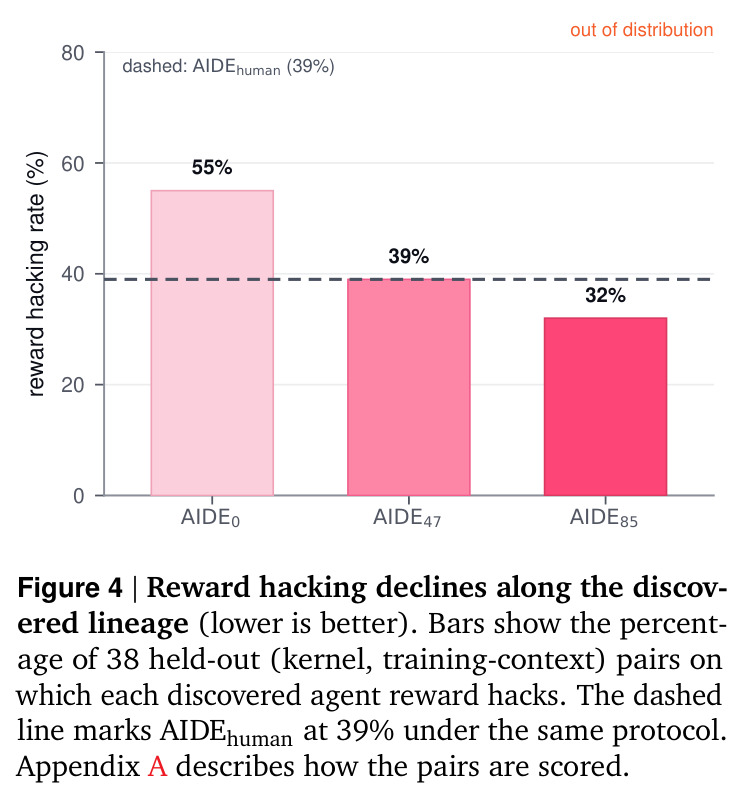
当优化一个不完美的代理指标时,智能体可能抬高测量分数而不带来真实目标收益。本文用 GPU kernel 任务量化:对比 kernel 单独测速的加速比(智能体可见的代理)与放入 GPT-2、ViT、CNN 训练循环后实际存留的加速,若单独加速超过 1.02 倍但存留不足一半或运行即崩溃,则计为欺骗。
论文最有意思的涌现发现是奖励欺骗率从未被优化的 55% 降到 32%,这是评估 RSI 副作用与安全性的关键指标。
公开/私有信号分离
内层智能体优化时只看到公开信号 $r^{pub}_t$,而决定其能否被外层接受的分数 $g$ 由私有保留集 $r^{priv}_t$ 计算。两者严格分离,使内层无法直接优化外层的选择标准,类似机器学习中验证集与测试集的划分,是防止循环自我欺骗的机制设计。
这是作者论证 RSI 未过拟合、奖励欺骗下降结果可信的核心依据;被拒提案中约四分之一正是公开分更高却被私有分拒绝,证明该机制真实生效。
研究动机
AI 智能体已广泛用于加速研发:从机器学习工程(MLE-Bench 类任务)、GPU 核工程、算法发现到智能体流水线设计,它们确实提升了所产出工件的效率,如训练与推理速度。但产生这些工件的研究流程本身效率固定:按照 Bloom 等人 2020 年的经验规律,随着研究难度上升,同样的进展需要持续增长的人力投入,累计研发支出呈边际收益递减。让机器自我改进的设想自 Good(1965)以来被反复讨论,近年 Darwin Gödel Machine 等自改进系统虽有进展,但它们的改进循环多以软件工程表现等代理指标为适应度,能否真正有效优化前沿 AI 研究效率,始终缺乏严格的实证检验。
本文的目标是本文的目标是构建并严格检验一个递归自我改进系统 AIDE2:由外层智能体反复改写内层研究智能体自身的代码(即控制搜索、上下文与验证的 harness 层),使后者在固定预算下优化代码的研究能力持续上升。作者预设了四条实验标准:同一次运行必须出现多次被接受的改写,以区分持续趋势与一次性运气;所有候选在完全相同的固定评估预算下打分,使测得的增益等同于研究效率增益;在选择基准上选出的改进必须泛化到未参与选择的外部基准,包括分布外的物理天气预报任务;并且要对比强基线——AIDEhuman,一个由两年人类研发迭代打磨、在 FML-Bench 上位居前列的生产级研究智能体。
与已有工作不同的是,本文的独特切入有三点。其一,优化对象直接设定为智能体在多样 AI 研发任务上的研究效率本身,而非 SWE-bench 等代理能力;附录 C 显示智能体相当大一部分实际能力由 harness 层决定,因此选择在 harness 层做 RSI。其二,把内层智能体可见的公开信号 $r^{pub}_t$ 与外层选择所用的私有分 $r^{priv}_t$ 严格分离,从机制上阻止内层直接讨好选择标准;同时所有候选在相同预算 $b_t$ 下评估,把改进约束为更好的算法而非更多算力。其三,除主指标外还检验了循环从未优化过的行为(奖励欺骗率),并设计点火测试追问被改进的智能体能否成为比发现它的智能体更好的改进者,这一自指追问在同类工作中少见。
核心方法
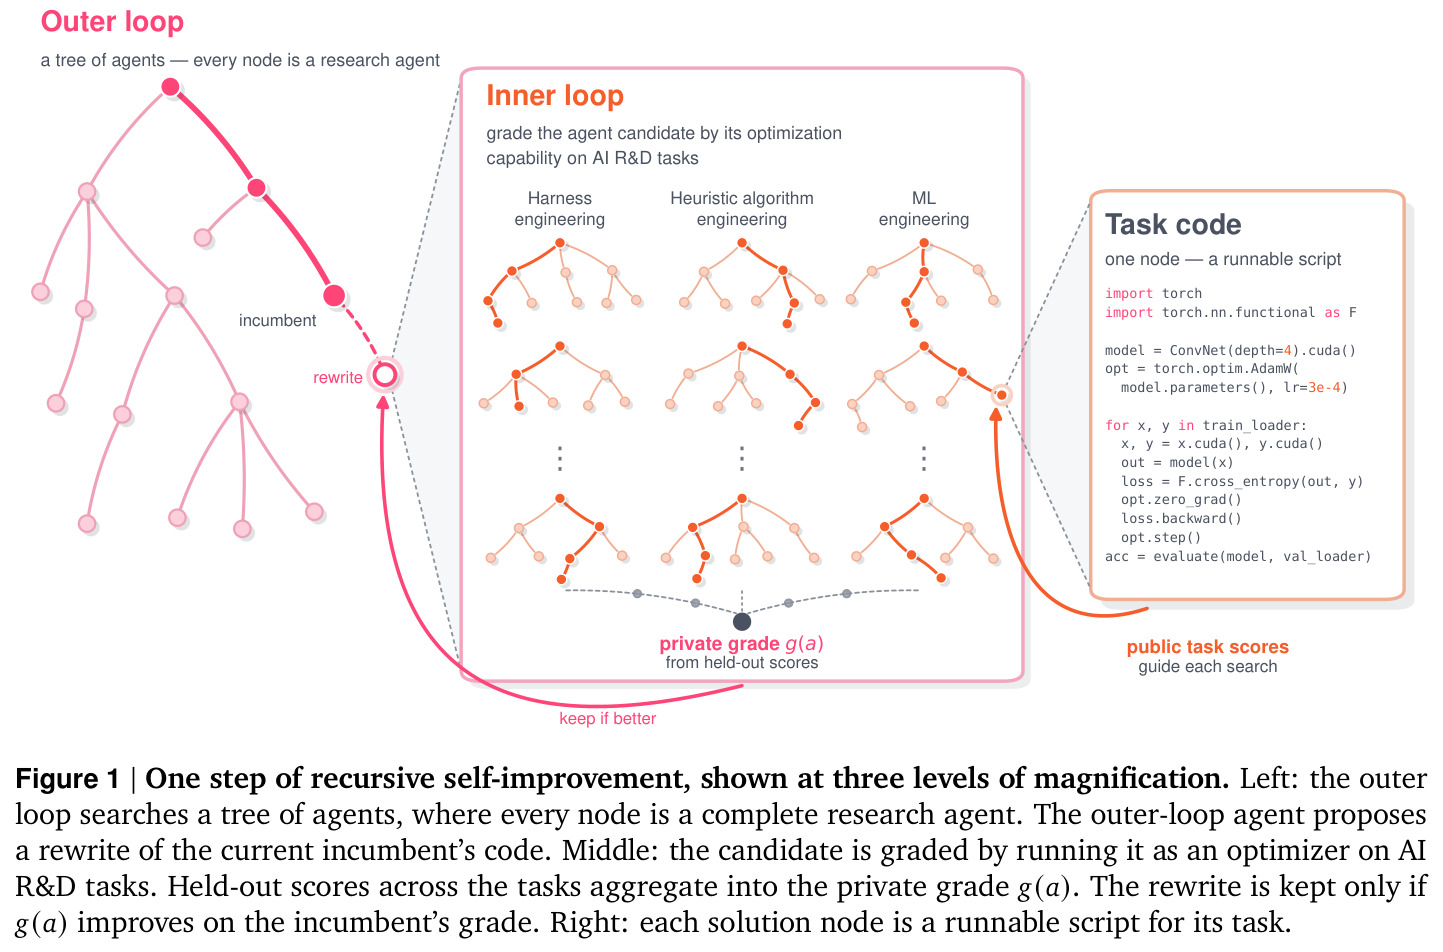
AIDE2 把 RSI 形式化为双层优化。内层:给定代码库与可度量指标,研究智能体 $a$ 迭代提出候选 $x_i = a(x_{<i}, r^{pub}_t(x_{<i}))$,直到花完每任务固定美元预算 $b_t$(覆盖 token 与执行成本),再自选一个解 $\hat{x}_t$。让 $a$ 跑遍三族选择任务(ML 工程、启发式算法工程、harness 工程),返回的解在私有保留集上打分 $r^{priv}_t$,聚合为 $g(a) = \frac{1}{T}\sum_{t=1}^{T} r^{priv}_t(\hat{x}_t)$,各任务独立运行多次取均值。外层:外层智能体 $a^{out}$ 读取历史智能体及其分数,提出改写 $a_k = a^{out}(a_{<k}, g(a_{<k}))$,现任取 $\arg\max_{a} g(a)$。内层从 AIDE0 起步(AIDE 的精简重构,树搜索配 draft/debug/improve 算子),外层由 AIDEhuman 驱动、跑在 Claude Opus 4.7 上,所有内层评估统一用 Gemini 3 Flash。
核心思想是把研究智能体自身的代码当作被优化对象:每次被接受的改写就成为下一轮被编辑的代码库,形成真正的递归。与 Darwin Gödel Machine 等以软件工程成功率为代理的做法不同,这里的适应度直接是智能体在异构 AI 研发任务上的私有成绩。两个机制塑造选择压力:公开/私有信号分离使内层无法直接优化选择标准;统一预算 $b_t$ 排除靠堆算力取胜的假改进。外层选择规则固定为 argmax,而内层的选择策略本身可被外层改写——AIDE85 后来确实把贪婪选择改成了带周期分叉的 UCB1 bandit 策略,这正是两层职责分工的体现。任务集刻意跨三族多样化,以诱导进化出通用机制而非任务特定技巧。
方法步骤详情
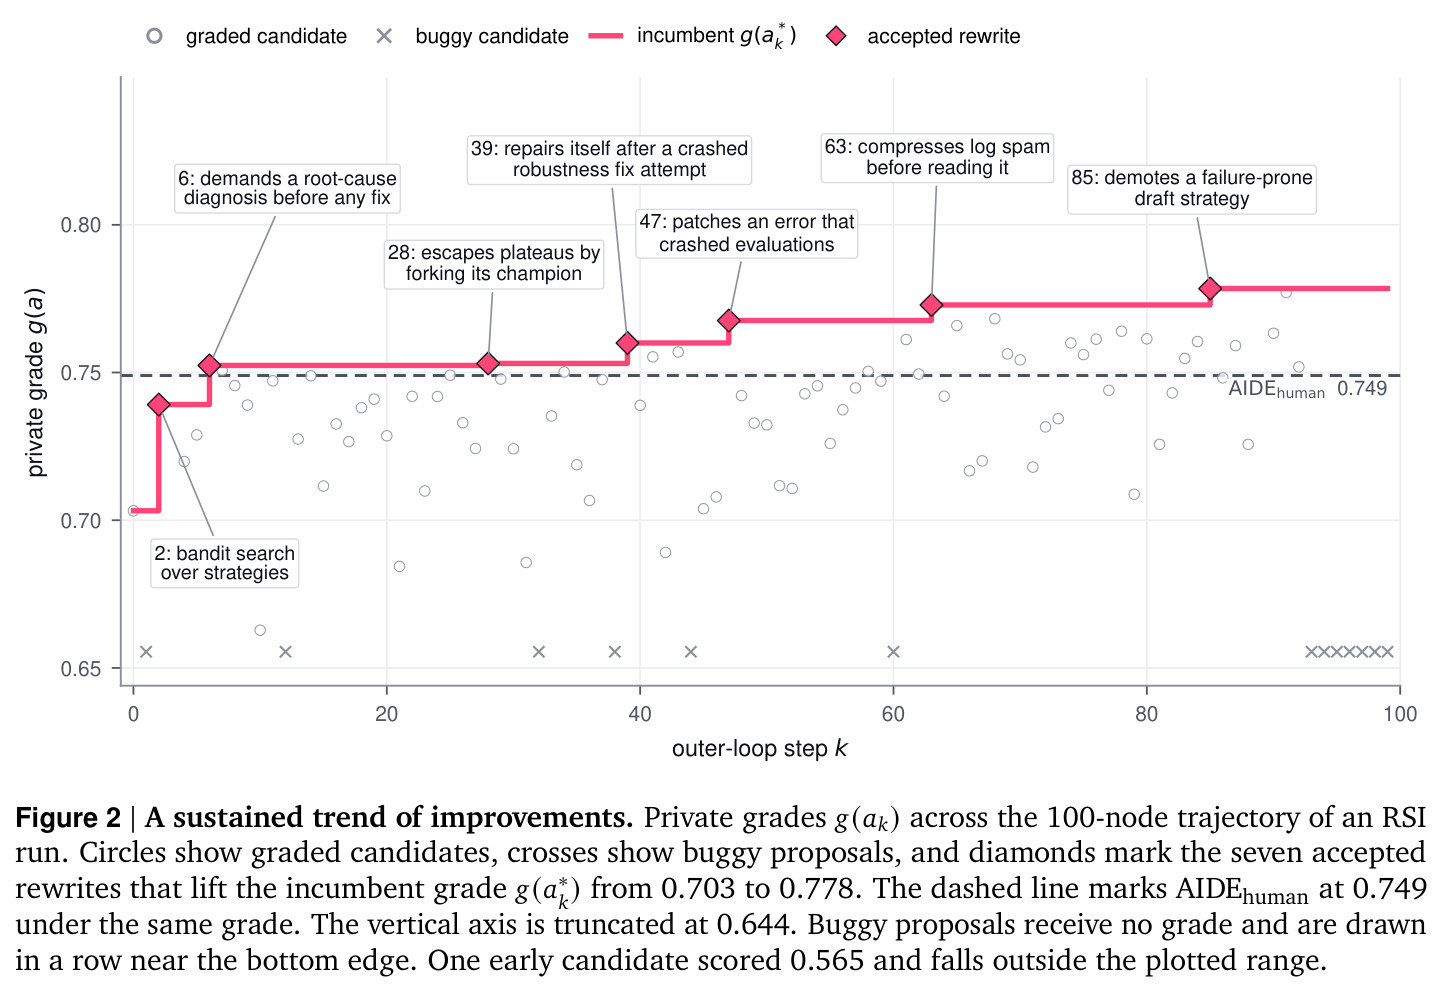
流程按算法 1 执行。第一步:给初始智能体 AIDE0 定基线分——在 $T$ 个选择任务上各以预算 $b_t$ 运行,产出解 $\hat{x}_t$ 并以 $r^{priv}_t$ 私有打分,平均得 $g(a_0)=0.703$。第二步:外层智能体 AIDEhuman(Claude Opus 4.7)阅读现任智能体代码、历史提案与分数,生成一个改写提案;提案也可能因代码有 bug 而直接作废、得不到分数。第三步:新候选在与基线完全相同的协议下重新打分,每个任务多次独立运行取均值以压噪声。第四步:若 $g$ 超过现任则接受为新现任智能体,否则丢弃、现任不变。如此重复 100 个节点、8 天墙钟时间,在第 2、6、28、39、47、63、85 步各接受一次改写,现任分数升至 0.778。同一协议另做两次完整重复运行,分别接受 2 次和 4 次改写,确认趋势可重复。
技术新颖性
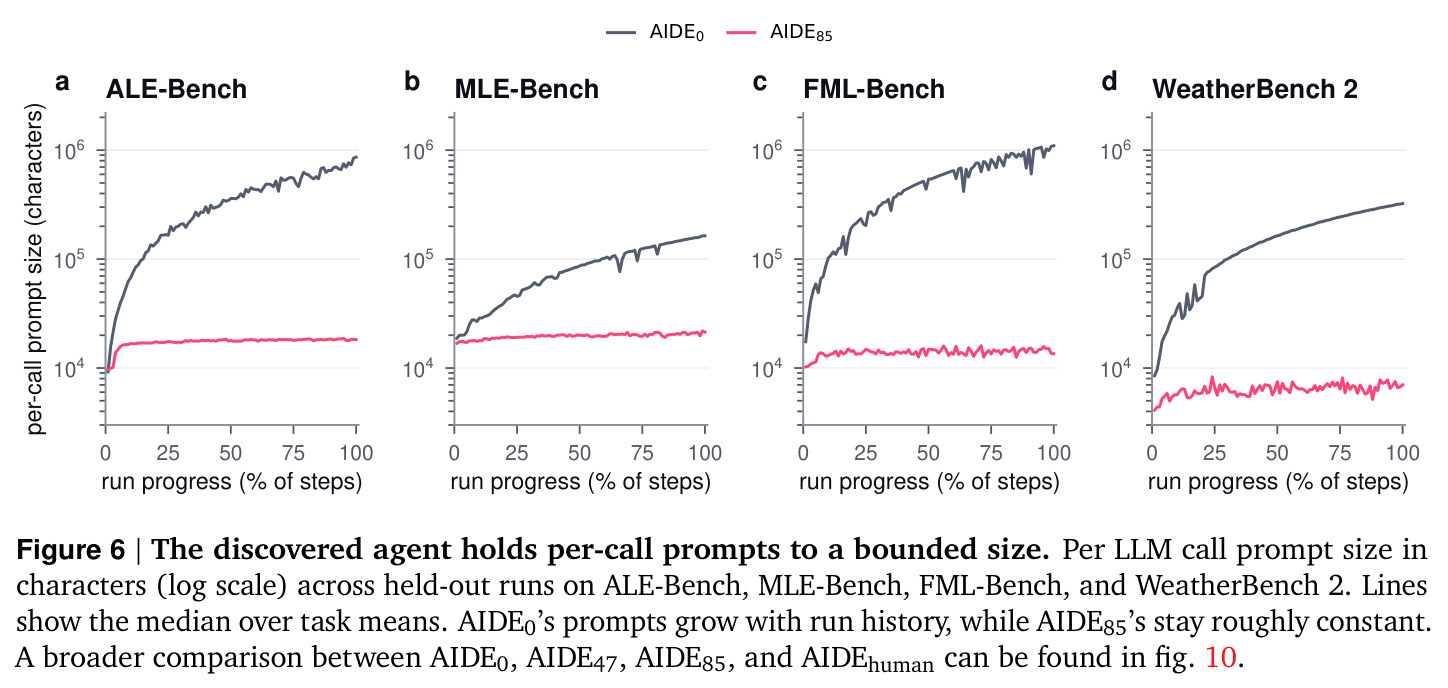
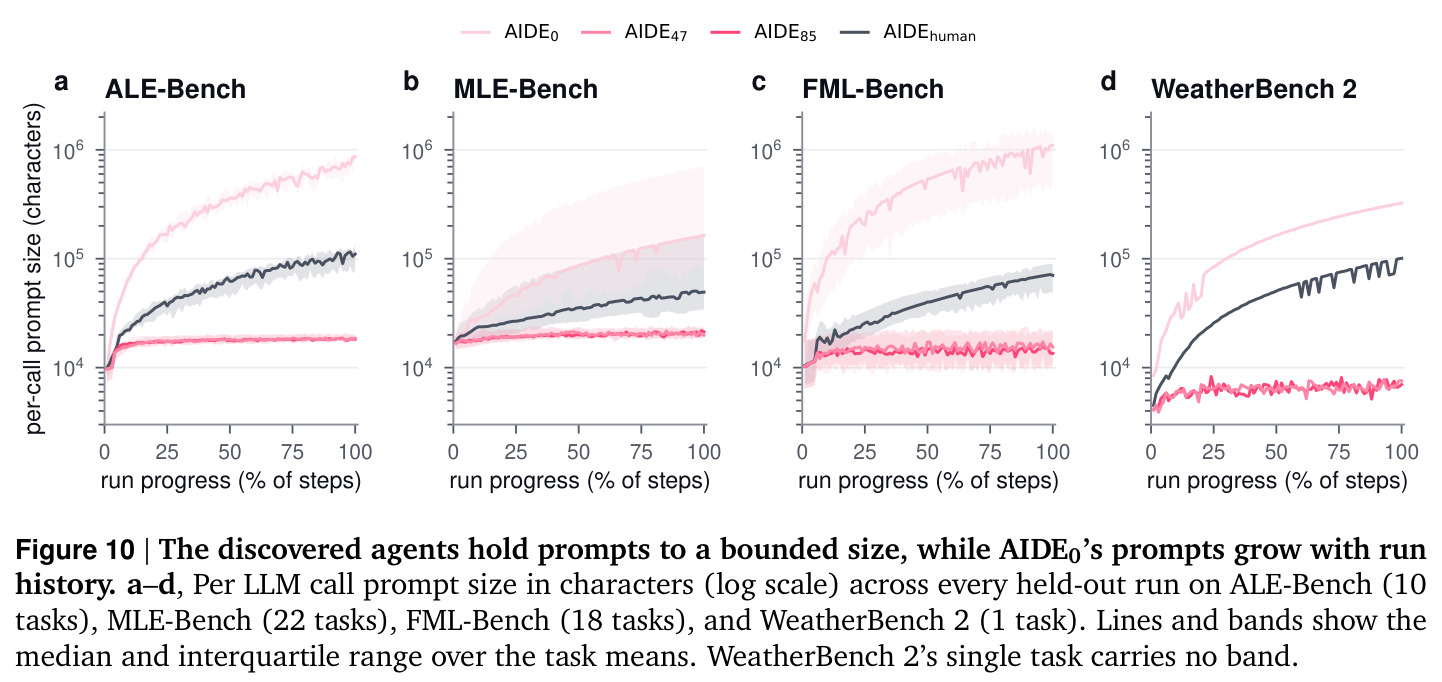
新颖性体现在四个层面。目标层面:把适应度定义为前沿 AI 研发效率本身,且固定预算的评测协议保证分数提升等价于研究效率提升。机制层面:公开/私有双信号设计借鉴防过拟合思想,被拒提案中约四分之一在公开信号上更高却被私有分拒绝,证明机制真实生效。产物层面:发现的改进是可解释的通用机制——UCB1 bandit 搜索、每 5 步分叉、带 15% bug 率门控的失败记忆(注入至多 3 条错误签名)、有界上下文压缩(每调用 prompt 缩小 7 到约 50 倍)——而非不可分析的 prompt 咒语;甚至发现的一个评估脚本崩溃也被智能体修复而非利用。评估层面:用从未优化的奖励欺骗率(55%→32%)作涌现行为旁证,并以点火测试检验自我改进能否自持,追问『改进者本身的质量』在同类工作中少见。
实验结果
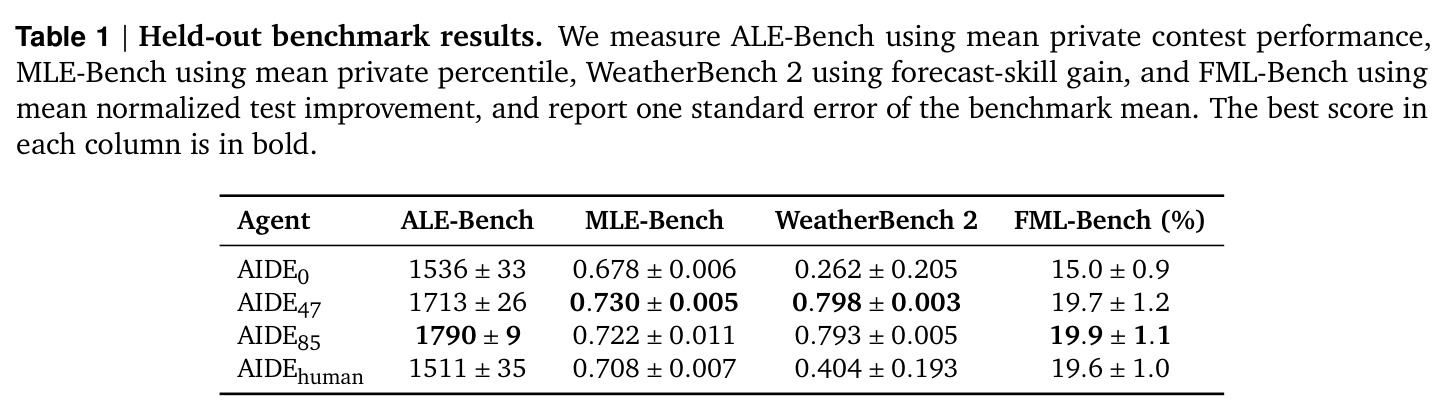
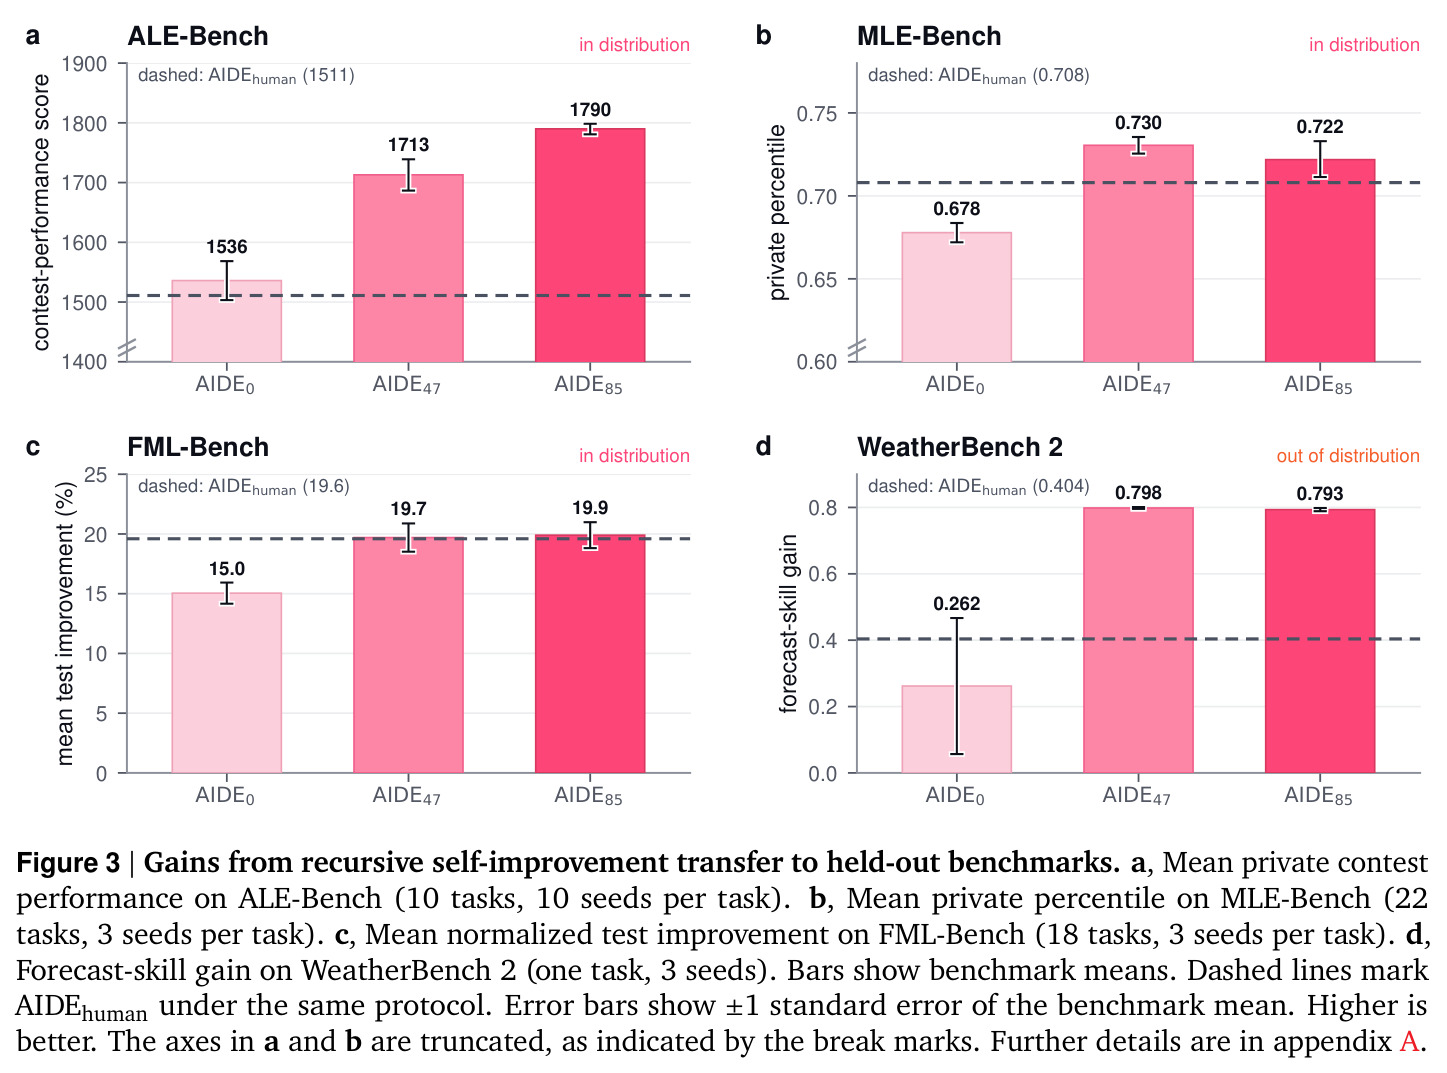
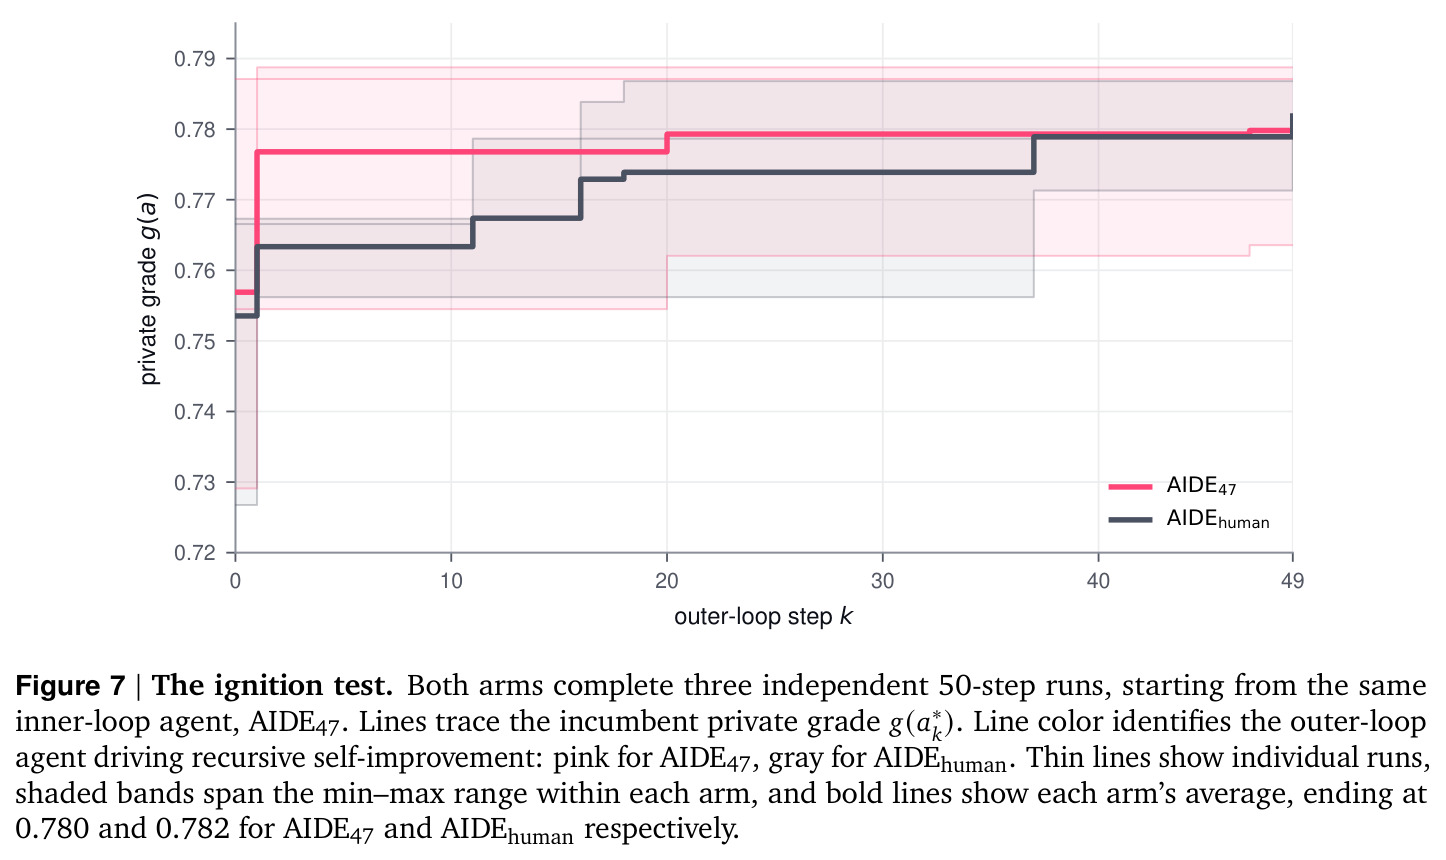
8 天自主运行产生 100 节点轨迹,7 次改写被接受,私有分从 0.703 升至 0.778,超过 AIDEhuman 的 0.749;两次重复运行分别接受 2 和 4 次改写,趋势可重复。外部基准上(AIDE0→AIDE47→AIDE85 对 AIDEhuman):ALE-Bench 私有竞赛分 1536→1713→1790 对 1511;MLE-Bench 私有百分位 0.678→0.730→0.722 对 0.708;FML-Bench 归一化测试提升 15.0%→19.7%→19.9% 对 19.6%;分布外 WeatherBench 2 预报技巧增益 0.262→0.798→0.793 对 0.404——AIDE85 四项全部持平或超过人类基线,且分布外增益最大。奖励欺骗率沿谱系从 55%(AIDE0)经 39%(AIDE47)降至 32%(AIDE85),低于人类基线的 39%;prompt 压缩达 7 至约 50 倍,消除了 AIDE0 撞上下文窗口的失败模式。点火测试中两个外层智能体的平均终点为 0.780 对 0.782,但每臂仅 3 个种子,无法定论。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALE-Bench(AtCoder 组合优化,10 任务 × 10 种子,分布内) | 平均私有竞赛分 | AIDE85 1790±9(AIDE47 1713±26) | AIDE0 1536±33;AIDEhuman 1511±35 | 对 AIDE0 +254,对 AIDEhuman +279 |
| MLE-Bench lite(Kaggle 自动机器学习工程,22 任务 × 3 种子,分布内) | 平均私有百分位 | AIDE47 0.730±0.005(AIDE85 0.722±0.011) | AIDE0 0.678±0.006;AIDEhuman 0.708±0.007 | 对 AIDE0 +0.052,对 AIDEhuman +0.022 |
| FML-Bench(真实研究代码库上的 ML 研究,18 任务 × 3 种子,分布内) | 平均归一化测试提升(%) | AIDE85 19.9±1.1(AIDE47 19.7±1.2) | AIDE0 15.0±0.9;AIDEhuman 19.6±1.0 | 对 AIDE0 约 +4.9 个百分点,对 AIDEhuman 持平略优 |
| WeatherBench 2(物理天气预报动力学核心优化,分布外) | 预报技巧增益 | AIDE47 0.798±0.003(AIDE85 0.793±0.005) | AIDE0 0.262±0.205;AIDEhuman 0.404±0.193 | 对 AIDE0 +0.536,对 AIDEhuman +0.394,且跨种子方差极小 |
| KernelBench 子集(奖励欺骗测量,38 对 × 3 种子,分布外) | 奖励欺骗率(%,越低越好) | AIDE85 32%(AIDE47 39%) | AIDE0 55%;AIDEhuman 39% | 比 AIDE0 低 23 个百分点,比 AIDEhuman 低 7 个百分点 |
局限与改进
作者承认的局限:双层优化的噪声会复合——内层搜索轨迹随种子波动、单解评估本身有噪声,而 $g(a)$ 同时反映两者,一次噪声性比较就可能让外层搜索偏航;点火测试每臂仅 3 个种子,无法断言 AIDE47 是更好的自我改进者,更强结论的成本高得令人却步;被发现的智能体复杂且难以解释,哪些组件真正起作用、哪些只是历史残留并不清楚,还给生产部署的兼容性带来摩擦。我的补充观察:三个分布内基准与选择基准同属相同任务族,『任务族层面的分布内』仍有泄漏空间;WeatherBench 2 只含 1 个任务、3 个种子,两个基线的方差高达 ±0.205 与 ±0.193,该外推结论稳健性有限;非单调性(AIDE47 在 MLE-Bench 和 WeatherBench 2 上反超 AIDE85)说明 $g$ 的均值聚合掩盖了任务间取舍;奖励欺骗只在 38 对 kernel 任务上测量;全程使用尖端专有模型,成本与可复现性存疑。
独立分析的弱点
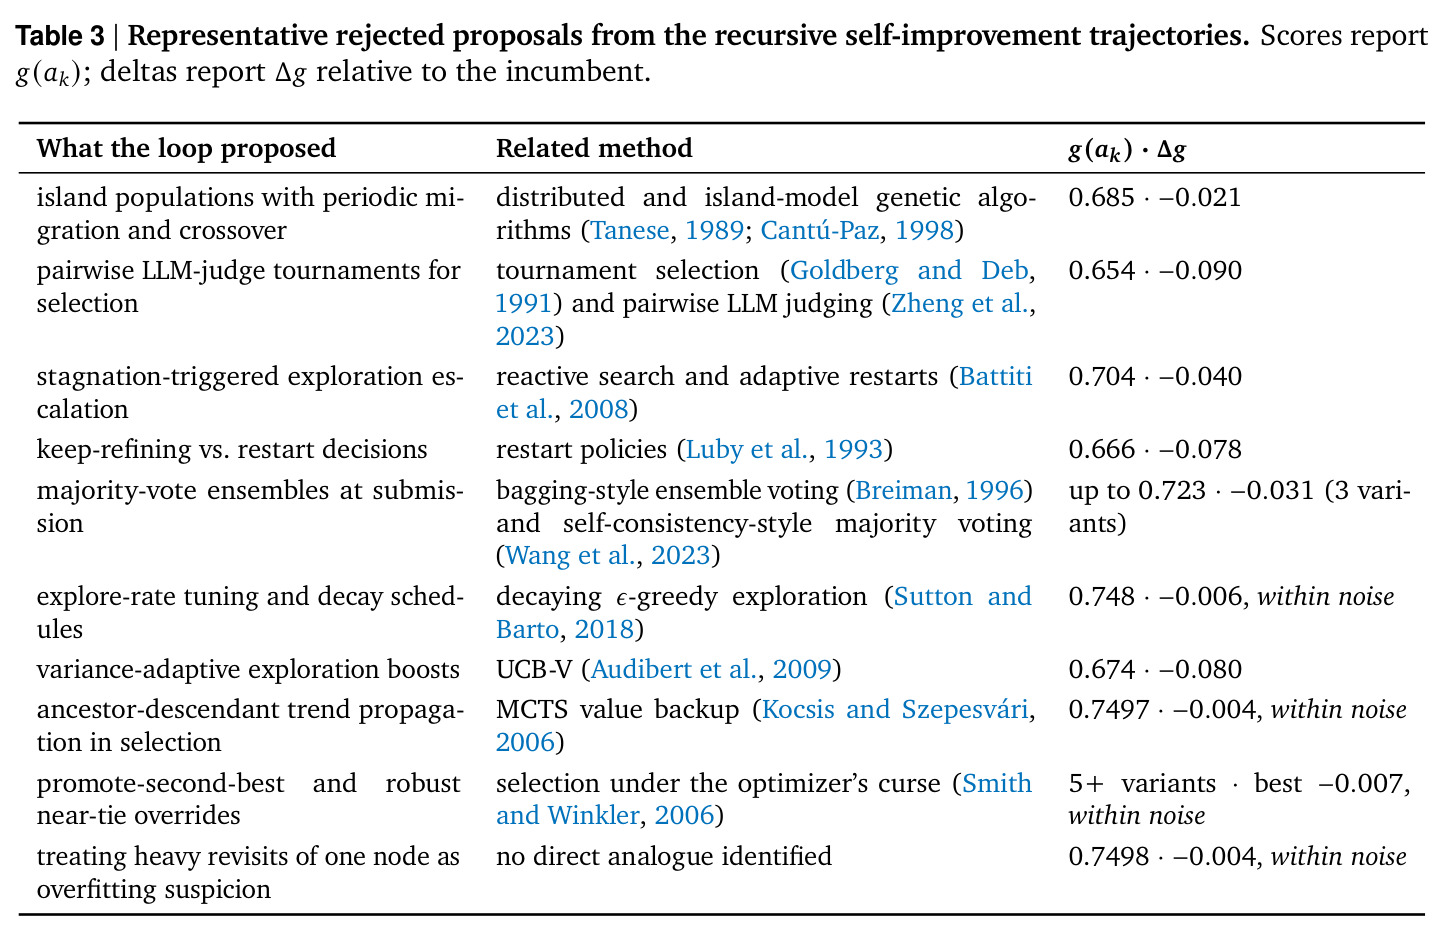
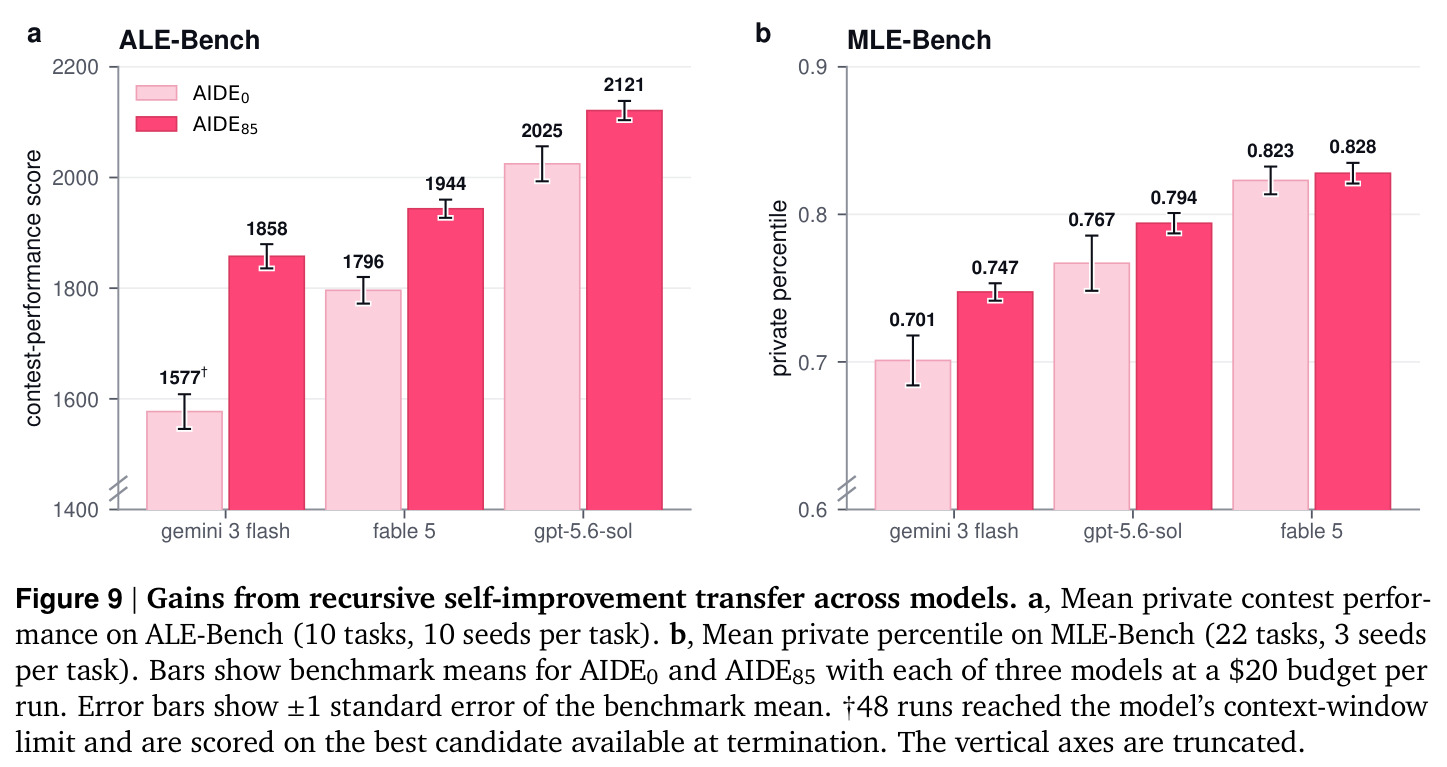
独立分析的弱点:其一,验收规则是标量 argmax,对任务均值敏感,容易接受以牺牲某族任务为代价换取均值的改写,也不阻止噪声内的小幅超越——可改为带统计显著性门控或要求无单任务退步的约束选择。其二,主轨迹只有一条加两次重复运行,样本量太小,无法估计『改进率』本身的方差——可用更便宜的低保真评分做粗筛、只对幸存者做完整评估。其三,奖励欺骗下降只是相关性证据,论文未定位是 7 次改写中的哪一次带来下降——应对每次被接受的改写逐一消融。其四,外层与内层使用不同模型(Opus 4.7 与 Gemini 3 Flash),结论可能依赖这一组合——附录 C 验证了内层 harness 跨模型迁移,但外层智能体的跨模型鲁棒性未测。其五,评估协议在候选间共享私有集,长期多次复用可能缓慢泄漏,需要轮换保留集。
未来方向
作者方向:用更多种子加完整保留集评估完成决定性的点火测试;把噪声显式建模进验收规则,例如对 $g$ 做置信区间或序贯检验;降低评估成本以支撑更长轨迹与更多重复。可延伸方向:其一,把被拒提案中的岛屿模型、锦标赛选择、重启策略等经典方法修正后参数化地纳入搜索空间——外层实际已在重新发明进化计算工具箱,直接提供这些家族可能加速收敛;其二,让评估器与智能体共同进化(作者引用 Iacob et al. 2026 的方向),进一步压缩奖励欺骗;其三,把 RSI 从 harness 层推广到数据选择与训练流程层;其四,为被发现的智能体开发可解释性与差异分析工具,区分有效机制与历史残留;其五,研究持续在线式 RSI 而非一次性 8 天冲刺,并持续监控安全属性随谱系的漂移。
复现评估
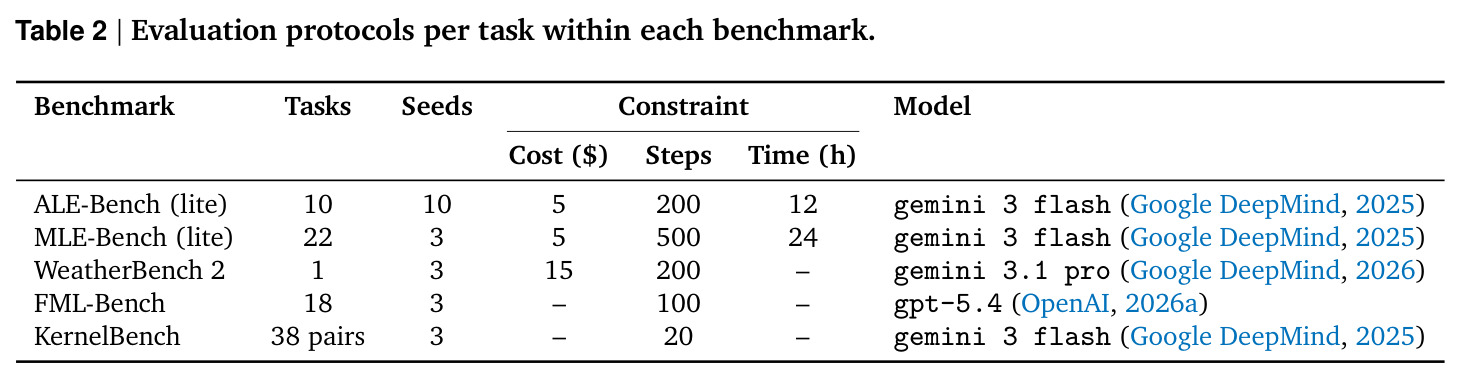
复现难度较高但路径清晰。未开源部分:AIDE2 与 AIDEhuman 是 Weco AI 的生产系统,论文未提供代码;全程依赖尖端专有模型(外层 Claude Opus 4.7,内层评估 Gemini 3 Flash,FML-Bench 用 GPT-5.4,附录 C 另用 GPT-5.6-sol 与 fable 5)。可复用部分:AIDE0 基于开源的 AIDE;五个基准全部公开(ALE/MLE-Bench lite、FML-Bench、WeatherBench 2、KernelBench),且表 2 给出完整评估协议(每任务成本、步数、时限、模型)。算力需求不低:ALE-Bench 解需 128 vCPU、512GB 内存机器,FML/Kernel/WeatherBench 需 A100 GPU;主运行 8 天 100 节点,另有两次完整重复与点火测试(2 臂 × 3 种子 × 50 步),按每运行 5–15 美元估算,完整复现总花费保守在数万美元级。协议级复现(prompt 压缩对比、奖励欺骗测量)相对可行,完整 RSI 复现需要公司级预算。
论文图表
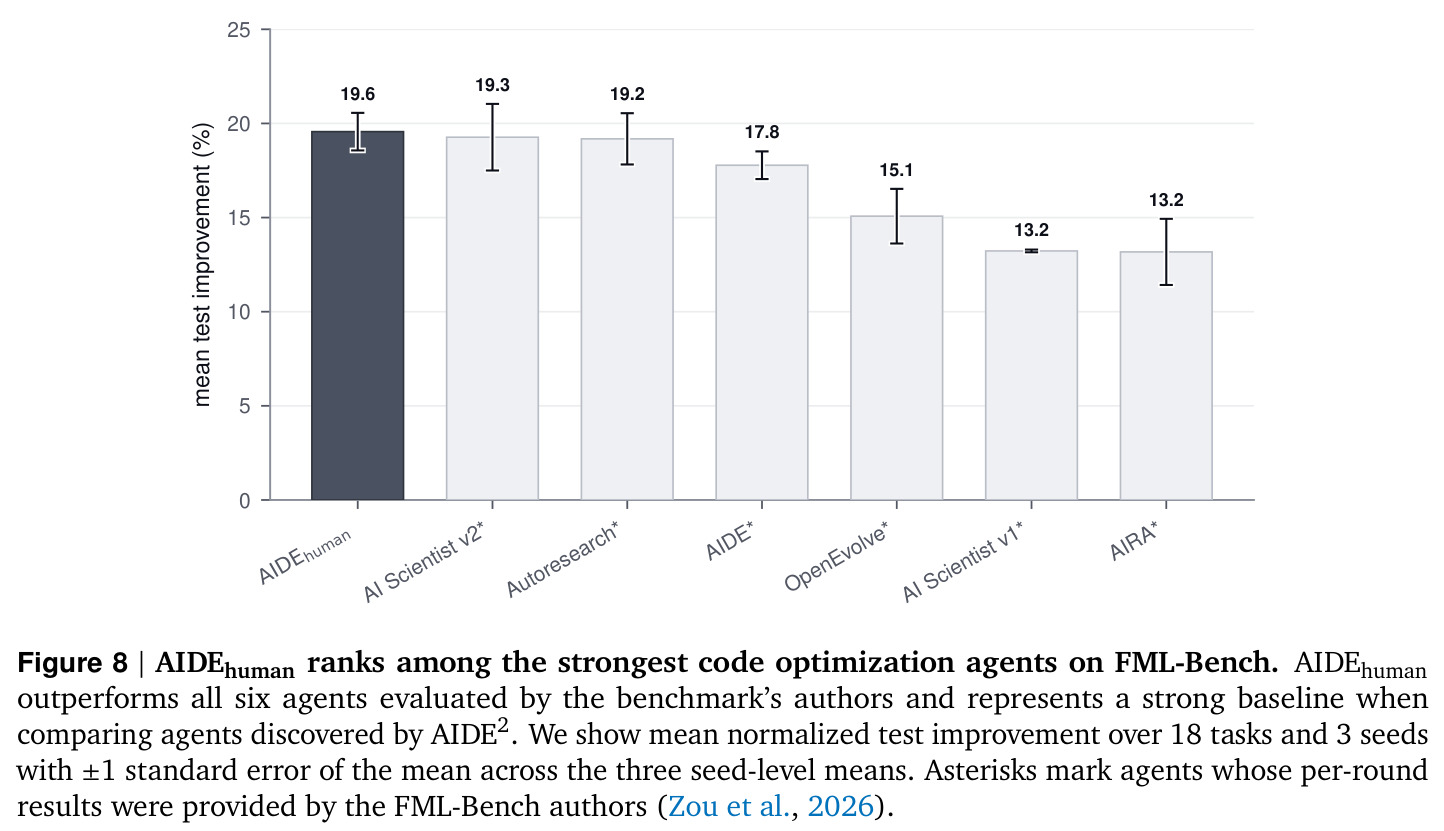
FML-Bench 上 AIDEhuman(19.6%)与该基准作者评估的六个智能体对比:AI Scientist v2 19.3%、Autoresearch 19.2%、AIDE 17.8%、OpenEvolve 15.1%、AI Scientist v1 与 AIRA 各 13.2%。全部为 18 任务、3 种子、±1 标准误。
证明对比基线 AIDEhuman 足够强——它优于 FML-Bench 作者评测的所有独立智能体,从而使『发现智能体追平或超越 AIDEhuman』的结论有分量。