广义智能体迭代:迭代策略改进与递归自我改进的统一形式框架 Generalized Agent Iteration: One Formal Framework for Iterative Policy Improvement and Recursive Self-Improvement
提出GAI框架,用两个旋钮把经典策略迭代与递归自我改进统一为同一循环的两个实例
前置知识
马尔可夫决策过程(MDP)
强化学习的标准形式化:五元组 $(\mathcal{S},\mathcal{A},p,r,\gamma)$,即状态集、动作集、转移核 $p$ 与奖励 $r$。策略 $\pi$ 从状态映射到动作分布,其价值为折扣回报期望 $V^\pi(s)=\mathbb{E}[\sum_{t\ge0}\gamma^t r(\mathcal{S}_t,\mathcal{A}_t)\mid \mathcal{S}_0=s]$,条件在首个动作上则记 $Q^\pi$。本文把外部世界固定为 $W=(\mathcal{S},\mathcal{A},p,r)$,奖励 $r$ 是外部目标 $G$ 的标量实例。
GAI 的全部讨论都在这个世界之上展开,GPI 的收敛保证也以有限 MDP 为前提;理解奖励与转移律的外部性,是理解两个旋钮为何重要的基础。
广义策略迭代(GPI)
Sutton 与 Barto 对绝大多数单智能体强化学习算法共享结构的抽象:评估步把价值估计推向与当前策略一致($V\to V^\pi$,可为 Bellman 回溯、时序差分或蒙特卡洛更新),改进步让策略在当前价值下更优($\pi\to\mathrm{greedy}(V)$,也可为 softmax、截断等形式)。两步可部分执行、可交错;有限 MDP 下该交替收敛到最优策略。
GAI 正是对 GPI 的致敬与推广:GPI 是框架中改进机制在智能体之外、评价基锚定于环境奖励时的那个实例,看懂 GPI 循环才能看出 GAI 加了什么。
递归自我改进(RSI)与哥德尔机
RSI 指系统改进『用来改进自身的那个机制』本身,思想可追溯至 Good 的 ultraintelligent machine 与 Yudkowsky 的 seed AI。其形式化原型是 Schmidhuber 的哥德尔机:一个自指程序,只有当它能证明某次对自身的重写会提高一个固定的外部效用时才执行该重写。因证明搜索不可行,实践后继者(Gödel Agent、Darwin Gödel Machine、STOP、SICA、Polaris 等)用外部基准上的经验验证替代证明。
本文的核心工作就是把 RSI 形式化为 GAI 的另一个实例,并逐条指出它在哪些地方违反了 GPI 的成立条件。
评价基与锚定
评价基 $\rho$ 是评价器打分所依据的标准:策略层的 $\rho_V$(如环境奖励)与修改层的 $\rho_U$(如外部基准)。『锚定』指基的内容来自系统外部(世界与目标)且 $\rho\notin Ag$,即智能体无法重写自己被衡量的标准。作者特别澄清:学习出来的评审器或奖励模型只要放在智能体外部就是锚定的,同一评审器一旦成为智能体组件就落入目标漂移档。
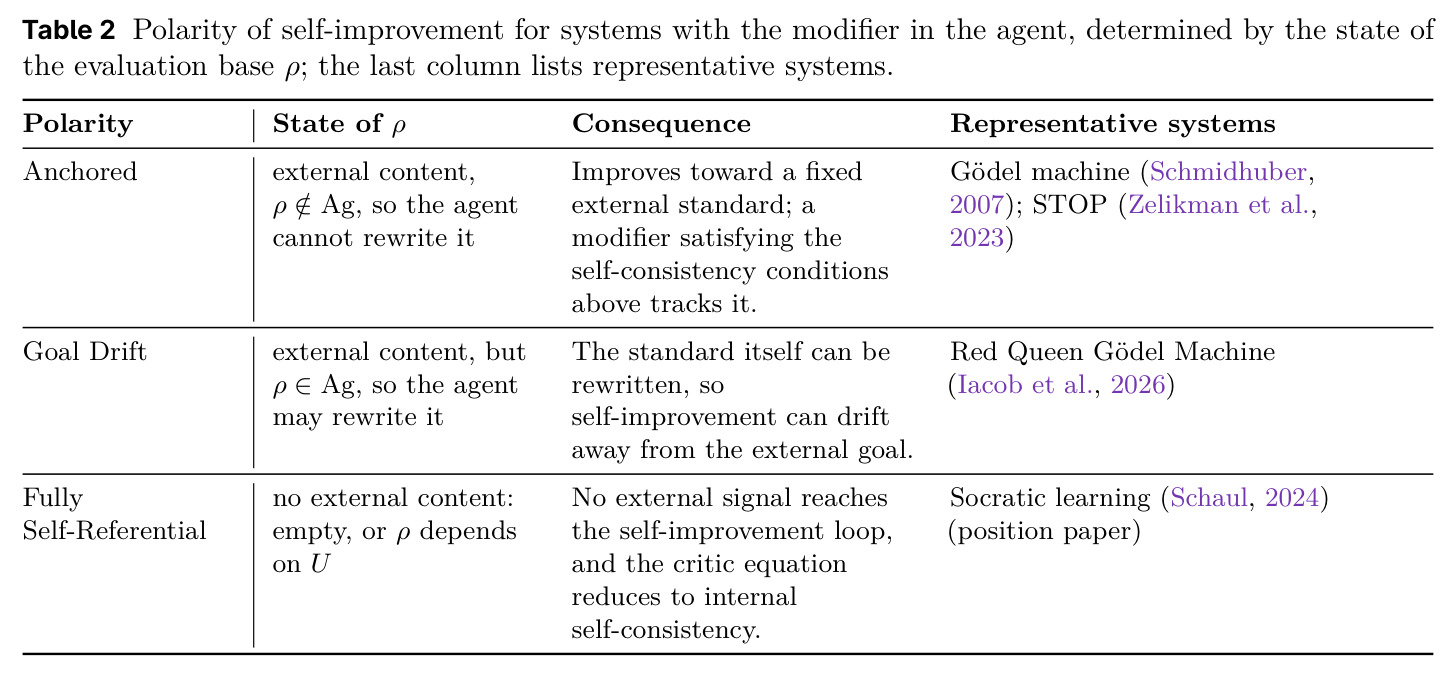
第二个旋钮完全围绕 $\rho$ 的状态展开:锚定、目标漂移与完全自指三档极性,以及未锚定基、目标漂移两个缺陷,都由 $\rho$ 的归属决定。
delusion box(妄想的盒子)
Ring 与 Orseau 在 2011 年提出的思想实验:一旦允许智能体重写自己的输入,强化学习智能体就可以让世界满足自己的判据而无需世界真正配合——它在自己构造的输入流中『看起来』表现很好,实际却停止学习或与目标脱钩。
它是本文『未锚定基』缺陷的早期形式类比:当评价标准落在智能体内部,一个自洽的系统完全可以在不服务外部目标 $G$ 的情况下持续报告改进。
研究动机
自我改进如今在多个尺度上被宣称:Self-Refine 和 Reflexion 让智能体打磨自身输出,STOP 与 SICA 重写自身代码,Darwin Gödel Machine 在档案中开放式搜索自身的改进例程,Red Queen Gödel Machine 甚至让评价器与智能体共同演化,AlphaEvolve 在固定评价器下搜索程序,Schaul 则提议完全去掉外部标准。2026 年的一篇综述(Chen et al.)指出这些标签使用随意、背后野心差异巨大——领域缺少的不是又一个例子,而是一个判据:能说清哪些系统在真正改进自身、以及它们改了之后失去什么。经典一侧其实有成熟理论:在有限 MDP 中,广义策略迭代(GPI)通过评估与改进的交替收敛到最优策略 $\pi^\star$,但 GPI 默认改进机制与奖励都在智能体外部;递归自我改进(RSI)恰恰让二者进入智能体内部,此时没有任何同等广度的形式化描述,导致哥德尔机、元学习、智能体循环等术语彼此割裂。
本文的目标是本文的目标是建立一个统一的形式框架——广义智能体迭代(GAI),把迭代策略改进与递归自我改进(RSI)描述为同一学习范式的两个实例,并把当代各类智能体学习系统(其改进组件表现为代码、参数或 harness 且可被编辑)纳入同一坐标系。具体要做三件事:其一,给出系统与智能体的形式定义,把学习过程刻画为『智能体评估—智能体改进』的循环,使 GPI 成为框架的特例、RSI 成为相邻且可定义的实例;其二,提供一种统一读法,把经典方法与当代自我改进系统放到相同的两个旋钮坐标上,使既有系统可比较;其三,收集离开锚定端的设置所伴随的缺陷,把 RSI 的每个缺陷表述为经典 GPI 某一条成立条件被违反的后果,为分析现有系统与设计新系统提供有原则的基础。
与已有工作不同的是,本文的独特之处在于:它不提出新算法,而是提出一套坐标语言。作者把现有系统的差异压缩为两个『旋钮』——改进机制是否属于智能体、改进所依据的标准是否锚定在智能体之外。这一步让 GPI 与 RSI 不再是两类现象,而只是旋钮设置不同的同一循环:把修改器 $m$ 固定在智能体外、评价基取环境奖励,就恢复经典 GPI;把 $m$ 放进智能体,就得到 RSI。进一步,作者用『锚定/目标漂移/完全自指』三档极性给 RSI 内部分层,使带证明门的哥德尔机与评价器共演化的 Red Queen Gödel Machine 能被放进同一张表逐项比较。文章还直接回应一个质疑:RSI 不能简单看成『配置空间上的 MDP』,因为 MDP 的转移律与奖励固定在智能体之外,而这里下一配置由智能体内部的修改器产生、评价标准也可能在智能体内部。
核心方法
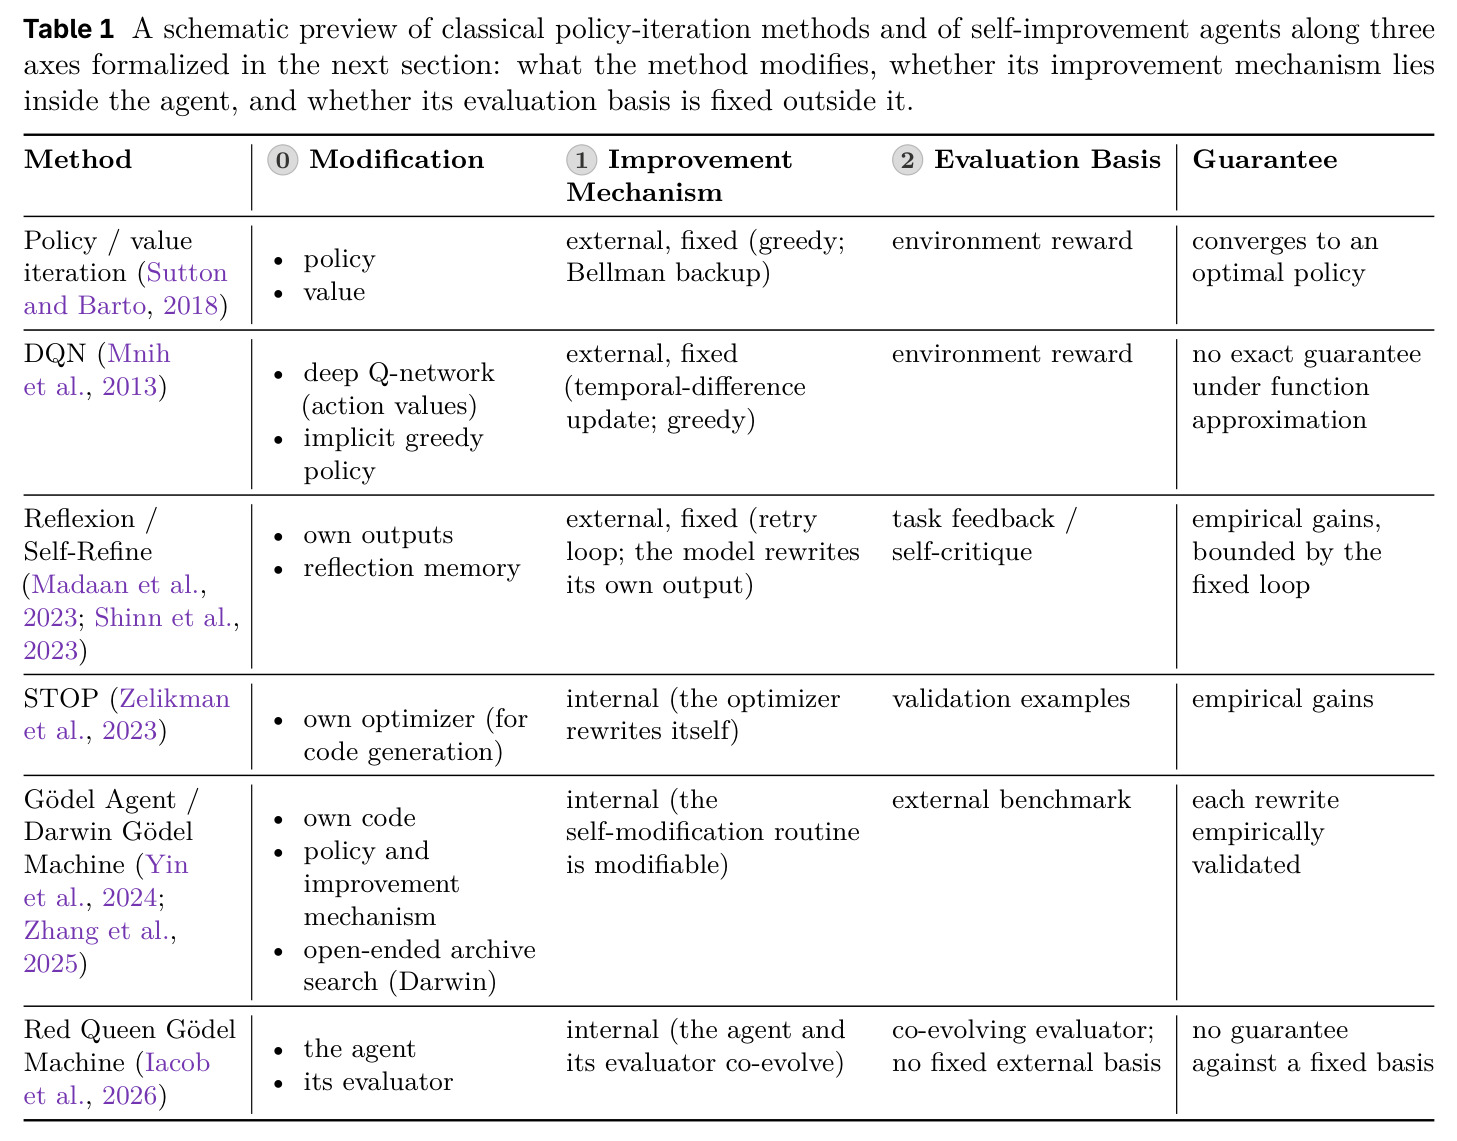
GAI 的直觉是把『学习系统』拆成五个可替换零件的配置 $\chi=(\pi,V,m,U,\rho)$:策略 $\pi:\mathcal{S}\to\Delta(\mathcal{A})$ 选择世界动作,行动评价器 $V$ 评估策略表现,修改器 $m$ 提议系统应如何改变,修改评价器 $U$ 评估提议是否服务外部目标 $G$,评价基 $\rho$ 是打分所依据的标准。智能体就是其中可修改的组件集合 $Ag$,成员随系统而变(如 $Ag=\{\pi,V\}$ 或 $Ag=\{\pi,V,m,U,\rho\}$)。学习过程是 GPI 式的循环:智能体评估(在用评价器按 $\rho$ 打分,$V$ 在策略层、$U$ 在智能体层)与智能体改进($m$ 产出新实例 $\xi\sim m(\cdot\mid\chi)$,系统采纳 $\chi\leftarrow\chi[\xi]$)。技术路线是先在世界 $W=(\mathcal{S},\mathcal{A},p,r)$ 与目标 $G$ 之上定义系统(定义 1),再定义循环(定义 2),最后用两个旋钮的设置读出 GPI 与 RSI 两种实例及其极性。
核心创新是『两个旋钮』的形式化。旋钮一:改进机制是否属于智能体。若 $m\notin Ag$,$m$ 的内容固定,充当 GPI 那个外部的评估-改进算子 $E_m,I_m$;若 $m\in Ag$,递归在 $m$ 处闭合——下一个修改器由当前修改器产生($m'\leftarrow(\xi)_m$),没有外部元层。旋钮二:评价基 $\rho$ 是否锚定,由此得到三档极性:Anchored(内容来自外部且 $\rho\notin Ag$,如哥德尔机的固定外部效用、STOP 的固定验证集);Goal Drift(内容来自外部但 $\rho\in Ag$ 可被重写,如评价器共演化的 Red Queen Gödel Machine);Fully Self-Referential(无外部内容,$\rho$ 为空或依赖 $U$,如 Schaul 的苏格拉底学习)。与既有工作的本质区别:哥德尔机等最近的形式工作只固定一种设计,统计变体只是在证明门上加风险预算,而两个旋钮把这些设计选择变成可比较的坐标,缺陷目录再记录每次偏离锚定端的代价。
方法步骤详情
形式化分五步。第一步,定义世界 $W$ 与外部目标 $G$,系统目标为 $\chi^\star\in\arg\max_\chi\mathbb{E}[\sum_t\gamma^t r]$,由世界决定、不受系统编辑。第二步,定义五组件配置 $\chi=(\pi,V,m,U,\rho)$ 与智能体集合 $Ag$。第三步,GAI 循环:评估阶段由在用评价器按 $\rho$ 打分,改进阶段采纳 $\xi\sim m(\cdot\mid\chi)$、$\chi\leftarrow\chi[\xi]$。第四步,旋钮一:GPI 取 $Ag=\{\pi,V\}$,固定算子执行 $V\leftarrow E_m(V,\pi)$、$\pi\leftarrow I_m(V)$;RSI 取 $Ag=\{\pi,V,m,U\}$,追加 $m'\leftarrow(\xi)_m$,递归在 $m$ 闭合。第五步,旋钮二定极性;『参考理想』自洽条件为:评价器校准到基 $U(\chi)=\mathbb{E}_\xi[\rho_U+\gamma U(\chi[\xi])]$,修改器只提议更优实例——刻画性条件,无机制保证。
技术新颖性
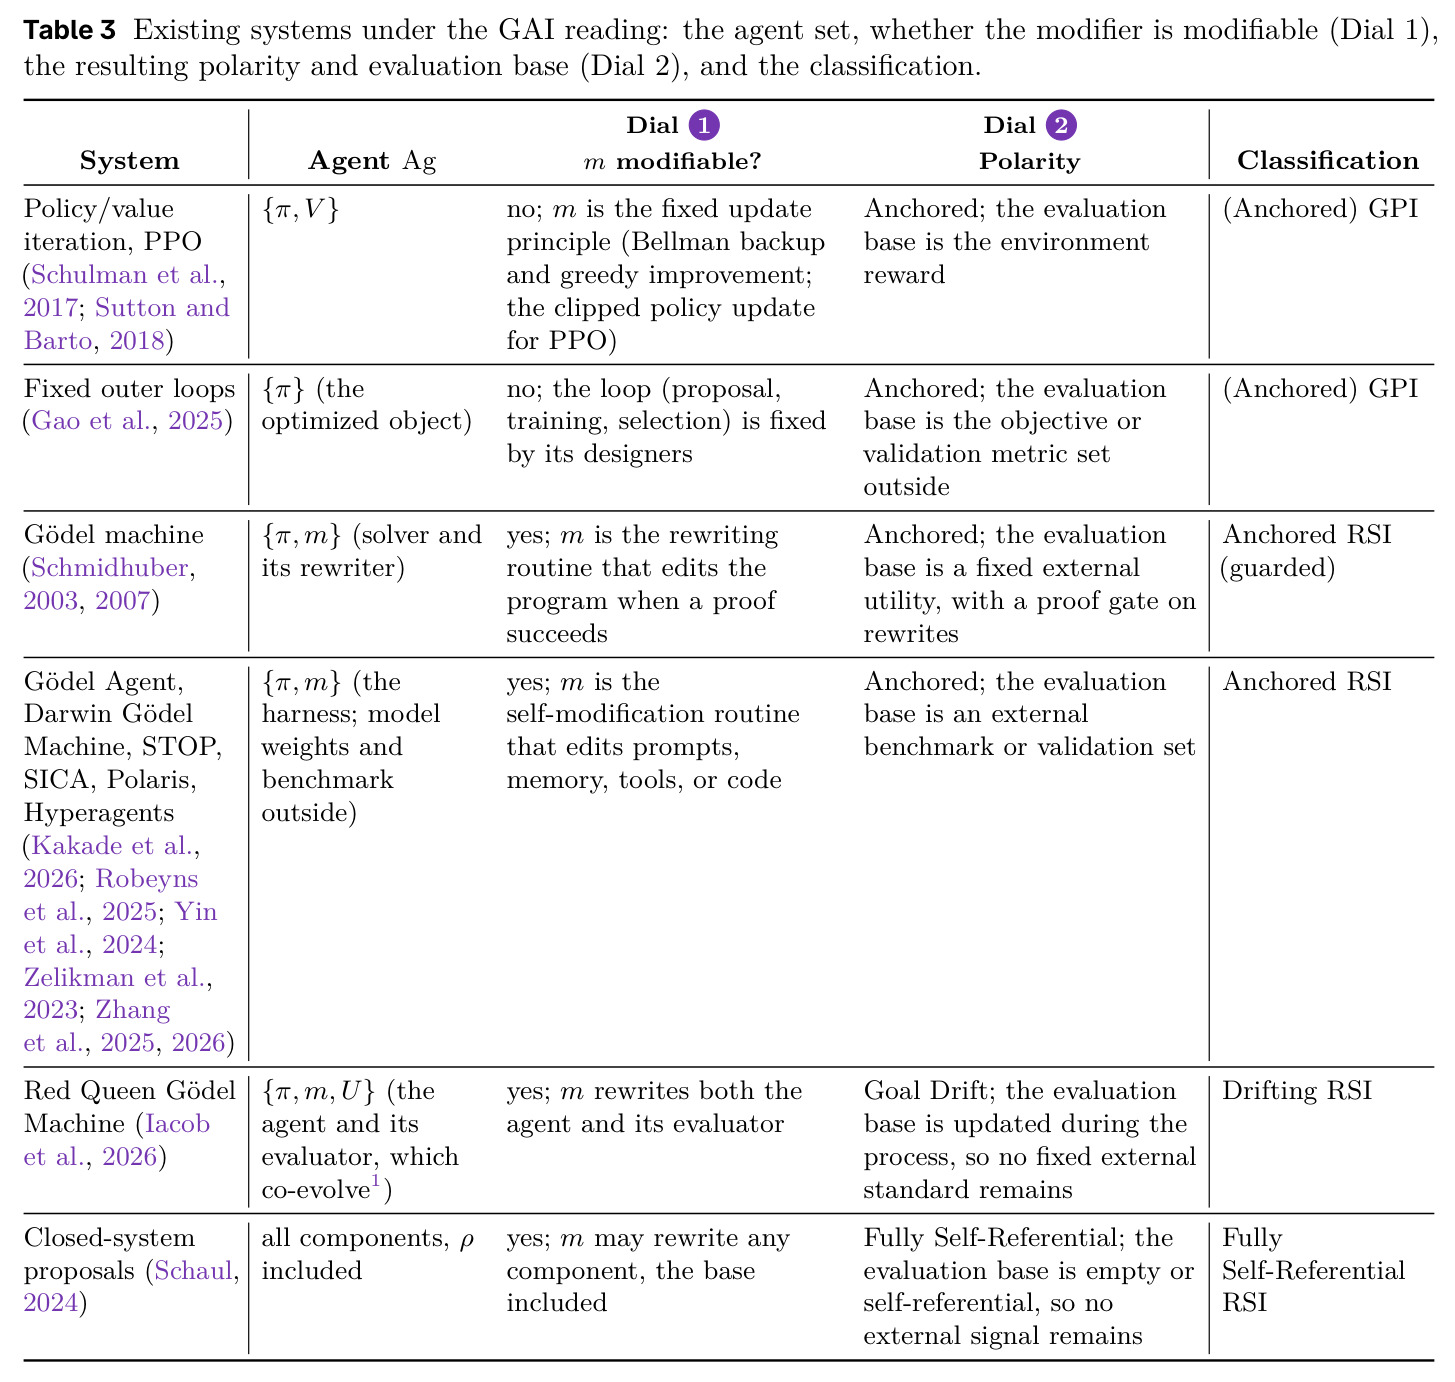
新颖性有四点。其一,统一性:GPI 与 RSI 首次被写成同一交替循环的两个旋钮设置而非两类现象,Running Example 中的编码智能体同时演示两种设置(PPO 式固定例程的锚定学习 vs. STOP 式对验证集自我重写的 RSI)。其二,可比较性:Table 3 用统一读法给九类系统标注 $Ag$ 集合、$m$ 是否可修改、极性与分类,从策略迭代/PPO、固定外循环(Gao et al. 2025 按参数/提示/记忆/工具/脚手架分类的经验工作)到哥德尔机家族,再到 Red Queen 与封闭系统提案。其三,缺陷的可定位性:每个 RSI 缺陷被写成一条经典条件的一次失效——『改进廉价且单调』『评价器在评价对象之外』『目标从智能体外评估』(Table 4),而非笼统的担忧。其四,概念澄清:自我提出的任务仍从属于不可编辑的外部目标,因此只是一种自我改进形式;学习出的代理评审器放在外部是锚定的、成为智能体组件则落入 Goal Drift;Hyperagents 把任务智能体与元智能体放进同一个可编辑程序但评价仍在外部,因此只能改进脚手架、有界。
实验结果
本文是理论/立场论文,无自有实验,产出为框架、分类与缺陷目录。第一项发现是统一分类(Table 3):策略/价值迭代与 PPO、固定外循环同属『(锚定)GPI』;哥德尔机是带证明门的锚定 RSI;Gödel Agent/Darwin Gödel Machine、STOP、SICA 等为锚定 RSI,以外部基准替代证明;Red Queen Gödel Machine 因评价器共演化落入 Goal Drift;Schaul 的提案是完全自指。第二项是四缺陷目录(Table 4):候选自我搜索($m\in Ag$,违反『改进廉价且单调』,被观察——引用 Meng et al. 2026:外部评价固定时,58.33% 的设置首次有效尝试即改进,但越过最佳分数继续搜索的案例中 78.26% 以更低分数收尾,改进步不单调);自我评价($U\in Ag$,被评对象与评价工具合一);未锚定基($\rho_U$ 不接地,自洽条件只约束 $(m,U)$ 而不再涉及 $G$,呼应 delusion box);目标漂移($\rho_U\in Ag$,标准被重写而目标名目不变)。这些缺陷是定义的推论而非定理。
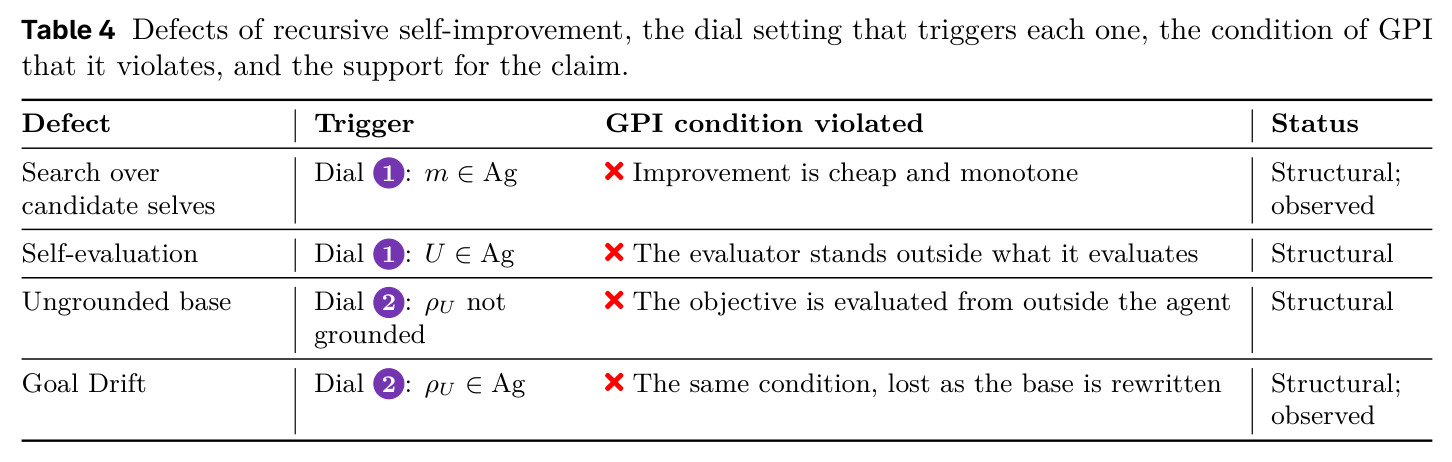
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 智能体在固定目标模型与固定外部评价下修订自身训练数据策略(本文引用的外部实证,Meng et al., 2026) | 首次有效尝试即改进的比例;越过最佳分数继续搜索后终次得分更低的比例 | 58.33% 的设置首次有效尝试即改进;78.26% 的继续搜索以更低分数收尾(引用数据,非本文实验) | GPI 锚定设置下改进步廉价且单调,有限 MDP 中交替收敛到最优策略 | 不适用:该数据被本文引用为 RSI 改进步不单调的经验证据 |
局限与改进
作者承认四条限制:框架描述系统如何变化而非如何计算变化,配置空间是参考理想化,定义不含可达性或复杂性断言,缺陷是形式化的性质、被观察到时只引证而不测量;不建模时间尺度,世界动作与智能体更新按步数计数不计算力;证明门、编码基准等护栏被当作限制修改器提议范围的外部机制,护栏本身是否应成为智能体组件是留白的设计选择;只研究无人干预的运行,接受、审计或回滚更新的人类在形式化之外,尽管实践中人仍设定方向并审查结果。我自己的观察:自洽条件(式 4)的解集完全未刻画,可能容纳大量不服务 $G$ 却自洽的系统;RSI 到 GPI 的归约只是文字描述而非带显式假设的命题;评价基被建模为单一标准 $\rho$,对真实系统中多个、可能部分可重写的标准(测试集加人工评审)表达力不足;此外全部断言是结构性或引证性的,没有任何受控模拟来测量目标漂移的速率或检测难度。
独立分析的弱点
弱点一:缺陷目录只有结构性陈述加零星引证,缺乏量化指标,例如『目标漂移』没有漂移速率或检测成本的定义;改进方向是为每个缺陷设计可测量协议,如固定外部 $G$、赋予 $\rho_U$ 重写权限,测量报告分数与真实分数的散度随重写次数的变化。弱点二:三档极性过于粗粒度,评价器部分可重写(如只允许改评审规则不许改数据分布)的系统无法安放,可引入连续的『锚定度』参数并研究其在自改过程中的守恒或衰减律。弱点三:人类审查被排除在形式化之外,而现实部署中人审是主要防线,应扩展一个审查操作符并分析『人审 + 内部自改』的混合极性。弱点四:$\rho$ 被当作单一标量标准,多标准场景(测试通过率、成本、安全约束)需要向量评价基与偏序比较,此时『锚定』的定义需逐维给出。弱点五:式 4 中折扣因子 $\gamma$ 的作用未被讨论,短视的小 $\gamma$ 可能系统性激励『快速过审』的重写,这本身就是一种未被列入目录的缺陷。
未来方向
作者明确提出三个具体目标:其一,刻画自洽条件的解集——它们容纳多少解、其中何时存在服务目标 $G$ 的成员,目前完全开放;其二,把『递归自我改进可归约回 GPI』从散文写成带显式假设的命题;其三,研究系统内部的忠实性监控器能否判定自身修改评价器的忠实性,作者预期这需要自指论证而非构造。在成果之上可延伸的方向包括:为每个缺陷建立量化基准(漂移率、非单调搜索的浪费比 78.26% 这类指标的系统化);在 GAI 坐标上系统搜索『锚定损失最小』的 RSI 设计点,例如 $\rho\in Ag$ 但带外部快照校验的混合设置;把框架作为审计工具回放现有系统,检验 Table 3 的标注是否被后续系统的实现推翻;以及研究把护栏(证明门、外部基准)作为智能体组件时缺陷目录如何变化——这正对应作者留白的设计选择问题。
复现评估
复现本文等于重走一遍概念论证:无代码、无数据集、无算力需求,全文约 12 页(arXiv:2609.13406v1,[cs.AI]),定义 1、定义 2、式(1)—(4)与四张表全部在正文中自足给出,读懂门槛在于强化学习与 RSI 文献的背景而非工程。可核查性主要体现在 Table 1 与 Table 3 的系统标注上:所引系统(哥德尔机、Gödel Agent、Darwin Gödel Machine、STOP、SICA、Polaris、Hyperagents、Red Queen Gödel Machine、AlphaEvolve、AI Scientist 等)绝大多数有公开论文或开源代码,读者可逐一对照原始实现核对 $Ag$ 集合与 $\rho$ 的归属是否如本文所标。唯一的主观风险在概念判读:『评价基是否可被智能体重写』取决于对系统实现的解读,个别带外部评审的流水线可能在 Dial 2 归类上引发分歧。建议的复核流程是先按定义 1 写出各系统的五组件清单,再对照 Table 3 检查分类一致性。
论文图表
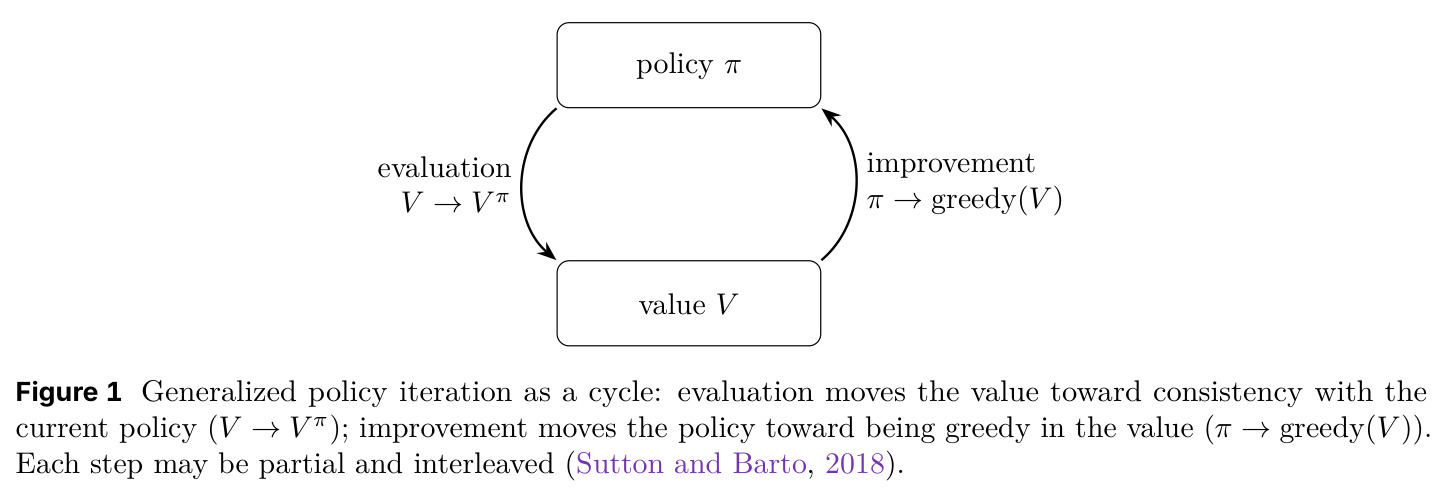
上半是策略 $\pi$,下半是价值 $V$,两条箭头构成循环:左侧评估箭头 $V\to V^\pi$ 把价值推向与当前策略一致,右侧改进箭头 $\pi\to\mathrm{greedy}(V)$ 让策略在当前价值下更贪心。图注强调每一步都可以只走一部分并且可以交错执行。
这是 GAI 要推广的基线图像。只有先理解 GPI 这个『评估-改进』两节点循环及其在有限 MDP 中收敛到最优策略的保证,才能看出 Figure 2 在何处加入了修改器与评价基,以及两个旋钮改变的是什么。