基于合成语音的固定音色泰语TTS构建与评估 Building and Evaluating Fixed-Voice Thai TTS from Synthetic Speech
以语音克隆大模型为数据引擎,蒸馏出82M参数固定音色泰英双语端侧TTS
前置知识
零样本语音克隆
大型 TTS 模型只需几秒参考音频即可复制说话人音色,代表如 600M 参数的 OmniVoice 与 Gemini 3.1 Flash TTS。它们基于自回归或扩散语言模型骨干,在大规模多语种语音上训练,具备零样本能力但推理依赖 GPU、成本高。
本文把它当作可编程的数据源而非部署对象,这是整条第三条路线的出发点。
固定音色 TTS
如 VITS、StyleTTS2、Kokoro 等紧凑架构,只为预定义的一组音色合成语音,推理时无需参考音频,可端侧运行;传统做法需要录制目标说话人的专用语料库。
这是学生模型的目标形态,82M Kokoro 骨干的选择与端侧部署动机都由此而来。
CER 与 ASR 式 TTS 评估
字符错误率 $CER=(S+D+I)/N$,即替换、删除、插入字符数除以总字符数。TTS 评估中先让 ASR 转写合成音频再计算 CER;泰语因空格不标记词边界,通常用 CER 而非依赖分词的 WER。
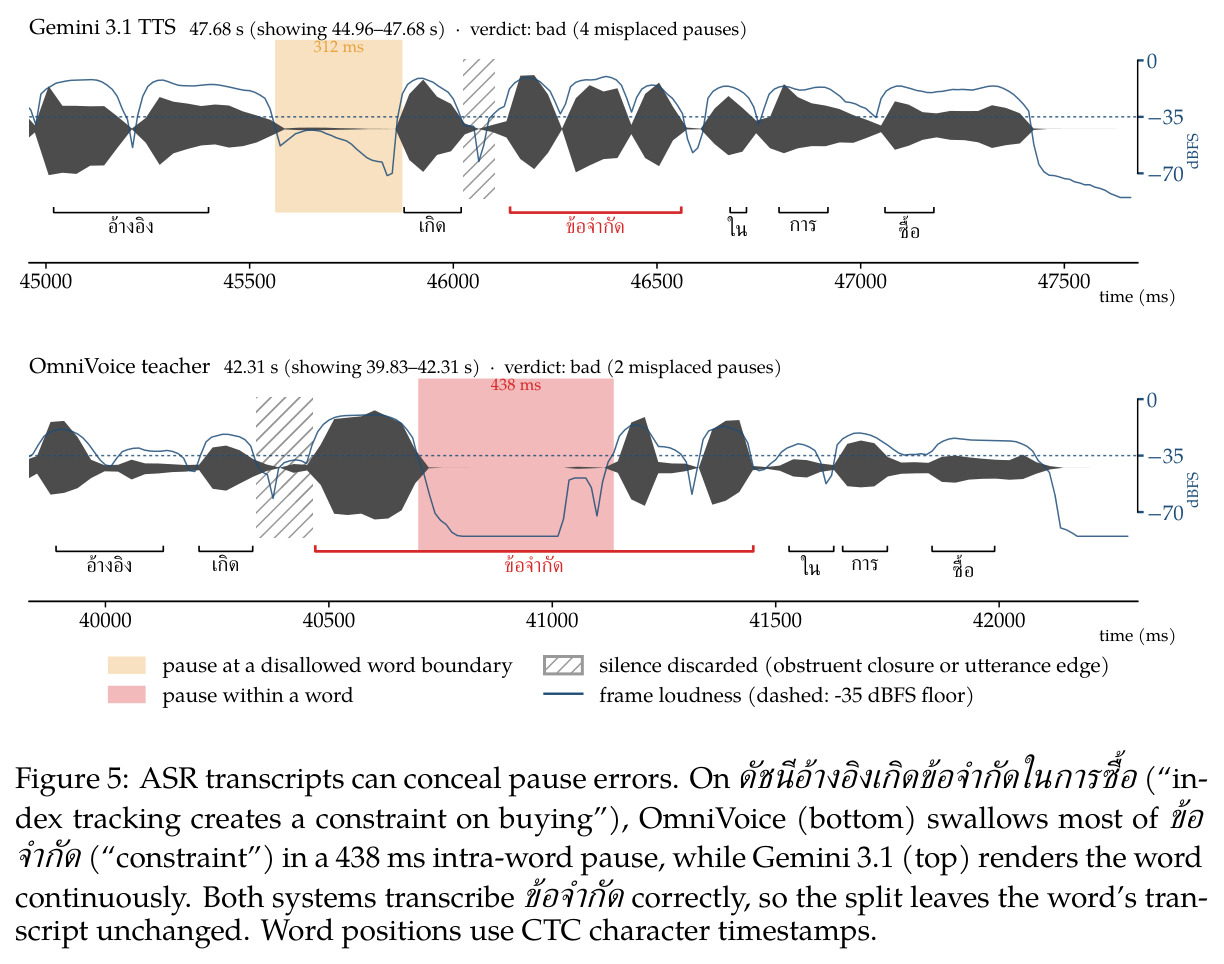
论文用数据论证 CER 会掩盖关键错误,是提出多维评估框架的直接动因。
CTC 与自回归 ASR 的差异
CTC 模型(如 wav2vec2)逐帧条件独立预测,无法利用语言上下文纠错;自回归模型(如 Whisper)可凭句意把读错的词'脑补'回来。过滤合成语音时,这一差别决定能否暴露真实的发音缺陷。
作者特意选 CTC 验证器做质量过滤器,这是保证训练目标干净的关键设计。
泰语声调与分词难题
泰语正字法不标记词边界,需 TLTK、PyThaiNLP 等工具分词;有五个声调(中、低、跌、高、升),声调是音位性的,读错即成另一个词。数字读法、外来词与泰英混写进一步增加文本前端难度。
理解为何需要 LLM 改写、含声调的音素级匹配以及专门的停顿位置评估。
知识蒸馏
让小模型(学生)学习大模型(教师)行为的范式,经典形式是匹配 logits 分布 $p_{teacher}(y|x)$。本文变体:教师只负责生成数据,学生用筛选后的合成波形训练。
论文灵感明确来自现代 LLM 蒸馏,但传输物从概率分布变成了语料本身。
研究动机
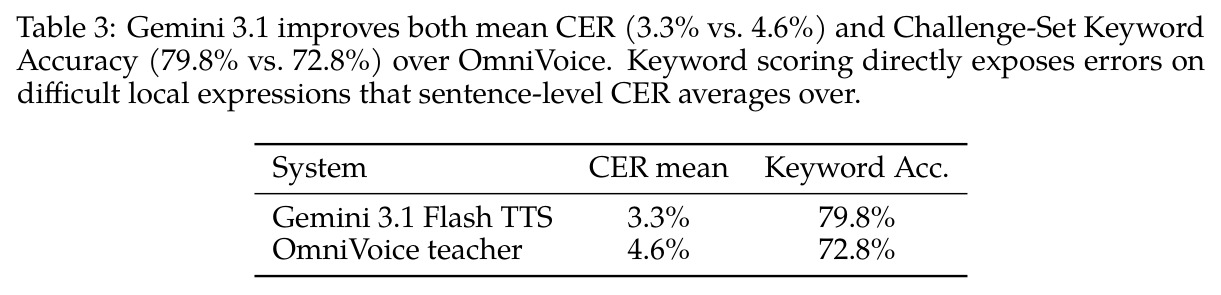
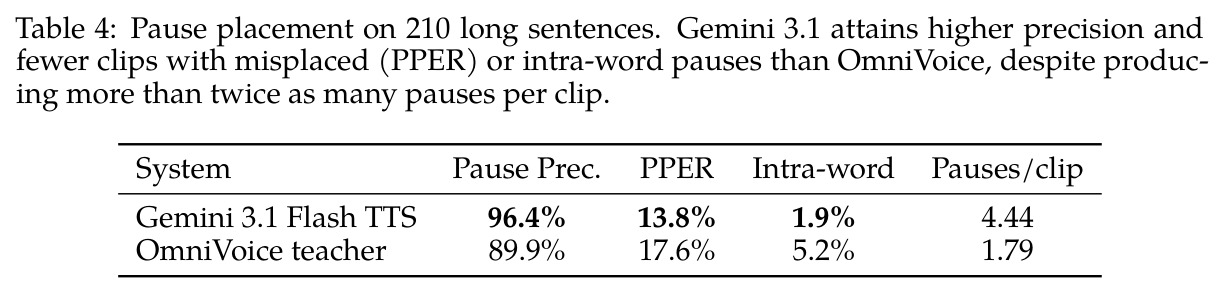
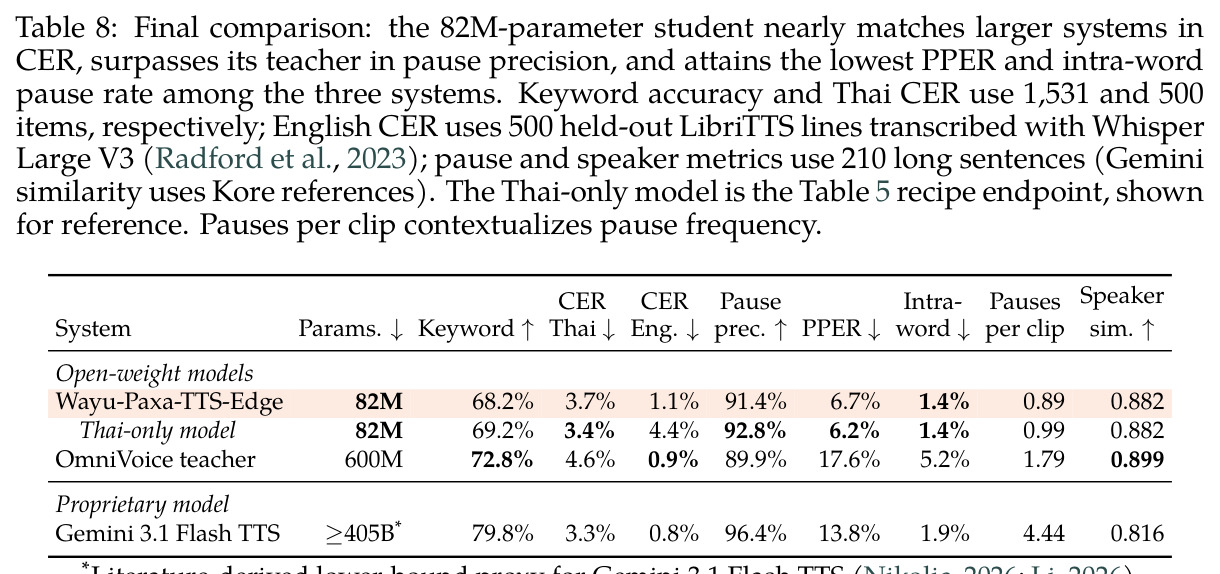
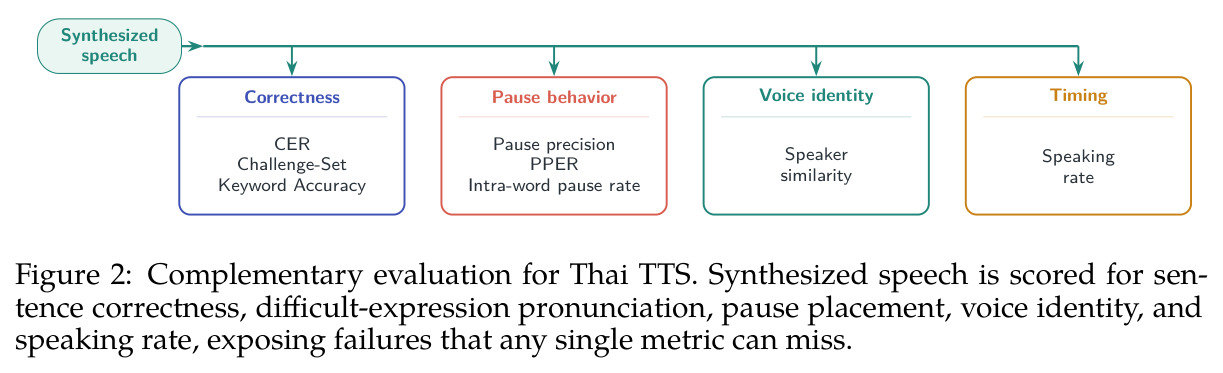
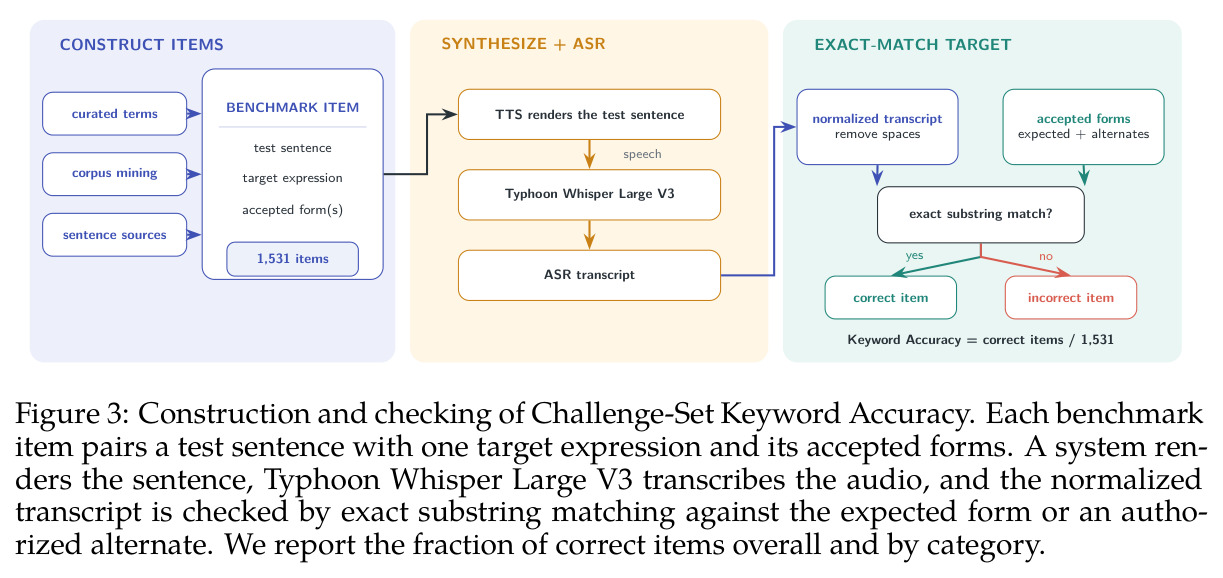
在低资源场景部署 TTS 时,从业者长期面临两难:要么使用大型零样本语音克隆模型(如 600M 参数的 OmniVoice 或 Gemini 3.1 Flash TTS),需要参考音频且推理依赖 GPU;要么训练 VITS/StyleTTS2 一类的紧凑固定音色模型,但必须录制成本高昂的说话人专用语料。泰语让问题更棘手:正字法不一致地标记词边界、五个音位性声调、不规则人名与外来词、非正式拼写、数字读法以及泰英混写,使文本前端与评估都难以对齐。更关键的是,句子级 CER 会掩盖局部致命错误——论文实测 Gemini 3.1 与 OmniVoice 的 CER 只差 1.3 个百分点(3.3% vs 4.6%),但挑战集关键词准确率相差 7 个百分点(79.8% vs 72.8%);一句 CER 很低的话仍可能读错人名,或在词内插入停顿而 ASR 转写不变,停顿数据也显示 OmniVoice 尽管每句只停顿 1.79 次,错位率 PPER 反而高达 17.6%。
本文的目标是本文的目标是把一段仅 15 秒的声音参考变成可部署的固定音色泰语 TTS:以零样本克隆模型为可编程数据源,构建质量受控的合成语料,训练出无需参考音频、可端侧推理的 82M 参数学生模型 Wayu-Paxa-TTS-Edge。围绕这一目标作者交付四件事:(1) 端到端配方,覆盖泰语文本准备、语音合成、质量过滤与拒绝采样;(2) 把句子级 CER、挑战集关键词准确率、韵律停顿准确率、说话人相似度与语速五个维度解耦的评估框架;(3) 对停顿过滤、拒绝采样、预训练初始化与前端策略的受控消融,包括不改声学模型、只改前端即可涨点的证据;(4) 通过 oracle best-of-K 采样量化教师能力上限与数据覆盖瓶颈的分析,外加证明 15 秒参考即可迁移依善方言音色的适配研究。
与已有工作不同的是,区别于两条既有路线——需要数小时真实目标说话人音频做适配的合成数据法(Joshi & Garera, 2023),以及构建大规模带声调与停顿显式标注语料的泰语专用系统(Geng et al., 2025)——本文提出第三条路:把大模型当作可编程的数据引擎而非部署对象。核心洞察是教师错误会成为训练目标,而简单丢弃被过滤文本会牺牲困难样本的覆盖率,因此管线设计本身成为决定性变量。作者同时指出评估侧长期被忽视:泰语 WER 依赖分词,MOS 缺乏泰语基础设施且无诊断价值,说话人相似度只度量音色,所以需要一个超越 CER 的多维评估体系,把发音、停顿、音色、语速分开度量,并用挑战集把'句子大体正确但关键词读错'这类隐藏失败暴露出来。
核心方法
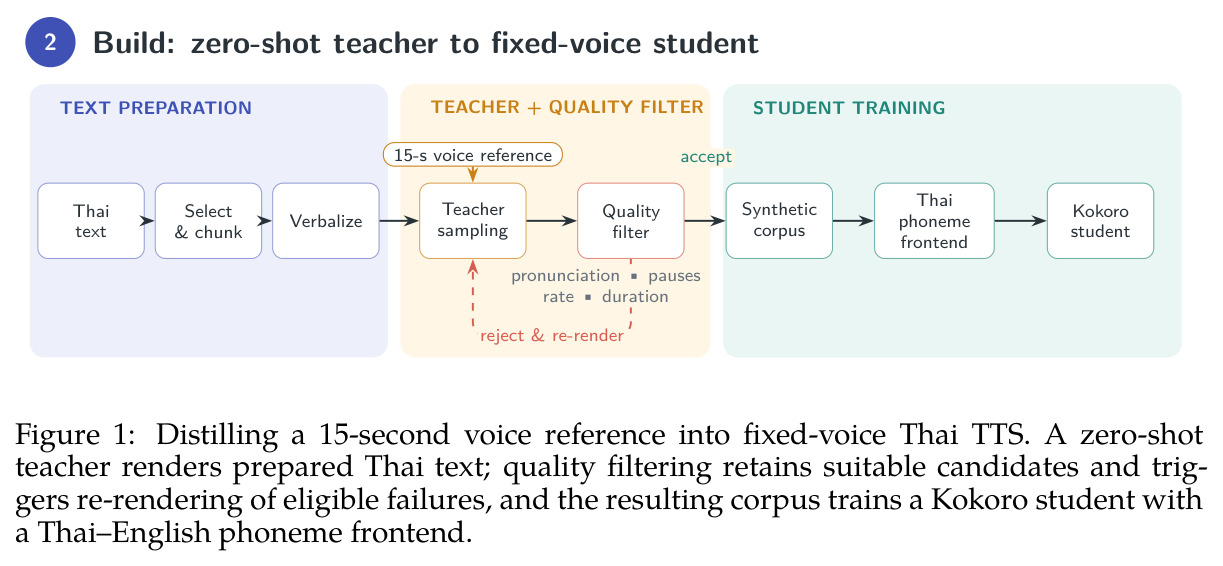
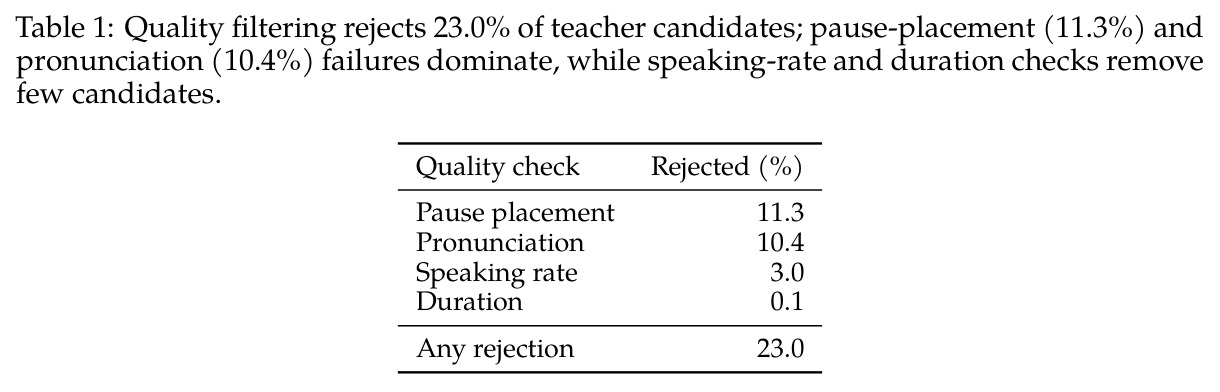
方法整体是一条三阶段蒸馏管线。直觉上,大型克隆教师是一个带噪声的随机采样器:给定 15 秒参考音色,它对同一文本能生成多个候选,其中部分是高质量目标;配上严格的质量过滤器,就能把教师分布中可用的部分蒸馏成训练集,学生只需学习被接受的部分。技术路线为:(1) 文本准备——从 WangchanThaiInstruct 与 LLM 关键词合成管线取泰语文本并做句子级切块,用 LLM 把数字和嵌入英文改写成泰语或 Tinglish 读法;(2) 教师采样——OmniVoice Voice Design 从 12 个说话人规格生成种子参考,再以克隆模式渲染语料;(3) 质量过滤——CTC 泰语 ASR 做音素级精确比对,叠加停顿位置、语速(约 ±10% 区间)与时长检查,总体拒绝率 23.0%,非停顿失败最多重渲染 4 次并保留最佳样本;(4) 用 82M 参数的 Kokoro/StyleTTS2 骨干训练学生,泰语经 TLTK、英语经 Misaki 路由到共享 IPA 音素表。最终双语版加入不超过泰语 30% 时长的英文数据,共 54.35 小时语料。
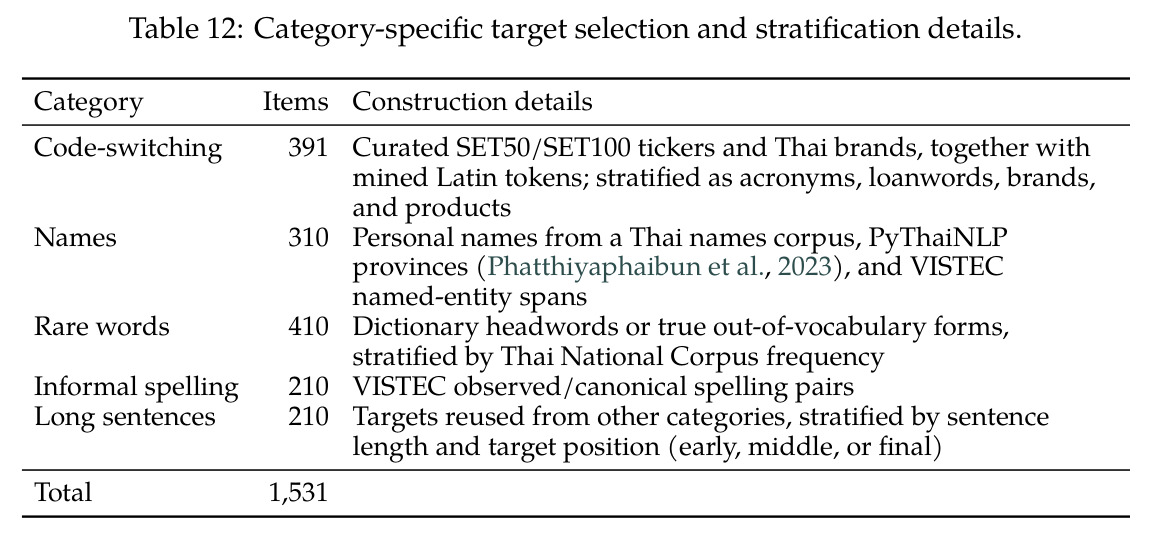
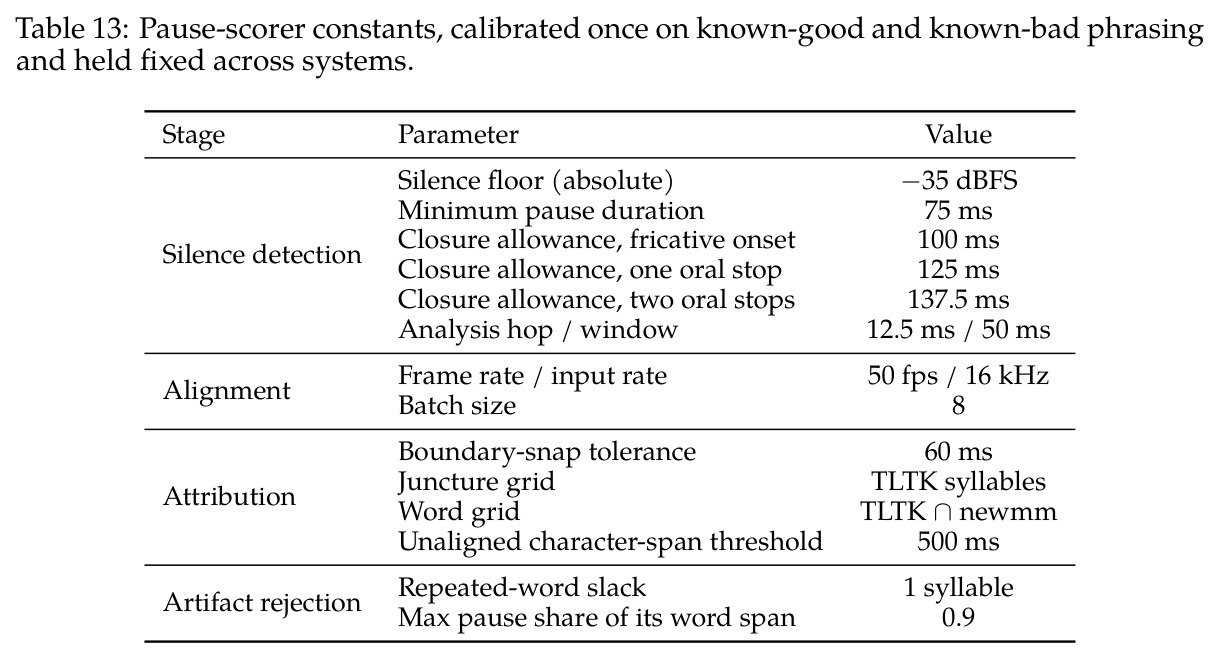
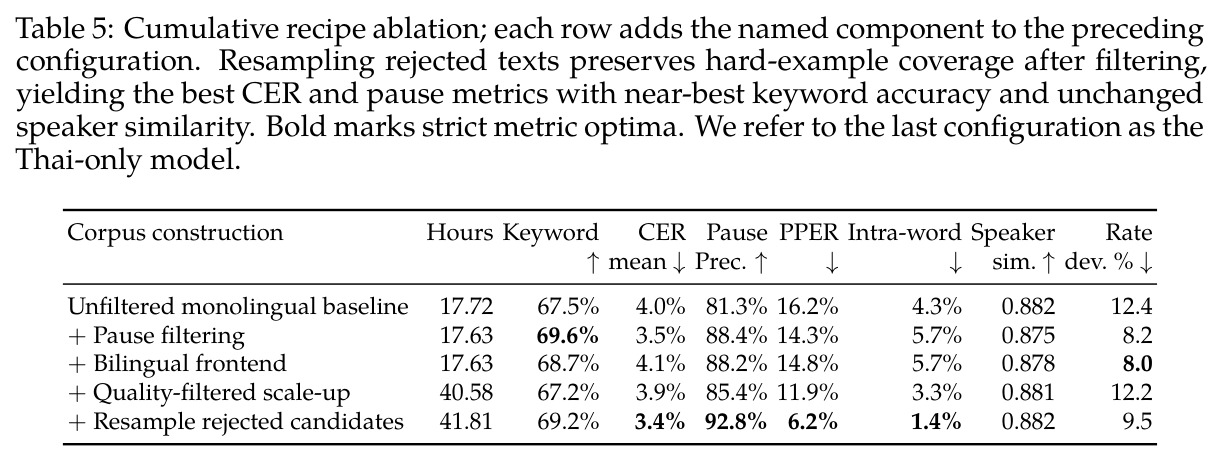
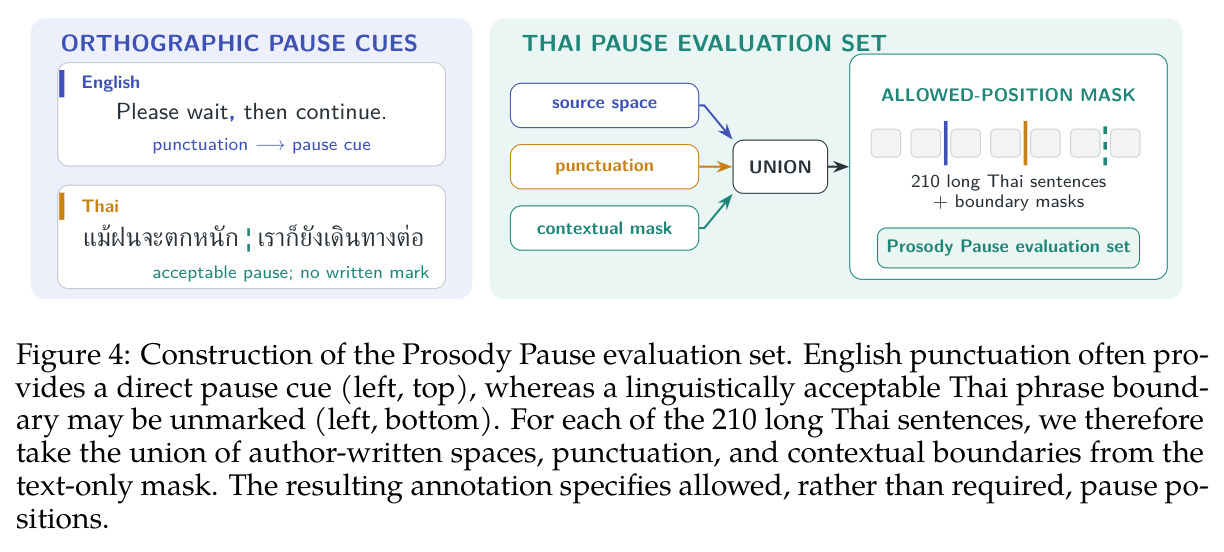
核心创新有二。其一是'教师即数据源'的固定音色蒸馏范式:与经典蒸馏传输 logits 或隐状态不同,这里传输的是经筛选的波形数据,教师误差直接成为训练目标,因此过滤与拒绝采样成为保住困难样本覆盖率的关键——消融显示拒绝采样使 CER 从 3.9% 降到 3.4%、停顿精度从 85.4% 升至 92.8%、PPER 减半到 6.2%。其二是用 CTC 验证器而非 Whisper 类自回归 ASR 做过滤器:自回归模型能凭上下文恢复读错的词从而掩盖发音错误,而 CTC 模型对硬词(OOV 或 TLTK 词典中在泰语国家语料库中低频的头词)做包含声调的精确音素匹配,能暴露真实缺陷。配套评估框架把停顿定义为集合预测问题——参考只标注允许位置而非必须位置,因此只报停顿精度不报召回,并要求同时报告每句停顿数,防止'少停顿刷低 PPER'的博弈。
方法步骤详情
第一步文本来源:WangchanThaiInstruct 提供广覆盖泰语,LLM 关键词合成管线定向生成困难表达句,句子级切块,发布版另加 LibriTTS 英文。第二步语声创建:先用 OmniVoice Voice Design 从 12 个说话人规格合成种子参考,再用克隆模式渲染语料,渲染前 LLM 把数字与英文改写为泰语或 Tinglish 读法。第三步质量过滤:wav2vec2-large-xlsr-53-th(CTC)转写后与目标做含声调的音素精确比对,硬词(OOV 或低频词典头词)不匹配即拒绝;韵律上拒绝停顿违规、语速偏离约 ±10%、硬词时长异常压缩者,总拒绝率 23.0%(停顿 11.3%、发音 10.4%、语速 3.0%、时长 0.1%),失败最多重渲染 4 次。第四步学生训练:Kokoro 82M 骨干,主要模块从 Kokoro 初始化、风格编码器取自 StyleTTS2-LibriTTS,8 个 epoch,AdamW,学习率 $1\times10^{-4}$(PL-BERT $1\times10^{-5}$),批大小 8,泰语低声调新增一个词表 token,最终加英文数据得 54.35 小时双语模型。
技术新颖性
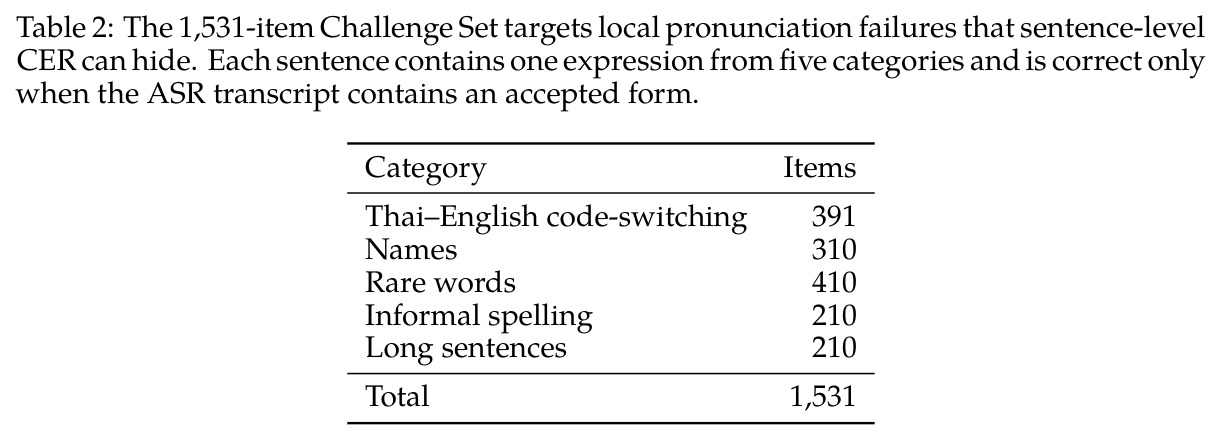
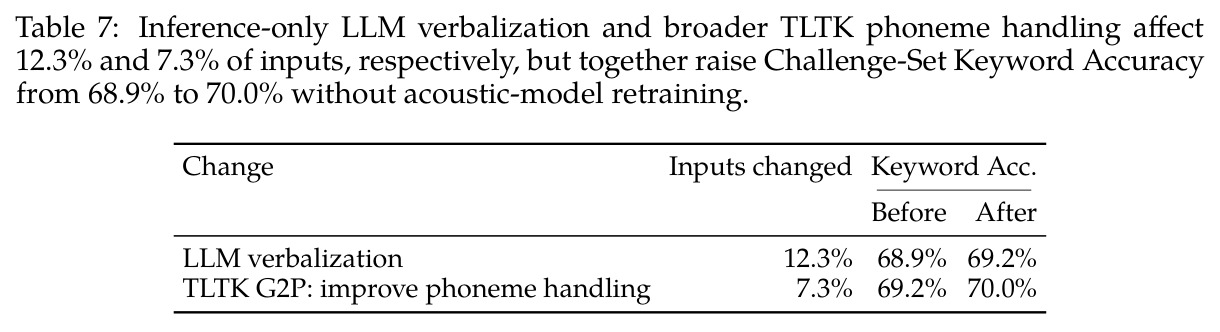
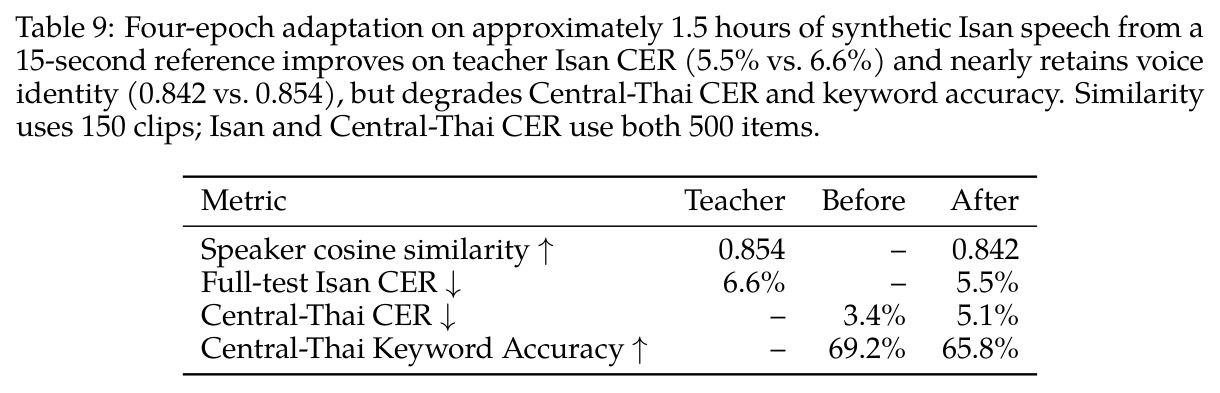
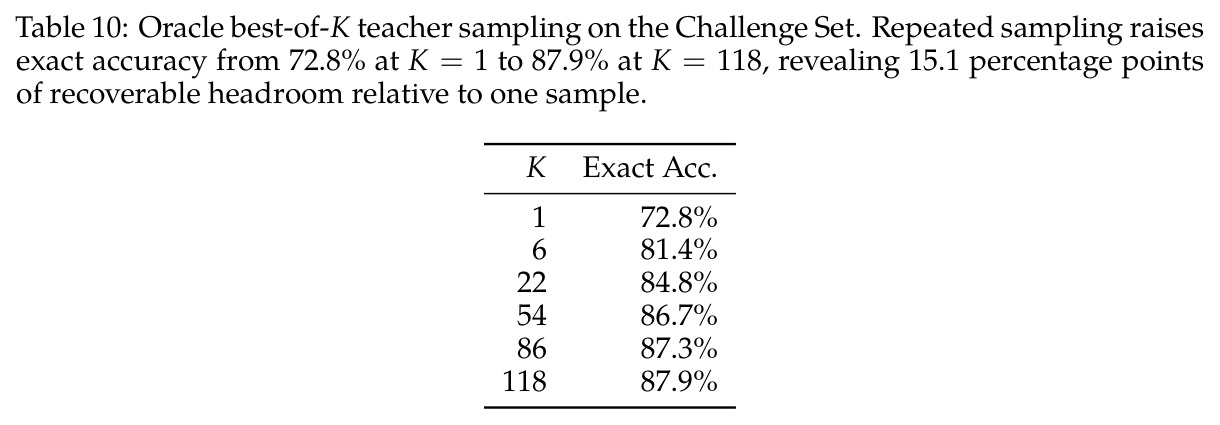
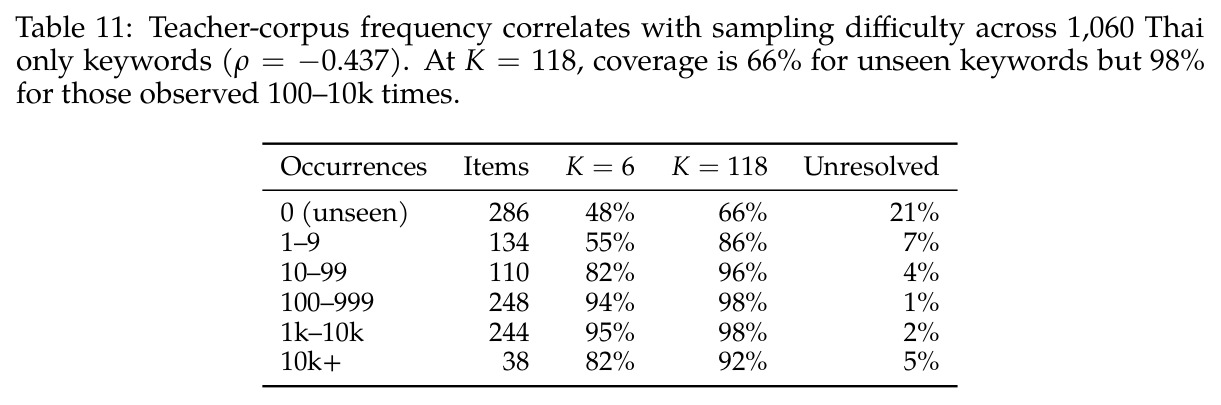
技术新颖性体现在四点。第一,范式上把蒸馏重新定义为语料工程:教师分布的覆盖与管线的选择策略而非模型架构成为性能瓶颈,best-of-$K$ 分析表明 $K=118$ 时准确率可从 72.8% 提到 87.9%,且恢复率与关键词在教师训练语料(约 1.05 万小时泰语,98.2% 来自 GigaSpeech 2)中的出现频次负相关($\rho=-0.437$)。第二,评估学贡献:1,531 句挑战集分为混码、人名、生僻词、非正式拼写、长句五类做精确子串匹配;停顿评估用 Gemini 标注上下文允许位置并与作者书写的空格/标点取并集,只算精度、PPER 与词内停顿率。第三,工程发现:仅改前端——LLM 改写影响 12.3% 输入带来 +0.3 点,TLTK 音素处理影响 7.3% 输入带来 +0.8 点——即可在不重训声学模型的情况下把关键词准确率从 68.9% 提到 70.0%,说明相当一部分失败源于上游文本处理。第四,15 秒参考即可迁移方言音色:依善适配后说话人相似度 0.842 对教师 0.854,Isan CER 5.5% 反而优于教师的 6.6%。
实验结果
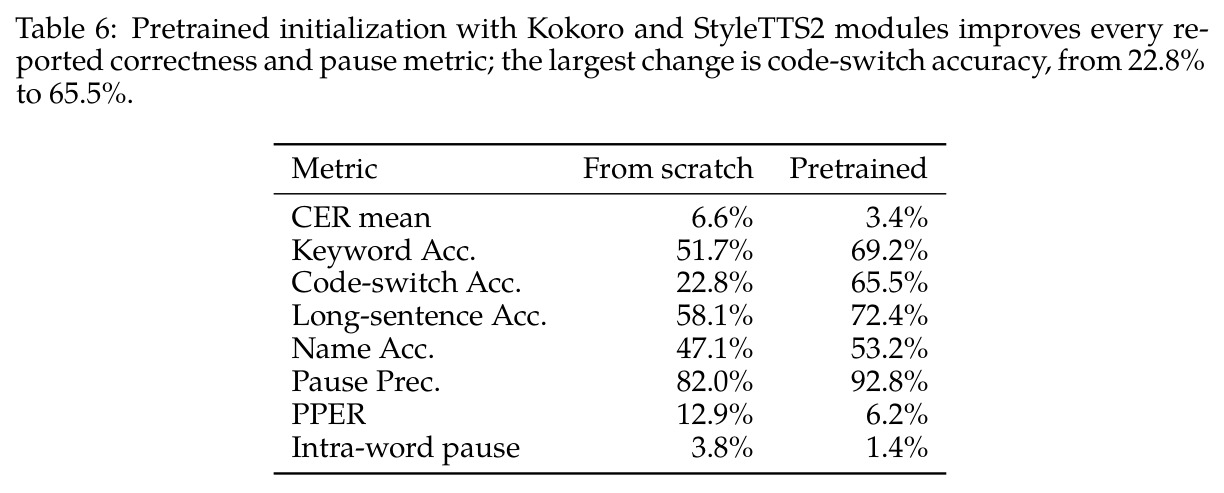
最终模型 Wayu-Paxa-TTS-Edge(82M)在 1,531 项挑战集上关键词准确率 68.2%(为 Gemini 3.1 的 85.5%,低于教师 OmniVoice 的 72.8%),泰语 CER 3.7%(教师 4.6%),英语 CER 1.1%;停顿精度 91.4% 反超教师的 89.9%,PPER 6.7%、词内停顿率 1.4% 均为三系统最低(教师 17.6%/5.2%),相似度 0.882 近教师 0.899。消融(表 5):停顿过滤使 CER 4.0%→3.5%、停顿精度 81.3%→88.4%;扩量到 40.58 小时反使关键词跌至 67.2%,拒绝采样(41.81 小时)恢复到 69.2% 且 PPER 砍到 6.2%。预训练初始化(表 6)全面占优,混码准确率 22.8%→65.5%(+43.4 点),人名仅 +6.1 点。仅改前端(表 7)68.9%→70.0%。教师分析(表 10-11):oracle best-of-$K$ 在 $K=118$ 达 87.9%(较单采样 +15.1 点),未解决项集中于低频表达(未见词覆盖 66% 对高频词 98%)。依善适配(表 9):Isan CER 5.5% 好于教师 6.6%,相似度 0.842 对 0.854,但中央泰语 CER 3.4%→5.1%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 泰语困难表达发音(挑战集 1,531 句) | Keyword Accuracy | 68.2% | OmniVoice 教师 72.8%;Gemini 3.1 Flash TTS 79.8% | 低于教师 4.6 点,为 Gemini 的 85.5%;压缩主要伤害困难词汇实现 |
| 泰语句子可懂度(500 句 CER 集) | CER mean | 3.7% | OmniVoice 4.6%;Gemini 3.3% | 优于教师 0.9 点,接近 Gemini |
| 英语句子可懂度(500 句 LibriTTS) | CER | 1.1% | OmniVoice 0.9%;Gemini 0.8% | 较纯泰语版的 4.4% 大幅改善,接近大模型 |
| 停顿位置正确性(210 长句) | Pause Precision / PPER / 词内停顿率 | 91.4% / 6.7% / 1.4% | OmniVoice 89.9% / 17.6% / 5.2%;Gemini 96.4% / 13.8% / 1.9% | 精度超教师,PPER 与词内停顿为三系统最低 |
| 音色保持(210 长句) | 说话人余弦相似度(ECAPA) | 0.882 | OmniVoice 0.899;Gemini 0.816 | 接近教师且高于 Gemini,说明压缩未伤音色 |
| 教师能力上限分析(挑战集) | Oracle best-of-K Exact Accuracy | K=118 时 87.9% | K=1 时 72.8% | +15.1 点可恢复空间,指向采样与选择策略的价值 |
| 依善方言适配(500 句 Isan) | Isan CER / 说话人相似度 | 5.5% / 0.842 | 教师 Isan CER 6.6% / 相似度 0.854 | CER 优于教师,音色近乎保留,但中央泰语 CER 3.4%→5.1% |
局限与改进
作者承认的局限:学生关键词准确率(68.2%)仍低于教师(72.8%)与 Gemini(79.8%),模型压缩主要伤害困难词汇的语音实现而非音色或停顿结构;停顿与关键词指标依赖泰语规则分词与音素转换等启发式,在上下文相关的泰语上并不完美;依善适配只证明了可懂度(CER 5.5%),未建立方言自然度与忠实度的评估集;人名类准确率仅 53.2%,是明显的短板类别。我的补充观察:所有正确性指标都构建在 ASR 之上,存在对特定 ASR 友好发音的选择偏差循环,过滤器和评估器共享同一 wav2vec2 模型时尤其如此;CER 按句截断在 100% 会掩盖 ASR 幻觉带来的极端样本;Gemini 参数量(≥405B)只是文献推算的下界代理,跨规模比较并不严格公平;依善适配因中央泰语 CTC 验证器拒绝方言形式而关闭了发音过滤,语料质量实际未经校验;全文无 MOS 主观评测,音质自然度缺乏直接证据。
独立分析的弱点
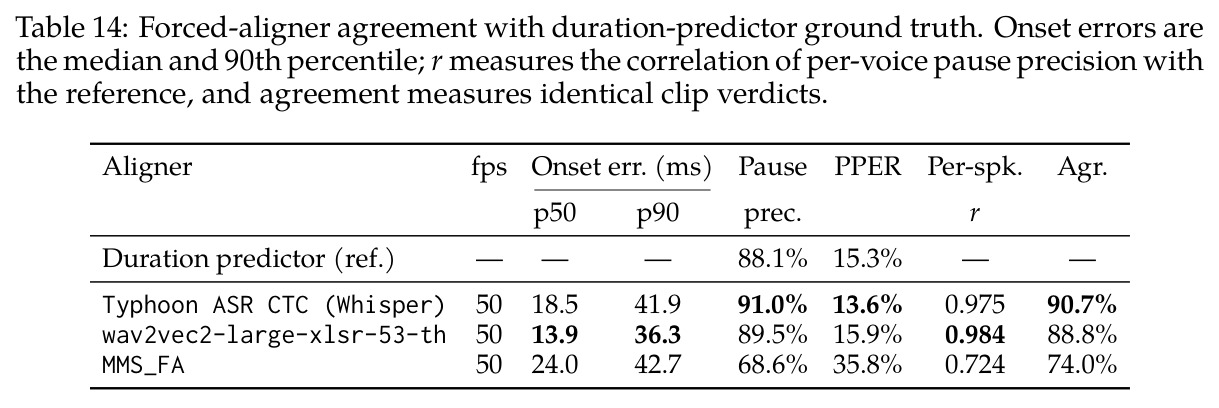
弱点一:过滤与停顿评分都依赖单一 CTC ASR(airesearch/wav2vec2-large-xlsr-53-th),会把与该 ASR 互补的发音偏差系统性放进训练集;改进方向是集成异构验证器投票——论文已验证 Typhoon ASR CTC 与参考的 clip 判定一致率达 90.7%、逐说话人相关 0.975,完全可作第二意见。弱点二:严格过滤淘汰困难文本会降低覆盖,拒绝采样虽缓解,但最多 4 次重渲染仍可能让极稀有词永远进不了语料;可引入音素级 prompt 引导或 LLM 改写后重试。弱点三:挑战集与 CER 集全部用 TTS 合成音频做评估(只取文本自行合成),与真实人声听感存在分布差距;应补充人类 MOS 与自然度盲测。弱点四:12 个固定音色由 OmniVoice Voice Design 生成,作者在脚注承认可能偶然接近真人音色,缺乏声纹伦理审查流程;建议加入说话人验证与名人音色黑名单筛查。弱点五:前端改写依赖 DeepSeek-V4-Flash 的泰语能力,改写错误会直接成为训练目标,管线缺少对改写本身的质检环节。
未来方向
作者明确提出的方向:改进采样与选择策略,把 best-of-$K$ 展示的 15.1 个百分点上限($K=118$ 时 87.9% 对 $K=1$ 的 72.8%)转化为可部署的训练目标;针对教师语料欠表示的表达(未见词在 $K=118$ 时覆盖率仍只有 66%)扩充数据覆盖;结合神经与规则方法处理泰语上下文相关的分词与 G2P;构建完整的依善方言评估集以验证自然度与方言忠实度。基于成果可延伸的方向:把 oracle best-of-$K$ 换成可部署的自动选择器(用同一 CTC 验证器做无 oracle 的 best-of-$N$ 路由);对困难词过采样或设计课程学习缓解频次相关($\rho=-0.437$)的采样难度;将该范式推广到其他声调语言与低资源方言;混合多个异构教师以互补覆盖盲区;对 82M 学生做 int8/int4 端侧量化并报告真实设备时延;建设泰语 MOS 基础设施与重音、语调轮廓等更丰富的韵律指标。
复现评估
复现条件较好:Wayu-Paxa-TTS-Edge 模型与 Thai-TTS-Eval 评估框架均已开源;教师 OmniVoice(k2-fsa/OmniVoice)、学生骨干 Kokoro-82M、过滤用 wav2vec2-large-xlsr-53-th、评估用 Typhoon Whisper Large V3 与 ECAPA 声纹模型均为 HuggingFace 公开权重,WangchanThaiInstruct、LibriTTS、TLTK 皆可获取。算力门槛适中:82M 学生仅训 8 个 epoch、有效批大小 8,多卡消费级环境即可。难点有三:其一,停顿评估的位置掩码依赖 gemini-3.1-pro-preview API,前端改写依赖 DeepSeek-V4-Flash,需外部 API 配额;其二,挑战集与停顿指标的构造细节在附录 A.1/A.2,需按文复刻并处理泰语文本归一化;其三,泰语低声调 token 扩展与双语前端路由需要工程适配。总体属中等难度复现:核心管线可离线完成,但完全对齐数字需仔细复现文本处理细节。
论文图表