合成数据能带泰语OCR走多远:受控文档重建分析与零真实标签的Wayu-Paxa-OCR-Zero How Far Can Synthetic Data Take Thai OCR?
受控重建揭示合成OCR数据迁移关键,零真实标签训练出超越Typhoon 7B的泰语OCR模型
前置知识
字符错误率 (CER)
衡量OCR质量的核心指标:$ ext{CER}=?rac{ ext{编辑距离}}{ ext{参考字符数}}\times 100\%$。论文同时报告两种聚合:Median(逐页CER的中位数,反映典型页面表现,对灾难性失败不敏感)与 Mean(总编辑距离除以总参考字符数,相当于按页长加权,会被严重失败页面放大)。
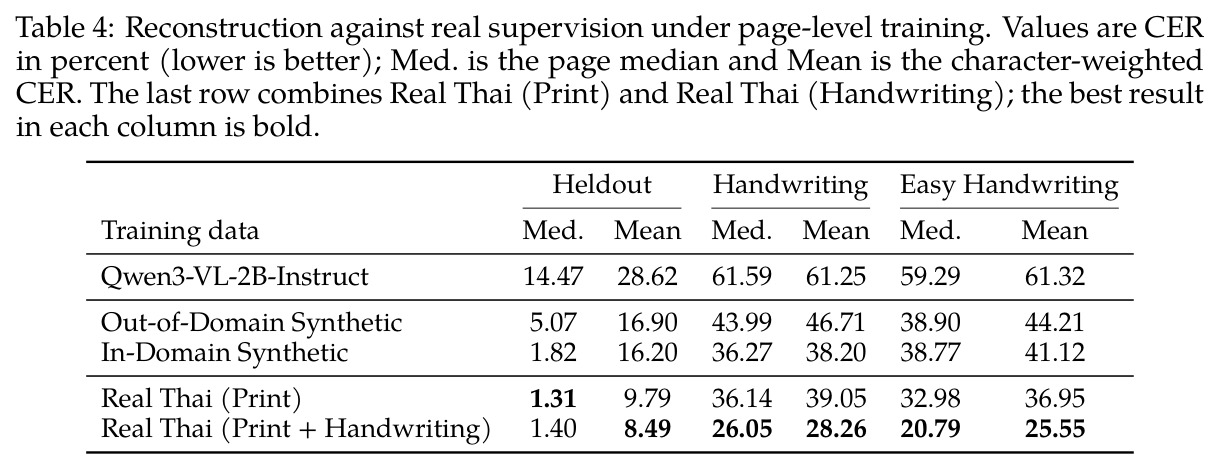
全文所有结论都用这两个数字表达,例如域内合成在Heldout上中位数1.82%接近真实的1.31%,但Mean 16.20%远差于9.79%——不理解两种聚合的区别就无法读懂表格背后的故事。
页面级与裁剪级训练
VLM-OCR的两种训练粒度。页面级把整张文档图喂给模型,一次推理输出全文与区域结构,模型可见完整上下文;裁剪级先用布局检测器(如PP-DocLayoutV3)切出区域再逐一识别,是GLM-OCR、PaddleOCR-VL等两阶段系统的做法,可见上下文被裁剪到单个元素。
本文最重要的发现是源域匹配的收益随训练粒度反转(页面级域内更优、裁剪级域内更差),所有消融都在两种设置下重复,不掌握这对概念就抓不住论文主线。
原地文档重建
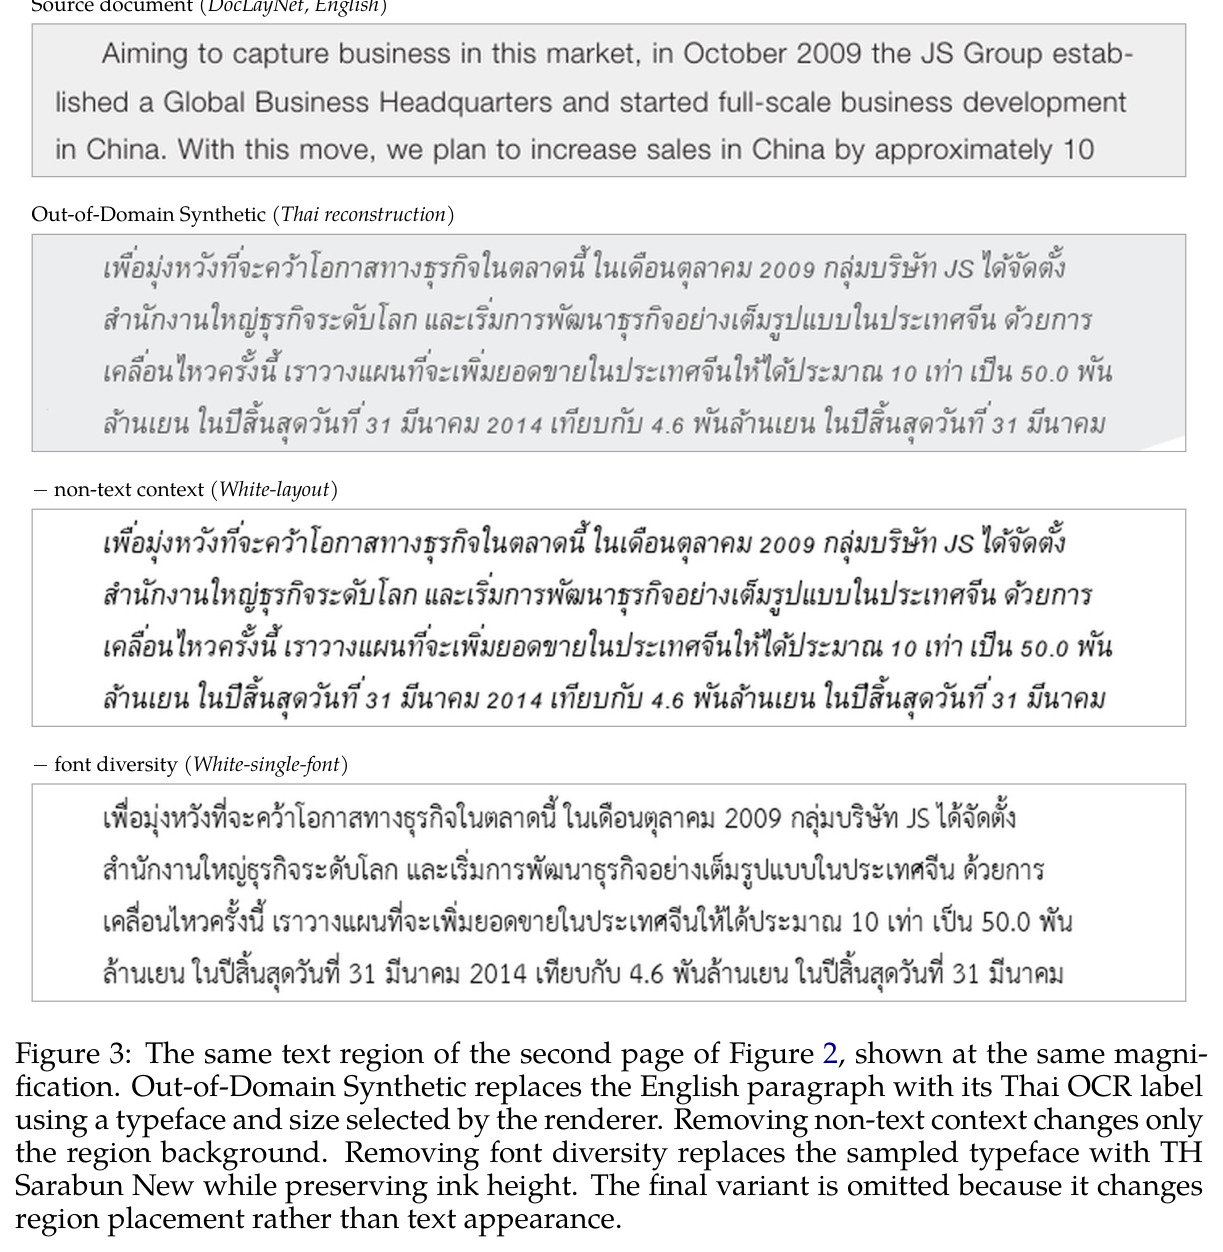
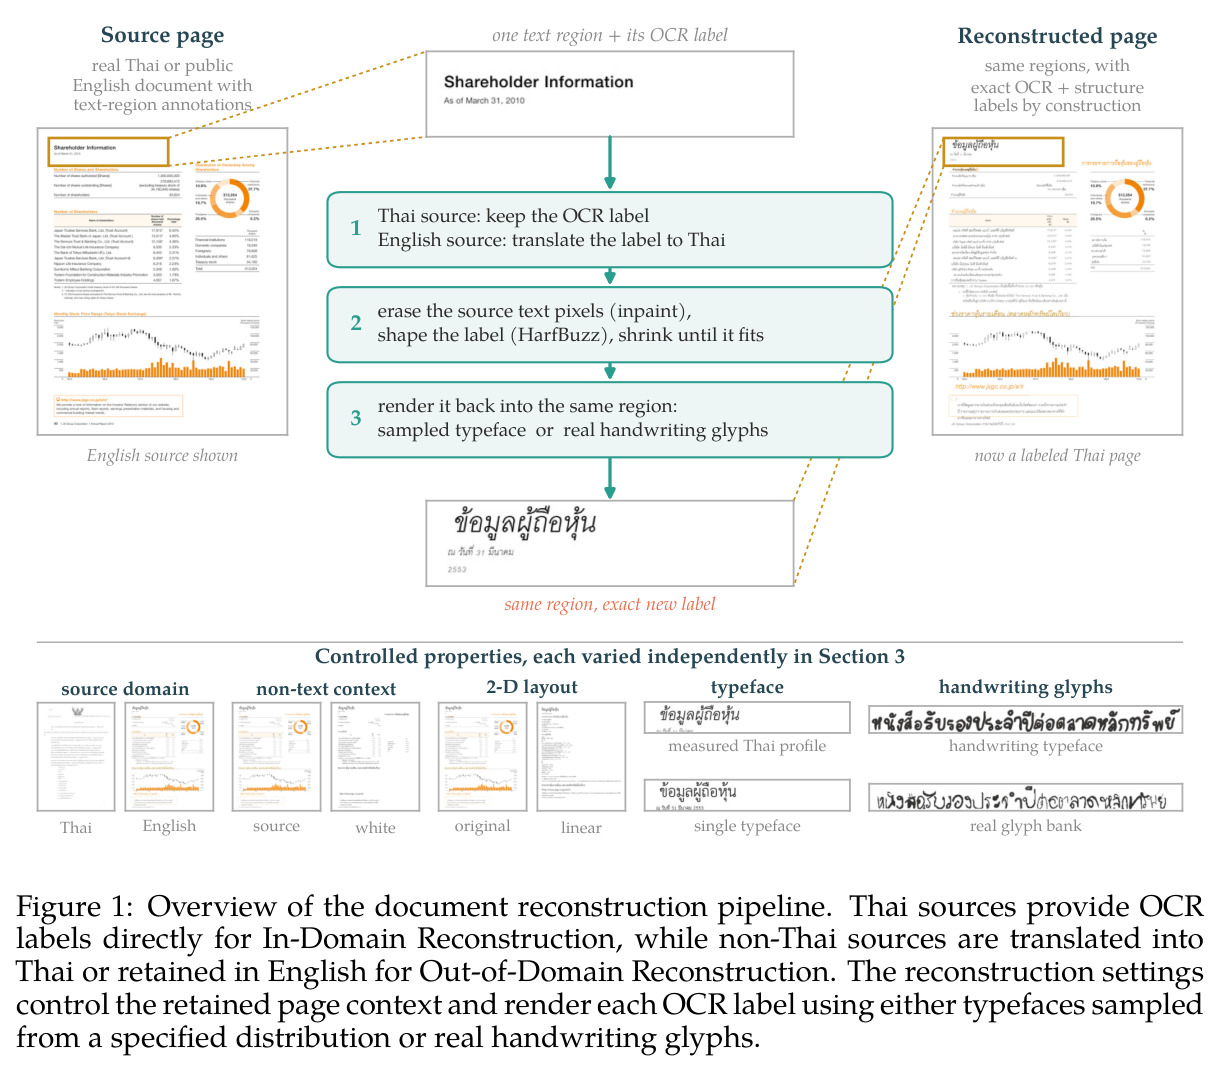
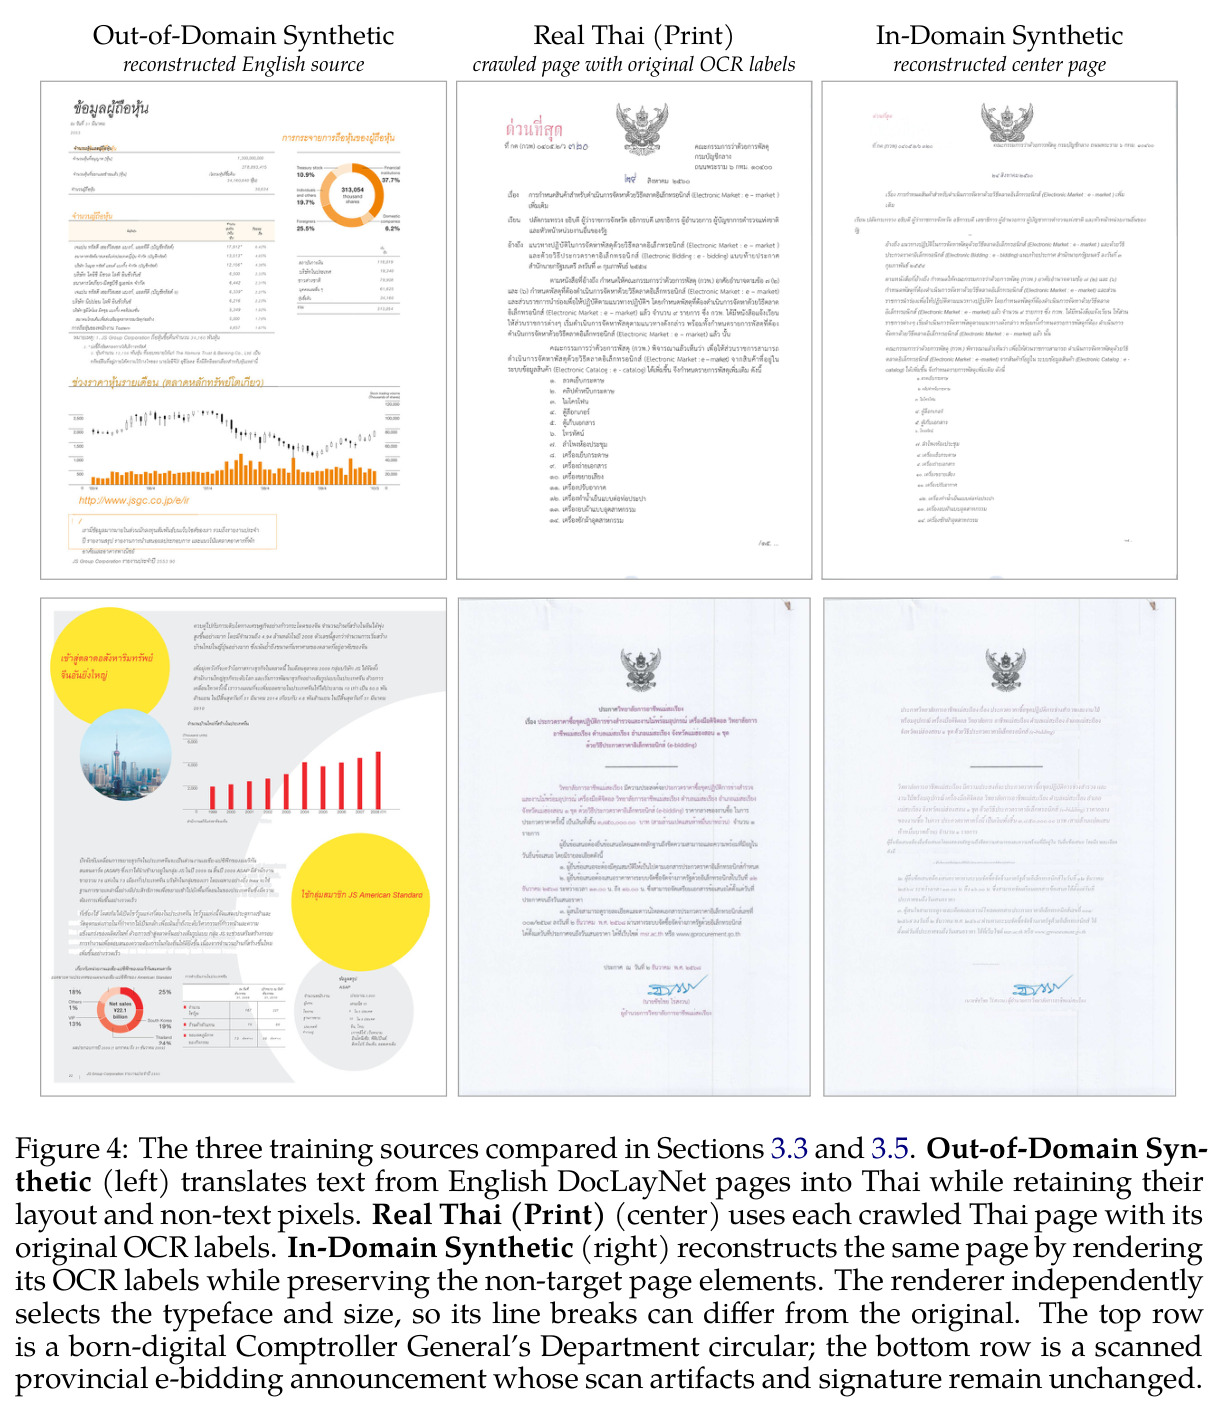
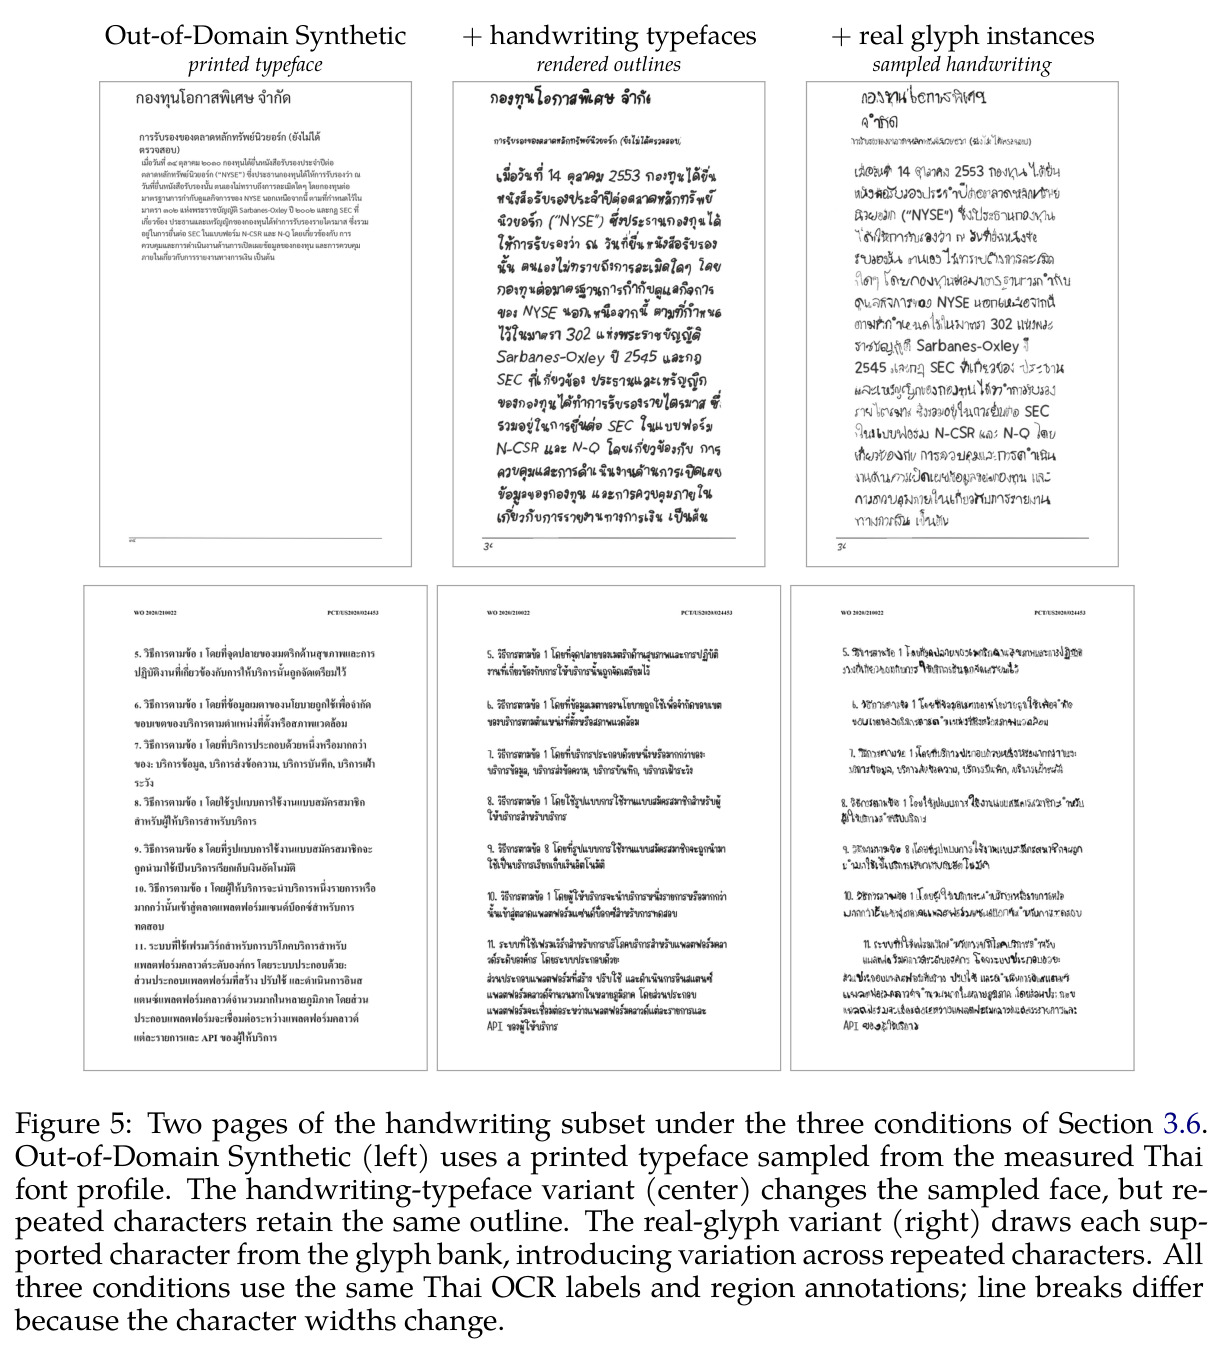
论文的合成数据生成方式:保留源页面的区域几何、元素类别与阅读顺序,把原文字像素擦除,再将OCR标签整形后缩放渲染回原区域。标签与区域一一对应且由构造保证,因此合成页天然拥有像素级精确监督,无需任何人工标注。
它是全文方法的基石:受控实验的每个变体和最终模型45,723页训练数据都由这条流水线产生。
文本整形
把Unicode码点序列转换为带定位信息的字形序列的排版步骤,由HarfBuzz等库完成。泰文尤其依赖它:元音与声调符号可叠放在基线上下多个层级,不做整形而逐字符渲染会使组合符号错位、文字不可读。
论文的渲染模块先用HarfBuzz整形完整区域标签、再逐步缩小字号适配原区域,这直接决定了泰语元音/声调叠放的正确性与合成页的可用性。
合成到真实的迁移
指用合成数据训练的模型在真实数据分布上的泛化能力。合成数据标签精确、规模可控,但与真实页面存在域差距。已有工作(版面感知印度语系页面、满文词图、跨语言阿拉伯语重建、退化感知历史页面)各自同时混入多种生成因素,迁移究竟来自版面、字体还是其他因素始终无法归因。
整篇论文的目的就是把这个黑盒拆开:每次只动一个生成因素,量化其对真实泰语页面CER的贡献。
研究动机
开源OCR模型、数据集与基准高度集中在英文和中文,泰语这类文档量大但可靠标注稀缺的语言被边缘化。泰文字形系统独特,无法从英文/中文模型直接迁移;PDF文本抽取与OCR伪标签常丢字符、打乱组合符号顺序、破坏阅读顺序;人工校对成本高昂。开源泰语前沿由Typhoon OCR定义,其2B的v1.5达到SOTA并可与更大的专有系统竞争,但其训练管线把传统OCR、VLM重构与策划合成数据打包在一起,无法隔离合成监督的真实贡献。此前的合成OCR迁移工作(版面感知印度语系页面、满文词图、跨语言阿拉伯语重建、退化感知历史页面)都同时变动多个生成因素,迁移究竟来自版面、非文本上下文、字体还是训练粒度,始终没有受控答案。
本文的目标是论文要回答一个核心问题:合成数据能把泰语OCR带到多远?具体分三步:一是建立可控的文档重建流水线,在保留源页面几何结构的前提下原位替换文字,从而独立操纵源域、非文本上下文、二维版面、字体分布、手写笔迹来源五个因素;二是用Qwen3-VL-2B-Instruct在页面级和裁剪级两种粒度下做对照实验,在打印体Heldout(301页)与手写体Handwriting/Easy Handwriting(各200页)上以Median/Mean CER量化每个因素的贡献,并与约34,000页真实泰语打印监督对比合成监督的逼近程度;三是把实验结论提炼成训练配方,用它把0.9B的PaddleOCR-VL-1.6改造成完全不使用任何真实泰语OCR标签的Wayu-Paxa-OCR-Zero,与Typhoon OCR 7B/1.5和Gemini 3.7 Flash正面对比,验证纯合成训练的竞争力。
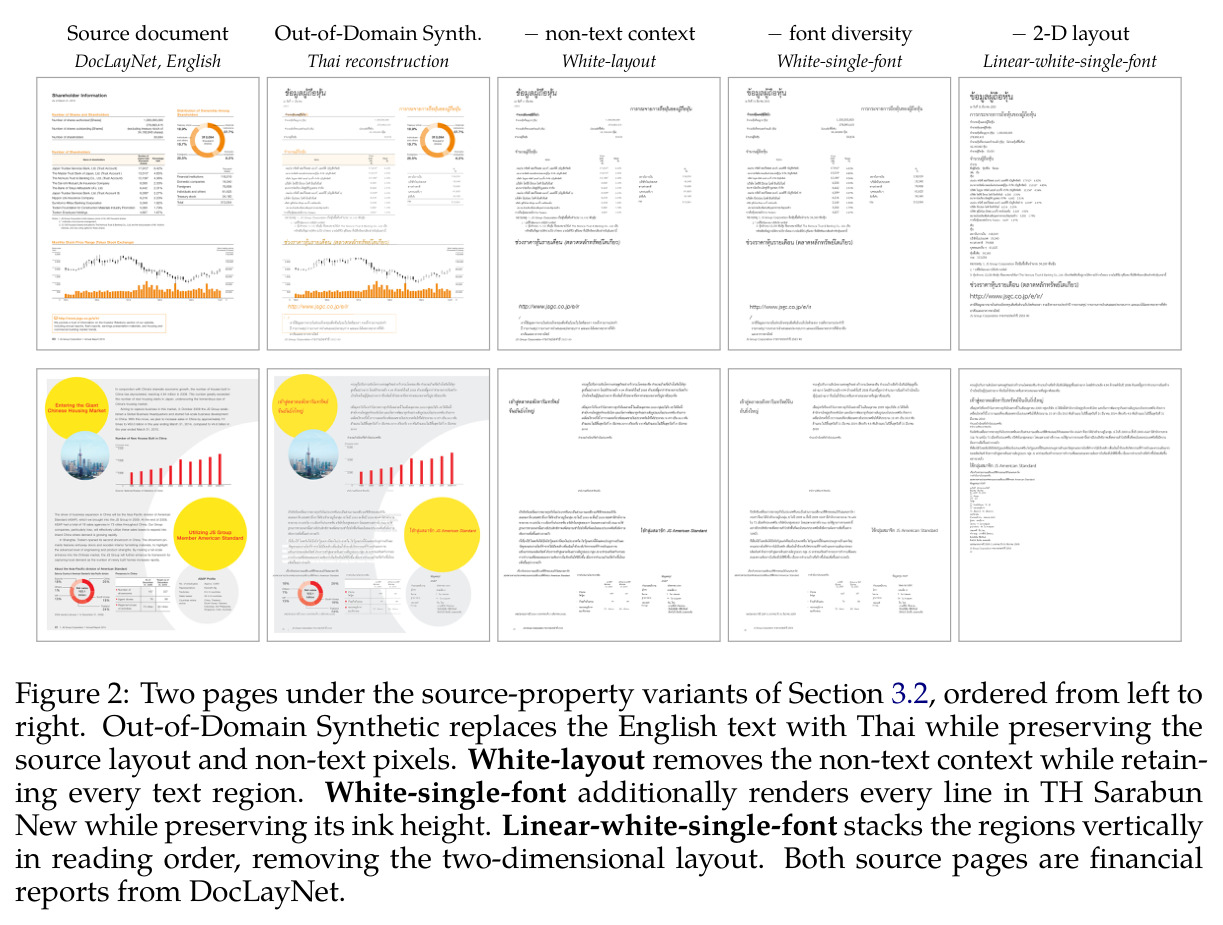
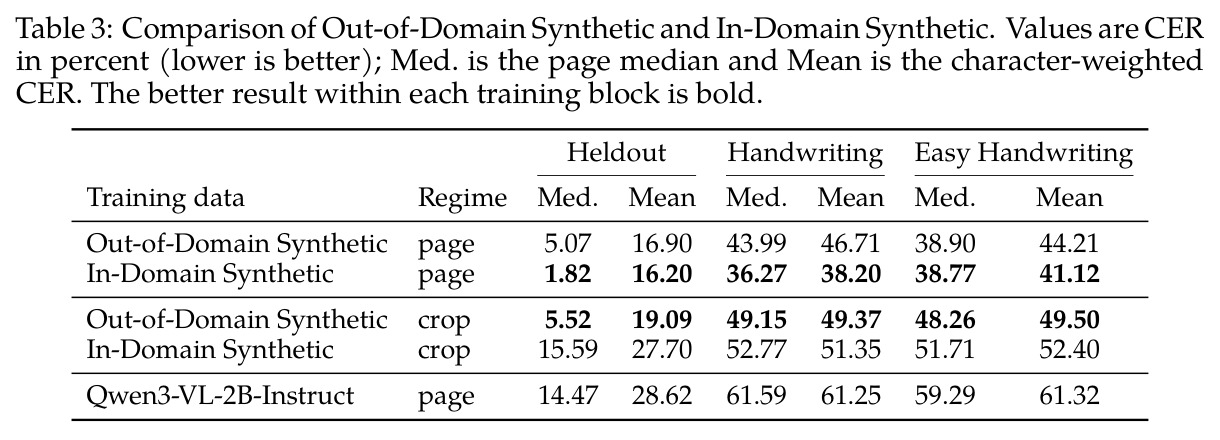
与已有工作不同的是,本文的独特切入是'受控归因'而非'又一个合成配方':不是同时堆砌版面、字体、退化增强,而是每次只动一个旋钮——非文本上下文(换白底)、字体多样性(单一字体)、二维版面(区域线性堆叠)、源域(英文DocLayNet/Crello/PubTabNet 对比 真实泰语页)、手写来源(手写风格字体 对比 真实笔迹字形库)——从而把'真实感'这个笼统概念分解成可单独测量的成分。另一个长期被忽视的维度是训练粒度:论文发现同一份数据在不同粒度下结论会反转(域内重建页面级中位数CER 1.82%优于域外5.07%,裁剪级却恶化到15.59%对5.52%),这为不同系统论文间互相矛盾的合成数据经验提供了一个统一解释框架。
核心方法
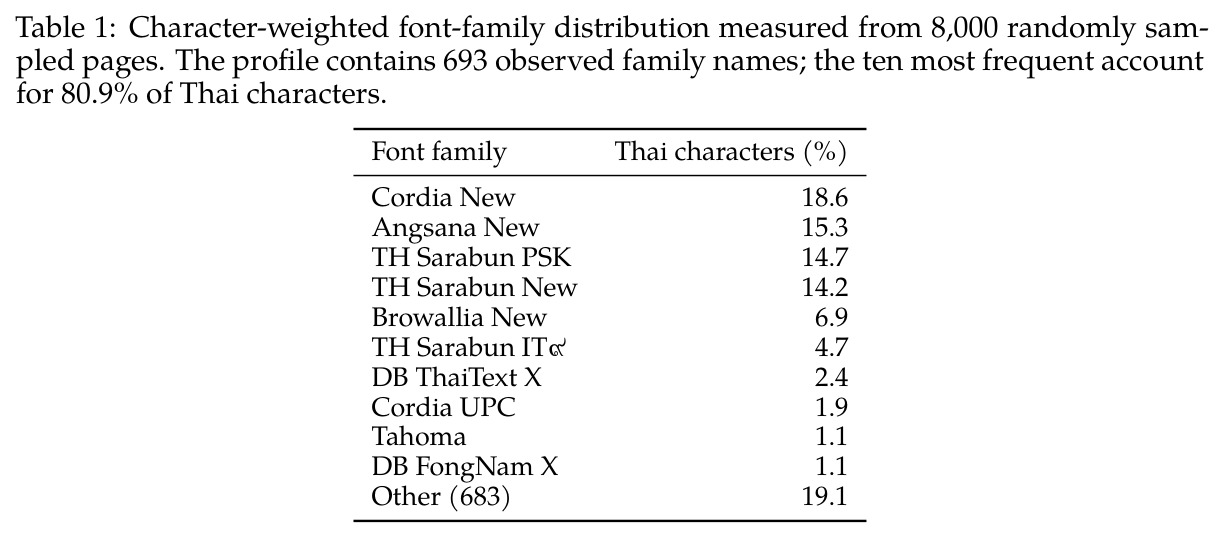
方法的直觉是:若能把一张已有文档的文字'原位换字',新页面就自带像素级精确的OCR标签,且版面、背景、噪声等其余一切保持不变,于是任何识别性能差异都能归因到被改变的那一个因素。技术路线分两段。第一段是重建流水线:取带文本区域标注的源页(泰语直接用原OCR标签;英语DocLayNet/Crello/PubTabNet的标签多数翻译成泰语),擦除原文字像素,用HarfBuzz对完整区域标签整形后适配回原区域——先独立采样字体和字号,再逐步缩小直到放得下,最小可接受字号仍溢出则整页丢弃;渲染时从测量得到的693个泰文字体族分布(来自8,000页公共PDF,前10族覆盖80.9%字符,Cordia New占18.6%)或约6,000实例、76类的真实手写字形库中采样。第二段是受控实验与规模化:用Qwen3-VL-2B分别在页面级/裁剪级训练各消融变体并报告Median/Mean CER,再把有效配方放大到45,723页合成数据,全参微调PaddleOCR-VL-1.6得到Wayu-Paxa-OCR-Zero,推理时由PP-DocLayoutV3提供区域。
核心创新是'一次只变一个因素的原地重建'。与Typhoon把传统OCR、VLM重构、策划合成数据打包的管线不同,也与此前的合成OCR工作(同时更换版面+字体+退化)不同,本文的流水线保留源页面的区域几何、元素类别和阅读顺序,只替换文字内容,使标签由构造保证正确;随后把源域、非文本上下文、二维版面、字体分布、手写笔迹来源设计成互相独立的开关。由此得到两个此前无人报告的结论:其一,迁移的关键因素是字体多样性、二维结构和真实笔迹变化,非文本上下文几乎没有一致作用;其二,源域匹配的价值取决于训练粒度——页面级下域内重建接近真实打印监督(中位数CER 1.82%对1.31%),裁剪级下域内重建反而大幅劣于域外(15.59%对5.52%)。这一反转说明'什么合成数据有效'不能脱离模型可见的上下文范围来谈,是全文最具启发性的洞见。
方法步骤详情
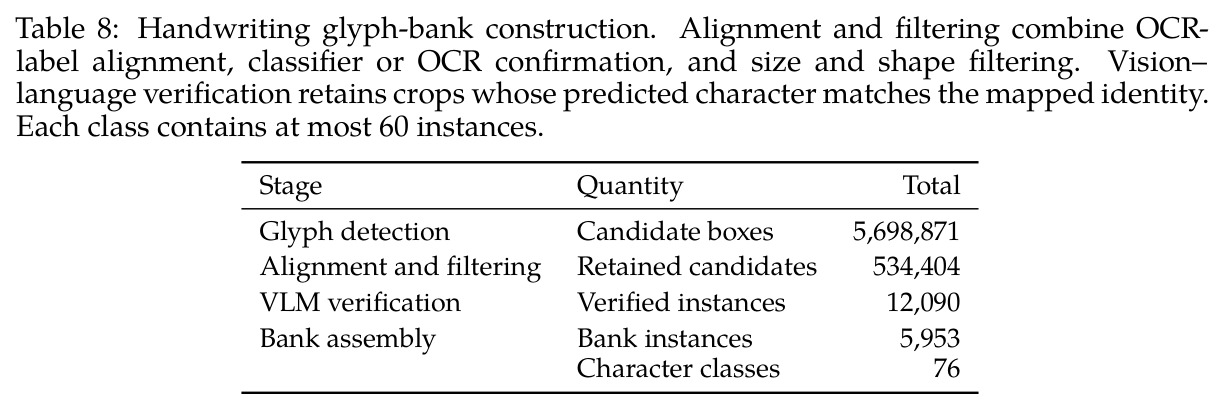
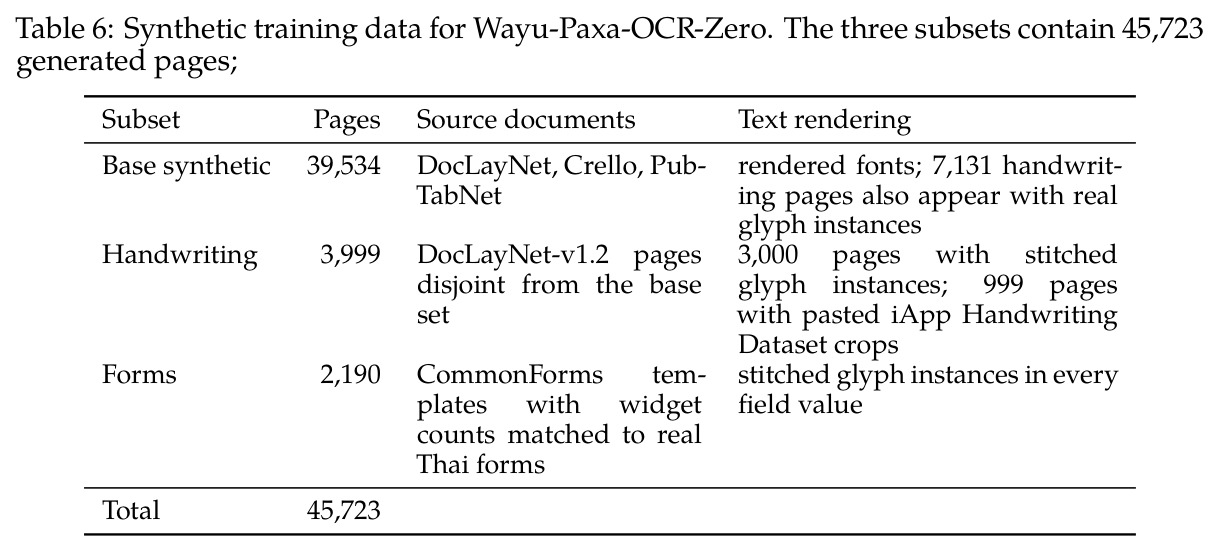
第一步,准备源页:真实泰语打印页约34,000页(公共PDF与Common Crawl的政府文件、表单、扫描件),真实手写笔记本页约4,000页;域外来源用DocLayNet、Crello、PubTabNet的英文页。第二步,获取标签:泰语区域直接用OCR标签;非泰语区域多数翻译成泰语,保留7.61%英文页模拟真实语料比例。第三步,擦除与渲染:inpaint原文字像素,HarfBuzz整形区域标签,按测量的字体分布采样字体、逐步缩小字号直到适配原区域(仍溢出则弃页);手写变体从字形库逐字符独立采样真实笔迹,不支持的字符回退字体渲染。第四步,受控消融:依次去掉非文本上下文(换白底)、字体多样性(单字体)、二维版面(线性堆叠),在页面级与裁剪级分别训练Qwen3-VL-2B一个epoch(AdamW,学习率$3\times10^{-5}$,余弦调度)。第五步,评估:在Heldout/Handwriting/Easy Handwriting上用模糊对齐把预测投影到评估区域后计算Median与Mean CER。第六步,规模化:按结论组装45,723页(基础39,534+手写3,999+表单2,190),全参微调PaddleOCR-VL-1.6一个epoch。
技术新颖性
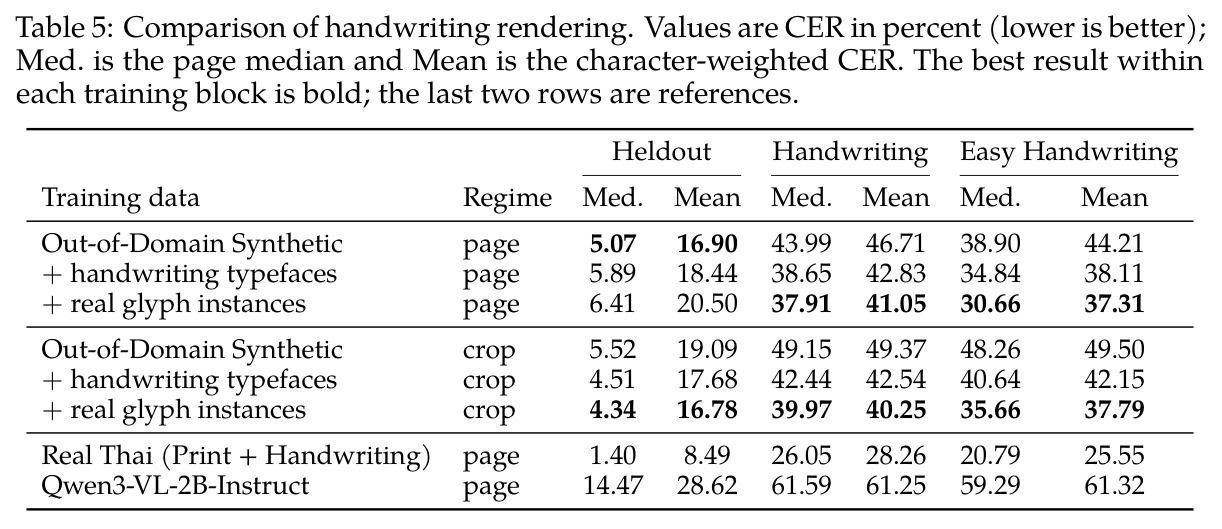
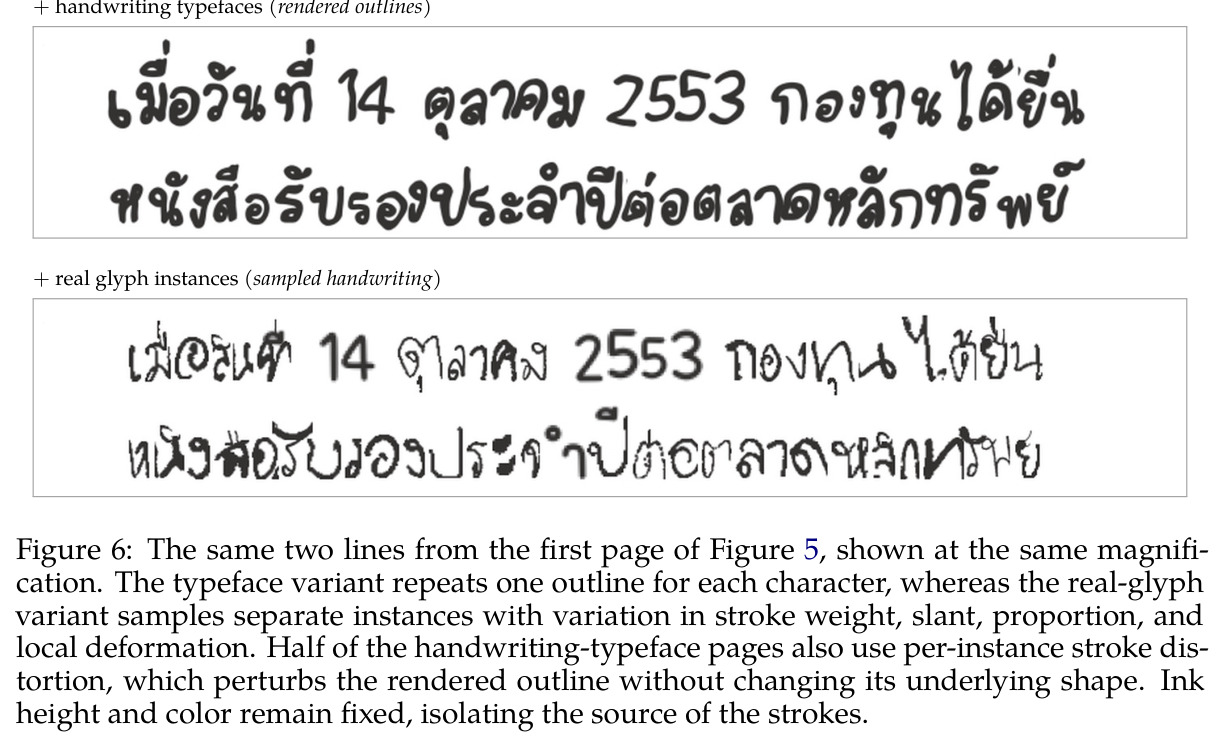
新颖性体现在四个层面。数据构造上,原地重建同时做到'标签精确'与'因素可控':传统合成OCR要么整页生成(标签易错),要么裁剪拼接(丢失版面),本文保留源页几何因此标签由构造正确,又因其余属性全部冻结,任何CER变化都可干净归因。实验设计上,首次把训练粒度作为变量纳入合成数据消融,发现域内重建收益随页面级/裁剪级反转的现象(1.82%优于5.07% 对 15.59%劣于5.52%),为领域内互相矛盾的经验提供了新解释维度。渲染技术上,真实手写字形库(iApp数据集+手写训练集,76类约6,000实例,逐字符独立采样使重复字符笔画不同)被证明优于手写风格字体:仅改变笔画来源,Easy Handwriting中位数就从34.84%降到30.66%。工程结果上,45,723页纯合成监督让0.9B模型在全部五个评测集上超过7B的Typhoon OCR(如ThaiOCRBench 15.3对30.6),证明'小模型+对的合成数据'可以替代'大模型+真实标注'的部分价值。
实验结果
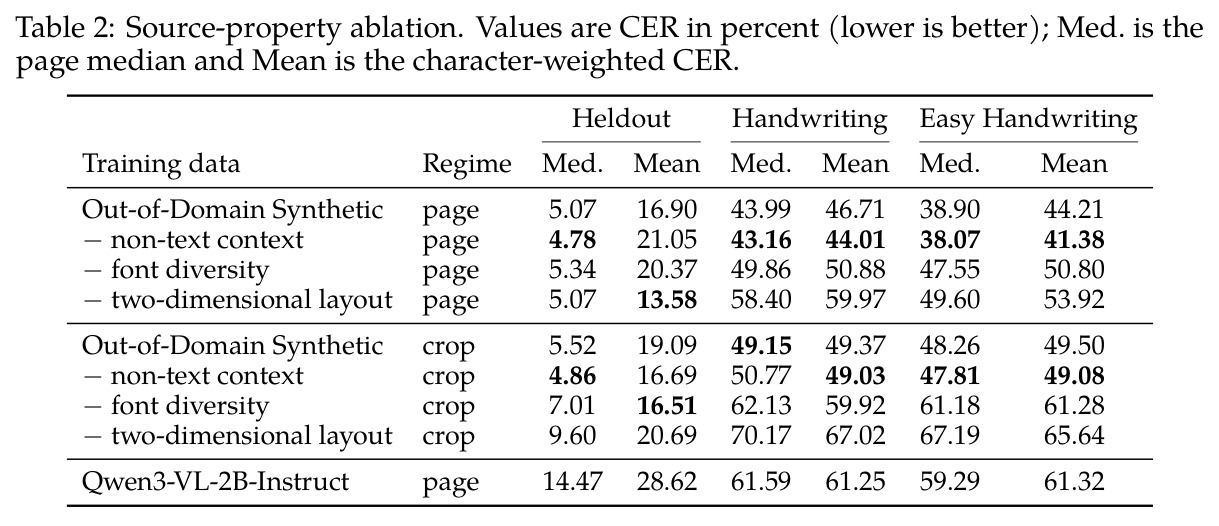
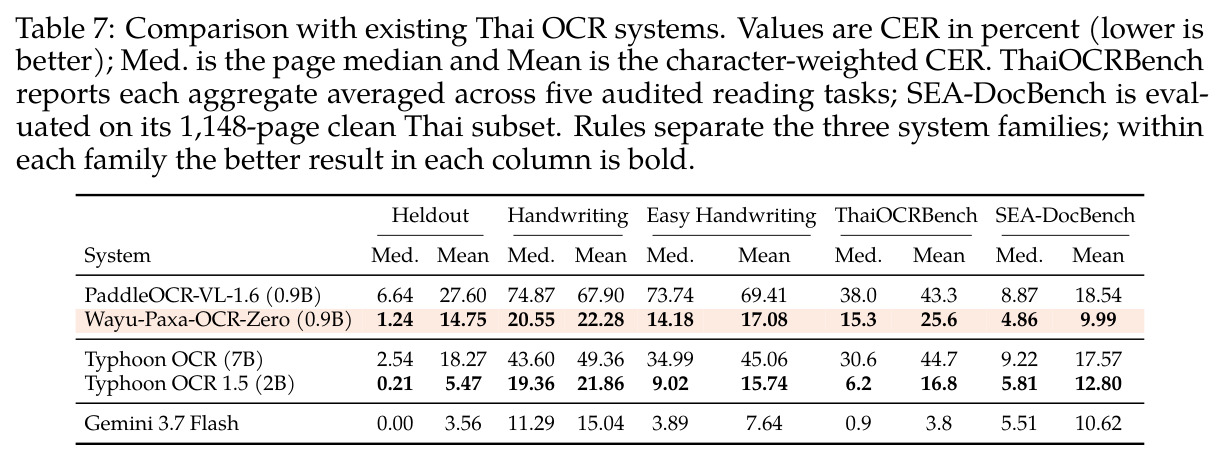
证据链由五组实验构成。(1)源属性消融(Table 2):去掉非文本上下文,各设置中位数CER变化不超过1.62个点,背景与噪点几乎不影响迁移;去掉字体多样性使手写集中位数上升6.70–13.37个点(页面级43.99→49.86,裁剪级49.15→62.13),打印体Heldout只动0.56–2.15个点;再拍平二维版面,手写恶化到58.40/70.17,裁剪级Heldout从7.01升至9.60。(2)源域对比(Table 3):页面级下域内重建把Heldout中位数从5.07降到1.82、手写从43.99降到36.27;裁剪级下完全反转,域内15.59对域外5.52。(3)逼近真实监督(Table 4):域内合成1.82%中位数接近真实打印的1.31%,但Mean为16.20%对9.79%,长尾仍在;手写上域内合成(36.27)≈真实打印(36.14),须加真实手写监督才到26.05/20.79。(4)手写渲染(Table 5):手写字体、真实字形逐级改善所有手写指标(Easy页面级38.90→34.84→30.66),但页面级Heldout从5.07升至5.89/6.41。(5)最终模型(Table 7):微调后Heldout中位数6.64→1.24、Handwriting 74.87→20.55、Easy 73.74→14.18、ThaiOCRBench 38.0→15.3、SEA-DocBench 8.87→4.86,五集全部超过Typhoon OCR 7B,但仍落后Typhoon 1.5 2B(Heldout 0.21)与Gemini 3.7 Flash(Handwriting 11.29)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 打印体泰语页识别(内部 Heldout,301页) | 中位数 CER(越低越好) | 1.24% | 基座 PaddleOCR-VL-1.6 6.64%;Typhoon OCR 7B 2.54% | 较基座相对下降约81.3%,同时优于7B的Typhoon OCR,但落后Typhoon 1.5 2B(0.21%)与Gemini 3.7 Flash(0.00%) |
| 手写泰语页识别(Handwriting,200页) | 中位数 CER(越低越好) | 20.55% | 基座 74.87%;Typhoon OCR 7B 43.60%;Typhoon 1.5 2B 19.36% | 较基座下降54.32个百分点,几乎追平2B的Typhoon 1.5(差1.19个点),大幅超过7B |
| 易读手写识别(Easy Handwriting,200页) | 中位数 CER(越低越好) | 14.18% | 基座 73.74%;Typhoon OCR 7B 34.99%;Typhoon 1.5 2B 9.02% | 较基座下降59.56个百分点,仍落后Typhoon 1.5与Gemini(3.89%) |
| ThaiOCRBench(5类已审计阅读任务平均) | 中位数 CER(越低越好) | 15.3% | 基座 38.0%;Typhoon OCR 7B 30.6%;Typhoon 1.5 2B 6.2% | 较基座下降22.7个百分点,超过Typhoon 7B约一半,仍落后Typhoon 1.5与Gemini(0.9%) |
| SEA-DocBench 泰语干净子集(1,148页) | 中位数 CER(越低越好) | 4.86% | 基座 8.87%;Typhoon OCR 7B 9.22%;Typhoon 1.5 2B 5.81% | 五个评测集中唯一同时低于Typhoon 1.5(5.81%)与Gemini 3.7 Flash(5.51%)的项目 |
局限与改进
作者承认的局限:其一,裁剪级训练下域内重建反而变差(15.59%对5.52%)的机制不明,论文直言'原因尚不清楚,值得进一步研究';其二,合成监督在长尾上仍落后——Heldout的Mean CER 16.20%对真实监督9.79%,严重失败未被消除;其三,手写字形库只有5,953个实例,更大字形库的效果留待未来;其四,与独立系统的排名只证明竞争力,不证明合成数据本质上优于其他系统使用的真实监督。我的补充观察:三个内部评测集的参考标签由作者自己的评估管线构建,存在一定循环性且未公开,第三方难以核验;Wayu-Paxa-OCR-Zero的分数包含PP-DocLayoutV3的布局检测与阅读顺序错误,端到端比较混入了检测器因素;研究限于泰语的打印/手写两类文本,未评估表格、公式、印章等复杂元素;手写评测集与训练用手写数据来自同一采集渠道,真实世界手写多样性可能被低估;翻译生成的泰语标签自然度未经审计。
独立分析的弱点
第一,粒度反转缺乏机理解释:一个合理猜测是裁剪级模型只看到单区域,域内重建页保留的真实背景噪点、扫描伪影成为干扰,而域外的白净渲染反而更干净,但论文未做验证;改进方向是补一组'域内重建+白底'的交叉条件,并分析两种粒度下的梯度或注意力差异。第二,手写识别缺口仍然很大:Wayu-Paxa-OCR-Zero手写中位数20.55%,明显落后Gemini 3.7 Flash的11.29%;字形库规模(5,953实例、76类)与'逐字符独立采样导致笔画风格不连贯'是明显瓶颈;改进方向是建模书写者风格一致性(如风格向量条件化)、用扩散模型生成连贯手写页、系统性扩大字形库。第三,Mean与Median的巨大差距(如基座Heldout 27.60%对6.64%)暴露灾难性失败长尾,可引入难例挖掘、课程学习或针对性数据增广。第四,标签多数由英文机器翻译而来,泰语自然度存疑,可能限制模型的语言建模能力;可加回译一致性检查或母语者抽检。第五,核心评测集闭源,社区无法在同一基准上比较;应发布Heldout/Handwriting集合并接入ThaiOCRBench式的独立审计流程。
未来方向
作者提出的方向包括:弄清裁剪级下域内重建失败的原因;扩大手写字形库研究规模效应(当前仅5,953实例);把合成OCR范式推广到其他文档标注稀缺的语言。在此之上可以延伸:其一,把五个受控因素参数化为连续可调的'配方空间',用小规模代理实验自动搜索最优配比,替代手工消融;其二,研究合成数据规模律——CER如何随页数(45,723之外)、字体数(693族之外)、字形库大小缩放,判断收益何时饱和;其三,混合策略——只用极小比例(如1%)的真实标签校正合成数据的系统性偏差,可能以极低成本压掉Mean CER的长尾;其四,把原地重建扩展到表格结构、数学公式、印章、签名等元素,覆盖当前未评估的文档类型;其五,跨脚本泛化——泰文的组合符号系统与老挝文、高棉文、缅甸文同源,验证五个因素结论的可迁移性能把本文升格为低资源文字OCR的方法论;其六,与布局检测器联合训练或蒸馏,消除端到端分数中PP-DocLayoutV3带来的误差混淆。
复现评估
复现基础相当好:模型权重在HuggingFace公开(wayu-ai/wayu-paxa-ocr-zero),重建流水线以wayu-research/docaug开源;上游数据全部公开——DocLayNet、Crello、PubTabNet、CommonForms、iApp Handwriting、Common Crawl;基座PaddleOCR-VL-1.6仅0.9B参数,一个epoch、有效批16、学习率$3\times10^{-5}$,单节点多卡消费级GPU即可承担,实验模型Qwen3-VL-2B更小。难点有三:三个内部评测集(Heldout 301页、Handwriting/Easy Handwriting各200页)未公开,无法精确对齐论文数字,只能借ThaiOCRBench(15.3)与SEA-DocBench(4.86)间接核对;渲染所用主流字体多为Windows自带(Cordia New占18.6%、Angsana New 15.3%),商用需注意授权;英文→泰语翻译环节依赖的具体系统论文未说明。综合评估:方法级复现难度中等,指标级复现因评测集闭源而较难。
论文图表