SEAM:面向低资源语音合成的谱嵌入对齐与合并方法 SEAM: Spectral Embedding Alignment and Merging for Low-Resource TTS
DFT谱滤波+闭式岭回归做零音频词表初始化,省75%训练数据
前置知识
BPE 子词分解
字节对编码(BPE)把词拆成词表中已存在的高频子单元,例如英文单词可拆成若干常见片段的组合。TTS 与 LLM 处理新词的标准做法就是先查分词器、再组合子词嵌入。本文始终使用生成预训练词表 $V_{old}$ 的原 BPE 分词器,保证所有子词都属于旧词表,从而能仅凭旧词表自我监督地学习新嵌入的合并规则。
SEAM 的输入就是子词嵌入序列,校准数据的构造完全依赖旧词表的可分解性,这是方法成立的前提。
离散傅里叶变换(DFT)
DFT 把长度为 $m$ 的序列分解为一组复指数频率分量:第 $k$ 个系数 $\hat{S}(k)$ 的模是振幅、辐角是相位。低频分量对应缓慢、全局的变化,高频分量对应序列中的急剧跳变;对实序列而言相位信息编码了各成分在序列中出现的位置与时刻。
SEAM 的核心操作是对子词嵌入序列逐维做 DFT 再低通滤波,保留复系数相位正是其保持音序、区别于均值池化的机制来源。
高斯低通滤波
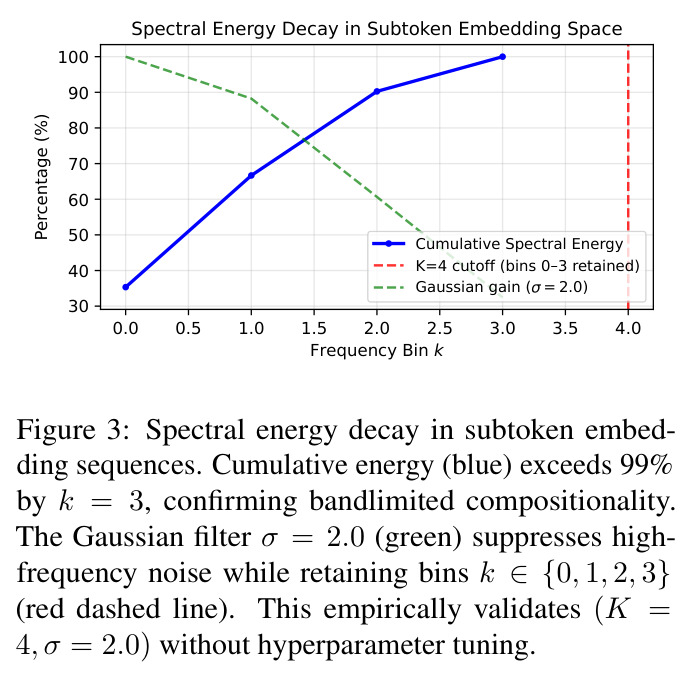
在频域对系数乘以高斯增益 $G(k)=\exp(-k^2/2\sigma^2)$,频率越高衰减越快。本文用它压制子词边界处的尖锐不连续(高频伪影),保留平滑的全局音素组合性(低频)。取 $\sigma=2.0$ 时 $G(1)\approx0.88$、$G(2)\approx0.61$、$G(3)\approx0.32$、$G(4)\approx0.14$,即第 4 个频率 bin 被压制 85% 以上。
论文实测子词嵌入轨迹的累计谱能量在 $k=3$ 处已超 99%(带限性),因此只保留 $K=4$ 个低频 bin 就足够,这是默认超参的依据。
岭回归闭式解
带 $L_2$ 正则的最小二乘回归,目标为 $\min_{W,b}\|XW^\top+1b^\top-Y\|_F^2+\lambda\|W\|_F^2$,解为 $(\tilde{X}^\top\tilde{X}+\lambda R)^{-1}\tilde{X}^\top Y$,一步矩阵运算即可求得,无需梯度迭代。本文用分块对角正则 $R=\mathrm{diag}(1,\dots,1,0)$ 免除对偏置项的惩罚,$\lambda=10^{-6}$ 仅起数值稳定作用。
SEAM 的投影参数 $W,b$ 靠它解析求出,是其零音频、免梯度、可复现性质的技术基础。
Lipschitz 连续性
若函数输出的变化量被输入变化量乘以常数 $L$ 所约束,则称其为 Lipschitz 连续。论文假设 1 声称条件 TTS 生成器对条件嵌入满足此性质:$E_z[\|\Phi_\theta(c_a,z)-\Phi_\theta(c_b,z)\|^2]\le L\|c_a-c_b\|^2$,即嵌入空间中的扰动会按比例映射为声学输出的扰动。
这是把'新嵌入在流形上构造得好'与'合成语音稳定不炸'联系起来的理论桥梁,是 SEAM 设计原则的出发点。
CER 与 WER
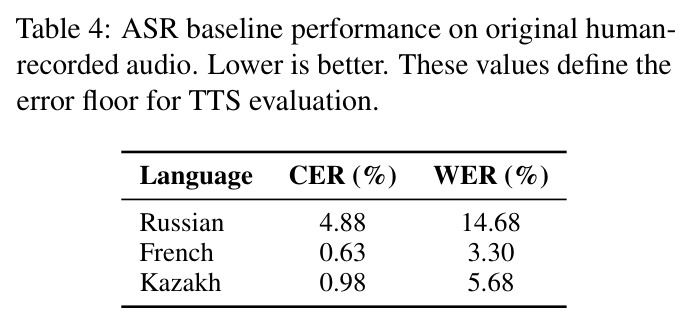
字符错误率(CER)和词错误率(WER)用预训练 ASR 模型转写合成语音后与参考文本对齐,统计替换、删除、插入的比例,是 TTS 可懂度的常用自动指标。本文用 NVIDIA FastConformer 系列 ASR(俄/哈/法语各一),并在真人录音上测出误差地板(俄语 CER 4.88%、法语 0.63%、哈萨克语 0.98%)供参照。
论文所有定量结论都建立在这两个指标上,解读时必须扣除 ASR 地板才能估计 TTS 本身的错误率。
研究动机
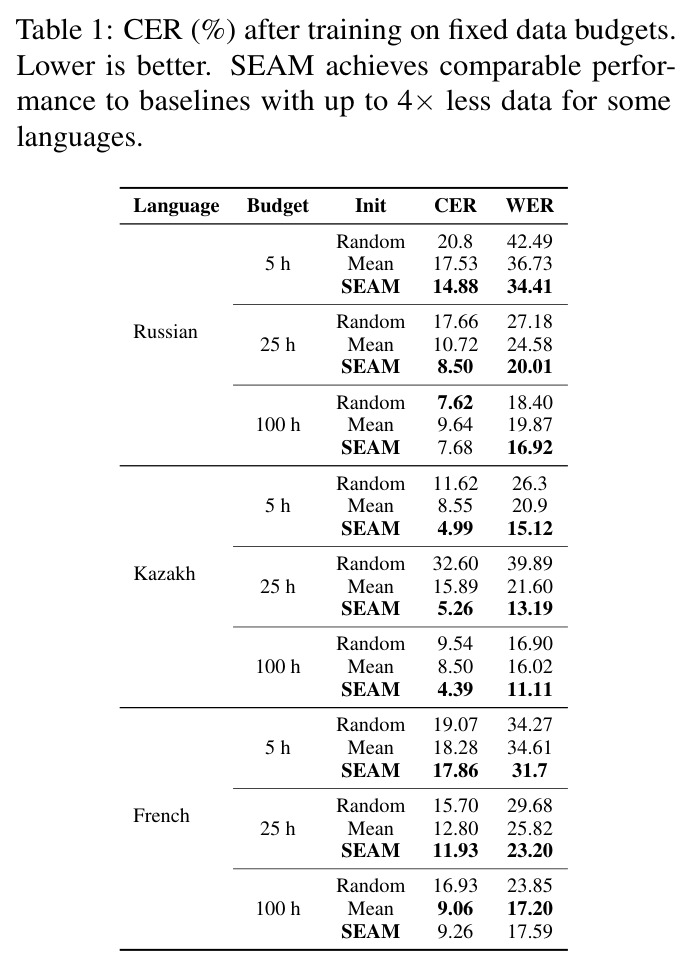
条件式 TTS 模型每新增一个未见词元(音素或字素)都需要在条件嵌入空间里配置一个对应向量,工程上的默认做法是随机初始化再用大量配对音频微调,这在目标语言数据稀缺或采集成本高的低资源场景下不可行。目前社区从语言建模借来的启发式方法是把新词元分解成已知 BPE 子词后对其嵌入取算术平均(Tikhomirov and Chernyshev, 2024),但均值池化是置换不变的,完全丢弃了语音合成所必需的时序发音结构与子词先后顺序,迫使模型在微调阶段从零重学序列结构,抬高样本复杂度。论文在三个语言上量化了这一瓶颈:5 小时预算下随机初始化的俄语 CER 高达 20.8%(WER 42.49%),均值池化也有 17.53%,哈萨克语随机初始化 CER 达 11.62%,均远差于合理初始化应达到的水平,加剧了语音技术在全球部署中的可及性鸿沟。
本文的目标是本文要为 llm-diffusion 架构的 TTS 模型构造一个'零音频'的新词元条件嵌入初始化方法:不需要任何目标语言配对音频、不需要梯度优化,仅凭预训练词表中已知子词的嵌入就能解析地合成出新嵌入。该嵌入需同时满足三条性质:(i) 在生成过程下稳定,避免早期微调阶段的分布漂移与声学伪影;(ii) 保留子词的时间音序结构,与置换不变的均值池化形成本质区别;(iii) 与预训练条件流形对齐,嵌入的范数与几何位置匹配原有分布。量化目标是在固定训练预算(5h/25h/100h)下取得低于随机初始化与均值池化的 CER/WER,最终实现 4 倍数据缩减(节省 75% 训练数据),并能优雅扩展到至少 1000 个新词元而不显著退化。
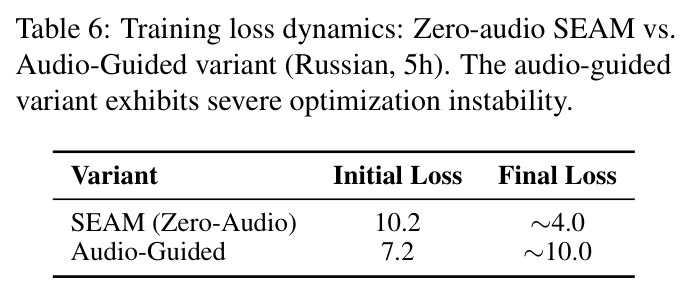
与已有工作不同的是,已有跨语言与低资源 TTS 研究集中在模型级适配:零样本多说话人迁移(YourTTS 的外部说话人编码器)、跨语言音素共享(Huang et al., 2022b)、元学习快速说话人对齐(Meta-TTS)等。这些方法默认能拿到足够的目标语言数据做嵌入对齐,或在数据极稀缺时梯度优化不稳定,因此都绕开了'词表扩展的初始化'这一基础步骤。SEAM 的独特切入角度是把这个被忽视的步骤当作独立问题:把子词嵌入序列看作离散信号而非集合,用信号处理工具(DFT 加高斯低通滤波)做保持顺序的合并,再用闭式岭回归把结果投影回预训练条件流形,全程无梯度。作者明确指出没有先验工作提出面向自回归 transformer TTS 词表扩展的初始化方法,而附录 B.7 的消融进一步表明:用 1 小时目标语言音频精调新嵌入反而导致训练损失从 7.2 飙升到 15.0,最终收敛到约 10.0,远差于零音频 SEAM 的约 4.0,证明零音频不是妥协而是刻意的设计选择。
核心方法
直觉是把'新词嵌入应该长什么样'变成一个可从旧词表自我监督学习的回归问题。对旧词表中每个可分解的词 $t$,用原 BPE 分词器拆出子词序列 $\{s_1,\dots,s_m\}$,嵌入矩阵 $S$ 作输入、原嵌入 $E(t)$ 作目标,构成训练对。SEAM 先对每维嵌入沿子词序列做 DFT,用高斯低通滤波 $\tilde{S}_j(k)=\hat{S}_j(k)\cdot e^{-k^2/2\sigma^2}$ 只保留前 $K_{eff}=\min(K,\lfloor m/2\rfloor+1)$ 个频率 bin(默认 $K=4$、$\sigma=2.0$),将实虚部展平为谱特征 $\phi(S)\in\mathbb{R}^{2Kd}$,再用线性读出 $\Psi(S)=W\phi(S)+b$ 得到新嵌入。$W,b$ 由岭回归 $(\tilde{X}^\top\tilde{X}+\lambda R)^{-1}\tilde{X}^\top Y$ 闭式求解($\lambda=10^{-6}$),最后归一化到预训练嵌入的平均范数。Figure 3 显示子词嵌入轨迹累计能量在 $k=3$ 处已超 99%,证明其本质带限,$K=4$ 截断无需调参即可覆盖绝大部分信息,同时天然压制子词边界的高频伪影。
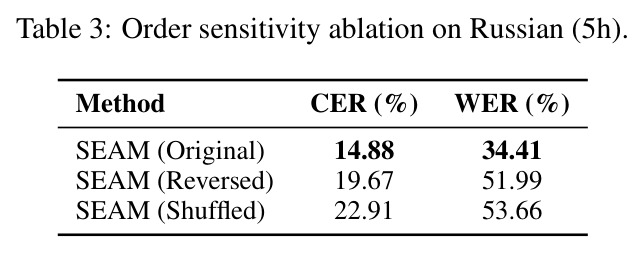
核心创新有两条。第一,把子词嵌入序列当作离散信号而非集合:DFT 复系数天然携带相位信息,相位直接编码时间进程,因此合并算子是序敏感的。命题 1 给出充分条件:只要存在一个被保留的非 DC 频率 bin 满足反转不对称性 $e^{-2\pi ik(m-1)/m}\hat{S}_j[k]^*\neq\hat{S}_j[k]$,且投影矩阵 $W$ 不湮灭该特征差值,就有 $\Psi(S^{rev})\neq\Psi(S)$,即倒序输入必然产生不同输出。这从机制上区别于置换不变的均值池化。第二,闭式自校准:完全不用目标语言音频,只在旧词表上构造自监督对 $(S^{(i)}, c^{(i)}_{target}=E(t))$,用岭回归把谱特征解析地投影回预训练条件流形——最小化投影误差保证流形对齐,从有序子词序列学习保证序一致性,再借助 Lipschitz 假设(假设 1)把条件化误差的界传递为声学偏差的界。Table 3 的消融证实序保持是主要增益来源:打乱子词顺序使俄语 CER 从 14.88% 恶化到 22.91%,WER 从 34.41% 近乎翻倍到 53.66%。
方法步骤详情
流程分两阶段。阶段一(学习投影器):遍历旧词表 $V_{old}$,对每个可分解词 $t$ 收集自监督对——输入子词嵌入矩阵 $S^{(i)}\in\mathbb{R}^{m\times d}$,目标 $E(t)$;对每维 $j$ 计算 DFT $\hat{S}_j(k)=\sum_{n=1}^{m}s_n e^{-2\pi ik(n-1)/m}$,乘高斯增益 $G(k)=e^{-k^2/2\sigma^2}$(实测 $G(1)\approx0.88$、$G(3)\approx0.32$),保留前 $K_{eff}$ 个 bin 的实虚部展平为 $\phi(S^{(i)})$;堆叠成 $X\in\mathbb{R}^{N\times 2Kd}$、$Y\in\mathbb{R}^{N\times d}$,解闭式岭回归 $(W^{*\top},b^{*\top})=(\tilde{X}^\top\tilde{X}+\lambda R)^{-1}\tilde{X}^\top Y$,$R=\mathrm{diag}(1,\dots,1,0)$ 不惩罚偏置。阶段二(嵌入新词):非拉丁文字先用 transliterate/qazaq_transliterator 转成英语 IPA,再切分为 $V_{old}$ 内子词,计算 $c_{new}=W^*\phi(S_{new})+b^*$ 并归一化到原嵌入平均范数;随后照常微调——Chatterbox 0.5B 全参微调(AdamW lr $5\times10^{-4}$、有效 batch 64、1 epoch),VibeVoice 1.5B 用 LoRA r=128(lr $5\times10^{-5}$、3 epochs)。
技术新颖性
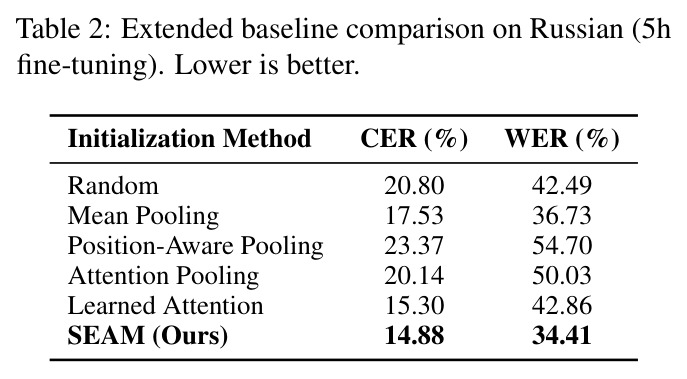
技术新颖性体现在三点组合。(1) 谱合并算子:首次把 DFT 低通滤波引入词表扩展的嵌入合并,利用复系数相位保持时序。与四类基线的对照说明了每个组件的必要性——均值池化置换不变;Position-Aware Pooling 有位置统计加岭回归但无谱滤波,CER 23.37%;Attention Pooling 用随机 query 无学习参数,CER 20.14%;Learned Attention 需要梯度训练,在 5 小时校准数据下欠收敛(与真值嵌入的余弦相似度低约 10%),CER 15.30%;SEAM 的 14.88% 证明谱滤波压制分词边界高频伪影才是关键。(2) 闭式自校准:完全解析求解,$\lambda=10^{-6}$ 跨语言跨架构固定、零超参搜索,CPU 上瞬时完成,与需要 AdamW 训练的注意力池化方法在极端低资源下形成数据效率差。(3) 理论支撑:用 Lipschitz 连续性假设把嵌入质量与声学稳定性形式化地连接,并给出序敏感性的充分条件证明(附录 A.2),这是语言建模嵌入传播类工作(如 LEAP)所不具备的'信号处理+回归+理论'组合。
实验结果
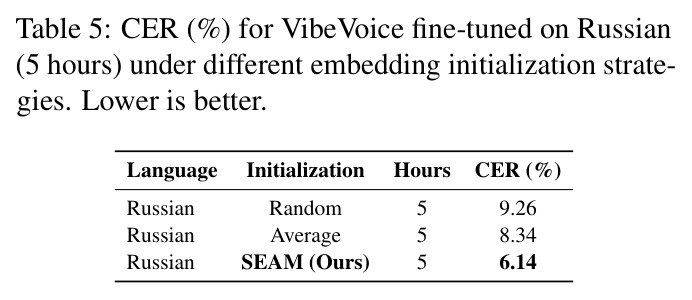
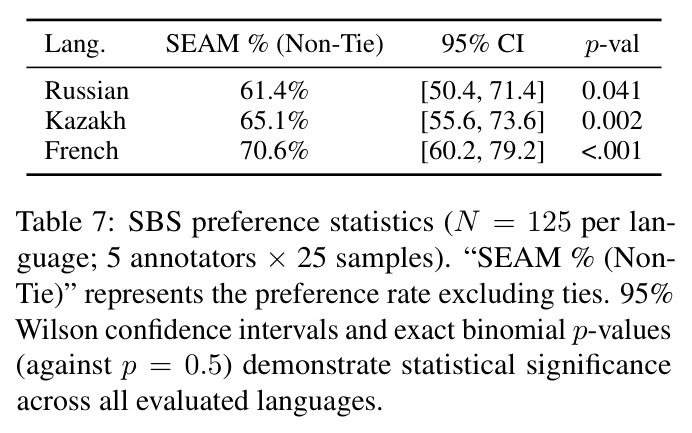
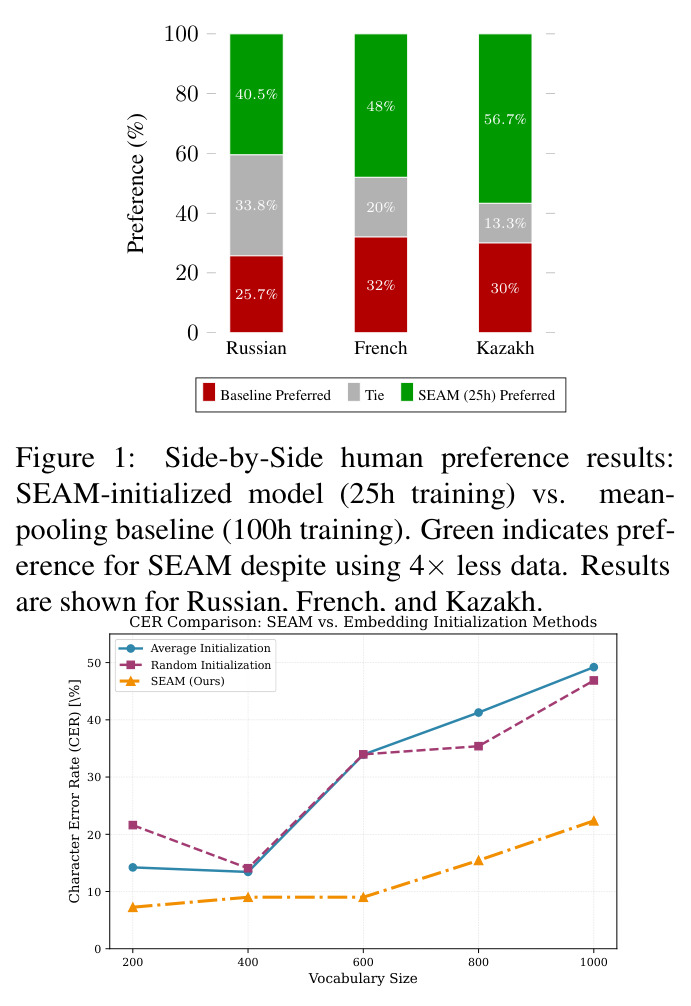
主实验(Table 1)在俄/哈/法三语、5h/25h/100h 预算上对比随机初始化、均值池化与 SEAM。25h 时 SEAM 相对均值池化的 CER 提升:俄语 2.22 点(10.72%→8.50%)、哈萨克语 10.63 点(15.89%→5.26%)、法语 0.87 点(12.80%→11.93%);相对随机初始化提升 9.16/27.34/3.77 点。SEAM 用 25h 即达基线 100h 水平(俄语 SEAM 25h 为 8.50%,Random 100h 为 7.62%),即 4 倍数据缩减;100h 时各方法收敛到 ASR 方差内,说明优势在样本效率而非渐近性能。扩展基线(Table 2,俄语 5h):SEAM 14.88%/34.41% 胜过 Learned Attention 15.30%、Attention Pooling 20.14%、Position-Aware Pooling 23.37%。序消融(Table 3):反转 CER 升至 19.67%(+4.79),打乱升至 22.91%(+8.03,WER 34.41%→53.66% 近乎翻倍),证实 DFT 相位编码的时序是增益主源。词表规模实验(Figure 2,|V_new| 200→1000、25h 微调):SEAM 平滑退化,随机/均值在超 500 词后急剧恶化。跨架构(Table 5,VibeVoice 俄语 5h):SEAM 6.14% 优于 Average 8.34%、Random 9.26%。人评(Table 7):SEAM(25h)对均值池化(100h)非平局偏好率俄 61.4%(p=0.041)、哈 65.1%(p=0.002)、法 70.6%(p<0.001)。B.5 划分消融显示稳健(哈萨克语 CER 均值 5.27%、σ=0.36)。B.7 消融:音频引导精调使损失从 7.2 飙至 15.0 后停在约 10.0,远差于零音频 SEAM 的约 4.0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 俄语 TTS 微调(Chatterbox,25h 预算) | CER (%) | SEAM 8.50(WER 20.01) | Mean pooling 10.72(WER 24.58);Random 17.66(WER 27.18) | 相对均值池化降 2.22 个绝对点、相对随机降 9.16 点,达到基线 100h 训练的水平 |
| 哈萨克语 TTS 微调(25h 预算) | CER (%) | SEAM 5.26(WER 13.19) | Mean pooling 15.89(WER 21.60);Random 32.60(WER 39.89) | 相对均值池化降 10.63 点、相对随机降 27.34 点,为三语言中最大增益 |
| 法语 TTS 微调(25h 预算) | CER (%) | SEAM 11.93(WER 23.20) | Mean pooling 12.80(WER 25.82);Random 15.70(WER 29.68) | 相对均值池化降 0.87 点、相对随机降 3.77 点,法语 ASR 地板低(0.63%)故绝对空间有限 |
| 俄语 TTS,序敏感性消融(5h 预算) | CER (%) | SEAM 原版 14.88(WER 34.41) | SEAM 反转序 19.67(WER 51.99);SEAM 打乱序 22.91(WER 53.66) | 打乱顺序使 CER 恶化 8.03 点、WER 近乎翻倍,证明时序相位是核心 |
| 俄语 TTS,扩展基线对比(5h 预算) | CER (%) | SEAM 14.88(WER 34.41) | Learned Attention 15.30;Attention Pooling 20.14;Position-Aware Pooling 23.37 | 胜过全部顺序感知基线,谱滤波是决定性差异 |
| 跨架构验证:VibeVoice 1.5B(俄语,5h,LoRA) | CER (%) | SEAM 6.14 | Average 8.34;Random 9.26 | 相对平均初始化降 2.20 点,证明方法跨架构泛化 |
| 人耳偏好:SEAM(25h 训练)vs 均值池化(100h 训练) | SBS 非平局偏好率 (%) | 俄语 61.4%;哈萨克语 65.1%;法语 70.6% | 均值池化基线获得剩余偏好(每语言 N=125,5 标注者×25 句) | 三语言精确二项检验均显著(p=0.041 / 0.002 / <0.001),SEAM 用 4 倍少的数据胜出 |
局限与改进
作者承认三条局限:(1) 依赖子词分解与 IPA 音译——对缺乏可靠音译表的非拉丁文字语言,映射错误会传播到条件空间;(2) SEAM 只解决初始化瓶颈,不替代下游适配,声学对齐仍需配对音频(虽然用量大幅减少);(3) 极低资源下评估方差大,哈萨克语 5h→25h 时 Random 与 Mean 的 CER 非单调上升(Random 11.62%→32.60%)源于训练/测试集词级重叠的伪影而非模型能力问题,B.5 的划分消融证实了这一点。我的补充观察:其一,ASR 误差地板(Table 4)俄语高达 4.88% CER,意味着俄语多数结果都贴着地板,跨语言结果的可比性受限;其二,新词规模实验上限 1000 词,且缺少'均值池化+25h 更多轮训练'等替代样本效率策略的对照;其三,SBS 每语言仅 5 名标注者×25 句(N=125),俄语 p=0.041 仅勉强显著;其四,理论只是充分条件,且 Lipschitz 假设(假设 1)本身未在实验中验证;其五,强制经英语 IPA 音译引入英语音系偏置,对音系差异大的语言(声调、咽化辅音等)可能系统性失真。
独立分析的弱点
弱点一:IPA 音译管线是单点故障。方法依赖现成工具(transliterate、qazaq_transliterator),对没有此类工具的语言需人工建映射表,且'英语 IPA'强制用英语音系近似目标音位,声调或咽化辅音语言会被系统性扭曲。改进:改用语言无关的泛音素表示或多语言音素模型自动对齐。弱点二:岭回归是全局线性投影,所有新词共享同一 $(W,b)$,无法刻画子词组合的非线性交互(辅音同化、连读)。改进:核岭回归或小型 MLP 读出头,但需权衡低资源过拟合。弱点三:带限假设只在旧词表统计上验证(Figure 3),$K=4$ 针对短序列设定,多音节长词可能需自适应 $K$,且论文未按词长分层报告性能。弱点四:B.7 显示任何后续音频引导精调都会破坏闭式校准(损失 7.2→15.0),微调中更新嵌入层可能重蹈覆辙;改进方向是把投影误差作为正则项加入微调损失。弱点五:评估维度单一,只有 CER/WER 与整体偏好,未测说话人相似度、韵律自然度等 MOS 分项,无法定位 SEAM 改善的具体感知维度。弱点六:每个新词独立计算,忽略批量扩展时新词间的共现与形态约束。
未来方向
作者提出或暗示的方向:把 SEAM 推广到更多语言尤其是缺乏 IPA 音译表的语言;与更大规模词表扩展结合(Figure 2 只做到 |V_new|=1000,更大词表还带来更短 token 序列与更快推理);探索稳定的音频引导初始化方案(当前消融显示其导致优化不稳定)。基于成果可延伸的研究:(1) 把谱合并思想迁移到 LLM 词表扩展——NLP 中的 LEAP 类嵌入传播方法同样是均值或学习式的,DFT 保相序思想可直接移植且 LLM 侧有更大的旧词表可供自监督校准;(2) 可学习频域滤波器:用旧词表上的自监督目标联合优化频域权重,替代固定高斯增益;(3) 与跨语言音素共享、零样本说话人迁移等模型级方法正交组合——SEAM 解决初始化、它们解决数据效率,叠加收益值得量化;(4) 理论完善:把 Lipschitz 假设从前提变成可测量的模型属性,并将命题 1 的充分条件放宽为更普适的保证;(5) 扩展到流匹配、扩散 TTS 等更多骨干架构,检验条件流形对齐假设的普适性;(6) 研究多词联合初始化,引入新词间共现与形态约束。
复现评估
复现门槛中等偏低。作者承诺只发布嵌入初始化代码而非完整模型权重(出于语音克隆滥用风险考虑),算法完全确定性:闭式解无随机性,shuffle 消融固定 seed=42,主结果为三个随机种子平均。算力只需单卡 RTX 3090 24GB 加 i9-14900K(附录 B.1 说明 Chatterbox 0.5B 全参微调与 VibeVoice 1.5B LoRA r=128 微调均在此配置完成),SEAM 本体是 CPU 上秒级的矩阵求逆。数据全部公开:ru-librispeech、KazakhTTS、AdrienB134/french-unique-speaker-tts,ASR 用 NVIDIA FastConformer 公开 checkpoint。关键超参披露完整:K=4、σ=2.0、λ=1e-6;Chatterbox lr 5e-4、10% warmup、余弦衰减、有效 batch 64、1 epoch;VibeVoice lr 5e-5、LoRA α=256、DDPM 10 步。风险点:音译工具版本与俄语元音弱化等归一化规则未完全指定,Chatterbox 词表与 BPE 分词器的绑定需自行确认,100 句测试集构成与人评协议(5 名母语者×25 句)需自行组织。总体估计一周内可在单卡复现 Table 1 主结果。
论文图表
横轴为新增词元数量 |V_new| ∈ {200, 400, 600, 800, 1000}(俄语 25h 微调),纵轴为 CER。SEAM 曲线随词表规模增长仅轻微退化,而随机初始化与均值池化在超过约 500 个新词后急剧恶化。主实验将 |V_new| 限制在 200 以保证比较公平,作者指出更大词表会带来更短 token 序列与更快推理,且 SEAM 的相对优势随规模扩大更加明显。
展示方法最重要的工程特性——可扩展性:均值池化在批量扩展场景下失效,而 SEAM 依然稳健,这决定了它能否用于真实的大规模词表迁移。