Tacit-TTS:从自回归解码到掩码预测的高效免转录零样本声音克隆 Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning
把IndexTTS2蒸馏成掩码非自回归架构,免转录克隆且提速10倍以上
前置知识
自回归(AR)与非自回归(NAR)解码
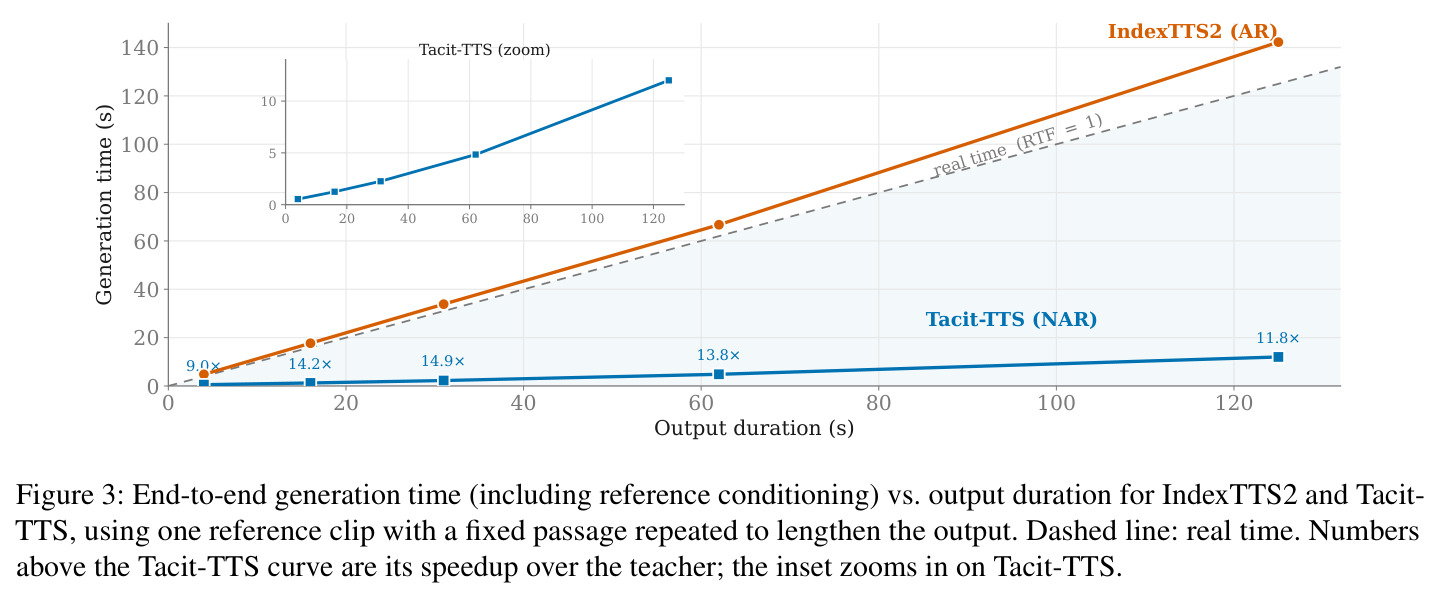
AR模型逐token顺序生成,每步依赖之前所有输出,天然支持可变长度(遇到停止符即停),但延迟随序列长度线性增长;NAR模型一次性并行预测所有位置,速度快得多,但必须在解码前预先确定目标长度T。
本文全部加速(T2S阶段26.5倍)正来自把IndexTTS2的AR语义解码换成NAR掩码解码,而NAR定长约束又引出了论文的免训练时长估计设计,理解这对取舍是读懂全文的前提。
掩码生成与MaskGIT式迭代反掩码
借鉴BERT掩码语言建模的生成范式:训练时按cos调度采样掩码率r=cos(u)、随机掩住部分语义token让模型预测;推理时从全MASK序列出发,每轮并行预测所有掩码位、只提交最置信的部分,固定轮数(本文12轮)后得到完整序列,可形式化为离散扩散。
Tacit-TTS的文本到语义(T2S)模块就是这个机制,论文损失函数中的掩码率分桶嵌入与AdaLN条件化都基于它,不懂它就无法理解方法章节。
知识蒸馏与重整流(ReFlow)
知识蒸馏让小模型(学生)模仿大模型(教师)的输出分布,可用教师合成数据训练而无需原始语料。重整流是针对流匹配模型的蒸馏:记录教师多步积分产生的(初始噪声,最终样本)配对,让学生沿这些模型自身诱导的直线轨迹学习,从而用极少积分步数达到同等质量。
本文两个阶段都是蒸馏——T2S用教师合成的87.4万条语义码数据蒸馏,S2A渲染器用重整流从25步Euler积分压到8步,这是整个方法框架的骨架。
流匹配与语义token两阶段TTS
流匹配学习从高斯噪声到数据分布的速度场,沿近似直线路径用Euler法积分生成样本,步数越多质量越高。语义token是语音经神经编解码器离散化后的中间表示,现代TTS普遍采用文本到语义token(T2S)再加语义到音频(S2A)的两阶段范式。
论文的S2A阶段就是流匹配DiT渲染器加BigVGAN声码器,T2S预测的对象就是离散语义token加连续残差隐变量,两者构成方法的技术底座。
零样本声音克隆与解耦条件嵌入
仅凭几秒参考录音克隆未见过的说话人。IndexTTS2用w2v-BERT特征经Perceiver重采样得到32个固定长度的说话人潜向量E_s和单个情感向量E_e,两者作为前缀token注入Transformer,实现身份与情感控制的解耦,且完全不依赖参考文本转录。
Tacit-TTS原样继承教师这套免转录条件机制(约468ms一次性开销),这正是它能在跨语言和婴儿咿呀等无词汇参考上稳定克隆的根本原因。
研究动机
现代零样本声音克隆的高质量依赖大规模自回归建模。IndexTTS2在5.5万小时语音上训练(生成模块1094M参数),说话人相似度与情感表现力领先,但其文本到语义(T2S)阶段逐token顺序解码,在单张A100上合成约5秒语句需5274ms,总延迟6632ms,仅0.813倍实时,长文本延迟更线性放大。非自回归系统如MaskGCT、F5-TTS、CosyVoice2并行生成快得多,却普遍依赖参考语音的ASR转录作为条件:一旦参考语言不在ASR支持范围内(如俄语、阿拉伯语、约鲁巴语),或参考内容根本没有词汇意义(婴儿咿呀、合成胡言乱语),转录就变得不可靠甚至为空,克隆质量随之崩塌——论文跨语言实验显示CosyVoice2在英语目标上WER高达45.95%,SparkTTS达47.27%,MaskGCT在俄语和阿拉伯语参考上100%无法生成。此外固定长度NAR解码要求生成前预先确定目标时长,通常依赖学习式时长预测器或参考转录,进一步收窄了适用范围,在高保真克隆与高效免转录克隆之间留下一道现实鸿沟。
本文的目标是本文的目标是构建一个高效且免转录的零样本声音克隆系统,同时满足四个约束:第一,推理速度比教师模型IndexTTS2快一个数量级,5秒以上的语句要超过10倍加速;第二,完全不依赖参考语音的转录文本,使跨语言参考和无词汇参考(婴儿咿呀、合成胡言乱语)也能稳定克隆;第三,不要求用户预先指定目标时长,由系统从参考音频语速与目标文本自行估计;第四,尽可能保留教师质量,且不接触教师原始的5.5万小时训练语料,仅凭约2000小时教师合成数据完成蒸馏。量化目标是在LibriSpeech test-clean、SeedTTS test-en/test-zh、AISHELL-1 test四个标准集上,说话人相似度(SS)达到可部署系统最优、感知质量(UTMOS/DNSMOS)贴近教师,同时生成时长与真值的Pearson相关不低于主流系统。
与已有工作不同的是,作者的独特切入是蒸馏而非重训。现有NAR系统(MaskGCT等)从零在真实文本-音频对上训练,既需要海量数据又依赖参考转录;本文把IndexTTS2当作教师,用教师单次前向合成全部训练数据(参考语音配内容无关的目标文本),在不接触原始语料的情况下继承其语义token空间、说话人/情感条件机制和连续隐变量表示。第二个独特设计是训练无关的时长控制:不训练时长预测器,而是从参考波形直接估计语速——用有声段RMS能量峰计数作为音节数的声学代理,与目标文本音节数相乘得到目标语义长度,彻底绕开转录依赖。第三个是对下游流匹配渲染器施加重整流蒸馏,把25步Euler积分压到4至8步。三者组合形成从AR教师到NAR学生的完整蒸馏路线,同时解决速度、转录依赖和时长约束三个痛点。
核心方法
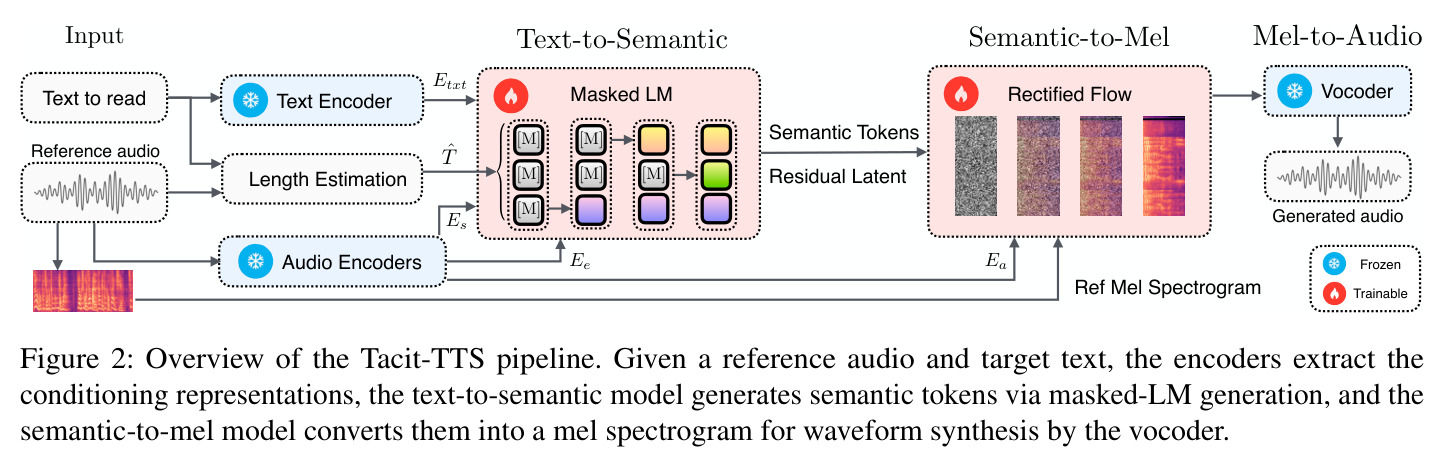
Tacit-TTS沿用两阶段范式:文本到语义(T2S)与语义到音频(S2A)。T2S阶段用269M参数的双向DiT掩码生成器替换教师527M的自回归Transformer——从全MASK的语义序列出发,以文本嵌入、32×d的说话人嵌入E_s(Perceiver重采样)和情感嵌入E_e为条件,在固定12轮迭代中并行预测并提交最置信token。训练用共享主干的双头损失 $\mathcal{L}_{T2S} = \mathcal{L}_{mask} + \lambda\mathcal{L}_{res}$:掩码预测头对被掩位置做交叉熵学习离散语义码;残差恢复头用均方误差重建教师隐变量中超出离散码嵌入的连续增量 $\Delta = S - vq2emb(y)$,保住下游渲染器依赖的连续信息。S2A阶段保留IndexTTS2的流匹配DiT渲染器与BigVGAN声码器,先在学生输出分布上微调,再用记录的噪声-输出耦合做重整流训练,把25步Euler积分压到8步。整体生成模块参数从1094M降到836M,T2S延迟从5274ms降到199ms。
核心创新有三。第一,架构替换式蒸馏:87.4万条训练样本全部由IndexTTS2单次前向生成(只存语义码与隐变量,不需音频波形),目标文本与参考内容解耦,使学生的语义表示空间与教师严格对齐——这是仅用约2000小时(对比教师5.5万小时)就逼近教师质量的关键,也区别于MaskGCT依赖真实文本-音频对的训练方式。第二,训练无关的长度控制:参考语速因子 $\rho_r = T_r/(\kappa N_{ra})$,其中 $T_r = D_r f$ 为参考裁剪静音后的语义帧数、$N_{ra}$ 为参考音频声学音节数,裁剪后乘以目标文本音节数得 $\hat{T} = \mathrm{round}(N_{xt}\tilde{\rho}_r)$,最短8帧;声学音节取有声帧dB能量 $e_m = 20\log_{10}(E_m + \epsilon)$ 的显著峰计数(峰间隔≥100ms),语速钳制[7,12]码/音节,中文用 $\kappa=0.92$ 补偿字音失配,彻底绕开转录。第三,重整流蒸馏让渲染器沿拉直的轨迹积分,S2A延迟从875ms降到310ms。
方法步骤详情
流程分五步。步骤一(条件提取):参考音频经教师冻结编码器得到32×d说话人嵌入E_s(Perceiver重采样32个潜查询)与情感嵌入E_e,约468ms,一次性成本。步骤二(长度估计):30ms窗/10ms移位计算RMS能量转dB,用YIN判定有声帧,保留超过自适应阈值且间隔≥100ms的能量峰得参考音节数N_ra;目标文本音节数N_xt中文按字计、英文用textstat估计;按 $\hat{T} = \mathrm{round}(N_{xt}\tilde{\rho}_r)$ 确定语义长度。步骤三(T2S掩码解码):文本嵌入上采样到长度T并与语义token嵌入拼接投影融合(序列长度保持T),从全MASK序列开始12轮迭代,每轮并行预测所有掩码位并提交最置信者,残差头同时重建连续隐变量。步骤四(S2A渲染):语义表示送入微调加重整流的流匹配DiT,8步Euler积分生成mel谱(损失只算非提示区 $[\ell, L)$),BigVGAN合成波形,约310ms。步骤五(数据构建):T2S训练集87.4万条、约2000小时、2739个说话人(2342英/397中);S2A耦合集8000对噪声-mel配对、约36小时。
技术新颖性
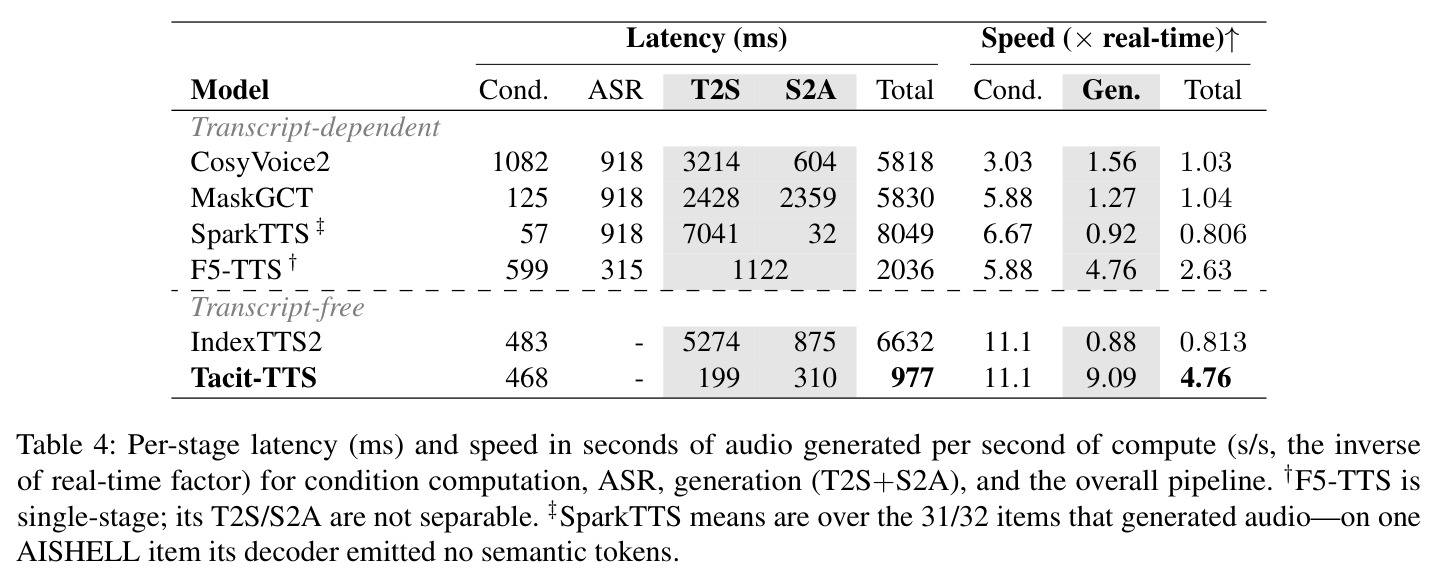
技术新颖性体现在四组对照上。对MaskGCT:同样采用掩码预测架构(MaskGIT式迭代反掩码、cos掩码率调度、16桶嵌入加AdaLN条件化),但MaskGCT从零在真实文本-音频对上训练、需要参考转录、时长用音素比例缩放或学习式预测器;Tacit-TTS整个T2S由AR教师蒸馏而来,时长由免训练声学语速决定。对IndexTTS2:保留其解耦的说话人/情感条件接口、w2v-BERT加Perceiver编码器、以及连续隐变量增强渲染器的设计——通过残差恢复头在NAR框架中复现 $\Delta = S - vq2emb(y)$ 的连续信息通路,只替换解码范式,因此说话人保真几乎无损。对通用知识蒸馏(Hinton式logit对齐):本文先用微调让渲染器适配学生输出分布,再记录模型自身诱导的噪声-输出耦合做重整流,属于针对流模型的轨迹拉直蒸馏,且双头损失同时迁移离散语义码与连续隐变量。对E2 TTS/F5-TTS等单阶段系统:保留两阶段可解释性,且不依赖内置Whisper转录,免去了ASR的计算开销(转录依赖系统ASR阶段需315至918ms)。
实验结果
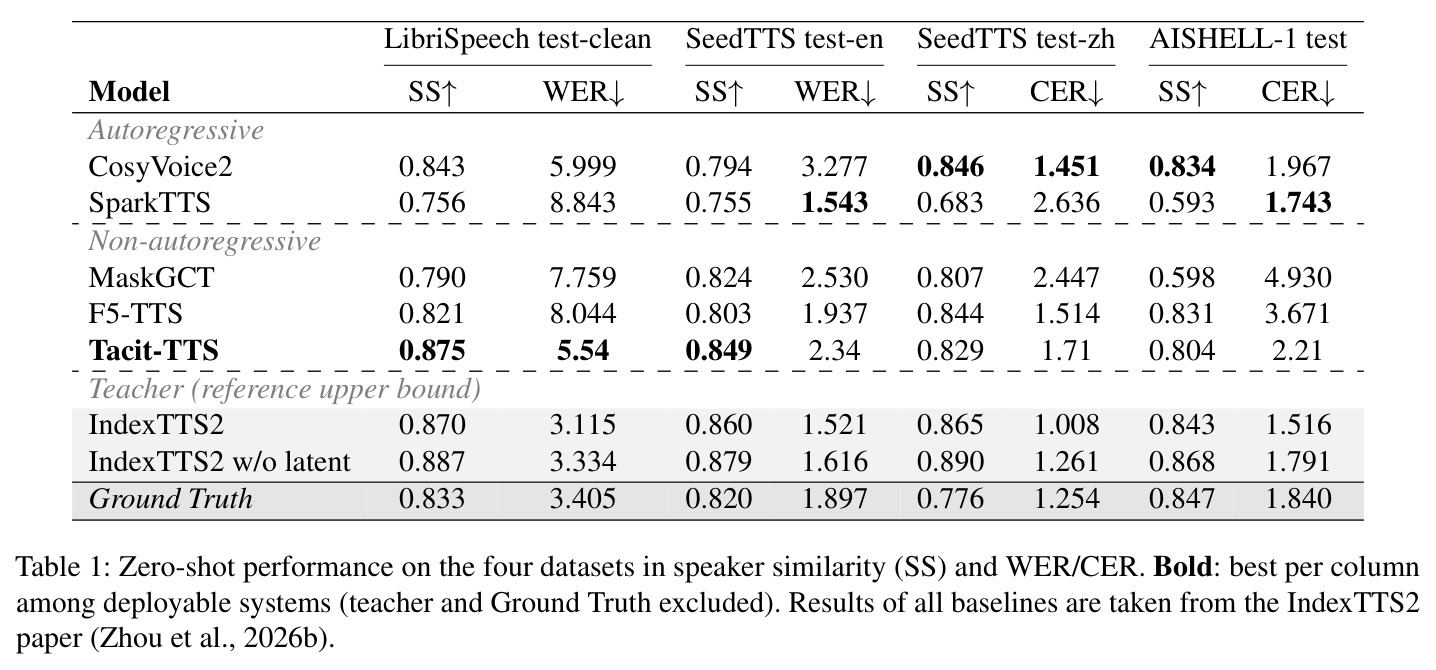
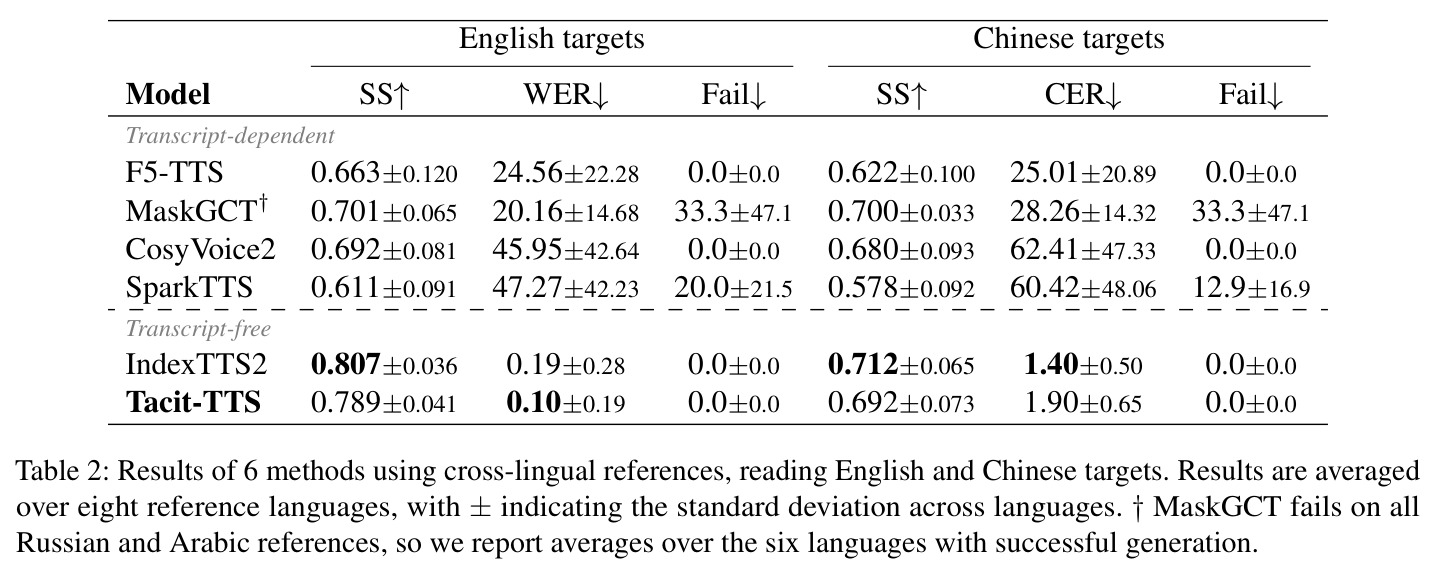
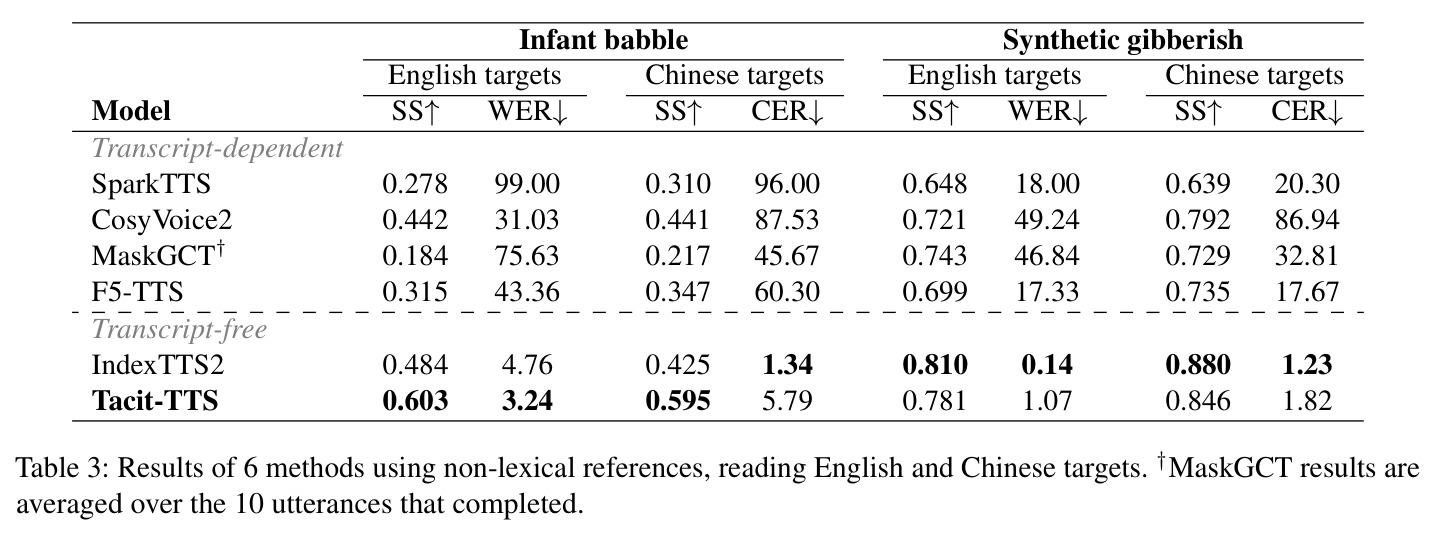
主结果(Table 1):LibriSpeech test-clean上SS 0.875、WER 5.54,为可部署系统最高相似度,对比F5-TTS 0.821/8.044、MaskGCT 0.790/7.759,接近教师的0.870/3.115;SeedTTS test-en为0.849/2.34;中文稍弱:test-zh 0.829/1.71、AISHELL-1 0.804/2.21(教师0.865/1.008与0.843/1.516),归因于2342英/397中说话人失衡。跨语言(Table 2,FLEURS八语言参考):英语目标SS 0.789/WER 0.10%、中文0.692/1.90%,错误率均低于3.4%且零失败;而CosyVoice2英语WER 45.95%、MaskGCT在俄语与阿拉伯语参考上100%失败。非词汇参考(Table 3):婴儿咿呀英语SS 0.603反超教师的0.484。效率(Table 4):T2S延迟5274→199ms(26.5×),S2A 875→310ms,生成合计12.1×提速,总延迟977ms、4.76倍实时;加速比从4秒9.0×升至30秒峰值14.9×,125秒回落至11.8×。时长Pearson相关r=0.948(教师0.956)。消融(Table D.1)确定默认12步T2S/8步S2Mel:S2Mel从1步到8步SS由0.711升至0.875。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本声音克隆(LibriSpeech test-clean) | 说话人相似度SS↑ / 词错率WER↓ | SS 0.875 / WER 5.54 | F5-TTS 0.821/8.044;MaskGCT 0.790/7.759;CosyVoice2 0.843/5.999;教师IndexTTS2 0.870/3.115 | 可部署系统中SS最高(较最强NAR基线F5-TTS高0.054),WER较F5-TTS低2.50点;与教师SS基本持平 |
| 跨语言参考克隆(FLEURS八语言参考→英语目标) | SS↑ / WER↓ / 失败率↓ | 0.789 / 0.10% / 0% | CosyVoice2 0.692/45.95%/0%;MaskGCT 0.701/20.16%/33.3%;SparkTTS 0.611/47.27%/20.0% | WER较转录依赖基线降低约20至47点,失败率归零,错误率在任何参考语言下不超过3.4% |
| 非词汇参考克隆(婴儿咿呀,英语目标) | SS↑ / WER↓ | 0.603 / 3.24 | 教师IndexTTS2 0.484/4.76;CosyVoice2 0.442/31.03;F5-TTS 0.315/43.36 | SS超过教师0.119,为全部六个系统最高;中文目标SS 0.595同样超过教师的0.425 |
| 推理效率(约5秒语句,单张A100) | 总延迟ms↓ / 生成吞吐(s/s)↑ | 977ms / 4.76 s/s(T2S 199ms + S2A 310ms) | IndexTTS2 6632ms / 0.813 s/s(T2S 5274ms + S2A 875ms);CosyVoice2 5818ms / 1.03 s/s | T2S阶段26.5×加速,生成阶段合计12.1×,总延迟约6.8×;长语句加速比峰值达14.9× |
| 时长保真度(四测试集汇总) | 生成时长与真值Pearson相关r↑ | 0.948 | IndexTTS2 0.956;MaskGCT 0.949;CosyVoice2 0.952;SparkTTS 0.579 | 与最强系统差距仅0.008,验证免训练长度估计器不牺牲时长自然性,远超SparkTTS的0.579 |
局限与改进
作者承认的局限:中文表现系统性弱于英文,AISHELL-1上SS 0.804对教师0.843、CER 2.21对1.516,主因是蒸馏语料397个中文说话人远少于2342个英文说话人;英语WER与教师仍有明显差距(LibriSpeech 5.54对3.115),说明蒸馏在内容准确性上有损;时长估计是启发式——textstat规则估音节、能量峰计数、手工常数κ=0.92与钳制区间[7,12],对异常语速或非典型语音可能失效;感知质量只用UTMOS/DNSMOS这类无参考MOS预测器,作者自己指出部分系统得分超过真实录音、可信度有限,全文未做人耳MOS测试。我的补充观察:超过一分钟的长文本加速比回落到11.8×,暴露NAR全注意力O(n²)的扩展瓶颈;T2S固定12轮迭代与置信度提交策略未与AR束搜索在错误传播行为上深入对比;加速基线中SparkTTS因无可用发行版被剔除计时,效率对比不完全;免转录克隆也降低了声音滥用门槛,伦理声明仅停留在建议层面。
独立分析的弱点
第一,中文短板:397个中文说话人导致SS/CER全面落后教师,改进方向是按语言配平蒸馏语料,或引入多语种教师合成数据做联合蒸馏。第二,WER差距(5.54对3.115):罕见词与领域外文本上学生语义码预测错误更多,论文已针对性补充548条英文加123条中文罕见词样本和22500条广告句,但规模仍小,可加入教师logit蒸馏项或更大规模困难样本挖掘。第三,长度控制是开环启发式:textstat对英文连读、缩写、数字读法的音节估计不准,能量峰法在气声、歌唱、强口音下会漏计,改进方向是用教师AR停止token行为做轻量监督训练一个时长头,仍保持免转录。第四,固定步数迭代解码的并行置信提交可能造成token间不一致(重复或跳字),可用熵自适应停止或半自回归块解码替代。第五,长文本O(n²)注意力:30秒后加速比见顶回落,可引入局部窗口注意力或线性注意力。第六,评测盲区:情感相似度、韵律迁移未单独度量,仅WER/SS无法刻画论文宣称的表现力保真,需要人耳MOS与情感维度评测补全。
未来方向
作者方向:伦理上建议部署时强制获得克隆者同意并配合音频水印与合成语音检测;机制上把免训练长度估计与更强的文本理解结合。基于本文成果可延伸:其一,把该蒸馏范式推广到多语言与情感可控生成——教师的情感条件接口已被完整保留,训练中已用one-hot情感标签扩充覆盖,可系统评估情感迁移保真度;其二,重整流可继续压到1至4步甚至做一致性蒸馏,S2A的310ms仍有下降空间;其三,用教师AR模型做在线伪标签或偏好优化,进一步缩小WER与教师的差距;其四,流式NAR解码使约1秒总延迟具备进入实时对话Agent的潜力;其五,跨语言与无词汇参考能力可产品化到配音、多语言翻译(论文提及Barrault等2023的翻译场景)与医疗辅助,并配套声纹欺诈检测研究;其六,长度估计可从单一总时长扩展到分段语速曲线控制,实现韵律级别的变速与停顿规划。
复现评估
论文未提及开源代码或模型权重,复现门槛中等偏高。有利条件:教师IndexTTS2开源(推理管线、说话人/情感编码器、S2Mel渲染器、BigVGAN声码器均可获取,官方仓库还提供10条参考语音),蒸馏数据由教师自动合成——87.4万条T2S样本只需LibriSpeech/AISHELL-1/ESD的参考语音加文本模板,无需人工标注,也不需存储音频(仅存语义码与隐变量);8000条S2A耦合对约36小时语音;推理单张A100即可,训练数据量约2000小时语义码不算大。不利条件:内容无关目标句的构造细节繁琐(6000条解说模板句、22500条广告句、53516条极端长度句、548+123条罕见词样本),跨语言与婴儿数据集的参考筛选流程(RMS能量VAD、CAM++嵌入k-means选参考、语言内两两相似度低于0.6过滤)需要仔细复刻;大部分基线质量数字引自IndexTTS2论文而非独立复现。总体估计有GPU集群的小团队数周内可复现主要结果,但逐位对齐论文数字存在不确定性。
论文图表
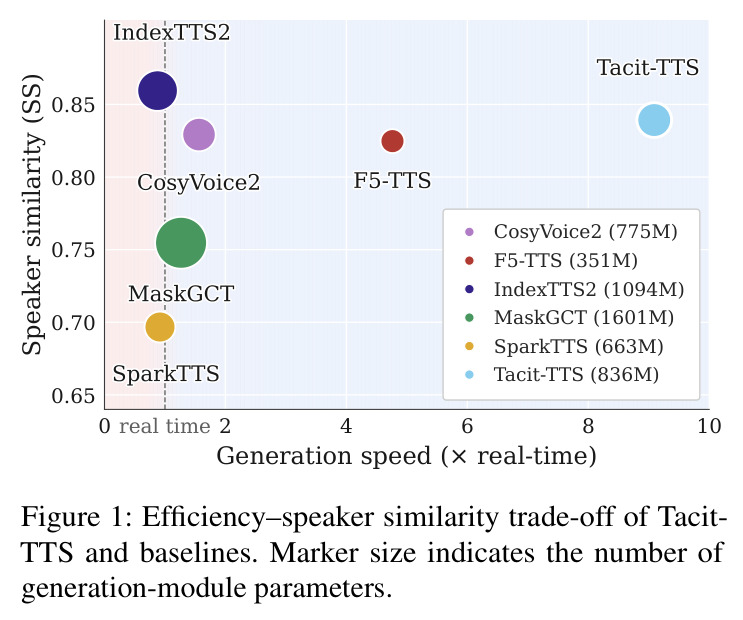
散点图:横轴为生成速度(0到10倍实时),纵轴为说话人相似度(0.65到0.85)。Tacit-TTS(836M参数)位于右上角,以约9到10倍实时达到约0.85的相似度;IndexTTS2(1094M)相似度约0.80但速度接近1倍实时;CosyVoice2(775M)、F5-TTS(351M)、MaskGCT(1601M)、SparkTTS(663M)均落在左下方区域。点的面积代表生成模块参数量。
一张图概括论文核心卖点:在效率-相似度权衡曲线上同时超越所有可部署基线并逼近教师,是引言部分最直观的总览证据,也直观呈现了参数量与速度、质量的分离。
四个测试集上的无参考感知质量评分表。Tacit-TTS的UTMOS(LibriSpeech 4.009、SeedTTS test-en 3.578、test-zh 2.890、AISHELL 2.419)与DNSMOS(3.289/3.072/3.297/3.159)全程贴近教师IndexTTS2(4.051/3.572/2.926/2.486),明显高于F5-TTS的3.102/3.592/2.864/2.069;部分系统(如CosyVoice2的4.344)超过Ground Truth的4.087。
补充质量维度的证据,说明大幅加速没有以听感为代价;作者同时坦承MOS预测器可能偏向训练分布、部分得分超过真实录音,这提醒读者正确解读所有自动感知指标。
T2S步数(8/12/16)与S2Mel步数(1/4/8)的网格消融,共8种组合的SS、WER/CER与效率(1/RTF,不含一次性条件计算)。最激进的8+1组合SS仅0.710、WER 7.11、效率17.9 s/s;默认12+8(灰色标注行)SS 0.875/WER 5.54、效率12.5 s/s;16+8质量增益微小(0.874/5.32)而效率降至10.9 s/s。
给出默认配置12步T2S/8步S2Mel的量化依据——这是质量-速度帕累托前沿上的显式取舍,也是复现论文全部主结果必须锁定的超参数。
六个系统生成时长对地面真值时长的散点图(联合四个测试集的英中文样本),各面板标注汇总Pearson相关:Tacit-TTS 0.948、IndexTTS2 0.956、MaskGCT 0.949、CosyVoice2 0.952、F5-TTS 0.950,SparkTTS仅0.579明显离群,散点在对角线附近分布。
回应NAR定长解码这一固有弱点的疑虑:免训练的声学语速长度估计器与学习式时长预测系统的时长自然度几乎相同(与最强系统差距仅0.008),证明论文的时长方案不牺牲保真度。
日、韩、德、西、俄、阿、印地、约鲁巴八种参考语言逐语言的SS/WER/CER/失败率明细。转录依赖系统逐语言剧烈波动:SparkTTS俄语英语目标WER 54.56且失败36.7%、阿拉伯语失败56.7%;MaskGCT俄语与阿拉伯语整行无结果(失败100%)、印地语失败66.7%;CosyVoice2日语中文目标CER 78.62%、印地语126.34%。Tacit-TTS全部单元格稳定、最高CER仅3.35。
Table 2平均值背后的原始证据:逐语言展示转录依赖系统在ASR不支持语言上的失败模式与巨大方差,是免转录主张最完整、最有说服力的支撑材料。
附录B列出10条伪词序列(如kalene kuguva ge yu mu nola vi pesa fa zula…)与配套的10条参考录音(voice_01至voice_10,来自IndexTTS2官方仓库示例)。每条序列约28个音节,由固定随机种子从18个辅音与5个元音中抽取组成1至3音节伪词,可发音但不含任何语言的真实词汇,经教师(25步)合成后构成非词汇参考集。
给出合成胡言乱语测试集的精确构造方法,保证非词汇实验可复现,也直观定义了无有效转录存在的极端测试条件是什么。