面向智能体机器人操作的世界上下文学习 World In-Context Learning for Agentic Robot Manipulation
冻结权重,在模拟器中演练并把世界反馈写入上下文,单演示零梯度成功率83.4%
前置知识
In-Context Learning (ICL,上下文学习)
大模型仅凭提示中的示例适应新任务的能力:权重完全冻结、无任何梯度更新,模型从上下文里读出任务模式并在推理时照做。例如给几个求解示例,模型即可套用到同类新问题上,适应性完全由上下文文本承载。
本文的核心问题就是“机器人能否在上下文中像在权重中一样学会操作任务”,WICL 正是对 ICL 的直接扩展——在演示之外再加入世界反馈。
VLA 与世界动作模型 (WAM)
视觉-语言-动作(VLA)模型把图像和指令端到端映射为机器人动作,通常先在大规模跨具身数据上预训练;世界动作模型(WAM)先预测未来观测或潜在计划再导出动作。两者都通过模仿学习把技能写进网络权重。
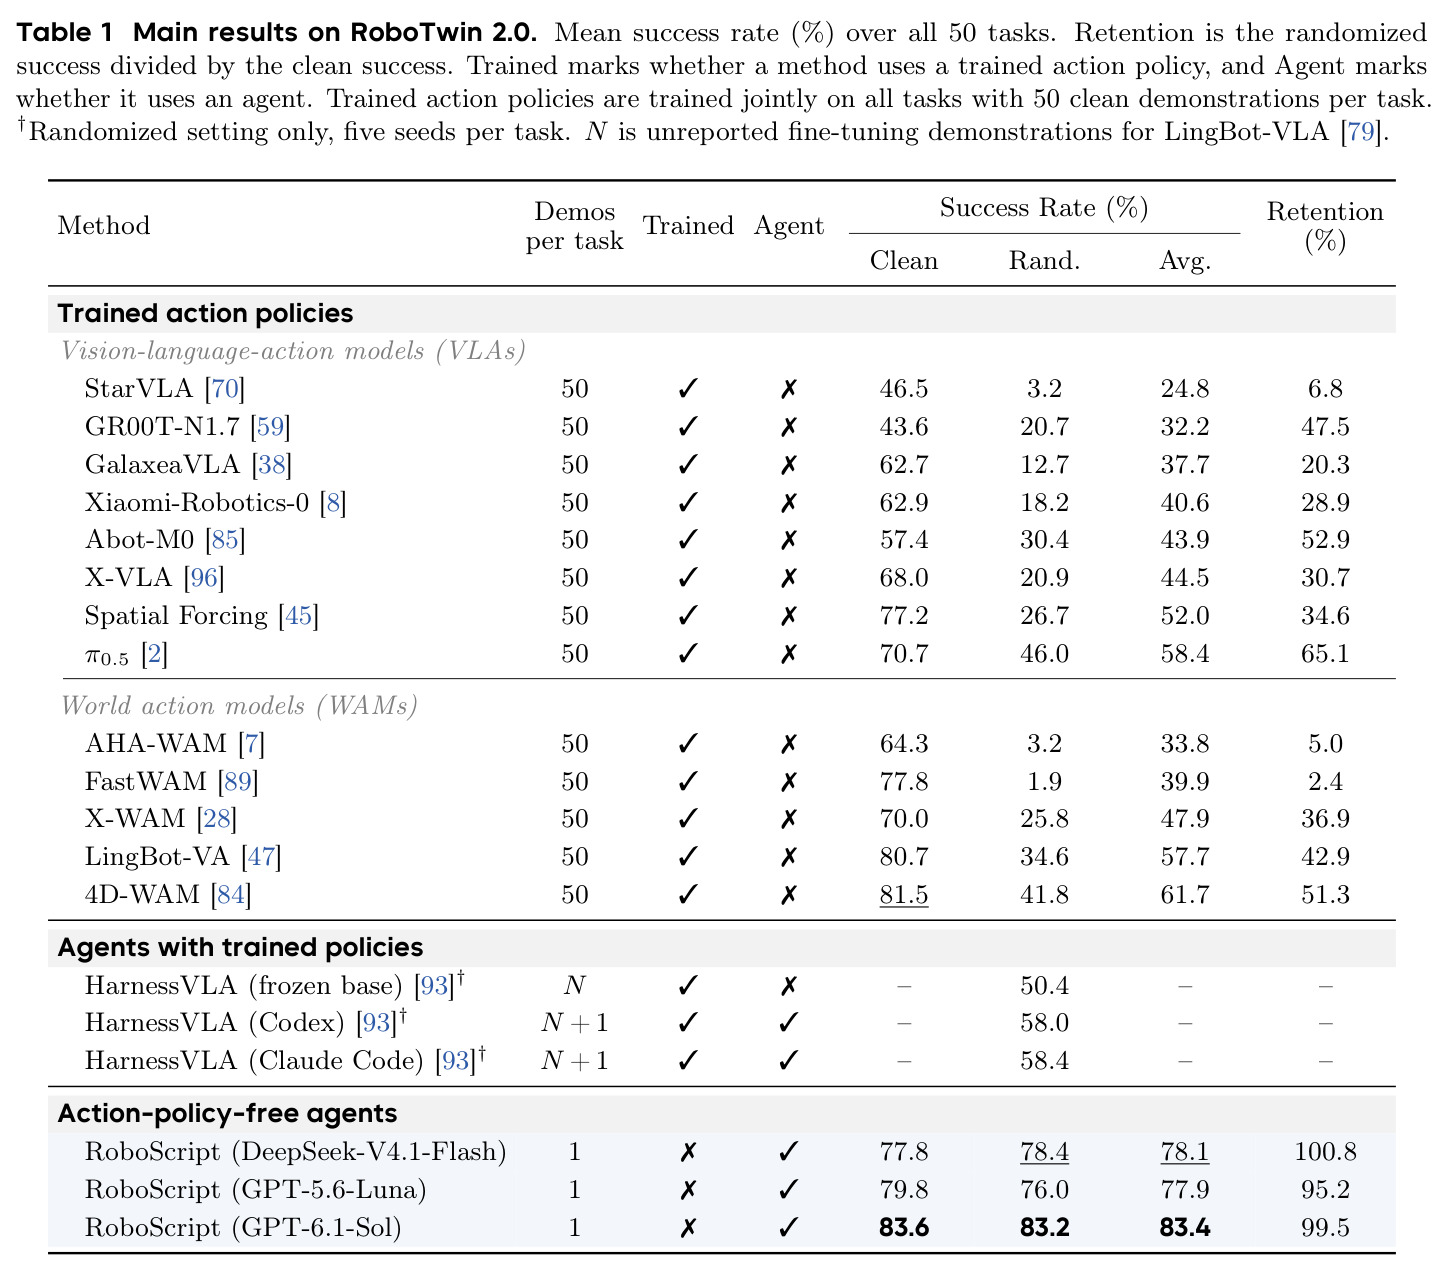
它们是本文的全部对照组。论文用 RoboTwin 2.0 排行榜上 13 个 VLA/WAM 的成绩与 RoboScript 对比,并指出权重类方法在分布偏移下普遍崩溃。
域随机化 (Domain Randomization)
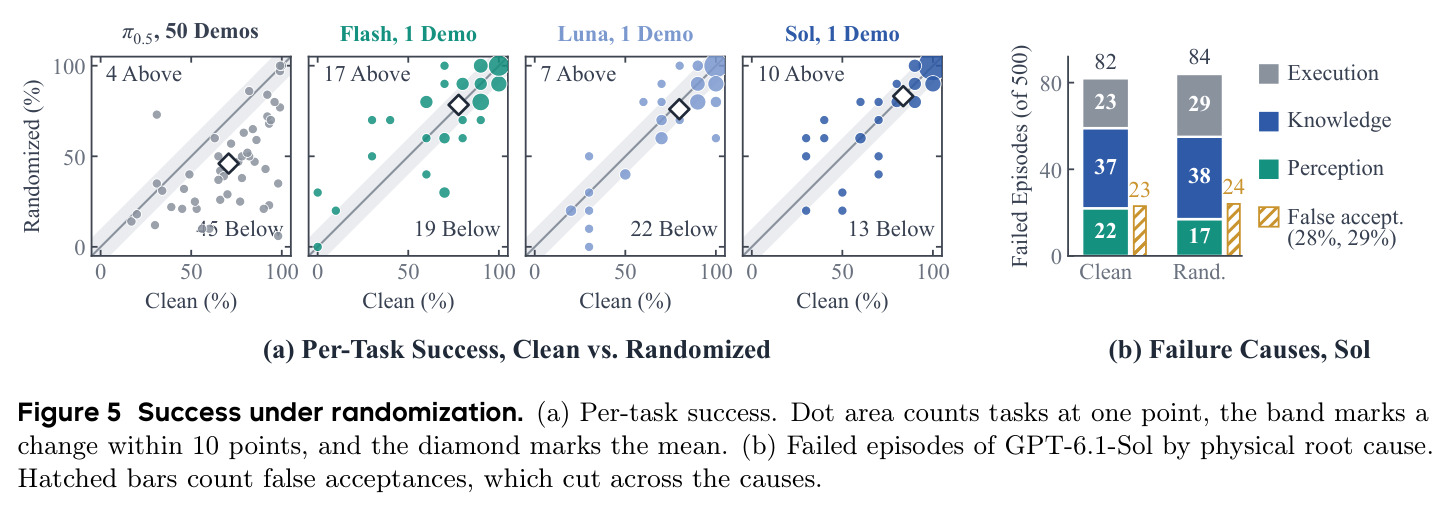
在评测或训练时随机化纹理、光照、桌面高度、干扰物等视觉与物理参数,用以检验系统是否记住了特定外观。留存率(随机化成绩除以干净成绩)是衡量泛化的关键指标。
论文最有力的证据是留存率:训练策略最多保留 65.1% 的干净成绩,而 RoboScript 保留 95.2%–100.8%,直接支撑“学的是语义而非外观”这一论点。
RoboTwin 2.0 基准
一个包含 50 个双臂操作任务的仿真基准,模拟 ALOHA 双臂机器人,每个任务提供干净(固定背景)与随机化(随机纹理光照桌面高度与干扰物)两种设定,配有官方评测服务器、成功率判定和排行榜。
本文全部主实验在其 50 个任务上进行,每设定每任务 10 个回合;真机部署的四任务也取自该基准,理解实验设计必须先了解它。
递归自我改进 (RSI)
智能体在不改权重的情况下,阅读自己过往回合的记录,总结失败模式,写出指导文本供下一轮使用,形成“评估—反思—改写上下文”的闭环。每次评估都用从未见过的新实例,保证改进衡量泛化。
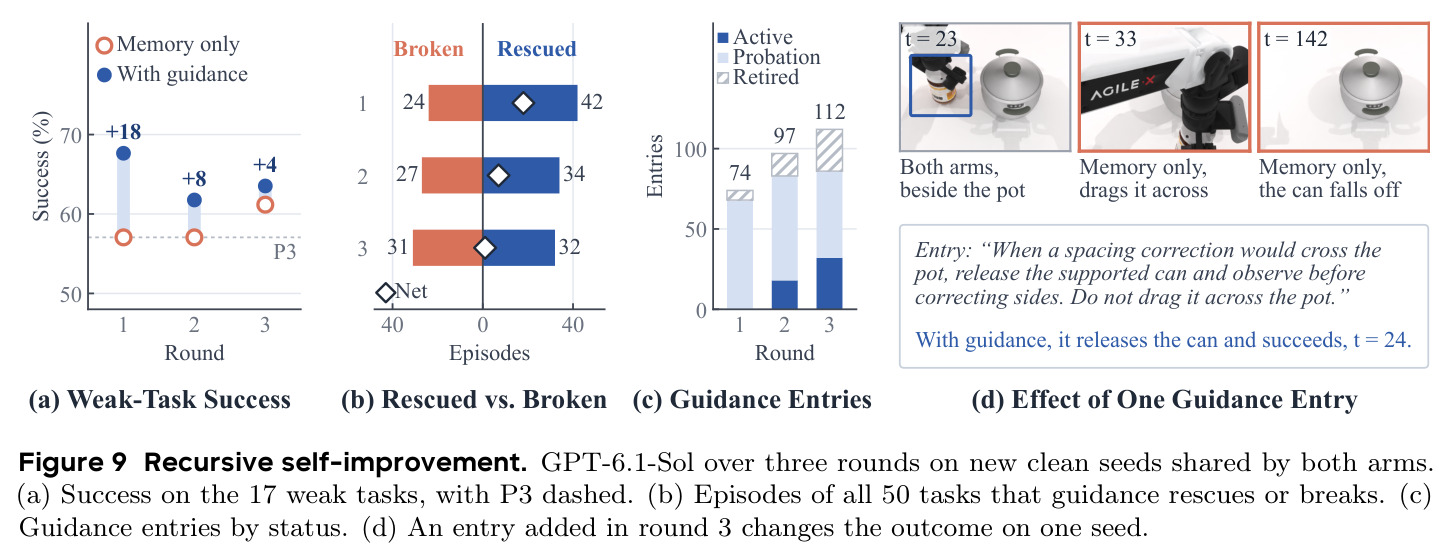
RSI 是 RoboScript 的第四阶段,论文用它证明冻结的记忆仍可逐轮提升(17 个弱任务三轮净增益 +18/+8/+4 回合),是“知识在上下文”假设的直接检验。
特权信息与数据隔离
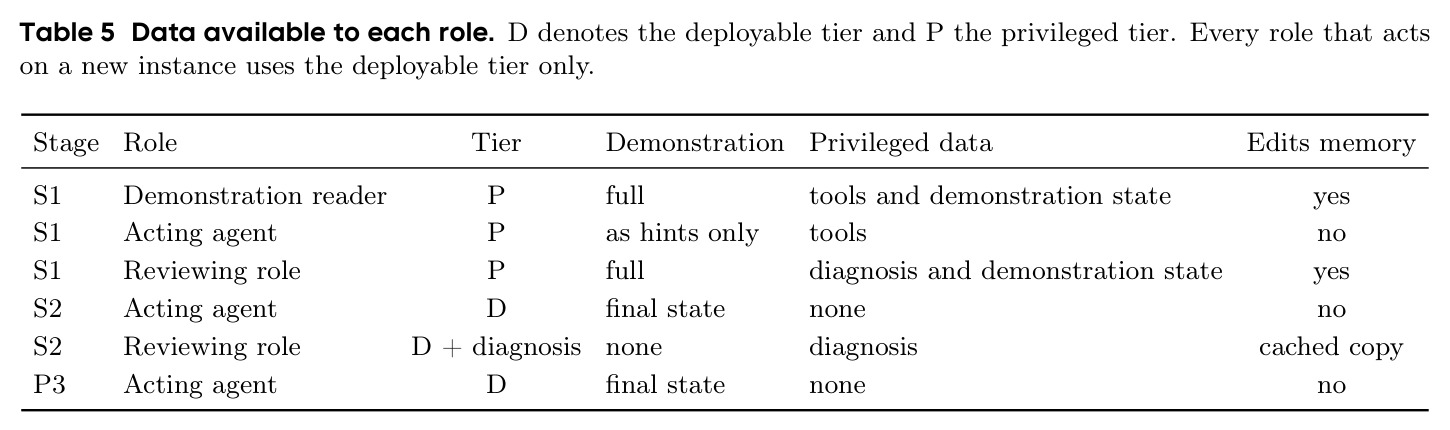
仿真器内部状态(物体真值位姿、分割、接触、成功判定、专家轨迹)是特权信息,真机上只有 RGB-D 相机、本体感知、运动规划器回执等可部署数据。系统在架构上强制不同角色只能访问相应层级。
RoboScript 的可部署性论证完全建立在“执行智能体只见可部署数据”的隔离设计上;消融实验“无特权监督”的成绩(86.5% 对 86.0%)也依赖这一分层概念。
研究动机
主流做法训练动作策略(VLA 或世界动作模型 WAM),把操作技能写进网络权重,这使所学内容与训练分布耦合:每换一个任务或分布都要新数据和新的梯度训练。具体证据在 RoboTwin 2.0 上非常刺眼:广泛采用的 WAM 基线 FastWAM 用每任务 50 条干净演示训练,在干净场景达 77.8% 平均成功率,域随机化下骤降到 1.9%;13 个训练策略在随机化下最多只保留干净成绩的 65.1%(π0.5),FastWAM 留存率仅 2.4%。上下文学习路线虽避免了这种耦合(单演示、无梯度更新即可执行新任务),但始终没追上训练策略,原因是上下文里只有别处录制的演示,没有来自当前桌面的世界反馈:一个前沿模型(GPT-6 Astra)在提示中加入不同布局的演示并无提升,尽管其轨迹显示它会根据观察到的结果纠正动作;Code as Policies 一类 API 控制方法没有世界反馈时误差会不断累积。而直接在真机上试错学习又不安全,已有不安全动作损坏设备的报道。
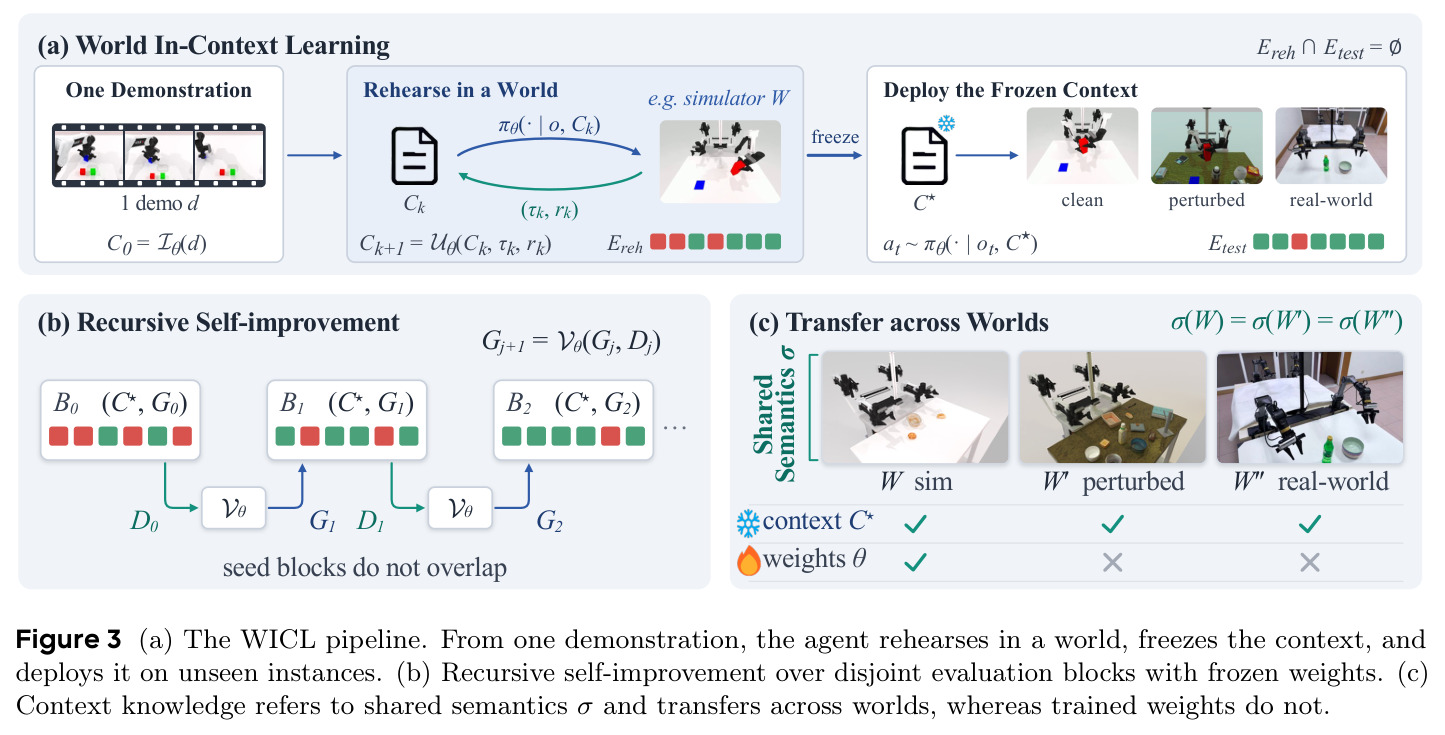
本文的目标是本文要回答的问题是:机器人能否在上下文中学会操作任务,达到与在权重中学习相当的水平?具体目标分三层。其一,形式化一个新学习范式 WICL:权重冻结的基础模型从单条演示出发,$C^0 = I_\theta(d)$ 初始化上下文,在一个“世界”(仿真器、学习型世界模型或场景潜在模型)中反复演练并按 $C^{k+1} = U_\theta(C^k, \tau^k, r^k)$ 把反馈沉淀进上下文而非权重,再把冻结的上下文 $C^\star$ 部署到从未演练过的评估实例上。其二,构建 RoboScript 模块化基础设施,实现技能构建、任务学习、部署与反思的完整生命周期,并以数据隔离保证一切所学在真机上可直接使用。其三,在 RoboTwin 2.0 全部 50 个任务上,用每任务 1 条演示、零梯度更新达到并超越用 50 条演示训练的最强策略,同时验证跨视觉分布泛化、反思增益、基础模型规模效应以及到真实双臂机器人的跨具身迁移。
与已有工作不同的是,本文的独特切入角度是一个关键观察:在上下文中学习的知识是语义性的——记录的是物体角色、任务步骤和哪里出了错,而不是世界的视觉外观。因此只要两个世界在任务语义上一致($\sigma(W) = \sigma(W')$),在一个世界里积累的经验就能迁移到另一个世界,一个廉价但忠实于任务的仿真器就足以作为学习场所。这与三条既有路线都不同:与上下文操作(in-context manipulation)相比,后者只把演示、指令或工具描述放进上下文,从不把世界反馈蒸馏成可复用记忆;与自我改进智能体和上下文强化学习相比,它们要么在同一实例上重复试错从而混淆记忆与泛化,要么需要先用目标域学习历史预训练权重,要么用世界反馈去更新权重;与编码智能体相比,它们有终端作为世界、有现成的反馈闭环,而机器人操作此前缺少对应物。作者把这个对应物明确为“世界即终端”:仿真器扮演编码智能体终端的角色,使软件工程中已被验证的反馈闭环第一次完整地搬到物理操作上。
核心方法
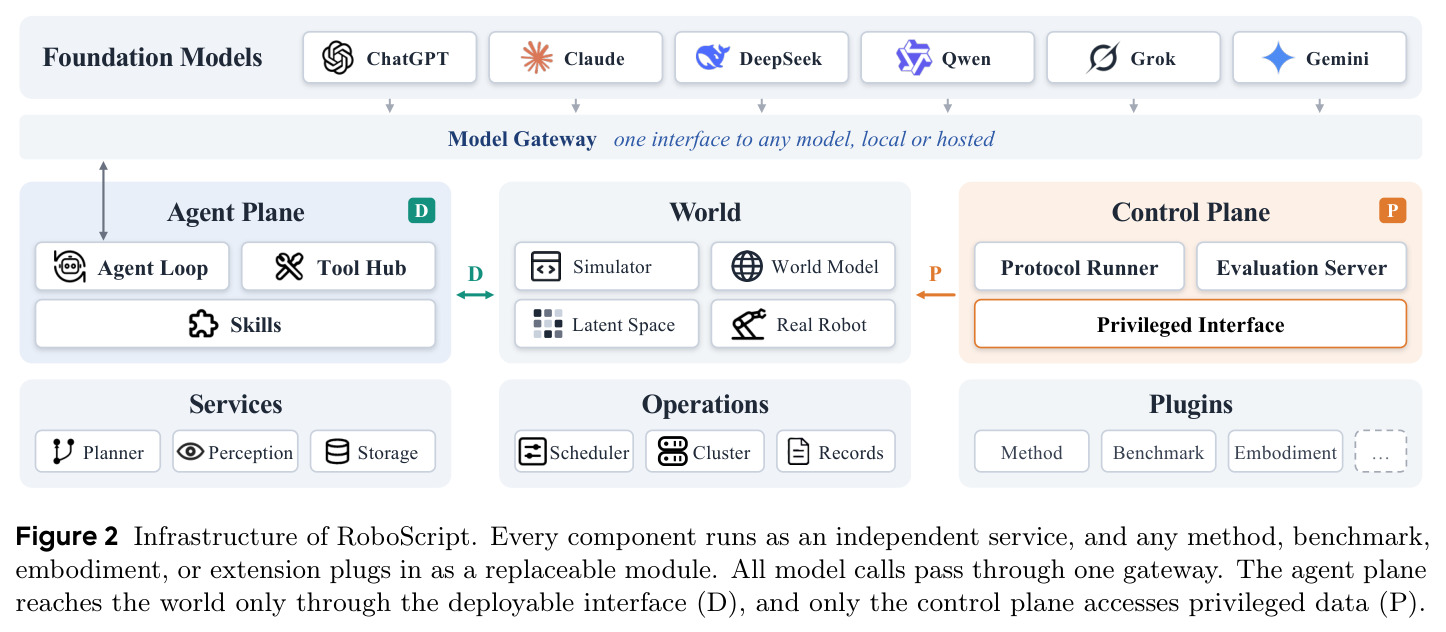
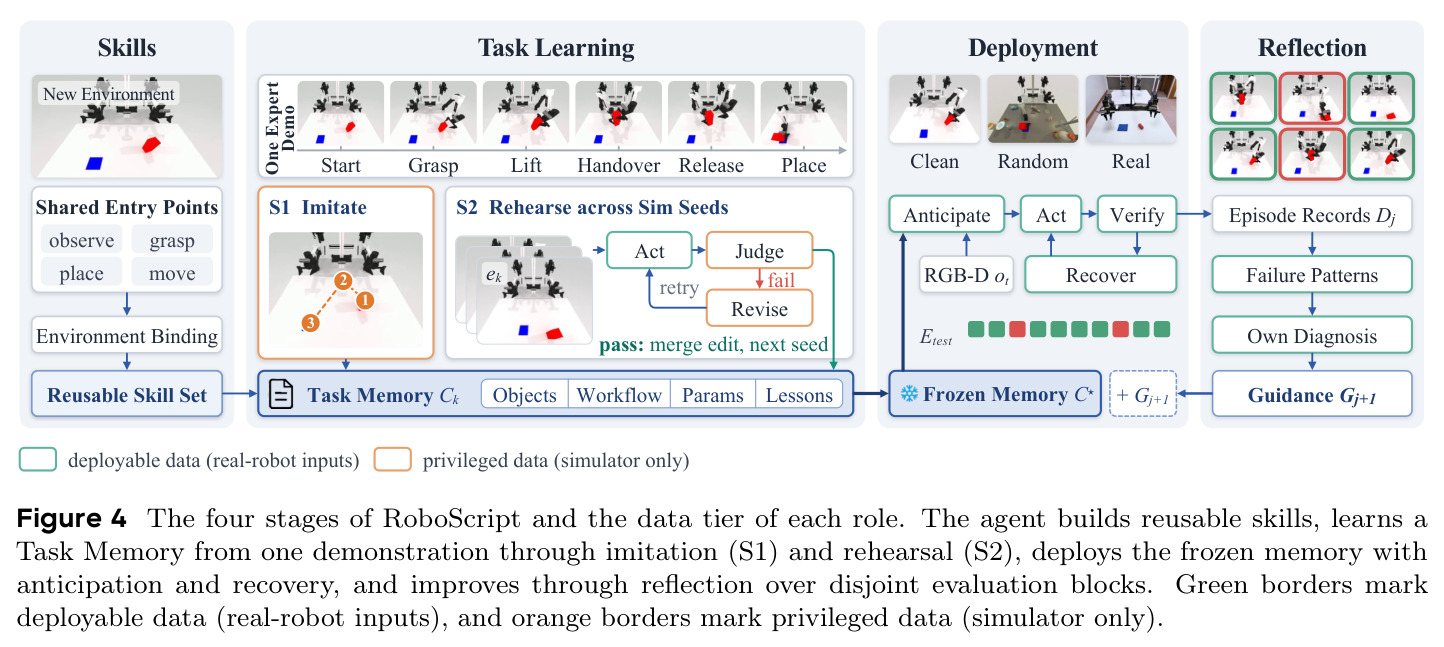
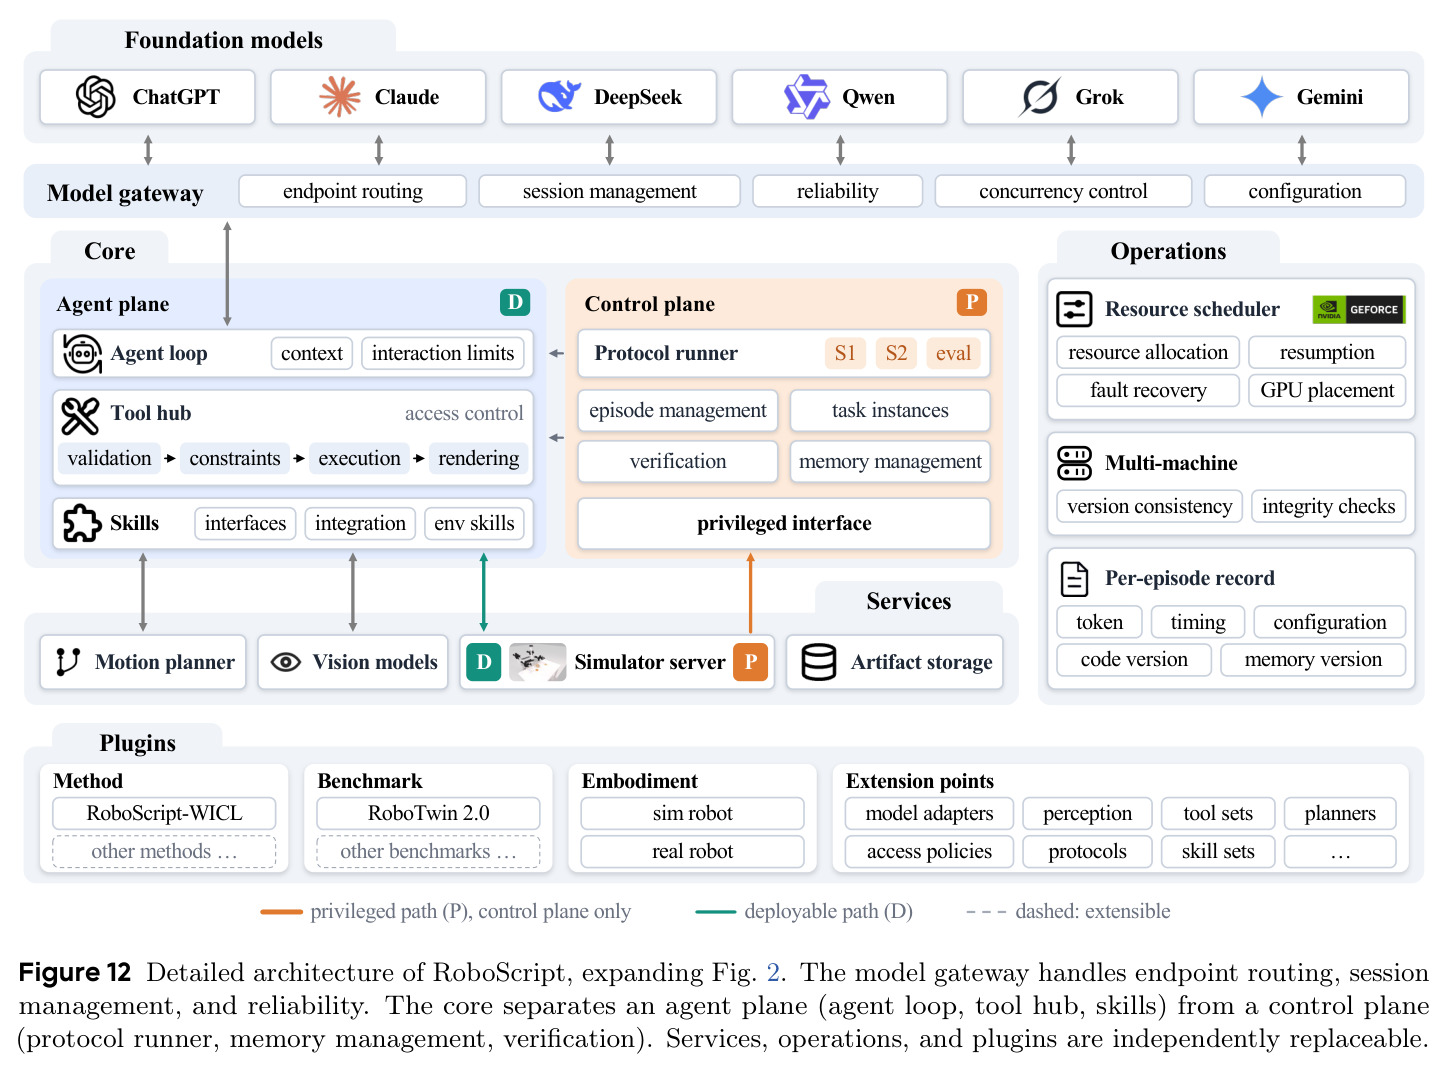
直觉上,RoboScript 像一个新员工:先看一遍老师傅的操作示范(演示),然后在训练车间(仿真器)里反复练习并把心得写成笔记(Task Memory),上岗时带着笔记预判与纠错,下班后复盘改进(反思)。技术上,WICL 用式 (1) 描述:$C^0 = I_\theta(d)$ 由读者角色从演示写出初始记忆;$(\tau^k, r^k) \sim \mathcal{W} \circ \pi_\theta(\cdot \mid o, C^k)$ 表示冻结模型在世界 $\mathcal{W}$ 中演练得到轨迹与反馈;$C^{k+1} = U_\theta(C^k, \tau^k, r^k)$ 把反馈改写进记忆,冻结为 $C^\star$。部署阶段按式 (2) $a_t \sim \pi_\theta(\cdot \mid o_t, C^\star)$ 执行,不再接收世界反馈。实现上分四阶段:技能构建(在共享入口点上为环境写技能)、任务学习(S1 模仿 + S2 演练)、部署(预判与恢复)、反思(跨不相交评估块的递归自我改进)。所有组件以独立服务运行,方法、基准、具身、模型皆可替换。
核心创新有三点环环相扣。第一,把世界反馈写进上下文而非权重:与 RL 和模仿学习把信号训练进参数不同,WICL 保持 $\theta$ 冻结,学习只改变可读文本 $C$,从而绕开分布耦合;上下文可被模型自己复查和改写,使递归自我改进无需任何梯度。第二,知识被刻意约束为语义性的:Task Memory 是结构化 Markdown 文档,记录物体角色与查找方法、各阶段工作流、以感知物体为参照系的 GraspSpec/PlaceSpec 相对规格(如“从左侧接近把手并抓其中点”)以及失败教训,绝不存任何场景绝对坐标;一个记忆 linter 拒绝坐标、真值术语和实例标识符进入。这解释了为什么 $\sigma(W) = \sigma(W')$ 时记忆可跨世界迁移,而权重会吸收 $W$ 的一切表面规律。第三,数据隔离是构造性保证而非口头约定:执行智能体在演练和部署中只见可部署层级数据(RGB-D、本体感知、运动规划器回执),特权仿真信息只作学习期监督且必须经 linter 才能进入记忆。这三点共同使“在廉价世界里学、在另一个世界用”成为可能。
方法步骤详情
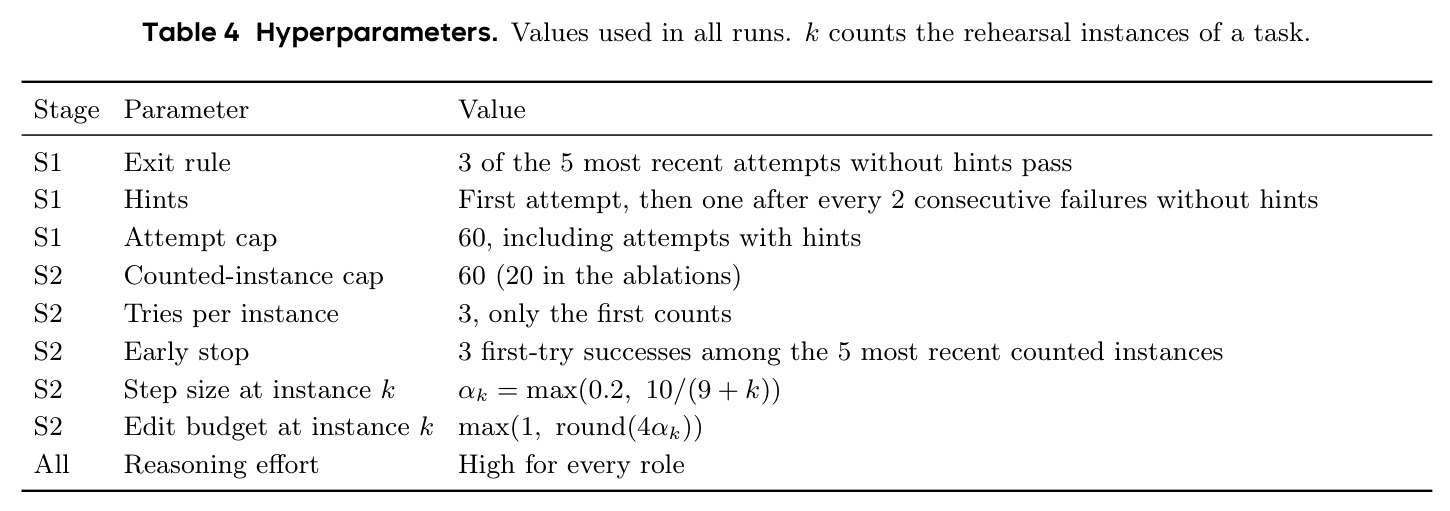
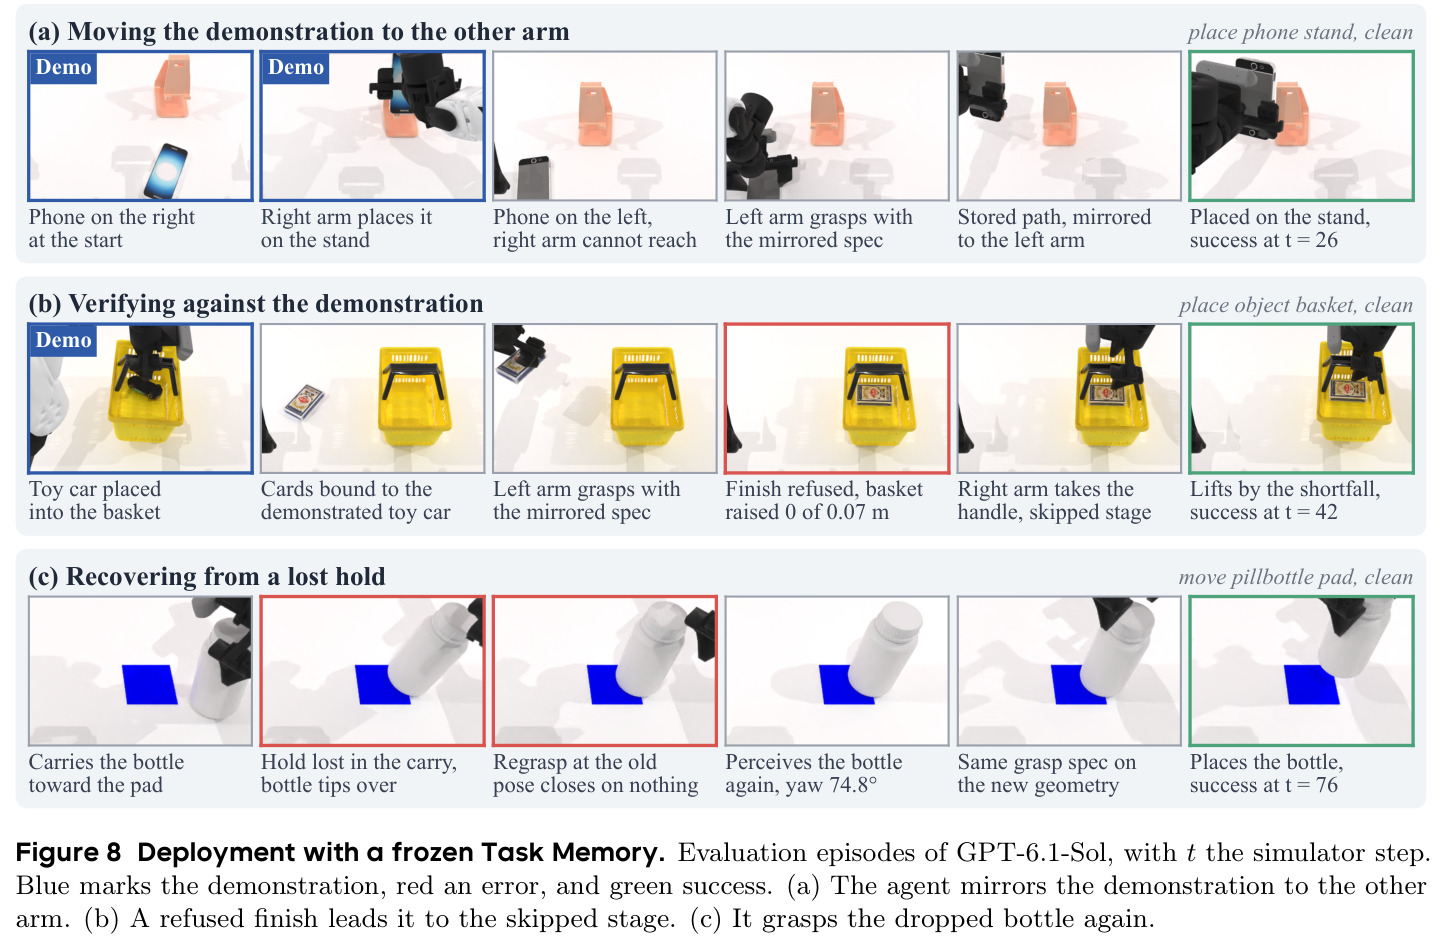
方法分四阶段。阶段一,接口构建:感知从深度图生成高度图做连通域提议,物体身份由 Set-of-Mark、grounding 模型与 VLM 三方投票确定;动作走三层 API——共享入口点(抓、放、纠偏、可达性、双臂协调)、自动探测的环境绑定、以及编码智能体按演示缺口写出的环境技能;每个动作返回回执(指令/实际位姿、夹爪开度、持物与否),把反馈 $r$ 具体化。阶段二,任务学习:S1 模仿中读者角色从演示 $d$ 写出 $C^0$,执行角色在演示实例上练习,评审角色逐次修订,最近 5 次中 3 次无提示通过即退出(上限 60 次);S2 演练在新实例上只计首试,失败时评审角色获真值诊断并改缓存副本,重试成功才合并,编辑预算与步长 $\alpha_k = \max(0.2, 10/(9+k))$ 递减,早停后过 linter 冻结为 $C^\star$。阶段三,部署:先场景预判(角色映射、可达性、序列可行性),失败不重置、退安全位姿重观察后继续,感知确认终态匹配后宣告完成。阶段四,反思:按 $G_{j+1} = V_\theta(G_j, D_j)$ 读可部署记录写指导,评估块互不相交。
技术新颖性
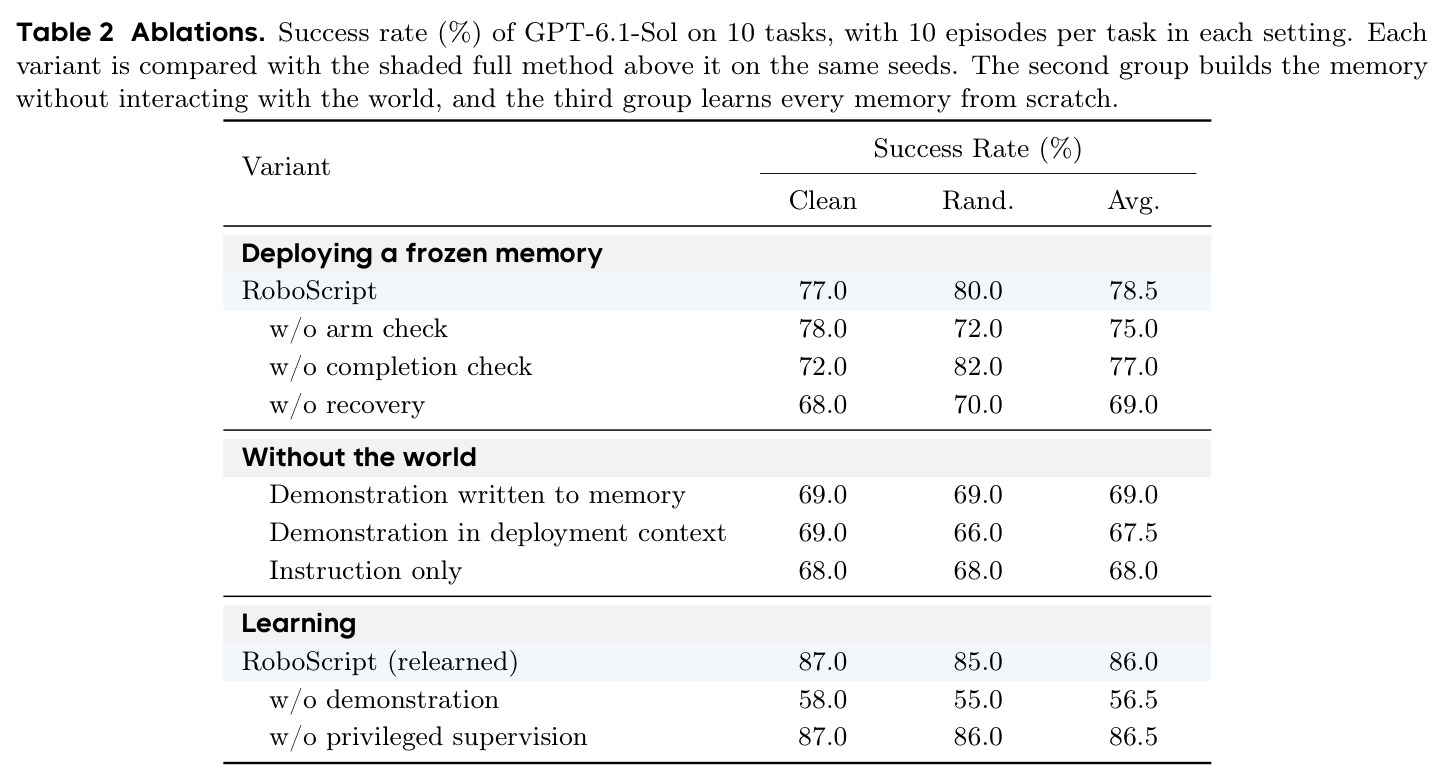
新颖性在于范式层面的组合而非单点技术。此前所有让机器人在交互中改进的方法——RL、自我改进系统、用仿真反馈写奖励函数的 Eureka 类方法、上下文强化学习——都把世界反馈写进权重,或要求先用目标域学习历史预训练模型;此前所有上下文操作方法都只把演示、指令或工具描述放进上下文,没有把跨回合的世界经验蒸馏成可复用记忆。WICL 第一次把“终端式世界反馈 + 冻结权重 + 跨回合记忆蒸馏”完整组合到物理操作。工程上也有可辩护的设计:$E_{\text{reh}} \cap E_{\text{test}} = \emptyset$ 使每个报告的成功都衡量泛化而非背题;类型化编辑与递减预算让记忆随练习自然稳定;回执机制让模型区分“命令被执行”与“效果已达成”;linter 把特权监督通道限制为只能以语义形式影响记忆。与最接近的 HarnessVLA 相比,RoboScript 从闭环中彻底移除了训练策略并强制数据隔离;与读取特权仿真状态的 FAEA 相比,它不依赖任何特权输入。消融显示特权监督完全移除后成绩 86.5% 对 86.0%,证明性能并非来自特权信息。
实验结果
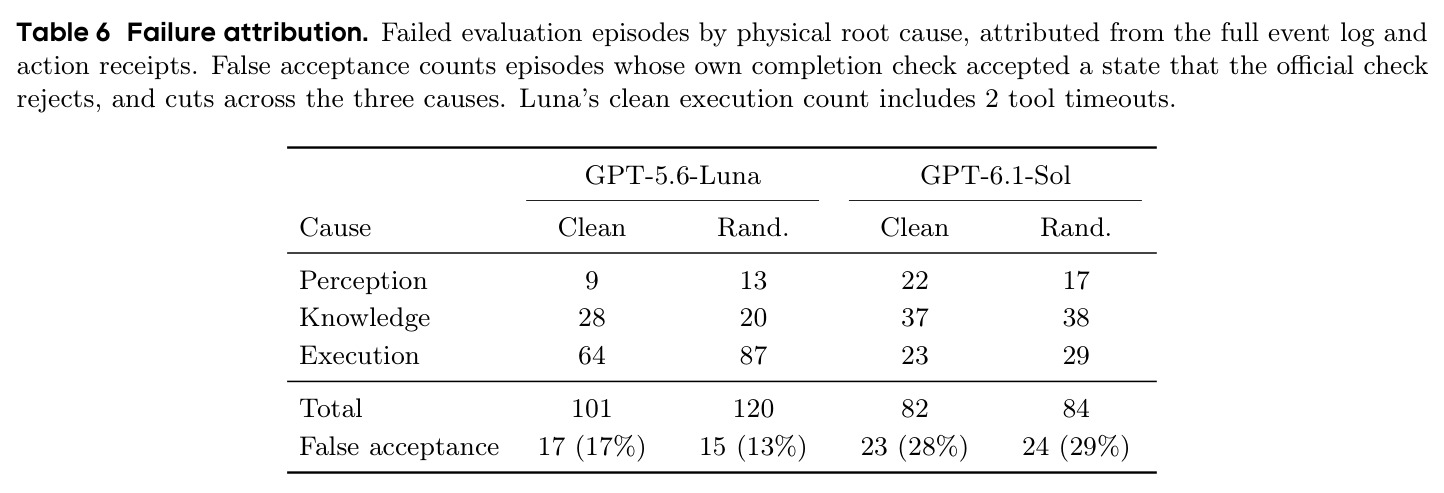
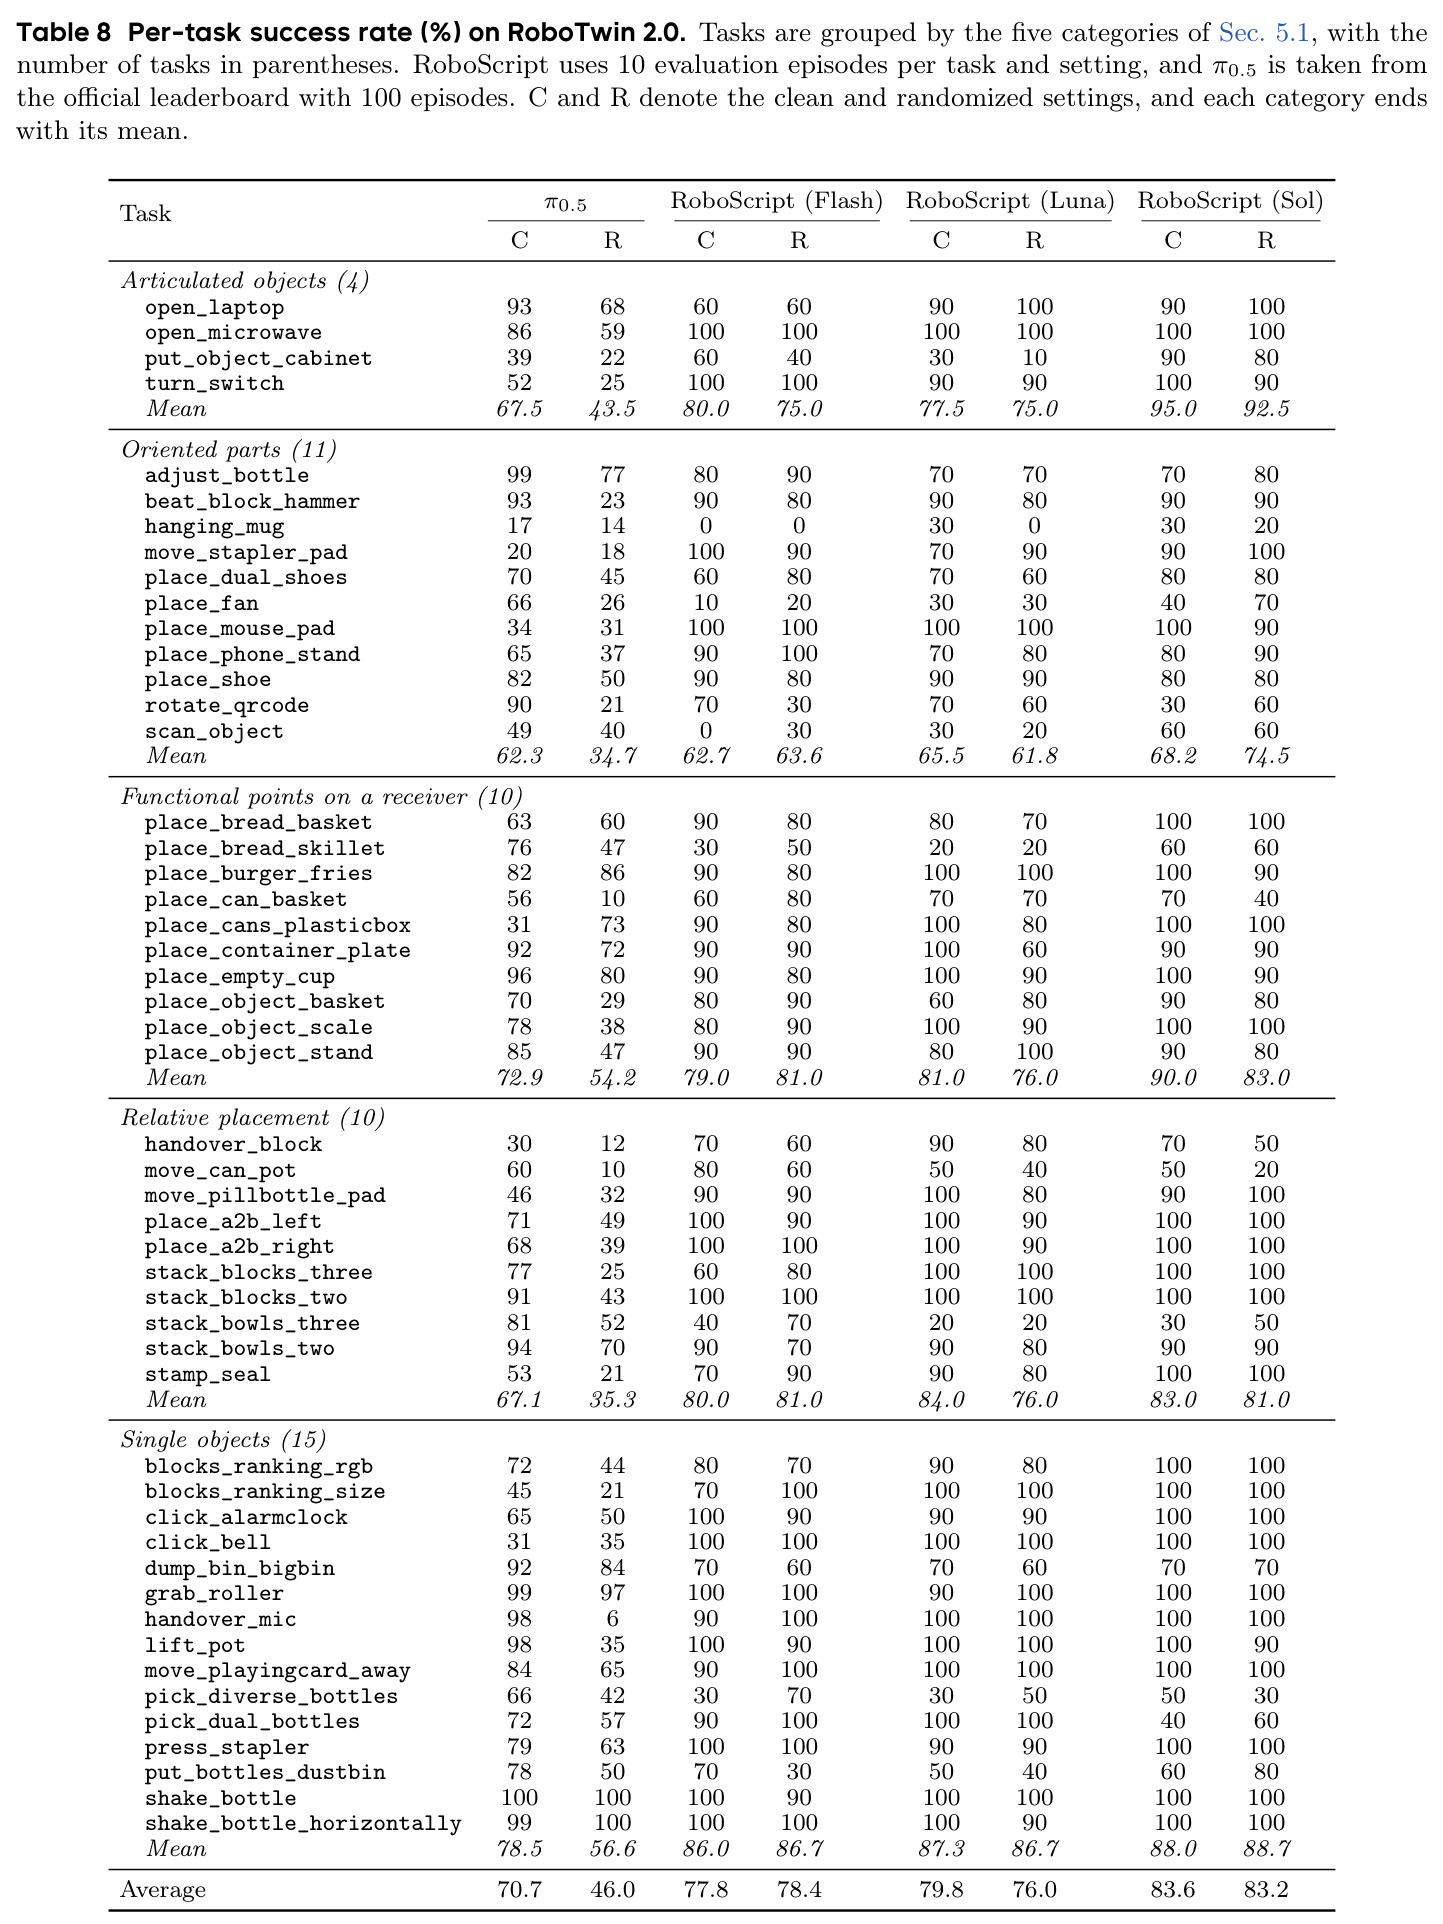
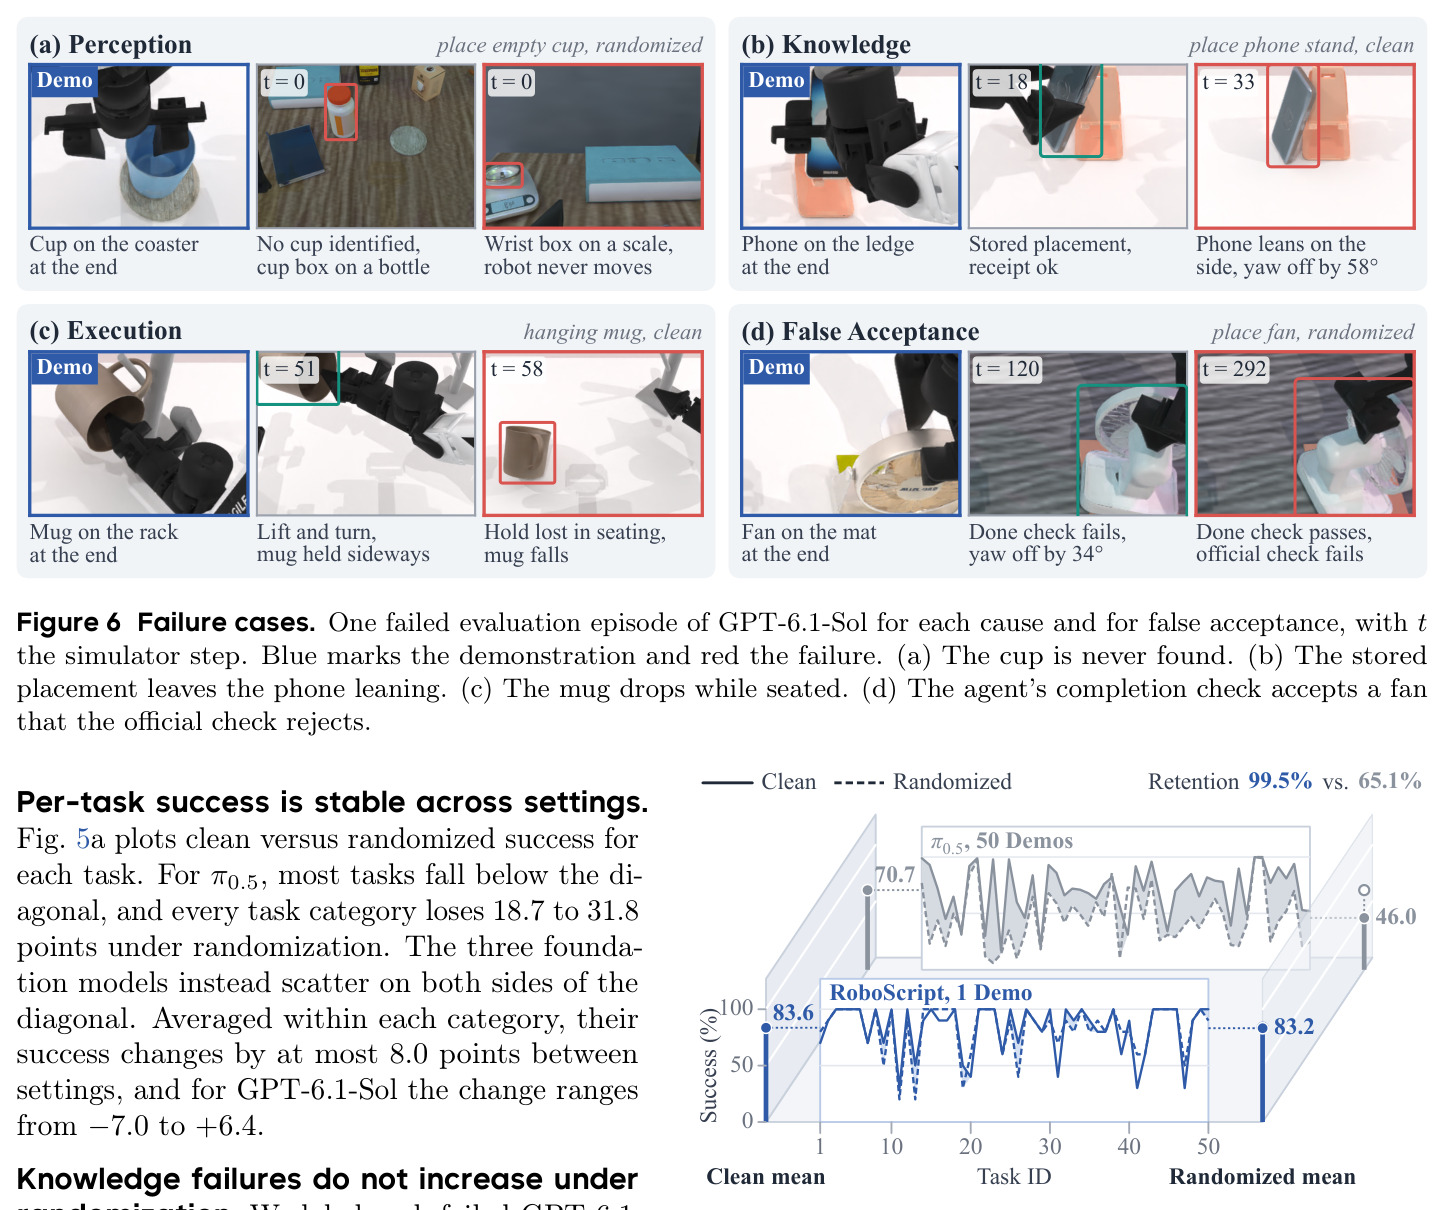
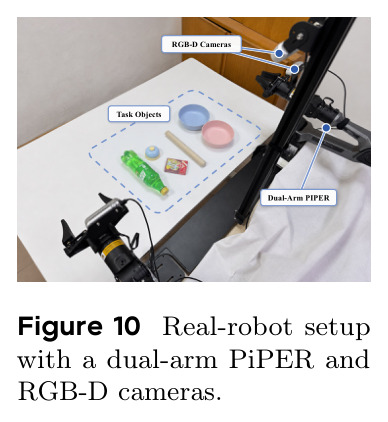
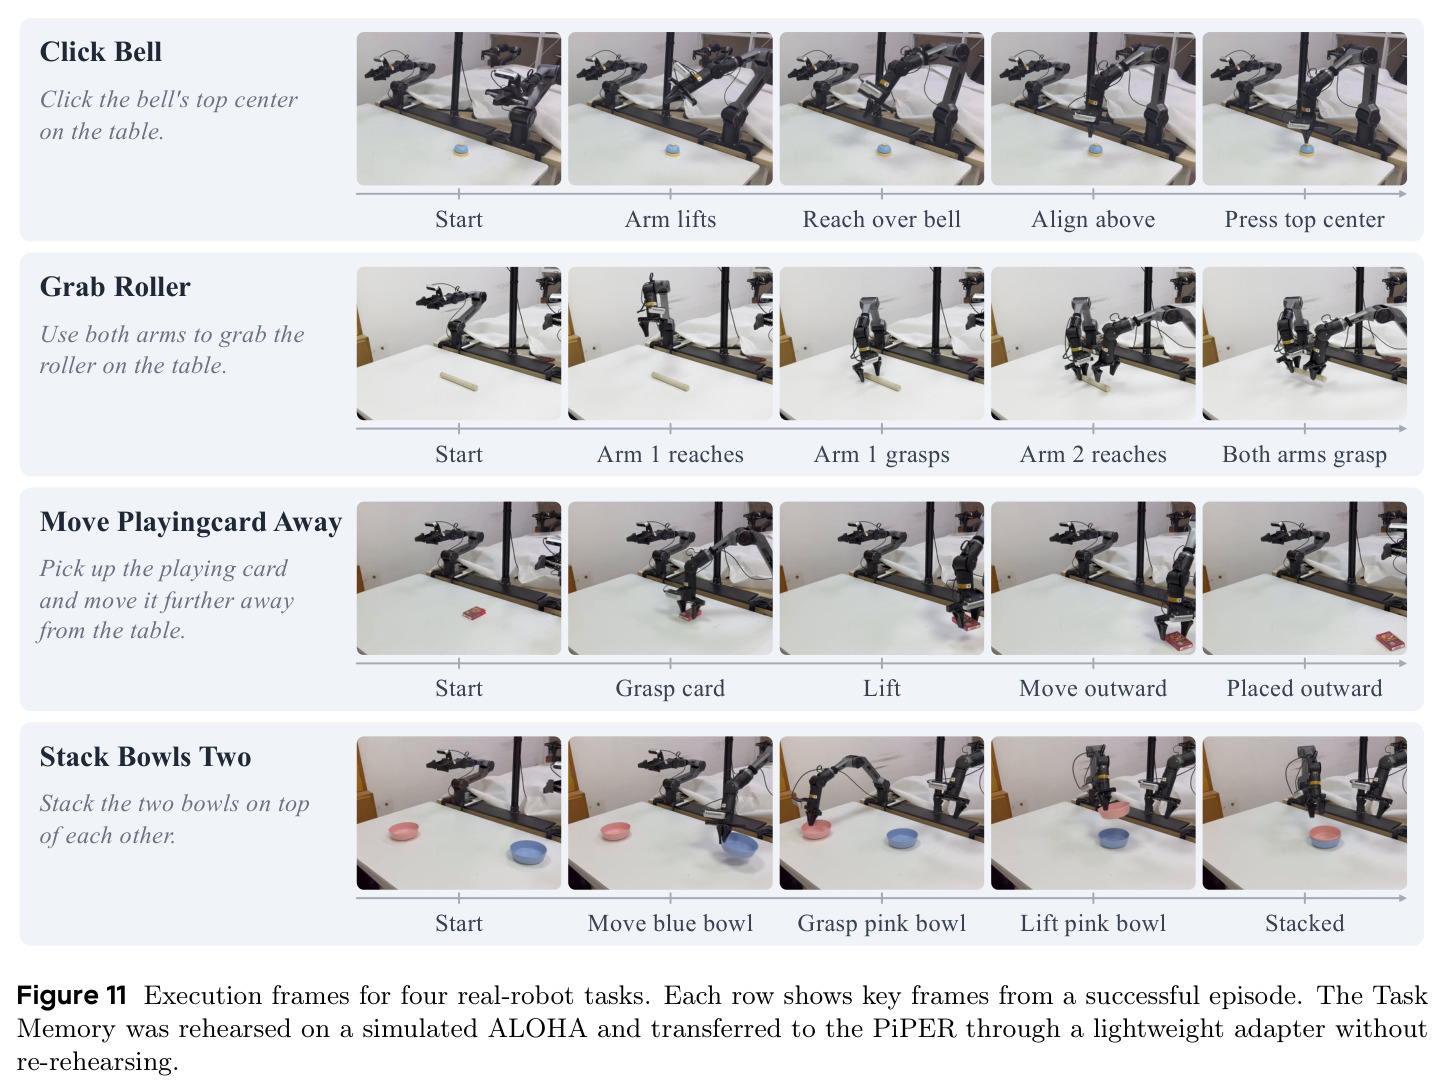
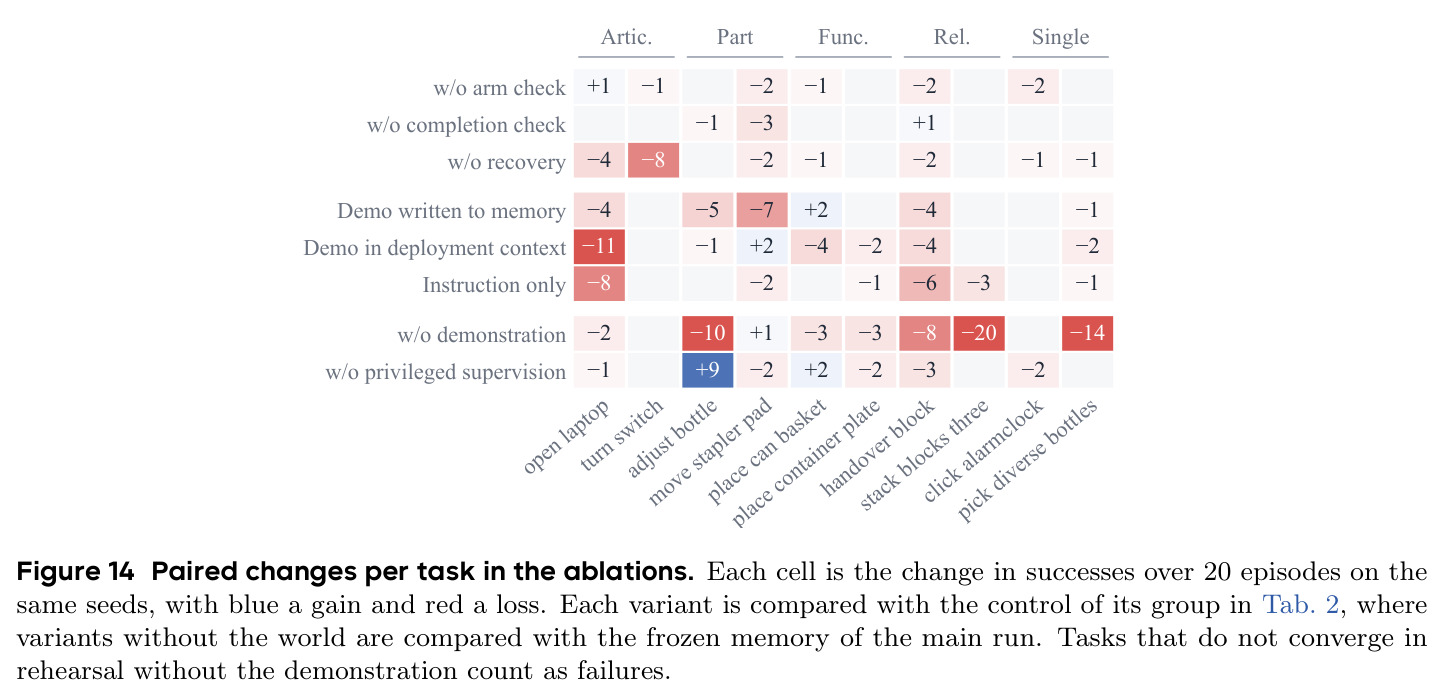
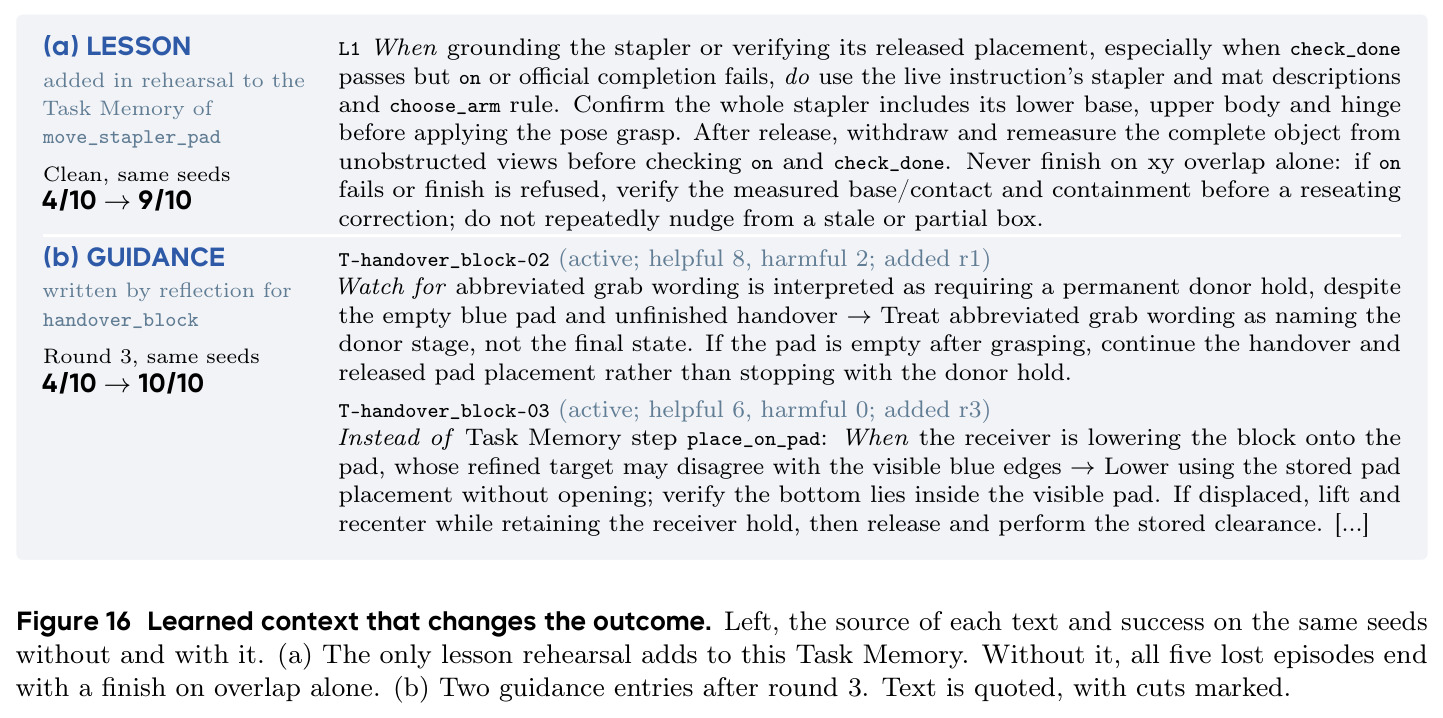
论文在 RoboTwin 2.0 全 50 任务上给出五条发现。其一,单演示加演练足够:GPT-6.1-Sol 版达 83.4% 平均成功率(干净 83.6%、随机化 83.2%,Wilson 区间 81.0–85.6),而 50 演示训练的最强策略 4D-WAM 仅 61.7%,平均差 21.7 点。其二,知识跨分布稳定:三模型留存率 95.2%–100.8%,训练策略最高 65.1%;随机化下超 HarnessVLA 24.8 点。其三,性能随基础模型扩展:同代码下 Flash 78.1%、Luna 77.9%、Sol 83.4%,Sol 领先的 bootstrap 区间为正。其四,反思改进冻结记忆:17 个弱任务三轮净增益 +18/+8/+4 回合,指导条目 74→97→112。其五,跨具身迁移:记忆经轻量适配器部署到真实 PiPER 双臂机器人,四任务 10/10、7/10、7/10、6/10。失败归因显示随机化下知识类失败不变(37→38);消融中移除恢复从 78.5% 降至 69.0%,无演示学习崩至 56.5%(p=0.004),无特权监督 86.5% 对 86.0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin 2.0 全 50 任务(干净+随机化平均) | 平均成功率 (%) | 83.4(RoboScript + GPT-6.1-Sol,每任务 1 演示,零梯度更新) | 61.7(4D-WAM,每任务 50 演示训练;次强 π0.5 为 58.4) | +21.7 个百分点,且训练数据少 50 倍 |
| RoboTwin 2.0 随机化设定 | 成功率 (%) | 83.2(仅在干净场景演练,从未见过随机化实例) | 46.0(π0.5,训练策略中随机化成绩最高者) | +37.2 个百分点 |
| RoboTwin 2.0 干净设定 | 成功率 (%) | 83.6 | 81.5(4D-WAM,50 演示/任务) | +2.1 个百分点(基本持平,优势主要来自随机化设定) |
| 域随机化留存率 | 随机化成功率 / 干净成功率 (%) | 99.5(Sol)、95.2(Luna)、100.8(Flash) | 65.1(π0.5,所有训练策略中最高;FastWAM 仅 2.4) | 至少 +34.4 个百分点 |
| 反思自改进(17 个弱任务,GPT-6.1-Sol) | 三轮净修复回合数(新修复 − 新破坏) | +18 / +8 / +4(指导条目 74→97→112) | 无指导的冻结记忆(同种子配对对比) | 每轮净增益均为正,验证 RSI 在零梯度下有效 |
| 真实 PiPER 双臂机器人 4 任务(Click Bell / Grab Roller / Move Playingcard Away / Stack Bowls Two) | 成功回合数(每任务 10 回合) | 10/10、7/10、7/10、6/10(合计 30/40) | 无直接可比基线(仿真 ALOHA 上演练的记忆经适配器跨具身迁移) | 首个零重训练、零重演练的跨具身记忆迁移验证 |
局限与改进
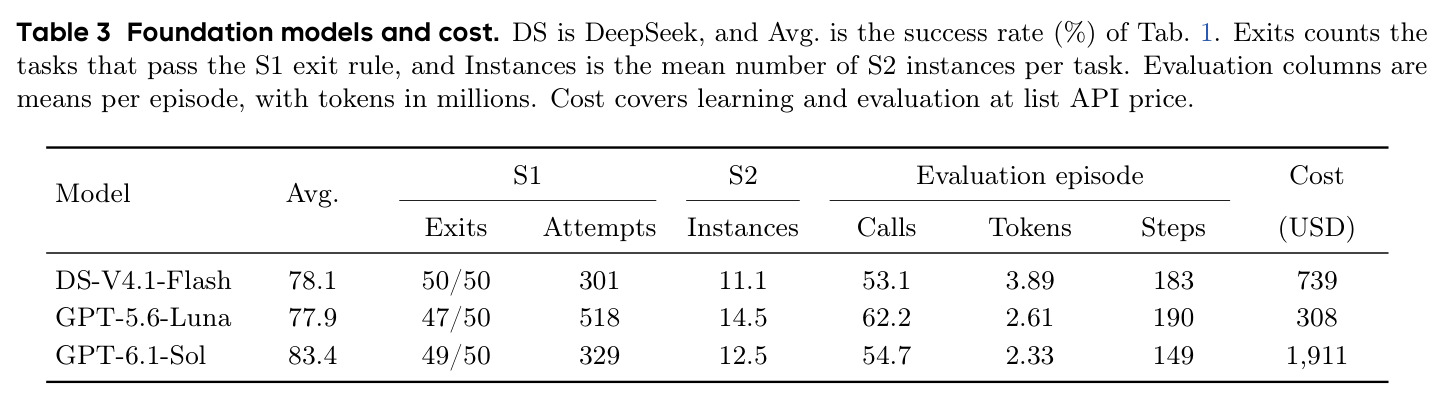
作者承认的限制:一是依赖商业 API 基础模型,服务质量随时间波动,同一实验不同会话成绩可差几个点;二是推理慢,GPT-6.1-Sol 一次评估回合平均 54.7 次模型调用、149 个仿真步,机器人每步都要等模型返回;三是反思的净增益迅速收缩(+18→+8→+4),且稀疏的成功信号使剩余失败难以归因;四是所有评测任务只涉及刚性或铰接物体,布料、线缆等可变形物体和需要双臂紧耦合接触的任务仍然困难。我的补充观察:每任务每设定仅 10 回合,按任务重采样的 95% 区间宽达 77.5–89.0,细粒度排名的统计功效有限;S2 评审角色仍依赖真值诊断这一特权监督(虽有无特权消融,但官方成功信号本身仍来自仿真器);技能构建需要全部 50 个任务的演示来覆盖技能缺口,新环境的冷启动成本未被量化;误接受率约 28–29% 恒定存在,说明完成检查本身是系统性短板;真机验证只有 4 个任务且采用离线规划的执行方式,未测试真机在线恢复。
独立分析的弱点
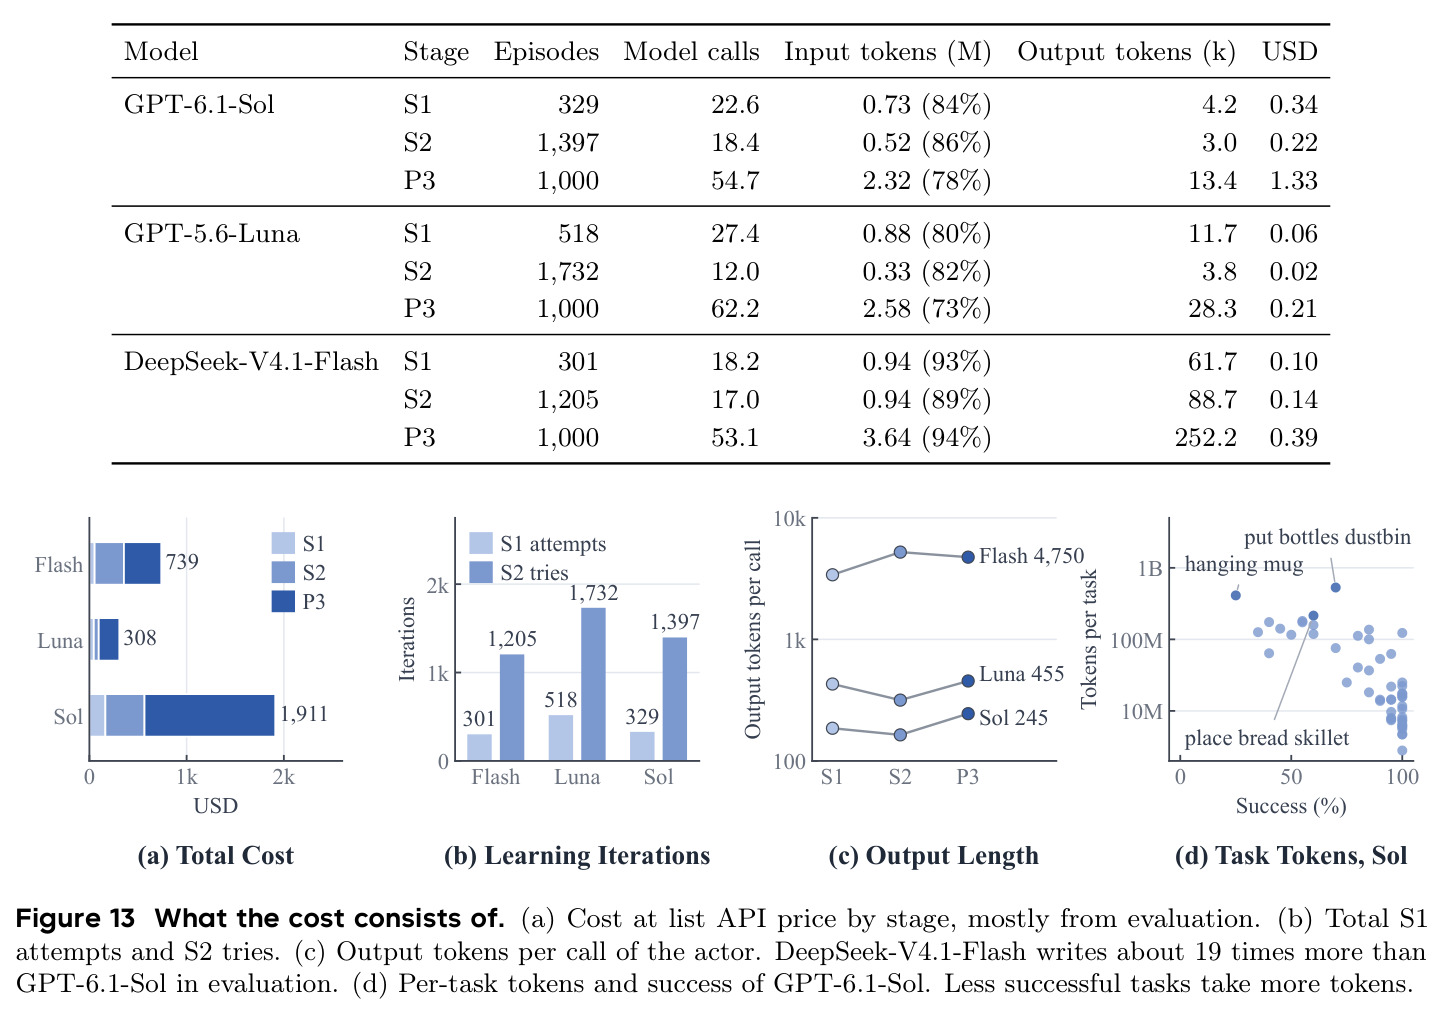
独立分析五个弱点。第一,实时性不足:每回合中位耗时 6.4 分钟且约 80% 在等模型 API,无法用于毫秒级反应场景;改进方向是把 Task Memory 蒸馏成小模型或做层次化执行(大模型规划、小模型反应控制)。第二,学习锚定在“语义忠实的仿真器”上:若仿真接触或可变形动力学与真世界语义不一致,$\sigma(W) = \sigma(W')$ 前提即失效;改进方向是用真实数据校准的世界模型补充并检验保真度。第三,闭源模型单点依赖:完整流程花费 308–1911 美元且绑定特定 API;改进方向是微调开源模型充当各角色或建立可共享记忆库。第四,感知链条是隐性瓶颈:高度图提议对遮挡、透明、反光物体脆弱,失败案例中杯子根本未被识别;改进方向是主动视角调整与多视角融合。第五,弱任务天花板明显:hanging_mug 仅 30/20、stack_bowls_three 30/50,精细接触与多阶段装配仍是短板;改进方向是接触富任务的专用技能模板。
未来方向
作者提出的方向:智能体在现有技能失败时自动编写新技能;多个专门化智能体协同完成长时程任务;无仿真器可用时在学习到的世界模型中演练;以及训练以具身为本的基础模型,使其天生会用具身工具、读物理反馈并维护任务记忆,从而比通过 API 调用通用模型更快、更便宜、更可靠。基于本文成果可延伸的方向包括:把反思循环与主动学习结合,让智能体主动挑选最能暴露记忆缺陷的演练实例,加速收敛;把 Task Memory 发展为可组合、可版本管理、可跨任务共享的技能库,研究记忆合并与冲突消解机制;探索“元记忆”——即关于如何学习任务的记忆——以压缩新任务的学习轮次;把 WICL 推广到移动操作、工具使用等更长时程的设定;在真机上以安全过滤器为边界做真实世界演练,摆脱对仿真器的依赖;以及从理论上刻画语义迁移的成立条件,量化世界保真度与迁移性能之间的关系。
复现评估
代码开源于 GitHub(ArcheOne-AI/RoboScript)并有项目主页,基准 RoboTwin 2.0 公开且有官方排行榜与评测服务器,复现条件较好。主要障碍在基础模型:结果依赖 GPT-6.1-Sol、GPT-5.6-Luna、DeepSeek-V4.1-Flash 等商业 API 模型,API 质量波动可使成绩差几个点,读者未必能获得相同版本。算力方面,仿真器、运动规划器与视觉模型需 16 块 RTX 4090(2 台服务器),基础模型走 API 不需本地训练 GPU;完整 50 任务学习加 1000 回合评估花费 308–1911 美元,每任务约 301–518 次 S1 尝试与 11–15 个演练实例,时间成本可观但并非不可及。基础设施为复现做了扎实设计:每回合记录代码版本、配置、记忆版本与 token 用量,作业可断点恢复,跨机校验和验证,所有模型使用一致提示与协议。总体评估:拥有 API 预算与多卡仿真机器的团队可复现主表量级;消融样本较小(每变体 200 回合),复现时应沿用其配对种子设计。
论文图表
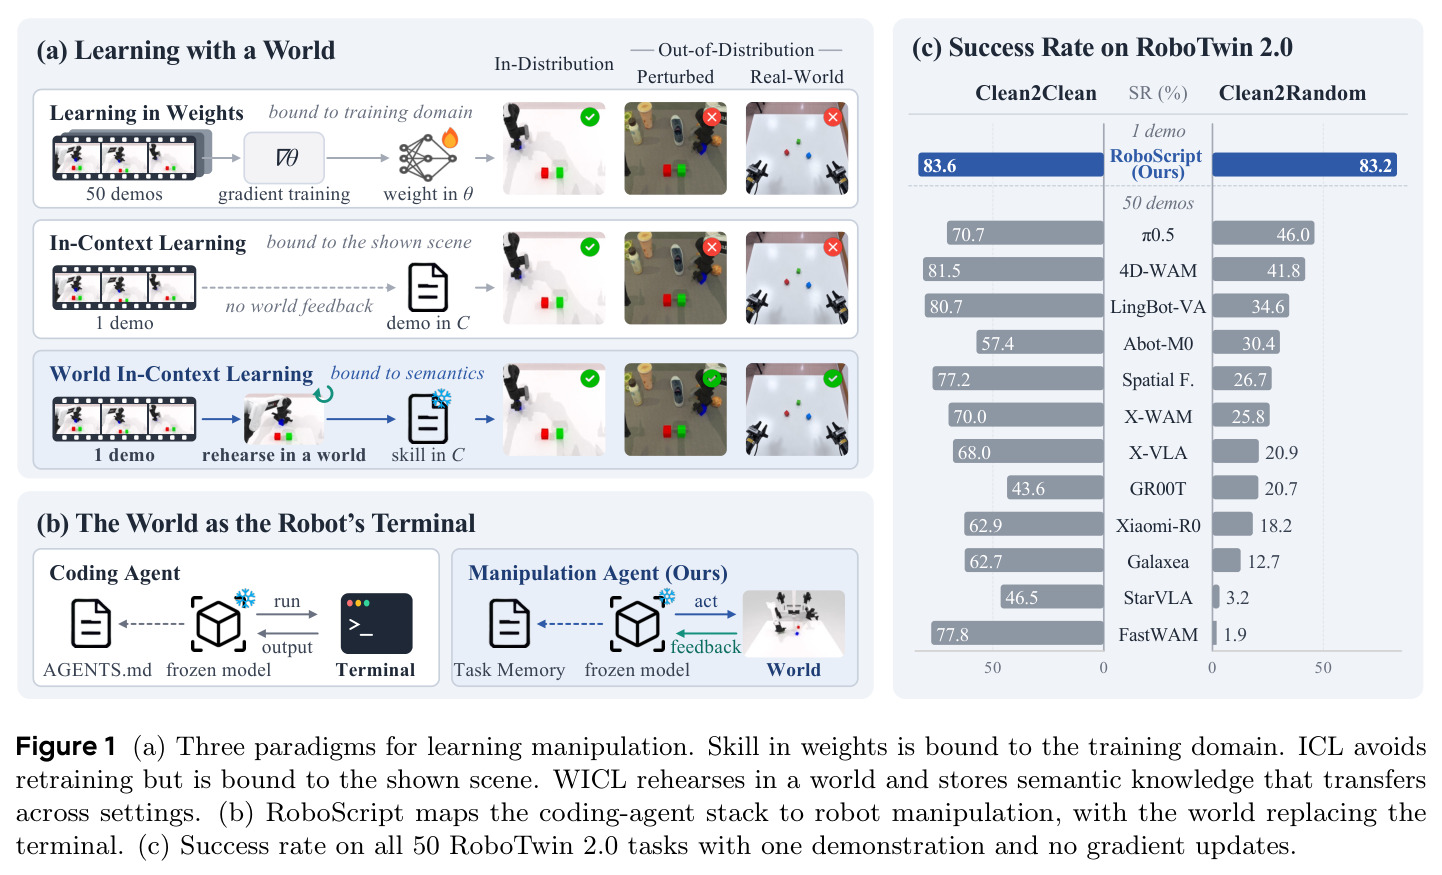
三联图:(a) 对比三种学习范式——权重学习绑定训练域、上下文学习绑定所示场景、WICL 绑定语义故可跨设定迁移;(b) 把编码智能体栈映射到机器人操作,世界取代终端的角色;(c) 50 任务上的成功率横条对比,RoboScript 以单演示达 83.2–83.6%,远超 50 演示训练的最强策略。
一张图概括了论文的问题定义、核心类比和主结果,是理解全文动机的最快入口。
对比 RoboScript 与 π0.5 的每任务成功率柱状图:π0.5 从 70.7% 跌到 46.0%,RoboScript 从 83.6% 几乎不变到 83.2%,留存率 99.5% 对 65.1%。
最直观地展示了“语义知识跨分布稳定”这一核心发现。
一个完整冻结 Task Memory 的原文展示:指令与物体角色、八个阶段的工作流(目标、用臂、API 调用、完成条件)、21 条类型化参数规格(放置偏移、姿态、阈值)、演练新增的阶段 3(换手交接)与两条教训。
让读者看到“学到的知识”的真实形态——一份语义化、无绝对坐标的结构化文档。
分阶段成本:Sol 的 S1 每回合 22.6 次调用 0.34 美元、S2 18.4 次 0.22 美元、评估 54.7 次 1.33 美元;输入 token 缓存命中率达 73–94%;Flash 输出 token 极大(评估 252.2k)导致总成本反超 Luna。
展示成本主要来自评估阶段且受模型输出习惯影响,为模型选型提供依据。