将视觉语言模型的智能迁移至机器人控制 Transferring the Intelligence of VLMs to Robotic Control
用游戏化语义动作接口加少样本上下文演示,让冻结VLM零训练闭环操控机器人达SOTA
前置知识
VLM(视觉语言模型)
在海量网页图文数据上预训练的多模态大模型,能同时理解图像与文本并进行推理、规划与工具使用,如 GPT-6 Astra、Gemini-3.8-Flash。它原生输出文本而非机器人动作,其智能主要形成于数字世界。
本文的核心论点是:这类模型已有的通用智能足以直接驱动真实机器人,只需合适的接口和少量示例来'释放'它,而不需要动作数据再训练。
VLA 模型(视觉-语言-动作模型)
在 VLM 基础上用大规模机器人演示微调出的模型,把视觉观测和语言指令直接映射为连续动作序列,代表工作有 π0.5、OpenVLA、X-VLA、LingBot-VLA。其训练数据采集昂贵且与机器人本体强绑定。
VLA 是本文最重要的对照组。理解其'用数据训练动作头'的范式,才能体会 RoboDawn '零参数更新'路线的本质差异及其声称的通用能力退化问题。
上下文学习(ICL, In-Context Learning)
在提示词中给出少量输入-输出示例,模型不做任何梯度更新即可模仿示例格式与策略解决新任务。演示的质量、格式和对齐程度决定效果,且上下文过长反而会干扰模型注意力导致性能下降。
RoboDawn 从零样本到 one-shot 的性能跃升完全由 ICL 驱动;论文的两级演示设计与 8-shot 反而退化的现象,都是 ICL 特性的直接应用与体现。
闭环视觉决策与末端执行器控制
闭环指'观测环境→推理决策→执行→再观测'的循环,模型可依据执行结果在线纠错。机械臂操控通常以末端执行器位姿为控制抽象,论文定义夹爪交互点 GIP 为两指尖中点,作为感知标注、状态汇报与运动指令的统一参考点。
RoboDawn 所有指令都被定义为 GIP 在世界坐标系下的增量位姿变化;闭环结构则是其执行反馈接地与失败恢复机制的根基。
研究动机
当前主流路线是用大规模机器人数据训练端到端 VLA 与世界-动作模型(WAM),让预训练 VLM 适配动作输出。这条路线代价高昂:RoboTwin 2.0 C2R 官方协议要求对 50 个双臂任务各收集 50 条干净示教再做全量后训练,而真机数据比构建 VLM 的互联网图文数据稀缺数个数量级,且绑定具体本体、难以跨机器人/环境/任务扩展。效果也不理想:同协议下 FastWAM 仅 1.9%、StarVLA 10.6%、GalaxeaVLA 12.7%,最强的 π0.5 也只有 46.0%。更严重的是,近期证据(Hancock et al. 2026 等)表明用动作预测微调 VLM 会损害其指令跟随与推理等通用能力,在数据稀缺背景下大规模参数更新还有过拟合狭窄分布、侵蚀可泛化智能的风险。
本文的目标是本文想回答一个根本问题:VLM 从数字世界习得的智能,能否不经过任何机器人训练就直接迁移到物理世界操控机器人?具体目标是设计一个对人类直觉友好的轻量动作接口,让冻结参数的 VLM 以智能体方式闭环控制机器人——观察视觉状态、推理下一步、执行、再根据结果调整后续决策;同时用极少量上下文演示(甚至 1 条)弥合接口语义与任务策略之间的鸿沟,并在 RoboTwin 2.0 C2R、RoboDojo 两个仿真基准和 Franka 真机上验证:零样本/少样本性能能否超过用全量数据训练的策略。
与已有工作不同的是,与把 VLM 当作可训练底座、用动作数据改造它的主流范式不同,本文把机器人操控重新表述为 VLM 已经极其擅长的交互式视觉决策问题:通过 move/rotate/gripper 等离散语义指令暴露控制权,类似人类玩游戏、用 GUI 工具的抽象层级,从而对齐网页级预训练中已见过的概念。另一个独特之处是接口-上下文学习协同设计:原始专家轨迹由连续低层动作构成,无法直接当示例,作者将其翻译到语义指令空间,并分解为指令入门 $\mathcal{D}_{prim}$ 与任务演示 $\mathcal{D}_{task}$ 两级上下文。相比同期工作 Show-Harness 只设计 harness,RoboDawn 证明 ICL 策略的共设计同样带来关键增益。
核心方法
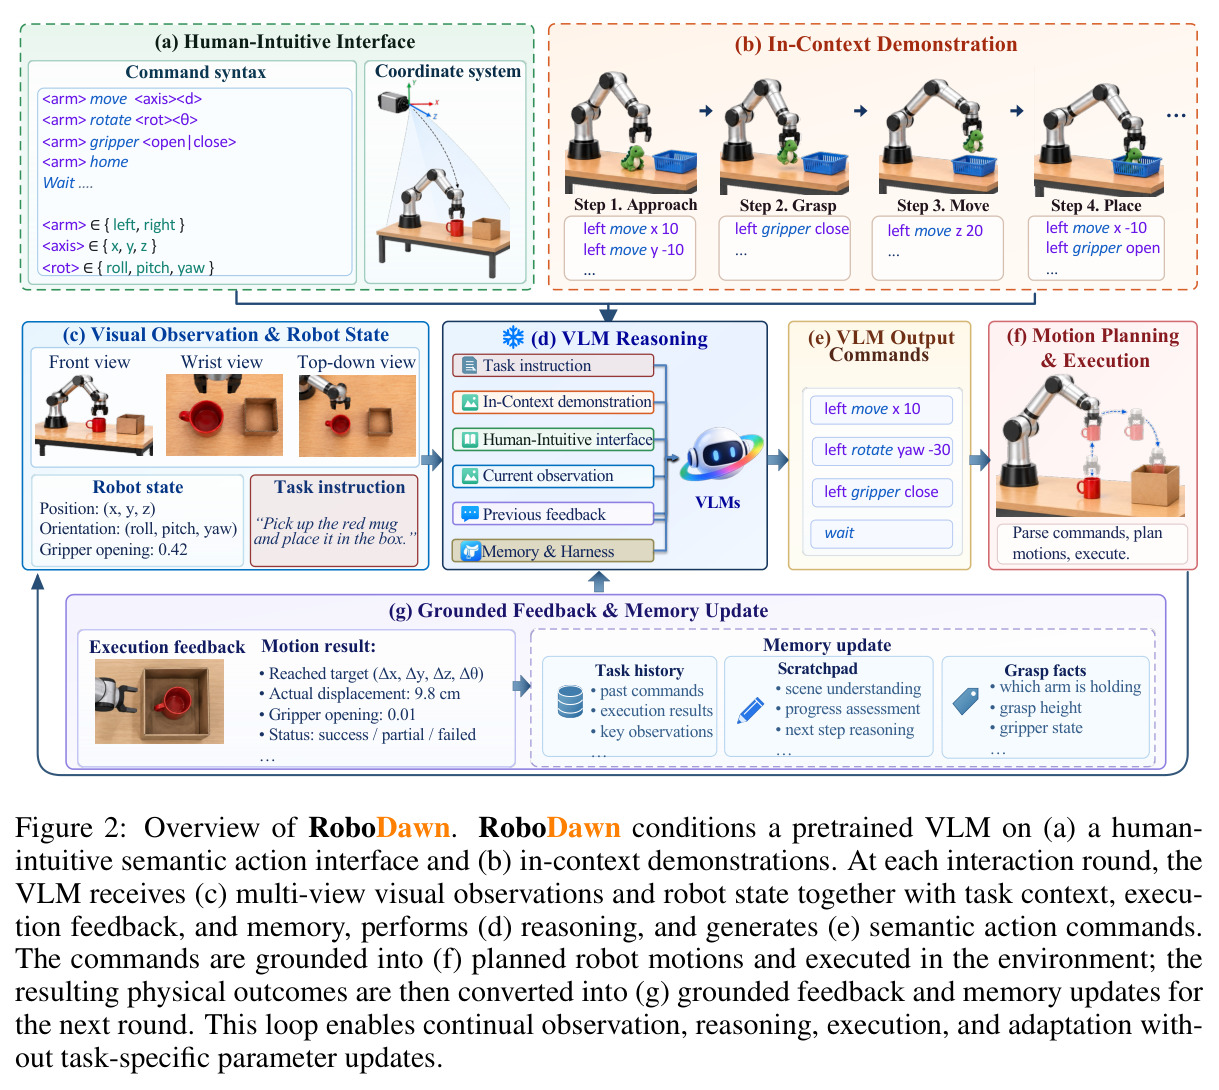
RoboDawn 把操控任务形式化为闭环决策过程。每轮 $t$,冻结参数的 VLM $\pi_\theta$ 接收语言指令 $\mathcal{L}$、固定的机器人-环境档案 $\mathcal{E}$、上下文演示集 $\mathcal{D}$,以及动态输入:标注后的多视角图像 $I_t$、机器人状态 $x_t$、上轮反馈 $F_{t-1}$、交互记忆 $M_t$,输出结构化响应 $y_t$(任务进度估计、当前计划、scratchpad)与语义指令序列 $a_t$:$(y_t, a_t) = \pi_\theta(\mathcal{L}, \mathcal{E}, \mathcal{D}; I_t, x_t, F_{t-1}, M_t)$。执行算子 $E_P$ 把指令落地为机器人运动并转化为反馈 $F_t$,观察算子 $O_P$ 构造下一观测,记忆按 $M_{t+1} = U(M_t, a_t, y_t, F_t, x_{t+1})$ 更新。全程不使用特权物体位姿,参数与 $\mathcal{E}$、$\mathcal{D}$ 回合内固定,适应完全来自观测、反馈与记忆的演化。
核心创新是两个互补设计。其一,人类直觉接口:以夹爪交互点 GIP(两指尖中点)为统一参考,定义 7 类离散语义指令——move 沿 x/y/z 轴平移、rotate 绕 roll/pitch/yaw 旋转(单步限幅 20cm/90°)、point 设定 down/forward/down45 朝向预设、gripper 开合、home、wait、done。这种游戏化的增量式抽象规避了低层连续控制,也避免了训练 VLA 造成的通用能力退化。其二,接口对齐的两级 ICL:$\mathcal{D} = \mathcal{D}_{prim} \oplus \mathcal{D}_{task}$,前者演示每条基础指令的物理效果,后者展示如何组合指令完成完整任务;专家轨迹先降采样为末端路点序列,再用短指令序列逐一到达,把连续轨迹翻译成模型本可自己发出的指令流,从而以零参数更新的方式教会冻结 VLM 使用接口并掌握任务策略。
方法步骤详情
第一步,定义 GIP 并搭建语义指令文法 $A=\{$move, rotate, point, gripper, home, wait, done$\}$,所有空间命令相对世界系、作用于 GIP 的增量位姿。第二步,构建观测:前视/腕部/俯视多视角图像加网格标注辅助定位,附带 GIP 位置 $(x,y,z)$、朝向 $(roll,pitch,yaw)$ 与夹爪开合度。第三步,VLM 逐轮推理,输出带 rationale 的结构化响应与指令序列(如 left move x 10 → left rotate yaw -30 → left gripper close)。第四步,执行器把每条指令翻译为到达目标 GIP 位姿的完整规划运动并执行到静止,将实际位移、夹爪开合与成功/部分/失败状态转化为反馈。第五步,更新记忆:任务历史、scratchpad、抓取事实(哪只臂持物、抓取高度、夹爪状态)。第六步,构建 ICL:脚本专家或人类遥操作轨迹转为路点、再转为指令流,图像按语义重要性稀疏化(每回合上限 16 张),rationale 由 VLM 回放补写。
技术新颖性
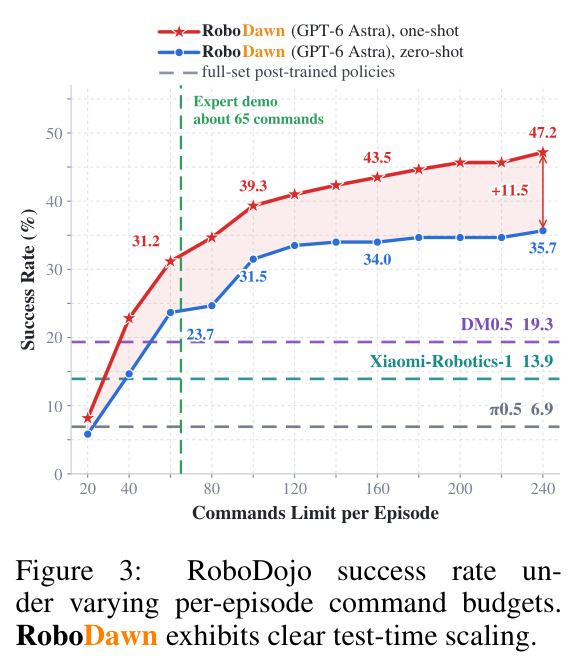
技术新颖性体现在四点。第一,范式层面:不训练、不微调,把'具身智能从零学起'换成'设计接口与在线课程以释放已有智能',并证明 VLM 高层决策能力可直接转化为操控能力——消融显示性能随模型强度单调上升(GPT-5.6-Luna 14.4% 到 GPT-6 Astra 73.6%)。第二,接口-示教共同设计:示教被重表达为语义指令空间的完整交互回合(含视觉观测与执行反馈),而非动作标签,使 one-shot 即可同时落地指令语义与任务级策略。第三,长程任务的图像稀疏化、记忆与 scratchpad 机制支撑了明确的测试时扩展:指令预算从 60 提到 240,one-shot 成功率从 31.2% 升至 47.2%。第四,反馈接地设计(实际位移、三态判定)让模型能在线纠错与恢复失败,这是纯开环 VLA 策略所不具备的能力。
实验结果
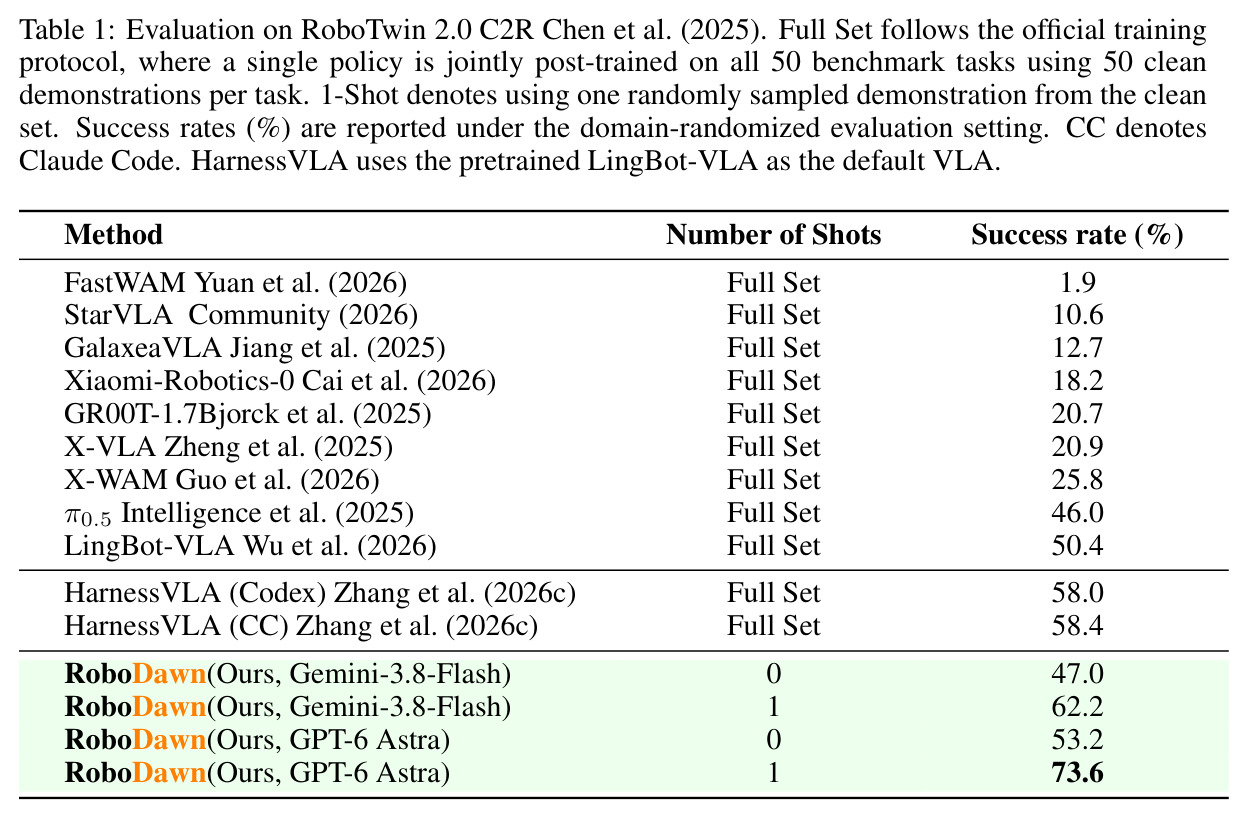
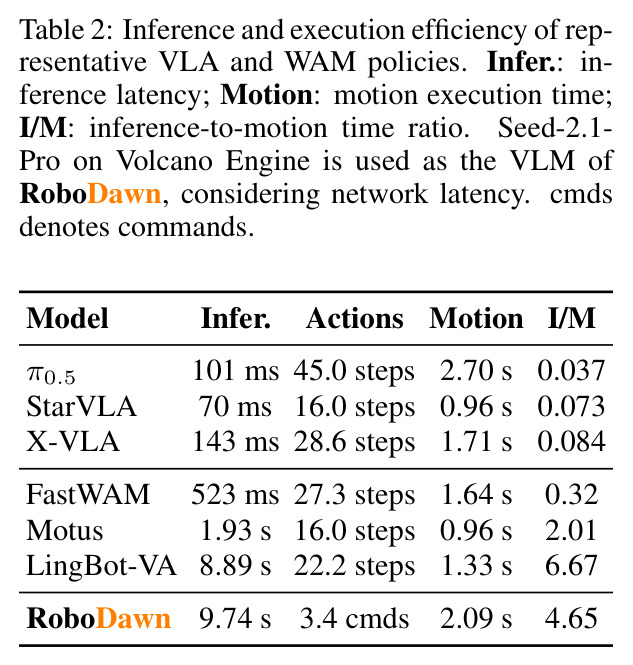
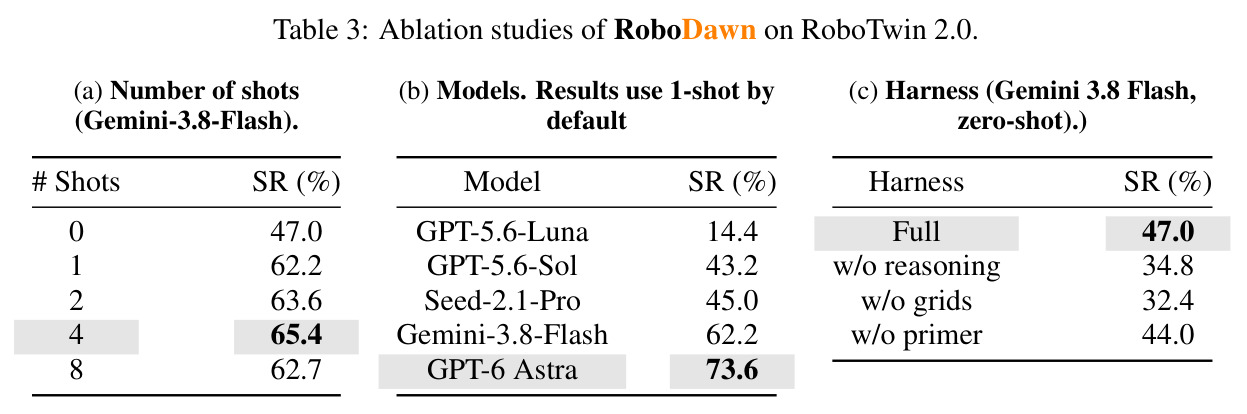
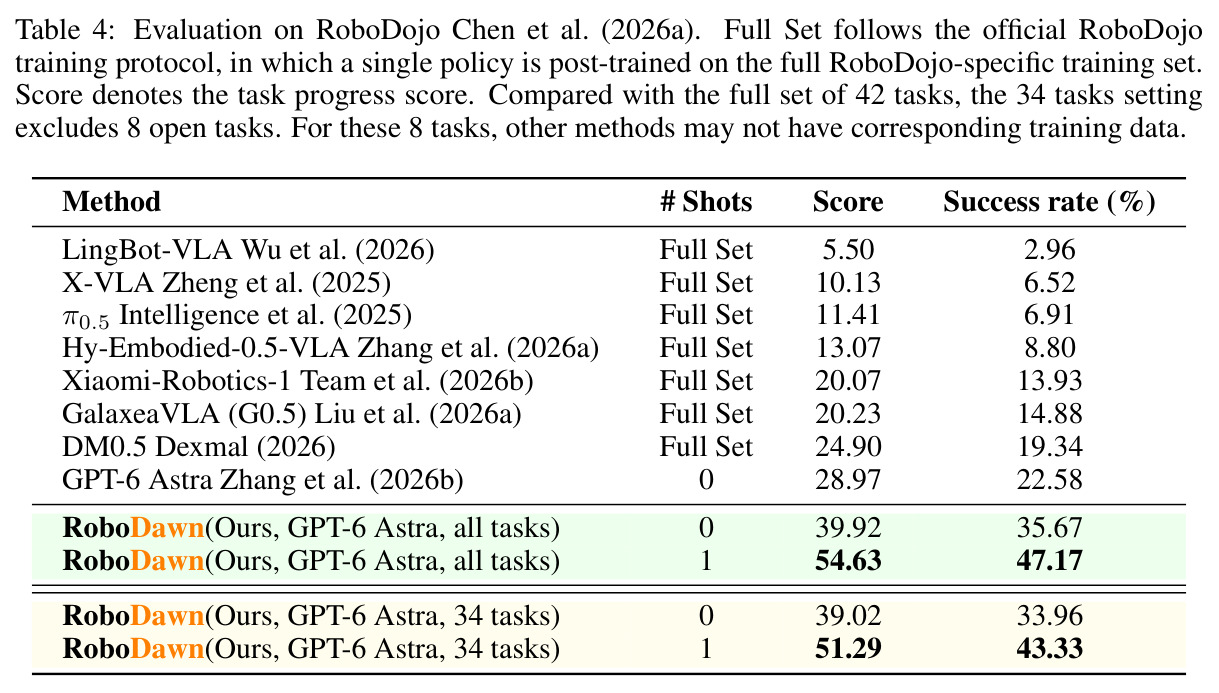
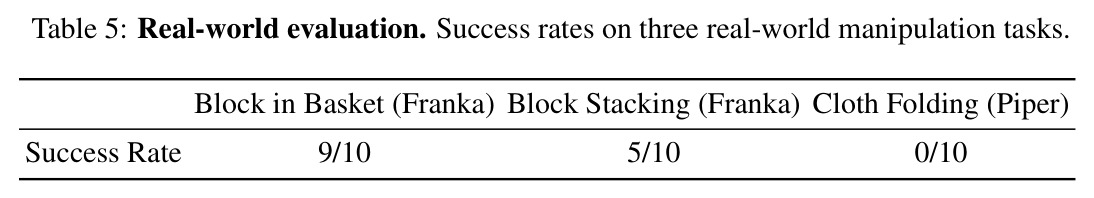
RoboTwin 2.0 C2R(50 个双臂任务、每任务 10 次评测、域随机化):GPT-6 Astra 零样本 53.2%,已超过用 50 任务×50 条示教全量后训练的 π0.5(46.0%)与 LingBot-VLA(50.4%);仅 1 条上下文示教即升至 73.6%,比 SOTA 智能体方法 HarnessVLA(CC) 的 58.4% 高 15.2 个百分点。Gemini-3.8-Flash 为 47.0%→62.2%。消融:示教数 0/1/2/4/8 对应 47.0/62.2/63.6/65.4/62.7%,8 条因长上下文干扰回落;去推理、去网格定位、去指令入门分别掉至 34.8%、32.4%、44.0%。RoboDojo:零样本 35.67%、one-shot 47.17%(进度分 39.92/54.63),远超全量后训练的 DM0.5(19.34%)。真机:Block in Basket 9/10、Block Stacking 5/10、Cloth Folding 0/10。效率:推理 9.74s/轮、3.4 条指令、运动 2.09s,I/M 比 4.65,远慢于 π0.5 的 0.037。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin 2.0 C2R(50 个双臂操控任务,域随机化评测) | 平均成功率 | one-shot 73.6%(GPT-6 Astra);零样本 53.2% | π0.5 全量后训练 46.0%;SOTA 智能体方法 HarnessVLA(CC) 58.4% | 较 π0.5 +27.6pp,较 HarnessVLA +15.2pp,且无需任何机器人训练 |
| RoboTwin 2.0 C2R(Gemini-3.8-Flash 消融) | 平均成功率 | 零样本 47.0%,one-shot 62.2%,4-shot 65.4% | π0.5 全量后训练 46.0%;LingBot-VLA 50.4% | 零样本即超过 π0.5;one-shot 反超 LingBot-VLA 11.8pp |
| RoboDojo(42 个通才操控任务) | 成功率 / 任务进度分 | one-shot 47.17%(进度分 54.63);零样本 35.67%(39.92) | 全量后训练 DM0.5 为 19.34%(24.90);裸 GPT-6 Astra 为 22.58% | 较 DM0.5 +27.83pp,较裸模型零样本 +13.09pp |
| 真机部署(Franka 双臂 / Piper) | 成功率(10 次试验) | Block in Basket 9/10;Block Stacking 5/10;Cloth Folding 0/10 | 无训练基线(同一框架零样本直接部署) | 证明仿真到真机可直接迁移,但高旋转形变任务失败 |
| 测试时扩展(RoboDojo,改变每回合指令预算) | 成功率 | one-shot 从 60 条指令的 31.2% 升至 240 条的 47.2%;零样本 23.7%→35.7% | VLA/WAM 策略无测试时计算扩展能力 | 更多交互预算单调转化为更高成功率,体现智能体范式的独特 scaling 行为 |
局限与改进
作者承认四点局限:推理效率低(迭代 VLM 推理不适合高频控制场景);自由度难度不均——平移可靠而末端精确旋转薄弱,源于网页数据中旋转与 3D 朝向表征稀少,ICL 只能部分弥补;细粒度交互控制差,离散指令在接近、抓取、放置的微调阶段过粗;部署安全无保障,错误动作可能碰撞、损坏物品或伤人。失败分析给出三种模式:小目标精插失败(硬币入存钱罐)、IK 执行碰撞(语义合理但物理扰动场景)、任务完成判断与基准标准错位(倒水量不足即停)。我补充观察:性能强依赖前沿闭源模型(GPT-5.6-Luna 仅 14.4%);叠布 0/10 说明大幅旋转的形变物体任务仍是盲区;示教来自与评测基准相同的脚本专家,任务分布外泛化尚未验证;每轮约 9.74s 的推理延迟也带来可观的 API 时间与金钱成本。
独立分析的弱点
第一,粒度僵化:指令限幅 20cm/90°、离散步长固定,精细插入类任务(真机堆叠仅 5/10、硬币精插失败)缺乏连续微调能力,可引入自适应步长或局部连续修正头。第二,低层执行不设防:IK 碰撞等执行层错误未被语义层感知,应在反馈中显式报告碰撞/奇异性并触发重规划,或加入碰撞检测护栏。第三,模型依赖性:弱模型上整个框架近乎失效(GPT-5.6-Luna 14.4% vs GPT-6 Astra 73.6%),方法红利被前沿模型垄断,可研究针对该接口蒸馏或轻量微调小模型。第四,长上下文退化:8-shot 反而降至 62.7%,可用检索式或分层示教选择替代全量拼接。第五,成功判定错位导致提前 done(倒水不足即停),可引入独立验证器或显式完成条件检查。第六,推理延迟:I/M 比 4.65 难以流水线化,可探索缓存、投机解码或更小的本地 VLM。第七,闭环每步都需多视角图像,感知成本高,可研究关键帧触发式观测。
未来方向
作者方向:把 RoboDawn 视为通才具身智能的早期蓝图,继续打磨接口设计与在线课程,让基础模型已有的智能在物理世界'迁移、行动、改进';补足旋转/形变操作的表征短板;强化部署安全。可延伸方向:其一,双层架构——VLM 慢思考做高层规划、小型 VLA 做高频执行,兼顾 73.6% 的成功率与实时性;其二,把测试时扩展(指令预算 60→240 带来 31.2%→47.2%)与并行搜索、自我反思结合,逼近推理时最优;其三,跨本体泛化:接口只依赖 GIP 抽象,理论上可零成本迁移到人形、移动操作臂,值得系统验证;其四,示教获取自动化——让 VLM 自主探索生成自示范数据,摆脱对脚本专家与遥操作的依赖;其五,把回合内记忆扩展为跨回合长期记忆,支撑家庭级长程任务;其六,为安全关键场景加入形式化动作可达性与碰撞预检。
复现评估
复现难度中等偏上。基准与协议完全公开:RoboTwin 2.0 C2R 提供 50 任务×50 条脚本示教与域随机化评测,RoboDojo 提供 42 任务与官方协议,示教即来自基准自带脚本专家,无需额外采数;项目页为 robodawn.top。但核心依赖前沿闭源 VLM(GPT-6 Astra、Gemini-3.8-Flash、Seed-2.1-Pro),API 费用高——每回合约 3.4 条指令、任务需迭代多轮,50 任务×10 次评测的调用量可观,延迟评测还受网络抖动影响。论文未明确声明代码开源,提示词模板、网格标注、示教稀疏化(16 图预算)等工程细节需按文中描述自行实现。仿真复现需 GPU 渲染集群跑域随机化环境;真机部分需要 Franka/Piper 硬件与遥操作采示教。总体协议清晰、无训练成本,但工程细节与 API 依赖构成主要门槛。
论文图表
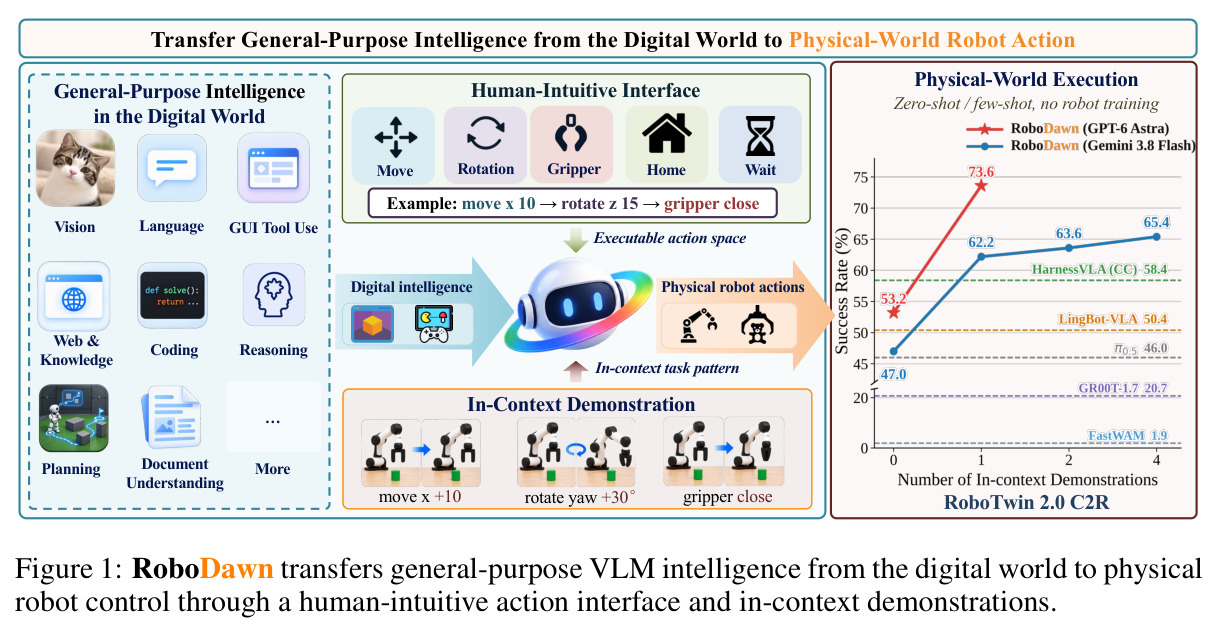
概览图:左侧是数字世界中的通用智能(视觉、语言、GUI 工具使用、编程、推理、规划等),右侧是物理世界执行;中间通过人类直觉接口(move/rotation/gripper/home/wait 等指令,如 move x 10 → rotate z 15 → gripper close)和上下文演示,以零样本/少样本、无机器人训练的方式把数字智能映射为可执行动作空间,右侧示意在 RoboTwin 2.0 C2R 上的指令序列示例。
这张图一图道尽论文核心命题:智能迁移而非技能学习。读者先看它就能理解'为什么不需要训练'——VLM 预训练中已具备的概念被接口直接翻译成机器人动作。
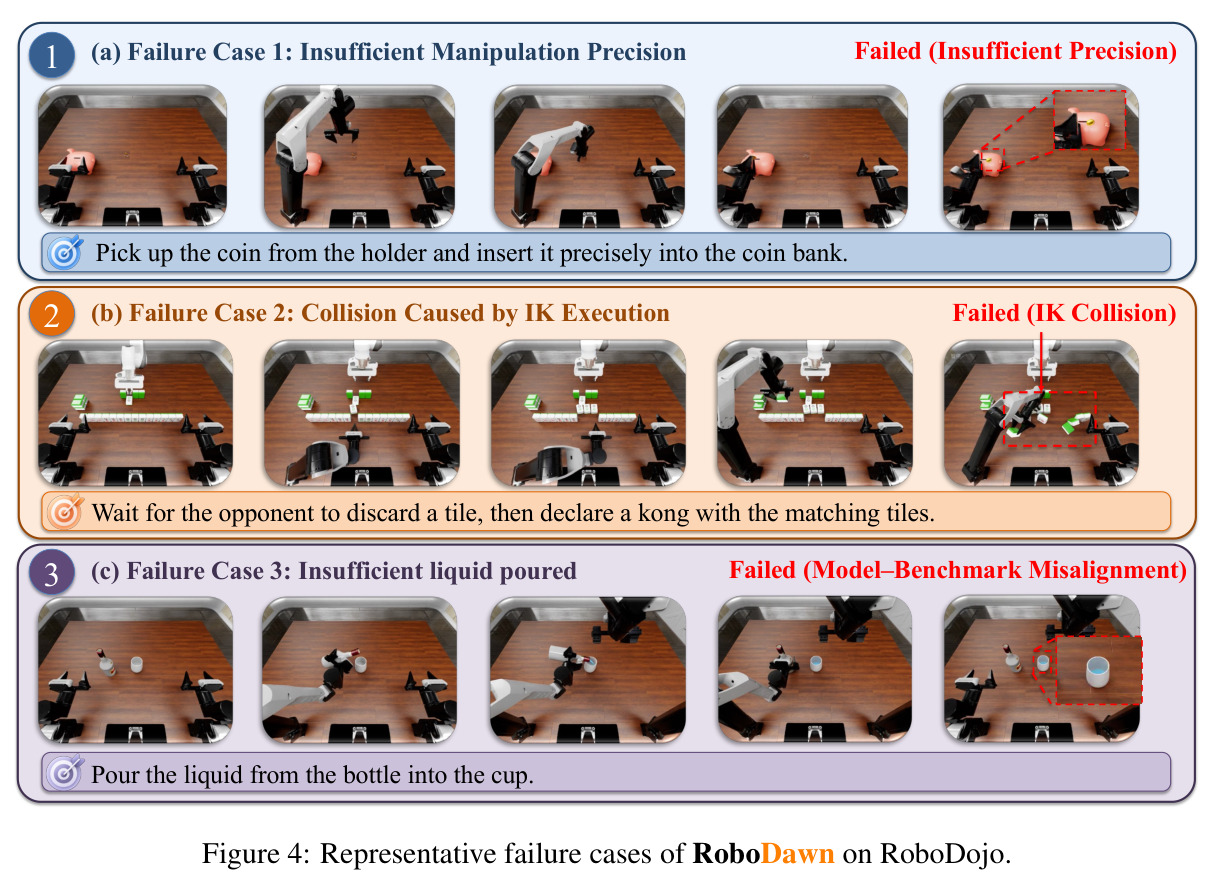
三类代表性失败:(a) 精度不足——硬币入存钱罐任务中高层意图正确但最终精插失败;(b) IK 执行碰撞——麻将碰牌任务中语义序列合理但运动与周围物体碰撞;(c) 模型-基准判据错位——倒水任务中液体转移不足模型即判定完成。
诚实呈现方法的边界:语义层规划能力与低层物理执行、精细控制之间的鸿沟,是理解该路线当前适用范围与改进方向的关键。