BlenderWorld:基于真实参考的视觉智能体三维创作评测基准 BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
首个223任务的Blender三维创作基准,冠军模型完整通过率仅42.2%
前置知识
MLLM 视觉智能体
以多模态大语言模型为大脑的自主智能体:模型接收任务指令与图像、视频等视觉输入,通过多轮「观察—思考—调用工具」循环操作软件(执行代码、查看截图、读写文件),并在交互中根据视觉反馈修正自己的行为。2D 设计(网页、海报、PPT)是其成熟应用,3D 建模是正在兴起的新场景。
本文的评测对象正是这类智能体,理解其工作循环才能看懂任务定义、工具统计与轨迹分析。
Blender 的 Python API 与 MCP 接口
Blender 是开源 3D 创作软件,可通过 Python API(bpy)以代码方式创建几何体、材质、灯光、动画并渲染,也支持 MCP(Model Context Protocol)把「执行 Blender 代码、查询场景信息、获取视口截图」等能力暴露为智能体可调用的工具。本文选它作为唯一评测环境,交付物是可编辑的 .blend 工程文件。
环境选择是论文开篇点名的三大挑战之首,所有任务、工具调用与结构检查机制都构建在 Blender 之上。
二元评分标准
把任务需求拆解为一条条可独立判定「满足/不满足」的检查项,每条附重要性权重(本文为 3/2/1 三档)与所需证据类型。加权通过率 $S_{rubric}=100\cdot\frac{\sum_{j=1}^{m}w_j\hat{y}_j}{\sum_{j=1}^{m}w_j}$ 度量需求满足度,比单一总分更可解释,还能精确定位失分在几何、材质还是布局。
2,651 条 rubric 是评测协议的核心,Rubric 分与 Perfect 率这两个关键指标都直接由它计算得出。
LLM/VLM-as-Judge 评测范式
用大模型代替人工评判生成结果:VLM-as-Judge 看渲染图判断视觉属性;Agent-as-Judge 则携带工具主动检查交付物(如查询场景内部状态、读取文件)后再判定。优点是可规模化,风险是裁判自身的偏差与幻觉,需要来源锚定、盲描述、证据强制等机制约束。
本文的证据路由双裁判设计是对这一范式的直接改进,是全文最重要的方法论创新点。
2D 视觉捷径
指生成结果只在某个特定视角下「看起来正确」,底层 3D 结构并不成立的作弊模式,典型如 view-dependent geometry——几何体只在提交相机视角下存在,换一个角度渲染内容就消失或穿帮。它说明模型可能在做 2D 图像拼贴而非真正的三维建模。
这是论文失败分析的核心发现,也解释了为什么多视角渲染与工程内部检查必须同时存在。
研究动机
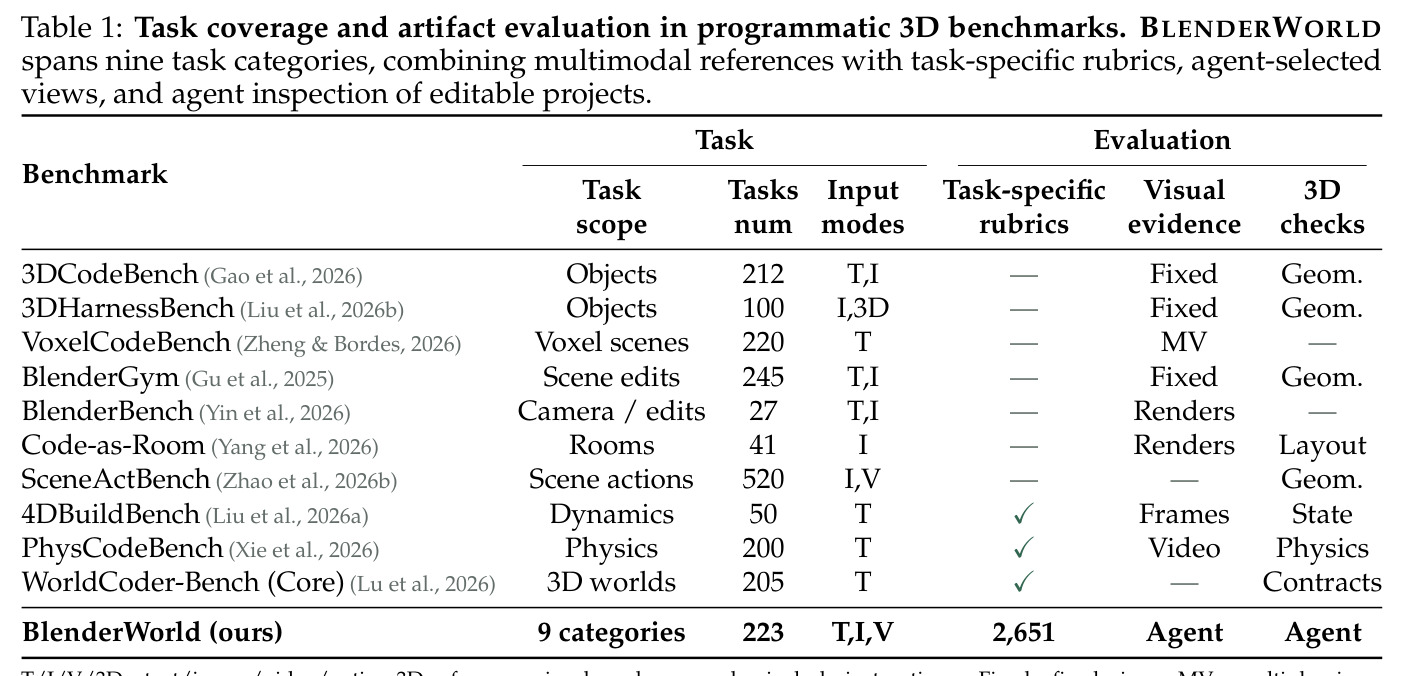
基于 MLLM 的视觉智能体已经能在网页、海报、PPT 等 2D 设计任务中自主操作软件,并正被推广到 3D 建模:智能体需要从照片、插画或视频参考中推断物体形状、材质、空间布局和光照,再通过代码或软件操作完成重建、修改与设计。但评测严重滞后:3DCodeBench 只测 212 个单物体任务,3DHarnessBench 只有 100 个物体任务,BlenderGym 的 245 个任务集中在场景编辑,BlenderBench 仅 27 个相机/编辑任务,SceneActBench 虽覆盖 520 个场景动作却局限于预定义几何目标——没有一个基准能覆盖真实用户请求中的重建、修改与开放式设计全谱系。更麻烦的是,真实请求通常没有 ground-truth 3D 资产,开放式设计又允许多种正确解法,而单一渲染视角只是 2D 投影,无法证明内部结构和物理关系正确,导致「渲染看起来对」与「3D 结构真的对」之间的鸿沟完全无法检测。
本文的目标是本文要建立第一个专门评测前沿模型在真实 3D 创作任务上能力的综合基准 BlenderWorld:223 个任务横跨建筑、产品、自然环境、科学可视化等 9 大类、22 子类、16 种应用场景;输入覆盖文本、图像、视频参考,另有 59 个任务附带 Markdown/YAML/JSON 结构化规格文件;要求智能体交付完全可编辑的 Blender 工程、渲染和视频等交付物。配套目标是给出统一评测协议:由评估智能体自动渲染 8 个任务相关视角,用 2,651 条带权重的任务专属二元评分标准加 8 维连续视觉质量分融合打分,最终在 13 个前沿模型上建立强基线,量化当前 3D 智能体在细粒度空间一致性上的能力缺口。
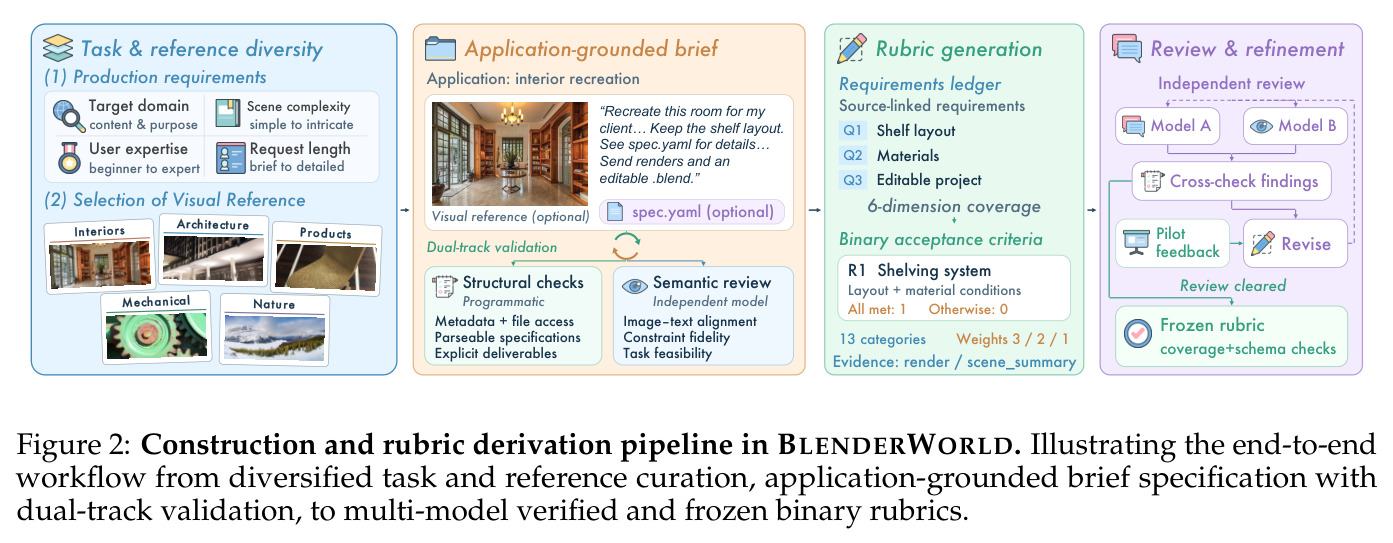
与已有工作不同的是,本文的独特切入点是「评测证据」问题:无标准答案、多解、单一 2D 渲染证明不了 3D 结构,这三个被现有基准集体回避的难题被作者当作核心设计约束。具体做法是证据路由评测——每条评分标准预先标注所需证据类型(render 或 scene_summary),视觉属性交给 VLM-as-Judge,内部场景结构交给能用 Blender 工具直接检查工程文件的 Agent-as-Judge,从机制上绕开视觉捷径;渲染视角由评估智能体根据任务自适应选择 8 个,而非固定机位。同时把 rubric 生成本身工程化:来源链接、双模型交叉审核、试点测试后冻结 schema。这使它成为第一个把「可编辑工程的结构检查」系统性纳入协议的 Blender 基准。
核心方法
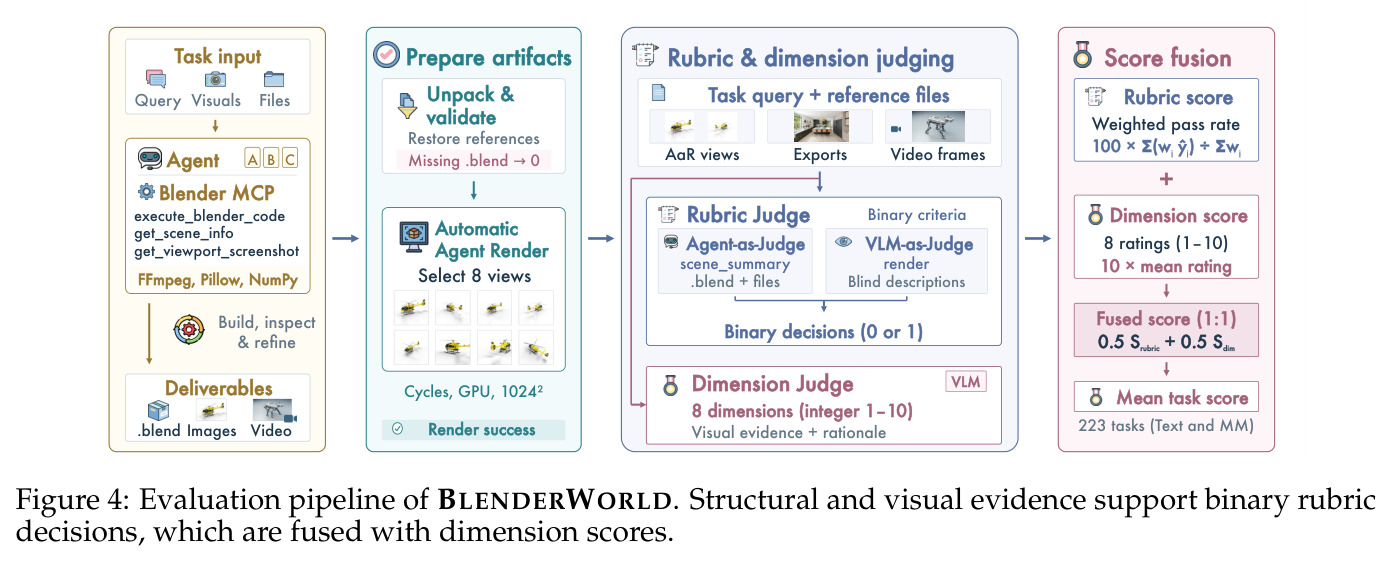
评测协议好比装修验收:不能只看宣传照(单视角渲染),要拿图纸核对水电(工程内部状态),还要多角度看。形式化上,每个任务提供 $x=(q,I,F)$:请求 $q$、可选参考 $I$ 与规格 $F$;智能体用 Blender 的 Python API 与 MCP 工具在预算内选动作 $a_t$,更新状态 $s_{t+1}=E_B(s_t,a_t)$,输出 $A_T=(B,R,V,X)$——可编辑 .blend 工程、渲染、视频与辅助文件。评测时 AaR 先渲染 8 个任务相关视角(1024×1024、Cycles 64 采样),按证据类型把 2,651 条二元标准路由给双裁判判定,VLM 另打 8 维 1–10 分。融合分 $S_{fused}=\lambda S_{rubric}+(1-\lambda)S_{dim}$,$\lambda=0.5$:$S_{rubric}=100\cdot\frac{\sum w_j\hat{y}_j}{\sum w_j}$ 为加权通过率,$S_{dim}=100\cdot\frac{\sum d_k}{10K}$ 为八维均分归一化。
核心创新是证据路由的双裁判评测协议,与以往基准的本质区别在于承认「视觉证据有盲区」。VLM-as-Judge 只处理确实需要看渲染才能验证的标准(外观、布局、运动);scene_summary 类标准(占 58.2%)交给 Agent-as-Judge,它用 Blender 提供的多种工具直接检查场景内部状态——物体是否存在、层级关系、材质参数、动画设置,必要时参考视觉证据,每条输出二值判定加支撑证据。三条配套设计防作弊:生成与评测在严格隔离的容器中运行,rubric 对生成方完全不可见,杜绝 rubric hacking;AaR 可调整相机和渲染设置,但必须保留提交的几何、材质、光照、动画与色彩管理,且不得修复提交作品的缺陷;视觉证据冲突时以原始导出媒体优先。二元标准每条带来源链接、13 个类别归属和 3/2/1 权重(83.3% 为权重 3 的主要标准),保证可解释与可复现。
方法步骤详情
构建端四步:(1) 任务与参考设计——沿「制作要求」(领域、复杂度、用户水平、请求长度)和「参考使用」展开,MLLM 筛选图像质量,为参考指派 recreation/modification/reference-based design 三种角色;(2) 应用场景化 brief——规格写成自然语言请求,59 个任务附 Markdown/YAML/JSON 规格文件并显式引用;(3) 双轨验证——结构检查确认元数据兼容、附件可解析、brief 要求交付可编辑工程,独立模型做语义审查,失败回炉重写;(4) rubric 生成——需求转二元标准,GPT-5.6-Sol 试点排查歧义,至少两个评审模型交叉审核后冻结,最终 2,651 条、每任务 6–22 条(均值 11.9)。评测端:智能体在隔离容器(1 GPU + Blender LTS)交付工件包,无 .blend 记 0 分;AaR 渲 8 视角(最多两次重渲、禁修缺陷);双裁判逐条判定,41.8% 走渲染证据、58.2% 走场景检查;VLM 打 8 维分并融合,评测统一用 GPT-5.6-terra。
技术新颖性
对照 Table 1,BlenderWorld 是唯一同时具备四项能力的程序化 3D 基准:多模态参考(T/I/V)、任务专属 rubric(2,651 条)、智能体自适应视角(对比 3DCodeBench/BlenderGym 的固定视角,以及 VoxelCodeBench 的多视角但无 rubric)、以及对可编辑工程的智能体级检查(对比 4DBuildBench/PhysCodeBench 的脚本化状态审计和 WorldCoder-Bench 的契约检查)。评测哲学上的新颖点是把 rubric 的生产当作软件工程来做:来源链接保证每条标准可溯源,双模型交叉审核加反例论证控制歧义,试点评测后冻结 schema。失败分析还反向验证了协议的判别力——它确实抓到了 view-dependent geometry 这类 2D 捷径,这是固定视角评测在原理上测不出来的失败模式。
实验结果
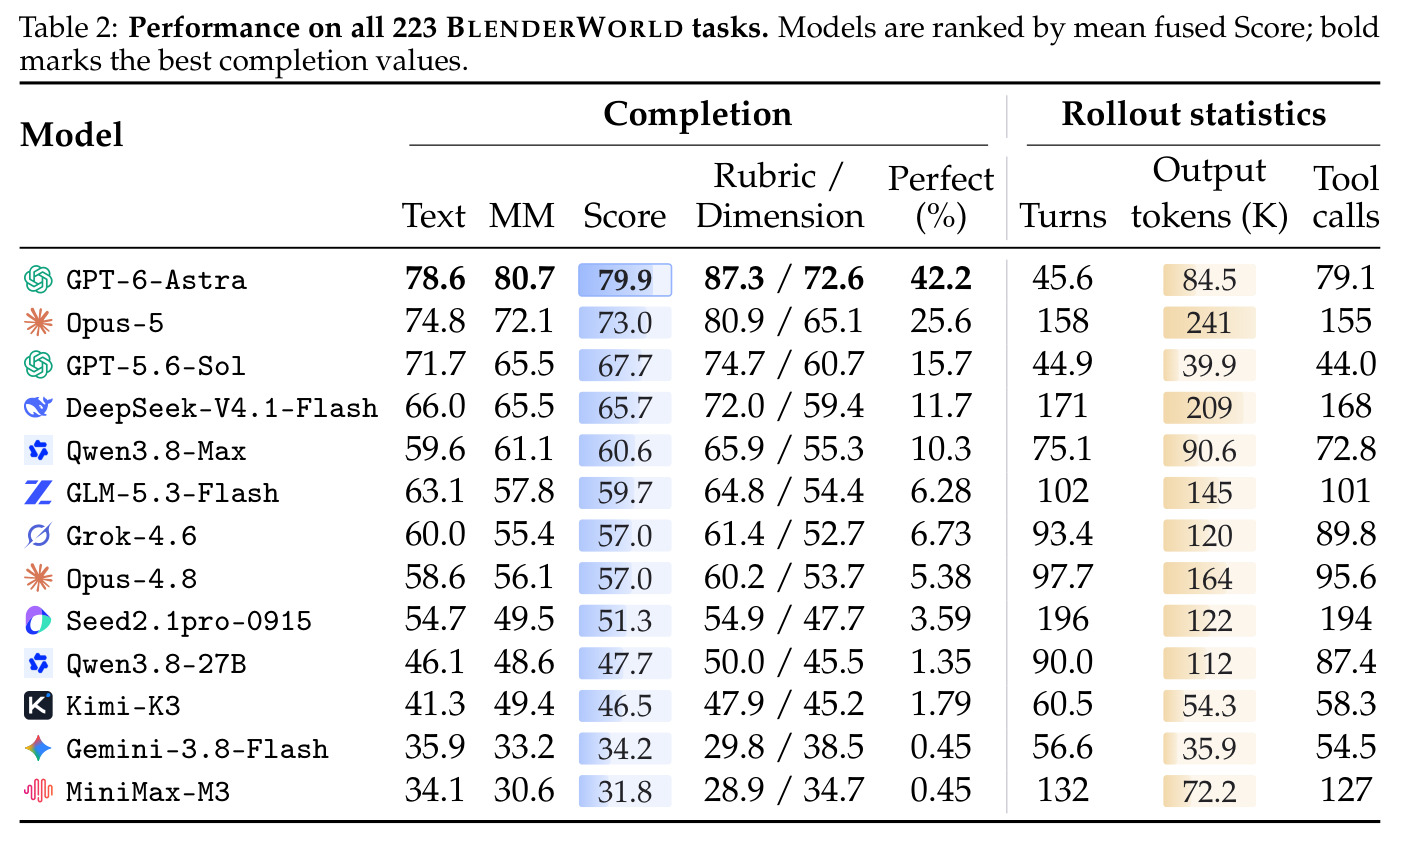
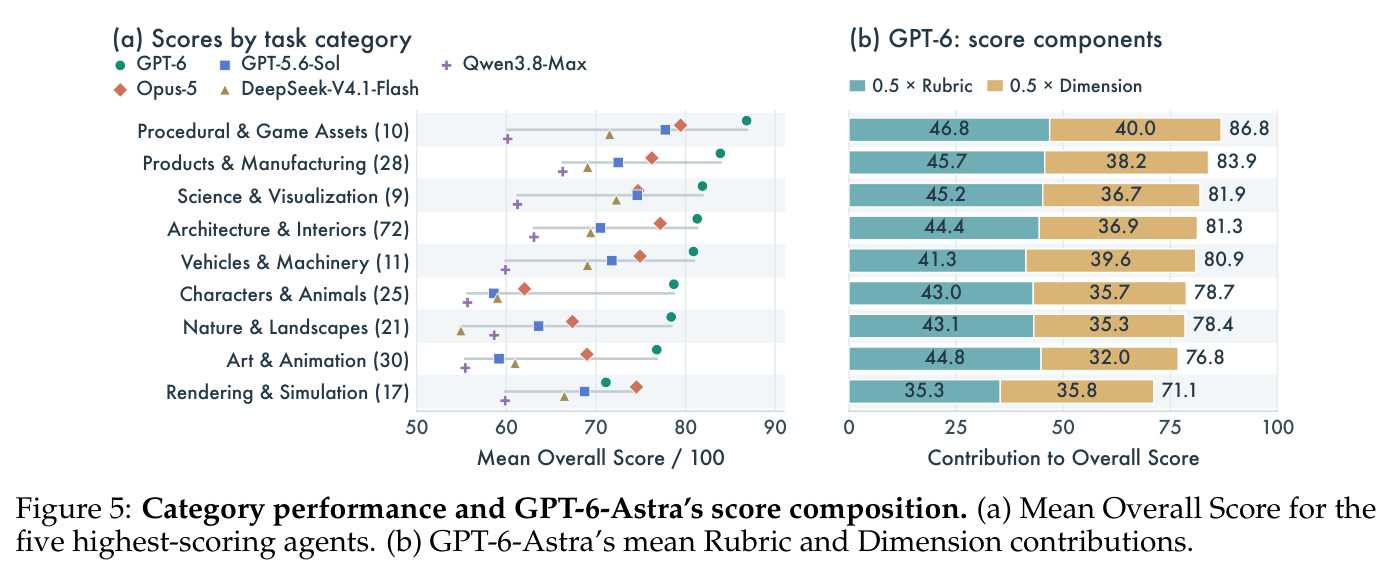
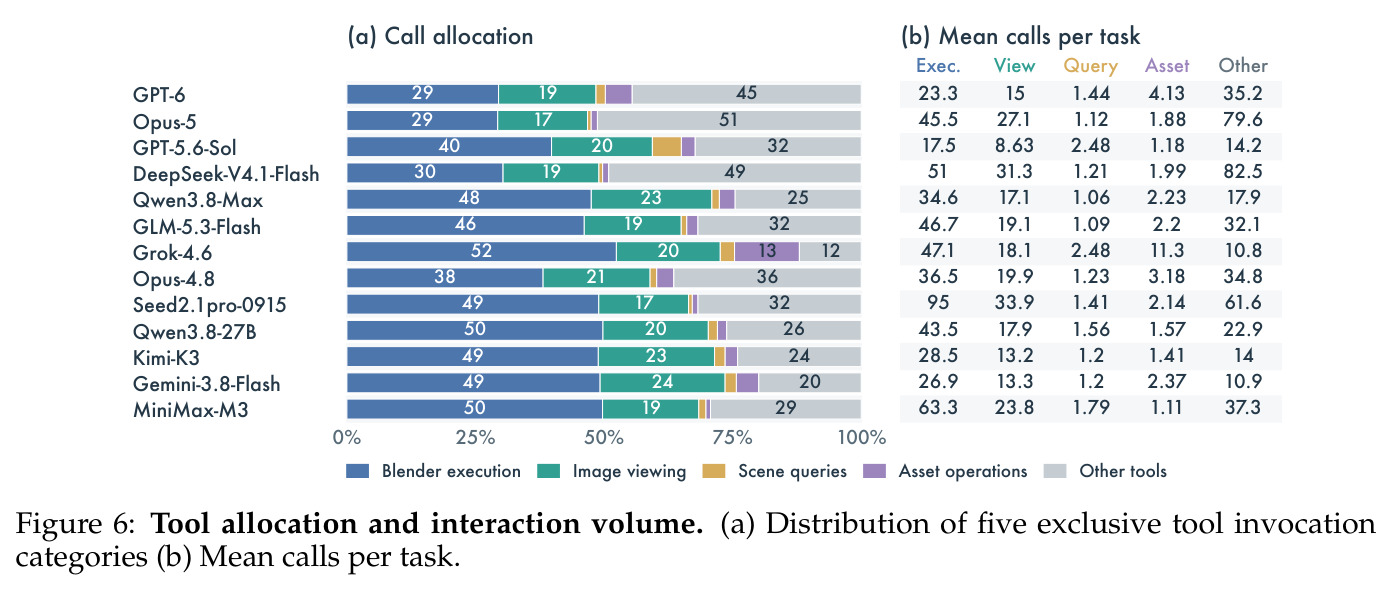
总榜(Table 2):GPT-6-Astra 融合分 79.9 居首,Opus-5 73.0。关键发现:其一,冠军 Perfect(rubric 全过)率仅 42.2%,Opus-5 为 25.6%,其余 ≤15.7%,细粒度要求仍未满足。其二,效率与效果脱钩:GPT-6-Astra 以每任务 45.6 轮、84.5K token、79.1 次调用登顶;Opus-5 花 158K token/155 次调用、DeepSeek 花 209K token/168 次调用仅得 65.7;看图最多的模型成绩平平,GPT-6-Astra 仅 15 次看图却有最高 MM 分 80.7——多看不等于改得对。其三,分类别(Figure 5a)赢 9 类中 8 类,程序化游戏资产 86.8 最高,渲染与仿真最低 71.1(Rubric 仅 70.6),行为复刻是瓶颈。,GPT-5.6-Sol 67.7,DeepSeek-V4.1-Flash 65.7(33.9 与 31.3 次/任务)失败四模式(Figure 7):动态交互缺失、视角不一致(2D 捷径)、几何失真、接触违例。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 223 任务整体(13 模型榜首) | 融合分 Fused Score (0-100) | GPT-6-Astra 79.9 | Opus-5 73.0(次优) | +6.9 |
| 全部 rubric 通过的任务占比 | Perfect (%) | GPT-6-Astra 42.2% | Opus-5 25.6% | +16.6 个百分点 |
| 多模态任务子集(145 个) | MM Score | GPT-6-Astra 80.7 | Opus-5 72.1 | +8.6 |
| 程序化与游戏资产类别 | 类别平均分 | GPT-6-Astra 86.8(9 类最高) | 自身整体 79.9 | 高于自身均值 +6.9 |
| 渲染与仿真类别 | 类别平均分 | GPT-6-Astra 71.1(其最弱项) | 自身整体 79.9 | 低 8.8,Opus-5 在该类反超 |
局限与改进
作者承认的局限:每个模型每任务只跑一次、未报告方差与置信区间;评测裁判依赖 GPT-5.6-terra 单一模型,虽在附录 E.1 做了裁判分析,但模型族偏差无法根除;二元 rubric 对有机形体等连续属性区分度有限,只能辅以 8 维评分弥补;评测环境限于 Linux 与 Blender LTS 版本。我的补充观察:不同模型使用不同 harness(GPT 系用 Codex、其余用 Claude Code),模型能力与 harness 效果在总榜中相互混淆;rubric 由 MLLM 生成并经模型审核,缺少专业 3D 艺术家的人工锚定,标准本身可能系统性偏向「模型可完成」的需求;最高效模型也需约 84.5K token/任务,重跑成本使重复实验几乎不可行;Perfect 指标对每任务 6–22 条标准的数量差异敏感,跨任务不能直接比较。
独立分析的弱点
独立分析四点弱点:(1) harness 混杂——GPT-6-Astra 与 GPT-5.6-Sol 用 Codex,其余 11 个模型用 Claude Code,第一名领先 6.9 分中有多少来自模型本身无法剥离;改进方向是同 harness 对照复测,作者已在未来工作中承诺此类实验。(2) 裁判单点依赖——AaR、rubric 判定、维度评分全部用 GPT-5.6-terra,且试点 rubric 也用 GPT-5.6-Sol,可能形成同族偏好,对 GPT 系模型的行为模式更宽容;改进是多裁判集成加人工一致性校准,尤其应对头部模型做对抗性抽查。(3) 单次运行——排名相差 2 分以内的模型(如 67.7 与 65.7)差异可能小于 rollout 方差,中间排名应谨慎解读;改进是在代表性子集上多次重跑并报置信区间。(4) AaR 的视角选择由 LLM 决定,存在「替提交作品挑好看角度」的诱导风险,且视角选择轨迹未被审计;改进是记录并公开视角选择策略,引入对抗性视角搜索来检验结构一致性。
未来方向
作者提出五个方向:给裁判配备 Computer-Use 工具,交互式检查 rig、动画与仿真的实际行为;结构化参数抽取加确定性脚本做几何复检(如统一对齐与尺度约定的 voxel IoU);扩展任务类型,包括局部编辑、网格故障诊断与修复、拓扑优化、工程图纸规格和基于已交付项目的修订式任务;与专业 3D 艺术家共创更贴近生产验收标准的 rubric;扩展到 Maya/3ds Max 等多 DCC、Mixamo 等资产库、更多模型/推理强度/harness、Windows/macOS 平台,并探索 GUI 操作与 API/MCP 工作流的差异。基于本文成果还可延伸:把 223 个任务与融合分数包装成强化学习环境训练 3D 原生智能体,用 Agent-as-Judge 的场景检查信号作为过程奖励;以及研究「视觉检查→结构修正」闭环的课程化训练,直接针对论文诊断出的最大瓶颈。
复现评估
复现可行性中等偏上。基准网站 blenderworld.github.io 已公开,论文附录给出了工具链与运行时细节(Shell/文件/图像查看/Blender MCP 工具、隔离容器、每智能体 1 张 NVIDIA GPU、Blender LTS)、rubric 生成流程与裁判模型分析。数据侧 223 个任务的 brief、参考与规格文件规模可控;算力侧主要开销在评测:AaR 用 Cycles 渲 8 个 1024²/64 采样视角,裁判统一调 GPT-5.6-terra API,而生成侧单任务输出 token 在 40K–209K 之间,全量复现 13 模型榜单的 token 成本可能达数亿级,只有资源充裕的团队玩得起。对普通团队,合理的用法是复用其评测协议与 rubric schema 评测自己的一两个模型,或取任务子集做消融;完整复刻榜单难度较高。
论文图表
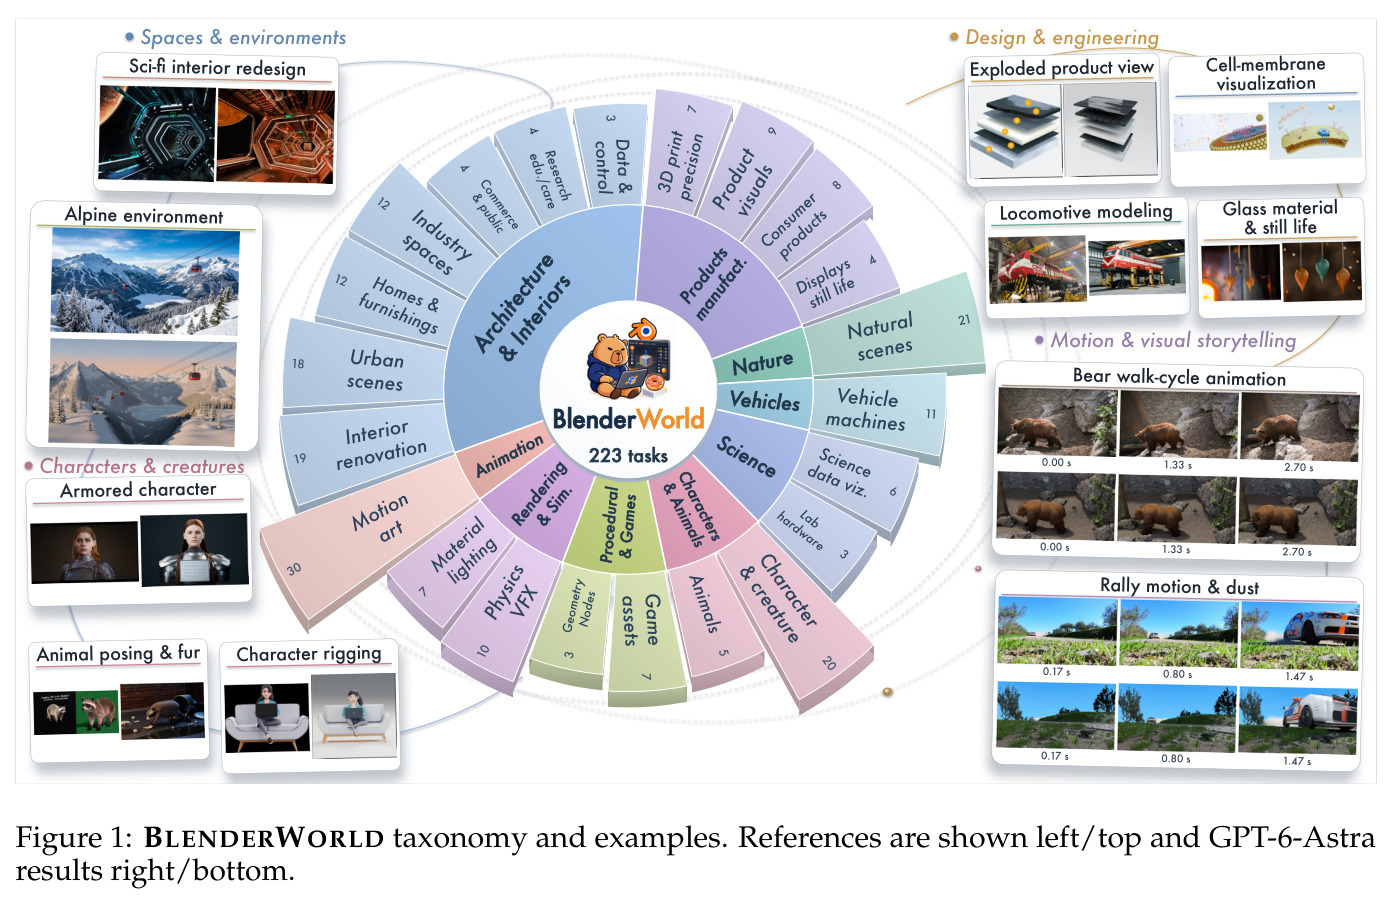
展示 223 个任务沿 9 大类、22 子类的分类树(建筑与室内、产品与制造、载具与机械、角色与动物、自然与景观、科学与可视化、程序化与游戏资产、艺术与动画、渲染与仿真),左/上方为参考输入,右/下方为 GPT-6-Astra 的生成结果,例如科幻室内重设计、爆炸图产品视图、细胞膜可视化、高山环境、火车头建模、熊的行走循环等。
一图看懂基准覆盖的任务广度和「参考→成品」的任务形态,是理解这个 benchmark 范围的入口。
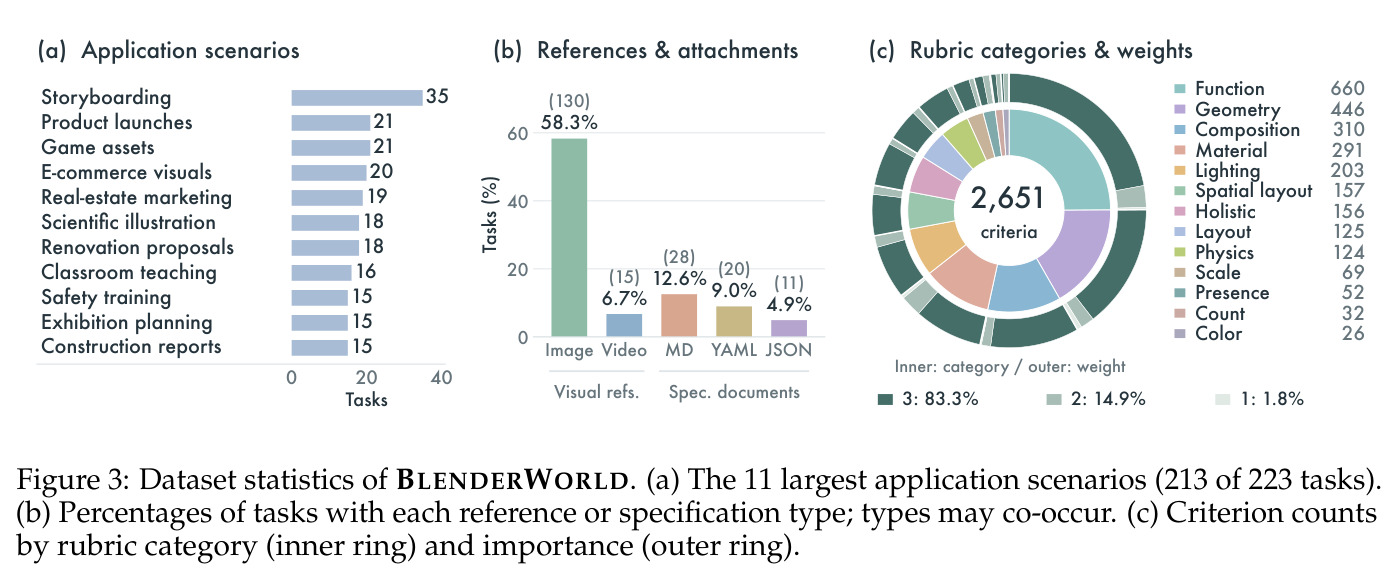
三幅统计图:(a) 11 个最大应用场景的任务数(故事板 35、产品发布 21、游戏资产 21、电商视觉 20 等);(b) 各类参考与附件的任务占比(图像参考 58.3%、规格文档 26.5% 等,类型可共现);(c) 2,651 条标准的类别与权重分布,Function 660、Geometry 446 最多,83.3% 为权重 3 的主要标准。
量化任务与评分标准的构成,帮助读者判断基准偏向功能性需求还是审美性需求。
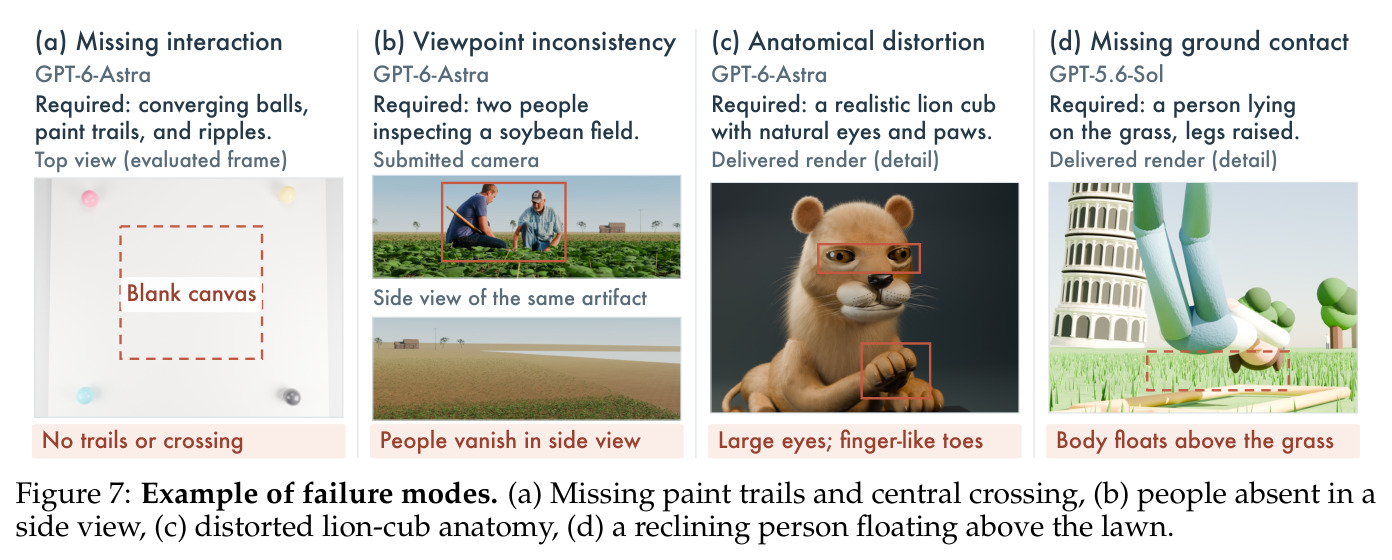
四个失败案例,各配任务要求与交付渲染的对比:(a) 要求彩球汇聚、颜料轨迹与涟漪,交付顶视图画布空白(缺失动态交互);(b) 提交相机中大豆田边有人、侧视图中人消失(视角不一致的 2D 捷径);(c) 狮子幼崽眼睛过大、脚趾呈手指状(细粒度几何失真);(d) 躺卧人物悬浮在草地上方(接触约束违例)。
直观看清当前 3D 智能体最典型的四类失败,是「2D 捷径 + 空间一致性弱」这一核心结论的实证。