WorldAuditBench:基于多模态智能体的交互式 3D 世界审计基准 WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
首个交互式3D世界审计基准:213个异常任务上最佳模型仅42.3%,远低于人类83.4%
前置知识
VLM(视觉语言模型)
以大型语言模型为骨干、接入视觉编码器的多模态模型,能把图像切分为 patch 编码成 token,与文本 token 拼接后统一送入 Transformer 做注意力计算,实现跨模态对齐与推理。现代 VLM 支持多图输入、工具调用与长上下文,因此可被包装成“看画面、想步骤、调工具”的智能体。
本文的审计智能体由 GPT-6 Astra、Claude Opus 5、Gemini 3.8 Flash 等 VLM 驱动,理解 VLM 如何消化多帧观察与工具调用是读懂实验设计的前提。
VLA(视觉-语言-动作模型)
在 VLM 基础上增加动作输出头的模型,直接根据视觉观察生成机器人或游戏环境的控制动作,通常用行为克隆在大规模演示数据上训练,强调低延迟端到端控制,决策时一般不输出显式的自然语言推理。本文使用开源的 Open-P2P 1.2B(为实时视频游戏训练的行为克隆模型)作为探索器。
VLA–VLM 两阶段范式是论文的对照组,理解 VLA“只行动不推理”的特性,才能明白为什么探索与分析分离的管线会在审计任务上吃亏。
VLM-as-a-Judge
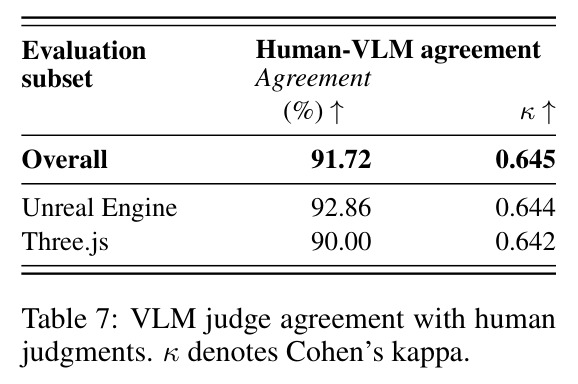
用强 VLM 当裁判评价其他模型输出的评测范式:裁判收到评分标准(rubric)、被评报告和证据图片,输出二值分数。优点是可扩展、能处理自由文本加图像的复杂输出;风险是与人类判断存在偏差。本文用 GPT-6 Astra 作 judge,实测与人一致率 91.72%、$\kappa=0.645$。
论文所有成功率都由 VLM judge 判定且 rubric 对 agent 隐藏,理解这一协议才能正确解读表格数字的含义与可信度。
游戏引擎碰撞与物理异常
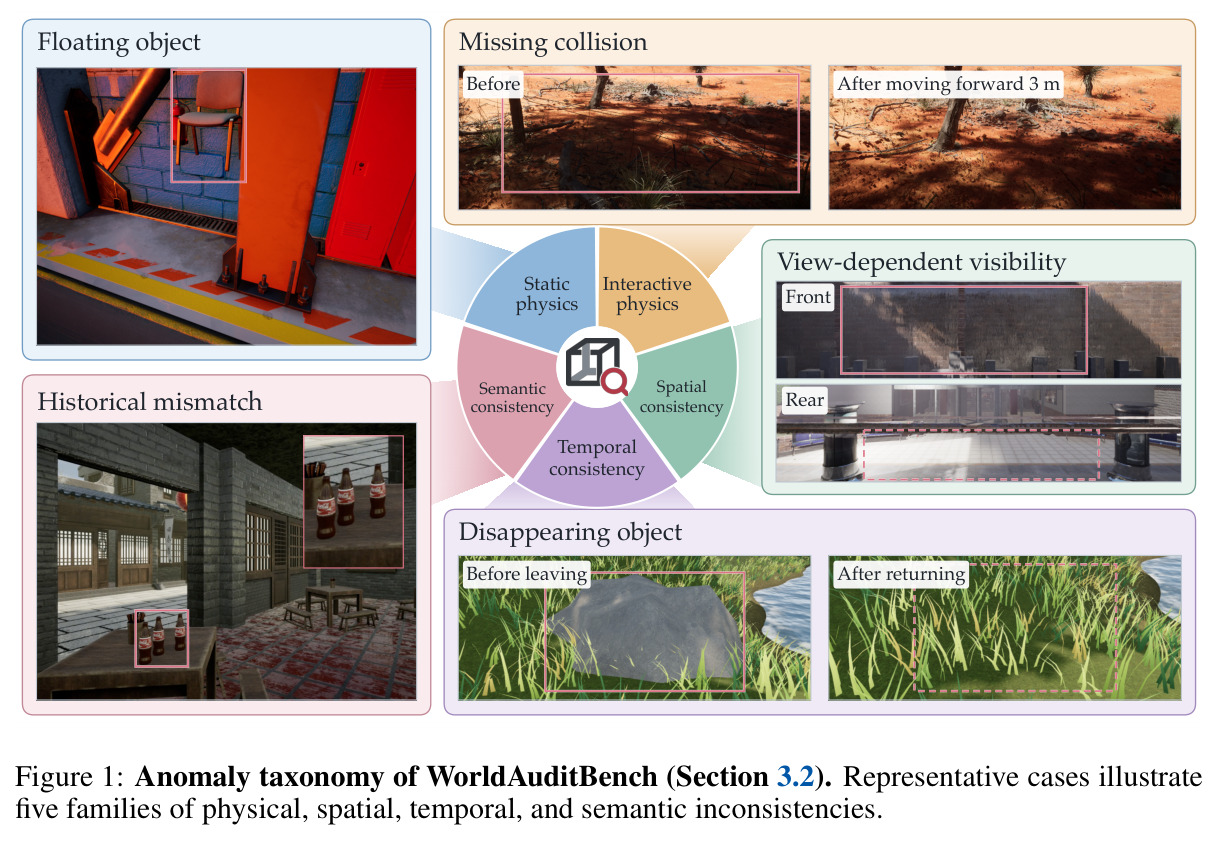
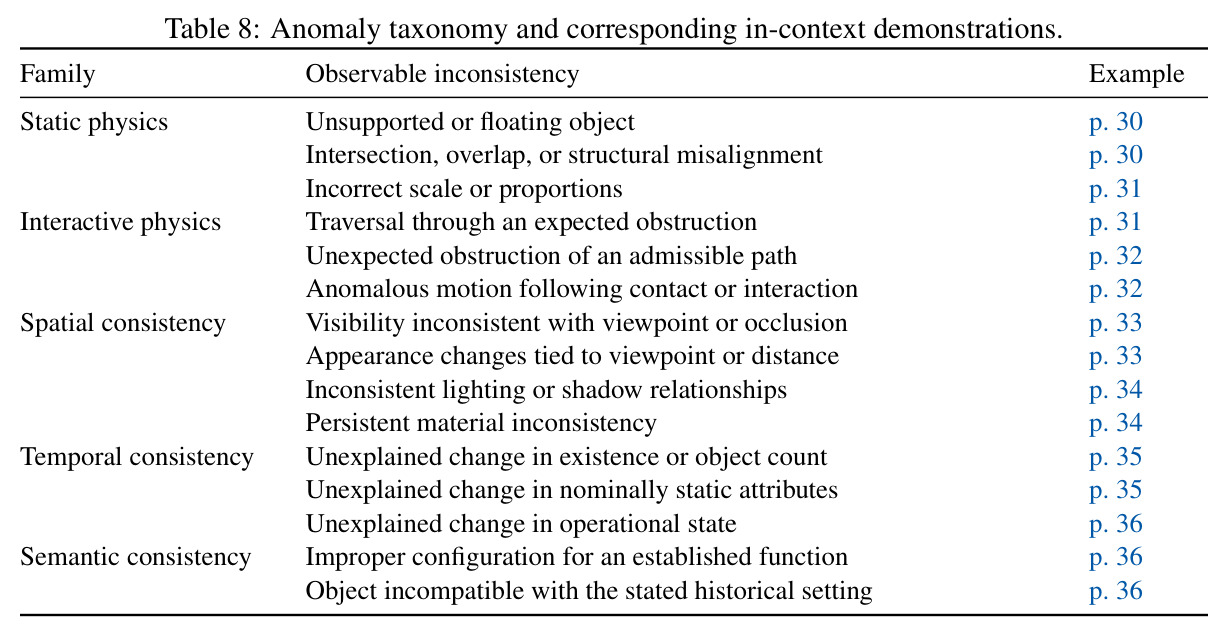
引擎中物体的视觉网格与碰撞体是两套数据:碰撞体决定能否挡住移动、如何响应接触。开发疏漏会造成“看得见却穿得过”(缺碰撞)、“看似空地却被挡”、悬浮、穿插等缺陷。游戏 bug 研究将其分为单帧可见与需跨时间/交互才能暴露两类,本文五族 15 类分类法正借鉴 Lewis 等 2010 年的分类学。
论文的异常分类体系与任务构造完全建立在游戏 QA 概念上,不懂碰撞体与视觉网格的分离就看不懂“穿墙”任务的含义。
上下文学习(ICL)与类型提示
上下文学习指在提示中给出若干演示示例(输入与参考答案),无需梯度更新即可引导模型行为。本文每个审计任务的提示包含场景描述、异常类型提示(如“悬浮/缺支撑”)和一个来自其他场景的匹配示例。消融显示去掉示例仅掉 2.4 个百分点,再去掉类型提示则暴跌 17.5 个百分点。
它是理解消融实验以及“模型真实自主能力可能被类型提示高估”这一批评的关键。
MCP(Model Context Protocol)
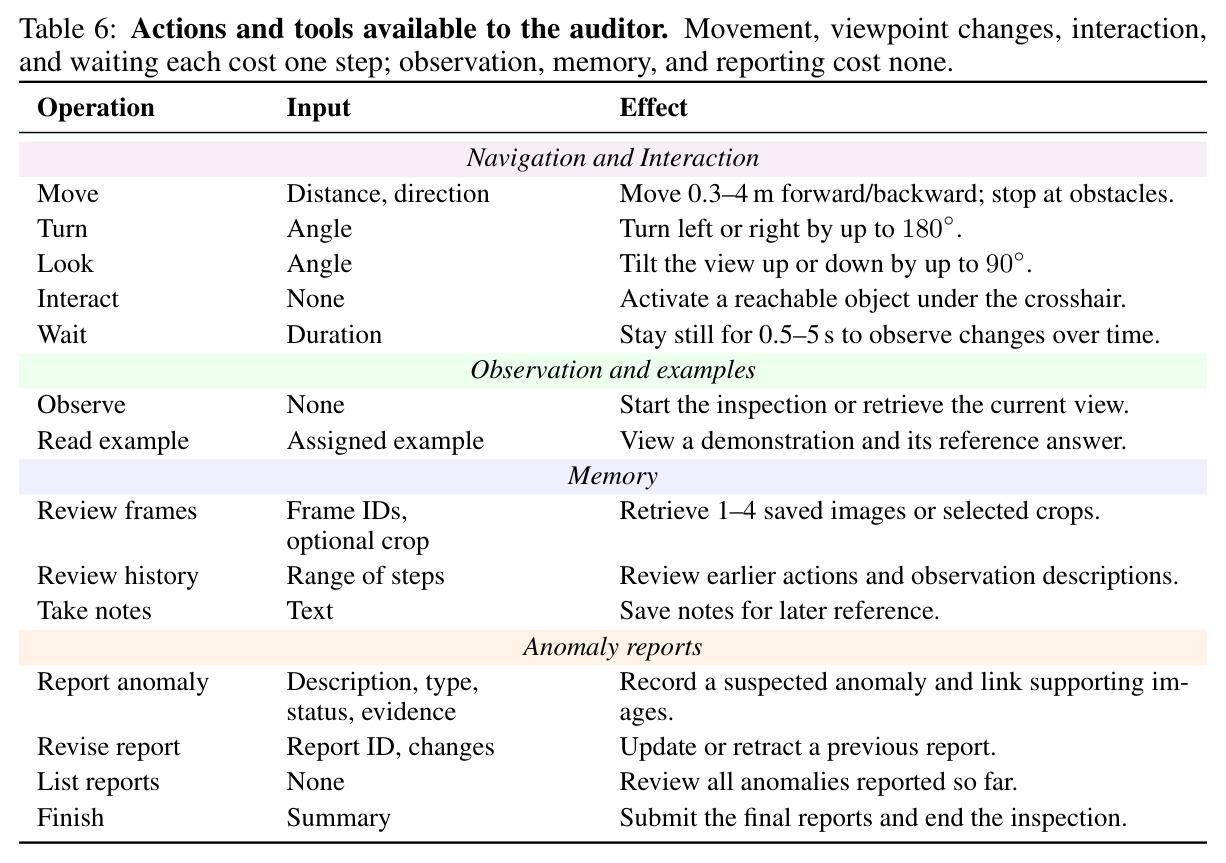
一个把工具以统一接口暴露给不同 agent harness 的标准化协议。本文所有模型通过共享的 MCP 工具集访问 3D 环境(移动、交互、记忆、报告),保证不同模型在同一动作空间与预算规则下对比。
实验中每个模型搭配自家 harness(Codex CLI、Claude Code、Gemini CLI 等),工具却经 MCP 统一,这是理解“评测对象实为模型+harness 组合”这一细节的基础。
研究动机
交互式 3D 世界正被广泛用于研究智能行为:agent 在其中导航、操作物体、完成任务。但一个世界可以“看起来很真”却暗藏缺陷——椅子悬浮在地板上方、实心栅栏挡不住任何移动、路牌会在 agent 转身离开后凭空消失。这类异常对研究危害极大:如果导航 agent 是靠穿过一面破损的墙抄近路完成任务,它的成功就不应被采信,据此得出的具身智能结论全部可疑。已有工作要么研究生成物理合理的场景(PhyScene、ClutterGen、PAT3D、LayoutDreamer 等改进物体摆放、碰撞与物理一致性),要么用静态图像/视频评测模型识别游戏 glitch(GlitchBench、VideoGameQA-Bench、VideoGlitchBench),而环境质量审计本身仍几乎完全依赖人工 QA。更麻烦的是,许多缺陷只在交互中暴露:缺碰撞的栅栏在画面上毫无破绽,只有走向它、直行约 3 米再回望,才能发现 agent 穿体而过;会消失的物体则要求离开再返回、对齐前后视角才能确认。审计因此远不止“看看画面”,而是要在有限预算内系统性地探索与取证,这正是现有基准未覆盖的能力。
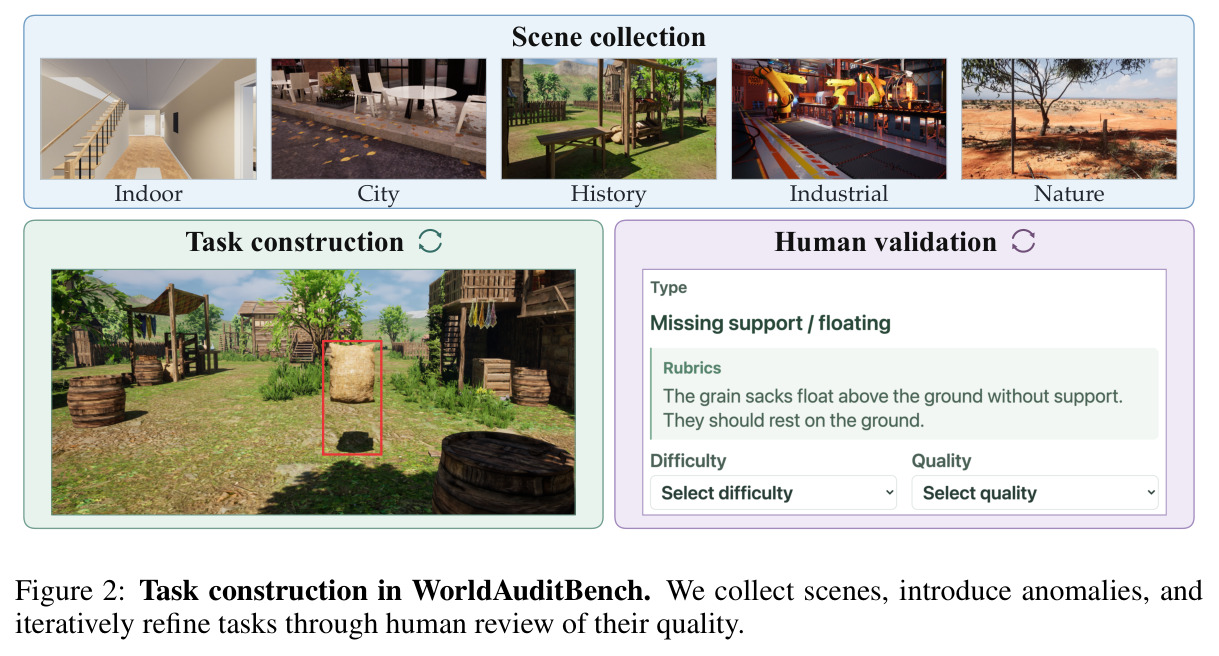
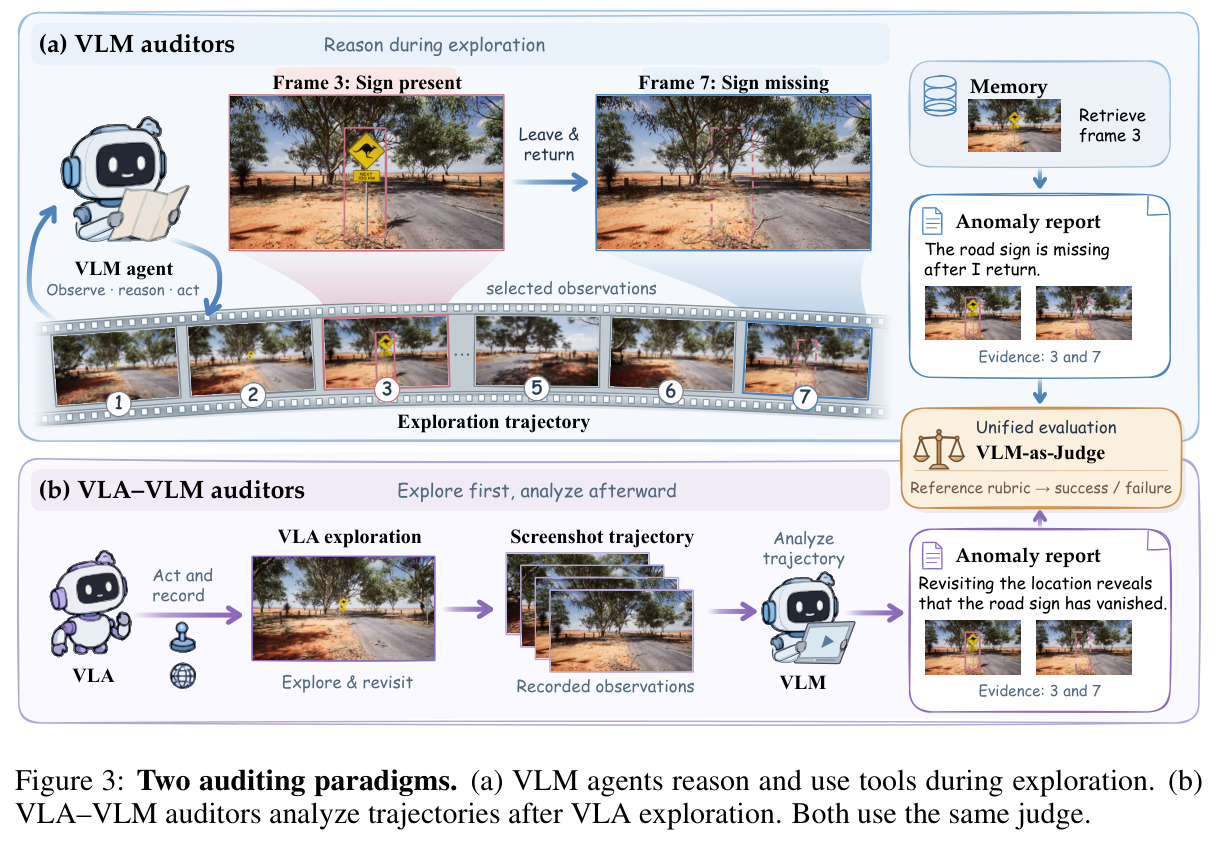
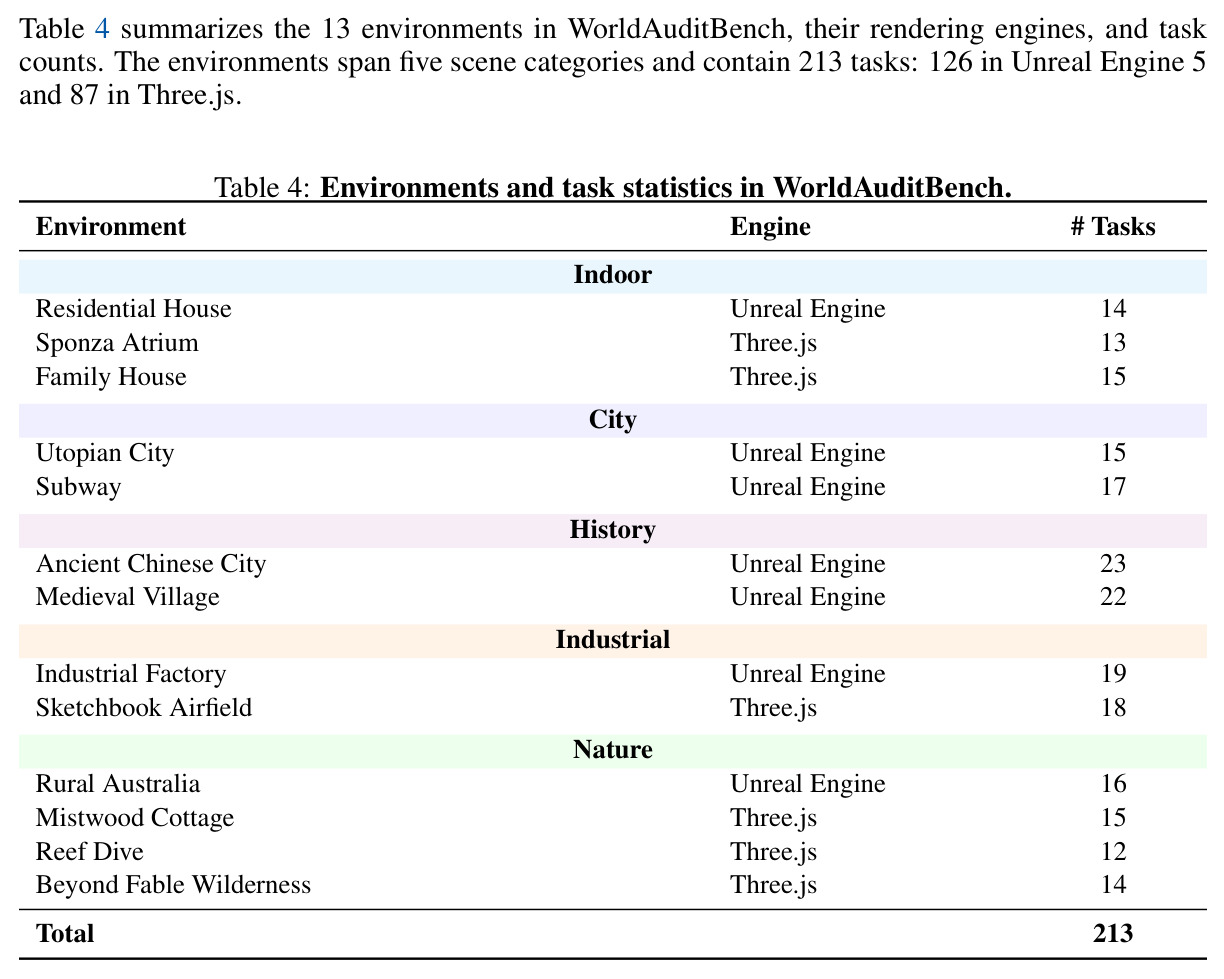
本文的目标是本文旨在回答:多模态 agent 能否自主地在交互式 3D 世界中完成“世界审计”——主动探索环境、发现并验证异常、提交带证据的报告?为此作者构建 WorldAuditBench:213 个手工构造的单异常任务,覆盖 13 个 Unreal Engine 5 与 Three.js 环境、室内/城市/历史/工业/自然五类场景,异常按五族 15 类组织(静态物理、交互物理、空间一致性、时间一致性、语义一致性)。评测侧定义并对比两种审计范式:一是端到端 VLM 智能体,视觉推理直接引导动作选择;二是 VLA–VLM 两阶段管线,先用 VLA 盲探 60 秒录制轨迹,再由 VLM 离线分析。评测在固定探索预算下进行(VLM 40 个环境动作、VLA 60 秒),以约 10 名计算机博士生组成的人类基线(成功率 83.4%)为参照,并通过消融和“暴露–识别”分解定位模型在探索与证据利用上的具体短板,为后续研究提供可衡量的测试床。
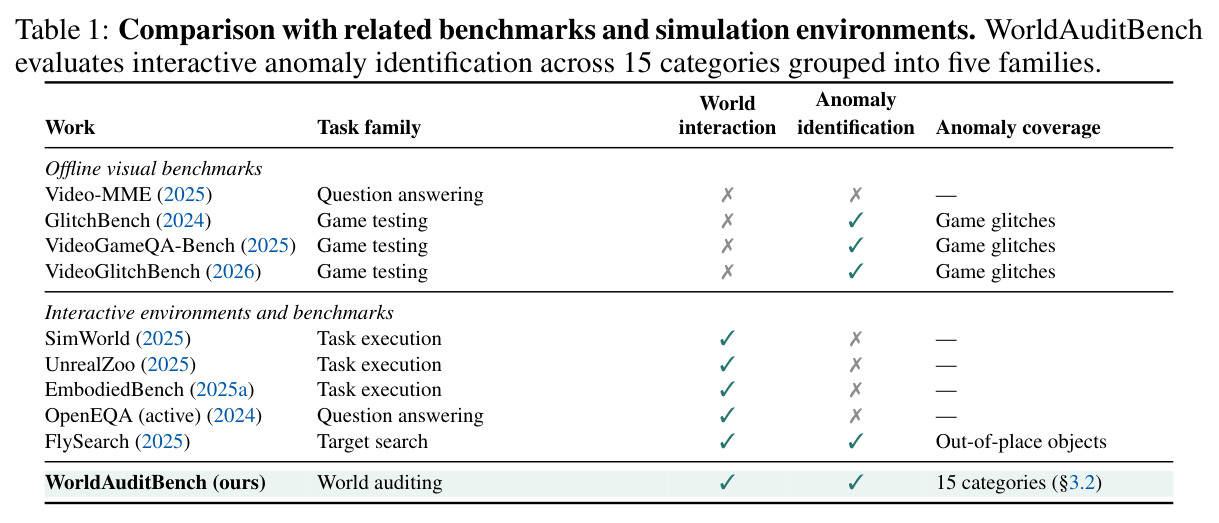
与已有工作不同的是,现有评测与本文之间存在清晰空白。静态视觉基准(Video-MME、GlitchBench、VideoGameQA-Bench、VideoGlitchBench)把观察预先喂给模型,只测“给定证据能否答题”,不测证据收集;交互环境与基准(AI2-THOR、Habitat、SimWorld、UnrealZoo、EmbodiedBench、主动版 OpenEQA)测任务执行或问答,不把“发现缺陷”作为目标;最接近的 FlySearch 虽含交互式异常搜索,但只针对“放错位置的物体”这类肉眼可见异常。本文的独特切入点有三:其一,把审计形式化为行动与视觉推理深度耦合的任务——视觉推理建立预期(栅栏应当挡路),行动产生检验(直行 3 米看是否穿过),观察更新假设,证据收集本身就是识别的一部分;其二,异常谱系从“单帧可见”(悬浮)覆盖到“必须交互、跨视角对比或离开后重访才能暴露”(穿墙、视角相关外观、消失物体),系统检验规划、记忆与场景理解;其三,引入游戏 bug 分类学(Lewis 等 2010、Truelove 等 2021、Butt 等 2023)作为依据,首次把游戏 QA 知识转译成 agent 评测的分类体系。
核心方法
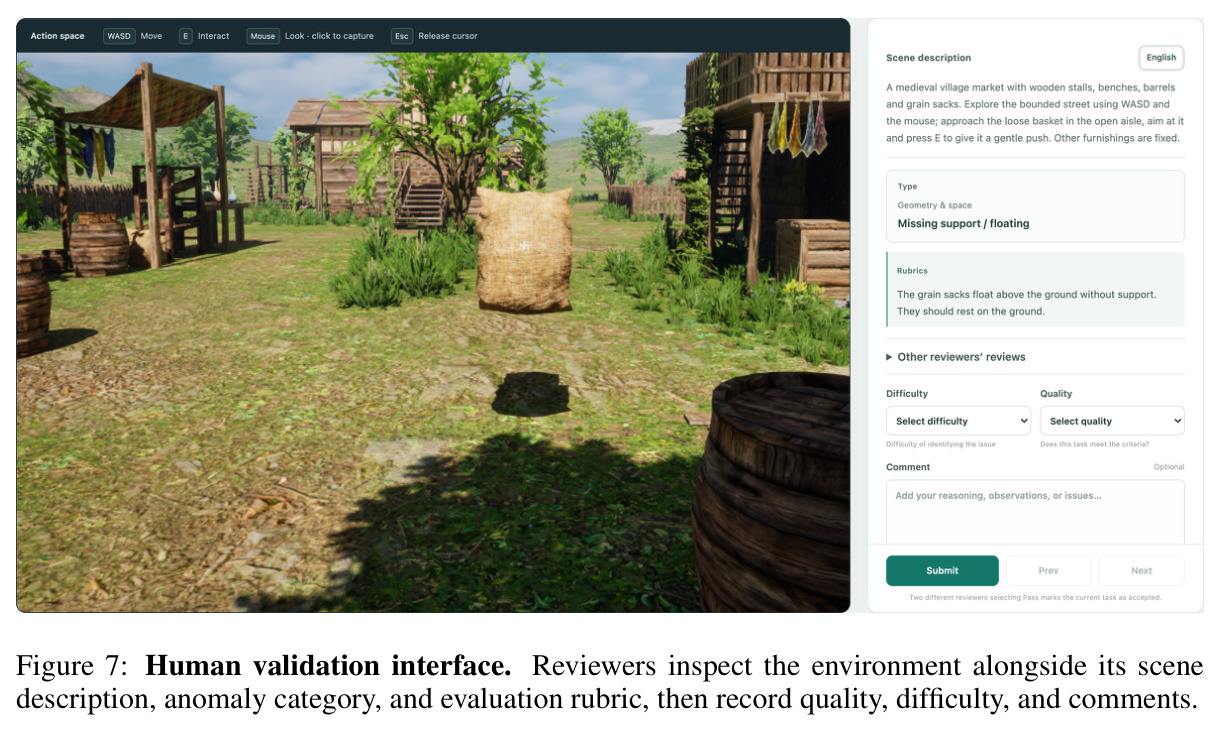
整体思路分“造题”与“考试”两半。造题侧三步:先收集 13 个 UE5/Three.js 交互环境(室内、城市、历史、工业、自然五类),大环境人工划出有界区域共 27 个场景;再由作者在无 bug 场景中按分类法手工植入恰好一个异常——改物体摆放/碰撞/外观/交互响应或时间行为(消失、位移、昼夜突变),同时固定 agent 起点、朝向、探索边界与可用交互;最后由未参与构造的评审经浏览器界面验证,评 Pass/Fail/Uncertain,至少两名评审对同一版本评 Pass 才接受,否则修改重审。考试侧,agent 收到初始输入:审计指令、任务上下文(场景描述、异常类型提示、来自其他场景的匹配 in-context 示例)和第一人称 RGB 初始观察;在固定预算内探索(VLM 40 个环境动作、VLA 60 秒),可用导航/交互动作及零成本的记忆、报告工具,最终提交含异常描述与证据帧的报告;隐藏 rubric 与报告、证据一起交 GPT-6 Astra 作 judge 打 0/1 分。整条轨迹形式化为 $\tau = (x, a_0, o_1, \ldots, a_{T-1}, o_T, y)$。
核心创新是把“世界审计”定义为行动与视觉推理必须耦合的任务,并用双范式对照把这种耦合本身变成研究对象。论文的直觉例子是缺碰撞的栅栏:画面上它只是普通栅栏,视觉推理建立“它应当挡路”的预期;agent 必须走向它并直行约 3 米,再回望确认穿体而过——识别驱动了动作,动作产生了证据,证据又支持了结论。为量化耦合的价值,作者对比两种范式:VLM-only 智能体在探索中随时推理,可疑发现可立刻转化为新的观察角度、交互尝试或重访计划;VLA–VLM 两阶段则把探索(Open-P2P 1.2B 盲走 60 秒)与分析(VLM 看固定轨迹)切开,中间观察无法再引导行动,退化成传统视频问答。第二个关键设计是零成本记忆工具:agent 可回看此前保存的帧(review frames,支持裁剪)、翻阅动作历史、记笔记,支撑跨视角、跨时间的对比——这正是空间/时间一致性异常的命门。第三个关键是评价协议:目标异常的身份、位置和 rubric 对 agent 全程隐藏,只给类型提示;judge 只认“是否命中目标异常”,报告别的 bug 不给分,且接受同义改写、要求动态异常写明触发条件。
方法步骤详情
一次完整审计流程如下。第一步,输入:agent 收到审计指令(用满 40 步预算,报告需含描述、类别与证据帧号)、任务上下文(场景描述、异常类型提示、匹配 ICL 示例)和初始第一人称 RGB 观察。第二步,动作分两类:耗预算的环境动作有移动(0.3–4 米/步)、转身($\pm 180°$)、俯仰($\pm 90°$)、交互(激活准星下物体)、等待(0.5–5 秒);不耗预算的工具包括 observe、review frames、review history、take notes 及 report/revise/finish。第三步,两阶段范式改为:VLA(Open-P2P 1.2B)先探索 60 秒、每 0.5 秒采样一帧,轨迹供不同 VLM 离线分析。第四步,产出最终报告:异常描述、类别、确认状态和证据帧,如悬浮麻袋任务引用第 9、11、14、15、19 步五张图。第五步,评测:GPT-6 Astra 独立上下文任 judge,对照隐藏 rubric 输出 0/1 分,动态异常须写明变化与触发条件。第六步,人类基线:约 10 名 CS 博士生、每任务 2 人、最多 10 分钟,与模型用相同提示和 judge。
技术新颖性
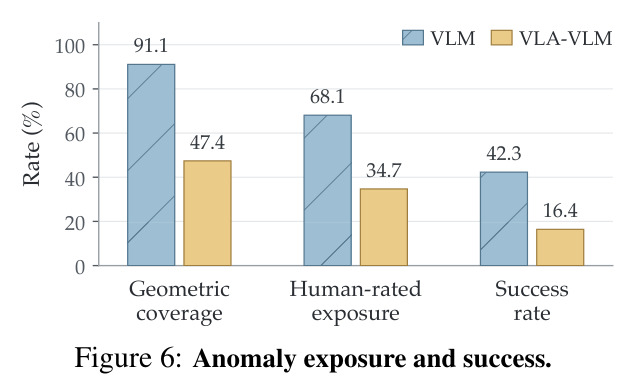
技术新颖性体现在四个层面。基准层面,这是第一个把“模拟环境缺陷审计”当作交互式 agent 任务来评测的工作:此前 GlitchBench 等只测静态识别,FlySearch 只找放错位置的物体,而本文 15 类异常覆盖了从单帧可判(悬浮、穿插、比例失调)到必须主动取证(穿墙需移动对比、视角相关外观需往返观察、消失物体需离开重访)的完整证据谱系,分类法移植自成熟的游戏 bug 研究。范式层面,双范式对照设计把“探索与分析是否耦合”从工程选择变成可量化的科学问题,并用三层指标(几何覆盖率 91.1% 对 47.4%、人工评定暴露率 68.1% 对 34.7%、暴露后识别率 38.5% 对 26.0%)把差距分解为“走没走到”和“走到后认没认出”两个环节。工具层面,为 VLM 智能体设计的最小记忆设施(帧检索带裁剪、历史回看、笔记)零成本却显著支撑证据管理。评价层面,rubric 对被测者隐藏、judge 规则精细(接受同义改写、防提示注入、rubric 按数据处理),并实测与人一致率 91.72%、$\kappa=0.645$,为同类工作提供可借鉴的评测协议模板。
实验结果
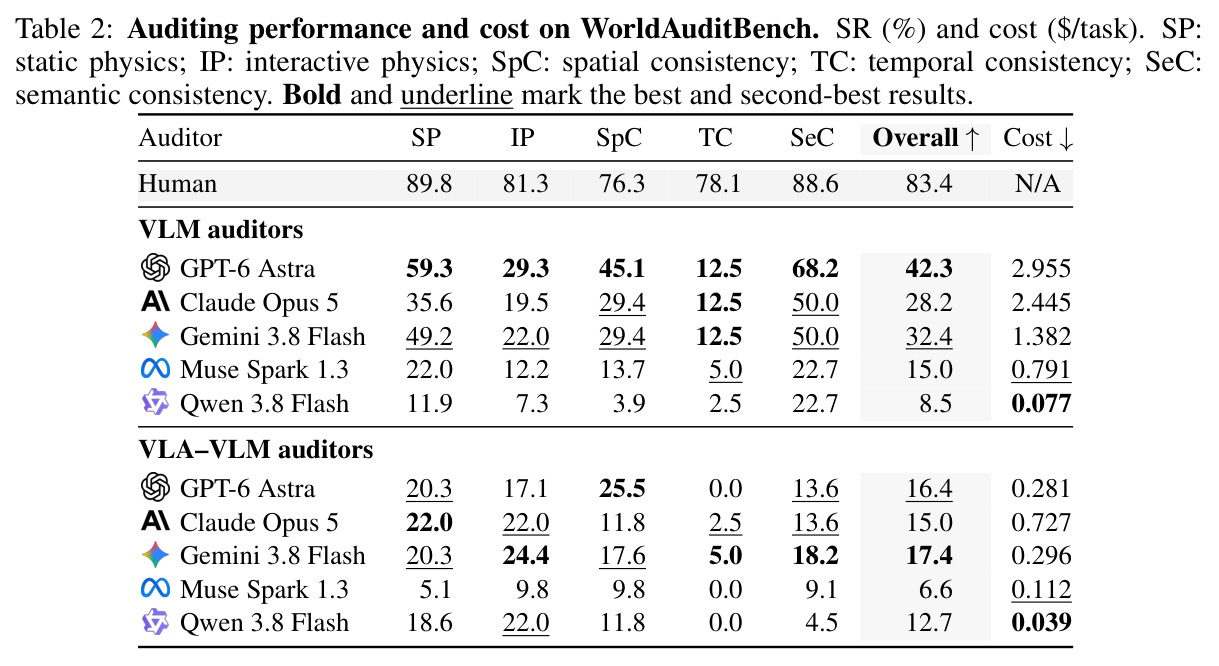
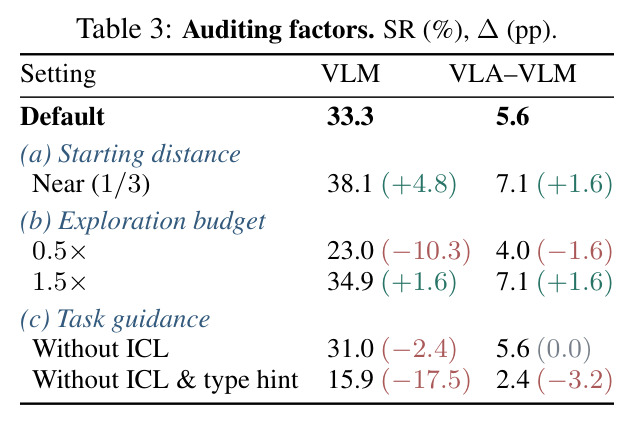
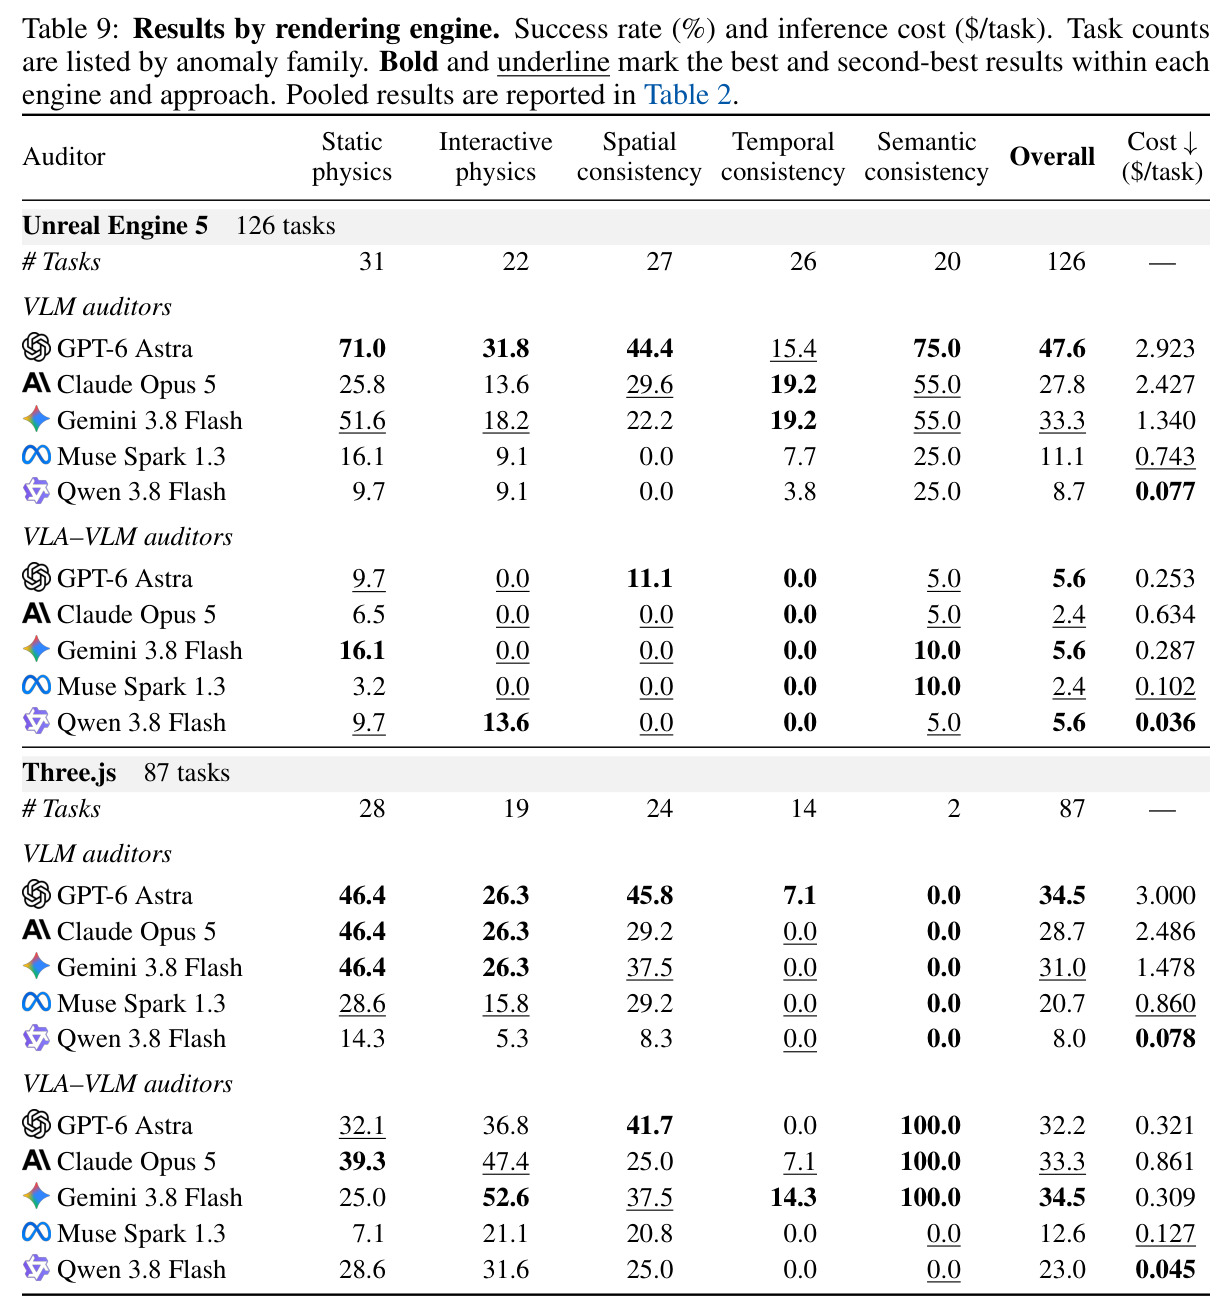
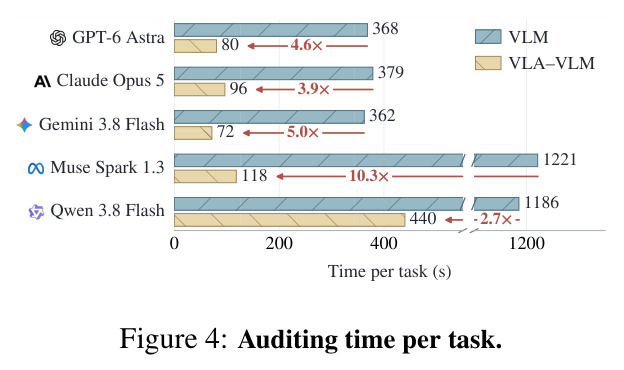
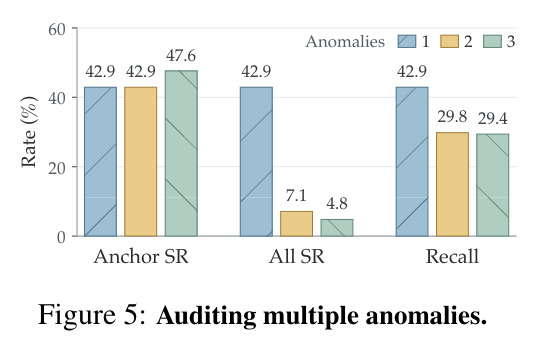
主结果(Table 2):VLM-only 阵营 GPT-6 Astra 以 42.3% 居首,其后 Gemini 32.4%、Claude 28.2%,最弱者仅 8.5%;VLA–VLM 全线 6.6%–17.4%,成本低一个量级且快 2.7–10.3 倍;人类 83.4%,与最强模型差 41.1 个百分点。分族看:静态物理(59.3%)与语义一致性(68.2%)最易,单帧可判;空间一致性 45.1% 居中;时间一致性最崩溃,全部设定下 SR ≤12.5%。消融(Table 3):起点缩至 1/3 时 33.3%→38.1%;预算砍半降至 23.0%(−10.3pp);去类型提示暴跌 17.5pp 至 15.9%,只去示例仅 −2.4pp。多异常(Figure 5):锚点成功率稳定在 43%–48%,但全部找齐仅 7.1% 和 4.8%,召回约 29%。暴露–识别分解(Figure 6):VLM 几何覆盖 91.1% 对 47.4%,人工评定暴露 68.1% 对 34.7%;共同覆盖任务上 VLM 仍以 38.5% 对 26.0% 领先,优势兼来自探索与证据运用。
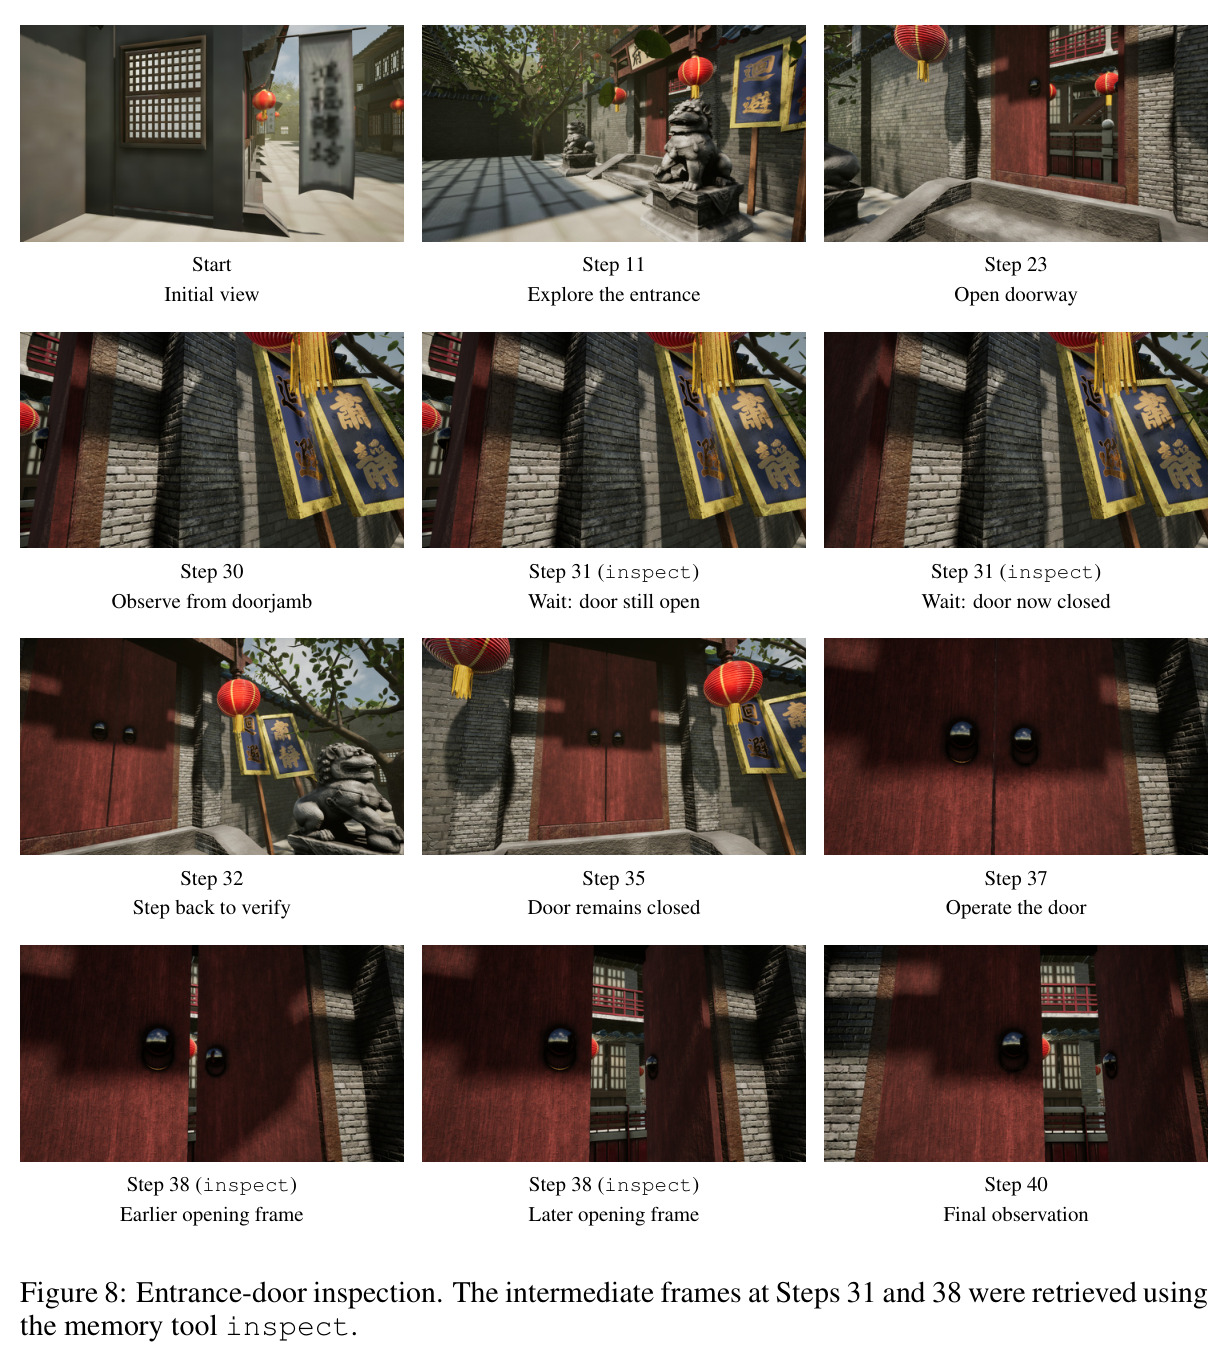
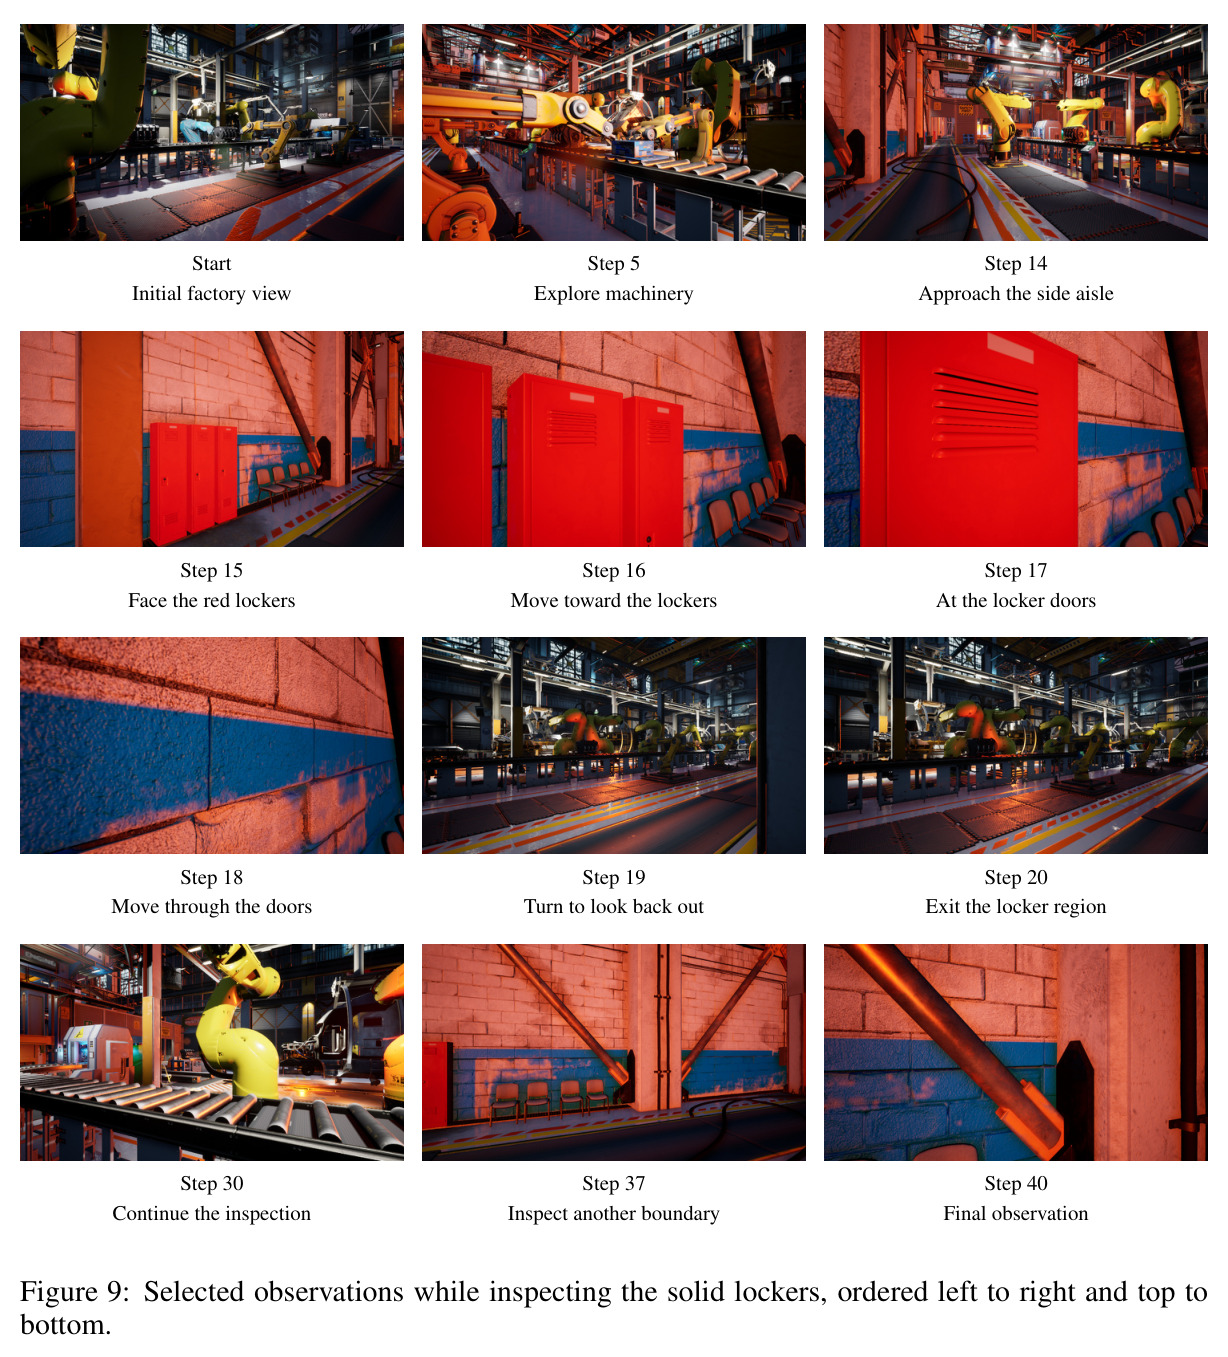
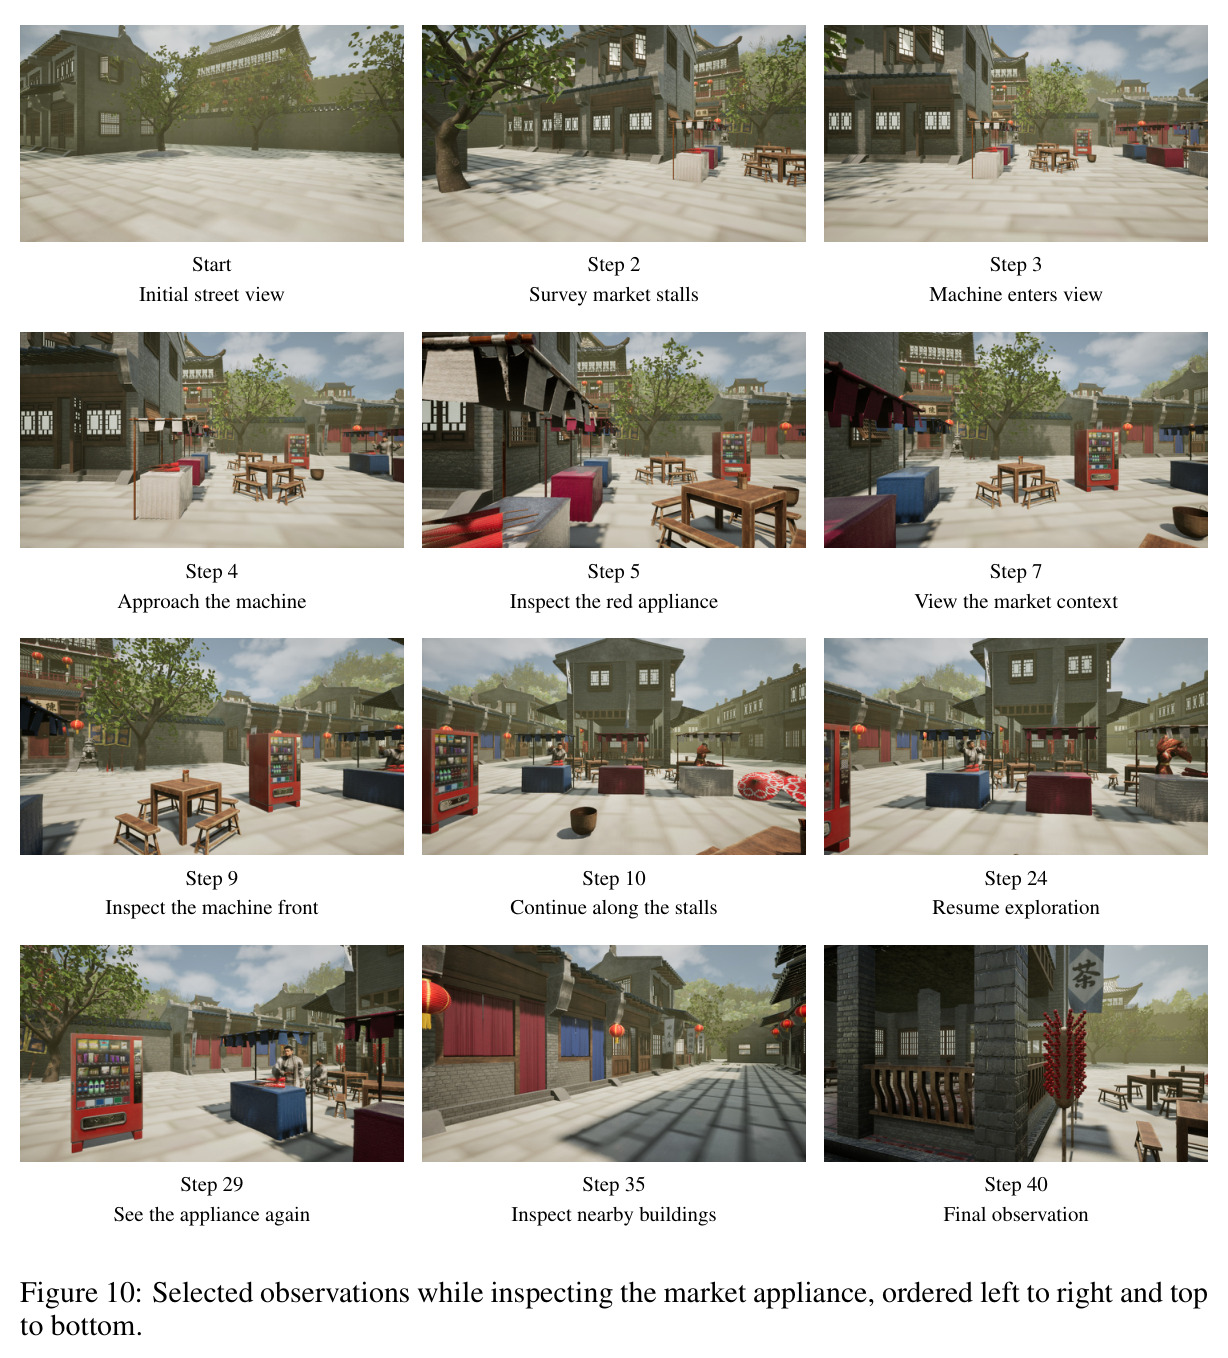
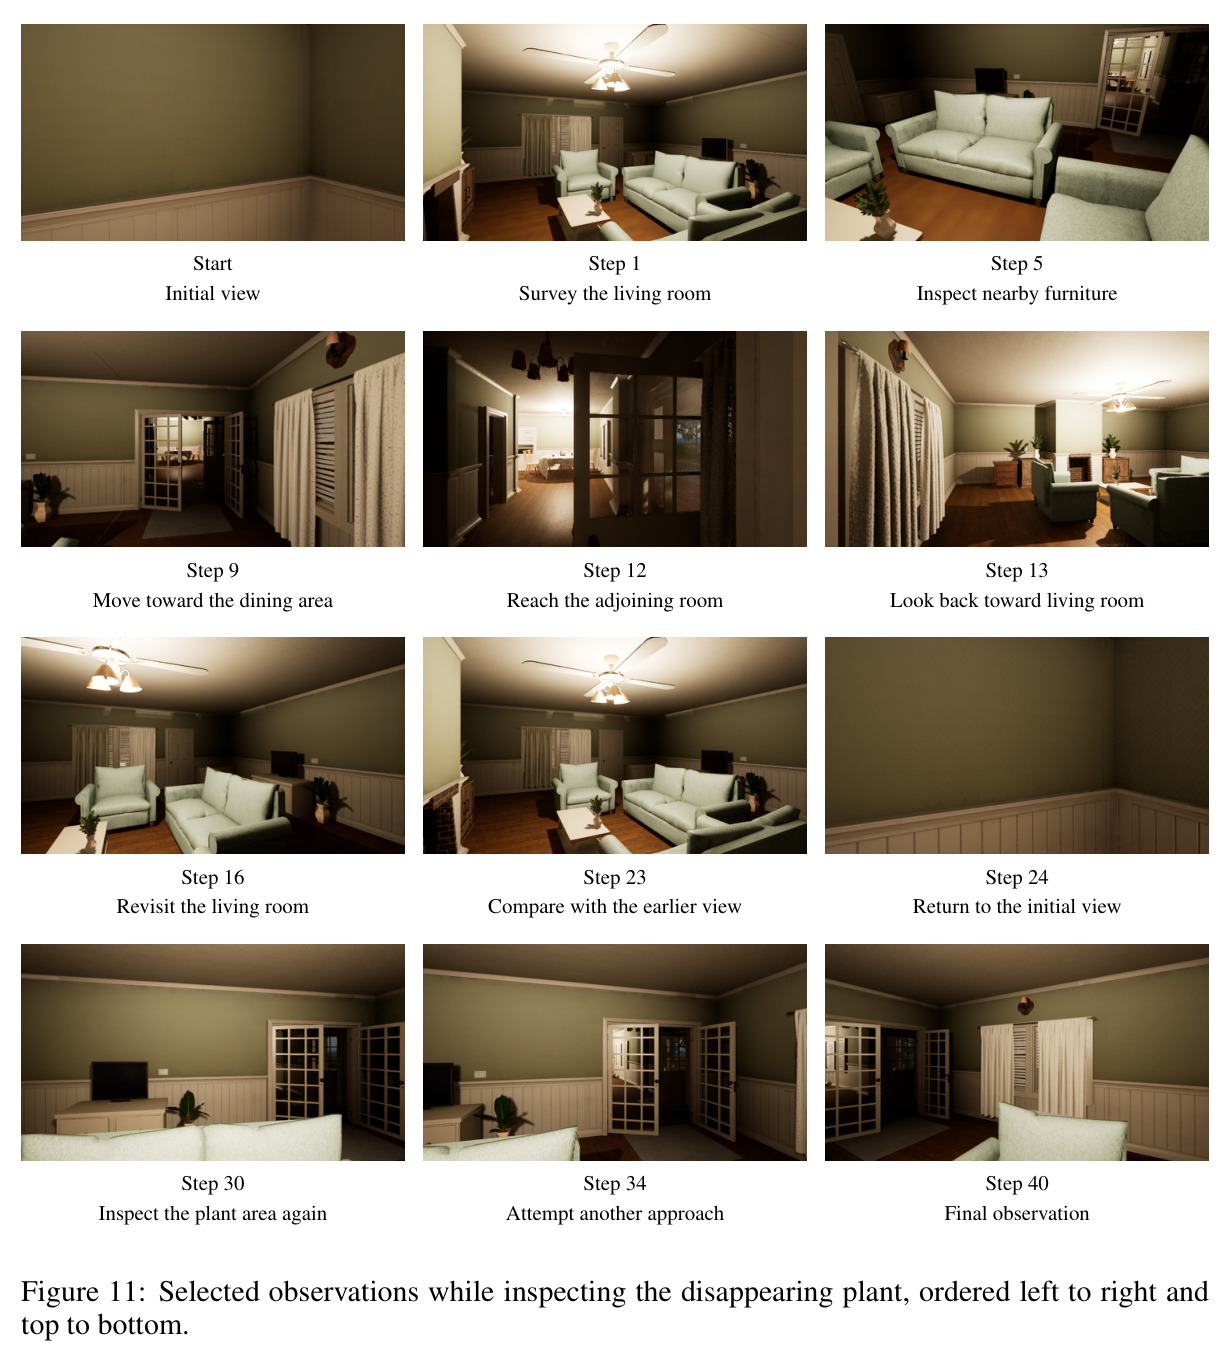
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 3D 世界审计(整体,VLM-only 范式) | 成功率 SR (%) | 42.3(GPT-6 Astra) | 人类 83.4;VLA–VLM 最好 17.4 | 超两阶段最好 24.9 个百分点,但仍落后人类 41.1 个百分点 |
| 时间一致性异常识别 | SR (%) | 12.5(GPT-6 Astra,VLM-only) | 人类 78.1 | 落后 65.6 个百分点,为五个异常族中差距最大者 |
| 静态物理异常识别 | SR (%) | 59.3(GPT-6 Astra,VLM-only) | 人类 89.8 | 落后 30.5 个百分点,为各族中最容易的一类 |
| 审计耗时(每任务,GPT-6 Astra) | 秒 | VLA–VLM 两阶段 80 秒 | VLM-only 交互式 368 秒 | 两阶段快 4.6 倍(全模型 2.7–10.3 倍),代价是 SR 从 42.3% 降至 16.4% |
| 推理成本(GPT-6 Astra) | 美元/任务 | VLA–VLM 0.281 | VLM-only 2.955 | 两阶段便宜约 10.5 倍,但成功率不到一半 |
| VLM judge 可靠性 | 与人判断一致率 / Cohen's κ | 91.72% / 0.645 | 无(judge 验证实验) | 跨引擎稳定:UE5 92.86%、Three.js 90.00% |
局限与改进
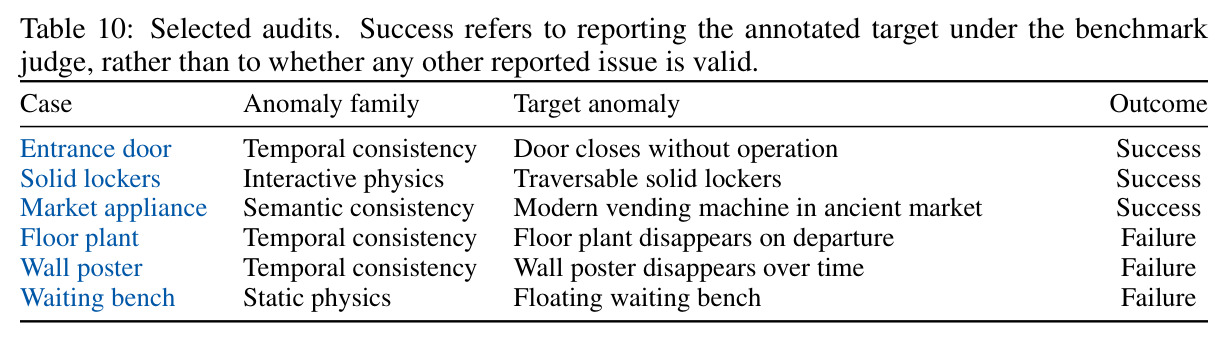
作者承认:主评测每任务只含一个目标异常,多异常仅是 21 个锚点任务上的附加实验;213 个任务全由作者手工构造,规模与多样性有限;评测的是“模型+harness”组合,差异无法干净归因于模型本身;judge 虽与人一致率 91.72%,但 $\kappa=0.645$ 只算中等。我的补充观察:第一,类型提示泄露过强——Gemini 在 Unreal 任务上去掉提示后 SR 从 33.3% 崩到 15.9%,主表的 42.3% 相当一部分来自“被告知找什么”,开放式审计的真实能力可能更接近 15.9% 一档;第二,“报告其他真实 bug 不给分”的规则加单异常设定,会系统性惩罚勤于报告的 agent,与真实 QA 的开放集合目标不一致;第三,两阶段所用 Open-P2P 1.2B 探索器几何覆盖仅 47.4%,VLA–VLM 低分可能是探索器太弱所致——Three.js 小场景上它反而达 23.0%–34.5% 即是佐证;第四,未与针对物理理解微调的方法或世界模型对比;第五,异常按人工模板植入,与真实游戏 bug 分布有差距;第六,人类基线每任务仅 2 人且同样拿到类型提示,基线也可能偏保守。
独立分析的弱点
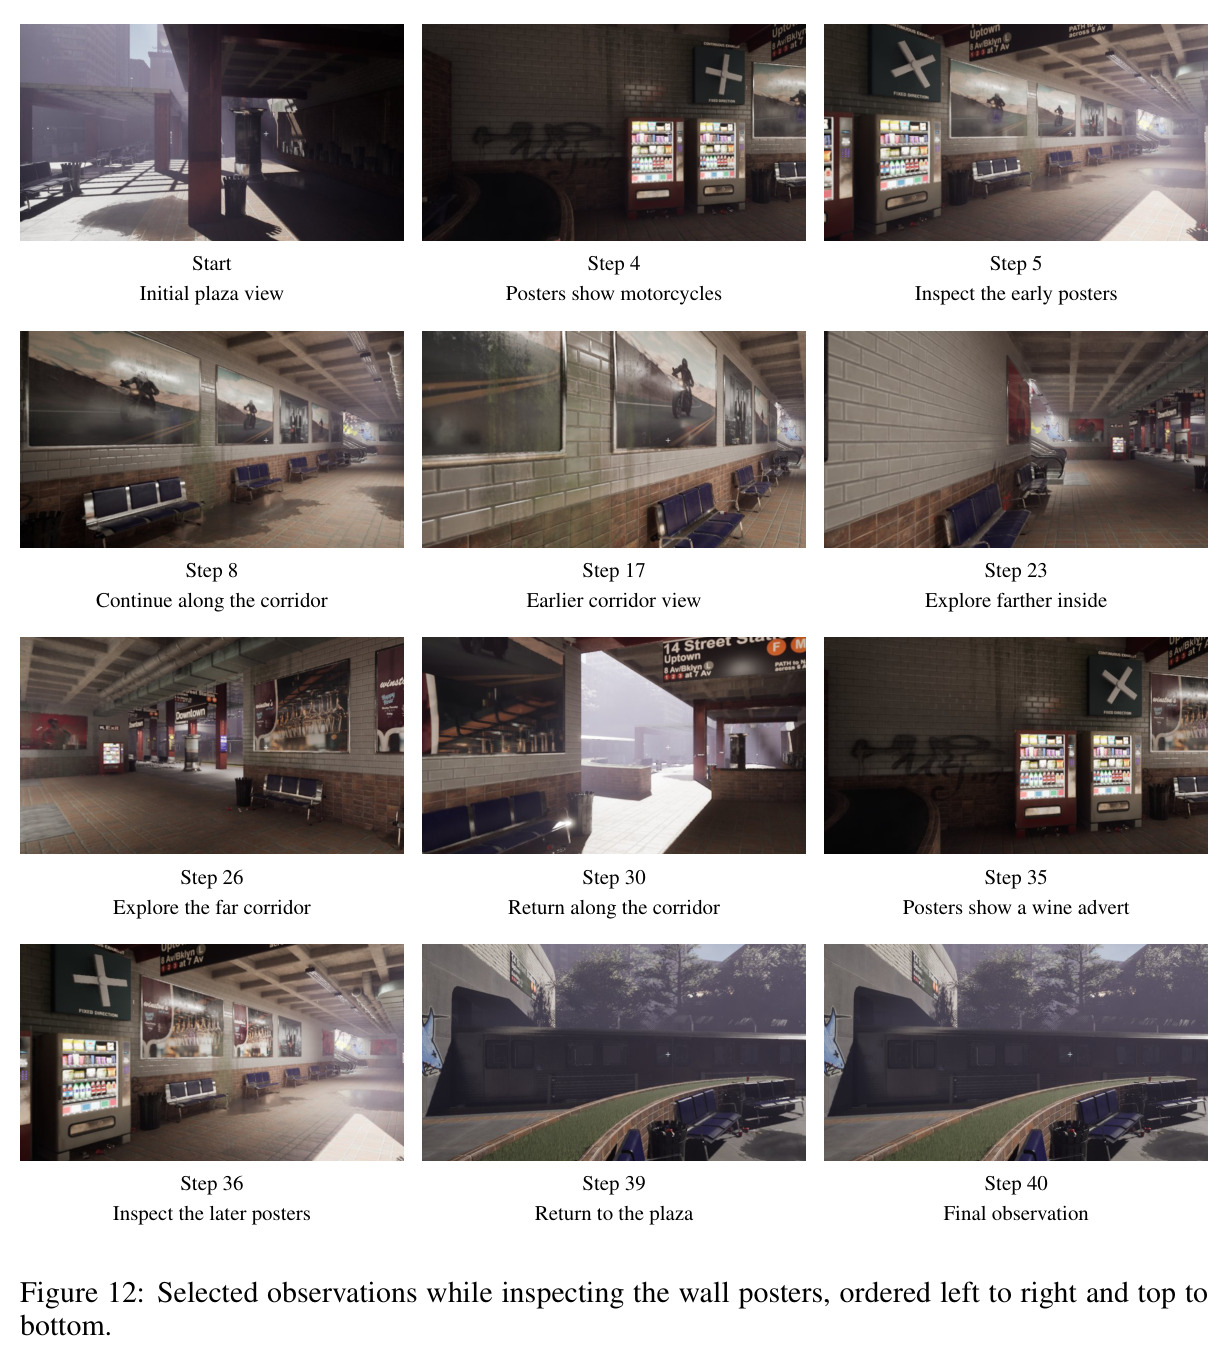
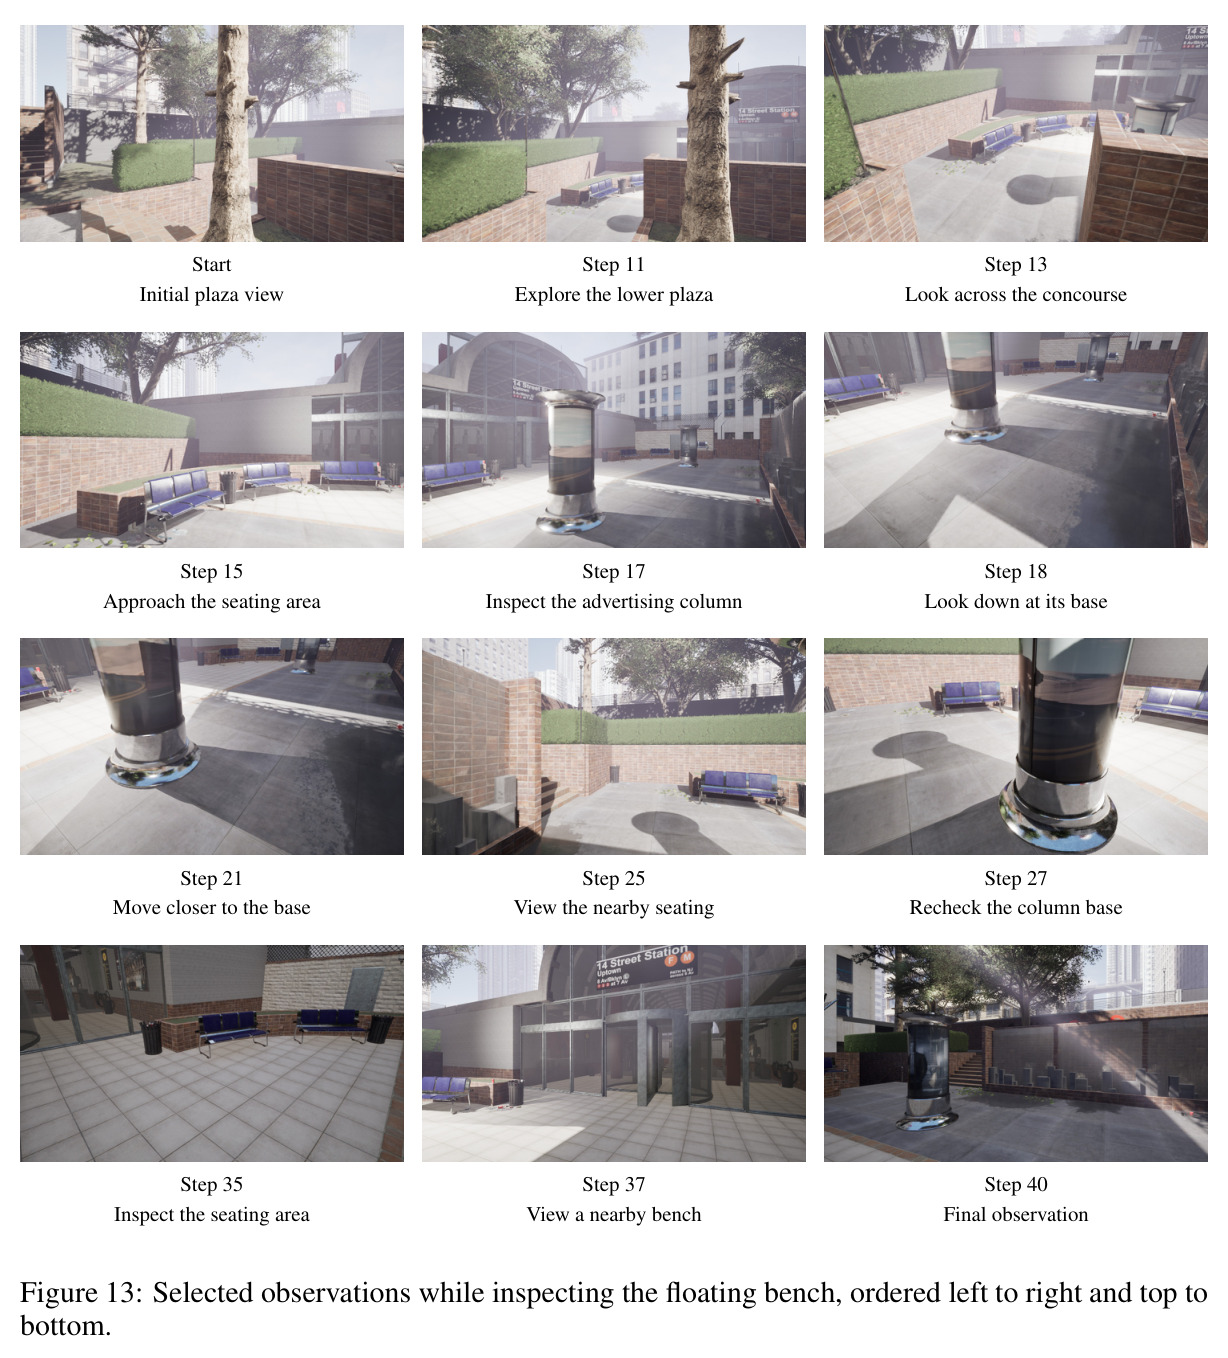
弱点一:假设生成能力缺失。模型高度依赖类型提示(去掉后 −17.5pp),说明它不会自主判断“哪里可疑”。改进:改为两阶段自我提示——先自由探索生成嫌疑清单再针对性验证,或训练“可疑度打分”辅助模块。弱点二:时间一致性崩溃(全模型 ≤12.5%,VLA–VLM 为 0)。消失/位移类异常需要“离开–返回”的重访调度和前后帧精确对齐,而失败案例显示 agent 重访后只做粗粒度全景对比。改进:显式重访规划器、关键帧自动配对与差分(同视角渲染差异图)。弱点三:假阳性与认错对象。案例中 agent 把正常广告轮播判为异常、把漂浮的候诊长椅误报成漂浮的广告柱。改进:报告前强制反事实检查(与同类参照物对比)及证据充分性自检(单一视角不得确认动态异常)。弱点四:固定预算下多异常召回仅约 29%。改进:把审计建模为覆盖–验证调度问题,按异常先验分配预算。弱点五:两阶段范式探索器太弱(几何覆盖 47.4% 对 91.1%)。改进:用 VLM 生成语言子目标引导 VLA,或探索中周期性回传文本摘要形成弱耦合。弱点六:harness 混杂使模型对比不纯。改进:统一 harness 只换模型骨干重跑,分离模型能力与工程贡献。
未来方向
作者层面:论文明确把 WorldAuditBench 定位为研究“从观察形成假设、用行动检验假设、跨视角与时间连接证据”的智能体的测试床,并承诺发布评测代码、任务配置与可运行环境包。可延伸方向:其一,自动化扩题——用程序化 bug 注入(修改碰撞体、材质、LOD、tick 逻辑)把任务从 213 个扩到数千级,缓解手工构造瓶颈并支持随机化防过拟合;其二,把审计器接入场景生成闭环——在 PAT3D、LayoutDreamer、ClutterGen 等生成管线后挂审计 agent,形成“生成→审计→修复”的自动迭代;其三,训练专用审计智能体——以 SR 和证据质量为奖励做强化学习,或用人类审计轨迹做 SFT,检验当前差距是能力问题还是提示问题;其四,把几何覆盖率/暴露率分解指标推广为通用具身评测诊断工具;其五,从 POMDP 视角形式化“取证式探索”,研究有限预算下最优信息获取策略;其六,迁移到真实游戏 QA 流程或数字孪生巡检验证实用价值;其七,多 agent 协作审计(分区分工、证据共享);其八,研究无类型提示下模型自主形成异常假设的机制,逼近真实开放式审计。
复现评估
复现条件总体友好。数据与任务:213 个任务基于 13 个公开来源环境(UE5 资产来自 Fab,Three.js 场景多为 MIT/CC BY 4.0/CC0 许可,Sponza 沿用 Crytek 条款),作者承诺按许可证发布评测代码、任务配置和可运行环境包——UE5 只发打包运行时不发源工程,Three.js 可在浏览器直接运行;不过截至论文尚未给出可用代码/数据链接(仅 Project Page 占位)。协议透明度很高:judge 完整提示词、15 类异常定义与 in-context 示例、全部工具定义、输入输出样例均在附录公开。算力:纯推理评测、无训练;需要 5 个商用模型 API(最强配置约 $2.955/任务,全量实验估计在 2000 美元量级内)和开源的 Open-P2P 1.2B;UE5 场景经远程串流访问,需要一定部署能力。难度评估:中等——拿到发布包后跑通评测主要是工程问题,主要风险是 judge 一致性($\kappa=0.645$ 属中等,复现时边界案例判定可能漂移)和 UE5 串流环境搭建;复现人类基线还需招募约 10 名博士生、每任务 2 人评审。
论文图表
列出每个任务的标注内容:场景描述(环境与可用交互)、异常类别(15 类之一)、评价 rubric(目标异常与预期正常行为)、人工验证记录(质量判定、难度、评论)。附“无支撑粮袋”示例。
说明 rubric 与标注的结构:rubric 对 agent 隐藏、只供 judge 使用,这是整个评测协议防作弊设计的基石。