通往真实世界的最后一公里:作为可复用积木的智能体原生原语(Agent-Native Primitives) The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
给每份资源配常驻LLM使其会用自己,再按任务组装、按证据修订,打通真实任务最后一公里
前置知识
Agent Harness(智能体线束/脚手架)
Harness 是围绕大模型的一段控制程序,决定观察如何进入模型、工具如何执行、何时重试、何时终止,例如 Codex 之于 GPT、Claude Code 之于 Claude,或 ReAct 的「思考-行动-观察」循环。模型能力固定时,harness 决定同一模型在真实任务上的成败。本文把它形式化为映射 $H$:运行任务 $q$ 产生轨迹 $\tau$,由任务自身的验收程序(测试、证明检查器、答案钥匙)打分 $R_q(\tau)\in[0,1]$。
本文的核心问题正是「每个任务的 harness 应该怎么造」:HEELO 主张用可复用原语按任务组装 harness,理解 harness 概念才能看懂它与固定 harness、harness 搜索类工作的本质区别。
Function Calling 与参数落地(schema binding / grounding)
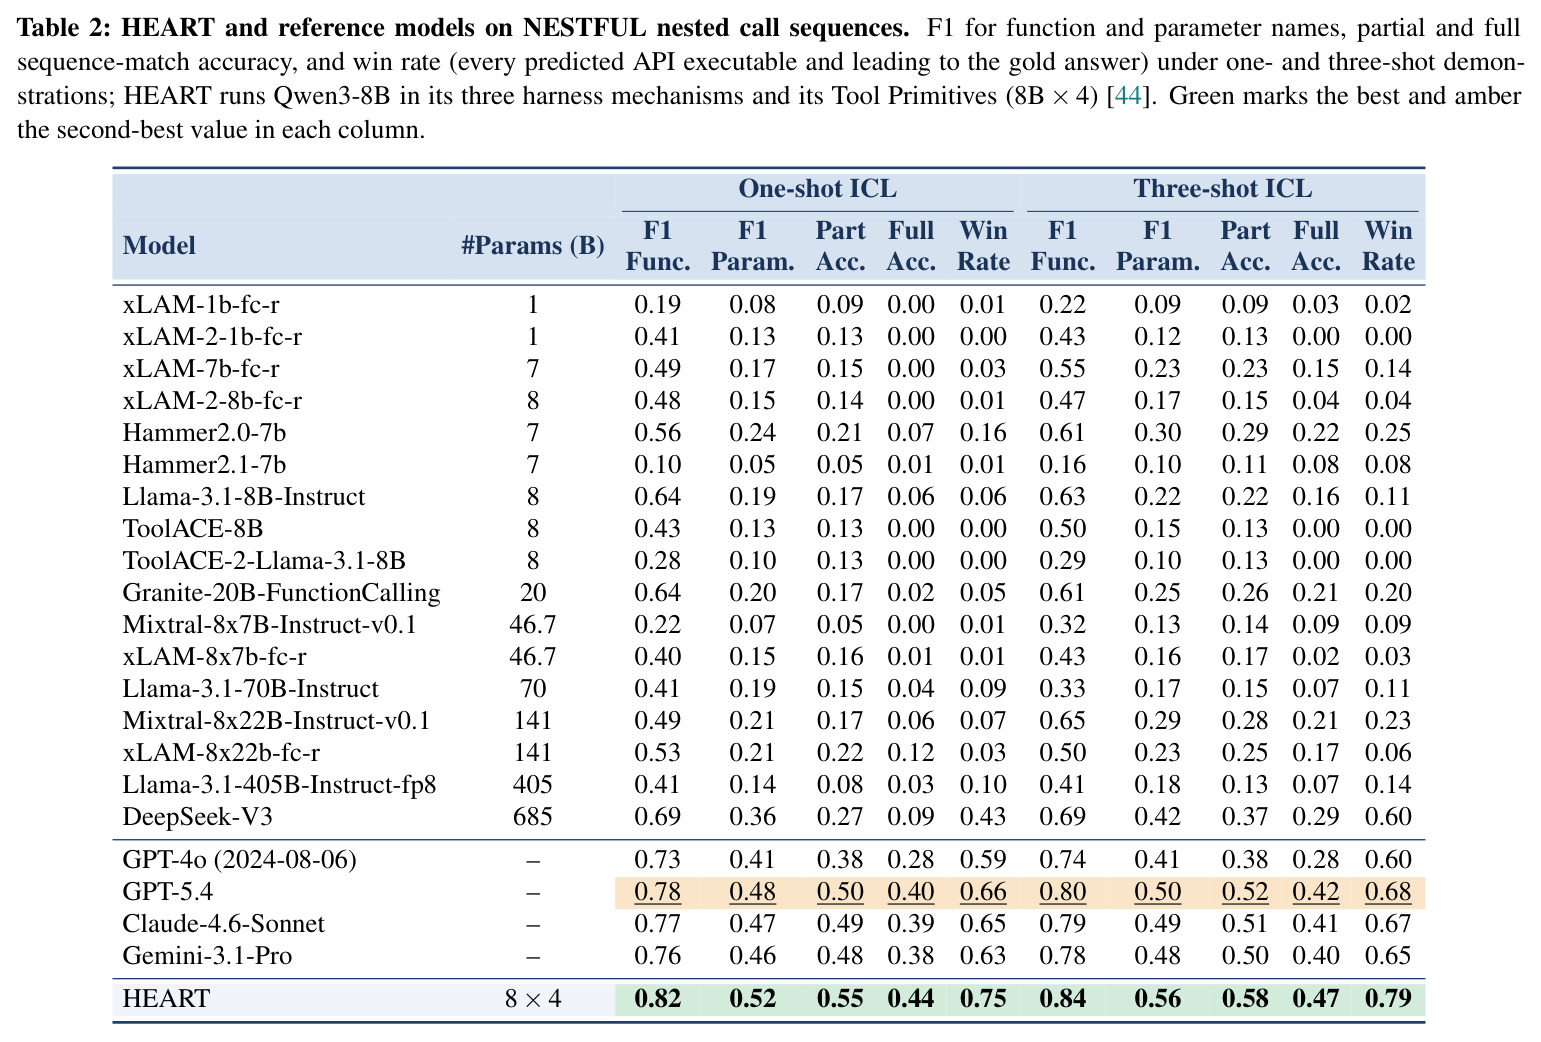
函数调用要求模型按工具的 JSON schema 生成合规参数,并把每个参数的取值落到具体对象上——尤其是把上一次调用的输出填进下一次调用的输入。工具目录一大、调用一嵌套,模型就容易写错参数或产生幻觉值;NESTFUL 等基准专门考察这种嵌套调用序列,xLAM 等在平坦轨迹上微调的模型在该基准上全序列准确率接近 0。
「应用资源」的第一层就是落地参数。Tool Primitives 的核心主张正是把这一步从调用者搬进工具自身的常驻 LLM,是全文动机最直接的例子。
RAG 与两阶段检索-重排
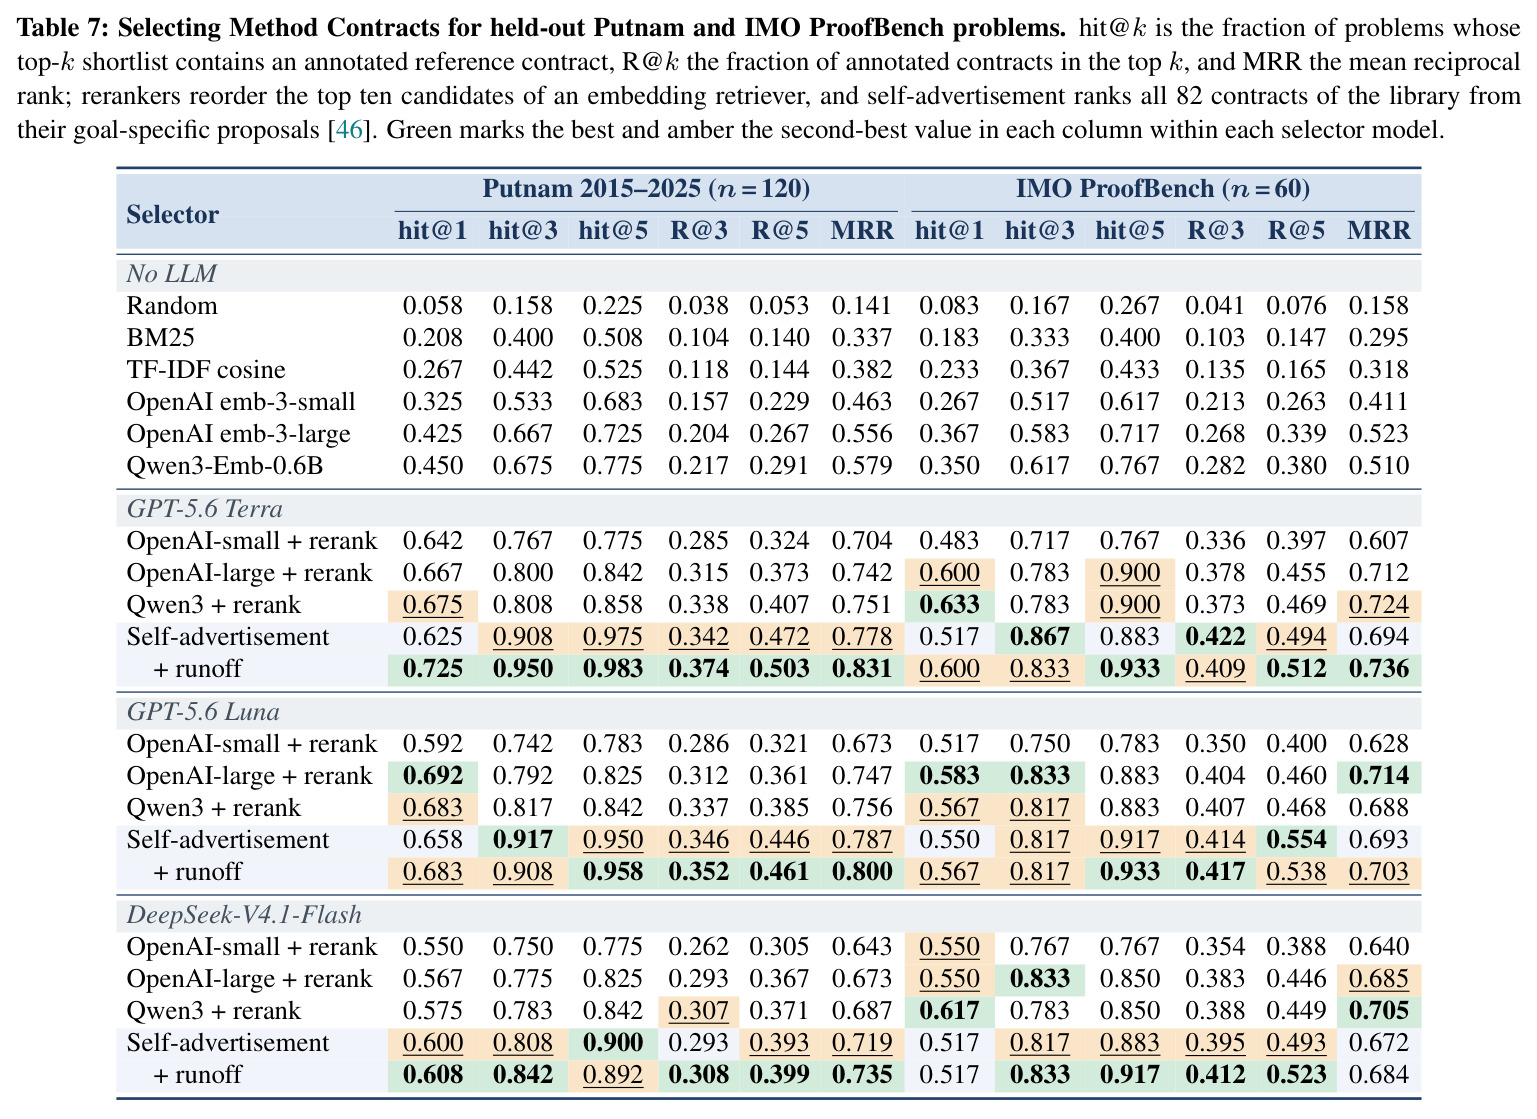
检索增强生成把外部文本切块、嵌入、按相似度取回后拼进上下文;多跳问答(HotpotQA、MuSiQue)需要串联多个证据。其结构性短板是:相似度先选出一个候选池,后面的重排器只能在池内排序,池里漏掉的内容永远无法恢复——本文命题 3.3 用 $hit@k\le \mathbb{1}[\mathcal{S}_m(q)\cap\mathcal{U}_q\ne\emptyset]$ 形式化了这一天花板。
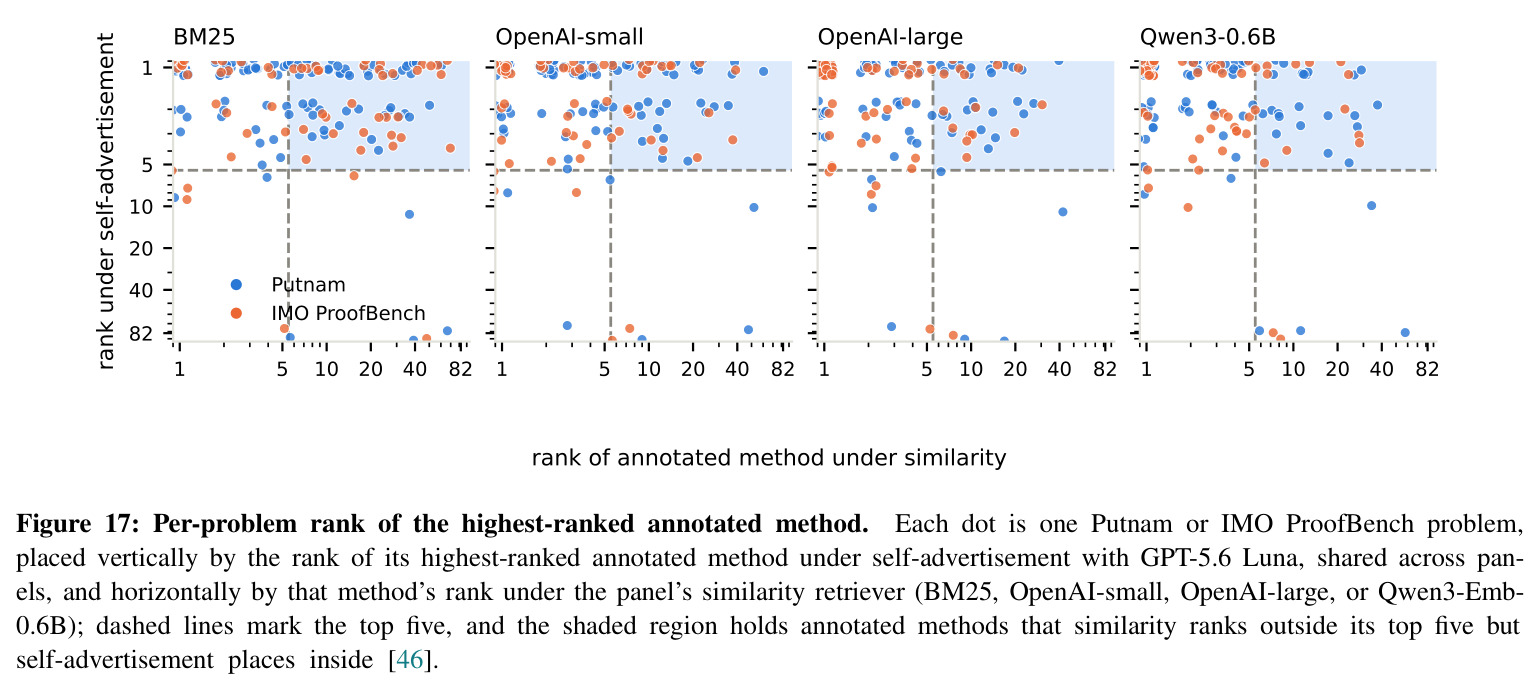
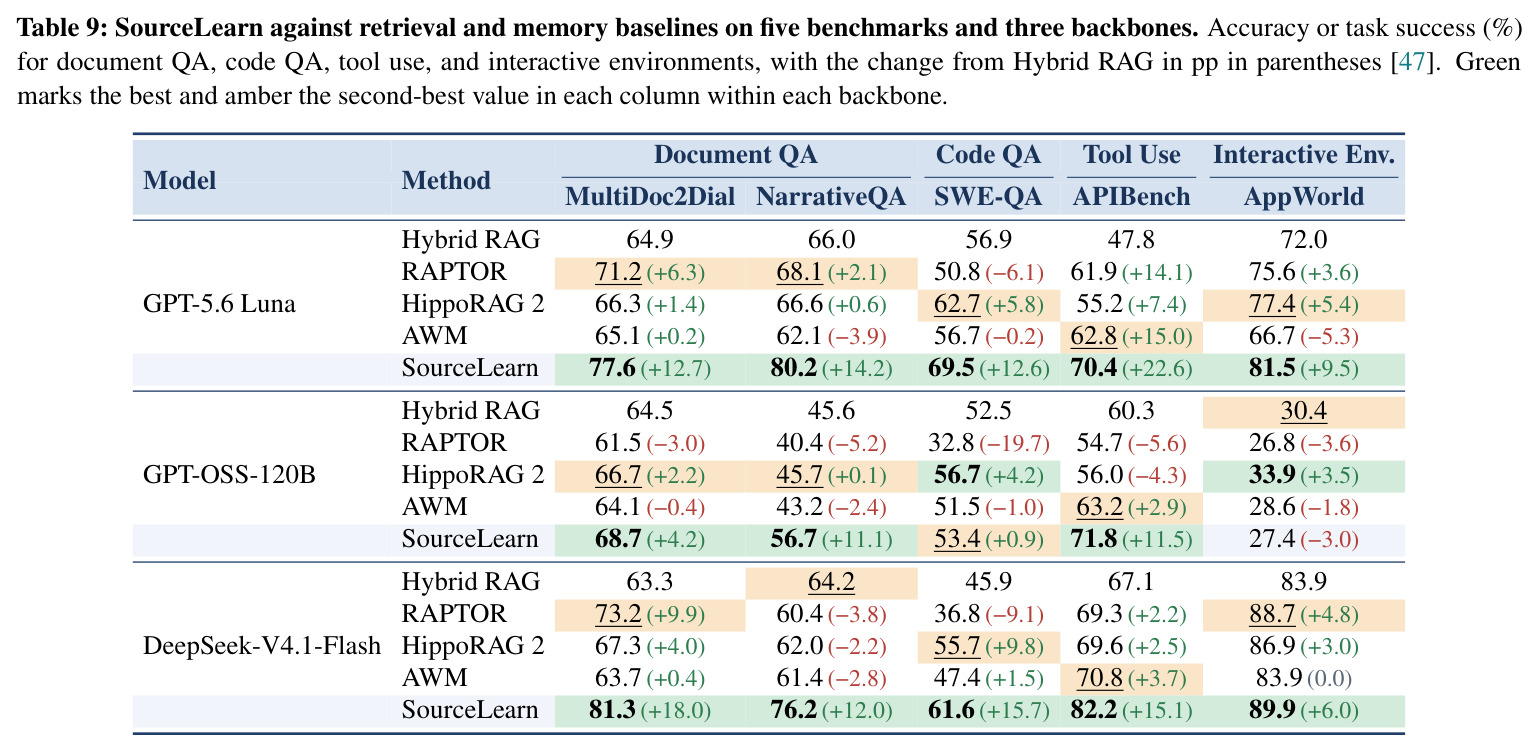
Knowledge/Navigation Primitives 的对照基线是 Hybrid RAG、RAPTOR、HippoRAG 2;Math Primitives 的自荐式选择正是为了绕开两阶段检索的覆盖天花板。
KV Cache 复用与 RoPE 位置重索引
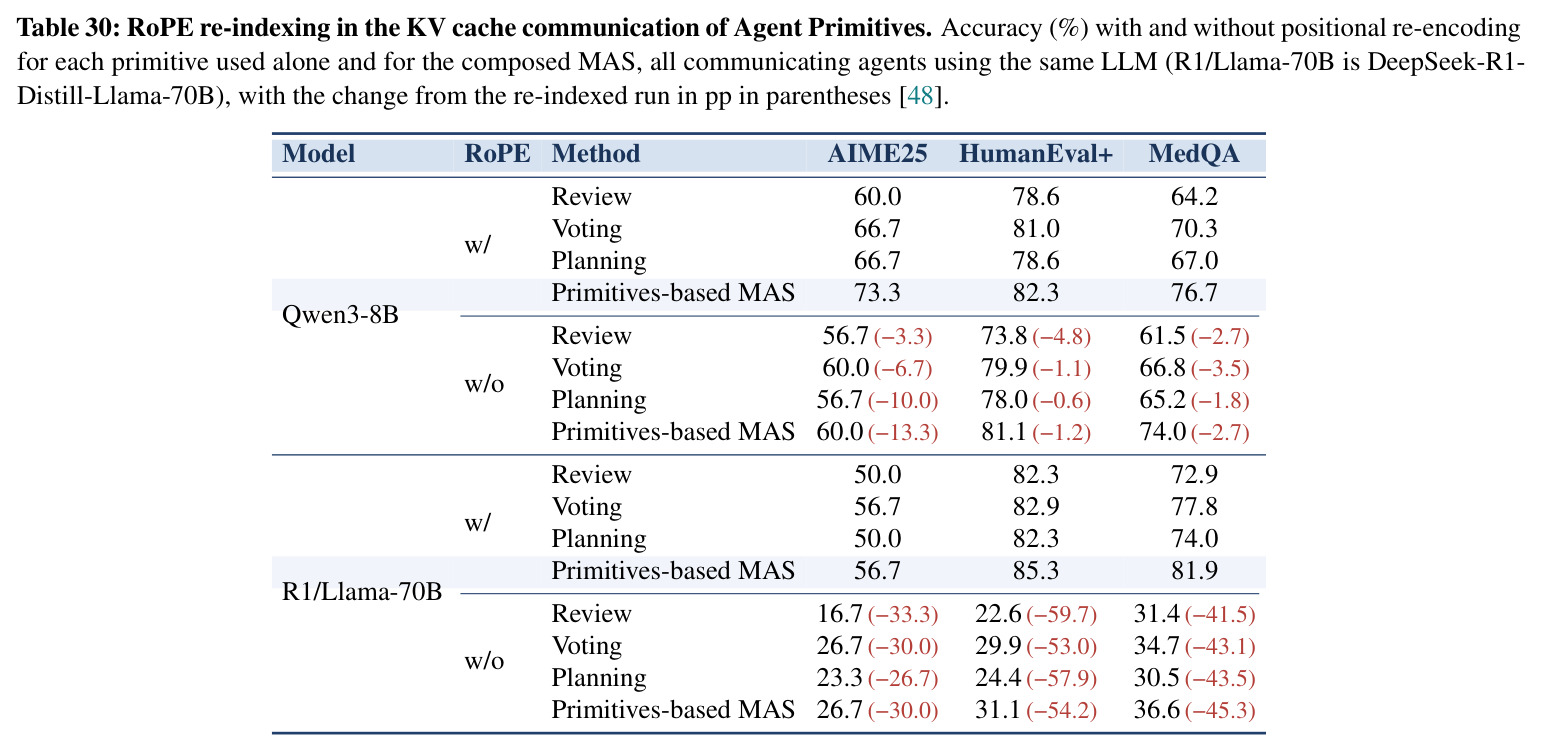
Transformer 推理时把每层的 Key/Value 缓存下来避免重复计算;RoPE 用旋转位置编码把 token 的绝对位置编进 Key。若多个智能体共享同一个 LLM,一个智能体可以直接读另一个的 KV cache 实现「潜空间通信」,但接收方读到的 Key 带着发送方时的位置,必须按新位置重新索引(re-indexing)才能保持语义正确。
Agent Primitives 让原语内部的智能体用 KV cache 通信;论文消融显示去掉 RoPE 重索引后 R1/Llama-70B 在 HumanEval+ 上从 85.3% 跌到 31.1%,是理解其结果的关键技术细节。
Lean 形式化定理证明
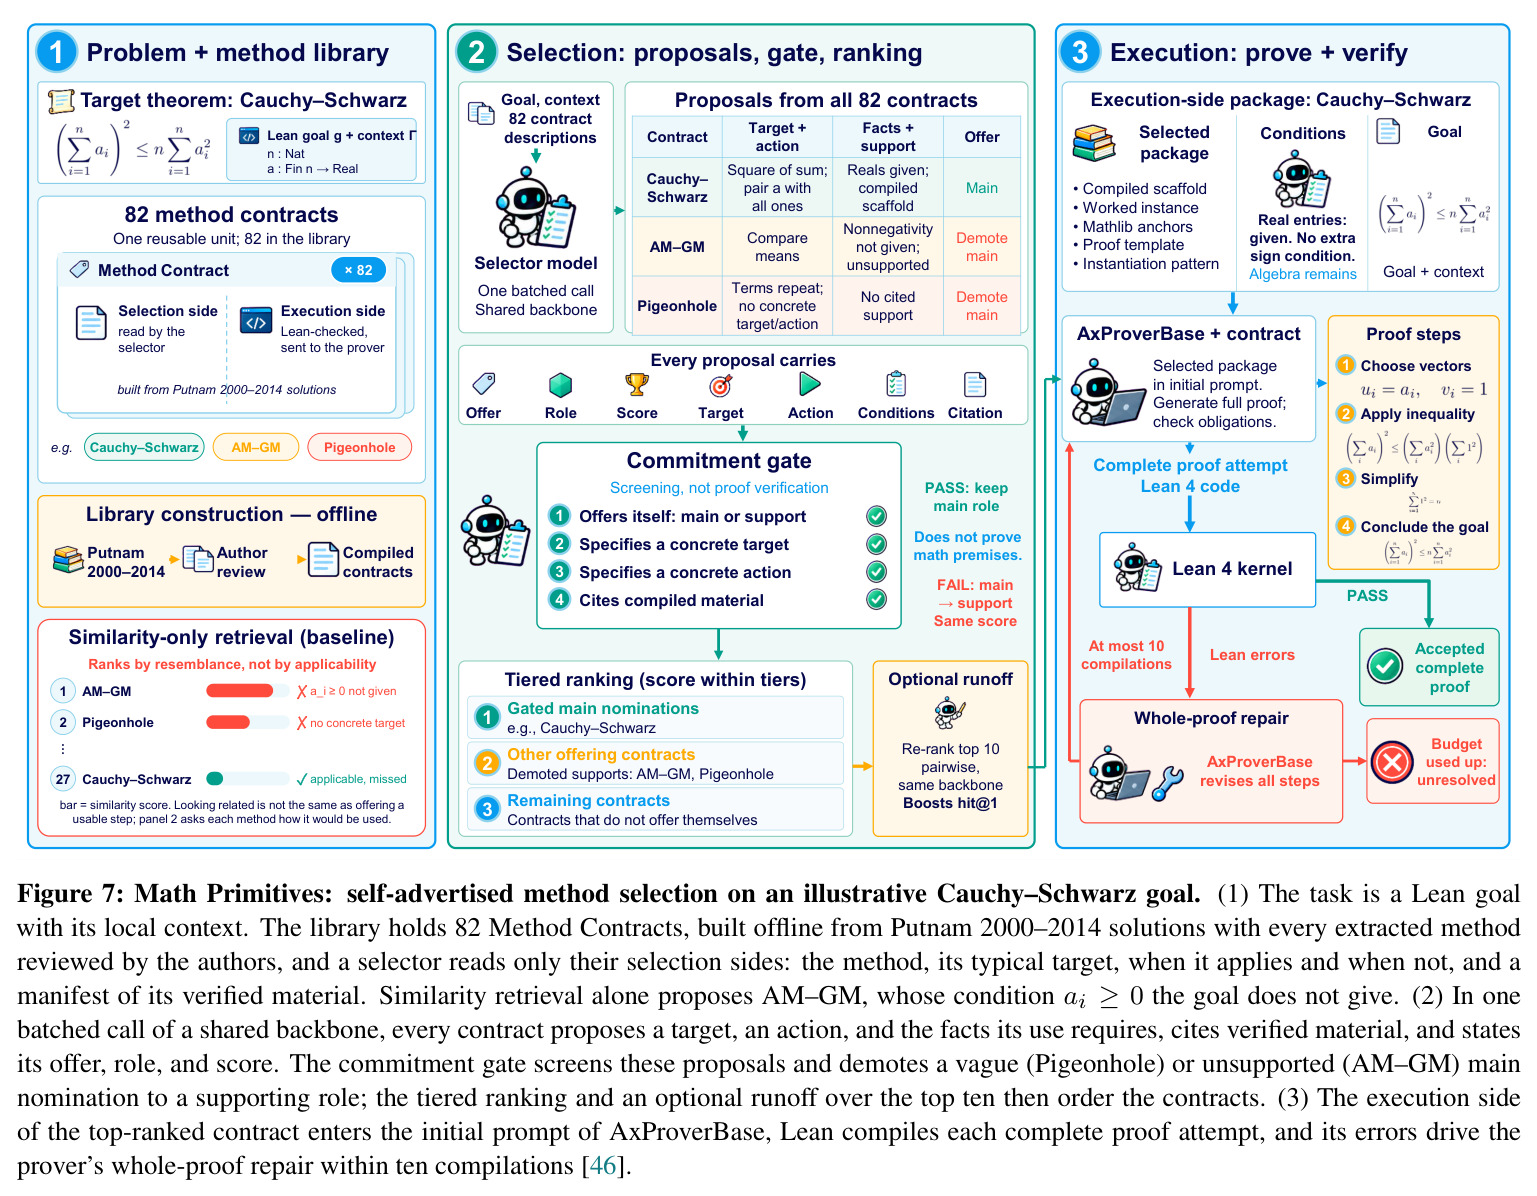
Lean 4 把数学证明写成代码、由内核逐条机器检查,Mathlib 是其大型数学库。LLM 证明器生成证明、依据编译器报错做整证明修复(whole-proof repair),hit@k 衡量前 $k$ 个候选是否包含正确要素。证明「方法」是否适用于当前目标(如 AM–GM 不等式需要 $a_i\ge 0$ 而目标并未给出该条件)是相似度检索和 LLM 重排都难以可靠判断的。
Math Primitives 把证明方法打包成 Method Contract(前置条件 Pre、目标动作、Lean 脚手架、残余义务),其「自荐式选择」正是为了解决方法适用性这个检索回答不了的问题。
MCP(Model Context Protocol)
MCP 是让外部工具/服务以统一接口接入智能体的开放协议,Claude Code、Codex、Cursor 等都可作为 MCP 客户端调用远端工具。第三方平台借此可以把真实动作(订票、发邮件、爬网页、渲染文档)注册成智能体可直接调用的工具,并保留会话状态、追问缺失信息。
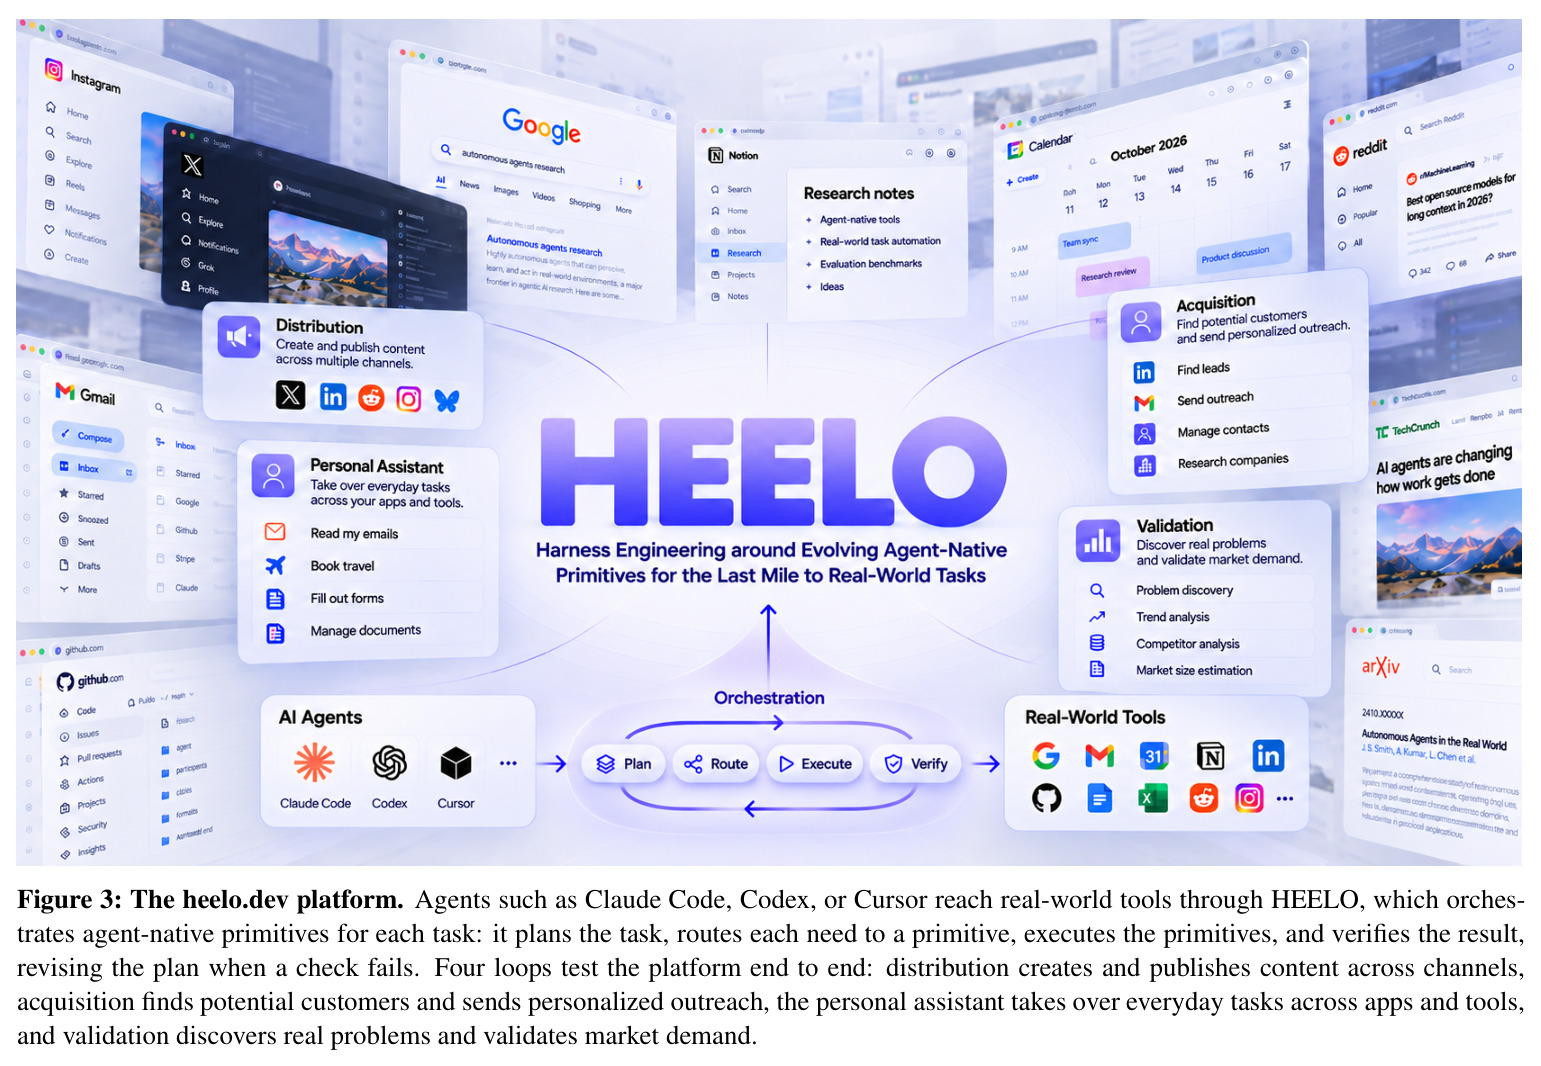
heelo.dev 平台正是通过 MCP 服务器把 HEELO 的真实世界原语暴露给 Claude Code 与 Codex;46 个真实任务「单打 vs 接 HEELO」的前后对比全部经由这一通道完成。
研究动机
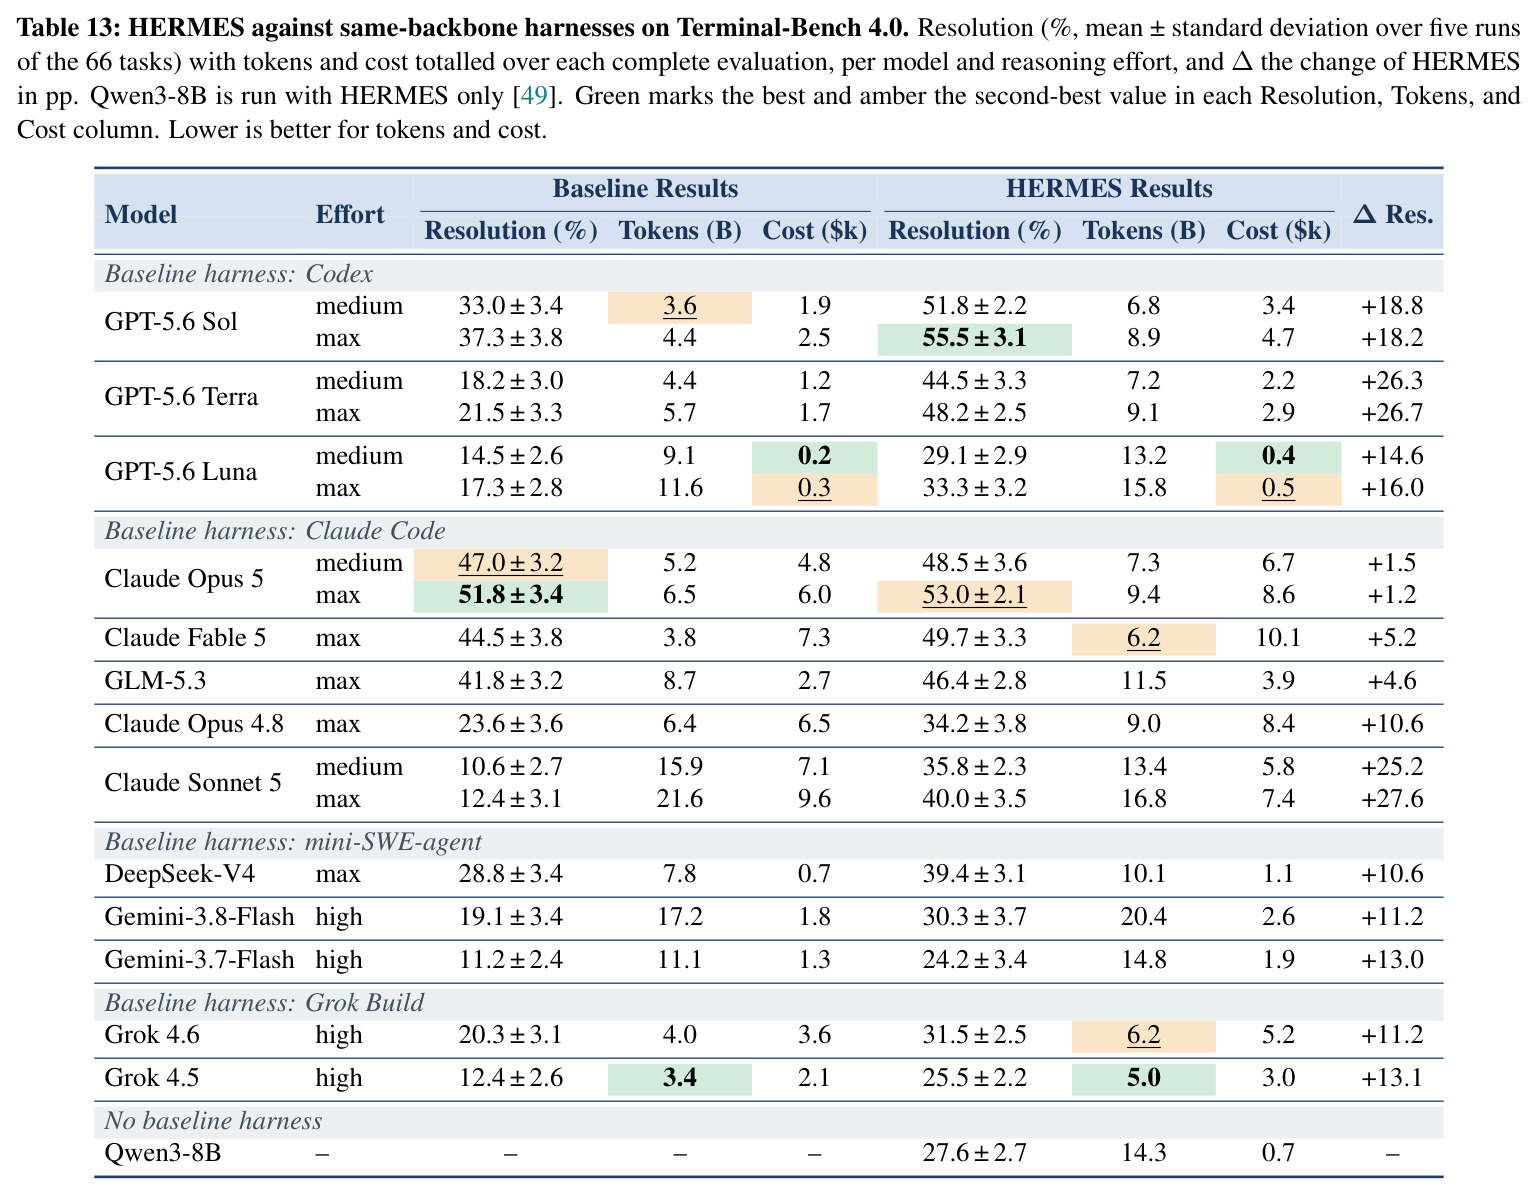
前沿模型与其专用 harness 在公开真实任务基准上仍远未解决:Terminal-Bench 4.0 最高推理档位下,GPT-5.6 Sol 配 Codex 只解决 37.3% 的任务,Claude Opus 5 配 Claude Code 为 51.8%;DevOps-Gym 四阶段上两者平均成功率仅 49.9% 与 52.1%;τ²-Bench 航空域里 Claude-4.6-Sonnet 也只有约一半任务能在四次独立试验中全部成功。作者把这些失败定位在「够到资源」与「用好资源」之间的最后一步,称为通往真实世界的最后一公里,表现为三点:应用要落地——工具调用的每个参数都要落到具体对象,常取自更早调用的输出,还要遵守环境规则;组合要连通——一步的返回值必须以可用形式送达消费它的步骤;失败要可追溯——环境里观察到的失败必须能追回到它牵连的工作。现有方法(工具学习、检索与记忆、技能库、多智能体框架、workflow 搜索与 harness 生成器)只是把资源送到调用者面前,把「会用」的能力留给调用者或折进单体 agent,于是每个 harness 都要为每个任务重建这种能力:调用者要读的内容随库增长,学到的能力随任务结束丢弃,结果也难以核查。
本文的目标是本文要回答的问题是:智能体如何端到端地完成一个真实世界任务?作者给出的目标是把「应用资源」的能力随资源本身携带,而不是反复交给调用者重建。具体分三层:第一,定义一类可复用的基本单元——agent-native primitive,让每个工具、代码组件、证明方法、源文档、多智能体计算模式、仓库文件乃至 harness 控制操作都自带一个常驻 LLM,会用自己、能与其他原语通信;第二,提出统一的 harness 工程框架 HEELO,按任务从演化的原语库中选件组图、按环境证据修订、验证后发布入库,使能力可以跨任务存续;第三,在八类真实任务、二十余个公开基准以及 heelo.dev 平台的 46 个带真实账号与副作用的任务上系统验证该路线,使每个新任务域都能作为一个新的原语族纳入同一框架。
与已有工作不同的是,独特之处在于「能力随资源走」这一视角转换与跨领域统一抽象。此前工作的单位——函数、代码组件、引理、段落或记忆、角色或团队、harness——都保留资源而把应用能力留给调用者,或锁死在单体里;本文让被动构件变成会推理、会互发消息的主动参与者。其次,八篇伴随研究(工具、代码、定理证明、知识、多智能体、软件工程、大信息空间、harness 本身)被统一为一个定义加三个机制:库选择与组合、基于证据的执行与改进、验证与发布,并用三条命题刻画该设计——激活数被任务需求界定、按任务组合何时优于最优固定 harness、相似度重排的覆盖天花板。最后配套 heelo.dev 平台与 46 个真实任务,把评估从环境冻结、评分器固定的研究基准推进到有真实服务、账号与人的场景。
核心方法
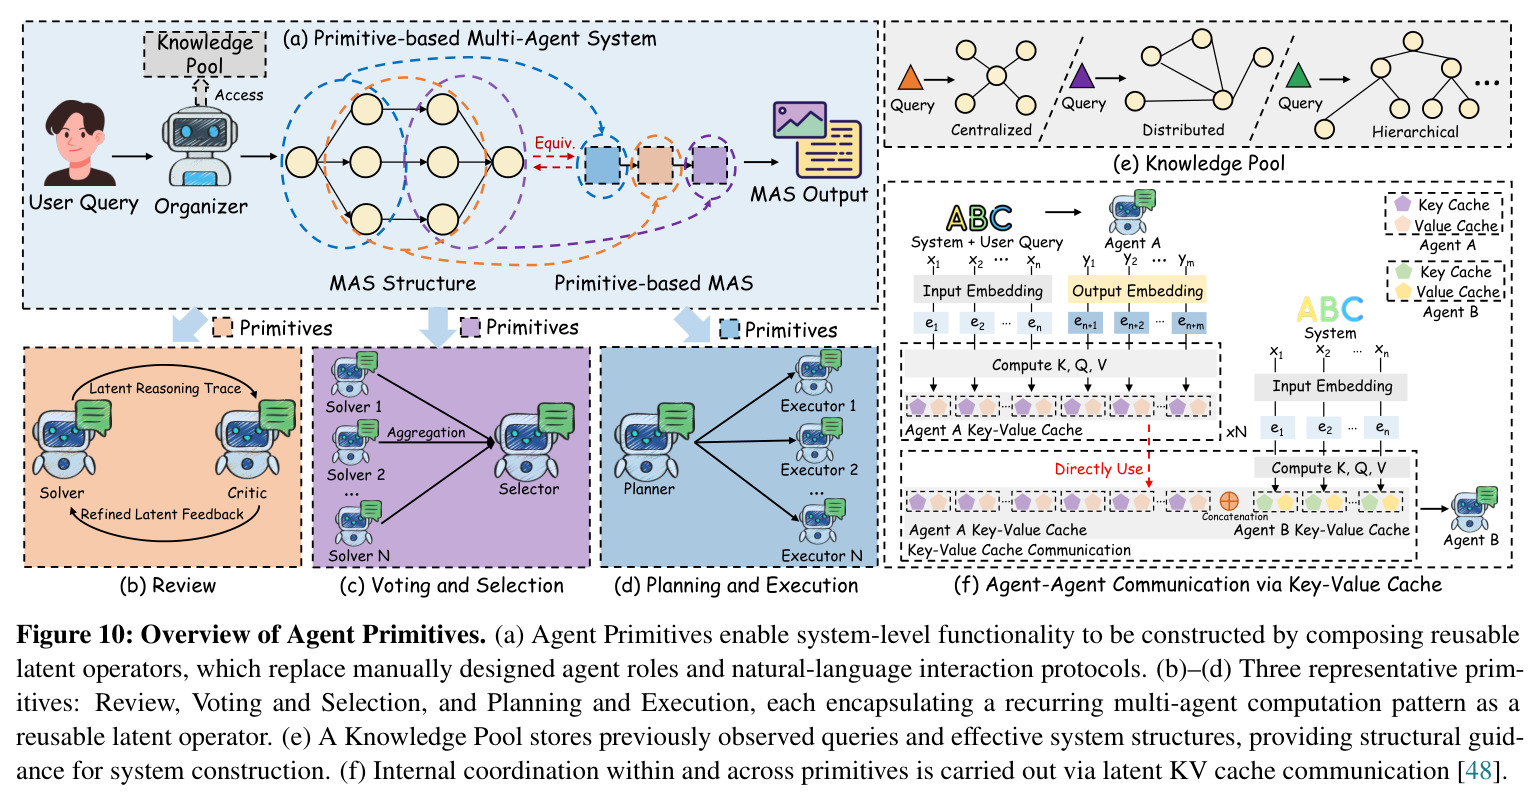
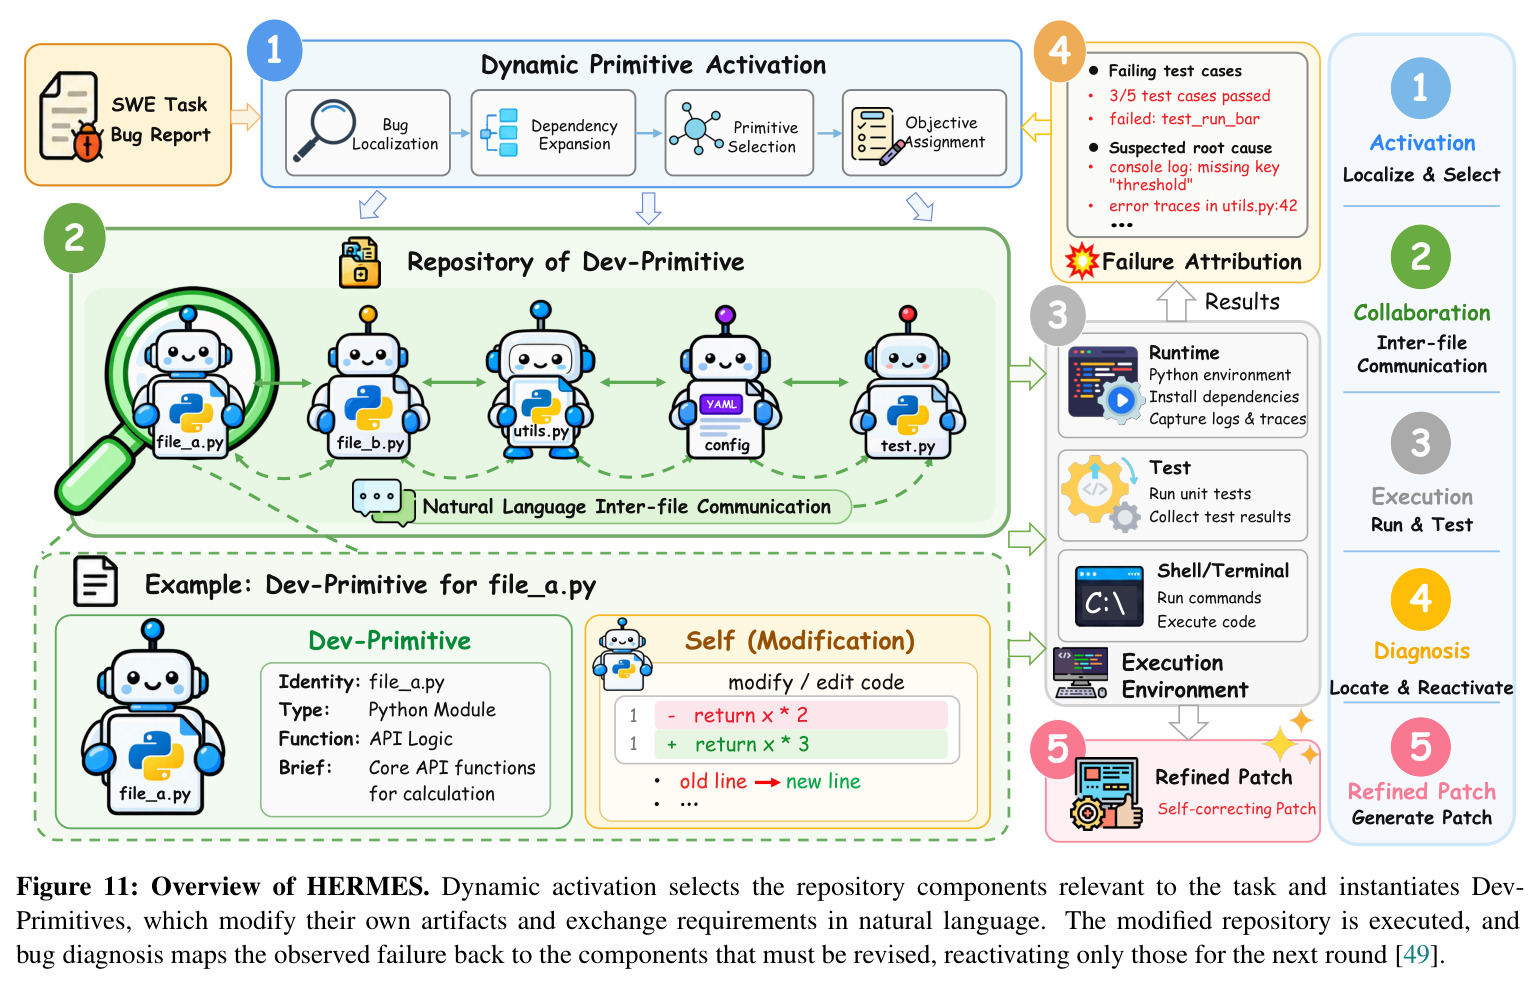
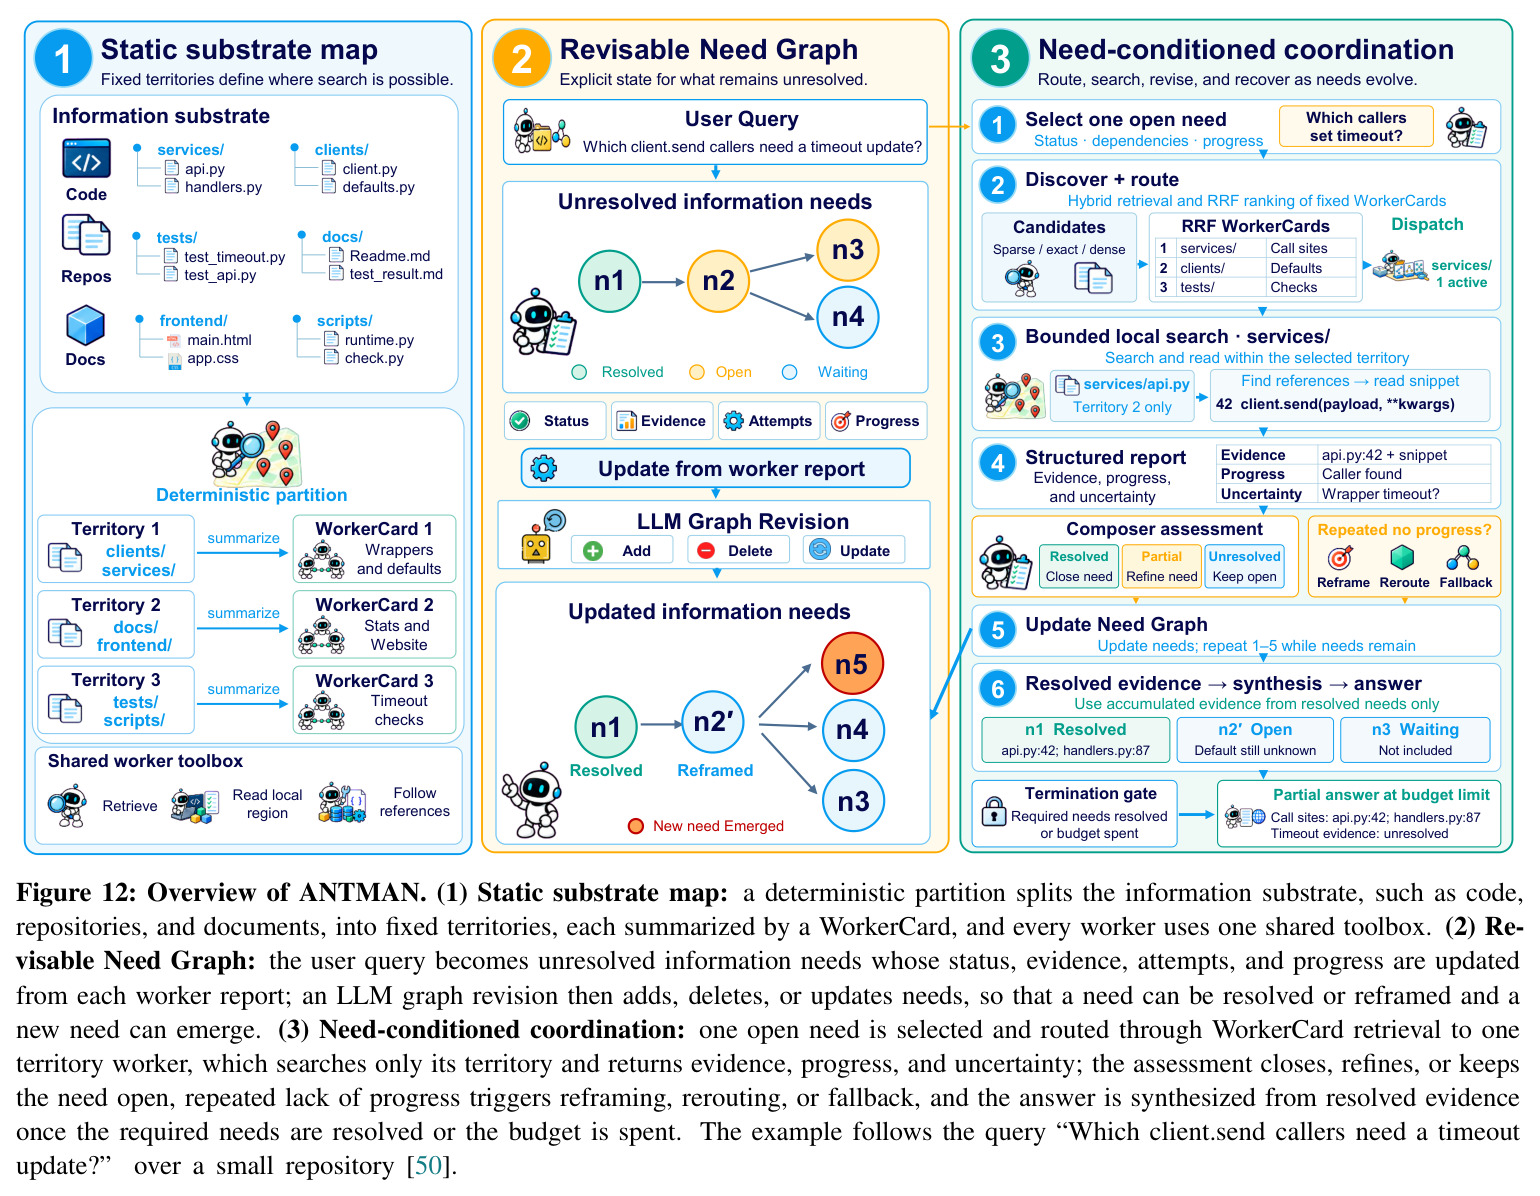
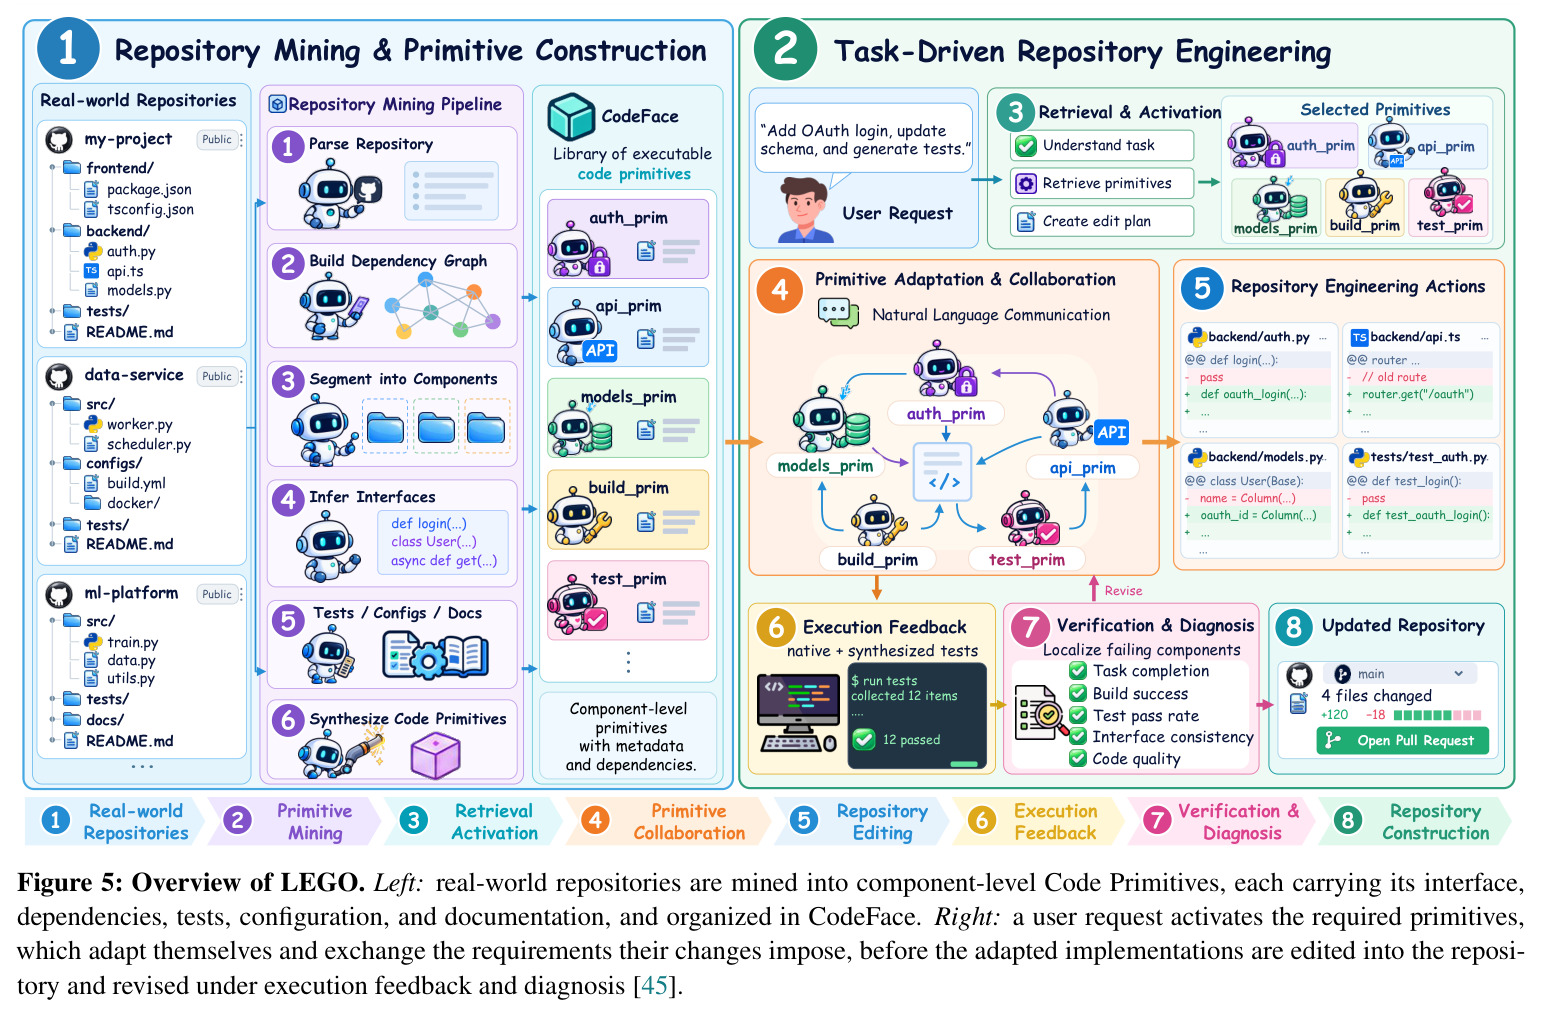
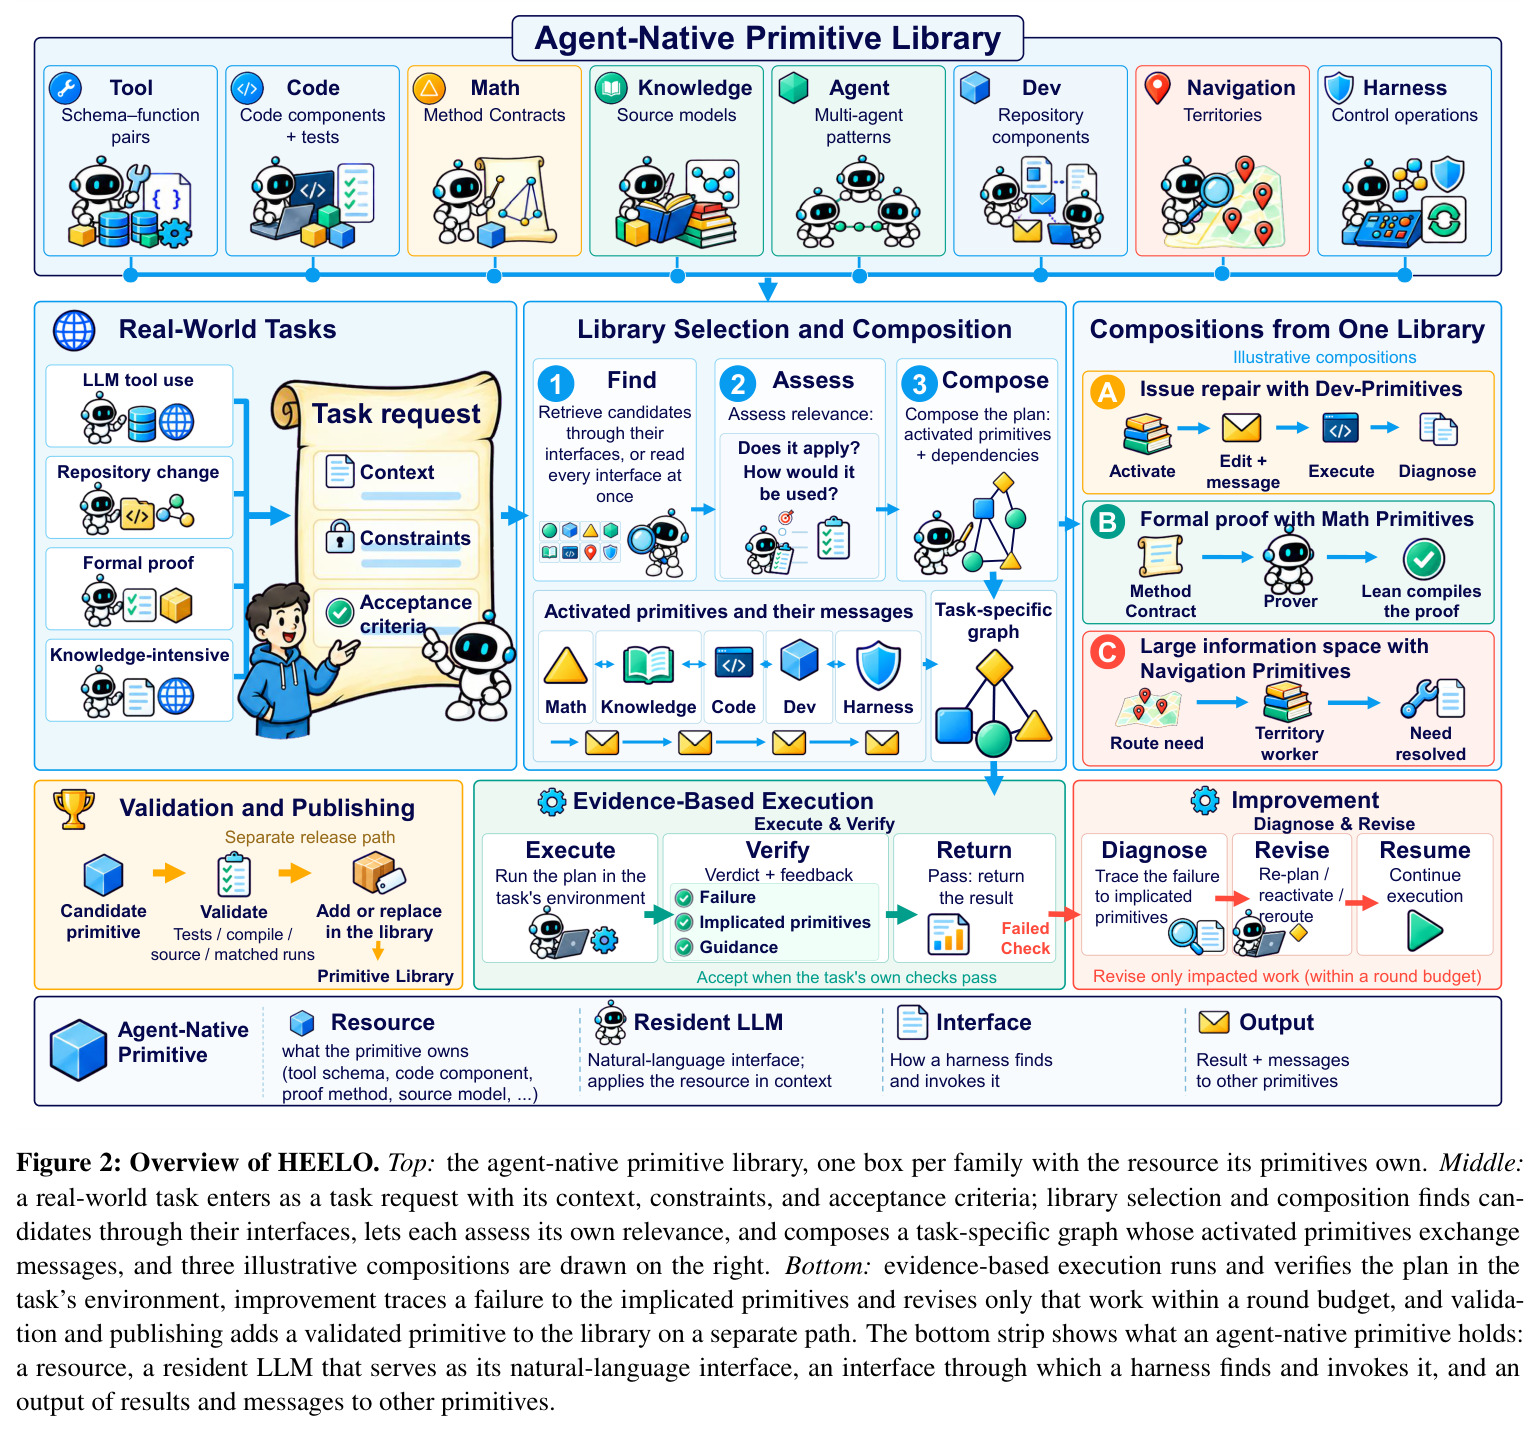
直觉:与其让调用者读遍所有工具手册并自己拼装,不如给每份资源配一个「懂自己的店员」——常驻 LLM。技术路线分三步。第一步定义原语:原语 $P_i$ 由资源 $a_i$、常驻 LLM $\mathcal{M}$ 与接口 $d_i$ 组成,收到自然语言请求 $x_i$ 与上下文 $c_i$ 时执行 $(r_i, m_i)=P_i(x_i;c_i)=\mathcal{M}([a_i;c_i;x_i])$,返回结果 $r_i$ 与给其他原语的消息 $m_i$;原语还可在选择前自评相关性,在返回前跑随行验证(自带测试或 schema)。第二步用三个机制工程化每个任务的 harness:COMPOSE 通过接口检索或一次读全库接口找候选,组装只含所需原语的任务专属图 $\Pi_t$;执行-验证-修订循环里 VERIFY 产出裁决与结构化反馈 $\varphi_t=(e_t,\mathcal{I}_t,u_t)$,失败只重做被牵连的原语,至多 $B$ 轮;VALIDATE 在与任务执行分离的通道上把通过测试/编译/匹配运行的新原语并入库。第三步按任务域实例化出八个原语族(Tool/Code/Math/Knowledge/Agent/Dev/Navigation/Harness),各自实现其任务所需的机制,使八篇伴随研究成为同一框架的实例。
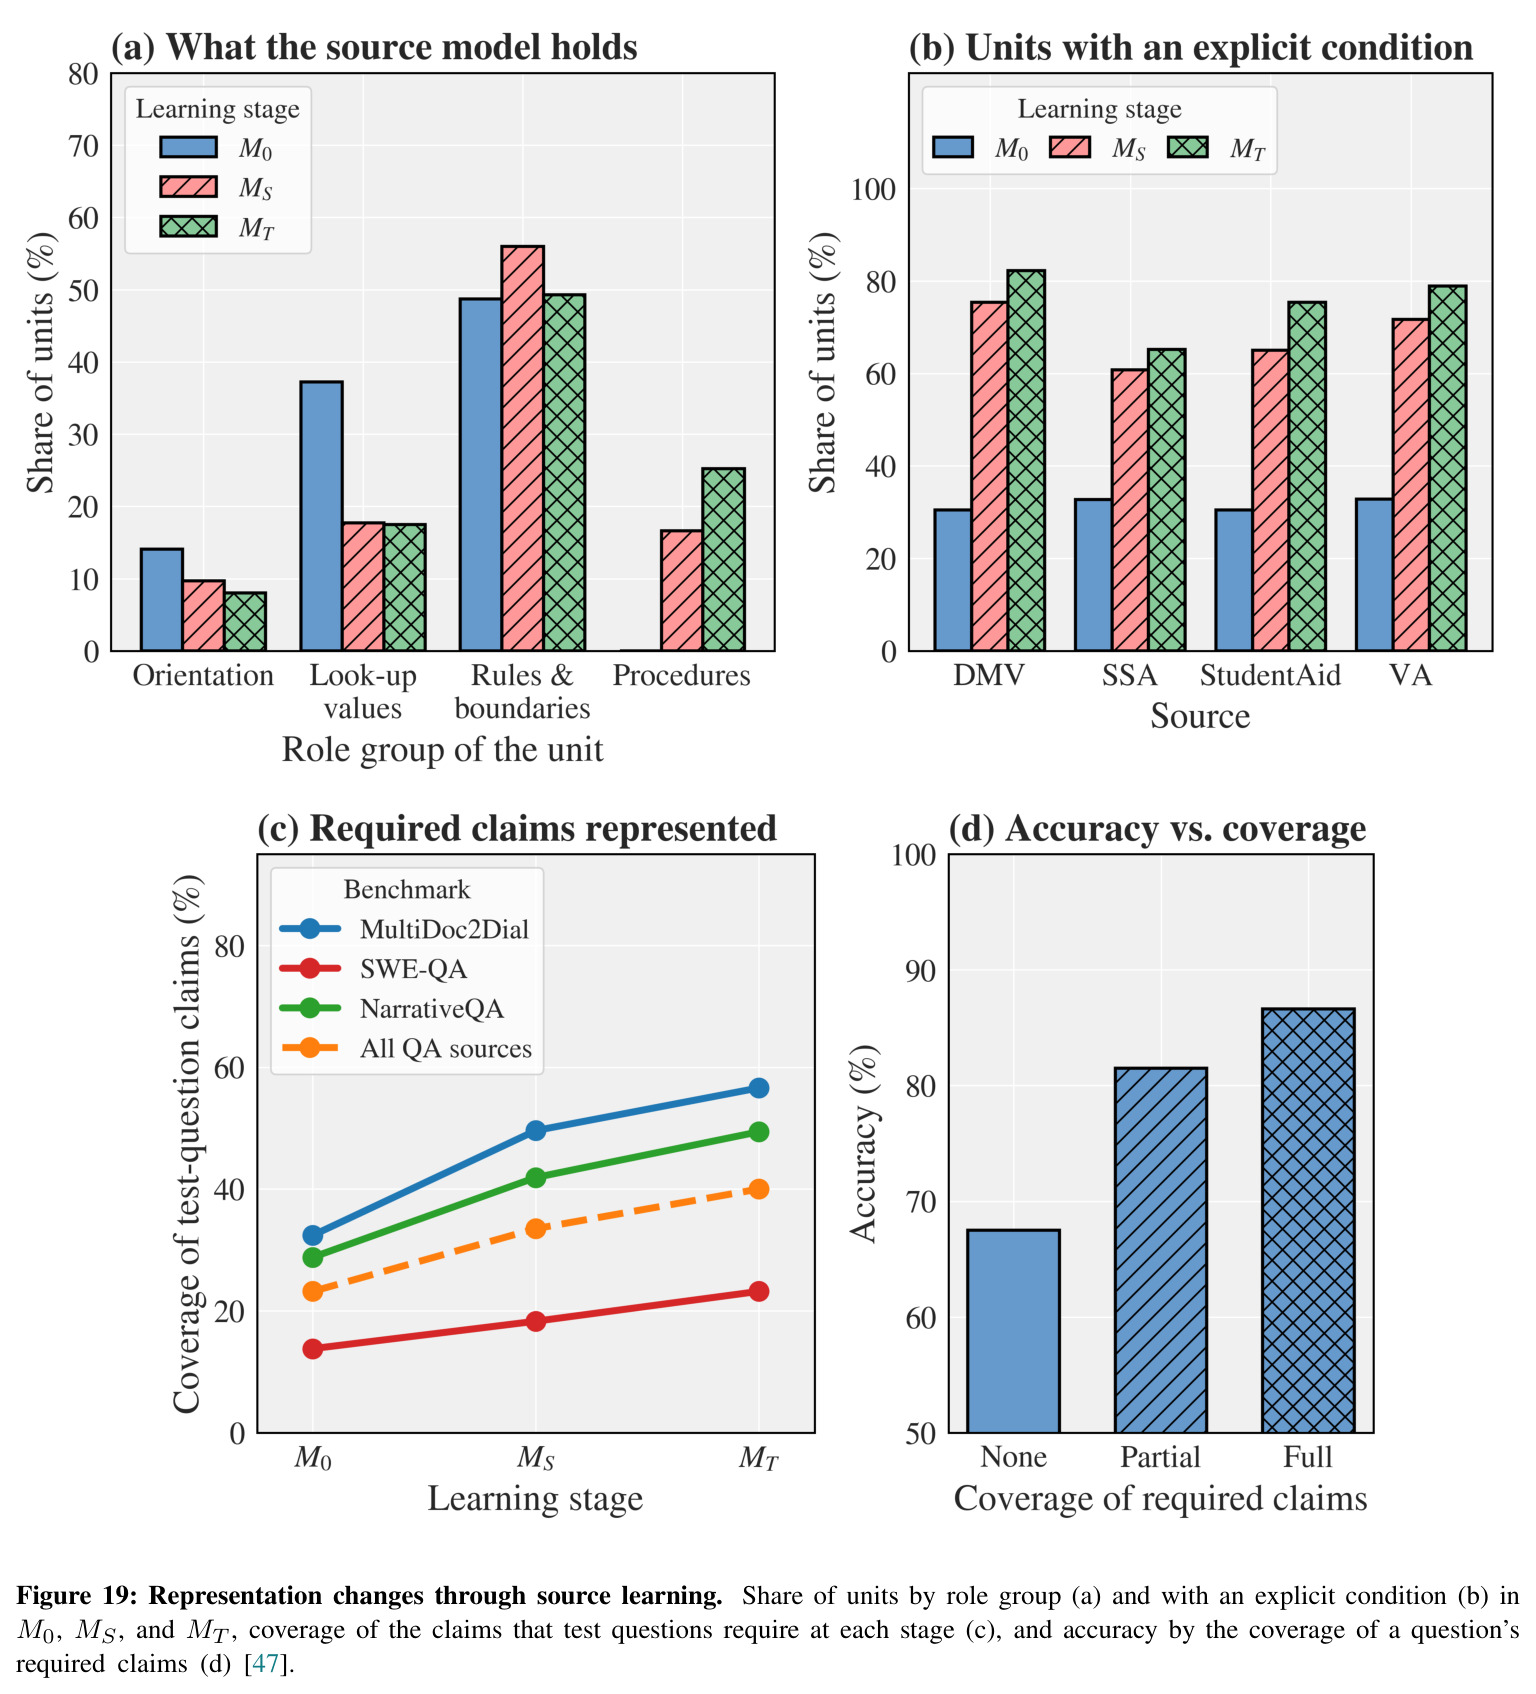
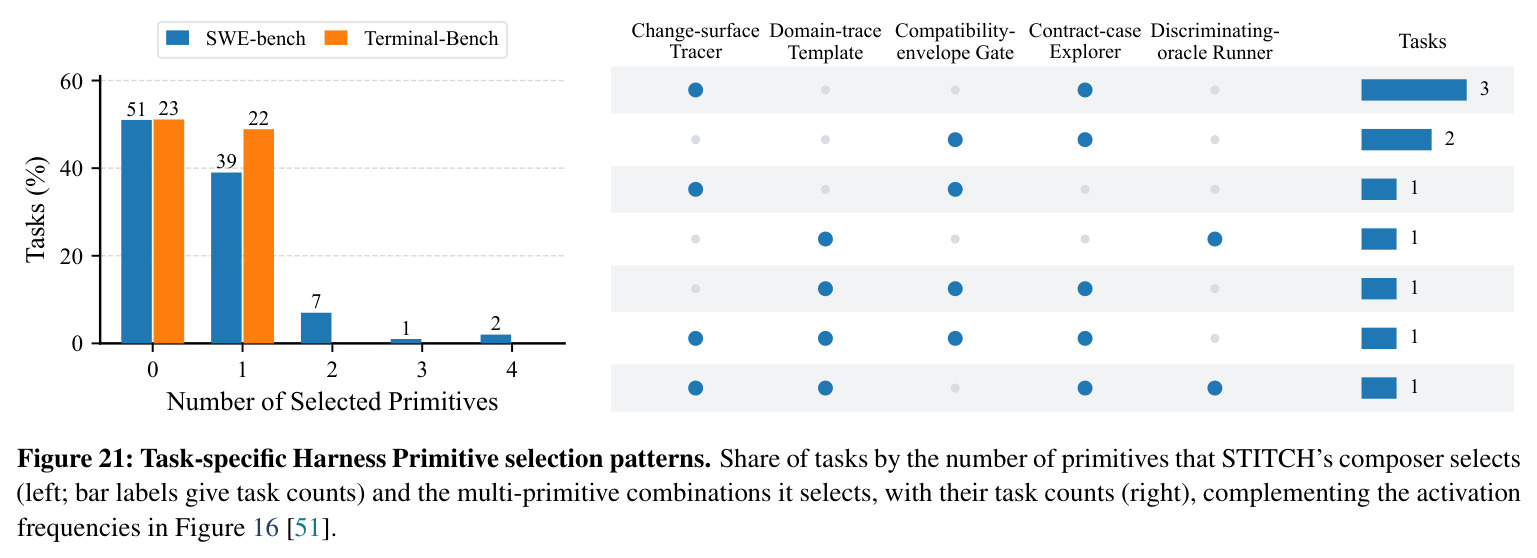
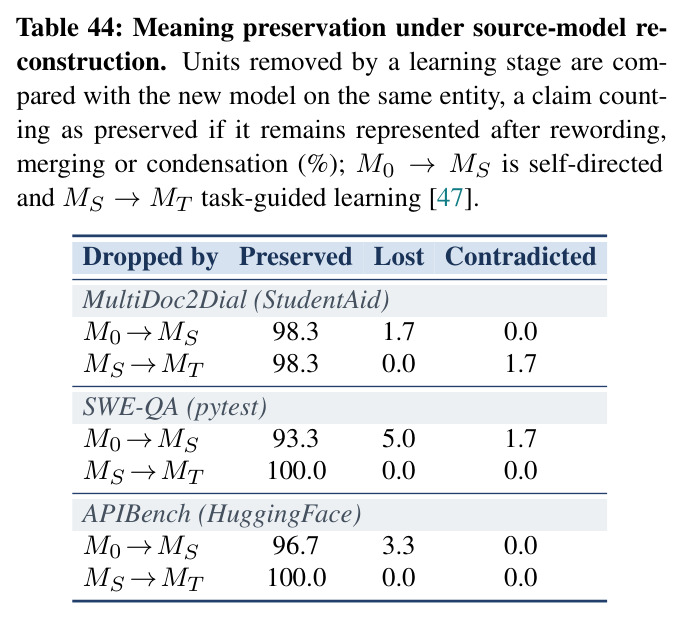
核心创新是把「应用能力」从调用者转移到资源自身:常驻 LLM 阅读并条件化于原语拥有的资源,把 schema 绑定(Tool)、组件适配与依赖通知(Code)、方法适用性论证(Math)、源理解与有据修订(Knowledge)、计算模式复用与 KV cache 潜空间通信(Agent)、沿仓库依赖的变更路由(Dev)、按未解决需求导航(Navigation)、控制操作的选择与确定性编译(Harness)都变成资源自己的操作。与已有方法的本质区别有三:单位不同——可复用的不再是被动工件,而是带接口、会互发消息 $m_{i\to j}$ 的主动单元,调用者不必把一切细节塞进单一上下文;验证不同——随行验证与入库前独立的 VALIDATE 让能力跨任务存续,而非随轨迹消亡;组合不同——激活集 $\mathcal{A}_t$ 由任务决定,成本随 $|\mathcal{A}_t|$ 而非库大小 $N$ 增长,且命题 3.2 给出按任务组合胜过最优固定 harness 的充要条件:组合器的选择损失要小于固定 harness 的不可避缺口 $\Gamma_{\mathrm{fixed}}=\sum_i \min(\mu_i\bar{g}_i,(1-\mu_i)\bar{\kappa}_i)$。
方法步骤详情
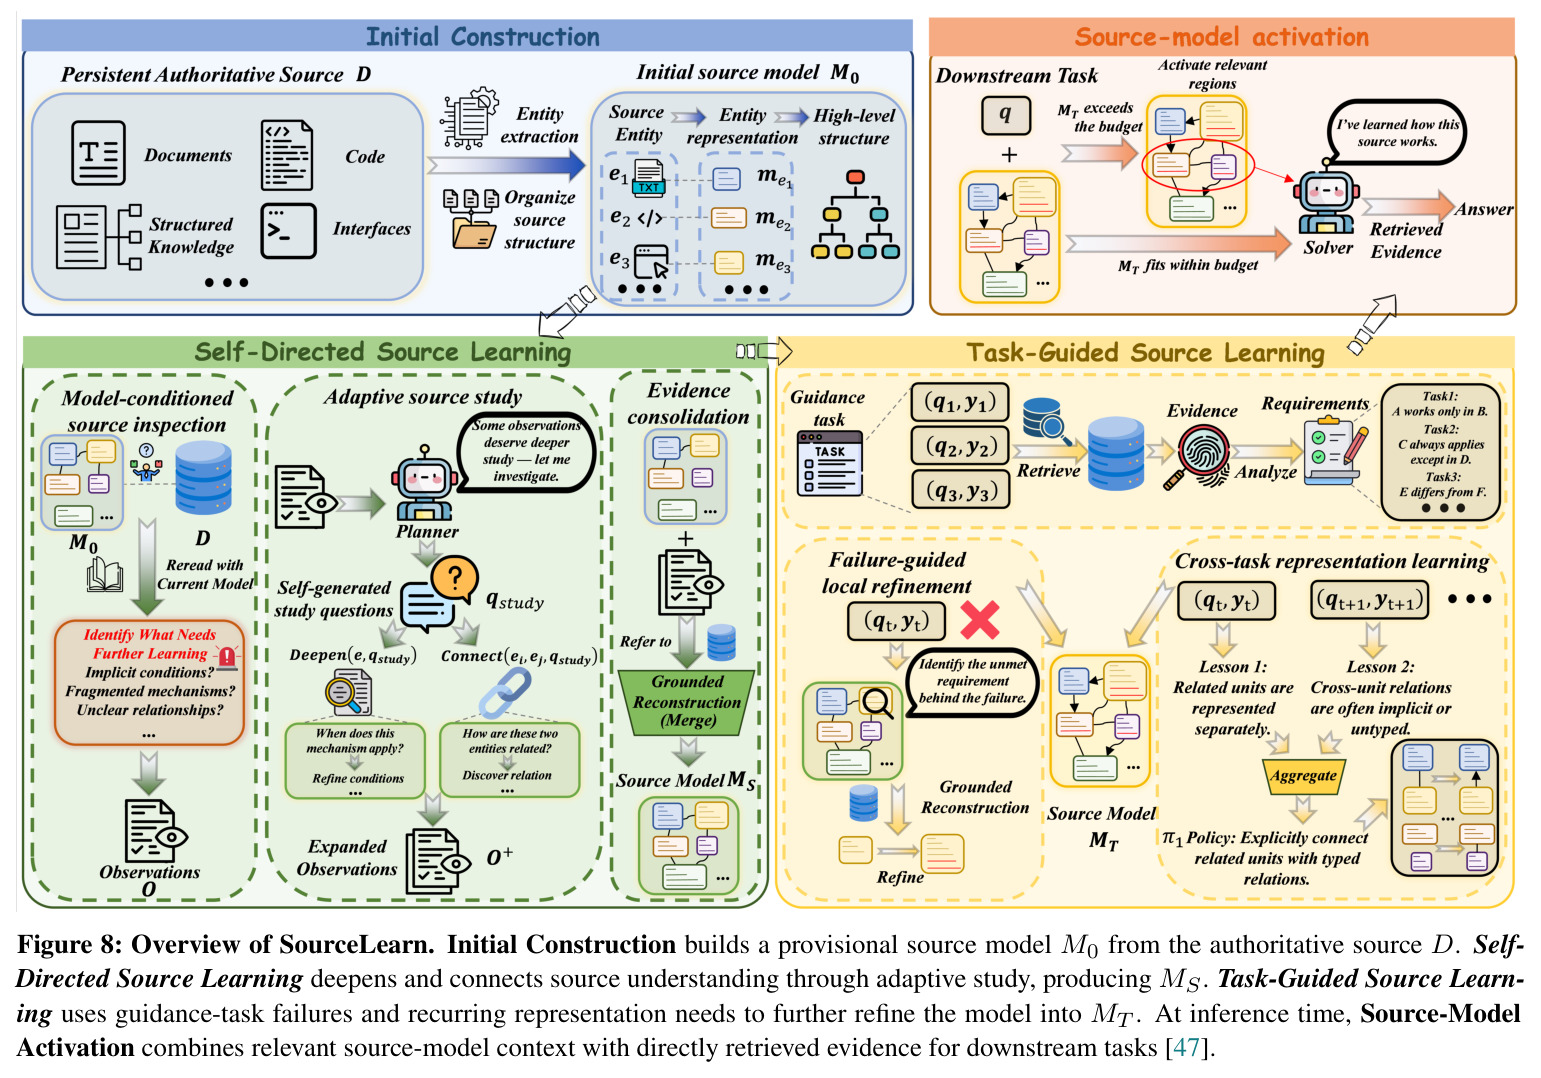
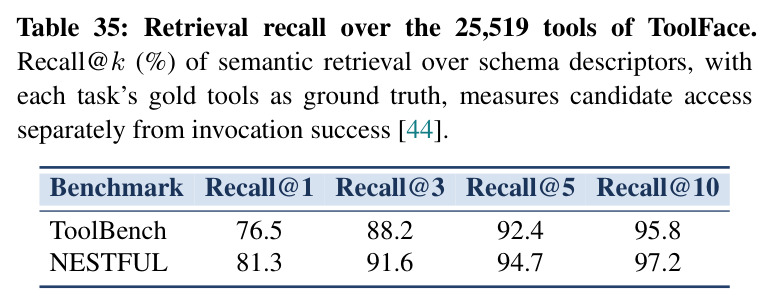
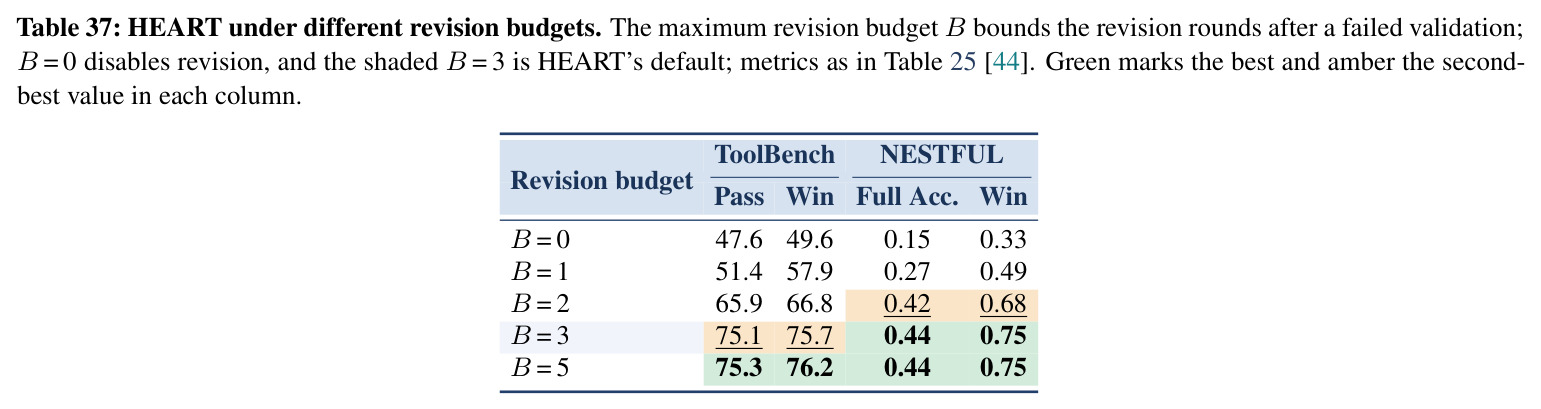
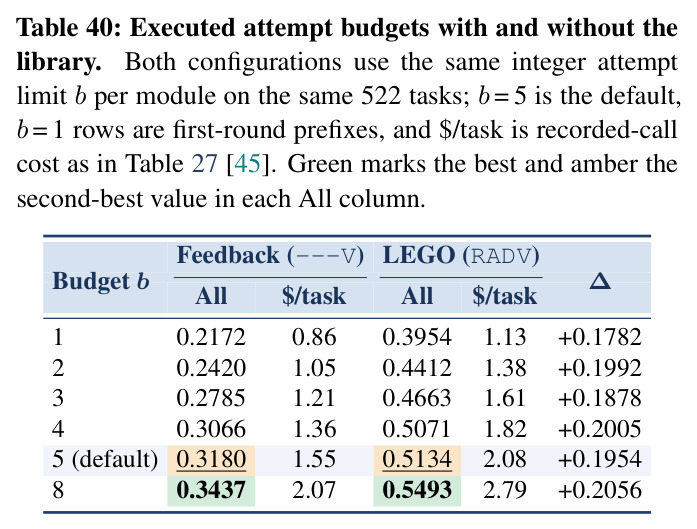
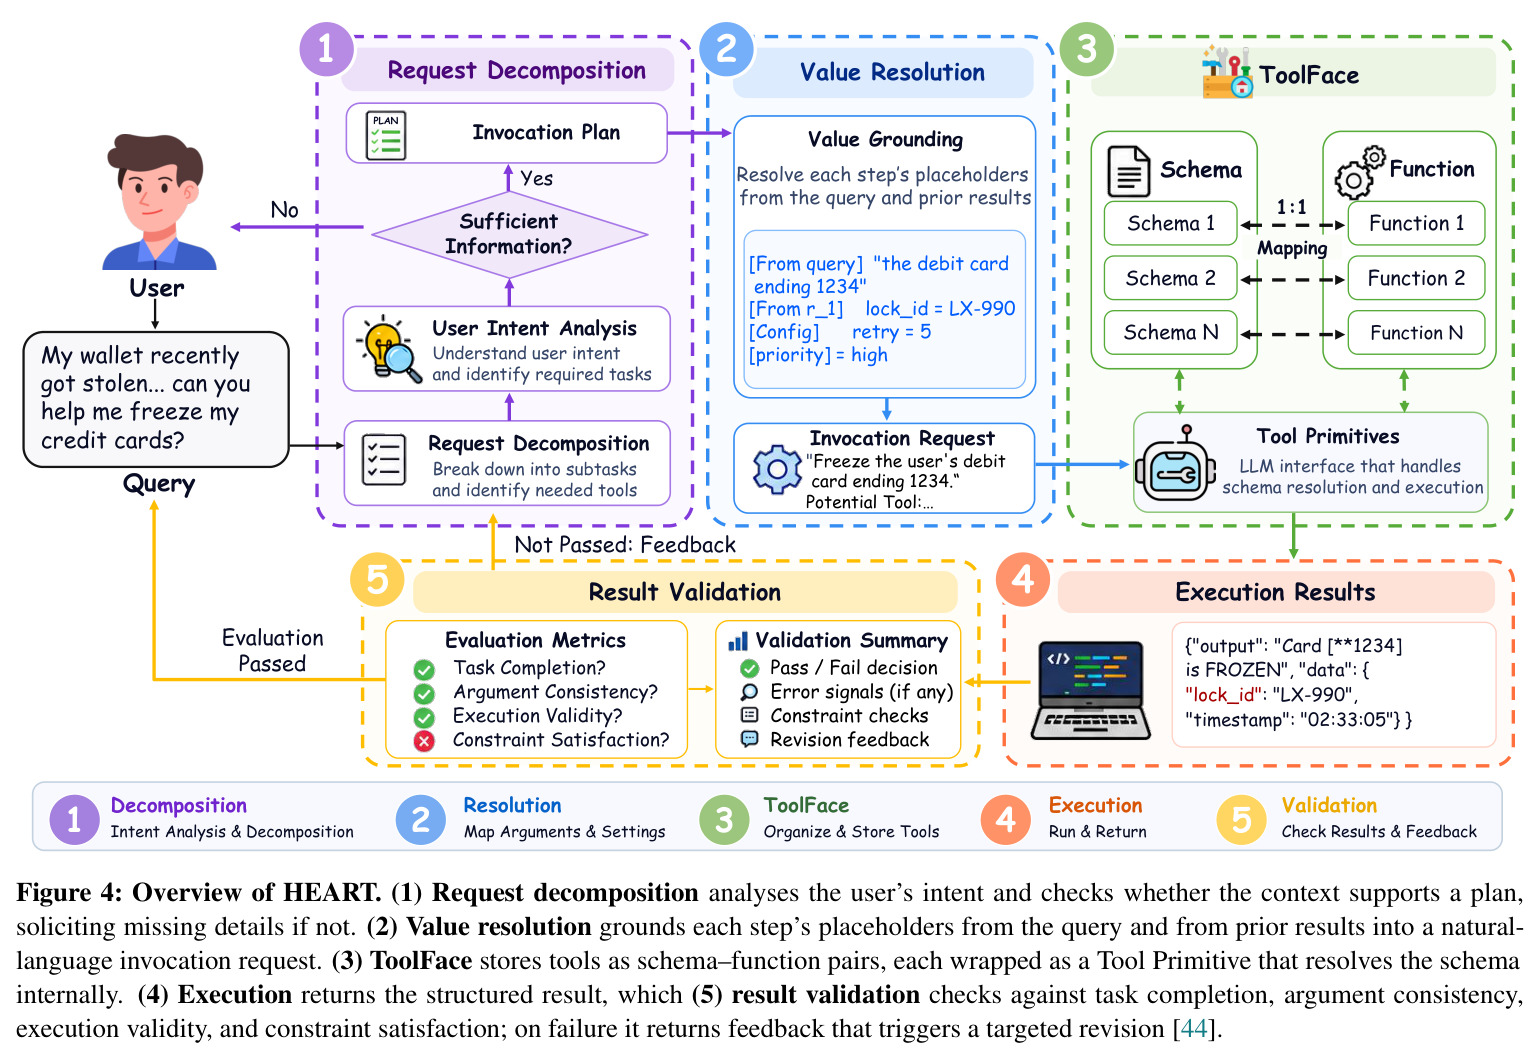
流程:任务 $q$ 携带上下文 $c_q$(输入、环境、约束、验收标准)进入。COMPOSE 以接口检索或一次读全库接口找候选,采纳原语自评 $(s_i,u_i)$,输出计划 $\Pi_t=(\{(i,x_i)\}_{i\in\mathcal{A}_t},\mathcal{E}_t)$:$\mathcal{A}_t$ 是激活集、$\mathcal{E}_t$ 是结果与消息流动的依赖边,无原语覆盖的需求留给 harness 本身。执行轮 $t$:每个被激活原语 $P_i(x_i;c_i^t)$ 完成自己的步骤,消息在轮内送达接收者;任务状态 $S_t$ 集成各步结果,EXECUTE 运行可执行部分并记录证据 $o_t$(构建状态、测试结果、编译器消息),VERIFY 输出 $v_t\in\{\mathrm{PASS},\mathrm{FAIL}\}$ 与反馈 $\varphi_t=(e_t,\mathcal{I}_t,u_t)$。失败时 $\mathcal{C}_{t+1}=\mathcal{C}_t\cup\{\varphi_t\}$,COMPOSE 只改动 $\mathcal{I}_t$ 牵连的原语并保留未矛盾的工作,至多 $B$ 轮。任务之外,候选原语只在独立通道入库:$\mathcal{L}_{k+1}=\mathcal{L}_k\oplus\{\tilde{P}:\mathrm{VALIDATE}(\tilde{P})=\mathrm{PASS}\}$。八族在此骨架上特化:HEART 预算 $B=3$、检索 ToolFace 的 25,519 个工具;LEGO 每模块至多 5 轮修订,按检索-适配-诊断-执行四阶段;82 个方法契约经承诺门、分级排序与 runoff 选出;SourceLearn 以 24k token 激活源模型;ANTMAN 每个未解决需求至多路由 $\rho$ 次到至多一个领地 worker。
技术新颖性
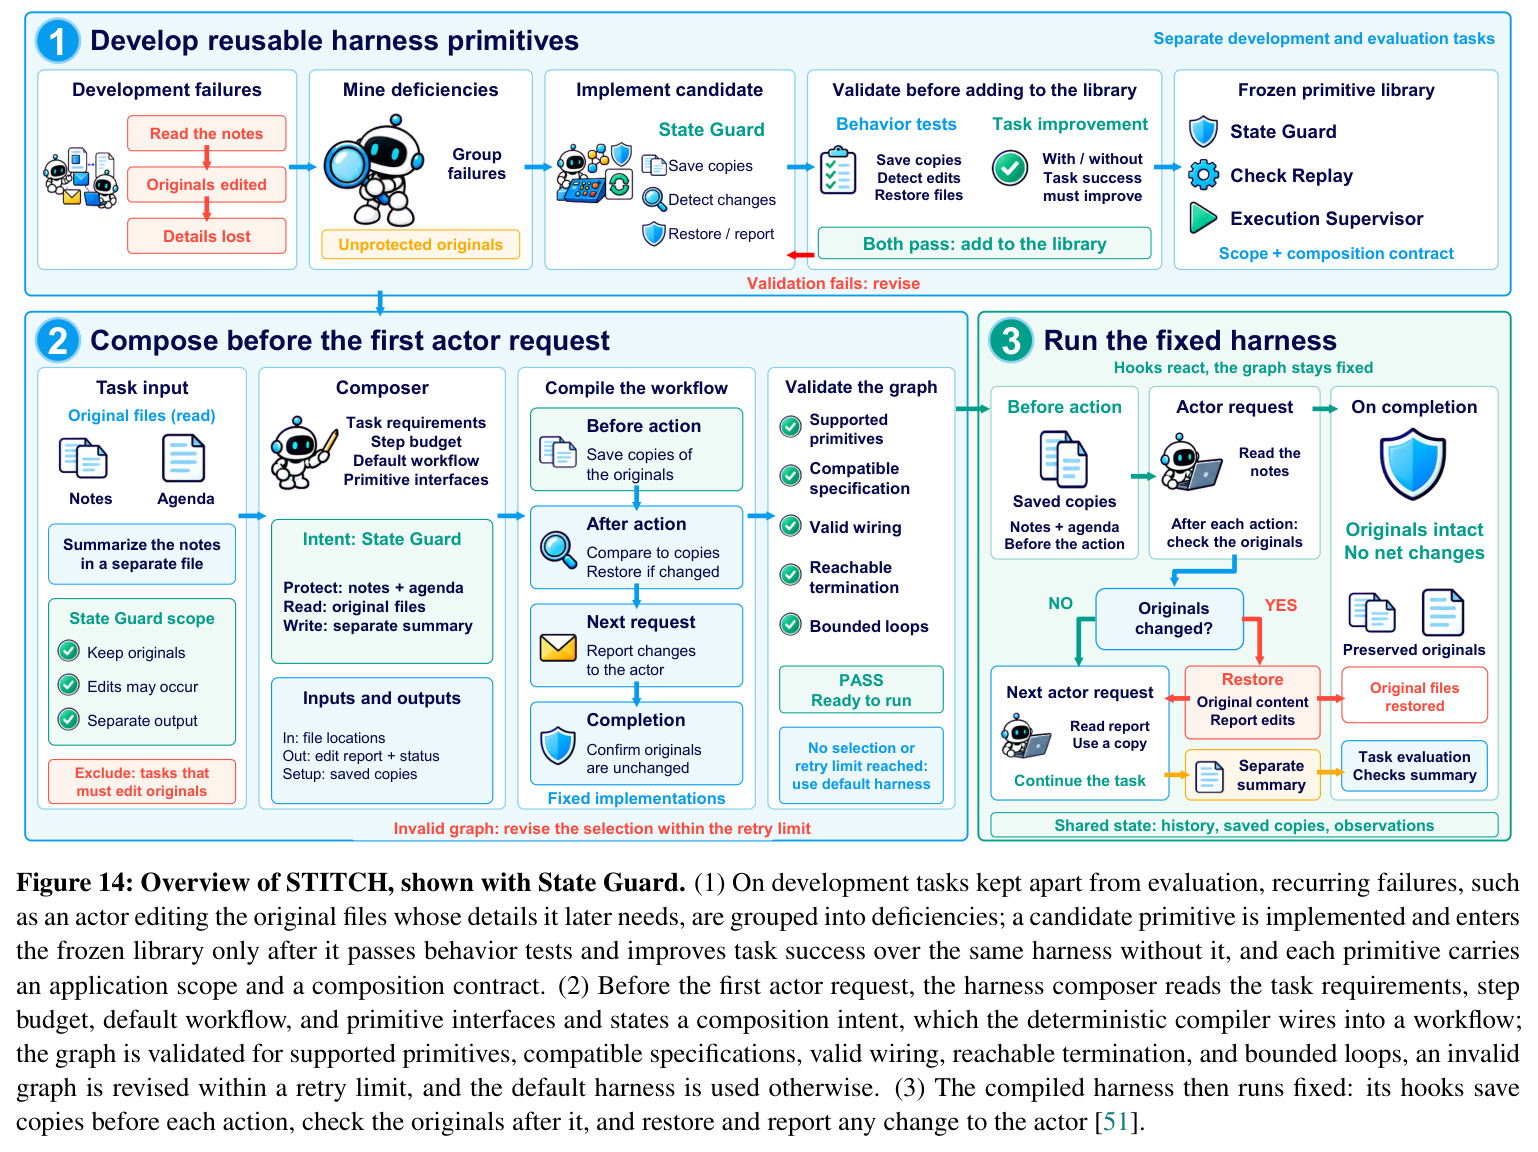
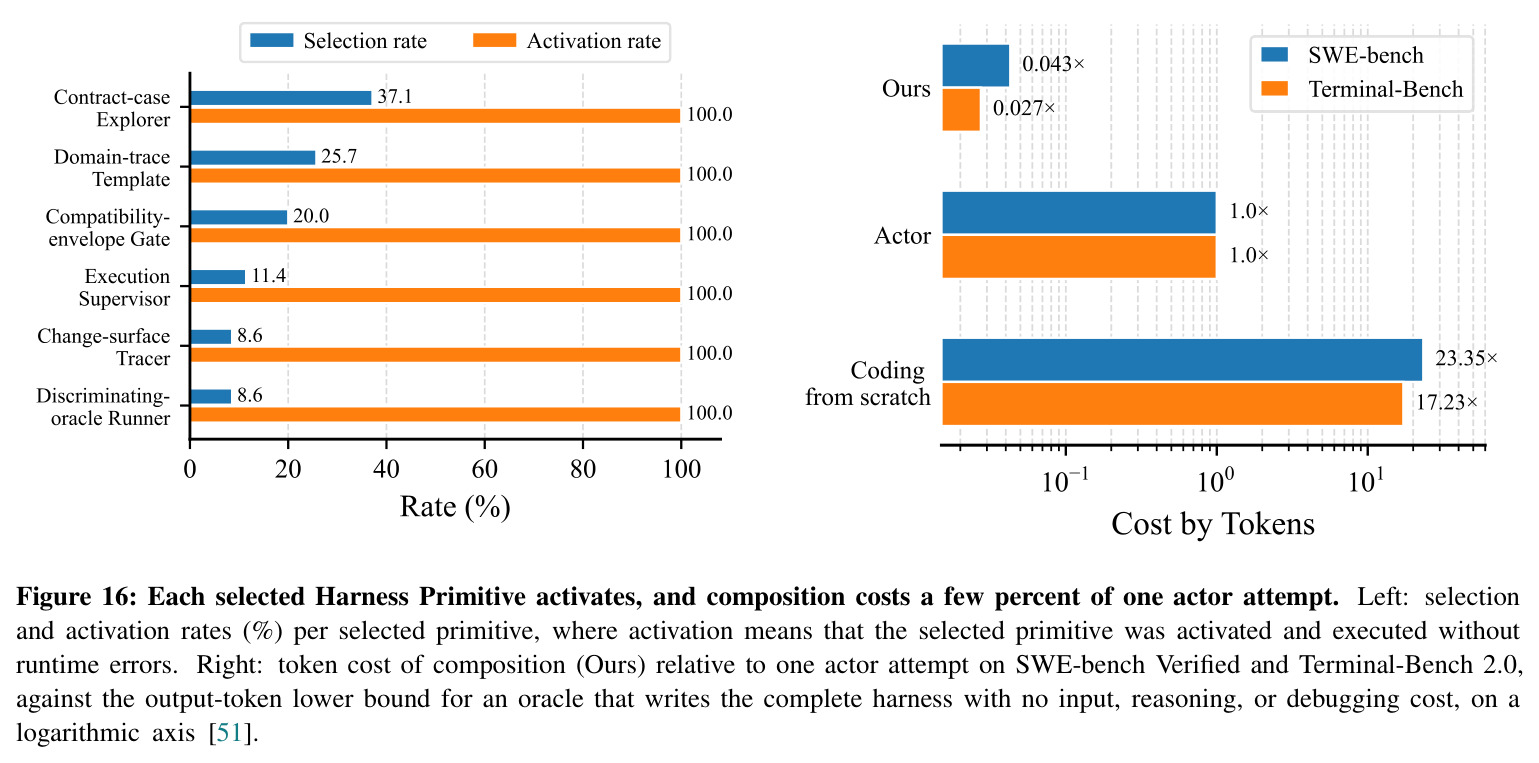
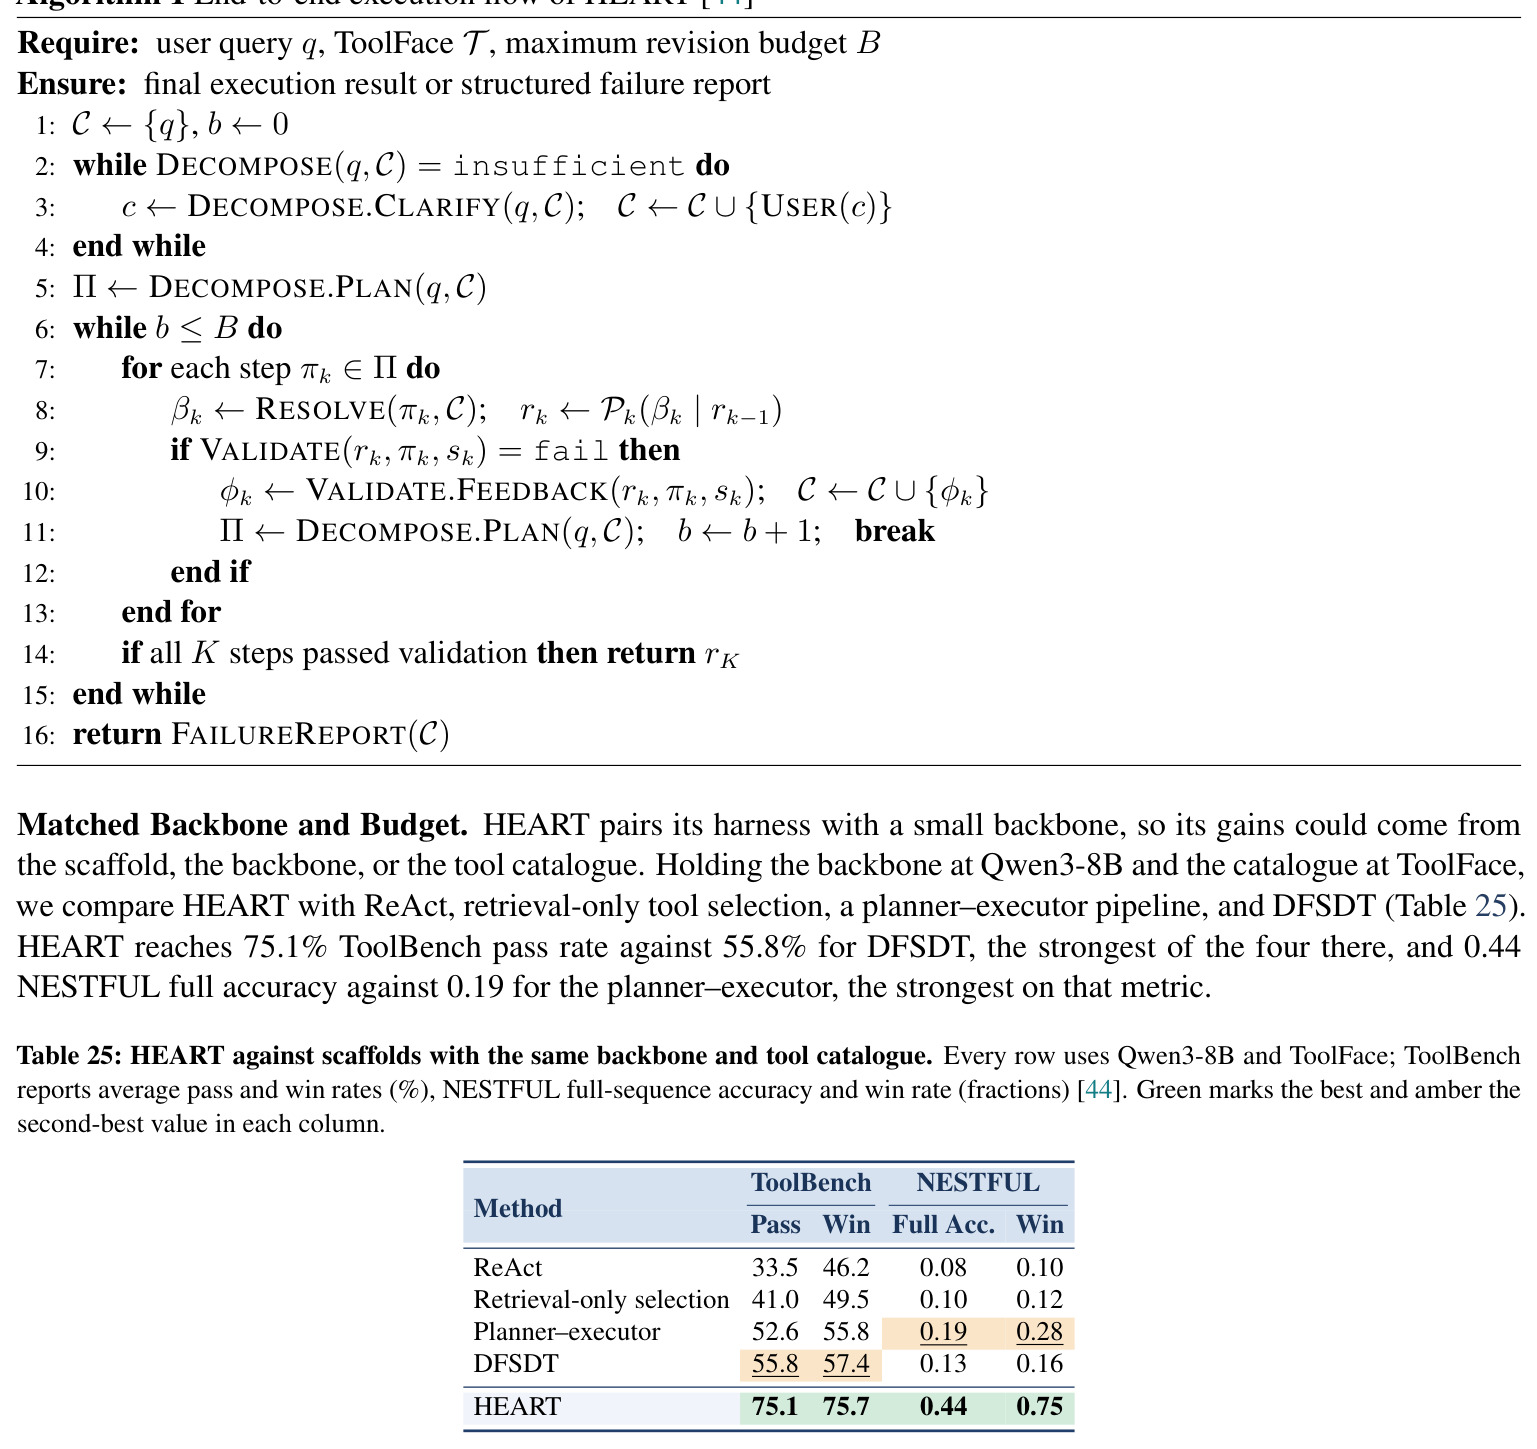
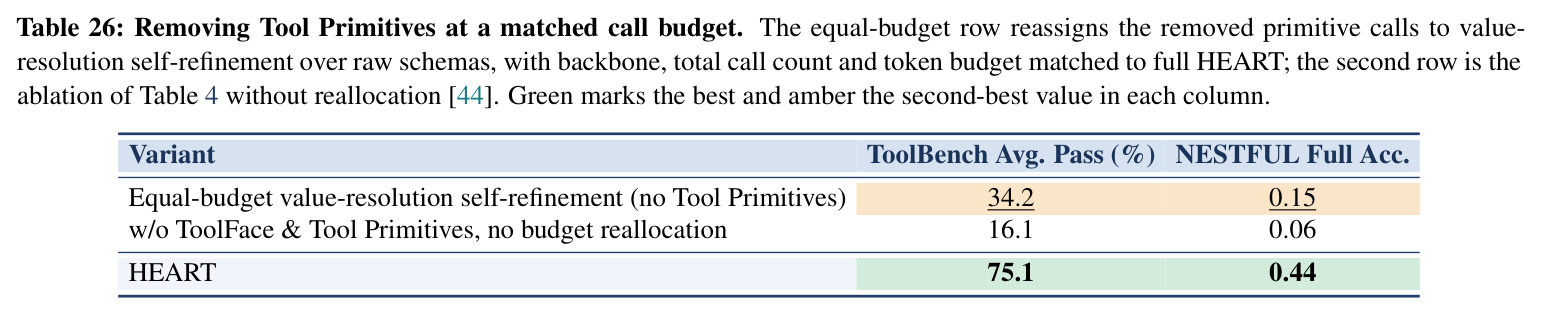
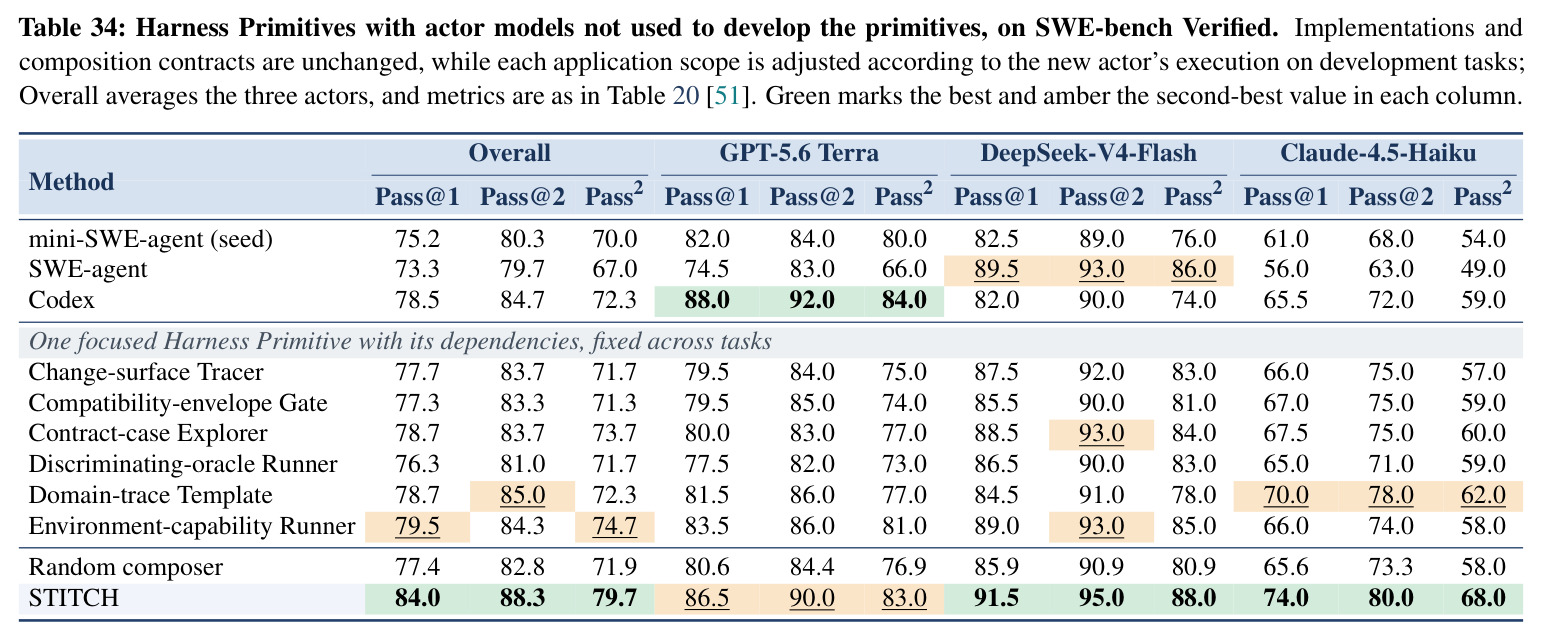
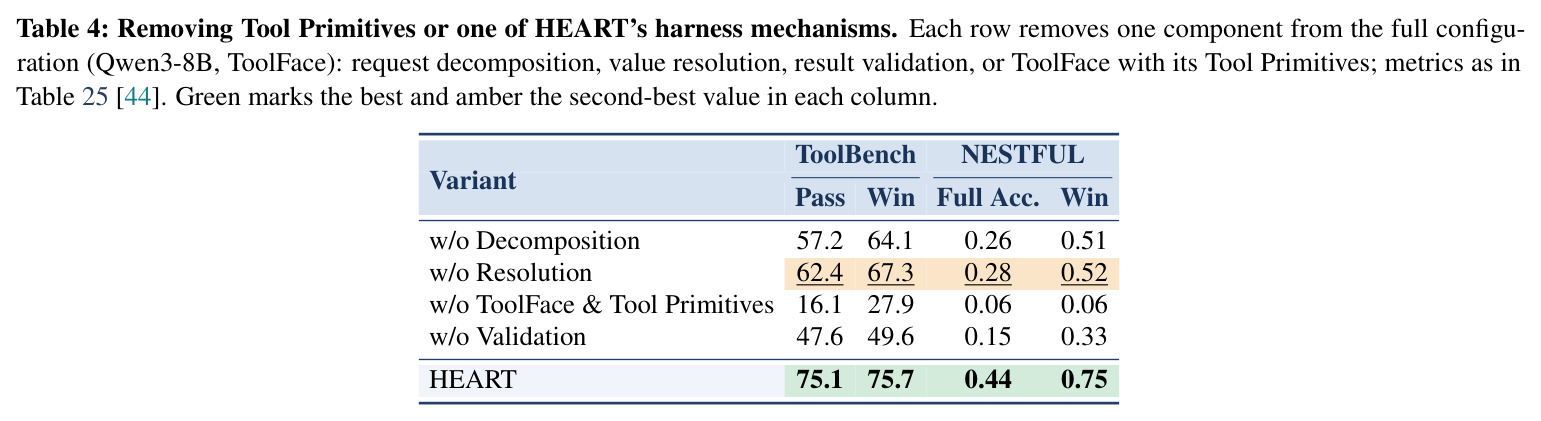
可从四组对照看清新颖性。对比工具学习(ToolLLM、xLAM、DFSDT):不是教模型写 schema 合规参数再自我精炼,而是让每个工具自带的常驻 LLM 产参——预算匹配对照里,把同样调用数用于原始 schema 上的自精炼只有 34.2%,Tool Primitives 达 75.1%。对比代码复用与仓库 agent(RAG、OpenHands、SWE-agent):适配与依赖通知成为组件自身操作,需求沿仓库依赖路由,而非单 agent 在一条轨迹里反复重建全仓状态。对比检索与记忆(RAPTOR、HippoRAG 2、AWM):持久化的是「可修订且修订须有源支持」的源模型,而非索引结构或任务经验。对比 MAS 与 harness 生成(MAS-GPT、MetaHarness、测试时生成 harness 代码):复用单位是计算模式(内部以 KV cache 通信)或已实现、已验证的控制操作,测试期只做选择与确定性编译,规避生成代码的执行风险——测试期完整写出 harness 的成本约是组合的 543–638 倍。配套理论(需求有界激活、组合优于固定 harness 的充要条件、子模覆盖上限)与 26 组公开基准对照全部领先的结果支撑其系统性。
实验结果
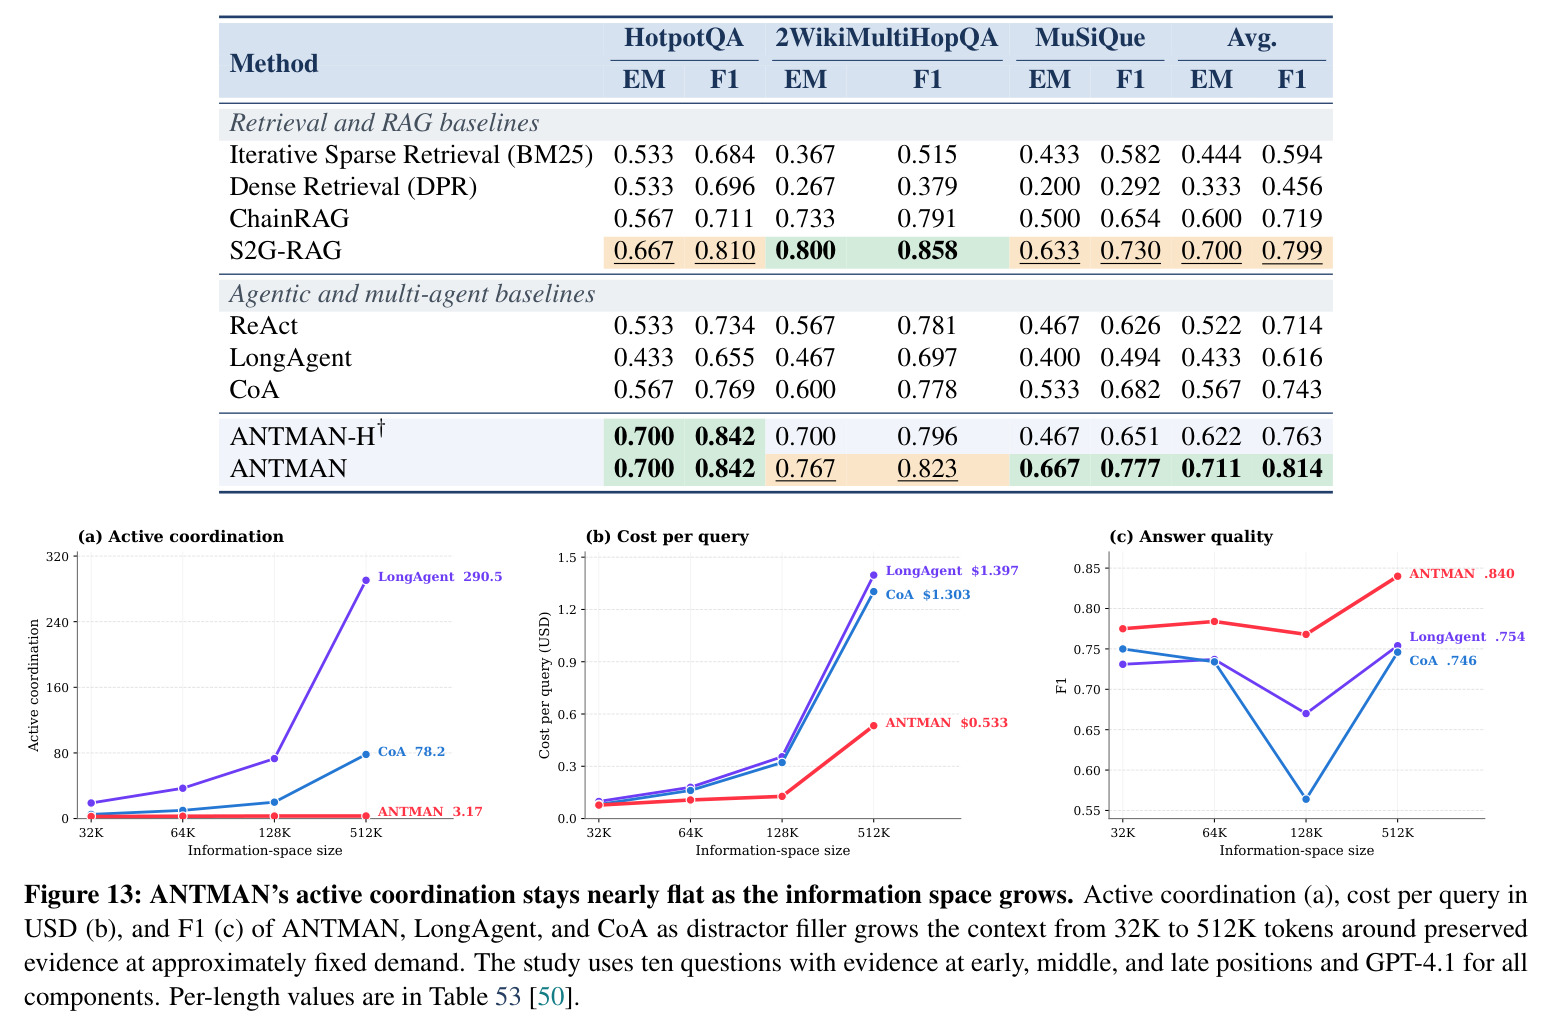
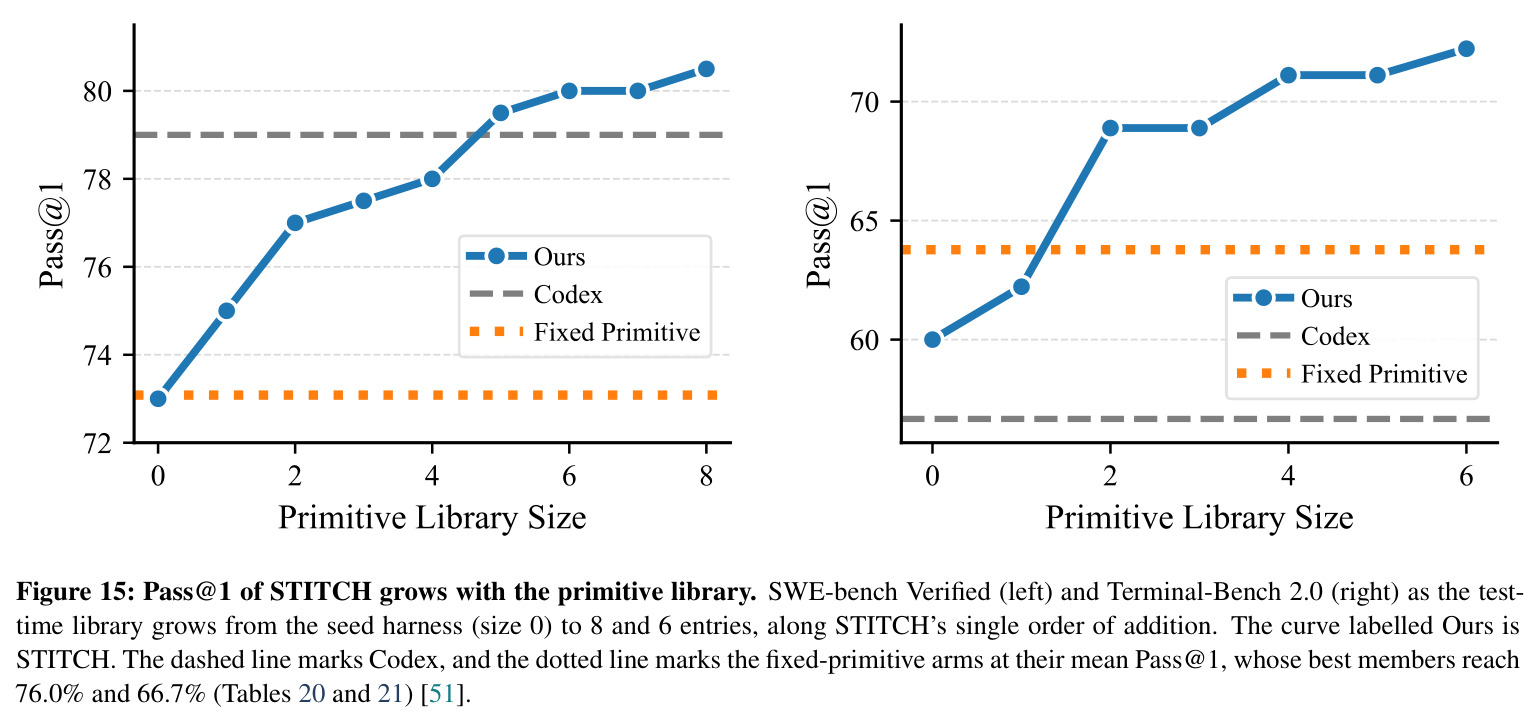
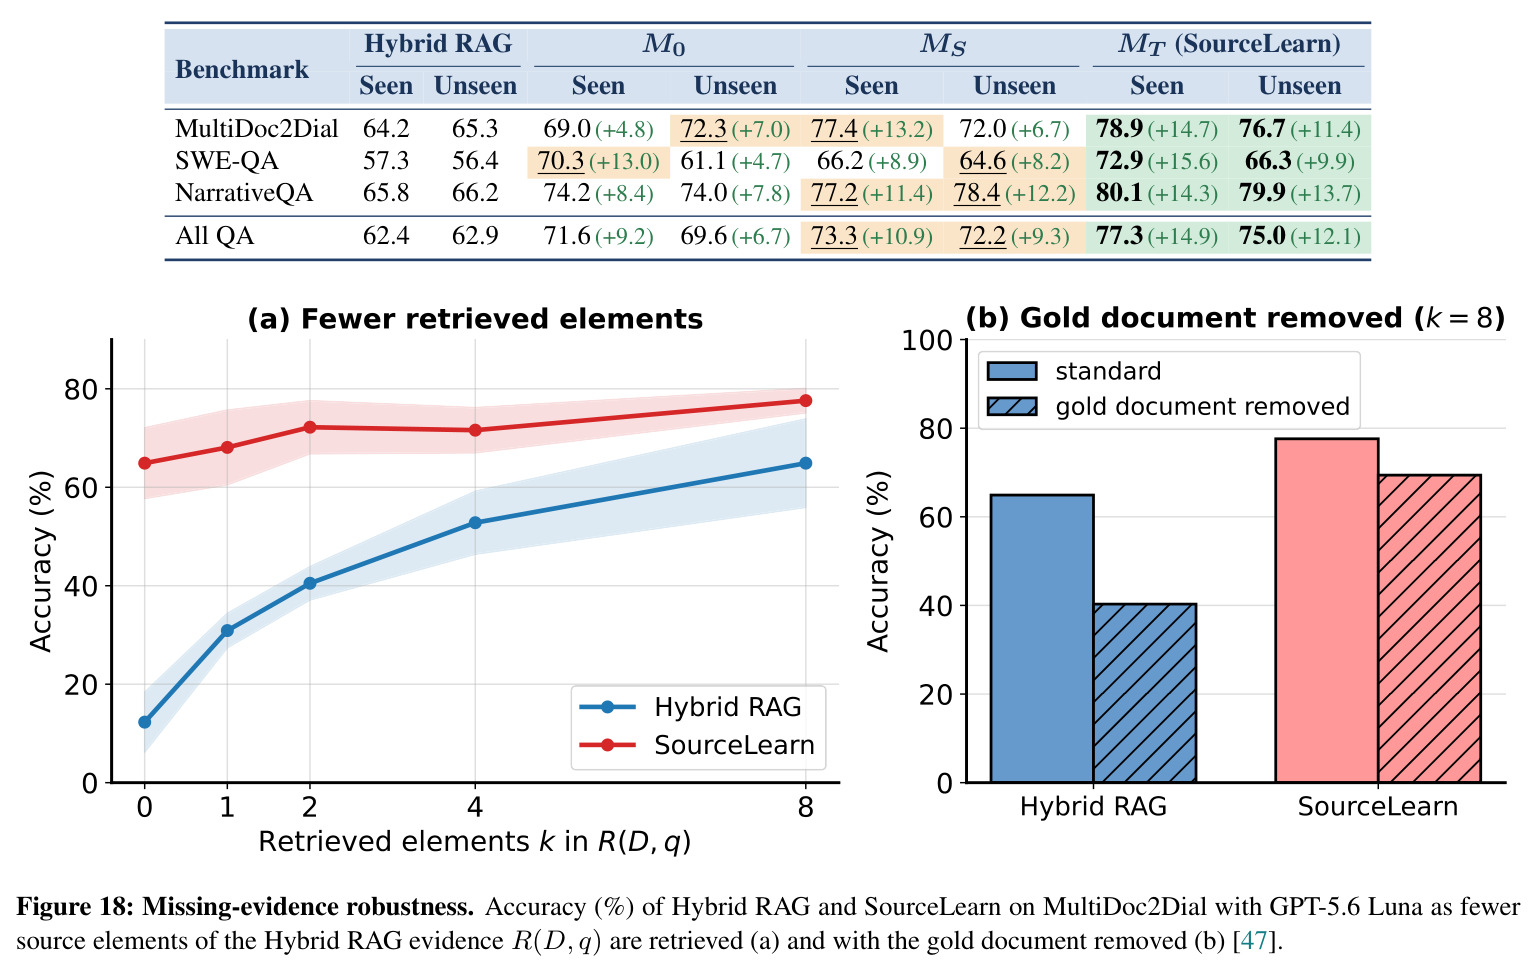
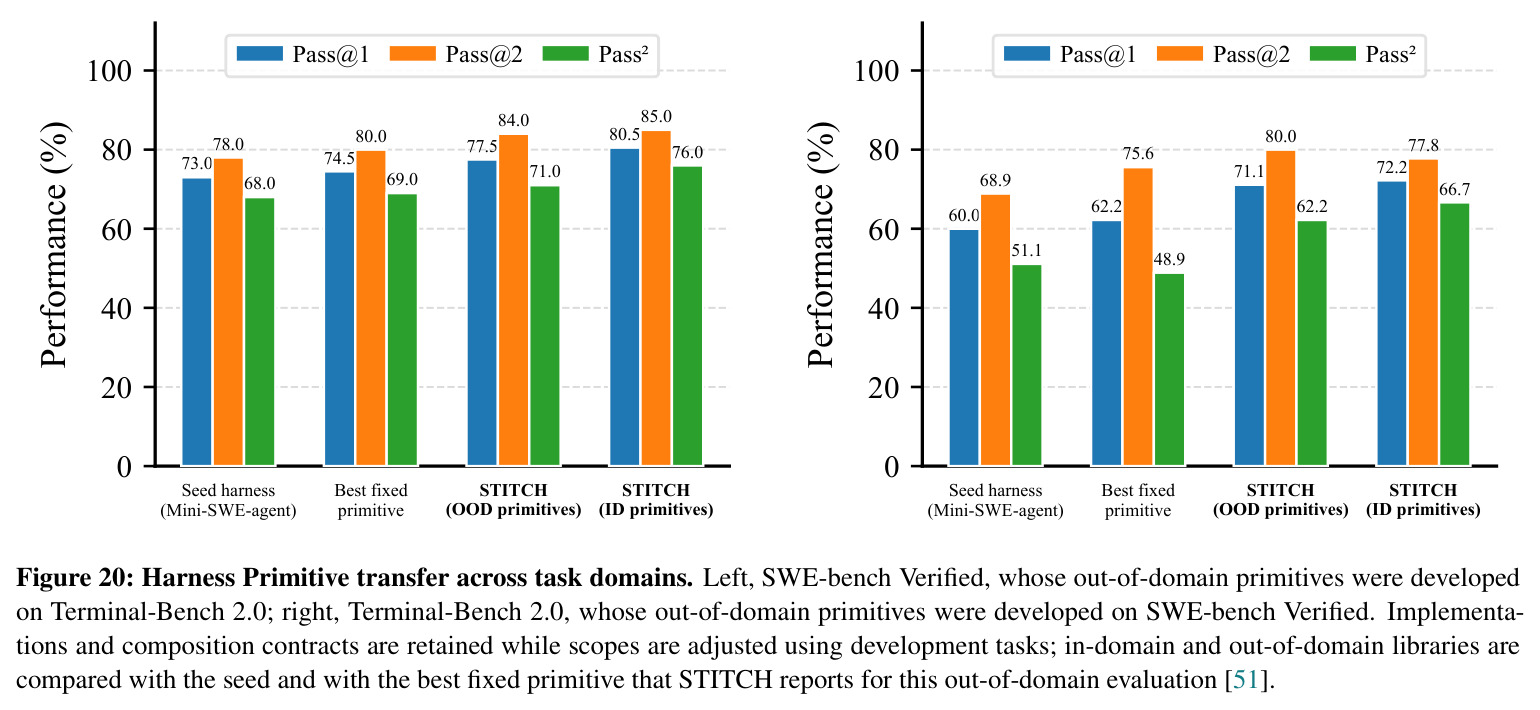
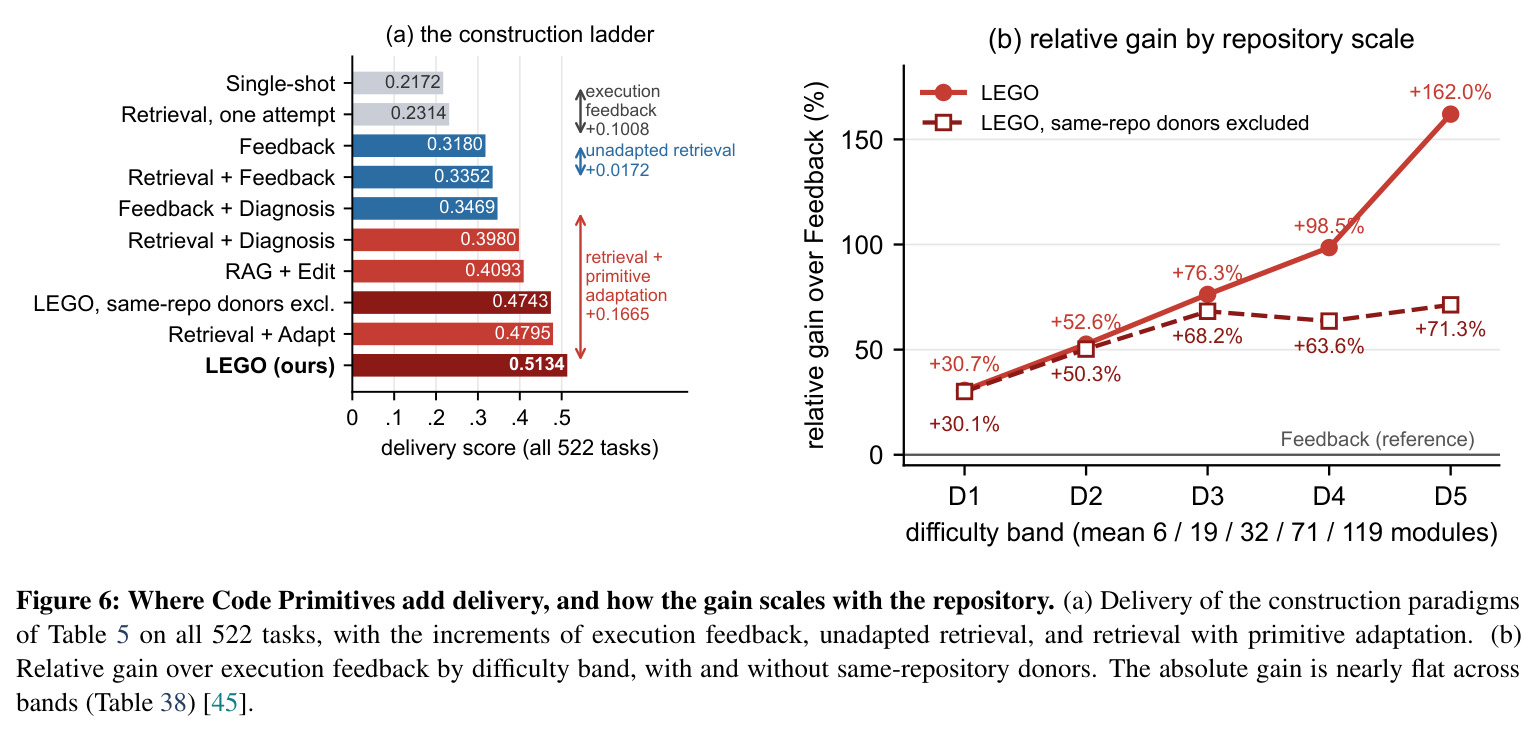
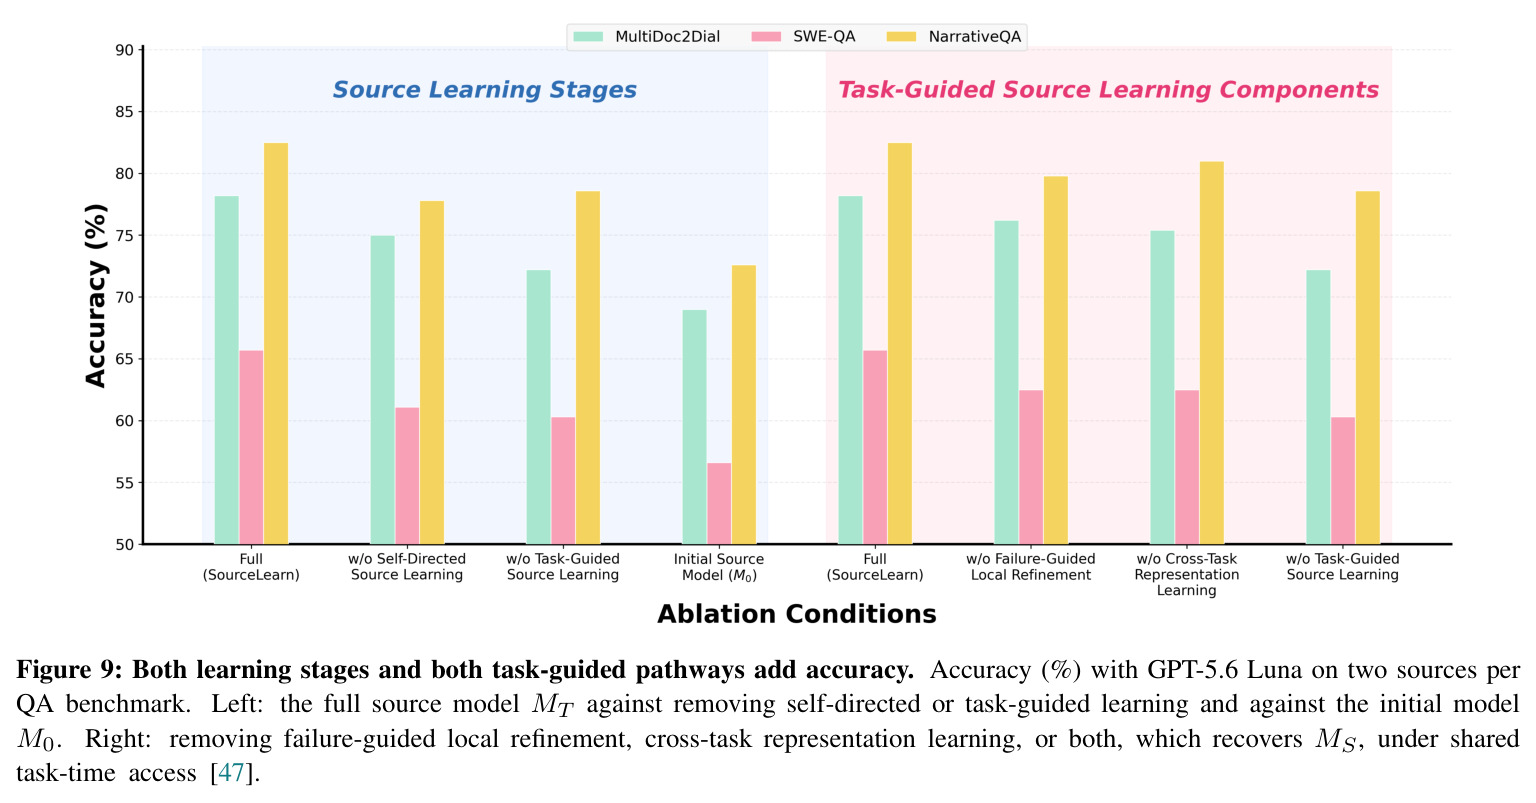
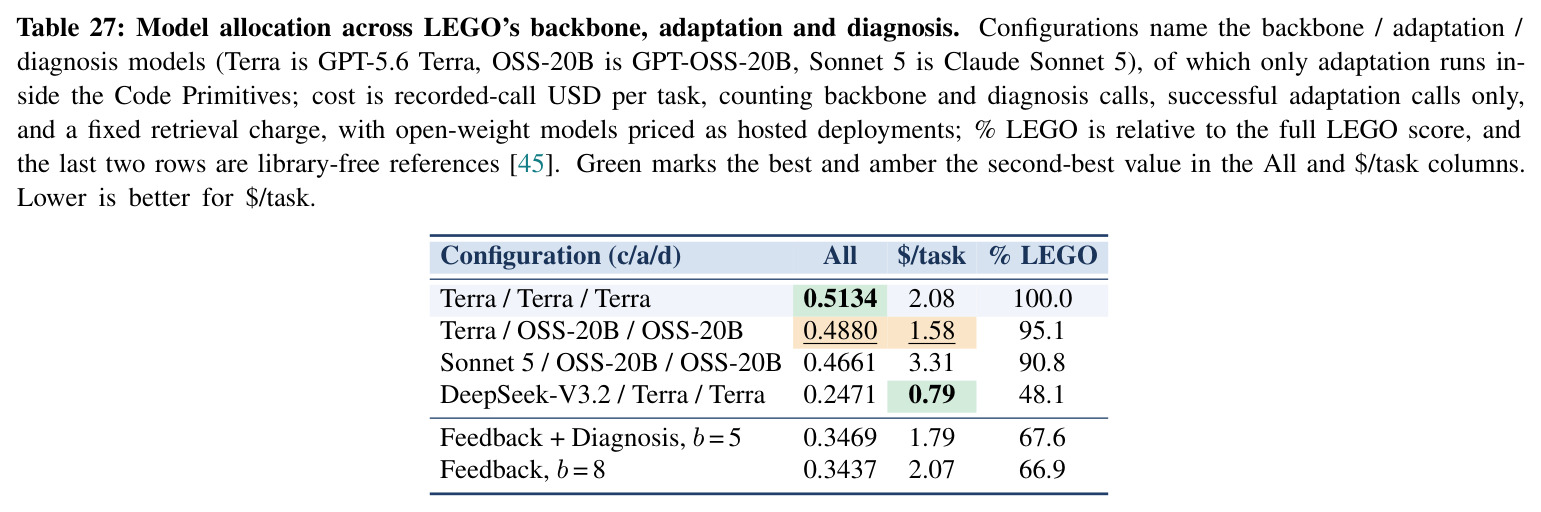
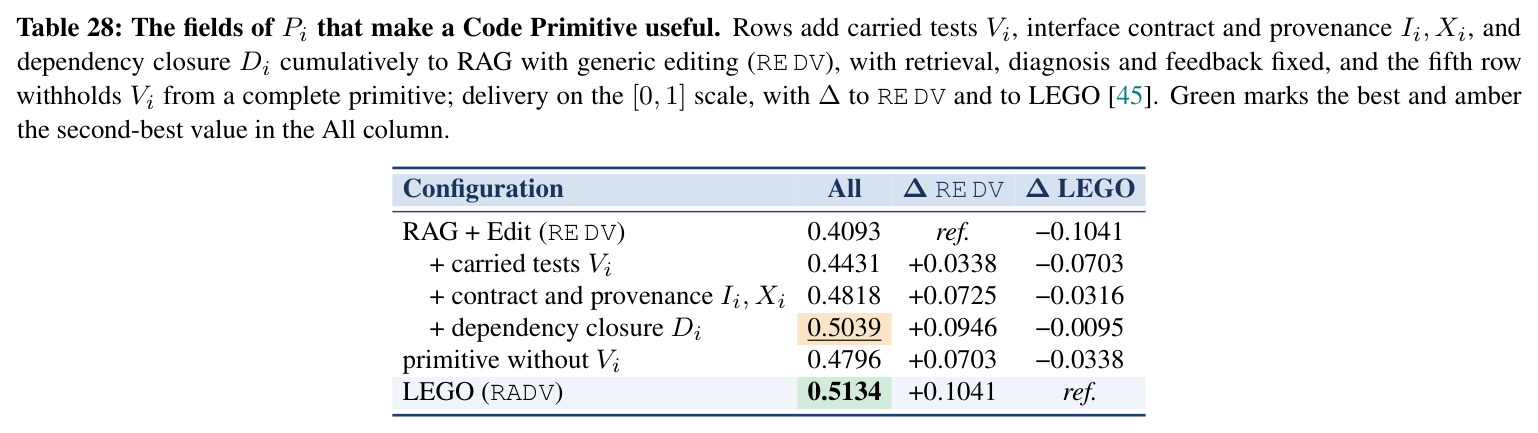
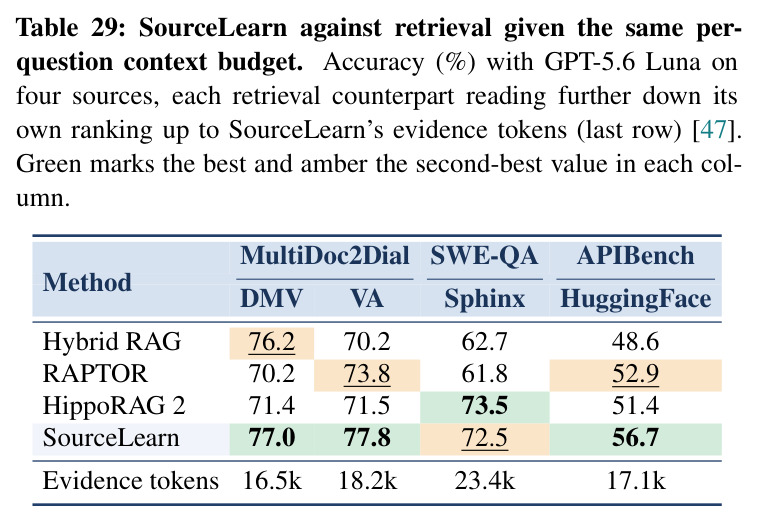
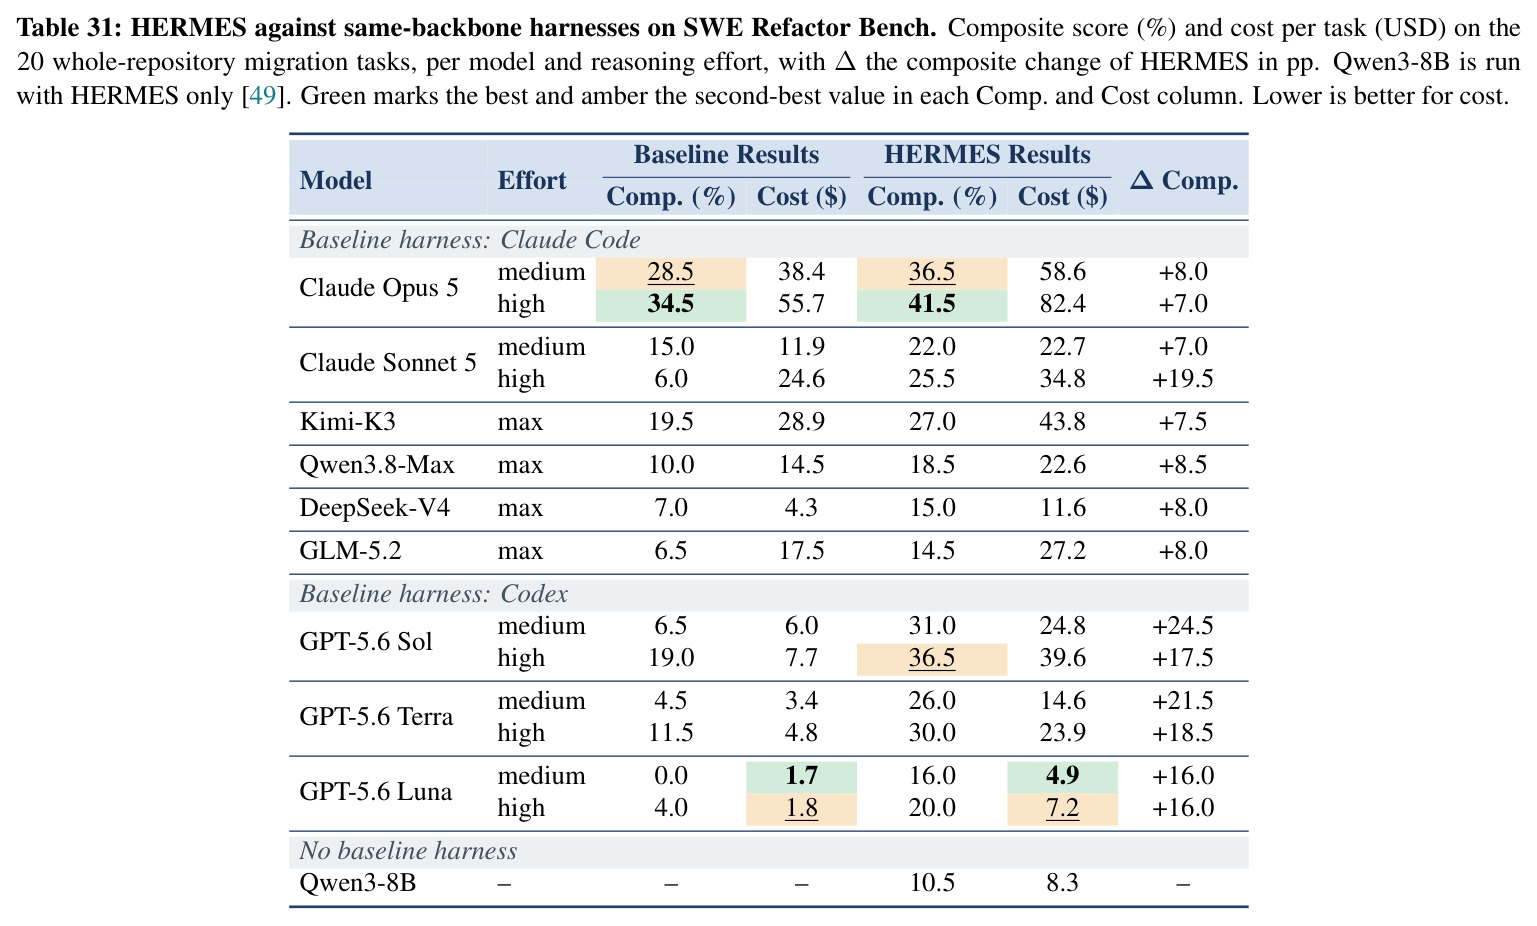
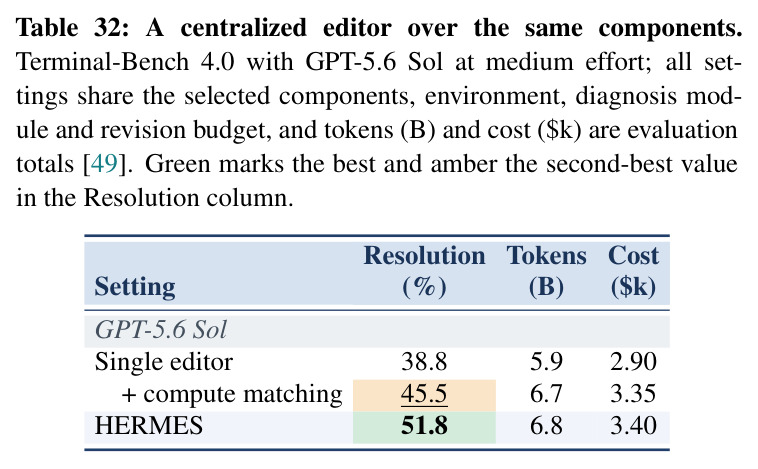
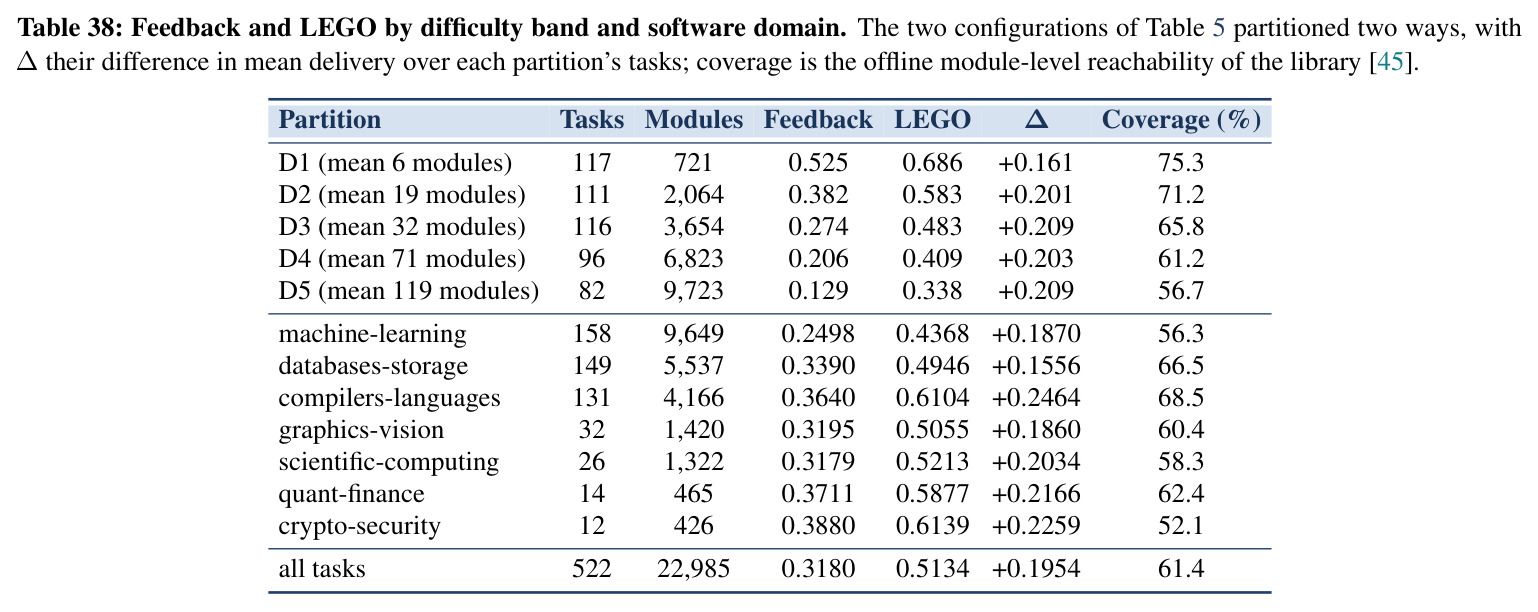
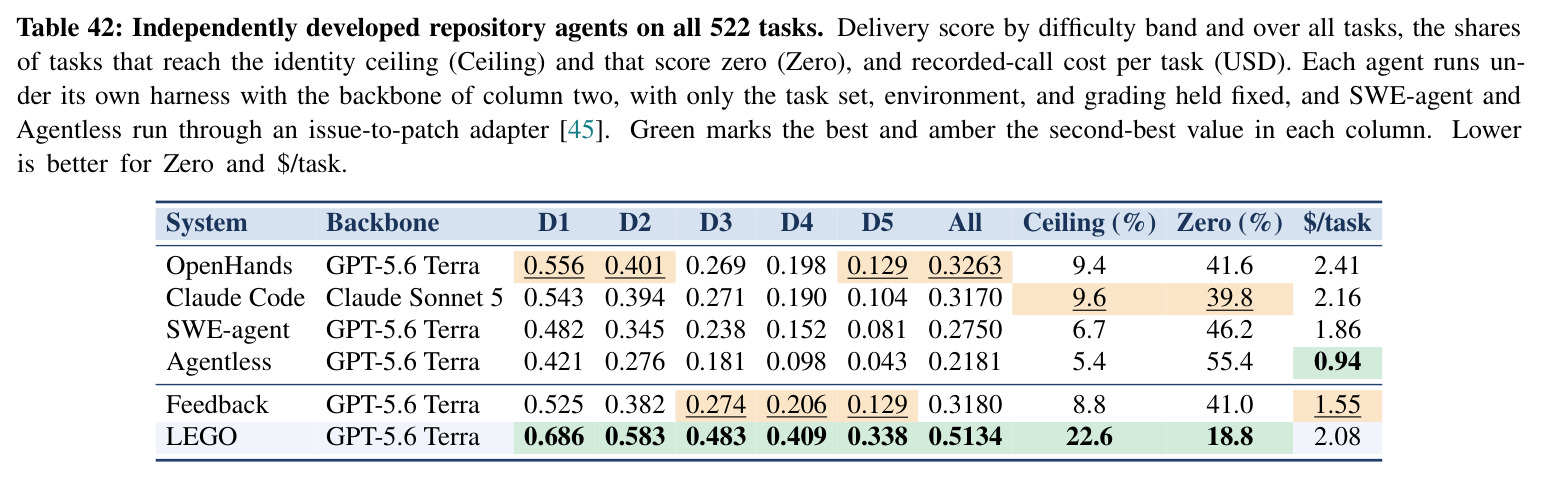
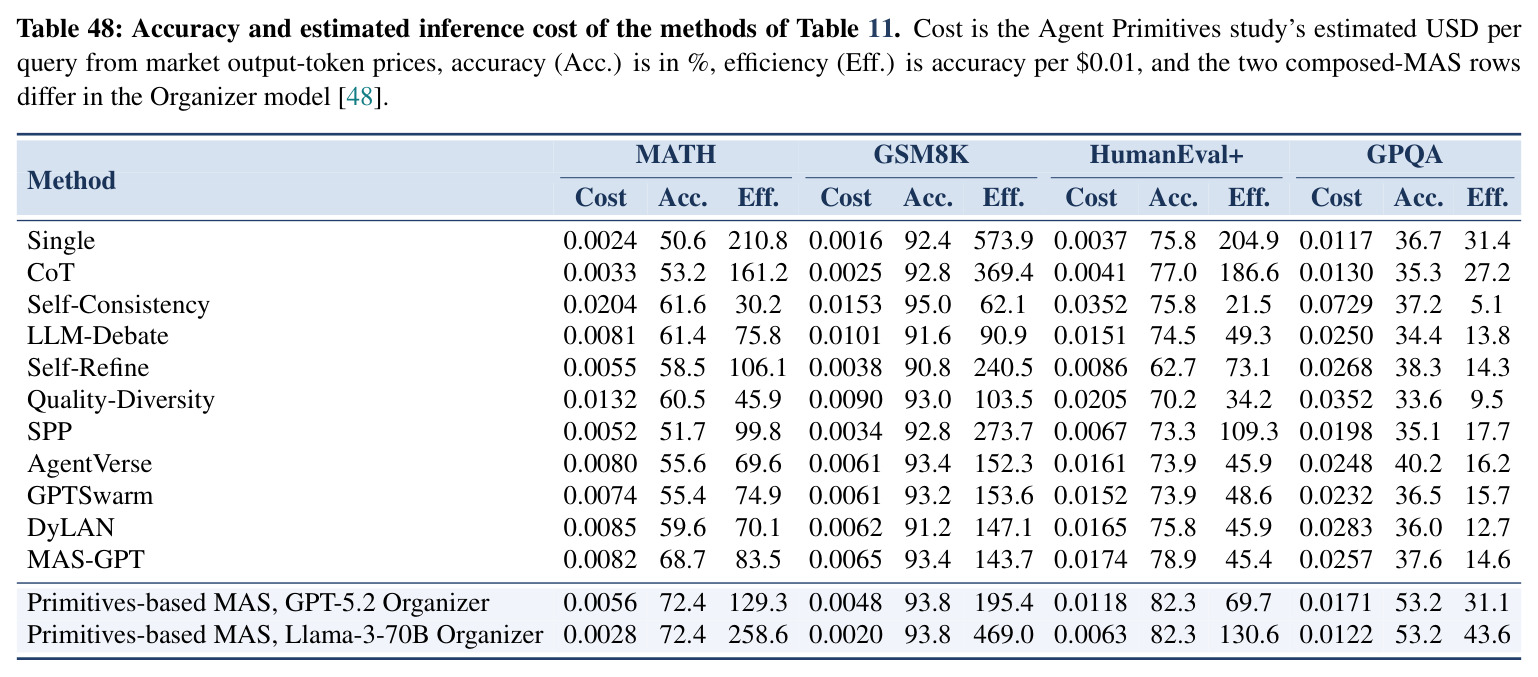
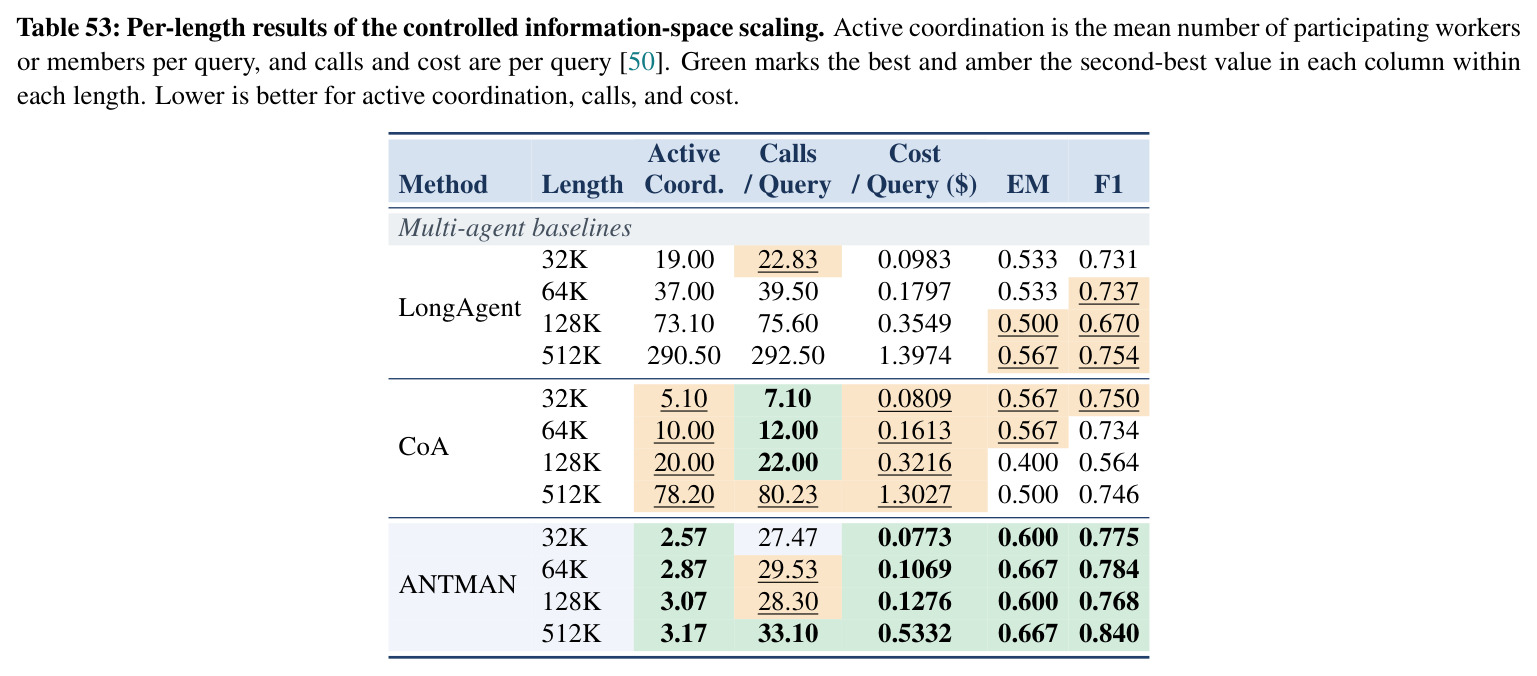
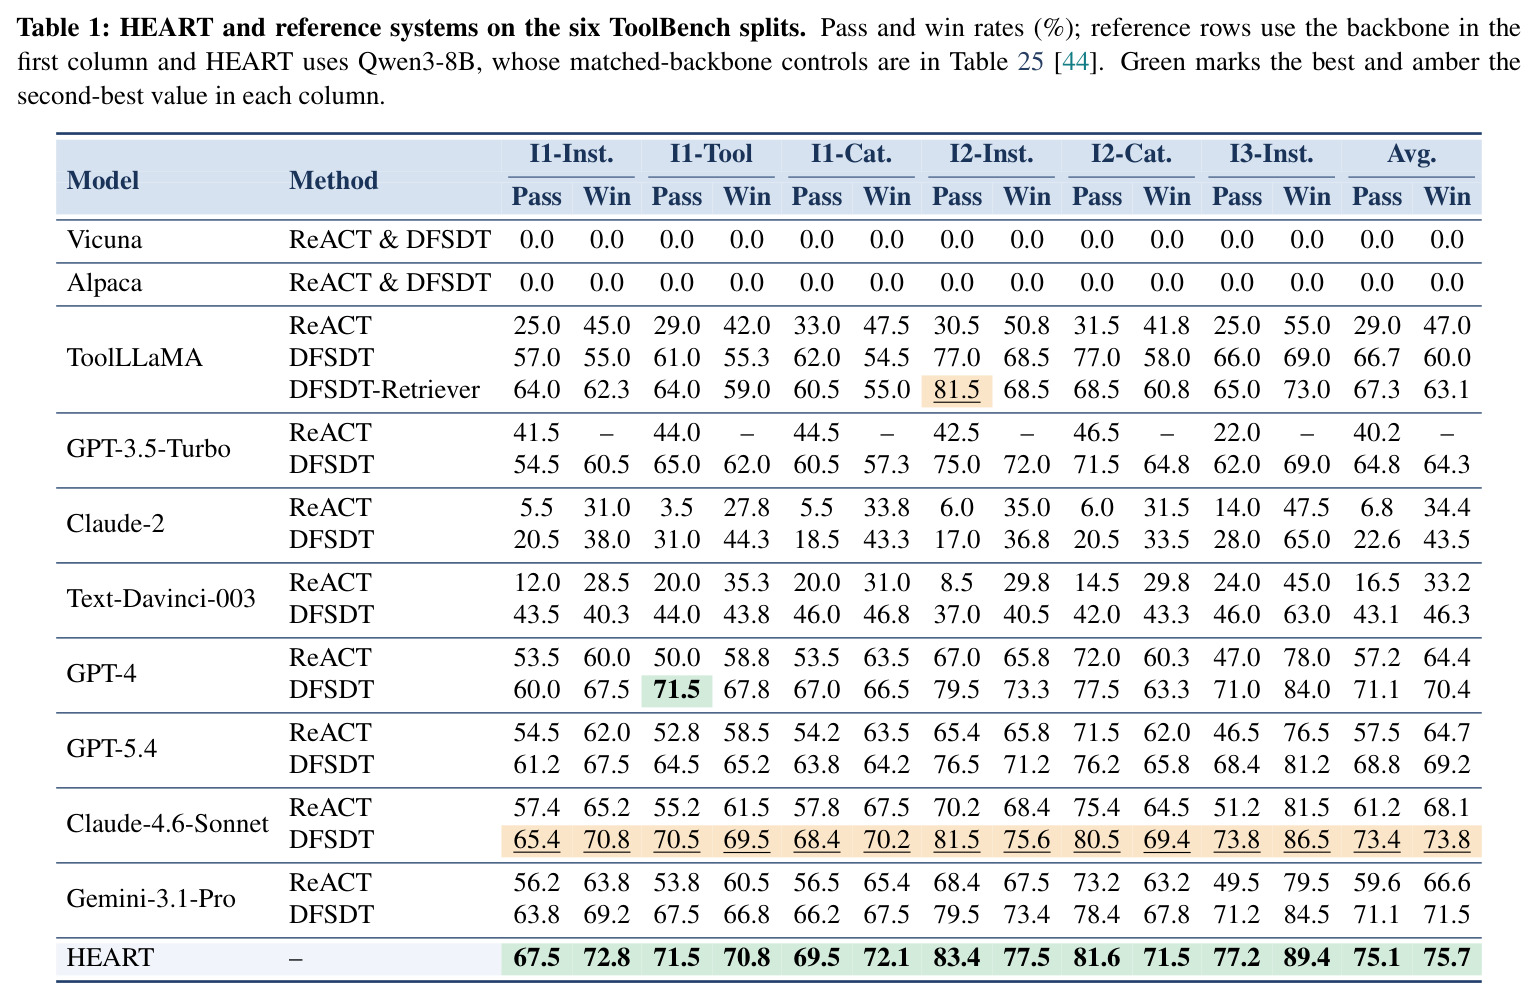
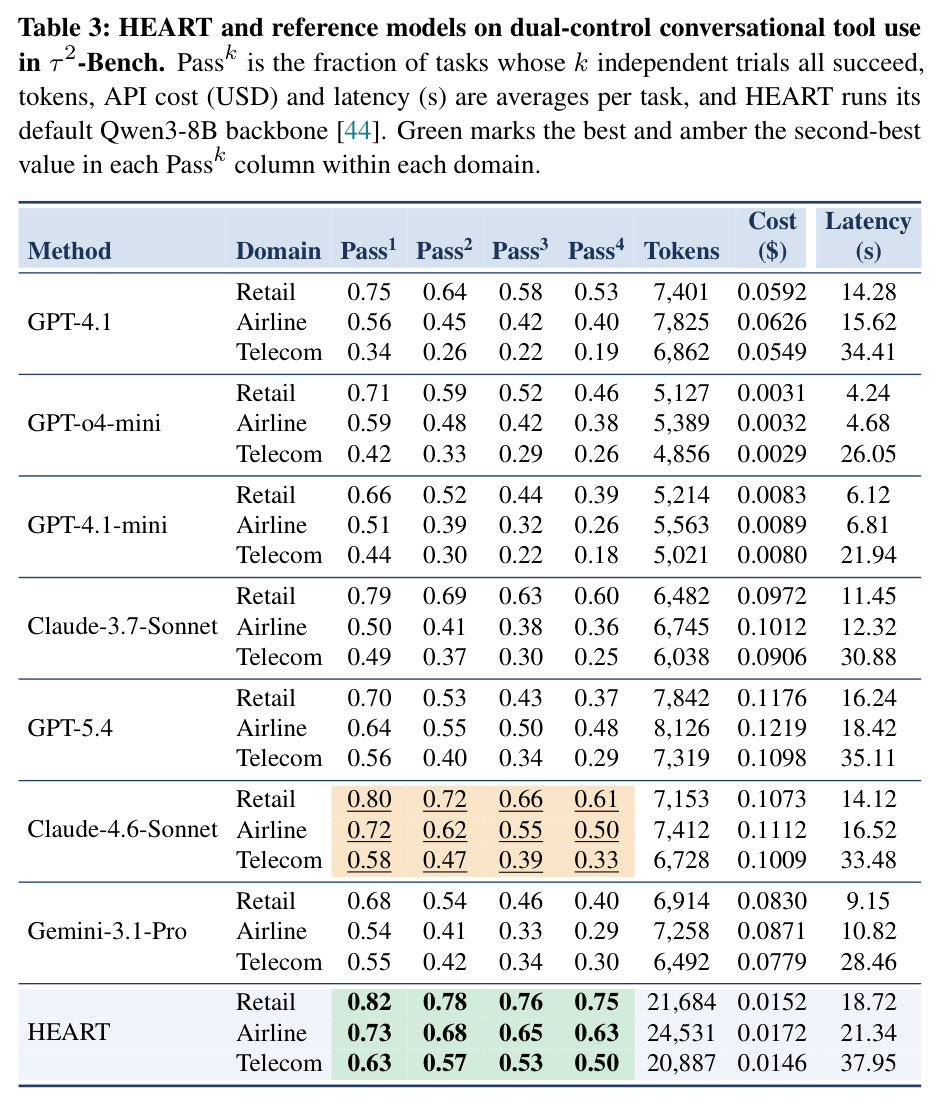
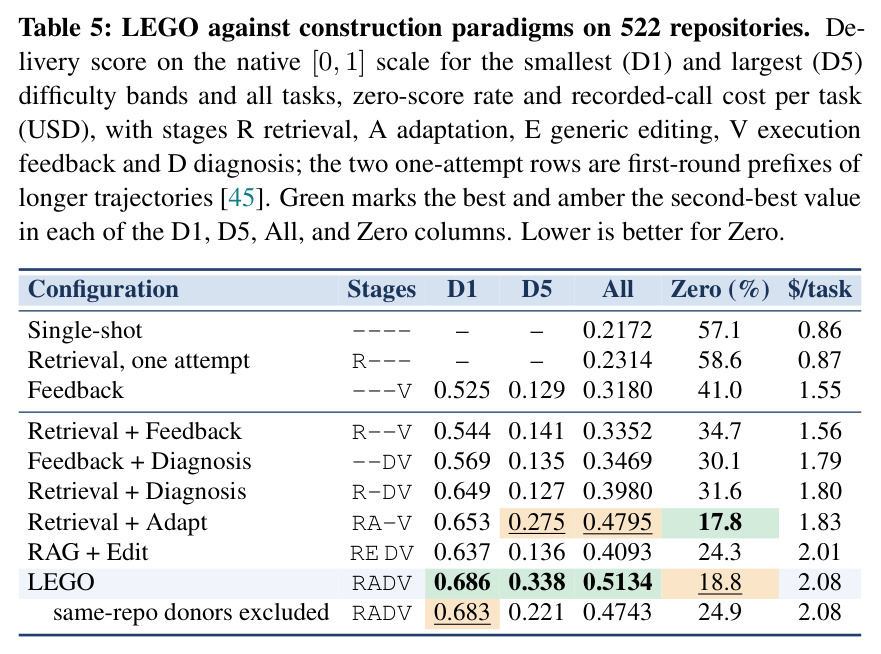
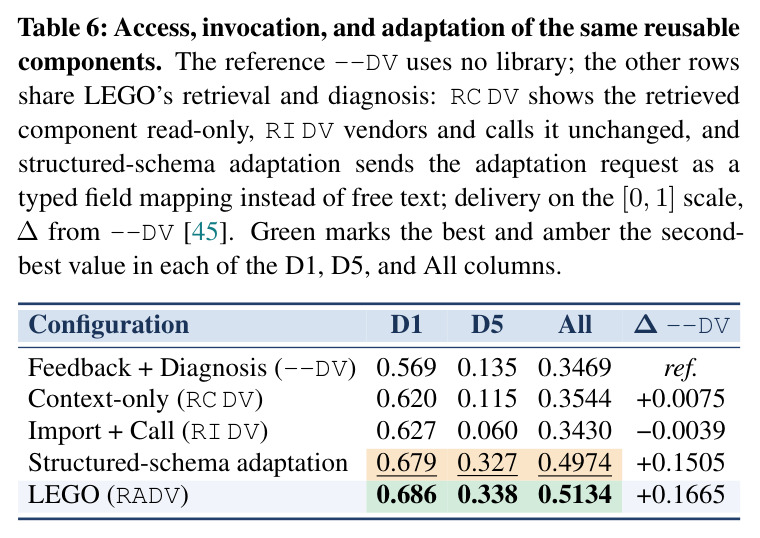
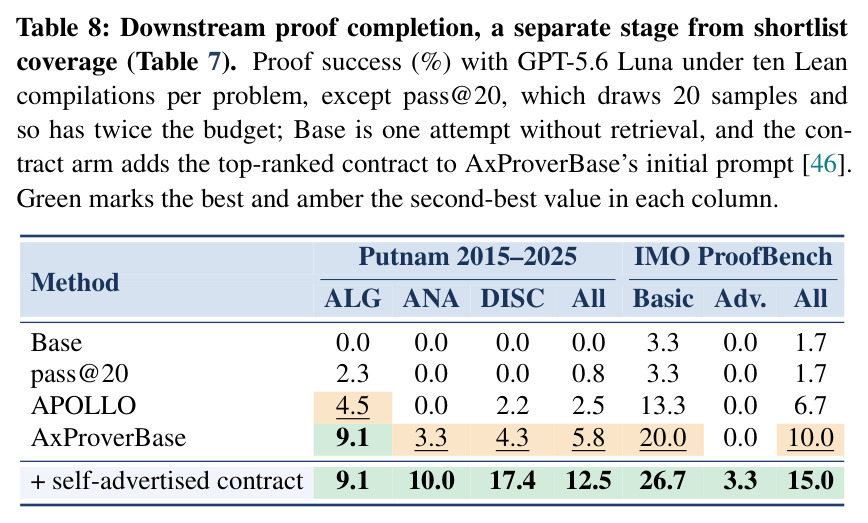
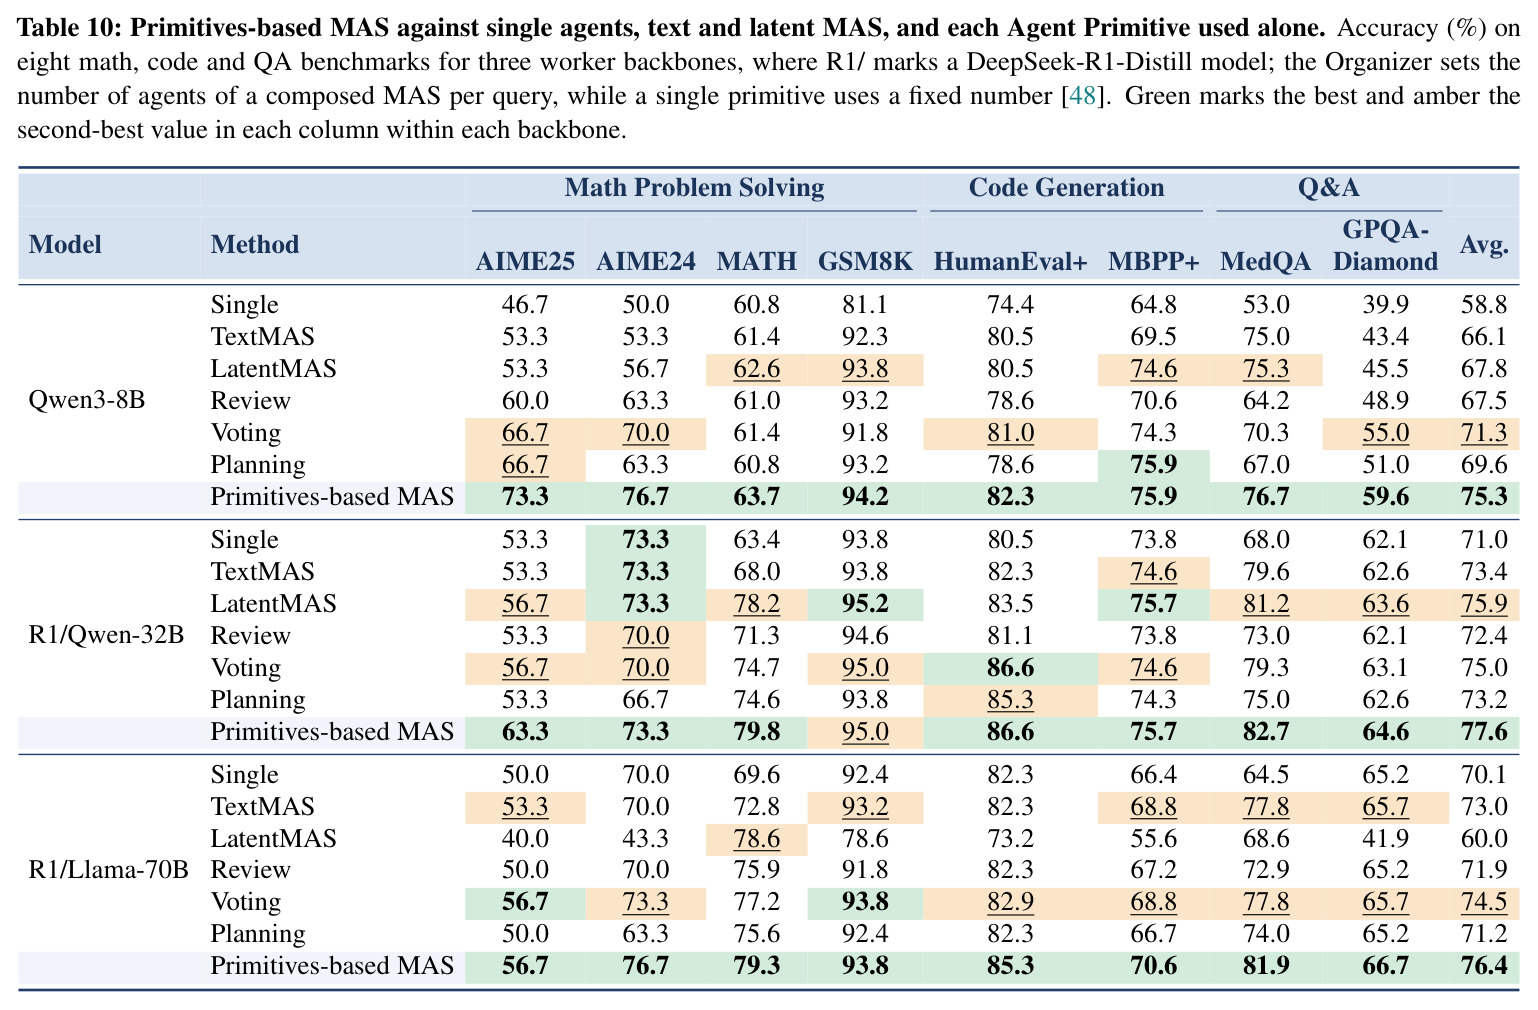
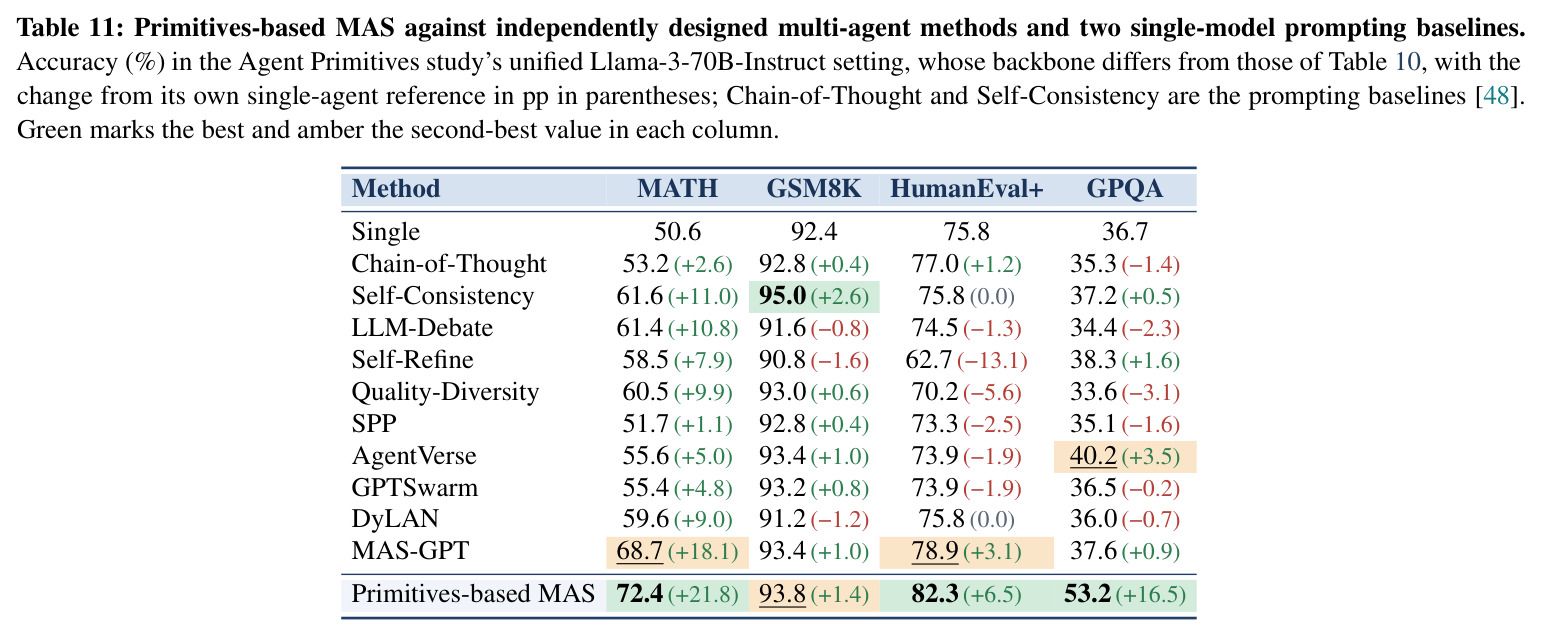
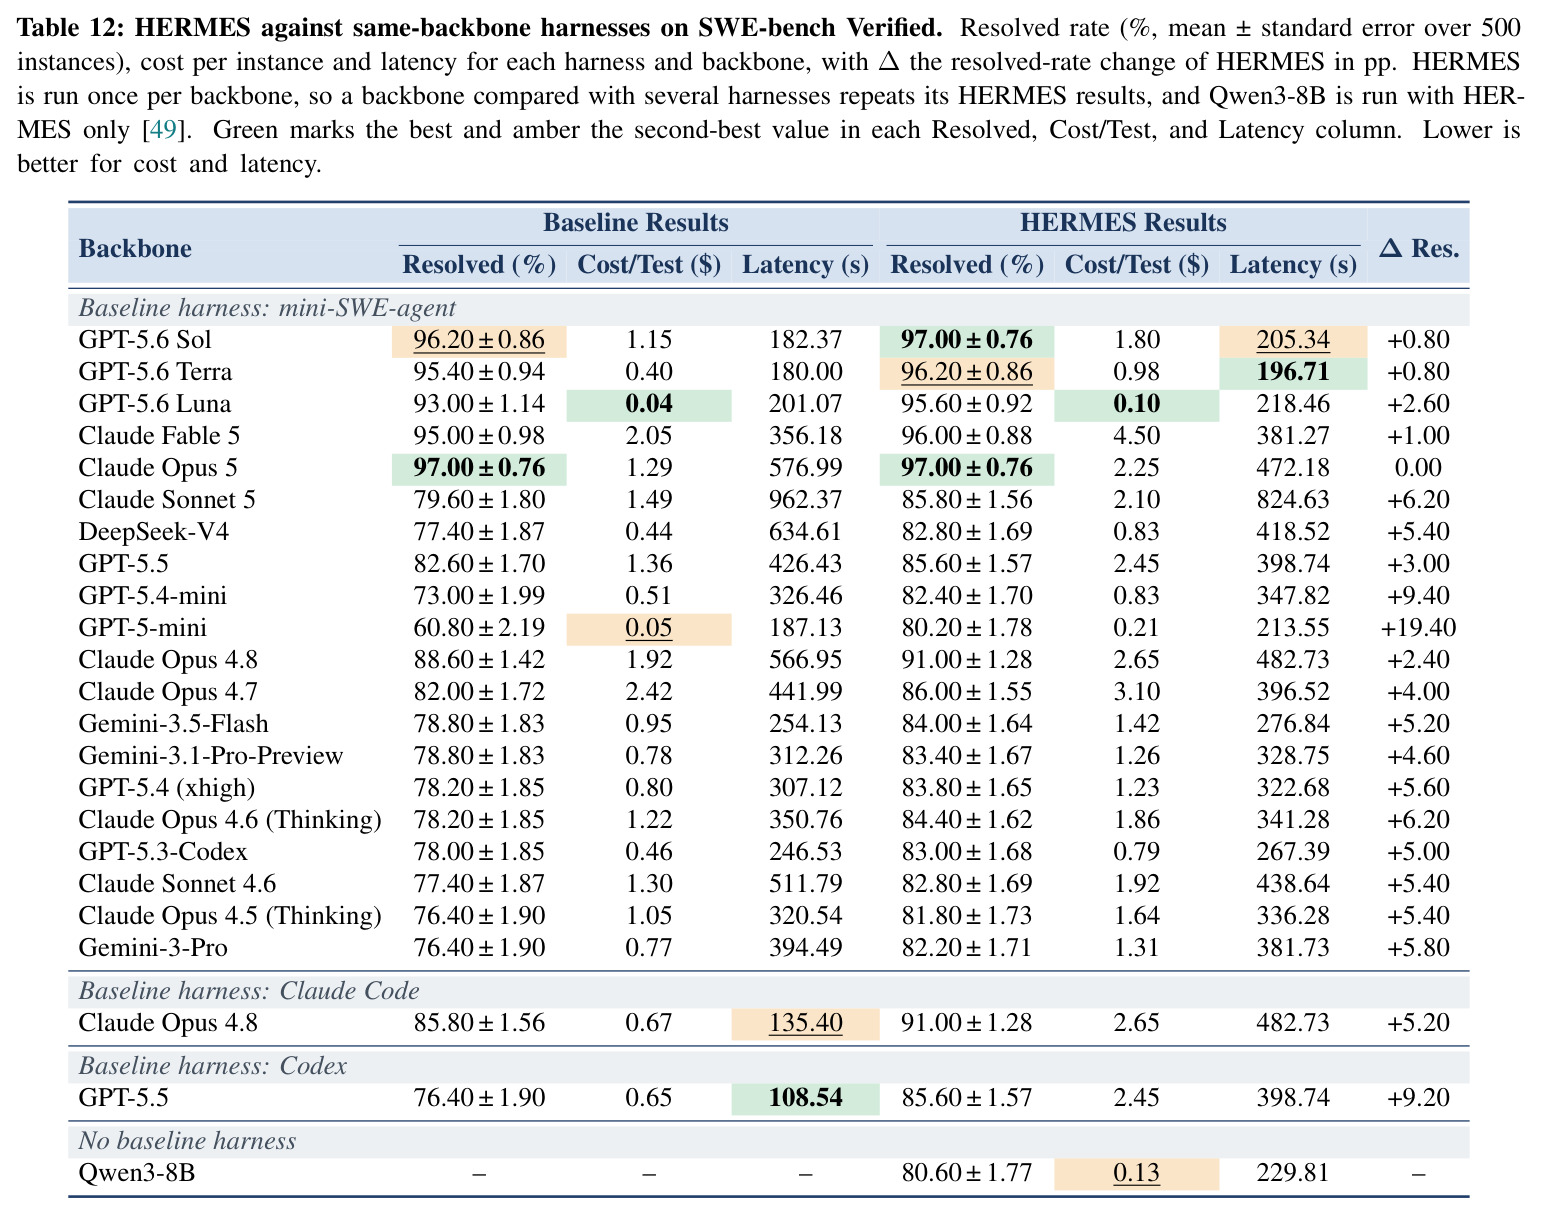
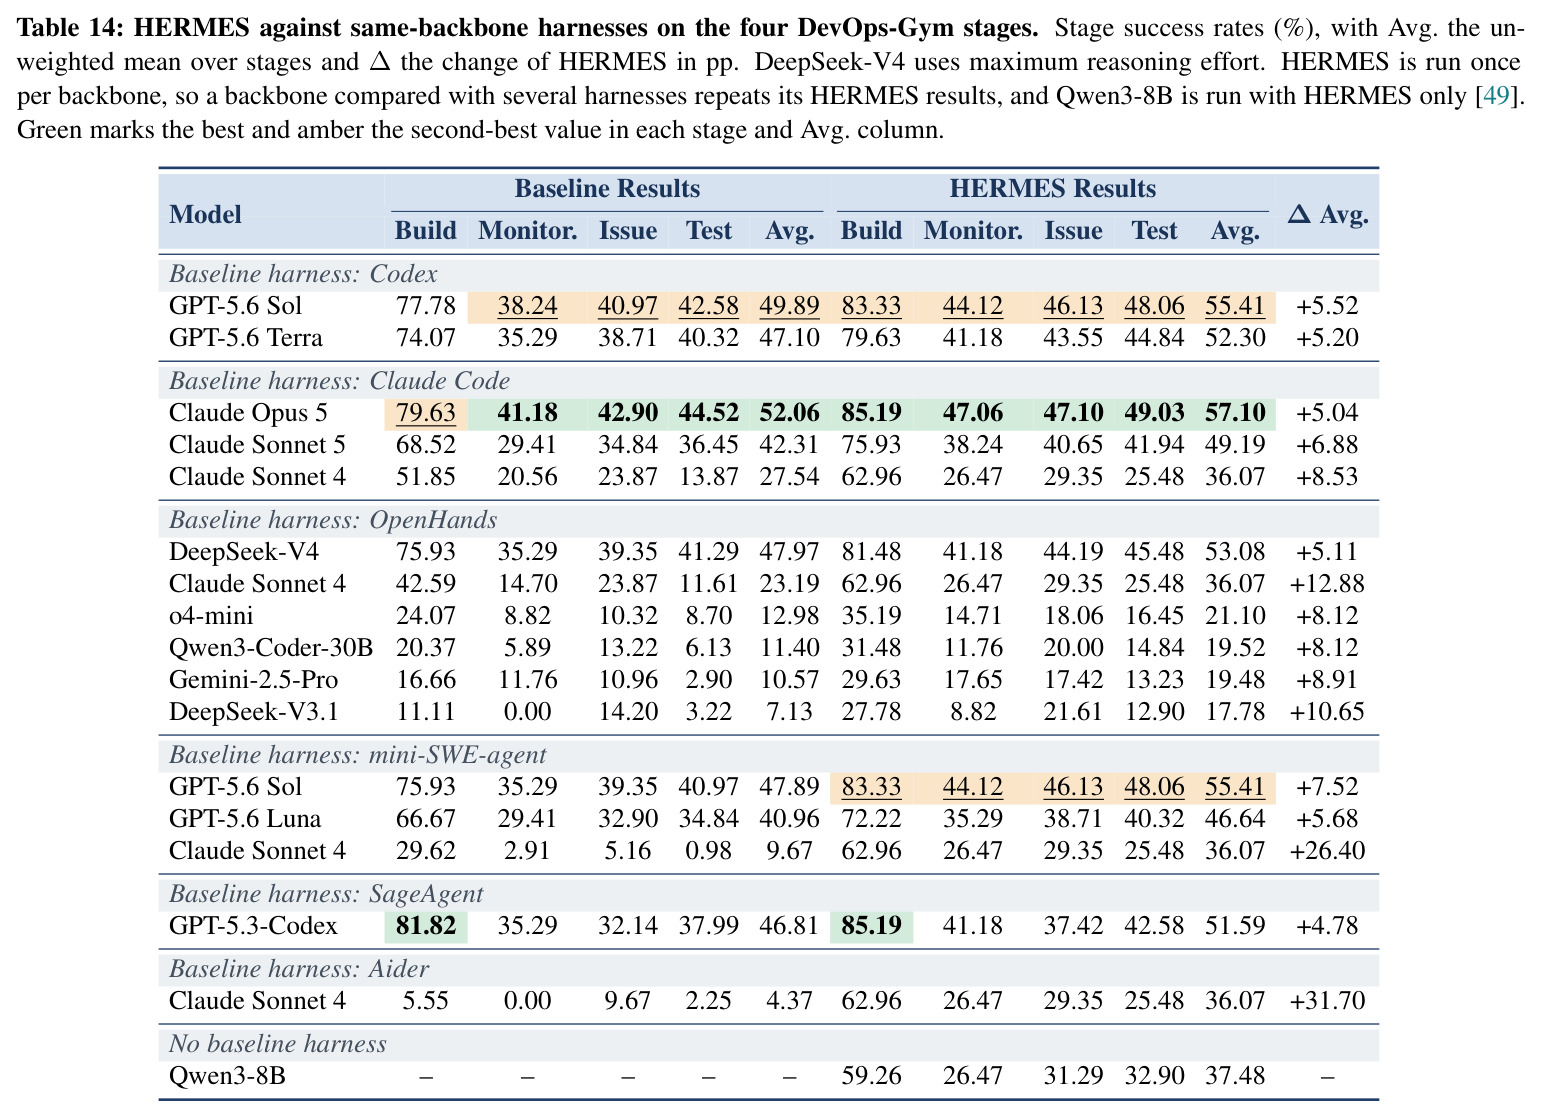
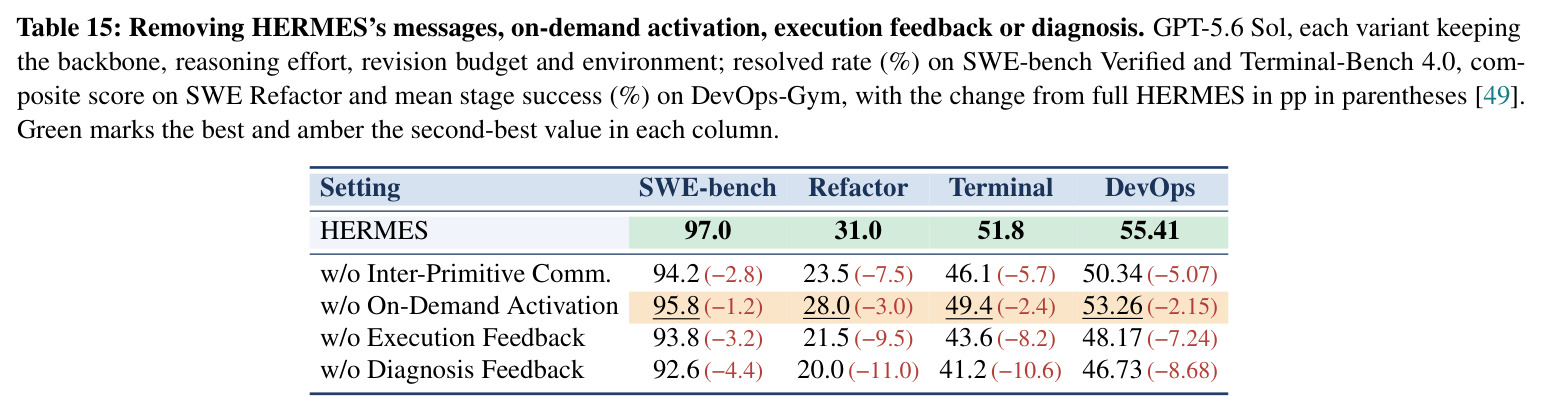
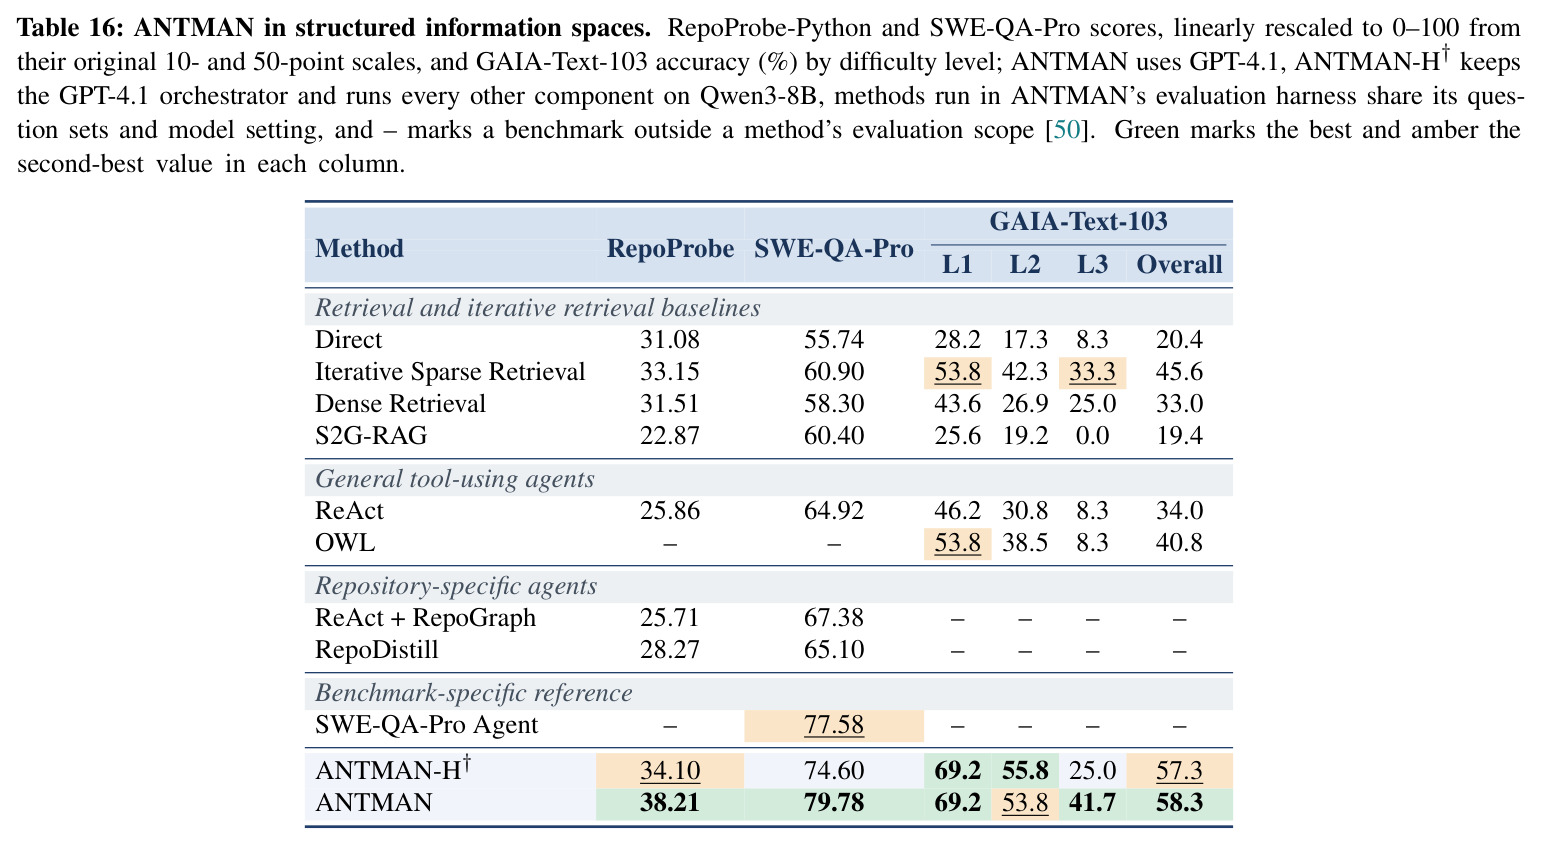
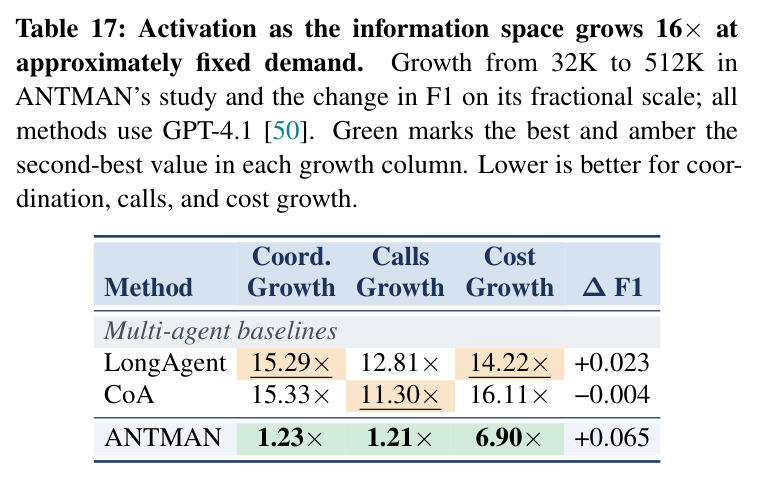
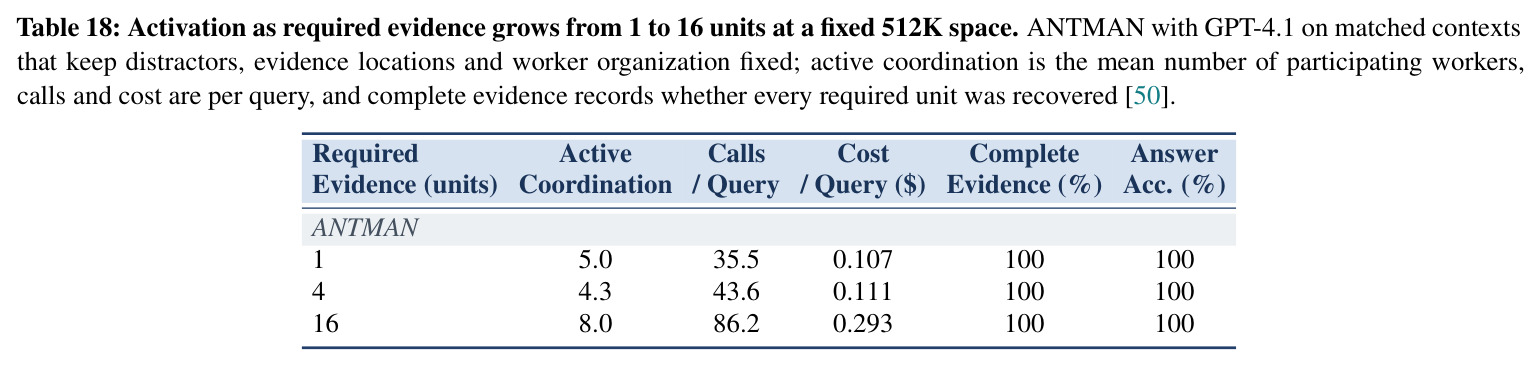
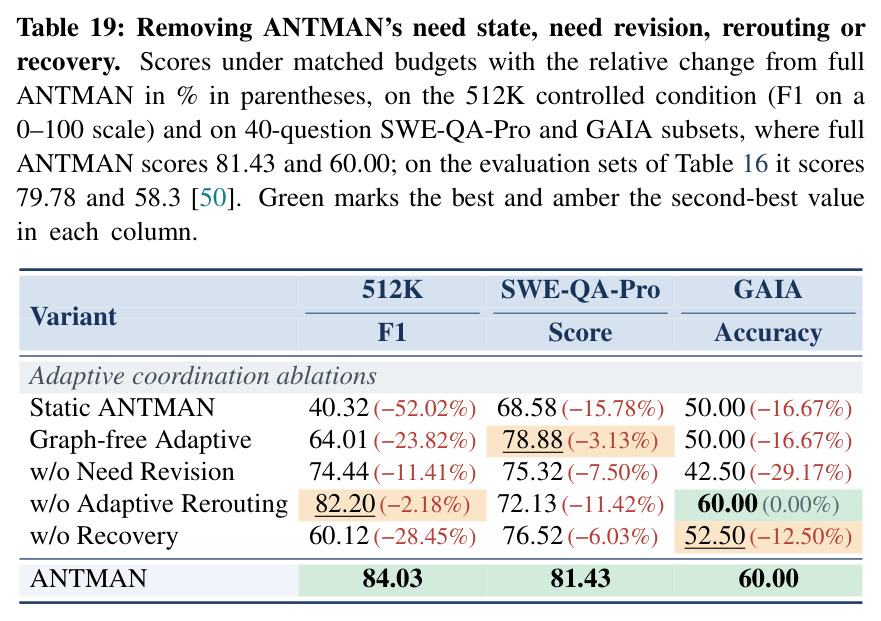
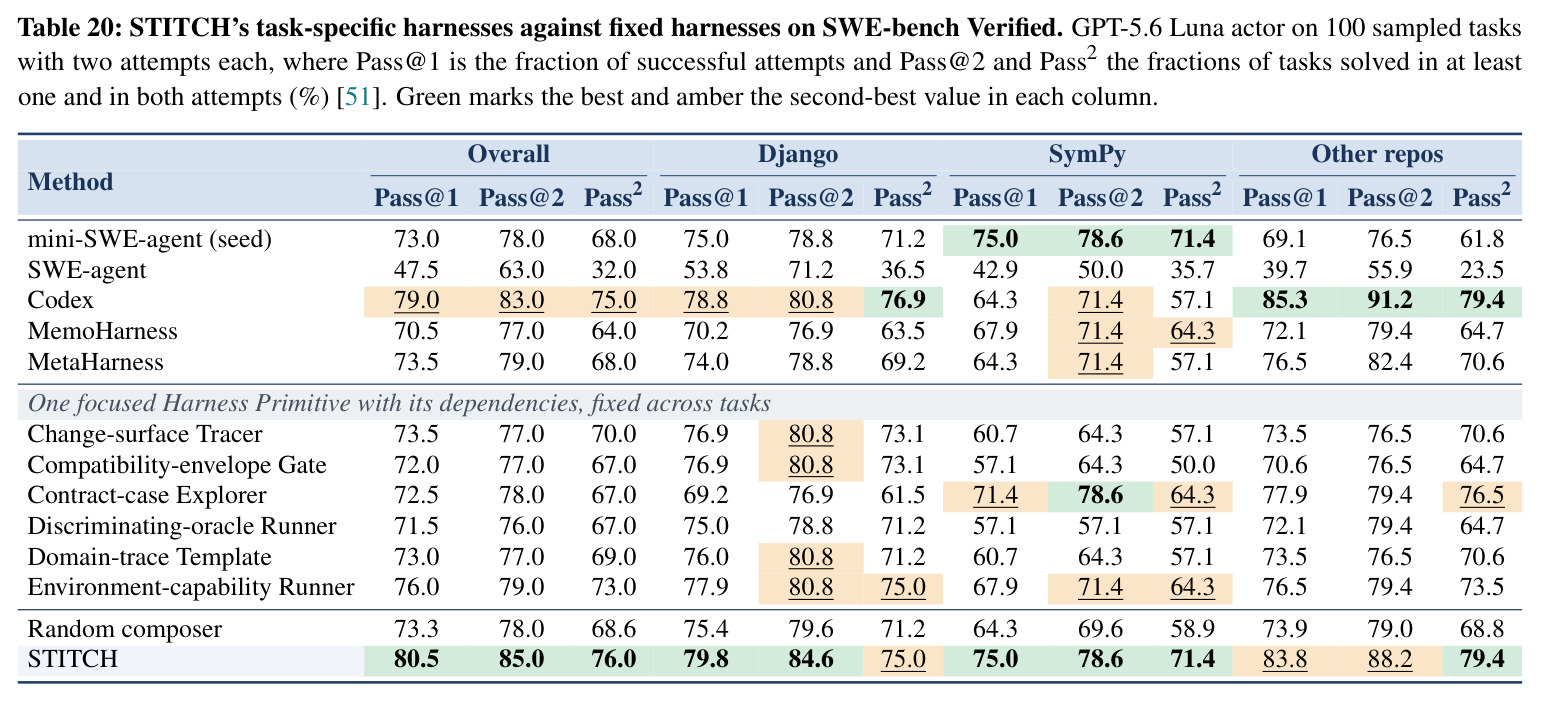
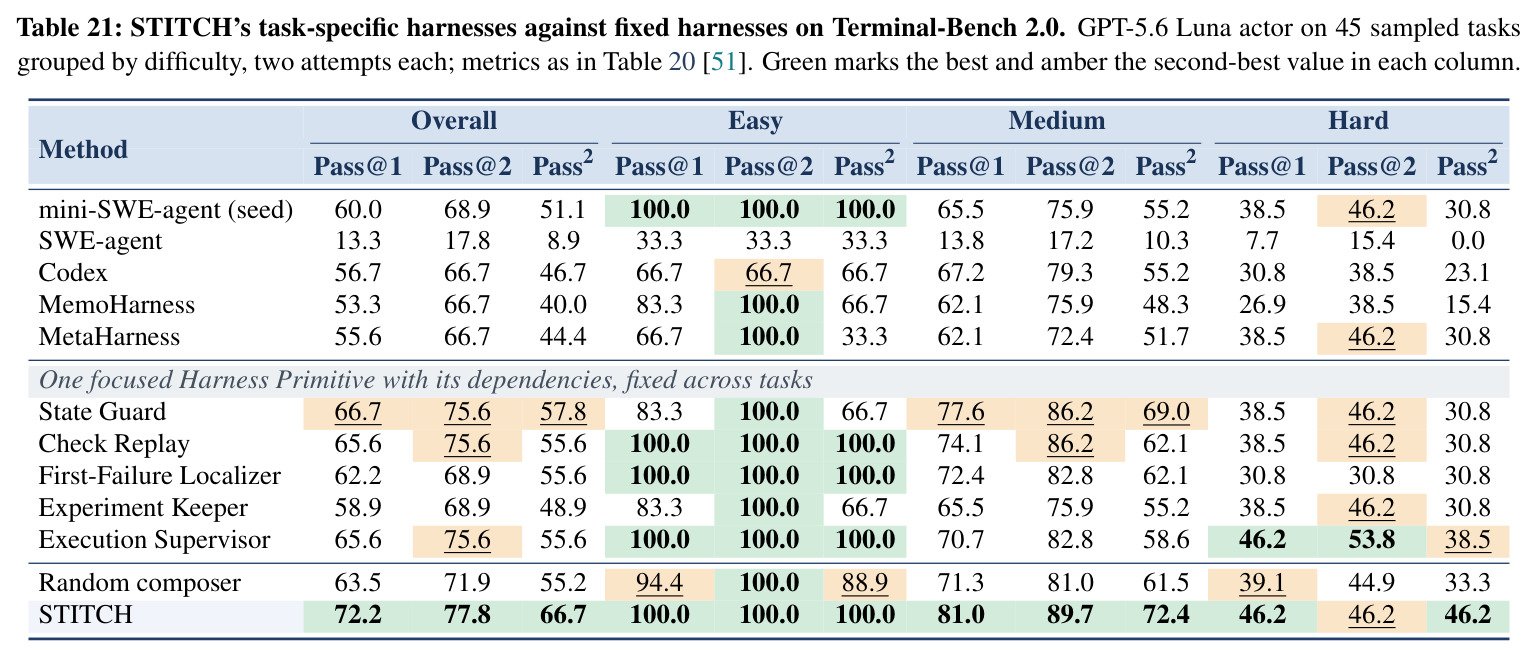
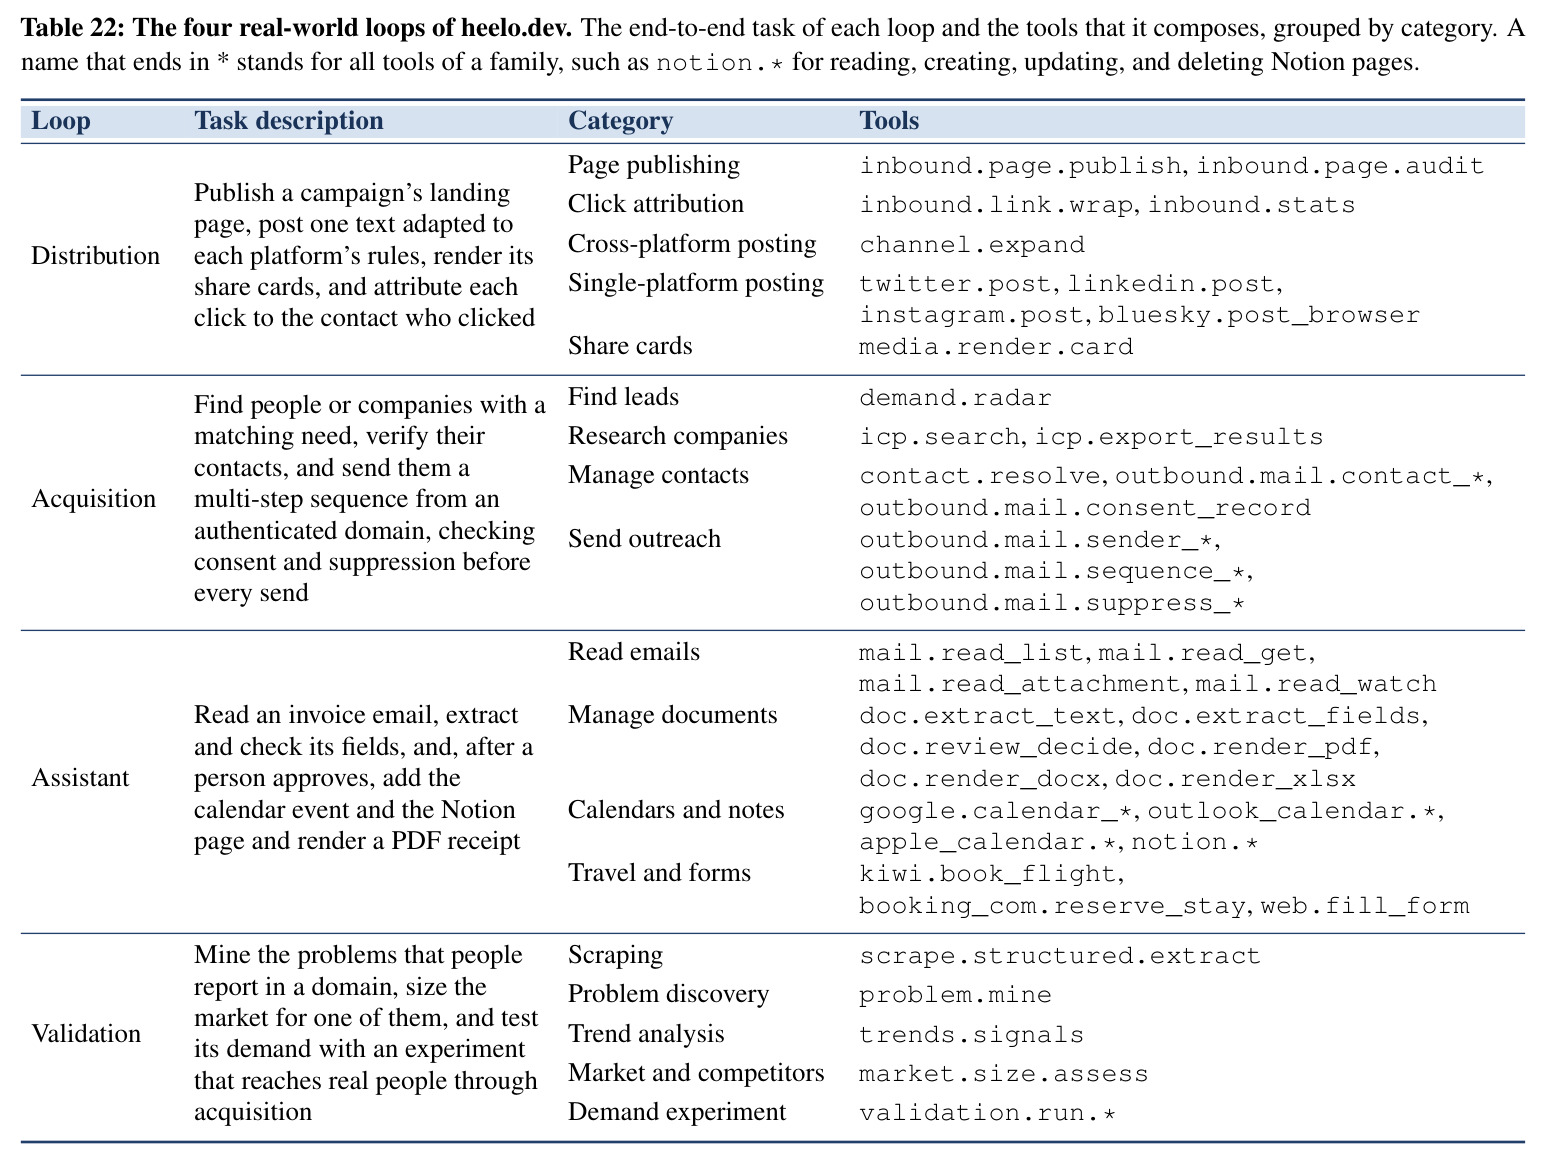
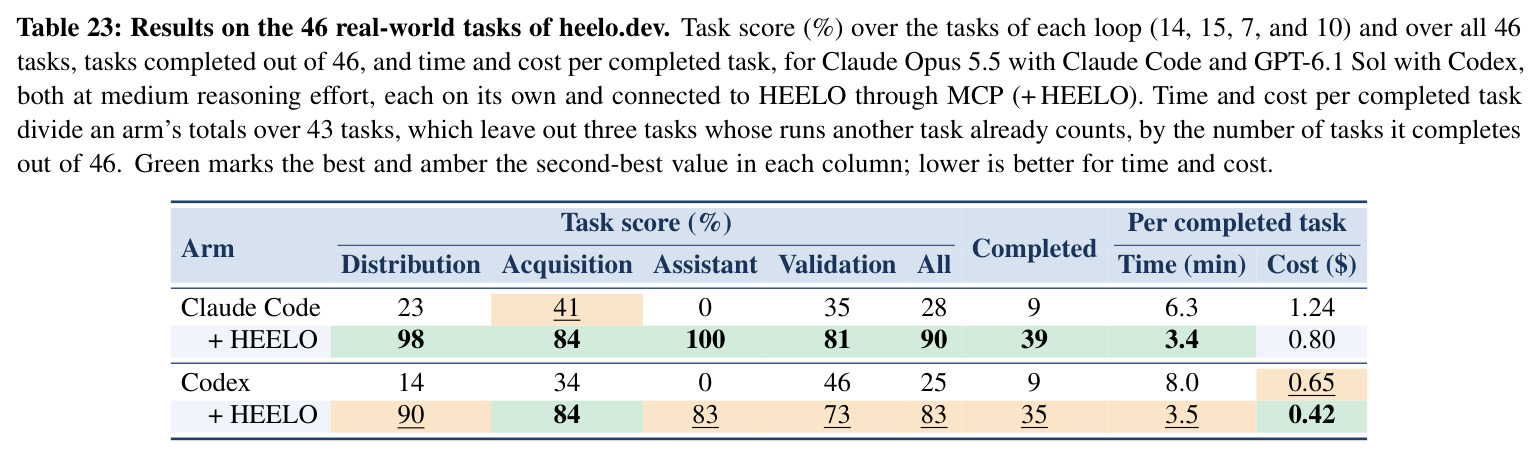
八个家族在 26 组公开基准对照中全部领先,且每组都有消融定位增益。软件工程:HERMES 使 GPT-5.6 Sol 在 Terminal-Bench 4.0 从 Codex 的 37.3%(max 档)升至 55.5%(+18.2pp;medium 档 33.0%→51.8%),SWE Refactor 整仓迁移 6.5%→31.0%(+24.5pp);SWE-bench Verified 全量 500 题上超过 mini-SWE-agent 基线 19/20 个骨干,同骨干对 Claude Code/Codex +5.2/+9.2pp,Qwen3-8B 全角色也达 80.6%。harness:STITCH 把 100 题 SWE-bench Verified 的 Pass@1 从种子 73.0% 提到 80.5%(Codex 79.0%、随机组合 73.3%、最强固定原语 76.0%),45 题 Terminal-Bench 2.0 从 60.0% 提到 72.2%(Codex 56.7%),组合成本仅为一次 actor 尝试的 2.7–4.3%。工具:HEART(Qwen3-8B)ToolBench 平均 pass 75.1%(最强商用基线 Claude-4.6-Sonnet+DFSDT 73.4%,同骨干最优脚手架仅 55.8%),NESTFUL 全序列准确率 0.44/0.47(GPT-5.4 为 0.40/0.42),τ²-Bench 航空 Pass⁴ 0.63 对 0.50,成本 $0.0146–0.0172 对 GPT-5.4 的 $0.1098–0.1219(最高省 7.7 倍);消融显示去掉 Tool Primitives 后 pass 跌至 16.1%,增益在原语接口本身。代码:LEGO 在 522 个仓库重建任务上交付分 0.5134 对执行反馈 0.3180(+61.4%),零分率 41.0%→18.8%,领先 OpenHands/Claude Code 57.3%/56.2%;GPT-OSS-20B 做常驻模型保 95.1% 交付、省 24% 成本;外部基准 RepoZero/RepoGenesis/RepoCraft 相对提升 16.9%/17.6%/14.9%。数学:82 个方法契约的自荐选择 Putnam hit@5 达 0.950(最强重排 0.842),随骨干从 0.900→0.950→0.975 而重排器停滞在 0.842–0.858;下游把 AxProverBase 从 5.8% 提到 12.5%(IMO 10.0%→15.0%)。知识:SourceLearn 五基准平均超 Hybrid RAG +14.3pp(GPT-5.6 Luna),MultiDoc2Dial 64.9%→77.6%、APIBench 47.8%→70.4%,15 个设置中 13 个最佳。多智能体:Qwen3-8B 八基准平均从单 agent 58.8% 升至 75.3%,GPQA 53.2% 远超八个已有 MAS(最高 40.2%),token 约为文本通信 MAS 的 1/3–1/4。导航:ANTMAN GAIA-Text-103 45.6%→58.3%、RepoProbe 38.21、SWE-QA-Pro 79.78;空间扩 16 倍时激活仅 1.23 倍(LongAgent/CoA 约 15.3 倍)而 F1 反升 0.065。真实平台:heelo.dev 46 个任务上,Claude Code 独立完成 9/46(均分 28%)、接 HEELO 后 39/46(90%),Codex 9/46(25%)→35/46(83%);每完成任务时长 6.3→3.4 与 8.0→3.5 分钟(1.9×/2.3×),成本 $1.24→$0.80、$0.65→$0.42(约 1.55× 降低)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 4.0(66 终端任务,GPT-5.6 Sol max 档) | Resolution(5 次运行均值) | 55.5%(HERMES/Dev-Primitives) | 37.3%(Codex) | +18.2 pp;对 Claude Opus 5+Claude Code(51.8%)+1.2 pp |
| SWE-bench Verified(500 实例,GPT-5.6 Sol) | Resolved rate | 97.0%(HERMES) | 96.2%(mini-SWE-agent) | +0.8 pp;对 Codex 骨干(GPT-5.5)+9.2 pp、对 Claude Code +5.2 pp,19/20 骨干提升 |
| SWE Refactor Bench(20 个整仓迁移,GPT-5.6 Sol) | Composite score | 31.0% | 6.5%(Codex) | +24.5 pp(high 档 19.0%→36.5%) |
| SWE-bench Verified(100 题采样,GPT-5.6 Luna actor) | Pass@1 | 80.5%(STITCH/Harness Primitives) | 73.0%(mini-SWE-agent 种子);79.0%(Codex) | +7.5 pp 对种子、+1.5 pp 对 Codex;组合成本仅一次尝试的 4.3% |
| Terminal-Bench 2.0(45 题采样,GPT-5.6 Luna) | Pass@1 | 72.2%(STITCH) | 60.0%(种子);56.7%(Codex) | +12.2 pp / +15.5 pp |
| ToolBench(六个 split 平均,Qwen3-8B) | Pass rate / Win rate | 75.1% / 75.7%(HEART+Tool Primitives) | 73.4% / 73.8%(Claude-4.6-Sonnet+DFSDT);同骨干 55.8% | +1.7/+1.9 pp 对最强商用基线;同骨干 +19.3 pp |
| NESTFUL 嵌套调用(one-shot) | Full sequence accuracy | 0.44(HEART,8B×4) | 0.40(GPT-5.4);DeepSeek-V3(685B)仅 0.09 | +0.04,五项指标全部第一 |
| τ²-Bench(零售/航空/电信,Qwen3-8B) | Pass⁴ 与每任务成本 | 航空 0.63、电信 0.50;$0.0146–0.0172/任务 | Claude-4.6-Sonnet 航空 0.50、电信 0.33;GPT-5.4 成本 $0.1098–0.1219 | Pass⁴ 大幅领先(航空 +13 pp);成本最高省 7.7 倍 |
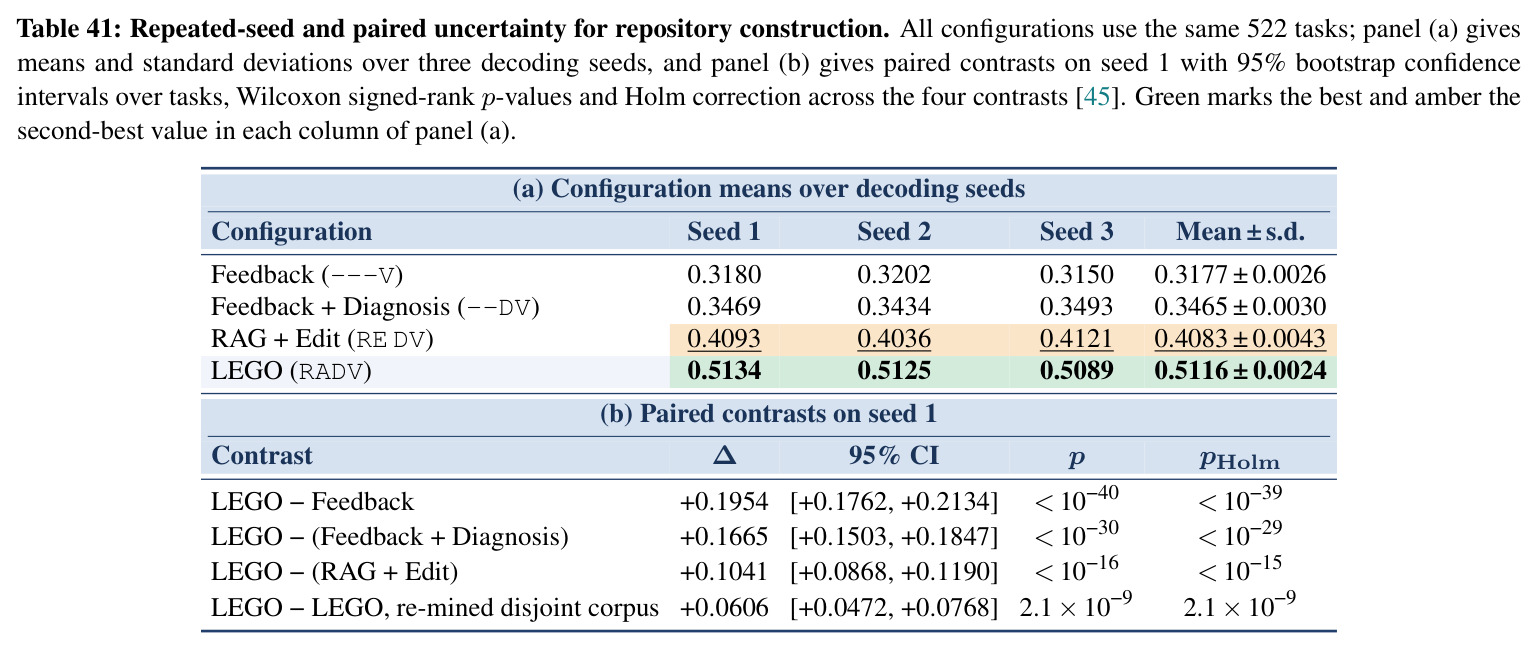
| LEGO-REPO(522 个仓库重建任务,GPT-5.6 Terra) | Delivery score([0,1]) | 0.5134(LEGO/Code Primitives) | 0.3180(执行反馈);OpenHands 0.3263、Claude Code 0.3170 | +61.4%;零分率 41.0%→18.8%;对 OpenHands/Claude Code +57.3%/+56.2% |
| Putnam 2015–2025(120 题,GPT-5.6 Luna 选择器) | hit@5 | 0.950(自荐式方法选择) | 0.842(最强嵌入+LLM 重排) | +10.8 pp;hit@5 随骨干升至 0.975 而重排器停滞 |
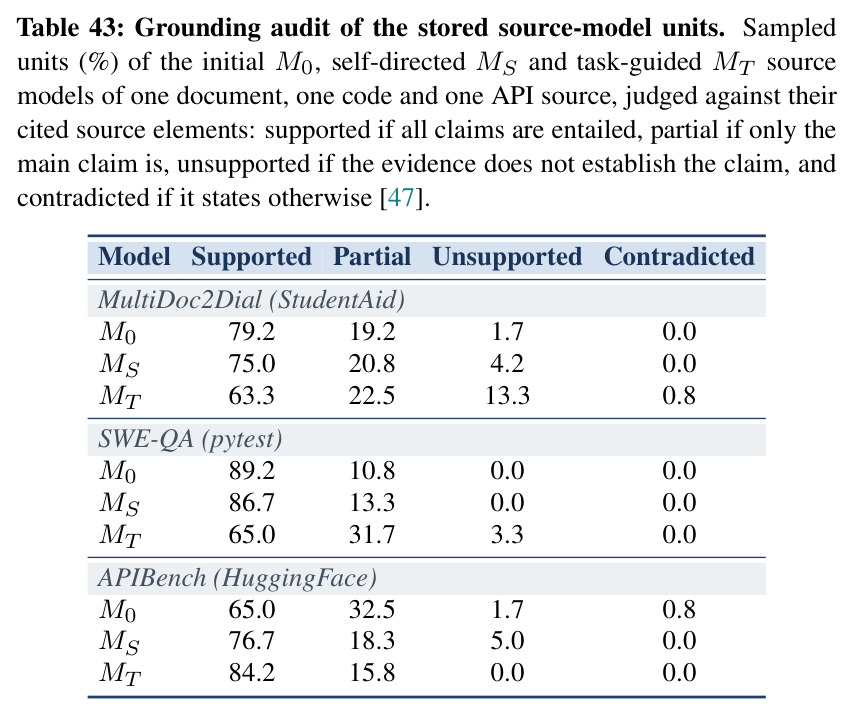
| 五知识基准平均(MultiDoc2Dial 等,GPT-5.6 Luna) | Accuracy 平均增益 | +14.3 pp(SourceLearn vs Hybrid RAG) | Hybrid RAG(如 APIBench 47.8%、MultiDoc2Dial 64.9%) | APIBench +22.6 pp、NarrativeQA +14.2 pp;15 设置中 13 个最佳 |
| 八基准平均(AIME25/24、MATH、GSM8K、HumanEval+ 等,Qwen3-8B) | Mean accuracy | 75.3%(Primitives-based MAS) | 58.8%(单 agent);66.1%(TextMAS);67.8%(LatentMAS) | +16.5 pp;GPQA 53.2% 对八个已有 MAS 最高 40.2% |
| GAIA-Text-103(GPT-4.1) | Overall accuracy | 58.3%(ANTMAN/Navigation Primitives) | 45.6%(迭代稀疏检索) | +12.7 pp;L3 41.7% 对多数基线 ≤8.3–33.3% |
| heelo.dev 46 个真实任务(Claude Opus 5.5 + Claude Code,medium 档) | 完成任务数 / 任务均分 | 39/46,90% | 9/46,28%(Claude Code 单打);Codex 单打 9/46,25% | 完成数 4.3×;每完成任务 1.9× 省时(6.3→3.4 分钟)、1.55× 省钱($1.24→$0.80) |
局限与改进
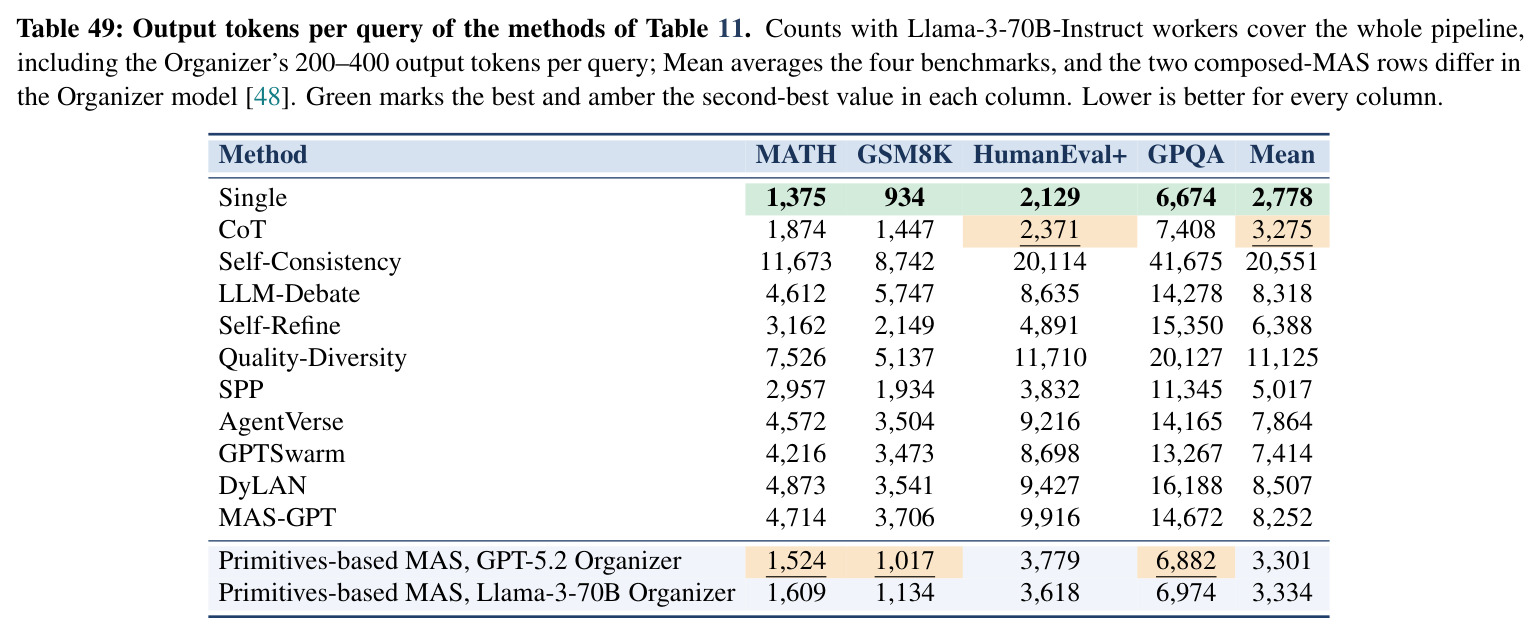
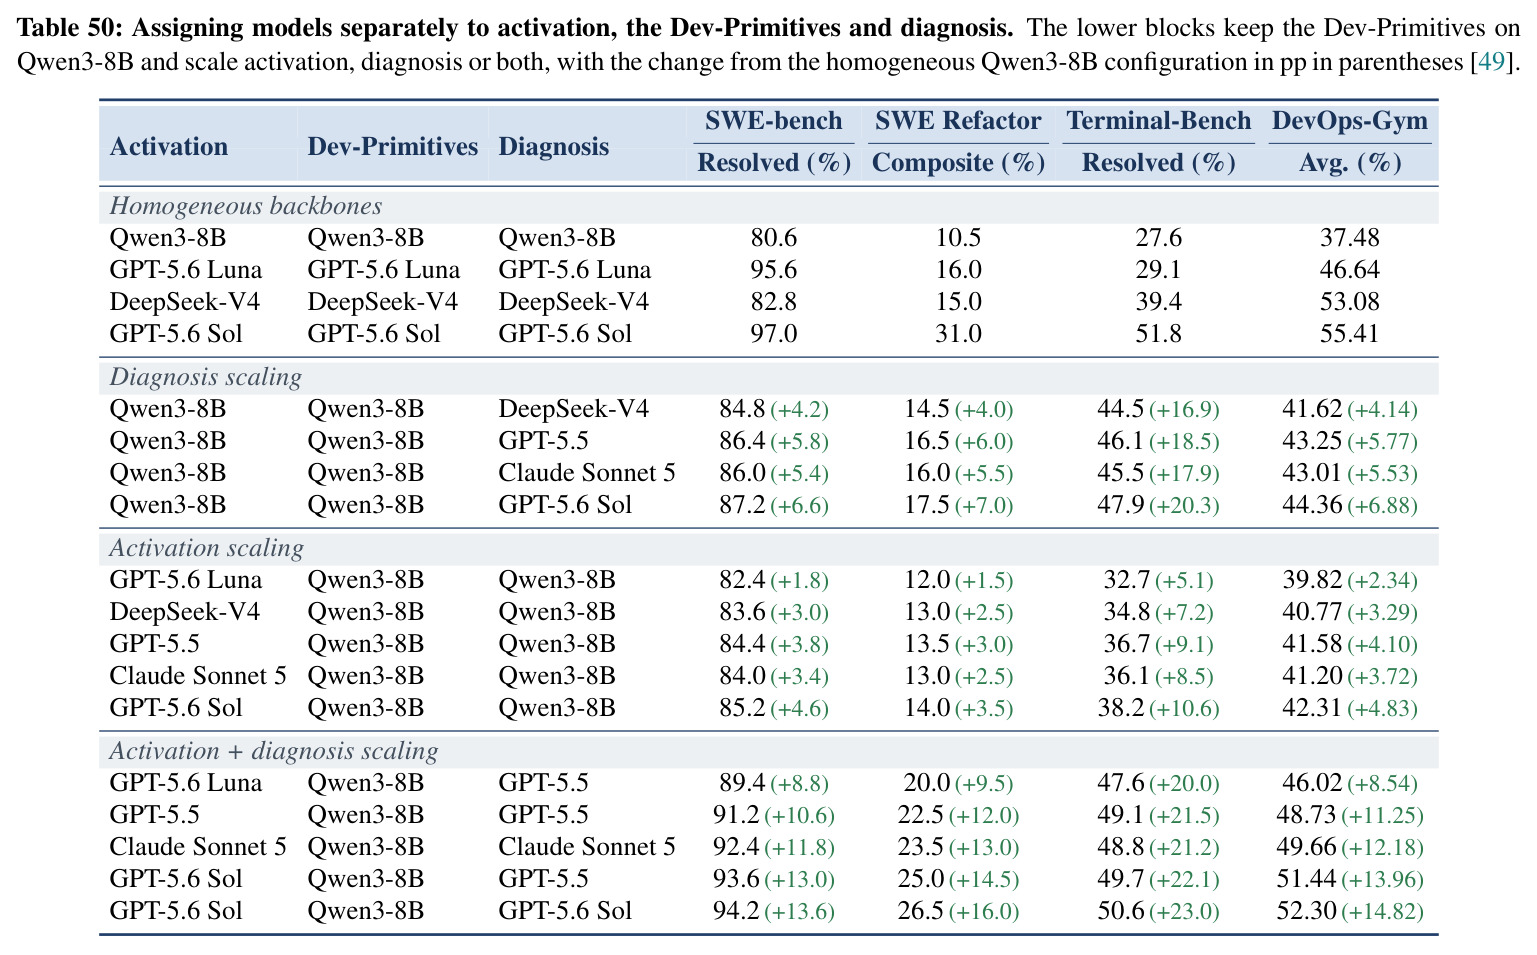
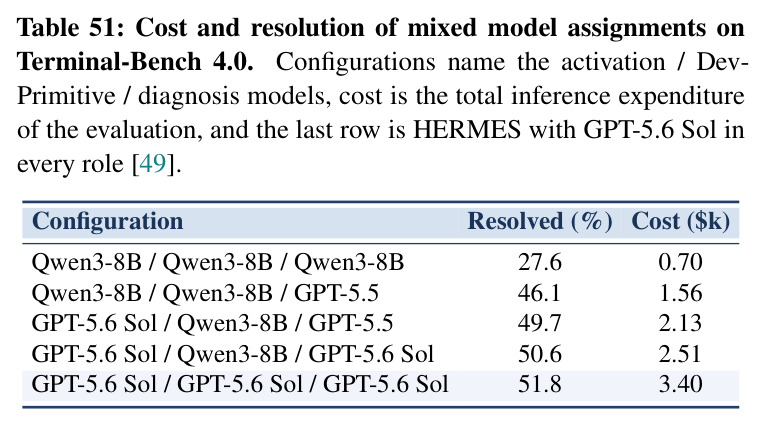
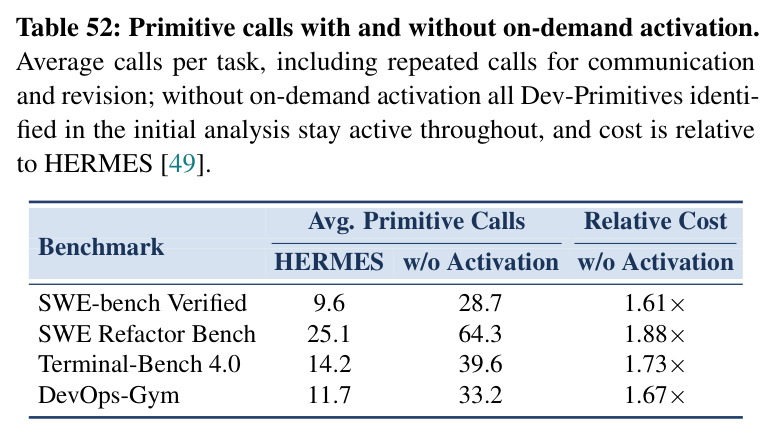
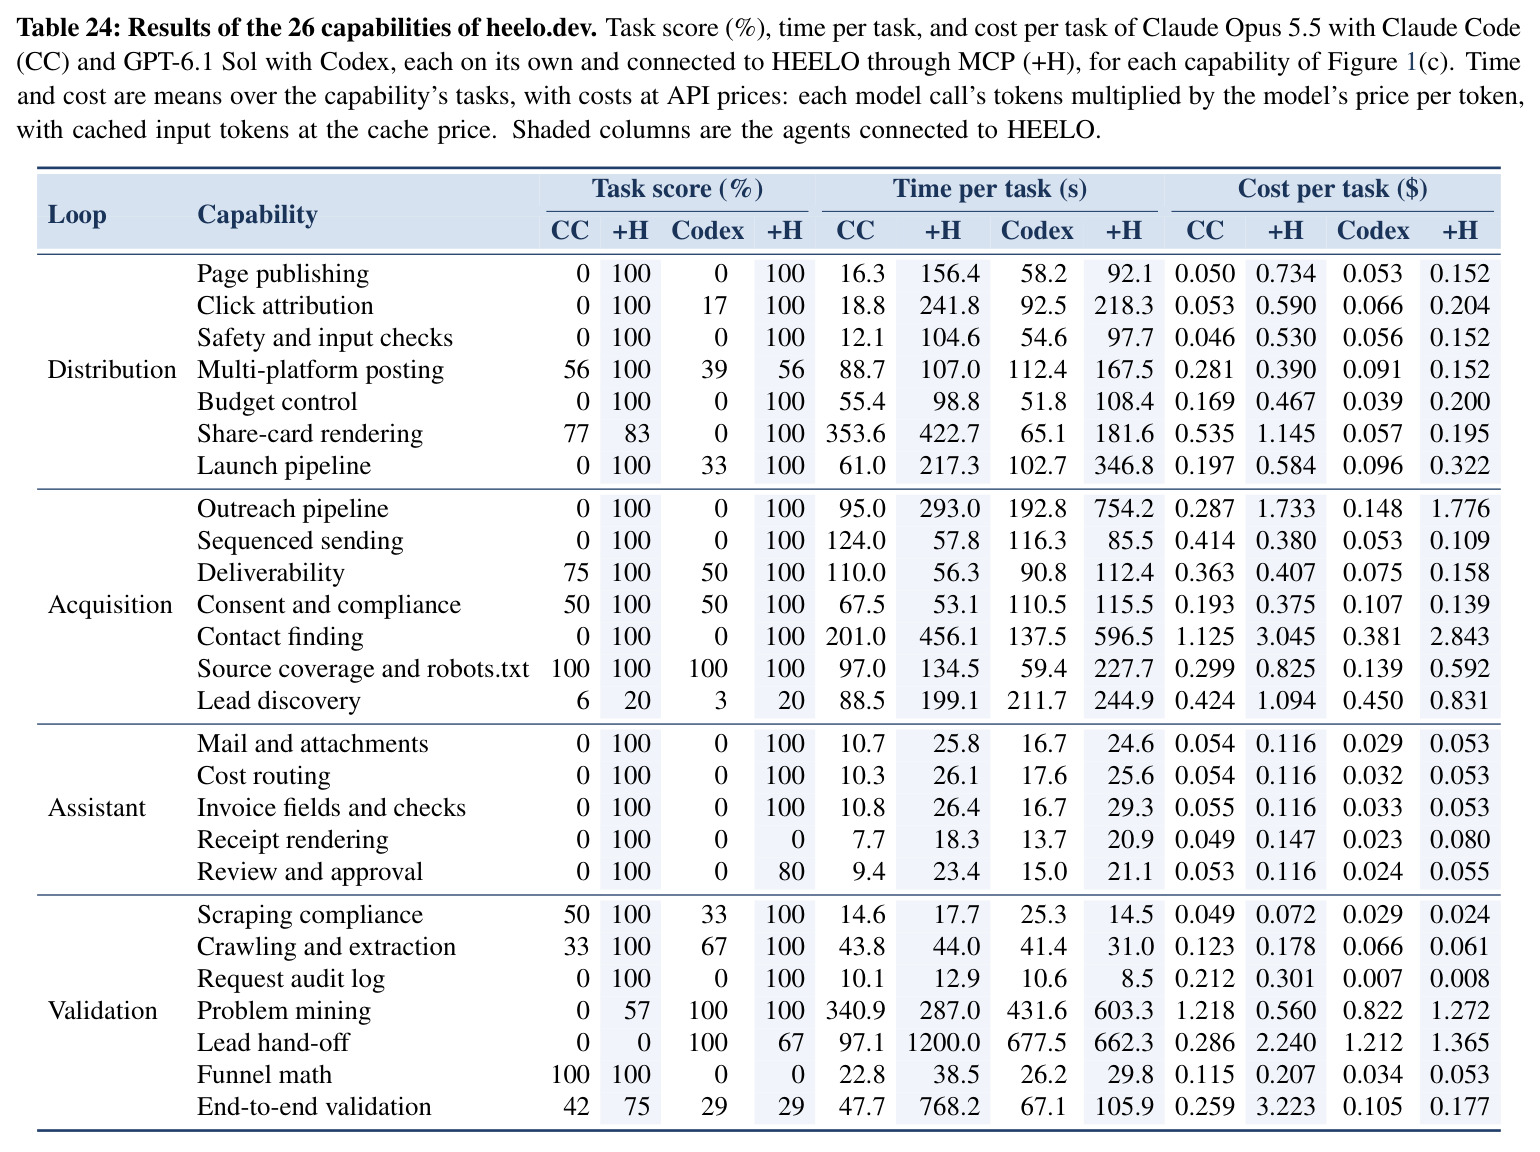
作者承认并可见的局限:增益与基线弱度正相关,对最强组合 Claude Opus 5 + Claude Code 在 Terminal-Bench 4.0 max 档只 +1.2pp、SWE-bench Verified 上对 GPT-5.6 Sol 的 mini-SWE-agent 仅 +0.8pp;token 与调用数普遍上升,HEART 在 τ²-Bench 每任务 20,887–24,531 tokens,HERMES 多数配置 token 近乎翻倍,仅个别配置(Claude Sonnet 5 max 档)涨点又省钱;Harness 研究只用 100/45 题采样、每题两次尝试,原语库的 scope 在开发任务上调整过,存在选择偏差;heelo.dev 部分评分依赖 Claude Sonnet 5.5 盲评加人工复核,且任务同时充当原语的验收测试(发现缺陷、修复后重跑并只报告修复后结果),带乐观偏差。我的补充观察:理论命题建立在加性增益、需求路由次数上界等简化假设上;八族细节散布在八篇伴随研究与附录中,本文只给骨架;库构建成本高——25,519 个工具 schema 人工编写、82 个契约来自 Putnam 2000–2014 解答,明显偏向 Putnam 风格(IMO 上 recall@5 优势收窄);lead discovery 是唯一所有臂都不超过 20% 的能力,暴露开放网络长程探索短板;对 GPT-5.6/Claude 等专有模型的依赖使第三方复现受 API 可用性与成本约束。
独立分析的弱点
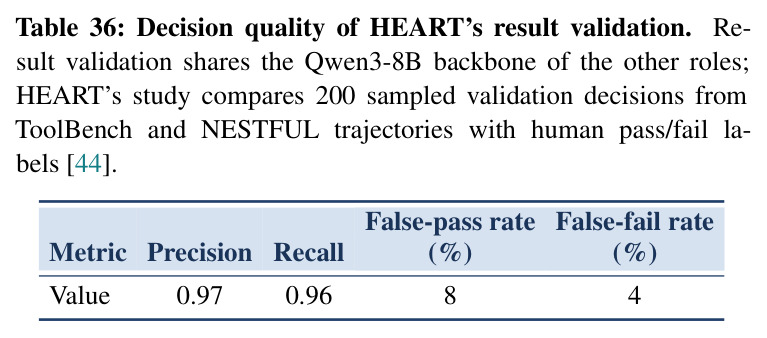
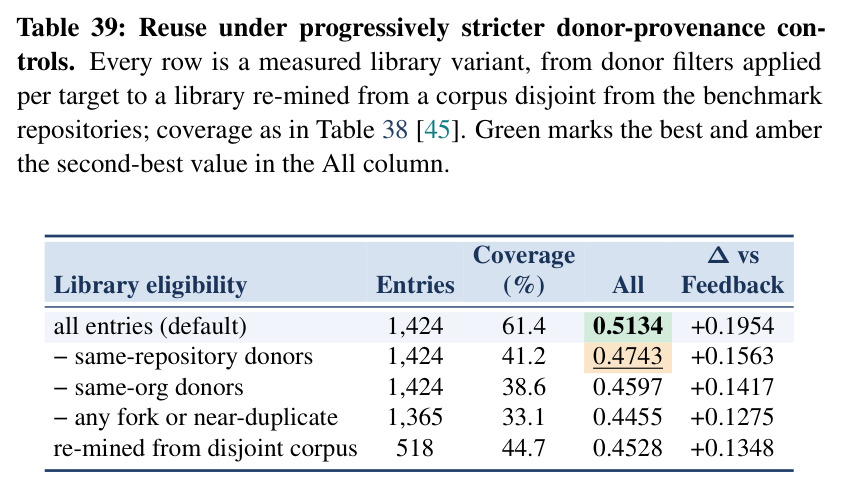
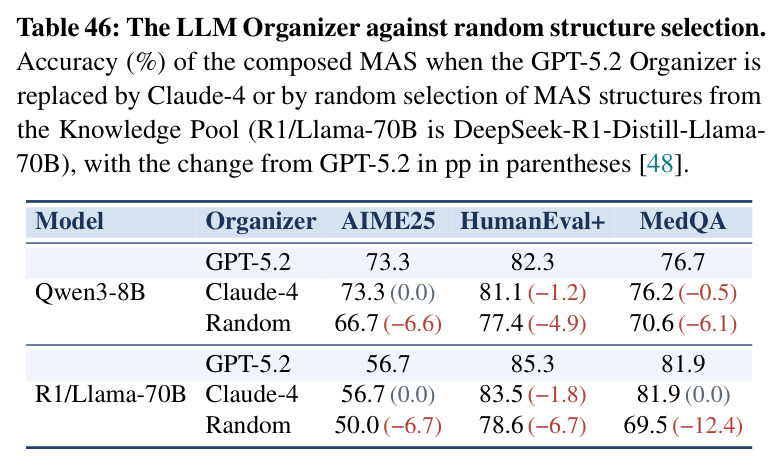
1) 常驻 LLM 每次调用都叠加延迟与成本,轻量任务可能得不偿失——可用蒸馏的专用小型 resident 模型、缓存与批处理缓解;论文已给出证据:GPT-OSS-20B 做常驻与诊断保留 95.1% 交付省 24% 成本、Sol 只做诊断省 37.4% 开销仅损 2.1pp,值得系统化为「模型-角色分配」的自动搜索。2) VERIFY 在缺硬检查器的领域依赖模型判断,HEART 结果验证有 8% 假通过率(精度 0.97/召回 0.96),错误反馈会误导修订——可引入多验证器投票与弃权机制。3) 库覆盖决定上限:CodeFace 对三个外部基准的目标模块仅覆盖 29.6–34.8%,剔除同仓供体后 LEGO 从 0.5134 降到 0.4743——应强化自动挖掘+验证的入库管线,形成「任务越多库越强」的飞轮。4) 原语间消息 $m_{i\to j}$ 的内容无人把关,坏消息会沿依赖边传播;HERMES 去掉消息在整仓迁移掉 7.5pp,既反证其重要性,也提示需要消息校验原语或可信通道。5) COMPOSE 目前多为提示驱动的 LLM 决策(随机组合即退化:STITCH 随机组合 73.3%、Agent Primitives 随机结构 66.7%),说明选择本身承载增益,值得学习化并做不确定性估计。6) 真实开放任务缺乏有效原语:heelo.dev 的 lead discovery 所有臂 ≤20%、Codex 漏斗计算漏报小样本警告,需要 web 级长程探索与「知道何时报告不确定性」的原语族。
未来方向
作者提出的延伸:任何新任务类型都可作为新的原语族接入 HEELO,只要实现同一组定义与三机制;heelo.dev 作为平台持续扩充真实动作原语(航班、日历、邮件、社交、爬虫、发票等)并把验证-发布通道跑成常态。基于成果可再延伸:把 COMPOSE 从提示决策升级为可学习的组合策略,并研究原语间非加性协同/冲突下的组合理论(现有命题假设加性增益);为原语间消息设计标准化协议与校验机制,类比 MCP 之于工具调用;把 VALIDATE 扩展到统计性验证(多开发任务匹配运行的显著性检验),降低「开发任务调 scope」的选择偏差;探索更小的 resident 模型与端侧部署,把「强模型协调、小模型执行」的分配规律(诊断位受益最大)自动化;在对抗环境(AgentDojo 式提示注入)下检验消息通道与 KV cache 通信的安全性——论文自己展示了 KV cache 通道对注入的鲁棒性优势(73.3% vs 15.6%),值得系统化;以及跨组织共享原语库的生态问题:许可、审计、质量分层与恶意原语检测。
复现评估
数据层面友好:所用基准全部公开(ToolBench、NESTFUL、τ²-Bench、SWE-bench Verified、Terminal-Bench 2.0/4.0、DevOps-Gym、Putnam 2015–2025、IMO ProofBench、GAIA-Text-103 等),新提出的 LEGO-REPO 522 任务、82 个 Lean 可编译契约与 heelo.dev 平台(公开网站、提供 MCP 接入)理论上可重建。代码层面不确定:正文未见明确的开源仓库声明,八族实现细节在附录 B 且部分依赖内部工程,需按附录逐族重建。算力与成本门槛高:大量实验依赖 GPT-5.6 系列、Claude Opus/Claude-4.6 等专有模型 API,开源侧需 Qwen3-8B、Llama-3-70B、DeepSeek 系列的多卡推理;按文中单价,HERMES 跑一次 SWE-bench Verified 全量约每实例 $0.1–4.5,Terminal-Bench 4.0 一次全评 $0.7k–10.1k,复现全部 26 组对照开销可观。总体难度中等偏高:单族(如全 Qwen3-8B 的 HEART,或组件用 Qwen3-8B 的 ANTMAN-H)可低成本复刻「常驻 LLM + 证据修订」的核心机制并验证思想,完整框架的忠实复现则需较强工程能力与预算。
论文图表