HERMES:基于模块化可执行开发原语的软件工程线束工程框架 Harness Engineering for Software Engineering via Modular Executable Dev-Primitives
让仓库组件自带LLM主动推理与通信,按需激活与缺陷诊断驱动迭代修复,平均提升12.4个百分点
前置知识
智能体线束(Agent Harness)
线束是包裹 LLM 的执行框架,涵盖动作循环、工具接口、上下文管理、反馈与终止规则等系统层设计。同一个模型搭配不同线束(如 mini-SWE-agent、Claude Code、Codex)在同一基准上成绩可相差十几个百分点,因此线束本身是被低估的性能杠杆。
本文标题的 Harness Engineering 即线束工程:HERMES 本身就是一个新线束,全部主实验采用同 backbone、只换线束的对照设计,理解这个概念才能读懂 Table 1-4 中 Δ 列的含义以及平均提升 12.4 个百分点这一结论的实验逻辑。
SWE-bench Verified
从 12 个流行 Python 开源仓库的真实 GitHub issue 中筛选、经人工验证的 500 个修复任务。agent 需在真实仓库快照上定位并修改代码,以 FAIL_TO_PASS 与 PASS_TO_PASS 测试是否通过来判定任务是否解决。
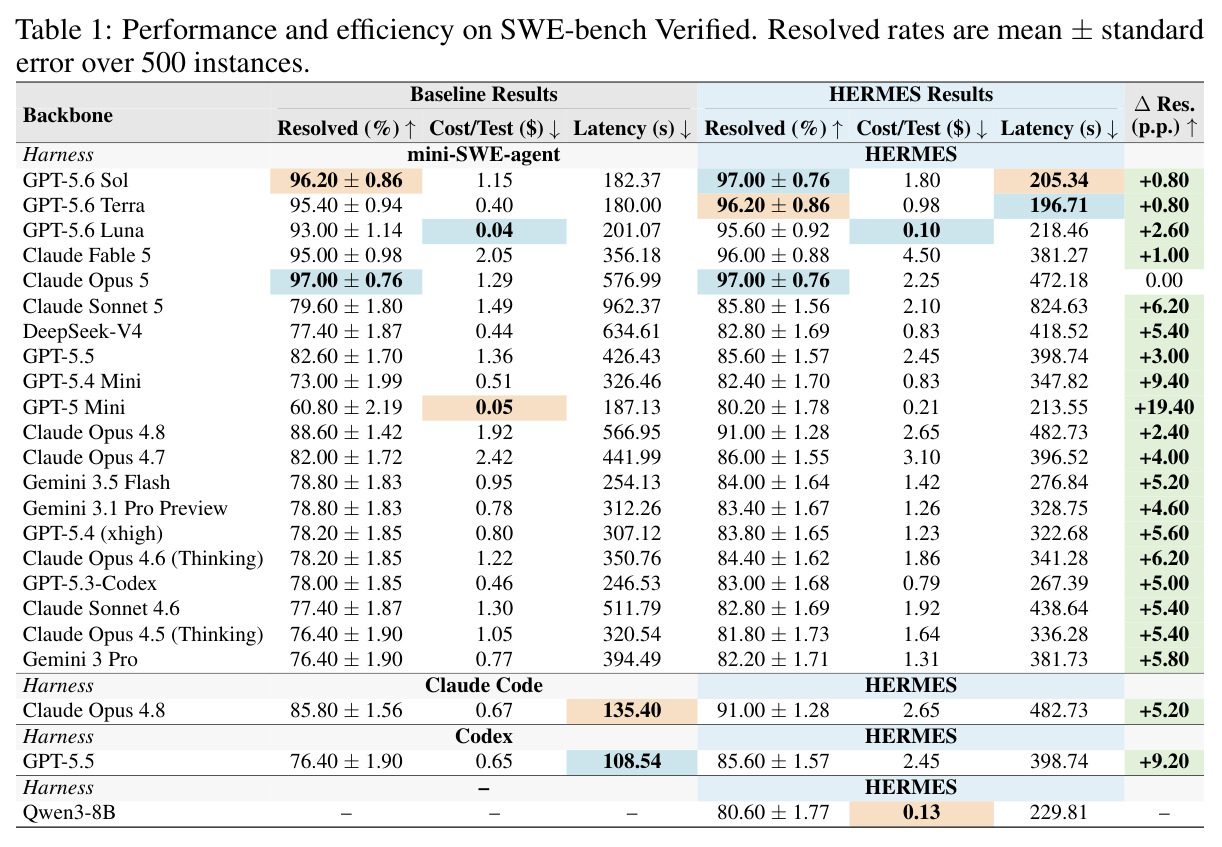
它是论文四大评测基准之首和 Table 1 的对象,文中大量数字(如 GPT-5.6 Sol 的 97.0%、GPT-5 Mini 的 +19.4)均出自此表,不了解其判定机制就无法评估这些结论的可信度。
上下文爆炸与语义漂移
长时程 agent 的交互历史按 append-only 方式不断增长,输入变长、注意力被稀释、成本攀升,称为上下文爆炸;对历史做有损压缩又会丢失关键约束,使后续推理逐渐偏离最初目标,称为语义漂移。二者是长时程智能体的公认瓶颈。
这是论文的问题出发点:程序状态散落在相互依赖的源文件、配置与测试中,反复重建状态的负担无法靠压缩消除,Dev-Primitive 把状态保存在组件侧正是针对这一瓶颈的架构级回答。
仓库依赖图(调用方/被调方)
代码组件通过函数调用、import、配置引用等形成依赖网络:修改某函数的接口时,其调用方、相关配置文件与测试往往需要同步更新。可以用静态分析构建,也可以由 LLM 阅读候选文件动态推断,节点是文件或符号,边是依赖关系。
HERMES 的动态激活沿依赖边从候选组件扩展到调用方、被调方、配置与测试;原语间定向通信的拓扑也由该结构诱导而非预先指定,是理解激活与协作两个核心机制的地基。
定向多智能体通信
多智能体系统中,消息可以全局广播给所有 agent,也可以定向发送给特定接收者。定向通信只把信息送给本地推理牵连到的组件,避免无关上下文污染与 token 浪费;消息进入接收方的通信上下文 $C_j$ 后可能触发其再次修改。
Dev-Primitive 之间采用定向自然语言消息且要求在协作轮终止前送达,使跨文件一致性在没有任何单一中心上下文的情况下达成;消融显示去掉通信后 SWE Refactor Bench 掉 7.5 个百分点。
研究动机
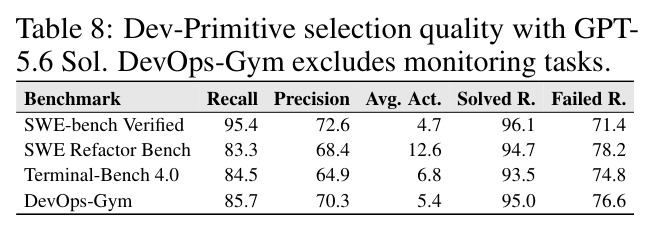
装备终端访问的 LLM agent(SWE-agent、OpenHands、Codex 等)在短任务上已很强,但在长时程工作流上依然脆弱,困难有两层。表层是交互历史 append-only 增长带来的上下文爆炸与语义漂移;更根本的是,相关程序状态散落在相互依赖的源文件、配置与测试中——修改一个文件的接口往往要求同步更新调用它的代码、控制它的配置和验证它的测试,而每次编辑又改变了仓库本身,agent 被迫反复重读受影响文件、重新推断连锁影响,这种负担任何历史压缩都无法消除。论文引用的评测显示了后果的严重性:在全仓库迁移任务上,520 次 agent run 中只有 5.4% 完成全部评估阶段(Hong et al., 2026);同时仓库动辄数千个组件,识别任务相关部分本身就很难。传统 issue 修复基准上强模型已接近饱和(GPT-5.6 Sol 在 SWE-bench Verified 上 96.2%),跨文件协调类任务才是真正的短板。
本文的目标是本文目标是回答一个自然的问题:与其要求一个中心 agent 反复重建分布式程序状态,能否让单个软件组件自己推理自身职责,并把相关信息直接传递给彼此?具体拆解为四点:其一,提出 Dev-Primitive 抽象,把仓库组件从被动 artifact 变成主动参与者,让组件级信息与推理留在拥有它的 artifact 附近,用自然语言解释请求、与其他组件协商接口与约束、必要时自我修改;其二,仓库可能含数千组件,全量实例化原语不可行,需要依赖感知的按需激活机制,使成本随任务相关组件数而非仓库规模增长;其三,执行只能报告仓库仍然失败,而不指出该改哪个组件,需要缺陷诊断机制把执行证据映射回被牵连的组件做靶向修订;其四,在覆盖 issue 修复、全仓库迁移、终端任务与 DevOps 工作流的四个基准上,用同 backbone 对照验证该线束的净增益,并量化各机制贡献与跨组件算力分配策略。
与已有工作不同的是,本文独特的切入角度是此前被忽视的维度:推理能力应该附着在哪个单元上。既有工作可分三类,均与此不同。第一类是多角色多智能体系统(MAGIS、CodeTeam、Coder 等):manager、文件级 developer 等角色及它们之间的通信路径由设计者预先固定,中心协调者必须重建并中转所有组件状态。第二类是可复用原语与技能(Agent Primitives、Tool Primitives、CodeSkill 等):封装的是任务无关的可复用行为、推理过程或工具接口,不绑定任何具体代码。第三类是上下文管理(压缩、检索、仓库记忆):仍在单一中心轨迹内部腾挪。Dev-Primitive 反其道而行:原语集合由仓库自身诱导,身份由它拥有的 artifact 定义,需求沿依赖边定向流动,且随 artifact 一起演化;HERMES 再补上按需激活与证据驱动的靶向修订,使该抽象能在真实仓库规模上运转并控制成本。
核心方法
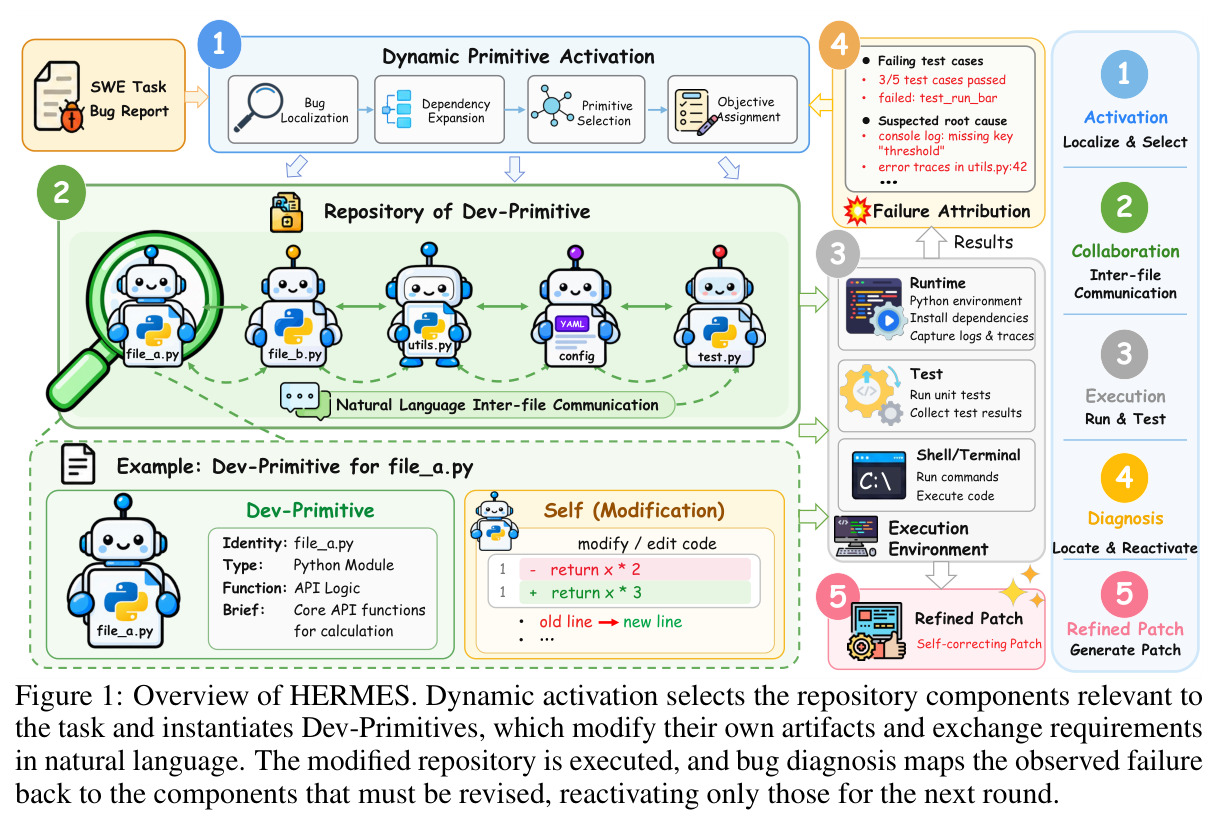
直觉版本:与其让一个中心 agent 把所有相关文件塞进上下文再逐个编辑,不如给每个文件配一个驻留 LLM——它读自己绑定的实现,理解自己的职责与依赖,用自然语言向相关组件提出接口与约束要求,并直接修改自己。技术路线:仓库 $R = \{a_i\}_{i=1}^N$ 的每个组件 $a_i$ 配一个 Dev-Primitive $P_i$,形式化为 $(a'_i, m_i) = P_i(a_i, x_i, C_i) = M([a_i; x_i; C_i])$,其中 $x_i$ 是激活模块分配的局部目标,$C_i$ 是来自其他原语的定向消息,$a'_i$ 是可选修改后的 artifact,$m_i$ 是发给其他组件的消息。在此之上,HERMES 增加两个由 LLM 调用链实现的机制:依赖感知的动态激活,产出计划 $\Pi = \{(i, x_i)\}_{i \in A}$,只实例化被选中的原语;缺陷诊断,把执行结果映射为 PASS/FAIL 判定与结构化反馈 $\phi = (e, c, u)$。整个系统按激活、协作、执行、诊断、修订的循环运转,默认修订预算 $B = 3$。
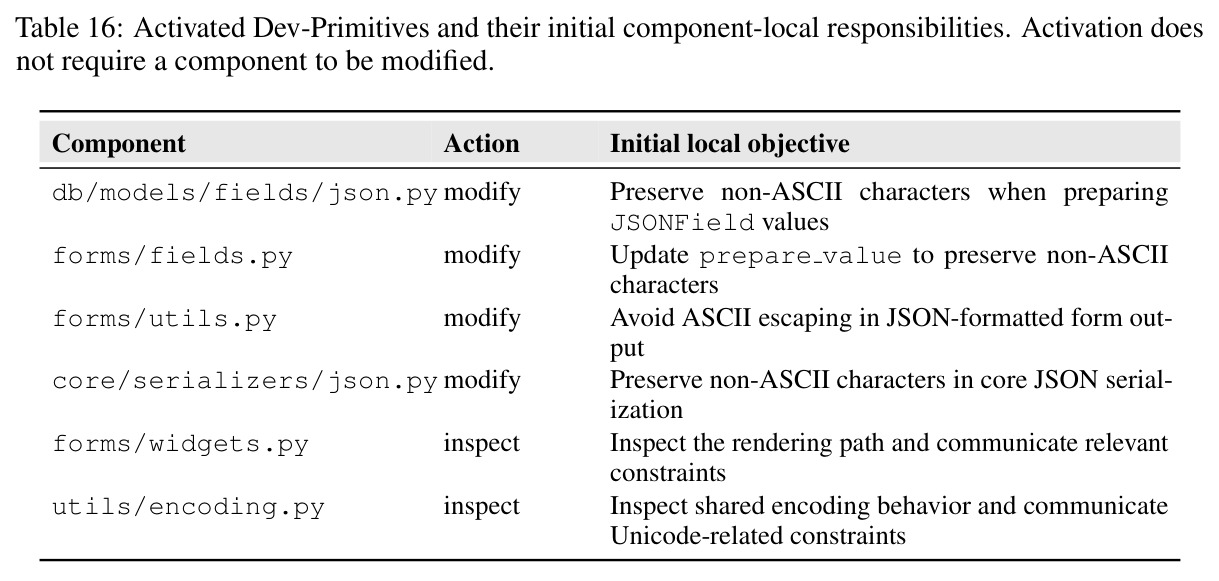
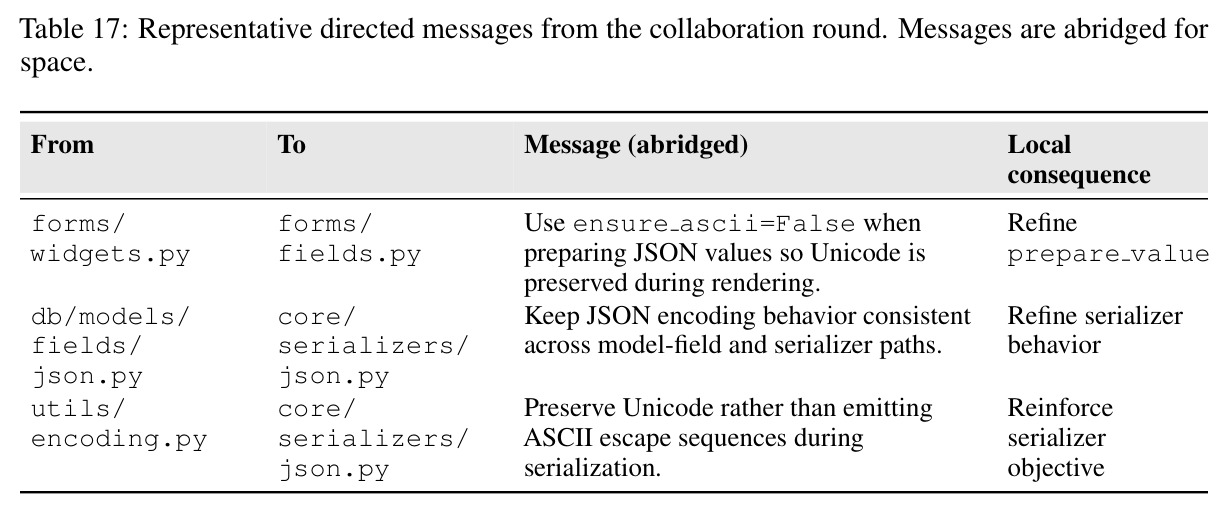
核心创新是把推理单元的选择权交给仓库结构本身,而非设计者。具体有三点本质区别。第一,原语身份由 artifact 定义:每个 $P_i$ 直接读取并只负责修改自己绑定的文件,组件级推理天然局部化,无需中心 agent 在单一上下文里拼装全局状态。第二,通信拓扑由依赖结构诱导:消息不是广播,而是只发给本地推理牵连到的调用方、被调方、配置和测试,且消息在协作轮终止前进入接收方的 $C_j$,接收方可在同一轮内修正自己的修改,跨文件一致性在没有任何单一上下文容纳所有被改组件的情况下达成。第三,参与不等于修改:原语可以只贡献信息而不改文件(案例中 6 个激活组件里 2 个仅 inspect),这使理解路径上的组件也能参与协调而不引入无关编辑。执行环境提供客观校验,诊断模块把仓库仍失败翻译成该改哪个组件,形成证据驱动的闭环。
方法步骤详情
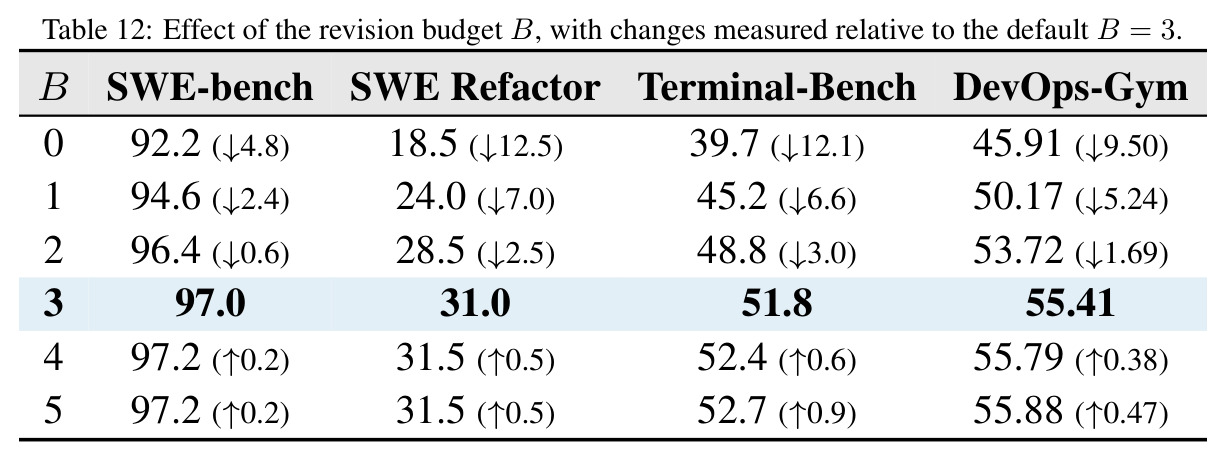
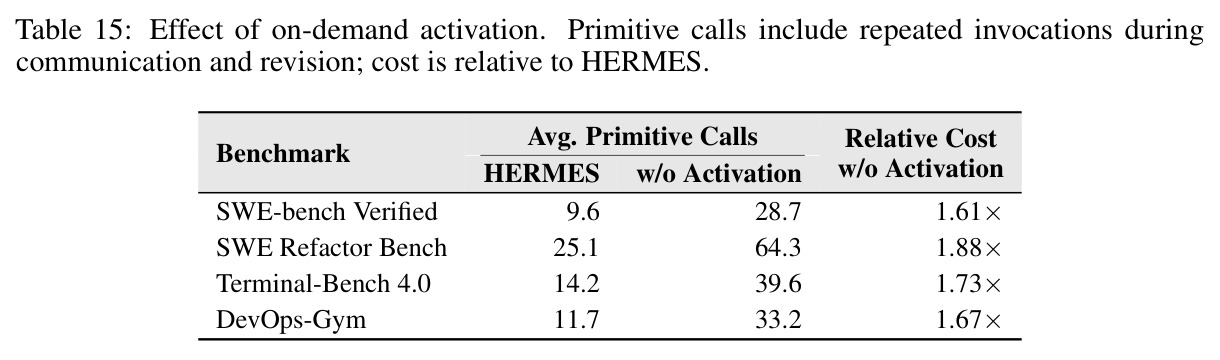
完整流程五步。第一步动态激活:激活模块对 issue $q$ 做问题分析、组件定位、依赖分析、任务分解与编辑规划,产出计划 $\Pi = \{(i, x_i)\}_{i \in A}$,只实例化被选中的原语集合 $P_A$,实测平均每任务激活 4.7-12.6 个组件而非全仓库;修订时改用 $\Pi' = \mathrm{ACTIVATE}(q, R', \Pi, \phi)$,可调整目标、增删组件。第二步协作:每个原语收到目标 $x_i$ 与收件消息 $C_i$,本地推理后输出修改后的 artifact $a'_i$ 与定向消息 $m_i$(接口变化、依赖更新、配置约束、测试要求),消息轮内送达、接收方可再修正。第三步执行:$o = \mathrm{EXECUTE}(R')$ 收集 shell 输出、测试结果、运行时异常与堆栈,held-out 评测测试求解期间不可见。第四步诊断:$v = \mathrm{DIAGNOSE}(q, \Pi, R', o)$,失败时输出证据 $e$、疑似根因组件 $c$、修订指导 $u$,且不能推翻确定性执行失败。第五步修订:依据 $\phi$ 只重新激活被牵连的原语,成功修改保留;PASS 或预算 $B = 3$ 耗尽终止,新建持久文件也会注册为新原语。
技术新颖性
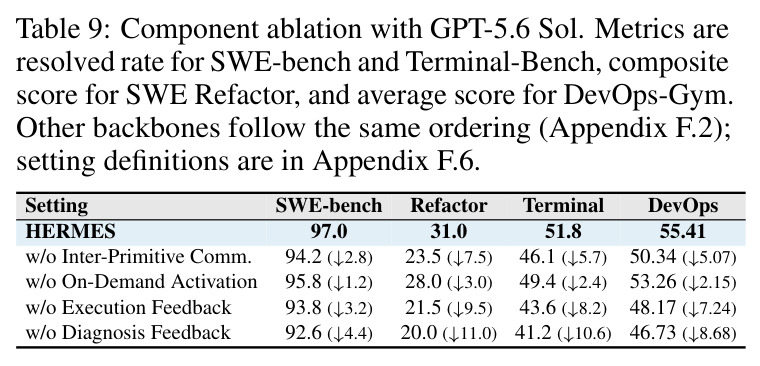
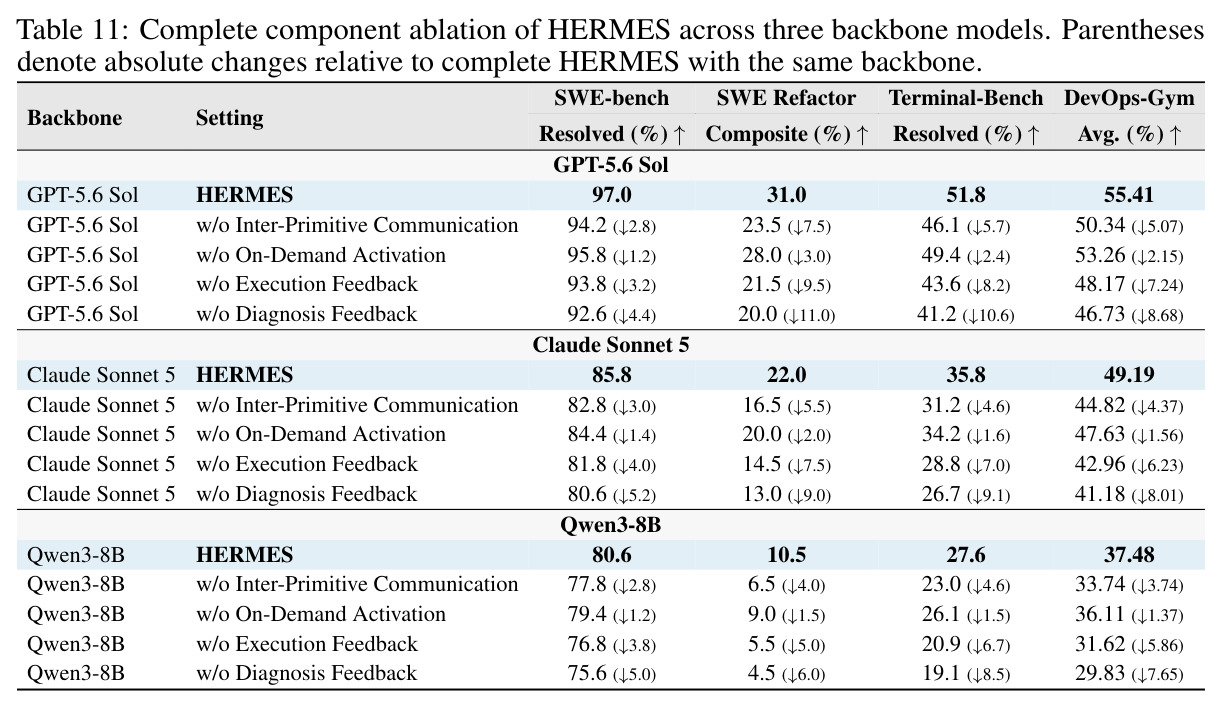
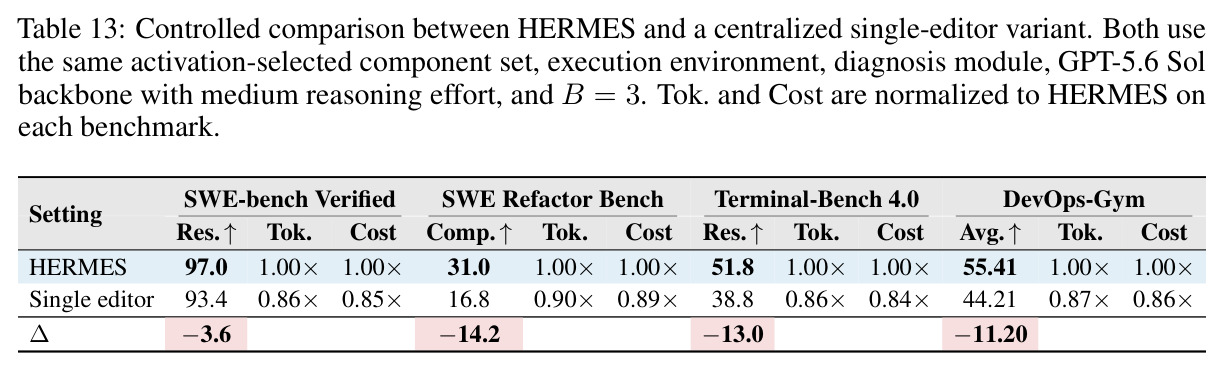
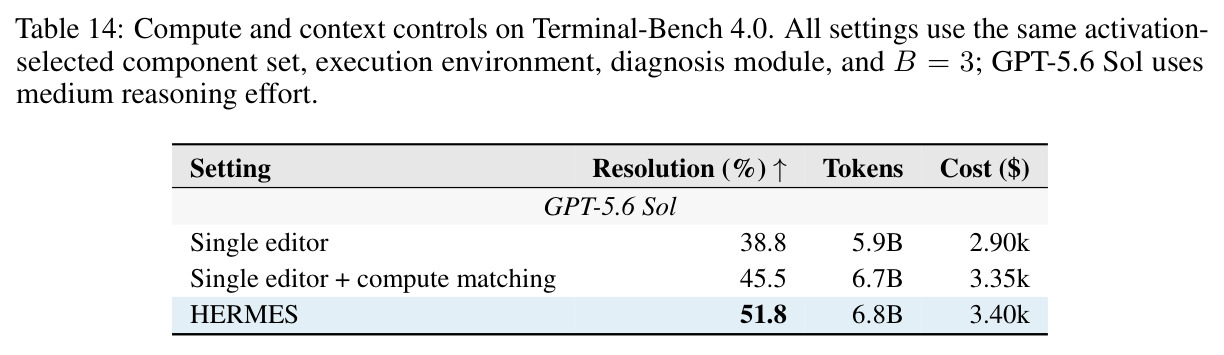
技术新颖性体现在三个对比面。相对多智能体 SWE 系统(MAGIS、CodeTeam、Coder):这些系统的角色划分与通信路径由设计者固定,中心管理器必须重建并中转所有组件状态;HERMES 无中心中转,通信边由仓库依赖实时诱导,消息也不经任何中央过滤改写。相对可复用原语类工作(Agent Primitives、Tool Primitives、AgentDistill、CodeSkill):它们封装任务无关的行为或工具、可在任务间迁移;Dev-Primitive 恰恰绑定特定可变 artifact 并随其演化,二者的模块化对象不同。相对上下文管理(压缩、检索、仓库记忆):那些方法在单一轨迹内部节省注意力,而 Dev-Primitive 把实现状态永久保存在拥有它的组件侧,只在需要协调时交换任务相关约束,从架构上消除反复重建状态这一负担。此外,诊断模块把失败归因组件化的设计与编辑局部化的抽象互为因果:正因为修改是 artifact 局部的,仓库级失败才必须路由回拥有者。消融证实换掉这一抽象(换成算力对齐的中心编辑器)仍差 6.3 个百分点。
实验结果
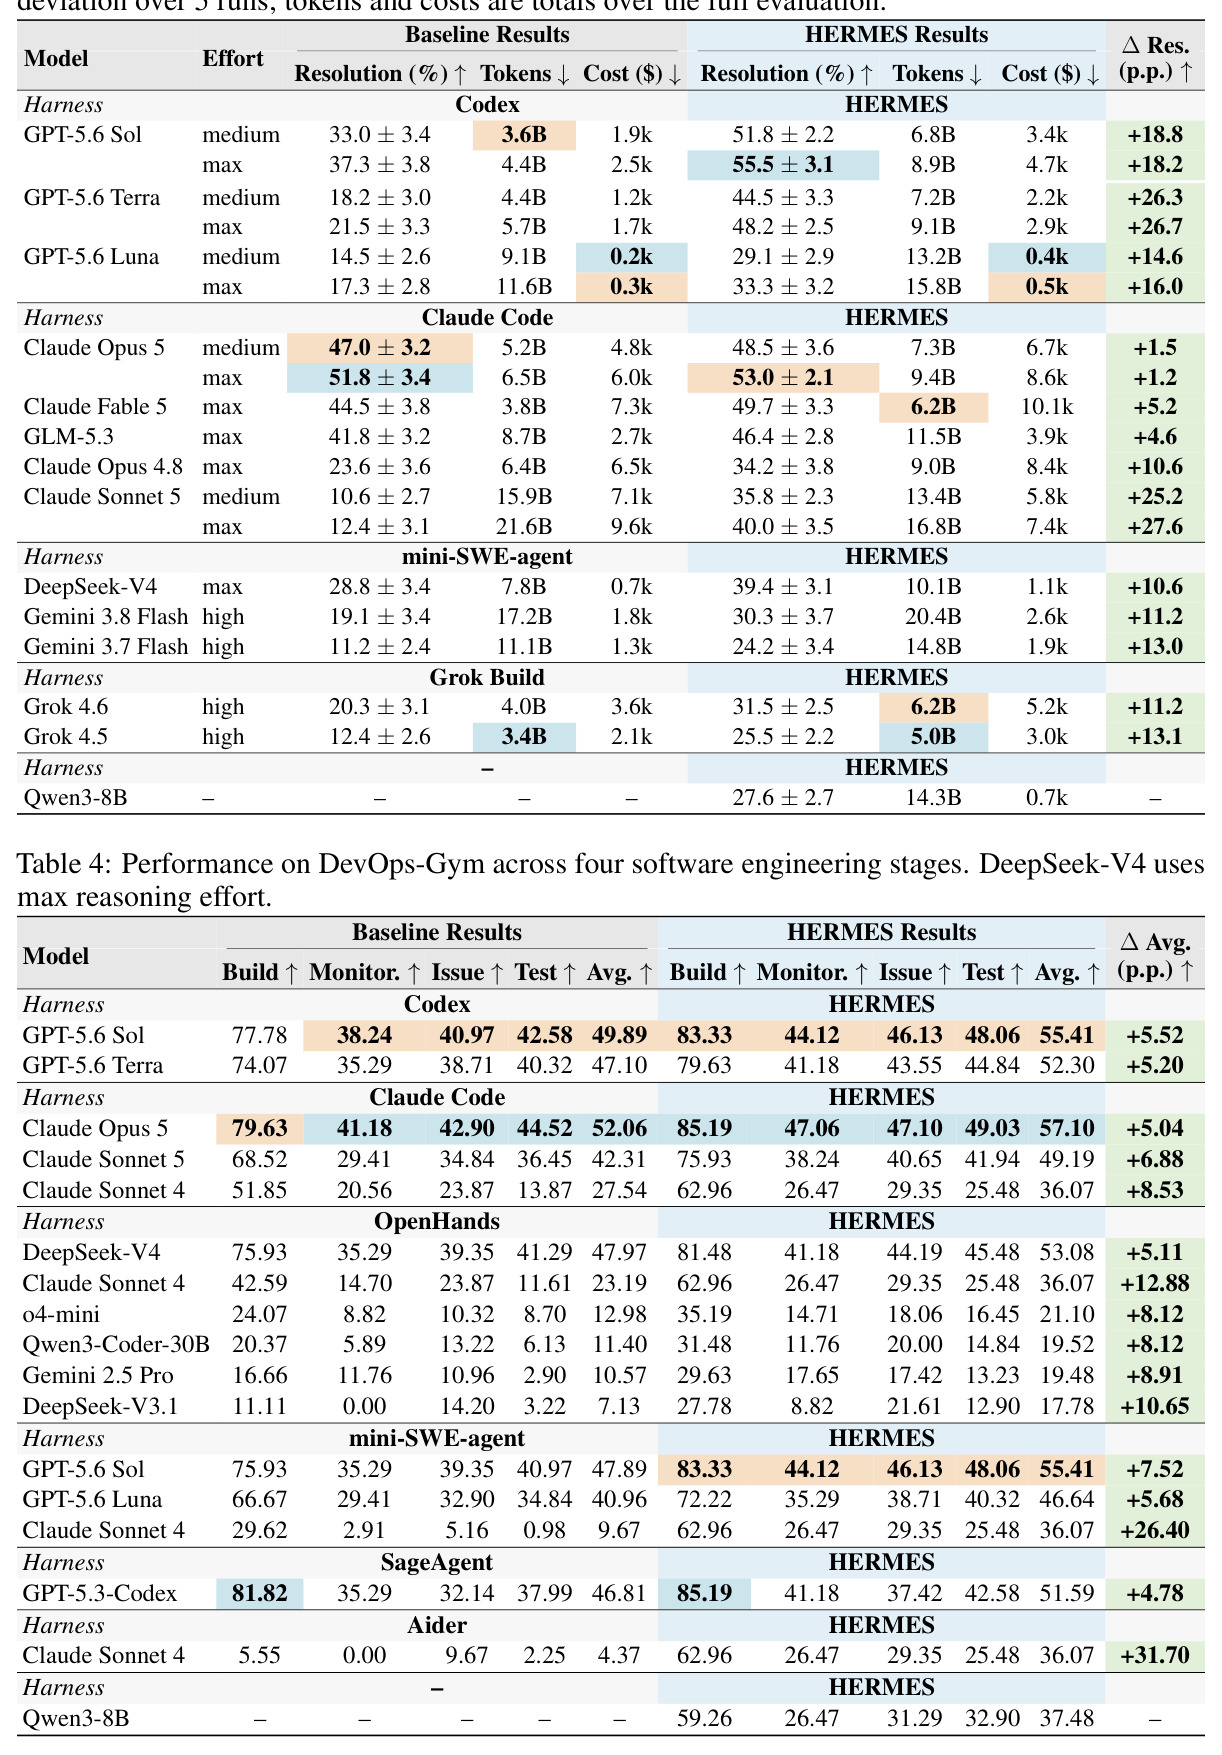
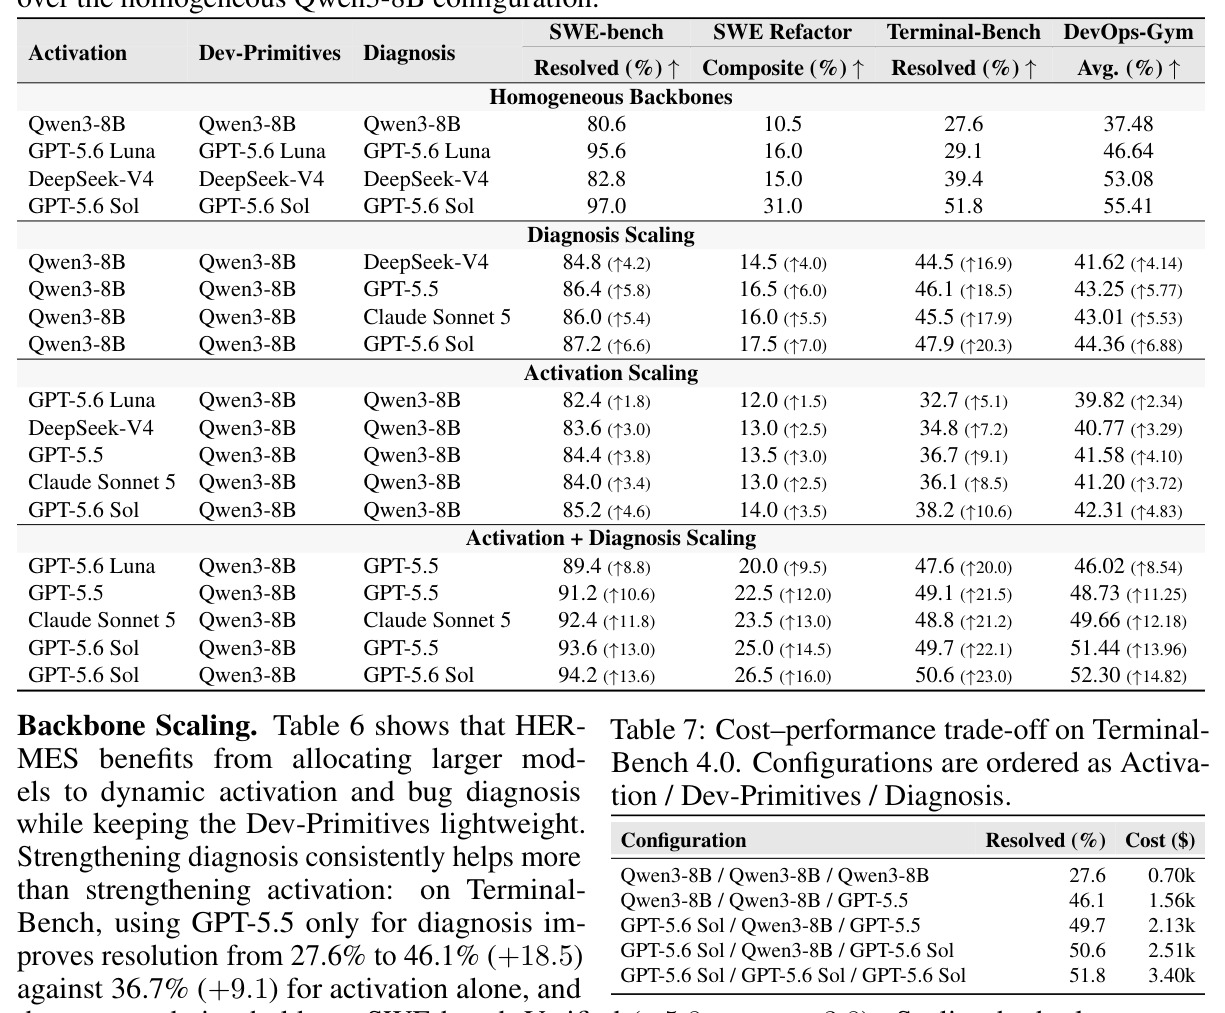
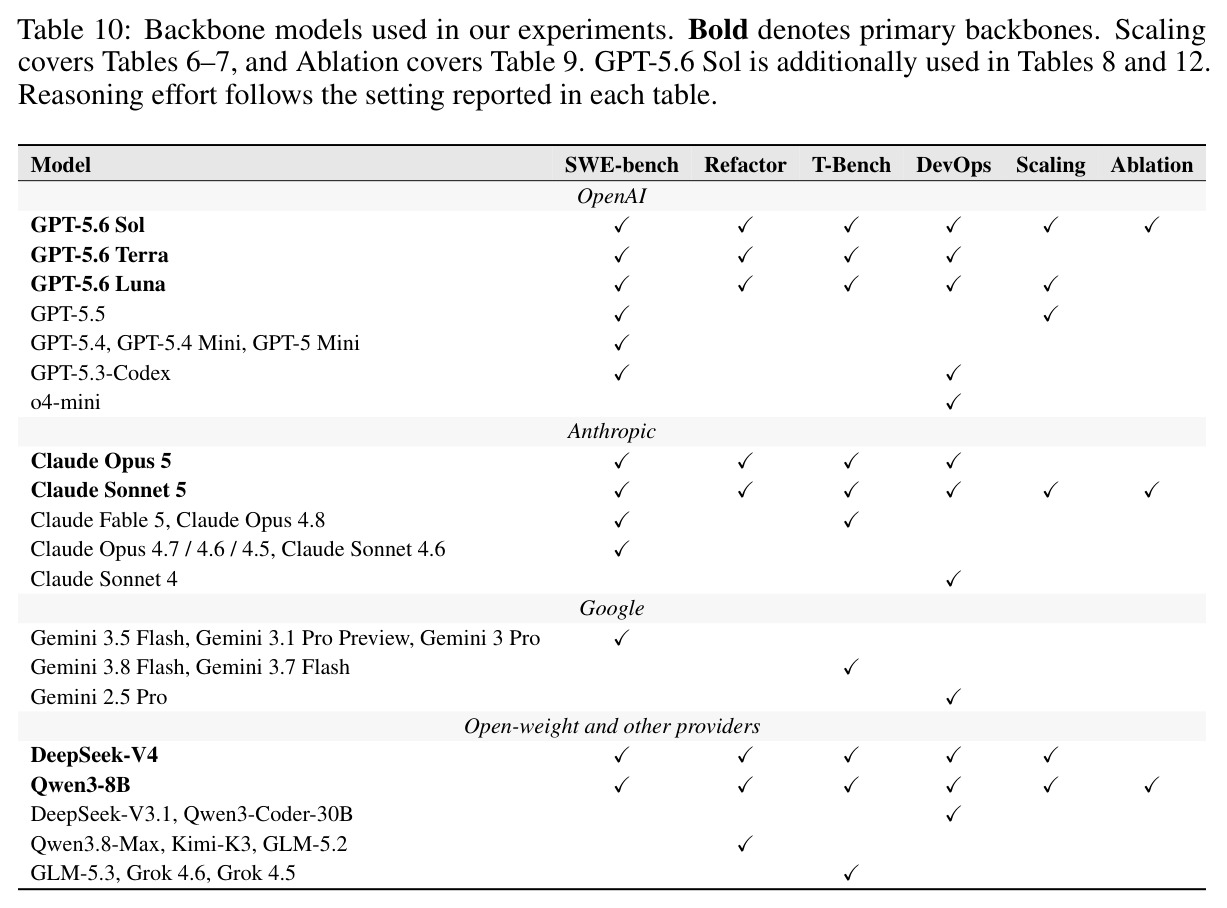
四大基准同 backbone 对照显示 HERMES 平均提升 12.4 个百分点。SWE-bench Verified(500 任务):20 个 backbone 中 19 升 1 平,GPT-5.6 Sol 达 97.0%(mini-SWE-agent 96.2%),GPT-5 Mini 增益最大 +19.4(60.8%→80.2%),Claude Sonnet 5 +6.2 且延迟反降(962.37s→824.63s),Qwen3-8B 达 80.6%。SWE Refactor Bench(20 个全仓库迁移)增益最大:GPT-5.6 Sol medium 6.5%→31.0%(+24.5)、high 19.0%→36.5%(+17.5),Luna 0.0%→16.0%,三次重复 31.0±1.3。Terminal-Bench 4.0(66 任务×5 次):Sol 33.0%→51.8%(+18.8),Terra +26.3/+26.7,Claude Sonnet 5 +25.2/+27.6 且 token 与成本同降。DevOps-Gym:Sol 49.89%→55.41%(vs Codex),增益遍布四类任务。异构配置:原语固定 Qwen3-8B,Sol/Qwen3-8B/Sol 达 94.2/26.5/50.6/52.30,与全 Sol 差距 ≤4.5 个百分点,Terminal-Bench 成本降 26.2%;诊断的边际收益大于激活(Terminal-Bench +18.5 vs +9.1)。消融:换成中心编辑器伤害最大(Refactor −14.2、Terminal −13.0),算力对齐后仍差 6.3 个百分点;机制重要性为诊断>执行反馈>通信>按需激活,关闭按需激活成本升 1.61-1.88 倍。激活召回率 95.4/83.3/84.5/85.7%,solved 比 failed 高 16.5-24.7 个百分点;预算 0→3 贡献主要增益,3→5 最多 +0.9。案例 django-13512 激活 6 组件、15 条定向消息、4 文件引入 ensure_ascii=False,407 个回归测试通过、held-out 35 个全过,修复路径异于开发者补丁。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Verified(真实 GitHub issue 修复,500 任务) | Resolved 率 | GPT-5.6 Sol:97.0%;Qwen3-8B:80.6% | mini-SWE-agent 同模型 96.2%;GPT-5 Mini 基线 60.8% | 20 个 backbone 中 19 升 1 平,最大 +19.4 个百分点(GPT-5 Mini 60.8%→80.2%) |
| SWE Refactor Bench(20 个全仓库迁移任务) | Composite 综合分 | GPT-5.6 Sol medium:31.0%;high:36.5% | Codex 同配置 6.0%(medium)/ 19.0%(high) | +24.5 / +17.5 个百分点,为四基准中最大;三次重复 31.0±1.3 |
| Terminal-Bench 4.0(66 个终端任务 × 5 次运行) | Resolution 率 | GPT-5.6 Sol medium:51.8%;GPT-5.6 Terra medium:44.5% | Codex 同配置 33.0%;Codex Terra 18.2% | +18.8(Sol)/ +26.3(Terra);Claude Sonnet 5 +25.2 且 token 与成本同降 |
| DevOps-Gym(构建配置/监控/issue 处理/测试生成四类) | 四类成功率非加权平均 | GPT-5.6 Sol:55.41%;Qwen3-8B:37.48% | Codex 同模型 49.89%;Aider 的 Claude Sonnet 4 为 4.37% | +5.52 个百分点且增益分布于全部四类;vs Aider 提升 +31.70 |
| Terminal-Bench 4.0 异构算力分配(激活/原语/诊断) | Resolution 率 / 总推理成本 | Sol 激活 + Qwen3-8B 原语 + Sol 诊断:50.6%,$2.51k | 全 GPT-5.6 Sol 同构:51.8%,$3.40k | 仅低 1.2 个百分点而成本降 26.2%(GPT-5.5 诊断版降 37.4%,低 2.1 点) |
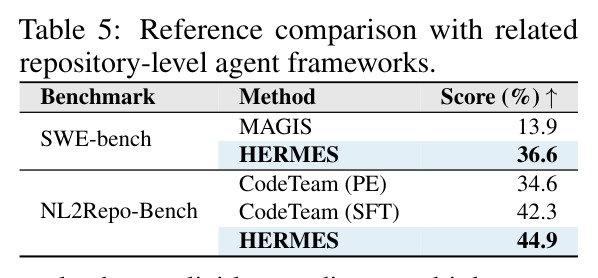
| NL2Repo-Bench / SWE-bench(与仓库级多智能体框架对比) | 平均测试通过率 / Resolved 率 | HERMES:44.9% / 36.6%(GPT-5.6 Luna) | CodeTeam SFT 42.3%;MAGIS 13.9% | +2.6 / +22.7 个百分点 |
局限与改进
作者在附录 I 承认:额外推理成本与延迟不可避免(多原语调用、执行与迭代诊断);在已饱和设置(最强 backbone + SWE-bench Verified)增益缩到统计噪声边缘(+0.8,标准误 ±0.86);性能依赖激活正确性与执行反馈质量,漏检依赖或稀疏运行时信号会限制恢复;文件是默认粒度;Qwen3-8B 走本地 Ollama(A40、32K 上下文)而其他模型走官方 API,部署差异可能影响结论。我的补充观察:基线数字部分取自排行榜、部分自行补跑,跨来源的协议对齐有固有不确定性;多数配置每 backbone 只跑一次(Terminal-Bench 5 次除外),小增益难以与噪声区分;SWE Refactor Bench 仅 20 任务,作者自认方差敏感(31.0±1.3);诊断可能在缺乏可靠任务特定信号时过早 PASS——案例中三次自动复现均失败仍判 PASS,虽 held-out 通过但含运气成分;峰值开销可观,如 Claude Fable 5 在 SWE-bench 上成本从 $2.05 涨到 $4.50。
独立分析的弱点
独立分析六点弱点。其一,成本与延迟显著上升:SWE-bench 上 GPT-5.6 Sol 每任务成本从 $1.15 升至 $1.80,Claude Fable 5 从 $2.05 升至 $4.50;方向是蒸馏专用小型诊断/激活模型并对消息与 artifact 做增量缓存。其二,激活精确率偏低(64.9%-72.6%):约三分之一激活组件与参考补丁无关,浪费调用并稀释通信;方向是置信度校准、激活预算约束或两阶段筛选。其三,诊断是单点故障:一次错误归因会把修订引向错误组件,且无机制保证归因正确;方向是多次采样投票、不确定性量化、把归因与 diff 级因果验证(如变异测试)结合。其四,文件粒度在超大文件上会撑爆小模型上下文(Qwen3-8B 仅 32K),在微小配置文件上又过度细分;方向是自适应粒度(函数/符号级切分与合并)。其五,通信只在已激活原语间流动,运行时才显现的动态耦合(反射调用、事件分发)无法被静态依赖扩展捕获;方向是把执行 trace 更系统地反馈进激活模块。其六,原语状态不跨任务持久,仓库级长期记忆(历史修复模式、项目约定)尚未利用。
未来方向
作者明确提出的方向:更细粒度的 primitive(函数/符号级)与更广泛的软件工程场景。基于成果可延伸的方向包括:其一,跨任务持久化原语状态,把当前版本 artifact 加通信上下文扩展为长期仓库记忆,使同一仓库的后续任务受益于历史修复与项目约定;其二,用 HERMES 产出的成功轨迹微调小型原语模型,形成数据飞轮,进一步压低 Qwen3-8B 量级原语的部署成本;其三,把激活建模为成本感知的序贯决策(何时值得再激活一个组件),可与 bandit 或强化学习方法结合;其四,通信协议从自由文本升级为带 schema 的结构化消息,便于跨仓库复用、审计与安全检查;其五,推广到多仓库/monorepo 跨服务修改、CI/CD 修复、基础设施即代码等真实 DevOps 场景(DevOps-Gym 已是雏形);其六,安全维度:多个 LLM 原语自动修改相互依赖的组件,引入的供应链与提示注入风险需要形式化审查;其七,与程序分析工具(静态调用图、类型检查器)深度融合,替代纯 LLM 的依赖扩展以提升激活精确率。
复现评估
复现材料相当完整:附录 B 给出各机制完整规格,附录 C 给出激活、原语、通信、诊断四套系统 prompt 全文,附录 D 给出伪代码,附录 E/F 给出模型部署、执行隔离与评测协议细节。Qwen3-8B 用 Ollama 部署在 NVIDIA A40 GPU(temperature 0.6、top-p 0.95、top-k 20、32K 上下文),可低成本复现异构实验的原语部分;其余模型走官方 API,完整 Terminal-Bench 评测约 $0.7k-3.4k,SWE-bench 500 任务单配置约 $600-1000。注意事项:正文未提供开源代码链接,需自行实现 harness;基线部分取自排行榜、部分自行补跑,严格复现需对齐基准版本与协议;执行与评测隔离(held-out 测试对求解不可见)是实现正确性的关键,也最易做错。总体难度中等偏高:框架逻辑清晰、prompt 齐备,但多模型编排、并行执行与费用控制需要扎实工程;建议先在 SWE-bench 小规模子集上用 Qwen3-8B 全本地跑通,再逐步升级激活/诊断模型验证 Table 6 的 scaling 结论。
论文图表
SWE Refactor Bench 全部 20 个仓库迁移任务的综合分与成本对照。GPT-5.6 Sol medium 6.5%→31.0%(+24.5)、high 19.0%→36.5%(+17.5),GPT-5.6 Terra、Luna(medium 0.0%→16.0%)、Claude Opus 5(+8.0/+7.0)、Kimi-K3、DeepSeek-V4 等全线提升;Qwen3-8B 单列 10.5%。
展示 HERMES 增益最大的场景——需要跨文件协调的长时程迁移,直接支撑论文核心论点。
Terminal-Bench 4.0(66 任务×5 次)的分辨率率、总 token 与总成本对照(vs Codex、Claude Code、mini-SWE-agent、Grok Build)。GPT-5.6 Sol medium 33.0%→51.8%(+18.8)、max +18.2,Terra +26.3/+26.7,Claude Sonnet 5 +25.2/+27.6 且 token 从 15.9B/21.6B 降至 13.4B/16.8B、成本同步下降;Qwen3-8B 达 27.6%。
第二个核心基准,同时呈现性能、token 与成本的三角关系,包括反直觉的 Sonnet 5 性能成本双降案例。
跨组件算力分配:上块为同构 backbone(Qwen3-8B 全套 80.6/10.5/27.6/37.48,GPT-5.6 Sol 全套 97.0/31.0/51.8/55.41);下块固定原语为 Qwen3-8B,单独放大诊断(Terminal-Bench +16.9~+20.3)、放大激活(+5.1~+10.6)或两者(最高 94.2/26.5/50.6/52.30)。诊断的边际收益大于激活。
支撑异构部署这一最有实用价值的结论:小模型当原语、大模型当激活/诊断,四基准距全 Sol 配置 ≤4.5 个百分点。