Raven:可组合智能体的「Harness 之 Harness」开放生态系统 Raven: The Harness of Harnesses for Composable Agentic Intelligence
把模型与执行框架对封装为可组合单元,用主机智能体编排协作,靠进化、记忆与技能持续增强
前置知识
Agent Harness(智能体执行框架)
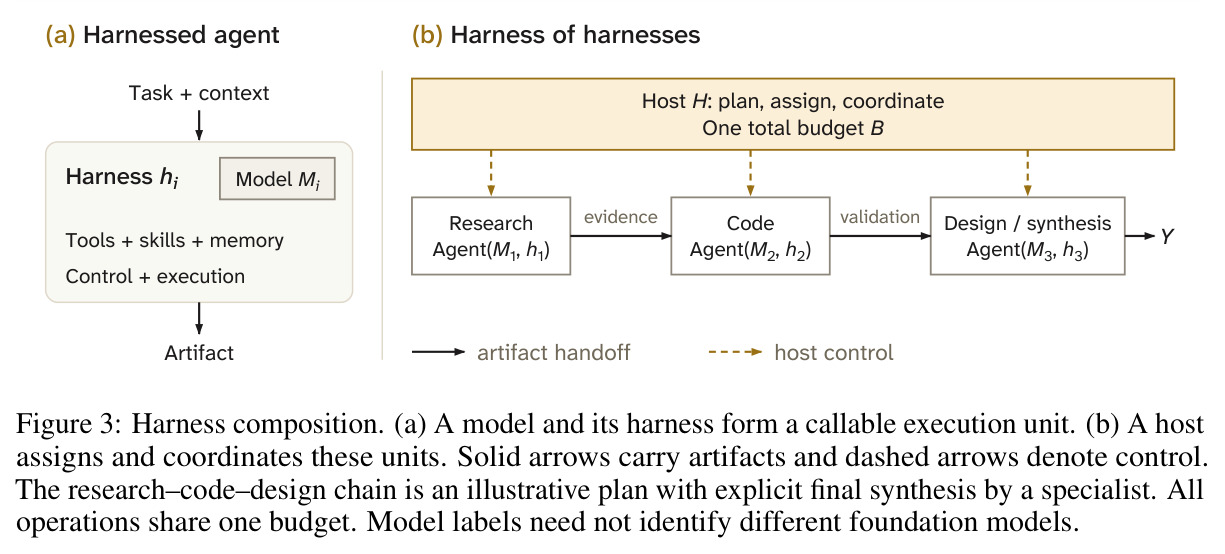
harness 是包裹在语言模型外围的整套执行策略,包括工具接口、上下文与记忆管理、技能库、控制规则(如迭代上限、完成判定)和失败恢复机制。同一个模型配不同 harness 会表现 出截然不同的任务能力,例如 SWE-agent 证明了”智能体—计算机接口”本身就是软件工程性能的决定因素。它把”模型会生成什么 token“与”系统如何把 token 变成有界任务执行”区分开来。
本文的标题'Raven: The Harness of Harnesses'直指这个概念:论文把每个可执行的模型–harness 对当作可组合的基本单元,全部五个组件(编排、进化、记忆、技能、理论)都围绕 harness 展开。不理解 harness 就无法理解论文要解决的核心问题——harness 复杂度上升导致手工设计无法扩展。
DAG 任务图编排
有向无环图(Directed Acyclic Graph)用节点表示子任务调用、有向边表示产出物(artifact)依赖:只有当某个节点的全部前驱完成并审定后,该节点才被调度执行。相比自由消息传递的多智能体对话(如 AutoGen),DAG 把协作结构变成可以先静态检查、再并发调度的显式对象,天然支持并行分支与汇聚点。
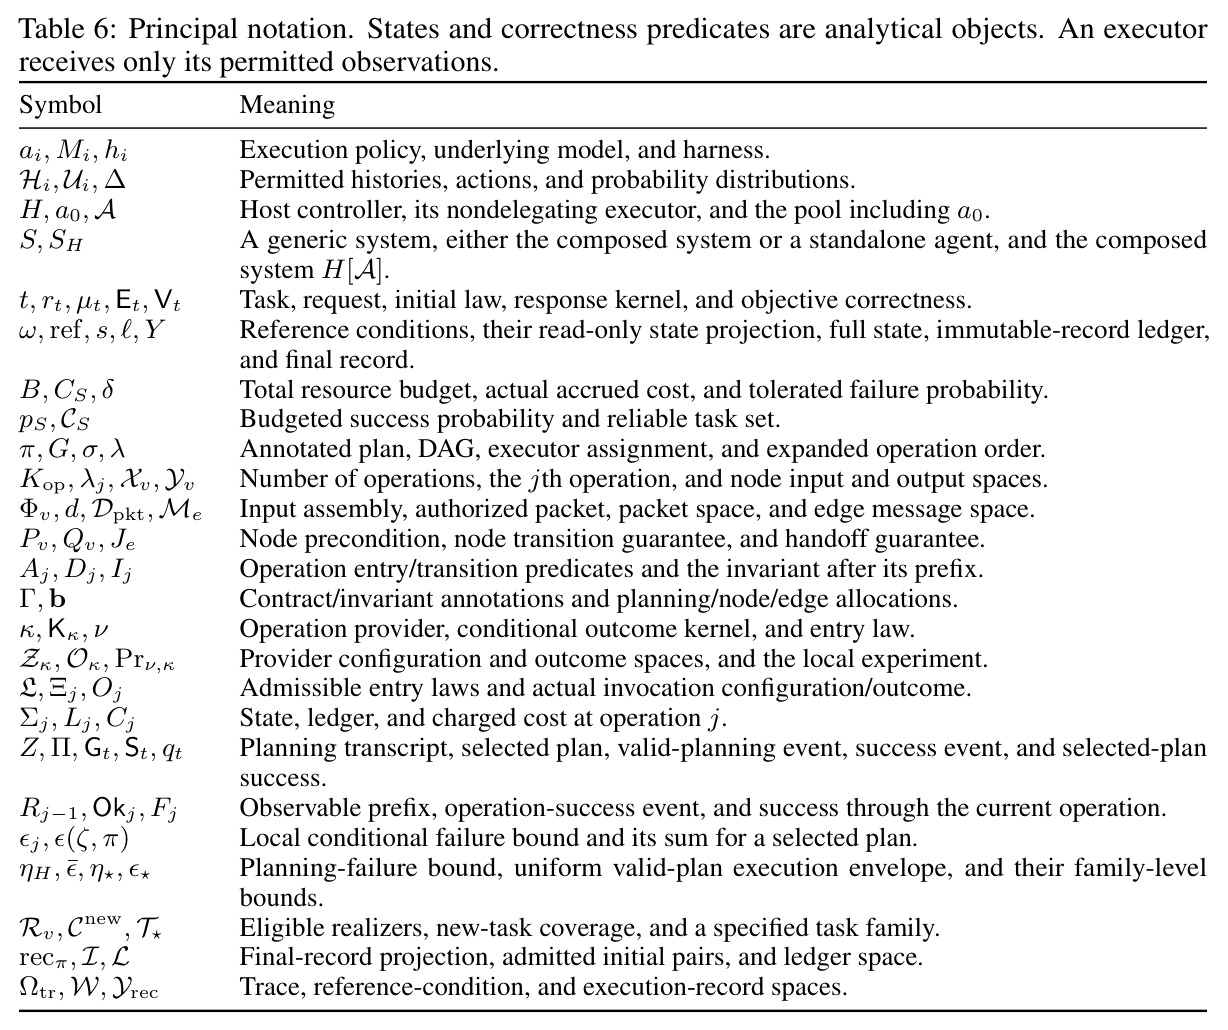
Host Agent 的核心职责就是把用户目标分解为一棵 DAG(公式 $\pi=(G,\sigma,\Phi,\Gamma,\lambda,b)$),节点绑定执行器与提示模板,边表达工件交接。论文的 MAOB 基准度量的正是'提出的 DAG 与参考 DAG 的一致性',Node F1、Edge F1、POA、Exact Match 四个指标全部定义在图上。
Hoare 逻辑式前后置断言
Hoare 逻辑是程序验证的经典框架,用前置断言 $P$、命令 $C$、后置断言 $Q$ 组成的三元组 $\{P\}C\{Q\}$ 推理程序正确性:若执行前 $P$ 成立且 $C$ 正常终止,则执行后 $Q$ 成立。把每步操作的含义用可检验的谓词固定下来,就能通过归纳把局部性质组合成全局保证。
论文第 2 章用这套语言定义'兼容计划'(Definition 1):每个操作有入口谓词 $A_j$ 与转移谓词 $D_j$,不变式 $I_j$ 逐操作传递(公式 (8)(9)(10)),最终推出交付记录满足任务判定 $V_t$。这是 Lemma 1(确定性组合可靠性)和 Theorem 1(概率可靠性下界)的推理骨架。
MAP-Elites 质量多样性搜索
MAP-Elites 是一种质量多样性(quality-diversity)算法:把解空间按行为/语义特征划分为若干'格'(cell),每个格只保留至今为止表现最好的一个精英解。它与只追求单一最优解的贪心搜索不同,能同时保留针对不同失败模式的多样化候选,供后续重组与回溯使用。
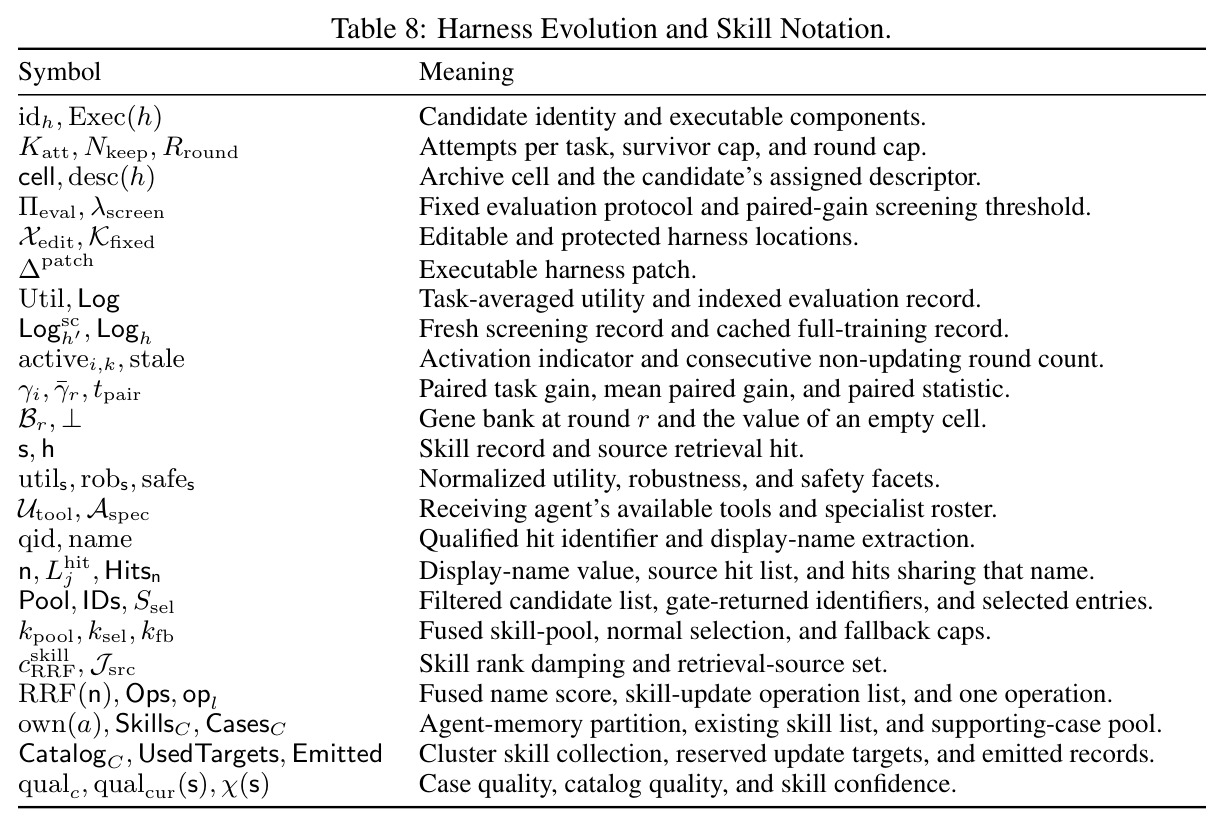
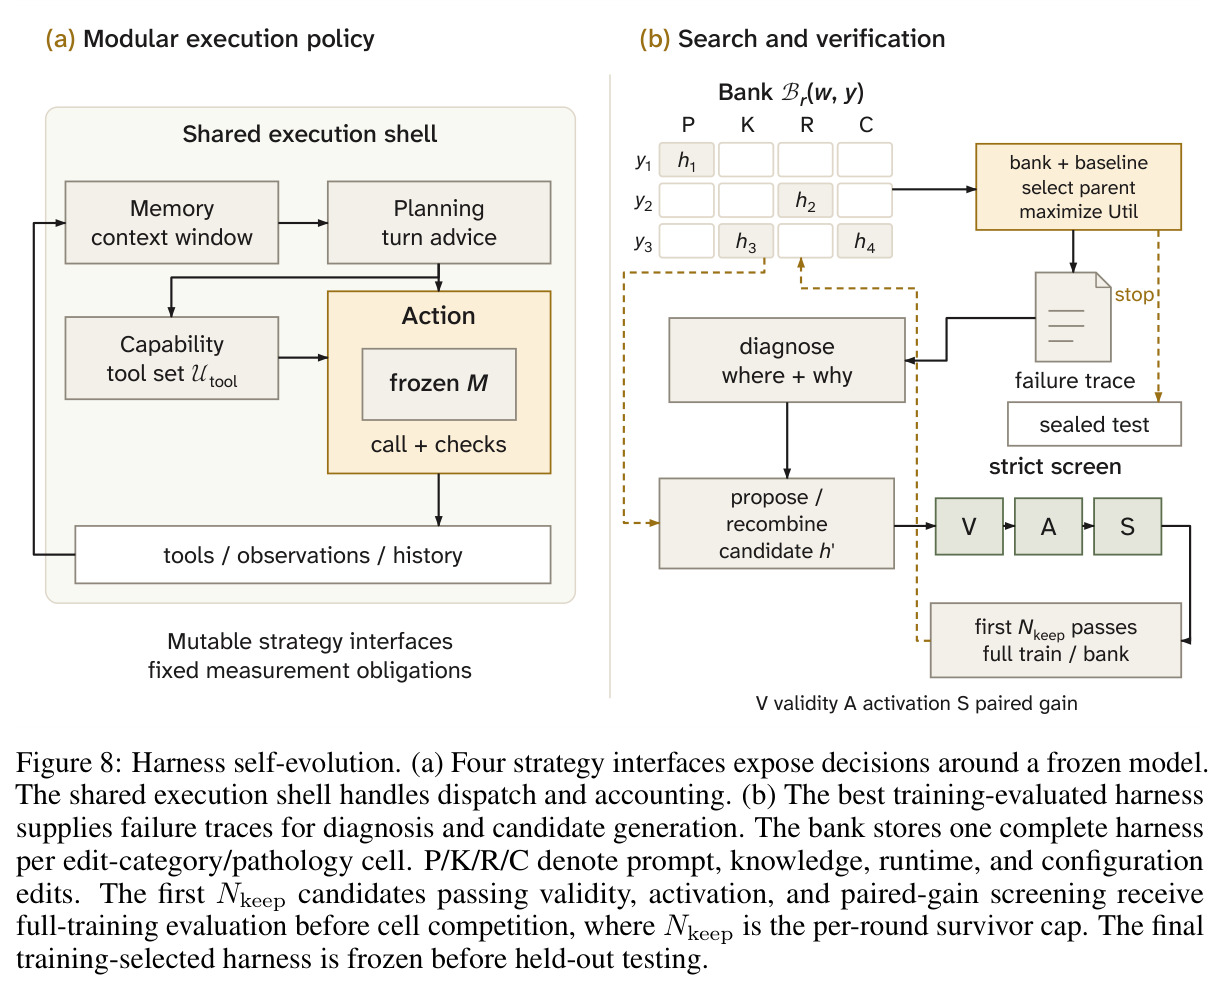
Harness 自进化的核心数据结构 Harness Gene Bank(公式 (45))就是 MAP-Elites 的应用:以'编辑类别(prompt/knowledge/runtime/config)× 病理标签'为语义格,每格保留一个完整 harness 及其评估日志,父代从全库最优中选取,候选可通过重组不同格的谱系产生。
混合检索与 RRF(倒数排名融合)
混合检索同时使用词法通道(BM25)与稠密向量通道召回文档;Reciprocal Rank Fusion 按 $RRF(i)=\sum_\ell 1/(c+\mathrm{rank}_\ell(i))$ 把多个通道的排名融合成单一顺序,避免不同打分尺度不可比的问题。融合只决定'扩展顺序',最终相关性由另一个校准分(如 logistic 回归)决定。
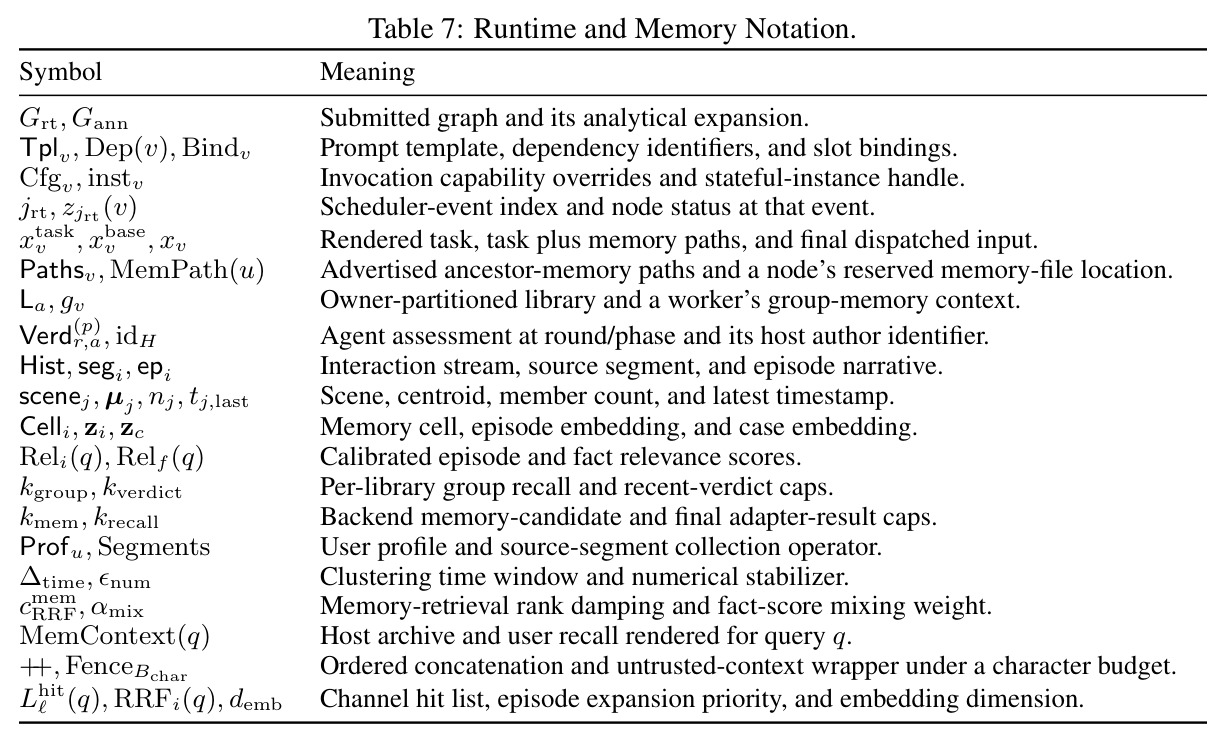
EverOS 的 HYBRID 用户记忆检索(Figure 10)与 Skill Forge 的三源技能融合(公式 (71))都建立在这套机制上:先按 RRF 决定 episode/技能名的扩展顺序,再让原子事实或具体技能体在有限候选集内竞争,最后恢复父上下文。理解 RRF 才能看懂论文为什么'先词法后稠密、事实可以顶替父节点'。
Pass@1 与配对增益检验
Pass@1 是单次尝试的通过率,智能体评测的常用指标。配对增益检验在同一批任务上比较新旧系统,以任务为单位计算增益 $\gamma_i$,再用配对 t 统计量 $t_{pair}=\bar\gamma/\hat\sigma_{\bar\gamma}$ 判断平均增益是否显著(本文用固定截断 $\lambda_{screen}=1.96$),可消除任务难度差异带来的方差。
本文几乎所有实验都用配对比较报告增益(如 Raven-Research 的 McNemar 检验、harness 进化的配对增益筛选门 $g_{sig}$),且把'任务'而非'任务×尝试'作为样本单位。读懂这些统计设定才能正确解读各表格中的 pp(百分点)提升及其可信度。
研究动机
随着 LLM 能力增强,智能体正从孤立的单领域任务走向长程、跨领域工作流,这暴露出两个相互纠缠的难题。其一是 harness 复杂度失控:harness 包含工具接口、上下文管理、技能、执行策略与恢复机制,支持的工具和执行条件越多,需要同时配置和验证的交互式设计选择就越多,手工开发难以跨模型、跨领域扩展。其二是专用 harness 的领域耦合:例如开发并运营一款 FPS 游戏需要需求调研、玩法编程、视觉设计、集成测试与持续运维,各阶段工具与完成标准不同,产出必须支撑后续阶段;而像 Claude Code 这样的专用智能体把对工具、工作环境和预期产出的假设编码进了自身,把它们的能力组合起来需要为子任务匹配合适的执行器并建立兼容的交接。多智能体失败分析(如 MAST 分类法)指出智能体间错位与任务验证不足是反复出现的问题。现有框架(AutoGen、MetaGPT)虽然在共享框架内组织角色分工,但角色由开发者配置在同一 harness 架构内;主机通过自由文本消息转发结果会消耗上下文、丢失细节,且没有显式工件引用,后续输出难以溯源。
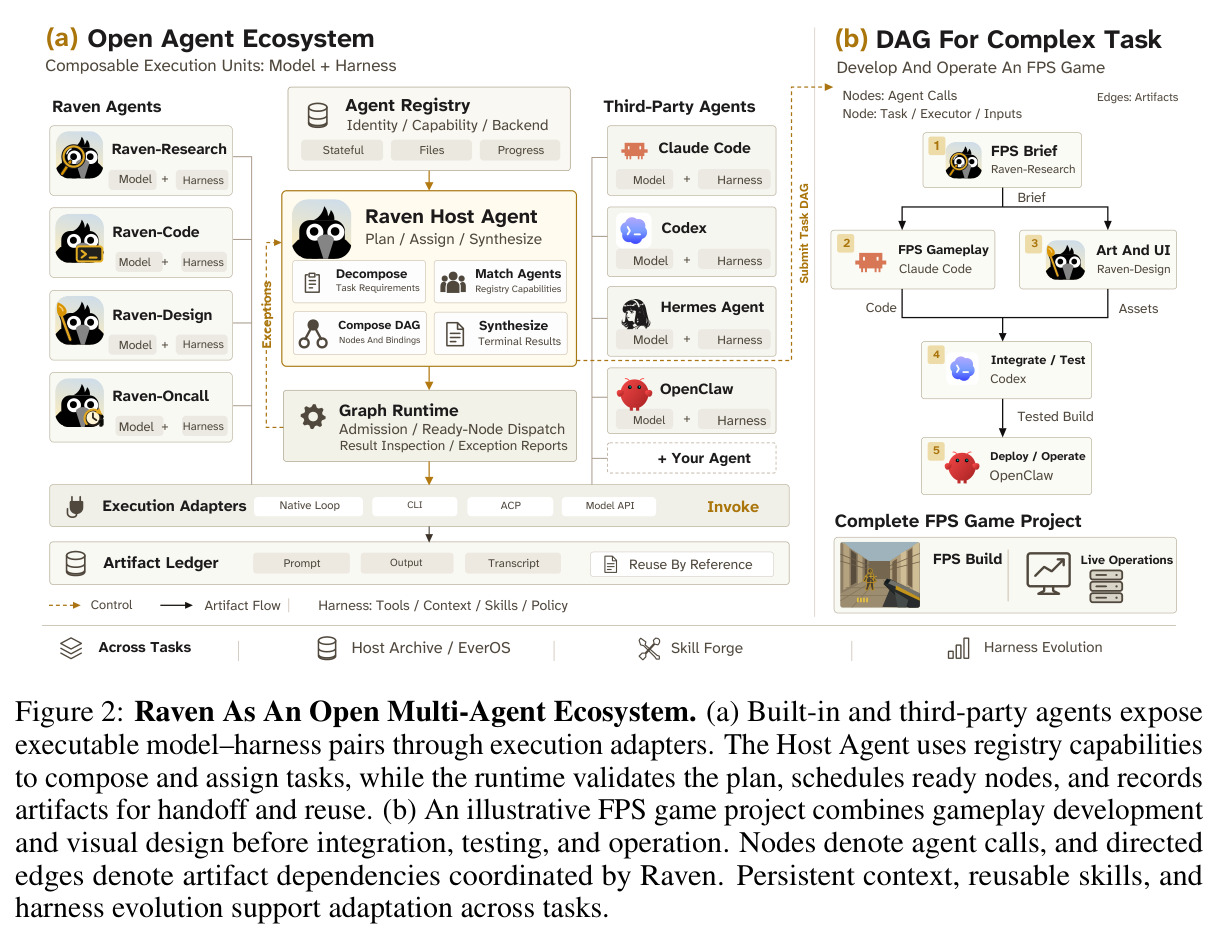
本文的目标是本文的目标是把问题的提法从'如何为某一领域工程化一个更强的 harness'转变为'如何自主构建专用 harness、通过经验改进它们、并跨领域编排它们'。具体而言,作者要交付一个开源多智能体生态系统 Raven:(1) 把每个可执行的模型–harness 对(内置的 Raven-Research/Raven-Code/Raven-Design/Raven-Oncall 以及 Claude Code、Codex、Hermes Agent、OpenClaw 等第三方智能体)封装为可组合的智能单元,通过执行适配器接入统一编排接口;(2) 由 Host Agent 分解目标、将子任务匹配到专家、以 DAG 表达执行依赖、协调执行并整合结果;(3) 用主机档案与 EverOS 记忆跨任务保留经验,用 Skill Forge 把经验变成可复用程序;(4) 给出理论,刻画在共享资源预算下组合何时能扩展可靠任务覆盖;(5) 提供新基准 MAOB 与覆盖研究、编码、设计、值守四大领域的实证评估。
与已有工作不同的是,本文的独特切入在于'元层'视角:不做单域 harness 的极限优化,也不训练更大的通用模型,而是把 harness 本身作为可组合、可进化的对象——'harness 之 harness'。与已有工作的本质差异有三点。第一,组合对象是真正异构的执行单元:AutoGen/MetaGPT 组合的是同一框架内的角色提示,而 Raven 通过执行适配器保留 Claude Code、Codex 等独立智能体的原生工具与内部策略,只统一交接协议。第二,协作从自由消息协议升级为带类型契约的工件交接:提交的 DAG 在任何 worker 启动前经过格式、图结构、能力、状态、环境五组校验,每次交接经过有记录的工件账本,配合 Hoare 风格的兼容计划定义,使'计划质量'可以在派发前独立度量——这正是他们新建 MAOB 基准的动机。第三,理论首次在共享预算约束下(把规划、协调、握手成本都计入 $C_S$)给出组合系统超越可用个体智能体的充分条件与显式构造,避免'加智能体必然更强'的错觉。
核心方法
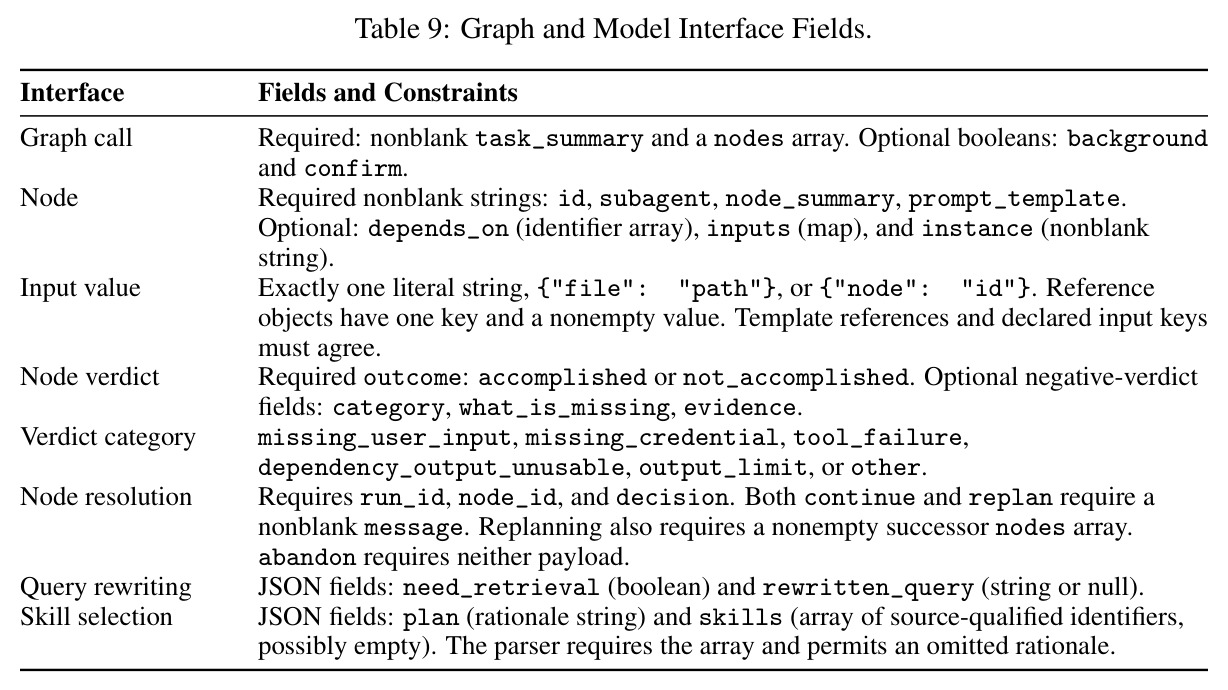
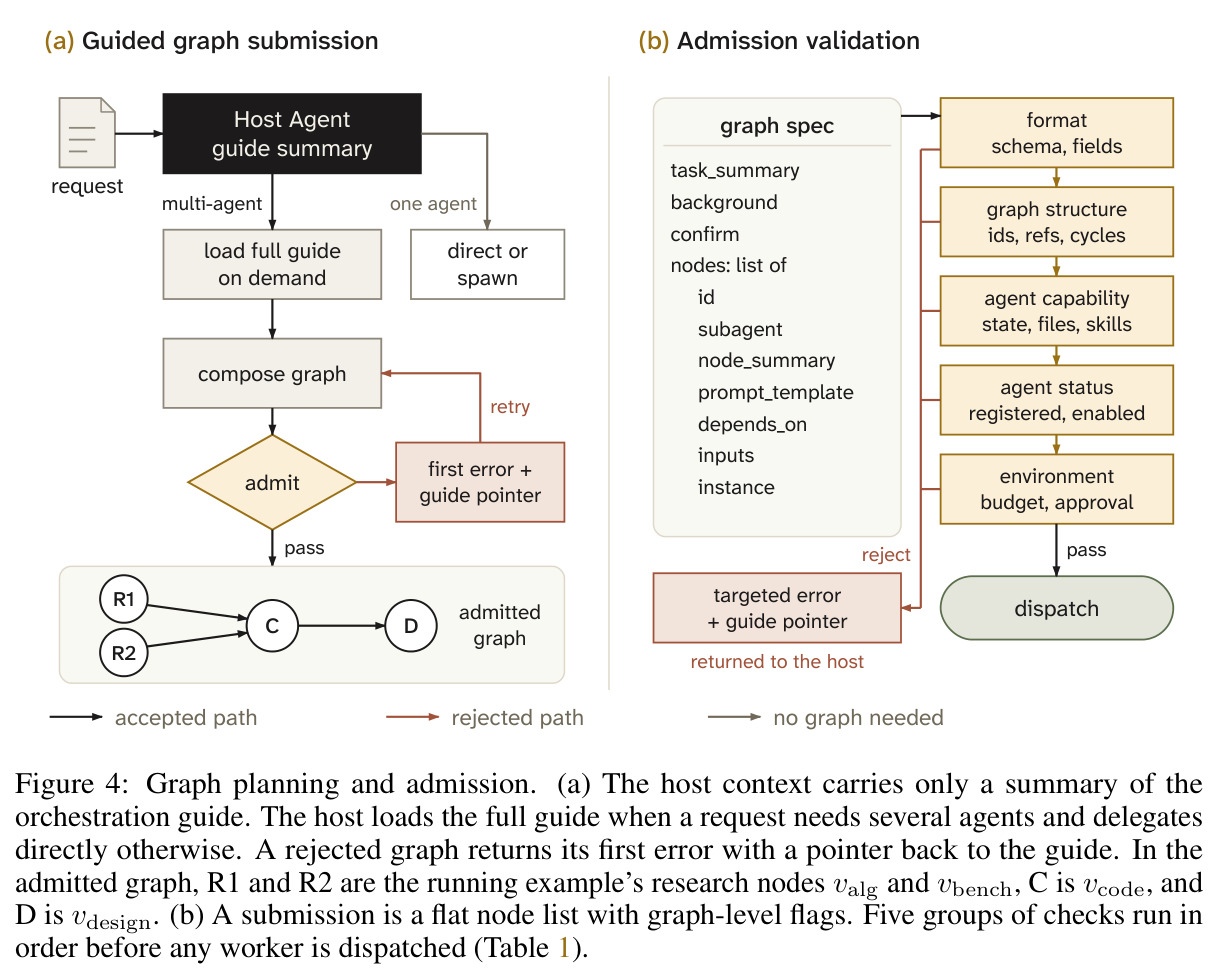
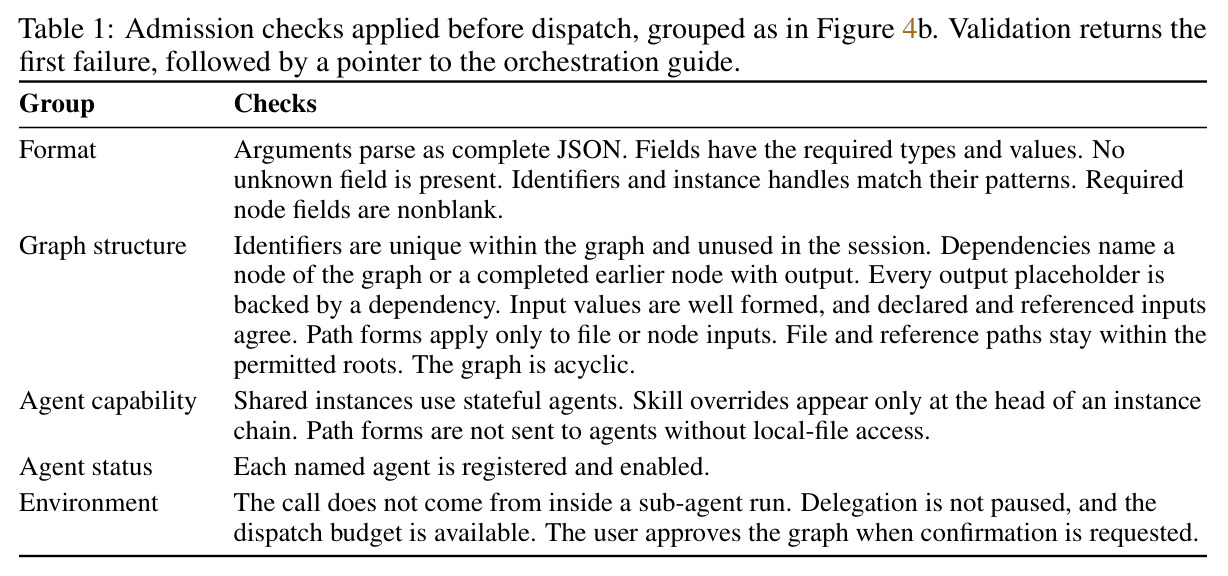
直觉上,一个团队的能力不是把最强的个人堆在一起,而是来自明确的分工、可靠的交接和可沉淀的经验,Raven 的五个组件正好对应这三件事。首先,异构智能体注册表把可用智能体标识为'注册名 + 能力描述',绑定四种执行后端之一(进程内 Raven 循环、命令行进程、ACP 连接、OpenAI 兼容模型 API),并记录三项约束规划的能力标签:有状态(可续接会话)、可读文件、可报告进度。其次,Host Agent 按需加载分阶段的编排指南,从交付物倒推构造类型化 DAG $\pi=(G,\sigma,\Phi,\Gamma,\lambda,b)$,节点记录 $n_v=(id_v,\sigma(v),Tpl_v,Dep(v),Bind_v,inst_v,Cfg_v)$,输入绑定把模板槽位接到字面量、文件或上游输出(如 $\{\{research\_alg.output\_path\}\}$ 以路径引用避免复述长报告)。第三,运行时在派发前执行五组准入检查(Table 1),执行时按依赖就绪集合(公式 (31))在共享并发信号量下调度,每个完成的节点经独立 LLM 完成裁定器判决,未通过则挂起为异常交主机决定继续、放弃或重规划。第四,harness 自进化围绕冻结模型暴露 Memory/Planning/Capability/Action 四个策略接口(公式 (39)),Evolver 智能体诊断失败轨迹、提出补丁,存入语义基因库并经三重门控筛选。第五,EverOS 记忆把交互流切成语义段,提炼情节、原子事实与带有效期的前瞻,在线聚类成 MemScene 并维护用户画像;Skill Forge 则从 96,401 个策展技能的 SkillHub、本地与记忆技能三源融合检索,并把执行案例增量进化为技能。
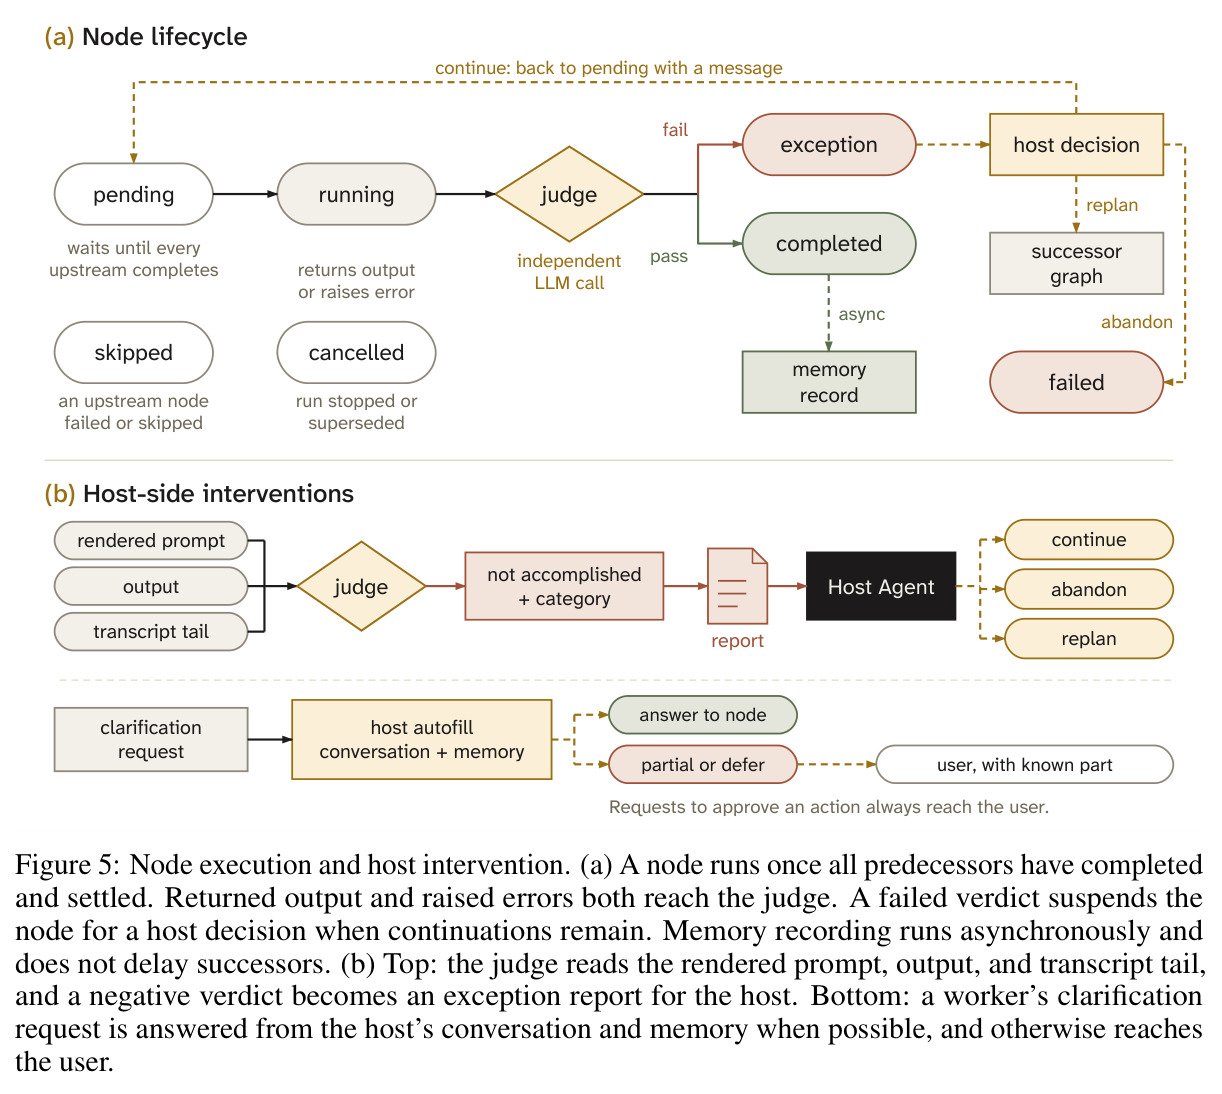
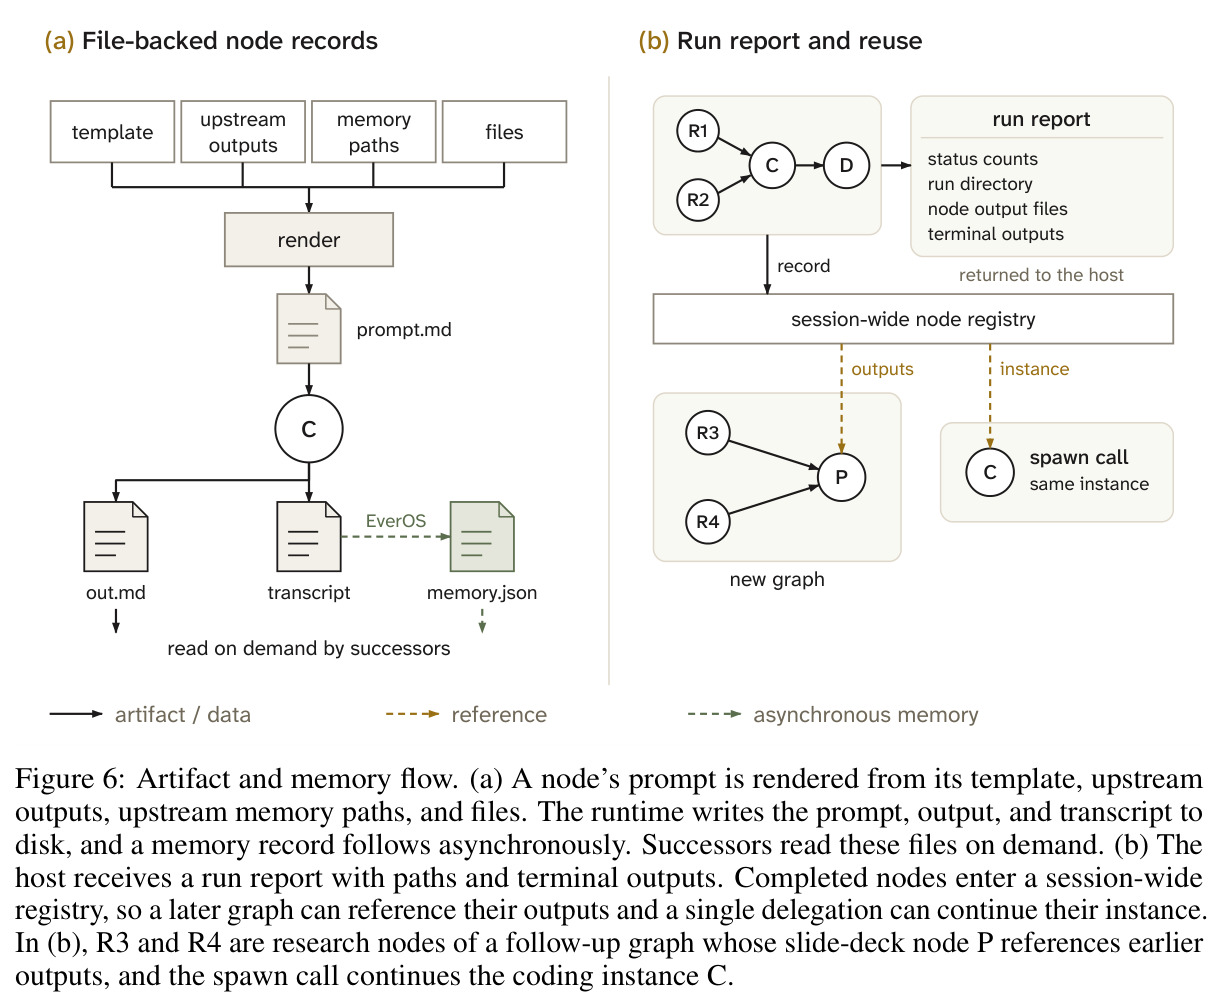
核心创新是'契约化编排 + 经验闭环'的组合,每一点都与已有方法有本质区别。第一,编排的不是角色而是异构执行单元:注册表只向 Host Agent 暴露能力标签,模型用当前上下文自行选择执行器,没有单独训练的路由分类器,也不假设先知式能力评分;第三方智能体保留其原生循环,只被要求通过统一接口提交可验证的产出。第二,交接从'复述'变为'引用':每个节点的提示、输出与转录先落盘(Figure 6),后继节点按路径按需读取,避免在主机和每个后继的提示里重复长工件,也保留来源溯源;依赖范围内的祖先记忆路径由运行时自动附加(公式 (32)),主机无需逐条复写。第三,完成与否由独立的模型裁定器判定而非执行者自报,负裁定必须给出类别(缺用户输入、缺凭证、工具失败、依赖输出不可用、输出截断)与证据,且'异常不传播'——失败节点只是挂起等主机修复,这与传统的失败级联截然不同。第四,理论上的关键一步是 Theorem 1 的可靠性下界 $q_t(\zeta,\pi)\ge[1-\epsilon(\zeta,\pi)]^+$:不需要任何独立性假设,只要每个操作在其调用语境下以 $1-\epsilon_j$ 概率实现契约,整棵 DAG 的条件成功概率就有该下界,且 Corollary 1 给出了超越所有个体的显式条件 $(1-\eta_H)(1-\bar\epsilon)\ge 1-\delta>\max_a p_a(t;B)$。
方法步骤详情
完整流程分五阶段(协作)加两条经验循环。阶段一(规划):主机每轮只携带编排指南的短摘要,判定需要多智能体时加载完整指南,从请求的交付物倒推添加节点与依赖;例如'AI for AI 综述+复现+网页'请求构造为 $\{v_{alg},v_{bench}\}\to v_{code}\to v_{design}$。阶段二(准入):按 Table 1 顺序做格式、图结构(唯一 id、可解析依赖、路径受限、无环)、能力(无文件能力的智能体不收路径引用)、状态(已注册且启用)、环境(禁止子智能体递归委派、派发预算、用户确认)五组检查,失败即返回首个错误并附指南指针,不启动任何 worker。阶段三(执行):就绪节点经共享并发信号量派发,提示由模板对授权包 $d$ 与上游输出 $y_u$ 渲染(公式 (30)),文件内容标记为不可信数据;后端返回或报错都交给独立裁定器,读渲染提示、输出与转录尾部,经受限工具回答 accomplished/not accomplished。阶段四(异常与澄清):挂起节点向主机发结构化异常报告(节点、类别、缺失条件、证据、被阻塞的后继、剩余尝试、决策期限),主机可附消息继续(有状态实例只收消息,无状态则收原提示+上次结果+消息)、放弃或以新 run id 重规划;worker 的澄清问题先由独立调用对照主机会话与 EverOS 记忆自动作答,绝不代替用户批准任何动作。阶段五(报告与复用):运行报告给出状态计数、各节点输出文件与终止输出,完成节点进入会话级注册表供后续图按引用复用,实例句柄跨 run 延续。经验循环一(进化,Algorithm 4):从基线 $h_0$ 出发,每轮选全训练效用最高的父代,诊断失败轨迹生成至多 $J$ 个提案(补丁+语义格+激活规范),在 $n$ 个抽样任务上过'有效日志→激活→配对增益 $t_{pair}\ge1.96$'三道门,幸存者跑全训练并按格竞争更新基因库。经验循环二(记忆与技能,Algorithm 5/6):完成的轮次异步写入 EverOS,情节聚类、画像更新;案例按意图嵌入聚类(阈值直并入/LLM 分派),质量达标的案例触发 LLM 生成 add/update 操作,经体长(≥5 非空行且 ≥50 字符)等校验后以 case 谱系写入 Markdown 技能,经级联索引供下次检索。
技术新颖性
技术新颖性体现在四个层面。其一,理论层的契约化组合分析是新的:把可组合智能形式化为'共享预算 $B$ 下的可靠任务覆盖' $p_S(t;B)=\Pr[V_t(\omega,Y_S)=1,\ C_S\le B]$,用类型化操作契约与 Hoare 断言证明确定性组合可靠性(Lemma 1),再在无需独立性假设的条件下得到 Theorem 1 与主机级 Proposition 1 $p_{S_H}(t;B)\ge(1-\eta_H)(1-\bar\epsilon)$;奇偶位构造(两个智能体各持一个比特、合成节点算异或,个体成功率 $\le 1/2$ 而组合为 1)给出了'互补局部能力'的显式见证,这类结果在多智能体文献中少见。其二,分阶段披露的编排指南:完整规则常驻上下文会为不需要编排的轮次白白付费,Raven 只在需要时装载并在每次拒绝时回传错误+指南指针,这是对'提示工程成本'的精细核算。其三,harness 进化把三件事分开验证:干预是否真的执行了(激活谓词)、在同批任务上是否配对变好($t\ge1.96$,以任务而非任务×尝试为样本单位)、选中后在冻结协议下的留出集表现,配合语义基因库的一格一精英,回应了 Darwin Gödel Machine 类自编辑的信用分配难题。其四,技能侧的'名字分组 RRF + 代表体选择'(公式 (71)(72))融合本地、记忆、SkillHub 三源排名而无需比较不同源的打分尺度,且策展(安全硬旗标、$safes\ge0.3$ 准入、1024 维嵌入去重阈值 0.995/0.90)与在线选择解耦,这些具体机制组合起来是本文独有的工程贡献。
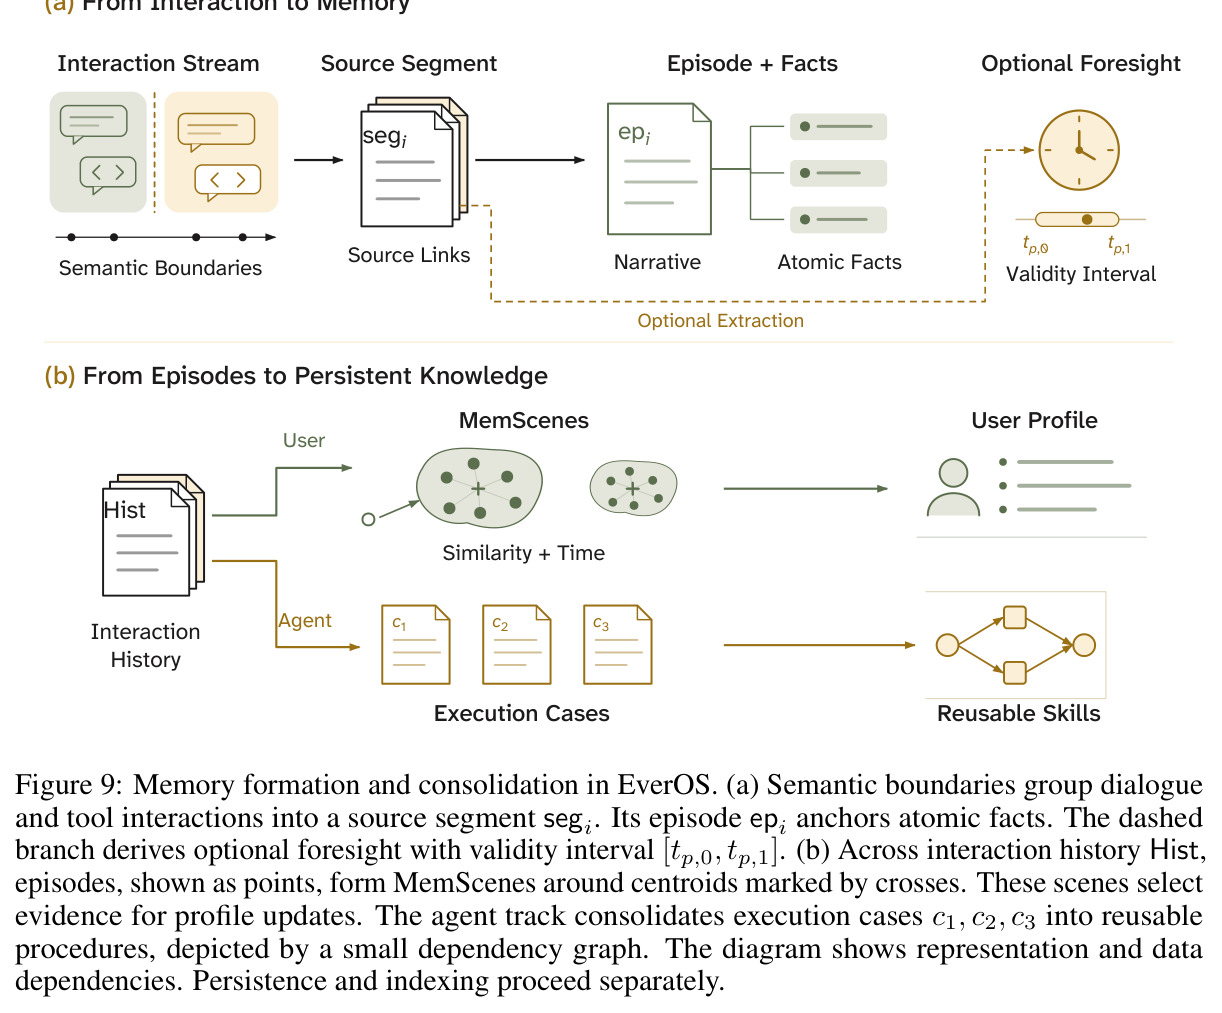
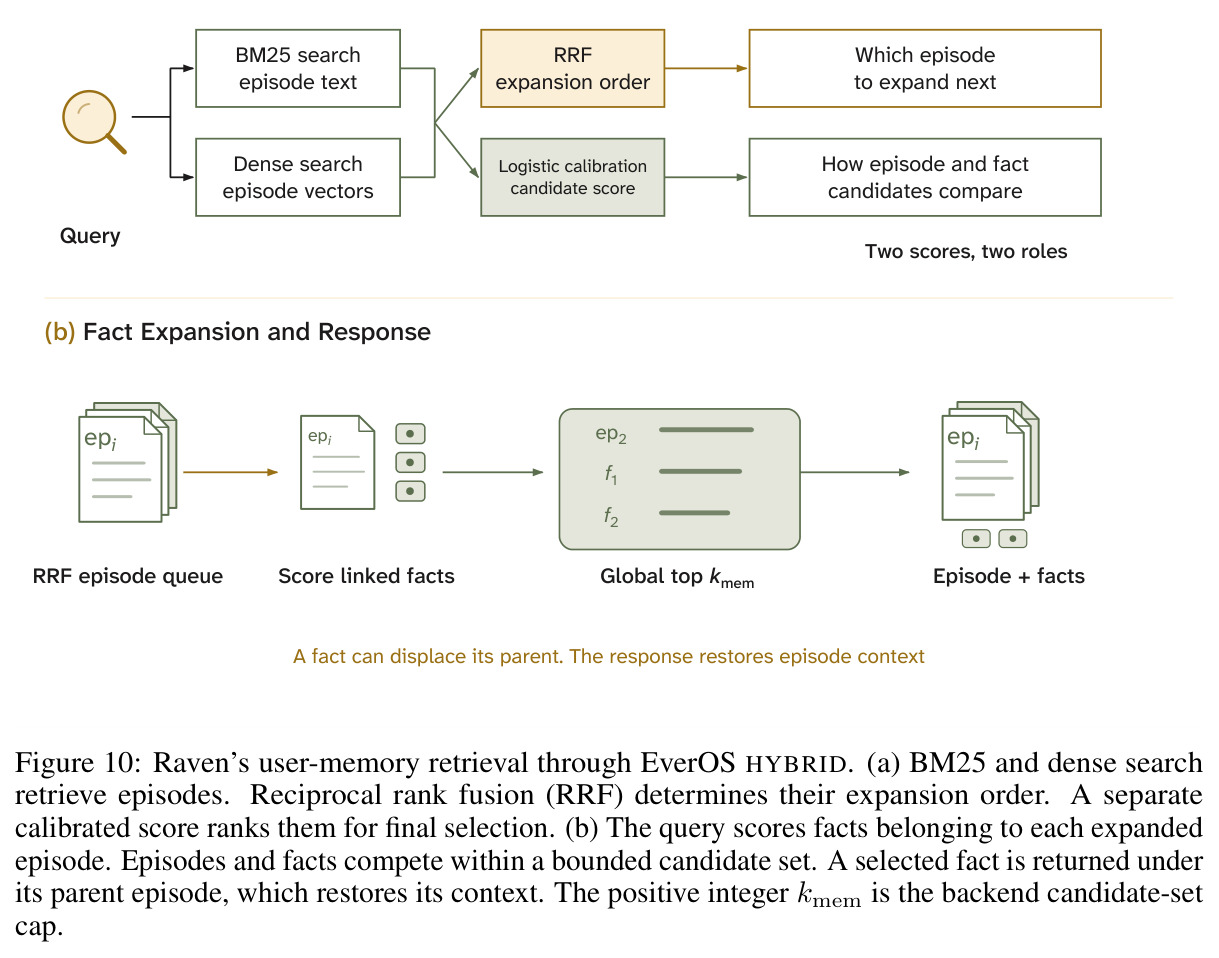
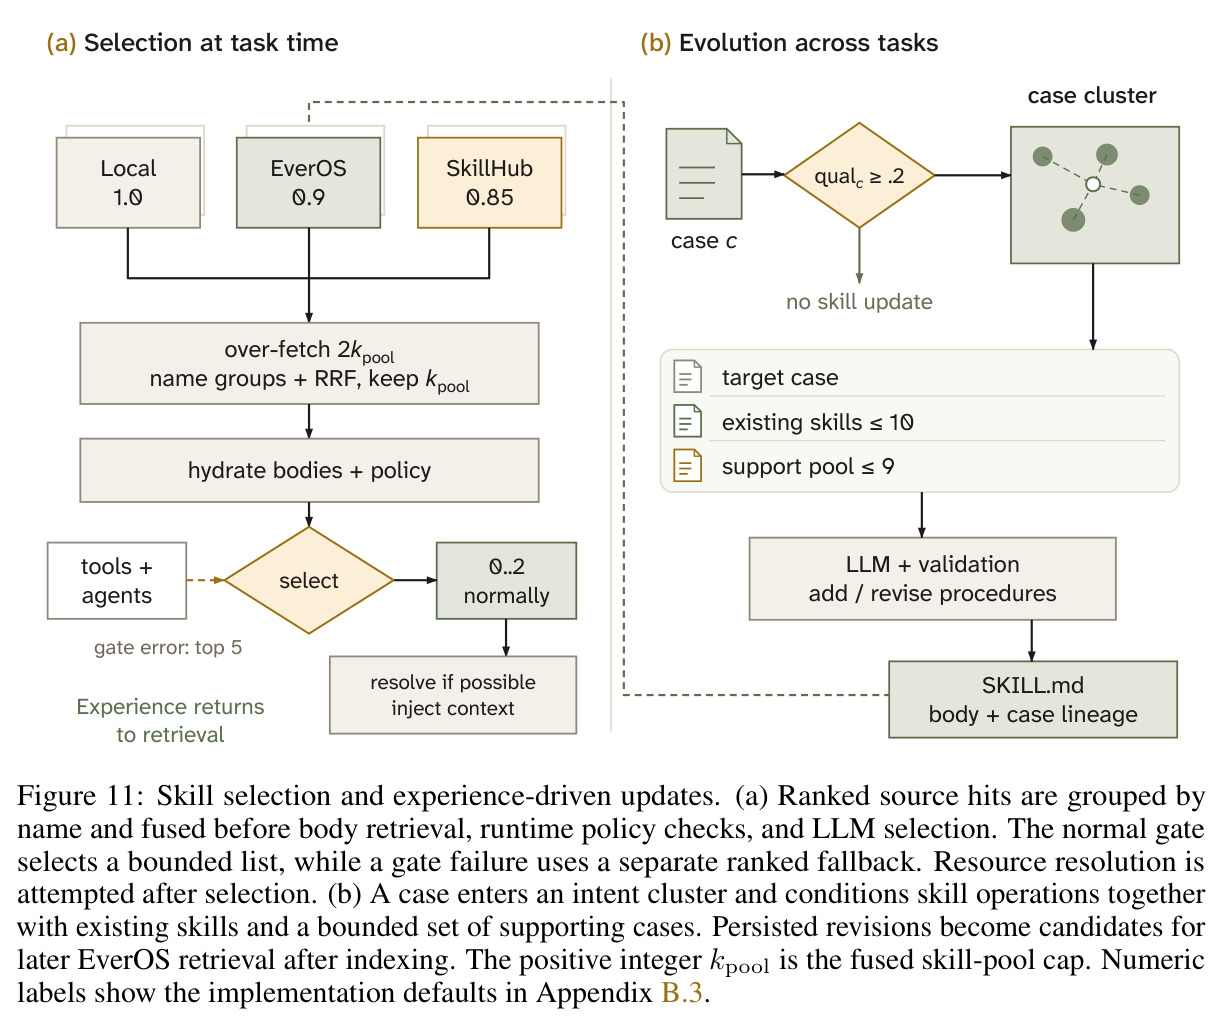
实验结果
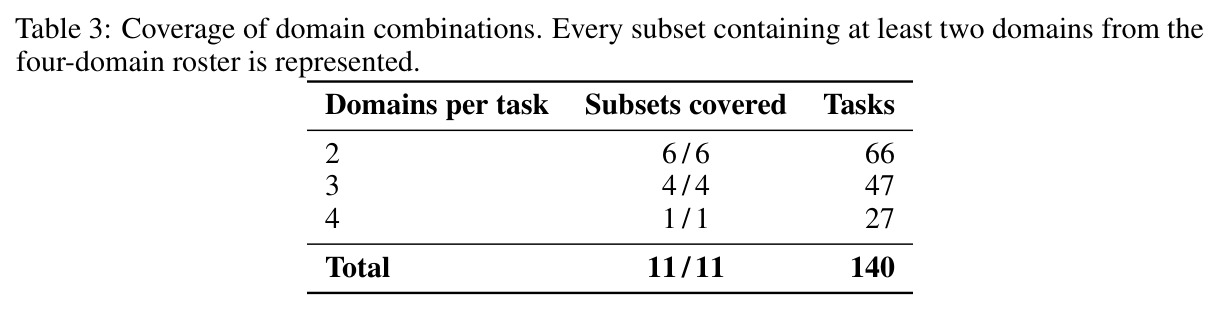
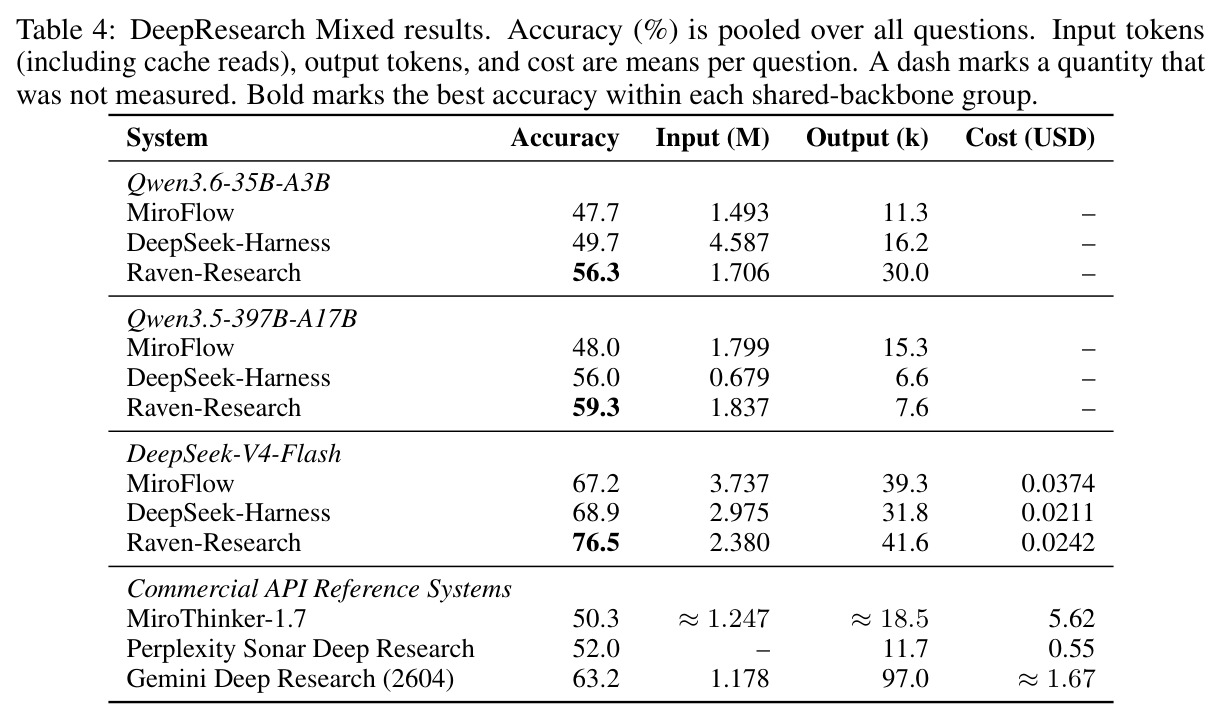
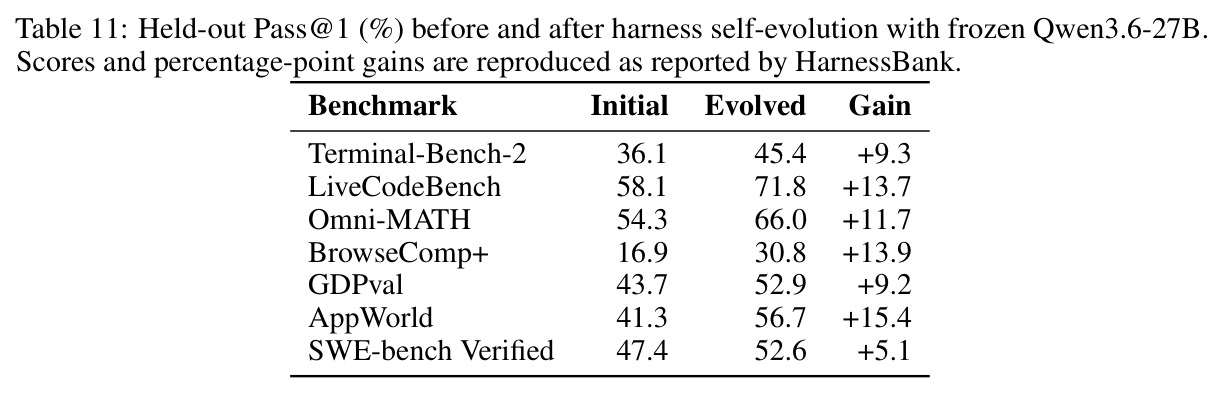
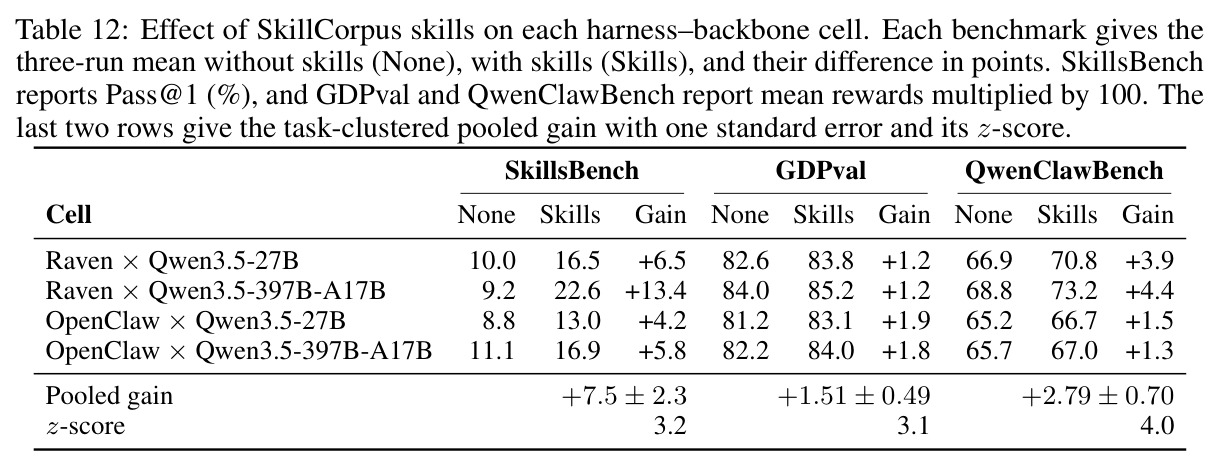
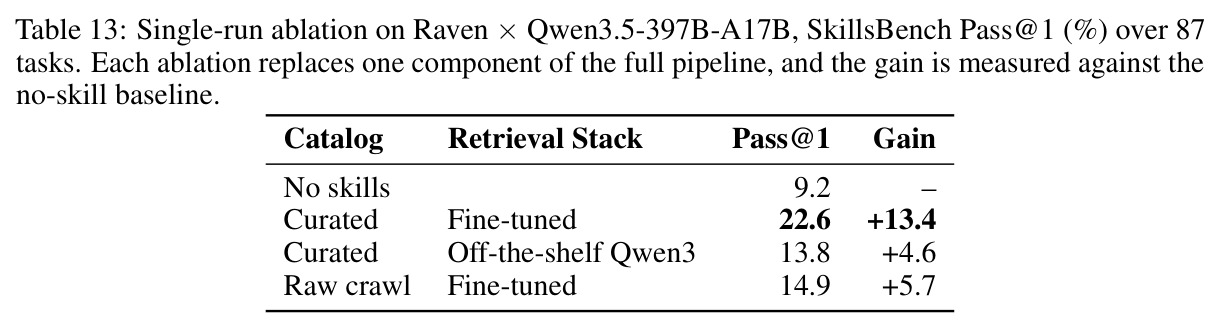
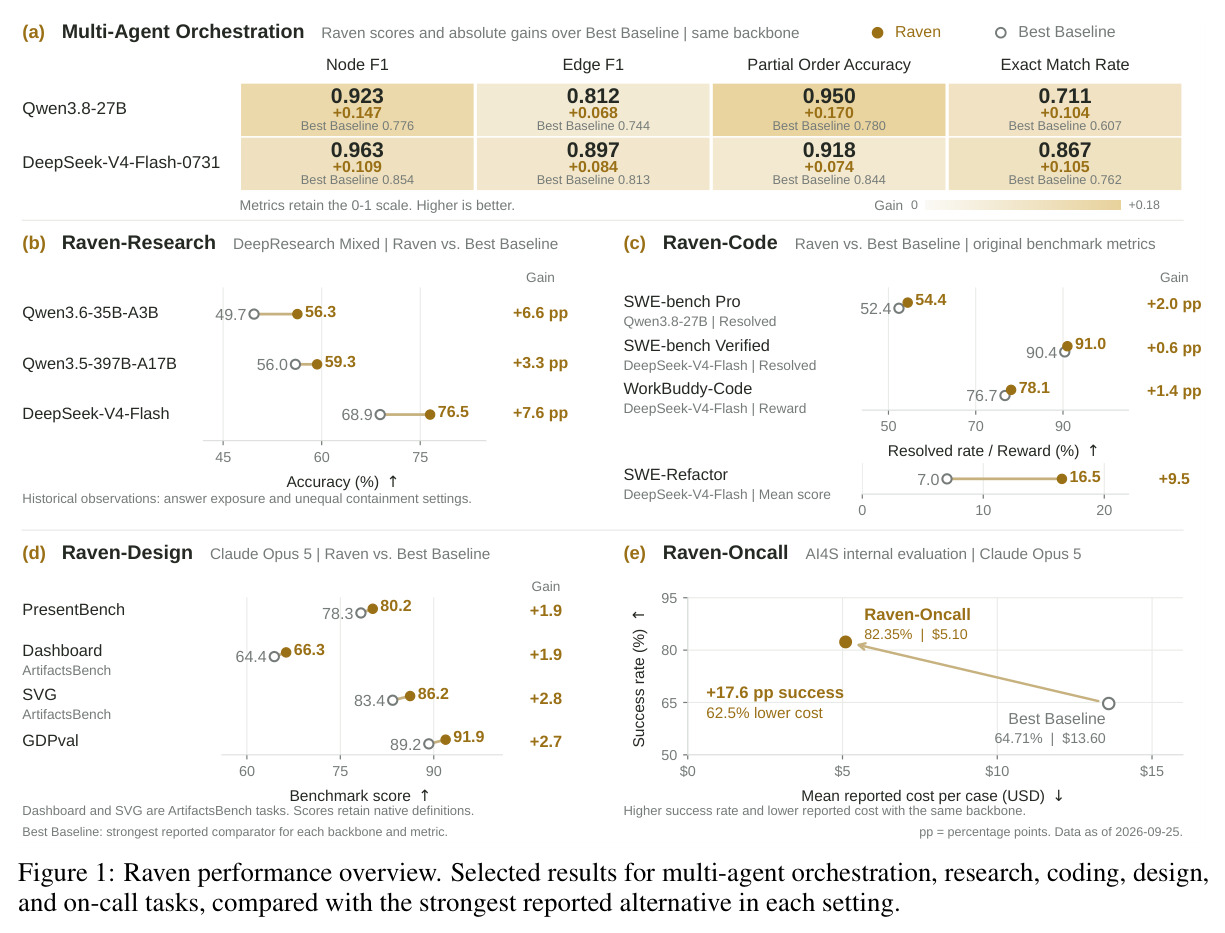
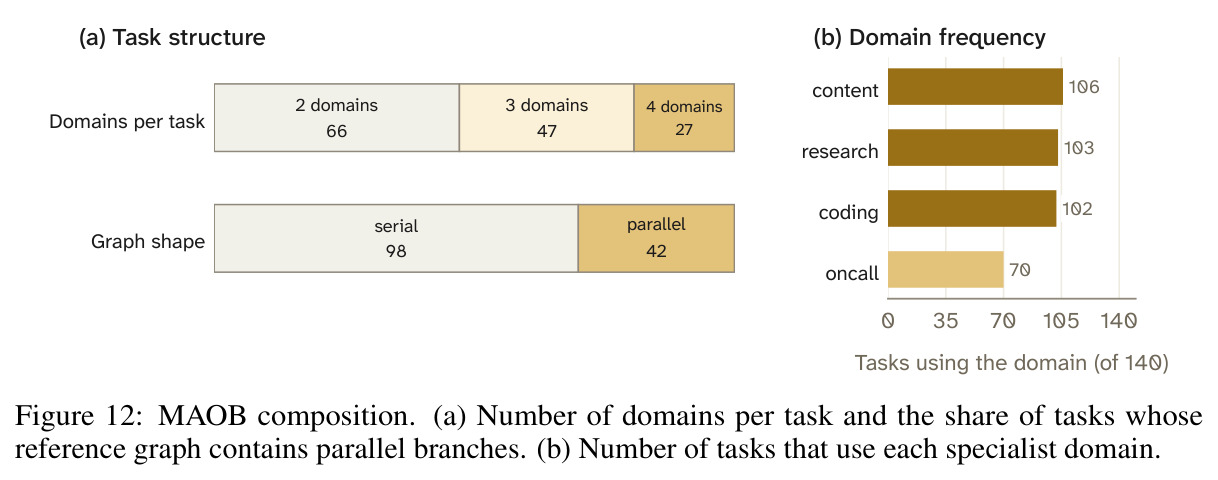
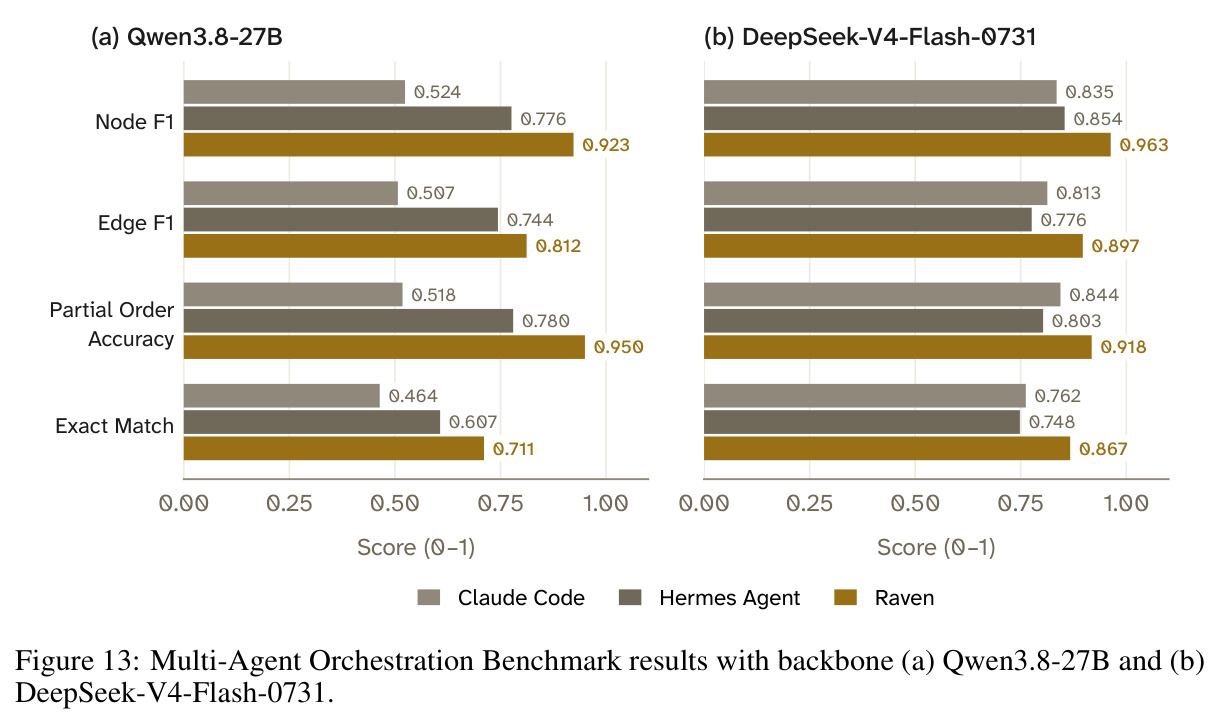
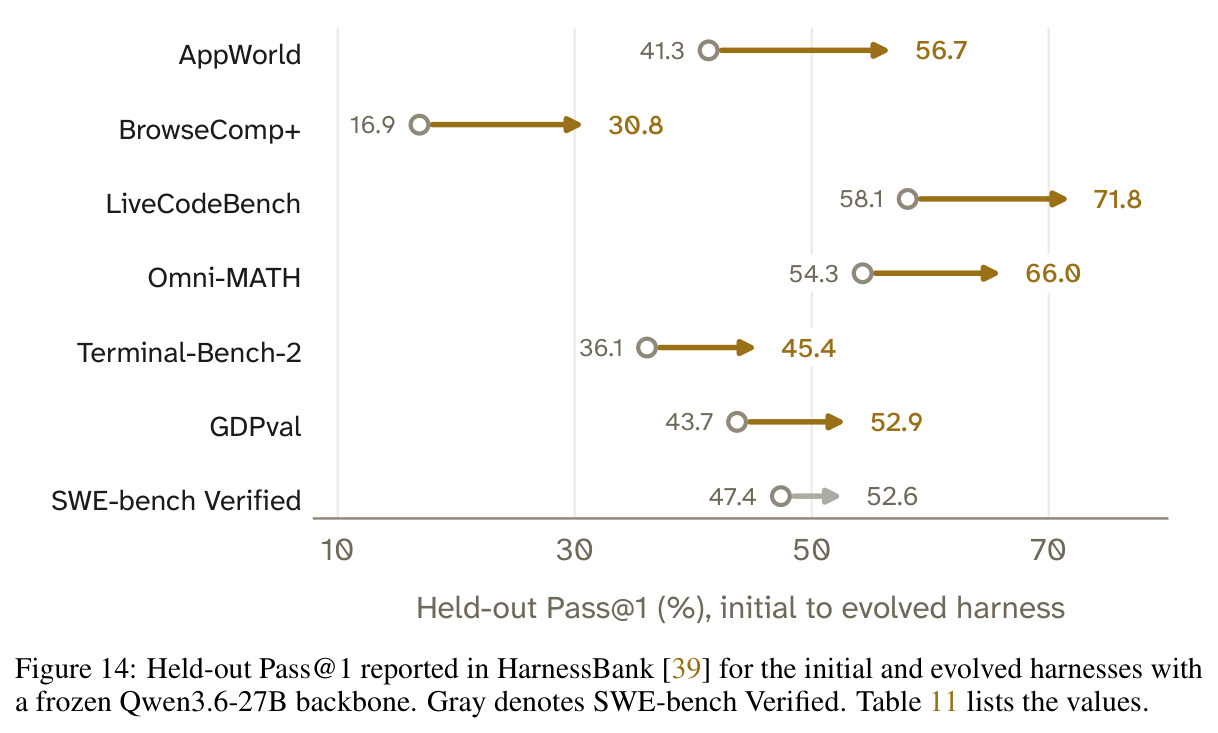
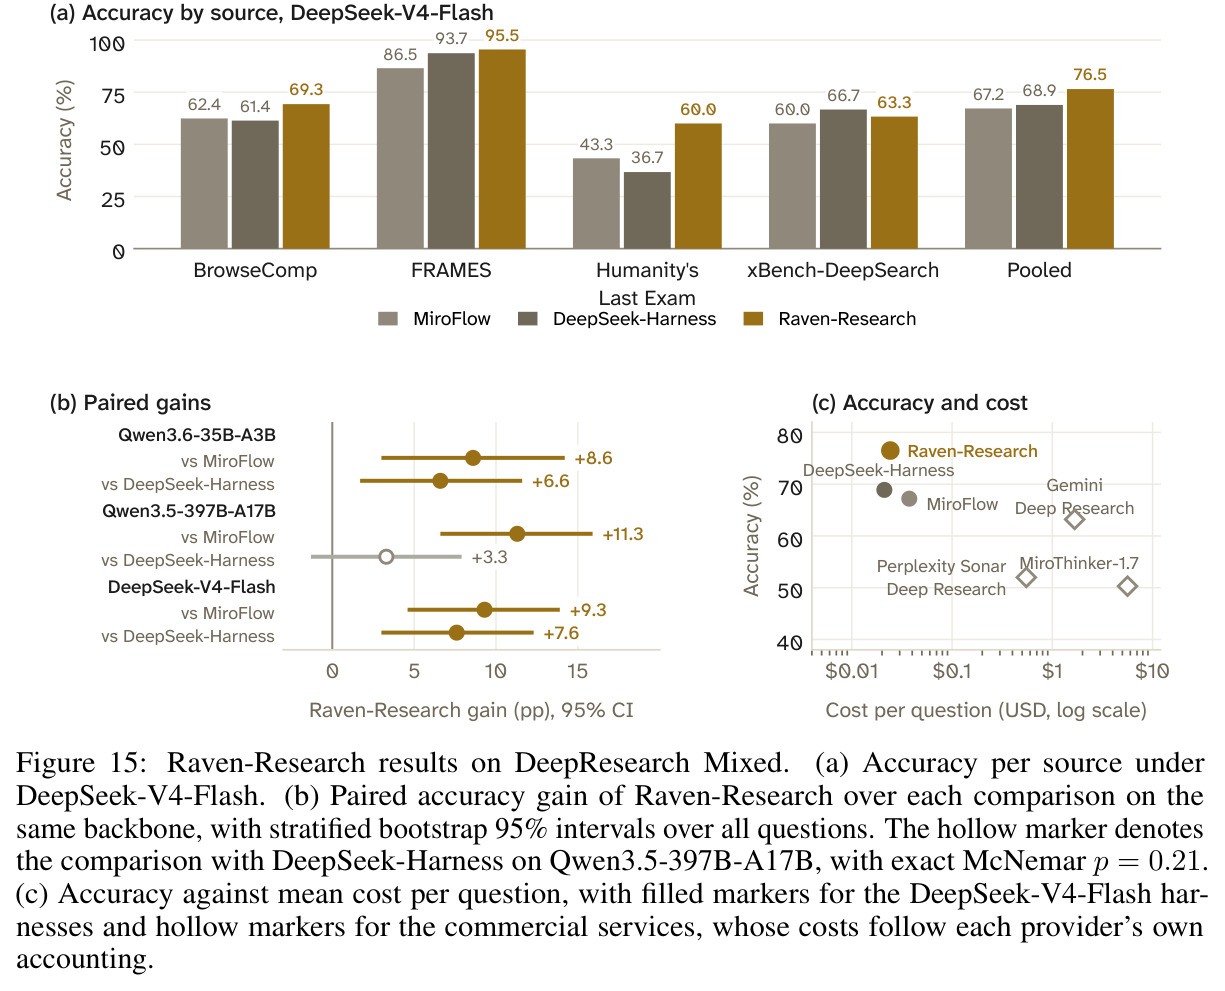
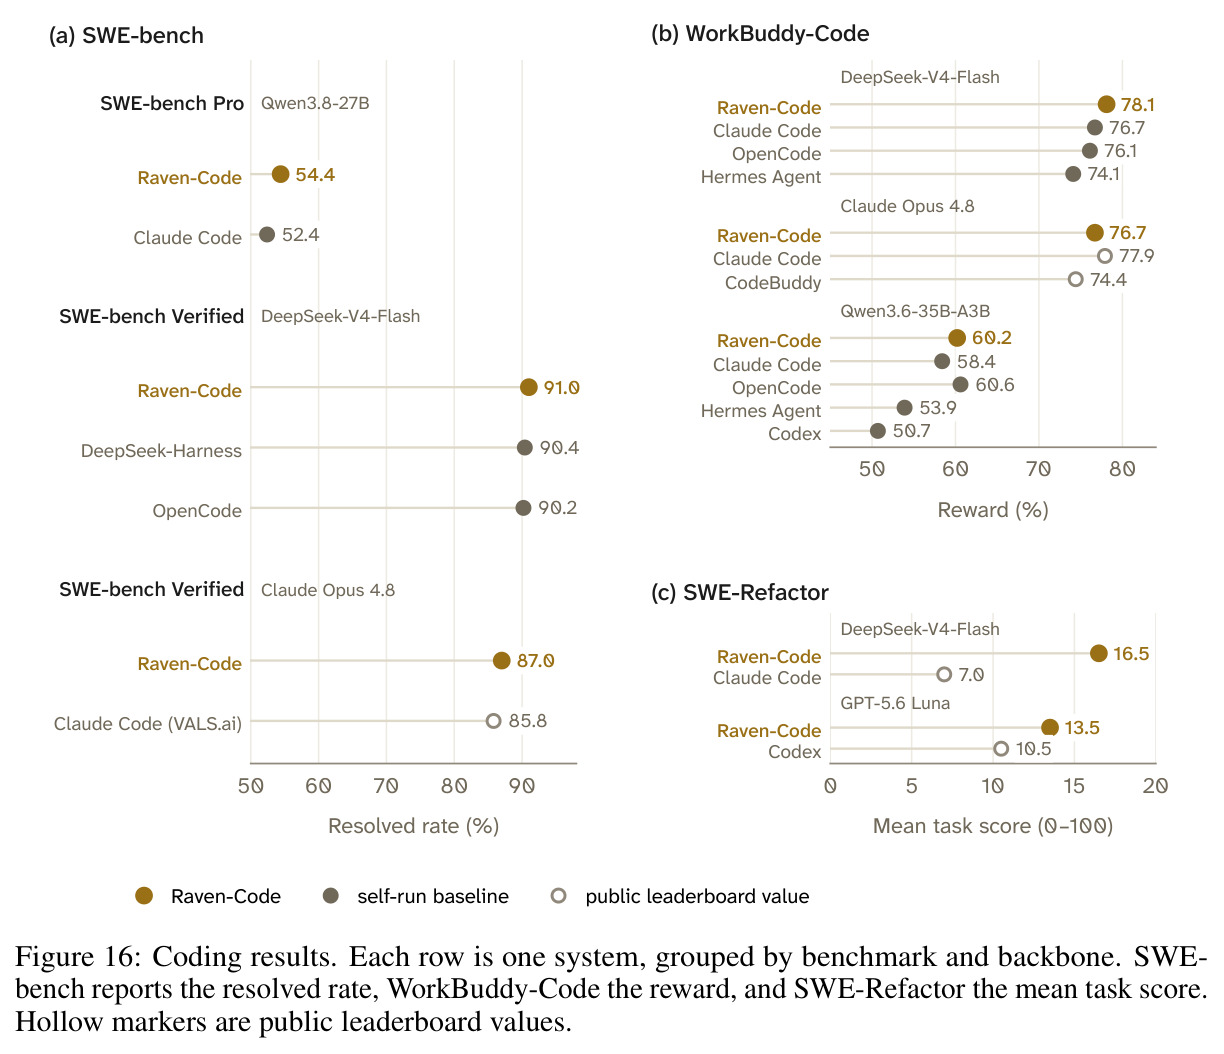
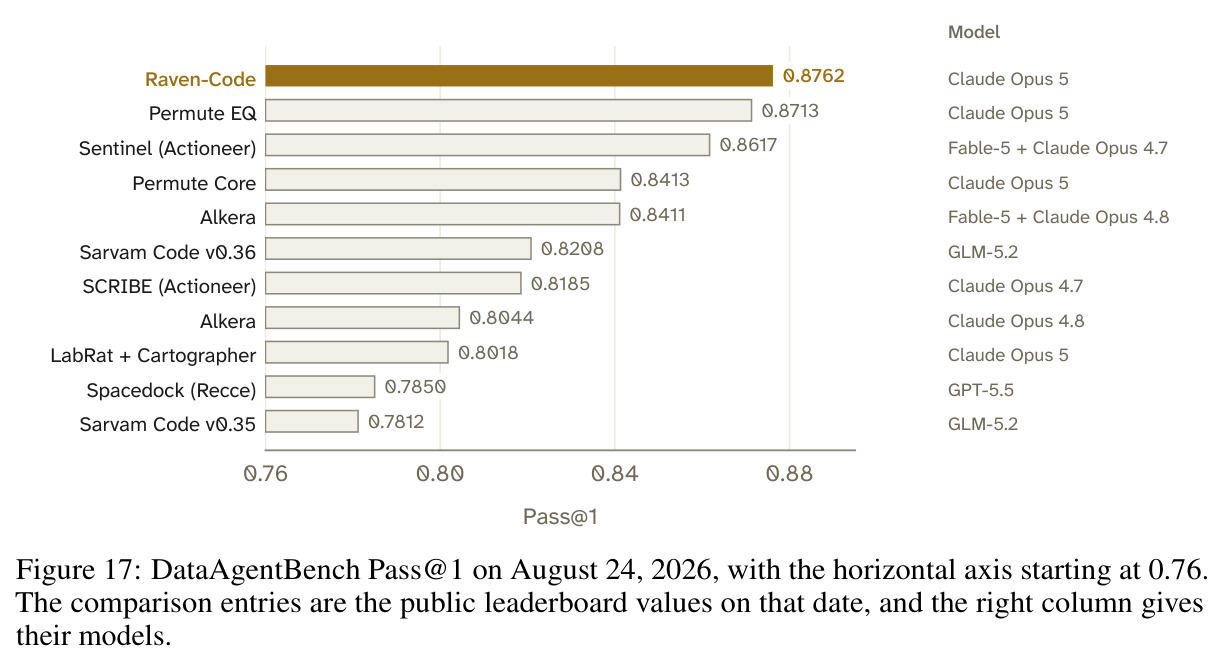
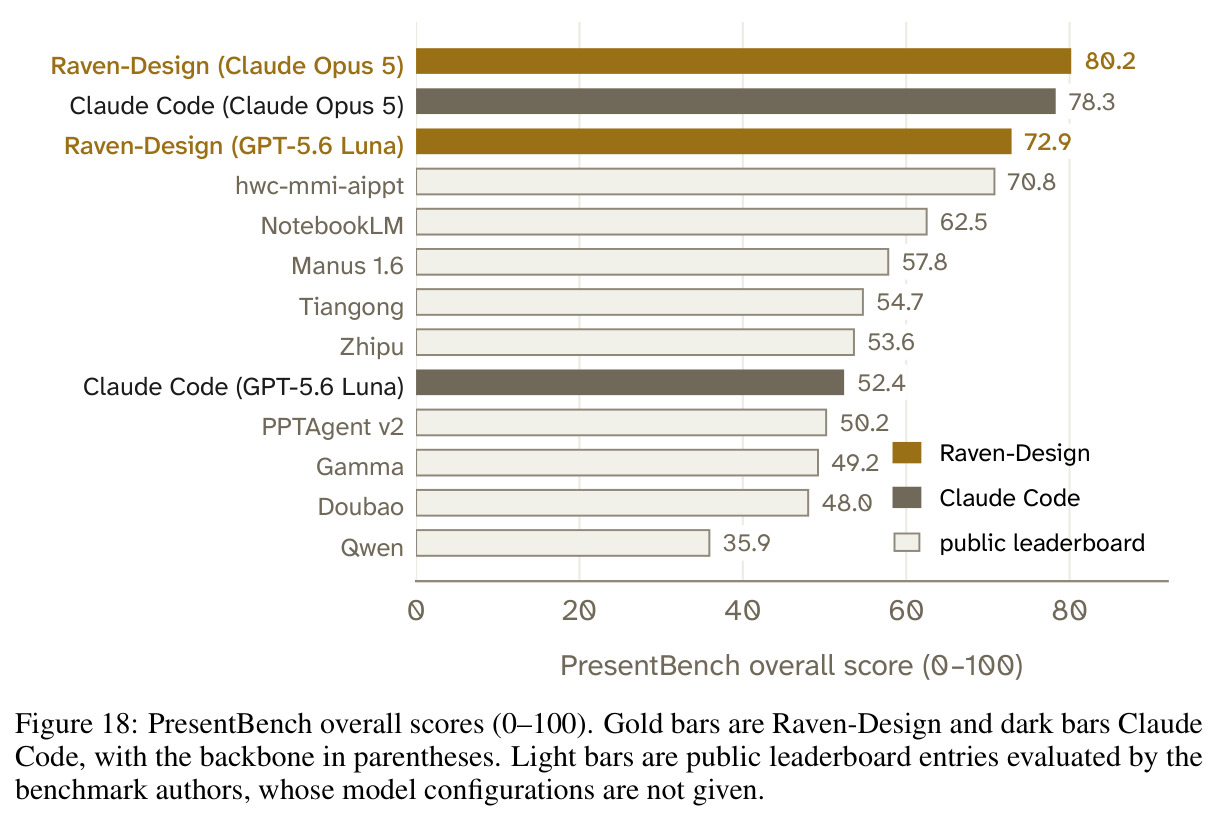
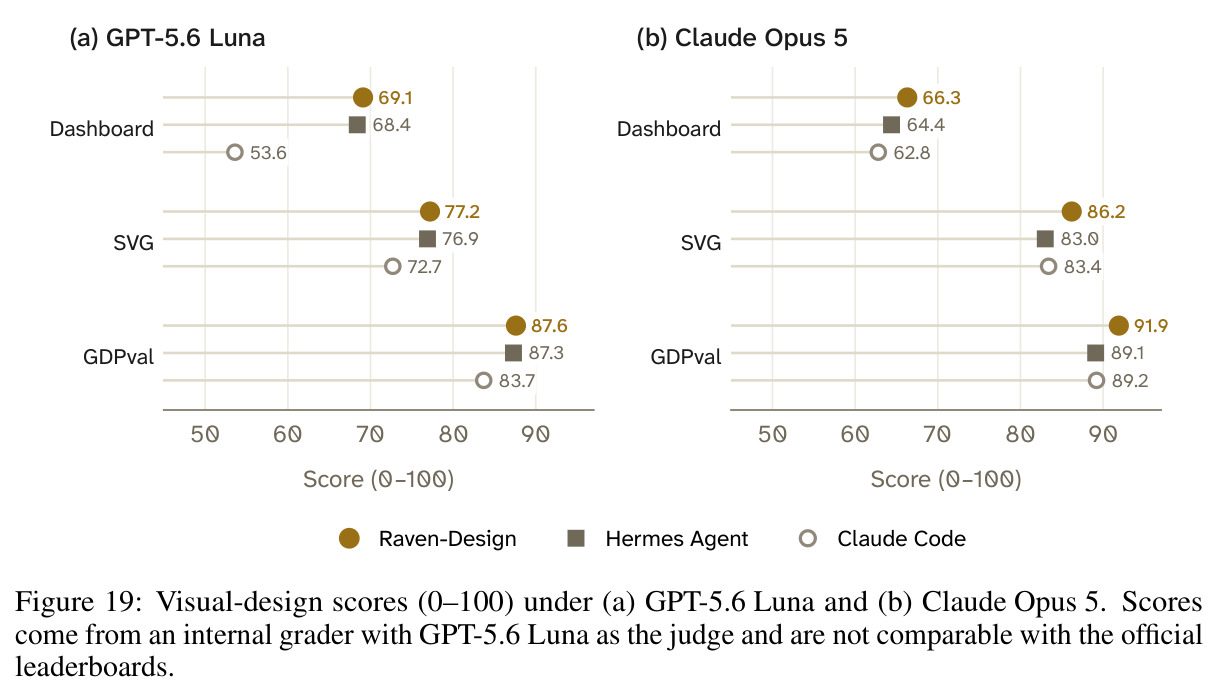
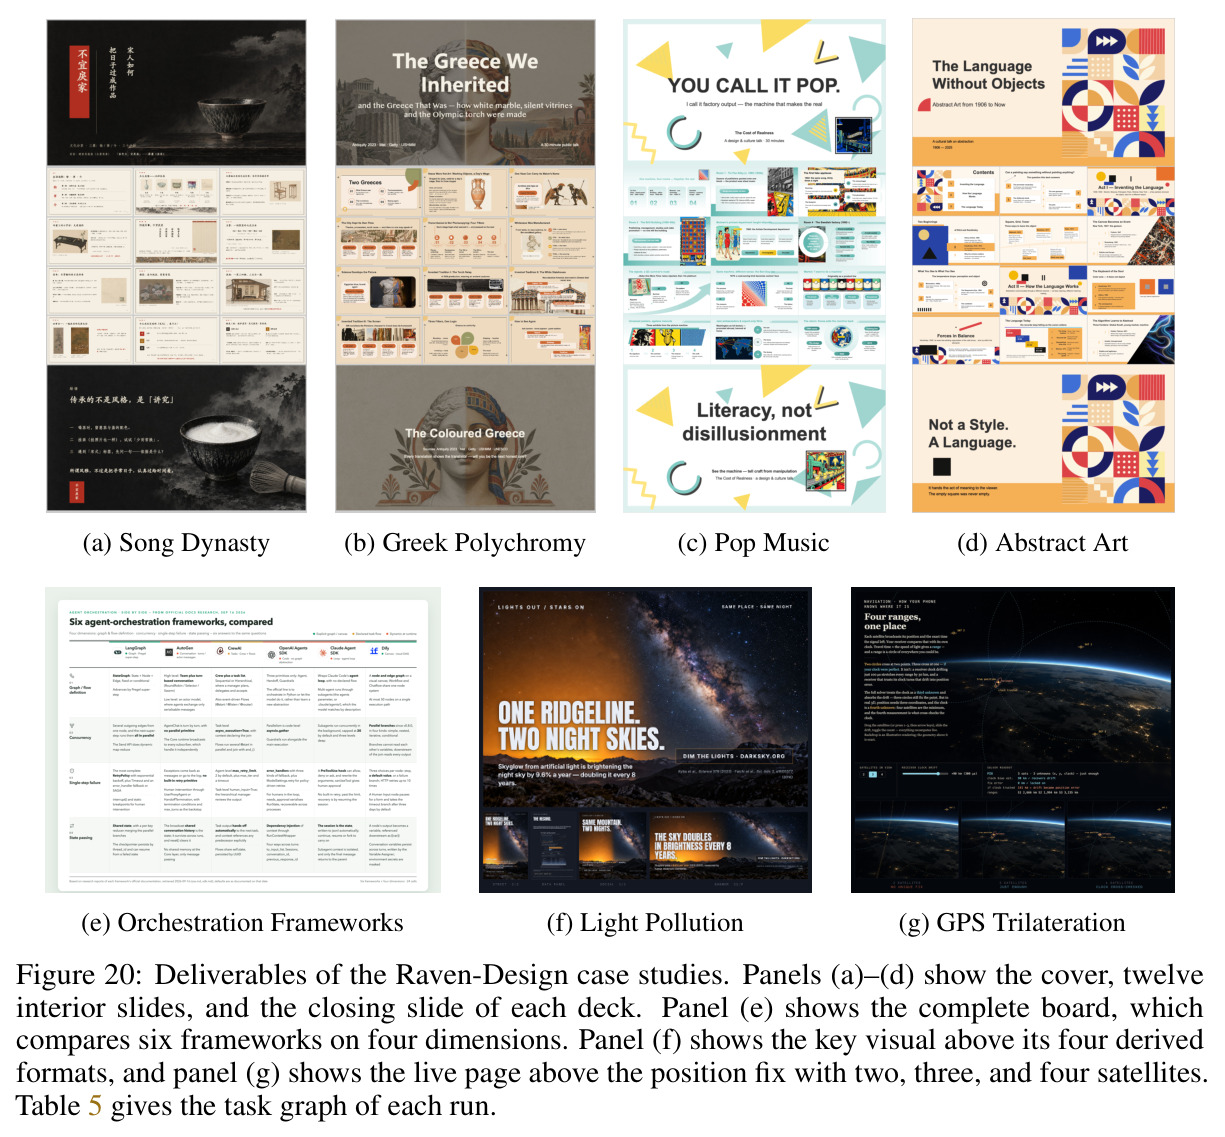
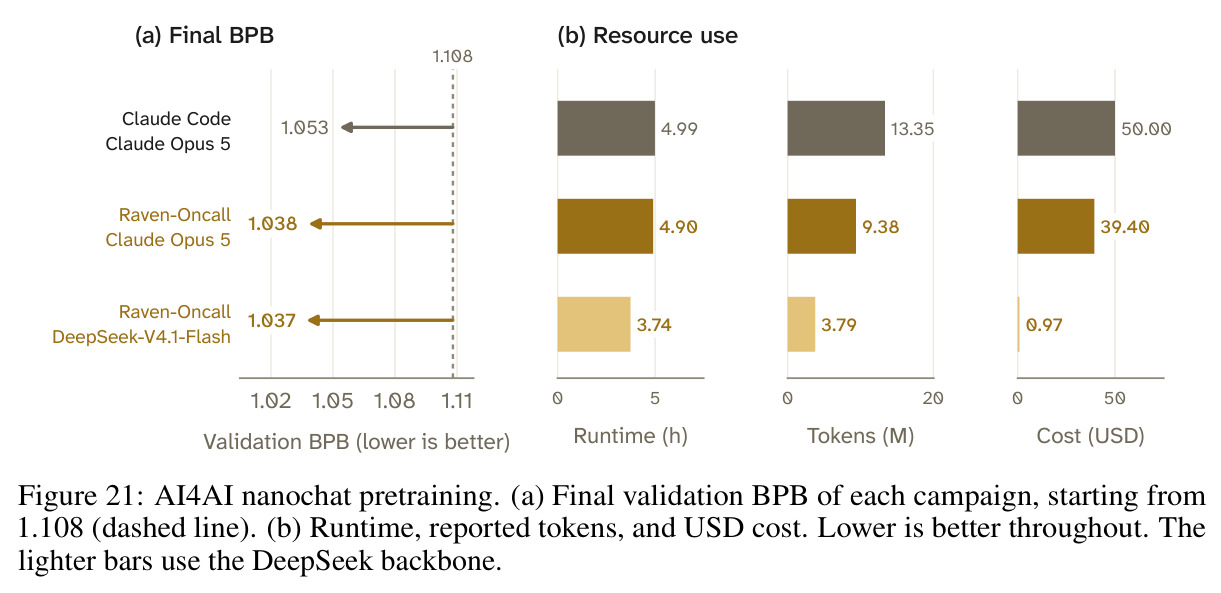
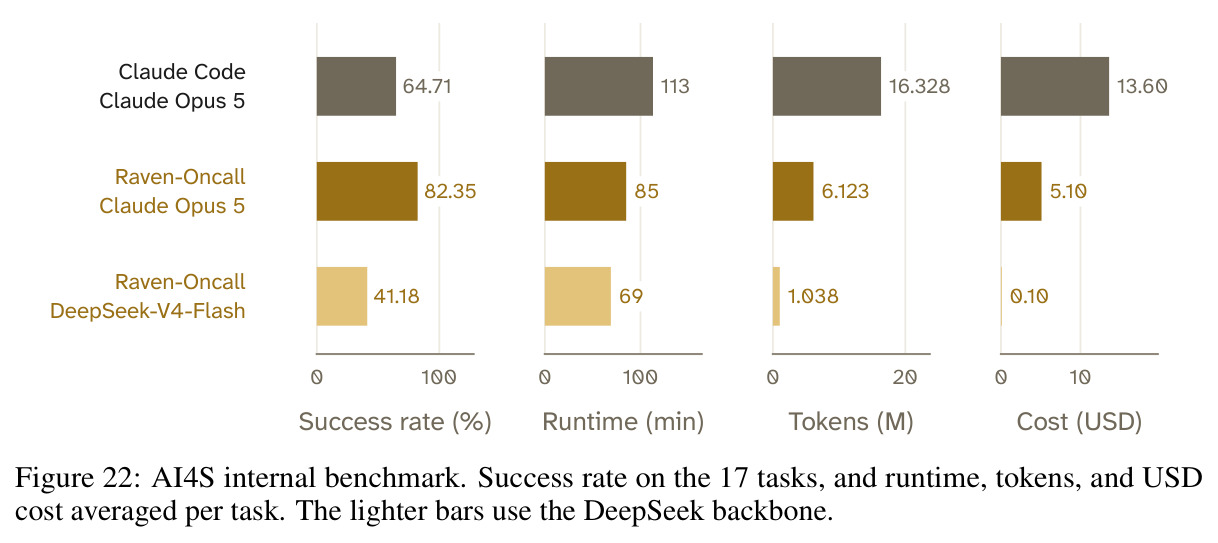
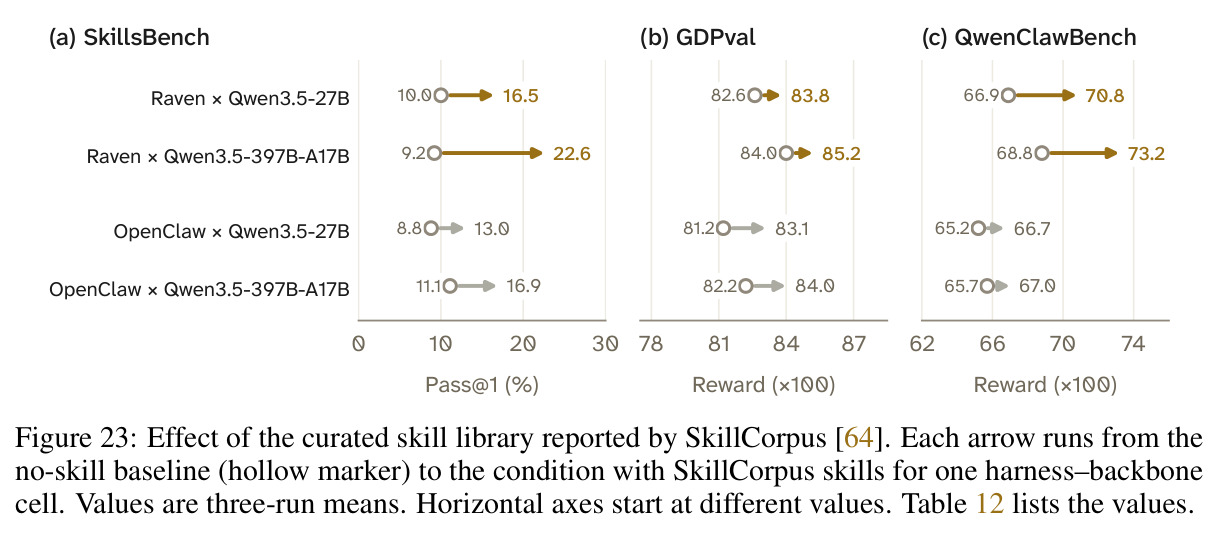
论文按'规划→专家执行→进化→复用'四个能力层级分别评估。(1) 编排规划(MAOB,140 请求、137 职业、参考图平均 2.72 节点/1.84 边):Raven 在两个 backbone、全部四个图指标上排名第一。Qwen3.8-27B 下 Node F1 0.923 对最强基线 Hermes Agent 的 0.776(+0.147),Edge F1 0.812 对 0.744(+0.068),POA 0.950 对 0.780(+0.170),Exact Match 0.711 对 0.607(+10.4pp);DeepSeek-V4-Flash-0731 下分别为 0.963/0.854、0.897/0.813、0.918/0.844、0.867/0.762(EM +10.5pp)。所有系统的 Edge F1 都低于 Node F1,说明依赖预测是更难的环节。(2) Harness 自进化(引用 HarnessBank,冻结 Qwen3.6-27B):七个基准的留出 Pass@1 全部提升,最大增益 AppWorld +15.4pp(41.3→56.7)、BrowseComp+ +13.9pp(16.9→30.8)、LiveCodeBench +13.7pp(58.1→71.8);SWE-bench Verified +5.2pp 但其 26 任务测试集未过配对增益准则。(3) Raven-Research(DeepResearch Mixed):三个共享 backbone 全部第一,较最强基线分别 +6.6/+3.3/+7.6pp;DeepSeek-V4-Flash 下 pooled 76.5% 对 DeepSeek-Harness 68.9%,其中 BrowseComp 69.3%(基线≤62.4%)、HLE 60.0%(基线≤43.3%),仅 xBench-DeepSearch 落后 3.4pp;六个同 backbone 配对比较五个 McNemar p<0.02;每题成本 $0.0242 介于两个本地基线之间且优于三个商业服务(50.3%–63.2%)。(4) Raven-Code:八个设置中六个第一,SWE-Refactor 整仓迁移 16.5 对 7.0(DeepSeek-V4-Flash,+9.5),SWE-bench Pro 54.4 对 52.4(多解 15/731 题),SWE-bench Verified 91.0 对 90.4 与 87.0 对 85.8,DataAgentBench Pass@1 0.8762 居排行榜第一。(5) Raven-Design:PresentBench 80.2/78.3(Claude Opus 5,+1.9)与 72.9/52.4(GPT-5.6 Luna,+20.5),SVG/Dashboard/GDPval 六个设置全第一(领先最强替代 0.3–2.8pp)。(6) Raven-Oncall:AI4AI 预训练把 1.108 BPB 降到 1.038(Claude Code 1.053),token 9.38M 对 13.35M、成本 $39.40 对 $50.00;AI4S 17 任务成功率 82.35% 对 64.71%,平均成本 $5.10 对 $13.60。(7) 技能复用(SkillCorpus,407 任务):12 个 cell×基准组合全部为正,池化增益 SkillsBench +7.5±2.3、GDPval +1.51±0.49、QwenClawBench +2.79±0.70(z 值 3.2/3.1/4.0);相同技能注入下 Raven 增益大于 OpenClaw(SkillsBench 6.5/13.4 对 4.2/5.8),最强配置 9.2%→22.6%;消融显示换现成检索模型降到 13.8%、换 82 万原始爬取目录降到 14.9%;技能覆盖率≥0.75 的任务平均增益 25.1pp(覆盖率<0.45 仅 2.2pp)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多智能体编排规划(MAOB,Qwen3.8-27B) | Exact Match Rate | Raven 0.711 | 最强基线(Hermes Agent)0.607 | +10.4 pp |
| 多智能体编排规划(MAOB,DeepSeek-V4-Flash-0731) | Node F1 / Edge F1 | 0.963 / 0.897 | 最强基线 0.854 / 0.813 | +10.9 pp / +8.4 pp |
| 深度研究问答(DeepResearch Mixed) | 池化准确率 | Raven-Research 76.5%(DeepSeek-V4-Flash) | DeepSeek-Harness 68.9%;商业最佳 Gemini Deep Research 63.2% | +7.6 pp(同 backbone) |
| 整仓库技术栈迁移(SWE-Refactor,20 任务) | 平均任务分(0–100) | Raven-Code 16.5(DeepSeek-V4-Flash) | Claude Code 7.0 | +9.5 分 |
| 自动科研训练调优(AI4AI autoresearch) | 验证 BPB(越低越好)/ 成本 | Raven-Oncall 1.038 / $39.40 | Claude Code 1.053 / $50.00(同为 Claude Opus 5) | BPB -0.015,成本 -21% |
| 自动科学生产任务(AI4S,17 任务) | 成功率 / 平均成本 | Raven-Oncall 82.35%(14/17)/ $5.10 | Claude Code 64.71%(11/17)/ $13.60 | +17.6 pp 成功率,成本 -62% |
| 技能复用(SkillsBench 87 任务) | Pass@1 | Raven×Qwen3.5-397B-A17B + SkillCorpus 22.6% | 同 harness 无技能 9.2%;OpenClaw 同技能 16.9% | +13.4 pp(对自身无技能基线) |
| 智能体框架进化(HarnessBank,AppWorld 留出集) | Pass@1(冻结 Qwen3.6-27B) | 进化后 harness 56.7% | 初始 harness 41.3% | +15.4 pp |
| 幻灯片生成(PresentBench,238 任务) | 总体分(0–100) | Raven-Design 72.9(GPT-5.6 Luna) | Claude Code 52.4(同 backbone) | +20.5 分(Claude Opus 5 下 +1.9) |
| 数据库分析问答(DataAgentBench,54 问/12 库) | Pass@1 / Pass@5 | Raven-Code(Claude Opus 5)0.8762 / 0.9097 | 公开榜第二 Permute EQ 0.8713(2026-08-24) | Pass@1 +0.0049 居首 |
局限与改进
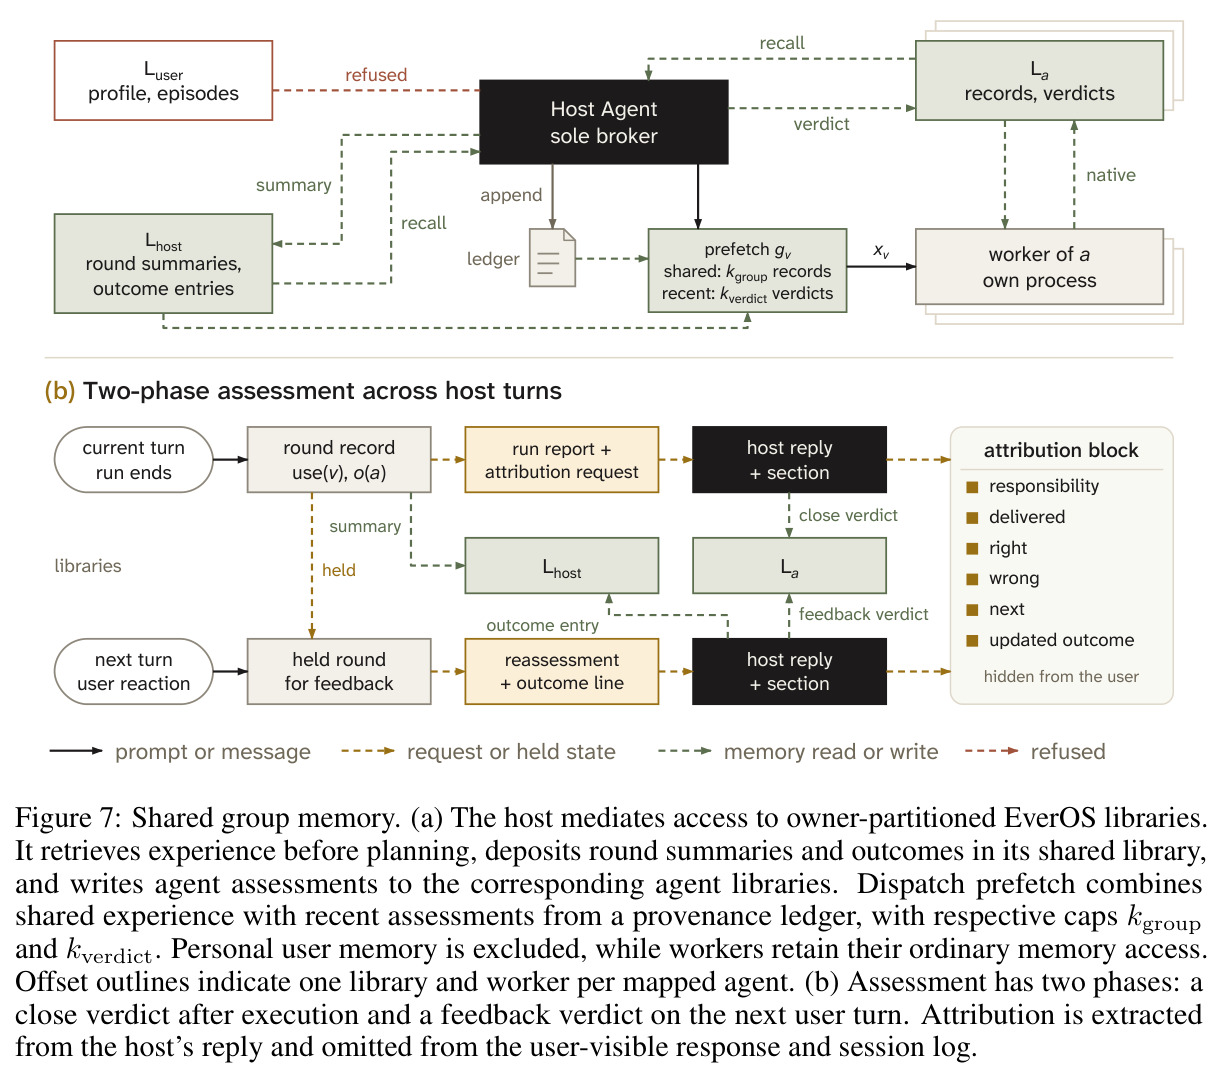
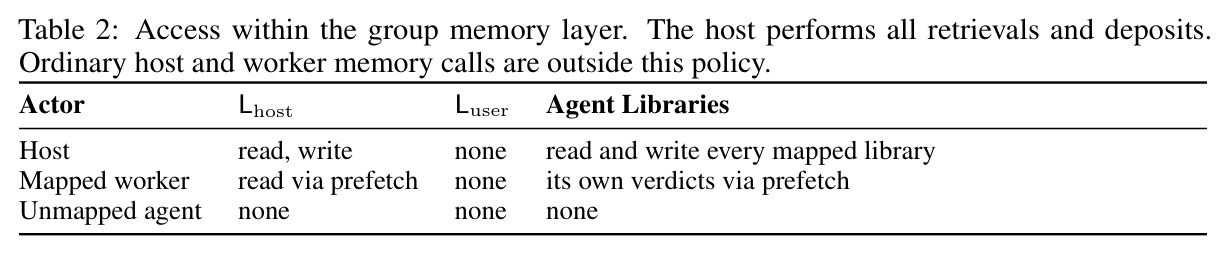
作者明确承认的限制包括:MAOB 只在派发前评估规划而不执行 worker,图一致不等价于语义正确(他们自己写道应辅以语义契约检查、端到端结果与成本核算);参考 DAG 在生成请求前先由 Claude Opus 5 创作、请求由 GLM-5.2 反向生成,词法泄漏过滤无法排除改述式的规划线索,参考图的非唯一性也是固有担忧;MAOB 覆盖四个固定领域的全部 11 种组合,但不推广到所有职业场景与工具配置。HarnessBank 与 SkillCorpus 实验是引用已发表结果而非本文重跑;shared group memory 默认禁用且完全未评估其效果。Raven-Research 在 xBench-DeepSearch 上落后 DeepSeek-Harness 3.4pp;GDPval 上的技能增益(+1.2~1.9pp)相对任务奖励标准差(20–27 分)不显著。我自己的观察补充如下:AI4AI 每个系统只跑一个 campaign、AI4S 是内部基准且成功由人工对照隐含参考值判定,统计功效薄弱;SWE-bench Verified 允许生成期联网、部分对比(WorkBuddy 部分行、PresentBench 榜单、DataAgentBench)直接取公开榜单数值而非同环境复跑,可比性打折;商业深度研究服务的成本按各家自有口径核算;理论结果只是充分条件,contract realization 所需的条件误差界 $\epsilon_j$ 在真实 LLM 系统中既难估计也难验证,parity 构造是理想化的;Edge F1 全面低于 Node F1 且最高只有 0.897,说明依赖结构预测仍有很大改进空间。
独立分析的弱点
第一,规划分与端到端成功之间缺少因果桥:MAOB 的 Exact Match 提升约 10pp,但论文没有展示'图一致性的提高转化为多少最终任务成功率/成本下降',多智能体失败分类研究表明验证与协调错误常发生在执行期。改进方向:构建'规划-执行'联合基准,报告 DAG 距离与最终交付质量、成本的相关性,并把完成裁定器的语义契约检查纳入评分。第二,评测统计功效不足:AI4AI 每系统单次 campaign、AI4S 为 17 个任务的内部基准且人工判定成功、Design 案例研究仅 7 个 run 且无人类偏好评分,这些结论容易被噪声放大。改进方向:多 seed 重复、公开第三方基准优先、报告置信区间。第三,生态自锁与基线覆盖不全:EverOS、SkillHub/SkillCorpus、HarnessBank 均为同一团队组件,MAOB 的编排基线只有 Claude Code 与 Hermes Agent,未对比 LangGraph、AutoGen、Magentic-One 等开源编排器;改进方向:把 Raven 的类型化 DAG 接口做成适配层,纳入成熟编排框架作对照。第四,机制本身的成本未被充分计入收益核算:准入校验、独立裁定器、异常上报、澄清自动应答都会增加时延与 token,论文虽强调'结构调度不建立成本优势',但未报告这些机制各自的开销占比。改进方向:给出组件级成本消融。第五,理论的可检验性弱:contract realization 需要逐操作的 $\epsilon_j$ 界与入口律一致性,实际系统无法提供;改进方向:为受限操作类型(如文件交接、代码执行判定)设计可估计的契约实例。第六,可变环境下的复用风险:harness 进化的增益已知会向留出任务部分迁移且依赖执行模型(作者引用 HarnessDev 指出这一点),本文未讨论进化后 harness 在新模型族上的失效与回滚策略。
未来方向
作者在结论中给出了明确的路线:构建覆盖日常设备与环境的互联多智能体系统——每个设备或环境一个 Raven 实例,管理其范围内的全部智能体,实例之间用 agent-to-agent(A2A)协议交换能力信息、委派任务并回传结果,形成 All-Domain Collaboration Network;同时连接各实例的记忆系统、迁移任务上下文、同步执行进度,使交互可跨设备延续,并以端到端评估度量任务成功、体验连续性与协调成本。基于论文成果可自然延伸的方向包括:(1) 评估并改进 shared group memory——论文实现了两阶段(close/feedback)评估但未报告任何效果,闭环'主机评价→派发预取→执行改进'的因果链值得量化;(2) 把 harness 进化与编排联合优化,让 Evolver 也能修改 Host Agent 的规划策略,并用 MAOB 风格的图一致性作为进化的中间奖励;(3) 扩大技能目录的领域覆盖——覆盖率与增益强相关(≥0.75 覆盖任务平均 +25.1pp,Pearson r=0.31–0.40),说明定向补齐低覆盖域(如数学、财经,其增益接近零)收益直接;(4) 契约的运行时验证自动化,例如把准入检查从结构层扩展到语义层(研究任务是否真的回答了用户问题);(5) 跨实例记忆同步与隐私边界:论文已区分用户库 $L_{user}$、主机共享库 $L_{host}$ 与各智能体库 $L_a$,多设备场景下所有权与可见性策略会更复杂;(6) 依赖预测模型:Edge F1 全面偏低,可尝试在编排指南之外引入轻量结构先验或约束解码。
复现评估
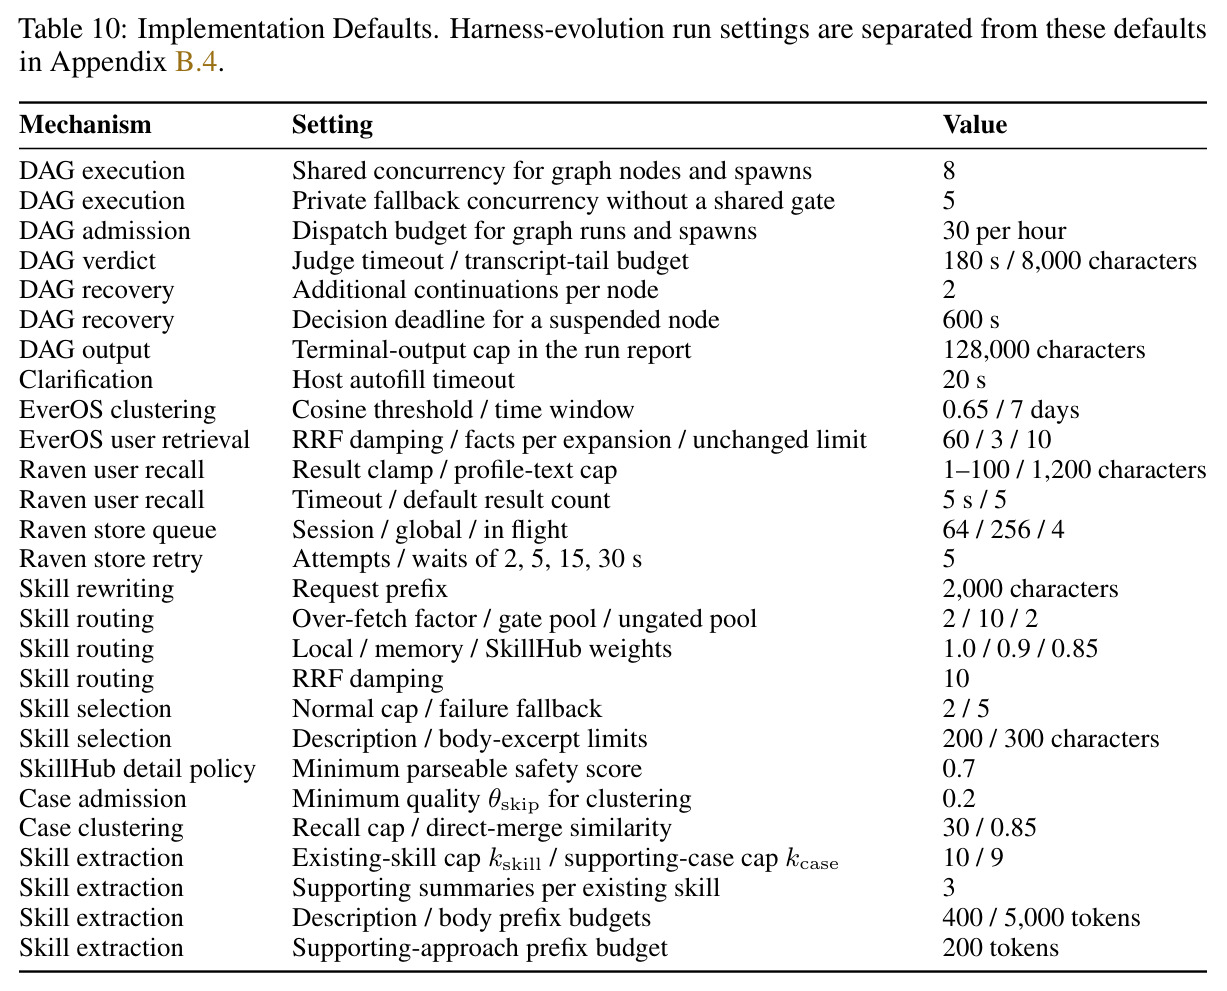
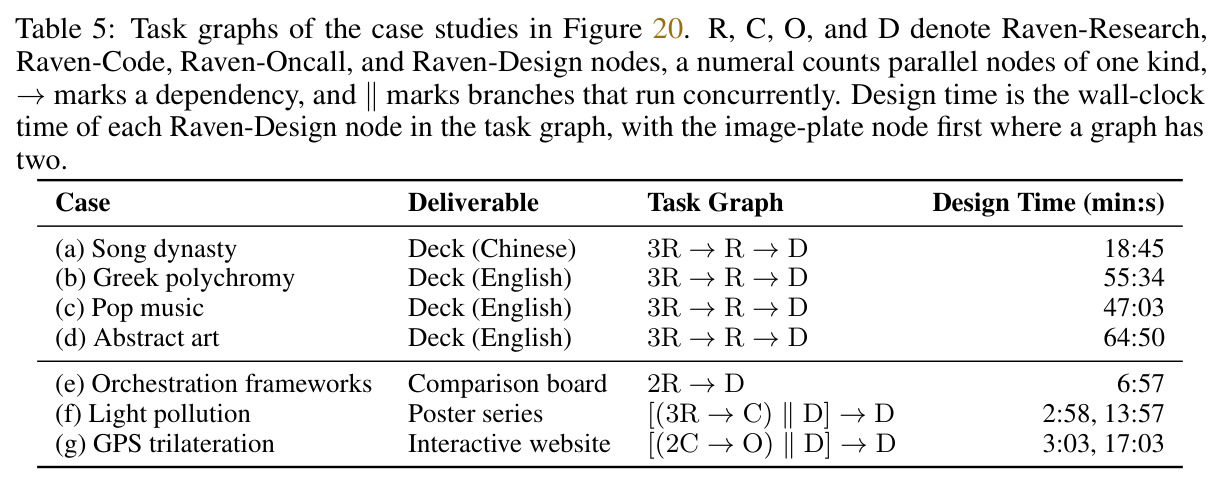
复现基础较好但门槛不低。开源方面:Raven 本体在 GitHub(EverMind-AI/Raven)开源,MAOB 基准(140 任务,含参考 DAG 与评审记录)随论文发布,showcase 案例(docs/showcase.md)可核对设计类结果;EverOS(记忆后端,Markdown+SQLite+LanceDB,可换 Milvus)、SkillCorpus(96,401 技能目录及微调的 Qwen3-Embedding-0.6B/Qwen3-Reranker-0.6B)、HarnessBank 均有各自的前作发表。协议透明度方面:附录 B 给出实现默认值(预算、融合权重、阈值 $\theta_{sim}$、$k_{pool}$ 等),附录 C 给出各评测的版本、预算与记账规则,算法 1–6 以伪代码完整给出,主文公式编号连续,这在此类系统论文中相当规范。困难与坑:AI4S 是 17 任务的内部基准,任务清单与隐含参考值不完全公开;HarnessBank 与 SkillCorpus 的数字是引用已发表实验而非本文重跑;部分对比(WorkBuddy 部分行、PresentBench 榜单条目、DataAgentBench)取自公开排行榜而非同环境复现。资源方面:完整复现需要多家商业模型 API(Claude Opus 5/4.8、GPT-5.6 Luna、DeepSeek-V4-Flash、Qwen3.5-397B-A17B 等),AI4AI 每战役需 2×A800 80GB 上 5 GPU 小时,Raven-Design 单个 deck 约 19–65 分钟、$0.80,DeepResearch Mixed 每题约 $0.02–0.04。总体评估:跑通系统与 MAOB 规划评测难度中等(开箱可用);完整复刻四个专家的全部对比属于中高难度,主要受 API 预算、内部基准缺失与第三方榜单数值的影响。
论文图表