TailSteer:面向抗漂移多轮图像编辑的轨迹尾部引导 TailSteer: Trajectory-Tail Steering for Drift-Resistant Multi-turn Image Editing
只微调去噪轨迹尾段,让基础模型在连续20轮编辑后几乎不漂移且不损失原有能力
前置知识
去噪速度场(Flow Matching)
扩散/流匹配模型在每一步预测一个速度 $v_\\theta(x_k, k, c)$,指明当前含噪状态 $x_k$ 沿时间轴(0 为纯噪声、1 为输出)向干净图像移动的方向与速率,采样即沿该速度场积分。TailSteer 的干预对象正是这个速度场,所有损失与混合策略都定义在速度空间上。
论文的终端干预损失、速度混合公式 $v^*_k$ 都建立在速度预测之上,不懂速度参数化就无法理解训练目标。
多轮编辑累积漂移
交互式编辑中每轮输出都成为下一轮输入,模型在未要求修改区域引入的微小误差被反复继承并放大:十几轮后纹理流失、人脸变形、背景变色。这是长程视觉创作工作流的根本瓶颈,单轮基准分数无法反映。
这是全文要解决的问题,论文新提出的 Add & Preserve 基准就是为直接度量这种漂移而设计的。
粗到细的去噪过程
扩散采样呈粗到细的推进:低频结构(布局、大色块)在早期几步确立,高频细节(纹理、边缘)主要在轨迹尾部恢复。Fig. 2 显示低频相似度在中途已很高,高频相似度在尾部陡升,且未修改区域的保留误差到终点仍非零但已可修正。
这一经验观察是整个方法的立论基础:只纠正尾部即可修复细节偏差而不破坏全局结构。
On-policy 自采样训练
借自强化学习的概念:训练用的状态不是预先生成好的固定数据,而是当前被训练模型自己 rollout 实际到达的状态,监督目标在该状态上重新计算,梯度只经采样步的预测回传(rollout 本身不追踪梯度,配 stop-gradient)。
这是 TailSteer 的关键设计,消融显示去掉 on-policy 后模型能保留画面却做不好空间推理(摆不出奶酪三角形)。
VAE 潜空间往返
主流编辑模型在 VAE 编码的潜空间做扩散,每轮编辑需把上一轮输出 decode 成图像再 encode 回潜空间,重建误差(尤其颜色偏移)跨轮累积。FLUX.2 曾专门优化编辑用 VAE 表示,但仍非无损。
论文发现 VAE 往返是尾部引导之外的另一漂移源,并做了 latent feedback 绕过 VAE 的补充实验。
PSNR / SSIM / LPIPS
三种常用图像保真指标:PSNR 度量像素级误差(越大越好),SSIM 度量结构相似性(越大越好),LPIPS 用深度特征度量感知差异(越小越好)。Add & Preserve 在红框之外的区域将每轮输出与原始源图逐轮对比。
论文用这三项指标在 10 轮内刻画累积漂移曲线,是判断抗漂移效果的核心量化证据。
研究动机
指令图像编辑模型(Nano Banana 2、GPT-Image、FLUX.2 等)单轮效果已很强,但交互式创作中用户往往连续发出十几条指令,每轮输出都会成为下一轮输入,单轮里非目标区域的微小改动被反复继承放大。论文用 FLUX.2 [klein] Base 9B 实测:基线模型连续编辑 5 轮后人脸已明显退化,20 轮后桌面颜色、先前添加的咖啡杯和拿铁拉花等细节全部漂移。现有三类方案各有硬伤:(i) 掩码、专用 LoRA、频域修正等辅助模块靠牺牲或约束预训练先验换取保留,只覆盖较窄的局部编辑类型,FreqEdit 会让 Klein 的 GEdit-EN 从 7.47 降到 7.20、ConsLoRA 降到 6.58;(ii) 改造 VAE 表示(VAE-LFA)或改用像素扩散只缓解单轮误差,跨轮仍持续退化;(iii) 缓存潜状态、跨轮记忆、agentic 规划等工作流方案不改进模型本身,长程一致性仍受制于基模型每一步的鲁棒性,还带来额外推理开销。结论是:强单轮性能并不自动转化为可靠的长程编辑。
本文的目标是作者的目标是把多轮鲁棒性直接'内置'到基础模型里,而不是外挂推理组件或从零重训一个多轮编辑器。具体拆成三点:其一,显著降低 15–20 轮连续编辑的累积漂移,同时基本保住基础模型已有的文生图与单轮编辑能力,在 Qwen-Image-Bench、BizGenEval、GEdit、RISE、ImgEdit 等基准上成绩贴近原模型;其二,方法与具体潜表示、注意力机制和模型架构解耦,在 FLUX、SenseNova、Qwen 三个家族的四个骨干上通用,覆盖单输入多轮与多输入多轮(多目标合成、多人物合成、骨架姿态引导)两类设置;其三,训练监督不依赖人工策划的编辑配对真值,直接从模型自身 rollout 出发、用'未被要求修改的源内容'构造保留参考,使训练成本可控,且作者用规模实验证明更多样的 rollout 数据能持续提升抗漂移能力。
与已有工作不同的是,论文的独特切入是对去噪轨迹做分阶段诊断后再动手。扩散采样是粗到细的过程:低频结构早期确立,高频细节集中在轨迹尾部恢复(Fig. 2 显示低频相似度在最后几步之前已经很高,高频相似度在尾部陡升);同时由于每个推理状态依赖前序预测,预测误差会沿轨迹传播,未修改区域的保留误差到终点仍未归零,但落在仍可修正的区间。据此作者确立'保留早期动力学、只纠正轨迹尾部'的原则,把干预点锁定在尾部,而不是像以往工作那样重塑整个预训练先验、更换表示或外挂推理时模块。再配合从模型自身 rollout 构造保留监督的'data-free'范式,形成一个最终阶段训练框架:多轮鲁棒性是在既有能力之上被'解锁'的,而不是靠跨轮数据重新学出来的——这是与多轮数据训练(VINCIE)、跨轮强化学习(MT-EditFlow)和一致性 LoRA 的本质区别。
核心方法
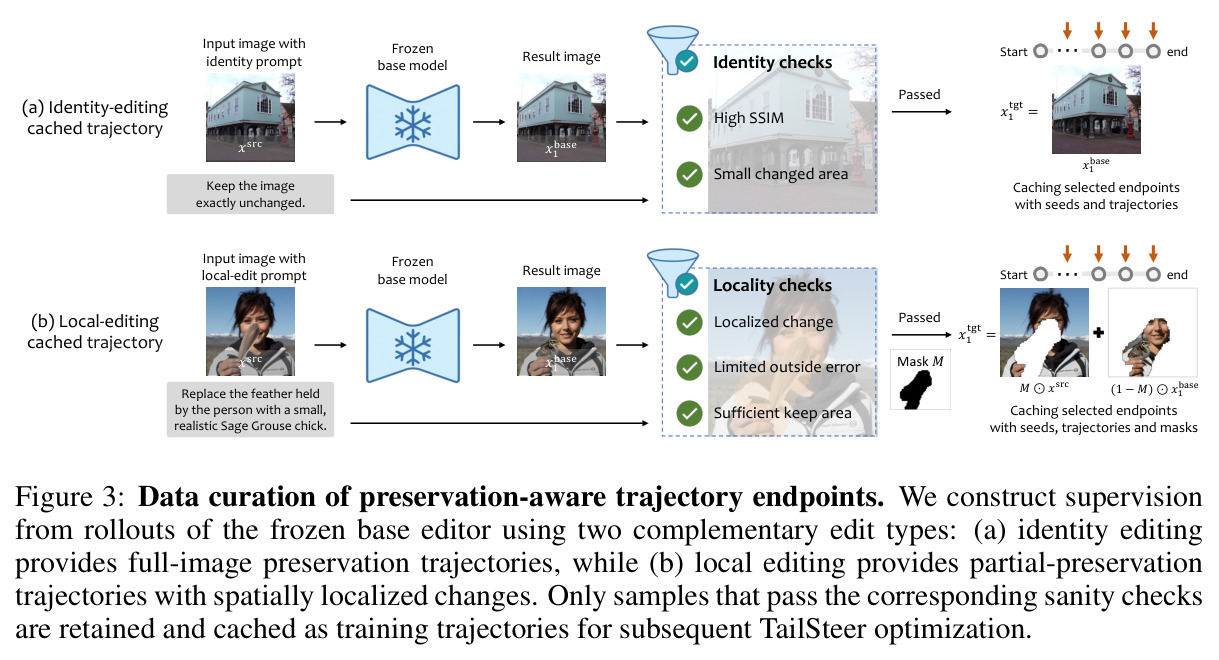
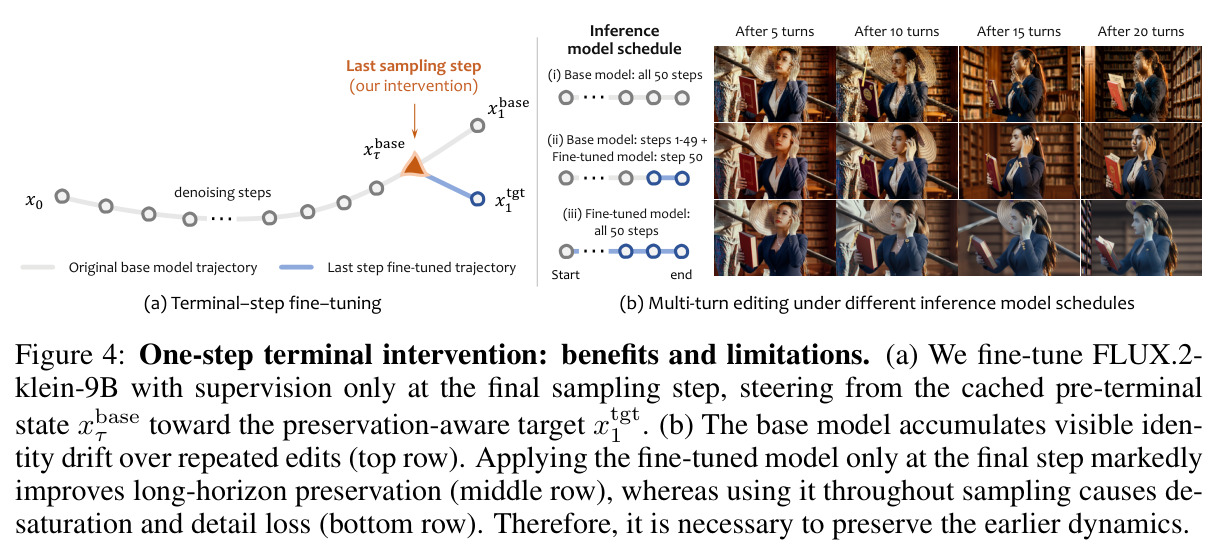
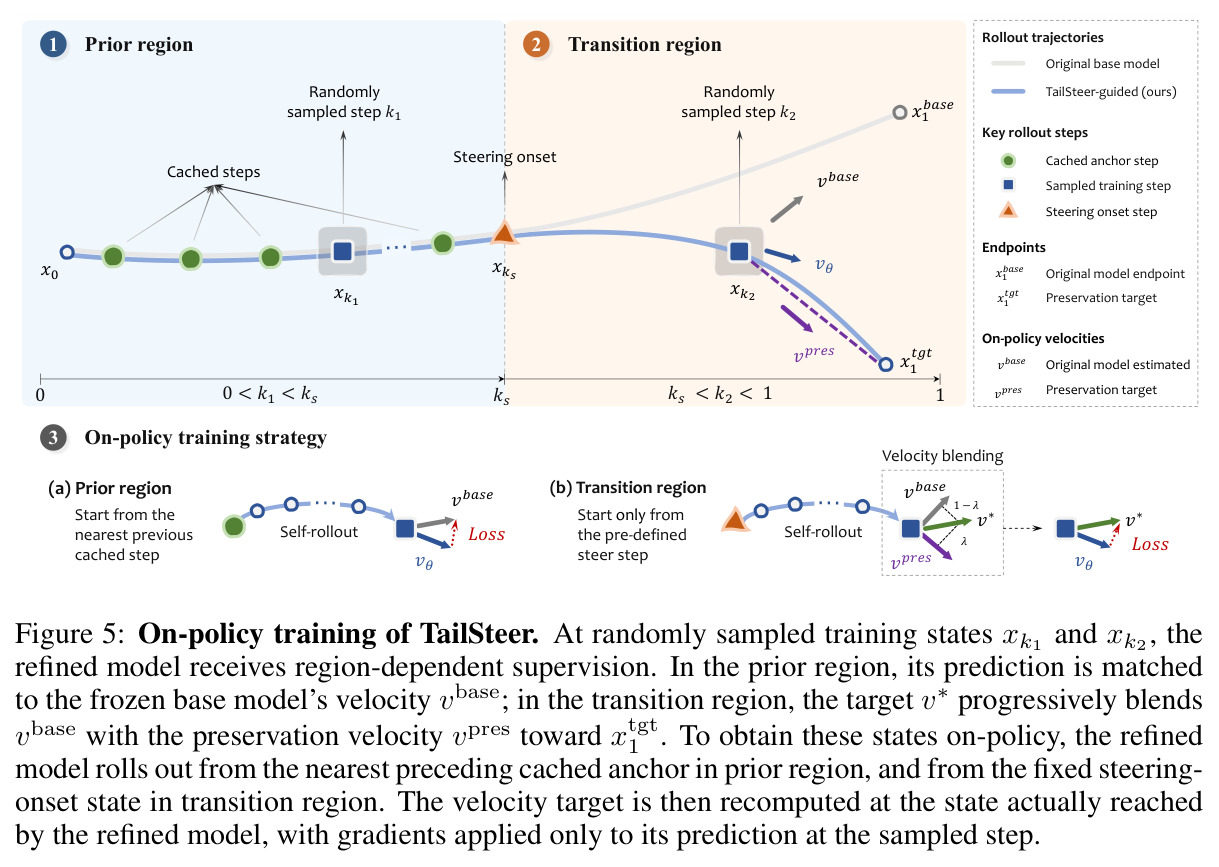
TailSteer 的直觉是:指令要求的改动长什么样交给模型自己决定,训练只负责把'没让改的地方'改回来。框架分三步递进。第一步构造保留感知的轨迹终点:身份编辑取 $M=1$;局部编辑从源图与基模型结果的差异自动导出掩码 $M$,构造目标终点 $x^{\text{tgt}}_1 = M \odot x^{\text{src}} + (1-M) \odot x^{\text{base}}_1$。第二步做最小验证:只微调最后一个采样步,从缓存的前终端状态监督到目标终点,速度目标 $v_\tau = (x^{\text{tgt}}_1 - x^{\text{base}}_\tau)/(1-\tau)$;仅最后一步换用微调模型即可 20 轮保持稳定,但全程启用会去饱和、丢细节,证明必须保住早期动力学。第三步是完整 TailSteer:引入引导起点 $k_s$,起点前复现基模型速度,起点后按 $\lambda(k)$ 把速度目标从基模型速度渐变到指向保留终点的 $v^{\text{pres}}_k$,并在被训练模型自己 rollout 到达的状态上做 on-policy 训练,最终单一模型即可独立完成全程采样。
核心创新有三层。其一,保留监督无需编辑配对真值:同一指令在不同种子下会产生不同但都合法的编辑,不应把模型拉向固定目标;而'未要求修改的内容'就在源图里,把 rollout 终点的保留区域替换回源图得 $x^{\text{tgt}}_1 = M \odot x^{\text{src}} + (1-M) \odot x^{\text{base}}_1$,既纠 rollout 偏差又尊重模型自选的编辑。其二,速度混合:$\lambda(k)$ 在起点 $k_s$ 处为 1、终端 $\tau$ 处为 0,早期与基模型动力学完全一致从而保全预训练先验,修正了单步终端微调全程启用会去饱和的缺陷。其三,on-policy 监督:基模型速度与保留速度 $v^{\text{pres}}_k = (x^{\text{tgt}}_1 - x_k)/(1-k)$ 都在被训练模型实际到达的状态 $x_k$ 上重算,损失 $\mathcal{L} = \mathbb{E}[\text{MSE}(v_\theta(x_k,k,c), \text{sg}[v^*_k])]$ 带 stop-gradient,推理时单一模型按原设置跑完全程、零外挂组件。
方法步骤详情
流程分四阶段。(1) 数据构造:从 Open Images 与 MONET 收集 11,947 张源图,每张配 3 条局部编辑 + 1 条身份编辑指令;冻结基模型 rollout 后经身份检查(高 SSIM)或局部性检查过滤,局部编辑从源图与结果的差异自动导出保留掩码,按式 (1) 缓存终点、中间锚点与掩码,共约 38,540 条轨迹。(2) 一步终端干预验证:仅对最后一步以终端损失 $\mathbb{E}[\|v_\theta(x^{\text{base}}_\tau,\tau,c)-v_\tau\|_2^2]$ 微调,确认监督有效但全程启用有害。(3) 完整训练:先验区($k\le k_s$)从最近缓存锚点(间隔不超过 3 步)短 rollout 复现基模型速度;过渡区一律从起点 $x^{\text{base}}_{k_s}$ 自 rollout,目标 $v^*_k = \lambda(k)v^{\text{base}}_k + [1-\lambda(k)]v^{\text{pres}}_k$,rollout 无梯度、梯度只回传采样步预测。(4) 配置:每骨干 2,000 updates、BF16、有效批 16、8 张 H100,四骨干 $k_s$=25/46/42/30,推理时按原步数独立完成全程采样。
技术新颖性
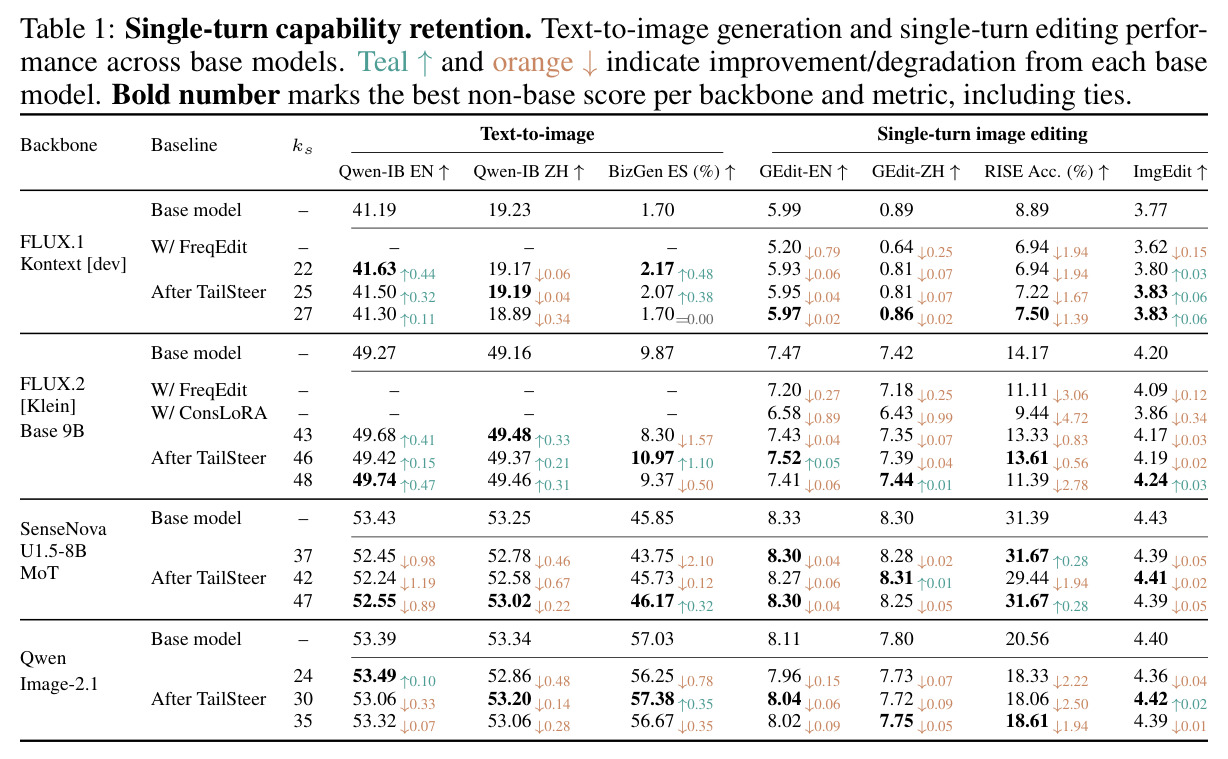
与已有工作的本质区别有四点。对辅助模块路线(FreqEdit、VAE-LFA、ConsLoRA 等外挂约束):TailSteer 不是推理时外挂,而是把纠错烧进模型权重,推理零额外组件,且不牺牲单轮能力——FreqEdit 使 GEdit-EN 降 0.27–0.79、ConsLoRA 降 0.89,而 TailSteer 基本持平(Klein 7.52 vs 7.47)。对表示层路线(VAE 重设计、像素扩散):它不改动潜空间,直接作用在去噪速度上,与骨干表示选择解耦,在 FLUX/SenseNova/Qwen 三个家族上同一套流程即可生效。对多轮专用训练路线(VINCIE 用视频数据、MT-EditFlow 用跨轮强化学习):TailSteer 只用单轮 rollout 的身份/局部编辑数据,却学到轨迹级纠错行为,并泛化到主体身份保持与多图编辑。此外它首次把'轨迹尾部'确立为多轮编辑的干预点,并提出 Add & Preserve 基准把'累积漂移'与'编辑完成度'解耦度量,弥补了聚合多轮成功率分不清'模型本来不会做'与'漂移导致做砸'的盲区。
实验结果
核心结论:抗漂移大幅提升且原能力基本不动。多轮漂移(Add & Preserve,框外对源图算指标):Klein 的 PSNR@10 从 13.85 升至 19.96(+6.11)、SSIM@10 0.289→0.621、LPIPS@10 0.524→0.290,COA 仅 31.02→31.84,并非靠压制编辑换保留;SenseNova PSNR@10 11.23→18.22 而 COA 94.78 与基线 94.93 持平;Klein 三项保留指标全面超过 GPT-Image-2.5 Sunburst API(18.55/0.540/0.378)。通用多轮基准:SenseNova 的 MSE-Bench SR@5 50%→55%,EdiVal CC@3 全部设置提升(Klein 85.24%→87.57%)。单轮保持:Klein GEdit-EN 7.52 vs 基线 7.47、ImgEdit 4.19 vs 4.20;FreqEdit 使 GEdit-EN 降 0.27–0.79、ConsLoRA 降 0.89。消融:只训最后一步 GEdit-EN 崩至 2.24、SFT 5.24 且删不掉物体、只训尾段 6.09、去 on-policy 后 7.44 但摆不出奶酪三角形,完整方法 7.52 最均衡。数据规模:1k 时局部编辑优于身份编辑(PSNR@10 17.61 vs 14.15),38,540 全量混合最优;叠加 latent feedback 绕过 VAE 后第 10 轮 PSNR 约等于普通反馈第 5 轮水平。
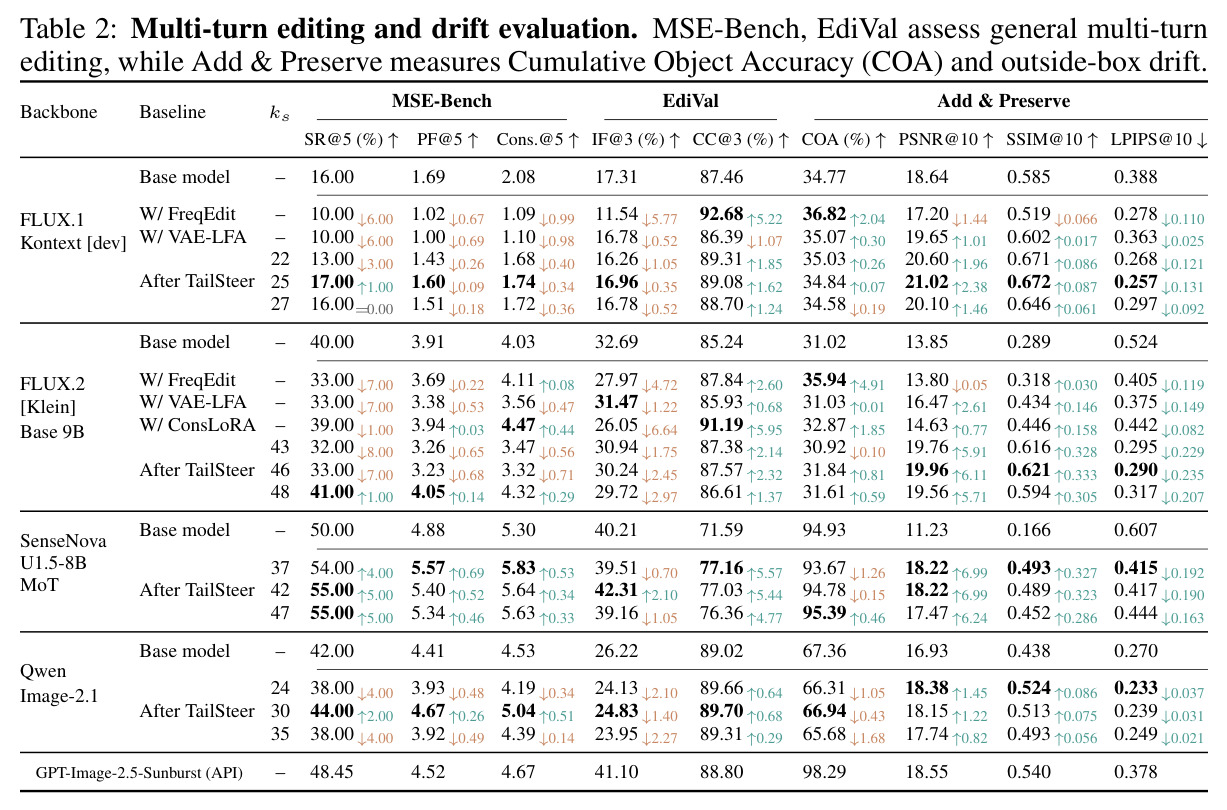
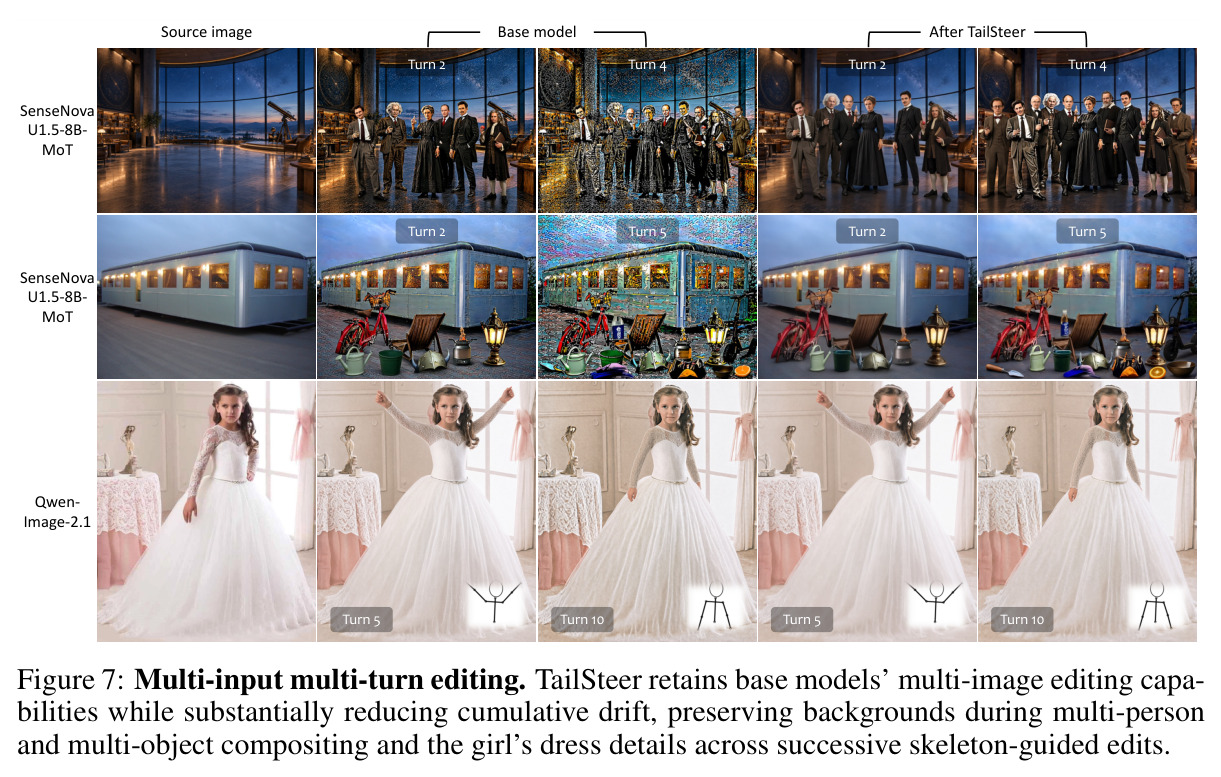
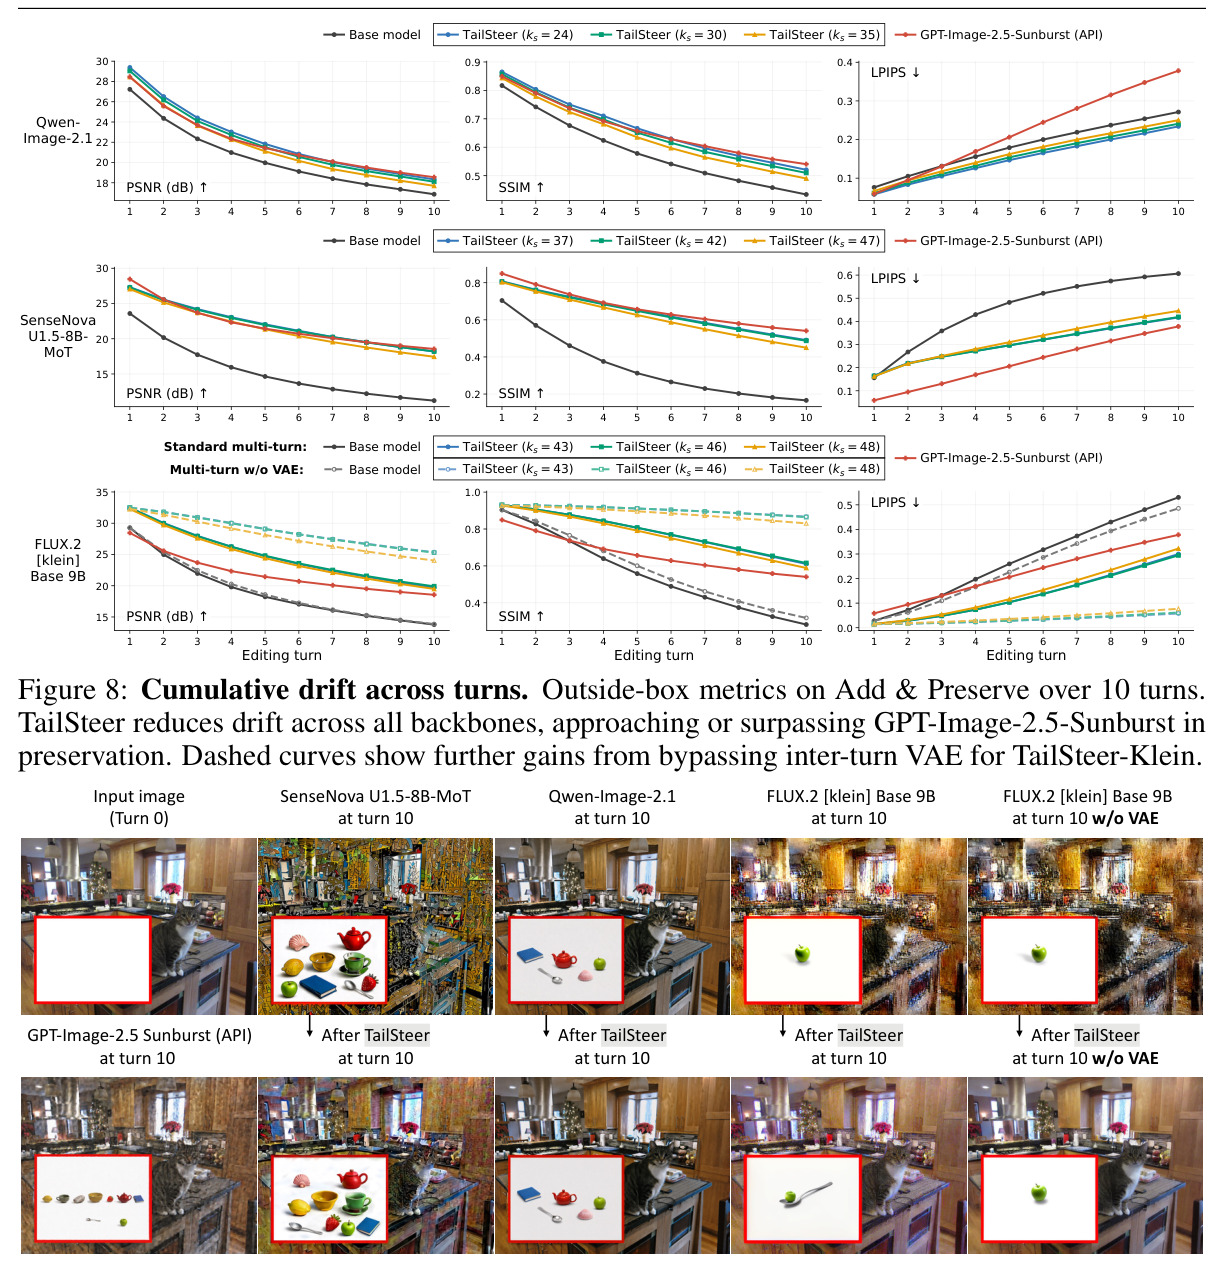
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多轮累积漂移(Add & Preserve,FLUX.2-Klein) | PSNR@10 | 19.96 | 13.85(基线模型) | +6.11;超过 GPT-Image-2.5 Sunburst 的 18.55 |
| 多轮累积漂移(Add & Preserve,FLUX.2-Klein) | SSIM@10 | 0.621 | 0.289(基线模型) | +0.333;超过 GPT-Image-2.5 Sunburst 的 0.540 |
| 多轮累积漂移(Add & Preserve,FLUX.2-Klein) | LPIPS@10(越低越好) | 0.290 | 0.524(基线模型) | −0.235;低于 GPT-Image-2.5 Sunburst 的 0.378 |
| 多轮编辑完成度(Add & Preserve,SenseNova) | COA 累积物体准确率 | 94.78% | 94.93%(基线模型) | −0.15,基本无损,同时 PSNR@10 +6.99 |
| 单轮编辑能力保持(FLUX.2-Klein) | GEdit-EN | 7.52 | 7.47(基线模型) | +0.05;对照 FreqEdit −0.27、ConsLoRA −0.89 |
| 通用多轮编辑(MSE-Bench) | SR@5 成功率 | 55%(SenseNova, ks=42) | 50%(基线模型) | +5%;Klein 在 ks=48 时 41% vs 40% |
| 通用多轮编辑(EdiVal-Bench) | CC@3 内容一致性 | 87.57%(FLUX.2-Klein, ks=46) | 85.24%(基线模型) | +2.32%,且在全部四个骨干上一致提升 |
局限与改进
作者承认的局限:MSE-Bench 上的指令跟随收益不一致,Klein 在 ks=43/46 时 SR@5 反而从 40% 降到 32/33%,不同引导起点各有利弊、需按骨干挑选;RISE 准确率普遍小幅下降(Klein 14.17%→13.61%),编辑推理有轻微损失;基于 VAE 的编辑器仍存在跨轮颜色偏移,VAE 往返本身是 TailSteer 之外的另一漂移源,latent feedback 能缓解但属于推理端附加机制。我自己的观察:保留监督只覆盖'不变/局部改'两类提示,对改色调、换视角这类整图都在变的编辑,'哪里该不变'并不明确,泛化性仍待验证;引导起点 $k_s$ 需对每个骨干在三个候选上评估后人工选定,缺乏自动化准则;Add & Preserve 采用白区+红框的合成设置,框外漂移度量与真实用户会话中的漂移形态未必完全一致,COA 还依赖自动判分器;训练时需同时持有冻结基模型与可训练副本(9B 级别)并反复 rollout,显存与工程成本不低;且方法在 30–50 步的完整采样器上验证,对少步蒸馏模型的适用性未测。
独立分析的弱点
第一,保留监督的提示分布窄:只用身份编辑与局部编辑构造监督信号,虽然论文展示了向主体身份和多图编辑的泛化,但全局风格迁移、大范围视角变化等'整图都在变'的场景如何定义保留区域尚无答案,改进方向是用 VLM 或分割模型自动判定'指令未涉及'的区域来生成更丰富的掩码。第二,数据过滤依赖高 SSIM 与局部性启发式检查,可能误杀改动大但合法的局部编辑,也可能放过高频纹理上的轻微漂移,可引入感知质量指标或轻量判别器。第三,跨轮 VAE 往返误差未被根治,TailSteer+latent feedback 只是推理端拼装,改进方向是把潜空间复用纳入训练目标或做成正式接口。第四,引导起点 $k_s$ 与 $\lambda(k)$ 的形状是超参,作者对每个骨干试三个值,模型数量增多时调参成本线性增长,可探索按频域能量曲线自动定位高频恢复起点。第五,训练需同时加载冻结基模型与可训练副本并持续 rollout,对 9B 模型是 8×H100 量级的门槛,可研究 LoRA 化的速度混合或将精炼模型蒸馏进原权重。第六,COA 与多个基准依赖 VLM 判分,评测偏差需要人工校准。
未来方向
作者明确提出的延伸方向有二:其一,潜空间复用与 VAE 保真度改进可与尾部引导叠加,他们已展示 latent feedback + TailSteer 让第 10 轮 PSNR 达到普通反馈第 5 轮的水平,说明表示层与轨迹层的纠错正交互补,值得系统化;其二,rollout 数据规模收益尚未饱和(Table 4 显示从 1k 到 38.5k 条轨迹持续变好),扩大并多样化自生成保留终点数据是清晰路径。基于成果可延伸的方向:把'保留早期动力学+纠正尾部'的原则推广到多轮视频生成、3D 场景迭代编辑等长程视觉任务;在少步/一致性蒸馏模型上检验该原则——当高频恢复被压缩进极少步数时,尾部干预点是否依然存在;将 on-policy 速度混合与跨轮强化学习(如 MT-EditFlow)结合,用漂移指标直接做奖励信号;把 TailSteer 作为 agentic 创作工作流(记忆、规划)的底层模型增强,两者正交可叠加;以及建立基于频域诊断的引导起点自动选择准则,免除逐骨干调参。
复现评估
复现条件中等偏上。有利因素:四个骨干全部开源(FLUX.1 Kontext [dev]、FLUX.2 [klein] Base 9B、SenseNova-U1.5-8B-MoT、Qwen-Image-2.1);数据源公开(Open Images、MONET),提示规则明确——每图 3 条局部编辑 + 1 条身份编辑,过滤准则(高 SSIM 身份检查、局部性检查)写清;训练超参完整(2,000 updates、BF16、有效批 16、8×H100,各骨干 $k_s$=25/46/42/30);评测基准全部公开(GEdit、RISE、ImgEdit、MSE、EdiVal 等),Add & Preserve 构造描述详细。不利因素:正文只给出项目页而未提及开源训练代码或缓存轨迹数据,on-policy rollout、锚点缓存、状态上重算速度的训练循环需自行实现;8 张 H100 门槛排除个人开发者;VLM 判分基准复跑有 API 成本。总体估计有 8 卡 A100/H100 的小团队一至两周可复现主结果;个人复现单骨干最小配置(1k 轨迹)也有参考意义。
论文图表
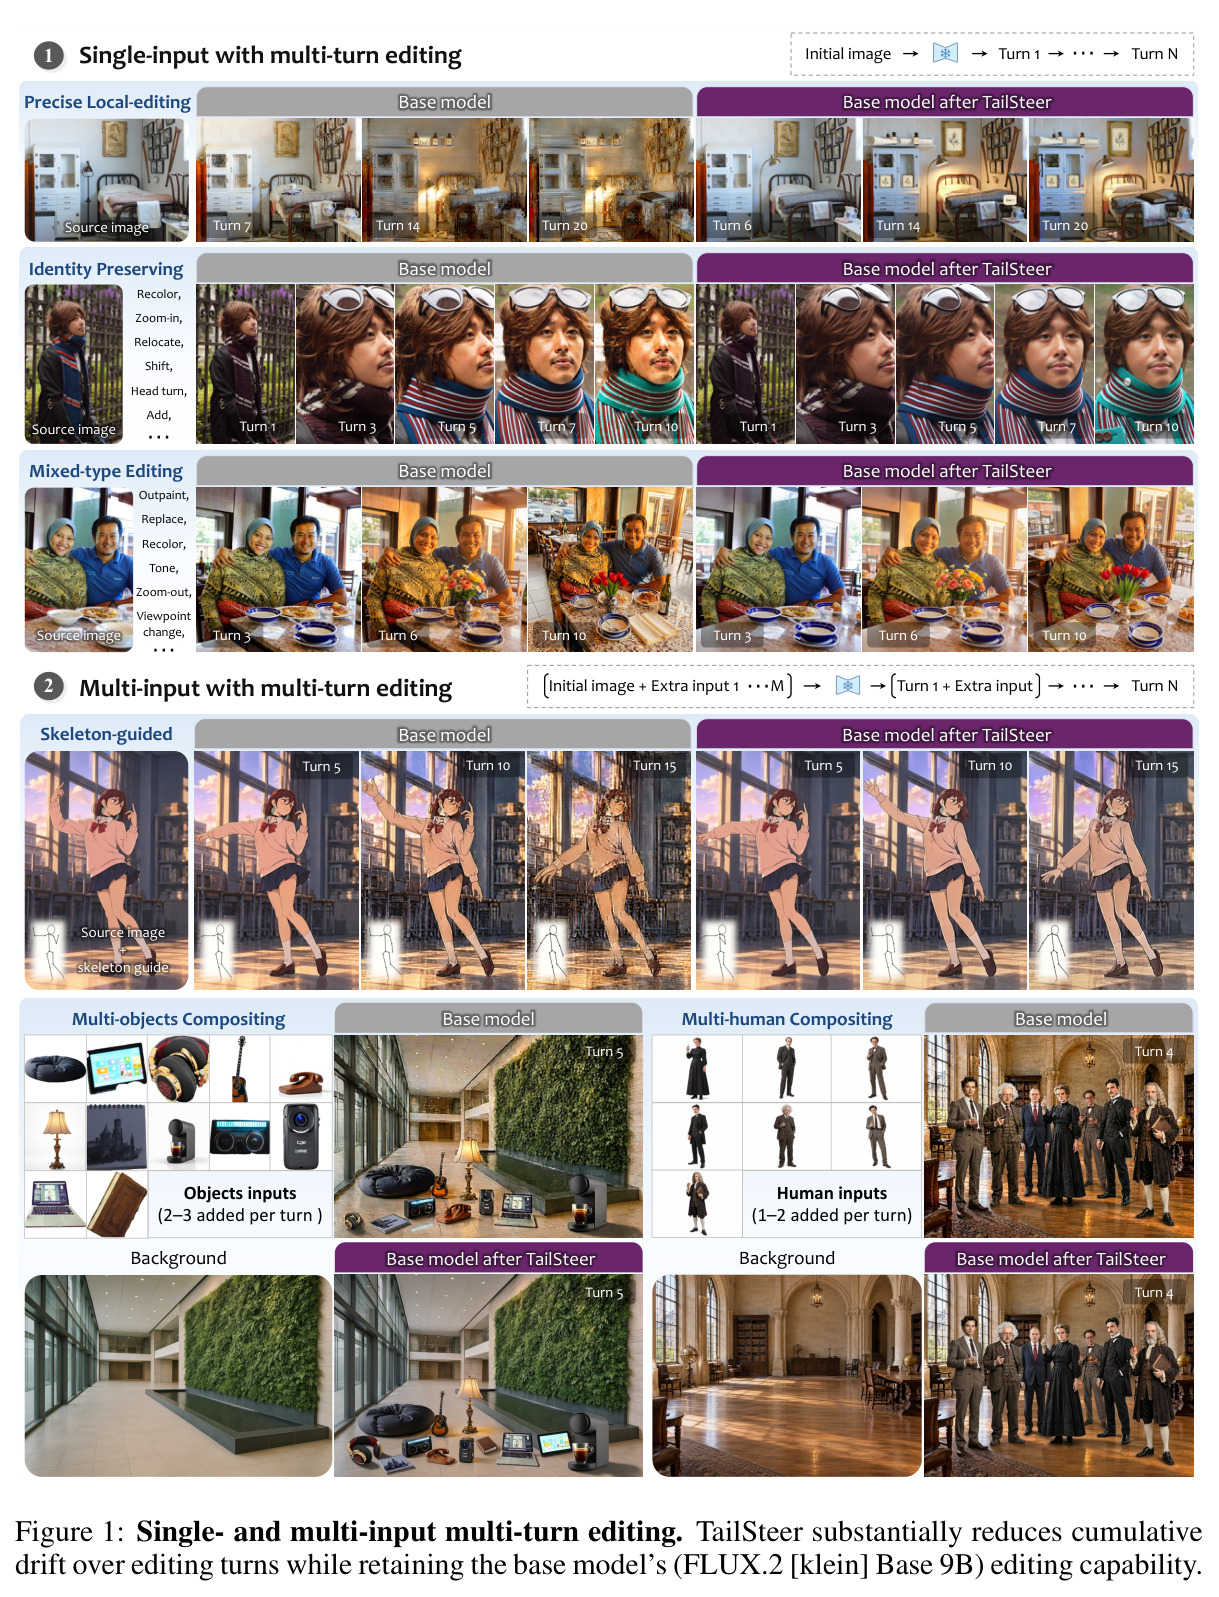
展示单输入与多输入两类多轮编辑的对比:左侧为基线模型在连续编辑(精确局部编辑 20 轮、身份保持 10 轮、混合类型 10 轮、骨架引导 15 轮、多物体/多人物合成等)后的严重漂移,右侧为 TailSteer 后同等轮数的结果,画面主体、背景与已添加内容保持稳定。
开篇即直观呈现论文要解决的核心问题与最终效果,读者一眼能看到基线在第 7–20 轮的崩溃与 TailSteer 的稳定性差距。
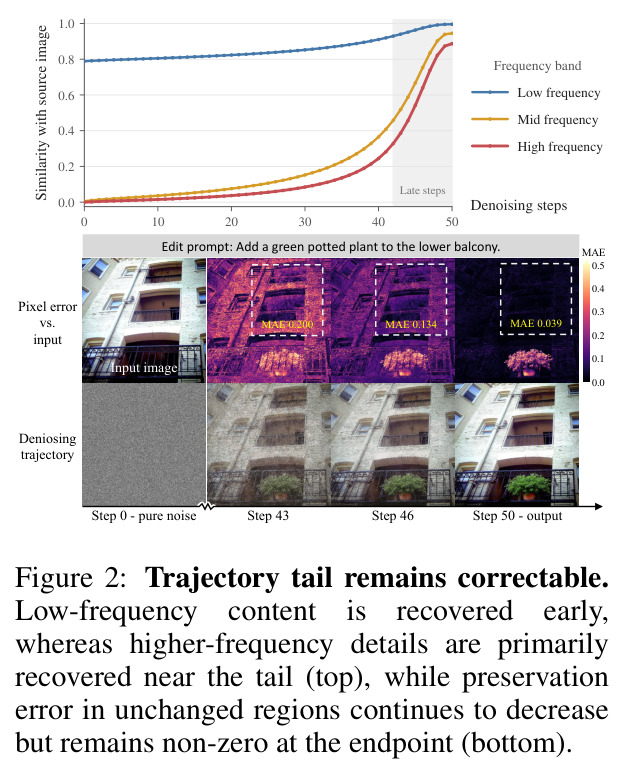
上排显示沿 50 步去噪轨迹,低频相似度在中途已接近饱和而高频相似度在尾部几步(约第 43–50 步)才陡升;下排显示未修改区域的像素 MAE 持续下降但在终点仍非零(第 43 步 0.200 → 第 46 步 0.134 → 第 50 步 0.039)。
这是方法的立论实验:证明轨迹尾部既是细节定型的时刻、又是保留误差仍可修正的时刻,直接支撑'只纠正尾部'的设计选择。
同一源图连续 20 轮编辑(加拉花、压杯、加饼干、换钢笔、加眼镜等),对比 MTC、VINCIE、FreqEdit、VAE-LFA、ConsLoRA、GPT-Image-2.5 Sunburst 与 TailSteer 在第 4/8/12/16/20 轮的输出。
主定性对比:可见 TailSteer 在 20 轮后仍保住桌面颜色与早期添加物,甚至比 GPT-Image-2.5 更忠实,直观展示方法价值。
第 10 轮的横向定性对比:基线背景已明显变色/变形,各骨干 TailSteer 版本背景贴近原图且框内物体按历史指令存在;Klein 加 latent feedback 后颜色失真更小,并与 GPT-Image-2.5 Sunburst 第 10 轮结果并列。
与 Figure 8 的曲线互为印证,让读者直观看到'漂移'具体长什么样以及 TailSteer 修复后的效果。
同一源图 10 轮编辑下对比基线、标准 SFT、只训尾段、去掉 on-policy 的 TailSteer 与完整方法:标准 SFT 第 3/6 轮删不掉物体;只训尾段编辑能力受损;去掉 on-policy 的版本第 8 轮摆不出奶酪三角形;完整方法兼顾保留与指令执行。
把 Table 3 的消融数字变成可视证据,说明先验区复现、on-policy 采样、尾段引导三个组件缺一不可。
在相同数据下对比五种训练策略(只训最后一步、标准 SFT、只训尾段、去掉 on-policy、完整 TailSteer)在单轮编辑与 Add & Preserve 上的表现:只训最后一步 GEdit-EN 崩至 2.24,SFT 5.24,只训尾段 6.09,去掉 on-policy 7.44 但 RISE 降 2.22,完整方法 7.52/PSNR@10 19.96 最均衡。
逐一验证先验区复现与 on-policy 训练的必要性,与 Figure 10 配合说明各组件失效的具体模式。
在 1k/5k/10k/38,540 条轨迹四种规模下对比身份编辑、局部编辑及两者混合数据的训练效果:小规模时局部编辑显著优于身份编辑(1k 时 PSNR@10 17.61 vs 14.15),规模增大后差距收窄,38,540 全量混合(3:1)达到最优。
回答数据层面的两个工程问题:该采哪类提示、数据要多少才够,为复现者提供直接的数据配比指引。