ACEdit:通过非对称条件实现稳定的多轮图像编辑 ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning
蒸馏训练让编辑模型在自己输出上迭代数十轮仍稳定,不累积伪影
前置知识
流匹配(Flow Matching)与蒸馏扩散模型
流匹配是扩散模型的一种训练范式:模型学习速度场 $v_\theta$,把纯噪声($\sigma=1$)沿近似直线的路径输运到干净图像($\sigma=0$)。给定中间状态 $x^{\sigma}$,模型预测可用于估计干净输出:$\hat{x} = x^{\sigma} - \sigma v_\theta(x^{\sigma})$。FLUX.2-klein-9B 是经步数蒸馏的 4 步流匹配编辑模型,推理只需 4 次前向即可出图。
论文的学生、教师、辅助编辑器全部是流匹配编辑器,蒸馏梯度需要从速度预测转换到干净输出估计,不熟悉这套记号就看不懂损失定义。
分数蒸馏(SDS / VSD / DMD)
分数蒸馏利用预训练扩散模型在噪声水平 $t$ 上的预测近似噪声图像分布的 score,直接优化生成器参数而不需要成对目标图像。SDS 用模型预测减去采样噪声,方差大、结果易过饱和模糊;VSD 引入一个在生成样本上微调的辅助模型,用『教师预测 − 辅助模型预测』作为梯度,抵消去噪分量、降低方差;DMD 进一步把 VSD 用于训练一个学生生成器逼近教师分布。
本文核心训练信号就是 DMD 式的蒸馏梯度,理解『教师减辅助编辑器』这一结构是读懂方法设计的前提。
Self-Forcing(自强制训练)
源自自回归视频生成的训练原则:训练时模型以自己之前生成的帧(而非干净真值历史)为条件继续生成下一段,即在自己的 rollout 上训练,从而在训练阶段就暴露并学习推理时才会遇到的分布偏移。
本文把该原则首次系统迁移到多轮图像编辑,让学生在自己输出的 10 轮编辑链上训练,是整个方案的骨架。
多轮编辑中的累积分布偏移
指令编辑模型训练时的输入都是干净图像,而多轮使用时第 $e$ 轮的输入是模型自己前 $e-1$ 轮的输出。每轮引入的微小分布偏移逐轮累积,使输入逐渐偏离训练分布,表现为伪影累积、细节丢失和颜色漂移,轮数越多越严重。
这是论文要解决的核心问题:Figure 1 中基线模型 15 步后毛发纹理消失并出现强烈色偏,正是这种偏移累积的直观表现。
LoRA 低秩适配
LoRA 冻结预训练权重,只在部分层注入可训练的低秩分解矩阵 $\Delta W = BA$($B\in\mathbb{R}^{d\times r}$,$A\in\mathbb{R}^{r\times k}$,秩 $r$ 很小),用极少量参数承载微调能力,显著降低显存与算力需求。
本文学生和辅助编辑器都只训 rank 16 的 LoRA(27.8M 参数,约占模型 0.3%),全流程仅 4.4 GPU 小时,直接决定了复现门槛极低。
研究动机
现代指令式编辑模型(如 FLUX.2 Klein)单次编辑质量已很高,但用户往往要连续十几轮修改同一张图。问题在于:编辑模型训练时输入都是干净图像,而多轮使用时第 $e$ 轮的输入是模型自己前 $e-1$ 轮的输出,每轮引入的微小分布偏移逐轮累积,使推理输入逐渐偏离训练分布,表现为伪影累积、细节丢失和颜色漂移——Figure 1 中基线在含 no-op 的 15 步序列后毛发纹理消失、出现强烈色偏。现有对策各有短板:训练无关方法(Emu Edit 像素阈值、VAE-LFA 低频潜空间对齐、FreqEdit 高频引导)把输出拴在上一帧上,编辑恰好要改动被锚定区域时旧内容渗透回来,且有推理开销;训练类方法中 VINCIE 依赖视频衍生序列,AnchorEdit 需监督式因果多轮训练加身份锚定,MT-OPSD 在内容固定的 identity-edit rollout 上蒸馏、误差照旧累积;在真值序列上训练又留下训练-推理鸿沟。此外现有多轮基准太短:EdiVal 只链 3 次编辑、MSE-Bench 5 次、Omni IIE Bench 平均仅 4.35 轮(260 条中仅 9 条到 10 轮),根本测不出漂移。
本文的目标是本文目标是给出一个训练方案,使图像编辑模型在多轮连续编辑中保持稳定:模型在自己输出组成的序列上训练后,既忠实执行每轮指令,又尽可能保持场景与已编辑内容不随轮数退化,同时不牺牲单步编辑质量。作者明确提出几个约束:(1) 不引入任何推理时开销,训练后模型与原模型采样方式完全相同(仍是 4 步无引导采样);(2) 对分布偏移的性质不做任何假设,对编辑序列不加限制(不要求 no-op 或内容固定);(3) 训练必须高效——最终只微调约 0.3% 的参数、单张 B200 上 4.4 GPU 小时完成。为支撑量化评估,作者还构建了 EdiVal-10 基准(252 条 10 轮累积编辑链),使『10 轮后的质量、保持性、指令遵循』可以被系统测量。
与已有工作不同的是,本文的切入点是把自回归视频生成中的 Self-Forcing 原则首次系统引入图像编辑:训练时让学生在自己生成的 10 轮编辑 rollout 上操作,直面推理时的分布偏移。但纯 Self-Forcing 在编辑场景不可行——一次编辑存在多种合理结果,学生中间输出一旦偏离真值轨迹,后续真值图像无法作为成对监督目标。作者的独特解法是非对称条件:学生只看(上一帧输出 $I_{e-1}$,当前指令 $c_e$),而教师始终锚定在(原始干净图 $I_0$,复合指令 $h_e$),即把前 $e$ 轮指令合并成一句复合编辑来评分。与 MT-OPSD 的关键区别在于:MT-OPSD 的 rollout 内容固定(identity edit),而本文 rollout 是内容持续演化、保持需求逐轮变化的真实编辑过程;与 DMD 的区别在于编辑教师的条件除文本外还包含图像,复合指令让教师无需接触被污染的中间图就能评估多轮结果。
核心方法
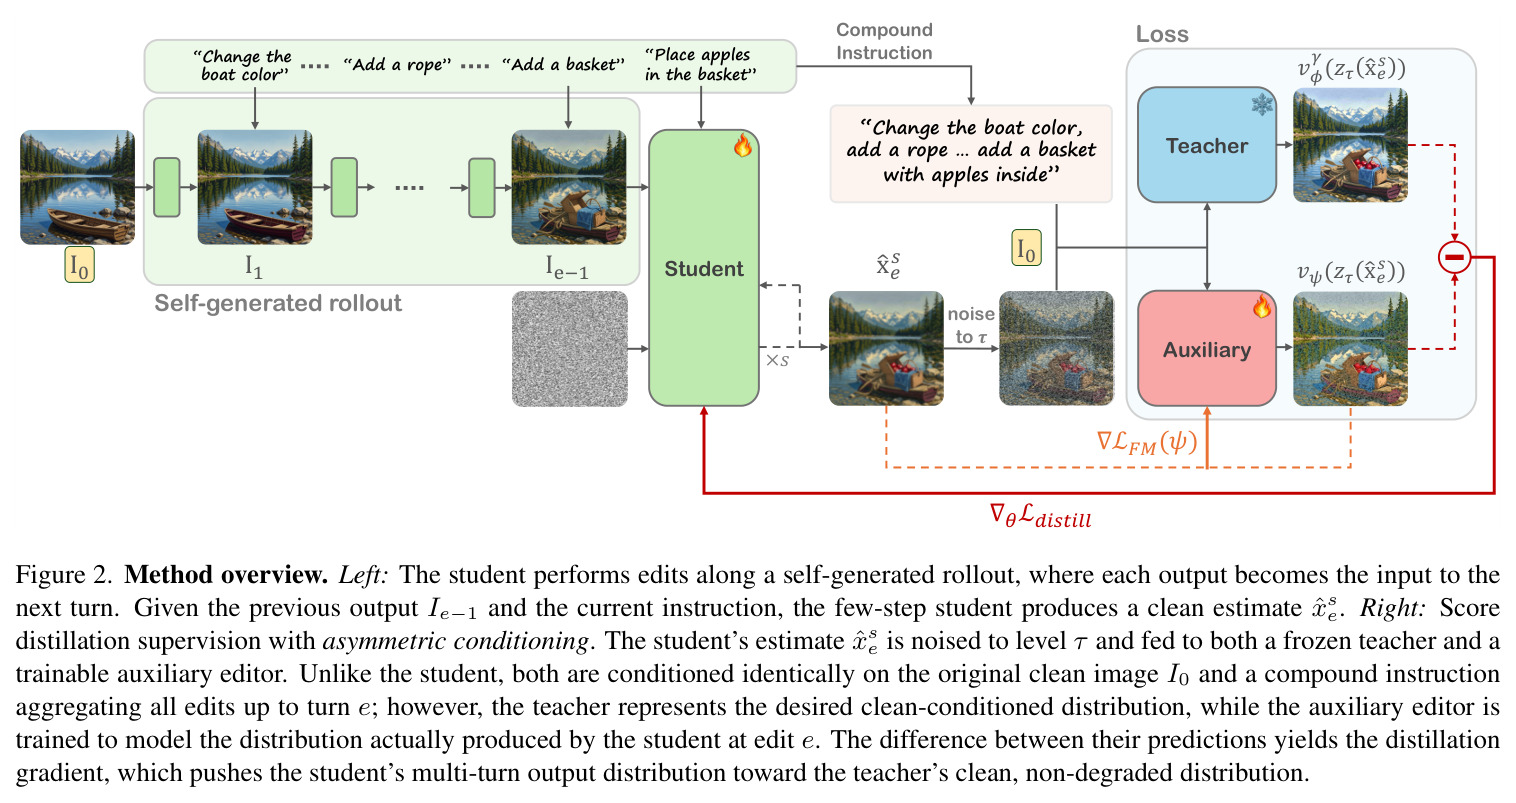
直觉上,多轮编辑像传话游戏,每传一轮丢一点信息。要防止跑偏,不能只盯单步质量,而要有一位始终知道『完整故事』的裁判,对着最初版本给整条链打分。技术上,作者以 FLUX.2-klein-9B(4 步蒸馏流匹配编辑器)为学生 $G_\theta$,冻结的 FLUX.2-klein-base-9B(同族未蒸馏版)为教师 $v_\phi$(CFG 尺度 2),另训一个同架构辅助编辑器 $v_\psi$。学生在自己输出的 $E=10$ 轮 rollout 上滚动编辑;在采样的编辑轮 $e$ 与去噪出口步 $s$,用 $\hat{x}^{s}_{e} = x^{\sigma} - \sigma v_\theta(x^{\sigma})$ 估计干净输出,加噪到 $\tau$ 后同时喂给教师和辅助编辑器,二者都在 $(I_0, h_e)$ 条件下预测速度,其差乘 $w_e(\tau)$ 构成蒸馏梯度 $\nabla_\theta \mathcal{L}_{\text{distill}} = w_e(\tau)(\hat{v}^{\gamma}_{\phi} - \hat{v}_{\psi})\, \partial \hat{x}^{s}_{e}/\partial \theta$,把学生多轮输出分布拉向教师『干净条件』下的分布。潜码在轮间直接传递、不经 VAE 编解码;推理图结构完全不变,零额外开销。
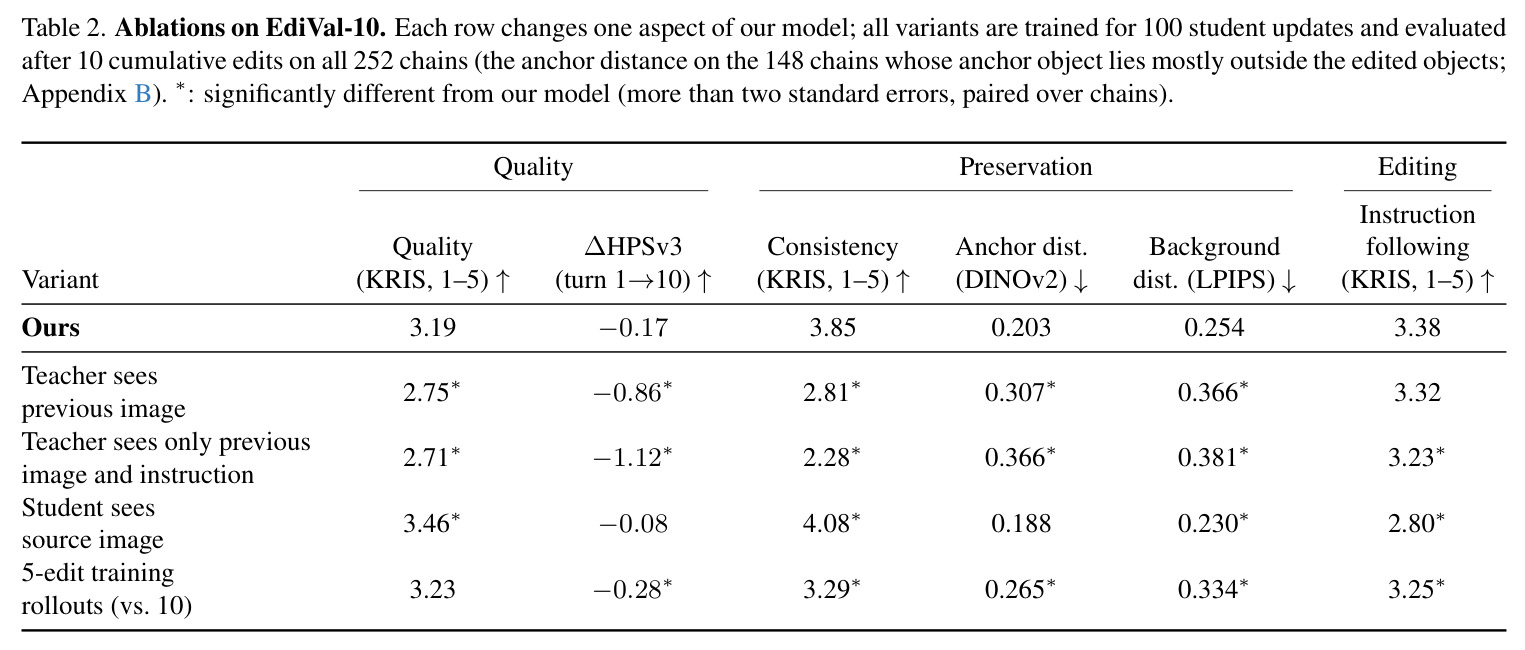
核心创新是非对称条件:学生与教师看到不同的世界。学生在推理式的状态下工作——只拿到上一轮输出 $I_{e-1}$ 和当前指令 $c_e$,因此训练覆盖的正是推理时会遇到的、可能已带累积误差的输入分布;而教师从不看学生的中间产物,它拿到的永远是原始干净图 $I_0$ 加累积指令 $h_e=(c_1,\dots,c_e)$,把多轮编辑视作一次复合编辑来评分(例如『加手包→改成红色→改成皮革→加金色扣』四步,等价于教师一步完成『加一个带金色扣的红色皮革手包』)。这样蒸馏信号忠实反映全部编辑意图,却不继承学生轨迹上的任何累积错误;第一轮两者条件恰好重合,因此每个 rollout 还顺带监督了一次普通单步编辑。非对称之所以必要,消融给出直接证据:若让教师也看上一帧输出,一致性得分从 3.85 跌到 2.81,甚至低于未微调基线的 3.03——被学生伪影污染的教师反而会强化而非纠正这些伪影;而把源图也给学生会引发已做编辑被回滚(指令遵循 3.38→2.80),说明两端条件都必须『恰到好处』。
方法步骤详情
(1) 数据:96 张 1024×1024 合成场景图(FLUX.2-klein-9B 生成),每张配 10 条局部编辑指令(增、删、替换、缩放或改属性),共 960 条;评测用真实照片,与训练集无重叠。(2) 生成 rollout:从 $I_0$ 出发,学生以完整 4 步去噪执行每轮编辑 $I_e = G_\theta(I_{e-1}, c_e)$,潜码直接传给下一轮。(3) 抽取监督点:每次迭代采样编辑轮 $e$ 与去噪出口步 $s\in\{1,\dots,4\}$,得干净估计 $\hat{x}^{s}_{e} = x^{\sigma} - \sigma v_\theta(x^{\sigma})$,梯度只经该步回传,不穿过更早的步或轮。(4) 蒸馏更新学生:把 $\hat{x}^{s}_{e}$ 加噪到 $\tau \sim U[0,1)$,教师(CFG 尺度 2,无条件分支保留 $I_0$、只丢指令)与辅助编辑器(无 CFG)在 $(I_0, h_e)$ 下各预测一次速度,差值经 $w_e(\tau)$ 加权后更新学生 LoRA,损失对 10 轮取平均。(5) 训辅助编辑器:对全部 10 个 $\hat{x}^{s}_{e}$ 以流匹配损失 $\mathcal{L}_{\text{FM}}$(目标为 $\epsilon - \hat{x}^{s}_{e}$)每步更新;教师全程冻结。(6) 调度:先 5 步只训辅助编辑器热身,随后 500 步内学生每 5 步更新一次(共 100 次);AdamW($\beta=(0,0.999)$,权重衰减 0.01,梯度裁剪 10,bf16),学习率学生 $4\times10^{-5}$、辅助 $8\times10^{-6}$,LoRA rank 16;总训练约 4.4 GPU 小时(单张 B200),推理与原模型完全相同。
技术新颖性
与已有工作的本质区别有三层。其一,对比推理时防漂移方法(Emu Edit、VAE-LFA、FreqEdit):本文把稳定性内化进权重,推理图结构不变,没有逐帧比对、频率滤波等额外开销,也不存在『输出被拴在上一帧』导致旧内容渗漏的结构性缺陷。其二,对比多轮训练方法:VINCIE 依赖视频衍生的 in-context 序列,AnchorEdit 需要监督式因果多轮训练加身份锚定,MT-OPSD 的 rollout 是内容固定的 identity-edit(误差仍会累积);本文 rollout 是真实编辑过程——内容逐轮演化、保持需求逐轮变化——并用分布匹配替代成对损失,回避『一次编辑多解』的监督难题。其三,非对称条件本身是对 Self-Forcing/DMD 框架的实质性改造:DMD 中教师与学生看同一个 prompt,这里教师被刻意锚定到干净源图与复合指令,把『暴露于偏移』(学生侧)与『可靠监督』(教师侧)解耦,用分数蒸馏连接两条路径而不需要成对目标——作者认为这是一条可推广到一切递归生成过程的通用训练原则。
实验结果
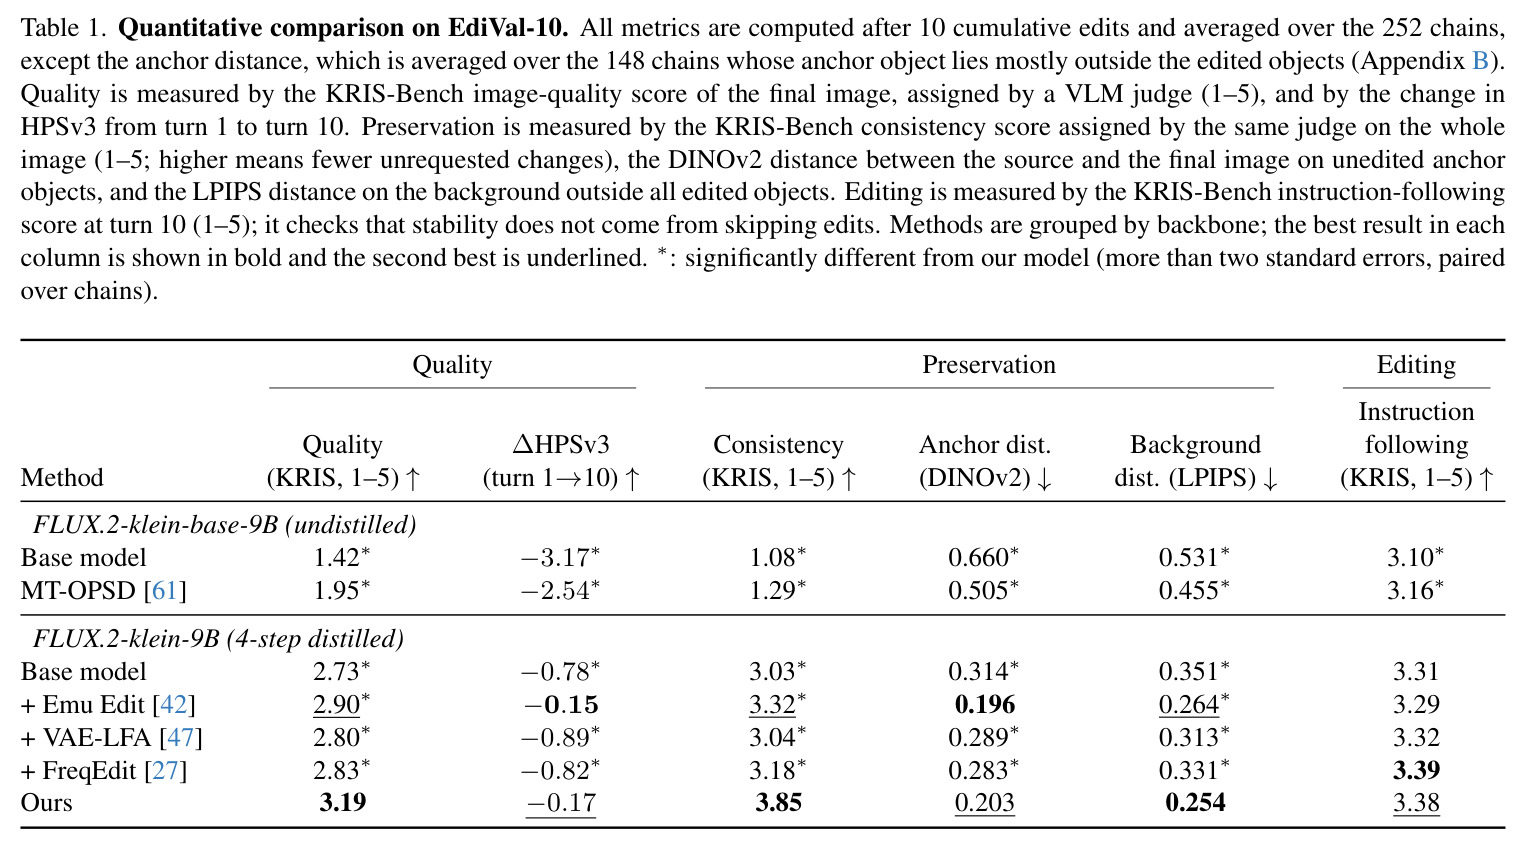
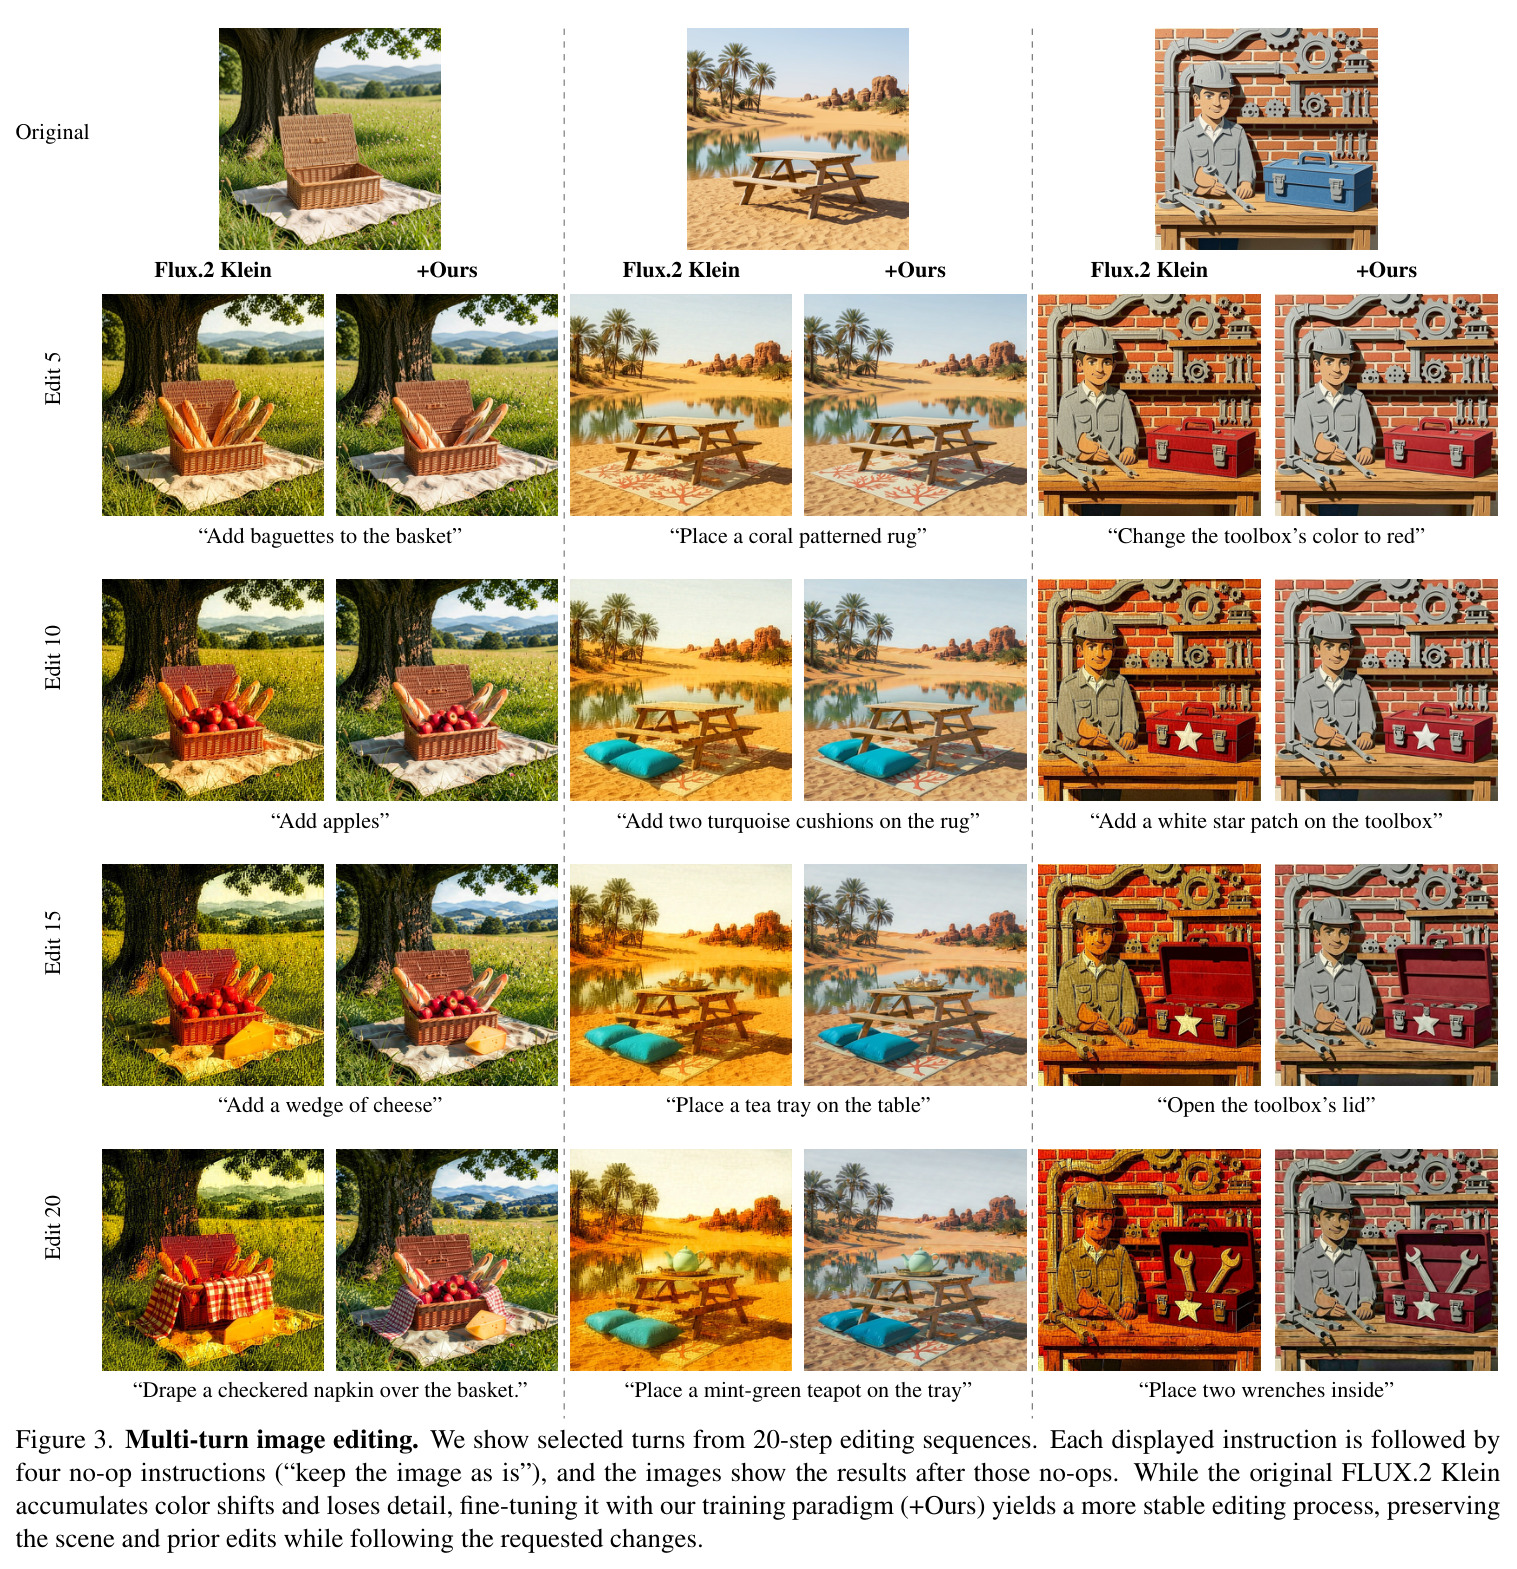
主实验在自建 EdiVal-10(252 条 10 轮累积编辑链、GEdit-Bench 真实照片、每链留 1-2 个不许动的锚物体)上进行,Gemma-4-31B 按 KRIS-Bench 提示判分,显著性按链配对、超两个标准误判定。10 轮后本文质量得分 3.19,显著高于所有对手(对次优 Emu Edit 为 +0.30±0.08);一致性 3.85,远超训练无关方法的 3.04-3.32、基线 3.03 与 MT-OPSD 1.29;背景 LPIPS 0.254 全场最低(基线 0.351,次优 Emu Edit 0.264 也显著更差);锚物体 DINOv2 距离 0.203,与 Emu Edit 的 0.196 统计无差;指令遵循 3.38,与最高 FreqEdit(3.39)无显著差、显著高于 MT-OPSD(3.16),说明稳定性不靠跳过编辑;$\Delta$HPSv3 −0.17,与 Emu Edit(−0.15)无显著差。单步也没牺牲:GEdit-Bench 606 条指令上单次编辑 HPSv3 只降 0.18,基线降 0.41(差 0.23±0.02),其余方法退化均显著更多。消融(Table 2,100 次学生更新):教师额外看上一帧,一致性跌至 2.81;只看上一帧加指令,跌至 2.28;学生看源图,一致性升至 4.08 但指令遵循崩到 2.80(编辑被回滚);5 轮 rollout 训练只恢复约三分之一增益(一致性 3.29)。定性上(Figure 4),连续 10 次物体删除后 Emu Edit 留下苍白块状 patch、VAE-LFA 变暗发霉、FreqEdit 发黄、MT-OPSD 洗白模糊,本文方法场景保持原样。作者还发现反复替换主体/背景的长序列本就不退化,退化集中在需内容跨轮保持的场景。
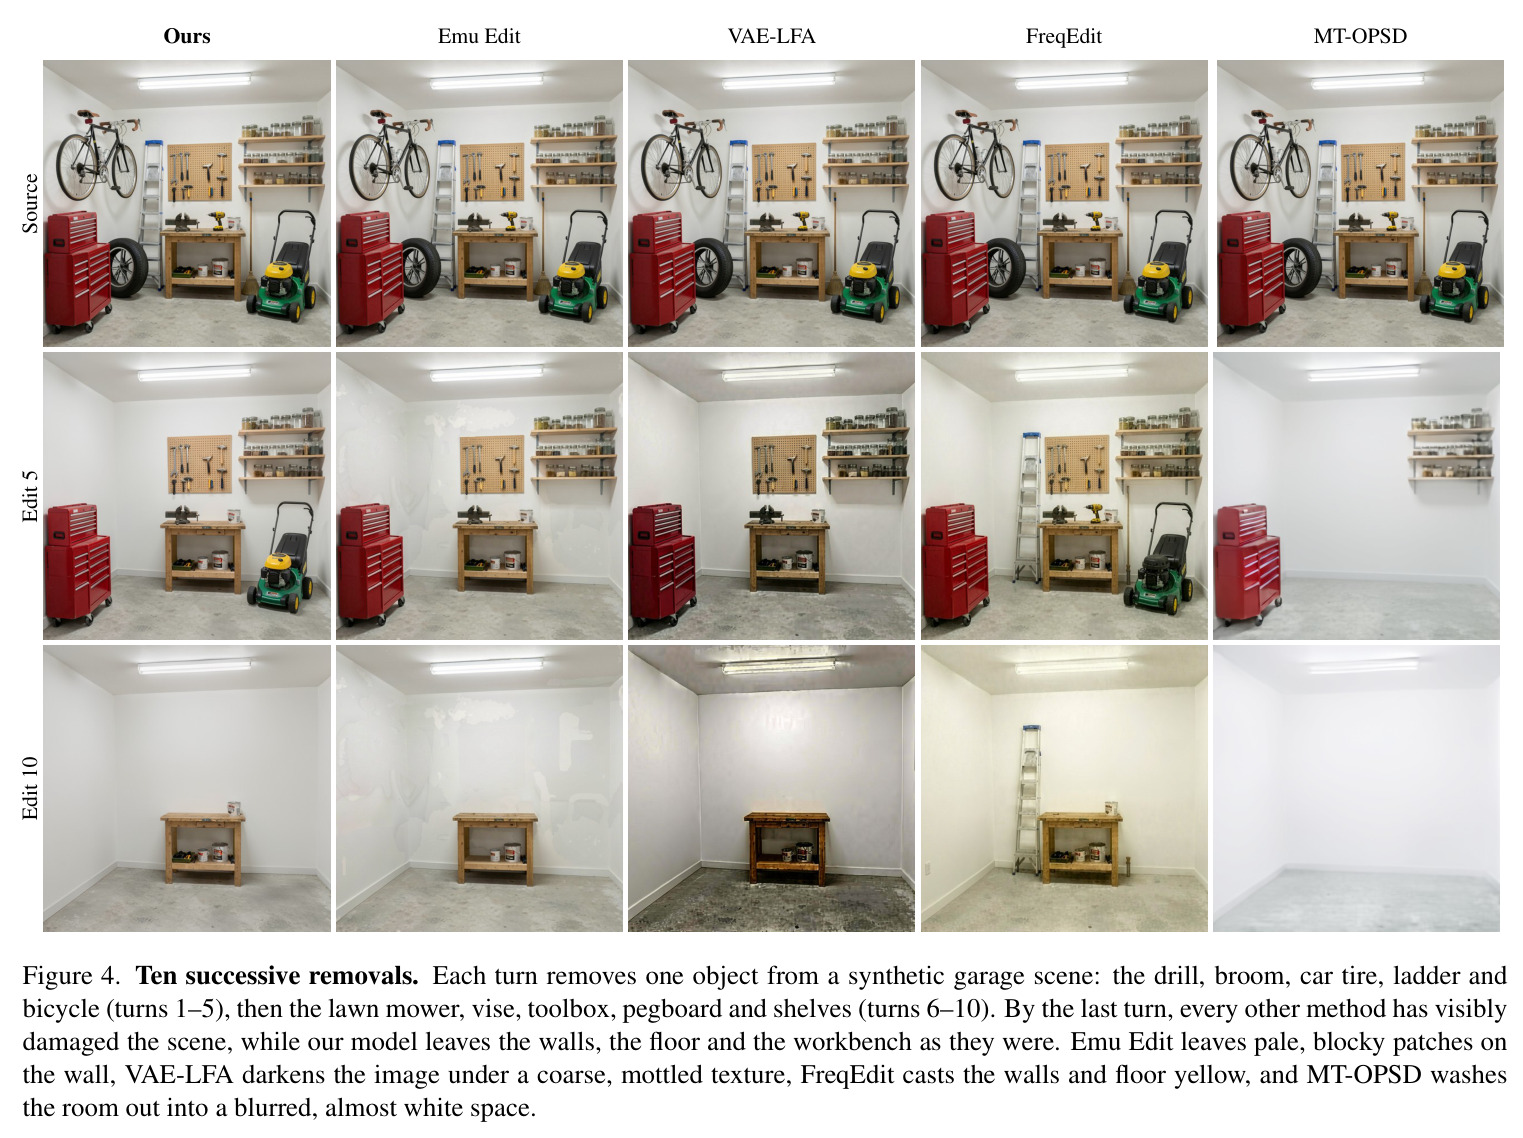
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多轮图像编辑(10 轮,EdiVal-10,252 链) | KRIS 图像质量得分(1-5,VLM 判分) | 3.19 | FLUX.2-klein-9B 基线 2.73;最佳对手 Emu Edit 2.90 | 较基线 +0.46,较次优 +0.30±0.08(对全部方法显著) |
| 多轮图像编辑(10 轮,EdiVal-10) | KRIS 一致性得分(1-5,越高非受求改动越少) | 3.85 | 蒸馏基线 3.03;训练无关方法 3.04-3.32;MT-OPSD 1.29 | 较基线 +0.82,较次优 Emu Edit +0.53(显著) |
| 多轮图像编辑(10 轮,EdiVal-10) | 背景 LPIPS 距离(越低越好) | 0.254 | 蒸馏基线 0.351;次优 Emu Edit 0.264 | 较基线降低 0.097;对 Emu Edit 优势 +0.010±0.005(显著) |
| 多轮图像编辑(10 轮,EdiVal-10,148 链) | 锚物体 DINOv2 距离(越低越好) | 0.203 | Emu Edit 0.196;蒸馏基线 0.314 | 与 Emu Edit 统计无差(−0.007±0.012),其余方法均显著更差 |
| 多轮图像编辑(10 轮,EdiVal-10) | KRIS 指令遵循(1-5) | 3.38 | FreqEdit 3.39;MT-OPSD 3.16;蒸馏基线 3.31 | 与最高分无显著差;显著高于 MT-OPSD 与未蒸馏基线 |
| 单步编辑(GEdit-Bench 606 条指令) | $\Delta$HPSv3(源图到编辑结果) | −0.18 | 蒸馏基线 −0.41 | 退化减少 0.23±0.02;所有对手的单步退化均显著更多 |
局限与改进
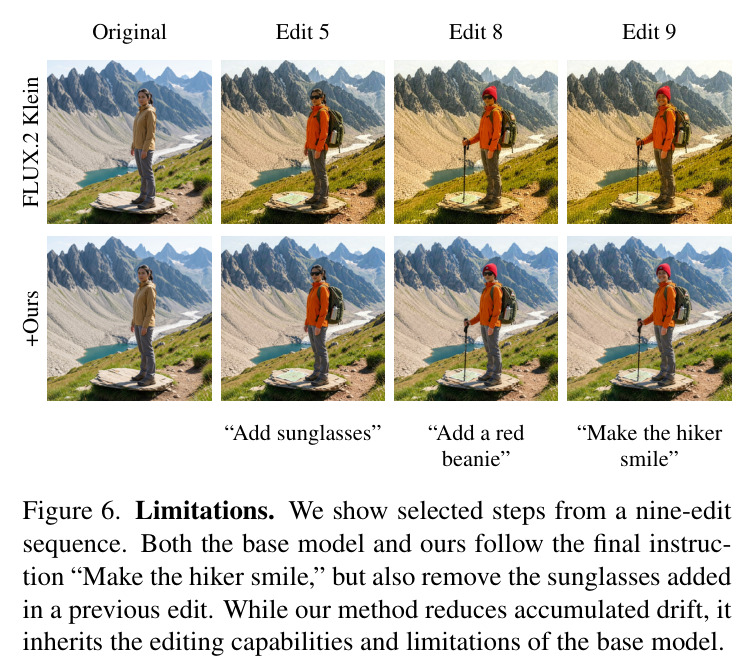
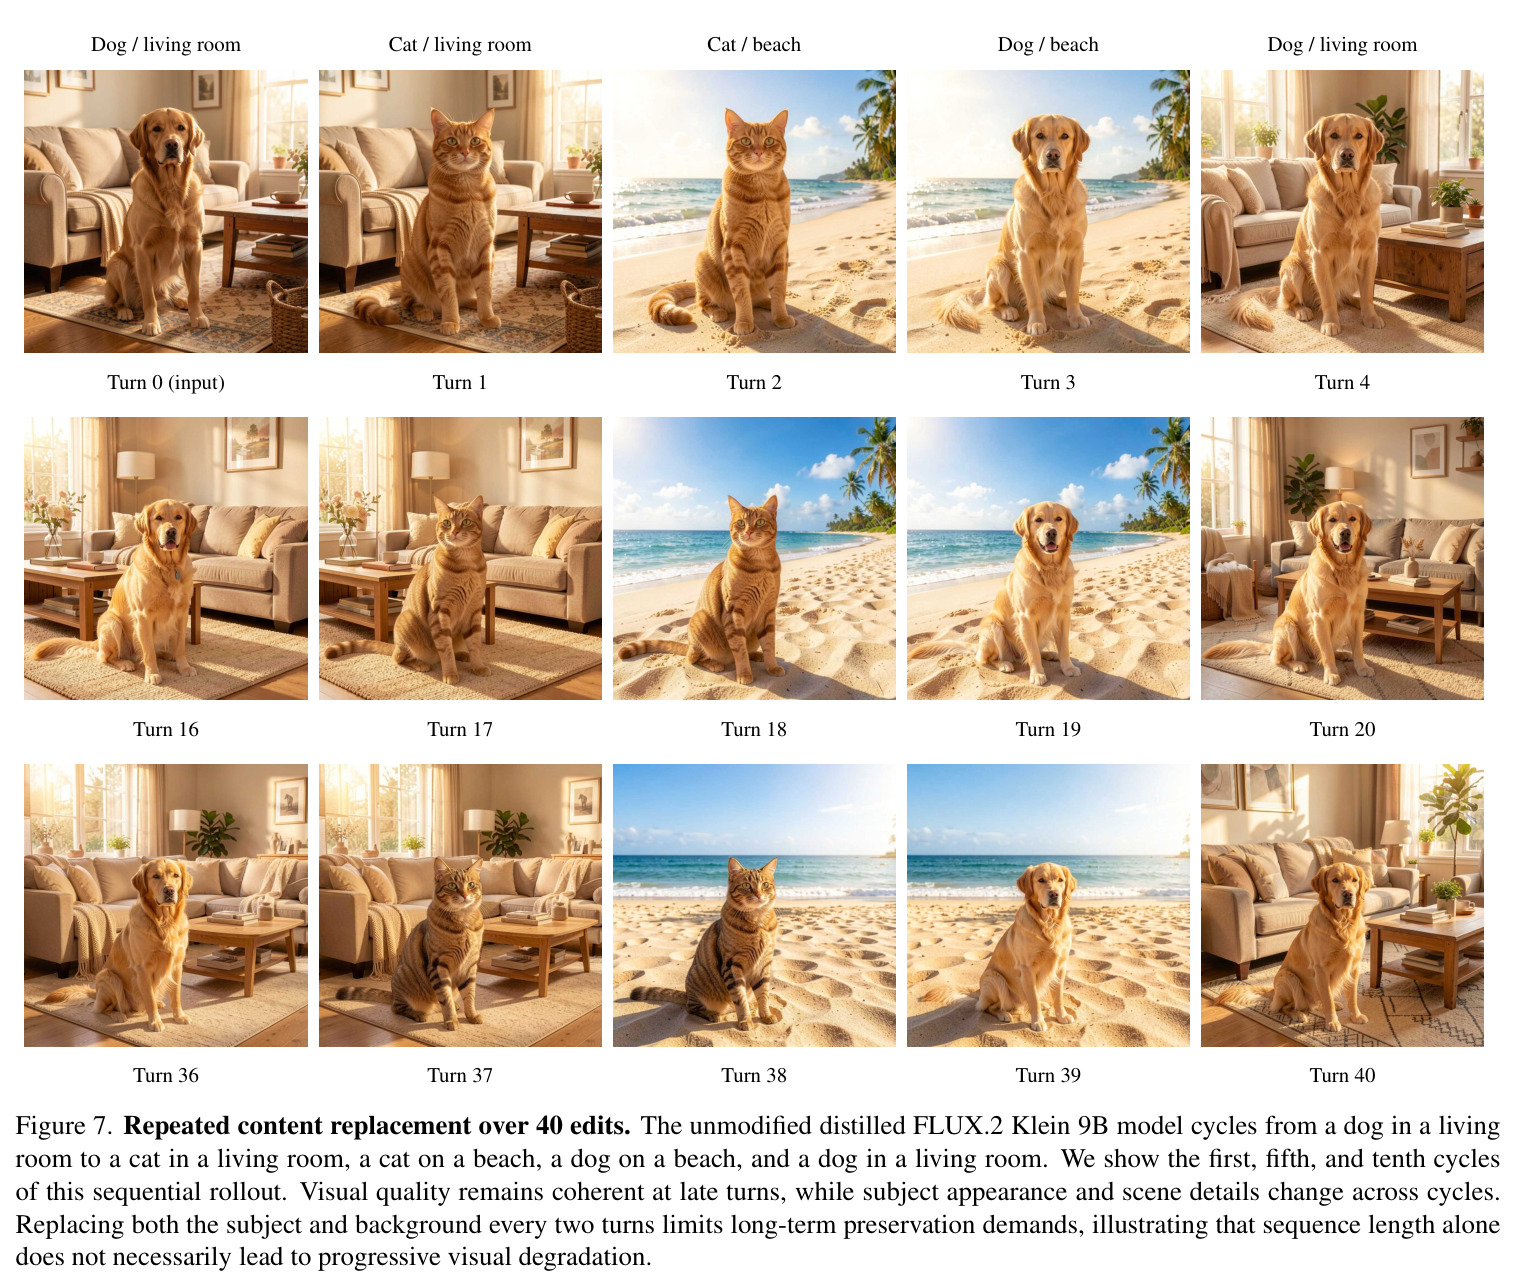
作者承认的局限:其一,稳定性与指令遵循是相关但不同的目标,困难指令仍会波及已编辑内容——Figure 6 中前几轮加上的墨镜,在最后『让徒步者微笑』时被顺手抹掉;其二,方法完全继承基模的能力上限与固有缺陷;其三,训练只用 10 轮 rollout,虽能泛化到更长序列(20 步仍稳定),但远超训练长度的鲁棒性仍是未来工作;其四,方法聚焦『未受影响内容必须跨轮保持』的序列,因为反复替换主体/背景的任务本身就不退化(Figure 7)。我的补充观察:(1) 训练数据全是 96 张合成场景加局部编辑,对全局编辑(风格、色调)与真实照片分布的泛化未验证;(2) 质量与一致性依赖 Gemma-4-31B 单一 VLM 判分、无人类评测,VLM 可能对保守、改动少的输出有系统性偏好;(3) 教师与学生同族,最终质量被教师单步复合编辑能力封顶;(4) 复合指令随轮数线性增长,几十轮时文本编码可能稀释或溢出;(5) EdiVal-10 由作者用 LLM 自建,训练类基线只比了 MT-OPSD 一个,与 VINCIE、AnchorEdit 缺少直接对比。
独立分析的弱点
几点独立分析:(1) 复合指令的可扩展性存疑——把 10 轮指令拼成一句复合编辑依赖教师的长文本理解,50 轮时可能溢出上下文或语义稀释,改进方向是让 LLM 先把累积指令压缩为摘要式复合指令,或对教师采用层级化条件。(2) 学生只见上一帧导致『无法回头』——消融显示把源图给学生会引发编辑回滚(指令遵循 3.38→2.80),说明模型缺乏『哪些是历史编辑、哪些是原始内容』的显式记忆,可尝试给条件加轻量的编辑时间戳或掩码编码。(3) 训练效率与扩展性——学生每 5 步才更新一次、100 次更新即收敛,更长训练能否继续抬升尚不清楚;且蒸馏需对每条 rollout 前向教师与辅助编辑器,扩大模型或分辨率时算力线性放大,可探索教师预测缓存或稀疏监督点采样。(4) 评测覆盖不足——质量/一致性全靠单一 VLM 判分、无人类研究,EdiVal-10 指令由 LLM 生成,出题者与判分器可能共享偏置;建议补充人类偏好评测与多判分器检验。(5) 数据分布窄——96 张合成图加局部编辑,真实摄影图与全局编辑上的保持性未经训练分布覆盖,可混入真实图像与全局编辑类型做课程式训练。
未来方向
作者提出的方向:把『Self-Forcing 暴露推理分布 + 非对称教师干净锚定 + 分数蒸馏免成对监督』作为通用训练原则,推广到一切模型反复消费自身输出的递归生成任务,例如自回归视频生成、3D 场景迭代生成、agent 多步轨迹等;并把多轮鲁棒性扩展到远超训练长度(10 轮)的序列。基于本文成果可延伸:结合轨迹级强化学习(如 MT-OPSD 一系的编辑奖励)在蒸馏稳定化之上进一步优化编辑质量;用 LLM 动态改写累积指令以支持几十轮编辑;把 EdiVal-10 扩展到 20-50 轮并纳入全局编辑类型,检验长程极限;设计带历史门控的源图一致性正则,在保留源图信息的同时避免编辑回滚;将该方案迁移到视频多轮剪辑、文档图像迭代修改、UI 设计稿迭代等对保持性要求强的真实工作流。
复现评估
复现门槛异常低,是本文一大亮点:只需微调两个 rank 16 的 LoRA(各 27.8M 可训练参数,约占模型 0.3%),单张 NVIDIA B200 约 4.4 GPU 小时即可完成全部训练;训练数据完全自产——96 张 FLUX.2-klein-9B 生成的合成图加每图 10 条局部编辑指令(共 960 条),无需任何人工标注。依赖条件:FLUX.2-klein-9B 与 FLUX.2-klein-base-9B 权重。评测侧需自建 EdiVal-10:从 GEdit-Bench 取真实照片,用 Claude Sonnet 5.5 生成并校验编辑链、GroundingDINO 打物体框、Gemma-4-31B 判分——流程描述详细,但涉及多个大模型组件;MT-OPSD 的 LoRA 与 LME-Bench 已由其作者发布可直接对照。正文未见官方代码发布声明,不过训练超参(学习率、调度、$\tau$ 与出口步采样、LoRA 配置)给出得相当完整,主要门槛是 B200 级硬件与师生双模型并行的显存需求(更小显卡降低分辨率或批次应可行)。总体复现难度中等偏低,对小实验室相当友好。
论文图表
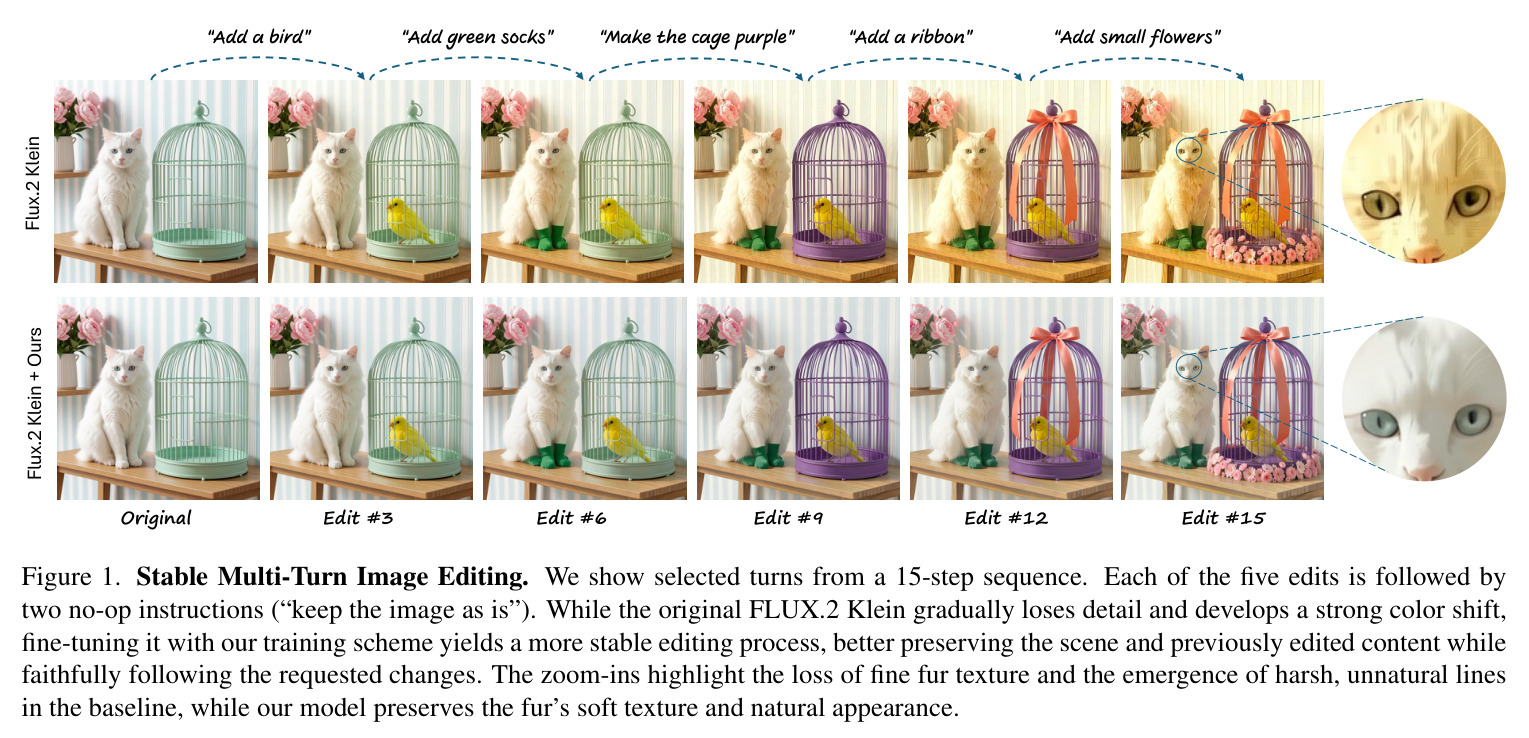
开篇对比图:对同一张松鼠图执行 15 步编辑序列(5 条真实编辑指令穿插 no-op 指令),展示第 3、6、9、12、15 次编辑后的结果。原始 FLUX.2 Klein 逐渐丢失细节并出现强烈色偏,放大图显示毛发纹理消失、出现生硬线条;用本文方案微调后的模型则保持毛发柔软质感与画面自然。
一图说明全文要解决的问题与最终效果:多轮+no-op 场景下基线如何退化、本文如何稳定,是判断论文价值的起点。
九步编辑序列的节选:基线与本文方法都能执行最后一条指令『让徒步者微笑』,但也顺手移除了之前某轮加上的墨镜。本文方法减少了累积漂移,但继承了基模的编辑能力与局限。
作者对局限的诚实展示:稳定性与指令遵循是相关但不同的目标,帮助读者校准对方法能力边界的预期。
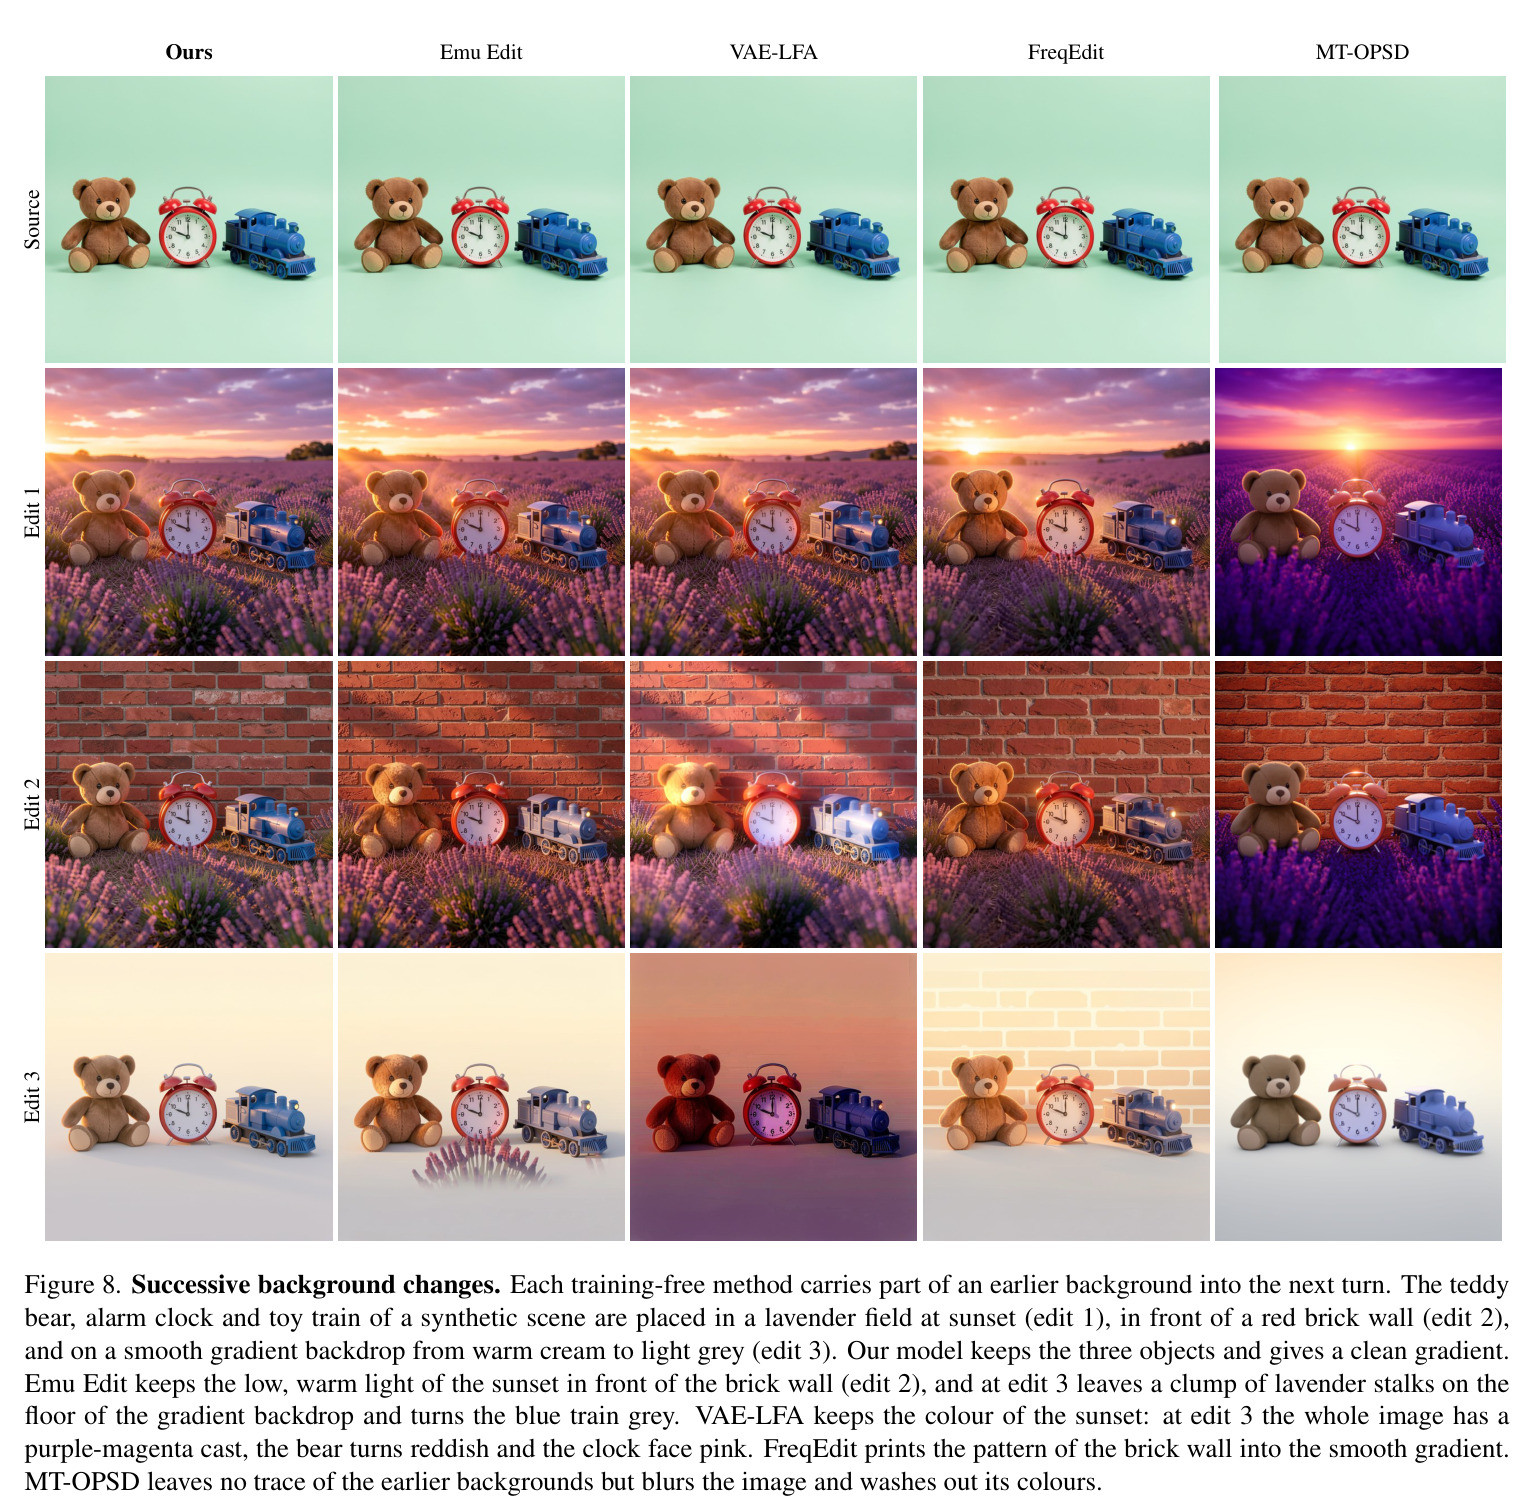
对应结论部分的讨论:当编辑反复替换主体和背景(生成新内容而非保持旧细节)时,现有模型在长序列中也能维持画质;退化主要发生在需要内容跨轮保持的场景。该图界定了一种『天然稳定』的编辑类型。
它解释了本文问题设定的边界——方法聚焦于未受影响内容必须跨轮一致的场景,帮助读者判断自己的应用场景是否落在该方法的目标范围内。