MT Forcing:基于自回归扩散的稳定且一致的多轮图像编辑训练范式 MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
单轮教师蒸馏加教师强制正则,双管齐下解决多轮编辑漂移
前置知识
统一多模态模型(UMM)
把视觉理解、生成与编辑统一在一个模型里的架构,通常用自回归方式建模文本上下文,用扩散过程合成图像,图像以共享 token 或潜变量形式进入序列,跨轮对话的图文历史可缓存为 KV 向量供后续编辑引用。
本文的训练范式专门针对 UMM 设计,SenseNova-U1/U1.5 是其验证底座,理解 UMM 的图文交织上下文机制才能看懂 KV 缓存与历史的处理方式。
自回归扩散(AR Diffusion)
以因果方式逐段生成内容的扩散模型范式:每一步在给定之前所有内容(历史)的条件下做扩散去噪,可写成 $p_\theta(x_{1:N}|x_{src},c_{1:N})=\prod_{i=1}^N p_\theta(x_i|H_{<i},c_i)$。多轮编辑天然是因果过程,每轮编辑依赖之前所有轮次的图像和指令。
论文的问题设定和曝光偏差分析都建立在这个因果分解上,MT Forcing 的自 rollout 训练正是对该自回归链路的对齐。
DMD 分布匹配蒸馏
Distribution Matching Distillation 是一种一步/少步扩散蒸馏方法:训练一个在线假模型 $F_\psi$ 估计学生生成分布的分数,与真实分布分数之差 $(\hat{s}^F-\hat{s}^T)$ 构成梯度,把学生输出分布的 KL 散度拉向教师分布。DMD2 进一步用在线分数估计和对抗损失稳定训练。
Single-Turn DMD 是本文两大组件之一,直接复用 DMD2 的分数差梯度估计来对齐学生 rollout 分布与单轮教师分布,不懂数值分数匹配就看不懂损失推导。
曝光偏差与 Teacher Forcing
序列模型训练时以真实参考历史为条件,推理时却要消费自己生成的(不完美的)历史,这种训练-推理失配称为曝光偏差,误差会沿序列累积。Teacher Forcing 是经典对策:训练时喂参考历史教模型学会依赖历史的正确转移,但推理阶段仍会暴露失配。
曝光偏差是本文对多轮编辑漂移的根因诊断;Teacher-Forcing Guidance 的 warmup 与正则两个阶段正是对这一经典概念的扩散化改造,也是理解其局限(只覆盖参考历史)的关键。
流匹配(Flow Matching)
一类生成训练目标:让网络 $v_\theta$ 预测加噪样本的速度场 $v^{\star,t}_i=\dot{\alpha}_t x_i+\dot{\sigma}_t\epsilon$,损失为 $\|v_\theta(x^{\star,t}_i,t,\cdot)-v^{\star,t}_i\|_2^2$,训练收敛后可沿学习到的速度场做 ODE 采样。
Teacher-Forcing Guidance 的监督损失 $\mathcal{L}_{TF}$ 就是参考轨迹上的流匹配损失,论文沿用其符号系统($\alpha_t,\sigma_t$ 及其导数)描述加噪前向过程。
研究动机
多轮图像编辑要求模型按用户给出的指令序列对同一张图递进修改,是交互式视觉创作的基础能力。现有基于 UMM 的方法在几轮之后就会出现明显漂移,表现在两方面:一是视觉质量不稳定,误差伪影逐轮累积,细粒度纹理和局部结构不断退化;二是内容不一致,未被要求修改的区域发生意外变化,先前轮次已完成的编辑也会丢失。作者将其根因归结为曝光偏差:训练时模型以参考轨迹为条件,推理时却必须递归地以自己不完美的历史输出为条件,失配导致误差滚雪球。论文在 MTEdit-Bench 的 step-wise 子集(100 个会话、每个含源图加 8 条顺序指令)上量化了问题的严重程度:SenseNova-U1 的指令遵循分 IF 从第 1 轮的 9.29 一路跌到第 8 轮的 1.67,内容一致性 CC 从 9.06 跌至 1.12,视觉质量鲁棒性 DRS 从 4.07 跌至 2.58;更强的 SenseNova-U1.5 也从 IF 9.90/CC 9.49 掉到第 8 轮的 IF 4.52/CC 3.22,几何偏移指标 Pixel 高达 6.89 像素。
本文的目标是本文目标是提出一套可直接套在 UMM 上的训练范式,使基于自回归扩散的多轮编辑同时满足两个性质:其一,视觉质量稳定——每一轮的画质都应接近单轮编辑水平,不随轮数增加出现伪影累积和纹理退化,量化目标是把 SenseNova-U1.5 的 DRS 全程稳定在 4.20-4.35;其二,跨轮内容一致——严格保住未要求修改的区域和先前所有已完成的编辑,只执行当前指令,量化目标是八轮平均 Pixel 位移从 6.34 降到 1 以下。同时指令遵循能力不能被牺牲(第 8 轮 IF 应从 4.52 回升到 9 以上),并且范式要从第 4 轮起在 IF/CC/DRS/Pixel 四项指标上全面超越基线。工程约束上,它应当即插即用于不同 UMM 底座(论文验证 SenseNova-U1 与 U1.5),且不依赖一个能联合建模完整多轮编辑轨迹的双向教师模型——这种教师在多轮编辑领域并不存在。
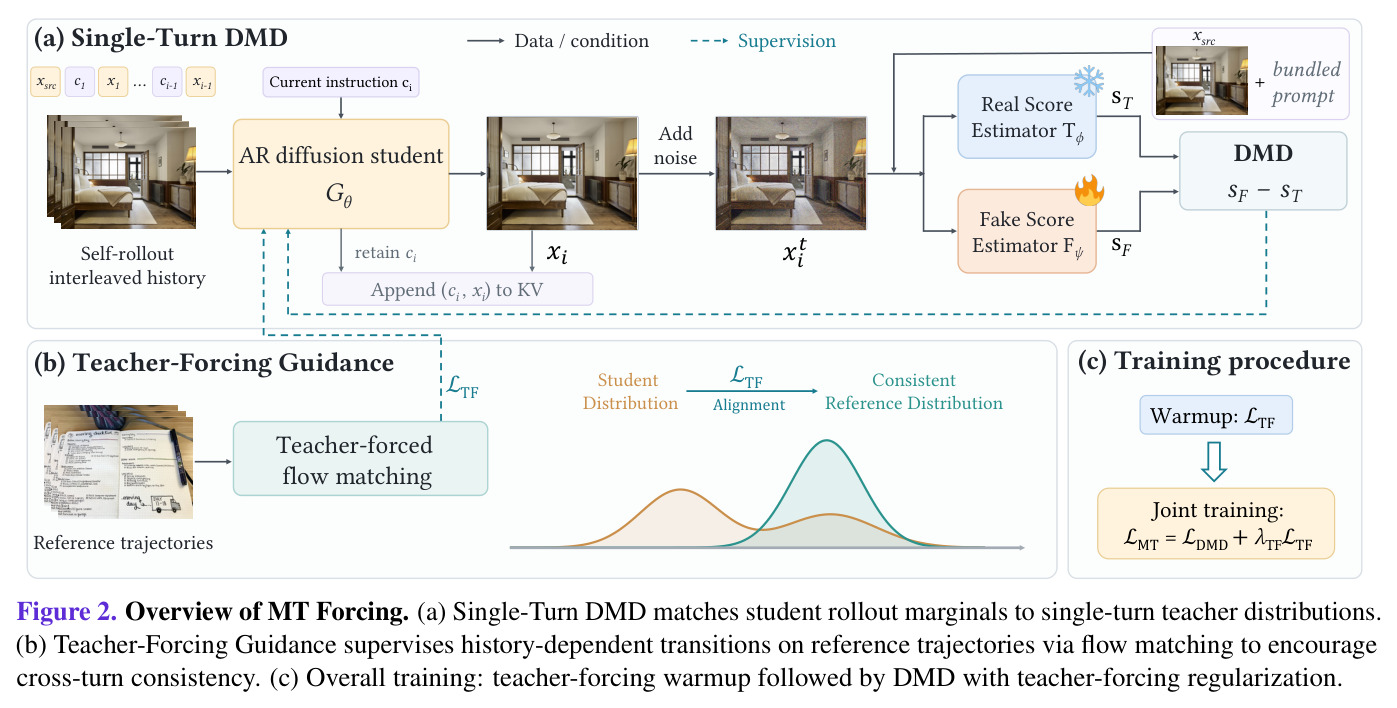
与已有工作不同的是,本文的独特切入是『用单轮教师监督多轮学生』的非对称蒸馏思路。视频生成领域缓解 rollout 漂移的标准做法是从能联合建模多帧的双向教师蒸馏,但多轮图像编辑缺少对应的可一次性生成完整编辑轨迹的双向 UMM。作者抓住两个观察打开缺口:(1) 单轮编辑本身引入的退化很有限;(2) 编辑模型可以在一轮内执行多个动作,例如『加一个花瓶』『把它变蓝』可以重组为单轮指令『加一个蓝色花瓶』。于是可以把截至当前轮的全部指令 $c_{1:i}$ 捆绑成一条提示词,让单轮教师直接在源图上一步到位完成累积编辑意图,构造出天然无跨轮误差累积的质量参照。另一个关键洞察是纯分布匹配并不足够:逐轮边缘分布对齐存在『忽略历史、逐轮独立采样』的退化解,因此必须再叠加参考轨迹上的 teacher forcing 流匹配监督来固定历史-输出依赖,二者构成互补的双目标。
核心方法
直觉上,学生推理时要面对自己生成的『带噪』历史,训练就该在这种历史下进行;质量标尺则取自『一步到位』的单轮教师。技术上,MT Forcing 把多轮编辑写成自回归扩散的因果分解 $\prod_{i=1}^N p_\theta(x_i|H_{<i},c_i)$,$H_{<i}$ 是源图与前几轮图文的 KV 缓存历史。训练分两线:Single-Turn DMD 把截至第 $i$ 轮的全部指令重组为捆绑提示词 $\bar{c}_i$,冻结的单轮教师在源图上一步执行它,作为无跨轮误差的质量参照;学生在自 rollout 历史上生成,用 DMD 损失逐轮对齐两者输出分布,梯度取教师分数 $\hat{s}^T_i$ 与假模型分数 $\hat{s}^F_i$ 之差。Teacher-Forcing Guidance 在参考轨迹上用流匹配损失 $\mathcal{L}_{TF}$ 监督依赖历史的转移。流程分两阶段:先以 $\mathcal{L}_{TF}$ 预热,再蒸馏并保留低权重参考监督,总目标 $\mathcal{L}_{MT}=\mathcal{L}_{DMD}+\lambda_{TF}\mathcal{L}_{TF}$;历史 KV 全 detach、每轮只在一个随机去噪步反传以控制开销。
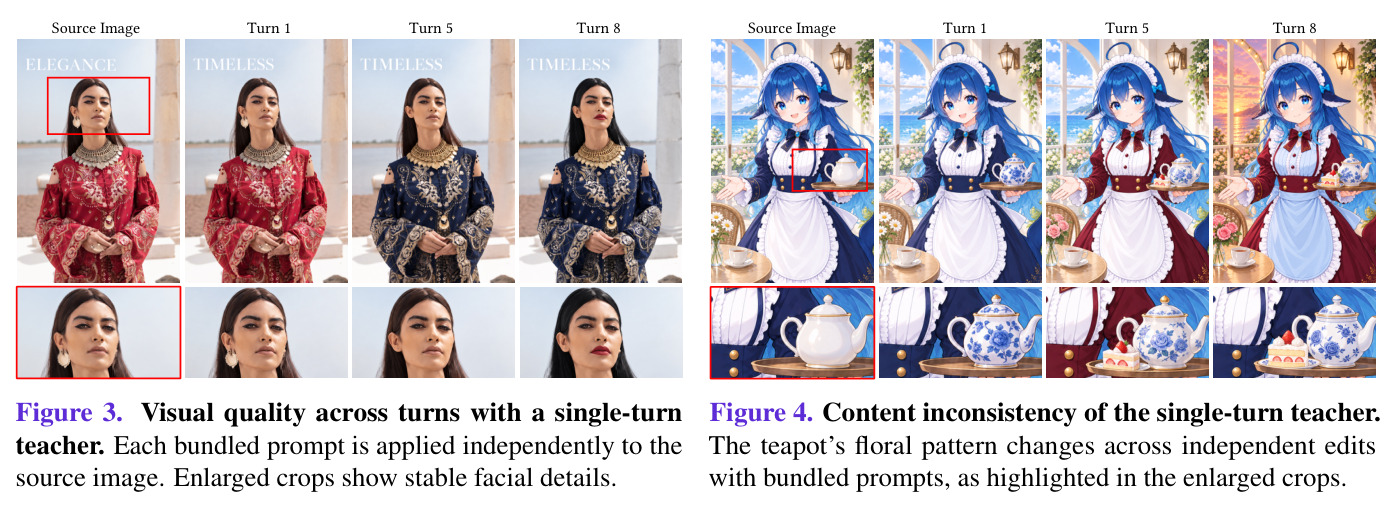
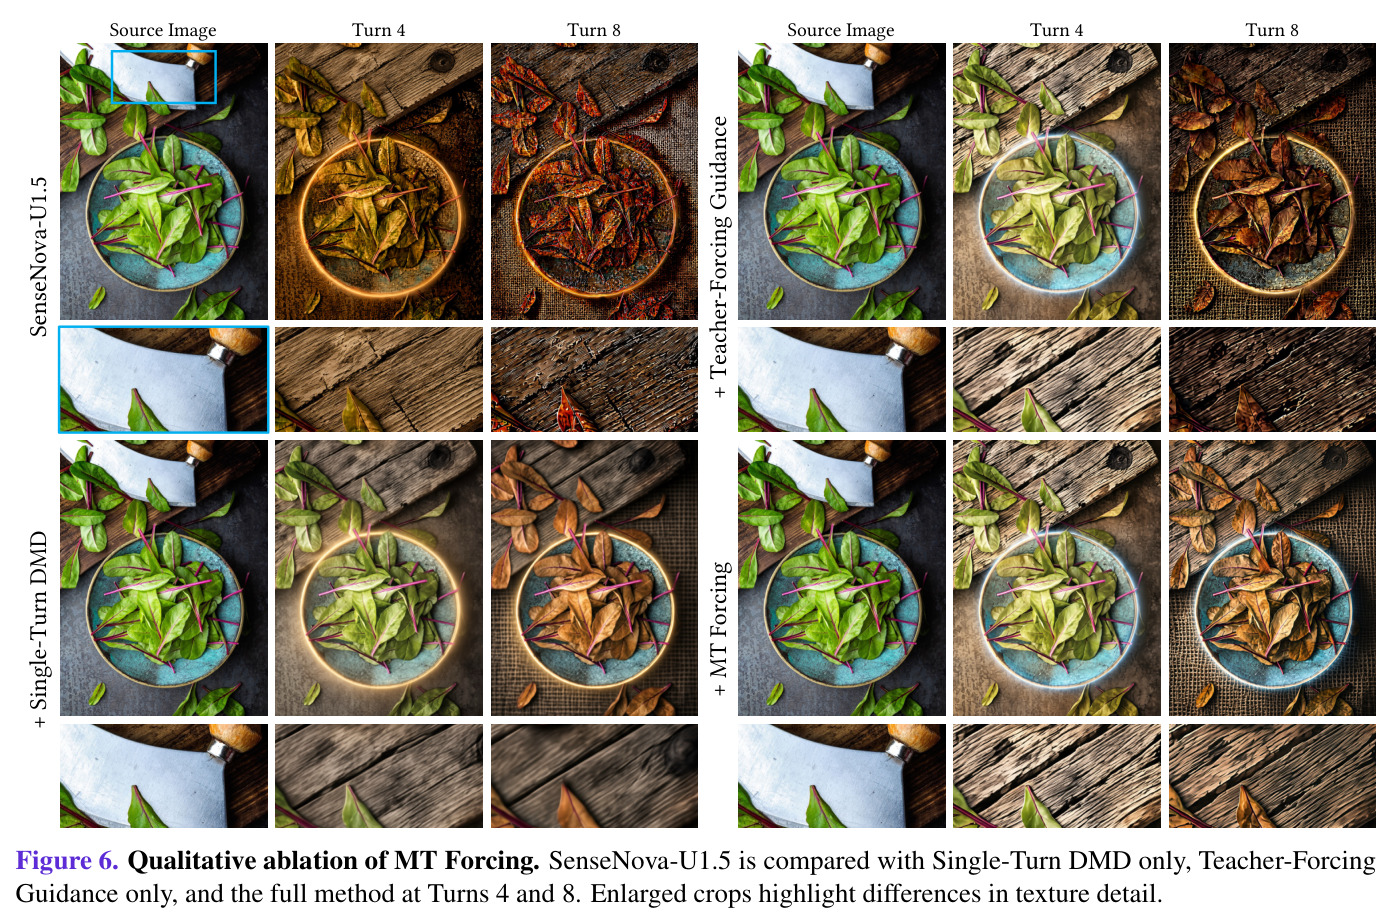
核心创新是『条件重组织+单轮教师蒸馏』的不对称设计。学生拿强条件 $C^S_i=(H_{<i},c_i)$(源图+全部历史+当前指令),冻结教师拿弱条件 $C^T_i=(x_{src},\bar{c}_i)$(源图+捆绑提示词),二者由映射 $\bar{c}_i=\mathrm{Reorganize}(c_{1:i})$ 连接——『加一个花瓶』『把它变蓝』重组为『加一个蓝色花瓶』——且映射单向可行 $C^S_i\Rightarrow C^T_i$ 而不可逆。教师在弱条件下单轮完成累积编辑,画质不随轮数衰减(Fig.3 第 1、5、8 轮人脸细节均稳定),学生 rollout 的边缘分布因此被逐轮拉向教师分布,等效于教学生在千疮百孔的历史上仍能画出干净的一笔。这与 MT-OPSD 在退化输入上做逐步蒸馏有本质区别:这里的监督目标本身不携带跨轮误差。论文还证明分布匹配存在盲区:若学生忽略历史、每轮独立从教师采样,DMD 损失可为零但轨迹仍不一致(Fig.4 茶壶花纹漂移),故必须补充 teacher forcing 固定『对每个历史给出正确响应』的历史-输出依赖,由此导出双目标设计。
方法步骤详情
流程见 Algorithm 1。第一步预热:在参考轨迹集 $D_{ref}$ 上用流匹配损失 $\mathcal{L}_{TF}$(Eq.8)微调预训练编辑器得 $\theta_w$,并以其初始化学生 $G_\theta$、冻结教师 $T_\phi$ 与在线假模型 $F_\psi$。第二步主循环,每次采样一条轨迹,先把源图编码进 KV 缓存并关闭梯度;对每轮 $i$:(a) 将 $c_{1:i}$ 重组为捆绑提示词 $\bar{c}_i$,设定教师条件 $C^T_i$;(b) 采样本轮反传步 $s_i\sim\mathrm{Uniform}(1,\dots,T)$,从纯噪声无梯度去噪到 $s_i$;(c) 在 $s_i$ 步开启梯度,计算 $\hat{x}^0_i=G_\theta(x^{t_j}_i;t_j,KV,c_i)$,随后关闭梯度并把 $(c_i,\hat{x}^0_i)$ 的 KV 追加进缓存继续 rollout;(d) 用 $C^T_i$ 下的教师与假模型分数差(Eq.6)得截断方向 $\hat{g}_i$。N 轮后以 $\frac{1}{N}\sum_i\hat{g}_i+\lambda_{TF}\nabla_\theta\mathcal{L}_{TF}$ 更新学生,再用 detach 输出训练假模型 $\psi$。
技术新颖性
新颖性有四点。第一,监督信号构造:用『指令捆绑』把多轮问题映射到成熟的单轮编辑能力上,绕开『不存在双向多轮教师』的领域空白——这是与 CausVid、Self Forcing 依赖双向教师蒸馏的根本差异,也与 MT-OPSD 在退化输入上逐步蒸馏不同,本方法的教师监督不携带递归误差。第二,理论洞察:论文指出逐轮分布匹配存在零损失却不一致的退化解(Eq.7),边缘对齐是必要非充分条件,这一分析干净回答了『为什么 DMD 还不够』,直接导出双目标设计。第三,训练调度:teacher forcing 先 warmup 建立历史依赖行为、蒸馏期再以低权重 $\lambda_{TF}$ 作正则,防止分布匹配更新冲垮预热学到的一致性行为。第四,工程实现:历史 KV 全 detach 的跨轮梯度截断,加上每轮仅一个随机去噪步反传,使 N 轮自 rollout 的显存与计算可控;并提出基于 MatchAnything-RoMa 匹配点位移的 Pixel 指标,在 MTEdit-Bench 原有 IF/CC/DRS 之外补充了几何对齐维度的评测。
实验结果
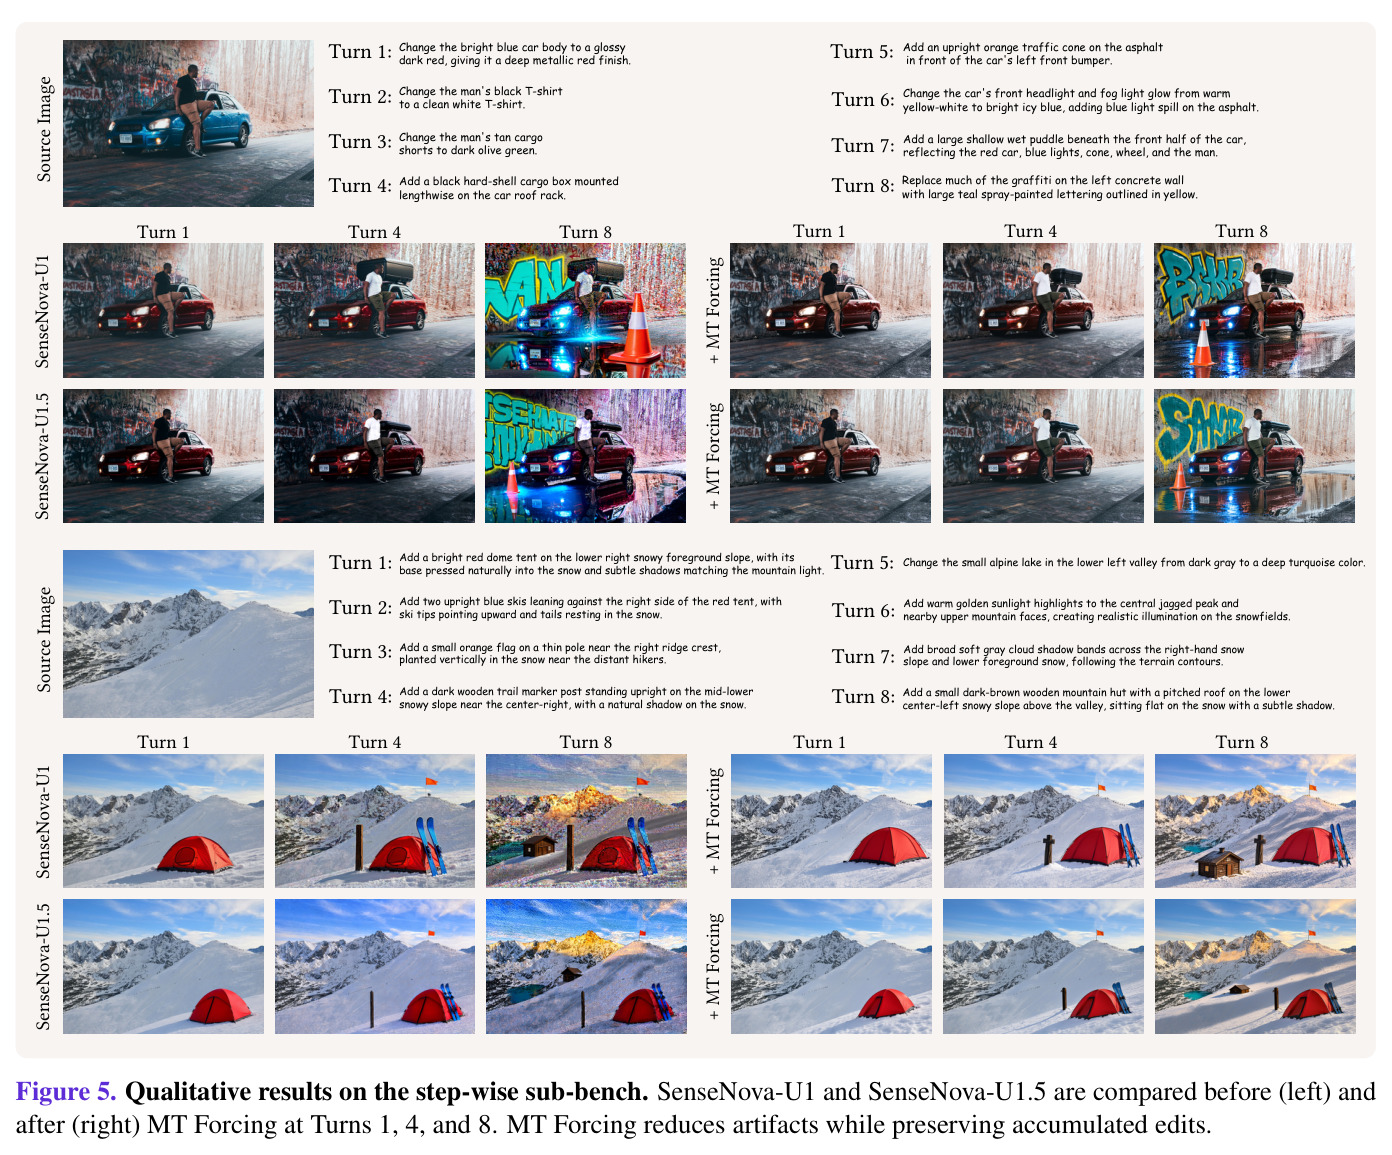
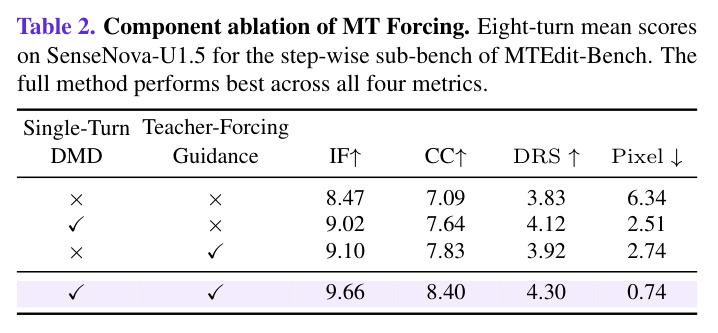
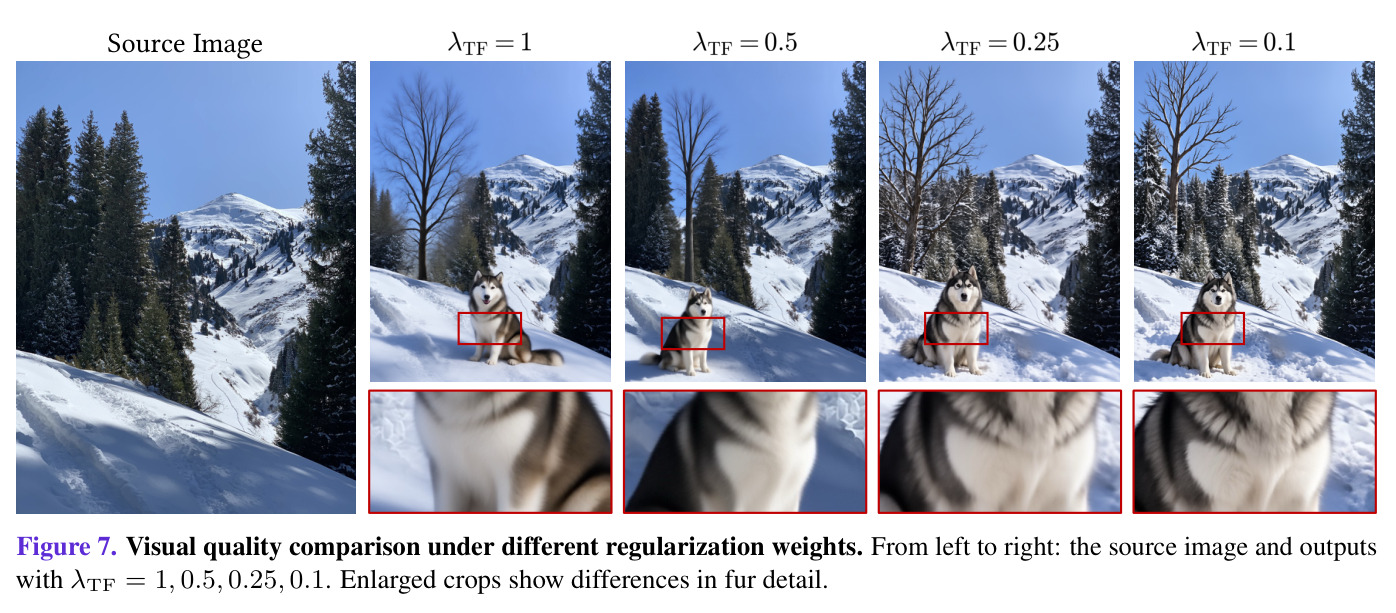
主实验在 MTEdit-Bench step-wise 子集(100 会话×8 轮指令)进行,对比 SenseNova-U1/U1.5 加与不加 MT Forcing。Table 1 显示第 4 轮起本方法在 IF、CC、DRS、Pixel 四项全面领先且优势随轮数扩大。SenseNova-U1 基线第 8 轮 IF 仅 1.67、CC 1.12,加方法后 IF 9.12(+7.45)、CC 7.94(+6.82)、DRS 4.22、Pixel 0.37;SenseNova-U1.5 基线第 8 轮 IF 4.52、CC 3.22,提升至 9.17(+4.65)与 7.68(+4.46),DRS 全程稳定 4.20-4.35 而基线从 4.09 跌至 3.03,八轮平均 Pixel 从 6.34 降至 0.74,位移减少 88.4%。Fig.5 定性显示基线第 8 轮出现汽车过饱和光照与雪山噪点纹理,本方法纹理干净且完整保留红车身、车顶行李箱、帐篷、滑雪板等先前编辑。消融(Table 2,U1.5 八轮均值)验证互补性:基线 8.47/7.09/3.83/6.34;仅 DMD 9.02/7.64/4.12/2.51(画质升但木纹跨轮漂移);仅 TF Guidance 9.10/7.83/3.92/2.74(一致性升但画质仍退化);全方法最优 9.66/8.40/4.30/0.74。Fig.7 扫描 $\lambda_{TF}=1/0.5/0.25/0.1$:权重过大产生模糊,0.25 或 0.1 兼顾一致性与毛发细节。
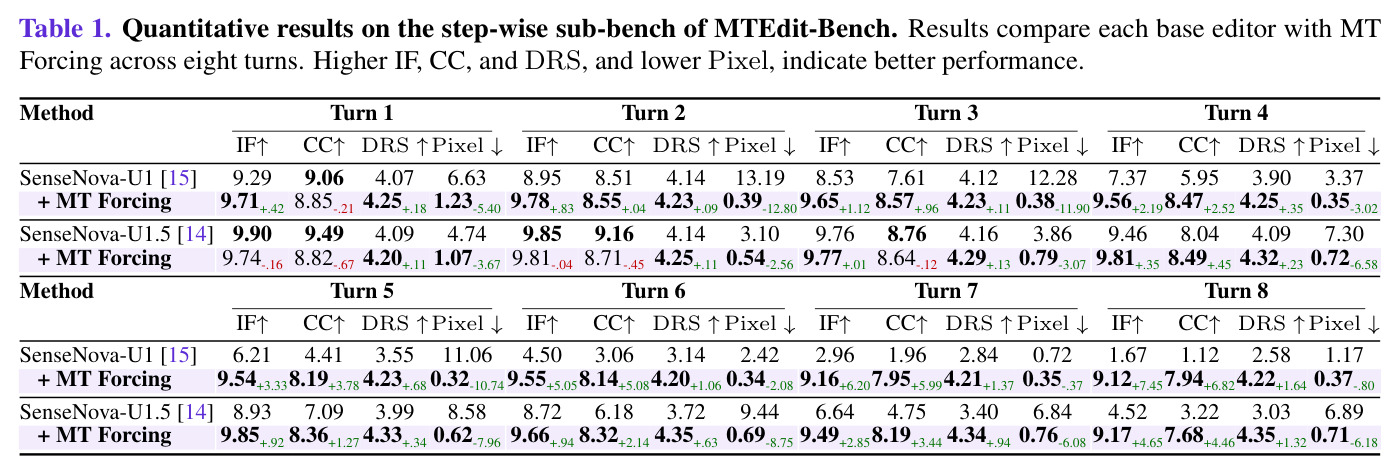
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多轮图像编辑(8轮,MTEdit-Bench step-wise,SenseNova-U1) | 指令遵循 IF(0-10) | 第8轮 9.12(八轮持续 9.5 上下) | SenseNova-U1 第8轮 1.67 | +7.45 |
| 多轮图像编辑(8轮,MTEdit-Bench step-wise,SenseNova-U1) | 内容一致性 CC(0-10) | 第8轮 7.94 | SenseNova-U1 第8轮 1.12 | +6.82 |
| 多轮图像编辑(8轮,MTEdit-Bench step-wise,SenseNova-U1.5) | 漂移鲁棒性 DRS(0-5) | 全程 4.20-4.35,第8轮 4.35 | SenseNova-U1.5 从 4.09 跌至 3.03 | 第8轮 +1.32 |
| 多轮图像编辑(8轮,MTEdit-Bench step-wise,SenseNova-U1.5) | 几何偏移 Pixel(匹配点平均位移,越低越好) | 八轮平均 0.74 | SenseNova-U1.5 八轮平均 6.34 | 降低 88.4% |
| 组件消融(U1.5 八轮均值) | IF/CC/DRS/Pixel 综合 | 全方法 9.66/8.40/4.30/0.74;仅 DMD 9.02/7.64/4.12/2.51;仅 TF 9.10/7.83/3.92/2.74 | 预训练基线 8.47/7.09/3.83/6.34 | 全方法四项全部最优,验证互补性 |
局限与改进
作者层面可读出的局限:其一,捆绑提示词隐含假设累积指令可被重组为单轮编辑意图,且映射 $C^S_i\Rightarrow C^T_i$ 不可逆——当指令依赖前轮具体视觉细节(如指代某生成物体的属性)时,弱条件教师无法完整表达累积意图;单轮教师自身也不保证跨轮视觉细节一致(Fig.4 茶壶花纹变化),监督只在边缘分布层面正确。其二,IF/CC 由 Qwen3.5-Plus 打 0-10 分,DRS 取 VisualQuality-R1 与 RALI 的均值,全自动评测器与人类判断的相关性未讨论。其三,仅验证 SenseNova-U1/U1.5 两个非开源底座。我的补充观察:训练需同时驻留学生、冻结教师、在线假模型三份 UMM 并完整 rollout 8 轮,算力门槛高;参考轨迹数据集 $D_{ref}$ 的来源与规模未披露;$\lambda_{TF}$ 需按底座调参;评测只到 8 轮,几十轮长会话外推性未知;且第 1-3 轮并非全面占优(U1.5 第 1 轮 IF 9.74 略低于基线 9.90),收益集中在长程退化场景。
独立分析的弱点
第一,Reorganize 算子是黑盒:论文未给出指令重组的实现、失败率统计和对指代/空间约束/否定类指令的鲁棒性分析,重组质量差会直接污染教师监督;改进方向是引入可验证的重组器(如教师在源图上自检每条子指令是否满足并回传置信度),或多候选采样加一致性筛选。第二,两个损失都不直接惩罚『学生在自己的历史上偏离一致轨迹』:DMD 只管边缘分布,TF 只看参考历史,自 rollout 历史下的历史-输出依赖缺乏显式监督;可加自 rollout 轨迹上相邻轮特征对齐或无参考的自身一致性正则。第三,每轮仅一个随机去噪步反传($s_i\sim\mathrm{Uniform}(1,\dots,T)$)省算力但分数差梯度方差可能偏高,可研究重要性采样或多步联合反传的方差-算力权衡。第四,Pixel 对所有匹配点一视同仁,当轮合法编辑区域也计入位移,可能混淆『该变的变了』与『不该变的变了』,建议按区域掩码拆成保留区/编辑区两个指标。第五,评测全靠自动裁判(Qwen3.5-Plus 等),缺少人工评测校准,且 IF/CC(0-10)与 DRS(0-5)量纲不同,跨论文比较需换算。
未来方向
作者提出的或方法天然指向的方向:把 MT Forcing 推广到视频多轮编辑与 3D 场景编辑——AR 扩散的因果结构天然适配时序内容,单轮教师可由强视频编辑模型充当;探索无需参考轨迹的自监督变体,例如用学生多条 rollout 之间的相互一致性替代 $\mathcal{L}_{TF}$,摆脱对 $D_{ref}$ 的依赖;为捆绑提示词建立自动化与可验证机制,覆盖不可重组的复杂指令链。基于本文成果可延伸的研究:其一,把『条件不对称蒸馏』框架迁移到其他存在曝光偏差的自回归任务,如多轮代码生成、Agent 轨迹规划——凡训练用参考历史、推理用自生成历史的场景都适用同一诊断;其二,与 KV 缓存管理结合攻关 20 轮以上的长会话编辑,检验误差累积模型在更长视野下的有效性;其三,与轨迹级奖励优化(如 MT-EditFlow 的 RL 路线)组合,用 DMD 打质量底座、RL 做偏好对齐;其四,做人类偏好评测校准 LLM 裁判,并在开源底座(如 Qwen-Image-Edit、FLUX Kontext 类单轮编辑器)上复现以验证泛化性,这两点论文均未覆盖。
复现评估
复现难度:中高。不利因素——论文未提及代码、权重或参考轨迹数据集 $D_{ref}$ 的开源计划,只有项目主页;底座 SenseNova-U1/U1.5 是商汤模型,公开可用性不明,无法直接复现 Table 1;训练需学生、冻结教师、在线假模型三份 UMM 同时驻留显存并完整 rollout 8 轮,估计要多卡 A100/H100 级资源;Reorganize 实现与关键超参(去噪总步数 T、学习率)披露有限,$\lambda_{TF}$ 还需按底座扫描(1/0.5 会糊、0.25/0.1 较好)。有利因素——方法描述完整:Algorithm 1 给出逐步伪代码,Eq.5 的 KL 目标与 Eq.6 的分数差梯度可直接对接 DMD2 开源实现,前向加噪沿用标准 $x^t=\alpha_t x+\sigma_t\epsilon$;评测协议明确(MTEdit-Bench step-wise 100 会话、Qwen3.5-Plus 打 IF/CC、VisualQuality-R1 与 RALI 合成 DRS、MatchAnything-RoMa 算 Pixel),均可独立获取。务实路径:用开源单轮编辑器当教师、自构建 8 轮指令数据集,先在 4 轮短会话上验证再全量复现。
论文图表
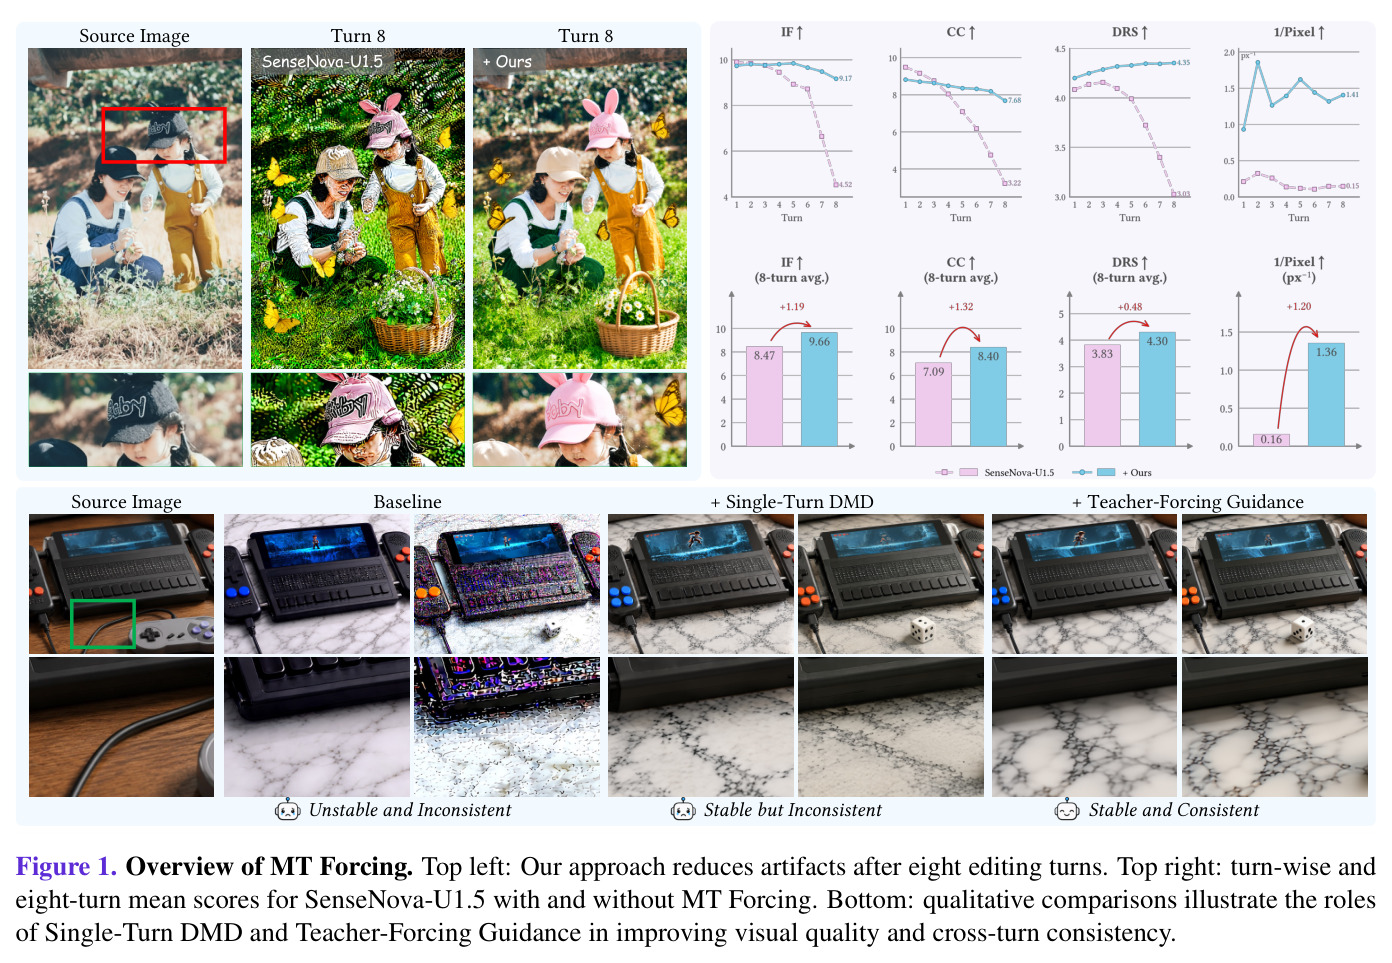
总览图。左上:对同一源图连续编辑 8 轮后,基线 SenseNova-U1.5 出现伪影而 MT Forcing 保持干净;右上:SenseNova-U1.5 加与不加 MT Forcing 的逐轮及八轮均值分数曲线,显示基线分数随轮数下滑、加本方法后保持平稳;底部:定性对比说明 Single-Turn DMD 主攻视觉质量、Teacher-Forcing Guidance 主攻跨轮一致性,二者结合达到稳定且一致。
一张图同时呈现问题(基线漂移)、结果(分数曲线)和两个组件的分工,是理解全文动机与结论的最佳入口。
以哈士奇图像为例对比教师强制正则权重 $\lambda_{TF}=1,0.5,0.25,0.1$ 的输出:权重为 1 和 0.5 时毛发被抹平、放大后难以分辨单根毛发,降到 0.25 或 0.1 后毛发细节和轮廓恢复锐利,在内容一致性与视觉清晰度间取得平衡。
给出关键超参 $\lambda_{TF}$ 的选取依据,说明一致性正则过强会牺牲画质,对复现者调参有直接指导价值。