SliderEdit++:改进指令式图像编辑中的滑块轨迹 SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
用轨迹正则化让编辑滑块平滑连续、互不干扰,总分提升18.5%且快3至20倍
前置知识
流匹配与速度场
整流流/流匹配模型学习一个速度场 $\epsilon(Z_t, X, P)$:给定带噪潜变量 $Z_t$、源图潜变量 $X$ 和文本提示 $P$,预测把噪声推回数据所需的位移方向。编辑模型据此从噪声逐步去噪得到编辑后的图像,推理即沿 ODE 积分若干步。
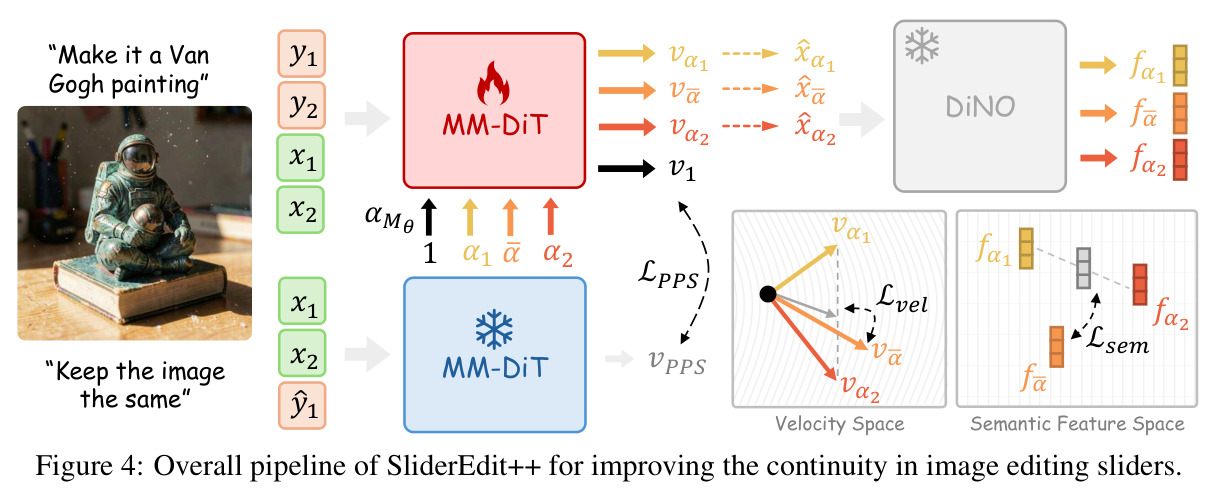
SliderEdit++ 的全部损失都定义在速度预测上:中点正则化约束 $\alpha$ 到 $\epsilon$ 的映射,解缠正则化约束不同滑块引起的速度偏移方向,读懂损失必须先懂速度场。
LoRA 低秩适配器
在冻结模型的每个线性层旁注入低秩更新 $\Delta W^\ell = B^\ell A^\ell$(秩远小于维度),只训练 $A,B$ 而不动原权重。推理时给更新乘一个缩放系数 $\alpha\in[0,1]$,即可连续调节该适配器的影响强度。
滑块的本质就是缩放 LoRA 权重的 $\alpha$:本文的谱范数正则化直接作用于 $B^\ell A^\ell$,多滑块的 STLoRA 也是按 token 位置对 $\alpha_i\Delta W^\ell$ 门控。
分类器无关引导(CFG)
推理时把条件预测与无条件预测做凸组合 $\epsilon = (1-\alpha)\epsilon_{edit} + \alpha\,\epsilon_{neutral}$ 来调节引导强度。由于是字面意义的向量线性插值,输出随 $\alpha$ 几乎必然平滑变化。
本文的核心直觉来源于此:显式 CFG 天然平滑,而缩放 LoRA 权重经过多层非线性后不保证平滑——作者把前者的平滑性作为训练信号注入后者。
谱范数
矩阵的最大奇异值 $\sigma_{max}(\Delta W)$,衡量该线性层最多能把输入拉伸多少倍,是网络对输入扰动敏感度的 Lipschitz 上界的关键项。逐层谱范数越大,累积的非线性映射越容易把微小输入变化放大成剧烈输出跳变。
作者诊断出滑块跳变的机理是适配器训练过久导致 $\sigma_{max}(\alpha B^\ell A^\ell)$ 增大、滑块变成硬开关,谱范数惩罚是替代早停启发式的核心手段。
DINOv2 语义特征
Meta 发布的自监督 ViT 视觉编码器,其特征对语义内容敏感、对低层纹理扰动相对鲁棒,常被用作感知相似度度量:两张图的特征距离近似反映人眼可见的语义差异。
语义空间正则化 $\mathcal{L}_{sem}$ 在 DINOv2 特征上做中点一致性,基准的连续性指标也用 DINOv2 距离衡量相邻滑档的语义变化,是连接训练目标与评测的桥梁。
停止梯度(stop-gradient)
记作 sg[$\cdot$],指在该张量处切断梯度回传:它参与前向计算作为常数目标,但反向传播时不产生梯度。常用于构造'目标固定、只更新一方'的对比或一致性损失。
本文三个正则项的目标端都套了 sg[·](如 $\frac{1}{2}(sg[v^{\alpha_1}]+sg[v^{\alpha_2}])$),保证只塑形轨迹内部而不破坏 LPPS 已锚定的端点行为,这是损失设计能否工作的关键细节。
研究动机
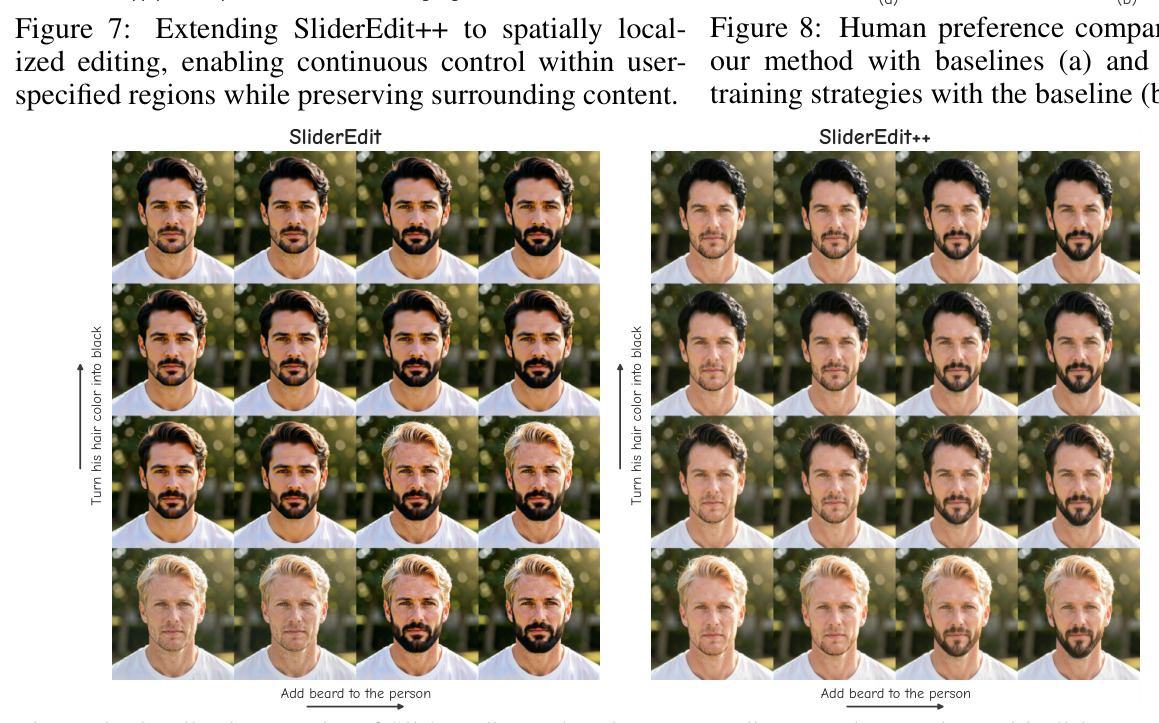
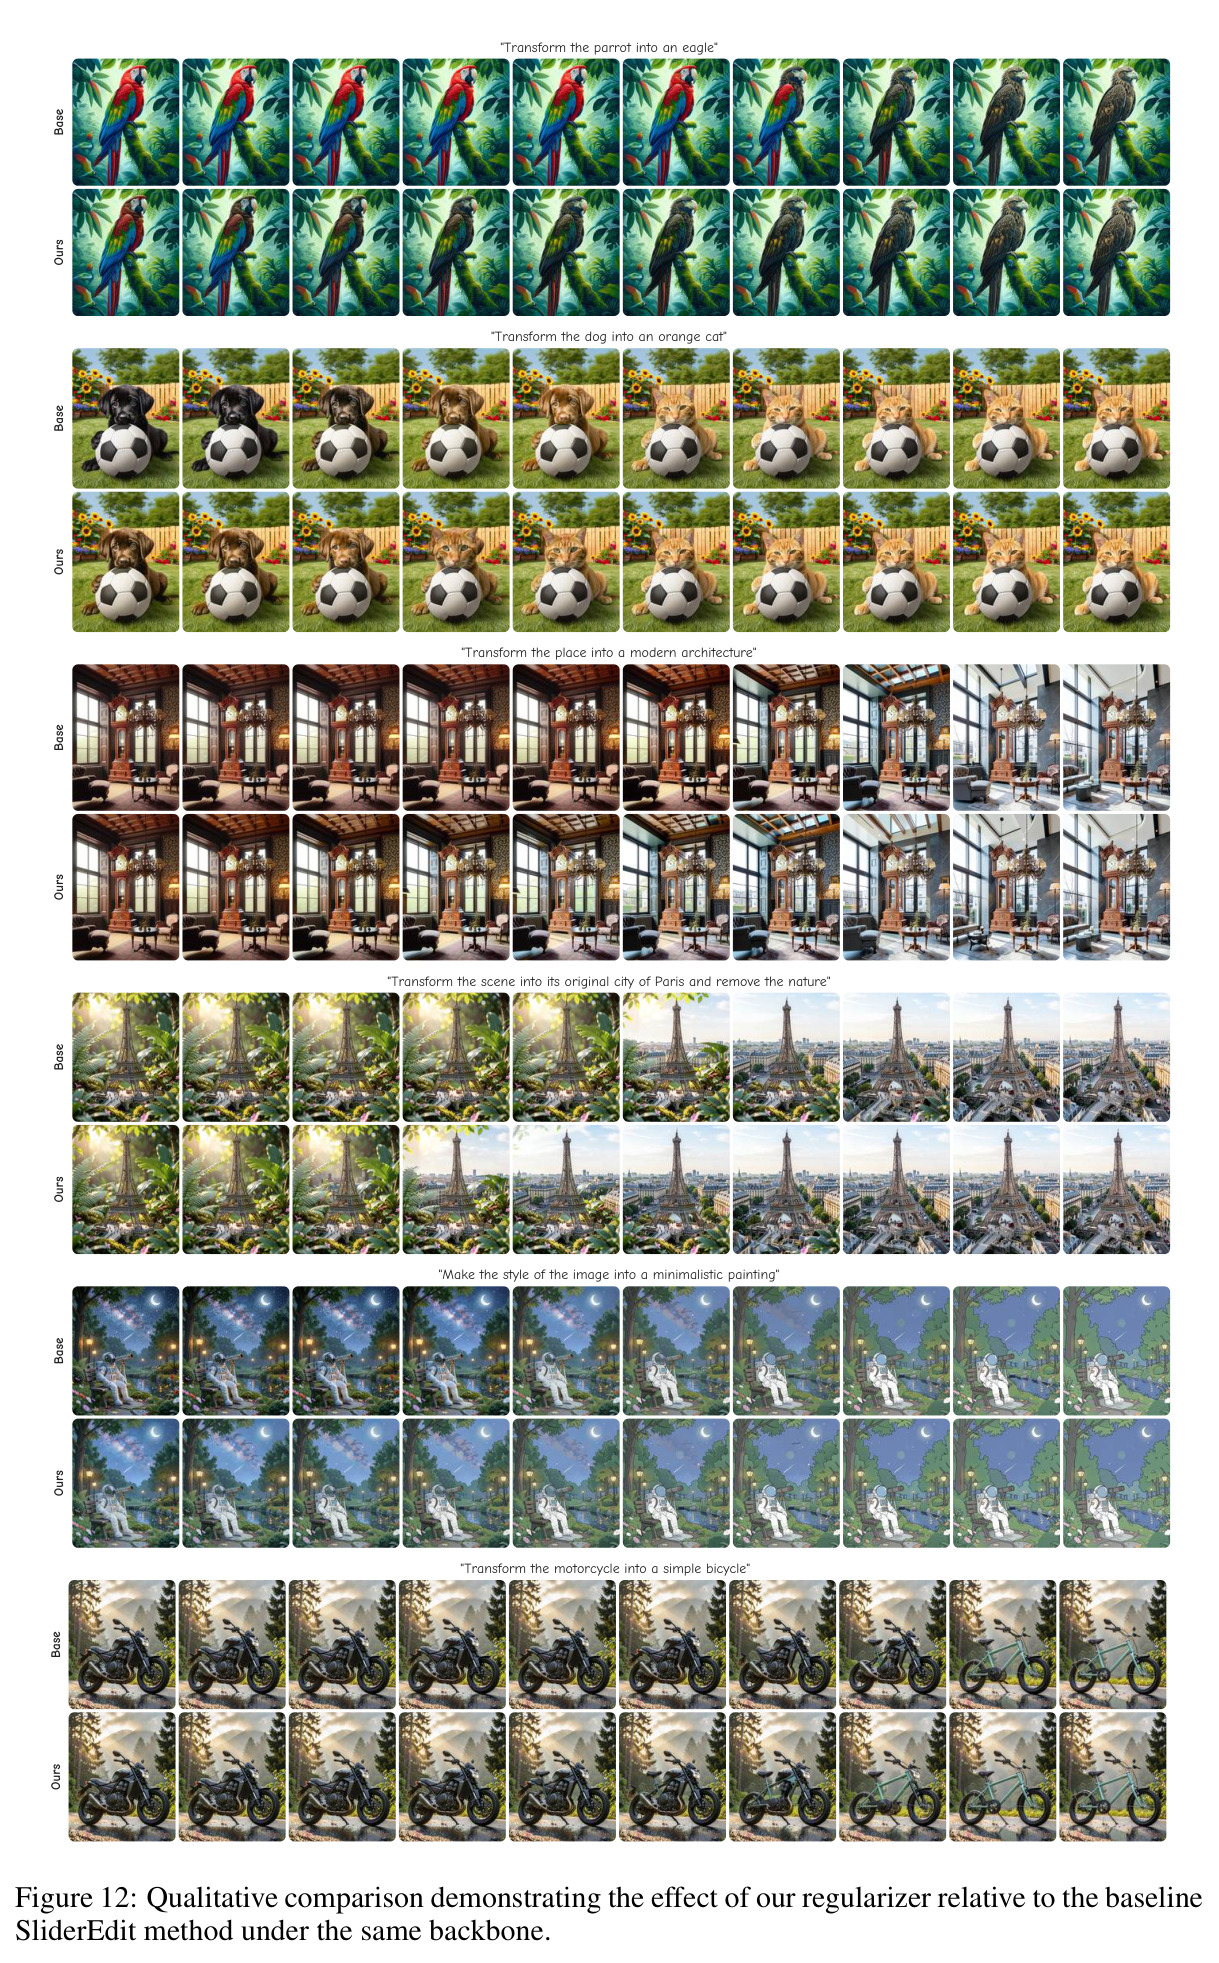
指令式图像编辑模型(FLUX-Kontext、Qwen-Image-Edit、Nano Banana、GPT-Image 等)虽能执行复杂自然语言指令,但输出是一次性固定编辑,难以对齐用户细微的视觉意图。为支持交互式调节强度,SliderEdit、Kontinuous Kontext、VeloEdit、FlowSlider 等工作引入了连续滑块控制,但作者系统观察发现两大缺陷:其一,滑块轨迹远非连续——相同的滑块增量引发悬殊的感知变化,常出现突兀跳变(如发色在某一步瞬间由黑变金),相邻滑档的 DINOv2 语义距离剧烈波动,基线方法平均高达 0.030–0.037;其二,多滑块联合控制时互相干扰,调一个属性会意外牵动其他属性(如加胡子时发色跟着变)。此外现有评测依赖方法自带数据集与临时协议,缺乏统一基准公平比较单调性、连续性与解缠程度。
本文的目标是本文有两个目标。评测侧:构建 SlideBench,覆盖 Lighting、Composition、Camera、Environment、Character、Style、Object 七大类、57 个细粒度子类共 285 个样本的连续编辑基准,配套统一指标——单调递进(VLM 成对判断编辑强度是否随滑块一致增加)、感知连续性(相邻帧特征距离均匀度乘以 VLM 编辑强度加权)、多滑块解缠(固定其他滑块时非目标属性对齐分数的平均偏差)。方法侧:提出 SliderEdit++,在训练时显式正则化滑块的中间轨迹而非只监督端点,让等步长滑块产生等步长、可预测的语义变化,并让多个滑块沿正交方向作用;同时借助少步蒸馏骨干把单次渲染压到约 20–50 秒,实现真正可交互的连续编辑。
与已有工作不同的是,已有工作的切入点各有局限:SliderEdit 的部分提示抑制损失只锚定 $\alpha=0$ 与 $\alpha=1$ 两个端点,中间轨迹完全无约束,还需早停防止适配器变'尖锐';Kontinuous Kontext 依赖约 11 万对带强度标签的合成数据训练标量投影器;VeloEdit、FlowSlider 与文本嵌入插值等免训练方案只能在推理时干预,无法修正模型内在不一致的控制空间。本文的独特角度是把一个已知事实转写为训练信号:显式 CFG 的凸组合 $\epsilon=(1-\alpha)\epsilon_{edit}+\alpha\epsilon_{neutral}$ 天然平滑,而缩放 LoRA 权重经多层非线性后不保证平滑——那就把'中点输出等于两端均值'直接写成损失,再辅以谱范数显式约束适配器对 $\alpha$ 的敏感度,从训练机制上根治跳变与干扰。
核心方法
直觉上,理想的编辑滑块应像音量旋钮:拧多少、变多少。显式 CFG 用字面凸组合 $\epsilon=(1-\alpha)\epsilon_{edit}+\alpha\epsilon_{neutral}$ 几乎必然平滑;而 SliderEdit 缩放 LoRA 权重 $\alpha\Delta W^\ell$,预测是 $\alpha$ 的强非线性函数,权重线性不等于输出线性。SliderEdit++ 沿用 SliderEdit 框架:在 FLUX-Klein 4B 每层注入秩 32 LoRA,用部分提示抑制损失 $\mathcal{L}_{PPS}$ 训练适配器在 $\alpha=1$ 时逼近'保持图像不变'的中性输出(带停止梯度)。在此之上叠加三个互补正则项:速度空间中点一致性 $\mathcal{L}_{vel}$、DINOv2 语义特征空间中点一致性 $\mathcal{L}_{sem}$、逐层谱范数惩罚 $\mathcal{L}_{spec}$;多指令场景再加效果方向正交的解缠损失 $\mathcal{L}_{dis}$。总损失加权合并训练,1000 步即收敛。
核心创新是把'只监督端点'改为'监督中间点'。对随机采样的 $\alpha_1,\alpha_2\sim U[0,1]$ 取中点 $\alpha_m=\frac{\alpha_1+\alpha_2}{2}$,惩罚中点预测偏离两端预测的均值(目标端带 sg[$\cdot$] 停止梯度),这是让 $\alpha\mapsto\epsilon$ 映射近似仿射的离散版本:等滑块步长对应等量可预测输出,且端点由 LPPS 继续锚定不受影响。第二个关键是在用户真正感知的语义空间做同样约束:单步干净估计解码成像素后过冻结 DINOv2-L 编码,捕捉速度空间里不可见但屏幕上可见的跳变。第三个是把 SliderEdit 靠早停的隐式做法换成显式谱范数约束 $\frac{1}{L}\sum_\ell\sigma_{max}(\alpha B^\ell A^\ell)^2$,允许训练到收敛而适配器不会变成'硬开关'。多滑块则强制不同指令的效果方向 $\delta_a$ 与 $\delta_b$ 余弦相似度为零,从几何上保证互不泄漏。
方法步骤详情
训练流程:(1) 加噪采样,冻结模型去掉目标指令算目标速度,得端点抑制损失 $\mathcal{L}_{PPS}$;(2) 采 $\alpha_1,\alpha_2\sim U[0,1]$ 与中点 $\alpha_m$,三次前向算 $\mathcal{L}_{vel}$:中点速度须等于两端均值(带 sg);(3) 干净估计解码过冻结 DINOv2-L 得 $f^\alpha$,特征空间同样做中点一致性得 $\mathcal{L}_{sem}$;(4) 逐层算 $\sigma_{max}(\alpha B^\ell A^\ell)^2$ 得 $\mathcal{L}_{spec}$;(5) 多指令时 STLoRA 按 token 门控,惩罚效果方向夹角 $|\cos(\delta_a,\delta_b)|$ 得 $\mathcal{L}_{dis}$;(6) 按 $\lambda_{vel}=10,\lambda_{sem}=1,\lambda_{spec}=0.1$ 加权,Adam lr $4\times10^{-5}$、batch 32、1000 步、8×H100 训到收敛;推理 8 步 Euler,渲染 8 个均匀 $\alpha$ 滑档。
技术新颖性
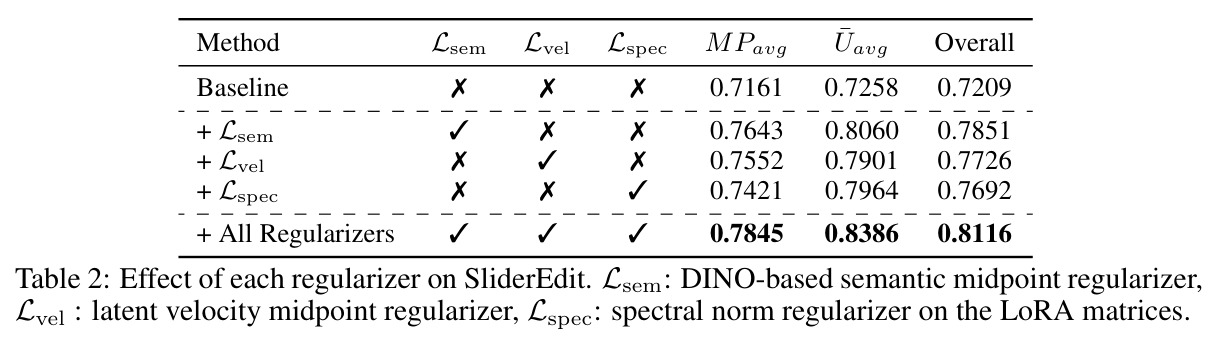
技术新颖性有三层。(i) 中点一致性正则首次把'滑块仿射性'写成可优化的损失,且停止梯度保证只塑形内部曲线、不与端点监督冲突——与 Kontinuous Kontext 用约 11 万配对数据学标量投影器相比,这里零额外标注,只在 ≤1 万无配对样本的抑制式训练上加约束。(ii) 语义空间正则直接约束用户感知量(DINOv2 特征)而非潜空间代理,屏幕可见、速度空间不可见的跳变是此前所有方法未处理的盲区。(iii) 用谱范数惩罚替代早停这一 ad-hoc 启发式,把'训练多久'从超参变成有原则的敏感度上界,使模型能训到收敛。消融(表2)证明三项各自有效且互补:无正则基线 Overall 0.7209,单项最高 +Lsem 达 0.7851,三项合并 0.8116。
实验结果
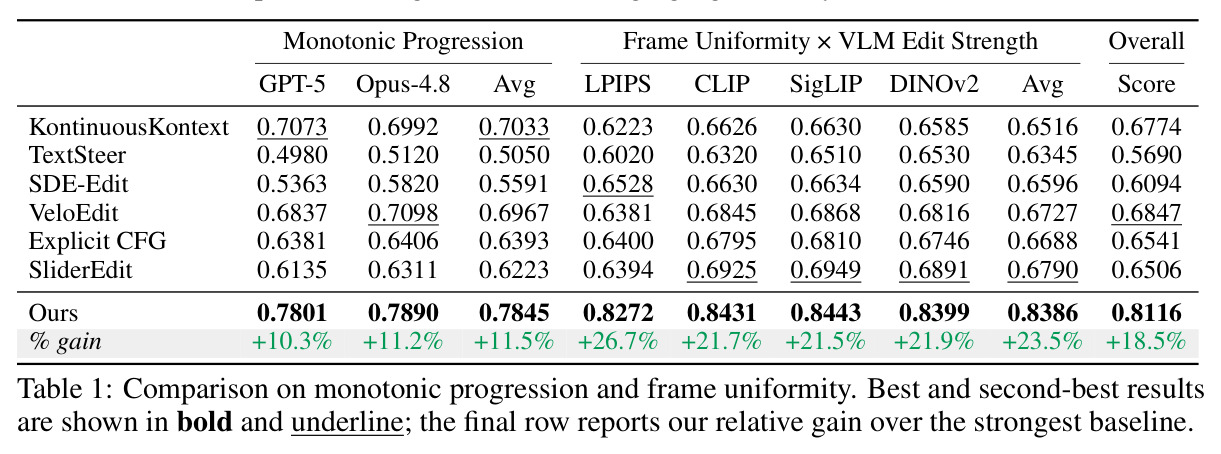
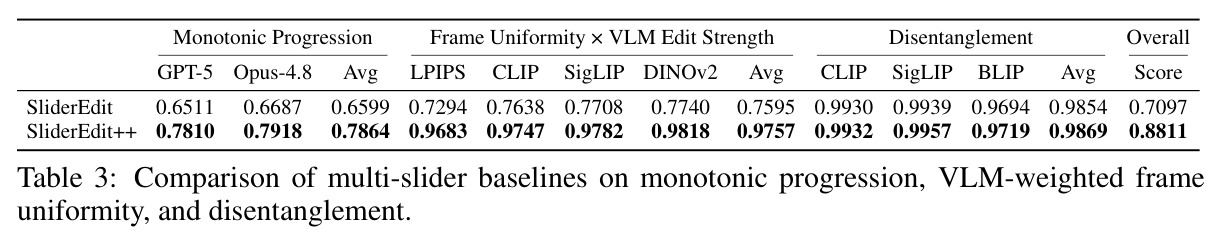
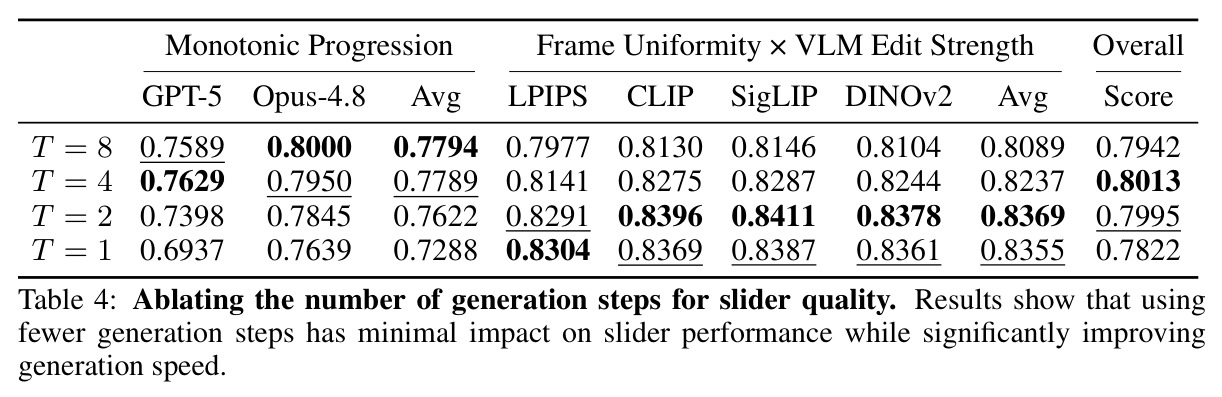
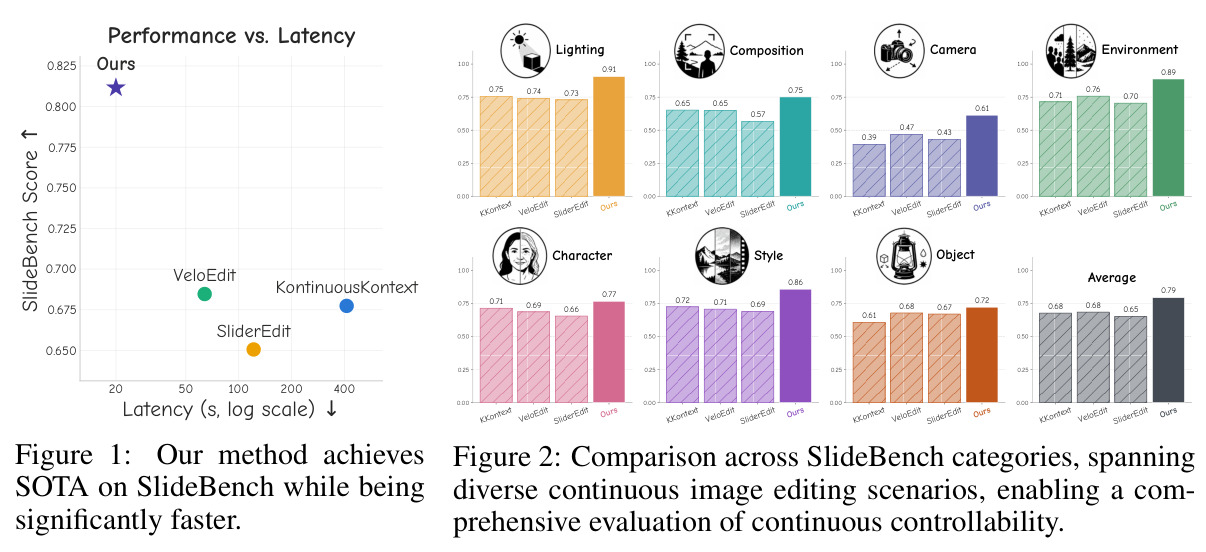
单滑块(表1):Overall 0.8116,较最强基线 VeloEdit 0.6847 相对提升 18.5%;单调性平均 0.7845(基线最高 0.7033,+11.5%);帧均匀性×编辑强度 0.8386(基线 0.6790,+23.5%)。图2:七大类全部第一,Camera 类所有方法最低(0.61–0.76)。图3:相邻滑档 DINOv2 语义变化距离从基线 0.030–0.037 降至 0.012 且最平稳。消融(表2):无正则基线 0.7209,+Lsem 0.7851、+Lvel 0.7726、+Lspec 0.7692,合并 0.8116。多滑块(表3):Overall 0.7097→0.8811,帧均匀性 0.7595→0.9757,解缠 0.9854→0.9869。少步消融(表4):去噪步数 8→1 总分仅 0.7942→0.7822,可再省最多 8 倍延迟。人类研究(图8):约 64% 用户选本文最平滑最忠实(基线 6%–15%),74% 偏好加正则策略。图1:单次滑档约 20–50 秒,比 100–400 秒的竞品快约 3–20 倍。
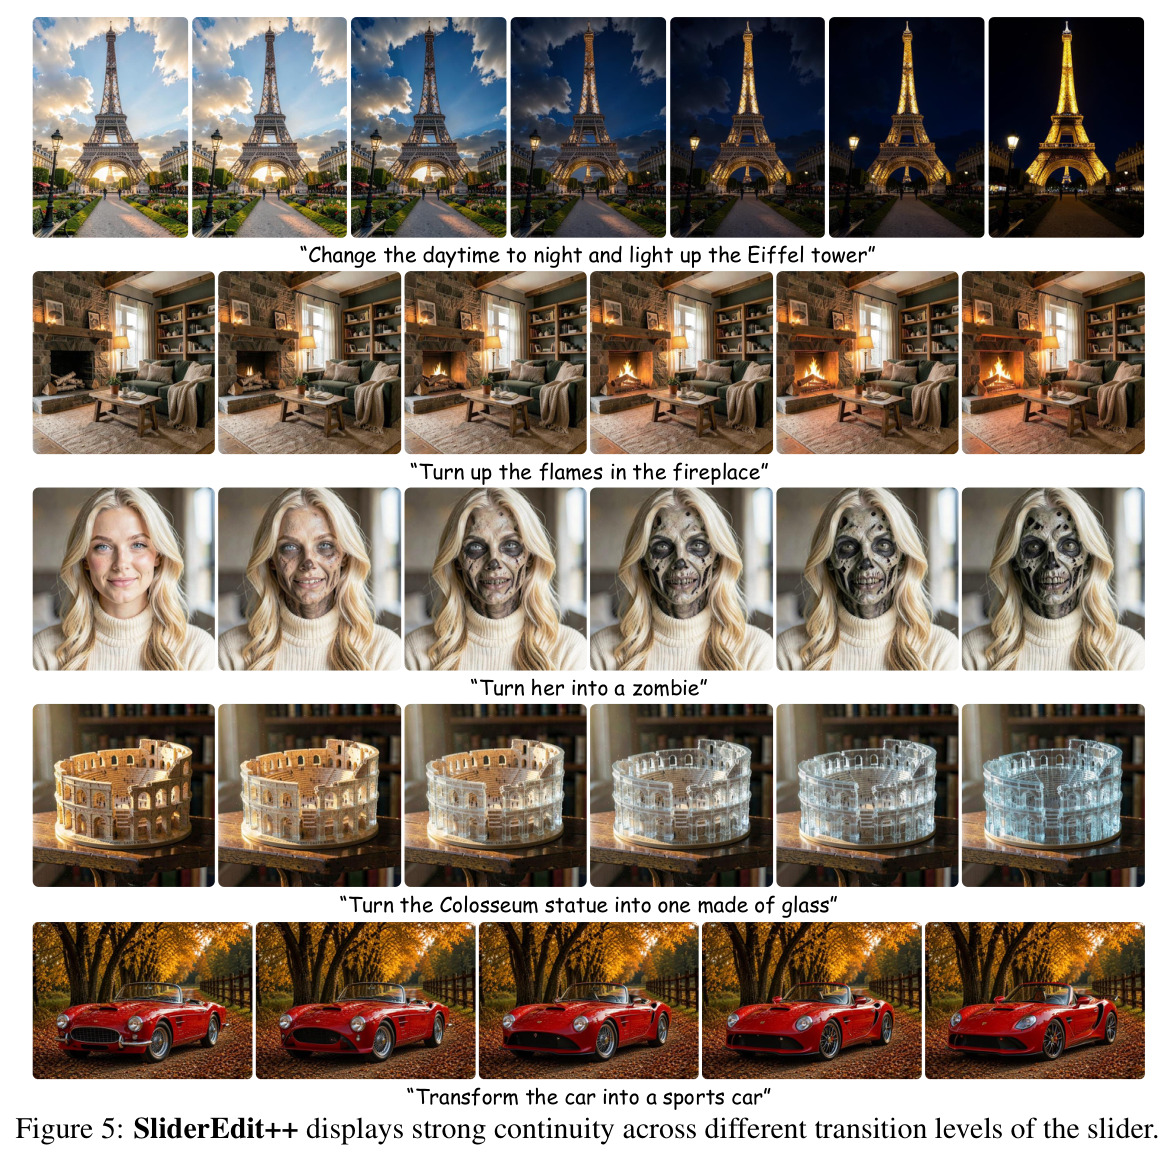
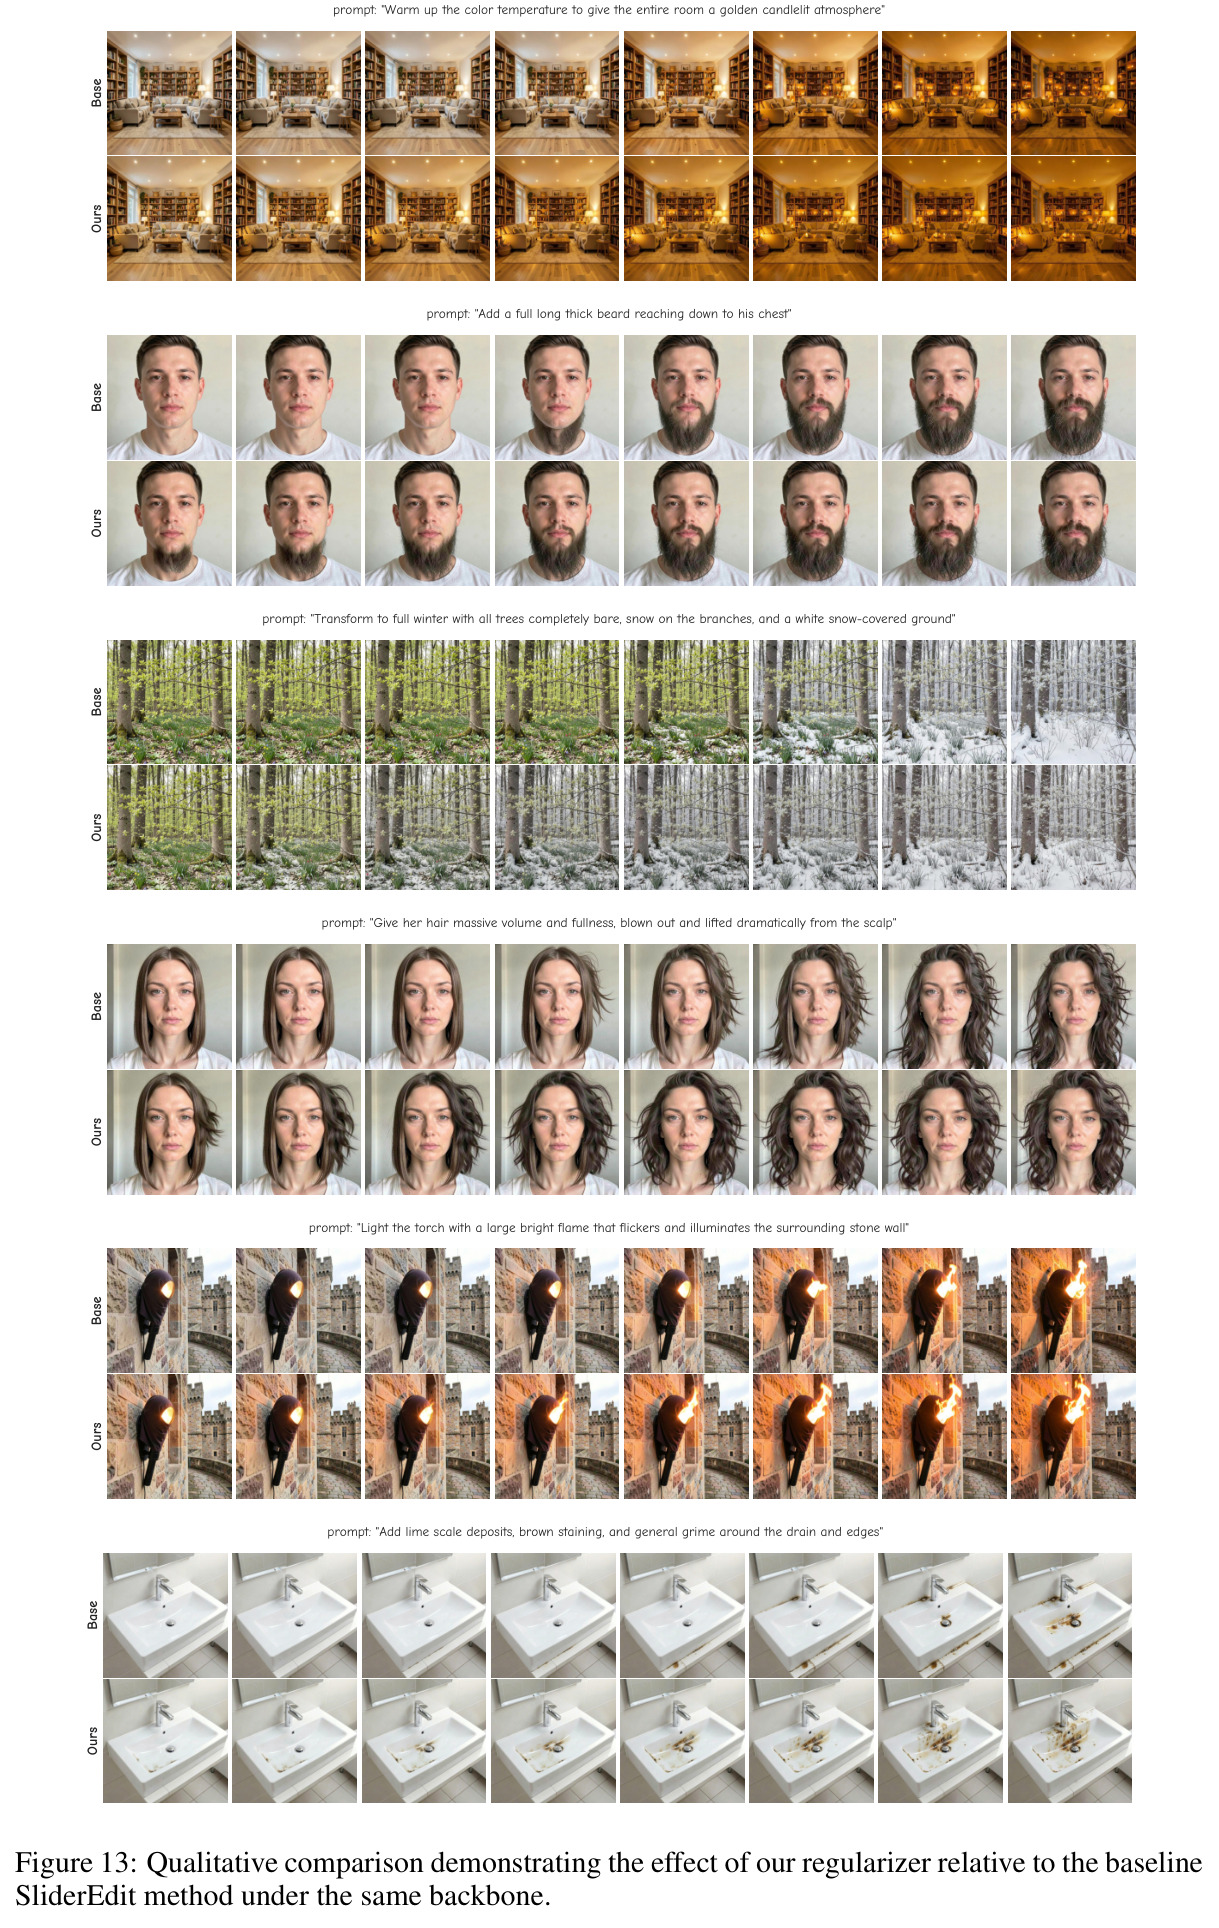
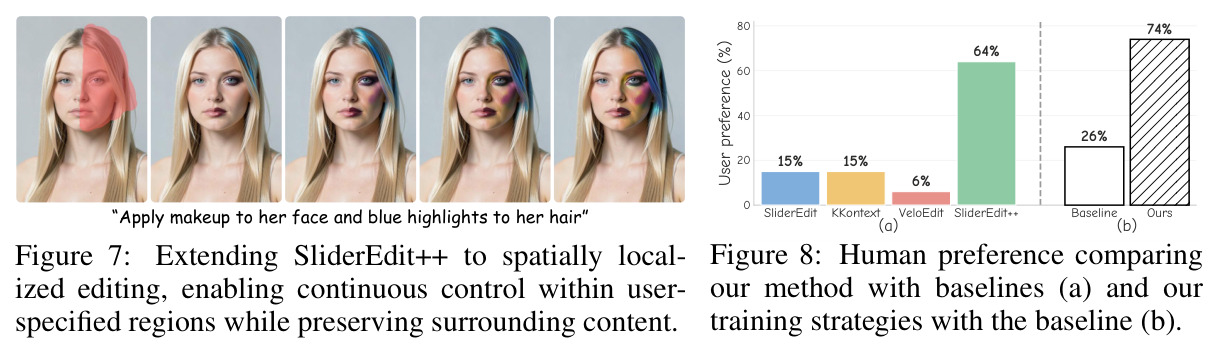
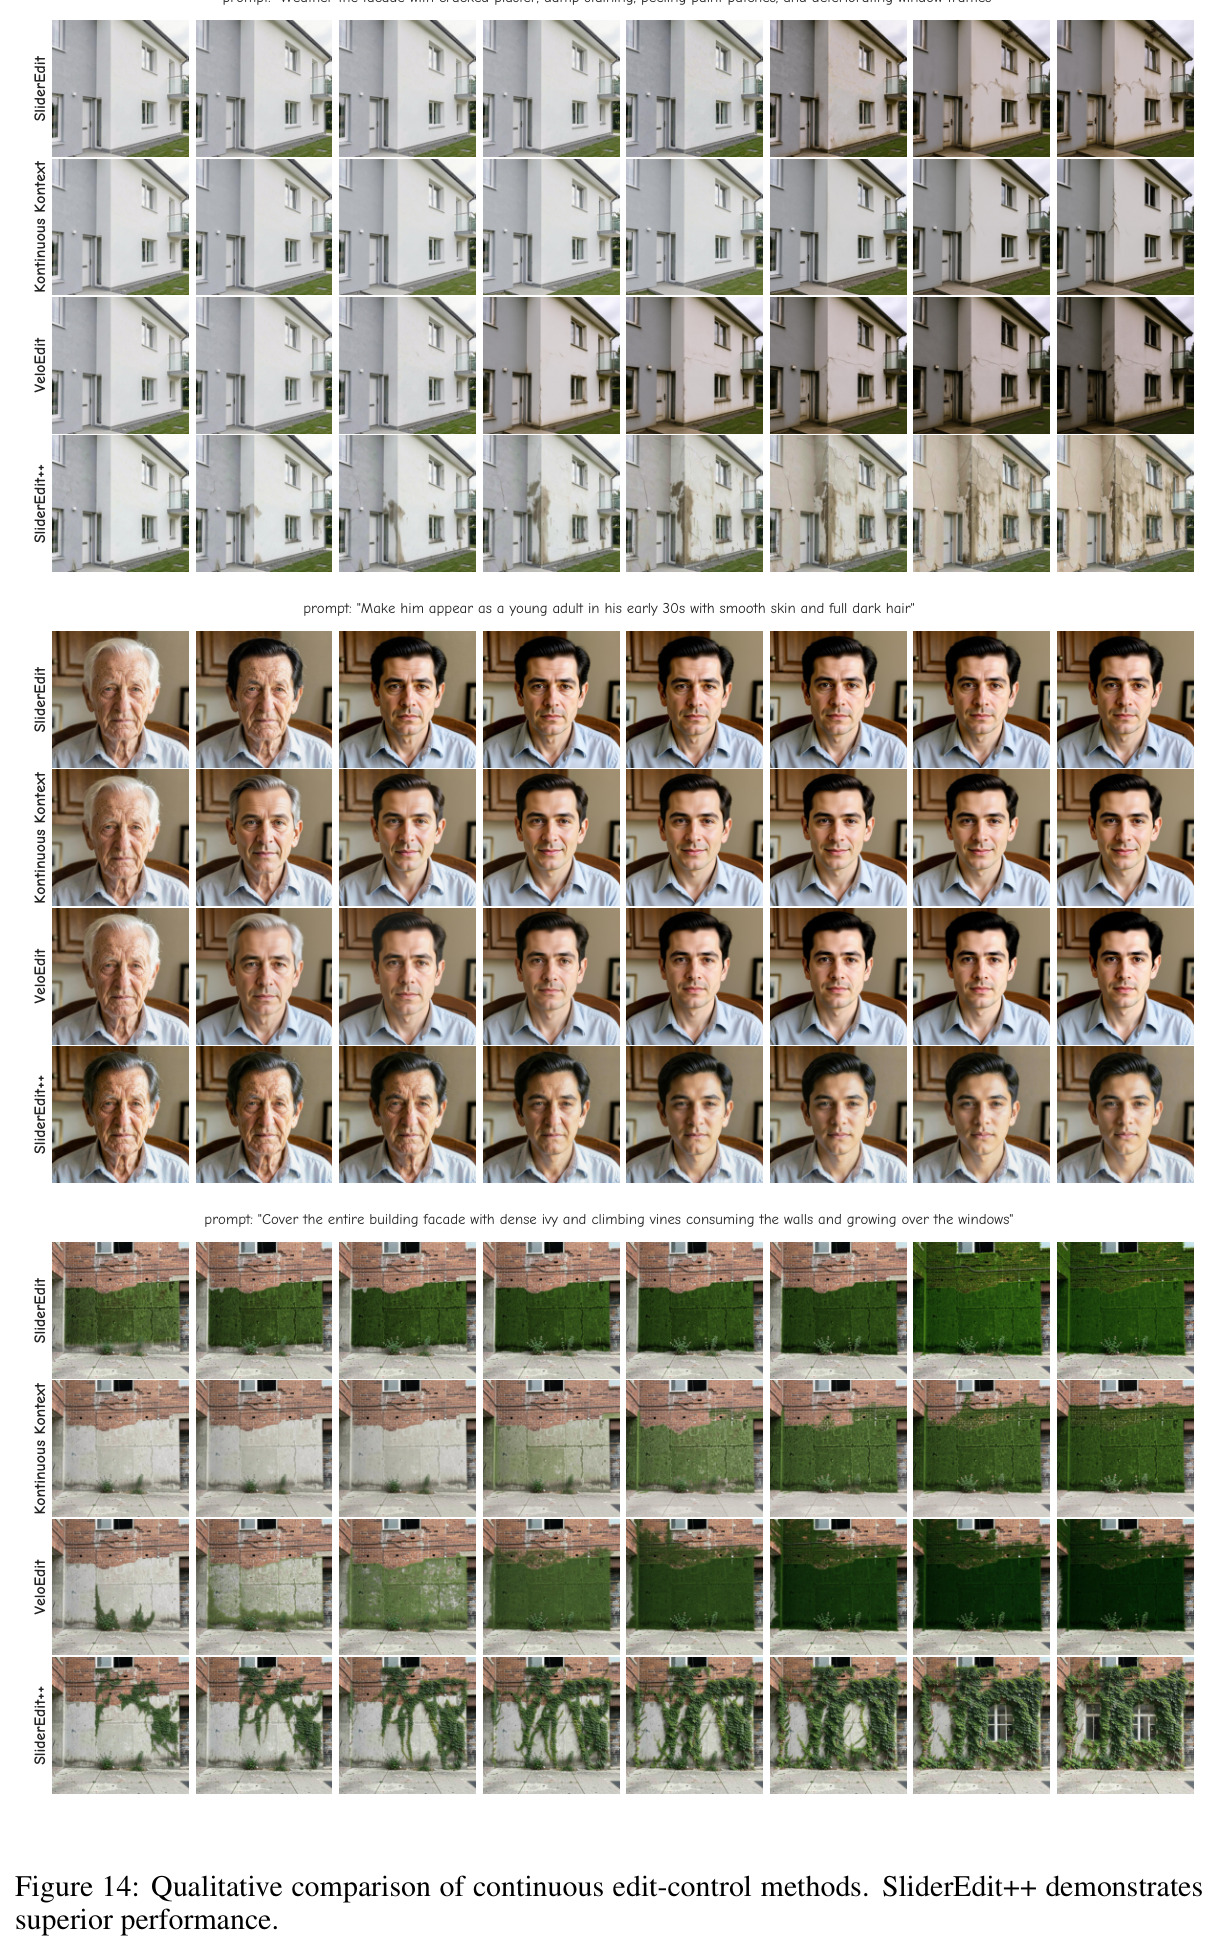
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单滑块连续编辑(SlideBench 全基准) | Overall Score(单调性×连续性综合) | 0.8116 | VeloEdit 0.6847(其余:KontinuousKontext 0.6774、SliderEdit 0.6506) | 相对最强基线 +18.5% |
| 单滑块单调递进 | VLM 成对判断平均准确率(GPT-5 与 Opus-4.8) | 0.7845 | KontinuousKontext 0.7033 | +11.5% |
| 感知连续性 | 帧均匀性(LPIPS/CLIP/SigLIP/DINOv2 平均)× VLM 编辑强度 | 0.8386 | SliderEdit 0.6790 | +23.5% |
| 多滑块联合编辑 | Overall(单调性 + 帧均匀性 + 解缠) | 0.8811 | SliderEdit 0.7097 | +24.2% |
| 轨迹平滑度 | 相邻滑档 DINOv2 语义变化距离(越低越好) | 0.012 | VeloEdit 0.037 / KontinuousKontext 0.032 / SliderEdit 0.030 | 约降低 60%–68% |
| 交互延迟 | 单次滑档渲染时延(8 步 Euler 求解器) | 约 20–50 秒 | SliderEdit 等约 100–400 秒 | 快约 3–20 倍 |
局限与改进
作者承认:方法性能受底层编辑模型能力上限约束——Camera 类所有方法绝对分数都偏低(0.61–0.76),瓶颈在基础模型的编辑能力而非滑块控制本身。我的补充观察:(1) SlideBench 仅 285 个样本、57 个子类各 5 张,规模偏小,VLM 判断的方差可能未被充分平均,也未报告置信区间;(2) 评测依赖 GPT-5 与 Claude Opus 4.8 两个商用 VLM,成本高且存在评测与训练范式同源的偏差风险;作者自己也承认 CLIP/SigLIP/BLIP 对细粒度编辑不敏感,导致解缠指标挤在 0.985+ 区间几乎无区分度(表3 中 0.9854 vs 0.9869);(3) 仅在 FLUX-Klein 4B 一个骨干上验证,正则项对其他编辑器的可迁移性未知;(4) 语义正则每个采样点需 VAE 解码加 DINOv2 前向,训练开销高于基线;(5) 损失权重 $\lambda_{vel}=10,\lambda_{sem}=1,\lambda_{spec}=0.1$ 为手工设定,未做敏感性分析。
独立分析的弱点
(1) 基准太小:285 样本、每子类仅 5 张,难以支撑'提升 18.5%'这样的强统计结论,改进方向是扩充样本量并报告逐类置信区间。(2) 解缠评测近乎失效:表3 中三种对齐分数都在 0.985 以上,本文仅比基线高 0.0015,任何方法都能'通过',改进方向是让 VLM 做逐属性问答或训练专用的细粒度属性探针。(3) 平滑与编辑强度存在张力:表4 显示去噪步数减少时单调性从 0.7794 降到 0.7288,谱范数约束也可能压低最大可达编辑强度,改进方向是自适应 $\lambda$ 或分段训练。(4) 全局共享 LoRA 对训练分布外的极端指令泛化未测,改进方向是补零样本指令覆盖实验。(5) 少步蒸馏骨干的绝对编辑质量上限拉低整体分数(Camera 类约 0.7),改进方向是接入更强基础编辑器(如 FLUX.2 级别)再验证正则增益是否保持。
未来方向
作者提出的方向:构造对细粒度编辑更敏感的鲁棒特征空间以改进解缠评测(现用 CLIP/SigLIP/BLIP 区分度不足);提升底层编辑模型以攻克 Camera 等困难类别。基于本文成果可延伸:(1) 把中点一致性与谱范数正则迁移到视频编辑,约束时间维上的连续性;(2) 与掩码条件滑块(图7,最后 k=2 步做 masked latent blending)深度结合,发展区域级连续控制的交互产品;(3) 对平滑–强度权衡做帕累托分析并探索自适应正则权重;(4) 把 SlideBench 扩充为带人类标注的公开 leaderboard,统一这一碎片化领域的评测协议;(5) 利用 1–2 步推理仍保持 0.78+ 分数的结果(表4),开发近实时的滑块式编辑系统;(6) 研究正交解缠目标在多概念文生图与个性化生成中的泛化。
复现评估
项目页(armanzarei.github.io/SliderEditPlusPlus)已上线,但论文未明确承诺代码与 SlideBench 数据开源,需关注后续发布。复现要素基本齐备:FLUX-Klein 4B 与 DINOv2-L 均为公开权重;超参完整($\lambda_{vel}=10$、$\lambda_{sem}=1$、$\lambda_{spec}=0.1$、秩 32 LoRA、Adam lr $4\times10^{-5}$、全局 batch 32、1000 步、8×H100);Algorithm 1 伪代码足以重写全部损失。训练量很小(仅 1000 步),瓶颈在每步 3 次骨干前向加 VAE 解码的算力,少量 H100 数天可复现;基线中 KontinuousKontext 与 SliderEdit(均 CVPR 2026)有公开代码可对照实现。评测需调用 GPT-5 与 Opus 4.8 的 API,对 285 样本 × 8 滑档 × 成对判断存在持续 API 成本。综合难度中等:若代码开源则较低,否则需自行实现 STLoRA 与三个正则项。
论文图表
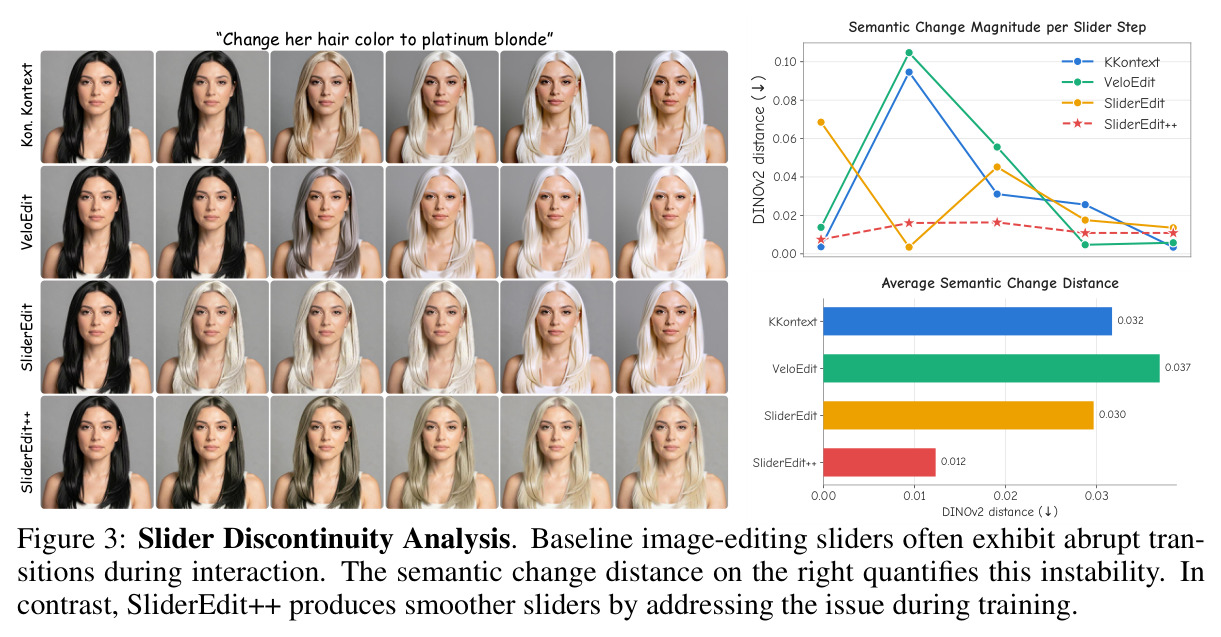
左侧为'Change her hair color to platinum blonde'的滑块定性对比,可见基线在某一步发色突变;右上为相邻滑档 DINOv2 语义变化距离曲线,右下为平均值:KontinuousKontext 0.032、VeloEdit 0.037、SliderEdit 0.030,而 SliderEdit++ 仅 0.012 且曲线平稳。
这是全文问题陈述的直接量化证据:把'滑块不平滑'从主观观感转化为可测指标,既是方法动机的依据,也定义了后续的连续性评测方式。