Vidu S2:实时交互、可编辑与空间视频生成 Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
实时交互数字人与实时视频流编辑双模型,720p 下 25~42 FPS,并拓展到 VR 空间视频
前置知识
扩散模型与 Diffusion Transformer(DiT)
扩散模型通过逐步去噪生成数据:给定加噪输入 $x^t$ 与噪声水平 $t$,网络预测干净信号 $\hat{x}^0$。DiT 用 Transformer 替代 U-Net 作为去噪骨干,配合 VAE 在低维潜空间工作,已成为 Sora 等视频生成模型的主流架构。
Vidu S2 的两个模型都是 DiT,论文所有训练公式(式 1–6)都建立在扩散去噪框架上,不懂扩散模型无法理解任何一节。
Diffusion Forcing(扩散强制)
一种训练框架:对序列中每个时间段独立采样不同噪声水平 $t_i$,让模型学会在任意噪声组合下生成。它统一了自回归扩散(历史干净、未来加噪)与全序列扩散(全部同噪声),天然适合流式生成。
SRF 的『对整条自生成轨迹独立重新加噪』步骤以及因果化训练中的历史加噪 $x_{<i}^{\tau_i}$ 都直接沿用 Diffusion Forcing。
Self-Forcing(自强制)
让模型在训练时以自己自回归生成的历史作为条件(on-policy),使训练分布匹配推理分布,从而缓解自回归误差累积导致的漂移与坍缩。其局限:历史以干净形式喂入且从计算图 detach,梯度无法跨块传播。
SRF 正是针对 Self-Forcing 这两个缺陷设计的改进,理解原方法的『干净历史 + detach』才能看懂 SRF 的『带噪历史 + 带梯度回放』这一本质区别。
DMD(Distribution Matching Distillation,分布匹配蒸馏)
把多步扩散教师蒸馏为一步/少步学生的方法:不逐点回归,而是让学生输出的分布匹配教师的评分函数(score),从而在极少步数下保持生成质量,是实时视频生成的主流蒸馏路线。
SRF 的本质是 on-policy DMD:损失 $\mathcal{L}_{DMD}$ 被施加在回放轨迹的所有块上,配合感知损失 $\mathcal{L}_{perc}$ 防止模式坍缩。
扩散 DPO 与 Streaming NFT
扩散版直接偏好优化(DPO)用人类偏好成对数据微调扩散模型,提升视觉保真度;Streaming NFT(负感知微调)在流式场景下对模型自生成轨迹做基于奖励的优化,使优化状态对齐推理时的自回归分布。
论文在双向预训练阶段用 diffusion DPO、在流式阶段用 Streaming NFT 两级偏好优化来提升指令跟随与画质,是效果提升的组成部分。
块级因果注意力(block-wise causal attention)
把视频切成若干段(chunk),注意力掩码保证第 $i$ 段只能看到参考图、当前段条件以及之前各段的有效历史状态 $x_{<i}^{\tau_i}$,看不到未来。这是把双向模型改造成流式生成的结构基础,配合 KV 缓存实现无限长生成。
论文的训练分两阶段:先双向预训练建立先验,再替换为块级因果掩码做因果化,式 (3) 的历史条件完全依赖这个掩码机制。
VAE 潜空间与潜空间单步超分
视频先经 VAE 压缩到低维潜空间再做扩散,大幅降低算力。超分 Refiner 在潜空间把低分辨率潜变量 $\hat{x}_i^{0,LR}$ 上采样 $U(\cdot)$、加噪到固定时间步 $t_r$($z_i^{t_r}=(1-t_r)U(\hat{x}_i^{0,LR})+t_r\epsilon_i$),单步预测高分辨率潜变量。
720p 实时化的关键:主骨干在低分辨率快速跑,靠一个单步 Refiner 提升分辨率,速度与清晰度因此解耦。
高效注意力核:SageAttention / SpargeAttention / SLA
三类近似注意力实现:SageAttention 用低精度量化加速注意力计算;SpargeAttention 做动态稀疏注意力跳过不重要 token;Sparse-Linear Attention(SLA)用稀疏线性近似把注意力复杂度近线性化。
注意力是流式视频生成的最大延迟瓶颈,论文按层敏感度混合使用这三种核(敏感层保精度、不敏感层激进加速),是推理系统工程的核心。
GSB 人评协议与 VFIDI 指标
GSB 即随机化成对比较:受训评估者在相同输入下二选一或判 Same,统计偏好率,用于黑盒商业系统对比。VFIDI 用 I3D 与 3D-ResNeXt101 提取的视频特征衡量生成与参考视频的分布距离(类似 FVD),数值越低越好。
实验部分一半结果用 GSB 呈现(Fig 6/7),虚拟试衣用 VFIDI(Table 4),不懂这两个指标无法解读成绩。
研究动机
现有最强视频生成模型(Sora、Veo、Wan、Seedance)几乎全部采用离线一次性生成范式:用户输入提示词后要等几分钟甚至几十分钟,生成结束后才能拿到完整视频,期间用户只能被动等待、无法发起任何交互。这一限制源自离线扩散范式本身——模型对整段视频同步多步去噪,最后才输出完整干净视频,它适合内容创作,但无法覆盖面对面交流、直播、游戏等必须即时响应的交互式视觉娱乐。作者还给出一个需求规模论证:设每个用户对实时交互内容的平均需求为 $\alpha$、对离线内容为 $\beta$,由于离线视频可被反复回放分享,其生成需求约为 $\beta \times N/m$($N$ 为用户数,$m$ 为单条视频平均播放次数);只要 $\alpha \approx \beta$ 且 $m > 100$,实时交互视频生成的总需求就远大于离线生成。前作 Vidu S1 虽已实现 540p@42FPS 的实时对话数字人,但有四个硬伤:分辨率只有 540p;定义角色的参考图在推流开始后就固定不可更换;难以跟随跳舞这类大幅肢体运动;完全不支持对输入视频流做实时编辑。
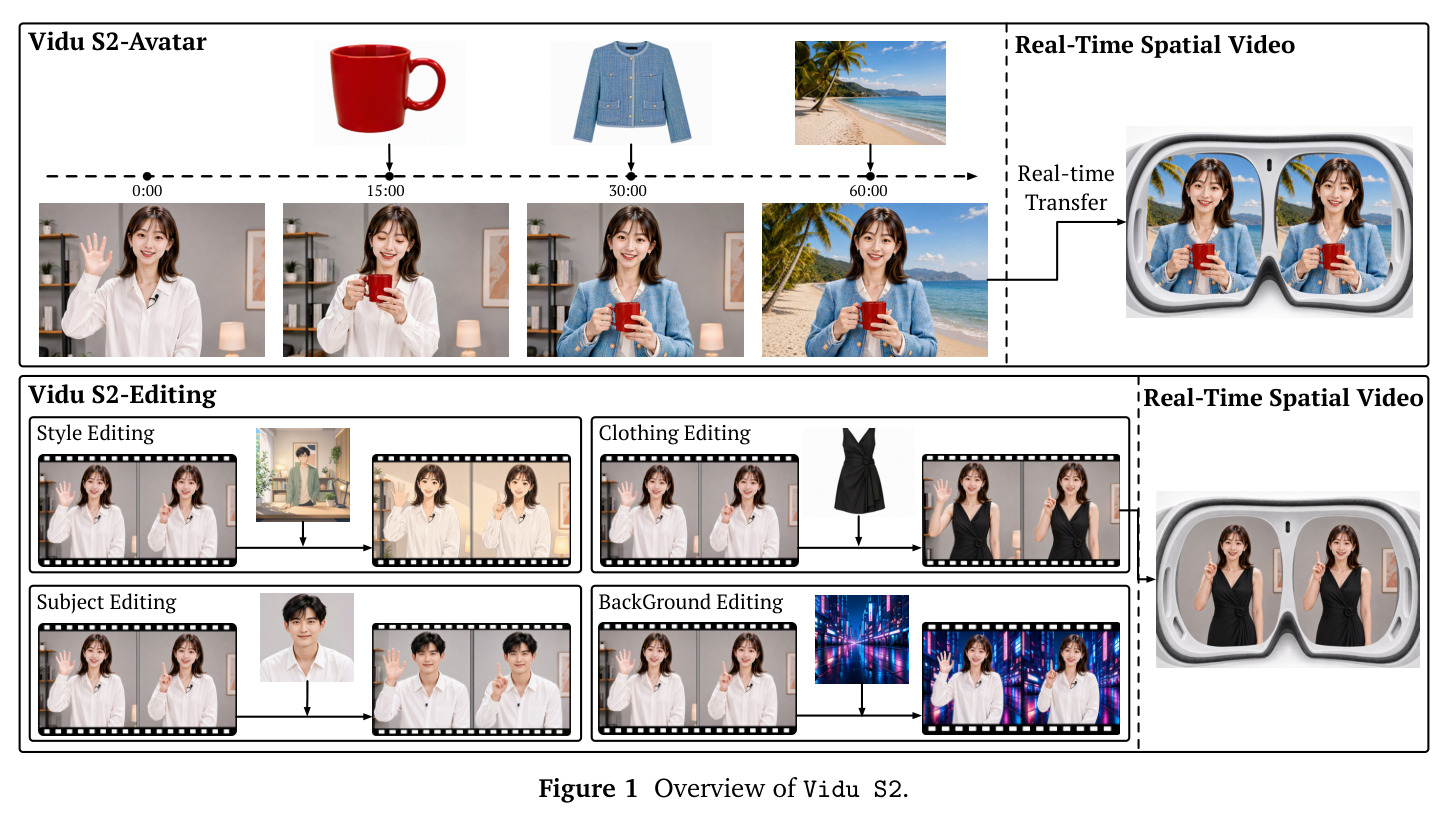
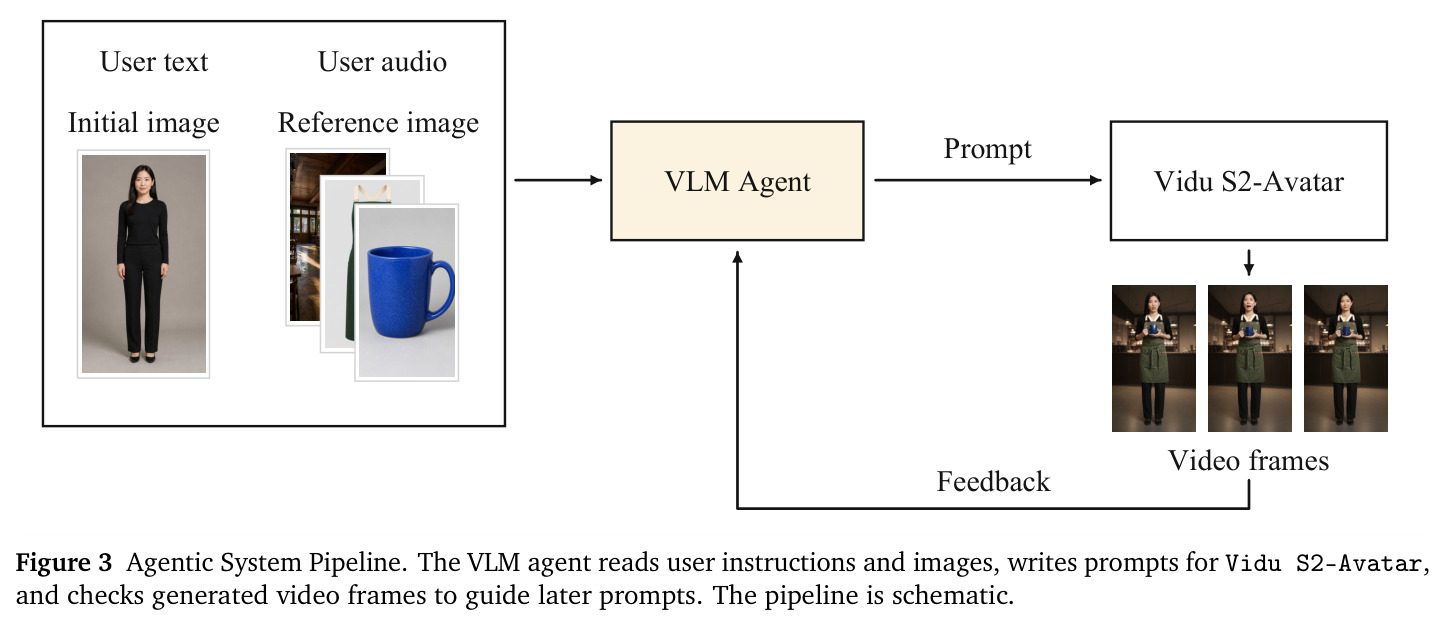
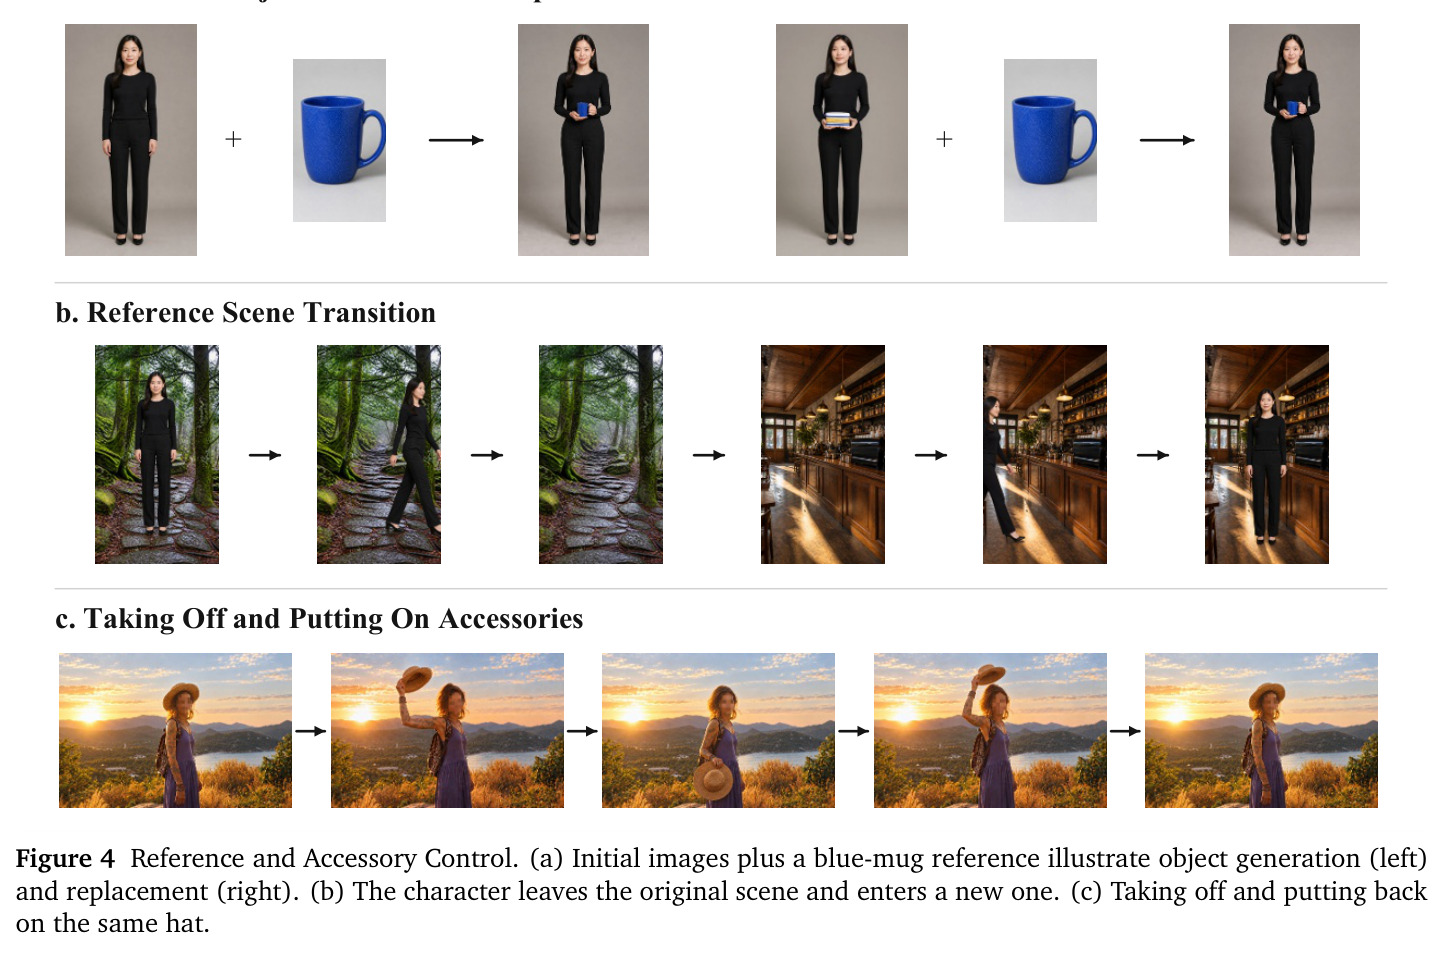
本文的目标是本文目标是构建新一代实时视觉生成系统 Vidu S2,包含三个组成部分。其一是 Vidu S2-Avatar:实时交互数字人模型,在四个方向上超越 S1——把实时生成从 540p 提升到 720p 且保持 25~42 FPS;支持任意时刻注入新参考图(拿起一个物体、换一件衣服、换一个背景)的动态参考交互;通过扩充独舞舞蹈与 2D/3D 动画数据、背景稳定化、时序稠密字幕与偏好优化实现更强的指令跟随;并用 VLM 智能体系统保证交互可靠性。其二是 Vidu S2-Editing:对持续到来的视频流做实时编辑,覆盖风格迁移、虚拟试衣、人物替换、背景替换四类任务,且编辑结果与输入动作严格逐帧对齐。其三是实时空间视频:把 Avatar 生成的单目流或编辑后的视频流转换为左右目同步视图推送到 VR 头显,或直接编辑已有立体视频。所有模型都必须在低成本消费级 GPU 上满足实时推理要求。
与已有工作不同的是,本文的独特切入角度是把『训练算法、数据工程、推理系统』三条线拧成一股绳,而不是单点改进模型。算法上,作者指出 Self-Forcing 虽对齐了推理分布,但自生成历史以干净状态输入且从计算图 detach,梯度无法跨段传播,限制了数据效率;他们提出的 Self-Replay Forcing(SRF)用『先 detach 完整 rollout、再按 Diffusion Forcing 重新加噪、最后单次带梯度的因果回放』同时保住了 on-policy 特性与跨块梯度流。数据上,作者发现标称分辨率不可靠(重度压缩的 1080p 视频依然模糊),改用实测清晰度选片;针对舞蹈视频普遍带运镜的问题,不丢弃这些视频而是用背景稳定算子把相机运动抵消掉,避免了运动多样性损失。系统上,作者把 VAE 编码器、因果骨干、Refiner、VAE 解码器放到共享 GPU 时间线上按时间片复用算力,这在学术工作中相当少见。此外把实时视频生成延伸到 VR 空间视频(双目转换与立体流编辑)也是同类工作中的首个完整尝试。
核心方法
直觉上,本文要把离线视频扩散模型改造成『边看边生成』的流式系统,需要同时解决四件事:模型必须对自己的生成历史鲁棒(否则长流会漂移坍缩)、分辨率提升不能拖慢主链路、编辑必须与输入流逐帧对齐、延迟预算要靠系统工程硬抠出来。技术路线分四步。第一步,在双向 Diffusion Transformer 上联合训练图像到视频(I2V,参考图为目标首帧)与参考到视频(R2V,参考图为身份图)两个任务(式 2:$\hat{x}_{1:N}^0 = f_\theta^{bi}(x_{1:N}^t, t, r, c_{1:N})$),并采用分段条件监督——每段有独立字幕 $c_i$,而非整段一个 prompt。第二步,把双向时间注意力替换为块级因果注意力掩码,按式 (3) 混合 Teacher Forcing(干净历史)与 Diffusion Forcing(带噪历史 $x_{<i}^{\tau_i}$)训练,获得初始流式能力与历史鲁棒性。第三步,用 Self-Replay Forcing 做 on-policy DMD 蒸馏,并在双向阶段用 diffusion DPO、流式阶段用 Streaming NFT 做两级偏好优化。第四步,加一个单步潜空间超分 Refiner 把低分辨率骨干输出升到 720p。推理侧用分层混合稀疏注意力、逐块 W8A8 量化 GEMM、Triton/CUDA 核融合、CUDA Graphs、量化的 Ulysses 上下文并行以及跨模块共享时间线调度,把延迟压到实时。
核心创新是 Self-Replay Forcing(SRF),一种保留跨块梯度流的 on-policy DMD 蒸馏。Self-Forcing 让模型以自身 rollout 为条件训练从而匹配推理分布,但它有两个结构性缺陷:自生成历史以干净形式喂入(而推理时历史是带噪的 KV 缓存),且历史被 detach,损失无法跨块回传,梯度只在当前块内部流动,两者都限制了数据效率和训练质量。SRF 的做法分三段:模型先做一次长自回归 rollout,生成的块与 KV 缓存全部 detach(避免在内存中保留整条 rollout 的计算图);随后对整条自生成轨迹的所有段按 Diffusion Forcing 独立重新加噪;最后在单次『带梯度的因果回放』中重算全部回放段——回放段彼此保持在同一计算图内连通,靠后段的损失可以经注意力传播到靠前的段,而继承自 detach rollout 的外部历史保持固定,因此不需要为原始 rollout 保留反向图。训练目标为 $\mathcal{L}_{SRF} = \mathcal{L}_{DMD}(f_\theta^{causal}(x_{1:N}^t, t, r, c_{1:N})) + \mathcal{L}_{perc}(f_\theta^{causal}(x_{1:N}^t, t, r, c_{1:N}))$,感知损失沿用 S1 以防模式坍缩。另一个关键设计是非对称缓存噪声调度:骨干 attend 高噪缓存 $\hat{x}_{ \tau_R$)保留身份与外观细节,把时间传播与空间细节恢复解耦。
方法步骤详情
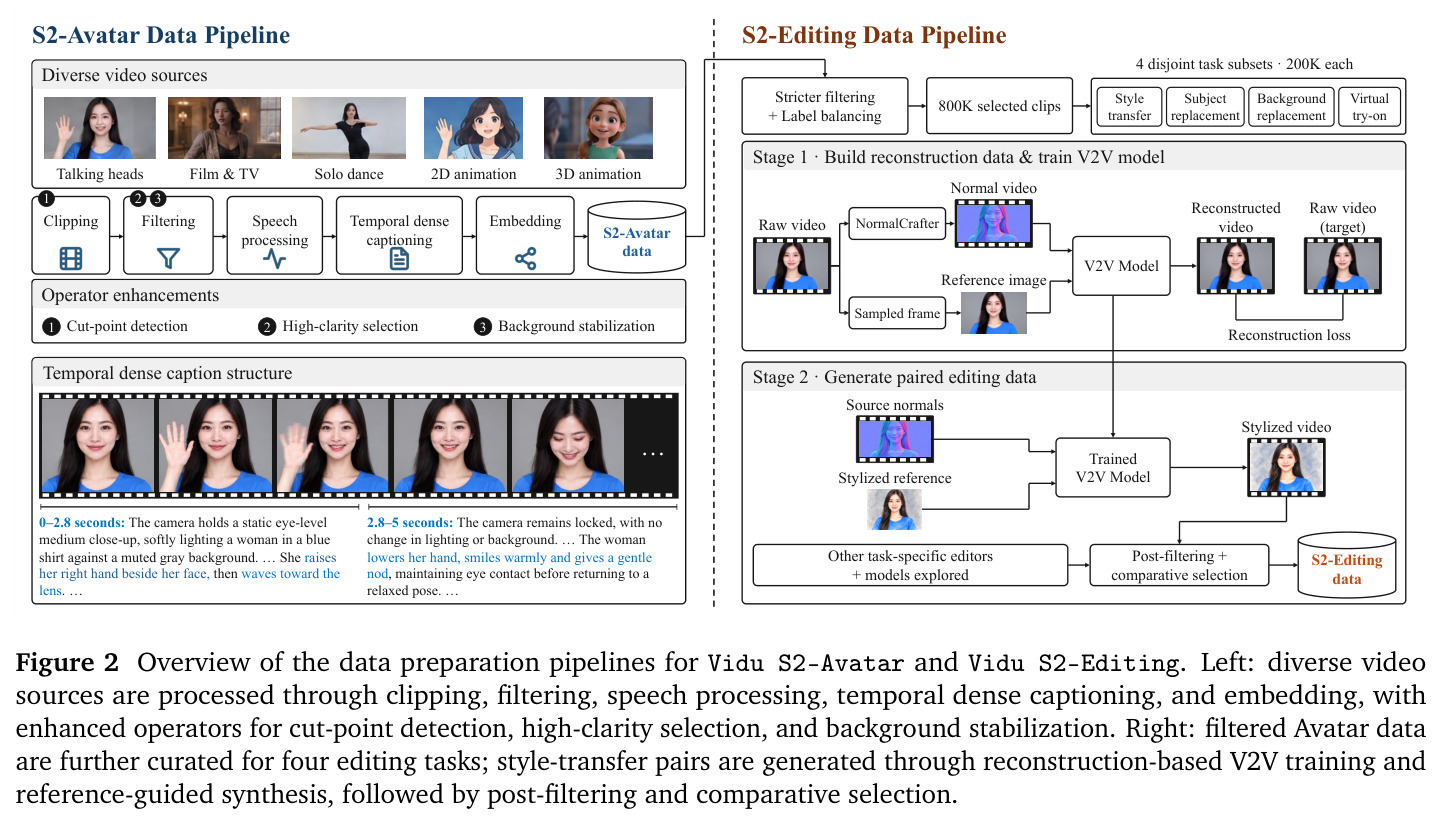
完整流程如下。(1) 数据准备:沿用 S1 五阶段管线(切分、过滤、语音处理、字幕、嵌入)并增强三个算子——剪辑点检测先粗检再用 VLM 对候选切点附近抽帧二次审核(保证片段无剪切且误杀率低于 2%);高清晰度选片综合分辨率、帧率、编码器、像素格式、位深、码率的相互关系以及专家模型对技术质量、纹理细节、边缘锐度、压缩伪影的评估,加权打分后按阈值筛选;背景稳定算子对保留的平滑运镜视频先检测并掩掉前景主体,再从背景区域做特征提取匹配估计相机变换,几何校正加裁剪得到稳定背景(大幅复杂运镜的视频直接排除)。字幕改为按事件时间顺序排列的稠密字幕(如『2.5s–3.8s 她在脸旁举起右手并朝镜头挥手』),块级字幕在事件边界切分而非固定时长,标注管线为分层多智能体(识别、描述、校验、过滤各司其职,专家模型提供检测与语音识别的事实锚定层)。(2) 双向预训练:按式 (2) 联合 I2V/R2V,分段条件监督。(3) 因果化:块级因果掩码 + 混合 Teacher/Diffusion Forcing 按预设概率采样训练。(4) SRF 蒸馏与偏好优化:detach rollout → 重加噪 → 带梯度因果回放 → DMD + 感知损失;双向阶段 diffusion DPO 增强表情、运动自然度与音画同步(为因果化提供更强教师),流式阶段 Streaming NFT 用自生成轨迹按 SRF 方式回放做奖励优化。(5) 超分:按式 (5) 在潜空间上采样并加噪到固定 $t_r$,单步预测高分辨率潜变量,骨干与 Refiner 使用非对称噪声缓存。(6) 编辑模型(式 6:$\hat{x}_{1:N}^0 = f_\theta^{edit}(x_{1:N}^t, t, s_{1:N}, r, c_{1:N})$):源视频与参考图编码为条件 token 与带噪目标 token 拼接,条件流用条件专属 RoPE 编码位置;帧对齐注意力保证每个目标帧只与同时刻源帧交换信息、参考图对所有帧可见;流式推理时每个源帧与其产出的目标帧一起消费,不进缓存。(7) 空间视频:逐帧估计深度并映射为水平视差,以单目帧为中心视图向相反方向 warp 出左右目,轻量填补遮挡空洞并做时序深度稳定。
技术新颖性
与已有工作的本质区别有四点。其一,相对 Self-Forcing:SRF 首次在 on-policy 流式蒸馏中实现跨块梯度流——Self-Forcing 的历史干净且 detach,SRF 的回放历史带噪且计算图连通,后续块的 DMD 损失可以直接优化先前块的生成,长程一致性的训练信号更强,这是训练效率层面的实质推进而非调参。其二,相对 Diffusion Forcing:DF 只是『给历史加噪』的训练框架,SRF 在其上叠加自生成轨迹回放与 DMD 分布匹配,把对齐从『训练分布=推理分布』推进到『带噪历史 + on-policy 轨迹』的双重对齐。其三,非对称缓存噪声调度(借鉴 S1 中 TwinCache 的分阶段缓存思想):同一模型链路内骨干与 Refiner 维护两种噪声水平的历史缓存,分别服务运动传播与细节恢复,这是分辨率与速度解耦的轻量方案,区别于级联式多模型超分管线。其四,编辑侧的帧对齐注意力:一般 video-to-video 编辑允许源与目标 token 自由混合注意,容易产生时序漂移与结构错位;强制逐帧时间对齐、参考图全局广播、源帧即用即弃不进缓存,构成了流式实时编辑在正确性与显存成本之间的折中设计。数据侧,用 NormalCrafter 法线视频 + 参考图训练重建式 V2V 模型、再换风格化参考图批量合成风格迁移配对数据的『以生成造数据』路线,也是可迁移的工程创新。
实验结果
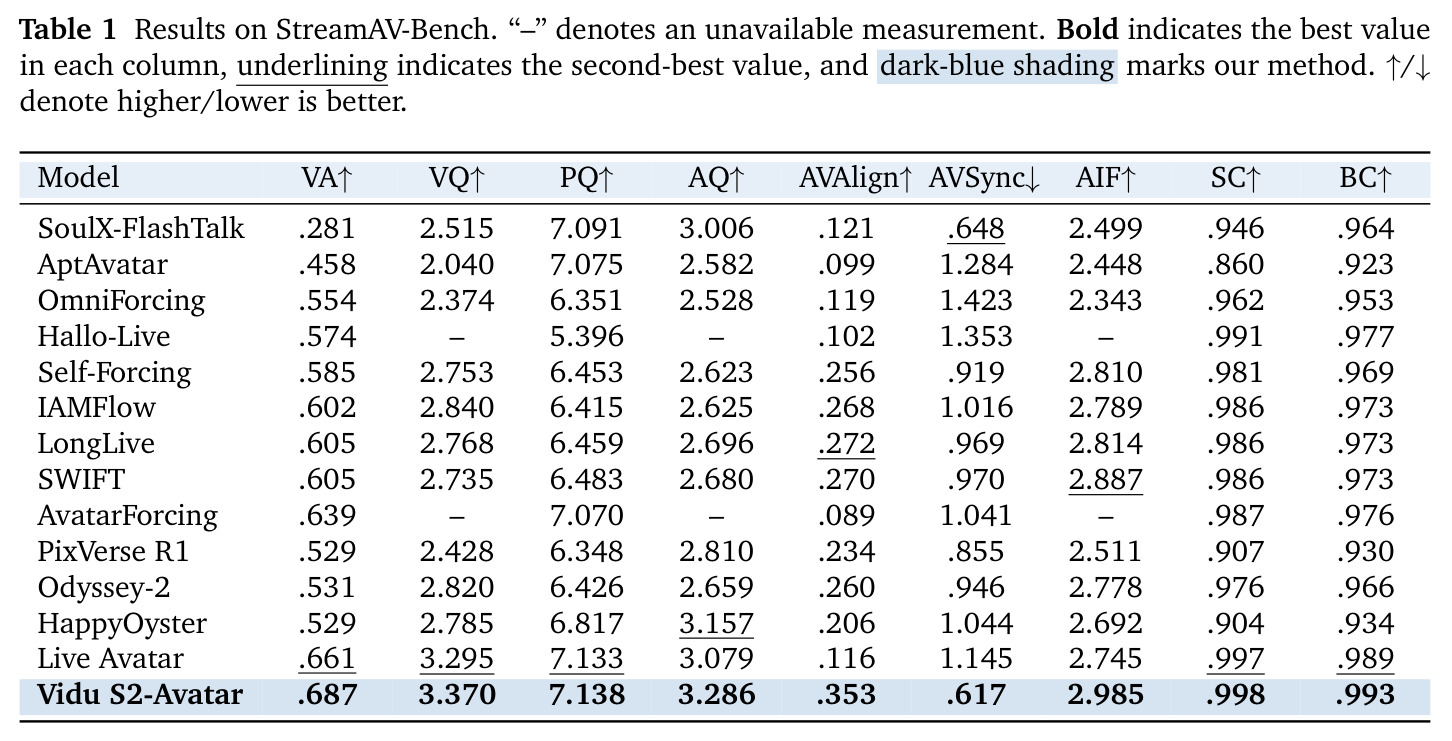
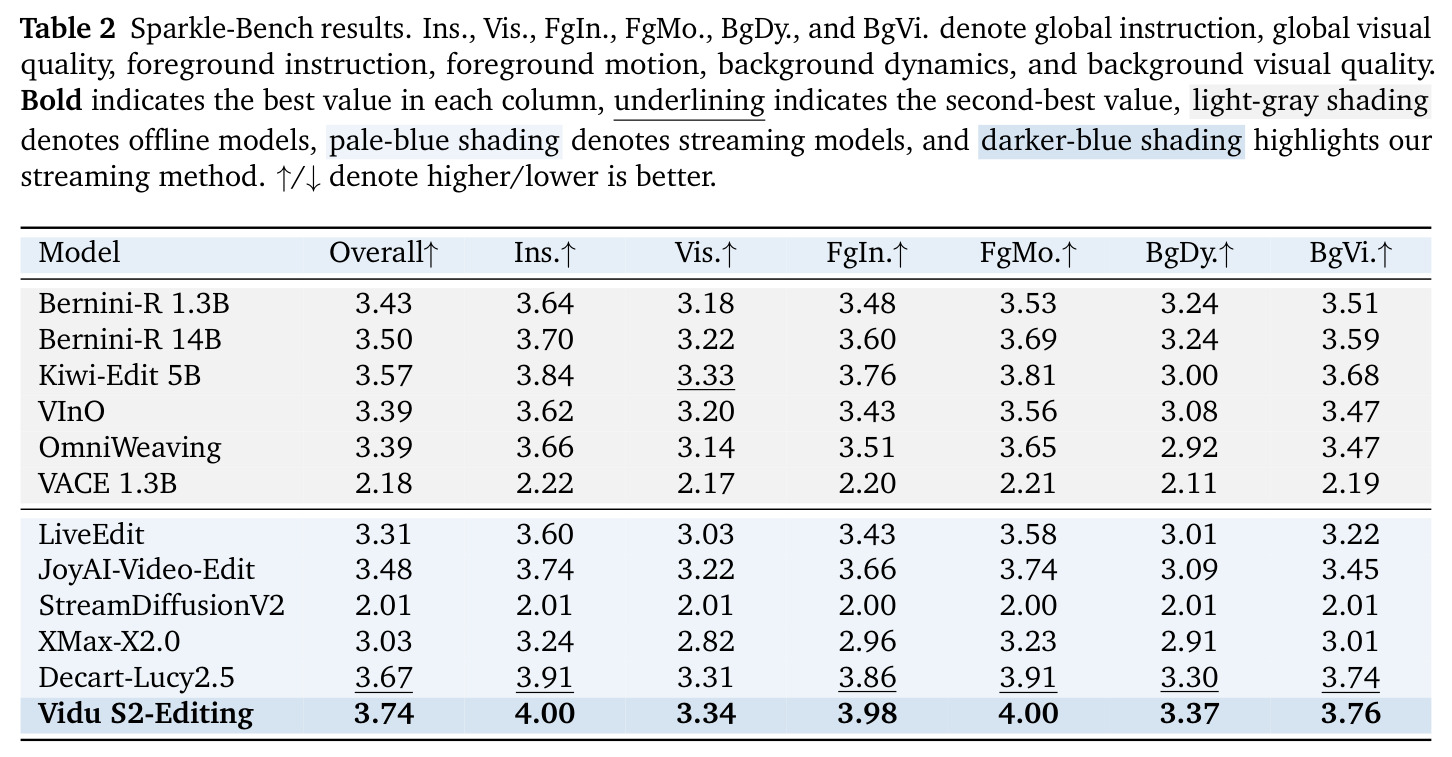
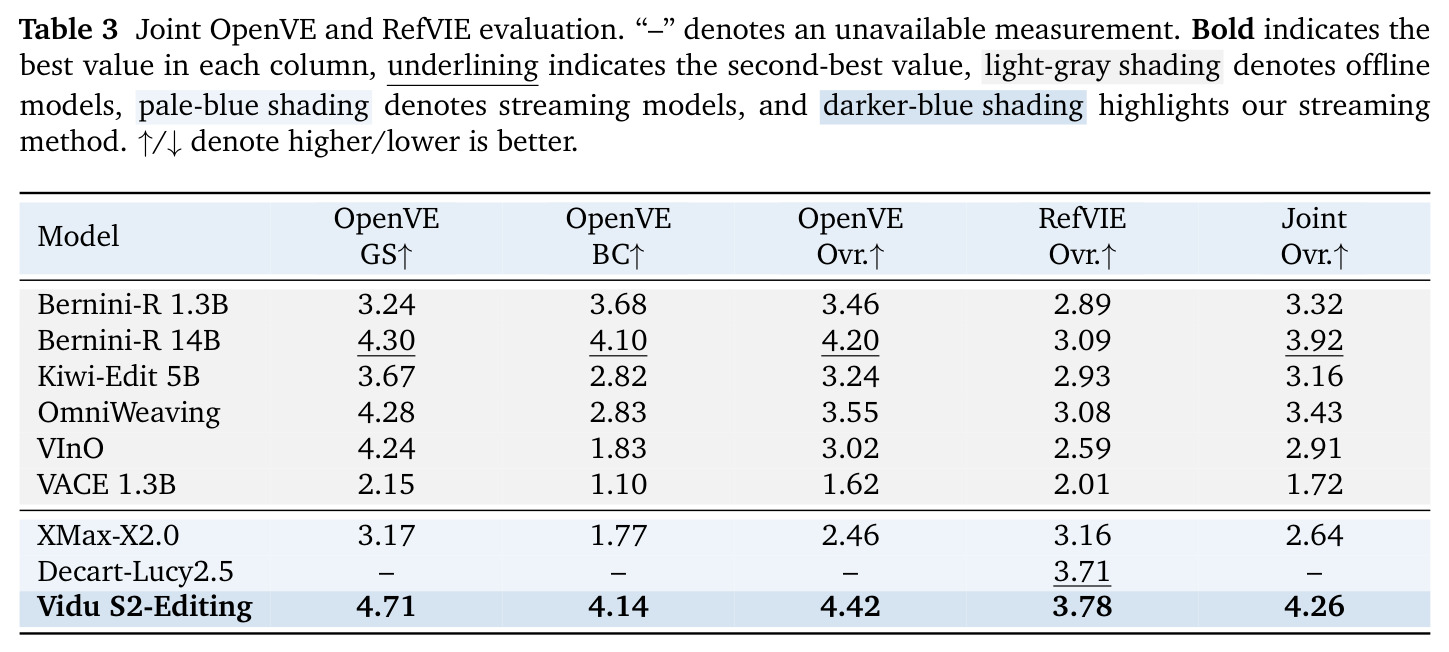
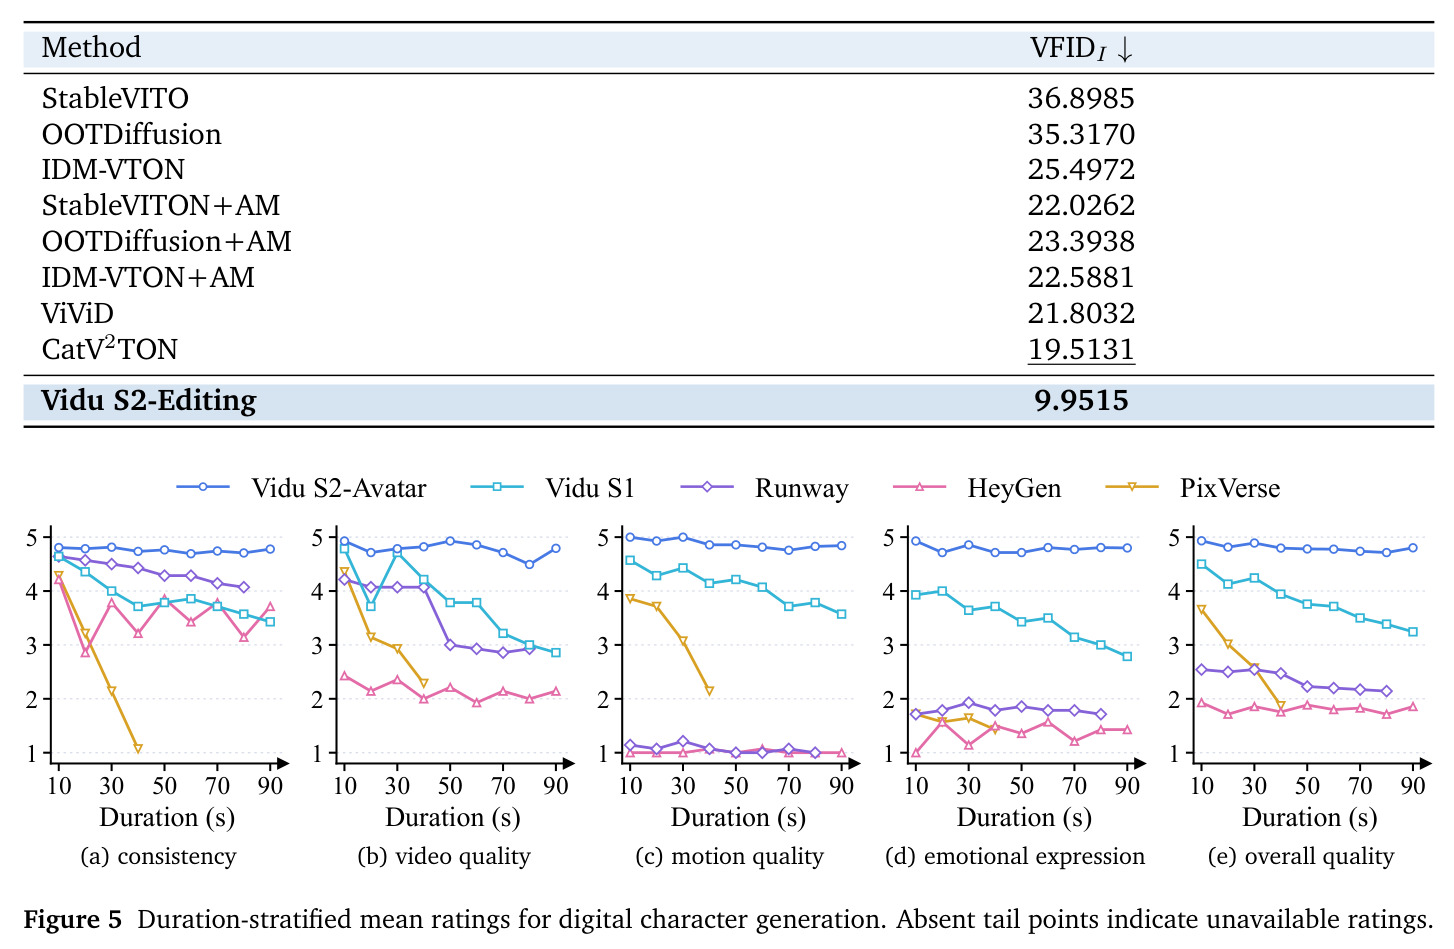
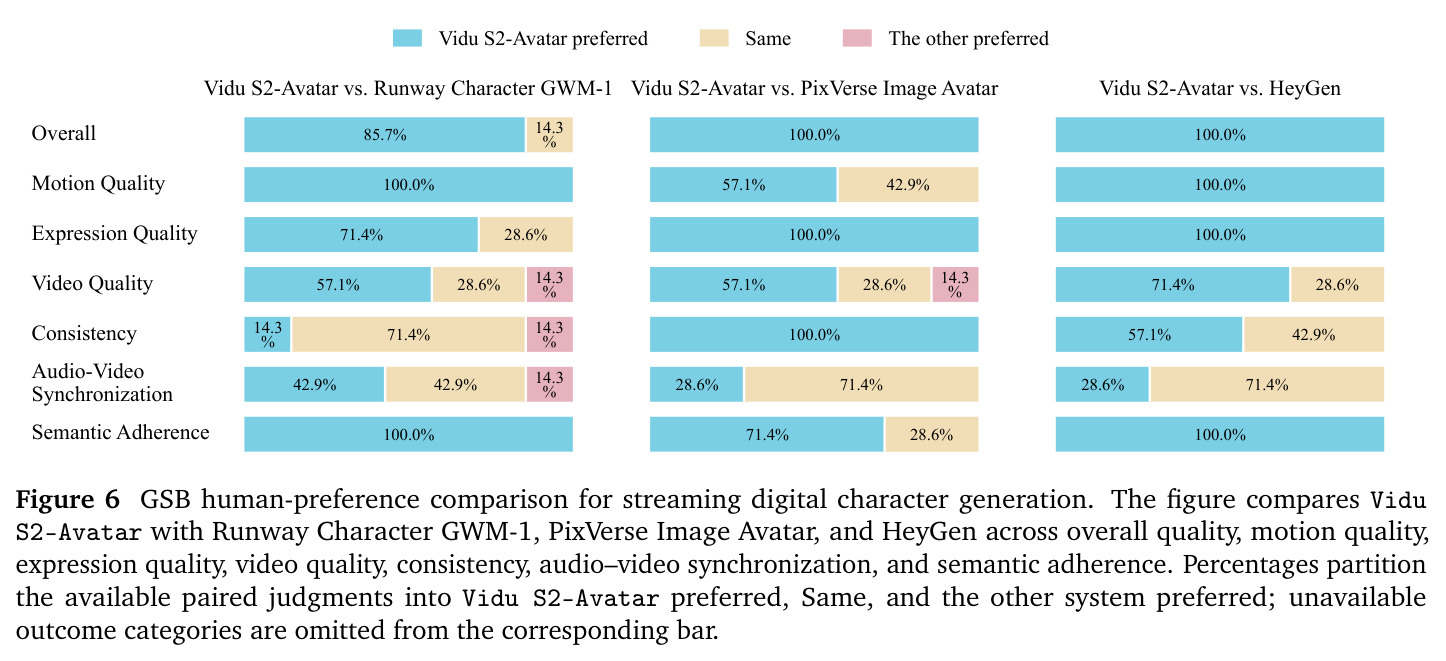
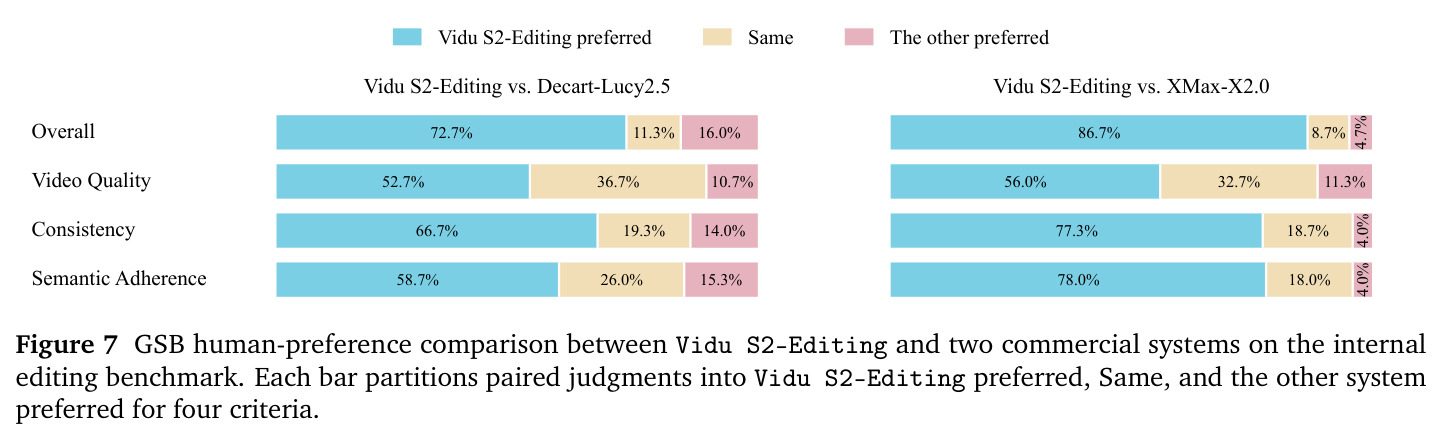
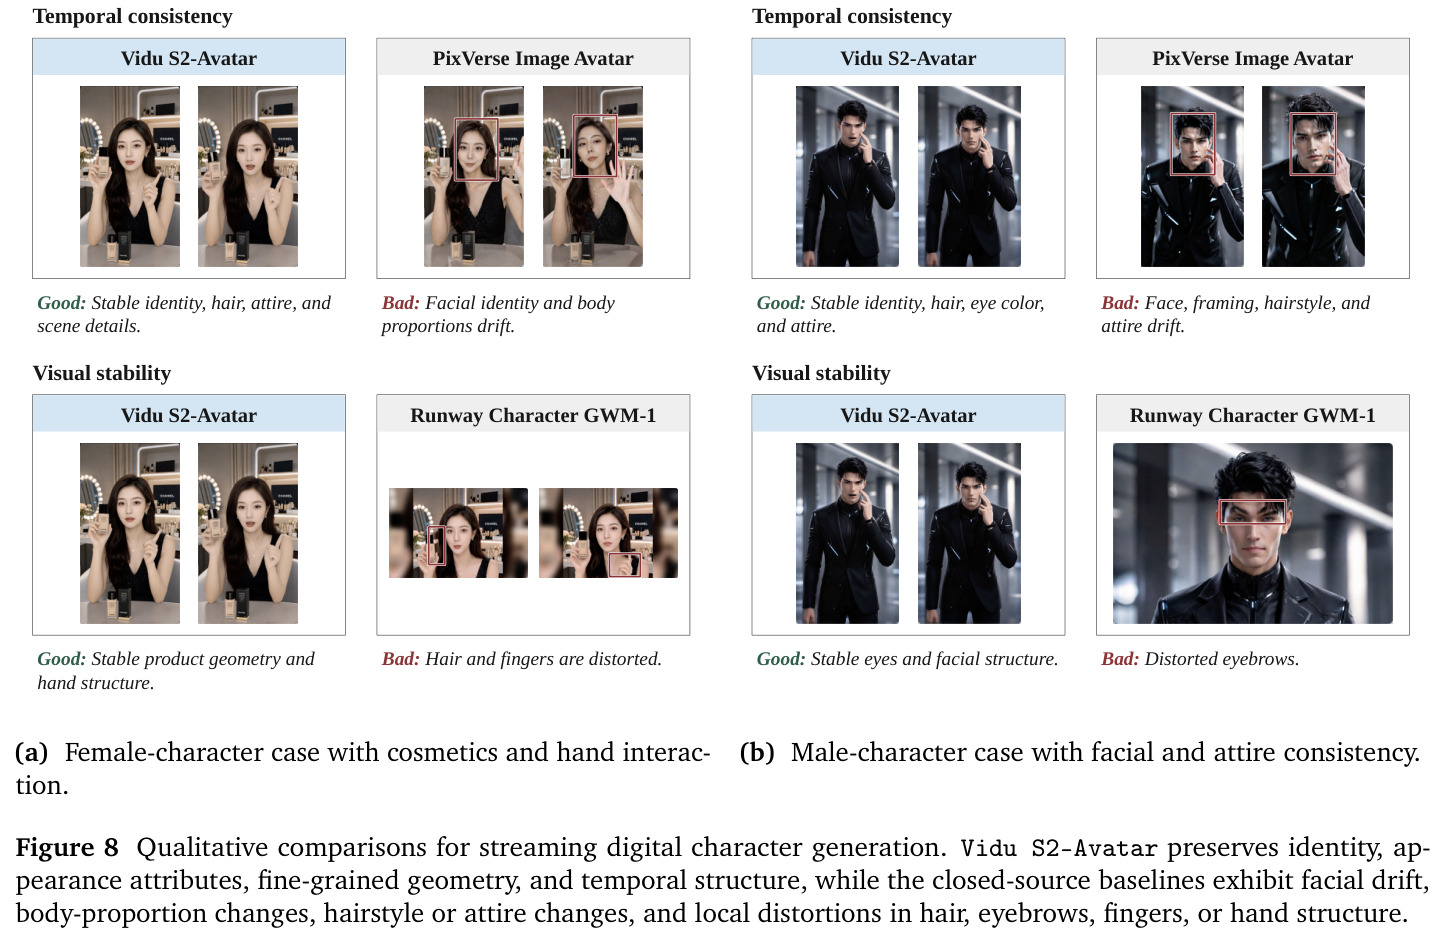
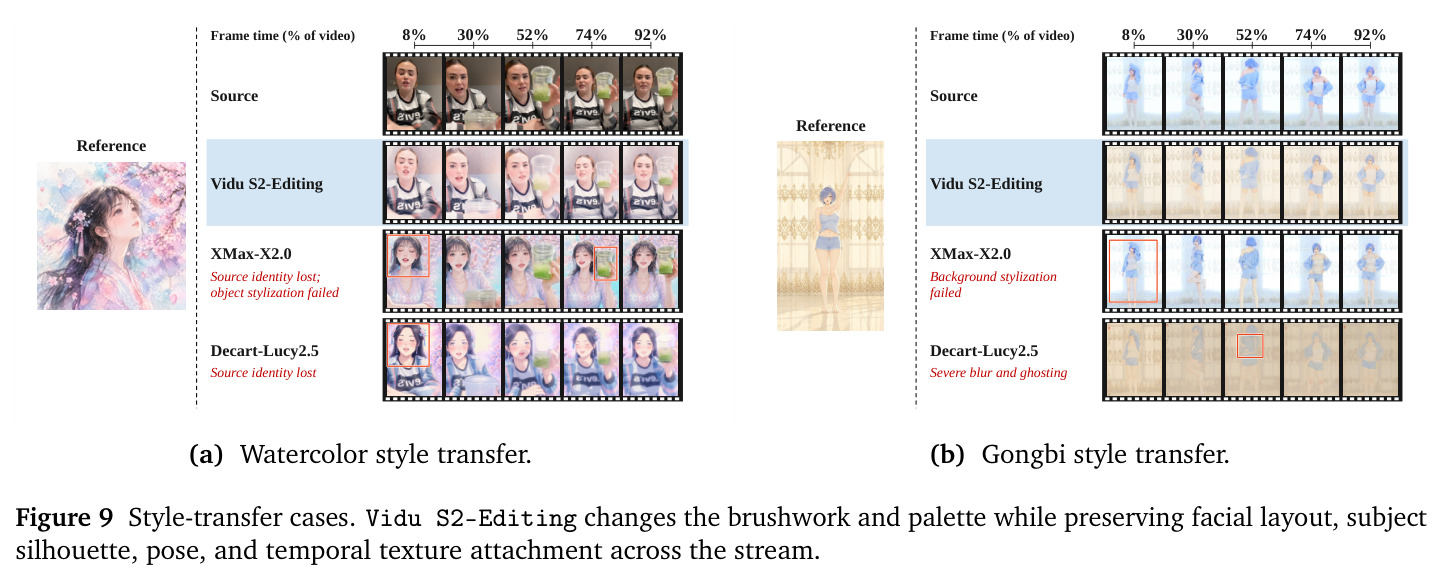
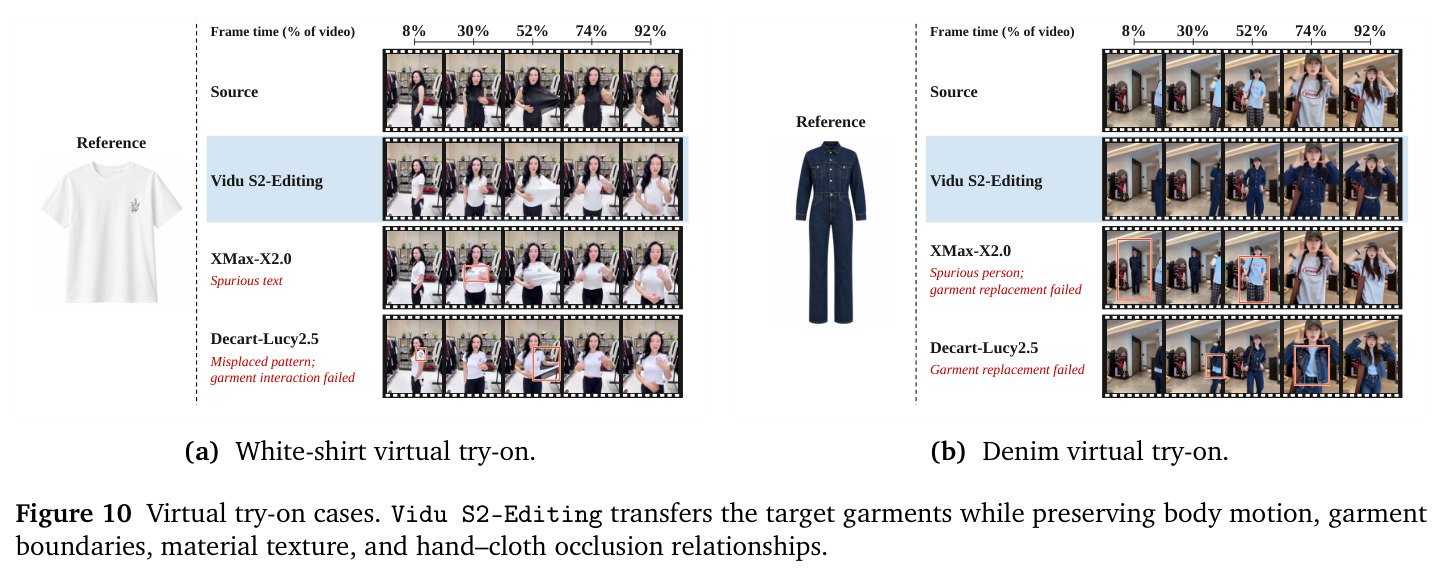
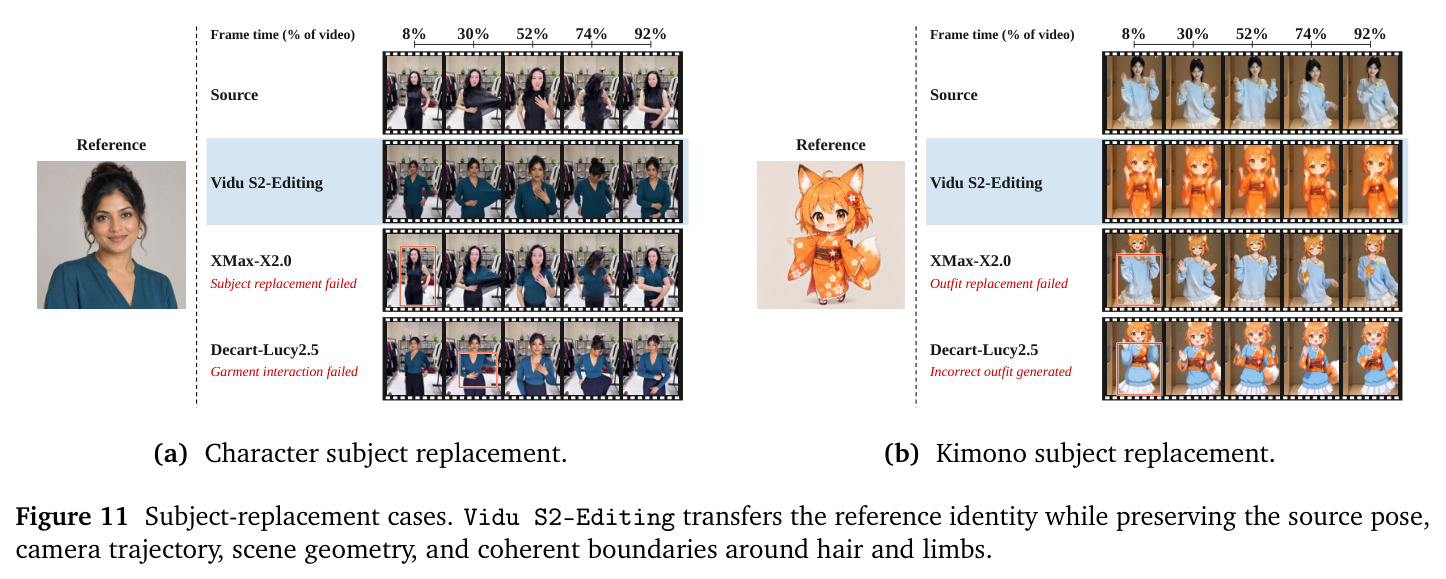
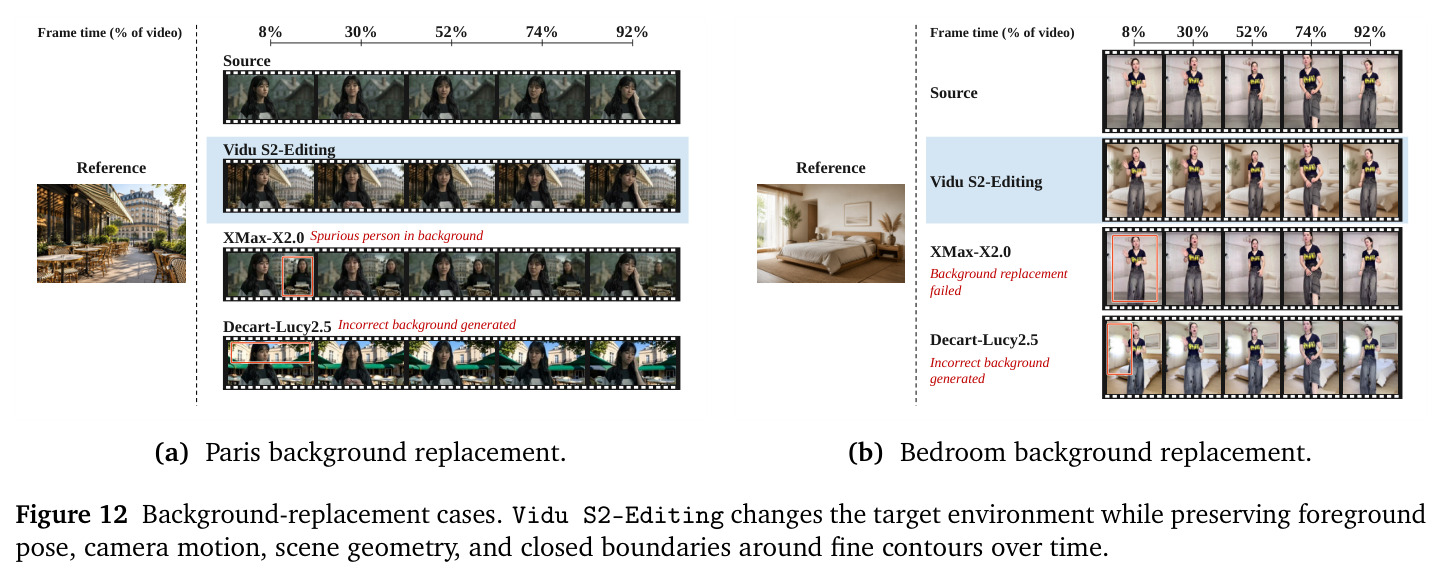
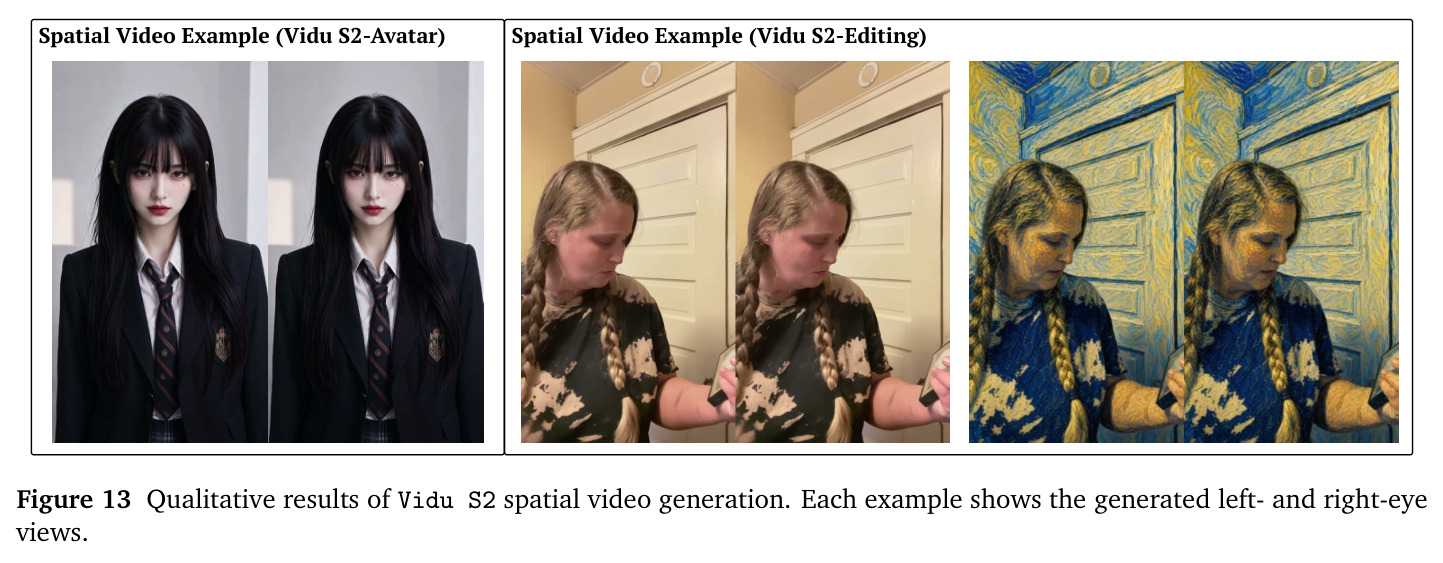
数字人生成方面:在 StreamAV-Bench 公开评测(Table 1)上,Vidu S2-Avatar 在全部 9 项指标上均为第一——视觉美学 VA 0.687、视觉质量 VQ 3.370、音频制作质量 PQ 7.138、音频质量 AQ 3.286、音画语义对齐 AVAlign 0.353、音画时序同步 AVSync 0.617(越低越好,次优 Self-Forcing 为 0.919,误差降低约 33%)、音频指令完成度 AIF 2.985、主体一致性 SC 0.998、背景一致性 BC 0.993;对比最强基线 Live Avatar(VA 0.661、VQ 3.295、SC 0.997)全面占优。时长分层评测(Figure 5,10–90 秒)显示其在整体质量、一致性、视频质量、运动质量、情感表达五个维度全程领先,一致性到 90 秒仍保持高位。GSB 人评(Figure 6):整体质量对 Runway Character GWM-1 偏好率 85.7%、对 PixVerse Image Avatar 与 HeyGen 均为 100%;运动与表情质量对 Runway 和 HeyGen 达到 100% 一致偏好;语义遵循在 71.4%–100% 之间。视频编辑方面:Sparkle-Bench(Table 2)Overall 3.74 六项子指标全部第一(全局指令 4.00、前景运动 4.00、前景指令 3.98、背景动态 3.37、背景视觉 3.76、全局视觉 3.34),最强流式基线 Decart-Lucy2.5 为 3.67;OpenVE+RefVIE 联合评测(Table 3)Joint Overall 4.26,超最强离线基线 Bernini-R 14B(3.92)0.34,其中 OpenVE Global Style 4.71、Background Change 4.14、Overall 4.42,RefVIE Overall 3.78 超 Decart-Lucy2.5(3.71)0.07。ViViD 无配对虚拟试衣(Table 4)VFIDI 仅 9.9515,不到次优 CatV2TON(19.5131)的 52%,与 ViViD(21.8032)、IDM-VTON(25.4972)相比分布距离缩小一半以上。内部 150 对编辑 GSB(Figure 7):整体质量对 Decart-Lucy2.5 偏好 72.7%(对 16.0%)、对 XMax-X2.0 偏好 86.7%(对 4.7%);时序一致性均分 3.56 vs 2.59 vs 1.67。定性案例(Figures 9–12)中两个商业基线在四个编辑任务上均出现身份丢失、多余人物、背景未替换、图案错位等失败,而 Vidu S2-Editing 能保留手部交互与服装遮挡关系。空间视频(Figure 13)左右目视图前景背景分离清晰、景深连贯。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式数字人生成 | StreamAV-Bench 9 项指标(VA/VQ/PQ/AQ/AVAlign/AVSync/AIF/SC/BC) | 全部第一:VA .687,VQ 3.370,PQ 7.138,AQ 3.286,AVAlign .353,AVSync .617,AIF 2.985,SC .998,BC .993 | 最强基线 Live Avatar(VA .661,VQ 3.295,SC .997);次优同步误差 Self-Forcing AVSync .919 | AVSync 时序误差降低约 33%(.919→.617),AVAlign 提升 38%(.256→.353,对比 Self-Forcing) |
| 指令引导视频编辑 | Sparkle-Bench Overall(1–5 分) | 3.74(子指标 Ins 4.00 / FgMo 4.00 / FgIn 3.98 均列第一) | Decart-Lucy2.5(最强流式)3.67;Bernini-R 14B(最强离线)3.50 | 较最强流式基线 +0.07,较最强离线基线 +0.24 |
| 编辑联合评测(OpenVE + RefVIE) | Joint Overall | 4.26(OpenVE GS 4.71,BC 4.14,Ovr 4.42;RefVIE Ovr 3.78) | Bernini-R 14B 3.92;RefVIE 上最强流式基线 Decart-Lucy2.5 3.71 | 联合 Overall +0.34;RefVIE +0.07 |
| 无配对虚拟试衣 | VFIDI(越低越好) | 9.9515 | CatV2TON 19.5131;ViViD 21.8032;IDM-VTON 25.4972 | 较次优降低约 49%,分布距离几乎减半 |
| 数字人商业系统人评(GSB) | 整体质量偏好率 | vs Runway Character GWM-1 85.7%;vs PixVerse Image Avatar 100%;vs HeyGen 100% | Runway Character GWM-1 / PixVerse Image Avatar / HeyGen(闭源商业系统) | 运动与表情质量对 Runway、HeyGen 均达 100% 一致偏好 |
| 流式视频编辑商业系统人评(GSB,150 对) | 整体质量偏好率与时序一致性均分 | vs Decart-Lucy2.5 偏好 72.7%;vs XMax-X2.0 偏好 86.7%;一致性均分 3.56 | Decart-Lucy2.5(一致性 2.59);XMax-X2.0(一致性 1.67) | 整体质量偏好率高出对手 56.7 与 82.0 个百分点 |
局限与改进
作者在 4.3 节明确承认:空间视频在头显中占据用户视场的很大部分,因此需要比常规实时单目生成更高的分辨率;摄像机直通(passthrough)模式下高延迟会使头部运动与显示画面失步,端到端低延迟与高画质兼得仍是关键技术挑战;当前系统生成的是固定视点空间视频,用户还不能转头自由探索场景,全景空间视频是未来方向。我自己的观察还有六点:其一,论文没有提供 SRF 相对 Self-Forcing / Diffusion Forcing 的受控消融实验,SRF、非对称缓存、两级偏好优化各自贡献多少无法剥离;其二,全程未开源代码与权重,所有对比对象是黑盒系统,社区无法独立验证;其三,25~42 FPS @720p 没有给出具体 GPU 型号、显存占用、端到端延迟 P50/P99 与成本数字,可复现的工程事实有限;其四,编辑任务限定四类,指令组合编辑(如同时换装并换背景)与局部精细编辑未见评测;其五,内部基准与 GSB 评测由自家受训评估员按自家协议完成,虽有校准与随机化,但仍存在利益相关风险,且 10 分钟级长视频稳定性只在内部集测试;其六,空间视频转换链路中深度估计抖动与遮挡空洞只以『轻量处理』『时序稳定』一笔带过,没有任何量化指标。
独立分析的弱点
独立分析出五个弱点。第一,组件贡献不可分解:SRF、DPO、Streaming NFT、非对称缓存同时上线,缺少消融表,难以判断哪项创新带来主要收益,例如无法回答『Self-Forcing + 干净历史回放是否已足够』。改进方向:在同一骨干上做 SRF vs Self-Forcing vs Diffusion Forcing 对照,并单独消融跨块梯度流的开/关。第二,空间视频深度链路不透明:逐帧深度→视差 warp 在快速运动、透明物体、头发丝等区域易抖动和出洞,论文只用轻量后处理 mitigation。改进方向:改用时序一致的视频深度基础模型,或更进一步让模型端到端直接生成双目潜变量(立体原生生成),消除后处理误差累积。第三,编辑训练数据依赖生成器质量:风格迁移配对由自训 V2V 模型合成、其余任务靠多个开源编辑模型加对比筛选,教师模型的系统性偏差会被学生继承(如风格化细节的纹理伪影)。改进方向:引入小规模真实配对数据或循环一致性约束做校准。第四,长时序证据不足:公开基准最长 180 秒,10 分钟级稳定性只有内部评测支撑,误差累积行为在更长尺度上未知。改进方向:公开长时序稳定性协议与失败样例分析。第五,交互链路延迟缺失:语音转写→VLM 智能体→prompt 生成→视频生成的端到端响应延迟未报告,交互体验的关键指标恰恰是它。改进方向:给出各环节 P50/P99 延迟分解与瓶颈分析。
未来方向
作者在论文中提出的方向:(1) 从固定视点空间视频扩展到全景空间视频,让用户转头自由探索生成的场景;(2) 以实时视频生成支撑『视觉内容实时生成的元宇宙』——场景、角色、事件随用户交互实时变化,大幅削减传统 3D 建模、材质、动画与场景搭建的需求;(3) 面向头显场景攻克更高分辨率与更低延迟的矛盾。基于本文成果可自然延伸的方向:(4) 把 SRF 的『detach rollout + 重加噪 + 带梯度回放』范式推广到其他自回归扩散任务,如实时音频、3D 资产、可交互世界模型,该思想是任务无关的;(5) 将 Avatar 与 Editing 融合为单一多任务流式模型,共享因果骨干与缓存调度,用户可以在对话中随时切换『生成/编辑』;(6) 把目前离线的偏好优化升级为基于用户实时反馈的在线学习,让模型在部署后持续适应个人偏好;(7) 立体原生生成——直接在训练中输出左右目一致的潜变量,替代深度 warp 后处理,同时解决遮挡空洞与深度抖动;(8) 与头显手势、眼动信号结合,实现视线驱动的内容响应与注视点渲染式算力分配;(9) 公开长时序(小时级)流式生成的稳定性研究,包括记忆机制与跨会话角色持久化。
复现评估
复现难度评估:高,接近不可独立复现。论文未提及开源代码、模型权重或训练数据,可玩的产品 demo 在 vidu.com/vidu-stream 但不提供下载。数据侧依赖大规模私有视频库(Avatar 管线输出再加 80 万条精选片段、四个互不相交的 20 万条子集)以及一整套专家模型与工具链(NormalCrafter 法线估计、Bernini/SCAIL-2/Wan2.1 VACE/SAMA-14B/CoinVE-Edit 等多个编辑模型、检测与语音识别专家模型、多智能体字幕系统、VLM 审核智能体),个人或小团队几乎无法凑齐同规模数据。训练侧是四阶段接力:双向预训练→因果化(混合 forcing)→SRF 蒸馏(DMD + 感知损失)→两级偏好优化,还需同步实现 Refiner 与非对称缓存。推理侧工程门槛极高:自定义逐块 W8A8 GEMM CUDA 核、Triton 融合核(RMSNorm + 逐元素算子)、CUDA Graphs 捕获重放、量化通信的 Ulysses 上下文并行、VAE/骨干/Refiner/解码器共享时间线调度。学术界可低成本复现的部分:SRF 算法本身公式描述完整,可在中小模型上验证『回放 + 跨块梯度』思想;帧对齐注意力结构简单可直接实现;评测可在 StreamAV-Bench、OpenVE、Sparkle-Bench、RefVIE、ViViD 等公开基准上与论文已报告数字对比。完整复现估计需要数十张高端 GPU、数月工程投入与大量数据基础设施。
论文图表
ViViD 无配对虚拟试衣评测,指标 VFIDI(越低越好)。Vidu S2-Editing 9.9515,大幅领先 CatV2TON 19.5131、ViViD 21.8032、IDM-VTON+AM 22.5881、StableVITO 36.8985 等全部 8 个方法,差距接近一半。
全文幅度最大的单项领先:VFIDI 几乎减半说明生成视频分布与参考分布的距离显著缩小,直接支撑虚拟试衣这一最难关卡的 SOTA 主张。