推理历史压缩的因果效应:重写旧推理以缩短未来生成并降低智能体成本 Why Pay for Long Reasoning When Rewrite Do Trick? Causal Effects of Reasoning History Compaction on Future Generation and Agent Cost
无需重训,把模型自身的历史推理改写成紧凑记录,即可显著缩短后续推理并降低智能体成本
前置知识
思维链推理与推理token
推理模型在给出最终答案前先生成中间分析文本(scratchpad,草稿簿)。这些被供应商标记为reasoning的token显著提升难题求解能力,但按输出token计费,是推理成本的主体。在智能体场景中它们还会作为输入历史被反复处理,造成双重付费。
本文的干预对象(历史推理块)与因变量(后续推理token数)都是推理轨迹,不理解其生成与计费机制就无法理解实验测的是什么。
上下文压缩(compaction)
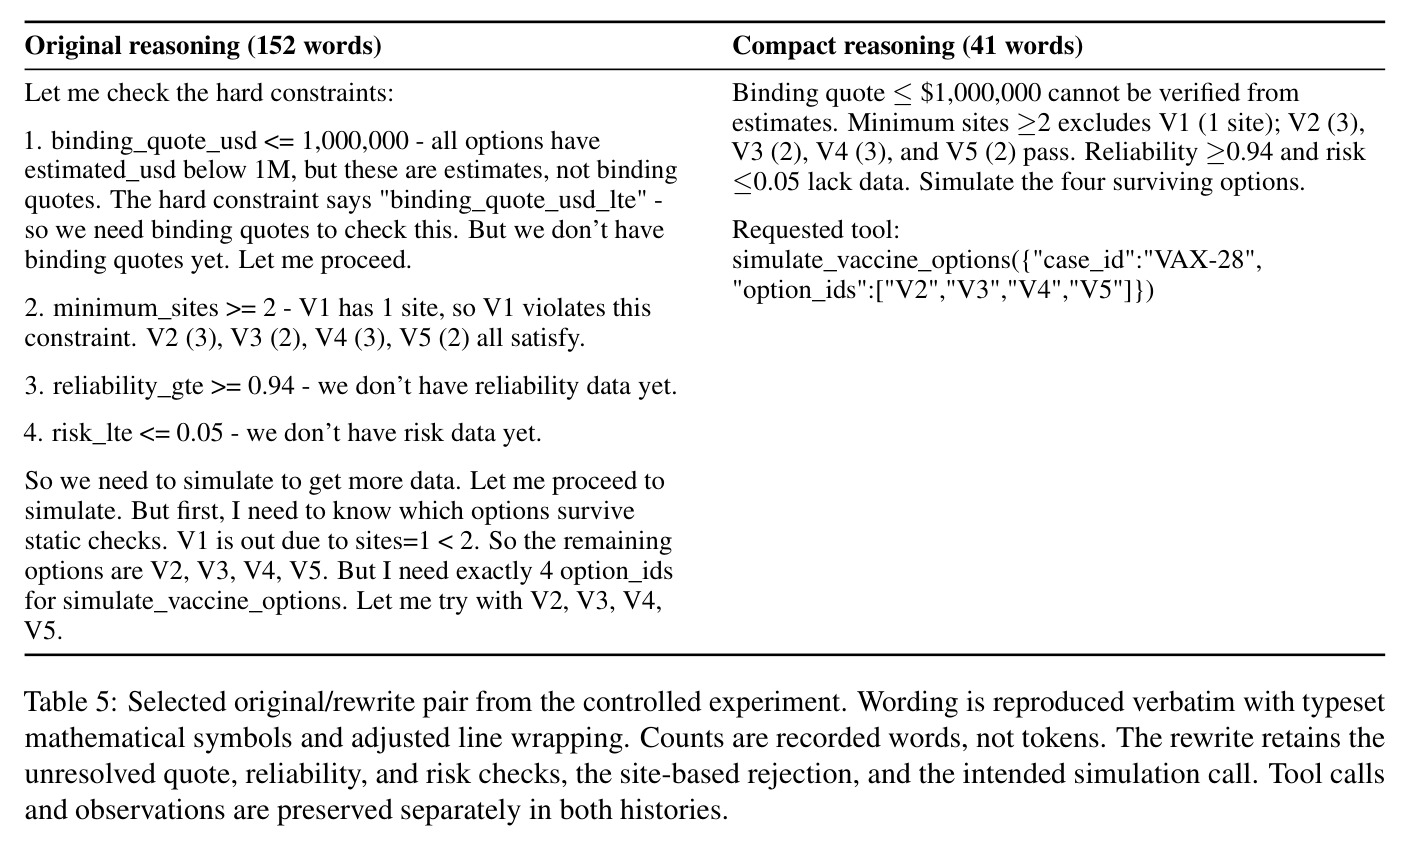
把对话历史中冗长的部分改写为保留决策所需信息的简短状态记录。本文的压缩器只读该推理块原文和请求的动作名,要求保留事实、数字、不确定性、结论与下一步动作,删除重复、修辞与重复算术,且禁止预测尚未执行的工具结果。
压缩规则直接定义了处理变量的含义:读者需知道改写保留什么、删什么,才能判断后续效应来自信息还是形式。
结果盲配对分叉实验设计
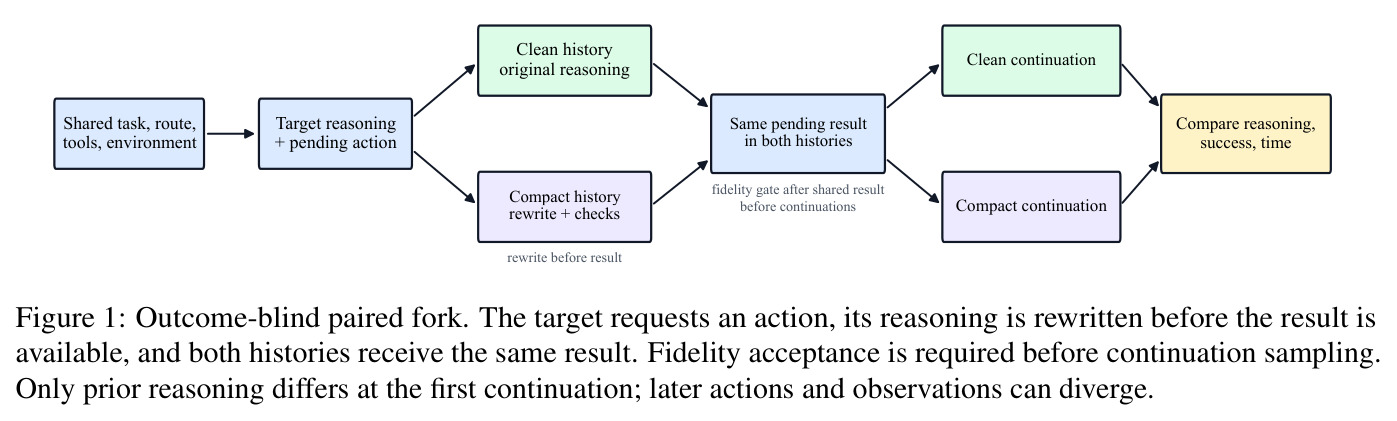
在动作已请求、工具结果尚未执行或揭晓的时点冻结历史并完成改写,使clean与compact两条历史只在助手推理文本上不同;随后同一路由各自续写并接收完全相同的结果。首轮逐字段校验请求,保证首轮对比是纯历史形式效应。
这是全文因果结论的识别基础:改写者偷看不到未来,目标模型也没被要求简洁,后续差异才能归因于历史形态而非混淆因素。
源级自助法置信区间
bootstrap重采样以模型–任务源历史为单元,同一源的3次续写复本绑在一起抽样(本文抽10,000次),取2.5/97.5分位作95%区间。这样避免把同源重复观测当独立样本导致的区间过窄。
论文几乎所有区间都由此而来;不理解重采样单元,会误读各表置信区间的覆盖含义与显著性。
SWE-bench Verified
基于真实GitHub issue的代码修复基准,Verified子集经人工核验。本文取固定50题Mini样本(25个Django加25个Sphinx),用SWE-agent 2.4.5框架、250步上限与官方4.1.0评测器,比较解决数、花费、工具调用与耗时。
部署实验的质量与经济学结论全部建立在该基准的固定样本上,是判断实用价值的关键场景。
KV缓存与token计费摊销
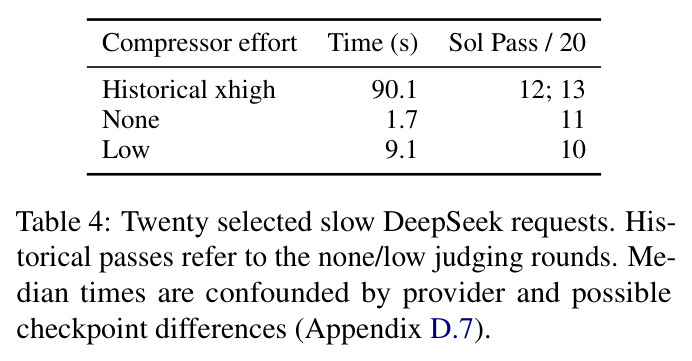
API按输入/输出token计费,缓存命中部分按更低费率;历史越长每轮输入越贵。压缩历史减少输入与后续生成长度,但每次压缩本身是一次额外的模型调用,有自己的费用和延迟,需要多次使用才能摊销回本。
论文的盈亏平衡分析(重写成本需多少次续写才能收回)完全建立在这些计费与延迟机制之上。
研究动机
推理是当前大模型能力的主要来源,也是最昂贵的部分。作者引用Artificial Analysis于2026年8月3日的数据:推理token占GLM 5.2全部生成token的84.9%、Claude Fable 5的75.1%;对DeepSeek V4 Pro,仅推理输出就占总API成本的53.4%。在软件智能体场景中问题被进一步放大:模型不仅每一轮都生成长篇草稿推理,还要把此前所有草稿作为输入历史重复付费处理,成本随任务轮次叠加。理论上最高效的做法是把有用分析表达在更少token里,OpenAI报告GPT-5.5相对GPT-5.4用更少token取得更好编码表现,也泄露过紧凑风格的推理笔记,但闭源模型不暴露原始草稿,无法做受控研究。现有认识多停留在相关性层面:简洁示例或上下文会缩短推理(有时掉点),但「改写模型自己写下的历史推理」是否因果地改变它后续的推理长度与质量,此前缺乏干净的测量。
本文的目标是本文要回答一个可因果检验的问题:在不重新训练、不给目标模型任何「请简洁」指令的前提下,仅把模型自己较早的推理草稿改写成紧凑状态记录,能否让它在后续步骤生成更少的推理token?这种干预是否损害任务成功率?把压缩器自身的费用与延迟计入后,在真实软件智能体部署中总体上是否仍省钱、省时?作者明确不追求普适最优压缩率,而是想给出「压缩策略必须逐模型评估效率与保留能力」的可操作结论,并公开协议、提示词与冻结数据支持复现。
与已有工作不同的是,相邻工作有三条线。一是示证与上下文效应:Chain of Draft、Reasoning Shift等表明简洁示例或追加上下文能缩短推理与验证,有时以质量为代价;二是智能体上下文管理:context-folding、self-compacting agents等折叠或摘要整段对话;三是推理状态引导:SEAL、激活转向需要训练或干预模型内部激活。本文的独特切入是把处理对象严格限定为「目标模型自己刚写下的推理块」——系统提示、用户消息、工具调用、参数、观测全部原封不动;改写发生在待决动作已发出、工具结果尚未揭晓之前,这一结果盲定时消除了「压缩器偷看未来」的混淆;目标模型完全不知道自己被要求简洁,排除了指令效应;再配上把重写费用与串行延迟摊销计入的部署经济学分析,这在效率推理文献中是少见的完整链条。
核心方法
直觉:历史推理在上下文里相当于「如何推理」的示证,把它改写成电报式紧凑状态记录后,后续生成会模仿这种简洁风格,从而省掉重复分析与低价值文字——目标没有被要求简洁,变短完全来自上下文形态的示范。技术路线分两条线。第一条是受控配对续写:先让目标模型在12个确定性多阶段工具任务(救援规划、疫苗模拟、制造召回等)上跑出源历史,每任务3个共享采集轮次;在每轮动作已请求、结果未揭晓的时刻,压缩器把该轮推理改写为保留决策相关事实、数字、不确定性、结论与意图动作的状态记录;经动作检查与规则化忠实度评审通过后冻结历史,得到只在助手推理上不同的clean与compact两版,同一路由各自续写3个复本,首轮请求逐字段校验后比较后续推理token与精确成功率。第二条线是连续压缩部署:在固定50个SWE-bench Verified Mini任务上,每次目标请求前把新的推理块压缩并缓存,对比得分、花费、工具调用与耗时,并额外做LiveCodeBench验证行为案例研究与延迟摊销分析。
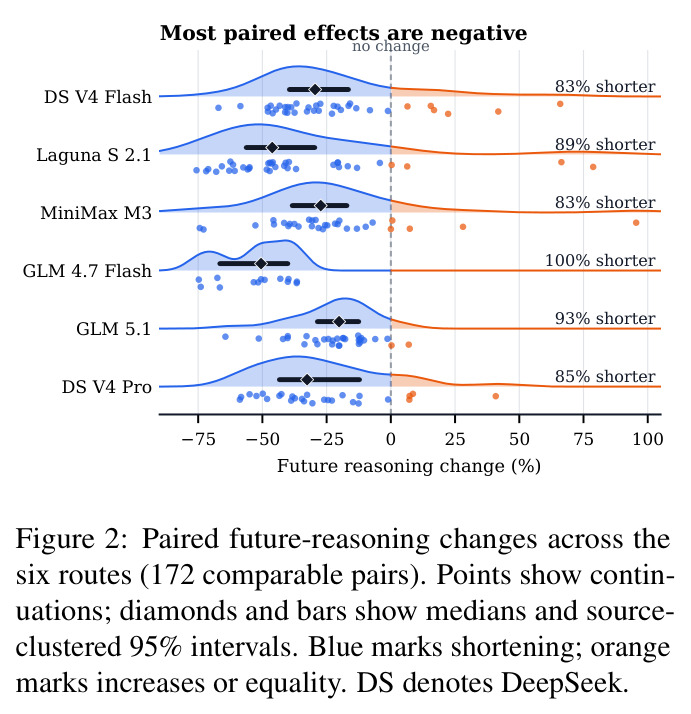
核心创新是结果盲配对分叉(outcome-blind paired fork):改写完成于动作请求之后、结果执行或揭晓之前,两条历史随后接收完全相同的结果。因此首轮对比是干净的历史形式因果效应,不会被「改写者看到了未来结果」污染;后续轮次的对比则允许包含处理诱导的轨迹分化(中介效应)。与既往工作的本质区别有三:其一,只改写目标自己的推理,其余消息全部保留,排除上下文长度或示证变化的混淆;其二,不给目标任何简洁指令,效应完全来自上下文示证而非提示;其三,工程上只允许缩短——非更短的改写回退为原文、不超过12词的恒等块原样保留,保证干预方向单调。估计量被明确条件化:只统计通过动作检查与忠实度门控的处理历史,后续推理变化用 $100(R_K/R_C - 1)$ 度量($R_C$、$R_K$ 分别为clean/compact的后续推理token数),负值表示减少。
方法步骤详情
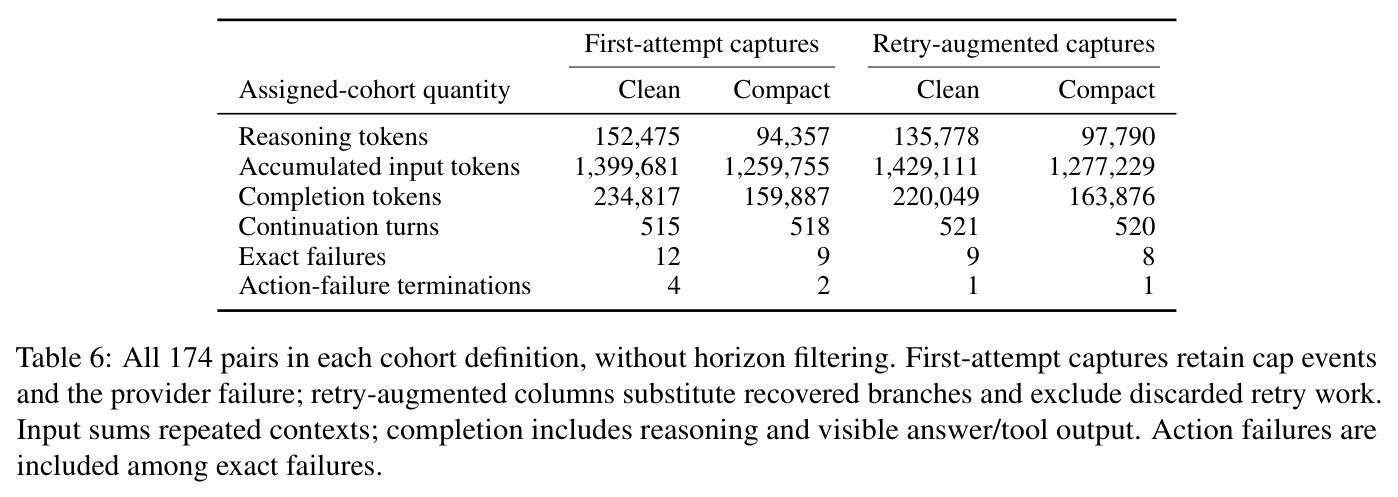
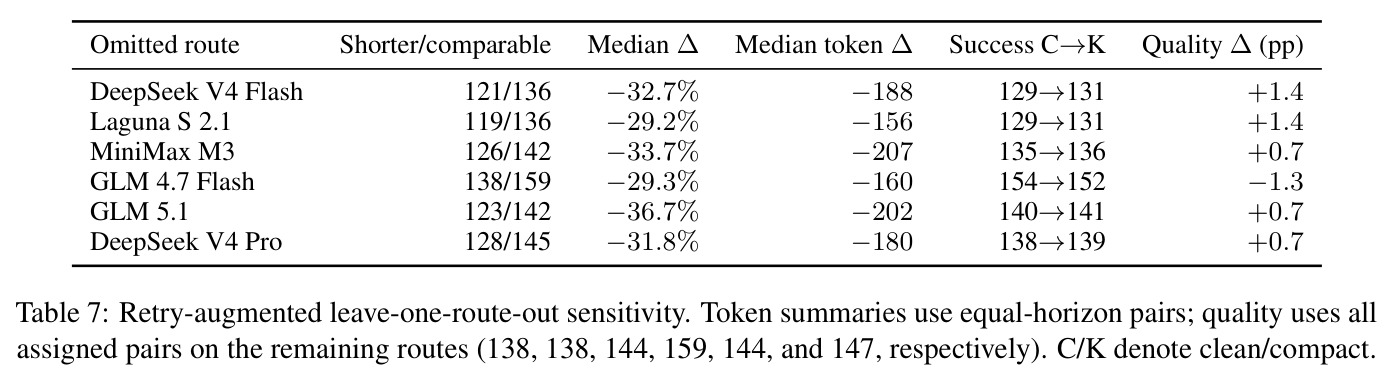
完整流程五步。第一步源历史采集:6条模型/供应商路由(DeepSeek V4 Flash、Laguna S 2.1、MiniMax M3、GLM 4.7 Flash、GLM 5.1、DeepSeek V4 Pro)各跑12个确定性多阶段任务,8192 token完成上限。第二步改写与门控:外部实验用GPT 5.6 Sol分两次调用——先生成改写(目标不超过原词数一半、不得增加事实),再按规则评审(保留全部决策相关事实、无未来结果泄露、动作保留);5个源未通过动作检查、9个未通过忠实度检查,72个源历史保留58个。第三步冻结与配对续写:两臂仅助手推理不同,各续写3个复本,得174个质量对、172个等轮次token对,区间用10,000次源级bootstrap。第四步部署:SWE-bench Verified Mini 50题、SWE-agent 2.4.5、250步上限;每个唯一推理块按原文加动作名缓存压缩一次,≤12词块不动、非更短回退;花费含重写费。第五步对照与稳健性:同义改写对照、完整句风格对照、四档风格扫描、双评审忠实度盲审、逐路由剔除与重试敏感性分析。
技术新颖性
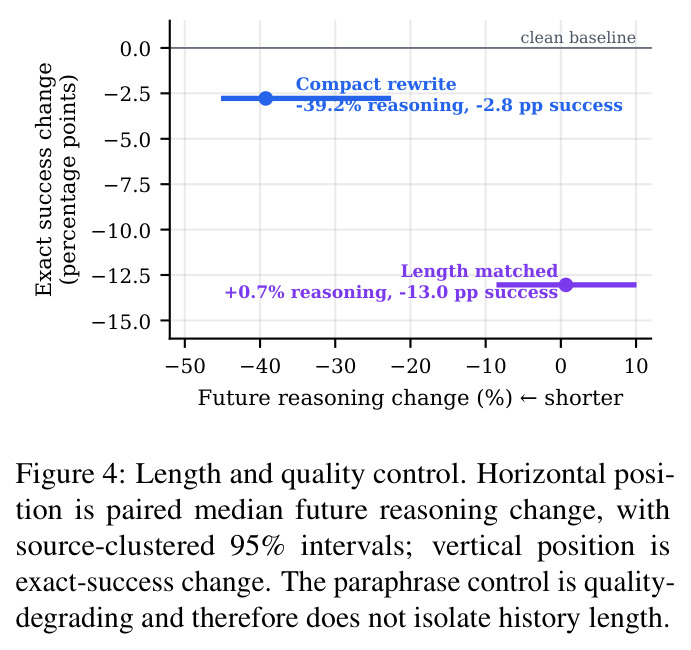
新颖性有四点。第一,把「历史推理的书写形式」本身当作处理变量,用结果盲定时保证因果识别,比上下文长度与推理长度的相关性研究干净得多。第二,发现改写与指令可分离:目标未被要求简洁仍持续变短(首轮配对中位−20.0%),说明上下文示证足以改变推理风格;而长度匹配(90–110%词数)的同义改写几乎不缩短后续推理(中位+0.7%)却使成功率从68/69跌到59/69,暗示起作用的是「压缩加重构」而非表面被改写。第三,经济学上首次把压缩器token费与串行延迟计入,给出回本条件:时间上需 $n(T_C - T_K) > T_R$、费用上需 $n(C_C - C_K) > C_R$($T_R$、$C_R$ 为一次性重写开销,$T_C/T_K$、$C_C/C_K$ 为两种历史的单次续写耗时/费用),并实测单次使用必亏。第四,结论按模型异质化:6/8配置省钱,但Nemotron反而更贵、Kimi外部压缩使工具调用增加19.8%,明确反对「更短即更好」的单一叙事。
实验结果
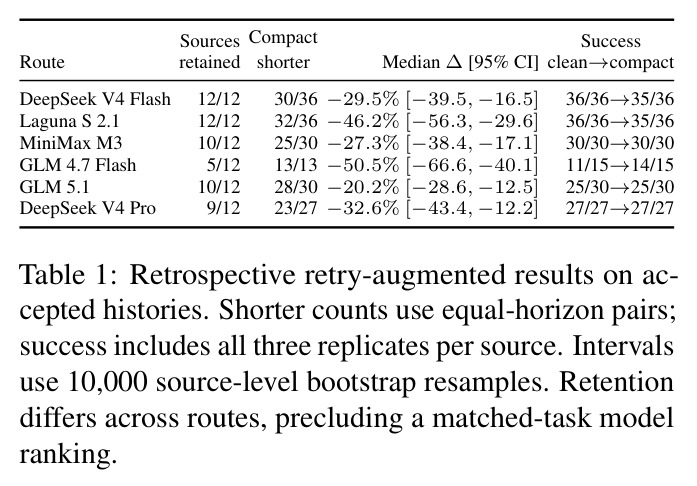
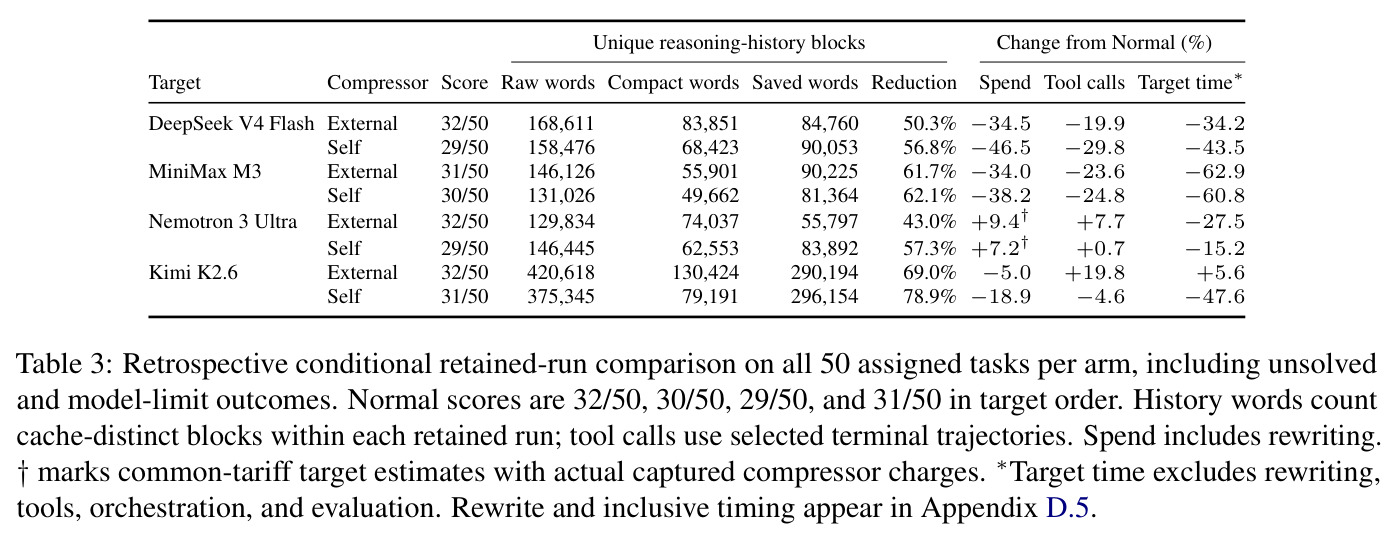
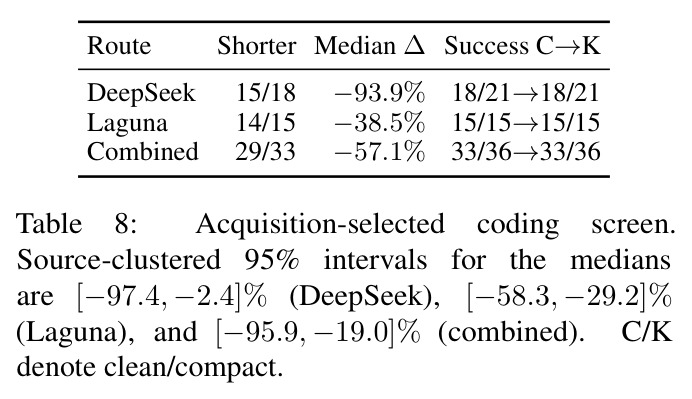
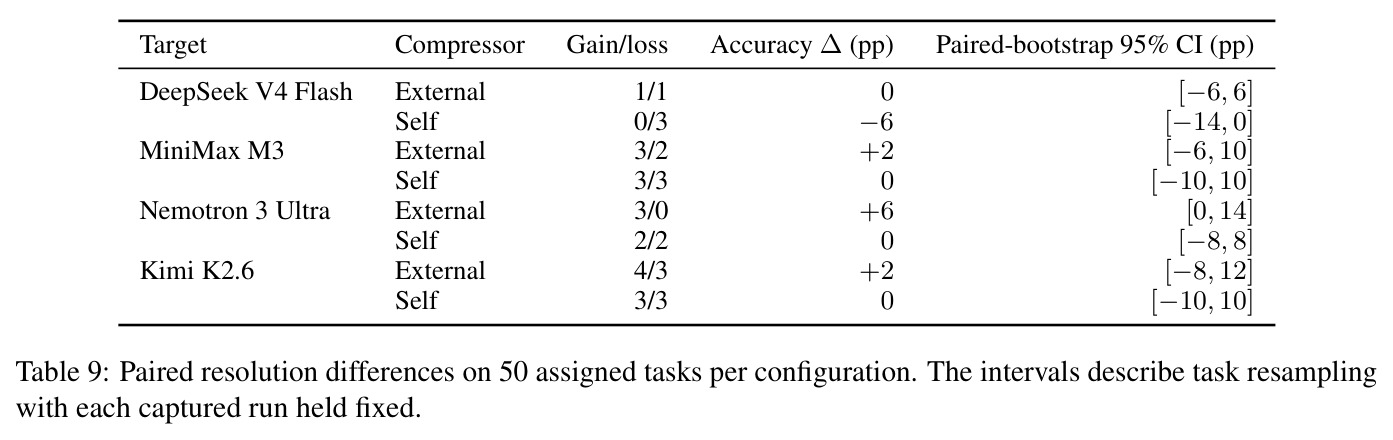
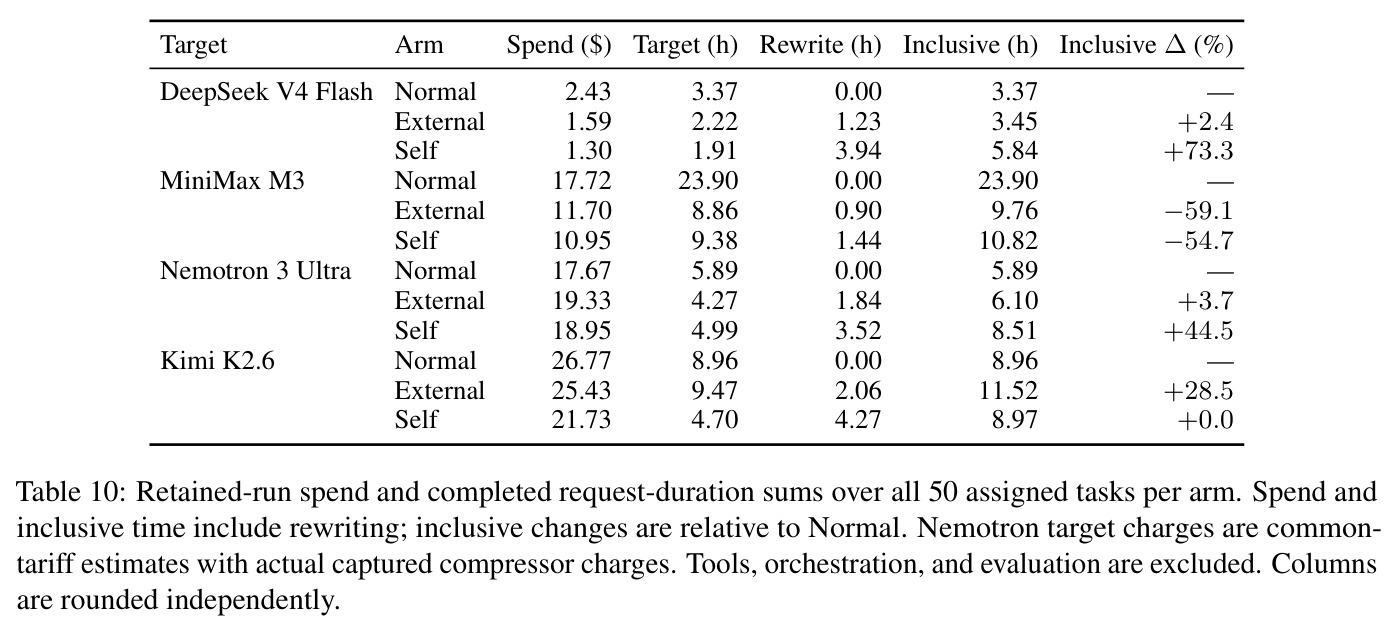
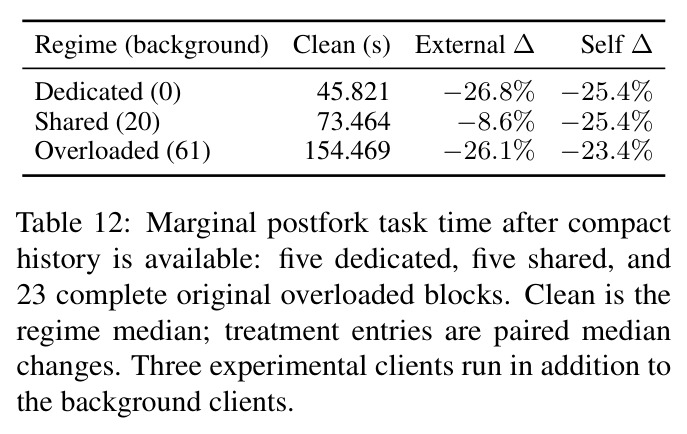
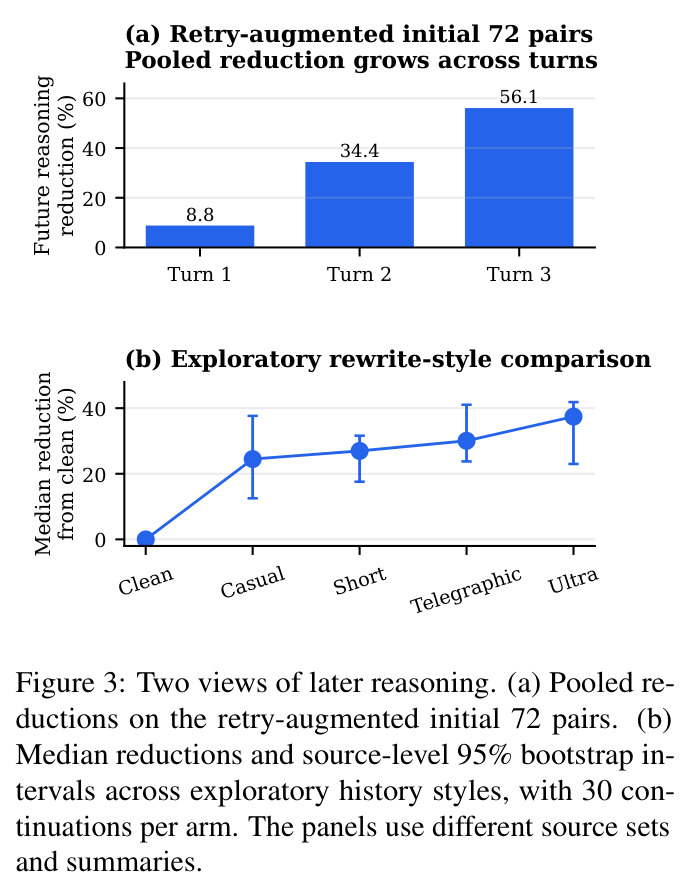
受控实验:151/172(87.8%)个等轮次对在压缩历史下后续推理更短,路由中位降幅−20.2%到−50.5%;总体配对中位−32.0%(95% CI [−38.8, −24.3]),中位绝对减少178 token;成功率165/174变为166/174。首轮推理中位−20.0%、后续轮−37.8%、全轨迹池化−38.1%;池化削减逐轮从8.8%增至56.1%。风格扫描显示越紧凑削减越大(超电报体−37.4%),各档成功率均100%。部署实验:6/8配置总花费更低,八臂共删除64.0%历史词;DeepSeek V4 Flash外部压缩省34.5%花费且32/50持平;MiniMax M3自压缩省38.2%花费、含重写时间省54.7%;但Nemotron两臂花费反增7.2–9.4%,Kimi外部压缩工具调用+19.8%。LiveCodeBench筛查:29/33缩短、中位−57.1%,两臂均解33/36,但提交前扩展验证(≥350推理token)从61.1%降到0%。延迟:托管单次续写省25.9%时间,串行加一次重写反增27.0%,费用回本中位需82.4次续写;自托管自压缩续写时间中位−25.4%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 受控配对续写(6路由×12确定性多阶段任务) | 后续推理token配对中位变化 | −32.0%(源聚类95% CI [−38.8, −24.3]),151/172对缩短(87.8%) | 原始clean历史(同一路由同设置续写) | 中位绝对减少178 token;精确成功率165/174→166/174基本持平 |
| SWE-bench Verified Mini 50题·DeepSeek V4 Flash(外部压缩) | 总花费(含重写)与解决数 | 花费−34.5%($1.59),得分32/50,目标耗时−34.2% | Normal:$2.43、32/50 | 成本降约三分之一而质量持平 |
| SWE-bench Verified Mini 50题·MiniMax M3(自压缩) | 花费与含重写的请求时间 | 花费−38.2%($10.95),含重写时间−54.7%,得分30/50 | Normal:$17.72、23.90小时、30/50 | 全包时间近乎减半且质量持平 |
| SWE-bench Verified Mini 50题·Kimi K2.6(自压缩) | 花费与历史词量 | 花费−18.9%($21.73),历史词−78.9%(375,345→79,191),得分31/50 | Normal:$26.77、31/50 | 极高压缩率下省钱且质量持平;对比之下外部压缩臂工具调用+19.8% |
| SWE-bench Verified Mini 50题·Nemotron 3 Ultra(外部/自压缩) | 总花费(统一费率重估) | 外部+9.4%、自压缩+7.2%(得分32/50、29/50 vs Normal 29/50) | Normal:$17.67、29/50 | 反例:重写开销超过推理节省,说明策略需逐模型评估 |
| LiveCodeBench v6编码筛查(DeepSeek+Laguna,33个可比较对) | 后续推理中位变化与解决数 | 中位−57.1%(29/33缩短),两臂均解33/36 | clean历史 | 推理砍半以上通过率不变;但成功分支扩展验证61.1%→0%,末轮推理489→12 token |
| 长度匹配同义改写对照(词数90–110%) | 后续推理中位变化与成功率 | +0.7%(CI [−8.2, +9.7]),成功率68/69→59/69 | 原始clean历史 | 阴性对照:单纯同义改写不缩短后续推理且大幅掉点,排除「改写即有效」的解释 |
局限与改进
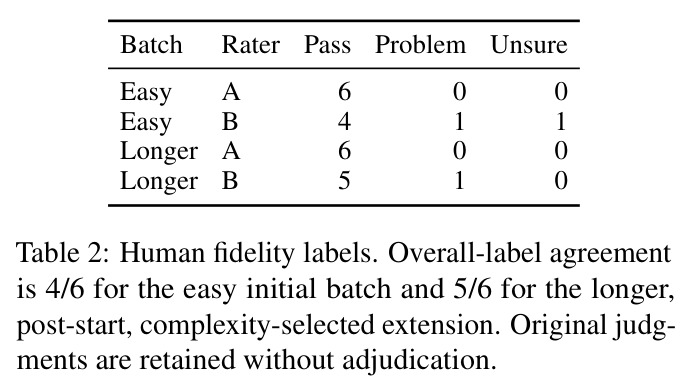
作者承认的局限:受控任务结构单一狭窄;源接受率不对称(GLM 4.7 Flash仅保留5/12),估计量条件于被接受历史,不能外推到被拒来源或新路由;同一模型GPT 5.6 Sol既写改写又做评审,可能共享盲点;人评仅6+6对、评审者是无ML背景的作者家属、延长批次在收数中途加入;等轮次筛选限制全轨迹推断;缺乏删除、截断或抽取式保留等更便宜的基线,无法回答「比免费方案好多少」;部署是单一非随机50题样本、无重复种子、供应商中途切换,因果解释受限;质量非劣性未正式确立。我的补充观察:隐藏推理与排队延迟不可见,供应商计费口径差异会影响花费结论;SWE-bench解决率与精确字符串匹配这类结果指标对「丢失的不确定性与验证习惯」等隐性能力损失不敏感;实验深度依赖2026年的特定专有路由与费率,时效性差;Kimi自压缩删掉78.9%历史词却从未直接测量信息保留,只靠下游成功率间接推断。
独立分析的弱点
四个独立弱点及改进方向。其一,条件估计量的选择偏差:缩短最猛的路由恰是保留率最低的(GLM 4.7 Flash仅5/12保留、13/13全缩短、唯一净涨成功率),「接受后才测量」会系统性高估总体缩短幅度;改进方向是同时报告意向处理估计量、按接受概率加权,或对被拒源做低成本续写补全。其二,重写经济学未优化:部署在每次目标请求前压缩所有新块,而单次使用注定亏钱(费用回本中位需82.4次续写,最长一例需82,725次);改进方向是学习「何时重写」策略——每N轮压缩一次、只压超过阈值词数的块,或用本地小模型当压缩器以消除API费用与隐私风险。其三,验证行为被无声移除:LiveCodeBench中扩展验证从61.1%归零,通过公开测试不能证明进一步验证冗余,遇到隐蔽bug时压缩臂可能更脆;改进方向是构造需要二阶段调试的任务子集,并直接测量不确定性保留。其四,缺基线且机制不明:没有截断、删除或抽取式摘要对照,风格扫描中长度、句法、措辞、压缩器来源同时变动无法归因;改进方向是内容匹配的文体变体加信息保留度量,解耦「家族熟悉度」与「信息损失」两种解释。
未来方向
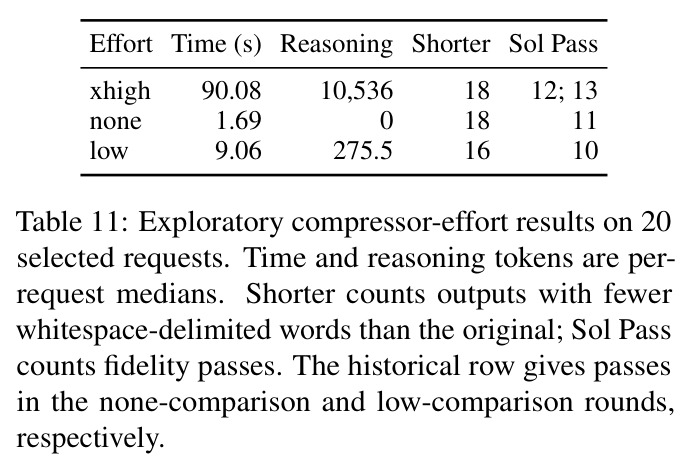
作者提出的方向:更低频次的重写(每N个智能体轮次);给压缩器更多对话上下文以更好保留信息;目标自行压缩时利用共享前缀复用缓存;在固定checkpoint与供应商上比较压缩器努力档位的更大规模匹配部署;跨同族/异族模型与压缩器的组合测试(匹配改写长度、独立评估状态保留、受控推理设置);用内容匹配的文体变体区分熟悉度与信息损失;用已知教师来源或受控混合的训练数据检验「训练数据多样性假说」;以及通过轻量训练鼓励紧凑推理风格。基于本文成果还可延伸:把压缩触发变成基于块价值与不确定性的策略学习问题;将结果盲fork协议推广为一切推理效率干预的标准评估器;研究压缩历史在数十至数百轮长程智能体中的累积影响与缓存友好的增量压缩设计;以及直接对「后续更短且成功不变」建模的RL目标,让模型内化压缩示证而非依赖外部改写。
复现评估
复现友好度中等偏上。代码与全部冻结实验记录公开于github.com/DebelToni/ShortReasoning;附录给出完整改写指令、评审系统提示、重试协议(每轮至多20次尝试、语义评审失败不得换源)与计费口径,任务与评估确定性强(精确字符串匹配、官方SWE-bench 4.1.0评测器、固定数据版本b316c34)。主要门槛不是算力而是API依赖:受控实验需要6条商业路由加GPT 5.6 Sol作压缩器/评审,部署需要4个目标模型加GPT 5.6 Luna;但花费很小——部署每臂约$2.43–$26.77,受控实验全部续写仅$0.096、单次改写$0.339,几百美元内可复现核心结论;自托管延迟实验需单张B300与vLLM 0.25.0,可降档到更小显卡。人评忠实度审计需两名评审;托管路由在相同种子下仍可能非确定,是抽样差异来源。总体难度中等,工程整理成本高于算力成本。
论文图表