你并不需要长上下文 You don't need long context
频繁压缩上下文即可让前沿模型在长程与长输入任务上保持精度,成本最高省233倍
前置知识
KV 缓存与解码的深度成本
Transformer 自回归解码时,生成第 $t$ 个 token 需让其与上下文全部 $t$ 个历史 token 计算注意力,算力随深度线性增长;同时每层每个注意力头都要缓存历史 token 的 K/V 向量,显存占用随长度线性上升。这导致上下文越长,逐 token 延迟越高、吞吐越低、云上费用越贵。
这是论文的立论基础:长上下文在云端与本地都意味着可量化的持续成本,对应图1、图2、图4的系统测量。
上下文窗口
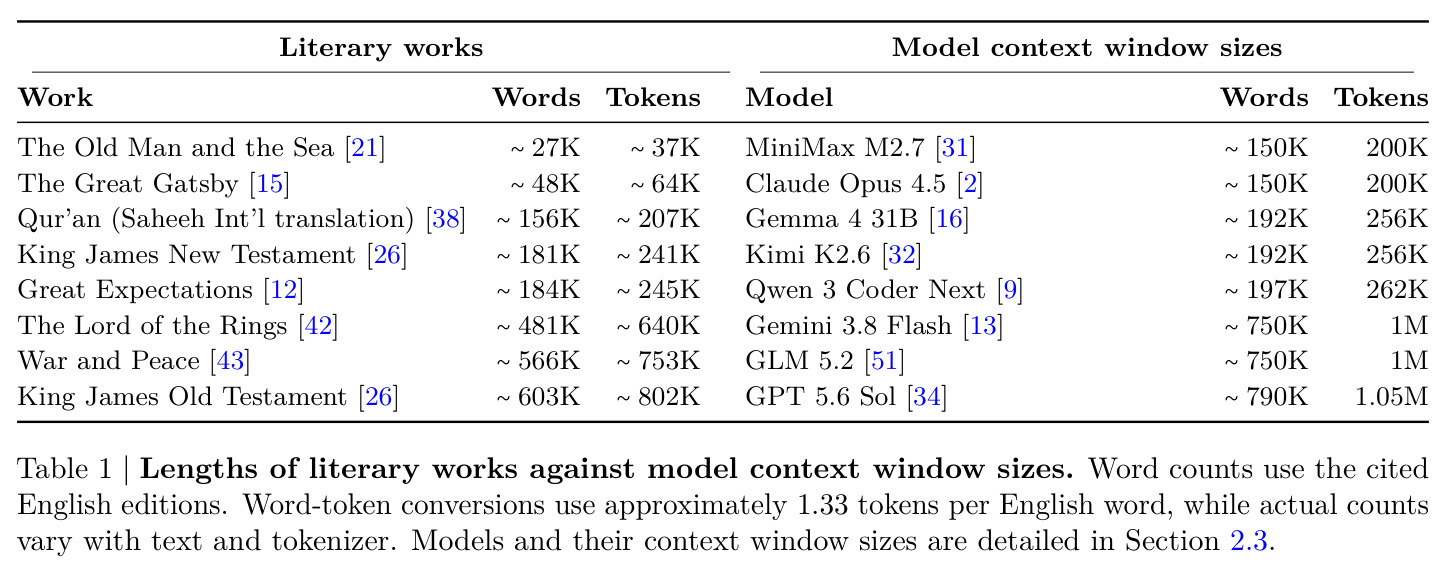
模型单次调用能理解的最大 token 数,由架构(位置编码、注意力机制)或后训练数据的长度分布决定,也可被服务端配置进一步收窄。2026 年前沿模型普遍在 200K 至 1M token 量级,而多数经典文学作品只有数万到数十万 token。
论文对长/短上下文的定义(短约 16K-50K,长则逼近 256K 以上)都以当代窗口大小为参照系。
ReAct 智能体循环
智能体工作流的基本形态:任务作为初始用户消息注入,模型每轮思考并发出一个工具调用(本文统一为 Bash 命令),环境把 stdout、返回码和错误作为观察回填对话,循环往复直到提交答案。若不加管理,对话历史随动作数持续膨胀,正是长上下文的主要来源之一。
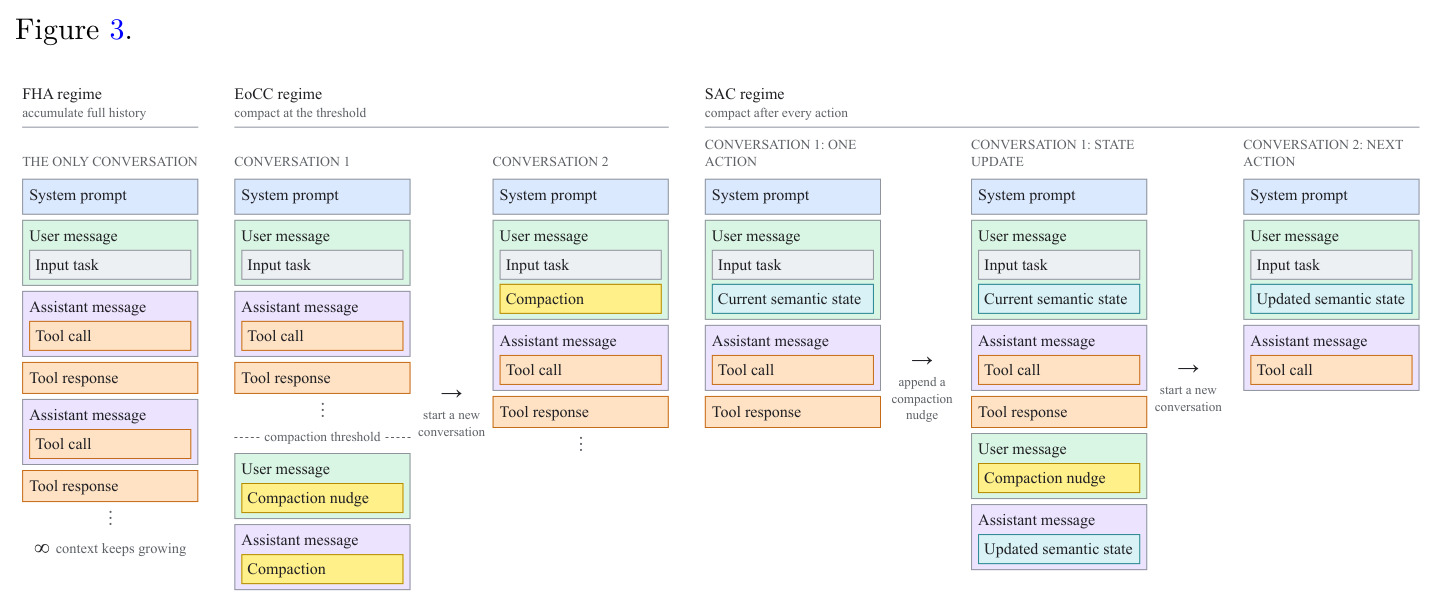
论文的三种上下文管理机制 FHA、EoCC、SAC 全部定义在这个循环之上,是读懂实验设置的前提。
上下文压缩
当对话长度逼近阈值时,让模型把全部历史浓缩为一份有界的、任务相关的状态摘要,随后以原任务加摘要重启新会话继续执行。它是有损压缩:被丢弃的细节无法恢复,摘要质量直接决定后续步骤是否会静默出错。
EoCC 与 SAC 两种机制的核心操作,也是论文短上下文结论得以成立的机制载体。
状态空间模型(SSM)
一类以固定大小隐状态递归处理序列的架构,生成每个 token 的成本与序列长度无关,区别于注意力 $O(t)$ 的深度代价。经典 SSM 的状态是黑盒神经向量;本文提出的 SSSM 则把状态替换为可解释的自然语言语义状态,在对话轮次之间显式传递。
这是论文结论部分的概念升华:SAC 实验证明语言化状态足以承接长程任务,从而引出 SSSM 的提议。
研究动机
生成一个 token 的代价并不均等:解码时新 token 必须与上下文中全部历史 token 做注意力,计算量随其在上下文中的深度 $t$ 线性增长,KV 缓存显存也随长度线性增加。在按需 H100 价格下,把服务窗口从 16K 开到 256K,GLM 5.2 每生成 1M 输出 token 的成本变为 3.6 倍,Kimi K2.6 为 5.6 倍,Qwen 3 Coder Next 高达 7 倍,这一收益可与激进量化相当,却常被“每百万 token 固定单价”的零售定价掩盖;本地 DGX Spark 上多款编码模型的逐 token 延迟在长上下文下约翻倍。与此同时,模型上下文窗口已膨胀到 200K 至 1.05M token(GPT 5.6 Sol 约 790K 词),远超《战争与和平》全文的约 753K token——模型在为罕见的大输入支付常态化的高成本。
本文的目标是论文要回答根本问题 RQ0:长上下文到底是否必要?它把长上下文的两大来源拆成三个可实证的研究问题——RQ1:长程任务(需要许多顺序动作、历史不断累积)能否不用长上下文完成?RQ2:长输入任务(输入本身可填满甚至超过窗口)能否不用长上下文完成?RQ3:能否苛刻到每个上下文只执行一个动作仍完成长程任务?若三者答案皆为是,就无需再为长上下文模型付费:通过适当的后训练调整即可砍掉窗口需求,云端每 token 成本与本地生成延迟都能大幅下降,这正是本文想推动的行业转向。
与已有工作不同的是,现有工作几乎都接受“需要长上下文”这一前提,致力于把长上下文做得更便宜:线性注意力、稀疏注意力、滑动窗口、KV 缓存压缩等架构级改进被反复提出却从未成为主流。本文反其道而行:不改进任何长上下文机制,而是直接质疑其必要性。切入角度是用最朴素、零训练的手段——会话末压缩与基于文件的选择性读取——在两个不同厂商的前沿闭源模型(Claude Opus 4.5 与 GPT 5.6 Sol)上、跨 13 个真实基准做系统对照实验。这呼应了可计算性理论“任何可计算之物只需有界输入与有限状态”的直觉,并把“必须驻留在上下文里的信息”与“可以按需检索的信息”区分开来。
核心方法
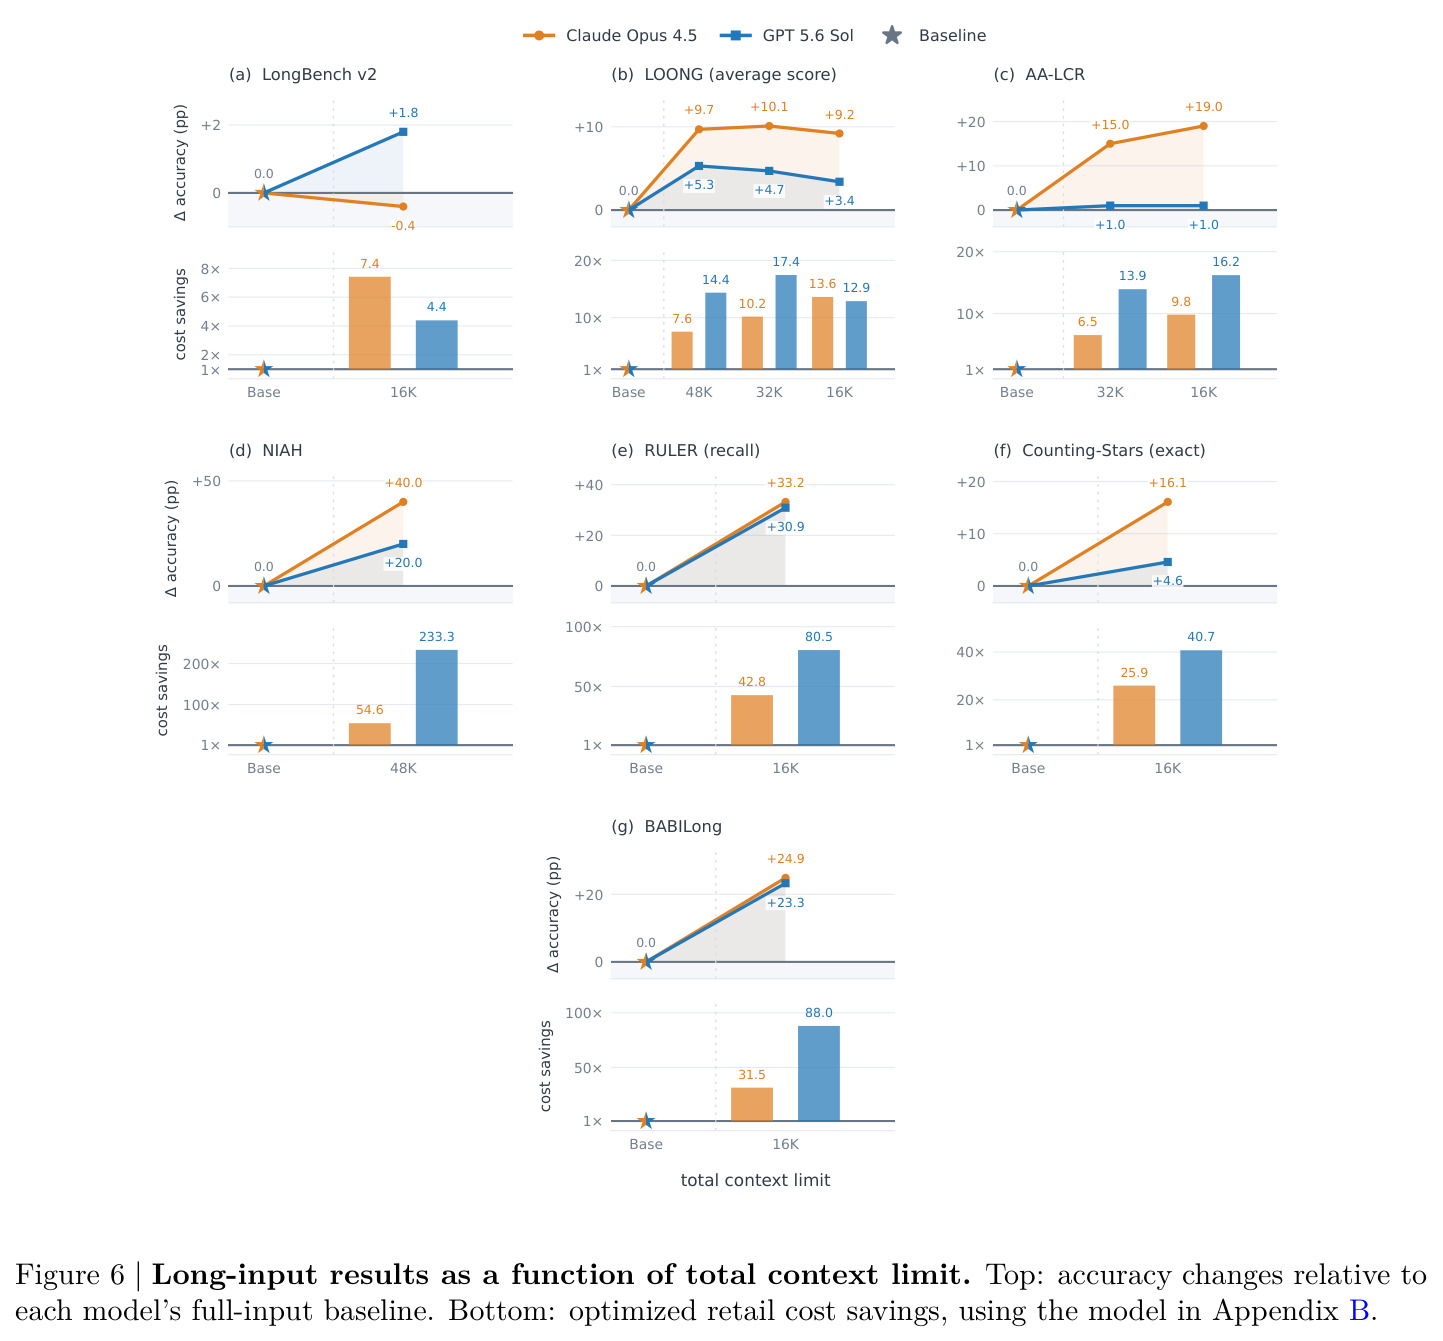
全文用同一套方法论回答三个研究问题。基座是两个最小 ReAct 智能体框架:mini-swe-agent(软件工程与终端任务)与其泛化版 mini-agent,均以 Bash 为唯一动作空间。在 FHA(全历史累积)、EoCC(会话末压缩)、SAC(单动作压缩)三种上下文管理机制下对照评测:EoCC 在对话达到预设的总上下文上限/压缩阈值(如 48K/36K 至 16K/12K)时让模型自己产出有界压缩,再以原任务加压缩状态重启会话;SAC 更极端,每个会话只读入任务与当前语义状态、执行恰好一个动作、更新状态后即弃。长输入任务把原文落盘为文件,教模型用 head、sed、awk 选择性读取。评测覆盖 6 个长程基准(SWE-bench Verified、Terminal-Bench 2.1 等)与 7 个长输入基准(LongBench v2、NIAH 等),主实验用 Claude Opus 4.5 与 GPT 5.6 Sol,另配云端与本地两组系统测量。
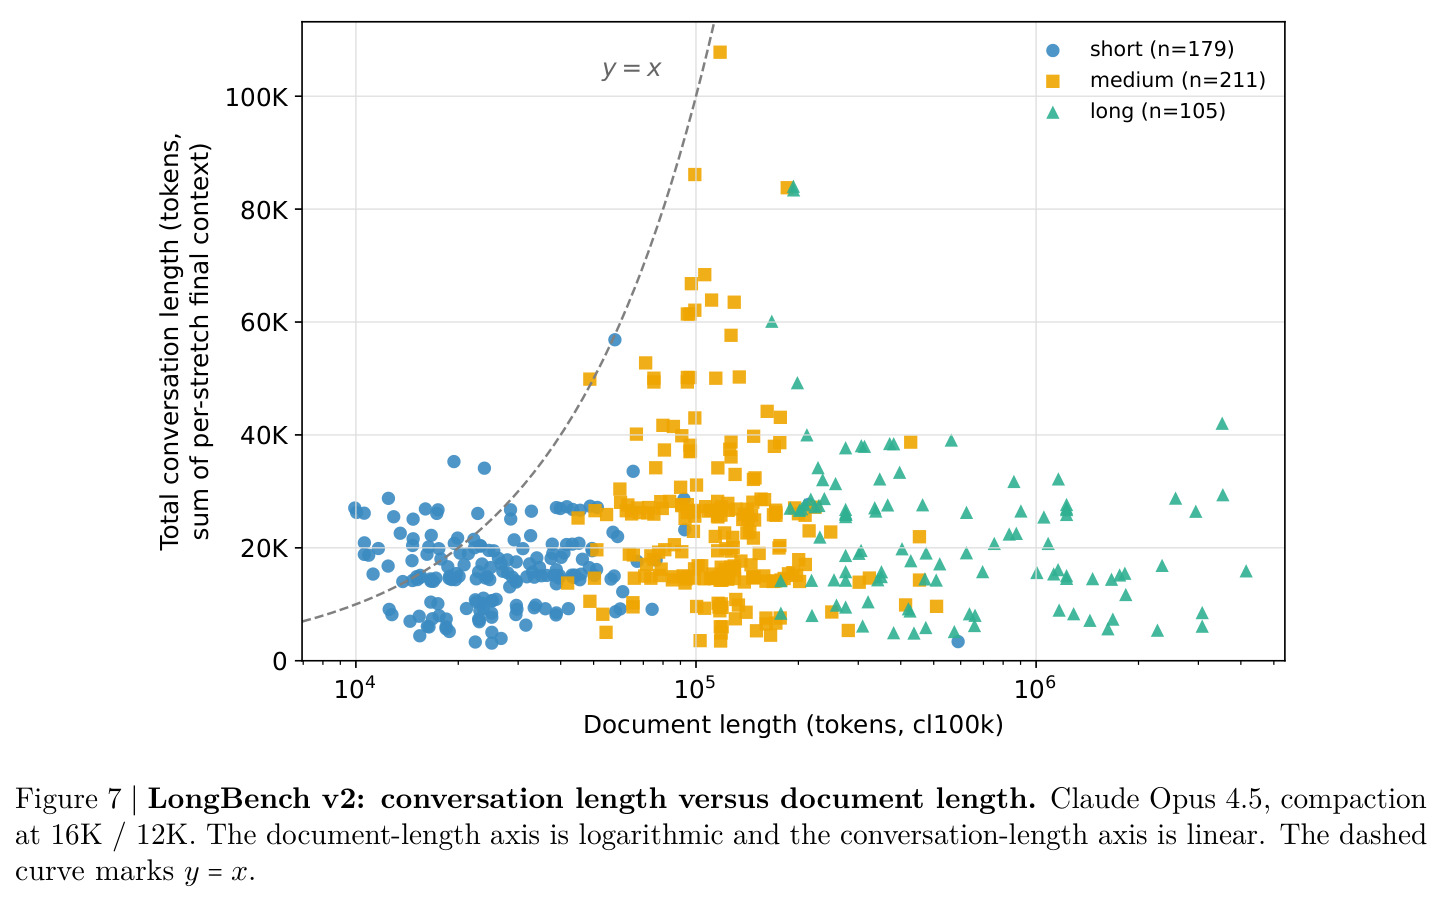
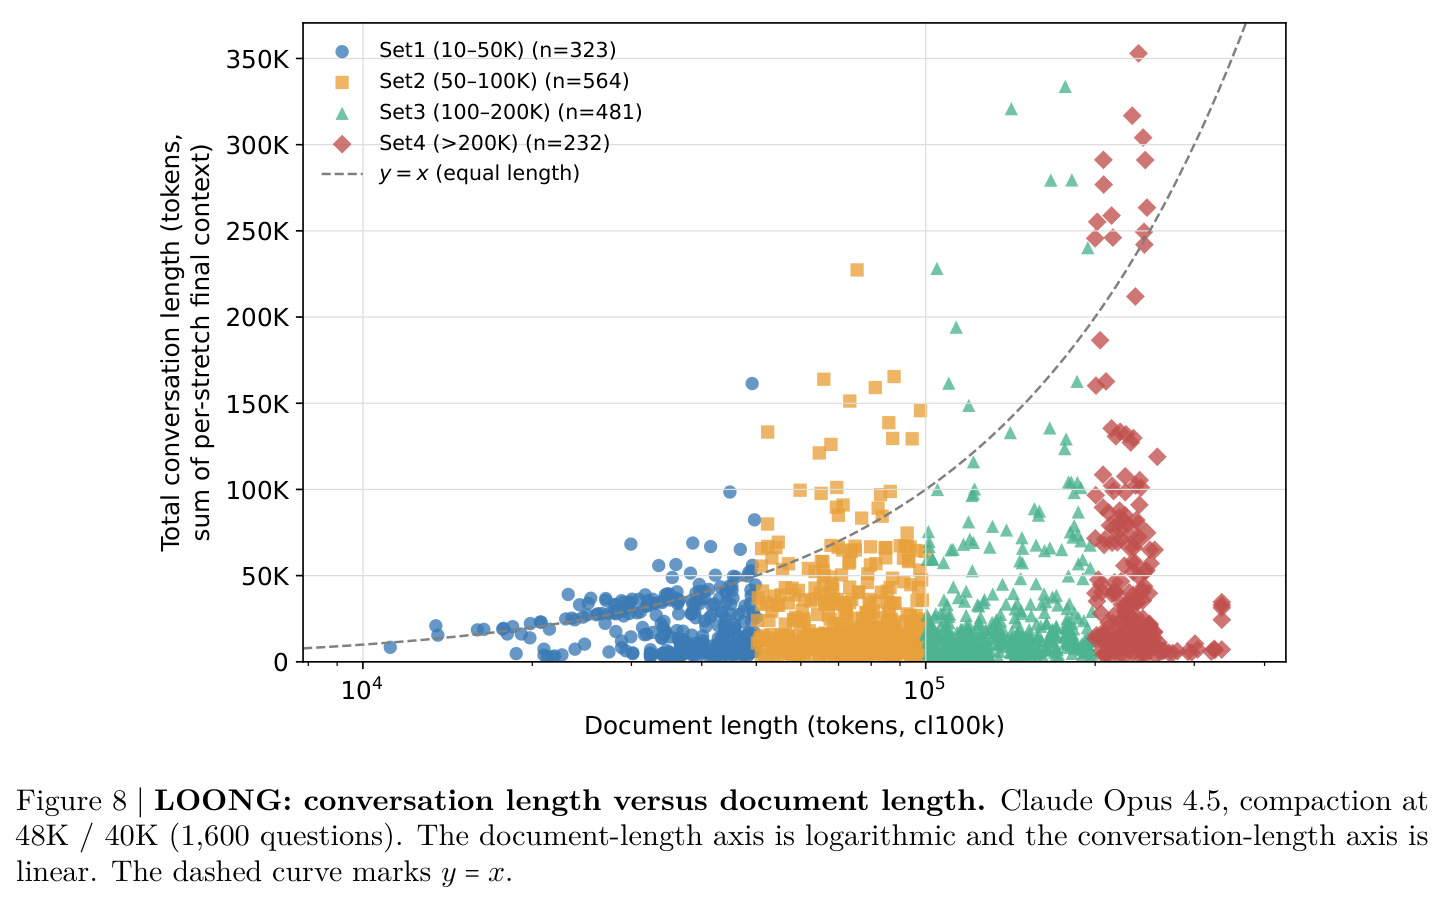
核心洞察是区分两类信息:“必须驻留在上下文中”与“可按需选择性检索”。长程任务的完整对话史并非每步都必要,可被压缩成有界的语义状态;长输入则可退化为长程任务——把大输入存为资源文件,配一个读取工具即可。压缩虽是有损的(论文用“无限掷硬币记录”构造了必然失败的反例),但实证显示绝大多数任务真正需要的信息量远小于输入量:LongBench v2 文档长度横跨 $10^4 \sim 10^6$ token,而会话总长度在散点图中大体保持有界、远低于 $y=x$ 参考线,LOONG 上同样如此。把压缩频率推到极限即得 SAC:上下文中只剩语义状态加一个动作,这一可扩展性直接催生了语义状态空间模型(SSSM)的概念。
方法步骤详情
第一步,任务作为初始用户消息注入 ReAct 循环,模型每轮输出一个 Bash 调用,stdout、返回码与报错作为观察回填。第二步,FHA 基线全程累积历史、不做删减。第三步,EoCC 设定“总上下文上限/压缩阈值”:SWE-bench Verified、Terminal-Bench 2.1、SWE-bench Multilingual、FRAMES 取 48K/36K、32K/24K、24K/18K、16K/12K;BFCLv3 取 24K/18K 至 12K/8K;τ²-bench 取 16K/12K 至 8K/6K。触阈后在当前会话内要求模型产出有界压缩,框架以原任务加压缩状态、同一系统提示开新会话续跑,上限同时为压缩回合预留空间。第四步,SAC 把每会话削减为“任务加语义状态→一个动作→观察→更新状态”,随后丢弃重开。第五步,长输入以 input01.txt 等文件暴露,教模型用 sed、awk、head 选择性读取。第六步,在 13 个基准乘两个前沿模型上逐级降阈值,记录精度、总长度、峰值长度与按 Appendix B 拟合模型估算的成本节省。
技术新颖性
压缩机制本身并不新鲜(Claude Code 等产品已有类似功能),本文的新颖性有三点。其一是系统性实证:首次在前沿闭源模型、6 加 7 个基准、涵盖软件工程/信息检索/多轮工具调用/长文档问答的工作负载上,量化把上下文压到 16K 乃至单动作的精度代价——多数配置损失不超过 2 个百分点,且成本节省达 2.2 倍至 233 倍。其二是概念贡献 SSSM:与经典状态空间模型用黑盒神经状态不同,SSSM 在对话轮次间维护可解释的自然语言“语义状态”,状态更新由前向推理而非训练完成,作者推测其训练数据效率更高(无需教会模型长程注意)。其三是系统测量:把短上下文的收益定量为云端 3.6 至 7 倍的吞吐与成本差、本地约 2 倍的延迟差,规模足以与量化、剪枝等正交优化相提并论。
实验结果
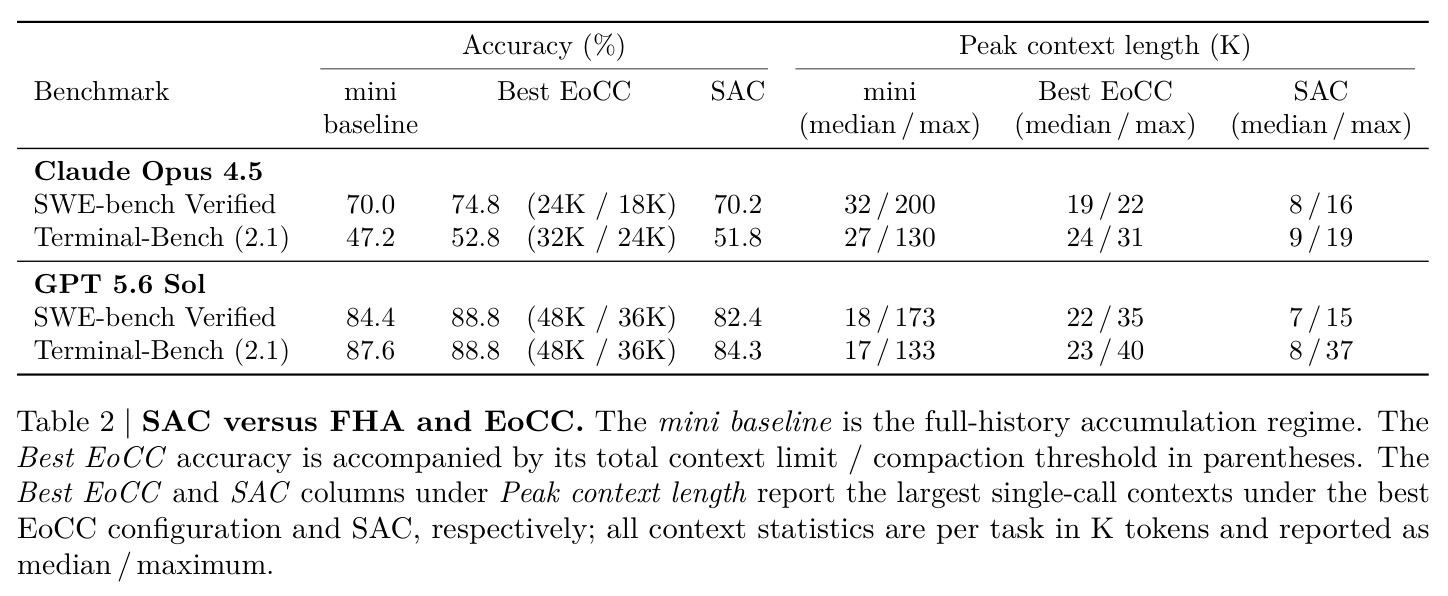
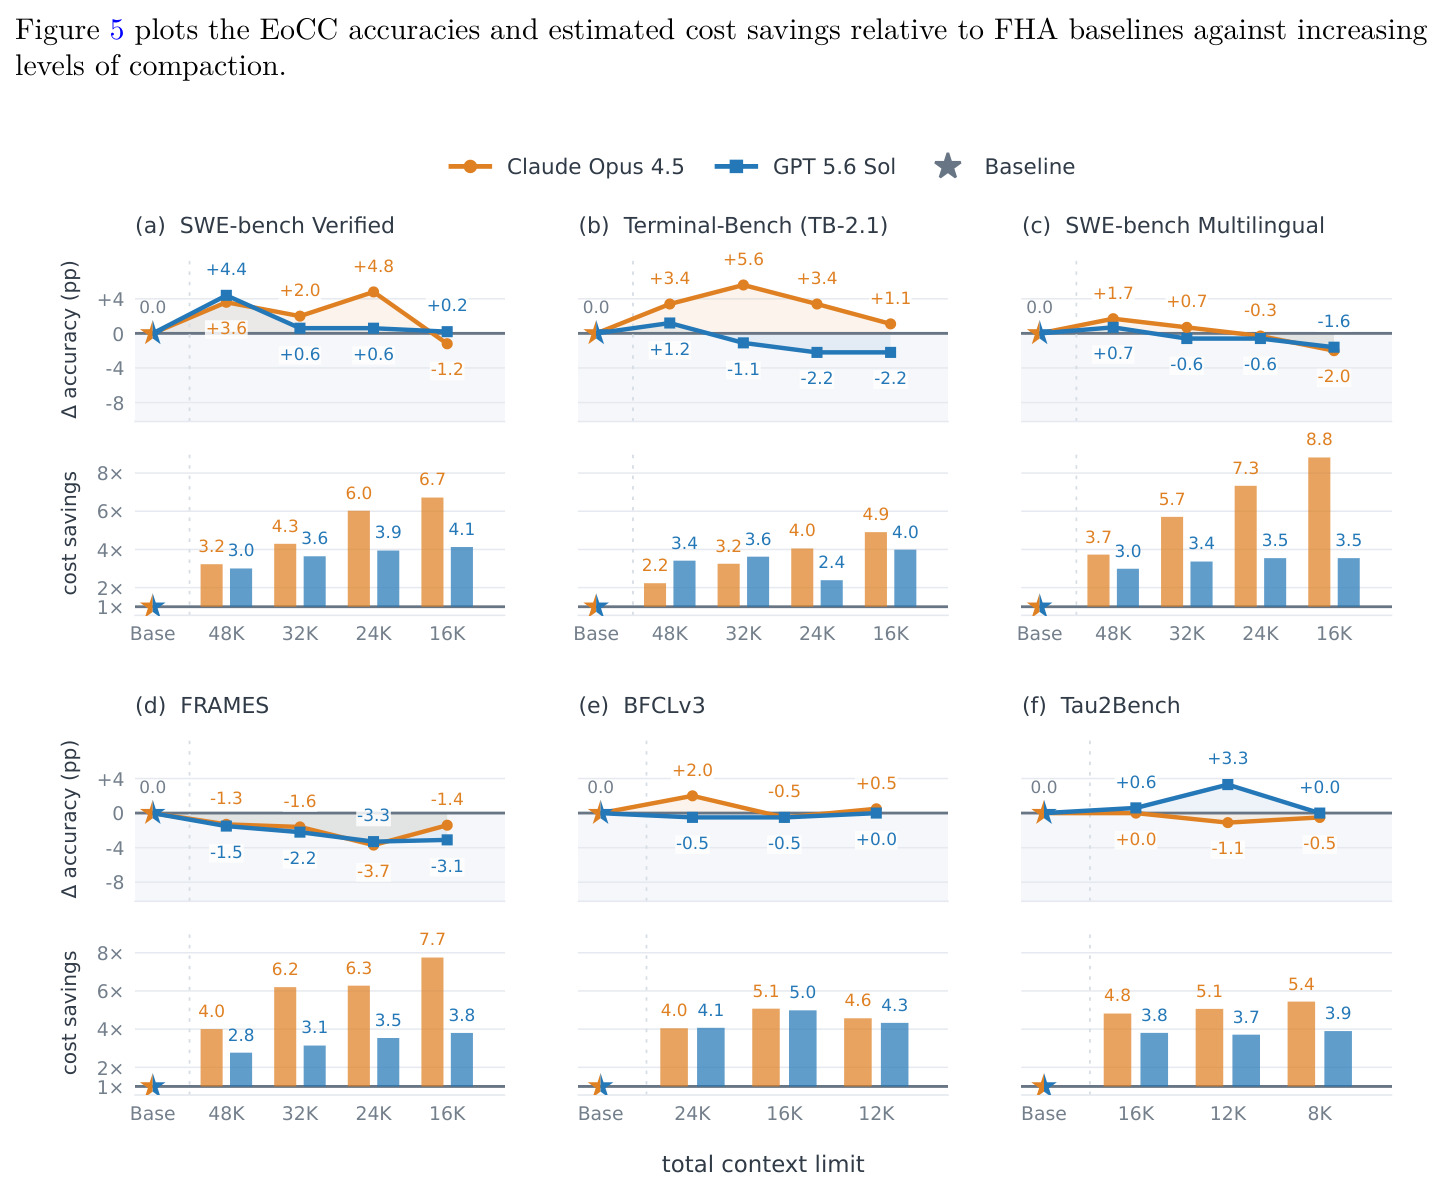
三个问题均得到肯定答案。RQ1(6 个长程基准,EoCC):Opus 4.5 精度相对 FHA 基线变化 -3.7~+5.6pp、GPT 5.6 Sol 为 -3.3~+4.4pp,22 个配置中每款模型至多 5 个损失超 2pp;成本节省 Opus 2.2-8.8 倍、GPT 2.4-5.0 倍。RQ2(7 个长输入基准,选择性读取加压缩):Opus 变化 -0.4~+40.0pp(NIAH +40.0)、GPT 为 +1.0~+30.9(NIAH +30.9),压缩次数中位数近零;成本节省最高 54.6 倍(Opus RULER 16K)与 233.3 倍(GPT NIAH);会话长度不随文档长度($10^4$~$10^6$ token)线性增长。RQ3(Table 2,SAC):Opus 在 SWE-bench Verified 达 70.2%(基线 70.0%)、Terminal-Bench 51.8%(+4.6pp);GPT 为 82.4%(-2.0pp)与 84.3%(-3.3pp);峰值上下文中位数仅 7-9K token,最大从 130-200K 降至 15-37K。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Verified(SAC,单动作压缩) | 解决率 % | Opus 4.5:70.2;GPT 5.6 Sol:82.4 | FHA 全历史基线 Opus 70.0;GPT 84.4 | Opus +0.2pp;GPT -2.0pp(峰值上下文从 32/200K 降至 8/16K) |
| Terminal-Bench 2.1(SAC) | 解决率 % | Opus 51.8;GPT 84.3 | Opus 47.2;GPT 87.6 | Opus +4.6pp;GPT -3.3pp |
| SWE-bench Verified(EoCC 最优配置) | 解决率 % | Opus 74.8(24K/18K);GPT 88.8(48K/36K) | Opus 70.0;GPT 84.4 | Opus +4.8pp;GPT +4.4pp |
| 长程任务组(6 基准 EoCC 全配置) | 精度变化(百分点) | Opus -3.7 至 +5.6pp;GPT -3.3 至 +4.4pp | 各基准 FHA 全历史基线 | 成本节省 Opus 2.2-8.8 倍、GPT 2.4-5.0 倍 |
| 长输入任务组(7 基准,选择性读取+压缩) | 精度变化(百分点) | Opus -0.4 至 +40.0pp;GPT +1.0 至 +30.9pp | 各基准全输入基线 | 成本节省 Opus 6.5-54.6 倍、GPT 4.4-233.3 倍 |
| 云端解码吞吐(256K 窗口 vs 16K) | 吞吐/成本倍数 | GLM 5.2 3.6 倍;Kimi K2.6 5.6 倍;Qwen 3 Coder Next 7 倍 | 256K 上下文窗口的持续解码吞吐 | 同硬件(H100 + vLLM)下缩短窗口直接获得数倍吞吐 |
局限与改进
作者明确承认:证据不排除存在长上下文确有益处的任务,也不证明所有任务都能短上下文解决;压缩是有损的,像“查询第 i 次掷硬币结果”这类需要不可再生原始观测的任务必然随压缩失败,尽管可以把历史存档加检索工具化解为长输入任务来规避;GPT 5.6 Sol 在 SAC 下仍有 2.0 至 3.3pp 的真实下降。我的补充观察:成本节省是按服务窗口大小用吞吐拟合模型(Appendix B)折算的估算值,并非实测账单;压缩质量完全依赖模型自身,被测模型并未专门训练过压缩能力,结论对未对齐此类指令的较小开源模型可能偏乐观(附录 D 有部分补充);评测绑定 mini-swe-agent 式的 Bash-only 动作空间,工具更丰富的智能体框架未必迁移;SAC 每步重开会话还会破坏 KV 前缀缓存复用,实际端到端延迟收益需要单独验证。
独立分析的弱点
第一,有损压缩的系统性失效模式:任何需要保留不可再生观测序列的任务(连续掷硬币、逐步传感器读数)必然失败,改进方向是让 harness 自动区分可再生信息与一次性原始观测,把后者落盘存档并暴露检索工具,而非全部托付给语义状态。第二,压缩结果无校验:EoCC 摘要由模型自由生成,一旦漏掉关键约束(测试命令、文件路径、用户偏好)就会静默污染后续所有步骤,可引入结构化状态模式(目标/已知事实/待办/约束)并做摘要一致性检查。第三,SAC 与前缀缓存天然冲突:每动作重开会话使 KV 缓存命中率骤降,论文宣称的吞吐收益在真实服务中可能打折。第四,任务粒度的脆弱性被均值掩盖:22 个配置中仍有个别损失超过 2pp,论文未报告哪类任务最易受损。第五,模型依赖性:主结论来自两款 2026 年前沿闭源模型,对更小或后训练风格不同的模型泛化性存疑。
未来方向
作者提出的方向是语义状态空间模型(SSSM):通过后训练让模型学会理解语言化状态描述、推理下一步动作、执行并登记结果、再更新状态,使任意长上下文工作流默认变成单动作工作流;作者推测 SSSM 因无需教会模型注意历史中的相关片段而更省训练数据,且没有理由不能追平全历史模型的表现。可延伸的研究包括:把语义状态设计为可验证的结构化格式并与外部记忆(文件、数据库、向量库)协同;训练小型专用压缩模型以摊薄压缩本身的开销;给出把窗口从 256K-1M 缩到 16-50K 的后训练配方;研究压缩调度与前缀缓存的联合优化;在多智能体并行与不可再生信息场景下建立混合持久化协议;以及用 SSSM 视角重新审视现有长上下文评测基准的有效性。
复现评估
复现门槛中等偏低。mini-swe-agent 本身开源,13 个基准全部公开可得:SWE-bench Verified 500 题、SWE-bench Multilingual 300 题、Terminal-Bench 2.1 89 题、FRAMES 824 题、τ²-bench 184 题、BFCLv3 200 集、LongBench v2 503 题、LOONG 1600 题、AA-LCR 100 题、NIAH 125 实例、RULER 13 任务乘 256K 与 500K 两个长度、Counting-Stars 192 题、BABILong 550 题。闭源模型经 API 调用即可,但多阈值乘数百题的评测费用可观;云端吞吐测量需 8 至 16 卡 H100 节点配 vLLM,本地复现需 128GB 统一内存设备(DGX Spark)及 GGUF/NVFP4 量化权重。正文未附 mini-agent 与压缩提示词的代码链接,需按 Appendix A 与 Appendix E 自行复刻压缩模板,这是主要的不确定之处。
论文图表
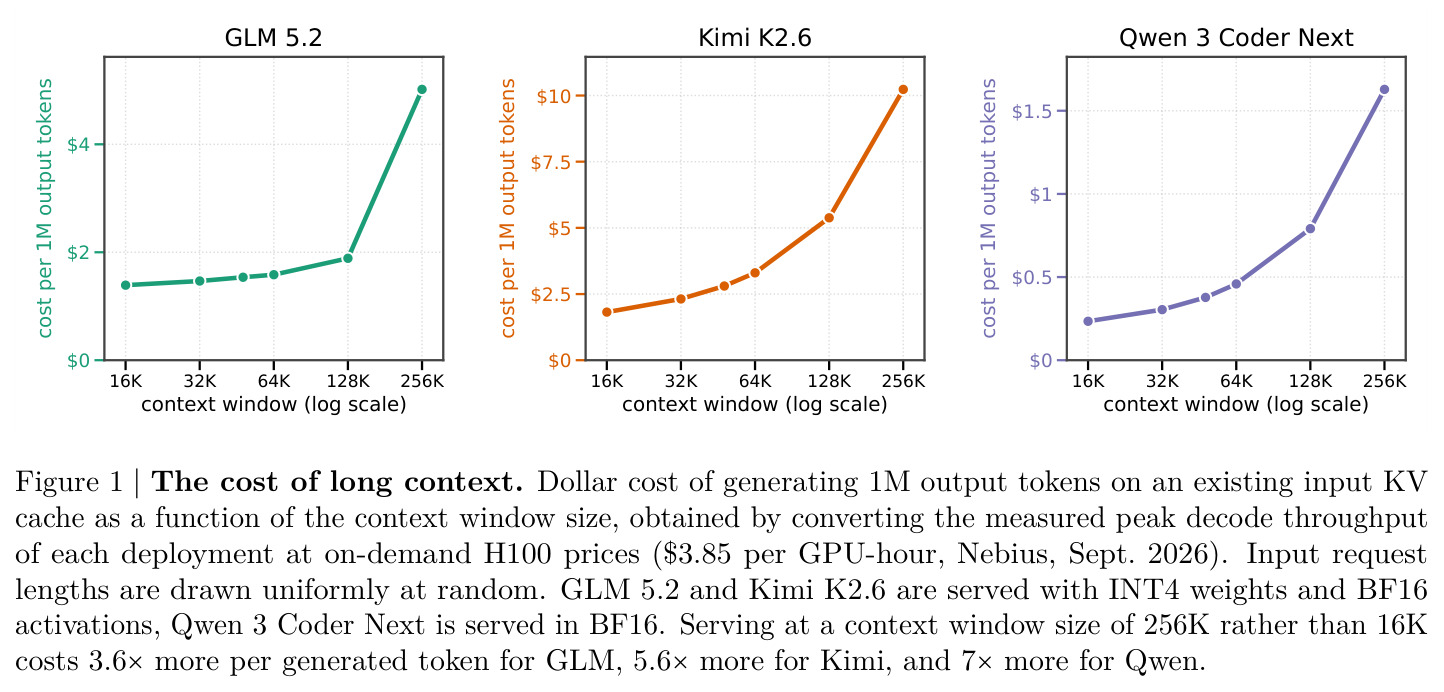
三款开源权重模型(GLM 5.2、Kimi K2.6、Qwen 3 Coder Next)在云 H100 上、基于已填充输入 KV 缓存生成 1M 输出 token 的美元成本随上下文窗口大小(16K 至 256K,对数轴)的变化。窗口从 16K 扩到 256K,每 token 成本分别变为 3.6 倍、5.6 倍和 7 倍。
这是全文动机的定量基石:长上下文在云端有具体、可观的货币成本,且量级堪比激进量化等正交优化,直接支撑“为什么要追求短上下文”的提问。
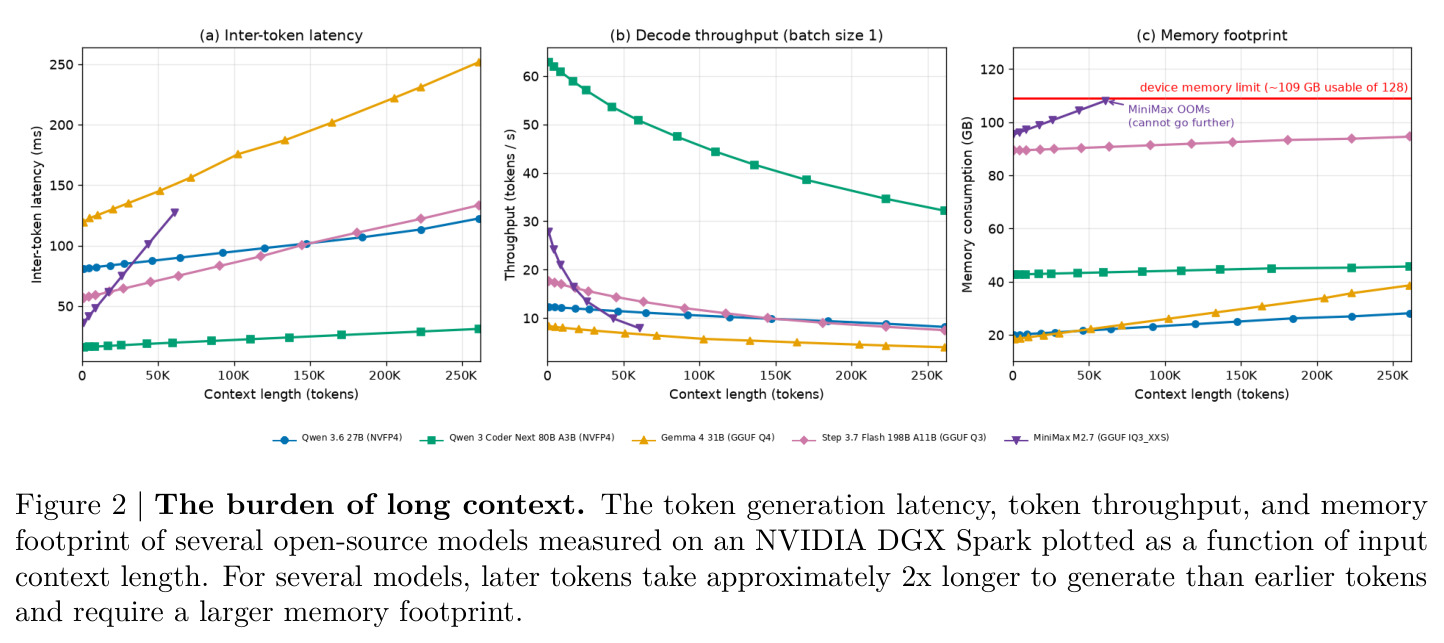
多款本地部署的开源编码模型在 NVIDIA DGX Spark 上的 token 生成延迟、吞吐与显存占用随输入上下文长度的变化。若干模型在长上下文下生成逐 token 延迟约变为 2 倍,显存占用也明显增加。
把长上下文的代价从云端货币成本扩展到本地边缘场景的延迟与内存,说明短上下文的收益对两类部署都成立。
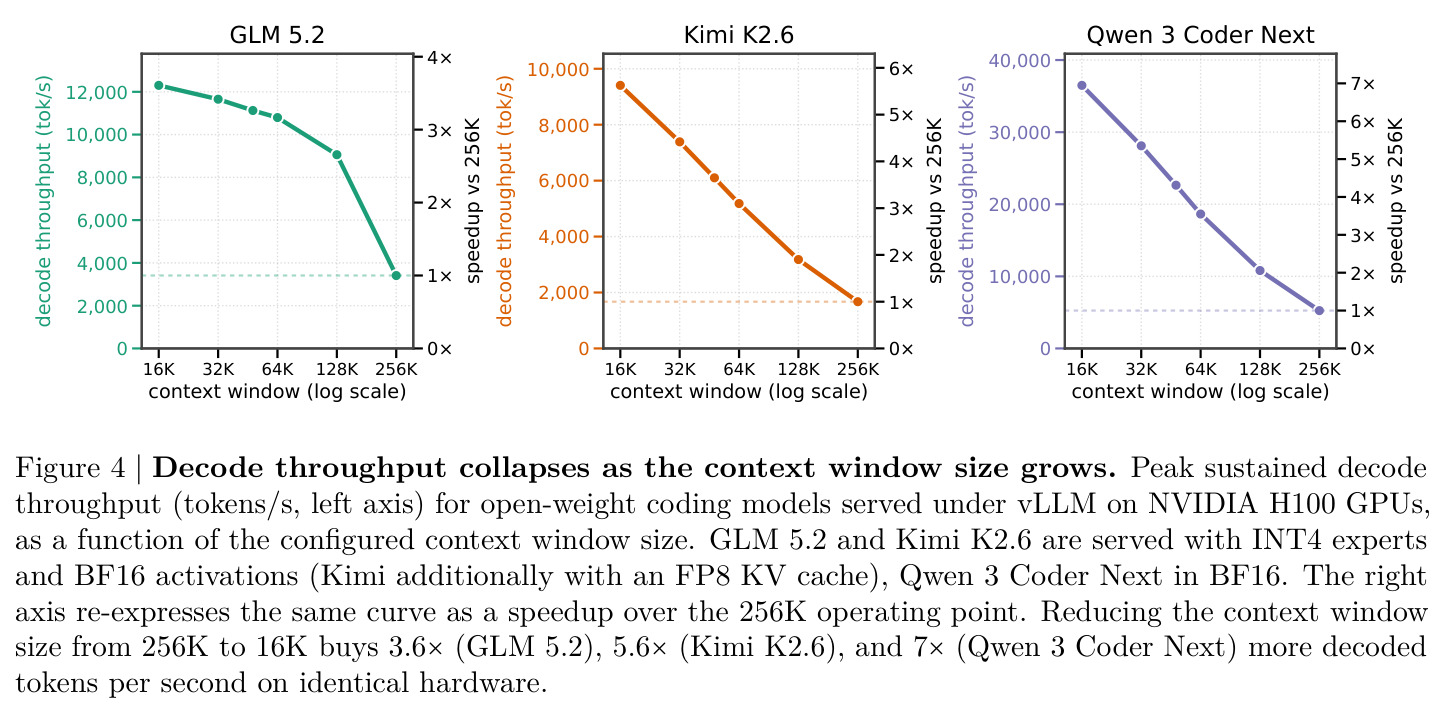
开源编码模型在 H100 上用 vLLM 服务时,峰值持续解码吞吐(tokens/s)随配置的上下文窗口大小从 16K 到 256K/1M 的坍缩曲线,右轴换算为相对 256K 工况的加速比:GLM 5.2 为 3.6 倍、Kimi K2.6 为 5.6 倍、Qwen 3 Coder Next 为 7 倍。
Figure 1 成本数字的原始测量来源,展示同一硬件上仅缩小服务窗口即可获得数倍吞吐,是成本节省估算的实证依据。