少想一点:面向推理压缩的局部偏好学习 Think Less, Locally: Local Preference Learning for Reasoning Compression
定位模型推理中的过度思考状态,从同一状态重生成更短续写,用局部偏好对训练模型学会何时停止。
前置知识
DPO(直接偏好优化)
一种离线偏好对齐算法:给定提示 $x$、偏好回答 $y^+$ 与被拒绝回答 $y^-$,以冻结的参考策略 $\pi_{\mathrm{ref}}$ 为锚,优化 $\mathcal{L}_{\mathrm{DPO}} = -\log\sigma\left(\beta\left[\log\frac{\pi_\theta(y^+|x)}{\pi_{\mathrm{ref}}(y^+|x)}-\log\frac{\pi_\theta(y^-|x)}{\pi_{\mathrm{ref}}(y^-|x)}\right]\right)$。它无需单独训练奖励模型,直接用偏好对拉大正负样本的相对似然,是 RLHF 的主流轻量替代。
本文的训练目标就是 DPO,理解“共享同一前缀下比较两个续写”的目标函数是看懂方法设计的前提。
过度思考(overthinking)
大型推理模型(LRM)在已获得充分信息甚至已得出正确答案后,仍继续生成验证、重推、换方法等冗余 token 的现象。近年研究表明,当任务本身可解时,过度思考更多与模型“偏好继续思考”有关,而非推理能力不足——问题在于模型何时选择停止,而非能否得到正确答案。
本文的检测、数据构建与训练全部围绕定位并消除该现象展开,是理解论文动机与方法命名(LoCo)的核心概念。
推理状态(reasoning state)
把思维链按段落边界切成推理步 $s_0,\dots,s_n$,状态 $P_i=\mathrm{prompt}(q)\|s_0\|\cdots\|s_i$ 表示完成第 $i$ 步之后、生成第 $i{+}1$ 步之前的全部上下文。每个状态都是模型“继续推理还是收束出答案”的局部决策点。
LoCo 的核心操作——冻结状态前缀、从同一状态对比两种续写——完全建立在这一形式化之上。
LoRA(低秩适配微调)
一种参数高效微调方法:冻结基座模型权重,仅训练注入到线性层(本文为注意力 q/k/v/o 投影)中的低秩分解矩阵,秩 $r$ 远小于原维度,配合缩放因子 $\alpha$ 控制更新幅度。推理时可合并权重或以适配器形式加载。
论文训练设置用 LoRA rank 256、$\alpha=512$、dropout 0.05,决定了复现所需的显存与算力规模(4 张 H20)。
AUC(准确率-长度曲线下面积)
评测推理压缩的综合性指标:改变最大生成长度预算,绘制“准确率 vs token 预算”曲线并计算曲线下面积。单一截断点的准确率或长度都可能误导,AUC 衡量的是整个预算区间上的效率-性能权衡质量。
论文主表用 Accuracy/Token/AUC 三指标对比方法,AUC 是判断“哪个方法的权衡真正更好”的关键,尤其在代码迁移实验中。
研究动机
大型推理模型(LRM,如 DeepSeek-R1)在数学与编程任务上依赖长思维链(CoT)推理,动辄生成数千个 token 做假设、计算、修订与验证,带来显著的解码延迟与显存开销。更关键的是,更长推理并不必然带来更高准确率:当任务可解时,模型常在很早阶段就已得到正确答案,却继续围绕已有结论反复推演。论文附录的日历题示例很典型:答案(周日)在第 28 步前已被三种方法交叉验证,模型仍追加约 986 个 token 的冗余重推;另一道分数题在验证两次后又多写了 1247 个 token。这种过度思考本质上是模型偏好问题而非能力问题。现有压缩方法主要在完整轨迹层面施加监督:或用 DPO 对比“更短 vs 更长”的正确解(Kimi k1.5、O1-Pruner、CoT-Valve),或在 RL 奖励中加入长度惩罚(L1 等);细粒度方法则删除冗余 token/句子(TokenSkip、VARR)或对比步级续写(Step-DPO、SSPO、ReCUT)。但它们优化的始终是“轨迹的哪一段该删短”,而非“模型在当前状态下是否还需要继续推理”这一局部决策。
本文的目标是本文要让模型在恰当的推理状态上学会“继续还是收束”(continue-or-conclude)的局部决策,而不是全局性地偏爱更短轨迹。具体路径是:完全从模型自生成的数学推理轨迹构建训练数据——先从轨迹中检测出过度思考状态,冻结该状态的推理前缀,从同一状态重新采样并验证出更短的正确续写,与原始冗余续写构成状态条件化偏好对,再用 DPO 微调 DeepSeek-R1-Distill-Qwen-7B。量化目标是在 MATH-500、AMC23、Olympiad、AIME24/25 五个数学基准上实现 40% 以上的生成长度压缩,同时保持甚至提升准确率与 AUC;并进一步验证仅用数学数据训练能否零样本迁移到 MBPP、LiveCodeBench、CodeContests 三个代码生成基准,以证明学到的是通用停止偏好而非任务知识。
与已有工作不同的是,本文的独特切入是把压缩决策从“轨迹级”下沉到“状态级”。作者抓住两个被现有工作忽视的事实:其一,LLM 推理是局部、增量的状态转移过程而非全局规划(Xu et al., 2026),因此压缩监督也应锚定在具体状态上——两条答案相同但路径不同的轨迹,仅凭整体长度根本无法判断冗余发生在哪;其二,压缩决策应随状态而变,有的状态需要继续推进,有的状态应该立即收束,全局偏好无法表达这种区分,一刀切地偏好短轨迹会伤害真正需要长推理的难题。此外,方法坚持“自生成”原则:候选状态由被训练模型自身的 token 置信度统计筛出,chosen 续写也由它自己重生成,仅引入 Qwen3-30B 做语义复核,保证监督信号贴近模型原生推理分布——消融显示换成 GPT-5.4 的外部续写后压缩与 AUC 均明显下滑。
核心方法
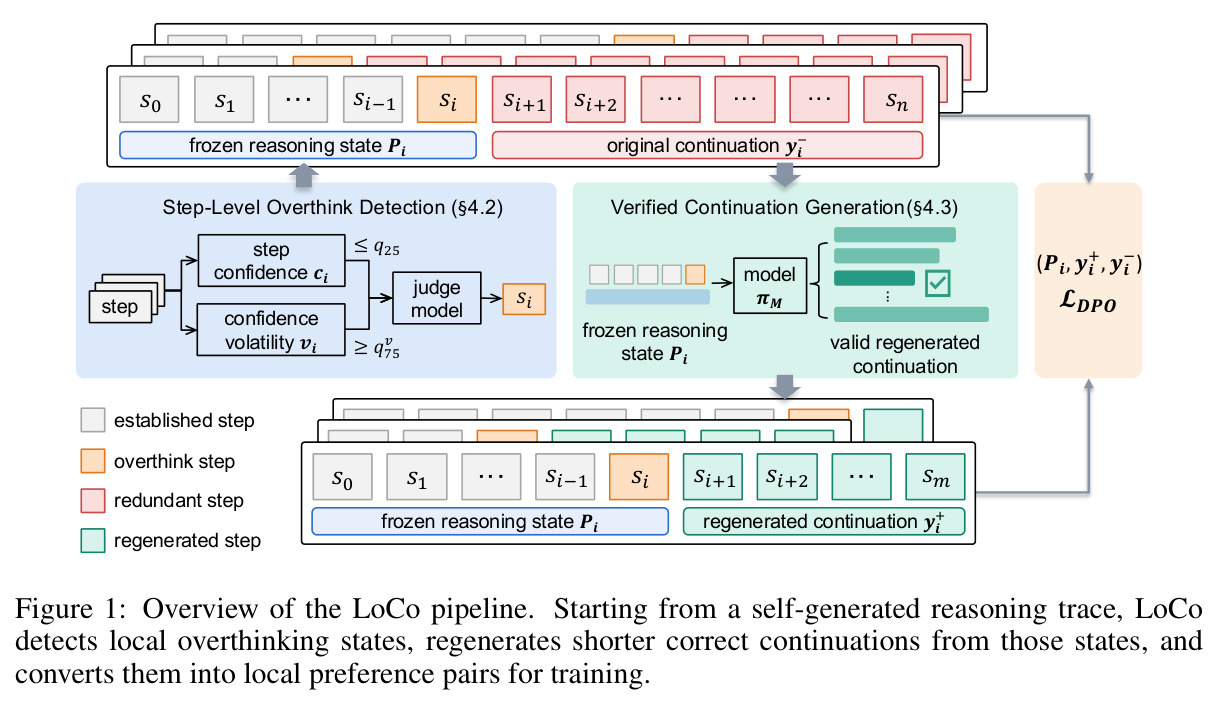
直觉上,LoCo 像一位教练不是泛泛要求学生“解题写得简洁些”,而是精确指出“到这一步答案已经确定,你应该停笔了”。技术路线分三阶段。第一阶段做步级过度思考检测:把完整 CoT 喂回模型自身,按位置记录最大 token 概率 $p^{\max}_\tau=\max_{v}\pi_M(v\mid S_{<\tau})$,对每个段落切分的推理步求平均置信度 $c_i$ 与相邻步波动率 $v_i=(c_i-c_{i-1})^2/4$,筛出“低置信且高波动”的候选状态($c_i\le q_{25}$ 且 $v_i\ge q^{v}_{75}$,分位数在自生成语料上一次性标定),再用更强的 judge 模型(Qwen3-30B)复核下一步属于 OVERTHINK/NORMAL/FINAL 哪一类。第二阶段做验证续写生成:冻结该状态前缀 $P_i$,从被训练模型采样 8 条续写,取符号等价于标准答案的最短一条作为 $y_i^+$,原始续写作为 $y_i^-$。第三阶段在三元组 $(P_i,y_i^+,y_i^-)$ 上做 DPO:两支共享同一前缀,偏好梯度直接作用于“到达该状态后应选哪条续写”的局部决策。
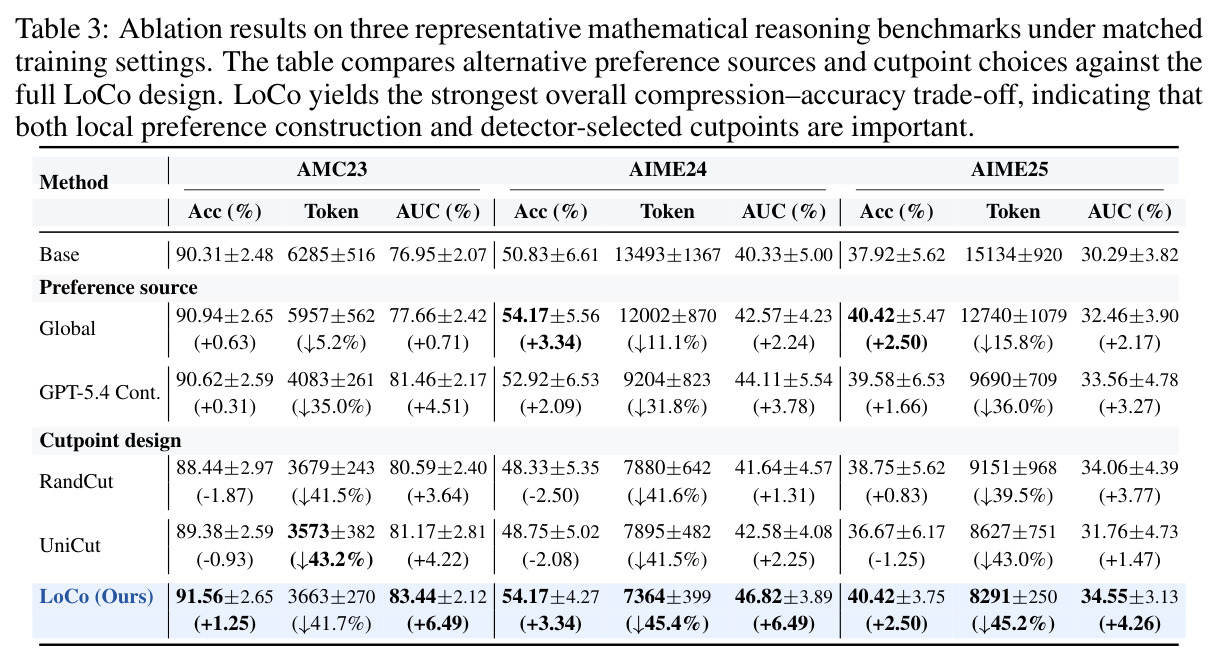
核心创新是把偏好学习的比较基准从“完整轨迹”改为“同一冻结推理状态下的两种续写”。轨迹级方法(Kimi k1.5、O1-Pruner 及 Global 消融)对比的两条正确解往往走完全不同的推理路径,长度差无法定位冗余位置;LoCo 的正负样本共享完全相同的前缀 $P_i$,唯一差异是从该状态出发的续写,因此监督精确作用于“该状态下继续推理 vs 立即收束”这一决策。消融直接证明这是性能来源:相同查询集、阈值与训练设置下,Global 变体只能压缩 AMC23 长度的 5.2%、AIME24 的 11.1%、AIME25 的 15.8%,而 LoCo 达到 41.7%、45.4%、45.2%,差距悬殊。另一个关键设计是检测器的因果性与自生成原则:$c_i$ 与 $v_i$ 只用到步 $s_i$ 结束前的信息,截断从不“偷看”要删除的内容;chosen 续写由被训练模型自己生成,与 GPT-5.4 外部续写消融对比显示分布对齐带来更高的压缩率与 AUC,尤其在更难的 AIME 上。
方法步骤详情
完整流程六步。(1) 源轨迹生成:在 TokenSqueeze 的 math14k 数学训练集(14,027 题)上,每题以 temperature 0.6、top-p 0.95 采样 3 条 rollout,保留最短的正确 rollout 作为源轨迹。(2) 置信度筛选:完整 CoT 经 vLLM 离线前向,记录每位置 top-1 概率,按段落边界切步,步内取均值得 $c_i$,窗口 2 的波动 $v_i=(c_i-c_{i-1})^2/4$,与分位数阈值联立输出候选状态集合。(3) Judge 复核:Qwen3-30B 读取题目、前序步骤、候选步骤与预测标签,按 JSON 模板返回修正标签(OVERTHINK/NORMAL/FINAL_ANSWER_WRAPUP)与理由,仅保留 OVERTHINK,每条轨迹最多 10 个候选(均匀采样)。(4) 验证续写生成:冻结前缀 $P_i$ 采样 8 条续写,用 math_verify 做符号等价校验,取最短正确者为 $y_i^+$;若无正确续写或未严格短于原始续写 $y_i^-$ 则丢弃该检测点。(5) 偏好对构建:要求节省 $g_i=|y_i^-|-|y_i^+|\ge\delta=300$ token,prompt 上限 $c_p=6$k、续写上限 $c_r=12$k,每题最多保留节省最大的 $K=3$ 对。(6) DPO 训练:LoRA rank 256、$\\alpha=512$ 挂在 q/k/v/o 投影,2 个 epoch,有效批大小 64,学习率 $1\times10^{-5}$ 余弦调度加 0.1 warmup,$\\beta=0.1$,参考策略为基础模型,4 张 H20 GPU,最大序列长 14,336。
技术新颖性
与已有工作的三点本质区别。其一,监督粒度上是“状态条件化偏好”而非轨迹或句子级操作:Step-DPO/SSPO/ReCUT 虽也共享前缀,但对比的是“正确 vs 错误”续写或以压缩为目标的步级重写;LoCo 在检测出的过度思考点上对比“冗余续写 vs 已验证更短的收束续写”,直接建模停止决策本身。其二,检测信号是模型自身行为统计(token 置信度与波动率的分位阈值)加 judge 语义复核的两级过滤,无需人工步级标注,且检测器因果构造保证不泄露被截断内容。其三,数据全自生成:检测出的切点集中在轨迹后段(平均相对位置 0.57,约一半落在最后 40% 步内),而随机/均匀切点(0.47/0.50)虽然压缩率接近(↓41.5%/↓43.2%),准确率却明显受损(AIME24 分别 -2.50/-2.08),证明“在哪切”与“怎么切”同样重要,这是以往工作从未定量分析过的维度。
实验结果
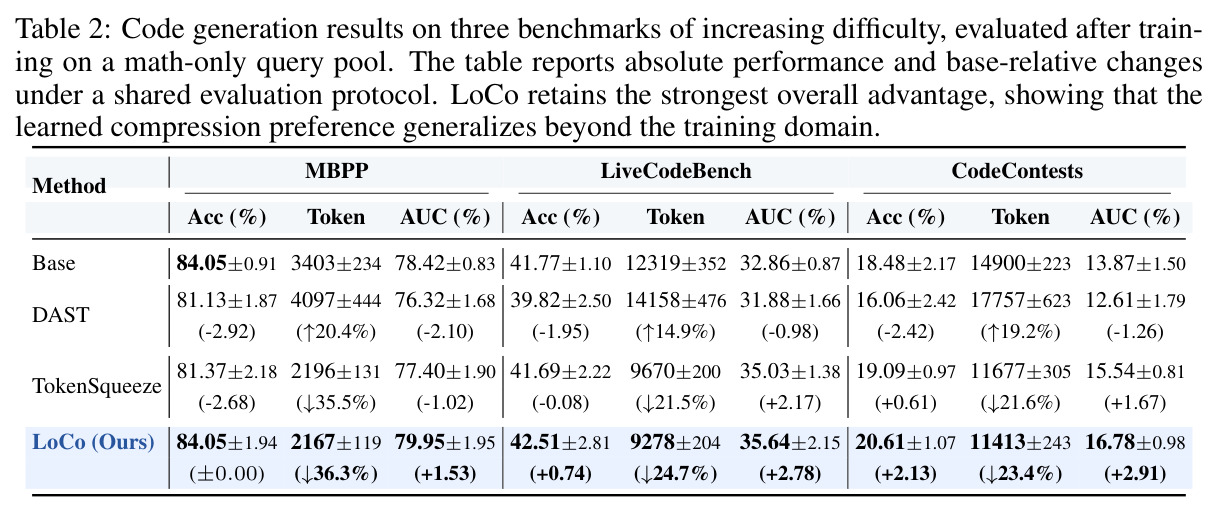
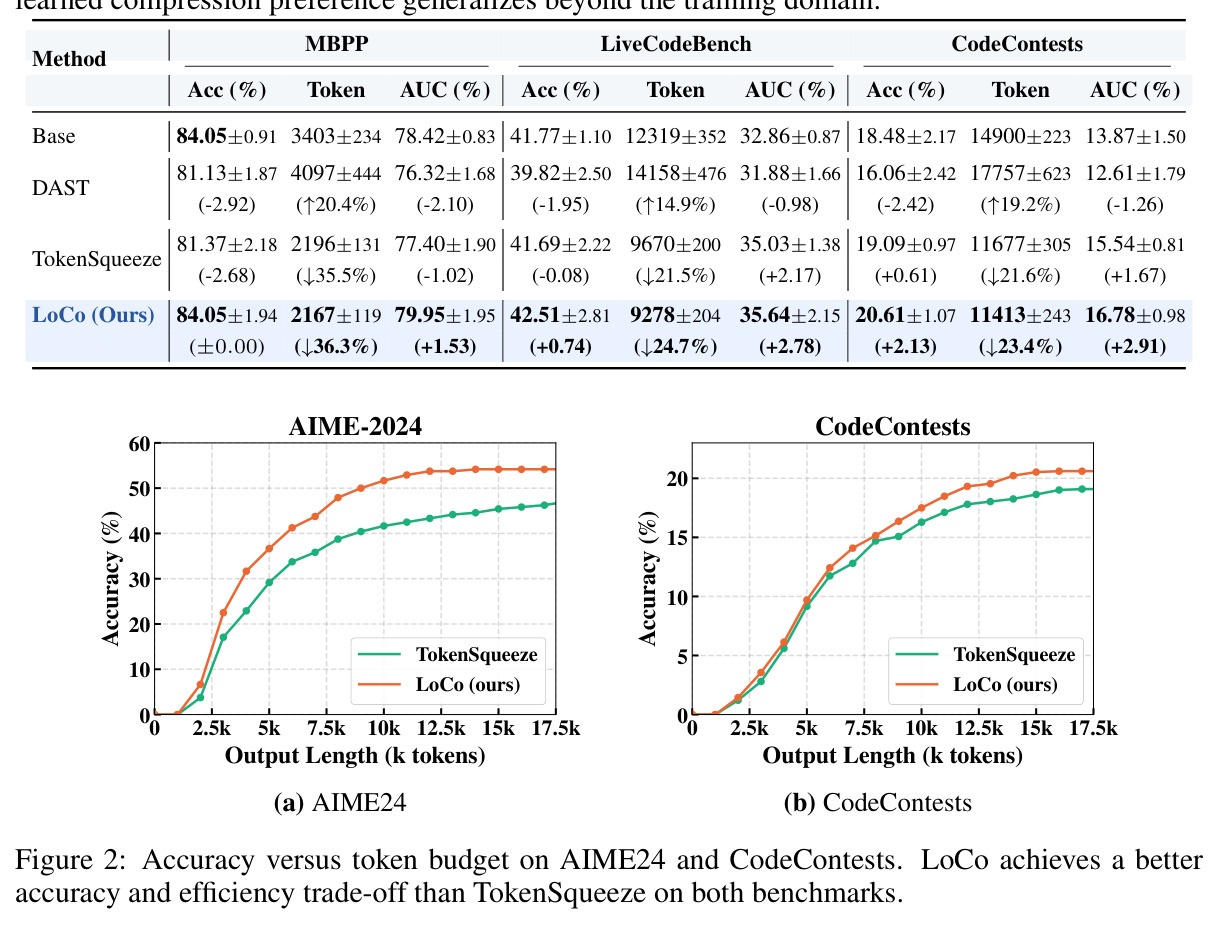
数学推理(Table 1):LoCo 在五个基准上同时取得最高压缩与持平或更高的准确率。MATH-500:准确率 91.80%(基线 91.88%),token 从 4015 降至 2243(↓44.1%),AUC 82.64→86.56(+3.92);AMC23:91.56%(+1.25),6285→3663(↓41.7%),AUC +6.49;Olympiad:62.78%(+1.45),8972→4968(↓44.6%),AUC +5.33;AIME24:54.17%(+3.34),13493→7364(↓45.4%),AUC 40.33→46.82(+6.49);AIME25:40.42%(+2.50),15134→8291(↓45.2%)。对比之下,DAST 压缩温和甚至在高难基准增加长度(AIME24 token ↑6.9%),TokenSqueeze 压缩激进但准确率随难度上升而下滑(AIME24 -2.08、AIME25 -2.09)。代码迁移(Table 2,仅数学数据训练):MBPP 准确率 84.05% 与基线持平,token ↓36.3%,AUC +1.53;LiveCodeBench 42.51%(+0.74),token ↓24.7%,AUC +2.78;CodeContests 20.61%(+2.13),token ↓23.4%,AUC 13.87→16.78(+2.91),三个代码基准 AUC 全部第一。消融(Table 3):Global 轨迹级偏好仅压缩 5.2%/11.1%/15.8%;GPT-5.4 外部续写压缩 35.0%/31.8%/36.0% 且 AUC 落后;RandCut/UniCut 压缩率接近但准确率损失大(AIME24 分别 -2.50/-2.08)。Figure 2 显示 AIME24 与 CodeContests 的大部分 token 预算区间上 LoCo 曲线均高于 TokenSqueeze,说明优势是整条效率-性能前沿而非单点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理 MATH-500 | 准确率 / 平均 Token / AUC | 91.80%,2243 tokens,AUC 86.56 | 基线 91.88%,4015 tokens,AUC 82.64;最强基线 TokenSqueeze 压缩 ↓39.2% | token ↓44.1%,AUC +3.92,准确率持平(-0.08) |
| 数学推理 AIME 2024 | 准确率 / 平均 Token / AUC | 54.17%,7364 tokens,AUC 46.82 | 基线 50.83%,13493 tokens,AUC 40.33;TokenSqueeze 48.75%、10457 tokens | 准确率 +3.34,token ↓45.4%,AUC +6.49 |
| 数学推理 AIME 2025 | 准确率 / 平均 Token / AUC | 40.42%,8291 tokens,AUC 34.55 | 基线 37.92%,15134 tokens,AUC 30.29;TokenSqueeze 35.83%、11055 tokens | 准确率 +2.50,token ↓45.2%,AUC +4.26 |
| 代码生成 CodeContests(数学数据零样本迁移) | 准确率 / 平均 Token / AUC | 20.61%,11413 tokens,AUC 16.78 | 基线 18.48%,14900 tokens,AUC 13.87;TokenSqueeze 19.09%、11677 tokens | 准确率 +2.13,token ↓23.4%,AUC +2.91,AUC 三个代码基准全部第一 |
| 消融:全局轨迹级偏好 vs 局部状态偏好 | AIME24 token 压缩率(相同训练设置) | LoCo ↓45.4% | Global 变体(最短 vs 最长正确 rollout 的轨迹级 DPO)仅 ↓11.1% | 压缩率约 4 倍差距,证明状态锚定是压缩能力的来源 |
局限与改进
作者承认与可观察到的局限:(1) 检测与数据构建依赖外部 judge(Qwen3-30B)复核,judge 判断错误会直接污染偏好对,且 FINAL 类(答案收束)步骤被误截断的风险必须靠语义把关,附录模板显示这一步完全由单一 judge 的 JSON 输出决定;(2) 正确性校验依赖可符号验证的数学答案(math_verify)与可沙箱执行的代码测试,难以直接推广到开放式生成任务;(3) 实验仅在 DeepSeek-R1-Distill-Qwen-7B 一个 7B 模型上验证,压缩收益是否随模型规模或基座家族变化未知;(4) judge 只复核置信度筛出的候选,若模型“高置信地冗余”(自信地空转),置信度信号可能漏检;(5) 代码迁移虽 AUC 全面领先,但 MBPP 等简单基准的压缩(↓36.3%)不及数学(↓44-45%),分布差距仍有影响;(6) 每个状态只取最短正确续写做 chosen,“略长但更稳健”的续写被忽略,在需要回溯的边界状态上可能教会模型过早收束。
独立分析的弱点
独立分析的几个弱点。(1) 第一级检测完全依赖 next-token 置信度,而 RL 训练的模型常“高置信地空转”(重复套话、模板化验证),此时 $c_i$ 高、$v_i$ 低,检测器会漏检——改进方向是融合 n-gram 重复度、相邻步语义相似度或多步熵变化等信号。(2) $\\delta=300$ token 的节省门槛与 $K=3$ 的每题上限是硬阈值:本身只有几百 token 推理的短题几乎无法产出偏好对,训练分布偏向长推理题,可按题目长度自适应设定 $\\delta$。(3) chosen 只取最短正确续写,忽略了续写间的可靠性差异,可对多条正确续写按长度-稳健性加权,或引入回溯代价估计以避免在边界状态教模型过早停笔。(4) DPO 存在压低 rejected 似然时拉低整体输出分布的已知偏置,论文未做长度归一化校准也未报告 rejected 侧 log 概率变化,可结合 length-normalized DPO 或 IPO 对比。(5) AIME 仅 30 题且 8 样本平均的方差较大(准确率 ±4.27),结论稳健性有限,建议扩大采样或合并多份 AIME 试卷交叉验证。
未来方向
作者承诺开源代码与模型(GitHub: MuyaoYuan/LoCo),并在结论中指出该范式可推广到更多域。基于成果可延伸的方向:(1) 把状态级 continue-or-conclude 信号从事后 DPO 前移到 RLVR 训练中,作为过程奖励,让模型在 rollout 时即时获得停止/继续的反馈;(2) 推广到开放式任务(写作、Agent 工具调用规划),核心挑战是替代符号等价的验证器,可尝试自一致性投票或 LLM-as-judge 评分构建弱验证;(3) 在线版本——推理时用置信度/波动率实时检测过度思考并触发早停或重生成,省去离线检测-训练循环,形成免训练的推理时压缩;(4) 在 32B/70B 蒸馏模型或 Qwen3 基座上验证缩放规律与阈值($q_{25}$/$q^{v}_{75}$)的迁移稳定性;(5) 与 CoT-Valve 类长度可控方法结合,学习“状态→应推理长度”的映射,按题分配计算预算;(6) 探索 judge 与被训练模型同源的完全自监督变体,消除对外部大模型的依赖。
复现评估
复现评估:论文承诺公开代码与模型(https://github.com/MuyaoYuan/LoCo),正文与附录给出完整超参、judge prompt 模板与评测指令,方法无黑箱。数据完全自生成:math14k(14,027 题)是 TokenSqueeze 公开的数学训练集;源轨迹需每题采样 3 条 rollout;检测阶段需要一次 vLLM 离线前向记录 top-1 logprob;judge 复核需部署 Qwen3-30B(vLLM 单卡 80G 或多卡量化均可);每个检测点采样 8 条续写并做 math_verify 校验。训练侧:LoRA rank 256、序列长 14,336、2 epoch,论文用 4 张 H20,A100/H100 x4 级别可行,消费级环境较难完整复现。评测需 vLLM 批量推理(8 样本 x 8 基准)加代码沙箱执行(MBPP 10s、LiveCodeBench 6s 超时,CodeContests 用 AlphaCode 判题协议)。总体复现难度中等:工程量大但每步文档清晰,主要风险是置信度分位数标定与 judge 行为的复现稳定性。
论文图表
五个数学基准(MATH-500/AMC23/Olympiad/AIME24/AIME25)上 Base、DAST、TokenSqueeze、LoCo 的准确率、平均 token 数与 AUC 及相对基线变化:LoCo 压缩 44.1%-45.4% 的同时准确率全部持平或提升(如 AIME24 54.17% vs 基线 50.83%),而 TokenSqueeze 压缩后准确率随难度下滑。
数学主实验的核心证据表,展示方法优势随基准难度递增而扩大的关键规律。