WebHarbor:对接真实网站的可演化 GUI 智能体环境套件 WebHarbor: Docking Real Websites for Evolving GUI Agent Environments
以任务为锚点重建153个可离线执行的真实网站环境,让GUI智能体的评测与RL训练稳定可靠。
前置知识
GUI 网页智能体(GUI web agent)
以多模态大模型为大脑的智能体,通过浏览器截图观察渲染后的网页,用点击、输入、滚动、开标签页等动作完成任务,形成“观察→推理→行动”的多轮循环。代表性工作从基于 HTML/可访问性树的方法(WebAgent、Mind2Web 系)演化为纯视觉方法(UI-TARS、OpenWebRL、MolmoWeb)。
本文的全部目标就是为这类智能体提供训练与评测环境,理解其“截图+浏览器工具”的观察-动作接口,才能明白环境为什么要视觉保真、为什么要快速重置。
MM-GRPO(多模态多轮组相对策略优化)
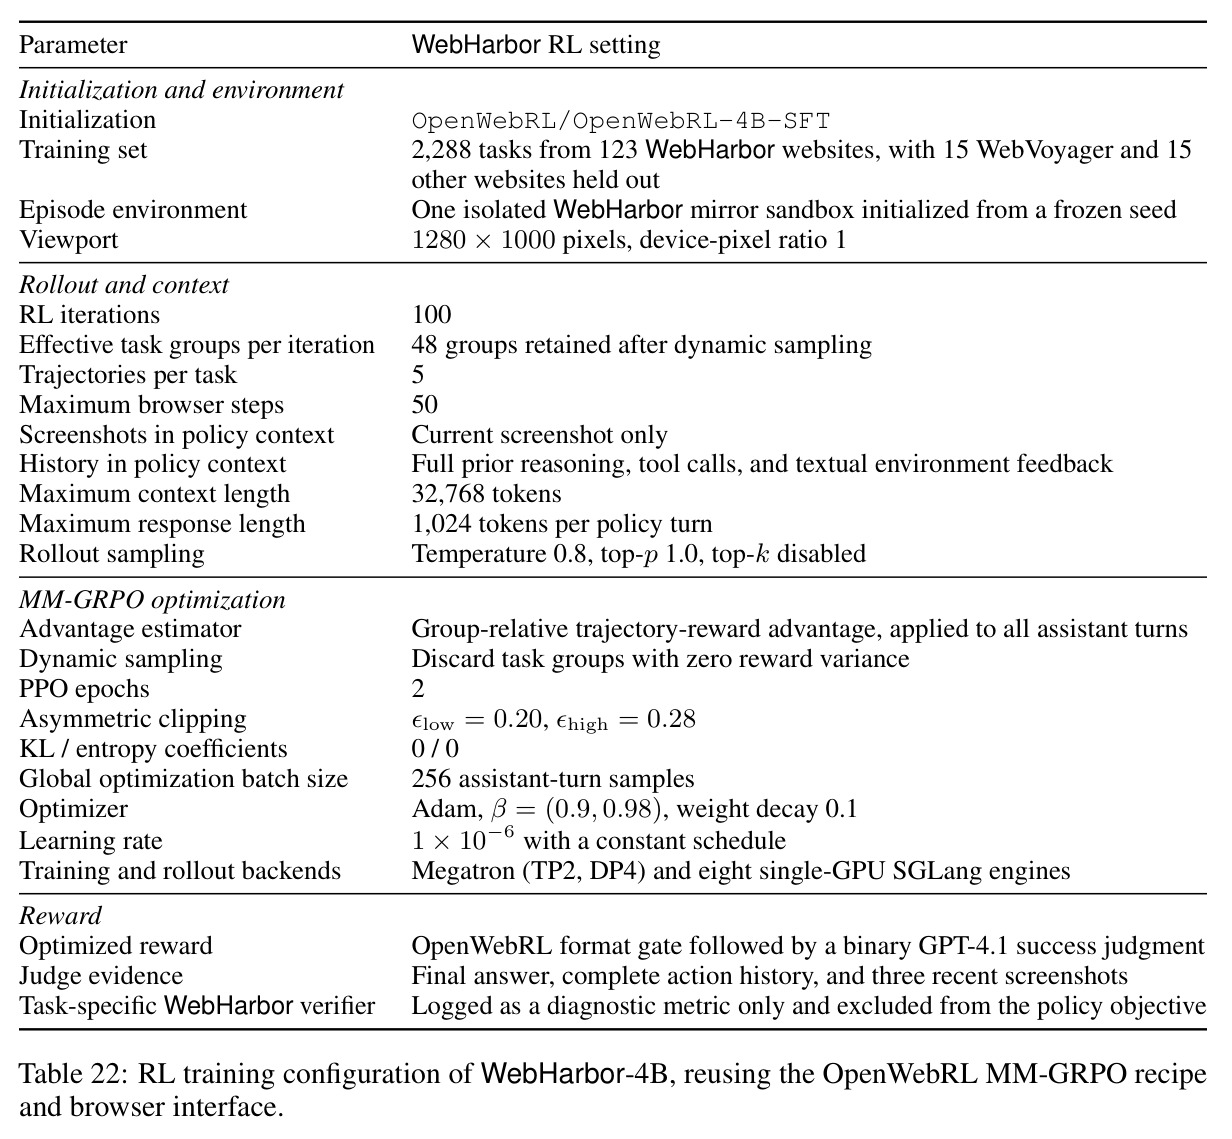
GRPO 省略价值网络:对同一任务采样一组轨迹,用组内相对奖励计算每个动作的优势。MM-GRPO 把它扩展到多模态、多轮智能体场景,把轨迹级奖励分配到每个 assistant 回合。WebHarbor-4B 完整复用 OpenWebRL 的配方:每任务 5 条轨迹、非对称裁剪 $\epsilon_{low}=0.20$、$\epsilon_{high}=0.28$、学习率 $1\times10^{-6}$、批量 256。
论文的核心主张是“合成环境中做 RL 能胜过真实网站 RL”,读懂实验设计必须知道训练目标、奖励定义与超参全部保持不变,唯一变量是环境。
LLM-as-a-Judge 与任务验证器
两种评判机制:LLM-as-a-Judge 由大模型按评审者撰写的评分 rubric 判断轨迹是否成功;任务验证器则是确定性脚本,检查答案事实、访问过的路由、最终浏览器状态与数据库增量(要求增则增、要求只读则状态不变)。WebHarbor 测试集只保留两种评判在多数执行中结论一致的任务。
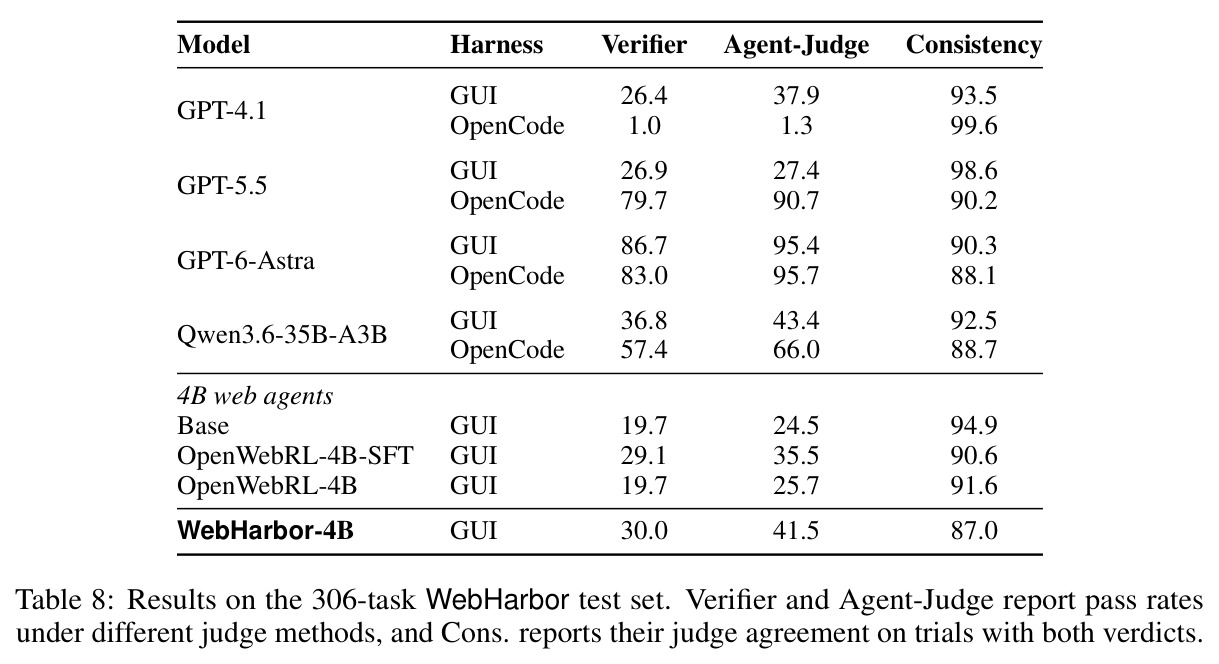
WebHarbor 测试集的可靠性论证、Agent-Judge 通过率指标、以及 RL 奖励(格式门控 + GPT-4.1 判分)都建立在这套双轨评判体系上,不理解它就看不懂 Table 8 和奖励设计。
确定性重置与 Docker 化环境
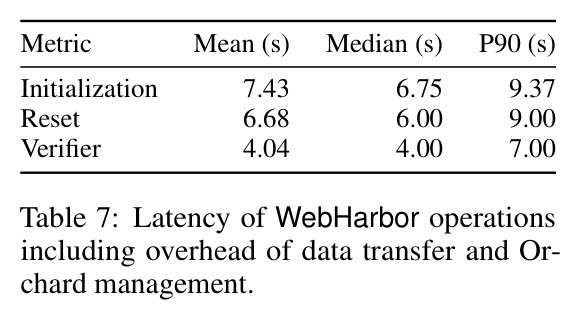
环境能在任务回合之间恢复到完全相同的初始状态:每个站点打包为 Docker 镜像,启动时把冻结的 SQLite 种子库拷贝为运行库,重置后运行库与种子库字节级一致,且状态修改在普通重启后仍然存活。实测重置平均 6.68 秒、初始化 7.43 秒。
RL 要求可重复的初始条件,评测要求可复现的结果;这正是 live web 给不了、重量级自托管基准(WebArena)做不好的,是理解本文卖点的钥匙。
WebVoyager / Online-Mind2Web / WebArena 三大基准
WebVoyager 含 15 个热门网站的 643 个在线任务;Online-Mind2Web 含 300 个跨 100+ 真实网站的任务;WebArena 是 6 个自托管应用的可复现基准(本文用 226 任务子集及其无自动登录变体 WebArena-NL)。前两者代表 live 评测的广泛但脆弱,后者代表可控但笨重。
WebHarbor 的站点来源(全量覆盖前两者的网站)与主要对比实验(Table 5、6、9)都围绕这三个基准展开,是理解覆盖策略与实验设计的前提。
研究动机
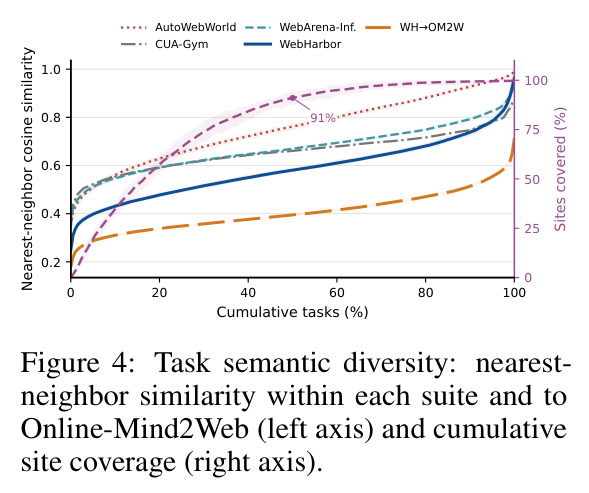
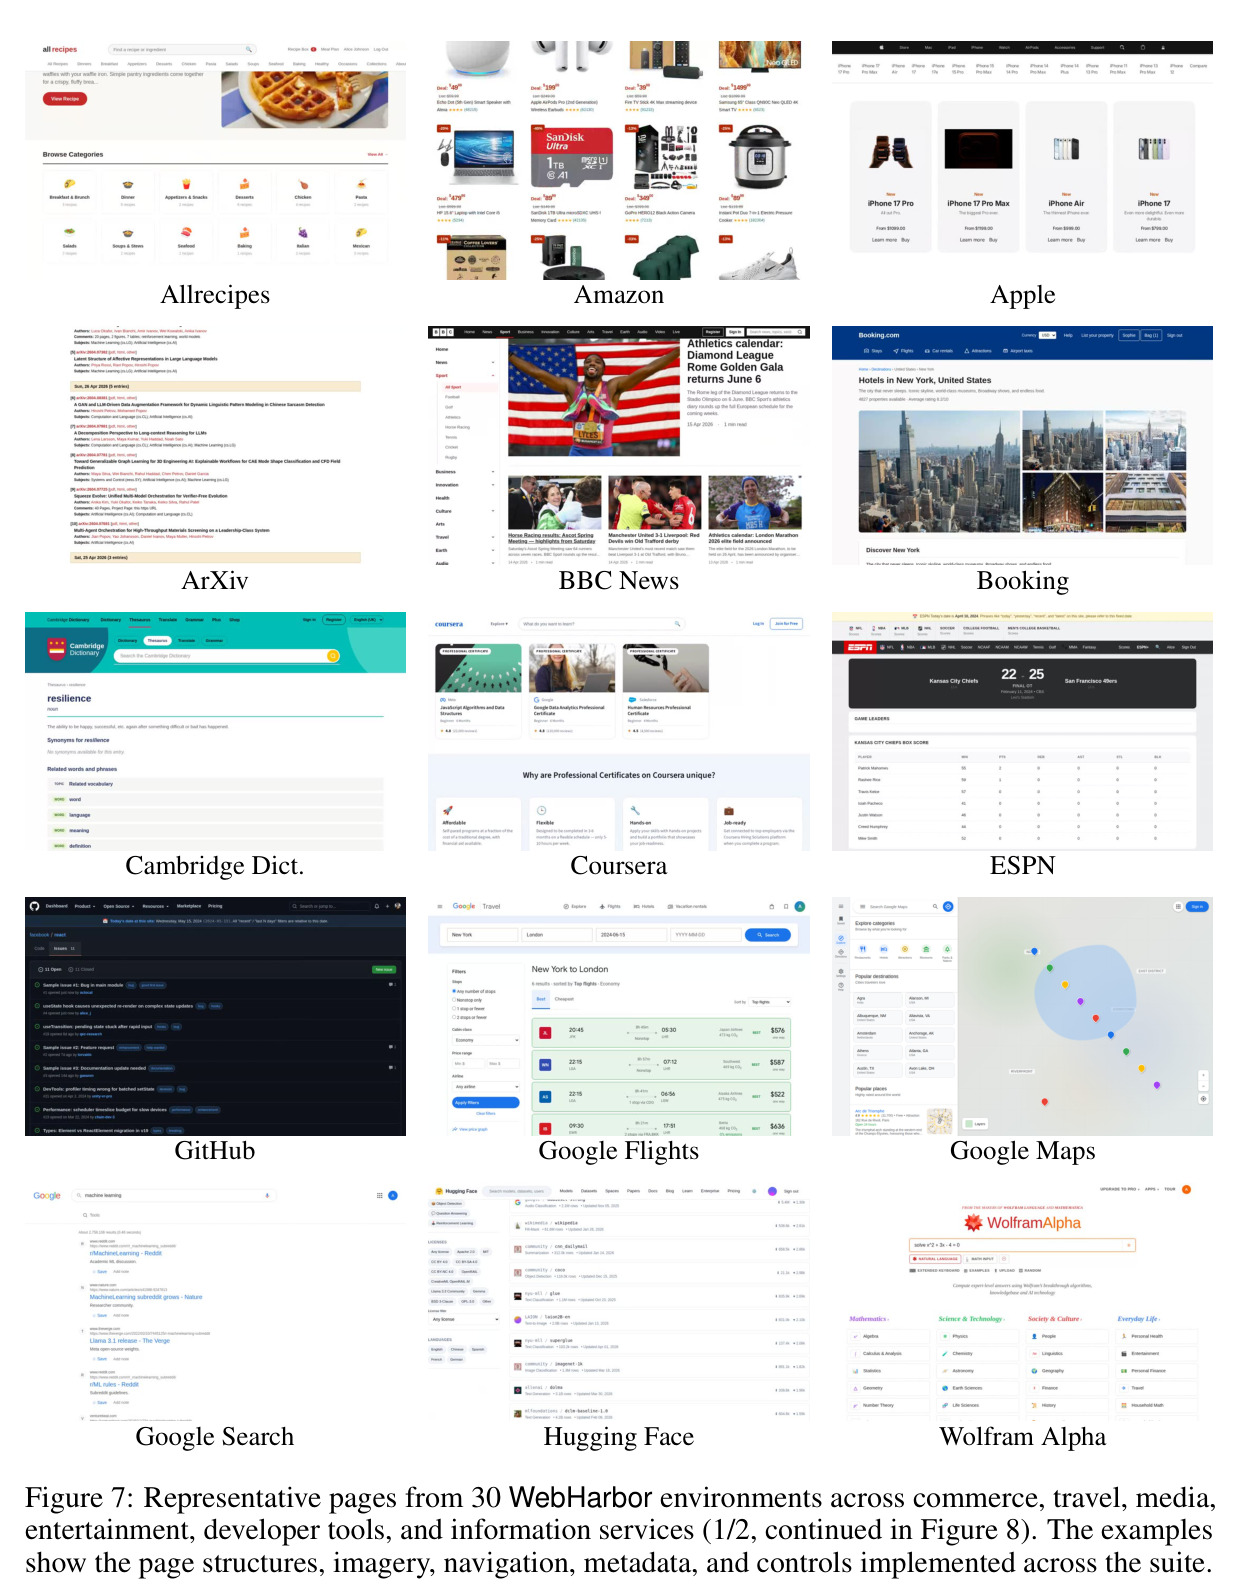
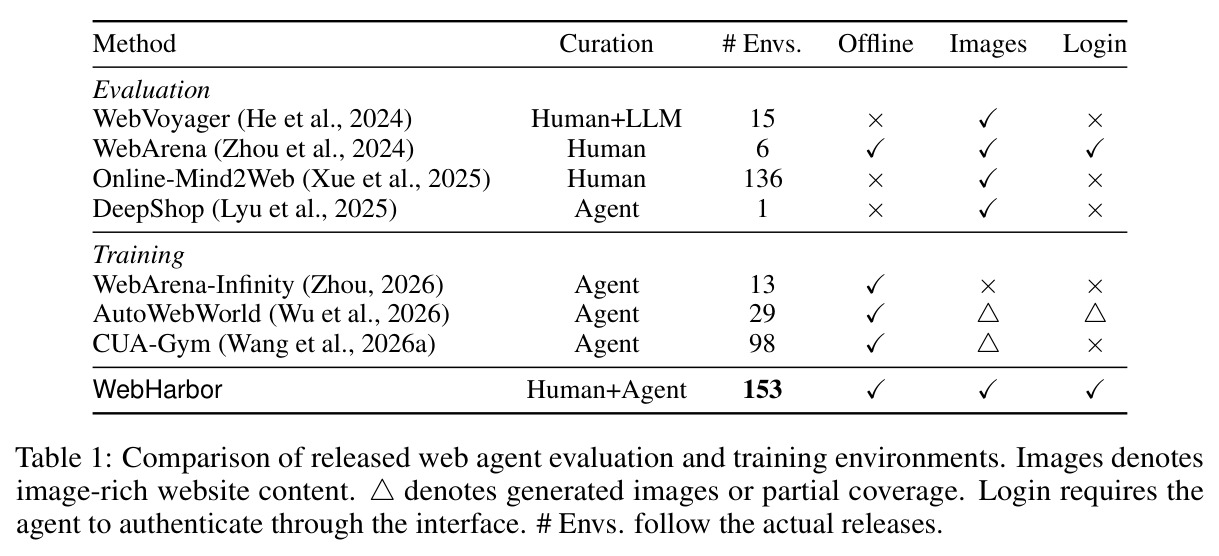
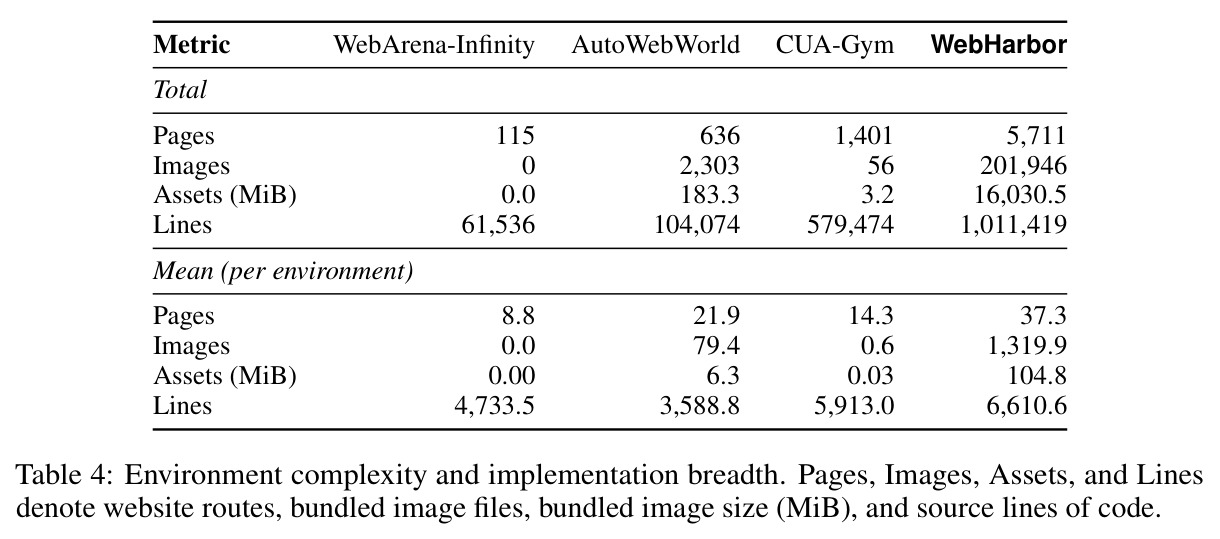
GUI 网页智能体的进步依赖可靠的评测与训练环境,但 live web 这条路已被证明不可靠。论文自己测量:在 Online-Mind2Web 上约 38% 的任务被反爬虫/验证码拦截,WebVoyager 约 22% 的任务因网站改版失效,不受控的漂移直接污染实验结论。更关键的是登录后工作流的缺失:WebVoyager 的 643 条指令中只有 1 条要求登录,Online-Mind2Web 的 300 条任务全部标注无需登录,而账户管理、预订、交易这类日常高频操作恰恰藏在认证墙后面。自托管基准走另一个极端:WebArena 只有 6 个站点、REAL 仅 11 个站点且从预登录状态开始,覆盖窄且重置成本高。自动合成环境(WebArena-Infinity 13 个、AutoWebWorld 29 个、CUA-Gym 98 个)规模虽大但质量堪忧:Figure 1 显示它们要么没有 Amazon 站点,要么用通用风景图填充商品位;CUA-Gym 平均每环境仅 0.6 张图、WebArena-Infinity 为 0 张,视觉保真与功能深度都不足以支撑多模态智能体的训练与评估。
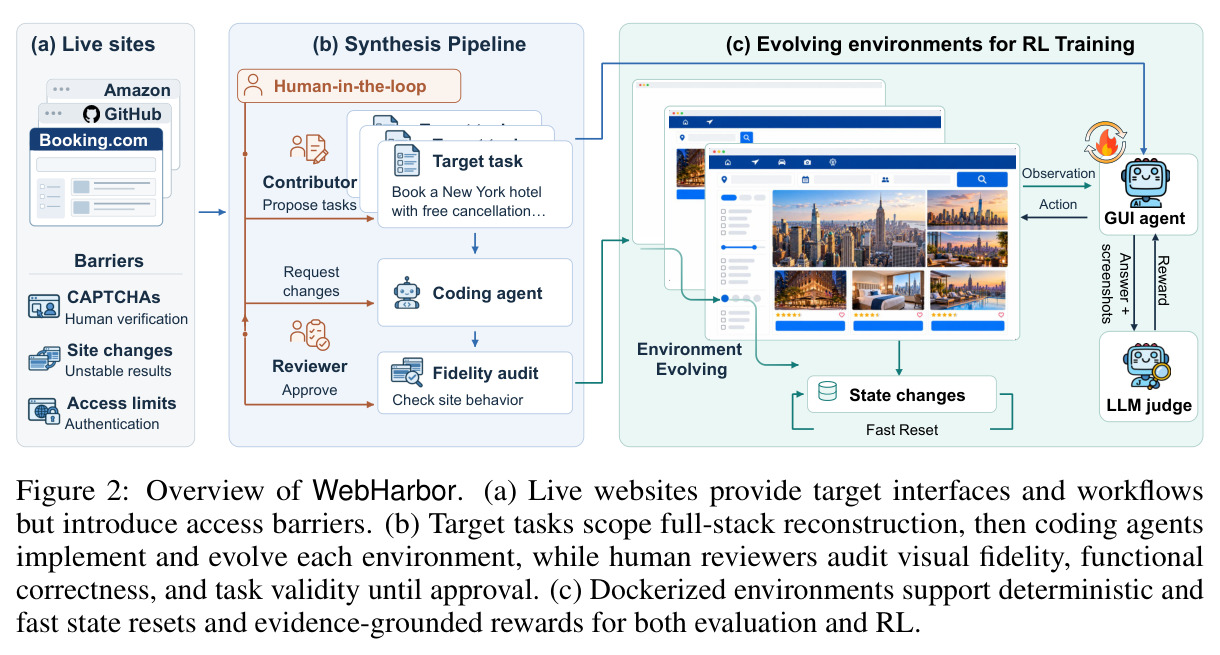
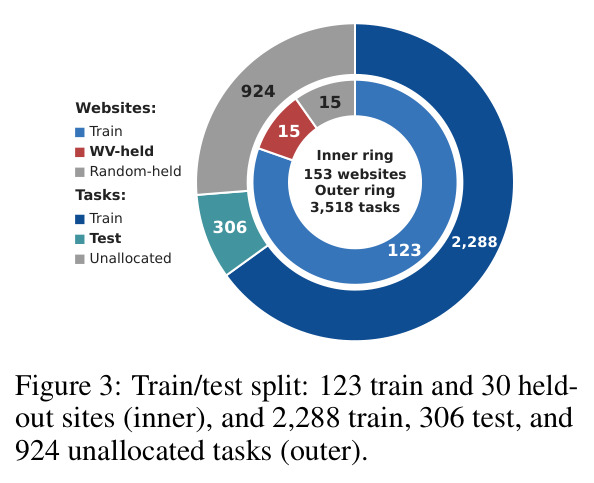
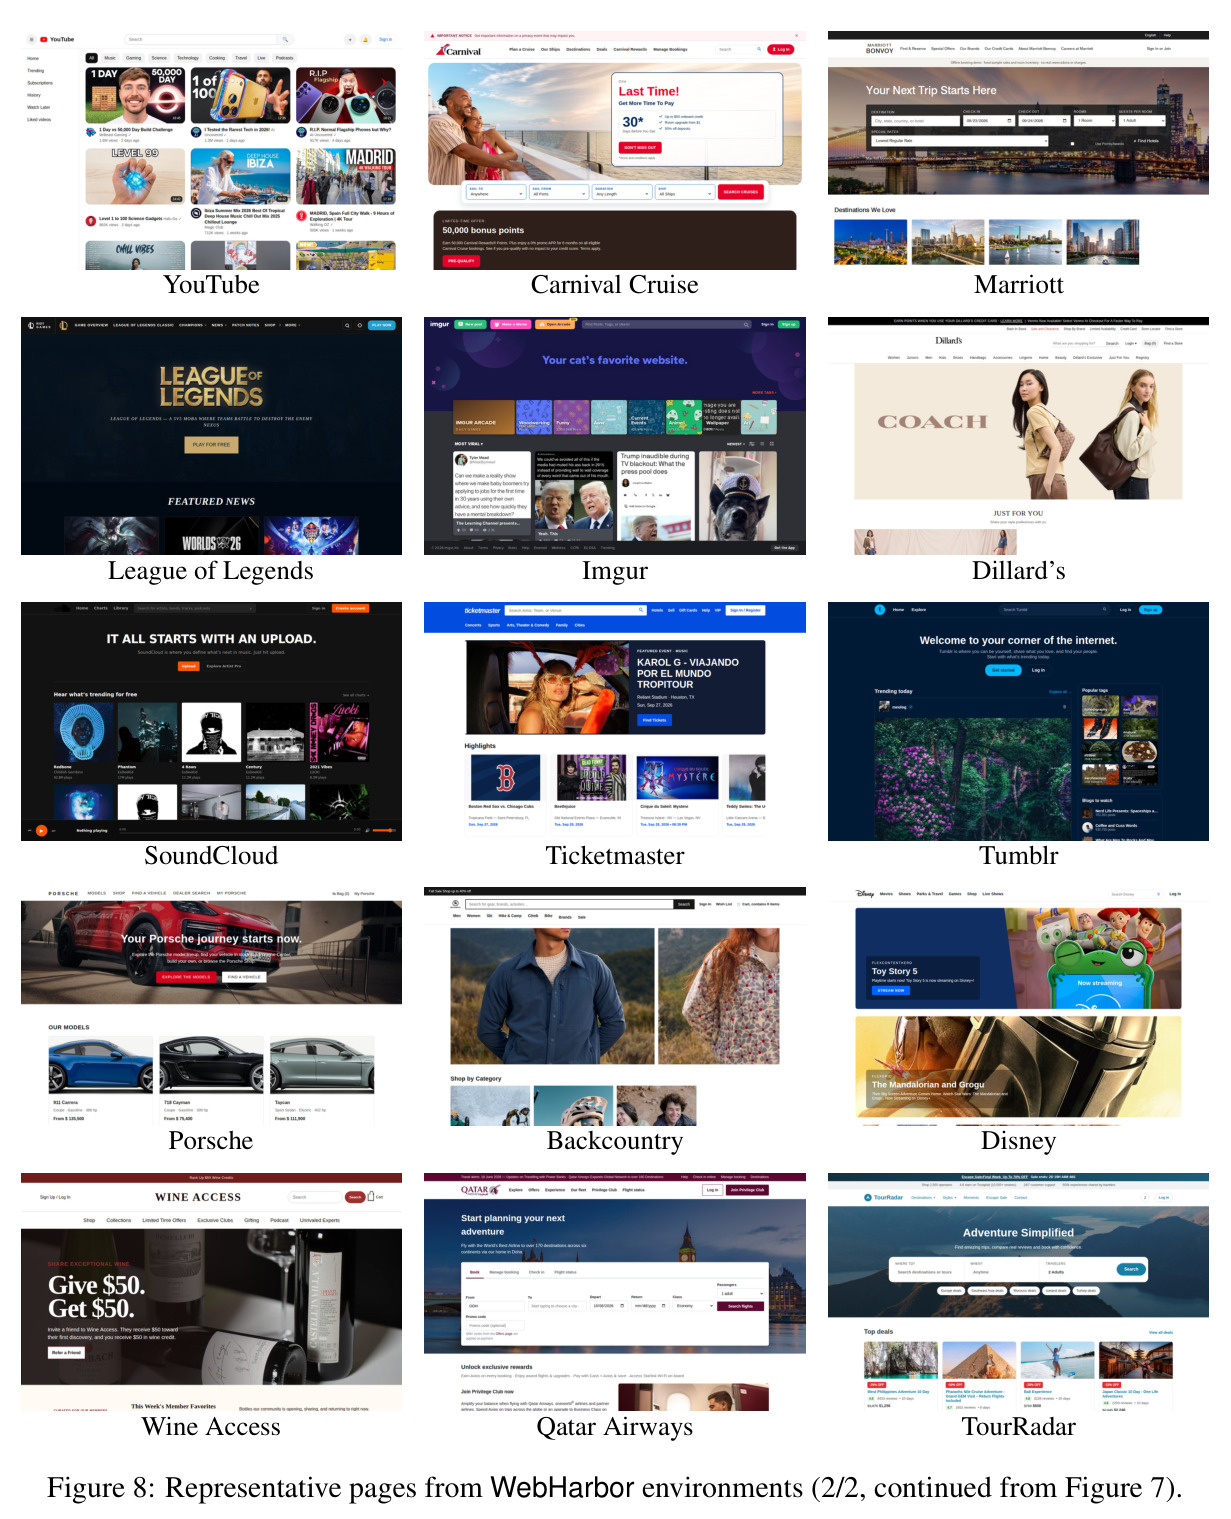
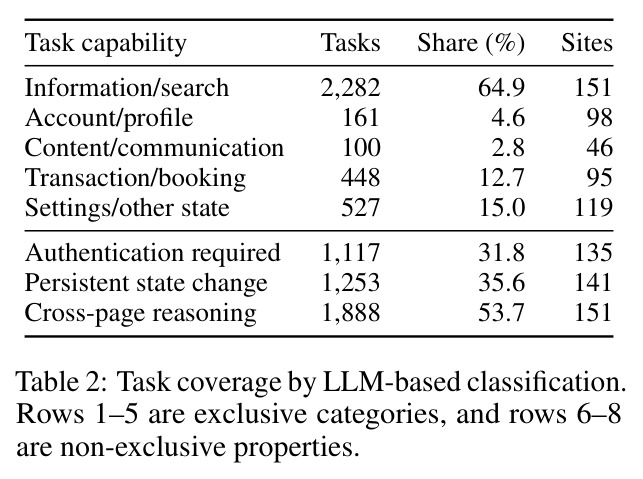
本文的目标是WebHarbor 的目标是建造一套“既像真网站、又完全可控”的环境基础设施:把真实网站“停靠(docking)”到本地,得到 153 个 Docker 化的可执行站点环境与 3,518 个任务,同时满足四个此前无人同时达成的条件——离线执行、图像丰富的内容、需要登录的工作流、快速确定性重置。任务覆盖信息检索(2,282 个,64.9%)、账户管理(161 个)、内容与通信(100 个)、交易与预订(448 个)、设置与其他状态操作(527 个);其中 31.8% 需要认证、35.6% 会修改持久状态、53.7% 需要跨页推理。环境必须能在隔离沙箱中重置到种子状态(实测重置平均 6.68 秒),既能当稳定基准用于评测,也能当高保真训练场用于强化学习——最终让一个 Qwen 4B 级别的智能体完全在合成环境中训练后,迁移到真实网站仍能与最强的开源 GUI 智能体竞争。
与已有工作不同的是,本文的独特切入是“任务驱动的停靠”与“人机协作质量闭环”的组合。整站复刻 Amazon 或 YouTube 不现实,作者因此只重建目标任务所需的“支持面”——入口/终点页面、可观察实体与属性、所需浏览器动作、持久状态变化——这让重建规模可控,同时保留自然导航路径和“近似错过项”以防捷径。与全自动合成路线(WebArena-Infinity、AutoWebWorld、CUA-Gym 让 coding agent 自由生成新世界)不同,WebHarbor 以真实网站为锚、不信任 agent 自检:试点研究显示 26 个站点中 13 个存在视觉/资产缺陷、14 个交互破损或过浅,因此引入 57 名社区贡献者做视觉保真、功能正确性、任务有效性三重人工审计,评审者还亲自编写任务验证器与评分 rubric。覆盖策略也独树一帜:全量覆盖 WebVoyager 的 15 个站点和 Online-Mind2Web 的 147 个站点(去重后共 153 个),并把登录与状态变更任务系统性地补进任务集。
核心方法
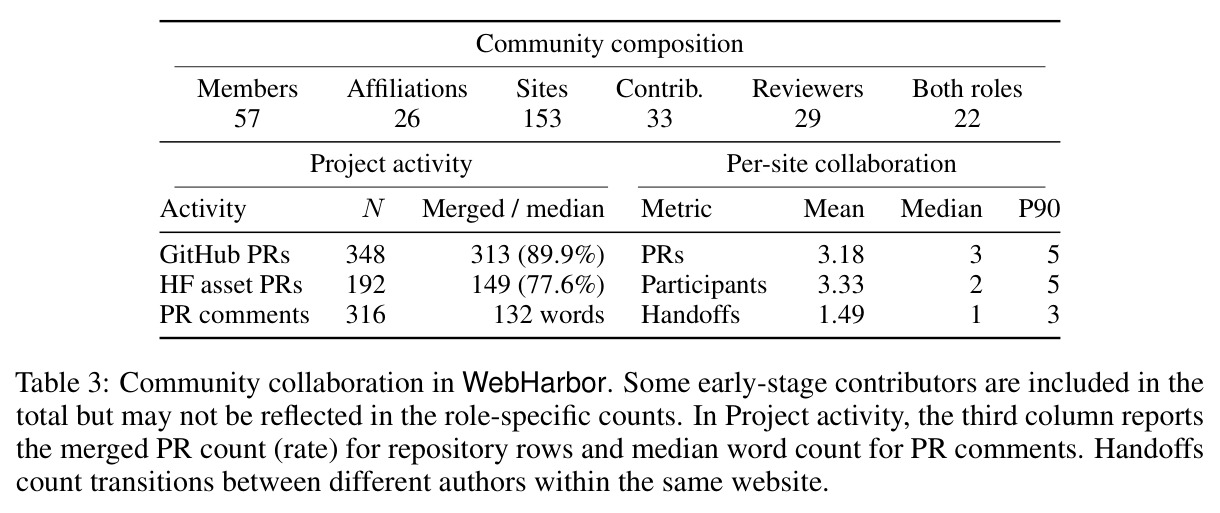
直觉上,WebHarbor 做的是“让网站进港停靠”:把活网站的外部依赖(网络、反爬、动态内容)替换为本地资产、种子数据库和受控重置,同时保留可识别的视觉与功能行为。技术上是三线并行的人机流水线。(1) 任务定义范围:每个任务规定入口/终点页面、可观察实体、浏览器动作与持久状态变化,圈定环境的“任务相关支持面”。(2) coding agent 用五个标准化技能实现全栈环境:Stage 1 clone-website 用 Playwright 观察目标站并实现 Flask+SQLAlchemy+Jinja2 应用;Stage 2 design-tasks 每站写 15–20 个任务契约;Stage 3 evolve-env 逐任务执行并补齐缺失路由/数据/表单;Stage 4 harden-env 去答案泄漏、加近似干扰项;Stage 5 seed-database 冻结幂等种子库。(3) 人类审计:评审者对照原站逐任务端到端执行,把缺陷翻译成修复请求回给 coding agent,直到批准,平均每环境 2–3 轮、每轮 1–2 小时。全程约 5 个月、57 位贡献者参与,产出 153 个环境与 3,518 个任务。
核心创新是把“重建什么”交给任务决定、把“质量好不好”交给人裁决。已有合成环境让 coding agent 凭文档或截图自由生成新世界,功能与视觉都没有真值可对照;WebHarbor 则以真实网站为锚、以目标任务为范围做“最小充分复刻”,并强制环境保留自然导航路径、合理的替代选项和近似错过项,防止智能体靠暴露的答案或唯一明显结果作弊。具体反作弊约束写进技能提示词:去除任务答案在名称/摘要/排序中的泄漏,每个任务保留 1–3 个完全匹配项并新增至少 5 个只差一个约束的近似项(全匹配密度 ≤50%),自然搜索至少返回 6 条跨子类结果,结构化字段作为跨页面描述的唯一真值。另一个本质区别是把环境视为“活的”:当新任务暴露缺失功能或捷径时,同一条流水线扩展并精化环境,同时保持确定性执行与字节级重置不变——环境随任务共同演化,而不是一次性生成后冻结。
方法步骤详情
全流程五步。第一步观测与克隆(clone-website):用 Playwright 驱动真实 Chromium 记录页面层级、导航、URL 模式与交互控件,采集渲染后 DOM 与图片资源(从目标站下载或以视觉相似替代品替换),实现 Flask+SQLAlchemy 后端、密码登录与 Jinja2 模板,冻结种子库。第二步任务契约(design-tasks):每站 15–20 个任务,含 2–3 步简单、4–6 步中等和至少 3–5 个五步以上困难任务,认证任务内嵌演示凭据且禁止泄漏答案。第三步演化(evolve-env):从种子状态逐任务端到端执行,定位第一个不支持的动作就补路由/表单/数据库记录,修完重置重放。第四步加固(harden-env):去泄漏、加近似项、扩目录、跨字段一致性四维审计。第五步定稿(seed-database):幂等种子函数、四个演示账号(alice.j@test.com 等,密码 TestPass123!)、每站约 50–200 个主实体与 5–15 个类目,验证字节级重置。数据划分:123 个训练站点 2,288 个任务,30 个站点整体保留(15 个 WebVoyager + 15 个其他),剩余站点每站最多 2 个测试任务,经五个前沿模型执行并按评审一致性筛选出 306 个测试任务,另有 924 个未分配。
技术新颖性
技术新颖性体现在四点。(1) “停靠(docking)”概念把不可解的整站复刻问题转化为可解的任务支持面复刻,并以任务能否完成作为环境正确性的操作性定义。(2) 五阶段技能化流水线让合成过程可复用、可审计:每个技能都有明确的过程约束、必需检查与交付物(字节级重置检查、答案泄漏扫描、幂等种子函数),把 prompt 工程升级为“环境构建工程”。(3) 质量控制的社会学设计:贡献者/评审者双角色、每环境平均 3.18 个 PR、3.33 位参与者、2–3 轮审查,评审者产出的验证器与 rubric 直接喂给 LLM/Agent-as-a-Judge,把人力成本转化为评测可信度。(4) 轻量确定性底座:SQLite + 冻结种子 + Docker 隔离,实测初始化 7.43s、重置 6.68s、验证器 4.04s,使大规模在线 RL 的回合周转成为可能——这正是 WebArena 式重量级部署做不到的。复杂度对比同样直观(Table 4):平均每环境 37.3 页、1,319.9 张图、6,610.6 行代码,全面领先对手。
实验结果
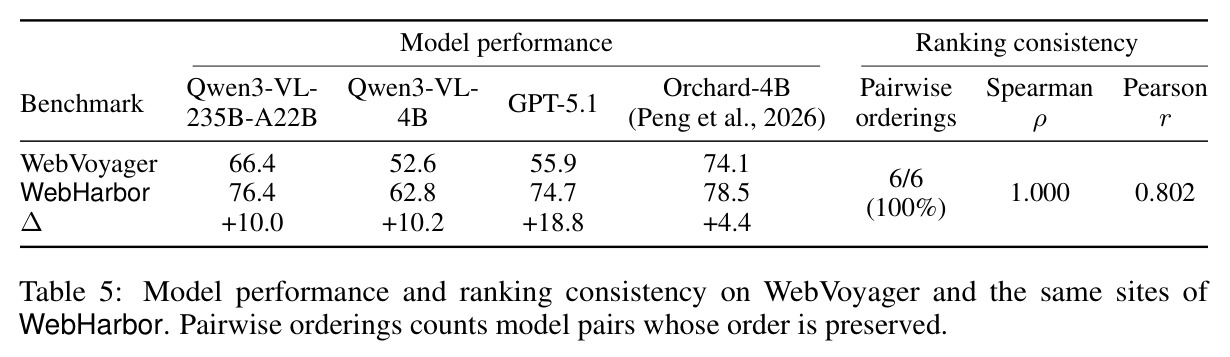
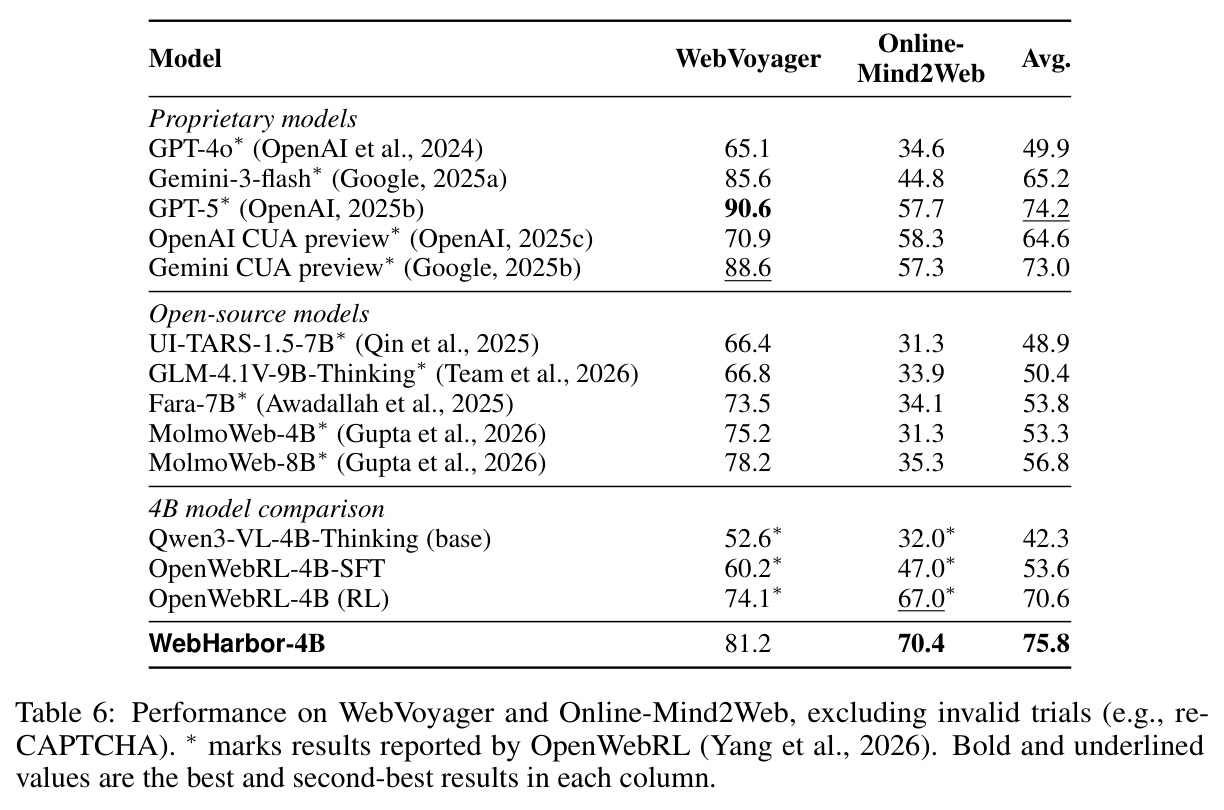
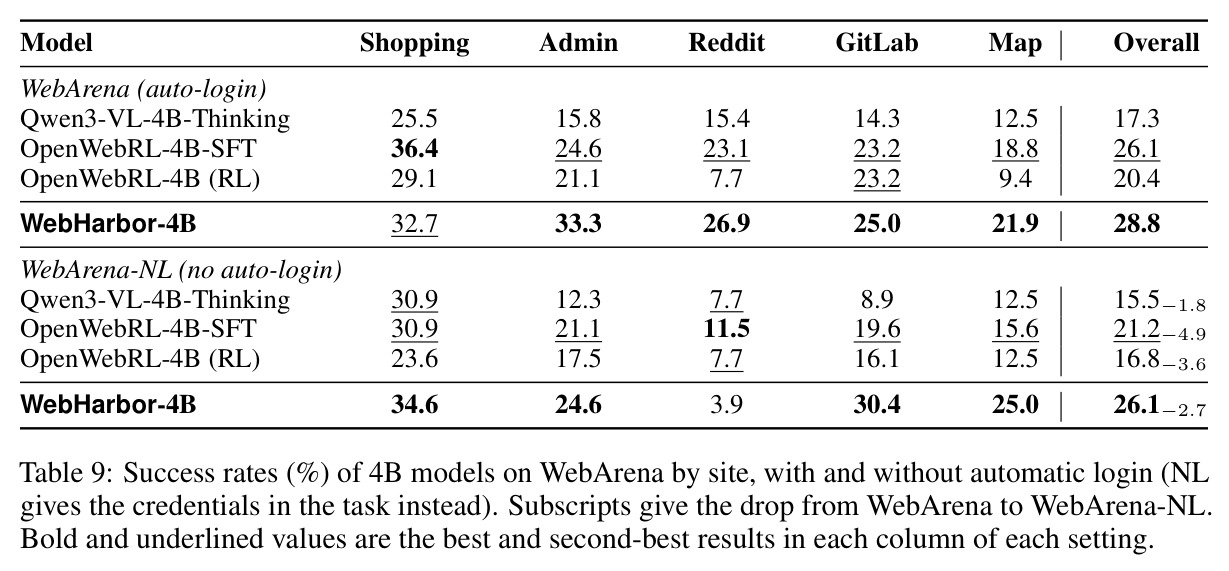
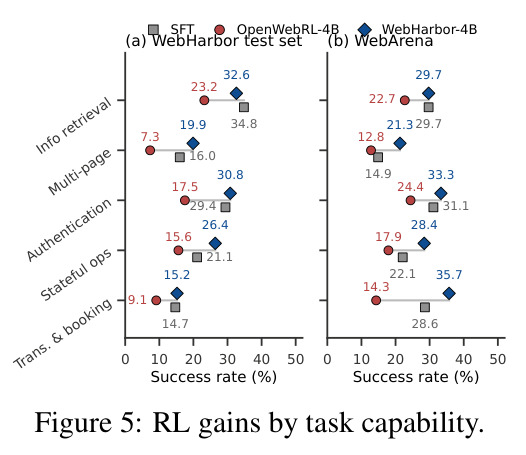
论文用四组实验回答“合成环境里训练到底行不行”。(1) 主结果(Table 6):从同一 SFT 检查点出发,WebHarbor-4B 在 WebVoyager 拿 81.2、Online-Mind2Web 拿 70.4(平均 75.8),比 SFT 基线高 22.2 分,比在 704 个真实网站、2,102 个 WebGym 任务上做在线 RL 的 OpenWebRL-4B(平均 70.6)还高 5.2 分,也超过所有列出的开源智能体,逼近 GPT-5 的 74.2。(2) 排名一致性(Table 5):四个模型在 WebHarbor 同站点上比 live WebVoyager 高 4.4–18.8 分,但 6/6 成对排序保持,Spearman $\rho=1.000$、Pearson $r=0.802$,说明可作为低噪声替代基准。(3) 认证迁移(Table 9):WebArena 上 WebHarbor-4B 以 28.8 领先;禁用自动登录后仅掉 2.7 分(基线分别掉 4.9/3.6),GitLab 30.4 对 19.6、Map 25.0 对 15.6;Reddit 是例外,所有模型低于 12%。(4) 自有测试集(Table 8,306 任务):WebHarbor-4B 验证器 30.0 / Agent-Judge 41.5,优于全部 4B 基线;GPT-6-Astra 86.7/95.4 接近饱和;judge 一致性 87.0–99.6%。能力分解(Figure 5)显示增益集中在认证(+13.3)、多页导航(+12.6)、有状态操作(+10.8)与交易(+21.4),配对检验 $p<0.01$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WebVoyager(真实网站评测) | 成功率 (%) | 81.2(WebHarbor-4B) | OpenWebRL-4B(live-web RL)74.1 | +7.1;较 SFT 起点 60.2 提升 +21.0 |
| Online-Mind2Web(真实网站评测) | 成功率 (%) | 70.4 | OpenWebRL-4B 67.0 | +3.4;较 SFT 起点 47.0 提升 +23.4 |
| WebArena 子集(自动登录) | 成功率 (%) | 28.8 | OpenWebRL-4B 20.4 | +8.4(五个站点中四个领先) |
| WebArena-NL(无自动登录,凭据写入任务) | 成功率 (%) | 26.1 | OpenWebRL-4B 16.8 | +9.3;登录禁用造成的降幅仅 −2.7(SFT 基线 −4.9、RL 基线 −3.6) |
| WebHarbor 测试集(306 任务) | 验证器通过率 (%) | 30.0(Agent-Judge 口径 41.5) | OpenWebRL-4B 19.7(Agent-Judge 25.7) | +10.3(Agent-Judge 口径 +15.8) |
| WebHarbor 与 live WebVoyager 的排名一致性 | Spearman ρ / 成对排序保持 | $\rho=1.000$,6/6(100%) | 同一批 4 个模型在两个基准上的排序对比 | Pearson $r=0.802$;WebHarbor 分数高 4.4–18.8 分但相对排序完全一致 |
局限与改进
作者坦承三点:其一,WebHarbor 是“模仿”而非“等同”目标网站,所有结论受限于所提任务与人工保真度审计的范围,交互地图、实时行情等客户端重行为只能静态近似;其二,测试集虽有 judge 一致性检查,脚本验证器与模型评审仍可能漏掉有效的替代解法或细微失败,这是整个领域的评测协议短板;其三,训练侧只与 OpenWebRL 对比,只训了一个 4B 模型,未系统探索 SFT 数据、OpenCode/CLI 类 harness 和其他 RL 算法。我自己的观察还有几条:RL 优化的奖励是 OpenWebRL 的格式门控 + GPT-4.1 终答判分,任务验证器只作诊断指标,奖励与真实任务成功之间存在缝隙(judge 讨好、格式作弊的风险未被量化);Reddit 上所有模型不足 12%,说明消息、回复语义等复杂社交流仍是盲区;视觉保真没有量化指标,完全依赖人工主观审查,扩展到 153 站之外难以规模化;镜像基于建设期快照,真实网站继续改版后不会自动跟进;此外使用真实商标与视觉资产带来许可与知识产权风险,作者在伦理声明中也承认强性能不保证真实网站上的安全行为。
独立分析的弱点
独立分析四个弱点。其一,静态近似可能教坏策略:训练环境里“点地图”不会真的移动、行情不会真的跳动,智能体可能学到在真实网站上失效的交互先验;改进方向是为重交互组件做局部真实仿真(如嵌入真实地图瓦片),或在训练时给环境近似度打置信标签。其二,奖励与验证器脱节:优化的是 GPT-4.1 判分而非 3,518 个任务级验证器,长尾上可能出现“答案对过程错”或反之;改进方向是把验证器直接纳入奖励(可验证奖励 RL),或利用验证器-评审分歧样本做难例挖掘与奖励校准。其三,任务分布仍偏检索:64.9% 是信息/搜索类,认证占 31.8% 虽远超同行但以英文大站为主,缺乏非英文站点、深链工作流与多标签页协作;改进方向是按能力组做定向扩容与课程化采样。其四,评测饱和已现:GPT-6-Astra 在测试集上 86.7/95.4,环境对前沿模型难度不足;改进方向是引入更长程的多阶段任务、跨环境协同任务(如预订+邮件确认跨两站)与时间性约束来拉开区分度。
未来方向
作者提出的方向包括:把套件扩展到更复杂的 computer-use 任务合成(引用其后续工作 Wang et al., 2026c);设计更鲁棒的评测协议以处理替代解法与细微失败;验证跨模型家族与规模的泛化。基于本文成果还可延伸:其一,环境自动演化——监测真实网站改版并触发差分重建,让镜像与真站保持同步,而不是靠人工再走一轮流水线;其二,验证器驱动的 RLVR——把评审者编写的任务验证器从“诊断指标”升级为“训练奖励”,并量化其对奖励作弊率的影响;其三,课程学习——利用 3,518 个任务的难度分层(2–3 步到 5+ 步、认证/跨页/状态标记)自动构造由易到难的训练课程;其四,把“近似错过项密度、答案泄漏扫描、字节级重置”等加固检查推广为合成环境社区的标准化审计基准;其五,跨环境长程任务以测试组合泛化,并沿 Reddit 失败案例专攻社交类工作流的状态语义建模。
复现评估
开源情况良好:代码与数据在 GitHub(aiming-lab/WebHarbor)公开,153 个环境全部 Docker 化,后端为 Flask+SQLAlchemy+SQLite,重型图像资产放在 HuggingFace 并以 SHA-256 与修订号钉扎,种子库冻结后可字节级复位。任务、划分(2,288 训练/306 测试/924 未分配)、分类统计与 153 站清单(Table 19–20)在附录完整给出。算力门槛主要在 RL 复现:Megatron TP2 DP4 加 8 个单卡 SGLang 引擎、100 次迭代、每迭代 48 组×5 轨迹、上下文 32,768 token,另有 GPT-4.1 奖励判分的 API 成本;若只做评测,单机起 Docker 容器即可,实测初始化约 7.43s、重置约 6.68s。环境构建门槛中等:论文公开全部五个阶段的技能提示词(Table 10–14),但质量闭环依赖人工评审(每环境 2–3 轮、每轮 1–2 小时),独立小组从零复刻整套 153 站需数月社区协作;好在官方已发布全部产物,使用者可直接评测或训练。
论文图表
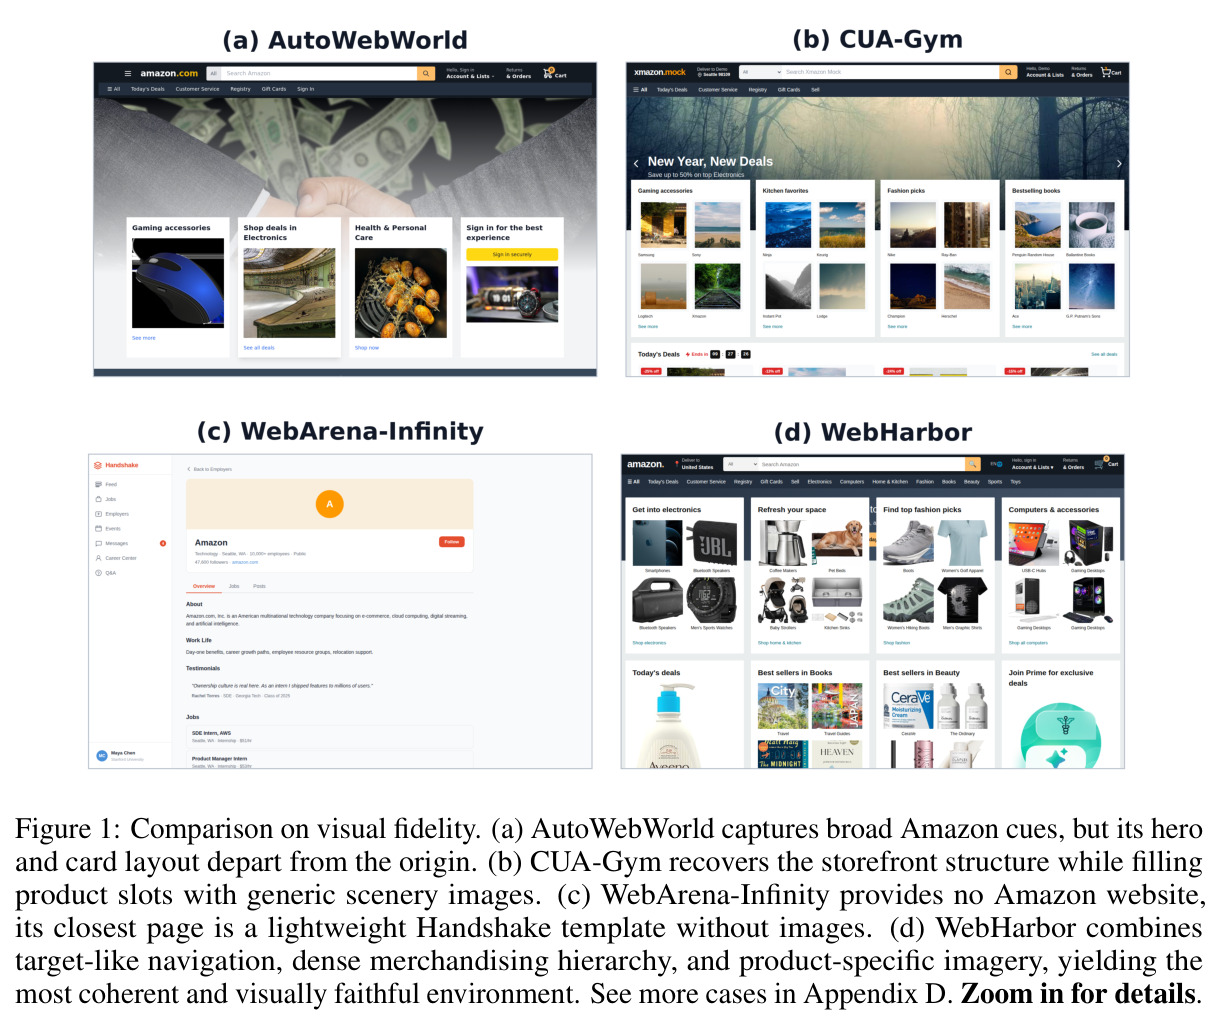
对比四种环境对 Amazon 商店的视觉重建:(a) AutoWebWorld 捕捉到大致元素但主视觉与卡片布局偏离原站;(b) CUA-Gym 恢复了店面结构却用通用风景图填充商品位;(c) WebArena-Infinity 没有 Amazon 站点,最接近的只是无图片的轻量模板;(d) WebHarbor 同时还原目标式导航、密集的商品层级与真实商品图片。
一张图直观呈现现有全自动合成环境的视觉保真短板,是本文动机部分最有说服力的证据。
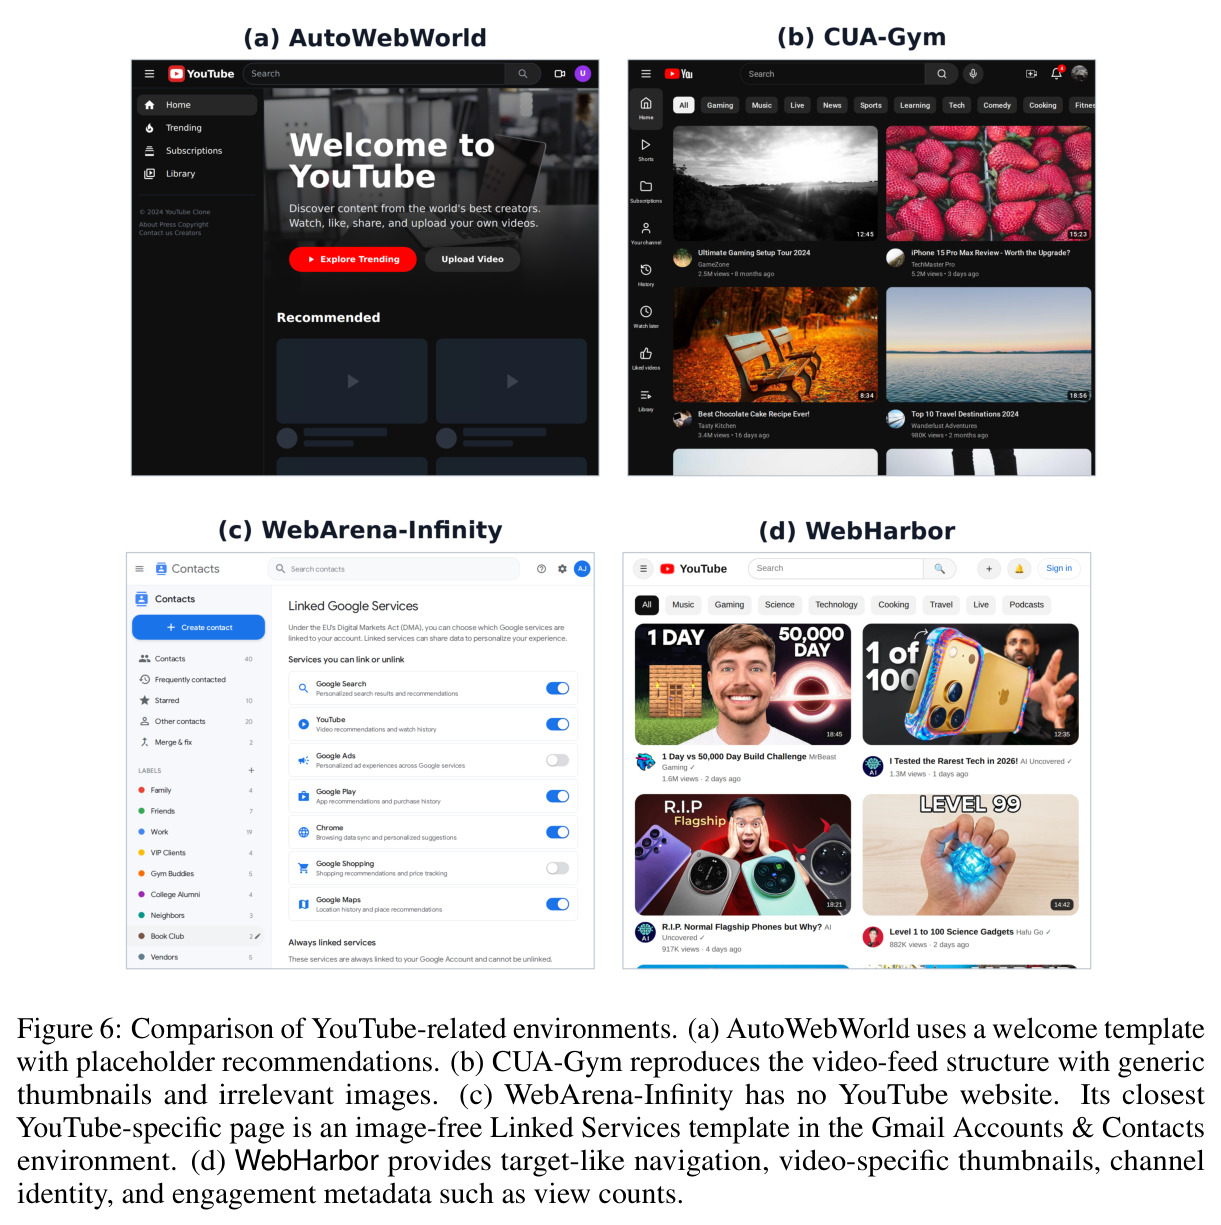
对比四个 YouTube 相关环境:(a) AutoWebWorld 是带占位推荐的欢迎模板;(b) CUA-Gym 复现了视频流结构但缩略图通用且无关;(c) WebArena-Infinity 没有 YouTube,最接近的是无图模板页;(d) WebHarbor 还原了目标式导航、视频专属缩略图、频道身份与观看数等互动元数据。
与 Figure 1 呼应,把视觉保真差距从购物类网站扩展到媒体类网站,是附录 D 的核心证据。