WebFovea:视觉网页智能体的四阶段可靠往返架构 WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
把网页智能体每步视为解析-执行-反馈-观察四阶段往返并加固,得分从31升至57
前置知识
视觉型网页智能体(Vision-based Web Agent)
只通过页面截图观察环境、用像素坐标发出点击/滚动/输入等动作的智能体,模型不接收 DOM 或无障碍树。与之相对的是 DOM 型智能体(如 Browser Use、Agent-E),它们把页面序列化为带索引的元素列表再决策。
WebFovea 是纯视觉方案,坐标如何换算、截图里有什么信息能到达模型,直接决定了论文中执行与观察两个阶段的全部设计。
Chrome DevTools Protocol(CDP)
Chrome 浏览器提供的调试协议,允许外部程序驱动浏览器:导航、注入输入事件、读取 DOM、截图等。harness 通过 CDP 把模型的动作翻译成真实浏览器操作,并在 1920×1080 视口下运行。
论文中执行器的一切行为(点击、iframe 内派发 DOM 事件、指纹采集)都通过 CDP 实现,理解它是理解 harness 与页面边界的前提。
聊天模板特殊 token(chat-template special tokens)
如 <|eot_id|>、<|end_of_turn|> 这类标记对话轮次结束的特殊符号。模型有时会在自由文本输出中模仿上下文里见过的模板语法(如 <|box_start|>)自行生成它们,污染下游解析。
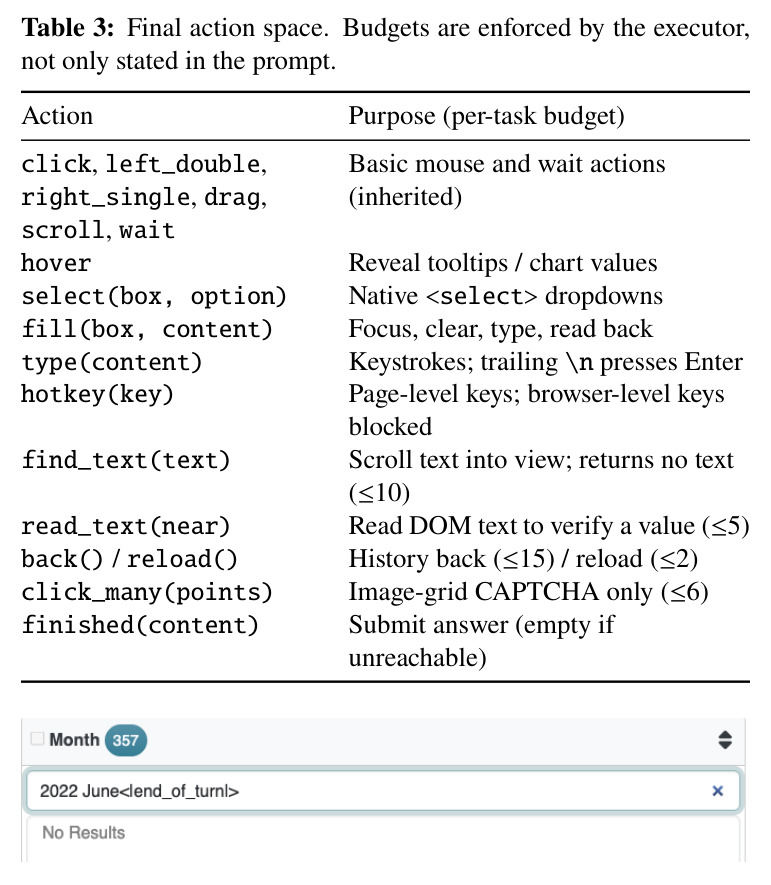
论文发现 4.9% 的任务回合被这类自生成 token 污染——它们被原样敲进搜索框导致查询失败,是解析阶段修复(token 剥离)的直接动机。
坐标 grounding 与 smart_resize
视觉智能体输出的坐标需要从'模型看到的图像空间'换算到'真实页面像素空间'。UI-TARS 的 smart_resize 约定基于 28 像素 patch 网格缩放图像;若 API 在幕后又私自降采样截图,这两层换算就会错位。
本文最核心的发现之一:API 把 1920×1080 截图降采样到约 1440×810,导致全部 1,312 次点击落在目标 3/4 处。不理解坐标空间错配就读不懂坐标对齐这一关键修复。
WebRetriever 基准与 Protocol III
在 800 个真实在线网站、1,550 个任务上评测网页智能体的大规模基准,分三个协议,其中 Protocol III 是端到端检索:从入口 URL 出发、只操作网站自身界面、返回可精确核验的单一答案,答案正确性与轨迹合规共同计分。
这是论文的全部实验舞台:四支官方提交在 100 个隐藏任务上评分,公开的 100 个任务被划分为 dev70/holdout30 用于本地开发与配对实验。
DOM 指纹(DOM fingerprint)
在动作前后各记录一次页面的结构性摘要(URL、标题、节点数、文本长度、滚动偏移、焦点)并对比,用于判断动作是否真的改变了页面。相比像素 diff,它不会被走动的时钟或轮播图欺骗。
反馈阶段的核心机制:把'实际发生了什么'如实上报给模型。子框架指纹、文本哈希等精化都是围绕它展开的,也是理解阴性结果(反馈不改行为)的关键。
研究动机
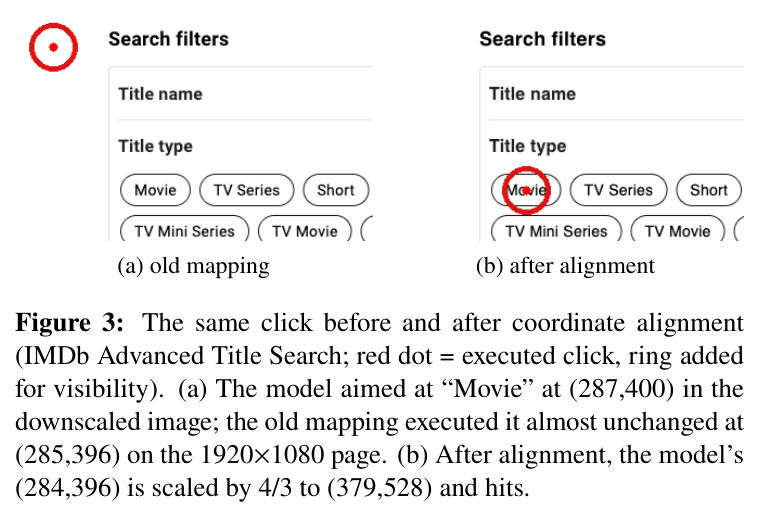
视觉型网页智能体在真实网站上频繁失败,且失败常被误诊为模型推理错误。WebRetriever 基准(800 个真实在线网站、1,550 个任务)已指出导航成功不足以预测任务完成。作者在开发中量化了一连串与模型能力无关的故障:由于模型 API 在幕后把 1920×1080 截图降采样到约 1440×810,而执行器按全分辨率解读坐标,1,312 次点击全部落在目标约 3/4 的位置,无一越过 $x=1440$ 或 $y=810$,两次独立任务实测偏差比恒为 4/3;模型偶尔自生成 <|eot_id|> 等聊天模板特殊 token,被原样敲进搜索框,污染了 305 个本地回合中的 15 个(4.9%),这些回合成功率仅 7.7%,远低于干净回合的 41.7%;原生 下拉点击九次仍打不开,iframe 内的点击被静默吞掉,提示词承诺的回车键从未真正按下,某次 CAPTCHA 后模型甚至凭参数记忆编造了完整轨迹并在第 1 步就提交了答案。这些故障表面上像'模型点错了地方',实际全部发生在模型与浏览器之间的 harness 上。
本文的目标是本文的目标是证明:在不更换模型的前提下(比赛限定核准模型列表,作者全程使用 claude-opus-4-6),仅通过加固模型与浏览器之间的执行框架,就能让视觉型网页智能体在 WebRetriever Challenge 2026 的 Protocol III 端到端检索赛道上取得高分,且全程合规——不许绕过界面、不许预存或缓存答案、答案必须来自本次会话在指定网站上看到的页面。具体目标包括:把每一步失败可靠地定位到解析、执行、反馈、观察四个阶段之一并给出对应修复;为每项改动提供配对实验或离线重放证据(包括阴性结果);在七天窗口、每日一次官方评测的限制内把隐藏集分数从 31.0 提升到 57.0,并保证组织方人工审查零扣分。
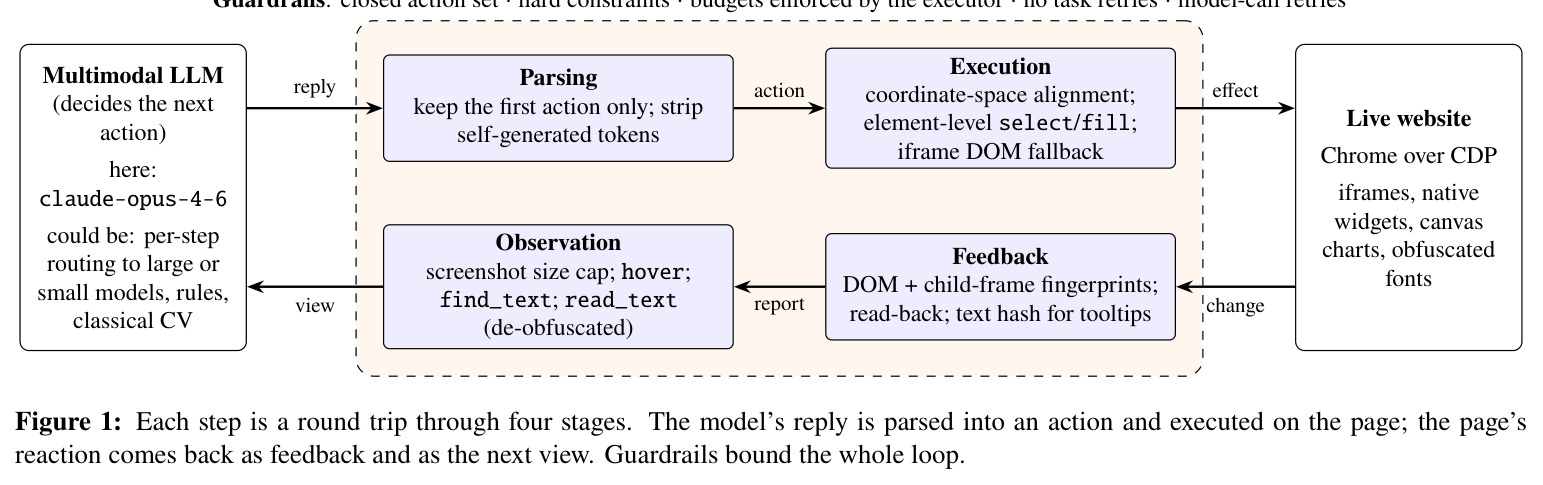
与已有工作不同的是,已有工作要么改进模型本身(UI-TARS 端到端训练、SeeClick 证明更好的 GUI 定位有帮助),要么改变页面表示(Browser Use、Agent-E 的 DOM 蒸馏与观察变化,Set-of-Mark 在截图上叠加元素标注),而本文的独特切入点是模型与环境接口的可靠性。作者把每一步建模为四阶段往返(round trip):模型回复被解析为动作、动作在页面上执行、页面反应被如实上报为反馈、下一个视图向模型呈现所需信息,护栏(guardrails)环绕整个循环。这一视角承袭 SWE-agent 的'智能体-计算机接口'思想,但首次把它具体化为视觉网页智能体的诊断清单——任何失败先问坏在哪一阶段。由于四支官方提交使用同一模型,31.0 到 57.0 的提升可完全归因于 harness,为'接口质量决定成败'提供了少见的受控证据。
核心方法
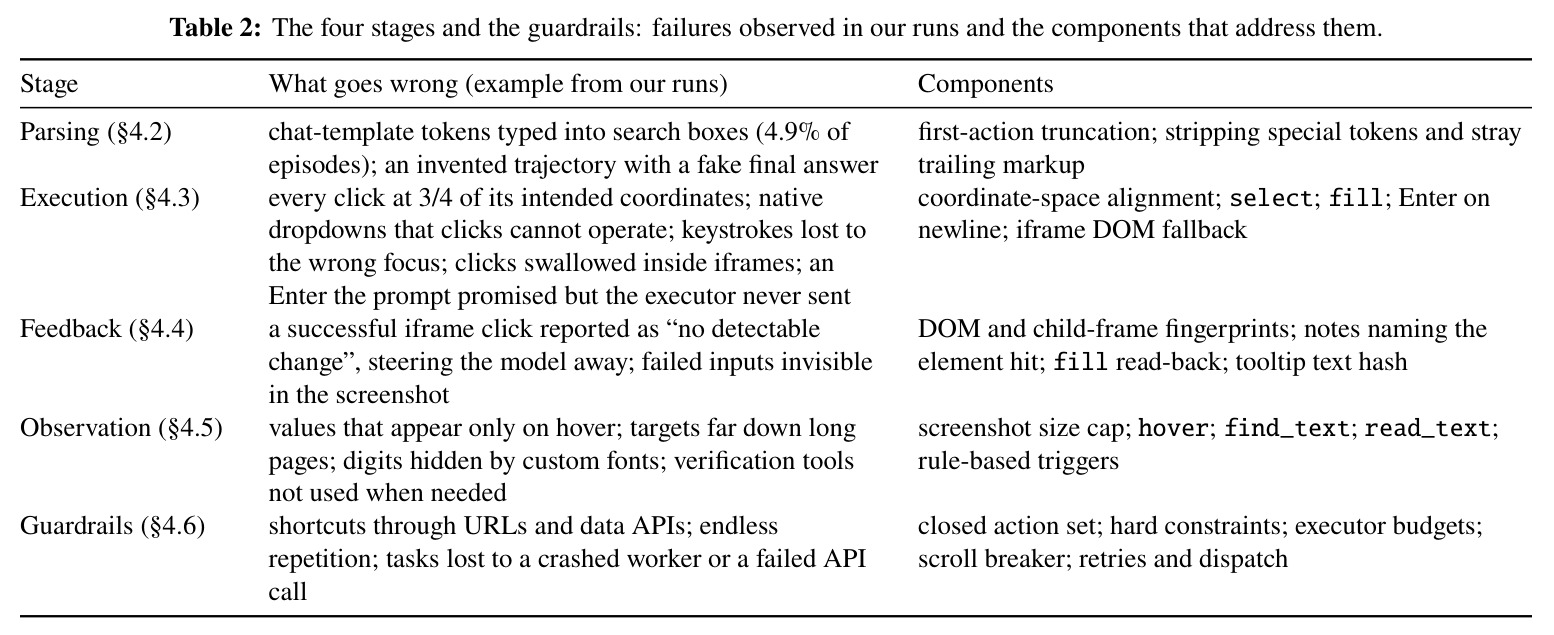
WebFovea 建在组织方给所有队伍的参考实现(UI-TARS 1.5 模板精简版)之上,保留观察-思考-行动循环:每步模型收到任务描述、动作空间、14 条硬约束、完整文本历史、最近 5 张截图和一条反馈备注,回复一个 Thought 与一个 Action,纯视觉操作、坐标基于像素。方法论的直觉是先诊断阶段、再修复阶段。解析阶段只取第一对 Thought/Action 并剥离特殊 token;执行阶段统一把截图降采样到不超过 $1440\times810$ 再发送,坐标按发送图像与实际视口之比换算($x_{page}=\frac{4}{3}x_{model}$),并提供 select/fill/Enter 与 iframe DOM 回退;反馈阶段对比动作前后的 DOM 指纹(URL、标题、节点数、文本长度、滚动偏移、焦点)并生成一句话备注;观察阶段用 hover/find_text/read_text 补足截图里看不到的信息;最后用封闭动作集、执行器强制预算(80 步/1,800 秒)和模型调用重试把循环包住。
核心创新是把可靠性从'模型能力'问题重构为'四阶段往返'工程问题,与已有方法的本质区别有三。其一,模型固定不动,只修理决策到达页面与页面反应返回模型的通路:标定实验发现 API 私自降采样使 UI-TARS 的 28 像素 patch 网格坐标约定失效,改为自降采样加运行时实测比例后,三个此前偏 122–189 像素的目标命中在 1–5 像素内——模型本来就准,错的是换算。其二,护栏内建于执行器而非提示词:删除 goto 动作前的审计显示,70 个开发任务共发出 692 次 goto,18 个任务直查数据 API、21 个访问搜索引擎,58% 的正确答案来自捷径;封闭动作集配合 14 条硬约束才让行为合规。其三,诚实的证据文化:配对评估总是包含已通过的任务以防回归,主动报告阴性结果——'无可检测变化'备注单独加入时 10 个空转任务仍 0/10、总步数不变,说明准确反馈必须与执行器强制预算配合才能改变行为。
方法步骤详情
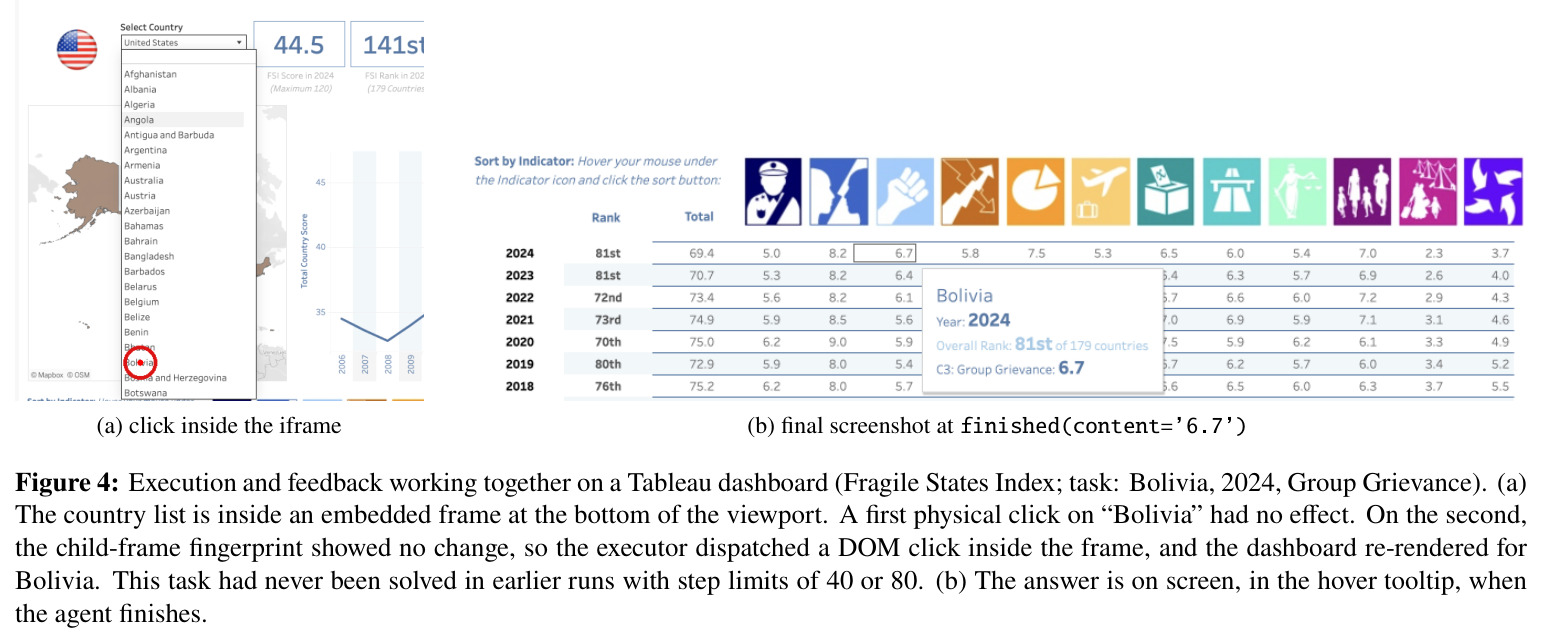
每一步依次经过五个环节。(1)解析:输入模型回复,输出单个动作——只保留第一对 Thought/Action,剥离 <|eot_id|> 等自生成 token 与动作后的杂散标记(保留 <|box_start|>/<|box_end|>);7,705 步离线重放显示恰好修改全部 551 个被污染步骤、未触碰 7,154 个干净步骤。(2)执行:截图降采样至不超过 1440×810 后按实测比例换算坐标;select 按精确/归一化/子串顺序设置下拉选项;fill 聚焦、清空、键入并回读实际值;以换行符 \n 结尾的 type(79/356,占 22%)由执行器补发 Enter;动作落入子框架且指纹无变化时,在框架内派发完整 DOM 鼠标事件序列(CAPTCHA 框架除外)。(3)反馈:动作前后各记一次 DOM 指纹,无变化则上报点击点下的元素及可点击性;fill 回读值,失败的 select 返回可选项列表;hover 与 SVG/画布目标额外比对文本哈希。(4)观察:hover 揭示工具提示数值;find_text 把下一个匹配滚入视野(含子框架、不返回文本);read_text 返回标签附近不超过 600 字符的 DOM 文本,乱码字体字符替换为'?'并计数。(5)护栏:80 步、1,800 秒与每动作预算由执行器拒绝超额调用;模型调用对 403/429/5xx 与超时在 240 秒内最多重试 6 次。
技术新颖性
技术新颖性有四点。第一,四阶段往返作为可迁移的诊断框架被系统提出,并配以每阶段的真实故障清单(Table 2),把 SWE-agent 的接口思想首次推广到多模态浏览器操作,给出可操作的归因方法:任何失败先问坏在解析、执行、反馈还是观察。第二,修复源于量化取证而非直觉:合成图上六个已知标记的标定实验测得 API 降采样因子 1.324/1.350(x/y 方向),加上 1,312 次点击无一越过 $x=1440$ 或 $y=810$ 的统计证据,共同锁定坐标空间错配;4.9% 回合被特殊 token 污染、7.7% 对 41.7% 的成功率对比,锁定解析故障。第三,把'动作一致性'工程化:同一动作在提示词描述、解析器、执行器与反馈中必须行为一致(Enter on \n 曾被提示词承诺却从未执行),并配自动化测试守护。第四,评估方法学严谨:所有组件证据标注样本量并声明只指示方向不声称显著性,还主动回退了无效的空闲熔断器(连续 6 步无变化即停会杀死本可成功的任务)。
实验结果
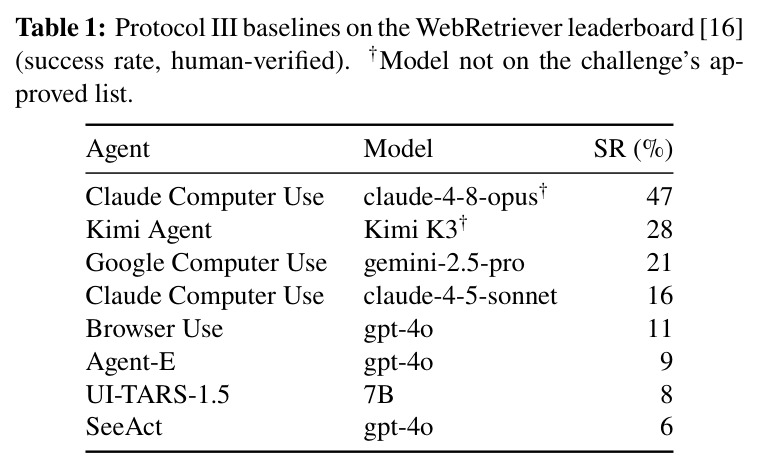
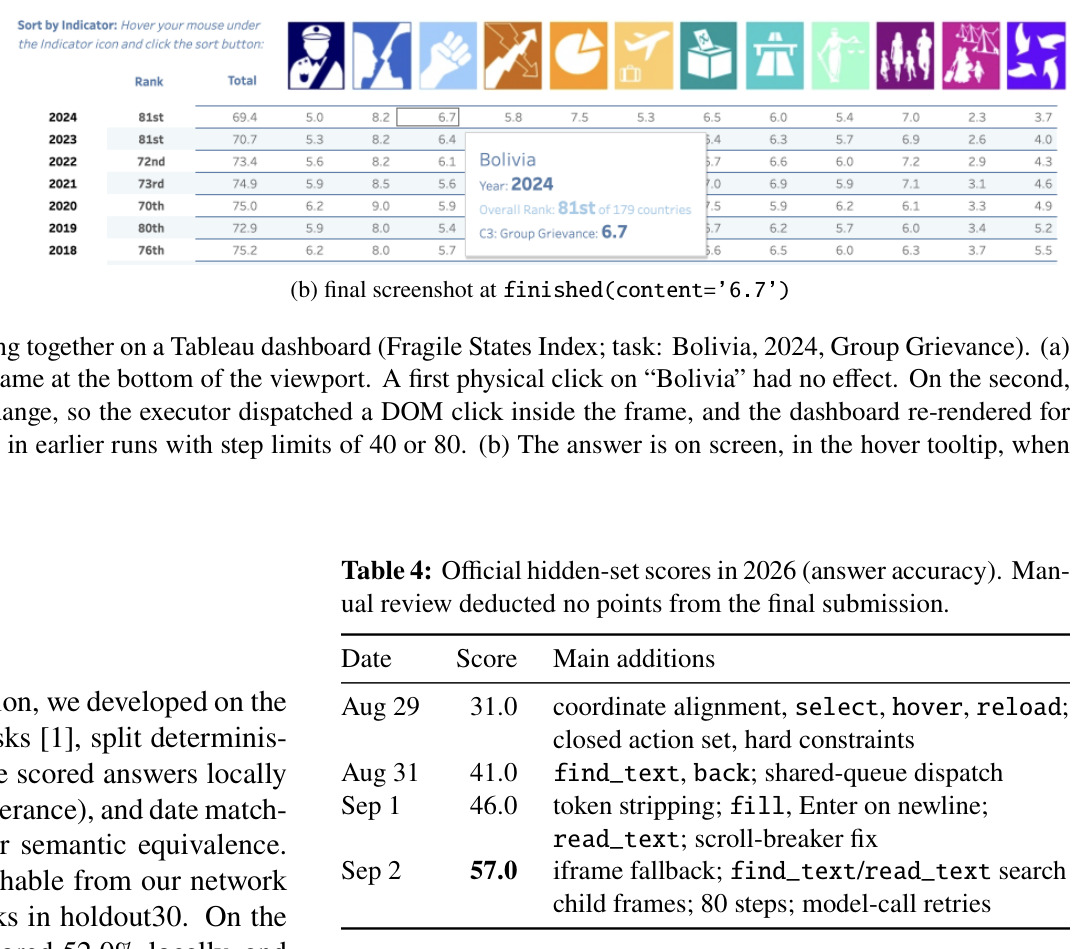
官方隐藏集(100 任务)四支提交得分依次为 31.0、41.0、46.0、57.0,全程使用 claude-opus-4-6,人工审查零扣分,位列 WebRetriever Challenge 2026 第二名;参照排行榜(不同任务集),高于 Gemini Computer Use 的 21 与 claude-4-5-sonnet 的 16。本地证据:坐标对齐使配对 24 任务从 8/24 升至 20/24(+12/−0),触步数上限比例从 67% 降至 4%;token 剥离在 7,705 步重放中修复 551/551 个污染步骤、不触碰 7,154 个干净步骤;fill+Enter 使 10 任务从 2 解升到 4 解且步数省 12%;hover 修复 5 个工具提示任务中的 4 个;find_text 让 1 个任务从 40 步失败变 12 步通过;read_text 规则化后用了 5/6 个定向任务但修复 0 个(一个短标签匹配 124 个元素);热键黑名单 +2/−0;步限 40→80 后 8 任务从解 0–1 升到 4;scroll 熔断修正救回 2/3;reload 预算救 2、省 2、无误伤;iframe 回退使从未解出的 Tableau 任务 25 步通过。首次官方评测因时限只完成 79/100(31 正确,39.2%),推算 +10 分中约 7 分来自完成率、约 3 分来自准确率。成本:每步平均输入 10.6k、输出 127 token(83 倍),100 任务约 170–230 美元。100 个公开任务按最好结果分桶:约 55 答对、13 参考答案过时、16 站点不可达、6 结构性障碍、约 4 能力缺口、3 路径决策错误。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WebRetriever Challenge 2026 Protocol III 官方隐藏集(100 任务) | 最终得分(答案准确率,满分 100,含人工审查) | 57.0(四次提交 31.0→41.0→46.0→57.0),人工审查零扣分 | 排行榜最高 Claude Computer Use(claude-4-8-opus)47.0;Google Computer Use(gemini-2.5-pro)21.0;UI-TARS-1.5 8.0(不同任务集,非直接可比) | 远超挑战赛已知基线;自身四次提交提升 26 分(约 +84%) |
| 本地 24 任务坐标对齐配对评测 | 解出任务数 | 20/24(修复后) | 8/24(修复前,版本级对比,对齐为主改动) | +12 且 0 回归;触步数上限比例 67%→4% |
| 特殊 token 污染回合的解析修复(7,705 步离线重放) | 受影响步骤数 | 551 个污染步骤全部被修改,7,154 个干净步骤零改动 | 污染回合成功率 7.7%,干净回合 41.7%(15/305 回合被污染) | 精确消除 4.9% 回合的主要失败源且无副作用 |
| hover 工具提示任务(5 个) | 解出任务数 | 4/5 | 0/5 | +4 |
| 步数上限 40→80 配对测试(8 个任务) | 解出任务数 | 4/8(2 个需要超过 40 步) | 0–1/8(早期 40→65 的测试无增益,因跑在过时代码上) | +3 到 +4 |
| holdout30 本地对照隐藏集 | 成功率 | 本地 52.0%(25 个可评分任务)vs 官方隐藏集 46.0% | 任务集不同,6 分差距在一个二项标准差内(n=25 约 10 分) | 验证本地数字可作为相对比较的合理指引 |
局限与改进
作者承认五点:(i) 全部结果基于单一模型 claude-opus-4-6,坐标对齐与 token 剥离针对该模型及其 API 的具体缺陷,不一定迁移到其他模型;(ii) 隐藏集上没有同模型的参考实现基线,31.0 的起点已包含部分修复,本地 10 任务子集上参考实现(加载了作者模型)解出 0 个;(iii) 组件证据来自 1–24 个任务的小样本,只指示方向不声称统计显著性;(iv) 真实网站会漂移,16 个站点对其网络不可达,同版本重复运行有方差,每个官方分数只来自单次运行,本地 52.0% 对隐藏 46.0% 的差距在一个二项标准差内(n=25 约 10 分);(v) 在公开任务上开发,本地数字与排行榜不可比。我补充两点:13 个公开任务的参考答案已过时或定义不同(如 100 年对 20 年全球升温潜势 GWP),说明所有实时网站基准都面临效度衰减,作者建议的'参考答案+时间戳证据截图'存档制度值得推广;另外四阶段框架虽是模型无关的,但证据深度与单一 API 的怪癖强耦合,读者难以分离通用工程原则与针对 claude-opus-4-6 的特调补丁。
独立分析的弱点
独立分析五个弱点。第一,统计功效不足:+2 量级的提升(热键黑名单 0→2、scroll 熔断救回 2/3)可能落在噪声内,改进方向是按作者展望构建带程序化真值的合成任务池,把组件评估做到有统计功效的样本量。第二,反馈不改变行为:加入'无可检测变化'备注后 10 个空转任务仍 0/10、总步数 400 不变,说明信息到达不等于行为改变;现解法是执行器硬预算,更优方向是引入独立验证器或让模型显式输出置信度来触发策略切换。第三,成本结构低效:每步重发 5 张截图使输入是输出的 83 倍(10.6k 对 127 token),强制端点不支持提示缓存,单次 100 任务 170–230 美元,原生 API 加缓存可省 55–70%,对资源受限团队是实际门槛。第四,验证工具触发仍靠把'何时需要'改写成提示规则,find_text 使用仅从 2 任务升到 3、read_text 修复 0/5,'何时该验证'没有真正解决。第五,封闭动作集在堵住捷径的同时也移除了合法的站内深链能力,对允许直接 URL 的部署场景过于保守。
未来方向
作者按预期收益/成本比排序:把不同步骤路由到不同模型(定位交给小模型或规则、密集表格读数交给大模型、停止决策可走经典视觉例程,四阶段与护栏保持不变);用经典计算机视觉强化反馈与观察(OCR 交叉核对截图读数、感知哈希捕捉 DOM 指纹看不见的画布/图像更新、模板匹配重复控件);在 finished 之前增加独立验证器调用(全新上下文,只看任务、最终截图与候选答案,针对错行错表错误);改用原生 API 以获得提示缓存与工具调用动作,预计省 55–70% 成本并消除自由文本解析及其大部分故障;对'截图+可交互元素坐标列表'的混合观察做 A/B 测试(SeeAct 提示混合并非必然更好);PDF 与表格类来源改为下载解析,并按任务类型建短清单加按站点操作笔记的技能库;在相同站点生成带程序化真值的合成任务,把教师轨迹蒸馏进更小的开源模型以降本。基于其成果还可延伸:把四阶段归因做成开源诊断工具,自动分类任意智能体轨迹的失败环节;以及系统验证哪些修复能跨模型迁移。
复现评估
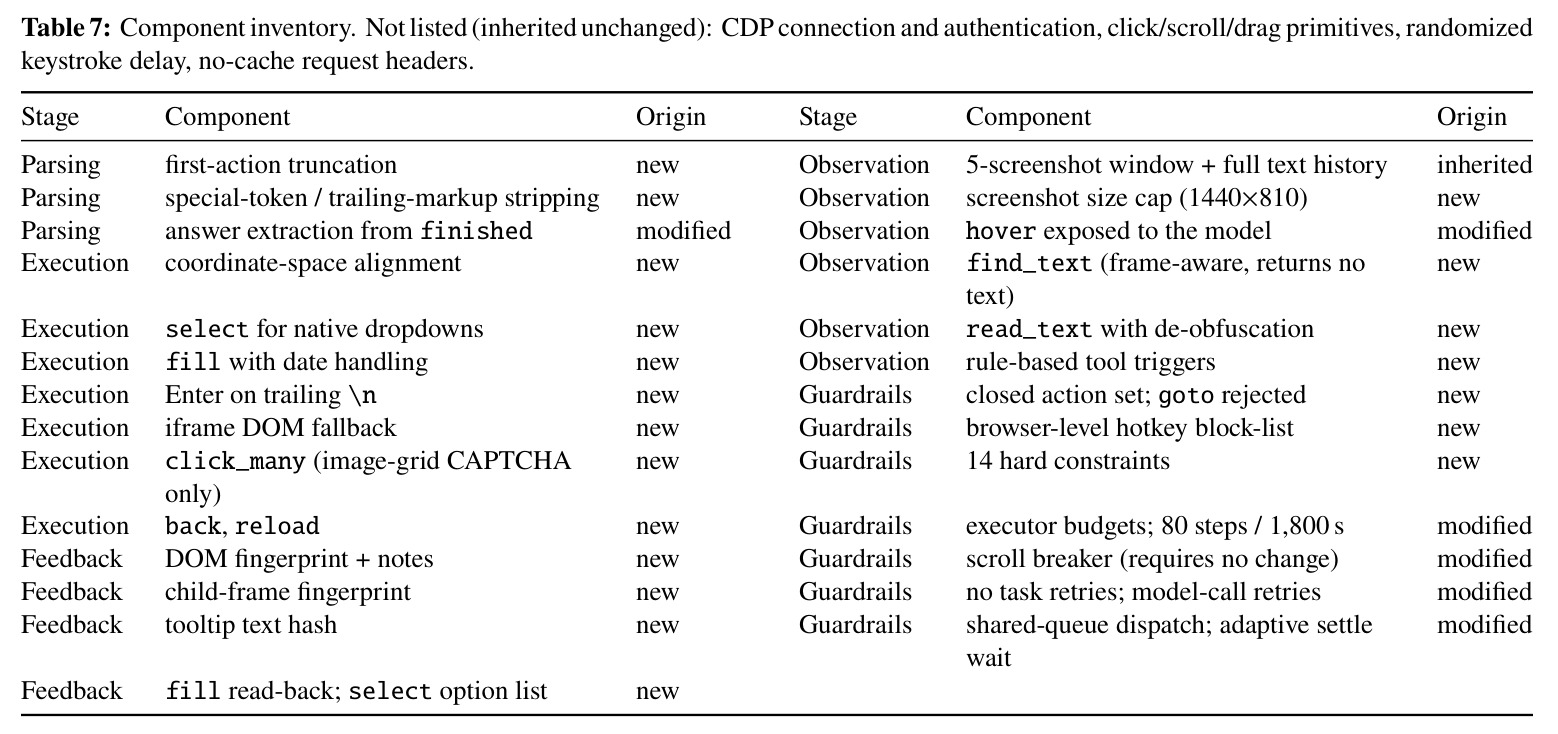
代码完全开源(github.com/jianganghan/WebFovea),附录 Table 7 逐项标注每个组件属于继承、修改还是新增,工程透明度很高。数据可复现:WebRetriever 公开 100 个 Protocol III 任务,作者按确定性划分为 dev70 与 holdout30,本地评分器支持精确匹配、0.5% 相对容差的数值匹配、日期匹配及可选的 LLM 语义等价判断。主要门槛有三:需要 claude-opus-4-6 的 OpenAI 兼容端点,一次 100 任务评测约 170–230 美元;真实网站漂移导致 13 个参考答案过时、16 个站点不可达,绝对分数难以对齐,但配对比较(坐标对齐 +12/−0、重放 551/551 等)仍可复现;官方隐藏集分数需要组织方的沙箱环境与每日一次的评测资格。总体而言,有工程能力的团队花数百美元即可验证核心结论,属于中等偏易的复现难度。
论文图表
截图展示模型把自生成的聊天模板特殊 token 原样输入统计门户 CSO PxStat 的筛选框,站点按字面字符串过滤导致零结果;模型在自己的推理中最终诊断出问题,但每步继续输出该 token,直到耗尽 40 步。
它是解析阶段故障最直观的证据:不是模型不会推理,而是输出被 token 污染后连自我纠错都救不回来。这直接催生了第一动作截断与特殊 token 剥离。
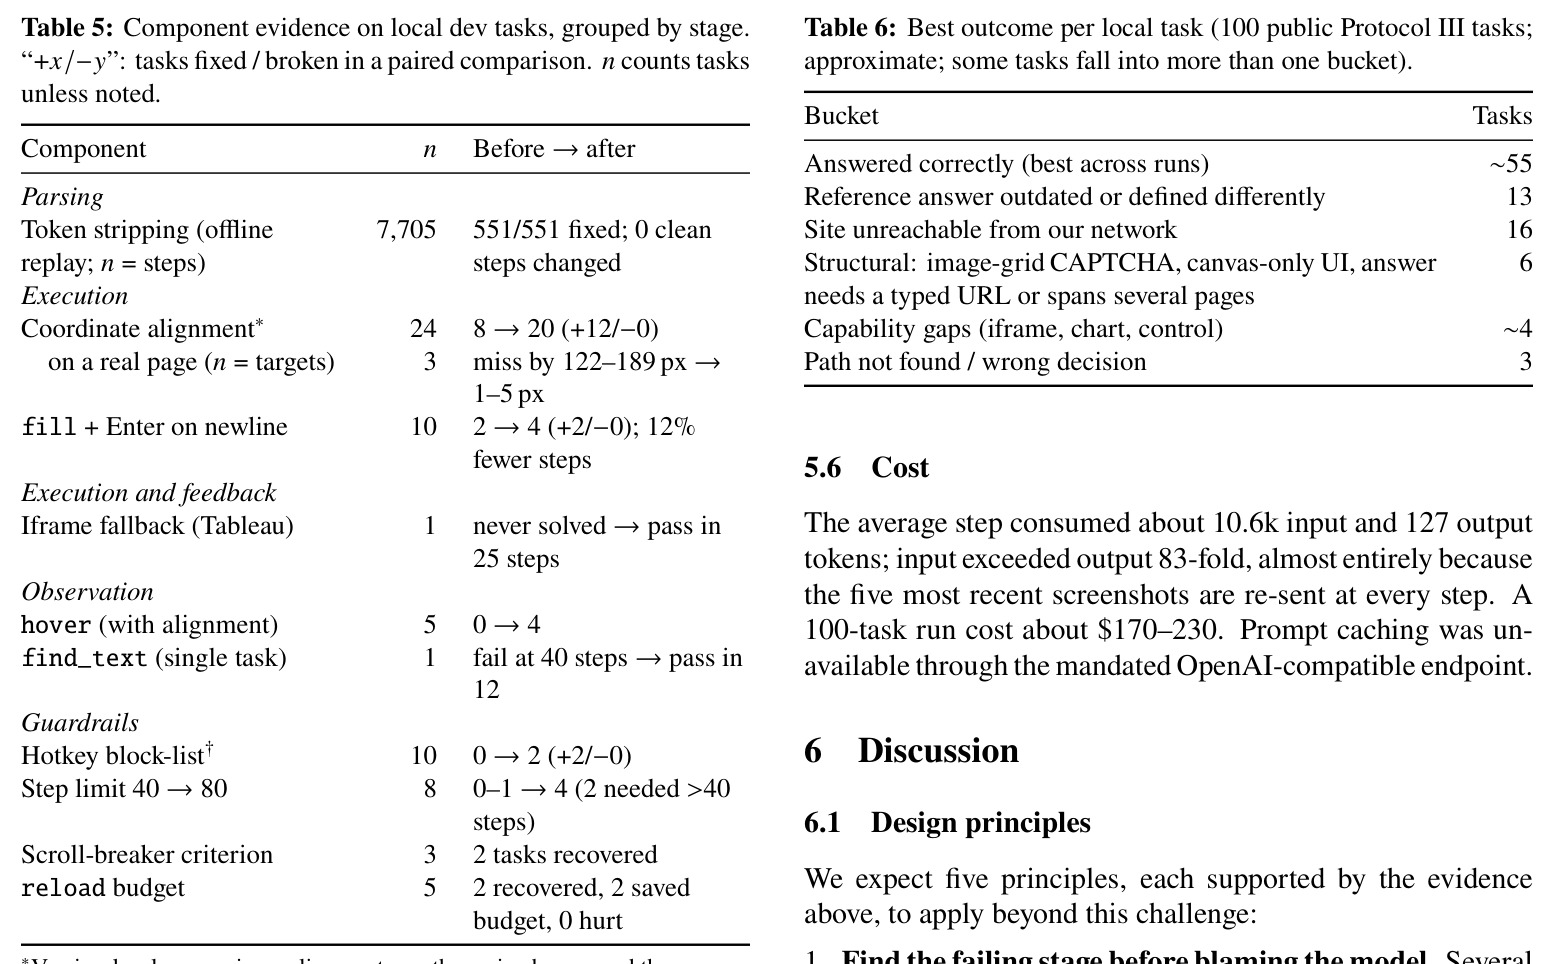
按阶段汇总组件级配对证据:解析的 token 剥离重放 551/551 修改、0 干净步受影响;执行的坐标对齐 24 任务 8→20(+12/−0)、三个真实目标偏差从 122–189 像素缩至 1–5 像素、fill+Enter 10 任务 2→4 且步数省 12%;iframe 回退使 Tableau 任务首次解出;观察的 hover 5 任务 0→4、find_text 单任务 40 步失败变 12 步通过;护栏的热键黑名单 10 任务 0→2、步限 40→80 后 8 任务 0–1→4、scroll 熔断救回 2/3、reload 救 2 省 2 伤 0。
论文证据密度的核心:每个组件的量化收益、样本量和是否伤及已通过任务都在这里,读者可以据此判断哪些结论稳固、哪些只是方向性信号。