WebAnything:从真实网站到可扩展的智能体环境 WebAnything: From the Wild Web to Scalable Agent Environments
全自动将真实网站重建为可执行、可复位的智能体环境,独立验证驱动修复迭代。
前置知识
Web Agent(网络智能体)
通过浏览器与网页交互完成任务的智能体:观察截图、DOM 或无障碍树等页面状态,执行点击、输入、滚动等动作,完成检索、表单填写、筛选下单等多步任务。WebArena、VisualWebArena 等基准把这类智能体放在自托管网站上评测;REAL、Odysseys、WebArena-Verified 是本文使用的三个下游评测集。
本文的最终目的就是为这类智能体提供可训练、可评测的环境,理解其任务与评测方式才能读懂 RQ3 中 SFT 提升数字的含义。
自托管可执行环境与状态复位
把网站复制成本地可运行的镜像(本文用 Flask/SQLite 技术栈),配备固定初始数据、复位接口和任务评测器,使每次交互都能从相同初始状态出发并客观判分。与直接在真实网站执行相比,它保证可复现、可隔离、允许修改状态并从中恢复。
这是论文对『环境』的定义与验收标准,探索、验证、任务生成和轨迹采集全部围绕这个目标展开。
三种环境构建路线的权衡
人工辅助镜像(逐站人工工程,如 WebHarbor)、生成式构造(从规格说明批量生成,如 WebFactory、InfiniteWeb,但不保证对应指定真实网站)、录制回放(保留源站内容但交互覆盖受录制限制,如 World of Bits、WARC-Bench),以及结合回放与源站合成的 Weblica。三者分别在自动化、源站保真、交互覆盖上各有短板。
论文的动机、Figure 1 和对比实验全部建立在对这三条路线权衡的理解上,是全文论述的坐标系。
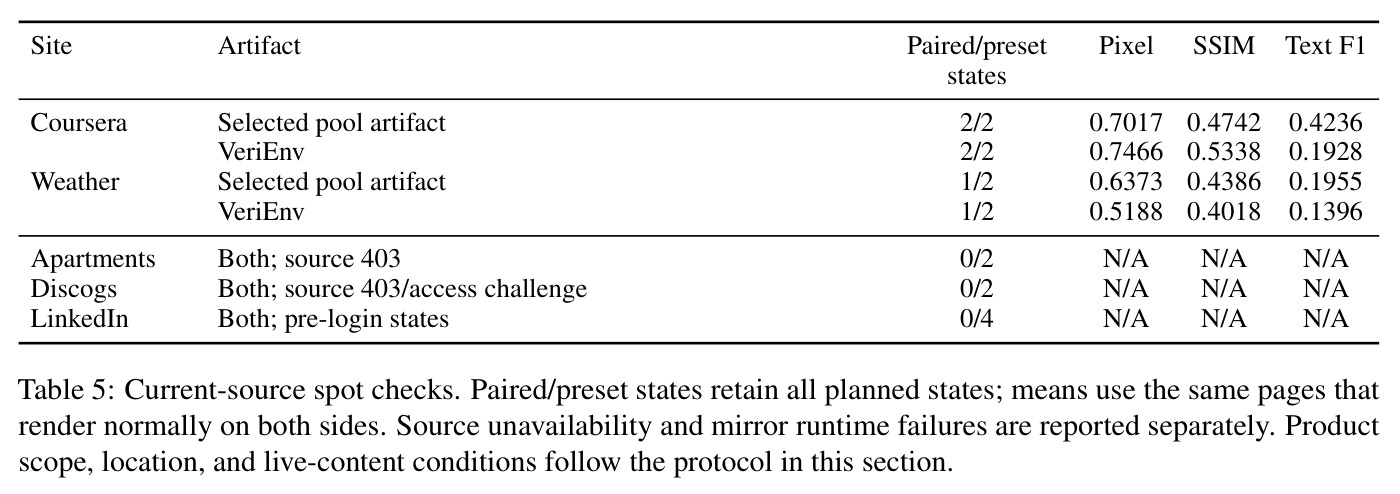
Pixel Similarity / SSIM / Text F1
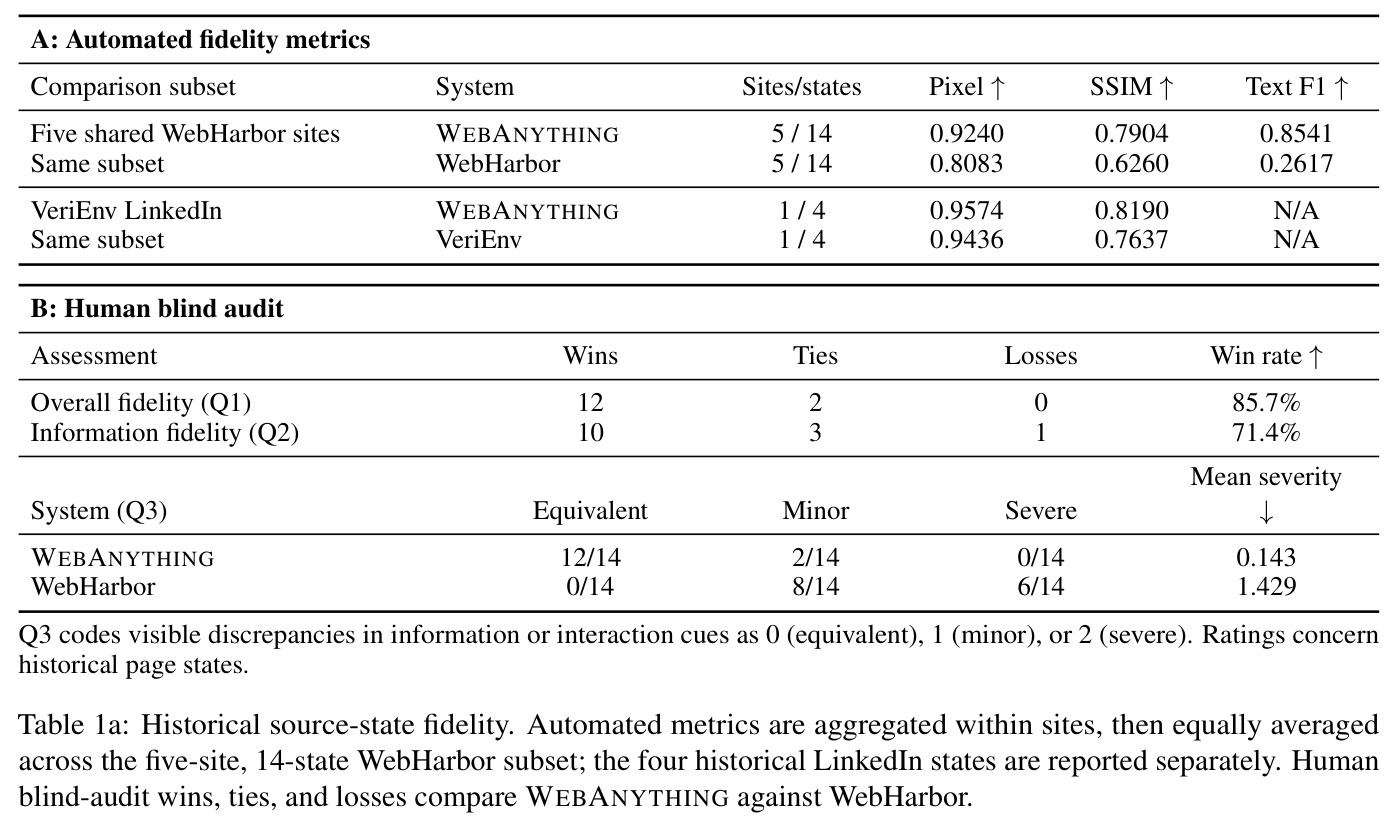
三种源-镜像保真指标:Pixel Similarity 按 $1-\mathrm{MAE}/255$ 衡量逐像素接近度;SSIM 在 7×7 窗口上衡量结构相似性;Text F1 对整页 body.innerText 做归一化后,以词和标点的多重集重叠计算 F1。三者分别捕捉外观、结构和文本信息保真。
RQ2 的核心结论由这三个自动指标加人工盲审共同支撑,需要知道各自衡量什么,才能理解为何 Text F1 上 0.8541 对 0.2617 的差距最大。
Builder–Verifier 解耦与候选冻结
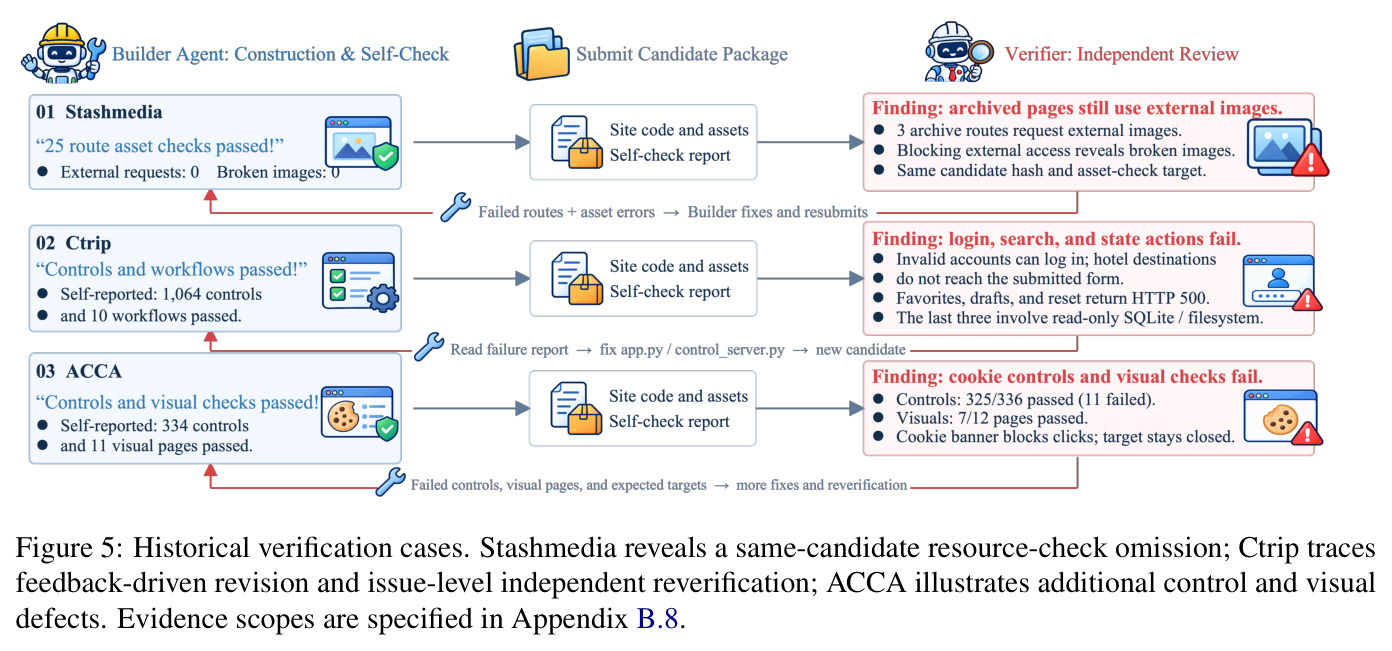
由 Builder 智能体实现并自检候选实现,随后把候选『冻结』(绑定版本摘要),交给运行在独立上下文中、无权修改候选代码的 Independent Verifier 重新渲染并实际操作,与源站证据和站点契约逐项比对;缺陷以修复包形式反馈给 Builder。
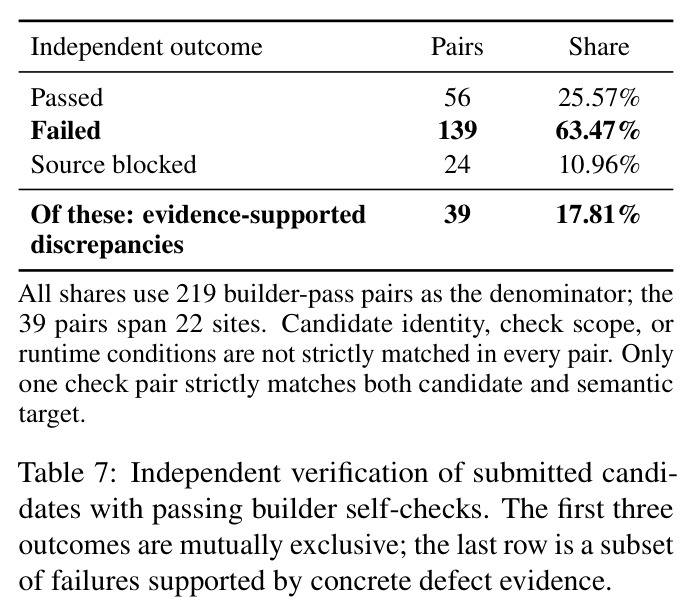
这是防止『自己检查自己』漏检的关键机制:历史数据显示 219/229 的自检通过,独立验证仍查出 39 处有据缺陷。理解它才能读懂验证实验。
监督微调(SFT)与交互轨迹数据
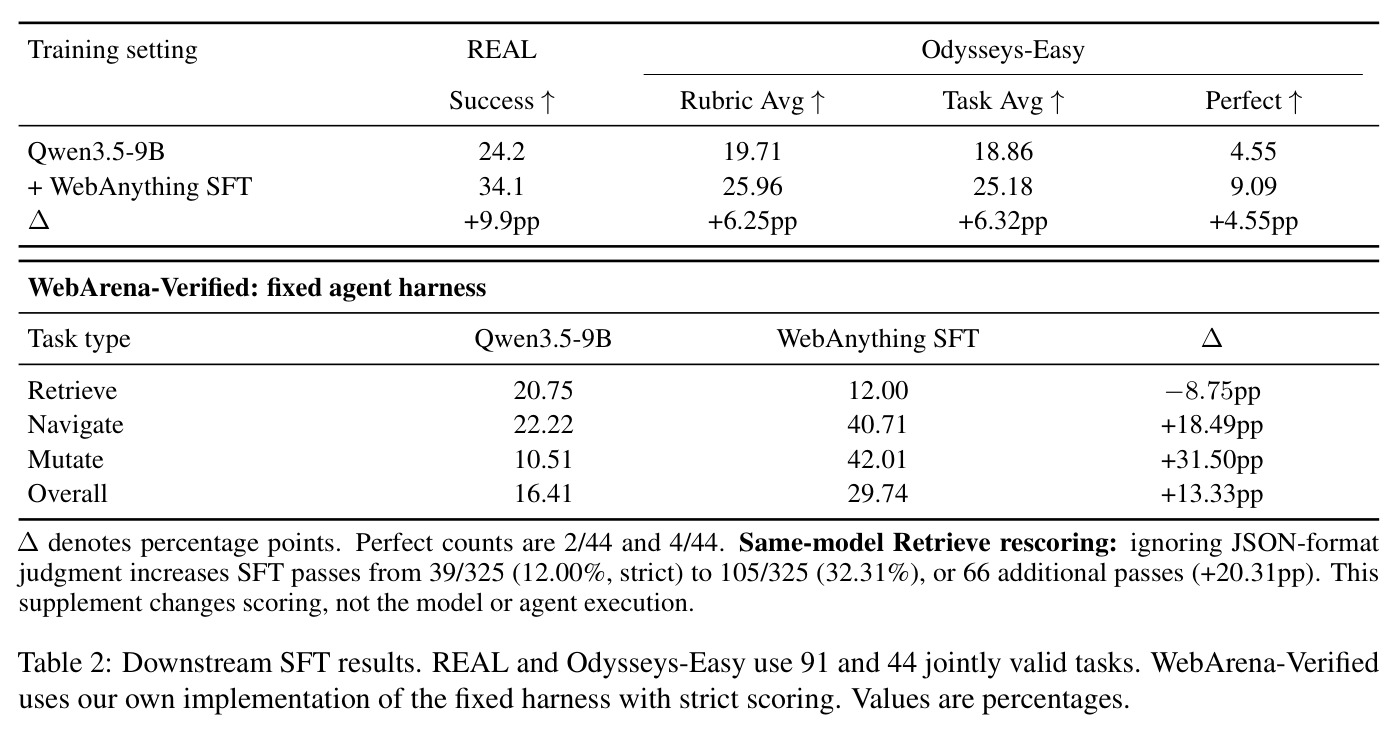
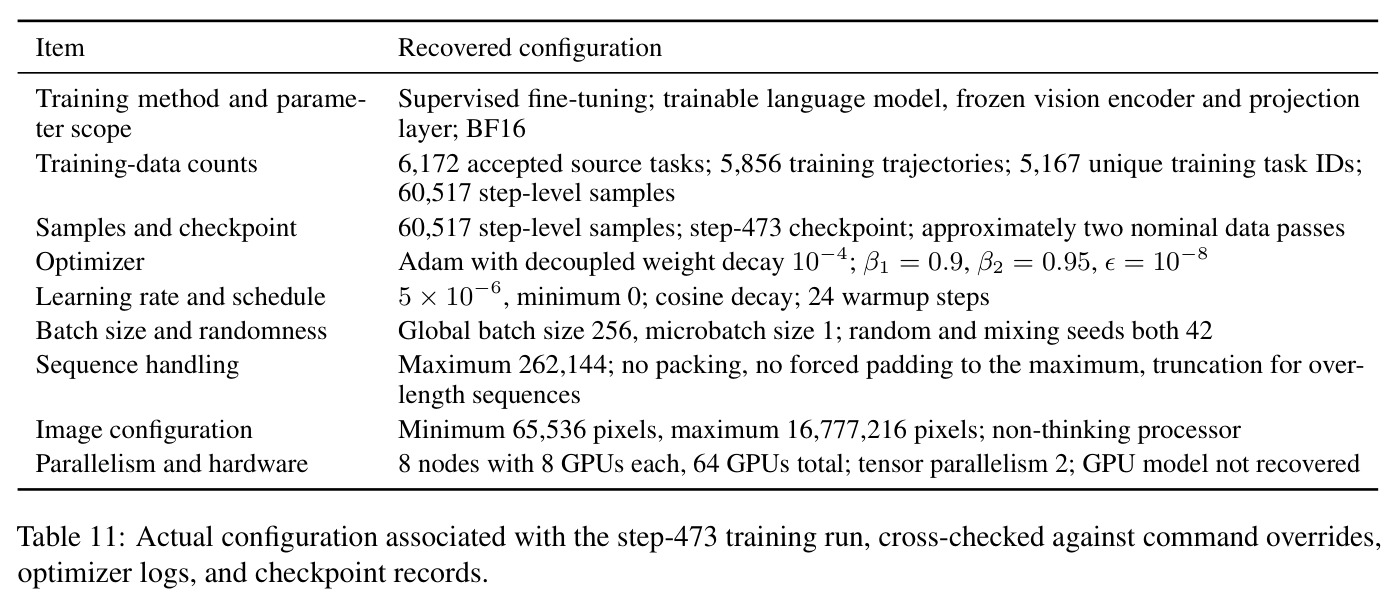
在预训练模型上用(指令,执行轨迹)数据继续训练。本文把通过验收的成功轨迹转成 60,517 条步级样本(只监督每个样本的最后一个 agent 回合),微调 Qwen3.5-9B:473 步、全局 batch 256、学习率 $5\times10^{-6}$、64 张 GPU。
RQ3 用下游基准的提升来证明重建环境的训练价值,理解 SFT 设置与判分协议才能正确解读 +9.9pp 等数字及其局限。
研究动机
视觉网络智能体需要稳定、可控、可复位的环境来探索、修改状态、从错误中恢复并获得执行反馈;直接在真实网站上执行会带来状态初始化困难、结果不可复现和安全隔离问题。现有环境构建路线各有硬伤:一是人工辅助镜像(如 WebHarbor),虽然与源站一一对应、可控性强,但每个站点都需要专门的工程、实现和调试,无法规模化;二是生成式构造(WebFactory、InfiniteWeb 等),能从规格与参考批量生成可执行网站,但生成结果会偏离『指定的那个真实网站』,源站对应性成为额外要求;三是录制回放(World of Bits、WARC-Bench),保留了源站观察,但交互覆盖被录制内容和回放能力双重限制,难以支持录制之外的新交互;Weblica 虽把回放与源站合成结合,覆盖与保真仍是权衡项。结果是:要么环境多样但不可复现,要么可复现但站点少、成本高,可重复交互与训练数据供给严重不足。
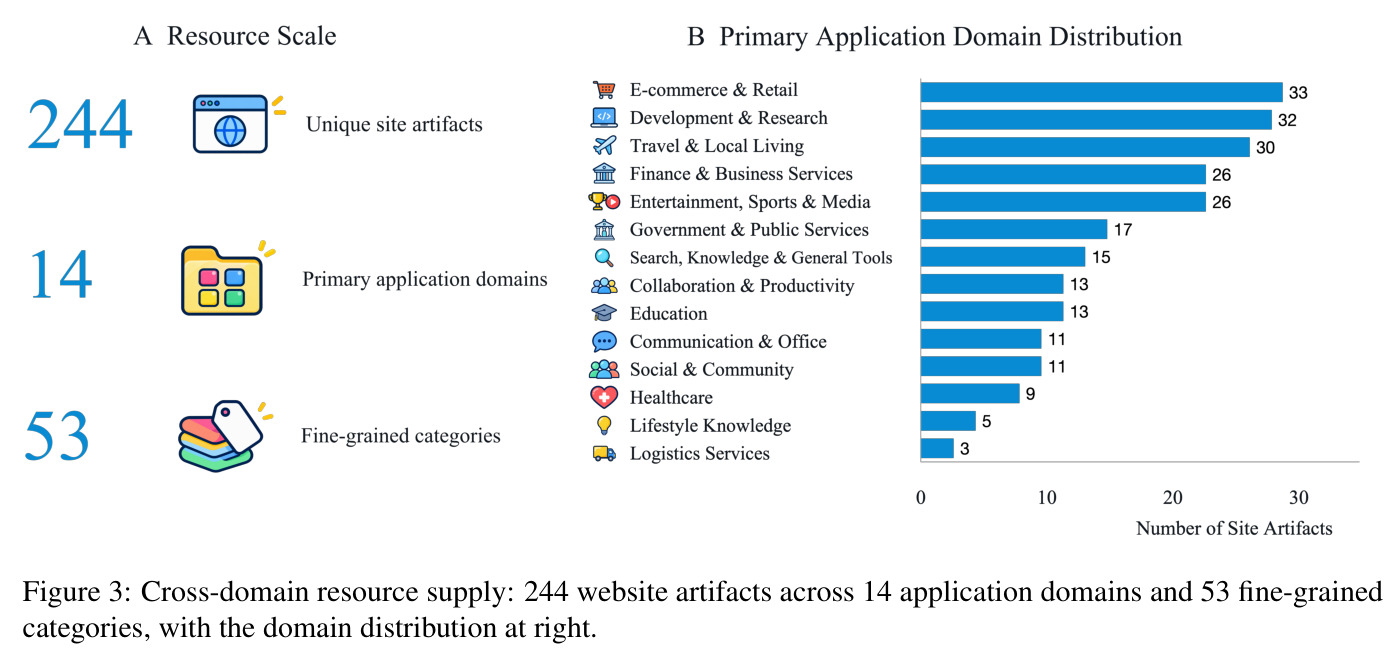
本文的目标是本文的目标是:给定一组真实 URL、许可访问范围和构建预算,在不做逐站人工实现与调试的前提下(仅需初始配置与授权),全自动地把它们重建为『源站对齐、可执行、可复用』的本地 Web 智能体环境。具体要求包括:在站点契约范围内保留观察到的页面呈现、交互行为和状态变化;提供固定初始状态、复位机制和任务评测器以支持可重复交互;独立验证发现问题后能自动局部修复或有针对性地重新抓取源站;最终形成规模化的环境池与任务池。论文实际构建了横跨 14 个应用领域、53 个细分类别的 244 个网站工件,支撑 12,984 个已执行并通过验收的任务,并用环境产生的 5,856 条交互轨迹做 SFT,在 REAL、Odysseys-Easy、WebArena-Verified 三个外部基准上验证环境数据的下游训练价值。
与已有工作不同的是,本文的独特切入点是把『源站证据』作为构建与验证的共享基础,并系统指出两个此前未被解决的鸿沟。其一是源站对齐鸿沟(Source-Grounding Gap):由于拿不到私有后端和网站内部代码,仅靠截图和模型先验重建会遗漏状态之间的关系——例如同一 URL 下菜单收起与展开是两个不同的实现约束;本文主张把浏览器可观察的结构、资源、行为组织成证据,用证据去约束实现,而不是让模型自由发挥。其二是验证与反馈鸿沟(Verification and Feedback Gap):Builder 自检会漏掉与源站不一致的缺陷——历史 229 对 Builder–Verifier 报告中 219 对自检通过,但独立验证仍在 22 个站点上发现 39 处有证据支持的差异;而且同一差异既可能源自实现错误、也可能源自观察不足,需要的动作完全不同。本文用『证据是否充分』来路由反馈:充分则局部修复,不足则定向重抓源站,这与以往『生成—自检』的闭环有本质区别。
核心方法
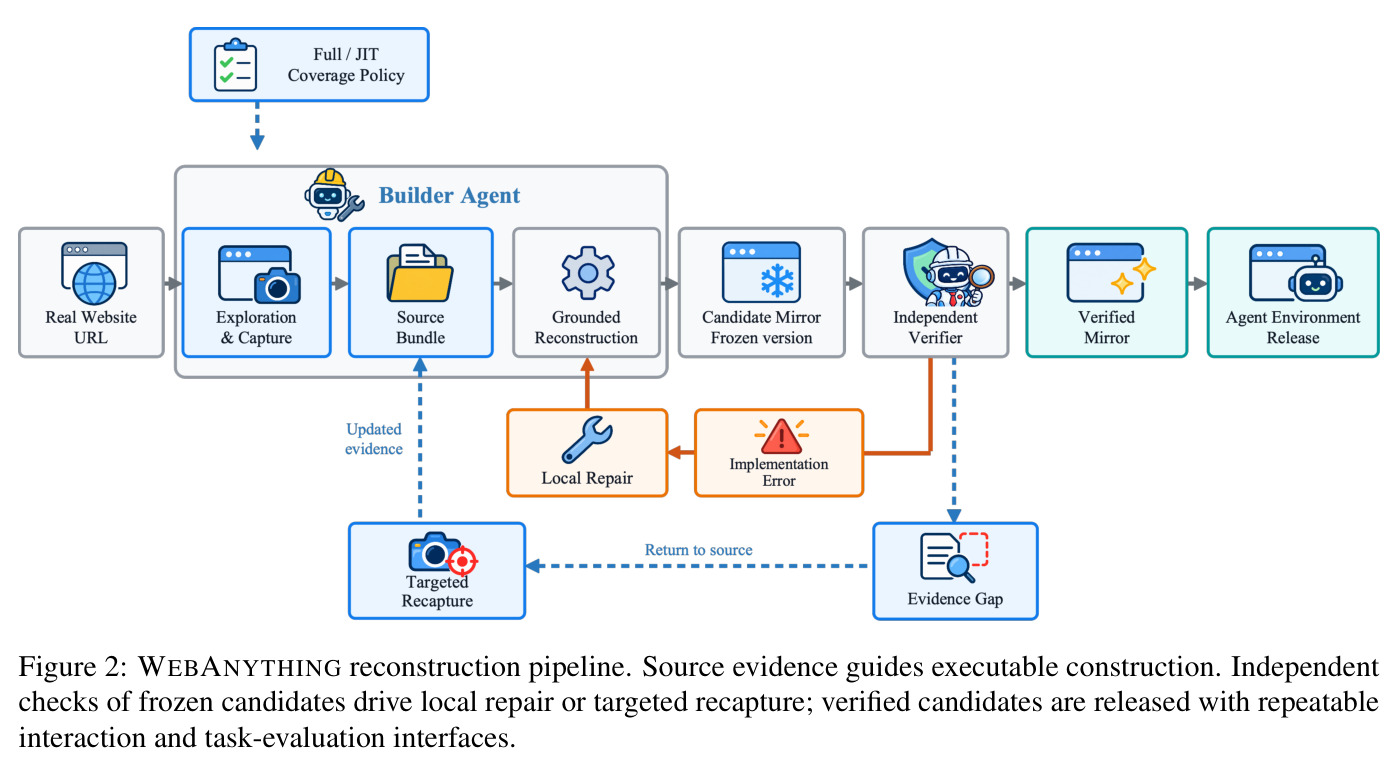
直觉上,WebAnything 是一条『自动测绘—施工—独立质检』流水线。先由耦合的 Explorer–Builder 到真实网站系统采集三类浏览器可观察证据:页面结构与外观 $E_p$、资源与依赖 $E_r$、交互前后的行为观察 $E_b = \{(o_t, a_t, o_{t+1})\}_{t=1}^{N_t}$;再把这些证据翻译成可执行的本地实现(Flask/SQLite 架构的本地路由、组件与共享对象关系),使页面呈现、交互和状态变化在站点契约 $\mathcal{C}$ 声明的范围内与源站一致。随后把候选实现『冻结』,交给独立上下文中的 Independent Verifier 重新渲染、实际操作,与源站证据和契约逐项比对,检查覆盖页面、控件、资源、工作流、持久化和状态恢复。发现差异时先做证据诊断:若源站证据已能确立预期结果而候选复现失败,走 Local Repair,把受影响页面、执行动作、预期/观察结果和支撑证据打包反馈给 Builder;若证据不足以确立预期结果,就生成定向重抓请求回到源站补采。更新后的候选再次冻结、复测受影响检查项并通过回归测试后才在声明范围内发布。发布环境带固定初始数据、复位接口和任务评测器,支持重复交互与轨迹采集。
核心创新有三点。第一,证据驱动的重建:不是『截图转代码』,而是把结构、资源、行为三类观察作为约束实现的证据,任何差异都能回溯到具体的页面状态和动作;同一 URL 下的不同交互状态(如关闭/展开的菜单)被当作不同证据分别约束实现,避免模型先验补全出源站没有的行为。第二,实现与验证解耦:Builder 实现并自检后候选被冻结(candidate freezing),独立 Verifier 在另一上下文中实际渲染和操作被冻结版本,且无权修改候选代码——这保证发现的问题严格绑定在被检查的实现上,防止验证期间目标漂移。这种解耦被历史数据证明必要:95.6%(219/229)的 Builder 自检通过,独立验证仍查出 39 处有证据支持的缺陷。第三,证据充分性路由:用『现有证据是否足以确立预期结果』来区分 Local Repair 与 Targeted Recapture,让反馈闭环既不凭空臆测源站行为,也不陷入无限返工;补采到的新证据反过来约束下一轮实现。
方法步骤详情
流程可拆为六步。步骤一(输入):给定网站 $W$ 的入口 URL、许可访问范围、构建预算和站点契约 $\mathcal{C}$——契约规定必需页面、工作流和可检验的验收结果。步骤二(探索与采集):Explorer–Builder 按 Full Coverage(从入口扩展所有可达页面类型、交互状态和邻接分支)或 Just-in-Time Coverage(按目标任务集的依赖扩展)策略浏览源站,为每个访问状态记录页面结构、计算样式、元素几何、截图和资源引用,并把动作与后续可见反馈、状态变化关联,形成 $E = (E_p, E_r, E_b)$。步骤三(证据约束实现):Builder 把结构观察落实为本地组件、布局与路由,资源观察落地字体、图片和媒体,行为观察实现导航、过滤和状态修改;共享对象关系让创建/修改/保存操作影响后续交互,技术栈为 Flask/SQLite。步骤四(自检与冻结):Builder 自检后提交候选,外层控制器冻结候选并绑定版本摘要。步骤五(独立验证与修订):Verifier 在独立上下文中重新渲染、执行有状态测试(通过本地 UI/API 接口操作并在结束后恢复初始状态),比对源站证据与契约,输出包含失败位置、预期/观察结果和证据的报告;控制器据此路由到 Local Repair 或 Targeted Recapture,更新后的候选再次冻结并复测受影响检查项与回归测试。步骤六(发布与任务供给):通过声明范围检查的环境打包为带初始数据、复位接口的工件;任务流水线读取页面、可见对象和种子数据生成自然语言指令与隐藏成功条件,智能体用固定浏览器 harness 执行,独立评测器核查最终答案或终态环境状态,被接受的轨迹经质量过滤后转成步级训练样本(5,856 条轨迹对应 60,517 条步级样本)。
技术新颖性
与已有工作的本质区别:截图转代码方法(pix2code、Pix2Struct、WebSight、Design2Code)只用外观证据,无法恢复状态关系;生成式环境(WebFactory、InfiniteWeb、WebGen-Agent)以规格或任务为中心,不承诺对应『指定的真实网站』;录制回放(World of Bits、WARC-Bench)保真但交互覆盖受录制内容限制;Weblica 把回放与源站合成结合,但没有冻结候选下的独立验证与证据路由;WebHarbor 依赖人—Coding Agent 协作,逐站工程成本高。WebAnything 的技术新颖性在于:(1)结构+资源+行为三类证据的联合使用,并为每处差异提供可回溯的『页面状态—动作』锚点;(2)把 Self-Refine/Reflexion 式反馈机制从『修改输出』搬到『修改冻结的环境实现』,反馈单位是带证据的修复包,并用候选冻结+独立上下文+回归测试构成可审计链条;(3)用证据充分性而非模型置信度来决定修复还是重抓,把『观察不足』与『实现错误』两类故障显式分离;(4)把验证有效性本身做成可检查的历史证据——1,007 条 issue 记录、49 条逐条语义裁定、18 条跨 6 站独立复验的修复记录。
实验结果
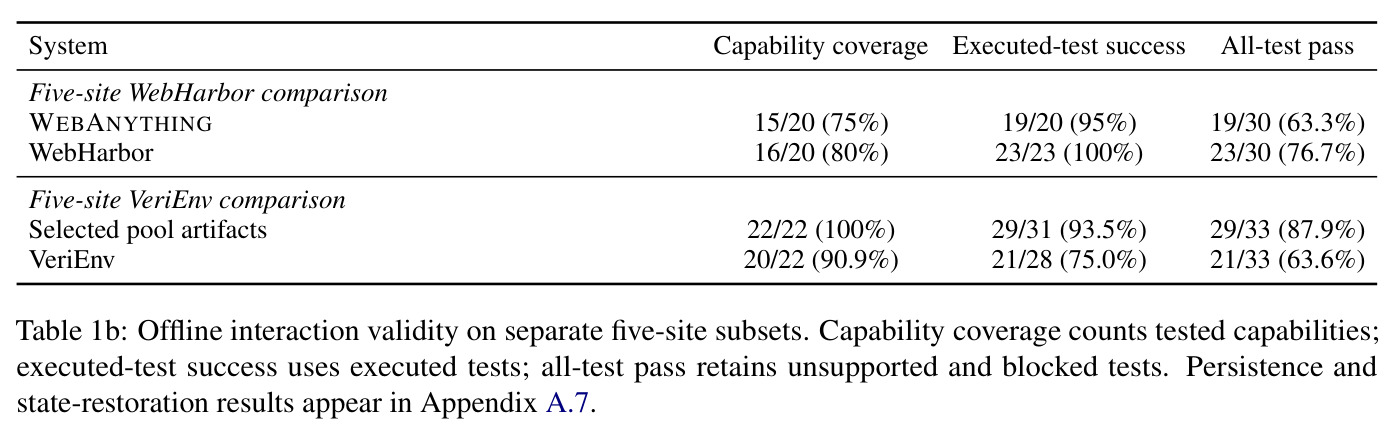
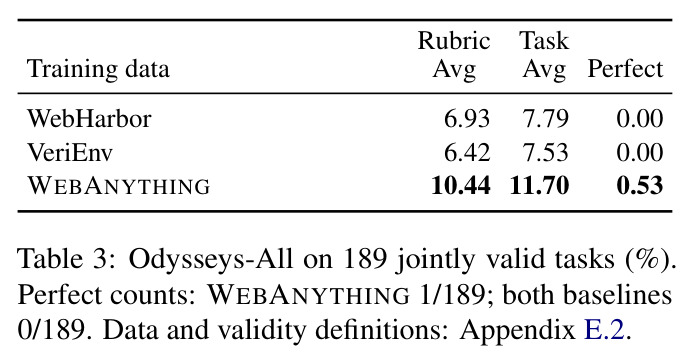
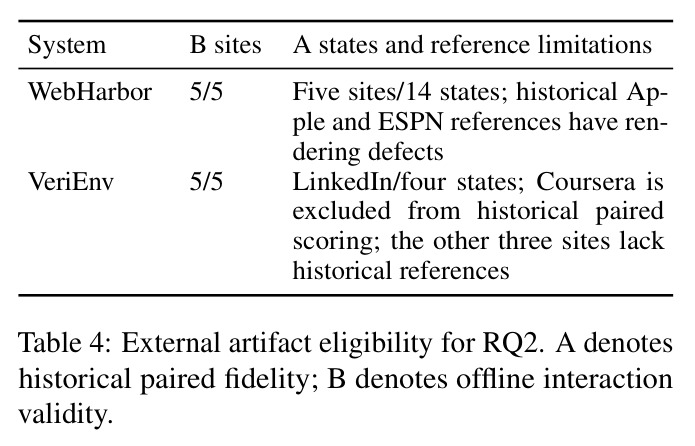
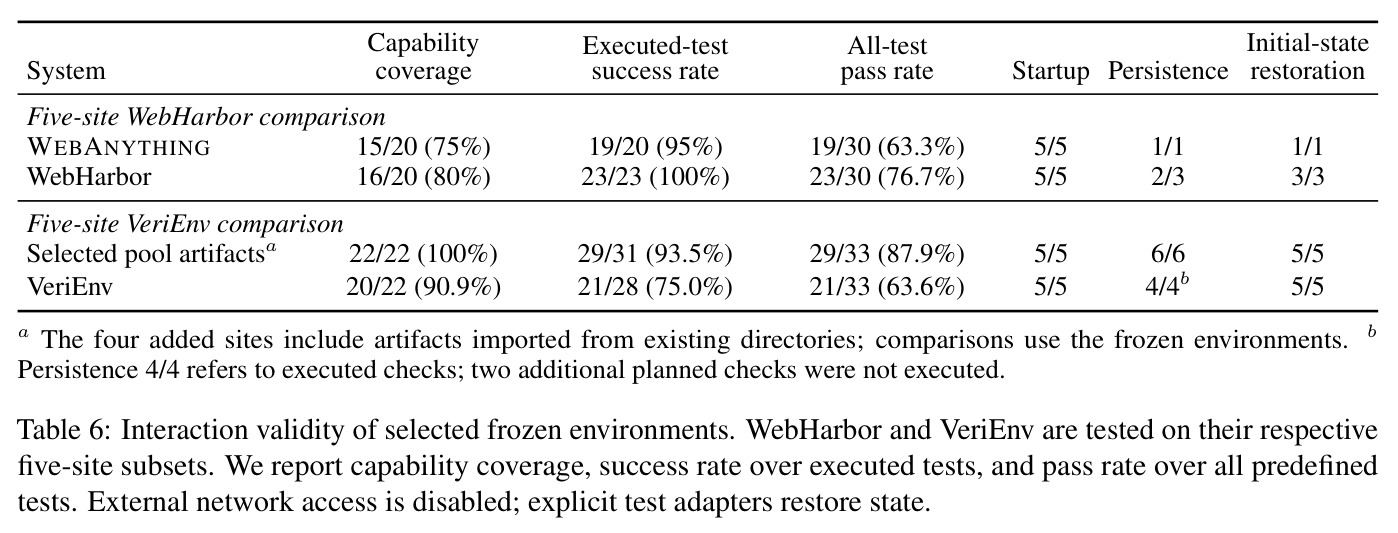
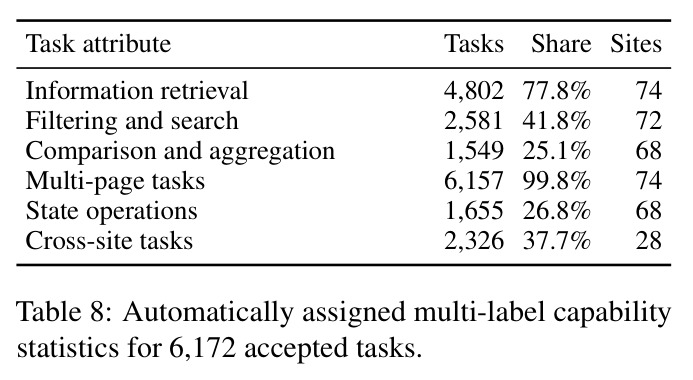
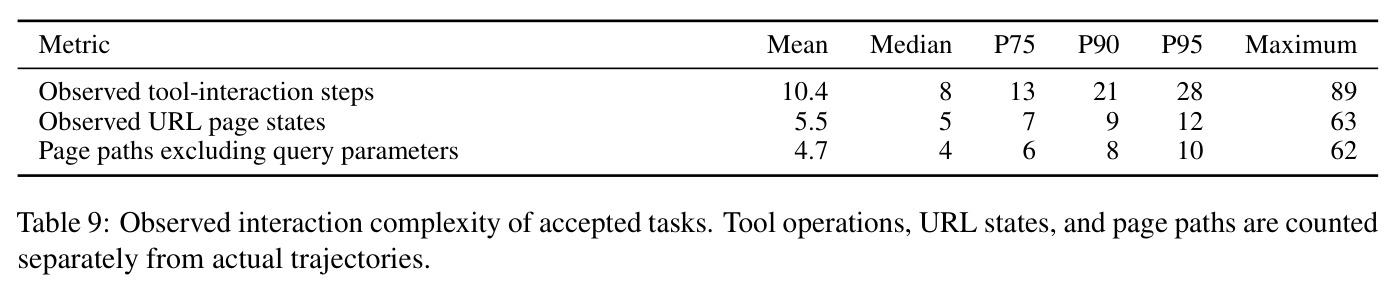
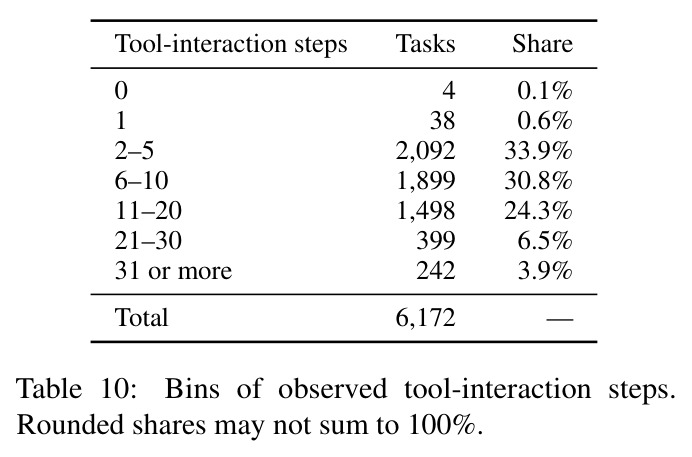
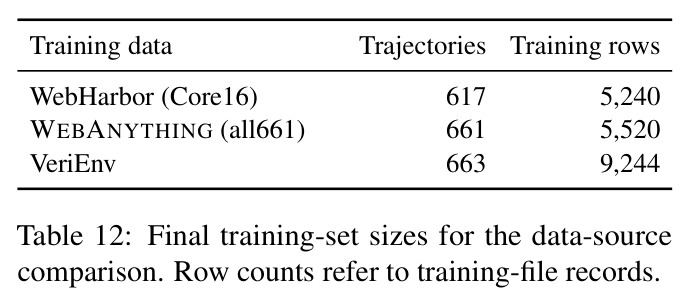
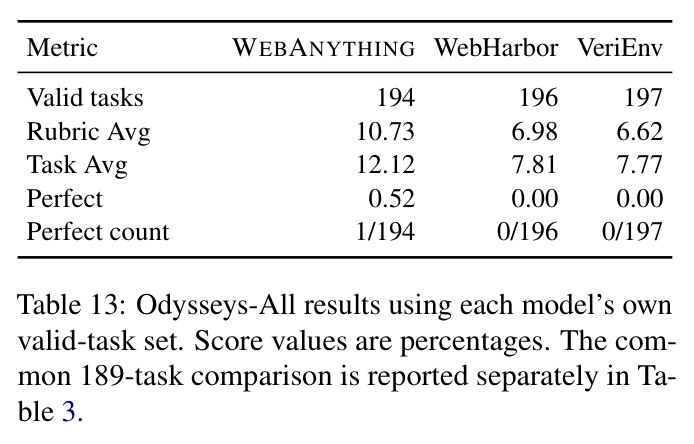
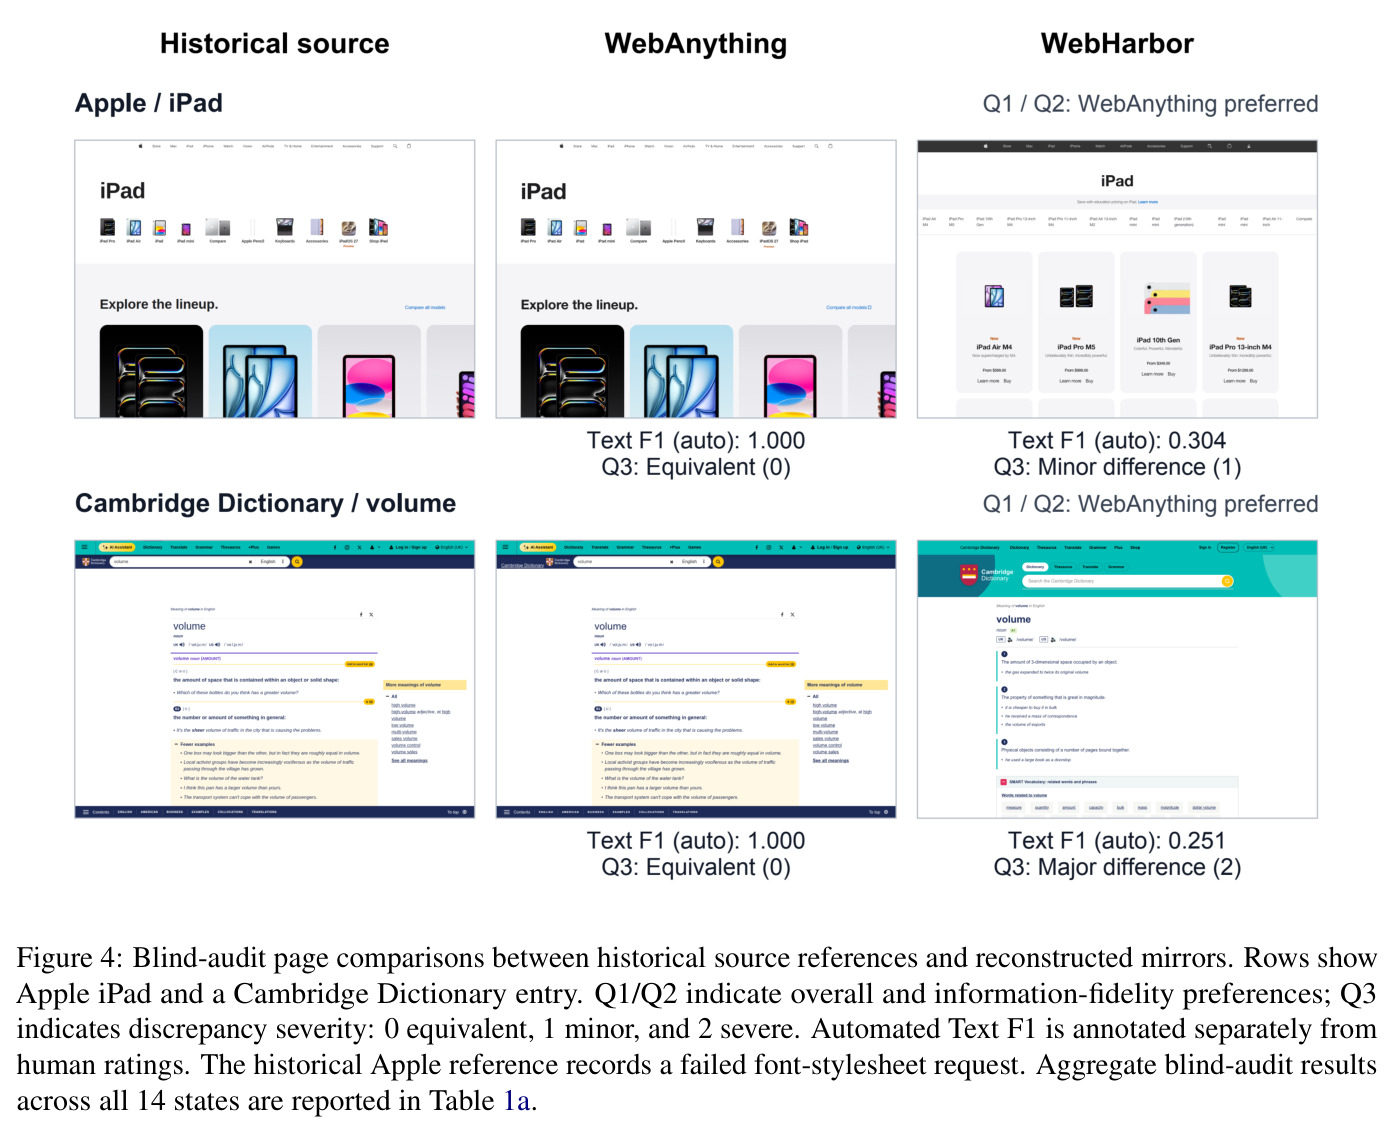
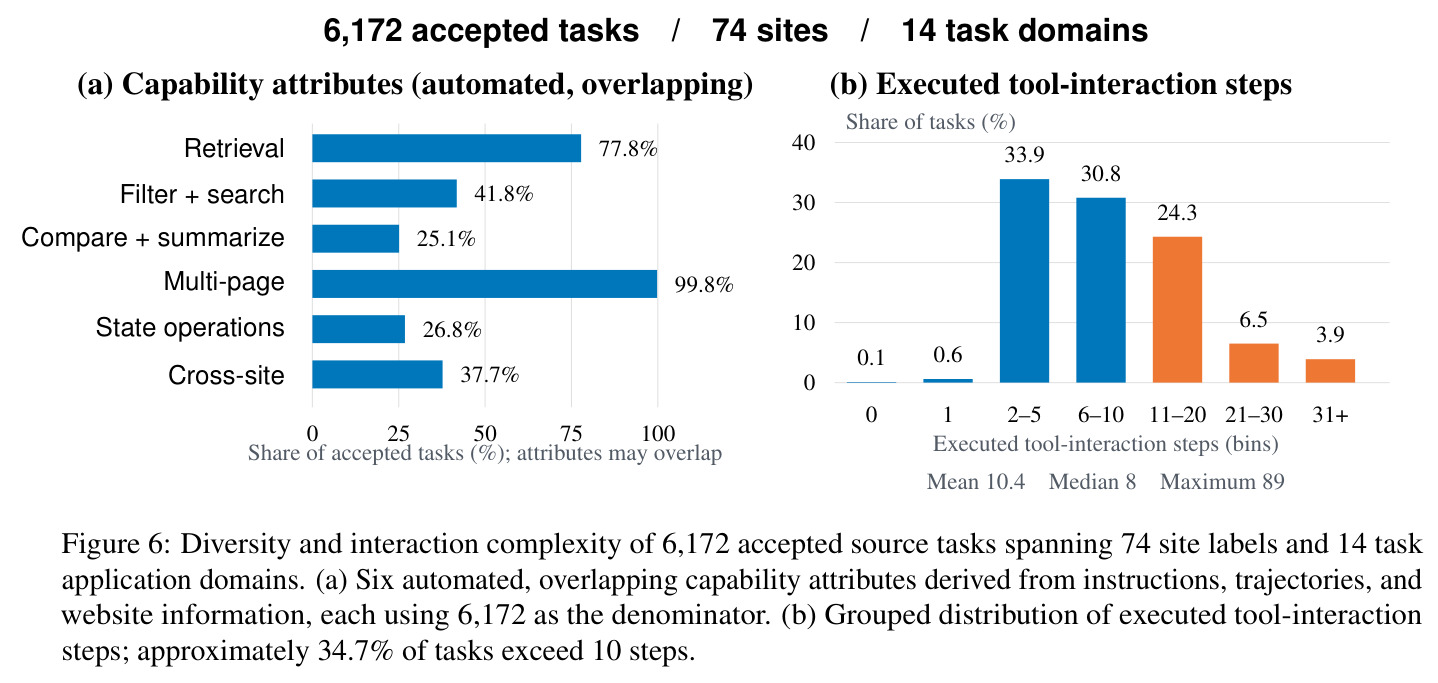
论文从规模、质量、任务供给三个研究问题展开。(RQ1 规模与成本)统一流水线产出 244 个网站工件,覆盖 14 个领域、53 个类别;85 站历史构建在初始配置与授权后无任何记录在案的逐站人工实现/调试/修复,84 站可计价模型调用成本合计 220.62 美元(均值 2.63、中位数 1.60 美元/站,仅为下限,不含未计价调用与系统开销),主要使用 gpt-5.6-sol(xhigh 推理)。(RQ2 质量)在与 WebHarbor 匹配的 5 站 14 个历史状态上,WebAnything 三项聚合指标全面领先:Pixel Similarity 0.9240 对 0.8083、SSIM 0.7904 对 0.6260、Text F1 0.8541 对 0.2617;三人盲审整体保真 12 胜 2 平 0 负(胜率 85.7%),信息保真 10 胜 3 平 1 负(71.4%),差异严重度均值 0.143 对 1.429(严重差异占比 0% 对 42.9%)。交互有效性互有胜负:WebHarbor 子集上 WebAnything 能力覆盖 75%(15/20)、全测试通过率 63.3%(19/30),低于 WebHarbor 的 80% 和 76.7%;但在 VeriEnv 子集上以 100% 覆盖(22/22)、87.9% 全测试通过(29/33)优于 VeriEnv 的 90.9% 和 63.6%。验证环节:219 个自检通过对中查出 39 处证据支持的差异(跨 22 站,占 17.81%);1,007 条 issue 记录中 49 条逐条裁定,18 条修复获跨 6 站独立复验确认(14 处本地实现修复、3 处运行时修复、1 处请求生命周期问题)。(RQ3 任务与学习)两批不相交任务集共 12,984 个已执行验收任务(6,172 个跨 74 站 + 6,812 个跨 229 站,新批次完成 244×30=7,320 配额的 93.1%);属性上信息检索 77.8%、多页 99.8%、状态操作 26.8%、跨站 37.7%;实际交互深度均值 10.4 步(中位数 8、P90 21、最大 89),34.7% 的任务超过 10 步。下游 SFT(Qwen3.5-9B,5,856 条轨迹、60,517 步级样本、473 步):REAL 成功率 24.2%→34.1%(+9.9pp,逐任务 15 例失败转成功、6 例成功转失败);Odysseys-Easy Rubric Avg 19.71%→25.96%(+6.25pp)、Task Avg +6.32pp、完美任务 2/44→4/44;WebArena-Verified Overall 16.41%→29.74%(+13.33pp),其中 Mutate +31.50pp、Navigate +18.49pp、Retrieve 在严格判分下 −8.75pp(若忽略 JSON 格式判分,Retrieve 从 39/325=12.00% 升至 105/325=32.31%)。数据源消融:在相近轨迹数(661/617/663)下,WebAnything 数据在 Odysseys-All 189 个共同任务上 Rubric Avg 10.44%、Task Avg 11.70%,高于 WebHarbor(6.93/7.79)与 VeriEnv(6.42/7.53)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 历史源状态保真(5 站 / 14 态 WebHarbor 匹配子集) | Pixel Similarity ↑ | 0.9240 | WebHarbor 0.8083 | +0.1157 |
| 历史源状态保真(5 站 / 14 态) | SSIM ↑ | 0.7904 | WebHarbor 0.6260 | +0.1644 |
| 历史源状态保真(5 站 / 14 态) | Text F1 ↑ | 0.8541 | WebHarbor 0.2617 | +0.5924 |
| 整体源状态保真人工盲审(14 个历史状态,3 人共识) | 胜-平-负 / 胜率 | 12 胜 2 平 0 负(85.7%) | WebHarbor(对手侧) | 不败,胜率 85.7% |
| 差异严重度盲审(Q3:0 等价 / 1 轻微 / 2 严重) | 平均严重度 ↓ | 0.143(严重 0/14) | WebHarbor 1.429(严重 6/14,42.9%) | 降低 1.286 |
| 离线交互有效性(5 站 VeriEnv 子集) | 全测试通过率 | 29/33(87.9%) | VeriEnv 21/33(63.6%) | +24.3pp(能力覆盖 100% 对 90.9%) |
| REAL(91 个联合有效任务,Qwen3.5-9B SFT) | 成功率 | 34.1% | 未训练 Qwen3.5-9B 24.2% | +9.9pp |
| Odysseys-Easy(44 个联合有效任务) | Rubric Avg / Task Avg | 25.96% / 25.18% | 19.71% / 18.86% | +6.25pp / +6.32pp |
| WebArena-Verified(固定 harness,严格判分) | Overall 成功率 | 29.74% | 16.41% | +13.33pp(Mutate +31.50pp) |
| Odysseys-All(189 个共同任务,数据源消融) | Rubric Avg / Task Avg | 10.44% / 11.70% | WebHarbor 6.93%/7.79%,VeriEnv 6.42%/7.53% | +3.51~4.02pp / +3.91~4.17pp |
局限与改进
作者承认的局限:SFT 验证只在 Qwen3.5-9B 规模进行,未系统评估更大基础模型、不同后训练方法或更大训练预算;环境只在特定时间点重建与验证,未评估镜像时效性以及源站持续变化下的长期维护成本;高保真重建涉及版权、商标和服务条款,环境分发范围受内容授权约束。我的补充观察:主保真对比只覆盖 5 站 14 个历史状态,且 Apple/ESPN 的历史参考本身带渲染缺陷、源站与镜像的 JavaScript 渲染条件不同(源文本来自 JS 禁用的回放、镜像文本来自 JS 启用的捕获),Text F1 的悬殊差距部分来自这种不对称;功能覆盖并未全面胜出——WebHarbor 子集上交互覆盖与全测试通过率反而更低,说明视觉保真与功能覆盖是两个独立维度;39 处差异中只有 1 处满足候选与语义目标双重严格匹配,证据链强度有限;盲审仅 3 名标注者讨论达成共识、未报告标注者间一致性;SFT 基线只是同一模型不训练,Retrieve 项严格判分下的回退原因未定位;85 站历史子集没有统一验收标准下的完整尝试队列,因此无法报告统一的构建成功率;新批次中 244 站里仍有 15 站零任务、12 站未满配额。
独立分析的弱点
独立分析四个弱点并给出改进方向。(1)功能覆盖短板:WebHarbor 子集上能力覆盖 75%(15/20)低于对手的 80%,全测试通过率 63.3% 对 76.7%,例如 Cambridge 镜像缺少查无此词的显式无结果反馈;改进方向是把 Just-in-Time Coverage 与任务依赖图结合,把被测任务所需的交互能力优先纳入契约与验收清单,并对否定路径(空结果、错误提示、越界输入)做强制检查。(2)验证证据链不够严格:39 处差异中仅 1 处满足候选身份与语义目标双重严格匹配,其余 38 处在候选、检查范围或运行条件上不完全对齐;改进方向是为每类检查定义确定性协议——固定候选摘要算法、固定检查集、固定浏览器与视口,使 Builder–Verifier 配对天然严格,并报告校准后的查全/查准率。(3)评估规模小且受基础设施失败影响:保真对比仅 14 个状态,SFT 联合有效任务只有 91/44 个,REAL 上 SFT 模型出现 11 例基础设施失败,分母选择会改变结论(+9.9pp 对 +8.8pp);改进方向是扩充匹配站点集、报告置信区间,并预注册含失败的主指标。(4)闭环不覆盖长期演化与真实改版:网站持续变化,当前只有时间点快照;改进方向是源站变更检测(结构 diff 抓取)、增量证据更新、镜像自动修补,并把维护成本量化为每站每季度美元数。此外 Retrieve 回退提示格式训练问题,可在 SFT 数据中加入判分格式对齐样本。
未来方向
作者提出的方向:在更大规模模型、不同后训练方法(如强化学习)和更大训练预算下验证环境数据的价值;研究源站变更检测、增量证据采集与本地环境更新,在保持源站对应的同时降低维护成本;发布通用构建框架、评测协议和去标识化研究数据,按许可证决定镜像与原始资源的分发范围。基于成果可延伸的方向:(1)在重建环境中做在线 RL——固定初始状态、复位机制与可验证奖励恰好构成闭环条件,可复用 WebRL 式自进化课程,把 6,812 个新任务作为起点;(2)验证器校准研究:把 139 对『自检通过但独立验证失败』的案例变成验证器训练/评测集,量化独立验证相对自检的增量查全率;(3)扩展长程多阶段任务供给——论文自述长时程、强中间状态依赖的任务覆盖有限,34.7% 超 10 步但 31 步以上仅 3.9%;(4)跨环境组合:37.7% 任务已具跨站属性,可构建跨环境工作流评测智能体的规划与迁移能力;(5)用步级轨迹训练过程奖励模型或 GUI grounding 模型,为无奖励环境提供稠密监督;(6)把构建成本曲线(均值 2.63 美元/站)外推到万站级,研究预算分配与覆盖率/保真的权衡。
复现评估
复现条件中等偏上。开源与材料:代码以 Web-Anything 名义发布在 GitHub;补充材料包含 244 站完整清单(截图哈希、审计状态)、14 领域/53 类别映射、113 站附加审查标记、原始 1440×1000 截图与摘要、独立验证器英文模板(supplementary-prompts.tex)、以及恢复出的训练配置(Table 11:BF16、冻结视觉编码器与投影层、AdamW 解耦权重衰减 $10^{-4}$、学习率 $5\times10^{-6}$ 余弦衰减 24 步预热、全局 batch 256、473 步约 2 个数据 pass、最大序列 262,144、8 节点×8 GPU 共 64 卡、张量并行 2)。数据与算力:构建成本极低(84 站均值 2.63 美元),但依赖 gpt-5.6-sol(xhigh)等前沿闭源 API 与浏览器自动化;SFT 需要 64 张 GPU,小规模复现可缩减数据与步数。主要障碍:环境与镜像分发受版权、隐私和授权限制,完整站点镜像未必公开,可能只发布框架与去标识化数据;历史构建混用了不同模型与阈值版本(如 fidelity v19),且没有统一验收标准下的完整尝试队列,完全对齐论文数字需要较强工程能力和源站授权。概念与流程描述清晰、接口定义完整,复现框架本身可行,精确复现 244 站工件较难。
论文图表
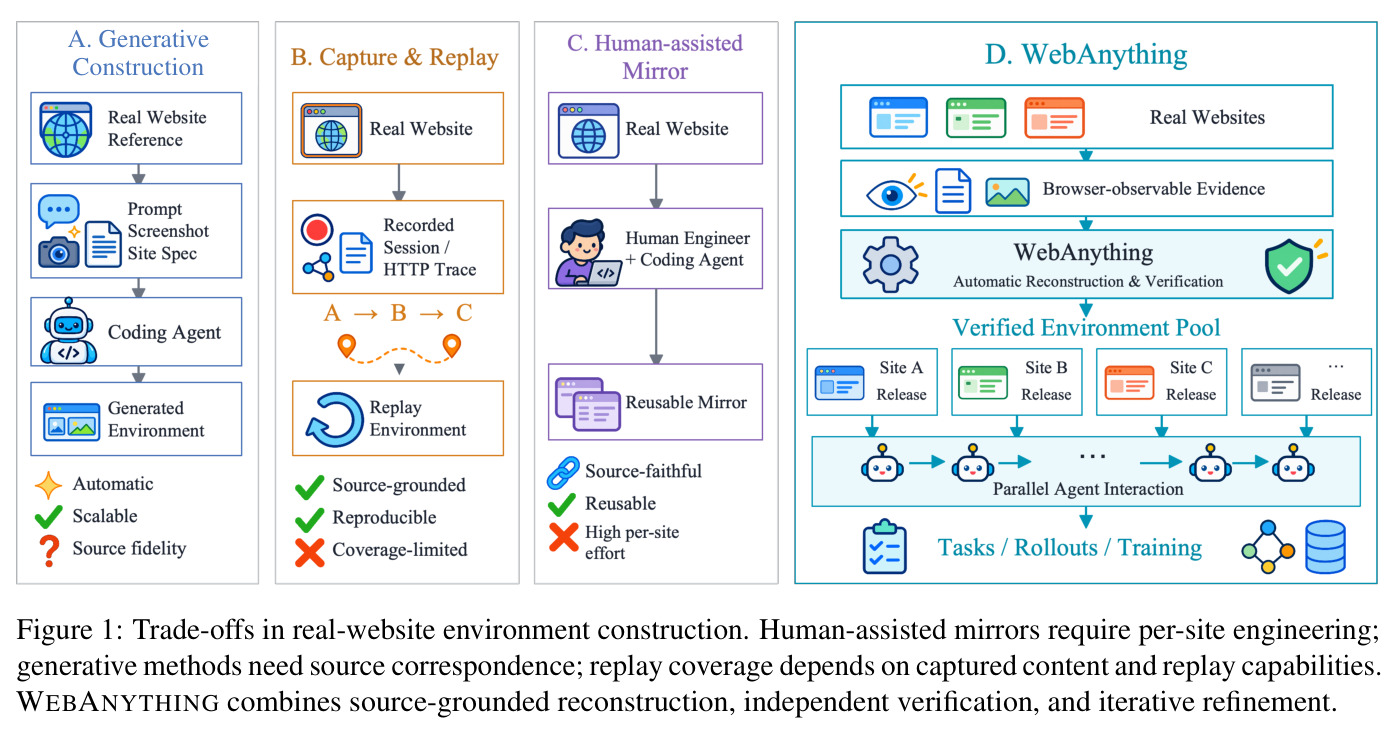
三栏对比示意:人工辅助镜像需要逐站工程;生成式构造缺乏对指定源站的对应性;录制回放的交互覆盖受录制内容与回放能力双重限制。WebAnything 以『源站证据重建 + 独立验证 + 迭代精化』的组合取三者之长。
一图看懂本文的问题定位与差异化主张,是理解全文动机(自动化、源站保真、交互覆盖的三角权衡)的入口。