VidDub:替换感知蒸馏的两步视频配音 VidDub: Replacement-Aware Distillation for Two-Step Video Dubbing
替换感知监督解耦口型重建冲突,全上下文扩散教师蒸馏成两步模型实现高同步视频配音
前置知识
流匹配(Flow Matching)
连续归一化流式生成范式:对干净 latent $z$ 与高斯噪声 $\epsilon$ 做线性插值 $x_\sigma=(1-\sigma)z+\sigma\epsilon$,训练网络回归速度场 $v^*=\epsilon-z$,推理时沿 ODE 用欧拉步积分去噪。相比 DDPM 的噪声预测,流匹配轨迹更直、步数更少,是 Wan 等新一代视频扩散基座的训练目标。
VidDub 的教师与学生全部建立在这个目标上:论文中的掩蔽监督就是给逐点速度误差乘上空间权重 $q\in\{w(M),\bar{M}\}$,看不懂流匹配就看不懂核心损失的设计。
分类器无关引导(CFG)
无需单独训练分类器即可放大条件影响的采样技巧:同时用条件 $a$ 与空条件 $\varnothing$ 前向,按 $v^{(g)}=v(x,\varnothing)+g[v(x,a)-v(x,\varnothing)]$ 外推,引导强度 $g>1$ 会让输出更贴合音频/文本条件但偏离真实分布。推理代价是每个去噪步要做两次前向。
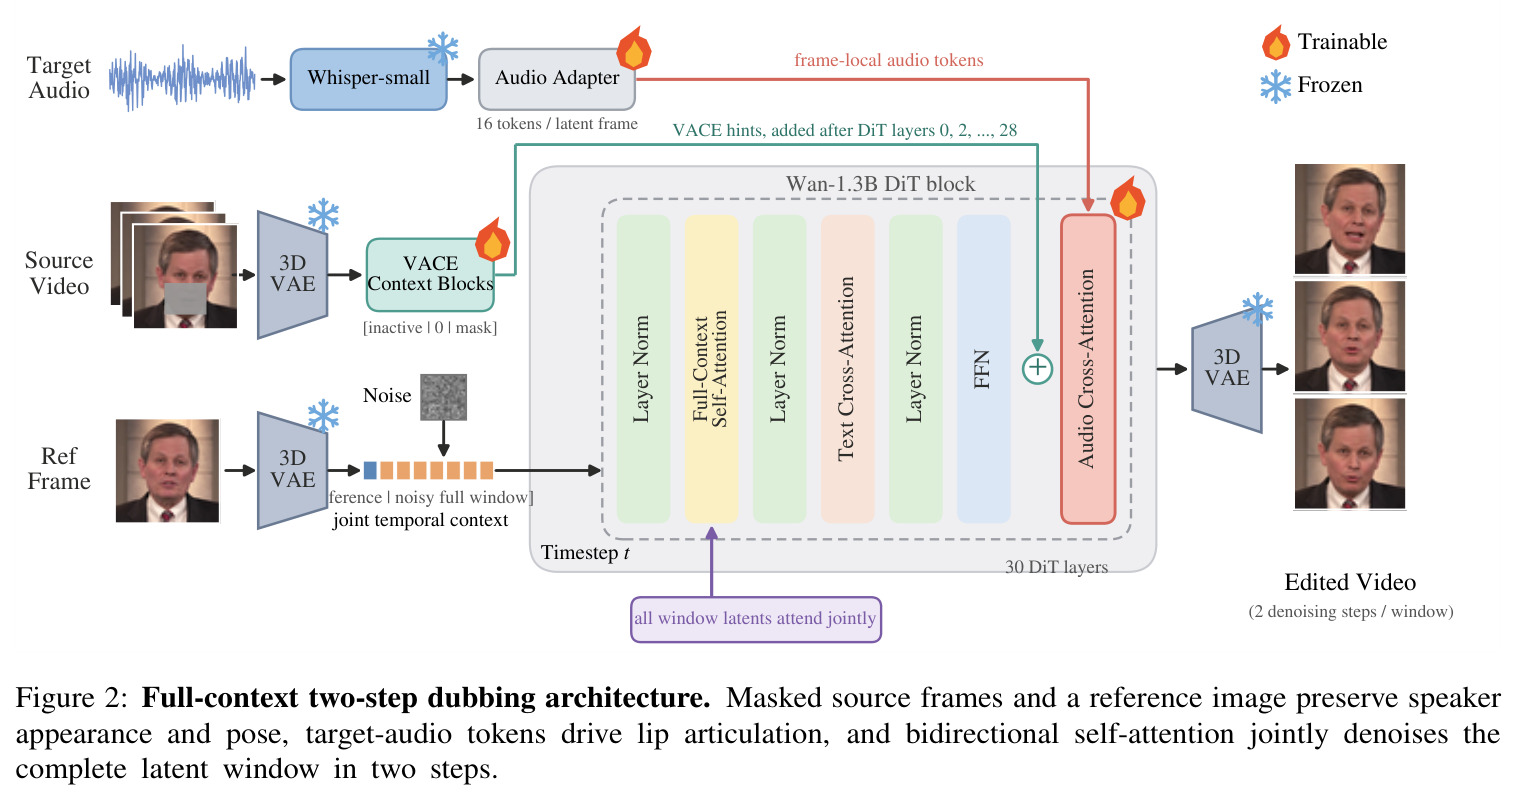
教师的音频控制力来自 CFG($g=2$),而 VidDub 的轨迹回归蒸馏把引导'吸收'进单分支两步学生,推理时每个学生步只需一次条件前向——这是 2 NFE 还能保持强同步的关键。
分布匹配蒸馏(DMD)
一种少步蒸馏后处理:维护一个冻结的'真分数'(真实视频分布)和一个在线训练的'假分数'(学生生成分布),在噪声水平 $\sigma$ 下分别得到干净估计 $\hat{z}_r=x_\sigma-\sigma v_r$ 与 $\hat{z}_f=x_\sigma-\sigma v_f$,用停止梯度方向 $d=(\hat{z}_f-\hat{z}_r)/\max(\mathrm{mean}|z-\hat{z}_r|,10^{-6})$ 更新生成器,使学生的输出分布对齐真实分布,弥补轨迹回归只匹配终点的不足。
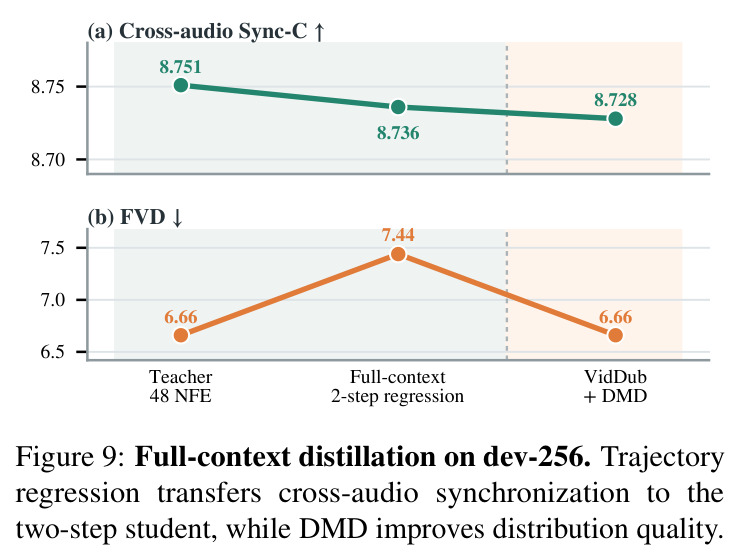
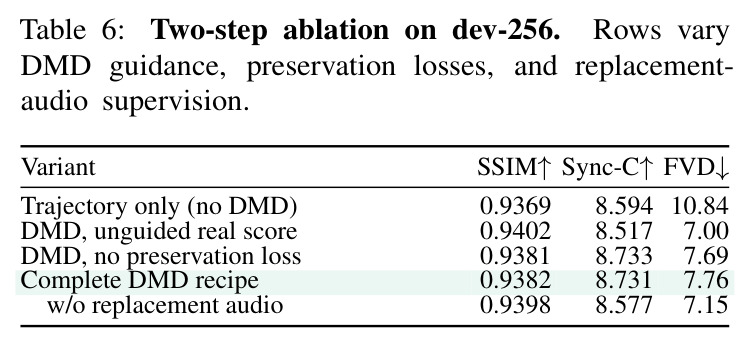
论文的三阶段蒸馏最后一步就是引导版 DMD2:消融显示仅轨迹回归时 FVD 为 10.84,加 DMD 后降到 7.76,是两步模型视觉质量的直接来源。
SyncNet 与 Sync-C/Sync-D 指标
SyncNet 是音视频同步判别网络:输入下脸图像嵌入 $e_v$ 与对齐 mel 谱嵌入 $e_a$,训练目标即余弦相似度。Sync-C 是置信度分数(越高同步越好,真实同音视频约 8–9),Sync-D 是欧氏距离(越低越好)。论文训练时用冻结的 LatentSync-1.6 StableSyncNet 提供可微同步损失,评测时改用官方 S3FD/SyncNet-v2 管线。
替换感知监督的核心就是在替换音频下'只用 $\mathcal{L}_{sync}=-\log[\max(\cos(e_v,e_a),10^{-6})]$ 驱动口型',同时所有主结果都以 Sync-C/D 为主指标,必须理解其含义才能读懂实验。
VSR(视觉语音识别/唇读)
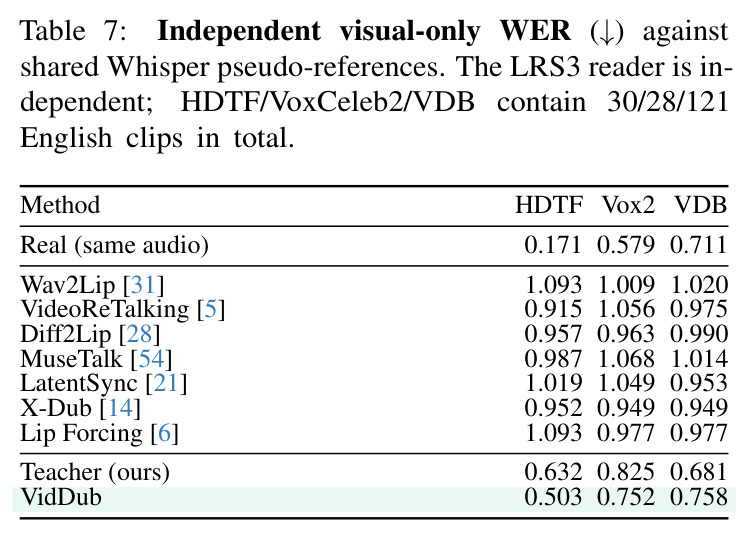
只看视频不听音频就把说的话转写成文字的模型。论文使用在 LRS3 上训练的独立视觉语音识别器(Ma et al., 2022),对生成视频解码并与 Whisper 生成的参考转写比对,得到词错误率 WER。它衡量的不只是'嘴动得同步',而是'嘴唇发出的内容能被唇读出来'。
同步损失与评测用的都是 SyncNet 族模型,存在循环性风险;独立 VSR(与训练同步器零权重共享)是论文打破循环、证明口型真的在说替换语音的关键证据链,替换感知掩蔽让 WER 下降 $0.144\pm0.009$。
VACE 上下文条件
VACE(Video All-in-one Creation and Editing)是给视频 DiT 加的一组上下文编码块:把被遮罩的源视频、参考帧等条件经 3D VAE 编码成额外的 context token,在 DiT 的若干层插入(本文在 0,2,...,28 层),让模型在保持原有权重结构的同时获得'按 mask 编辑视频'的能力。
VidDub 的骨架是 Wan-1.3B + VACE:遮罩源帧提供外观/姿态锚定,参考帧保身份,口型区留给音频驱动;不理解 VACE 的 hint 注入方式就看不懂架构图 Figure 2。
研究动机
主流视频配音编辑器(Wav2Lip、VideoReTalking、MuseTalk 1.5、LatentSync 1.6、X-Dub 等)几乎都采用同一音频自重建训练:模型拿到原视频和与之配对的原始语音,被监督逐像素复现视频中已有的口型运动。这个目标与配音的真实测试场景系统性错位——配音要求在替换语音下改变嘴部发音、同时保持身份、头姿和背景不变。在原配音频下源口型是合法真值;一旦换成未配对的替换语音,源口型的内容与新语音直接冲突,标准重建损失(流匹配速度回归、像素 L1、LPIPS)会把生成的嘴唇往错误的源口型上拉,导致跨音频同步显著退化。更麻烦的是,以往评测以短片段同音频重建指标为主,无法暴露这一矛盾:论文补充材料的秩相关审计显示,同音频 SSIM 与跨音频 Sync-C 的方法排名相关性在 HDTF 上仅 $-0.10$、VoxCeleb2 上 $-0.30$,即'同域同音频重建好'根本不能预测'换音频后会配音'。
本文的目标是本文的目标分三层。第一,训练一个替换感知的视频配音编辑器:给定源视频和替换语音,只改口型、其余像素不动,且口型精确跟随新语音——具体做法是让监督目标'按音频是否配对'逐区域开关。第二,把 48 步的 CFG 引导扩散教师压缩成两步(2 NFE)学生,使 1.3B 级模型在单张 H20 上达到 11.3 FPS 的离线吞吐,与 14.5B 的因果两步方法竞争。第三,建立系统评测协议:覆盖高清(HDTF)、野外(VoxCeleb2)、网络视频(TalkVid-Bench)与生成域四个源域的固定配对跨音频基准,自建 256 个源不相交生成视频组成的 VidDub-Bench,配合独立于训练同步器的 LRS3 唇读评测、时间偏移校准、null 音频干预、非口型保持指标与 60 秒长视频稳定性测试,并开源训练集、基准与统一评测代码。
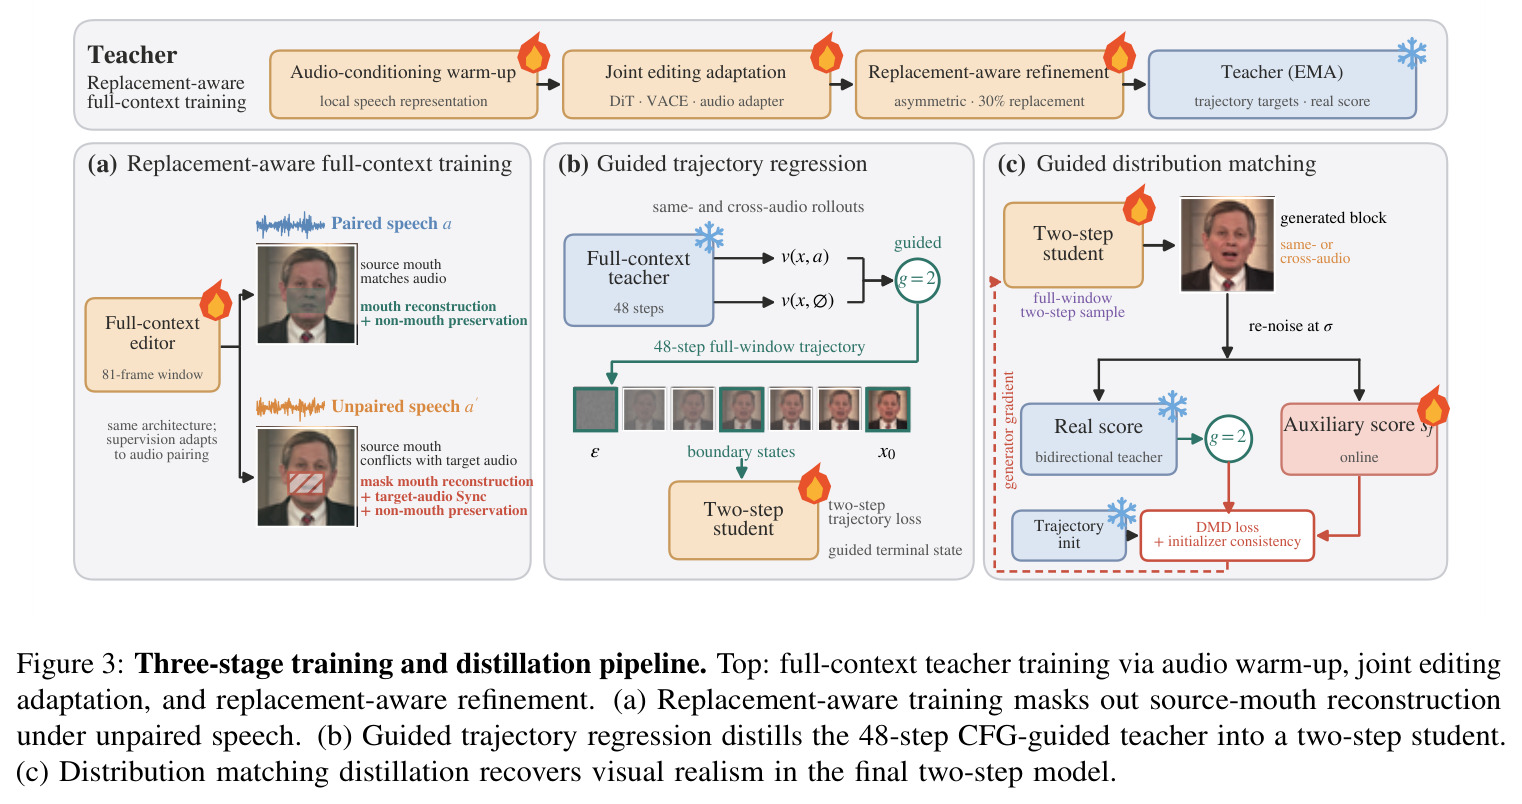
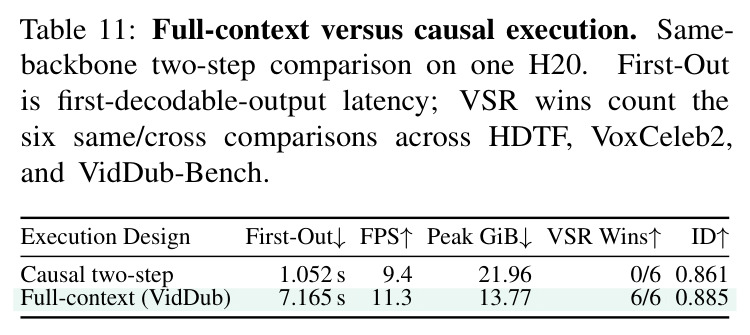
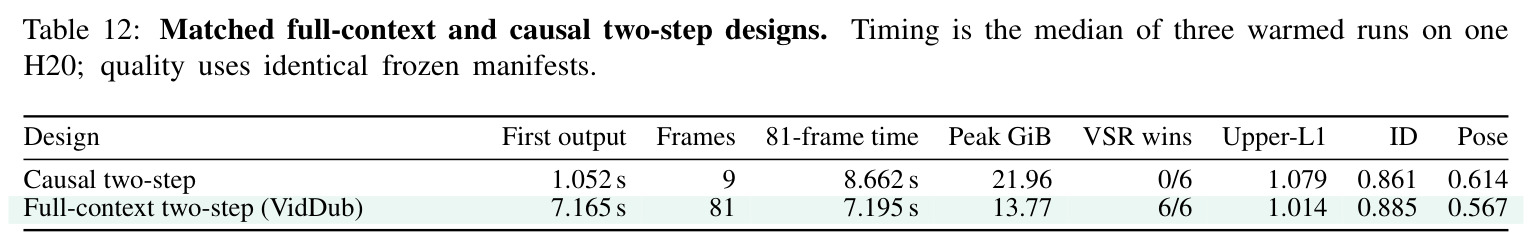
与已有工作不同的是,本文的独特切入有三点。其一,把'哪些区域是真值'变成音频配对状态的函数:配对样本用全帧重建(口型加权 $q=w(M)=1+\lambda_M M$),替换样本在口型区域 $\bar{M}=1-M$ 掩掉流匹配、像素与感知重建,仅保留可微 SyncNet 同步损失驱动嘴部、空间重建保留脸与背景——把跨音频配音重新表述为适定的人像局部编辑问题。其二,针对离线配音(源视频与目标语音在推理前已全部可得)的场景假设,保留 81 帧全窗口双向自注意力做两步蒸馏,而不是跟随 Lip Forcing/Causal Forcing 的因果流式路线,并用同骨干受控实验证明因果化只把首帧延迟降到 1.052 秒、却让吞吐(9.4 vs 11.3 FPS)、峰值显存(21.96 vs 13.77 GiB)和 VSR(0/6 vs 6/6)全面变差。其三,蒸馏目标不是源口型而是教师在替换语音条件下的 CFG 引导轨迹,从源头避免蒸馏阶段重新引入冲突监督。
核心方法
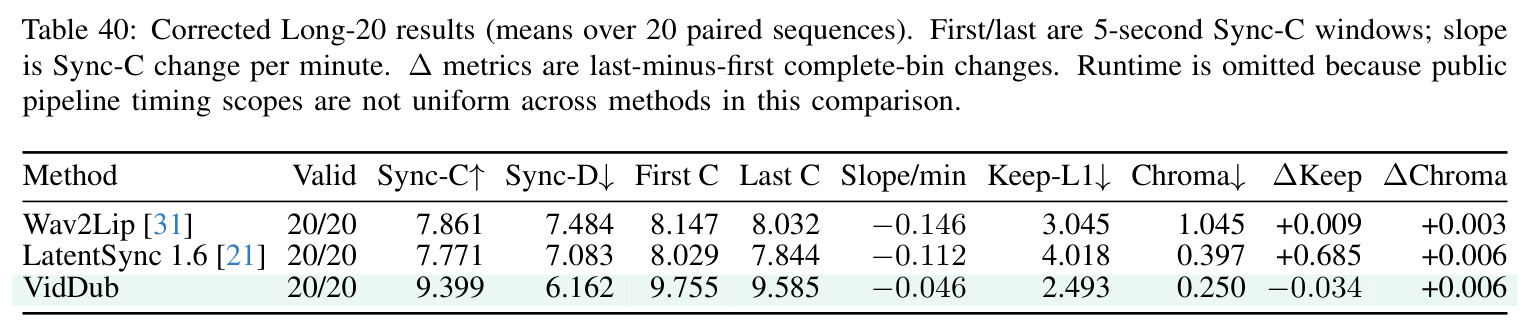
直觉上,口型区域的监督必须'按音频是否配对'开关——原音在时它是真值要学,替换音在时它是冲突源要屏蔽;而脸的其他区域、头姿和背景在两种情形下都是真值,必须始终保留。技术路线上,VidDub 基于 Wan-1.3B DiT,叠加 VACE 上下文块编码被遮罩的源视频与机械选取的参考帧,并用一个 287M 的音频适配器把冻结 Whisper-small 的逐帧特征(每个视频 latent 帧 16 个 token,约 320ms)注入全部 30 个 DiT 块的交叉注意力;21 个视频 latent 加 1 个参考 latent 在 81 帧(3.375 秒)窗口内做双向全上下文自注意力。训练分三阶段:(a) 替换感知教师训练——先音频适配器 warm-up,再联合编辑适配,最后以 70% 配对 / 30% 替换音频的混合做精调;(b) 轨迹回归——把 48 步 CFG 教师在同噪声、同边界状态下的终端 latent 作为停止梯度目标,匹配进两步学生;(c) 引导分布匹配蒸馏——用 $g=2$ 的引导真分数与在线假分数恢复两步压缩损失的视觉真实感。推理时每个 81 帧窗口只需 2 次去噪;长视频以 64 帧步进、17 帧重叠的滑窗混合,60 秒视频同步不衰减(每分钟斜率 $-0.046$)。
核心创新是替换感知跨音频监督(replacement-aware cross-audio supervision)。对未配对的替换音频样本,流匹配、像素和感知重建损失都在口型区域内被掩掉,即空间权重取 $q=\bar{M}=1-M$(对比配对样本 $q=w(M)=1+\lambda_M M$,$\lambda_M=2$),同时用冻结 LatentSync-1.6 StableSyncNet 的 cosine-log 损失 $\mathcal{L}_{sync}=-\log[\max(\cos(e_v,e_a),10^{-6})]$(不做时间滞后搜索)把梯度经冻结同步器与 VAE 解码器反传回生成器,让目标语音成为嘴部运动的唯一驱动力。关键细节是 latent $z$ 直接从未编辑源视频 $V^{src}$ 编码(而非合成伪目标),其口型区反映原始音频 $A^{src}$,掩蔽保证没有任何流/像素/感知损失把嘴唇拉回冲突的源口型。与已有方法的本质区别在于:此前所有编辑器都无法区分'源口型是真值还是冲突',本文第一次把这个冲突显式建模进损失设计;再配合'全上下文两步蒸馏'——保留双向时间注意力、把 CFG 吸收进单分支学生的轨迹匹配加 DMD——构成与因果少步方案正交的完整路线。
方法步骤详情
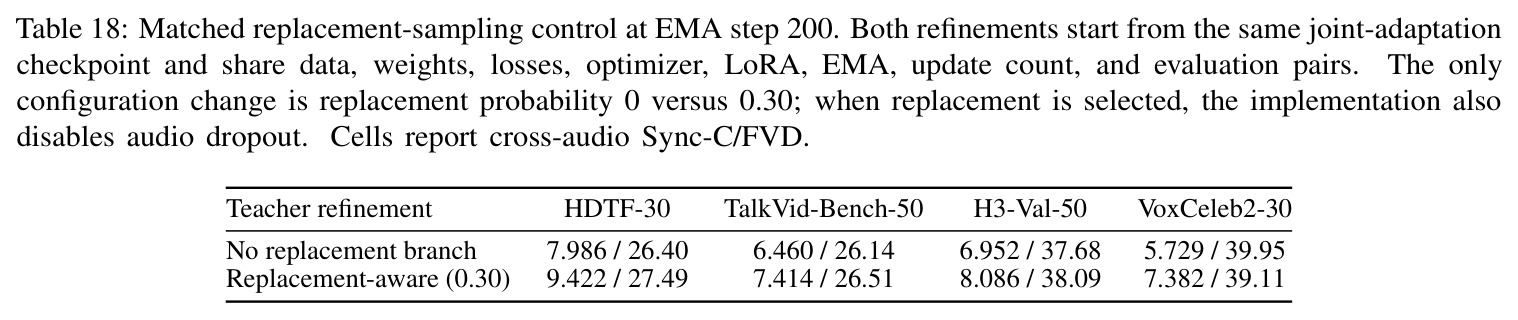
阶段 (a) 教师训练:先音频适配器 warm-up(49 帧、48 GPU、6,000+2,000+9,700 次更新,适配器学习率 $10^{-4}\to5\times10^{-5}$,DiT/VACE 冻结);再联合编辑适配(81 帧,DiT 与 VACE 全参数 $10^{-5}$,3,000+2,500 次更新);最后替换感知精调(DiT LoRA-64 学习率 $5\times10^{-5}$、VACE $2\times10^{-6}$,仅 300 次更新、16 GPU),替换比例 0.30,同步损失权重 0.02 且限制在 $\sigma\le0.8$,导出 EMA@200。损失为:配对样本 $\mathcal{L}_{same}=\mathcal{L}_{FM}^{w(M)}+\lambda_{pix}\mathcal{L}_{pix}+\lambda_{perc}\mathcal{L}_{LPIPS}+\lambda_{sync}\mathcal{L}_{sync}+\lambda_{keep}\mathcal{L}_{keep}$;替换样本 $\mathcal{L}_{cross}=\mathcal{L}_{FM}^{\bar{M}}+\lambda_{sync}\mathcal{L}_{sync}+\lambda_{keep}\mathcal{L}_{keep}$,其中 $\mathcal{L}_{keep}=\|\bar{M}\odot(D(z)-V^{src})\|_1/\|\bar{M}\|_1$ 强制口型外像素不动。阶段 (b) 轨迹回归:冻结 4,096 条完整轨迹(同/跨音频 1:1,替换语音同域同语言但来自不同源视频),以教师 CFG 输出 $v^{(g)}=v(x,\varnothing)+g[v(x,a)-v(x,\varnothing)]$ 的终端 latent $\tilde{z}_{T,g}$ 加 stop-gradient 为目标,优化 $\mathcal{L}_{traj}=\|\Psi^{(2)}_\phi(x_\tau,c)-\mathrm{sg}(\tilde{z}_{T,g})\|^2+\lambda_{traj}^q\,\mathcal{L}^{s/c}_q$,同分支含像素/LPIPS/同步/保持四项,跨分支只保留同步与非口型保持。阶段 (c) 引导 DMD:冻结引导真分数($g=2$)+ 在线假分数(每个生成器更新做 5 次假分数更新),方向 $d=(\hat{z}_f-\hat{z}_r)/\max(\mathrm{mean}|z-\hat{z}_r|,10^{-6})$,另加同噪声同时序到冻结初始化器的保留损失(权重 0.10)与分支化质量项(替换分支禁像素/LPIPS/Sync),替换比例 0.50。数据上教师池共 322,513 段(85,435 段自建 H3 生成 + TalkVid 152,713 + SpeakerVid 57,727 + Hallo3 17,674 + HDTF 6,527 + VoxCeleb2 2,437),按 30/20/15/12/8/10 域加权采样。
技术新颖性
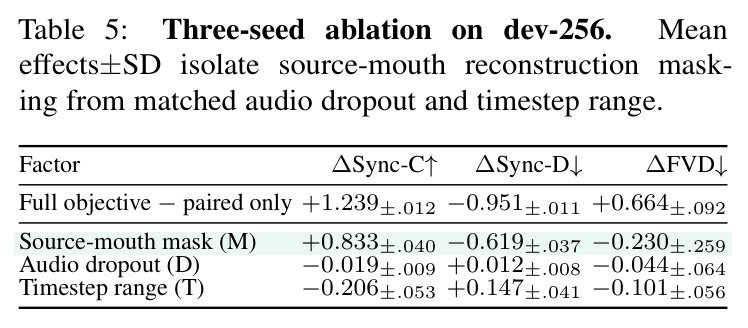
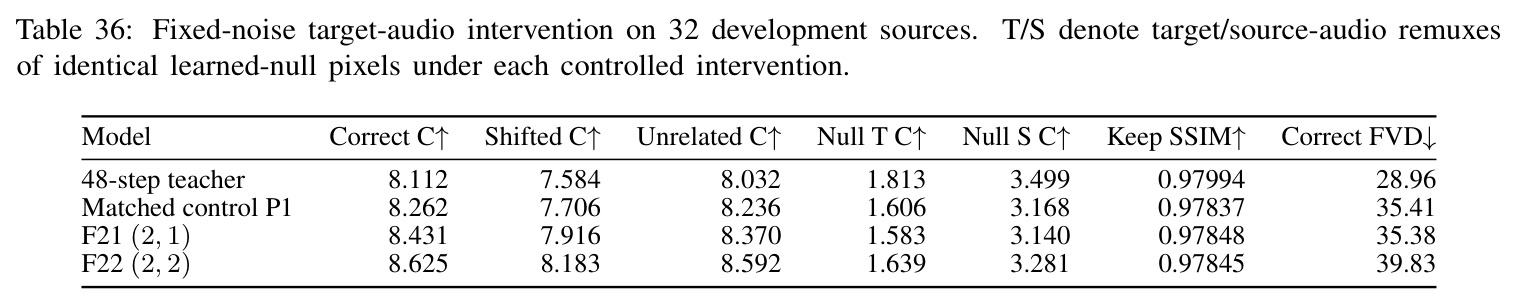
技术新颖性体现在四个层面。第一,监督设计:'按配对状态掩蔽口型重建'是一个极简却被整个领域忽视的修复;作者用三种子 $2^3$ 析因实验(源口型掩蔽 M × 音频丢弃 D × 时间步范围 T)证明主效应确实来自掩蔽本身($\Delta$Sync-C $+0.833\pm0.040$),而音频丢弃($-0.019$)和时间步策略($-0.206$)效应很小甚至为负,因果归因干净。第二,蒸馏路线:不同于把双向模型改造成因果流式的 Lip Forcing/Causal Forcing,本文证明离线场景下全窗口双向注意力在吞吐(11.3 vs 9.4 FPS)、峰值显存(13.77 vs 21.96 GiB,低 37%)和独立 VSR(6/6 全胜)上全面占优,因此直接对双向教师做 CFG 吸收式两步轨迹回归,而不是先因果化再蒸馏。第三,DMD 分支化:同/跨音频使用不同的质量损失组合,替换分支禁用与源口型绑定的像素/LPIPS/同步项,保证蒸馏不重新引入冲突。第四,评测体系:VidDub-Bench 固定配对清单、独立 LRS3 唇读、时间偏移校准($|k|\le3$ 帧时估计偏移精确等于施加偏移)、null 音频干预(null 输出 Sync-C 1.639 vs 正确音频 8.625)构成可复核的因果证据链,这在配音文献中少见地严格。
实验结果
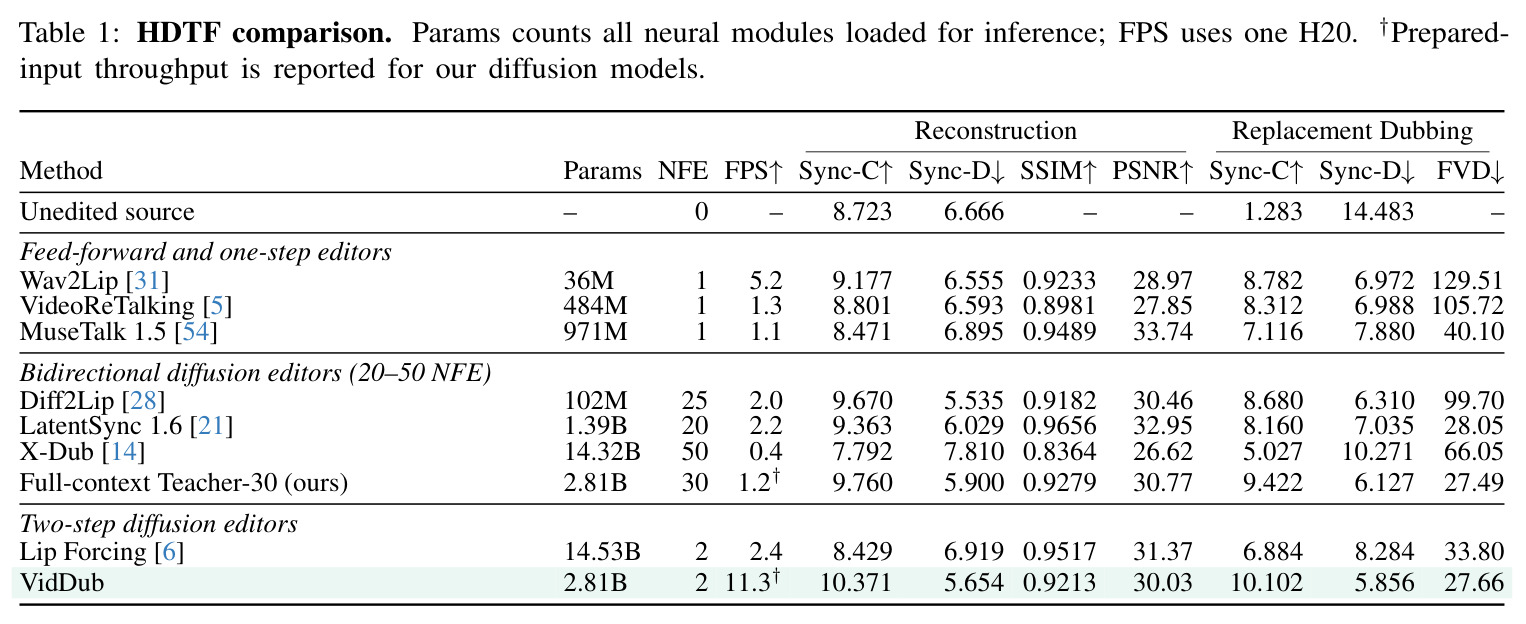
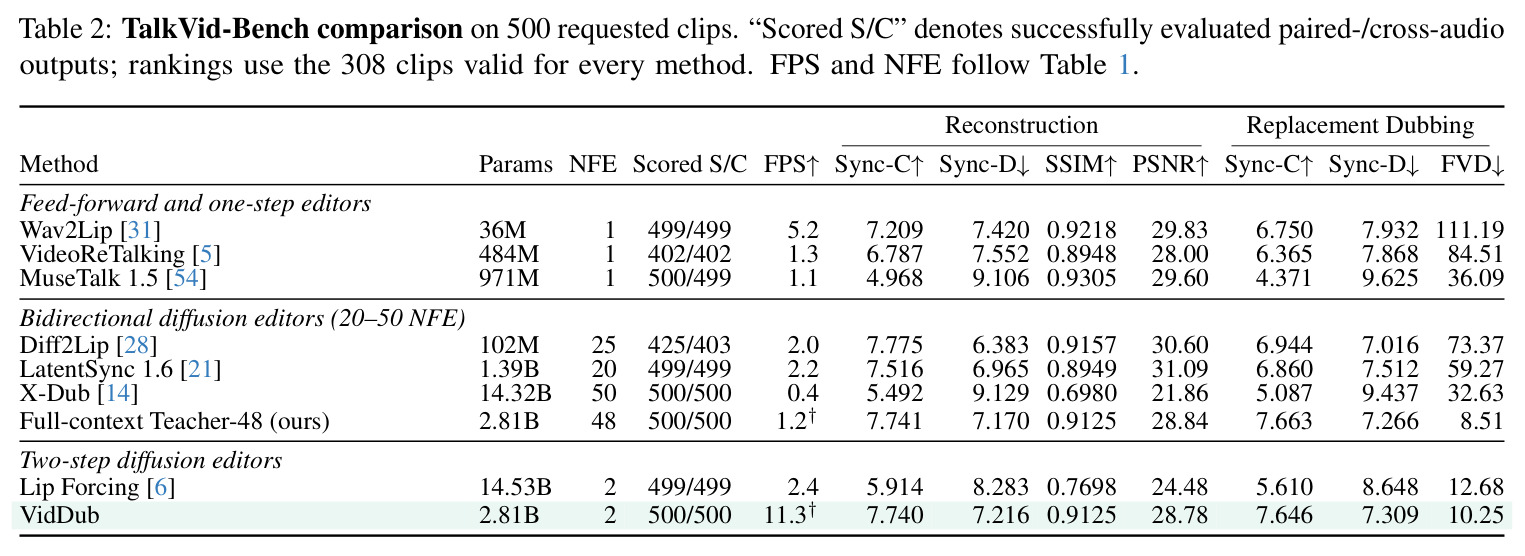
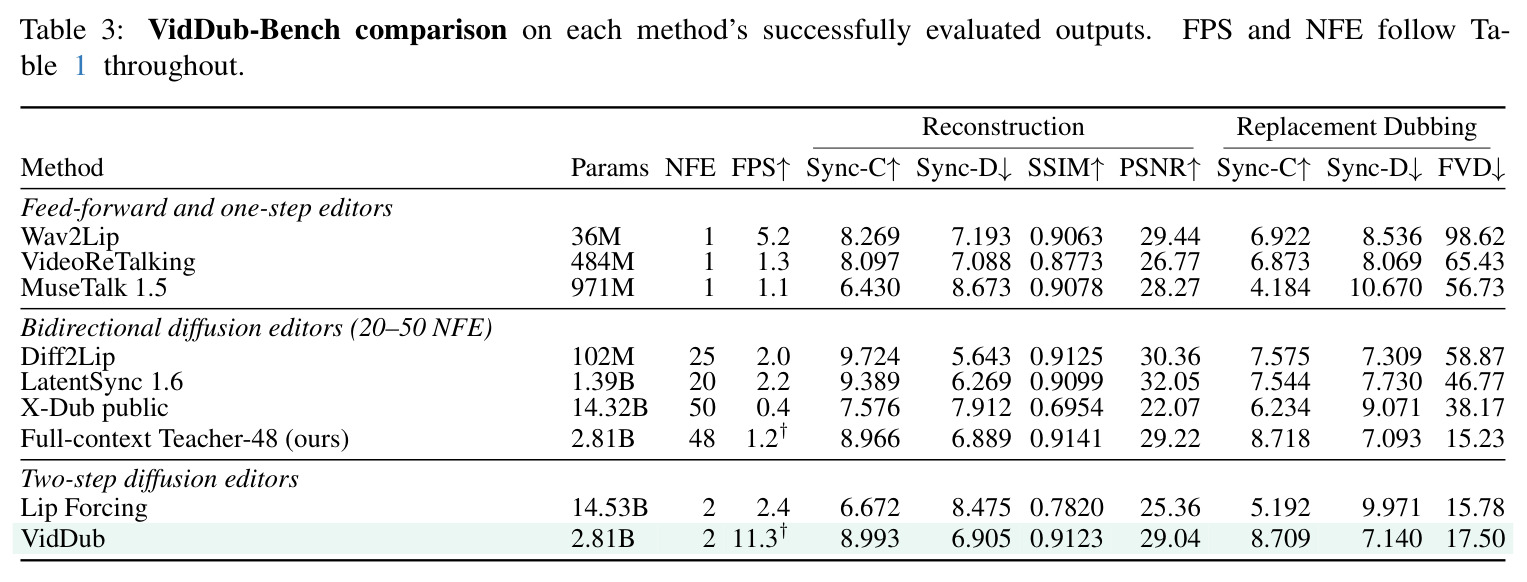
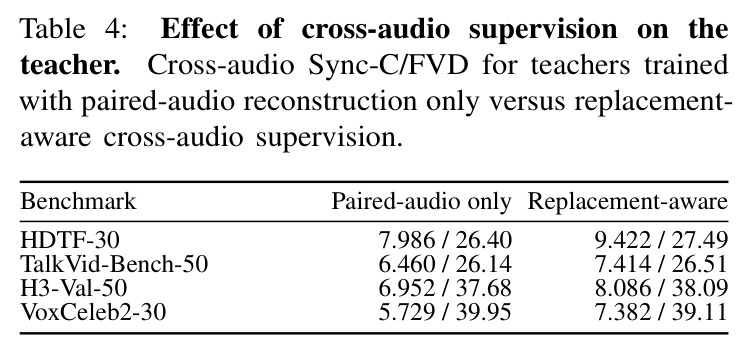
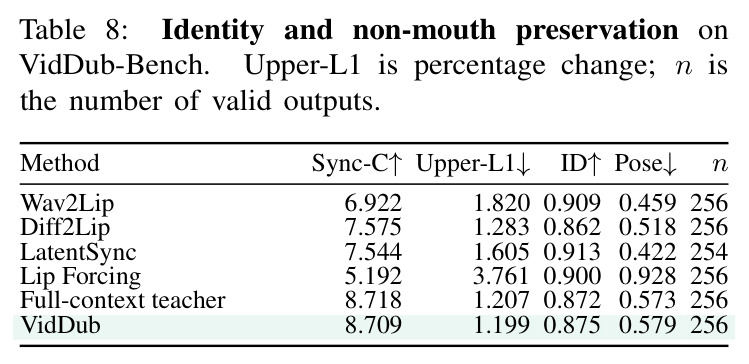
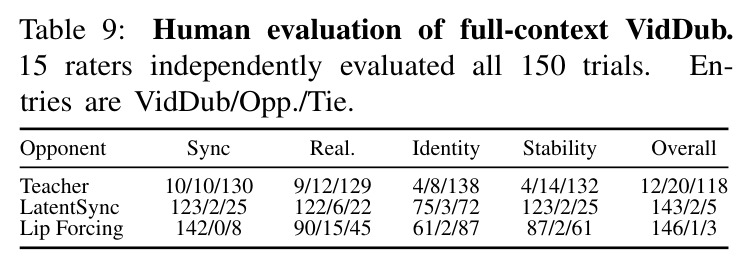
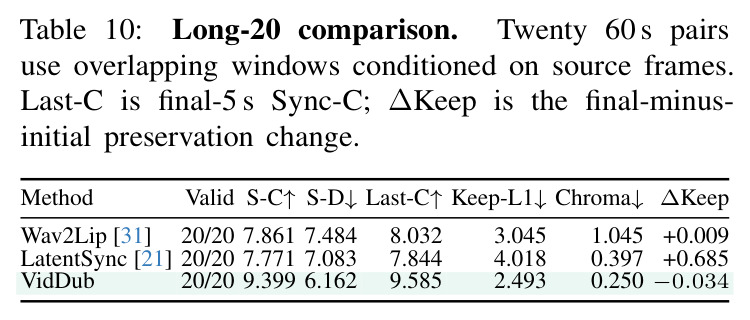
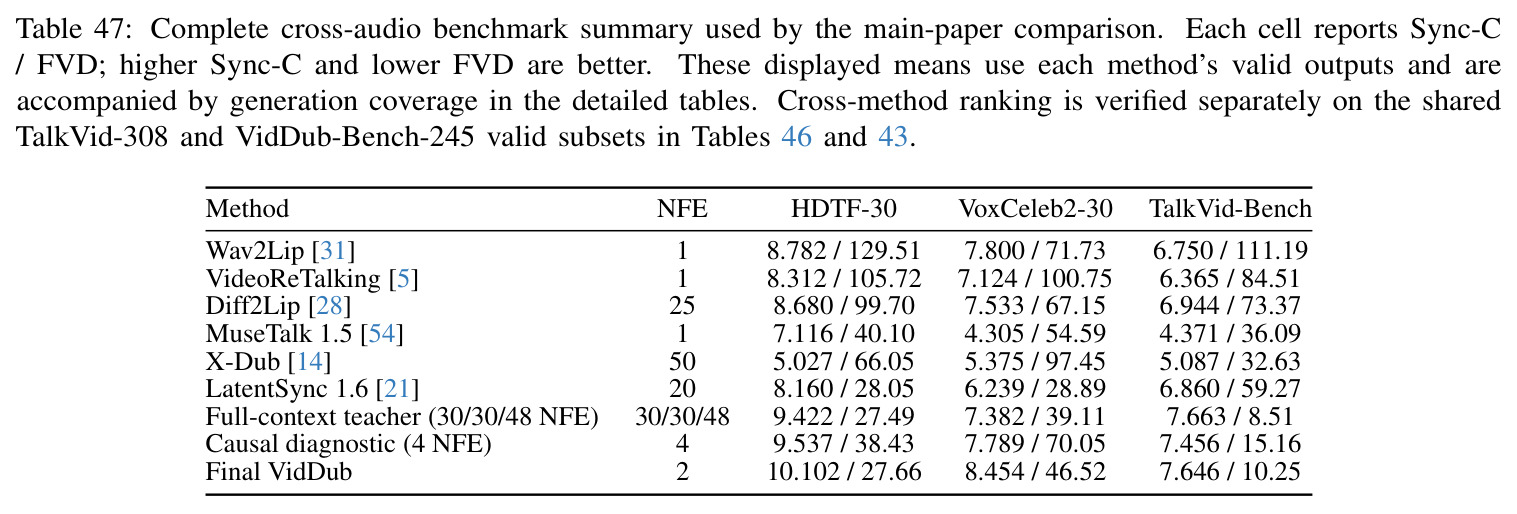
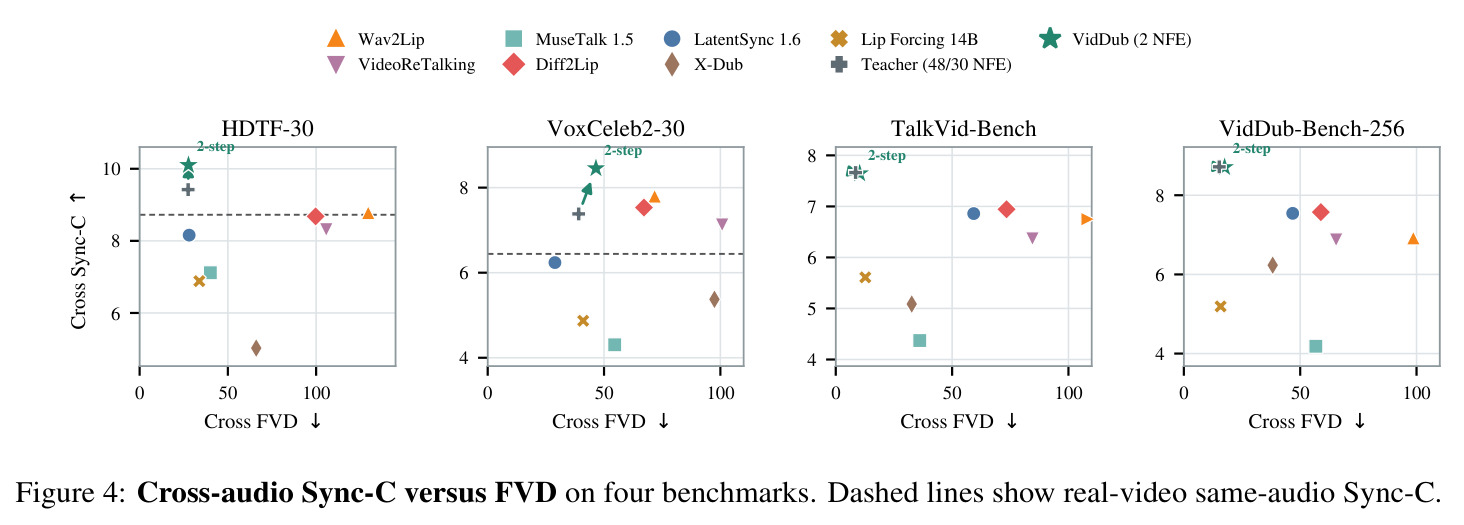
逐一分析核心实验。教师消融(Table 4/18):加入替换感知分支后四个基准跨音频 Sync-C 全部配对提升——HDTF-30 从 7.986 升至 9.422(+1.436)、TalkVid-Bench-50 6.460→7.414、H3-Val-50 6.952→8.086、VoxCeleb2-30 5.729→7.382(+1.653),10,000 次源级 bootstrap 的 95% 区间(如 HDTF [1.304,1.560])全部大于零;三种子析因(Table 5)给出掩蔽主效应 $+0.833\pm0.040$,独立唇读 WER 同步下降 $0.144\pm0.009$、CER 下降 $0.116\pm0.007$。最终模型对比(Tables 1–3):HDTF-30 上 2 NFE 达跨音频 Sync-C 10.102、Sync-D 5.856、FVD 27.66,超过 30 步教师(9.422/27.49)与全部外部方法(Diff2Lip 8.680、LatentSync 8.160、Lip Forcing 6.884),吞吐 11.3 FPS 为 Lip Forcing(2.4 FPS)的 4.7 倍且参数量 2.81B vs 14.53B;TalkVid-500 上 7.646/10.25 并 500/500 全覆盖;VidDub-Bench-245 公共子集 Sync-C 8.709,保留教师 8.718 的 99.9%。唇读(Table 7):WER 0.503/0.752/0.758(HDTF/Vox2/VDB)在所有方法中最低,接近真实同音视频(0.171/0.579/0.711),而 MuseTalk、LatentSync、Wav2Lip 均超过 1.0。保持性(Table 8):Upper-L1 1.199%、ArcFace ID 0.875、姿态误差 0.579°,与教师持平且远优于 Lip Forcing(Upper-L1 3.761%)。人评(Table 9,15 人 150 试):同步 142/0/8、整体 146/1/3 胜 Lip Forcing,同步 123/2/25 胜 LatentSync,对教师以平局为主。长视频(Table 10/40):60 秒平均 Sync-C 9.399、末 5 秒 9.585、每分钟衰减仅 $-0.046$、Keep-L1 2.493 最低。干预验证(Table 36):固定噪声下换 null 音频 Sync-C 从 8.625 跌至 1.639,证明口型确由语音驱动。效率(Table 11/12):全上下文比因果同骨干吞吐高 20%、峰值显存低 37%、VSR 6/6 全胜,因果仅在首帧延迟占优(1.052s vs 7.165s)。
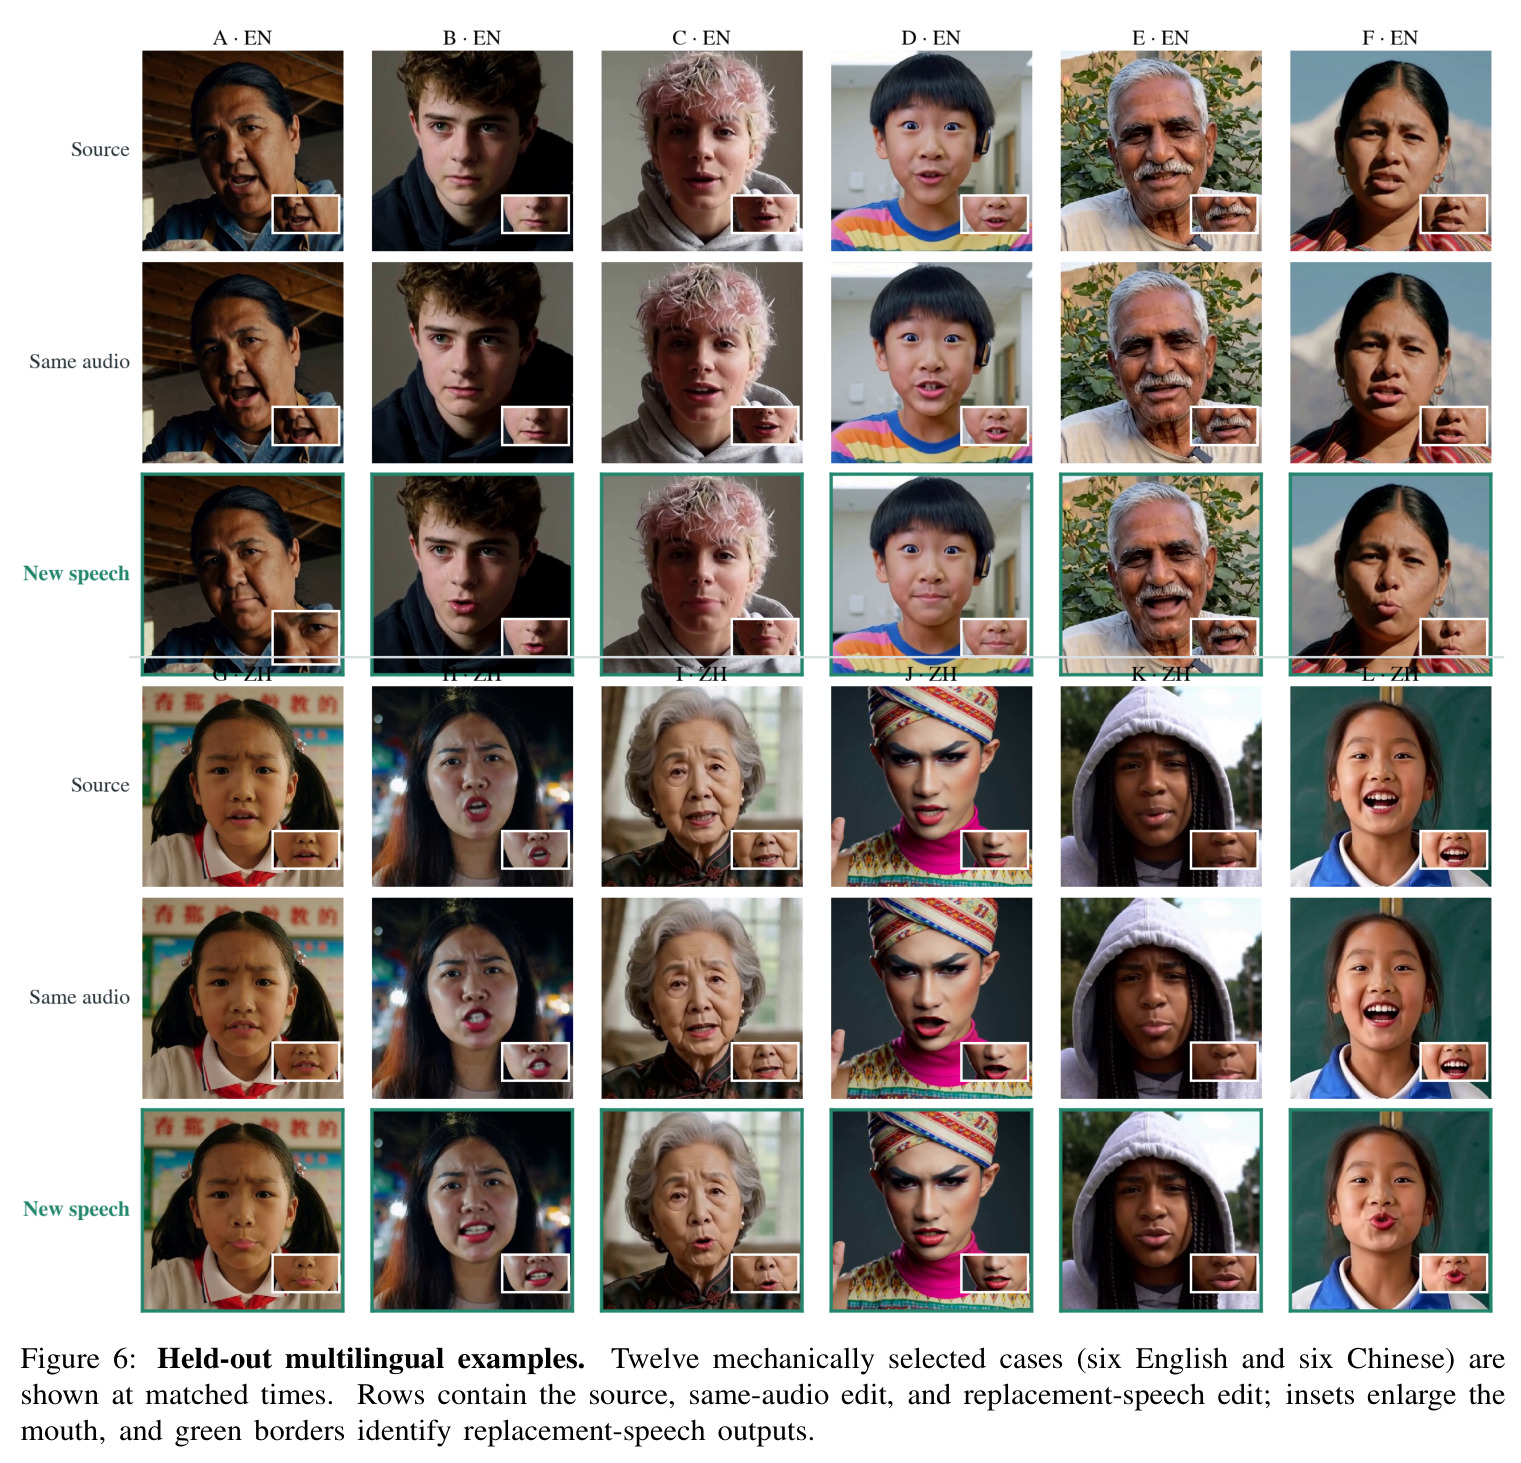
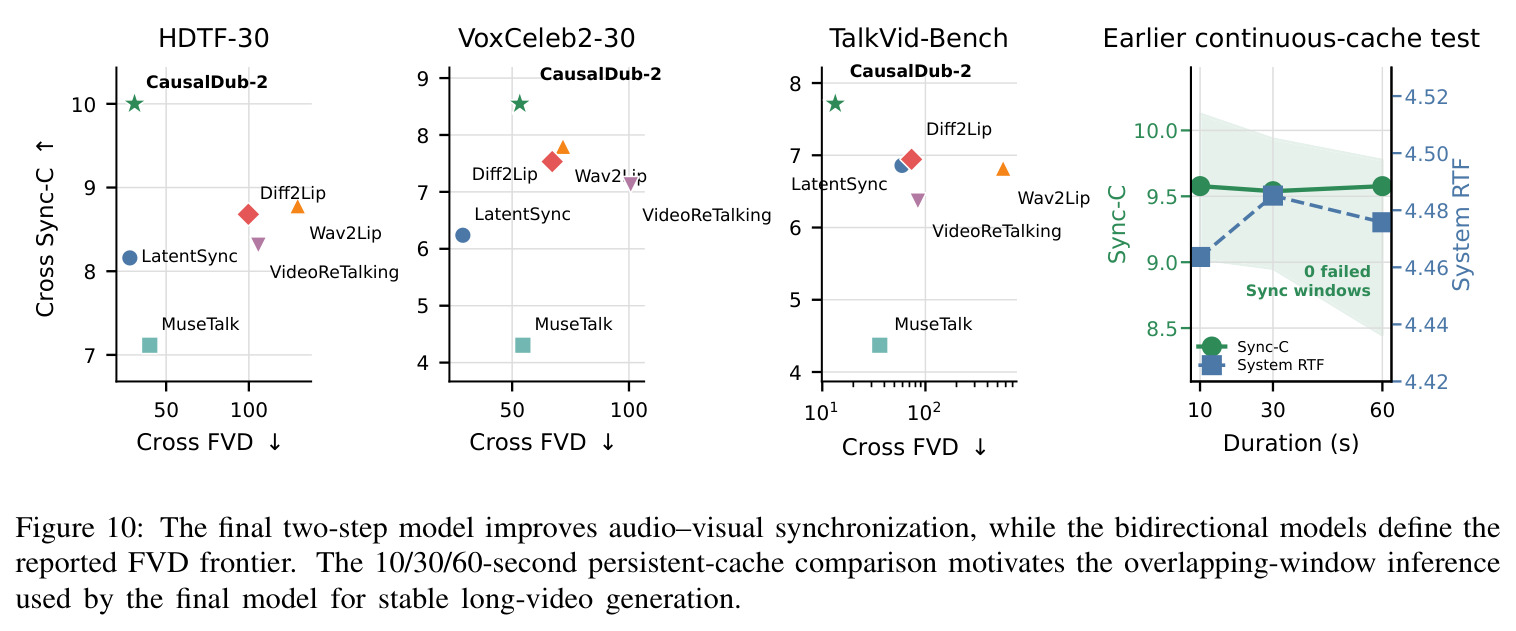
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HDTF-30 跨音频口型同步 | Sync-C ↑ / FVD ↓ | 10.102 / 27.66(2 NFE,11.3 FPS) | 30 步教师 9.422 / 27.49;LatentSync 8.160 / 28.05;Lip Forcing 14B 6.884 / 33.80 | 较最强外部基线 +1.94 Sync-C,较自身教师 +0.68 且步数 30→2 |
| TalkVid-Bench-500 跨音频 | Sync-C ↑ / FVD ↓ | 7.646 / 10.25(500/500 全覆盖) | 教师 48 NFE 7.663 / 8.51;Lip Forcing 5.610 / 12.68 | 较 Lip Forcing +2.04 Sync-C、FVD −2.43,且 SSIM 0.9125 vs 0.7698 |
| VidDub-Bench-245 公共子集跨音频 | Sync-C ↑ / FVD ↓ | 8.709 / 17.50 | 教师 8.718 / 15.23;LatentSync 7.544 / 46.77 | 保留 99.9% 教师同步,Sync-C 较 LatentSync +1.17 |
| 唇读可懂度(LRS3 独立视觉阅读器) | WER ↓ | 0.503 / 0.752 / 0.758(HDTF/Vox2/VDB) | 教师 0.632 / 0.825 / 0.681;LatentSync 1.019 / 1.049 / 0.953 | 三个源全部最低,接近真实同音视频 0.171 / 0.579 / 0.711 |
| 60 秒长视频(Long-20) | Sync-C ↑ / Keep-L1 ↓ | 9.399 / 2.493(末 5 秒 9.585,斜率 −0.046/分钟) | Wav2Lip 7.861 / 3.045;LatentSync 7.771 / 4.018 | Sync-C +1.54,非口型保持与色度稳定均为最优 |
| 替换感知监督三种子析因(dev-256) | ΔSync-C ↑ | 源口型掩蔽主效应 +0.833 ± 0.040(WER −0.144 ± 0.009) | 仅配对音频重建(无替换分支) | 四基准配对 95% 区间全部大于零,增益归因于掩蔽本身 |
| 推理效率(单张 H20) | FPS ↑ / 参数量 / 峰值显存 | 11.3(预备输入口径)/ 2.81B / 13.77 GiB | Lip Forcing 14B:2.4 FPS / 14.53B;因果同骨干 9.4 FPS / 21.96 GiB | 速度约 4.7×,显存较因果变体低 37% |
局限与改进
作者承认的局限:训练数据中约 26%(85,435/322,513)来自自建 H3 生成域,VidDub-Bench 与训练共享 H3 域(虽源视频不相交);引导 CFG 的 DMD 有可测的视觉代价——相对 $g=1$,Sync-C $+0.2134$ [0.1896,0.2372] 的同步增益伴随 SSIM $-0.0020$ 与 mouth LPIPS $+0.0045$;替换音频在线采样规则较弱(仅取同 rank 前一个样本,未强制不同身份/时间不重叠,同语言概率高达 50.4%);FVD 并非处处最优(VoxCeleb2-30 上 46.52 明显劣于 LatentSync 的 28.89)。我自己的观察还有五点:其一,模型固定工作在 512×512、81 帧(3.375 秒)窗口,对 1080p+/4K 制作场景分辨率不足,长视频靠 64 帧步进 17 帧重叠混合,持久缓存方案曾出现下脸塌陷与皮肤色度 MAE 7.48,最终靠源再锚定降到 2.43,说明长视频执行仍需小心设计;其二,训练同步损失用 StableSyncNet、评测用 SyncNet-v2,两者同族,'用同步专家训练、用同类专家评测'存在循环性风险,独立 VSR 缓解了这一点但 VSR 参考转写本身来自 Whisper 伪标签;其三,仅在'同域同语言'替换下验证,跨语言配音(如中→英)未测试;其四,两步学生同音频 SSIM 0.9213 仍低于 LatentSync 的 0.9656,像素级保真还有差距;其五,人评仅 15 人 150 试,对教师的对比平局占 86% 以上,区分度有限。
独立分析的弱点
独立分析四个弱点。1) 分辨率与时长天花板:512×512 输入与 3.375 秒窗口意味着高分辨率、竖屏、多人场景需要外挂超分与裁剪策略;滑窗混合点可能出现色度/运动不连续(作者自测持久缓存方案皮肤色度 MAE 7.48、下脸稳定性差,靠改为源再锚定 + 17 帧重叠才降到 2.43)。改进方向是更高分辨率 latent、自适应窗口长度或分层时序模型。2) 评估与训练的循环性:同步训练信号与主评测都基于 SyncNet 族特征,模型可能过拟合该特征子空间而非真实唇动可控性——Table 36 的 null 音频干预部分回应了这一点,但更彻底的做法是把多个异构同步专家集成进损失,或直接用大规模唇读模型的 CTC 损失替代单一 SyncNet。3) 数据与伦理依赖:85,435 段训练片段由商用 MiniMax-H3 生成,人口属性由 Qwen3.5 提示词分层采样(42 情绪/73 手势/38 场景/15 年龄段),标签本身可能携带偏见;模型卡、使用协议与检测器随模型发布尚未落地。4) 效率对比的工程公平性:FPS 对比中 Wav2Lip/Lip Forcing 走官方命令行管线(每次调用重新加载权重,固定开销高达 137–236 秒),VidDub 用常驻进程测吞吐,11.3 vs 5.2 FPS 的差距部分来自工程实现;且因果变体每块还需额外一次 clean state-commit forward 未计入 NFE。改进方向是统一 in-process 基准并公布端到端 RTF。此外 2 步学生同音频 SSIM(0.9213)低于 LatentSync(0.9656),说明少步蒸馏在像素保真上仍有代价,可探索对抗蒸馏或更强的初始化器一致性项。
未来方向
作者明确提出或暗示的方向:发布 VidDub-Bench 与统一评测代码,推动跨音频评测标准化(补充材料的秩相关审计表明单域同音频指标不可替代跨音频评测);受控因果变体已把首帧延迟降到 1.052 秒并验证了 10 秒流式生成(TTFF 1.16s、缓存零偏移漂移),说明替换感知监督可以迁移到实时流式配音。基于其成果可自然延伸:跨语言/跨口音配音(当前替换音频限制同语言,训练管线只需放宽采样约束并换多语 Whisper);把'区域-条件解耦'思想推广到其他存在目标冲突的编辑任务,如手势替换、眼神/表情驱动、歌声对口型;用更强唇读模型做奖励式微调,进一步压缩与真实同音视频的 WER 差距(0.503 vs 0.171);与 TTS/翻译模块串联成端到端视频翻译配音系统;探索文本可编辑的口型控制(当前仅音频条件);把 DMD 蒸馏压到 1 步并结合量化在消费级 GPU 上部署(2.81B 参数仍需 H20 级显存);评测侧建立'换音频+换说话人+换语言'组合压力测试与更强的时序漂移审计(当前 Long-20 仅 20 对、人评 15 人)。
复现评估
开源情况:论文承诺发布 85,435 段自建 H3 训练集、VidDub-Bench(256 个源不相交生成视频、128 中 128 英、固定同/跨音频配对、结构化提示元数据)、预处理输出、冻结清单、排除名单、统一评测代码与复现包(含 checkpoint 哈希、EMA 状态、精确命令),仓库为 github.com/LAW1223/VidDub;第三方公共基准只发布标识符与确定性清单而不重分发受限媒体。算力需求:教师 warm-up 与联合适配各用 48 GPU,替换感知精调仅 16 GPU×300 更新,轨迹回归与 DMD 各 16 GPU;推理单张 H20 达 11.3 FPS(预备输入口径)、峰值显存 13.77 GiB。超参披露极其完整:学习率、精确到 7 位小数的损失权重(如 $\lambda_{traj}^q=0.3664846$、$\lambda_{DMD}^q=0.9879127$)、种子 20261008、EMA 0.99、fake score 每生成器更新 5 次更新、$\sigma\sim U[0.02,0.98]$ 等全部给出。难度评估:评测复现容易(冻结清单 + 统一代码 + 公共子集审计),训练复现中等偏难——需要 MiniMax-H3 商用渲染器重生成数据或直接使用发布数据,且 48 GPU 级资源是门槛;总体属于该领域复现友好度较高的一档工作,但摘要级别信息(meta 中 abstract 为空)意味着必须读全文与补充材料才能动手。
论文图表
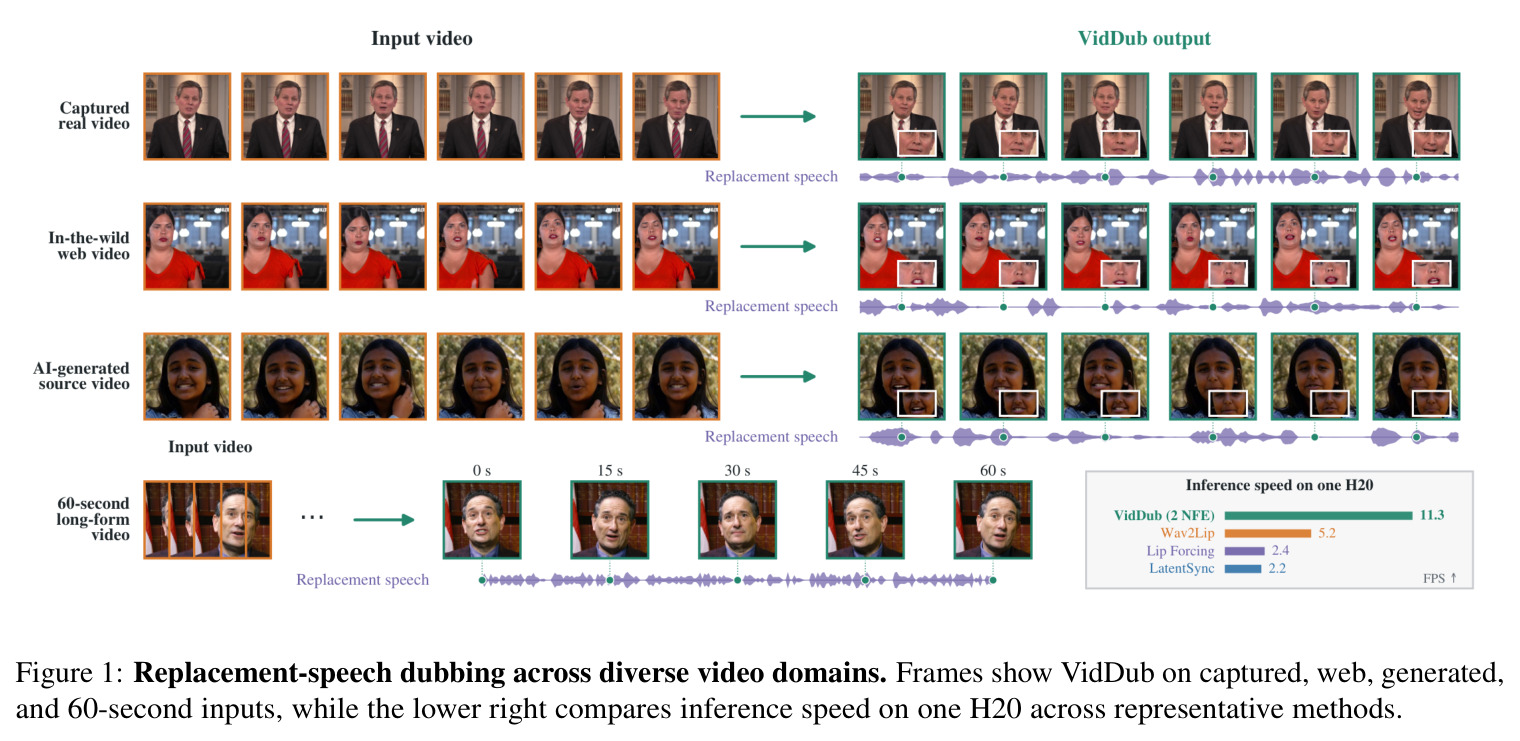
门面图:上排展示 VidDub 在拍摄素材、网络视频、生成视频和 60 秒长输入四类源域上的替换语音配音帧(口型随新语音变化而身份/背景不变),右下角是单张 H20 上各代表性方法的推理速度条形对比,突出 2 NFE 的吞吐优势。
一图总览任务定义(替换语音、保身份/头姿/背景)与两大卖点(跨域泛化、两步速度),读者可据此判断论文与自己场景的相关性。
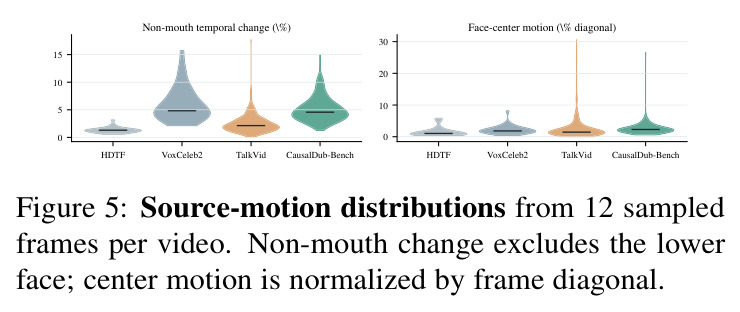
补充材料图:各基准源视频(HDTF、VoxCeleb2、TalkVid、CausalDub-Bench/VidDub-Bench)的非口型时序变化百分比与面部中心运动百分比分布,显示 HDTF 运动最小(非口型 Δ 1.30、中心运动 1.03%),生成域 VidDub-Bench 运动更大(4.57 / 2.29%)。
说明为什么要新建生成域基准:公共基准的源运动分布偏静态,不足以代表真实配音难度;同音频指标在单域上的排名与跨域表现相关系数可低至 −0.30。