Kandinsky 6.0 Video:同步视频与音频生成基础模型 Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
双流 CrossDiT 开源模型:文本或图像生成 5 秒同步音视频并超分至 Full-HD
前置知识
流匹配(Flow Matching)
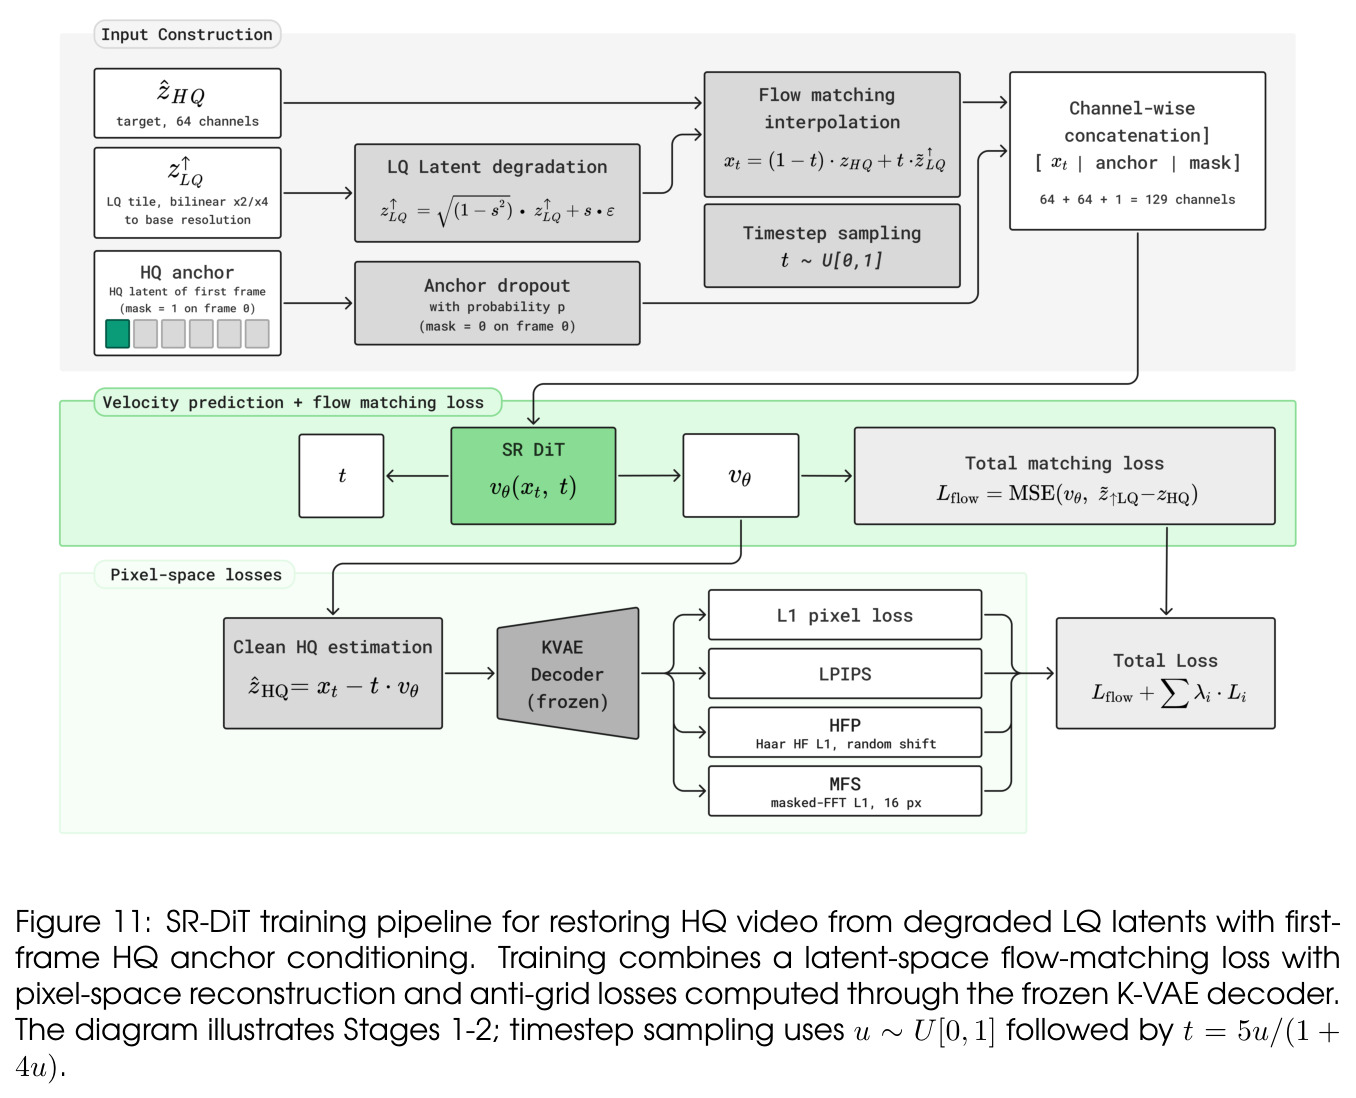
扩散生成训练范式:模型学习速度场 $v_\theta$,把噪声沿直线路径输送到数据分布,目标是速度回归 $\mathcal{L}=\mathrm{MSE}(v_\theta(x_t,t),\,\tilde{z}_{LQ}-z_{HQ})$,$x_t$ 为数据与噪声的插值。比离散扩散更稳、更易积分。
Kandinsky 6.0 全线(基础模型、SR-DiT)都用流匹配训练;论文中的独立时间加噪、SR 的噪声分数 $s=0.7$、时间步变换 $t=5u/(1+4u)$ 等设计都要在流匹配框架下理解。
CrossDiT 双流扩散 Transformer
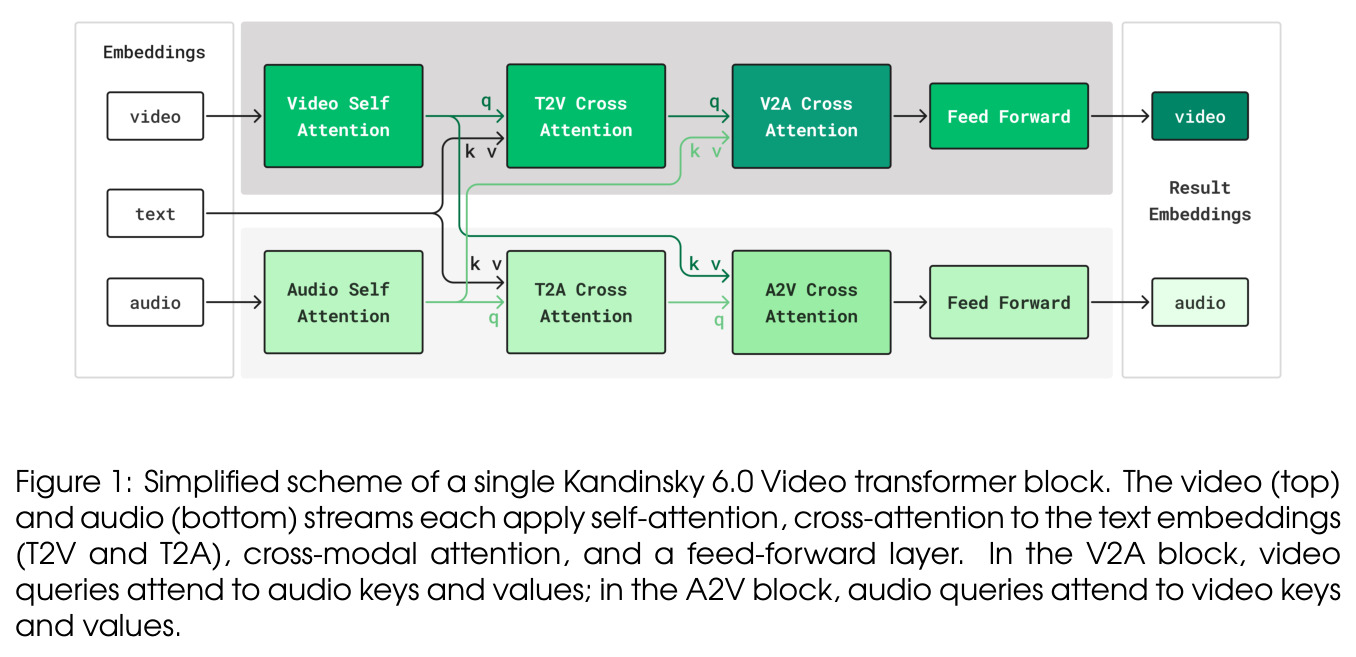
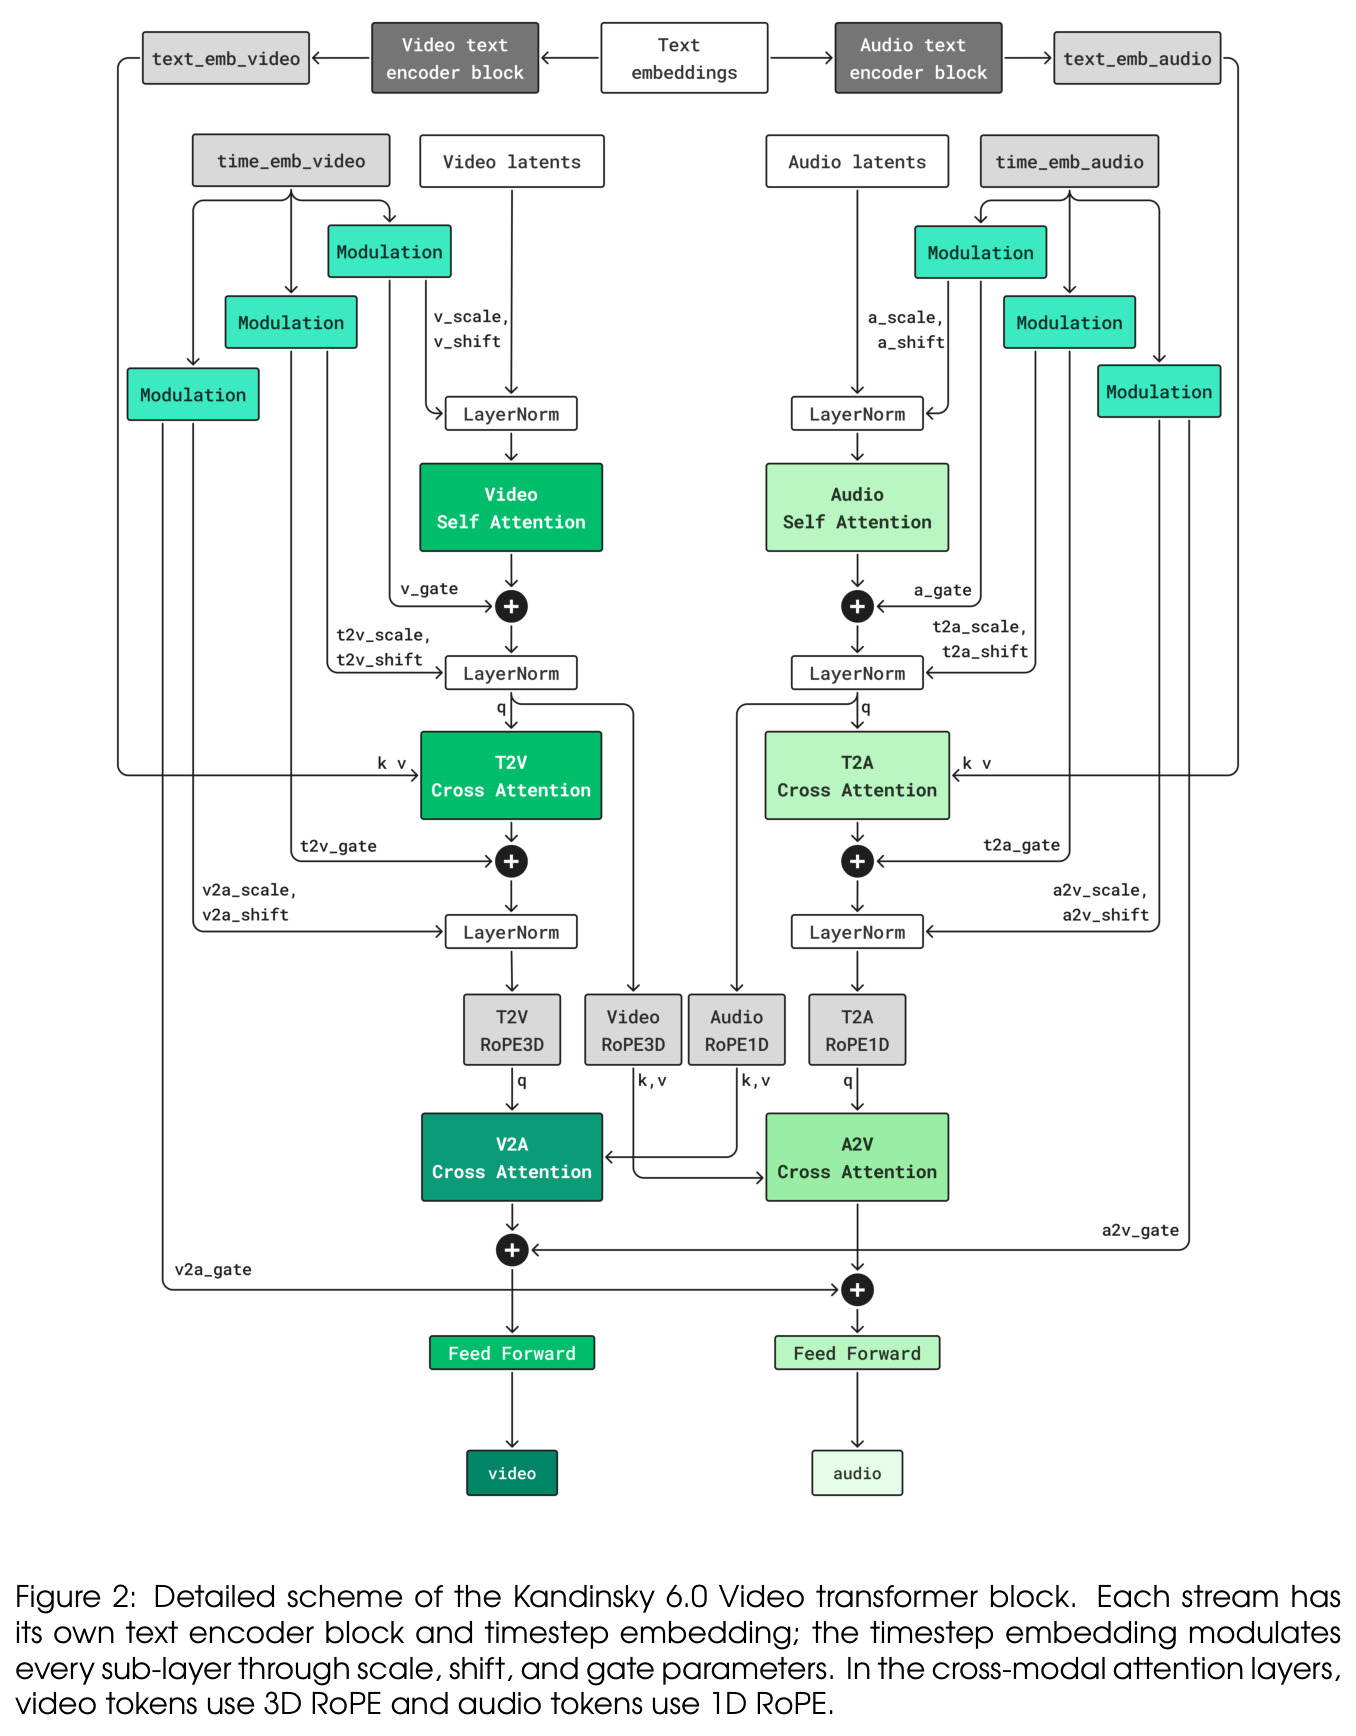
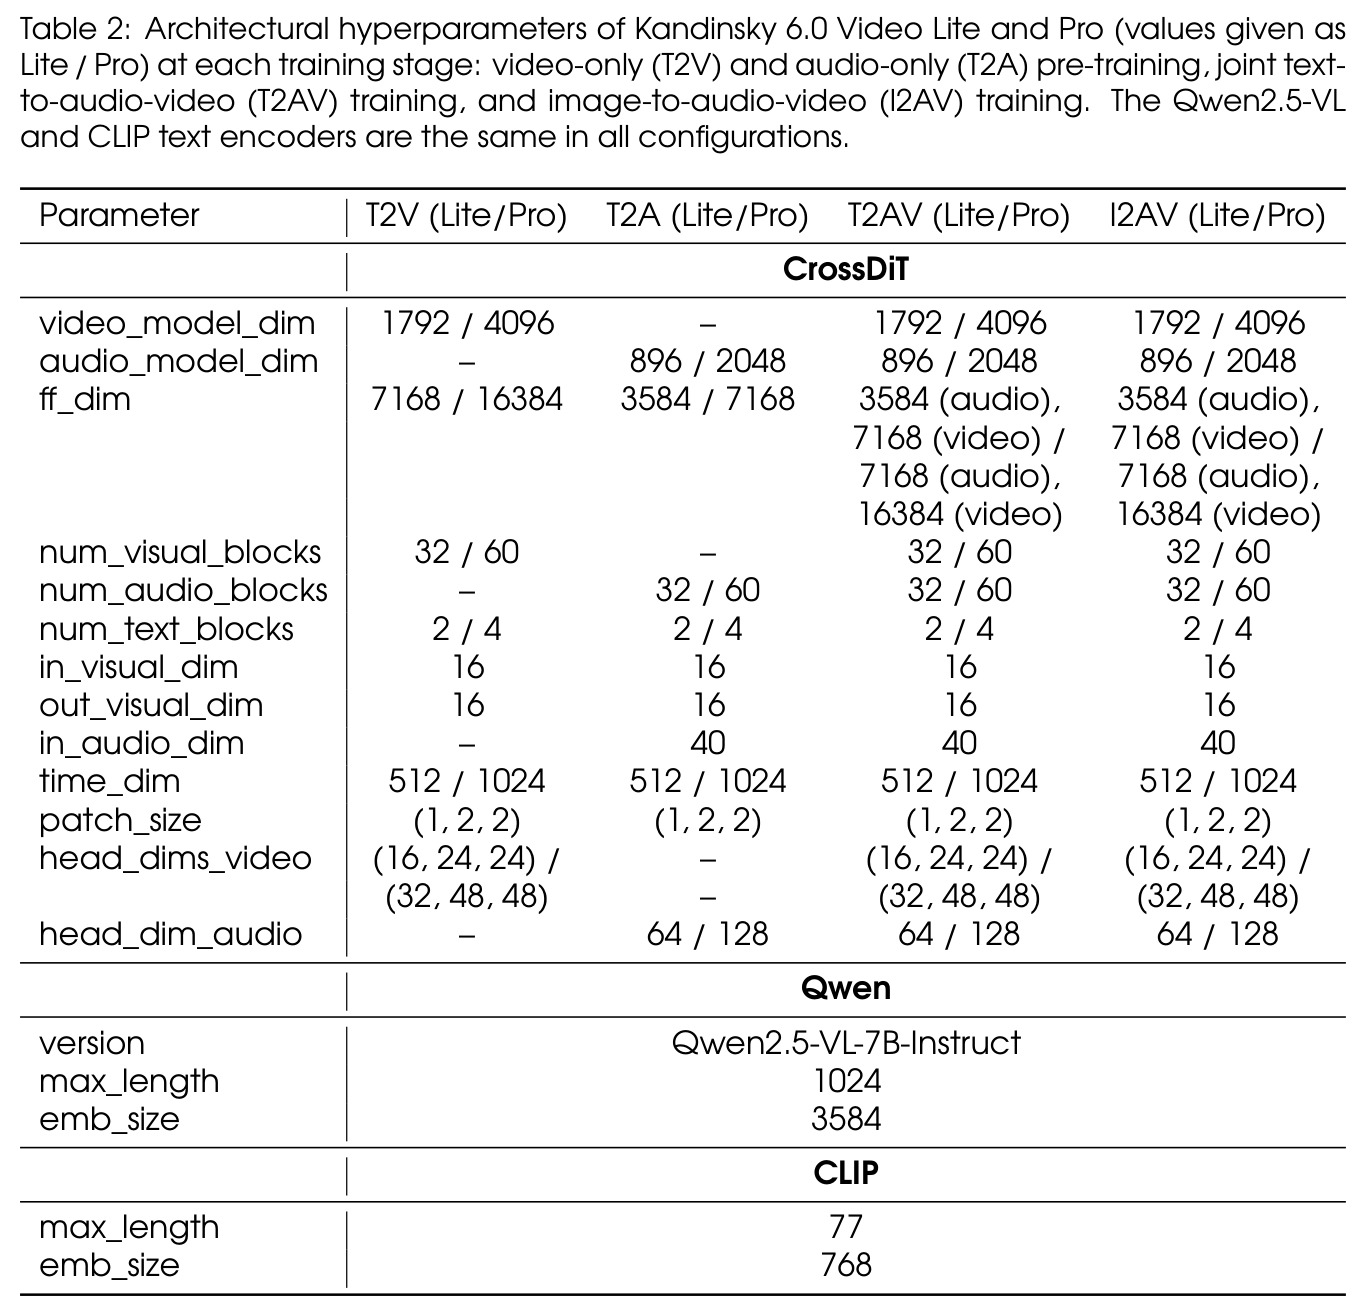
用两个独立的 DiT 主干分别处理视频和音频 token,每个块内除自注意力和文本交叉注意力外,还插入双向跨模态交叉注意力:V2A 块中视频 query 关注音频 key/value,A2V 块中音频 query 关注视频 key/value,让两个模态在每一层交换信息并协商同步。
这是本文核心架构(继承自 Kandinsky 5.0)。理解块级双向交叉注意力才能看懂 RL 的梯度手术为何作用于 V2A 的 KV 路径、区域重加权为何取自 A2V 注意力图。
潜空间扩散与视频 VAE
直接在像素上跑扩散代价太高,因此先用 VAE 把视频压缩到潜空间(本文视频用 Hunyuan VAE,超分用 K-VAE:64 通道、空间 16×、时间 4× 压缩,121 帧对应 31 个潜帧),音频用支持 44 kHz 的 MMAudio 自编码器,扩散 Transformer 只在潜码上工作。
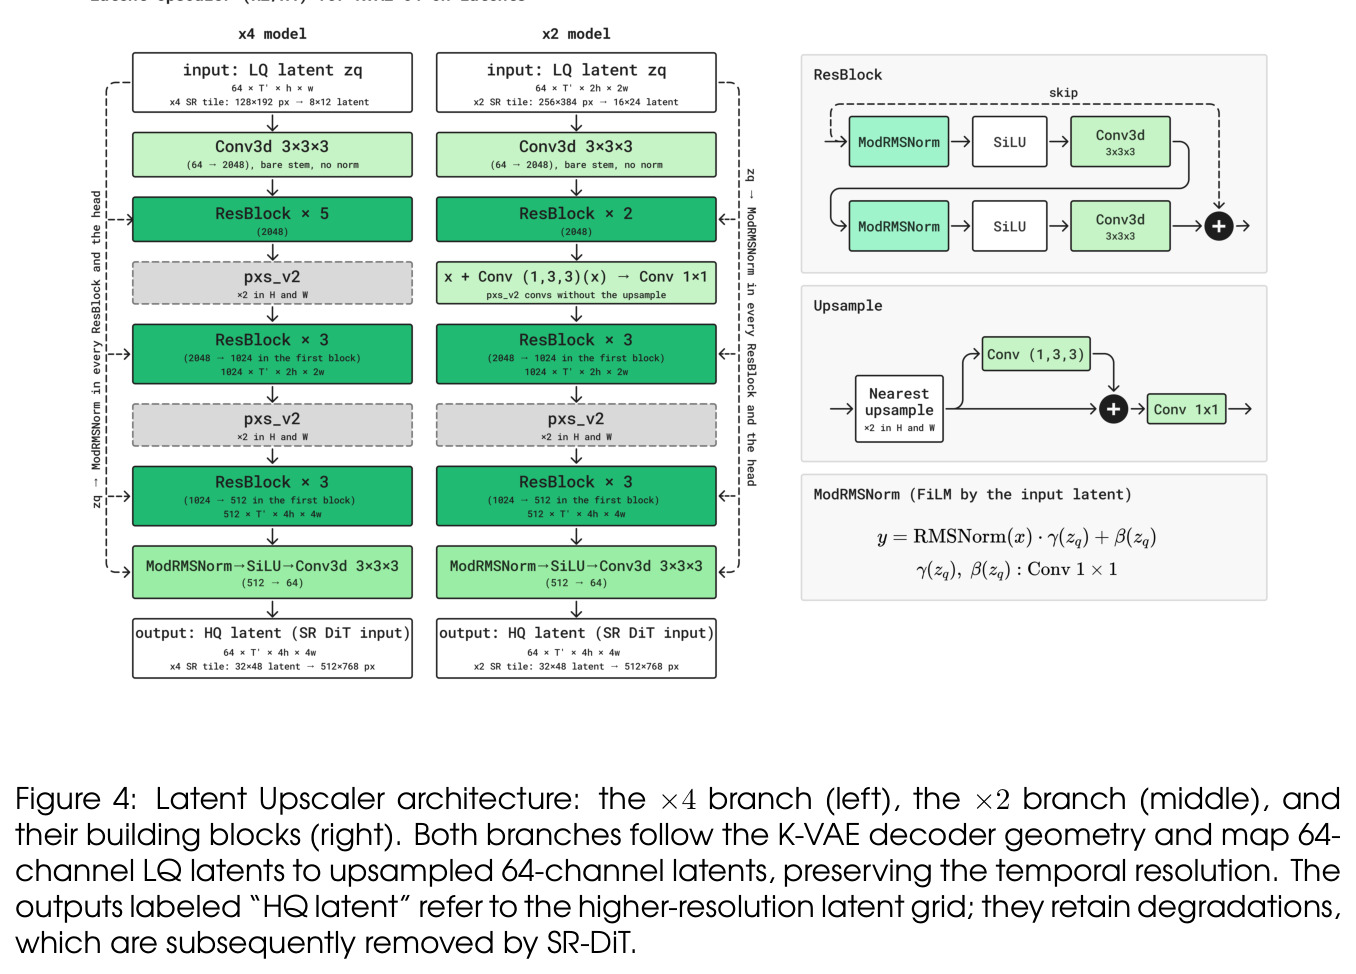
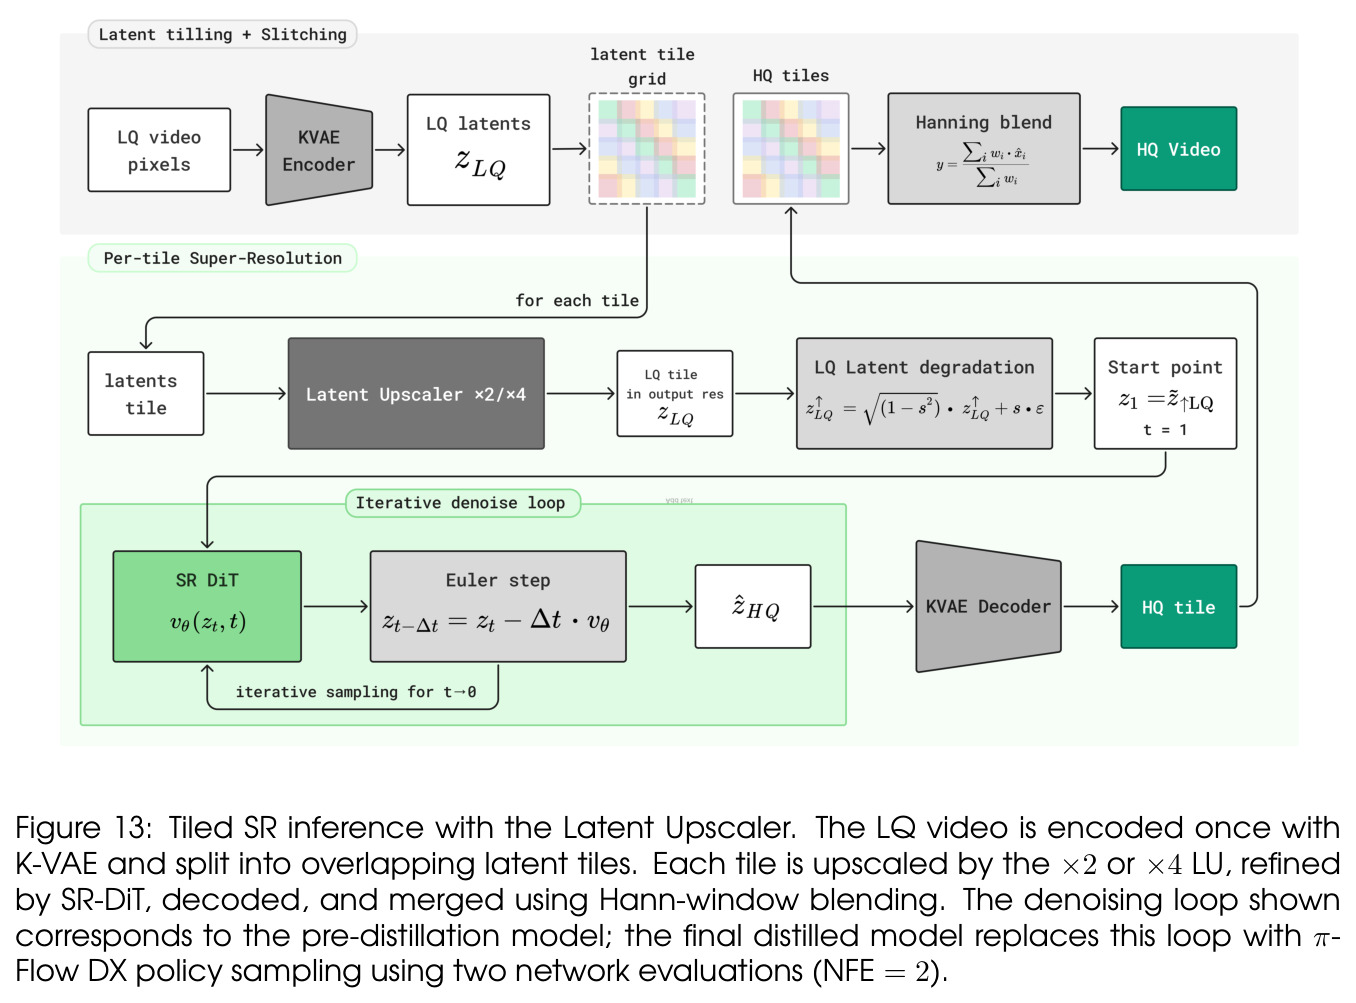
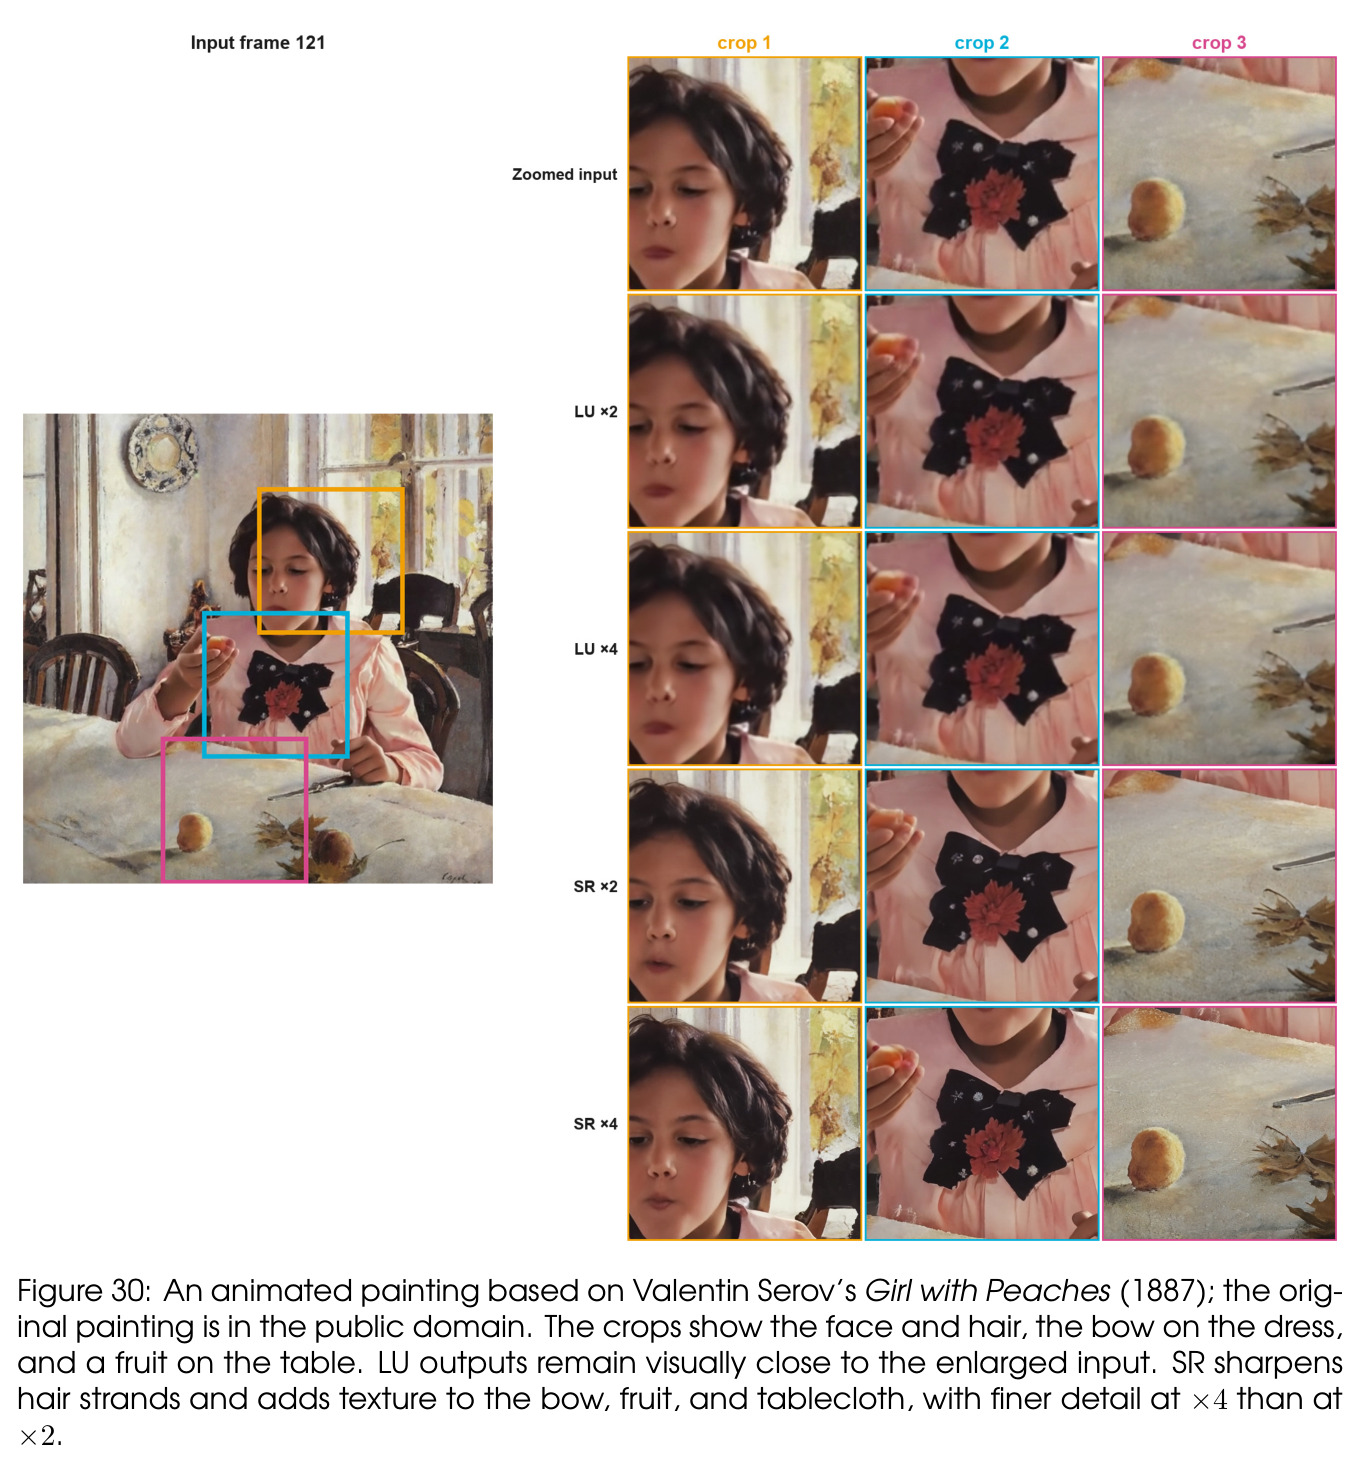
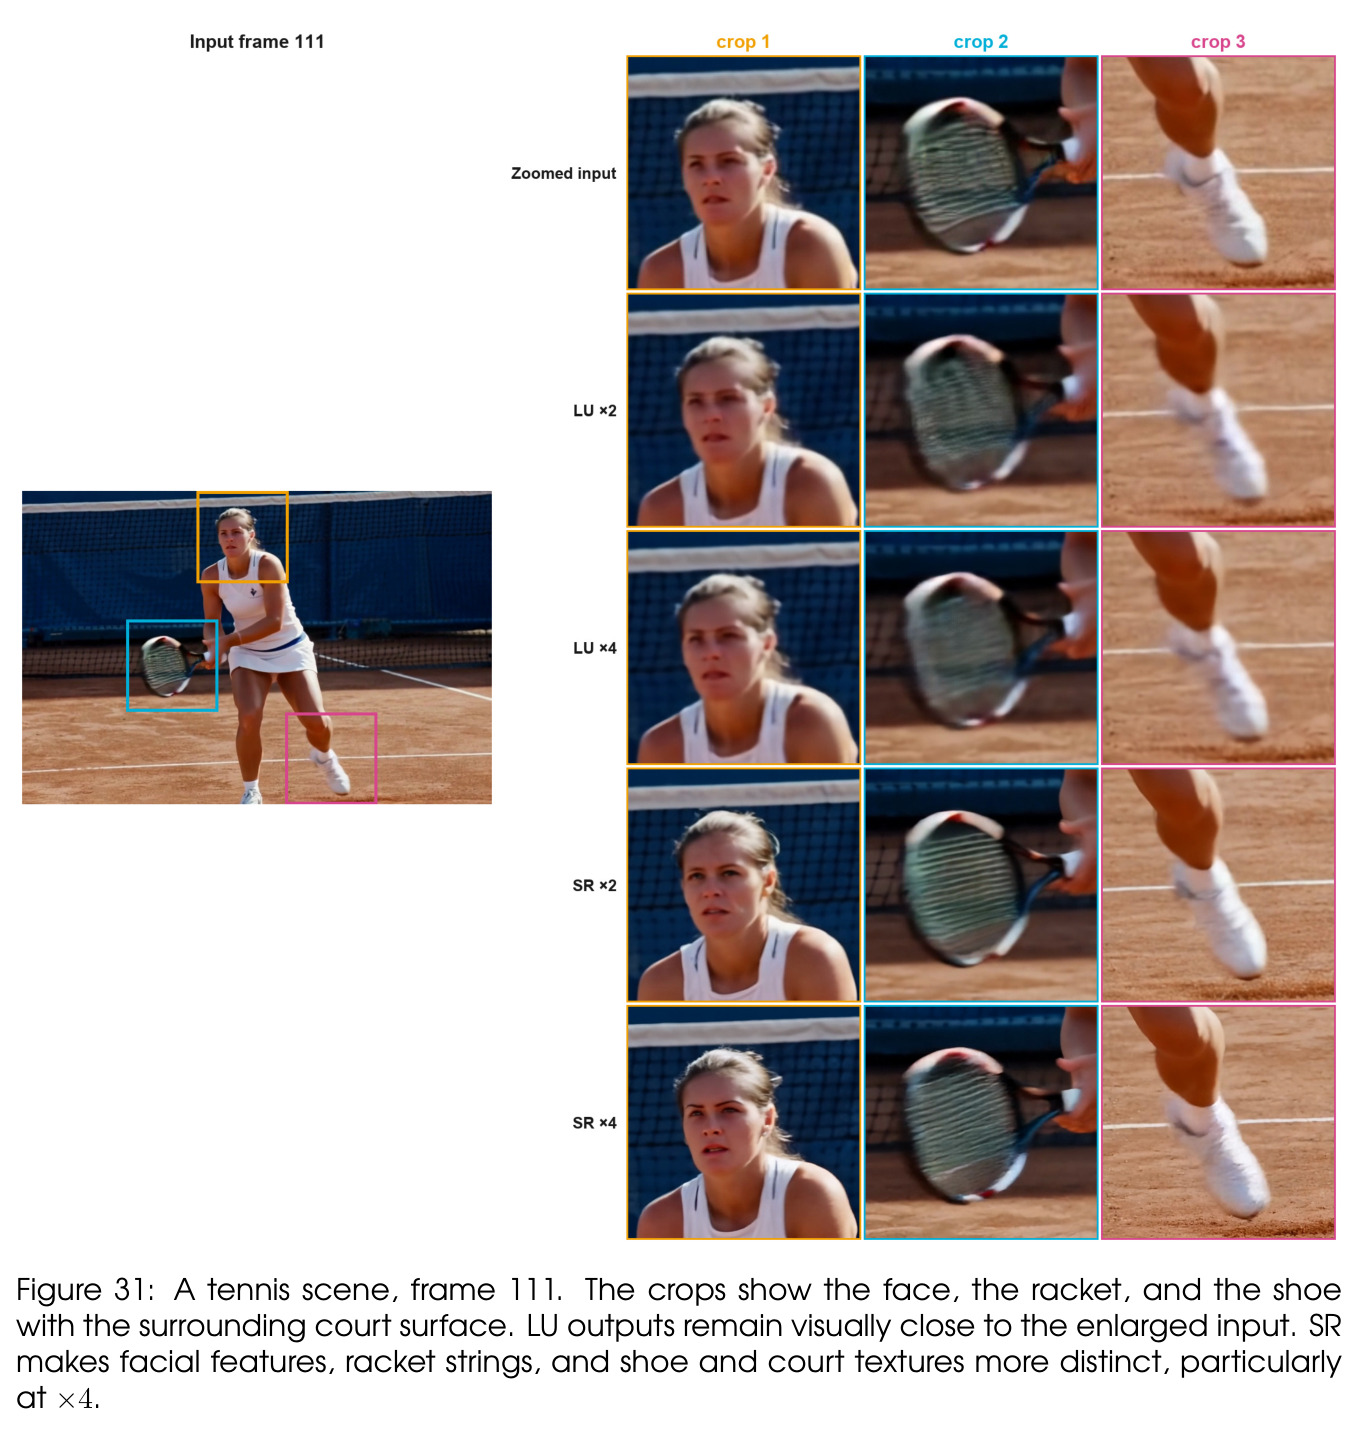
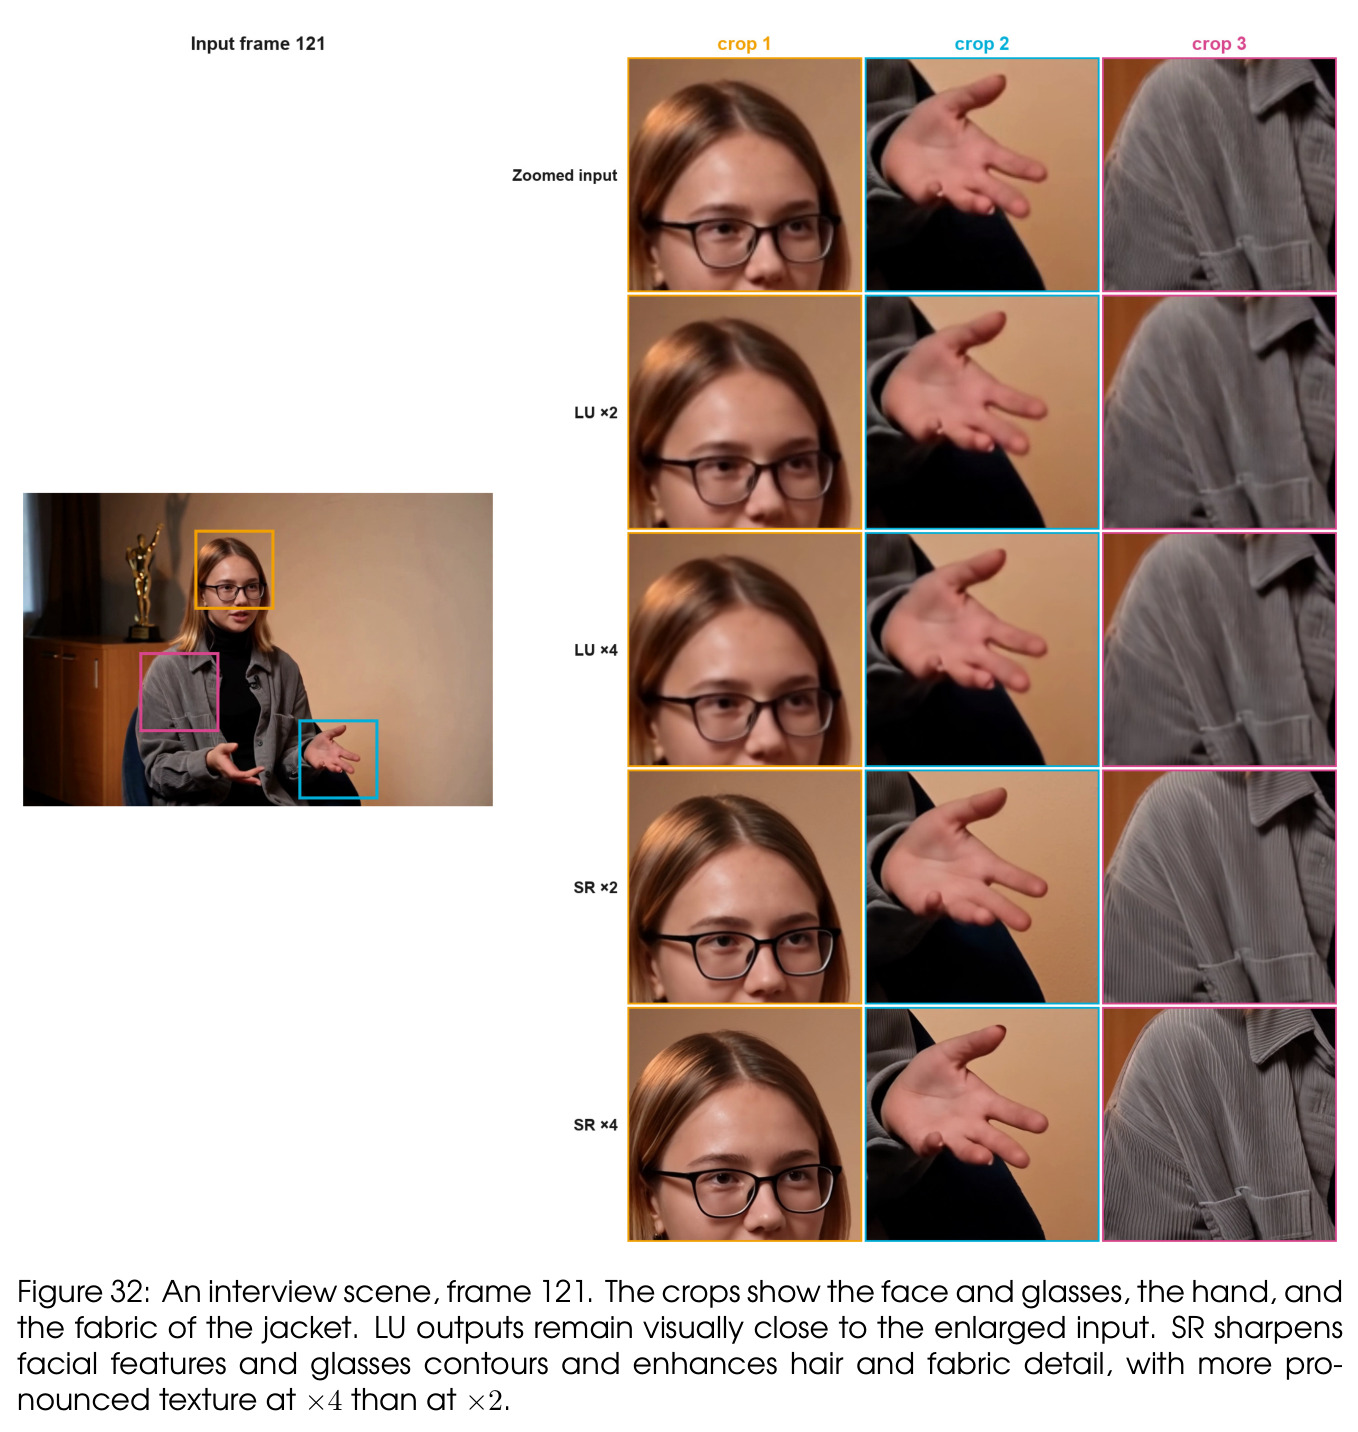
本文的超分模型完全在 K-VAE 潜空间内做上采样与去退化(Latent Upscaler + SR-DiT),VAE 的压缩几何(16px 对齐、tile 尺寸、帧数 $T'=(T-1)/4+1$)决定了所有推理管线的设计。
旋转位置编码 RoPE
一种相对位置编码:把 query/key 的特征维度分成若干频率对,按位置旋转。本文视频 token 用 3D RoPE(时间/高/宽三轴,头维切分为 16/24/24),时间轴索引按 $N_{frame}/(fps/24)$ 归一化以适配帧率;音频 token 用 1D RoPE 按时间位置索引。
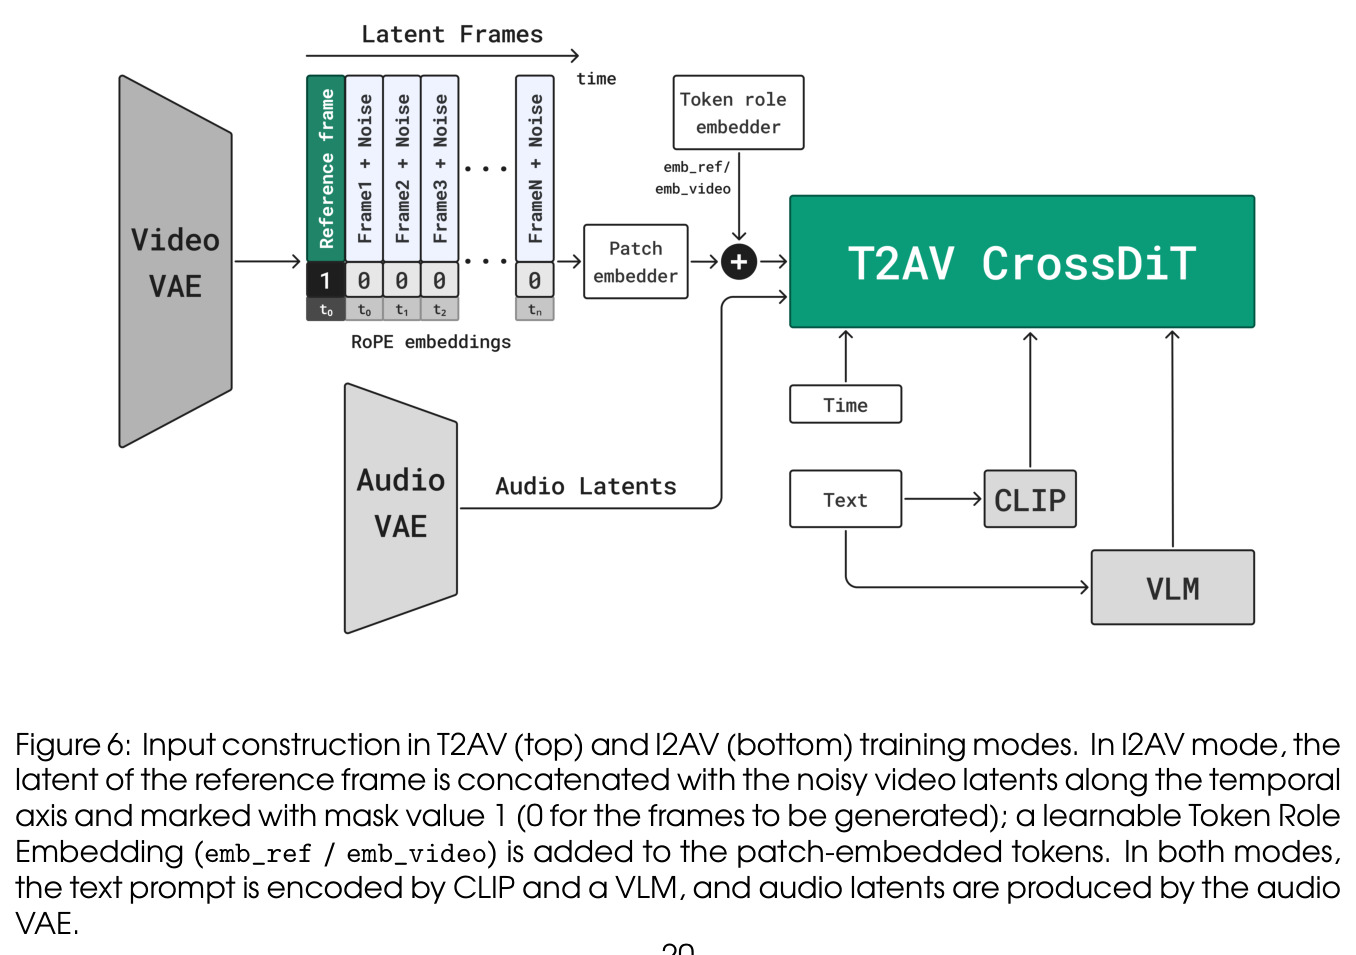
论文消融表明,I2AV 模式里参考帧主要靠 RoPE 时间位置绑定到生成序列的对应位置——改变参考帧的 RoPE 位置会让它变成该时刻的条件,这是理解图像条件化机制的关键。
GRPO 组相对策略优化与 LoRA
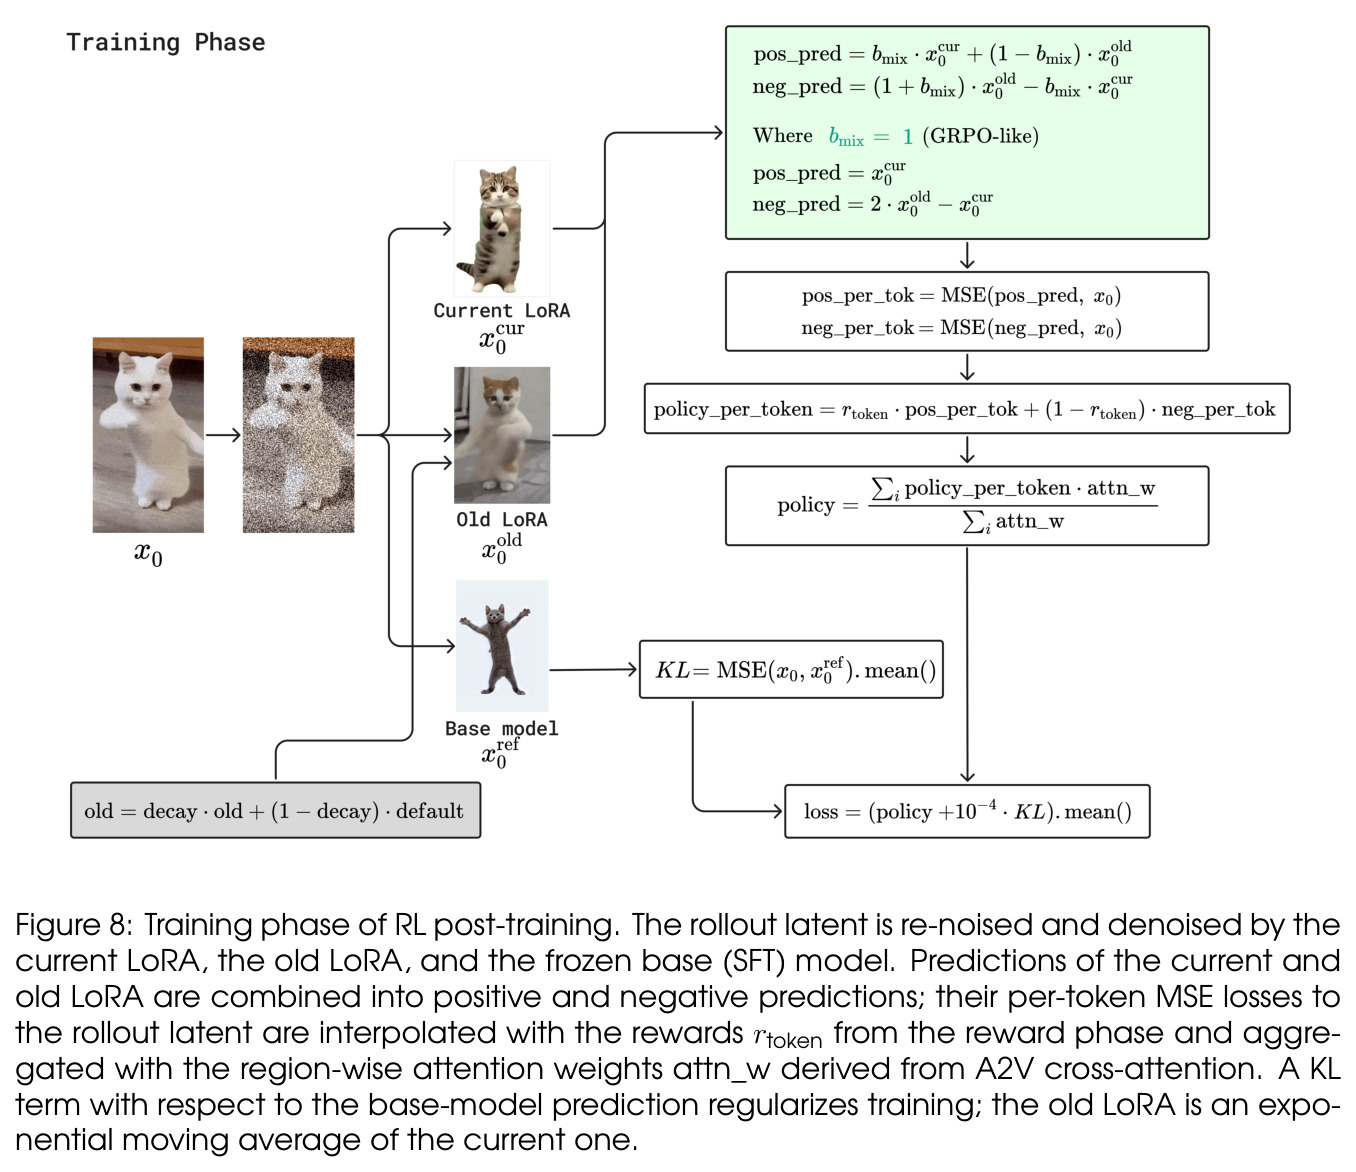
GRPO 对同一提示采样一组 rollout(本文 $K=10$ 个种子),用组内中心化加全批标准差缩放把奖励转成优势,无需价值网络即可做强化学习;LoRA 在冻结权重旁挂低秩矩阵($r=16$),只训练 0.69%(Pro 199M)参数,大幅降低 RL 显存与不稳定风险。
本文 RL 后训练把 OmniNFT 方法适配到自家 backbone,采用 GRPO 组采样 + LoRA,并加入奖励路由、梯度手术、区域重加权三项定制,是理解第 4.4 节和 RL vs SFT 消融的基础。
少步蒸馏与 NFE
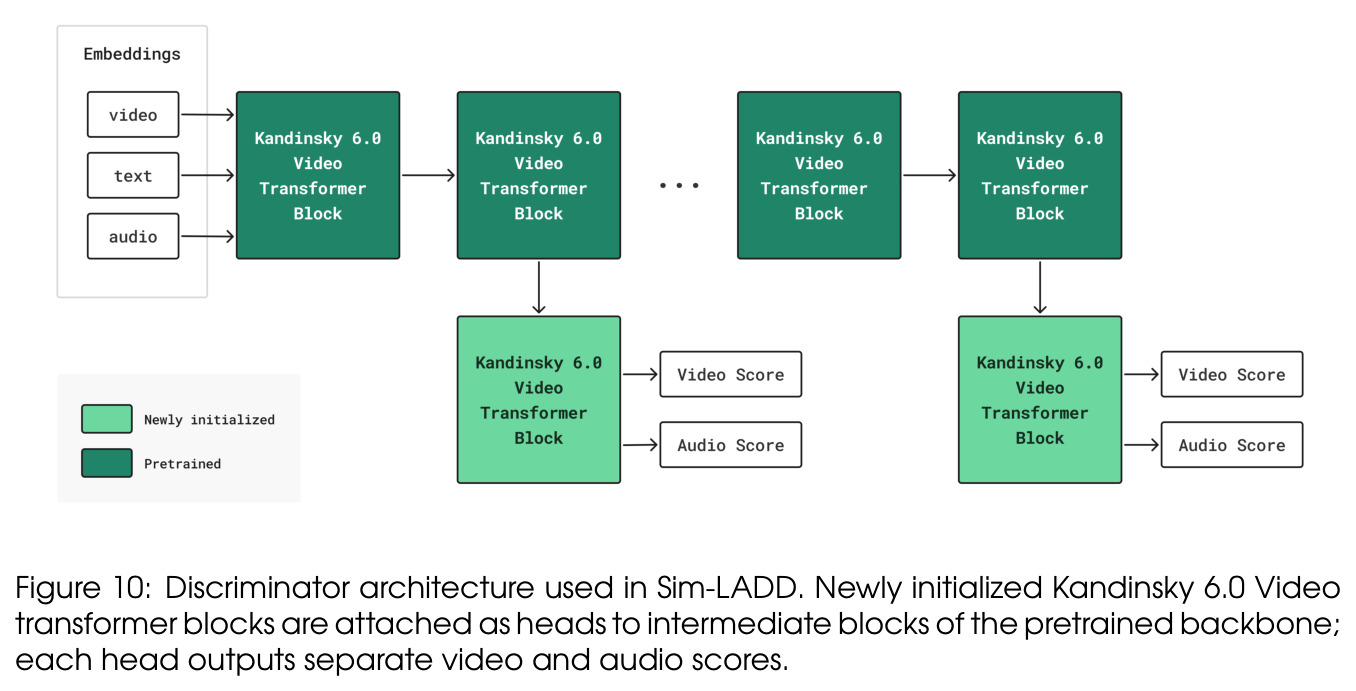
NFE(网络函数求值次数)指采样时前向跑几次扩散网络。蒸馏把 20 步教师压缩到 10 NFE 学生:π-Flow 把轨迹蒸馏表述为在线模仿学习,直接吸收教师 CFG 引导的轨迹而免 CFG 蒸馏;再经对抗蒸馏(LADD 类,用判别器在潜空间特征上做 hinge loss)恢复高频细节。
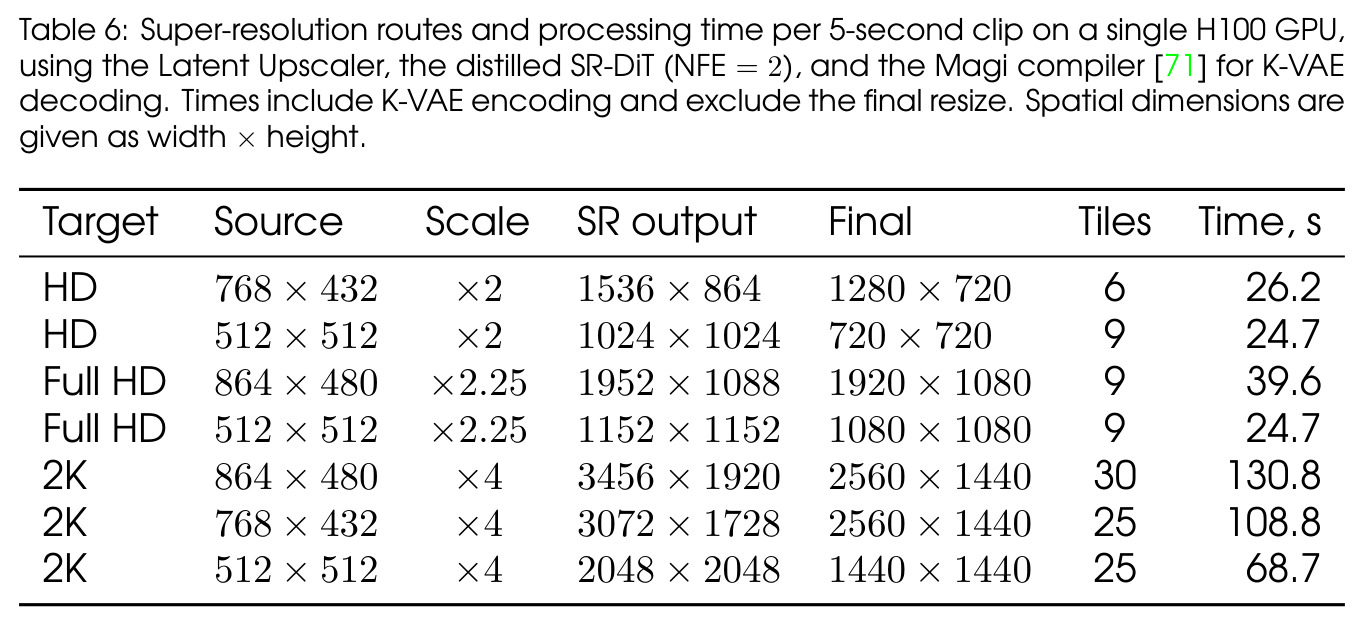
论文有两处蒸馏:基础模型到 10 NFE(π-Flow + Sim-LADD),SR-DiT 到 2 NFE(π-Flow DX 策略)。不熟悉蒸馏就无法理解推理成本数字(如 Full-HD 片段 SR 仅 39.6 秒)与蒸馏 vs 全模型消融。
Model Soup 模型汤
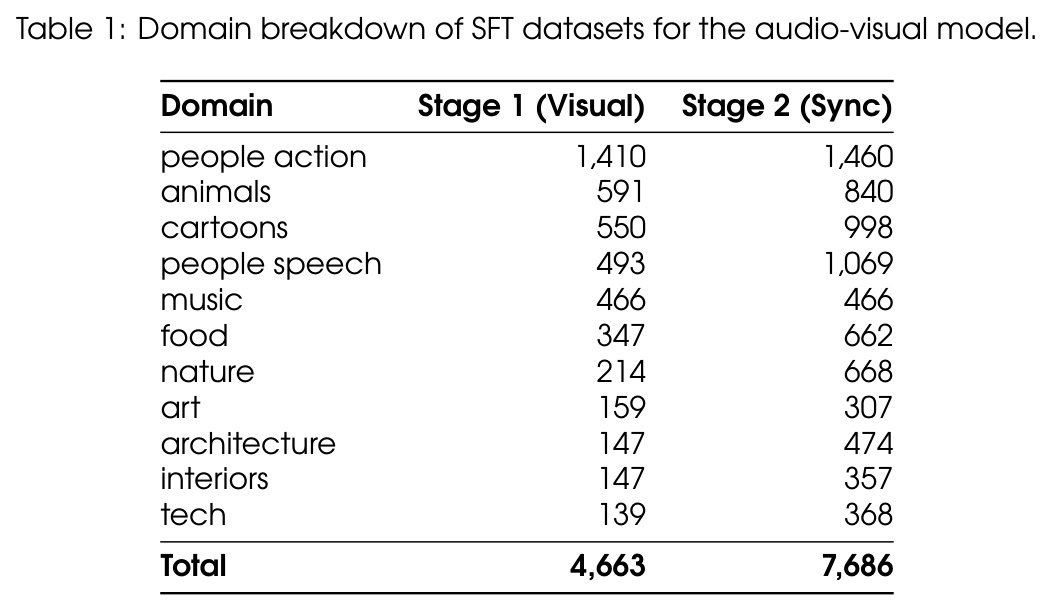
在多个数据子集/领域上分别微调出若干检查点,然后对其权重做均匀平均($\theta_{soup}=\frac{1}{N}\sum_i\theta_i$),常能获得比单一微调更好、更鲁棒的模型,且零推理成本。本文对 11 个内容领域各训一个模型,在 SFT 第二阶段结束后统一平均。
这是本文 SFT 阶段的组织方式(11 域、两阶段、最后成汤),解释了 Table 1 的数据划分和为何 Stage 1 的中间汤只用于测量而不用于继续训练。
研究动机
文本到音频视频生成(T2AV)远比单独生成视频或音频困难:它要求语义、时间与情感三个维度上的跨模态一致性——说话者的唇形必须与语音逐帧对齐,打击声必须恰好出现在接触的那一帧,背景音要与画面情绪匹配。闭源商业系统如 Veo 3.1、Sora 2 和 Wan 2.6 已展示出自然的唇同步、动态背景音效和多语言语音,但代码与训练细节完全不可得,阻碍了复现与后续研究。开源方面虽出现 ALIVE、SyncFlow、JavisDiT、3MDiT、LTX-2/2.5、MiniMax-H3、Cosmos 3 等尝试,模型规模也推进到 30B 左右,但在片段时长、分辨率与同步精度上仍落后于闭源系统;而「先生成视频再单独配音」的两段式做法天然难以保证事件级的音画对齐。
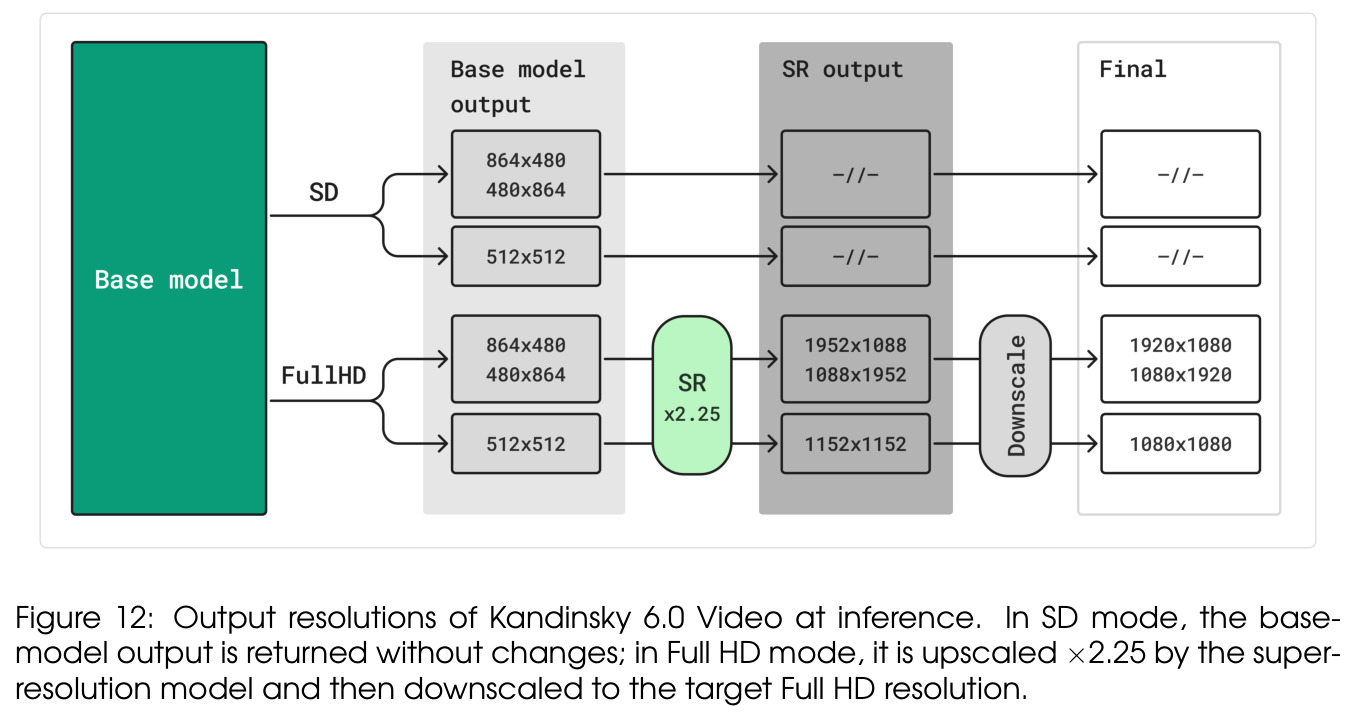
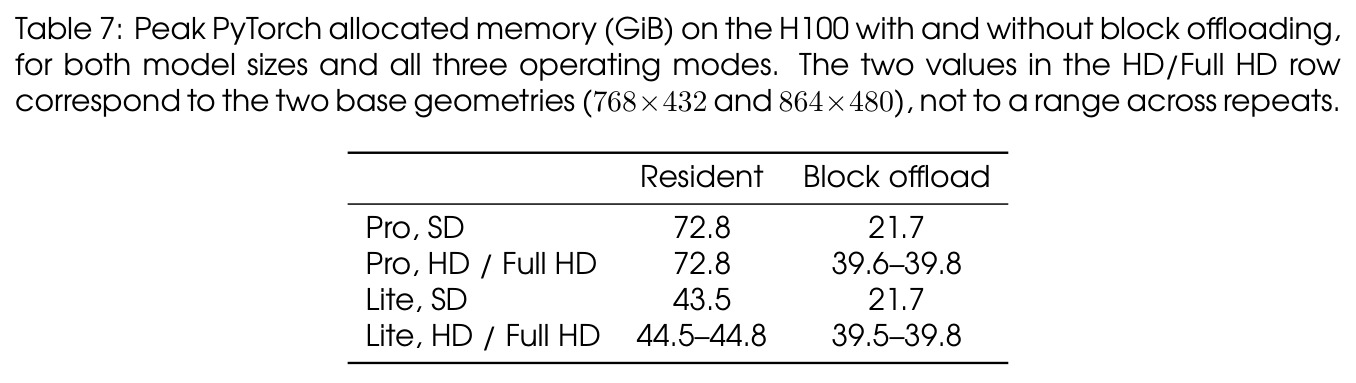
本文的目标是本文目标是构建完全开源(MIT 许可)的同步音视频生成基础模型家族 Kandinsky 6.0 Video,包含 Lite(3B 参数)与 Pro(29B 参数)两个规模。两者都能以文本到音频视频(T2AV)和图像到音频视频(I2AV)两种模式生成 5 秒、24 fps 的视频片段并附带 44 kHz 同步音频(含唇同步),内置潜空间超分模型把 SD 分辨率输出提升至 Full-HD(1920×1080)。工程目标同样明确:通过块卸载与显存预设,让模型能在 16–32 GB 消费级 GPU 上运行。评测目标是在 VABench 与成对人工评估中全面超越前代 Kandinsky 5.0 Video Pro,在多数指标上胜过开源 LTX 2.5,并在语音质量等维度与 Kling 2.6、Veo 3.1 Fast 等闭源系统保持竞争力。
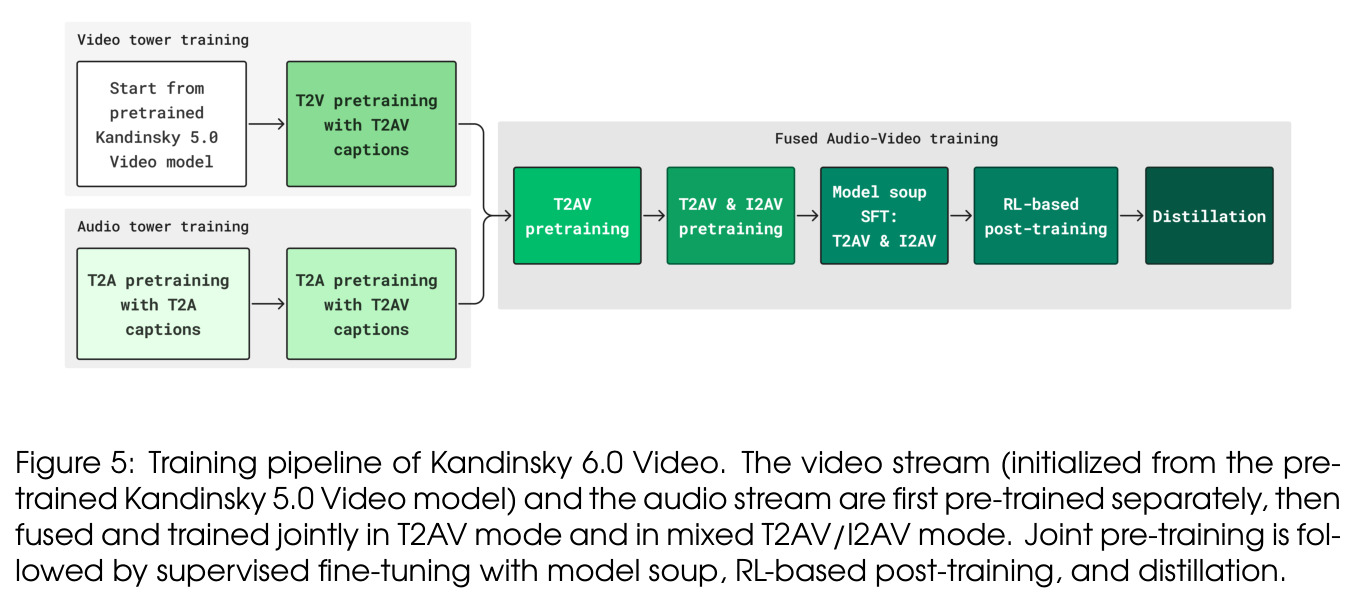
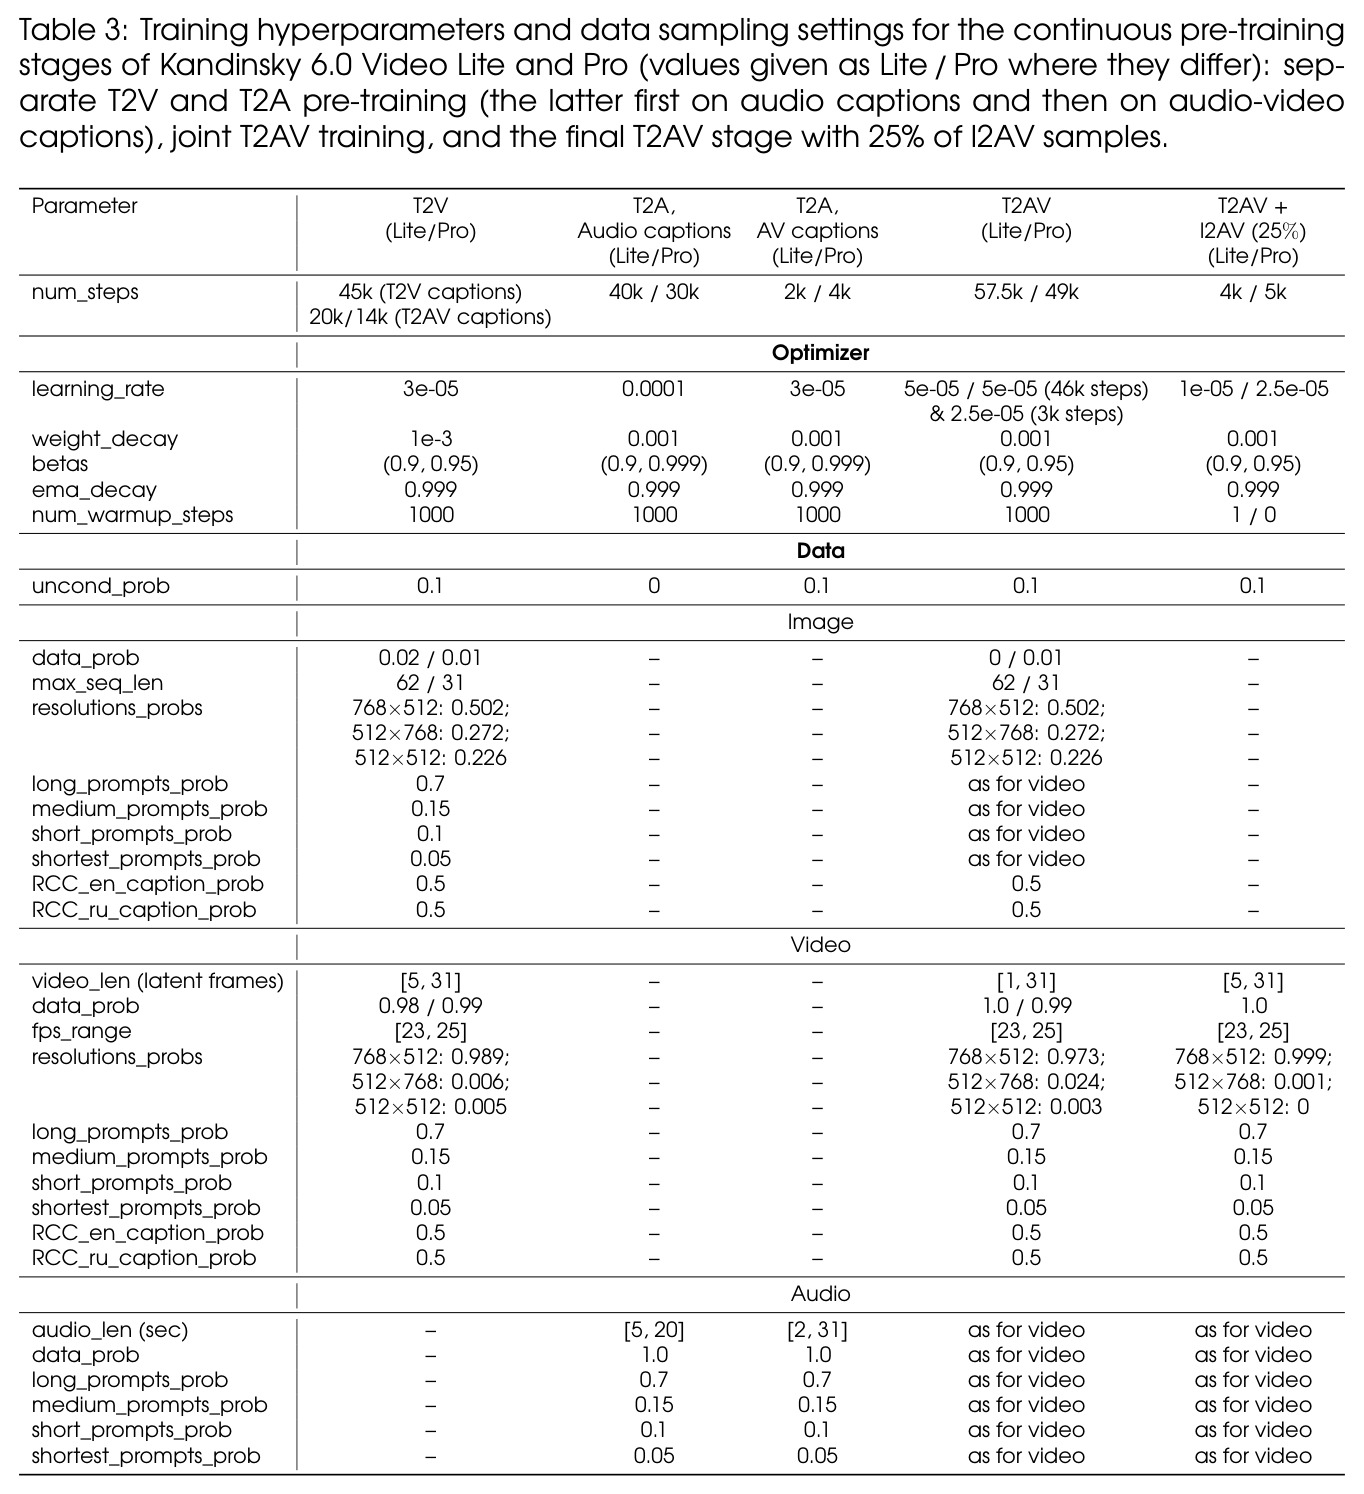
与已有工作不同的是,本文不把音视频生成当作「从零训练一个统一多模态 Transformer」的问题,而是提出连续预训练(continuous pre-training)策略:视频流直接继承 Kandinsky 5.0 Video 的预训练权重以保护已有视觉能力,音频流从随机初始化开始在 4000 万条纯音频语料上独立训练以建立单模态先验,随后才通过新初始化的块级双向交叉注意力把两者连接起来,在配对数据上联合训练。联合阶段采用 independent_time 模式——视频与音频被加噪到各自独立的扩散时刻 $t$,迫使模型学会利用另一模态的信息;同时 batch 内混入纯音频、纯视频、纯图像样本(并注入 120 万图 + 53 万视频的俄罗斯文化代码数据)对抗灾难性遗忘。这种「先分后合、让连接层承载对齐」的切入角度对算力受限的团队尤其务实。
核心方法
直觉上,这篇工作是给已经「会拍视频」的模型配上一个「会发声」的伙伴,让两者在每一层互相查看对方的中间表示,在生成过程中协商出音画同步。技术上核心是非对称双流 CrossDiT:Lite 为视频流 2B / 音频流 0.6B / 交叉注意力 0.4B 参数,Pro 为 19B / 5B / 5B;每块依次执行自注意力、文本交叉注意力、双向跨模态注意力(V2A 与 A2V)和前馈层,视频 token 用 3D RoPE、音频用 1D RoPE。视频潜码由 Hunyuan VAE 编码,音频由 44 kHz 的 MMAudio 自编码器处理,文本用 Qwen2.5-VL-7B 与 CLIP 编码。训练用流匹配分阶段推进:分离预训练(音频从零、视频续训)→ 联合 T2AV → 混入 25% I2AV → 两阶段 SFT(11 域微调后平均成 model soup)→ 在线 RL → 两阶段蒸馏(π-Flow 到 10 NFE,Sim-LADD 对抗精修)。最后由 Latent Upscaler 与 text-free 的 SR-DiT(2 NFE)完成 ×2.25 超分到 Full-HD。
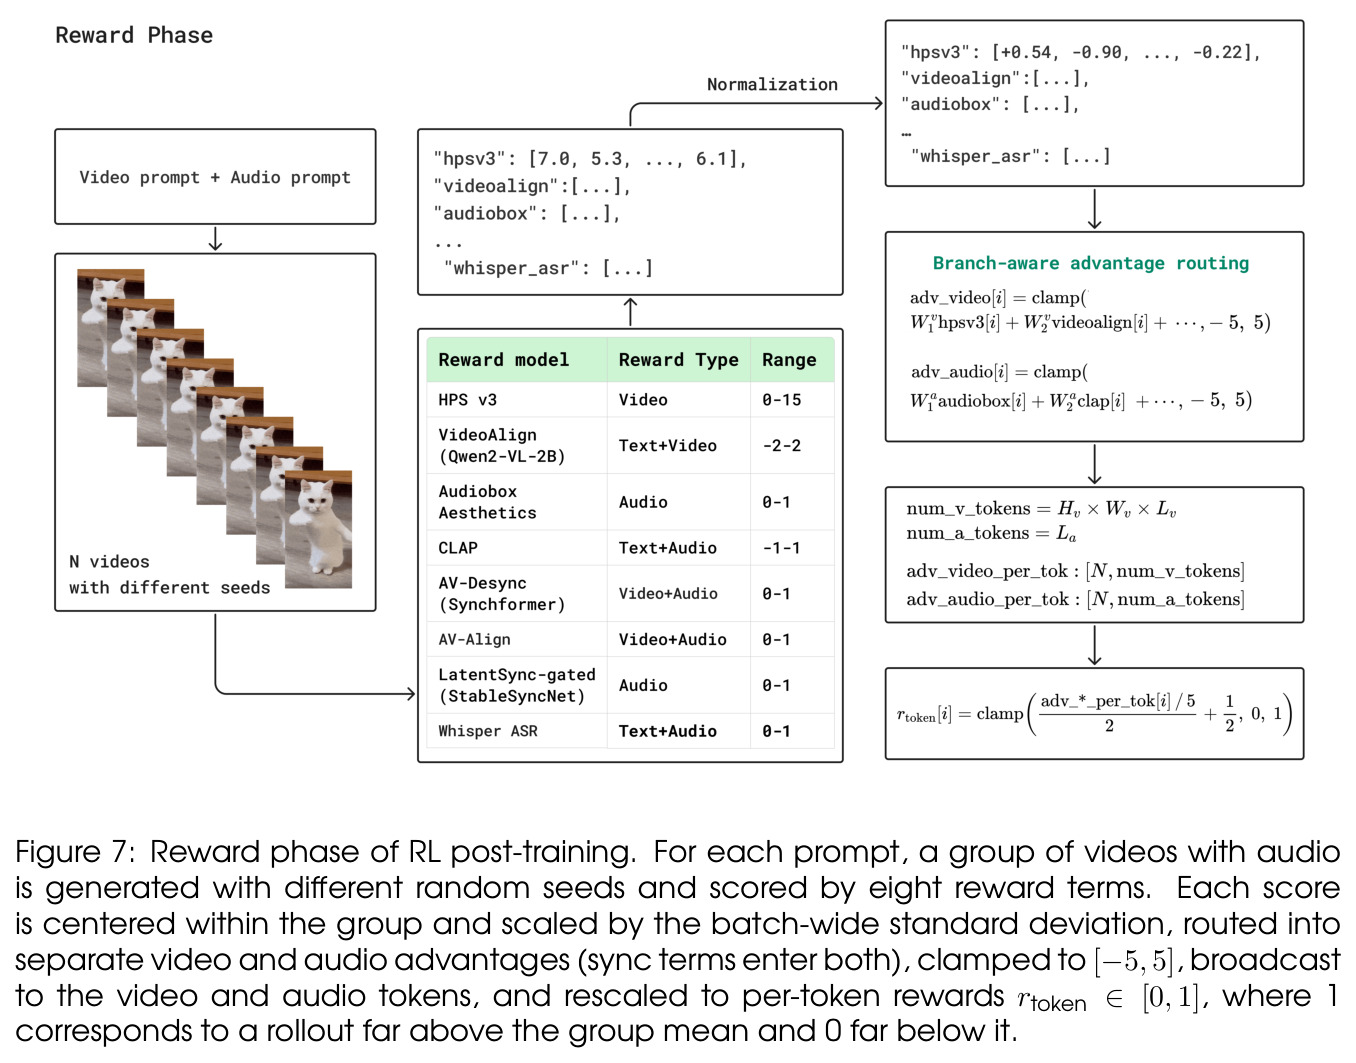
核心创新有三。第一,连续预训练 + independent_time:保留预训练视频流、从零训练音频流、只让新增交叉注意力层承载模态对齐;训练时两模态采样各自独立的扩散时刻 $t$,使单一模型既能做 T2AV/I2AV 也保留单向生成能力。第二,RL 的细粒度对齐控制:8 个奖励按视频/音频/同步三分支路由(权重 2.5/2.0/2.75),同步项同时进入两个模态的优势;用 A2V 注意力图定位与声音相关的视频区域(人脸、手、乐器)做最高 1.5× 的损失重加权;并对 V2A 交叉注意力 KV 路径按层调度缩放梯度(Pro:block 0→0.0、1–10→0.1、50–59→0.3),防止视频梯度破坏音频表示——作者发现 OmniNFT 原分层方案无法跨模型迁移,需用 KV 消融自行校准。第三,潜空间超分:Latent Upscaler 直接在 K-VAE 潜空间确定性上采样,省去逐 tile 像素放大再编码的开销,配合 text-free SR-DiT 蒸馏到 2 次网络调用。
方法步骤详情
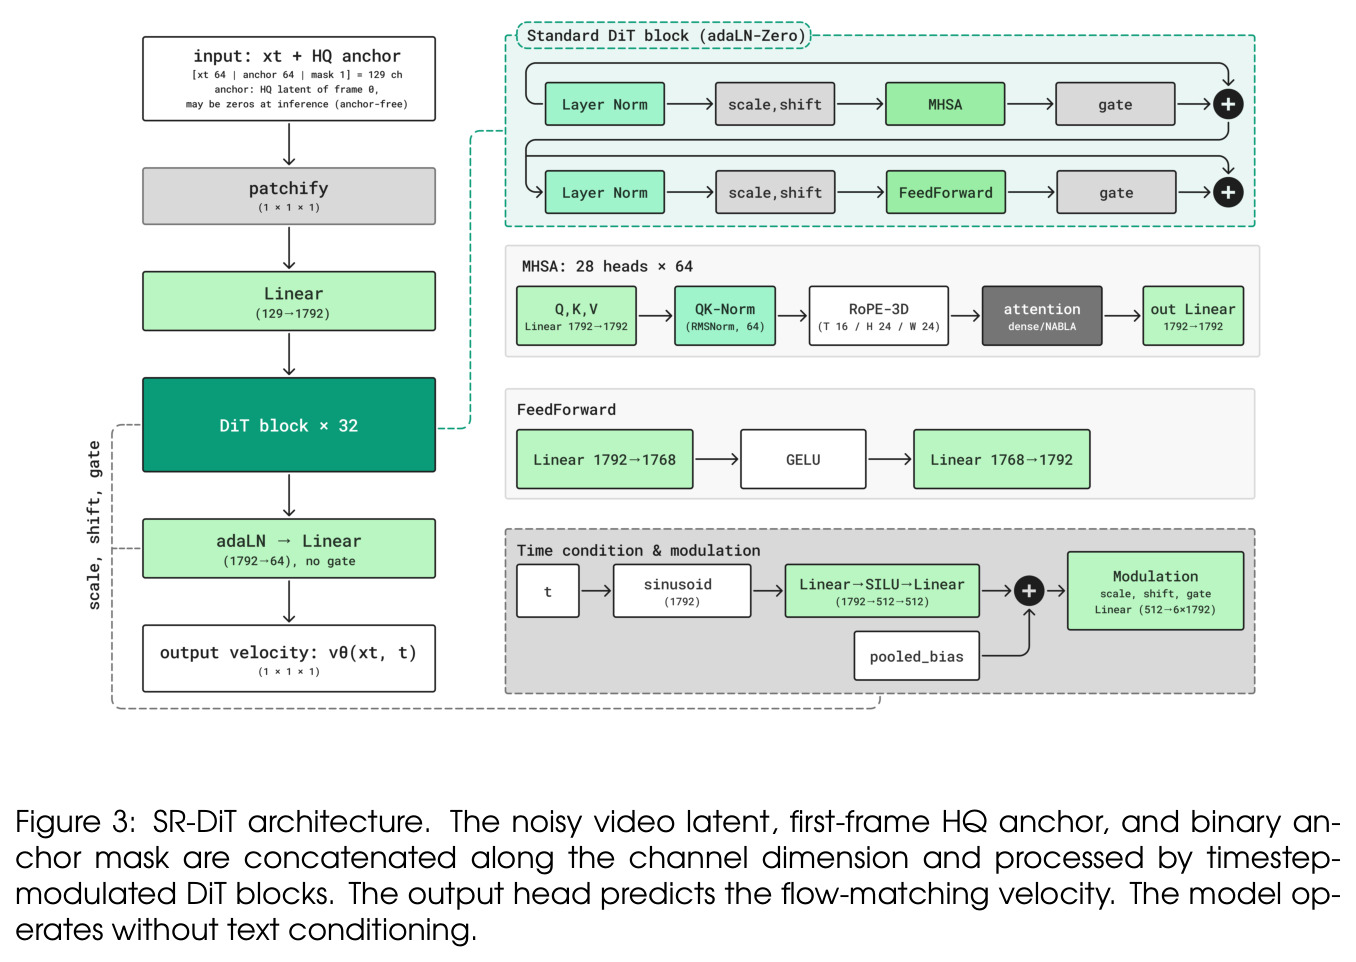
步骤如下。①数据构建:T2I 5000 万图、T2V 2000 万视频、T2A 4000 万条音频、T2AV 700 万段(人像 LSA≥3、事件 Desync<0.1)、I2AV 11.6 万样本、SFT 约 1.2 万场景(11 域)、RL 2984 条、SR 15 万片段。②分离预训练:音频流先在纯音频、后在 AV 字幕上训练;视频流从 K5.0 检查点续训。③联合 T2AV(Lite 57.5k/Pro 49k 步),两模态独立加噪。④混入 25% I2AV 再训数千步:参考帧潜码沿时间轴拼接,以掩码与时序 RoPE 绑定。⑤两阶段 SFT:Stage 1(7000 步)冻结音频流只优化视频损失;Stage 2(5000 步)损失为 $0.85\times$视频$+0.15\times$音频$+1.0\times$人脸损失,11 域模型最后平均成 soup。⑥在线 RL:GRPO 组 $K=10$、LoRA $r=16$(Pro 仅 199M 参数)。⑦蒸馏:π-Flow 到 10 NFE 后用 Sim-LADD 精修。⑧SR-DiT 三阶段训练并蒸馏到 NFE=2。
技术新颖性
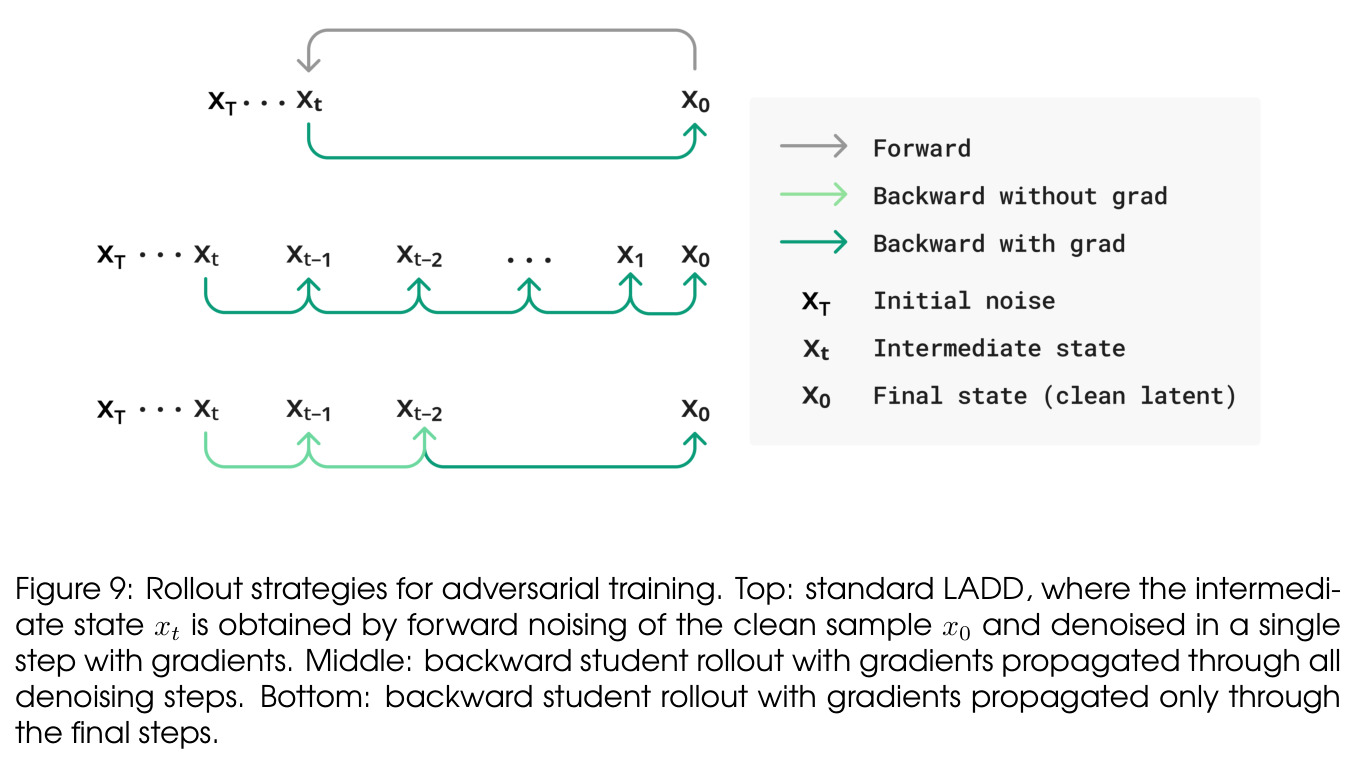
技术新颖性体现在若干具体设计。架构层面,双流 CrossDiT 与 Ovi、LTX-2 同类,但本文把「继承视频流 + 从零音频流 + 新初始化连接层」的连续预训练配方完整公开并系统验证,对算力受限团队有直接参考价值。RL 层面,OmniNFT 原为 LTX-2 19B 设计,本文发现其梯度手术的层分区不能跨模型迁移,提出用「逐块 KV 消融测量音画去同步 + 视频损失向音频流的梯度泄漏测量」自行校准调度,这一方法论本身可复用。蒸馏层面提出 Sim-LADD:标准 LADD 的对抗训练状态 $x_t$ 由前向加噪得到,Sim-LADD 改用学生自己的反向去噪 rollout 生成状态(on-policy),判别器看到的正是推理时真实遇到的状态,缩小训练-推理差距;并以 DRaFT-k($k=5$)截断反传控制显存。SR 层面,「确定性潜空间上采样 + text-free 扩散精修」的二段式设计与 2 NFE 蒸馏在消费级部署上有明确工程价值;SR 训练还联合 Real-ESRGAN 式空间退化与 CreativeVR 式时序退化,并用 HFP/MFS 损失抑制棋盘格伪影。
实验结果
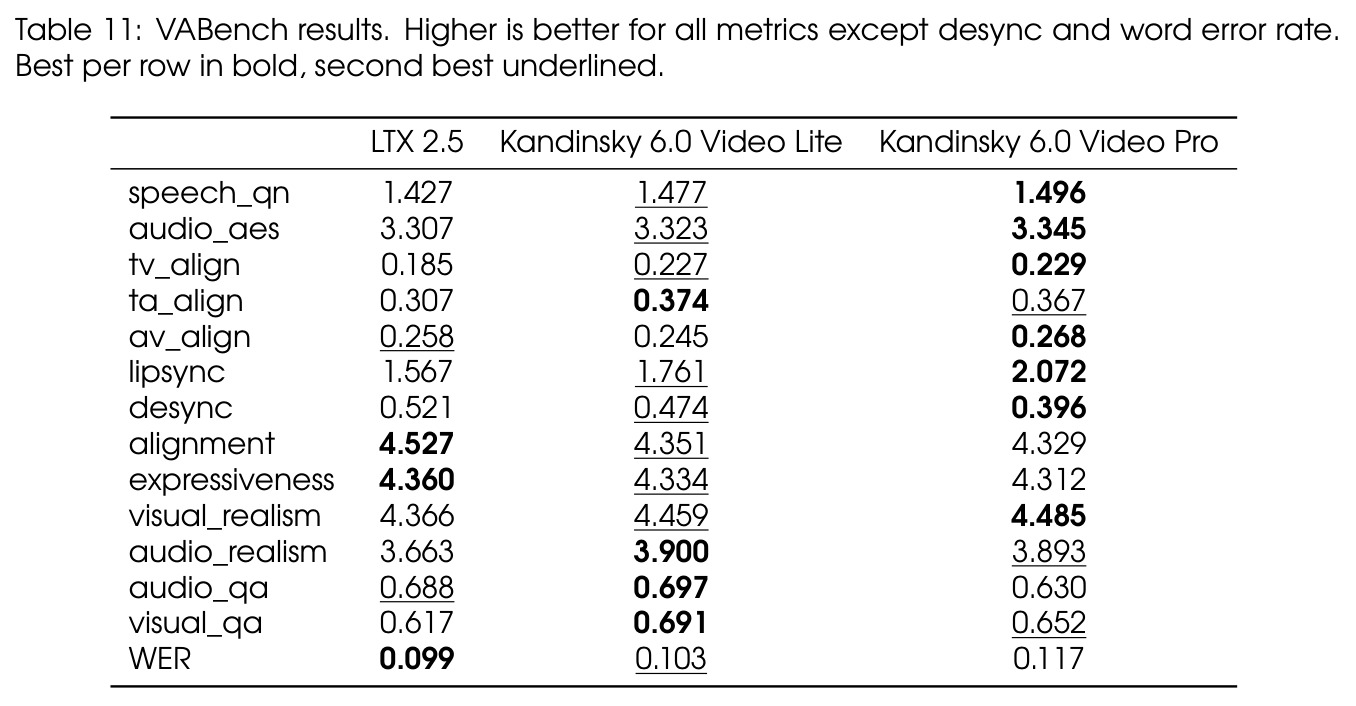
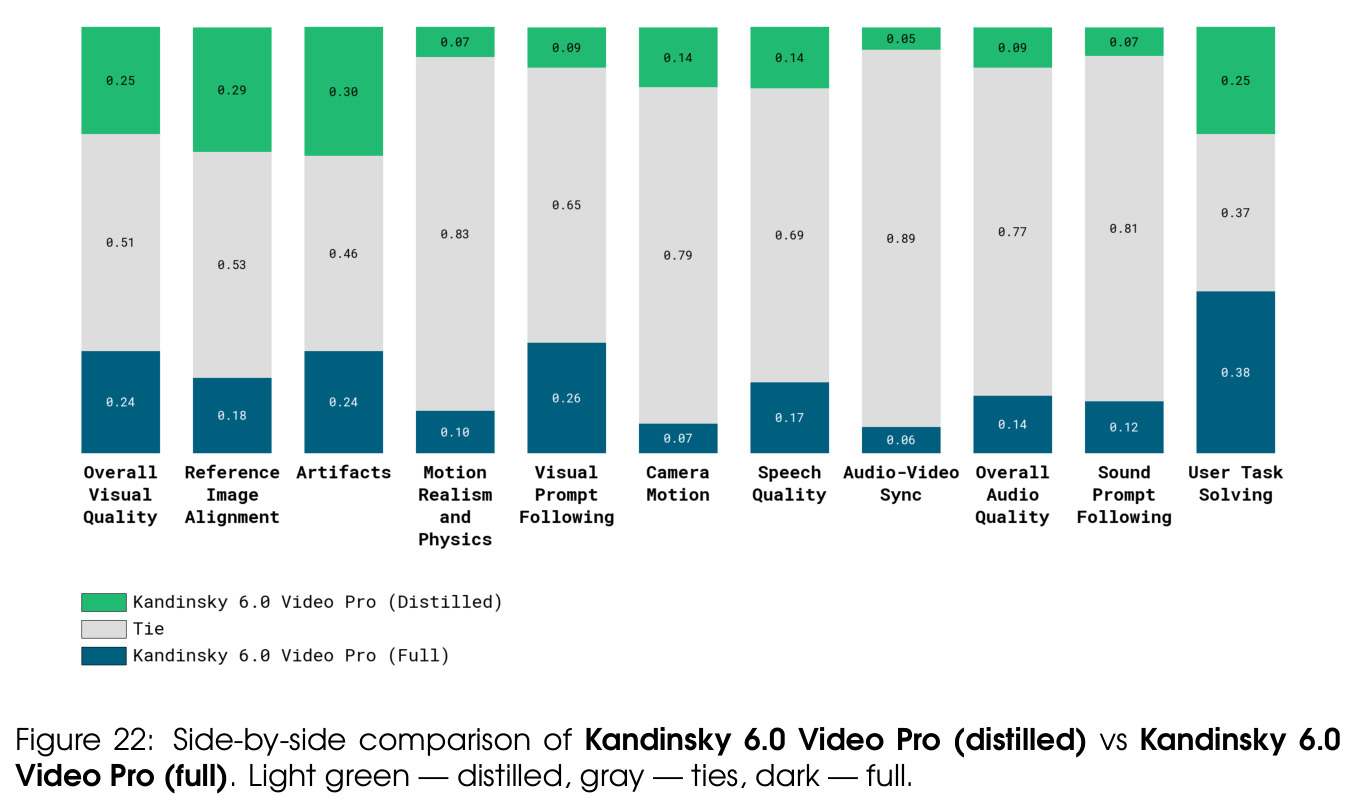
VABench:Pro 在语音质量 1.496(LTX 2.5 为 1.427)、唇同步 2.072(vs 1.567,约 +32%)、去同步 0.396(越低越好,vs 0.521)、视觉真实感 4.485 等 7 项领先;LTX 2.5 在 VLM 评判的对齐、表现力与词错率(0.099 vs Lite 0.103、Pro 0.117)占优。人评(每准则约 200+ 对比):对前代 K5.0 全部视觉准则占优;vs LTX 2.5 画质、任务完成与语音质量显著占优;vs Kling 2.6 互有胜负(声音-提示跟随占优);vs Veo 3.1 Fast 互有显著优势(K6:伪影、相机运动、参考图保持;Veo:提示跟随与音频);MiniMax H3 与 Seedance 2.0 视觉更强,但对 Seedance 语音质量仍占优、对两者同步性持平。消融:RL 相对 SFT 在三个设置全部改善;蒸馏模型与全模型偏好 51%:49% 无显著差异。RL 使 Pro 的 WER 从 0.235 降至 0.124(−47%,$p<10^{-3}$),Lite 从 0.179 降至 0.127。
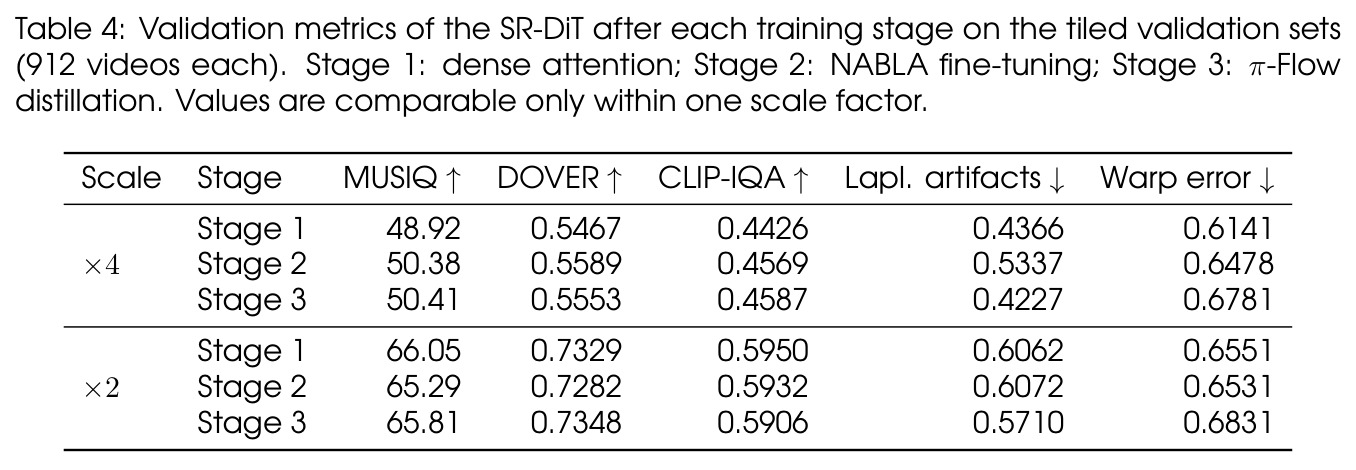
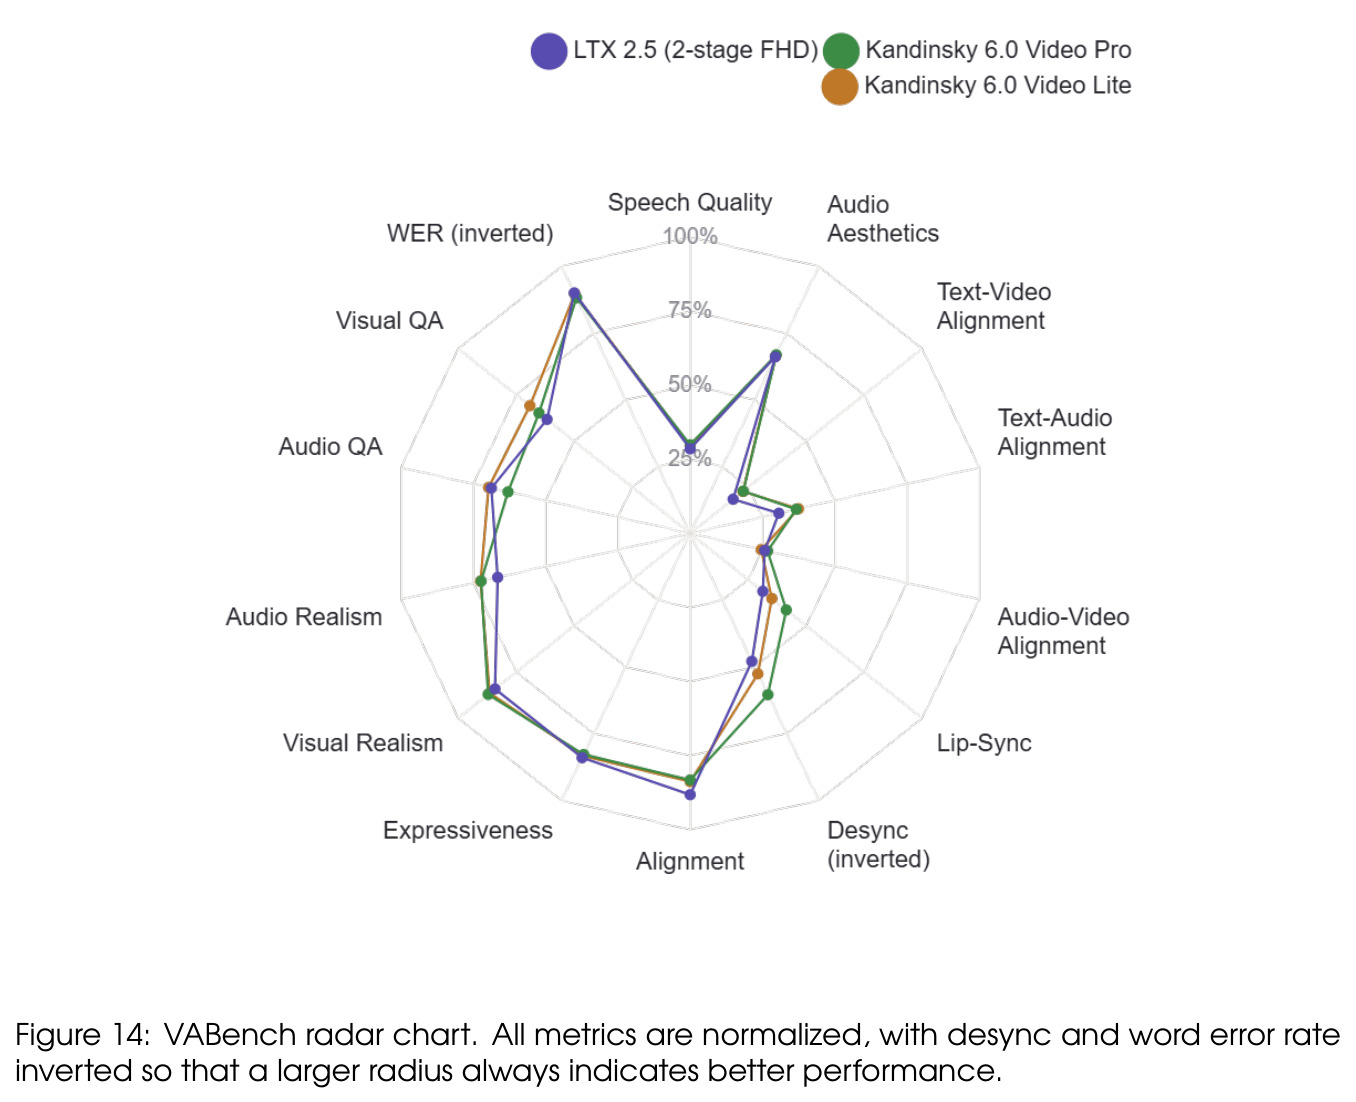
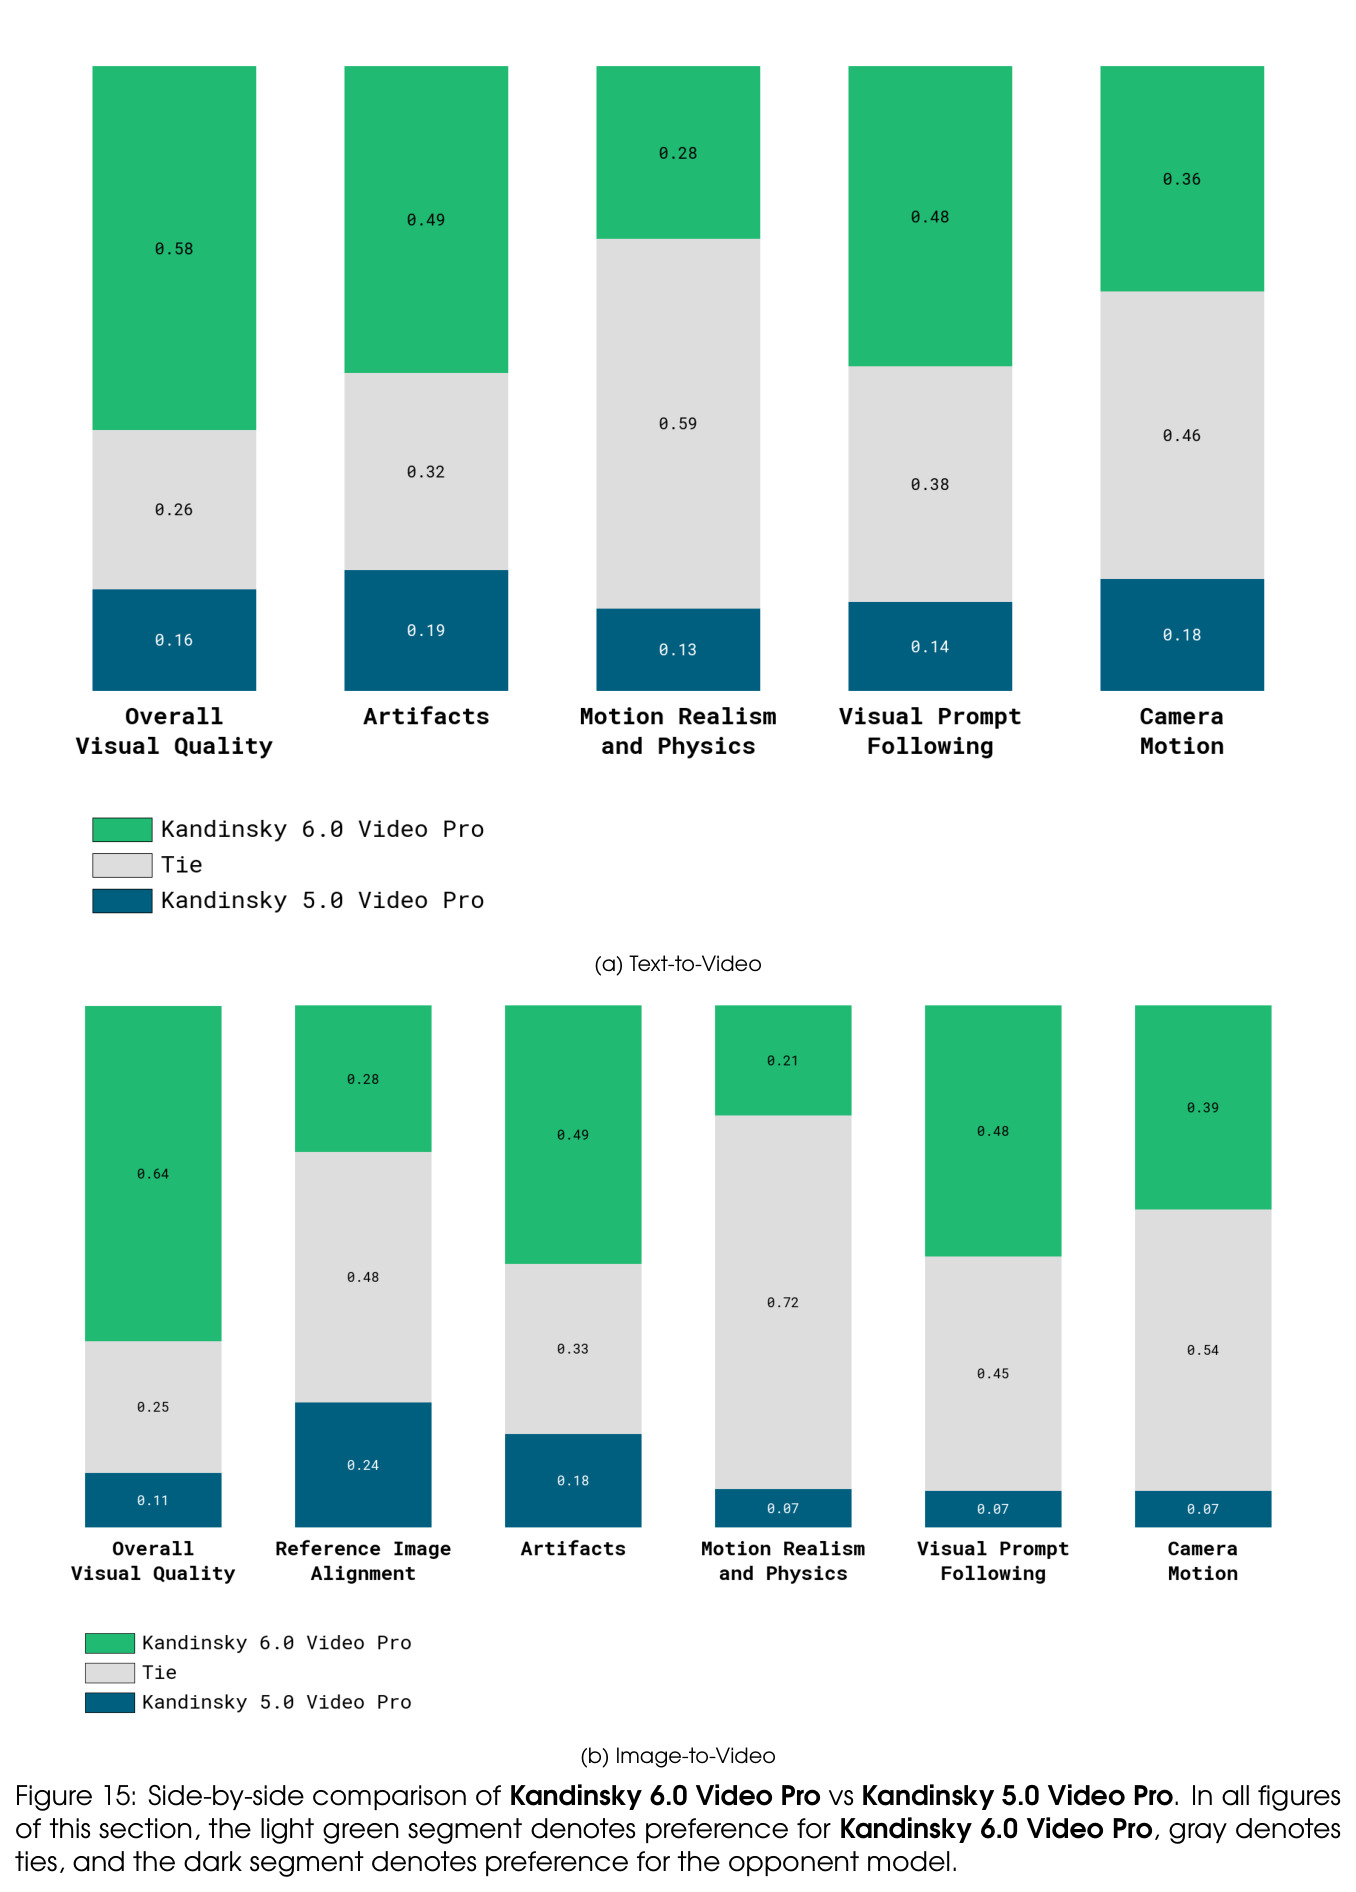
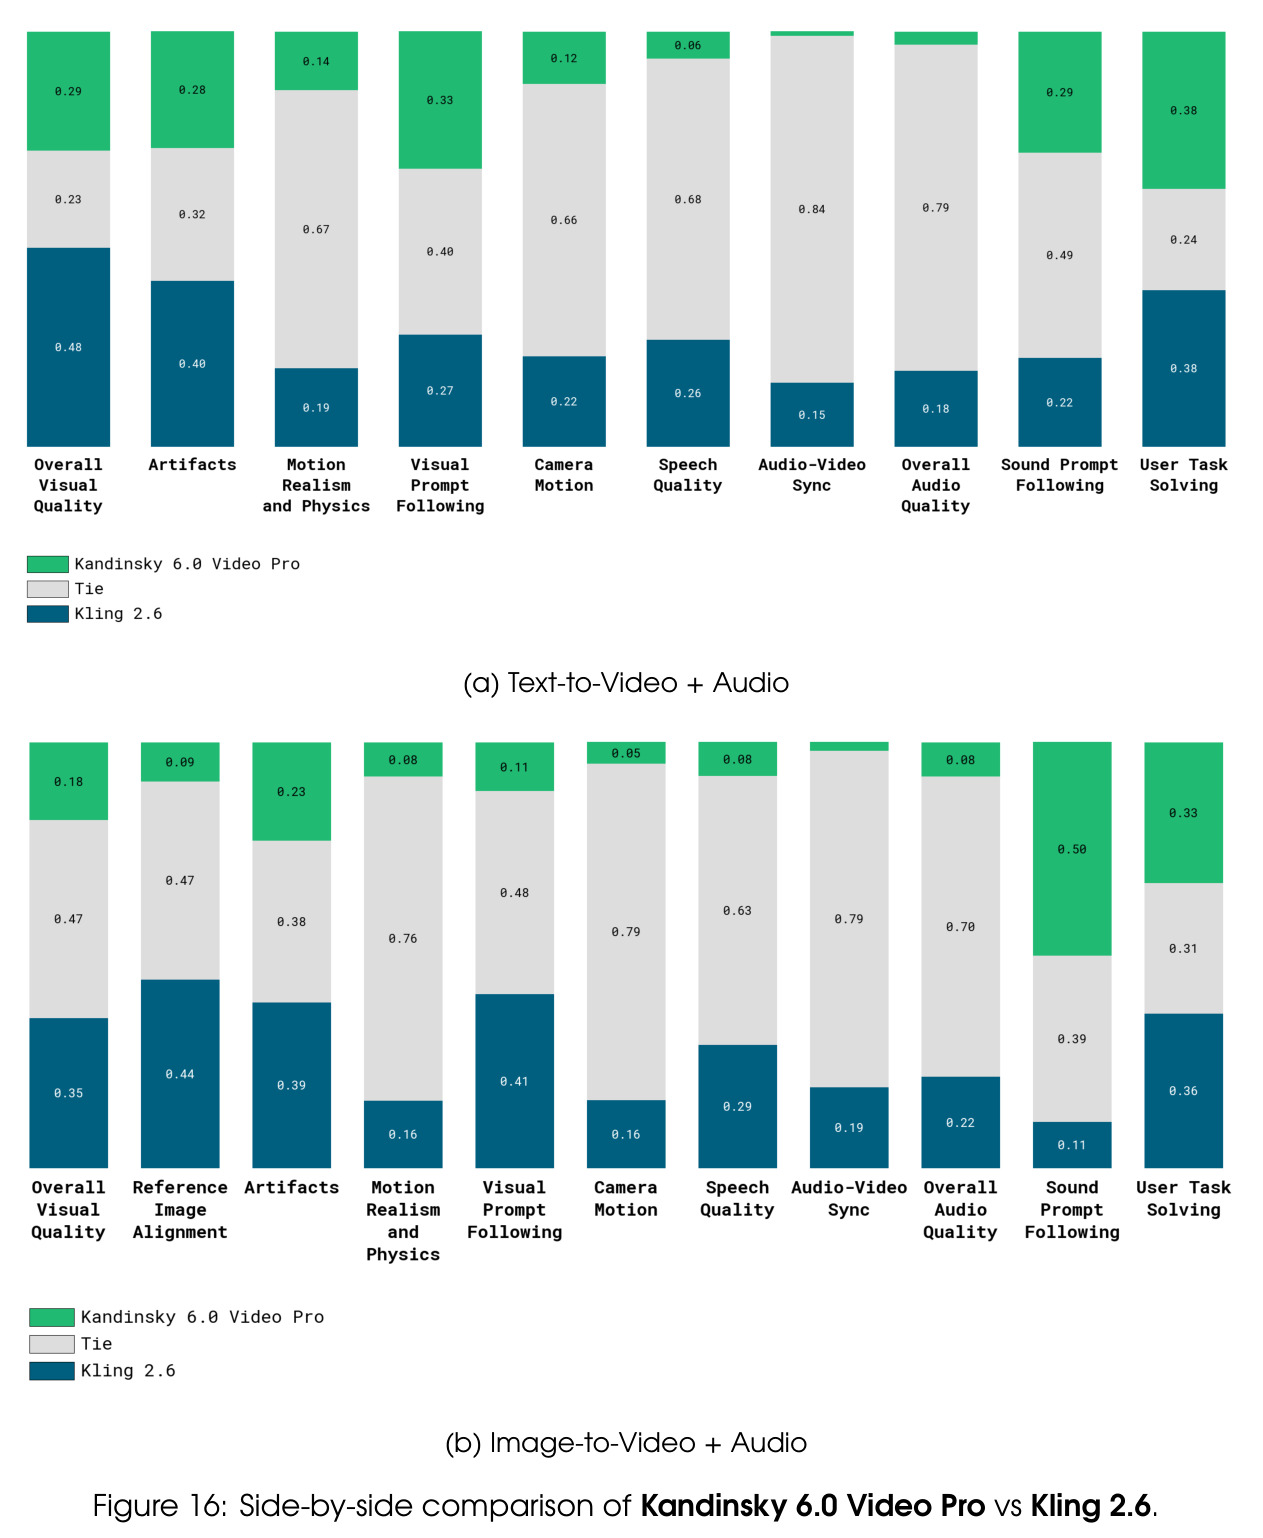
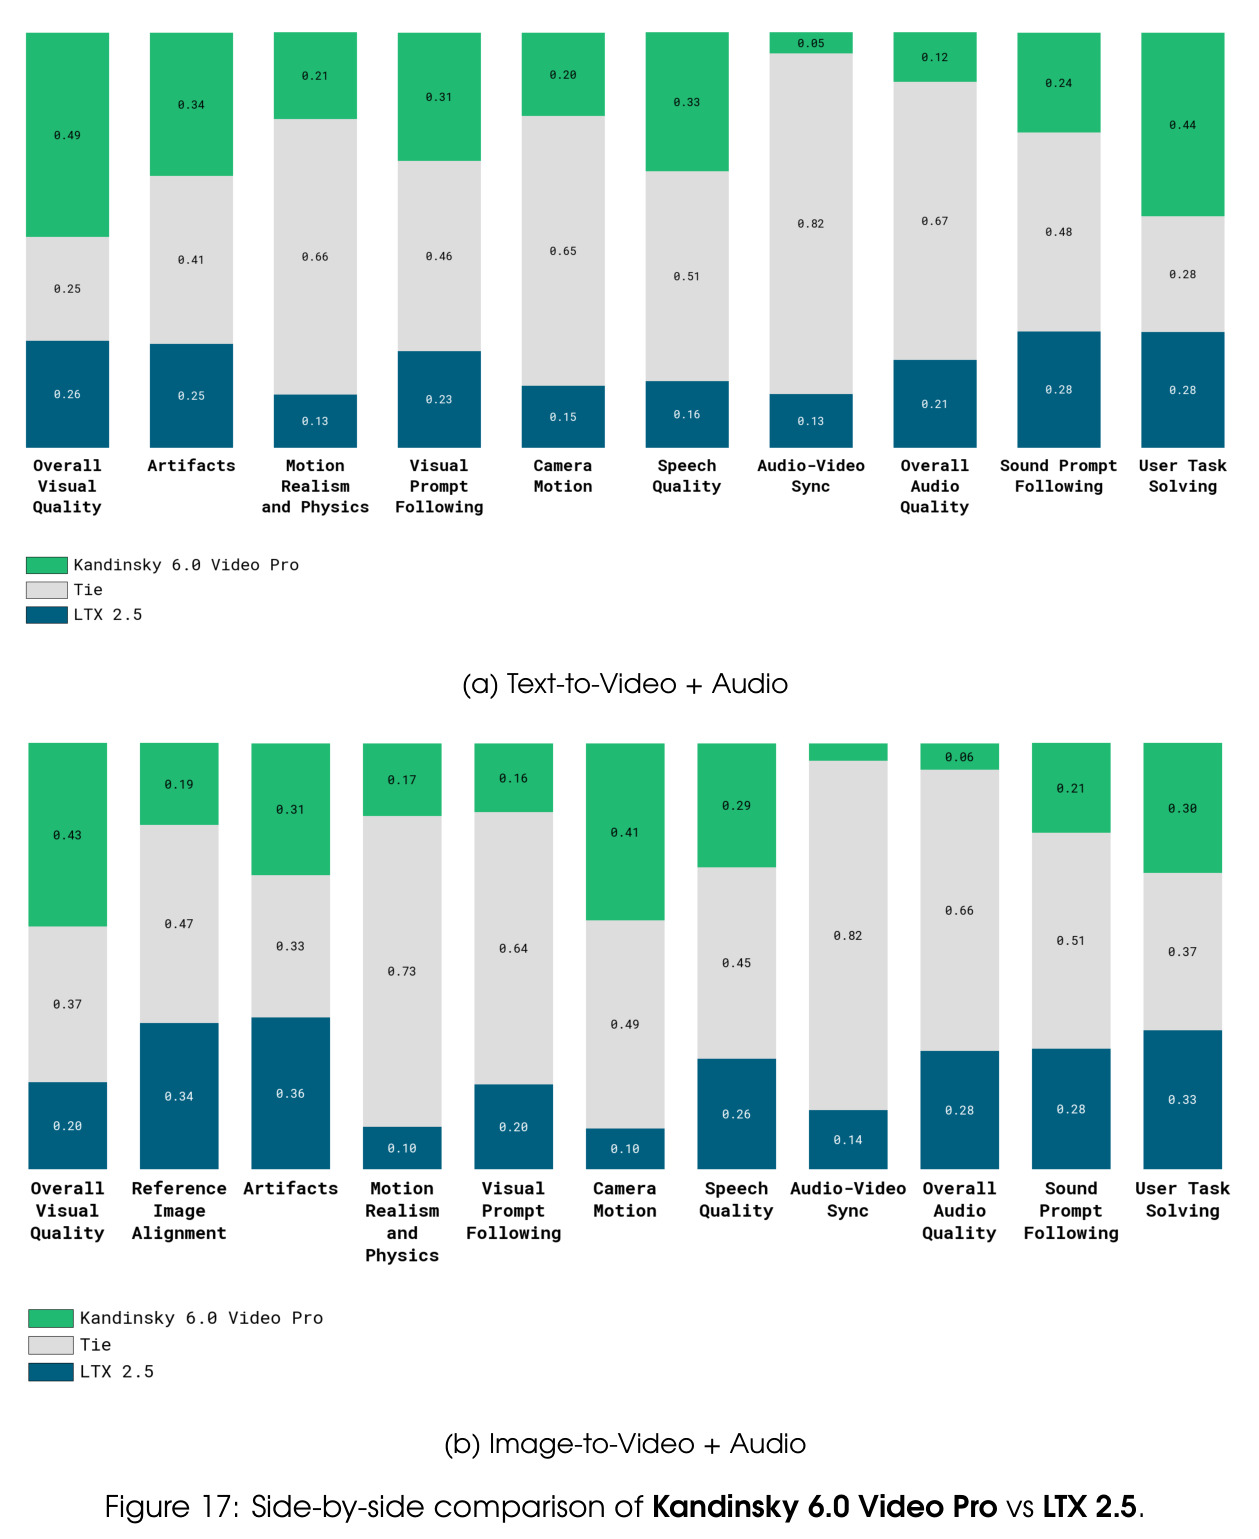
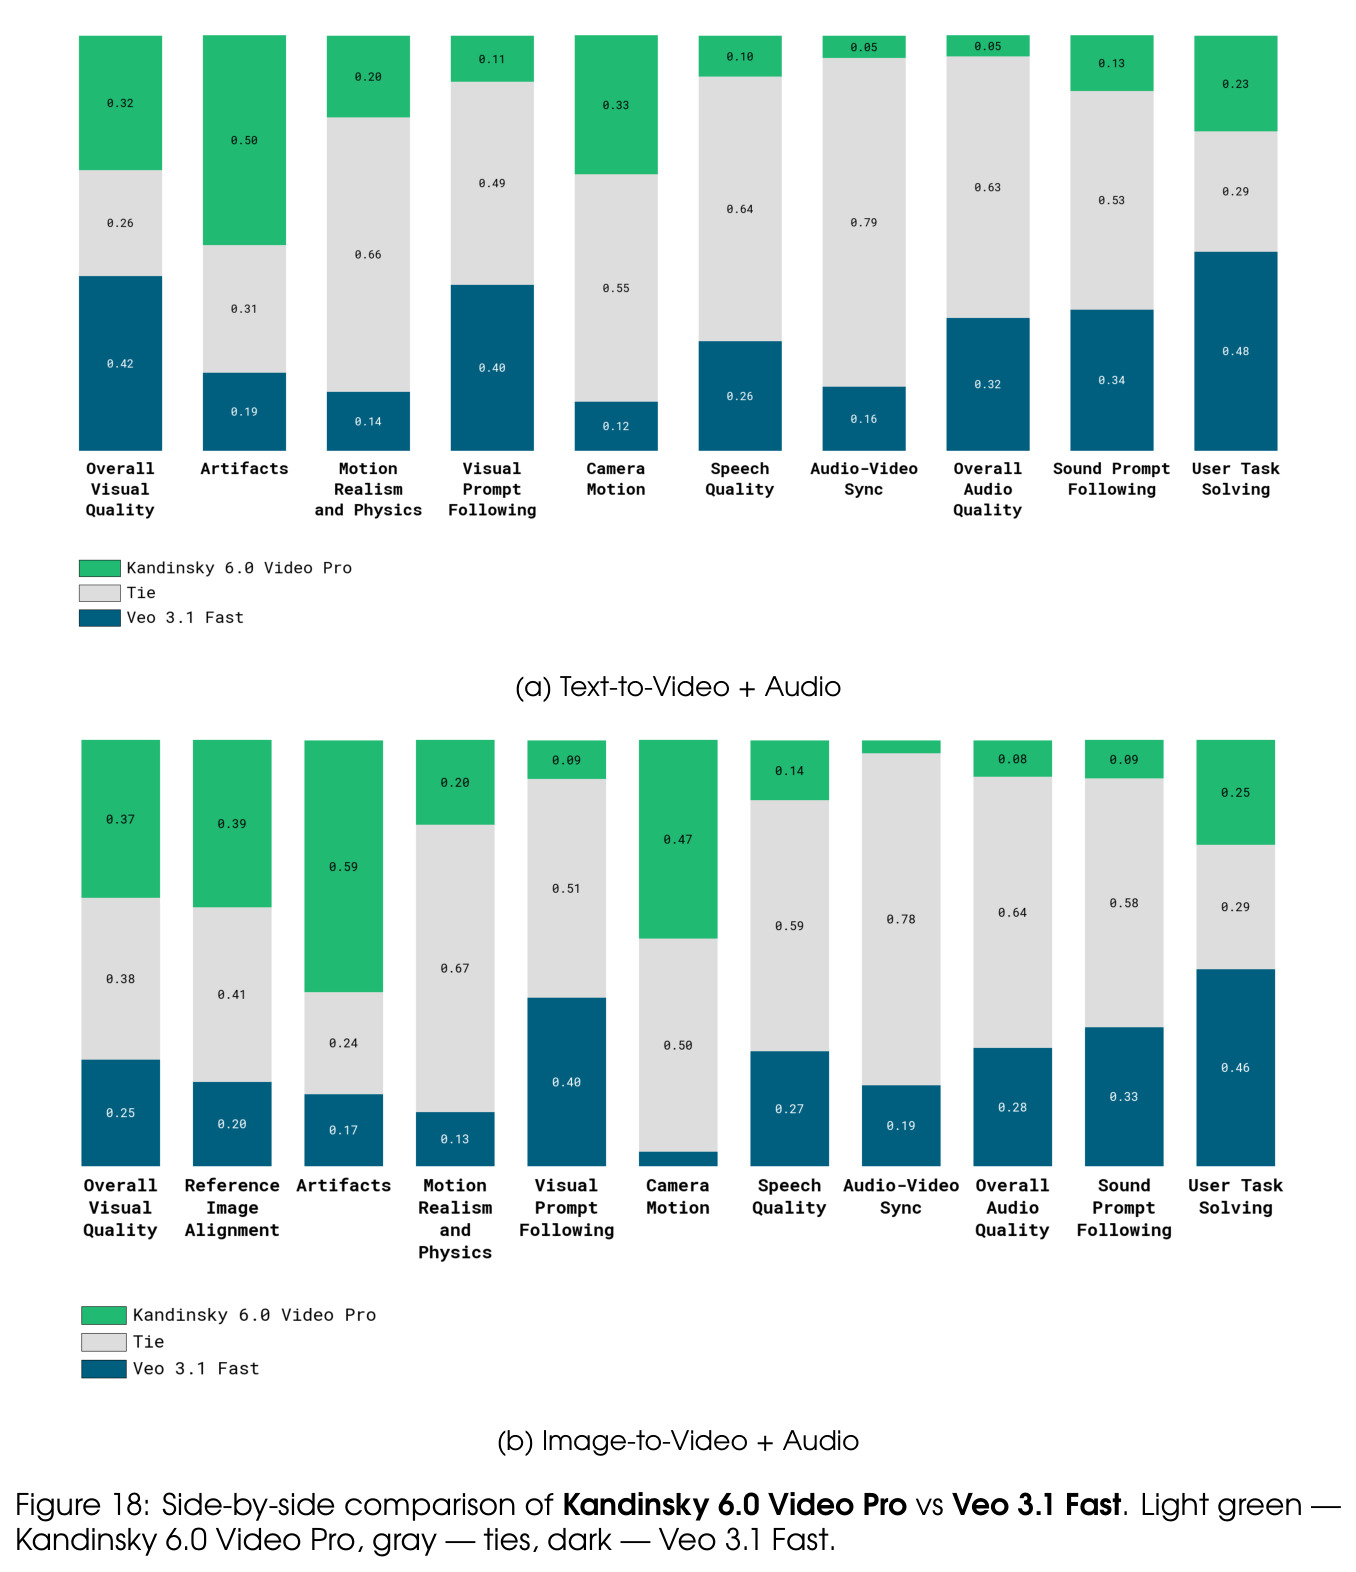
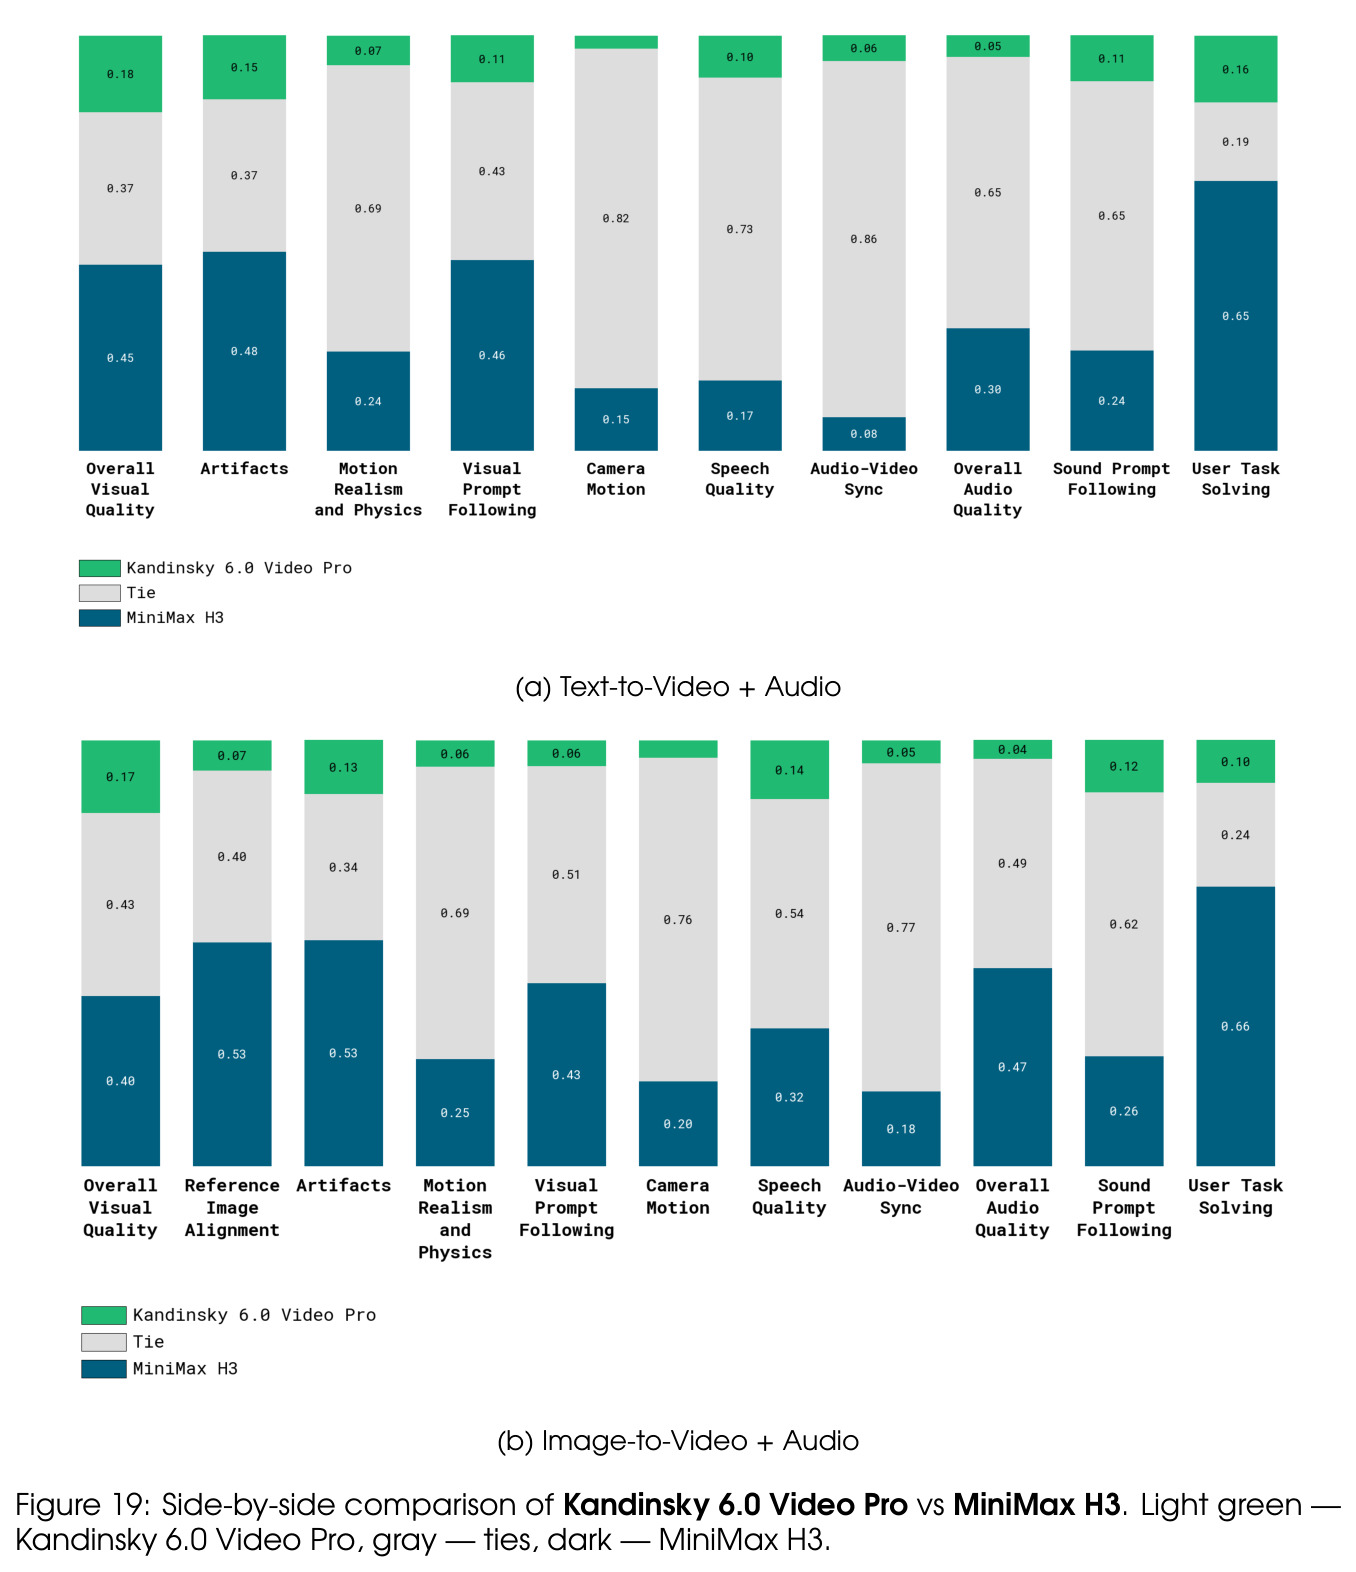
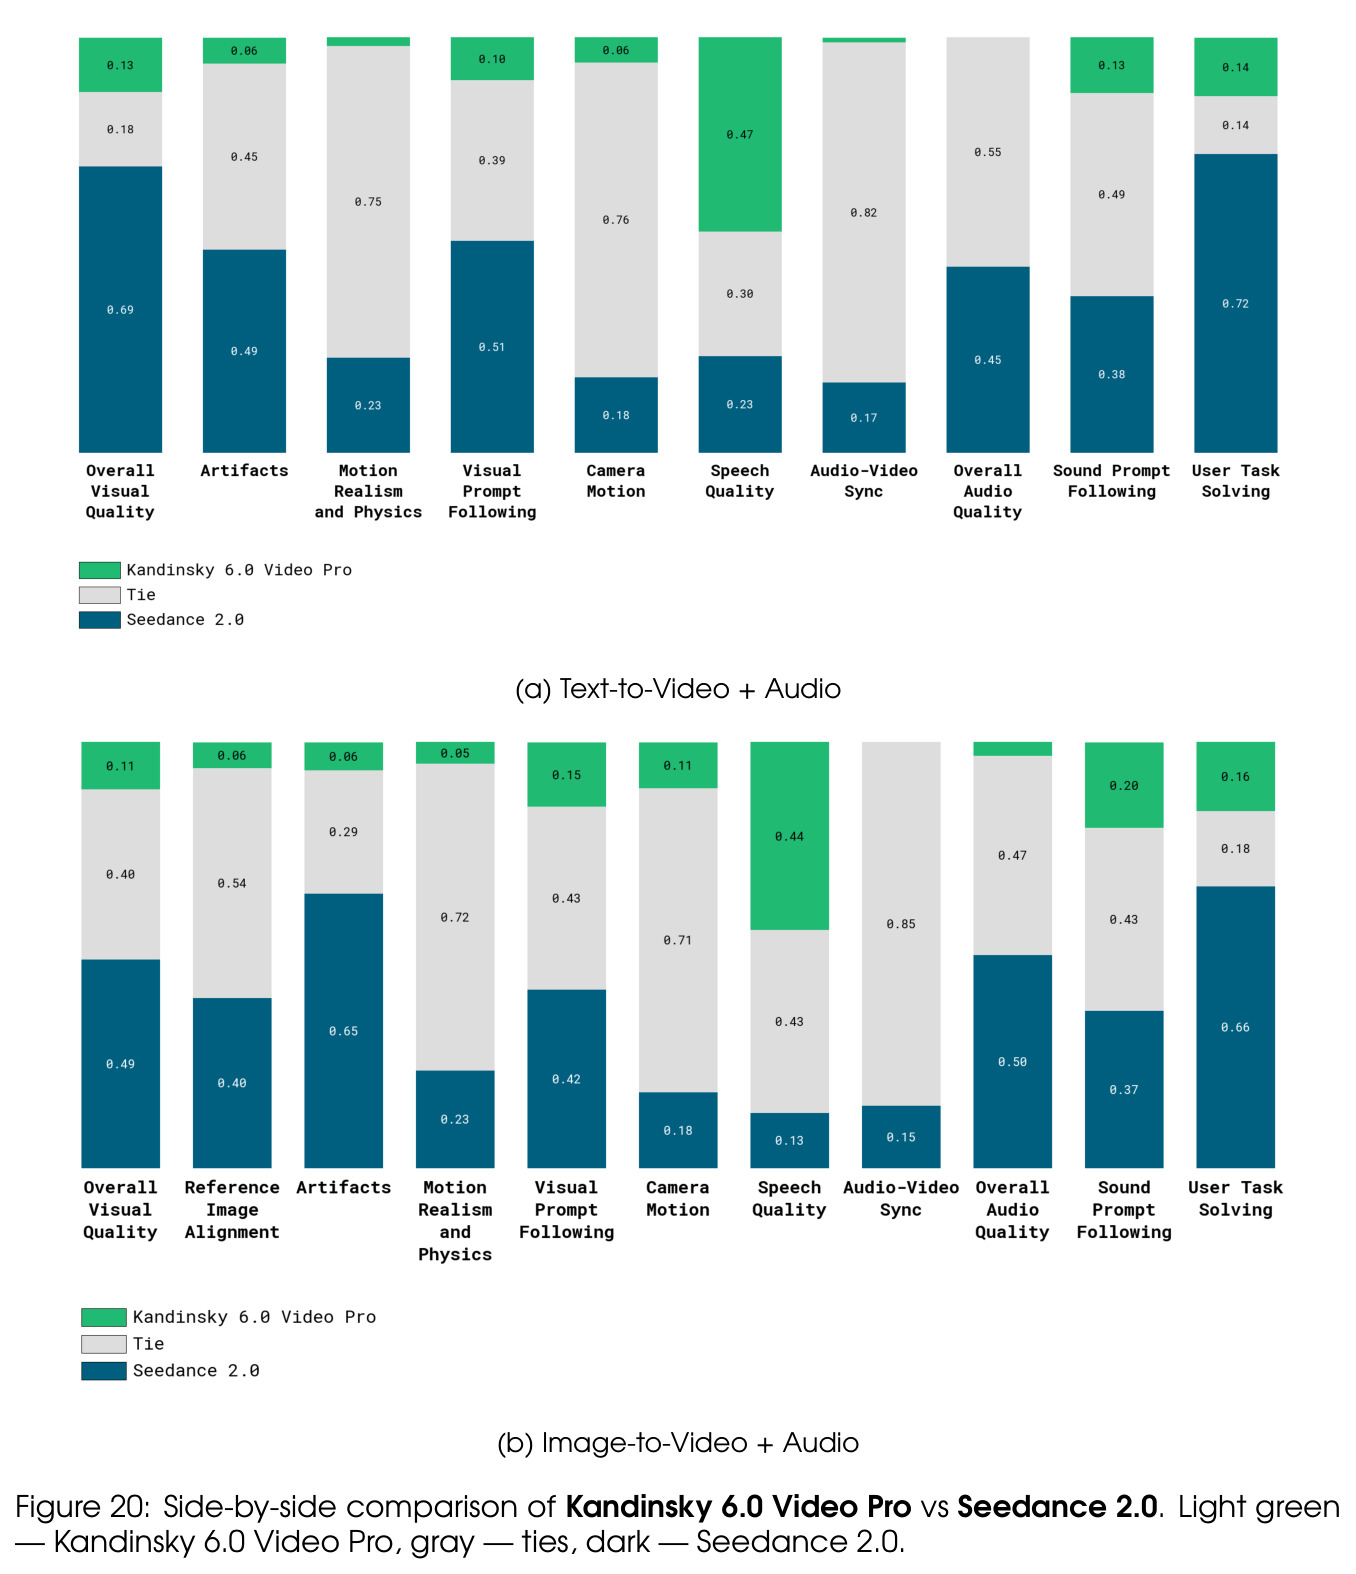
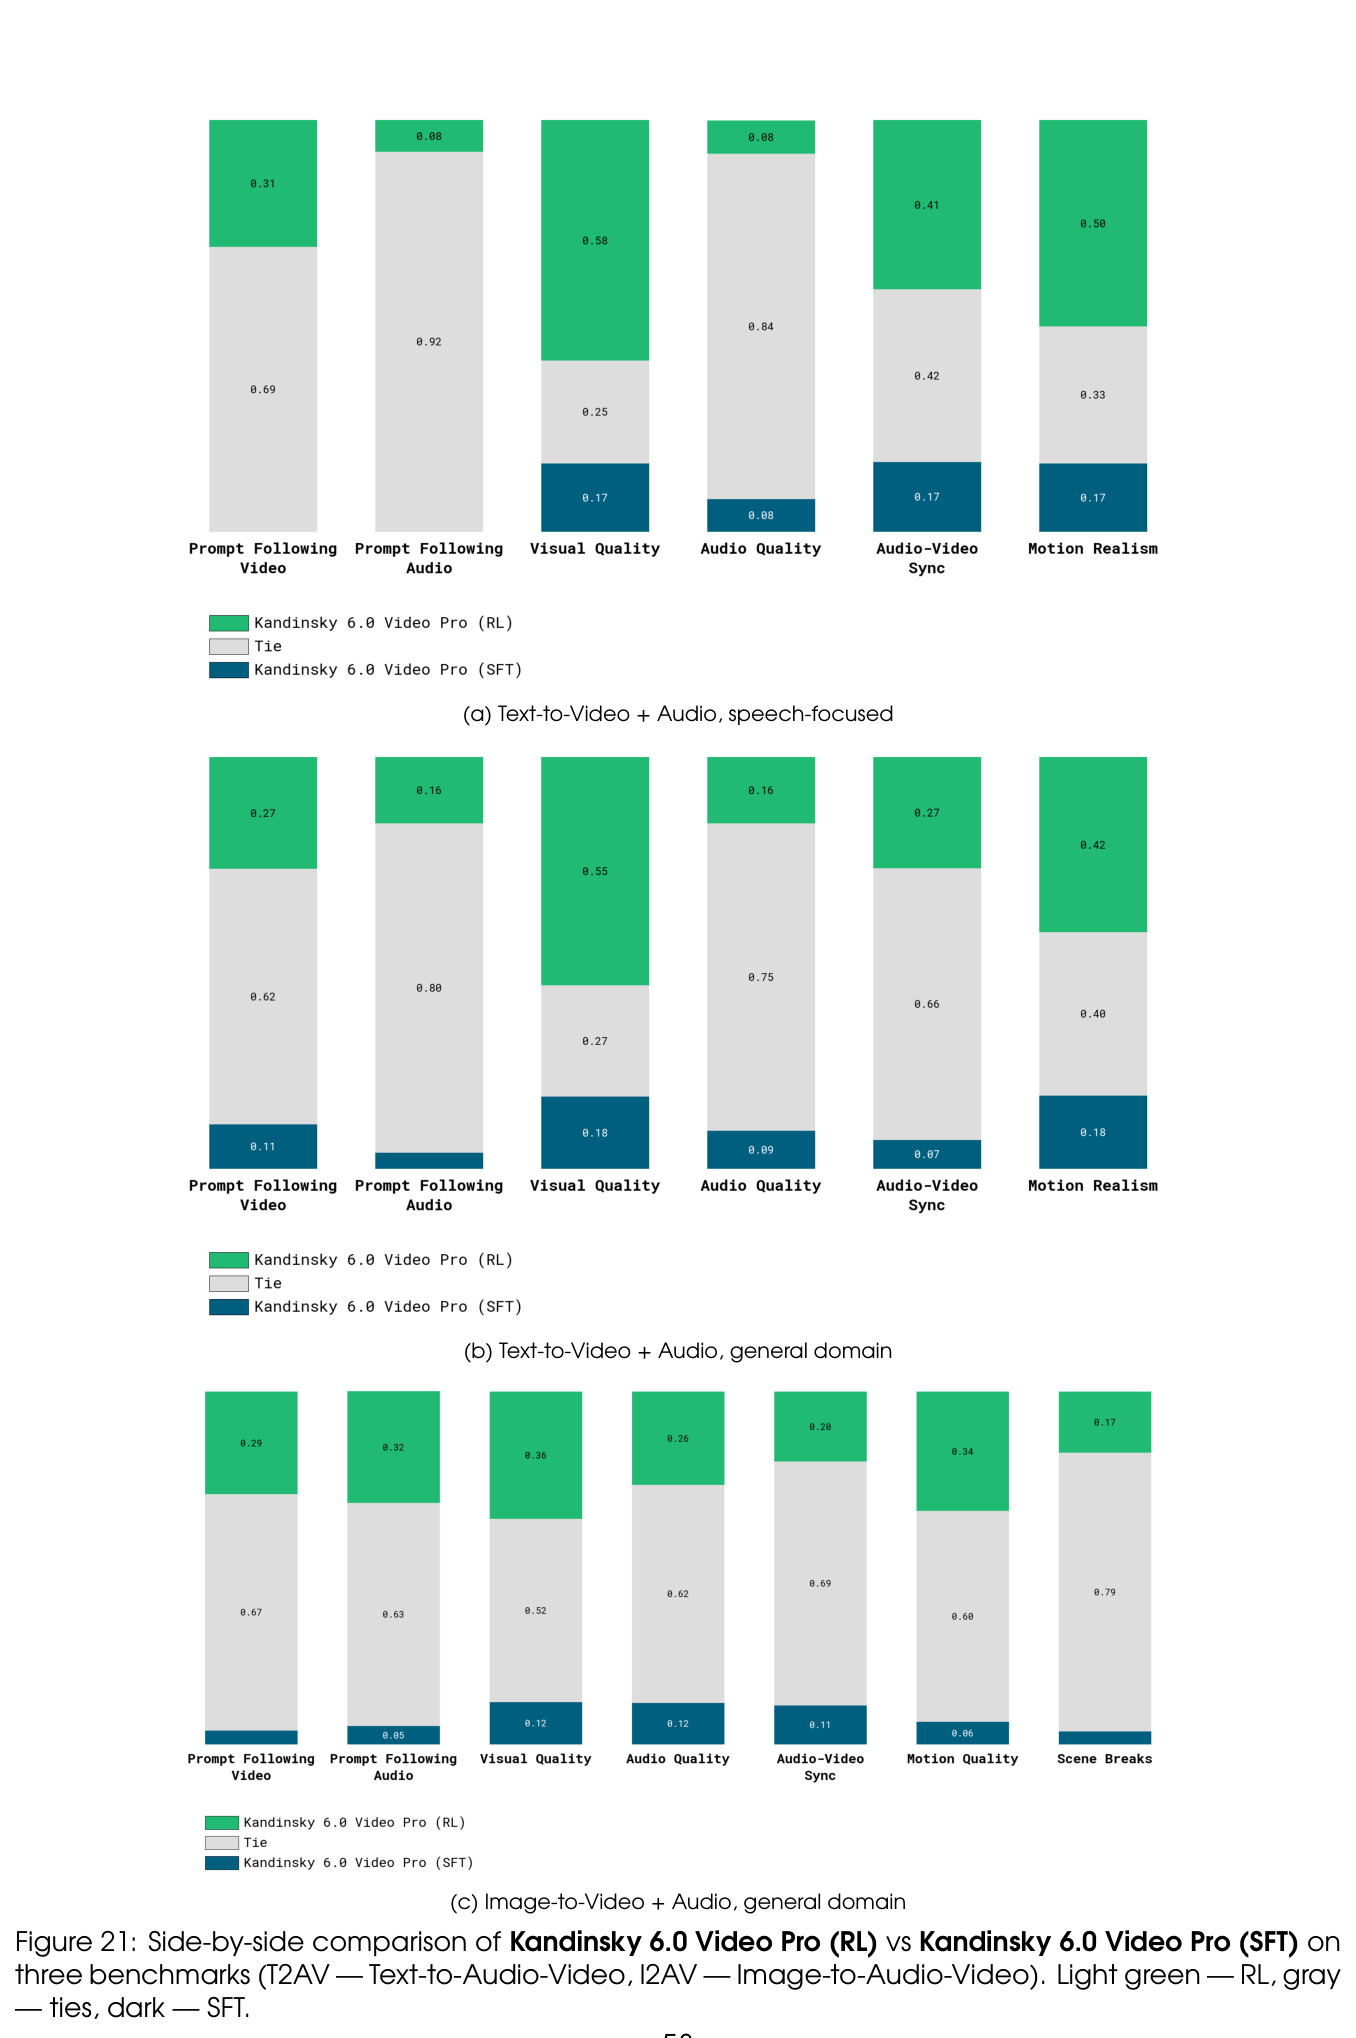
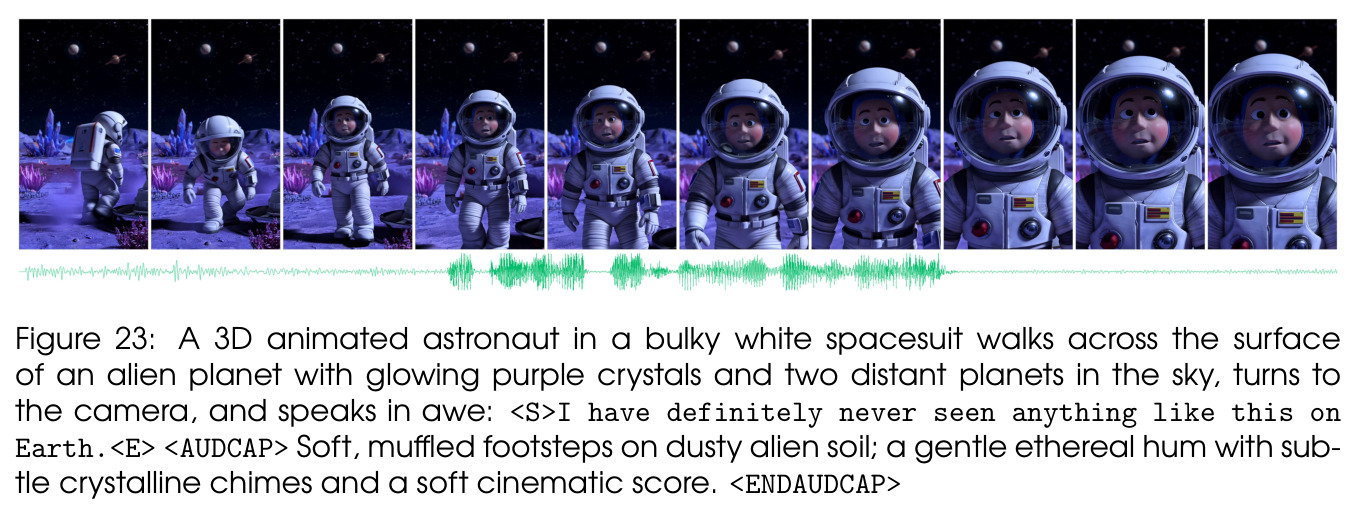
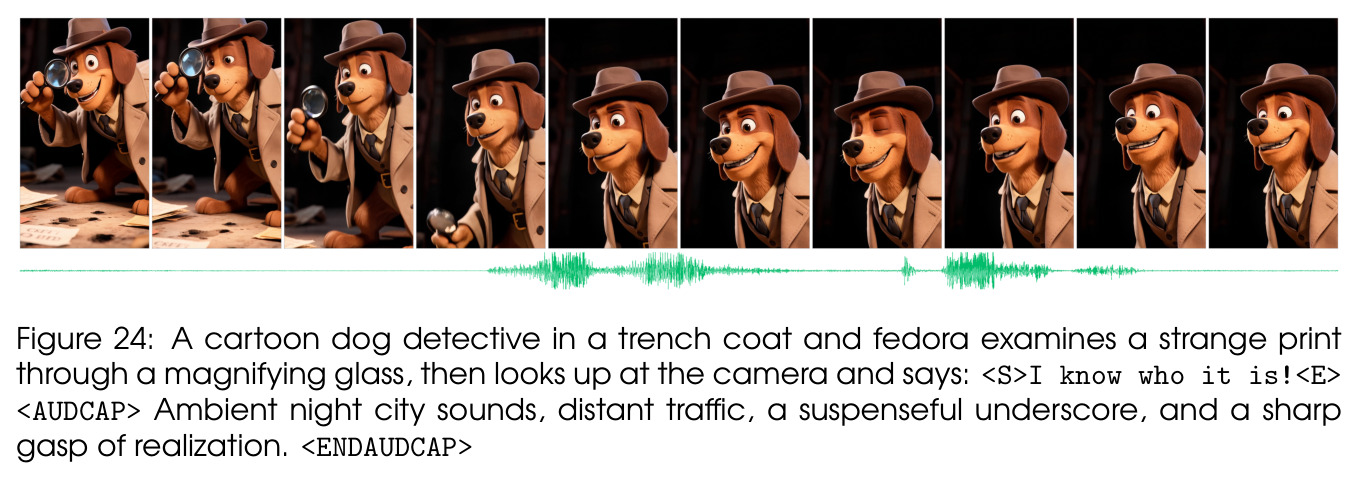
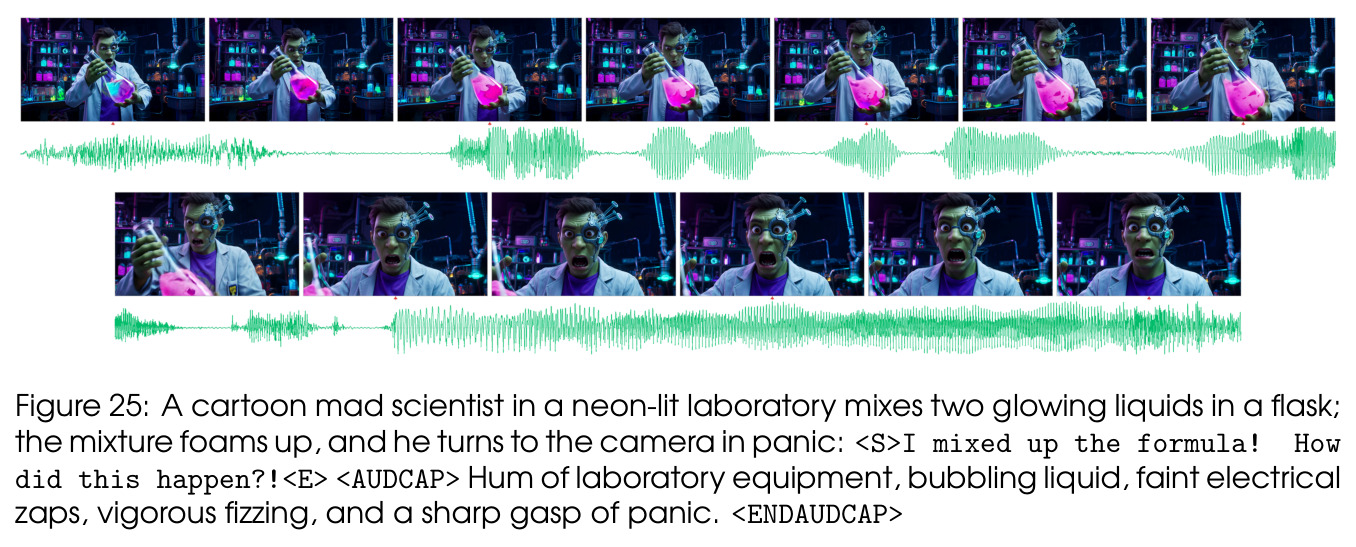
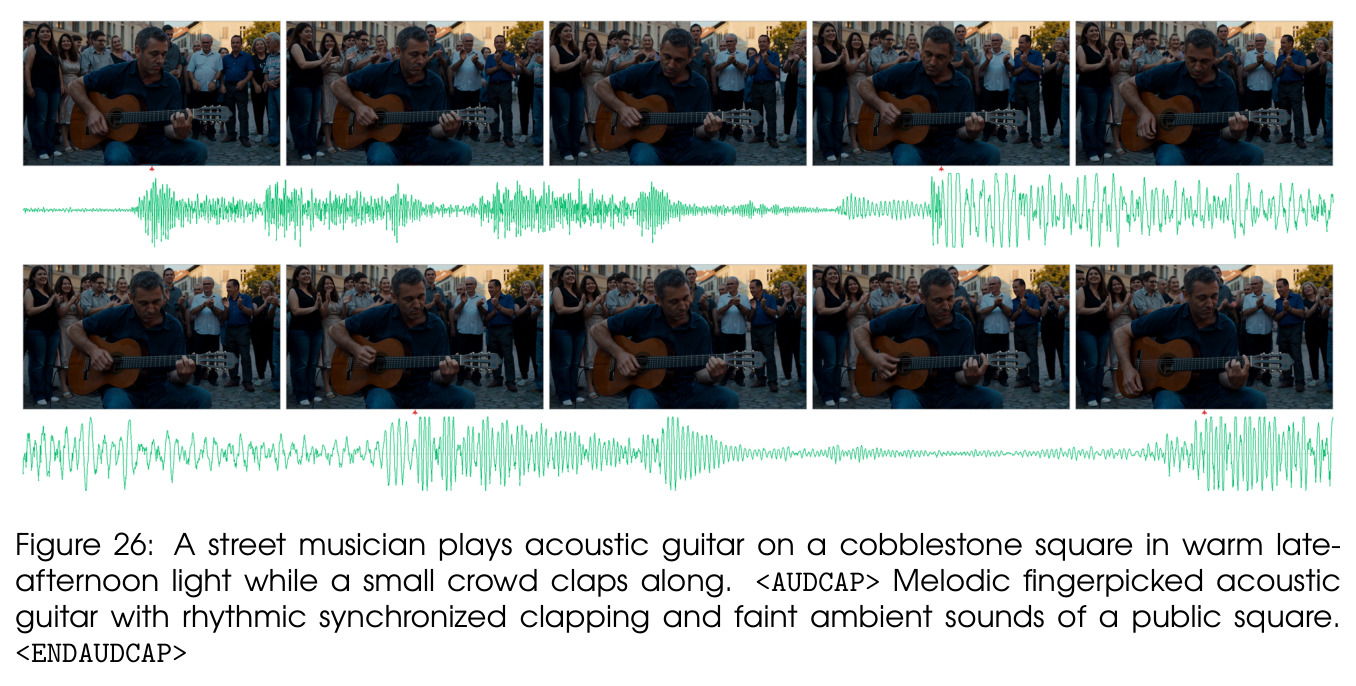
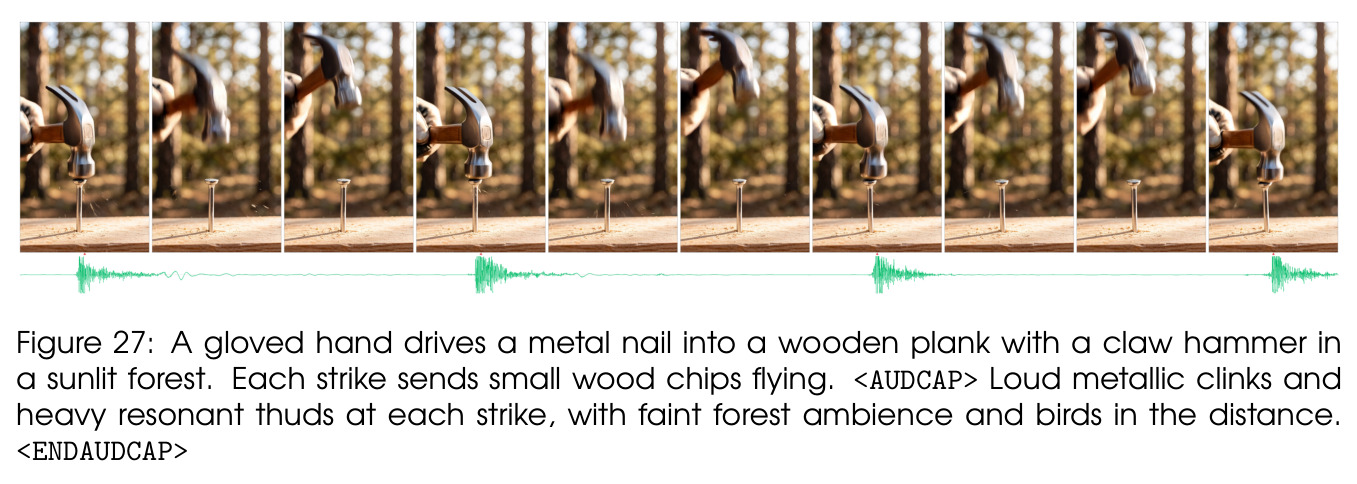
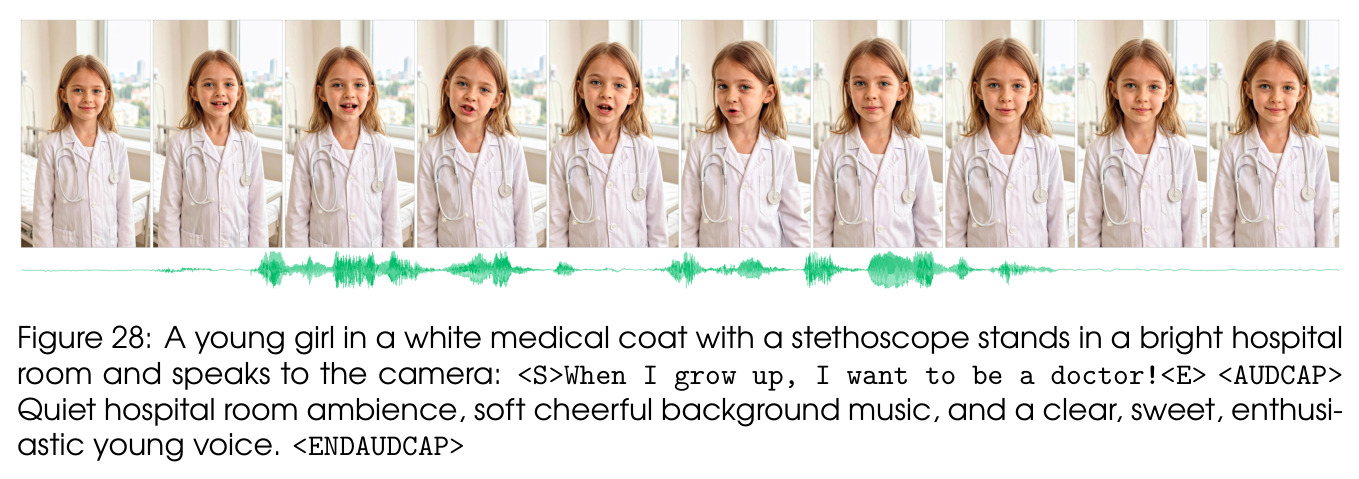
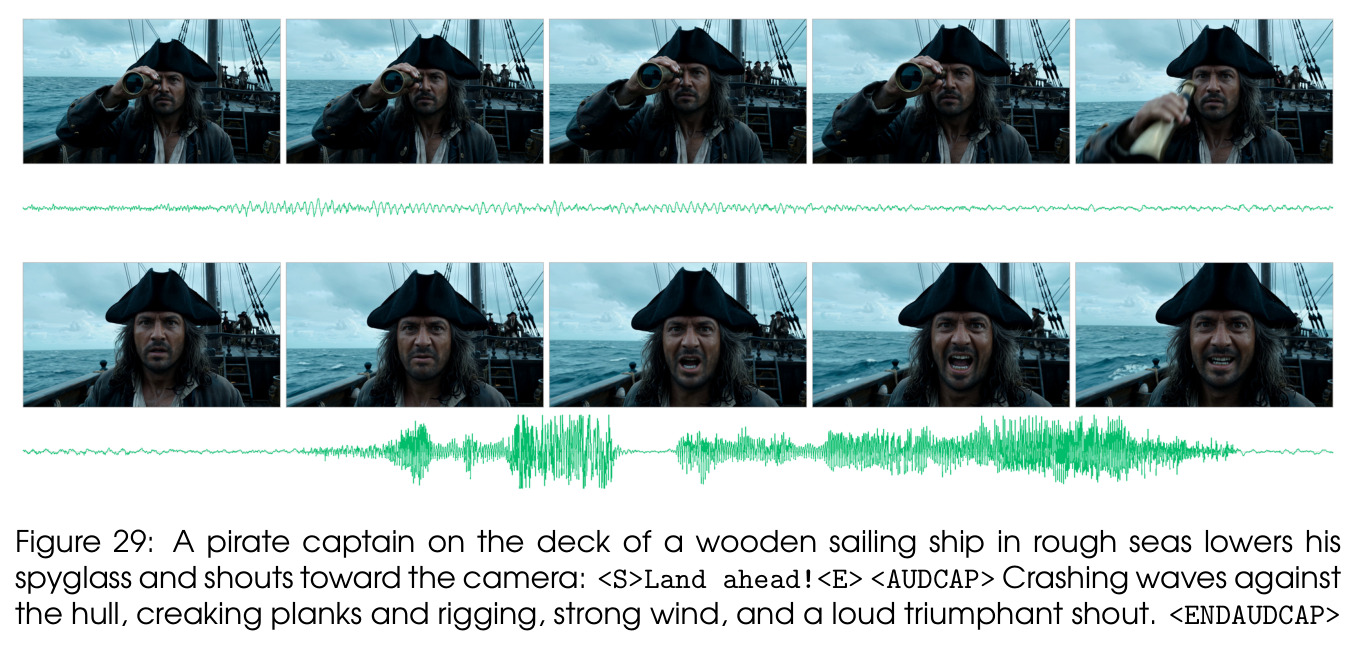
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语音质量(VABench speech_qn) | 归一化分,越高越好 | 1.496(Pro) | LTX 2.5:1.427;Lite:1.477 | 较 LTX 2.5 高约 4.8% |
| 唇同步(VABench lipsync) | 分值,越高越好 | 2.072(Pro) | LTX 2.5:1.567;Lite:1.761 | 较 LTX 2.5 高约 32.2% |
| 音画去同步(VABench desync) | 错误率,越低越好 | 0.396(Pro) | LTX 2.5:0.521;Lite:0.474 | 较 LTX 2.5 低约 24% |
| 视觉真实感(VABench visual_realism) | 分值,越高越好 | 4.485(Pro) | LTX 2.5:4.366;Lite:4.459 | 较 LTX 2.5 高约 2.7% |
| 词错率(语音子集,Qwen3-ASR-1.7B + jiwer) | WER,越低越好 | 0.117(Pro);0.103(Lite) | LTX 2.5:0.099 | 落后约 18%(劣势项,作者如实报告) |
| RL 后训练语音可懂度(64 提示×3 种子) | WER(Whisper-large-v3) | 0.124(Pro RL) | SFT 检查点:0.235 | 相对降低 47%(配对 Wilcoxon,p<10^-3) |
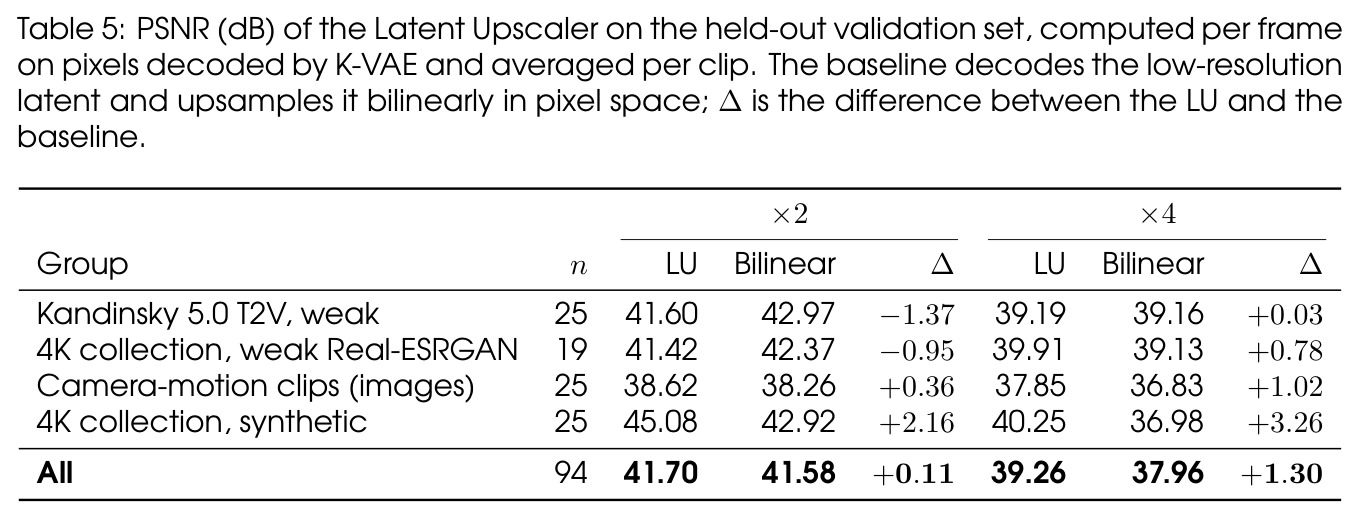
| Latent Upscaler 超分保真(退化到退化,94 片段) | PSNR (dB) | ×4:39.26 | 像素空间双线性上采样:37.96 | +1.30 dB,且四组数据全部为正增益 |
| 蒸馏 vs 全模型(I2AV 人评) | 平均偏好率 | 蒸馏模型 51% | 全模型 49% | 无统计显著差异(0.95/0.975 水平),推理成本大幅降低 |
局限与改进
作者承认的局限:片段最长仅 5 秒;基础生成为 SD 分辨率,Full-HD 依赖超分而非原生生成;与最强闭源系统在视觉质量和整体音频质量上仍有差距。我补充观察:其一,词错率 0.117 劣于 LTX 2.5 的 0.099,且 Whisper-ASR 既是奖励模型又参与评估,存在 reward hacking 风险(Harvard 句子上的独立验证部分缓解);其二,RL 全程在 512×768 做 rollout,而产品推理以 Full-HD 为主,训练-推理分辨率不匹配可能让 RL 增益打折;其三,I2AV 的 Token Role Embedding 消融显示作用微弱,参考帧条件化主要靠掩码与 RoPE,机制理解不完整;其四,SR 的 warp error 随训练阶段上升(×4 从 0.614 升至 0.678),时间一致性可能受损,且 ×2 LU 在两个弱退化视频组上 PSNR 反而低于像素双线性基线;其五,人评每准则约 200 次对比、单一会话、多数票聚合,统计功效有限,VABench 只对比了自家模型与 LTX 2.5。
独立分析的弱点
独立分析的弱点:第一,5 秒时长是硬限制,无法承载完整叙事,改进方向是时间维度外推训练,或自回归片段拼接并施加音频连续性约束。第二,音频能力不对称:语音强但环境音与整体音频质量弱于 Kling 2.6 和 Veo 3.1 Fast,可提高音频真实性奖励权重,或扩大音频流容量(5B 相对 19B 视频流明显偏小)。第三,RL 数据全为纯 T2AV,I2AV 模式未被 RL 直接优化,图像条件下的同步增益可能落后。第四,流程是 RL 之后再蒸馏,轨迹压缩可能部分抵消 RL 增益,「先蒸馏后在学生上做 RL」值得尝试。第五,×2.25 超分路线需先在像素空间 ×1.125 预放大再走 ×2 潜空间路线,工程上不够优雅;LU ×2 在弱退化组的负增益说明上采样器对退化类型敏感,可引入退化感知的路由或混合专家。第六,tiled 超分在 2K 路线需 25–30 个 tile、H100 上 100–131 秒,长视频成本线性放大,tile 间时间一致性仅靠 Hann 窗混合保证,跨 tile 的闪变风险未量化。
未来方向
作者提出的方向:更长的片段、更高的原生分辨率、以及更多基于参考的条件化(related work 提及参考声音克隆的扩展可能)。基于本文成果可以延伸的研究:把「用逐块 KV 消融校准梯度手术调度」推广为多模态 RL 的通用校准工具;将 Sim-LADD 的 on-policy 对抗状态构造应用到其他扩散模型的少步后训练;把「确定性潜空间上采样 + text-free 扩散精修」的二段式超分移植到其他视频生成器;把 RCC 文化代码数据集的方法论复制到其他文化圈,研究文化数据注入对联合训练的定量影响;探索长时长的流式音视频联合生成与事件级同步的自动化评测协议;以及用更大的音频流或专门的音频 RL 阶段补齐环境音保真度短板,并在更高分辨率或混合分辨率上做 RL 以消除训练-推理失配。
复现评估
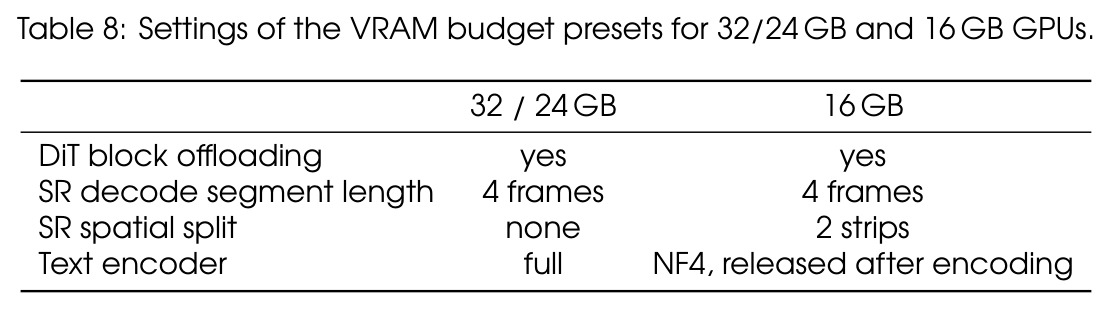
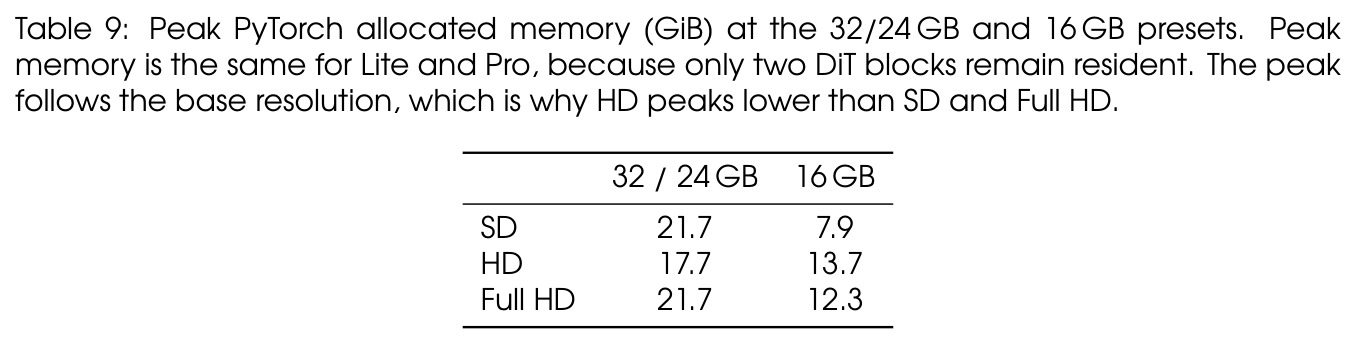
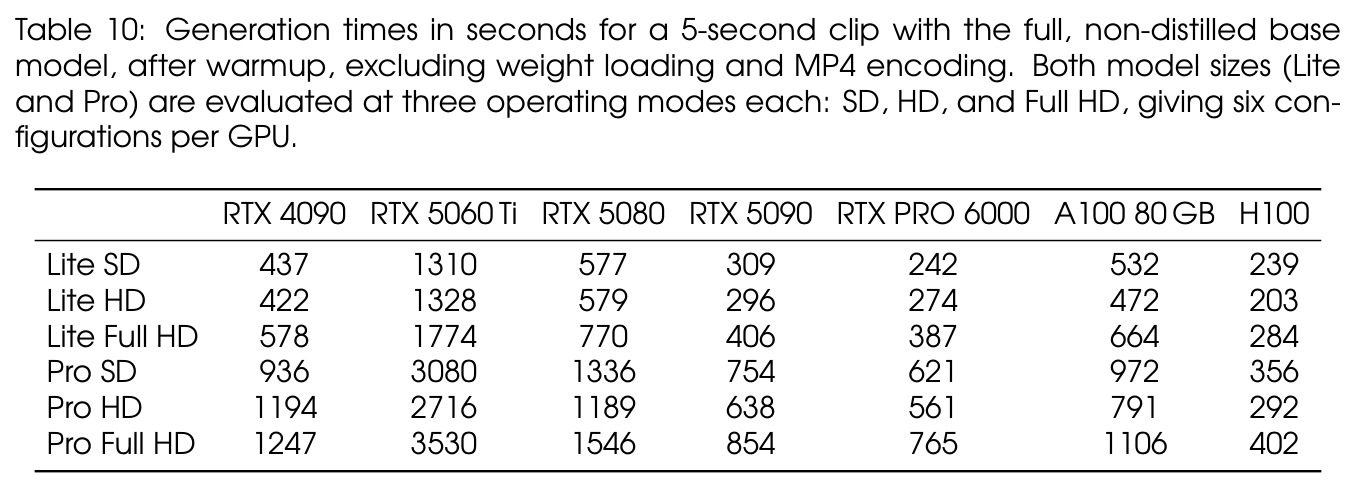
开源情况极佳:代码、Lite/Pro 检查点、diffusers 集成均以 MIT 许可发布(GitHub: kandinskylab/kandinsky-6)。数据集未完整开源,但论文对过滤与标注管线描述异常详细(模型、阈值、采样概率齐全,如 T2AV 的 LSA≥3、Desync<0.1),用公开工具(Qwen3 系列、TransNetV2、DOVER、Q-Align、Meta Audiobox)可近似重建。算力方面:推理门槛很低,16 GB 消费卡即可运行 Pro(进程占 15.1 GiB 显存、约 58 GiB 主机内存),RTX 5090 上 SD 模式生成 5 秒片段需 754 秒;训练门槛高,联合预训练总 GPU 时未完整披露,可参考的数字是 SR-DiT 三阶段仅 8×H100 约 9 天、LU 约 4 天、RL 与蒸馏规模较小。总体:部署复现容易(有 32/24/16 GB 三档预设与 MagCache 加速),自有数据上复现 RL/SFT 属中等难度,从零复现预训练需机构级资源;但作为技术报告,其透明度属最高一档。
论文图表