先对齐再推理:面向配音的多模态口型同步评判器 Align Then Reason: A Multimodal Lip-Sync Judge for Dubbing
用CTC单调对齐显式编码时序,让LLM在结构化证据上推理,免参考评判口型与文本是否匹配。
前置知识
CTC(Connectionist Temporal Classification)
一种无需帧级标注即可训练序列对齐的目标:引入可学习的 blank 空符号后,对所有能折叠(collapse)成目标序列的帧级路径求和并取对数似然 $\mathcal{L}=-\log\sum_{\pi\in\mathcal{B}^{-1}(y)}\prod_t p_{t,\pi_t}$,用前向-后向动态规划高效计算。路径天然自左向右单调,经典应用是语音识别。
本文把 CTC 用在非传统场景:标签不是固定音素/字符词表,而是候选台词内的位置 $1,2,\dots,N$,借其单调性给嘴型-文本对齐打分。这是方法的第一块基石,不理解 CTC 的路径折叠机制就无法理解对齐分数为何对时序扰动敏感。
视觉语音识别(VSR)
仅凭说话人唇部视频恢复所说文本的模型家族,代表包括 Auto-AVSR(CTC 训练的编码器)、AV-HuBERT、LLaMA-AVSR、VSP-LLM(自回归解码 + LLM)。它们优化的是转写似然,而非给任意候选文本打对齐分。
它们是本文最重要的基线(Table 1/2 中用 CTC log-likelihood 或解码条件似然当判分器),同时 Auto-AVSR 又被借用作 ATR 的视觉特征提取器,两个角色都要理解。
视频语言模型(VLM)的时序盲区
VLM(如 Qwen3.5-VL 系列)把采样的视频帧与文本一起送入 LLM。已有研究(Buch et al. 2022;Lei et al. 2023)指出单帧偏差普遍存在:固定文本、只重排帧序时模型性能几乎不掉,因为多模态预训练并不强制时序建模。
这是全文动机的核心证据:作者实测 Qwen3.5 2B–9B(含 SFT)在倒放/平移/冻结/交换等扰动上 AUC 仅 0.50–0.52。必须理解\u201c能看懂内容\u201d不等于\u201c能感知时序\u201d,才能明白为何要显式对齐模块。
Soft tokens(连续前缀注入)
把连续向量放在 LLM 输入 token 序列最前面、当作可微\u201c软提示\u201d的做法,源于 Frozen Language Model 与 prefix-tuning。它们占据 token 位置但不是词表条目,可以把任意结构化信息(检索结果、感知特征)注入语言模型。
ATR 用每个音素单元一个软 token $e^{\text{soft}}_n$ 把局部对齐证据喂给 LLM,是两阶段接口的一半;另一半(校准标量)则走文本 prompt,二者缺一不可。
置信校准(calibration)
让模型输出的置信度与实际正确率一致的技术。本文对原始对齐分数 $s_{\text{align}}$ 用留出集上真实配对的均值 $\mu_s$ 与标准差 $\sigma_s$ 做 z-score 归一后过 sigmoid,得到 $a(V,c)\in(0,1)$ 的稳定标量。
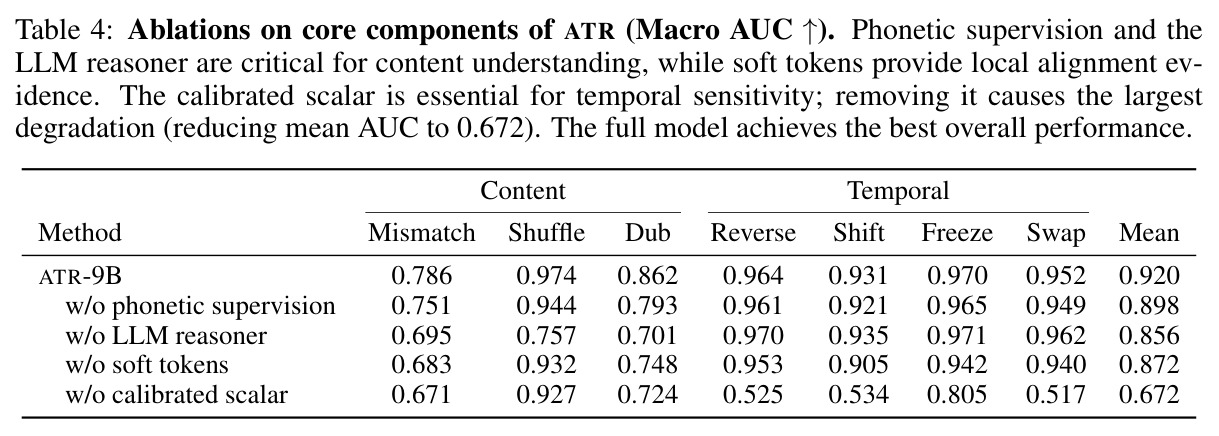
校准标量是消融中最关键的组件(去掉后平均 AUC 从 0.920 崩至 0.672),也是跨域时只需重估两个常数、无需更新任何模型权重即可修复性能(冻结轴 0.572→0.937)的设计关键。
Pooled AUC 与配对准确率
AUC 衡量模型把正样本(真实配对)排在负样本(破坏配对)之前的整体排序能力,0.5 等于随机,1 为完美;配对准确率进一步检查每一条真实配对是否得分高于它对应的破坏版本,是逐对更严格的口径。
本文设定没有参考答案,全部主表(Table 1–4)都用 pooled AUC 与 paired accuracy 报告,先掌握这两个免参考评估指标才能正确解读所有实验数字。
LoRA 低秩适配
参数高效微调方法:冻结预训练权重,为注意力和投影层注入可训练的低秩分解矩阵 $BA$(秩 $r$,缩放系数 $\alpha/r$),训练参数量小、可插拔、易换骨干。
ATR 的 LLM 推理器正是用 LoRA(rank 16, $\alpha=32$)适配 Qwen3.5/LLaMA/Mistral 的,理解它才能评估跨骨干迁移实验的成本与\u201c换什么 LLM 都行\u201d这一声明的含义。
研究动机
自动配音(dubbing)管线先用生成式系统完成翻译与改写,再合成目标语言语音,但一条语义通顺的译配台词仍可能与说话人口型对不上:开始得太早、落后于嘴部运动、或音素内容与可见的发音动作不兼容。人工质检昂贵且无法规模化,因此需要在语音合成之前、仅凭无声视频 $V$ 与候选文本 $c$ 打分的\u201c口型同步评判器\u201d。现有模型并不适配这一设定:视觉语音识别模型(Auto-AVSR、AV-HuBERT、LLaMA-AVSR、VSP-LLM)优化的是转写而非对候选文本打分;音视频同步模型(SyncNet、Synchformer)需要音频流;视频语言模型可以联合条件化但缺乏时序保证。论文实测:把候选文本固定、只将视频帧倒放/循环平移/冻结/对半交换时,Qwen3.5 2B–9B 的零样本与 SFT 版本在四个时序破坏轴上的 AUC 仅有 0.500–0.520,几乎等于随机;SFT 后内容轴能到 0.730–0.743,但时序能力完全没有被多模态预训练或 SFT 注入。识别内容的能力强,不等于具备细粒度时序对应能力,这就是结构性的模型-任务鸿沟。
本文的目标是本文目标是构建一个免参考(reference-free)的多语言口型同步评判器:输入无声视频 $V$ 与候选台词 $c$——评审时配音音频可能尚未合成,也没有参考转写——输出一个标量分数,衡量 $c$ 与可见口型在\u201c内容\u201d与\u201c时序\u201d两个维度上的一致性。评判器必须同时捕捉两类互补的失败模式:内容错误(候选文本与可见发音不兼容,如换行、词序打乱、译文)与时序错误(内容兼容但顺序错乱,如倒放、平移、冻结、对半交换);同时要跨语言泛化(配音可能翻成英/西/法/日/韩/巴西葡/土等语言)、可移植到不同 LLM 骨干,并在真实配音下游任务——候选台词重排与剧本-片段匹配——中展现实用价值,最终成为自动配音质量控制乃至测试时扩展(test-time scaling)流水线中的验证器。
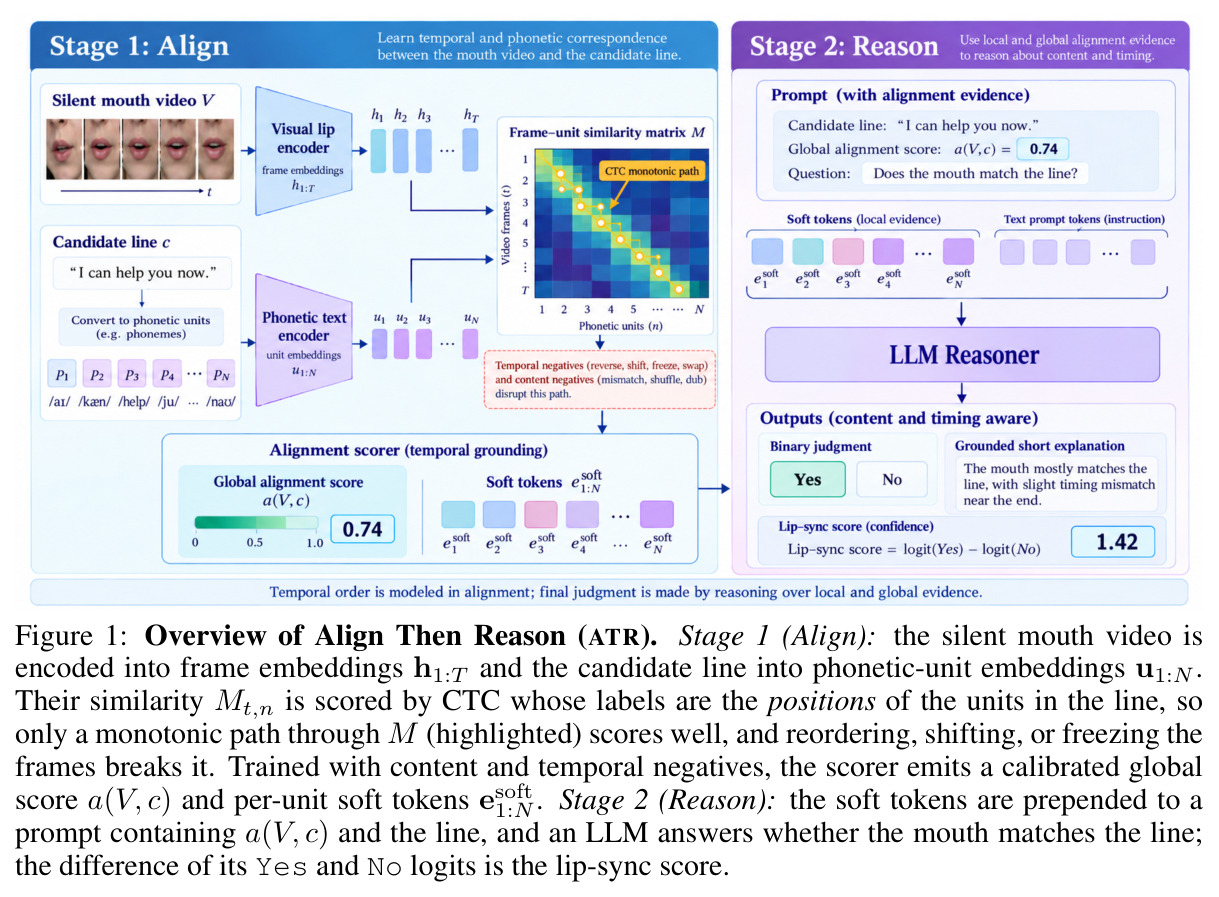
与已有工作不同的是,作者的独特切入是把\u201c时序追踪\u201d与\u201c语义评判\u201d彻底解耦:不指望 LLM 直接从原始视频帧里看出时间顺序,而是先用一个候选条件化的单调对齐打分器把时序结构显式编码成分数,再让 LLM 在这些结构化证据上做高层推理。关键洞察是一个几何观察:若 (视频, 文本) 真正匹配,帧级唇部表征与文本音素单元的相似度矩阵 $M_{t,n}$ 中必然存在一条强的单调路径——内容替换与时间扰动都会破坏这条路径。作者用 CTC 形式化这一直觉,且与传统 CTC 有本质不同:对齐标签不是固定的字符/音素词表,而是当前候选台词中单元的位置 $1,2,\dots,N$,这使同一机制天然跨语言泛化。此外,单一标量必然压缩整句证据,因此作者再引入 LLM 推理器,同时接收逐单元软 token(局部证据)与校准后的全局分数,把校准(calibration)变成两个模块之间的接口协议,而非可有可无的后处理。
核心方法
ATR 分两阶段。直觉:真实配音的嘴部动作与台词音素单元一一对应且顺序一致,把每帧唇部嵌入 $h_{1:T}$ 与每个音素单元嵌入 $u_{1:N}$ 的余弦相似度排成矩阵 $M_{t,n}$,正确配对应支持一条自左向右的单调路径,换词、倒放、平移都会破坏它。技术路线:阶段一“对齐”,用 Auto-AVSR 提帧级特征并适配为 256 维唇嵌入,用 XPhoneBERT 把文本转为音素单元嵌入;加入可学习 blank 后,以“标签=候选行内位置”的 CTC 计算长度归一化对数似然 $s_{\text{align}}(V,c)=\frac{1}{N}\log\sum_{\pi\in\mathcal{B}^{-1}(y_c)}\prod_{t}p_{t,\pi_t}$ 作为全局分数,并用 3 类内容负样本与 4 类时序负样本做平滑间隔对比训练、辅以音素 CTC 监督。阶段二“推理”,把逐单元软 token 作为连续前缀、连同写入 prompt 的校准分数 $a(V,c)$ 送入 LoRA 微调的 LLM,输出 Yes/No 与简短解释,最终分数为答案 token 的 logit 之差 $s_{\text{judge}}=\ell_Y-\ell_N$。时序接地由对齐器保证,内容判别与可解释性由 LLM 补足。
核心创新是“候选条件化 CTC”:传统 CTC 的标签是固定音素/字符词表,用于从语音恢复转写;这里标签 $n$ 就是候选台词的第 $n$ 个音素单元,目标序列恒为 $y_c=(1,2,\dots,N)$。打分器回答的因此不是“嘴在说什么”,而是“嘴的动作是否按顺序逐一支撑了这条台词的每个音”——时序性被直接写进评分结构,而非寄希望于 LLM 隐式学习。第二个关键是把证据拆成互补两路:逐单元软 token $e^{\text{soft}}_n$ 保留局部“哪个音对应哪段嘴型、最好匹配多强”的信息;校准标量 $a(V,c)=\text{sigmoid}\big((s_{\text{align}}-\mu_s)/\sigma_s\big)$ 给出整行单调拟合的全局度量。消融证明去掉校准标量后平均 AUC 从 0.920 崩到 0.672、时序轴近乎随机,说明时序敏感性的真正来源是单调路径分数而非软 token 或 LLM 本身。跨语言能力来自音素化表示(XPhoneBERT),与语言专属词表解耦,配音译文还可直接充当天然内容负样本。
方法步骤详情
第一步编码:Auto-AVSR 每帧输出 768 维特征,经 LayerNorm+投影到 512 维、两层 8 头时序 Transformer 再映射为 256 维唇嵌入 $\ell_t$;文本转音素单元后经 XPhoneBERT 投影到同一空间得 $u_{1:N}$。第二步打分:计算 $M_{t,n}$,加可学习 blank 后 softmax 得发射概率 $p_{t,k}$,按长度归一化 CTC 对数似然求 $s_{\text{align}}$。第三步对比训练:正样本对 $(V,c^+)$ 与 7 种负样本(换行/打乱/译文/倒放/平移/冻结/对半交换)以平滑间隔损失 $h(\Delta)=\log(1+\exp(1-\Delta))$、$\Delta=s^+-s^-_x$ 训练两编码器,另接音素词表 CTC 辅助损失 $\mathcal{L}_{\text{aux}}$。第四步构造证据:对每单元算注意力 $\alpha_{t,n}$、视觉摘要 $\bar{h}_n=\sum_t\alpha_{t,n}h_t$、最强匹配 $\rho_n=\max_t M_{t,n}$,拼接 $x_n=[u_n|\bar{h}_n|\rho_n]$ 经投影+LayerNorm 得软 token;全局分数用留出集的 $\mu_s,\sigma_s$ 校准后写入 prompt。第五步训练推理器:正样本标 Yes、$K$ 个内容负样本标 No,解释指出最弱单元位置(早/中/晚,$\arg\min_n\rho_n$),交叉熵训练 LoRA(rank 16, $\alpha=32$;AdamW,lr $3\times10^{-4}$,batch 32)。第六步推理:分数 $s_{\text{judge}}=\log\frac{P(\text{Yes}|V,c)}{P(\text{No}|V,c)}$。
技术新颖性
新颖性体现在四个层面。其一,任务形式化:首次系统定义并测量\u201c免参考的文本-视频口型同步评判\u201d,用文本固定的倒放/平移/冻结实验揭示自回归 VSR 与 VLM 的结构性时序盲区(Qwen3.5-9B SFT 时序 AUC 仅 0.510–0.520,前沿模型配对准确率也仅 0.656–0.737)。其二,候选条件化 CTC:把对齐标签从固定词表换成候选行内位置,使单调性约束成为可微的似然打分而非启发式动态规划——与其说像语音识别,不如说像把 visual forced alignment 改造成判别器,且无需帧级对齐标签。其三,证据接口设计:软 token(连续前缀注入)与校准标量(prompt 中的两位小数)把校准理论(Guo et al., 2017 式置信校准)变成两个模块间的协议,跨域只需在 300 条目标语言样本上重估两个标量、零参数更新即可把冻结轴 AUC 从 0.572 修复到 0.937。其四,负样本工程:内容/时序两类互补负样本系统性对应两类失败模式,并把配音译文 dub 作为天然内容负样本,训练信号与评测协议严格同构。
实验结果
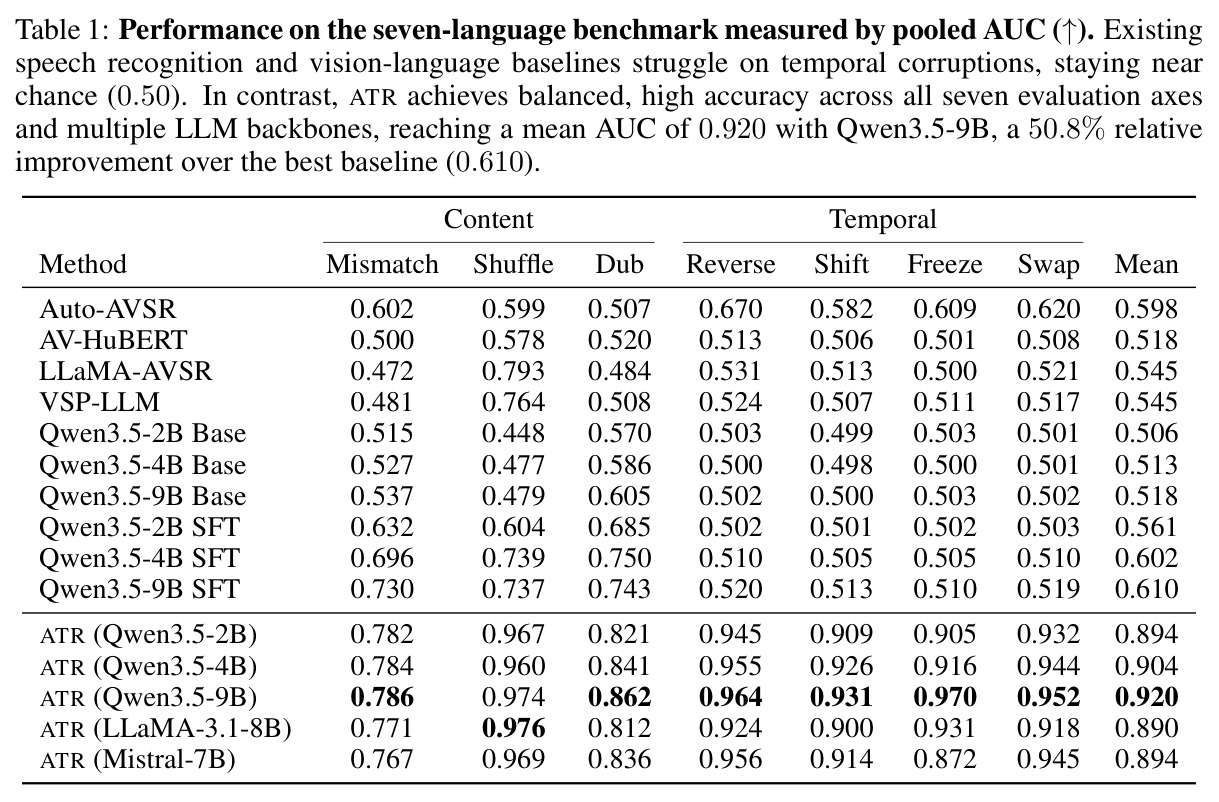
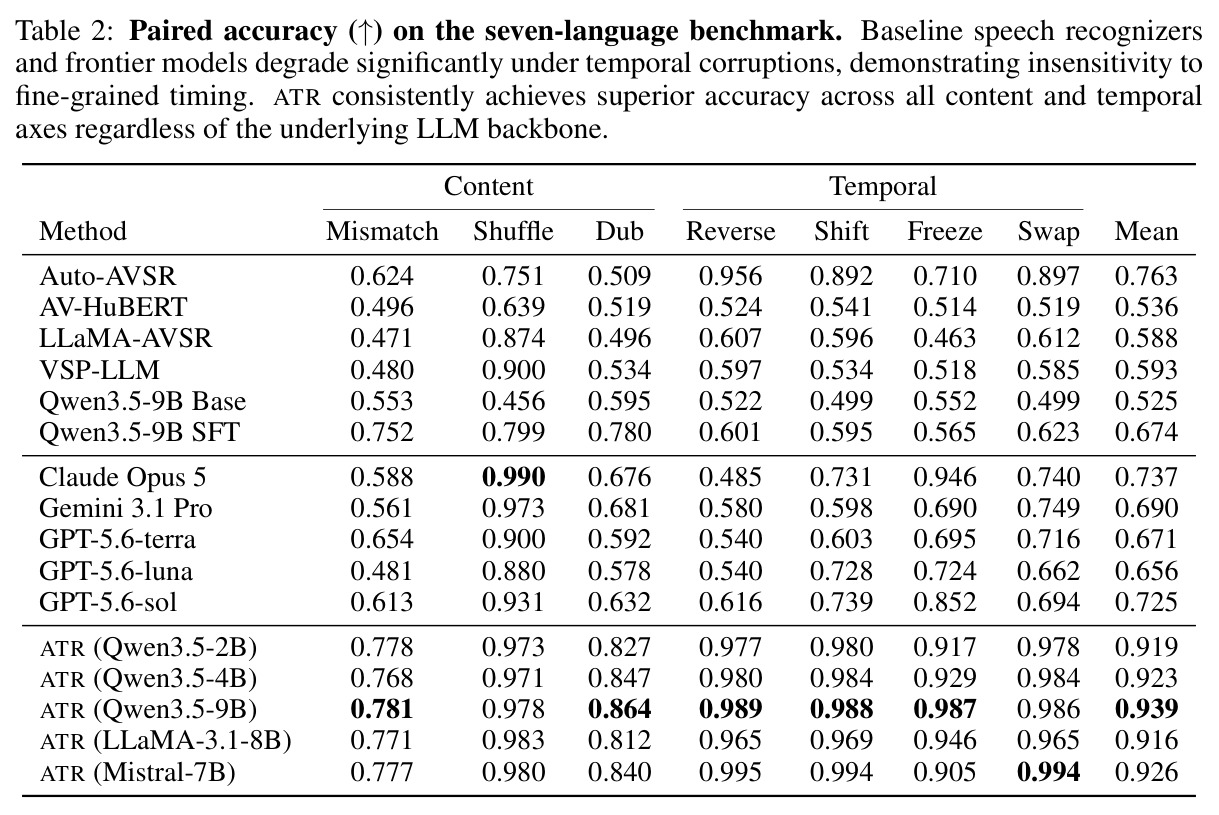
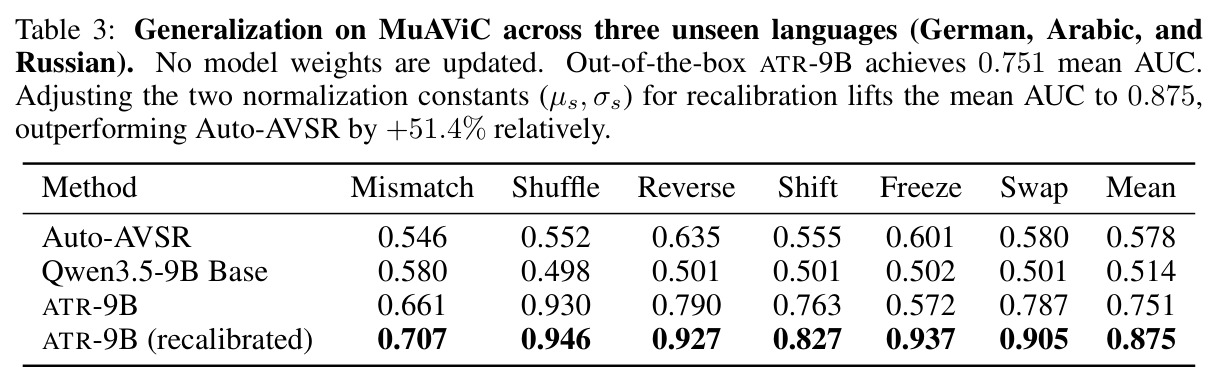
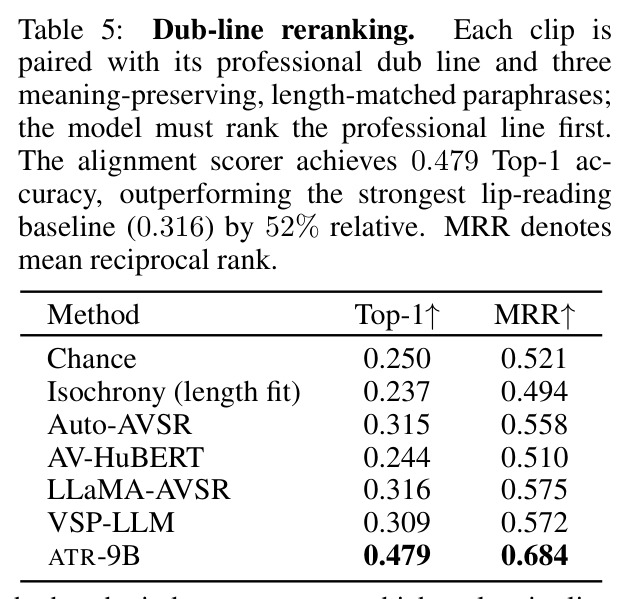
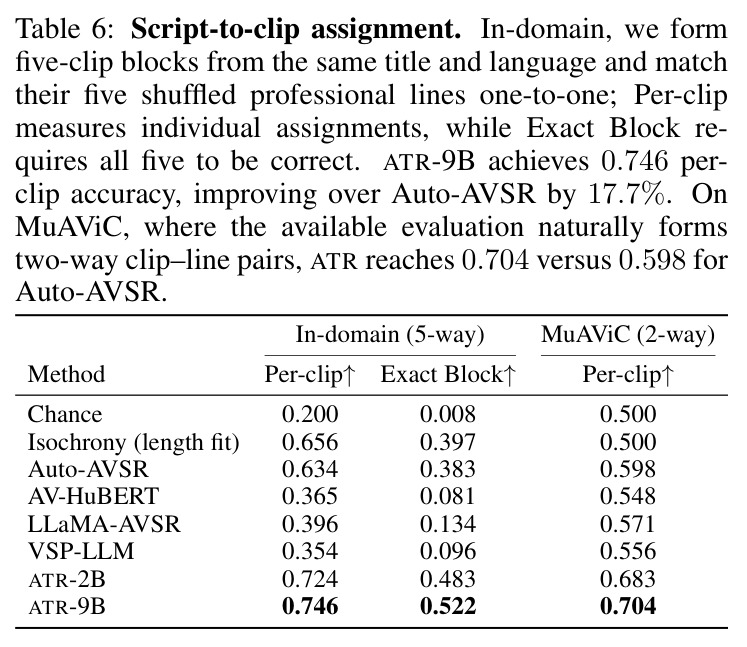
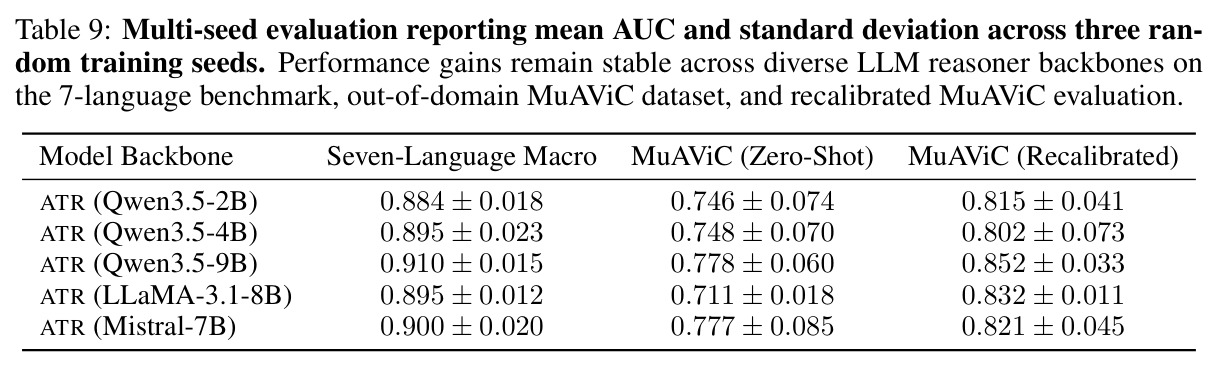
七语言基准(2100 条测试):ATR(Qwen3.5-9B) 平均 pooled AUC 0.920,较最强基线 Qwen3.5-9B SFT 的 0.610 相对提升 50.8%(+0.310);2B/4B 达 0.894/0.904(+59.4%/+50.2%)。关键在时序轴:SFT 基线仅 0.510–0.520,ATR-9B 达 reverse 0.964、shift 0.931、freeze 0.970、swap 0.952。跨骨干:LLaMA-3.1-8B 0.890、Mistral-7B 0.894(+45.9%/+46.6%)。配对准确率 ATR 全变体 ≥0.916(9B 0.939),前沿模型 Claude Opus 5、Gemini 3.1 Pro、GPT-5.6 虽 shuffle 最高 0.990,时序仅 0.656–0.737。MuAViC 德/阿/俄零样本 0.751,仅重估 $\mu_s,\sigma_s$(300 条、零参数更新)升至 0.875(较 Qwen Base +70.2%、较 Auto-AVSR +51.4%)。消融(9B):去音素辅助监督→0.898、去 LLM 推理器→0.856、去软 token→0.872、去校准标量→0.672(时序近随机)。下游:台词重排 Top-1 0.479 vs 最强唇读基线 0.316(+52.0%);剧本-片段匹配 per-clip 0.746、Exact Block 0.522(+17.7%/+0.139);MuAViC 两路 0.704 vs 0.598。多种子 9B 七语言 0.910±0.015,统计稳定。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七语言口型同步评判(3 内容轴 + 4 时序轴宏平均) | pooled AUC | ATR (Qwen3.5-9B) 0.920(2B 0.894 / 4B 0.904) | Qwen3.5-9B SFT 0.610(最强基线) | 相对提升 50.8%(+0.310 绝对) |
| 时序破坏判别(reverse/shift/freeze/swap) | pooled AUC | 0.905–0.970(9B) | Qwen3.5-9B SFT 0.510–0.520,Auto-AVSR 0.582–0.670 | 从近随机水平提升约 0.35–0.45 绝对 |
| MuAViC 零样本迁移(德/阿/俄,未见语言与数据集) | mean AUC(重校准) | ATR-9B 0.875(零样本 0.751) | Auto-AVSR 0.578,Qwen3.5-9B Base 0.514 | 较 Auto-AVSR +51.4%,较 Qwen Base +70.2% |
| 配音台词重排(2100 段真实配音,4 选 1) | Top-1 准确率 | ATR-9B 0.479(MRR 0.684) | LLaMA-AVSR 0.316(随机 0.250) | 相对提升 52.0% |
| 剧本-片段匹配(域内 5 路一对一指派) | per-clip 准确率 / Exact Block | ATR-9B 0.746 / 0.522 | Auto-AVSR 0.634 / 0.383(随机 0.200/0.008) | per-clip +17.7%,Exact Block +0.139 绝对 |
| 配对准确率(7 语言,含前沿闭源模型对比) | paired accuracy | ATR 全变体 ≥0.916(9B 0.939) | Claude Opus 5 0.737 / Gemini 3.1 Pro 0.690 / GPT-5.6 系列 0.656–0.725 | 高于最强前沿模型约 0.18–0.28 绝对 |
局限与改进
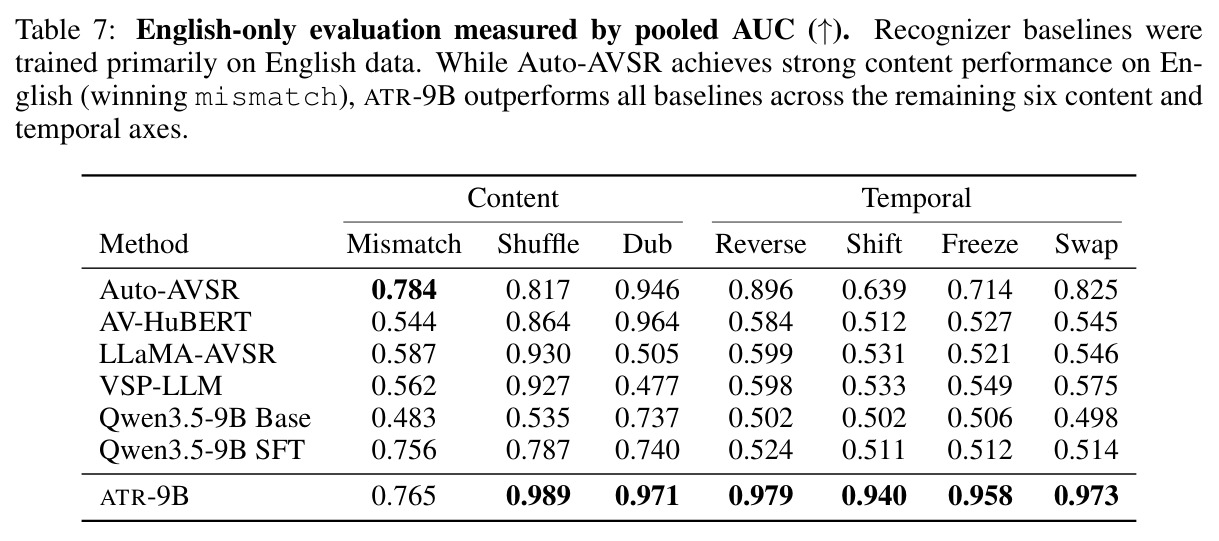
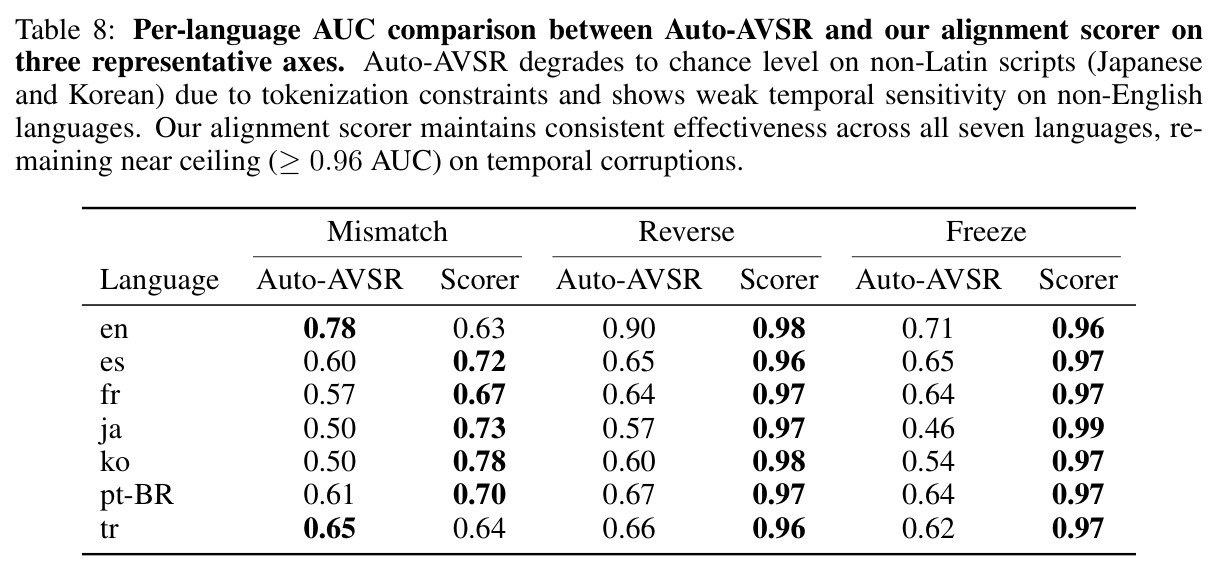
作者承认推理器仅用监督微调(SFT)训练,尚未引入强化学习,把 RL 列为自然下一步;跨域评估需在 300 条目标语言真实样本上重估两个归一化常数,虽无需参数更新,但依赖少量域内标注。我的补充观察:其一,时序负样本全部是合成扰动(倒放/平移/冻结/交换),真实配音错误(音节级替换、口音偏差、自然时长漂移)分布未必相同,近乎天花板的时序 AUC 可能高估实战表现;其二,内容轴仍是短板——mismatch 仅 0.786、dub 0.862,远低于时序轴的 0.93–0.97,且英语上 mismatch 还略输 Auto-AVSR(0.765 vs 0.784,Table 7),说明音素级整句判别有上限;其三,视觉编码器 Auto-AVSR 以英语语料为主,日语/韩语上其基线掉到 0.50(Table 8),唇部表征可能隐含语言偏置;其四,两阶段串行推理(视频编码 + CTC + LLM 解码)的延迟、显存与成本未报告,能否用于实时质检未知;其五,约 5 万条训练样本与 2100 条测试集来自 Netflix 片源与内部配音数据,外部完全无法获取,MuAViC 上 freeze 零样本仅 0.572 也暴露标量校准对域移的敏感性。
独立分析的弱点
第一,合成负样本与真实错误的鸿沟:reverse/shift/freeze/swap 是程序化帧序破坏,模型可能学到“检测帧序异常”而非“检测配音失配”,面对自然时长漂移或音素相近的同义改写会变弱。改进:从生产环境收集真实失败案例做困难负样本,或用生成模型合成自然的时长/韵律扰动。第二,内容判别上限明显:mismatch AUC 仅 0.786,且英语上略输 Auto-AVSR(0.765 vs 0.784);消融中去 LLM 推理器后 mismatch 掉至 0.695,说明内容能力几乎全靠 LLM。改进:构造音素 n-gram 级细粒度负样本、课程化加大对比难度。第三,校准只是两参数点估计:MuAViC freeze 零样本仅 0.572,域移大时 sigmoid 输出仍失真。改进:用 conformal prediction 给分数区间或在线重校准。第四,可解释性粗糙:解释仅定位早/中/晚三段。改进:把 $\rho_n$ 逐单元曲线作为证据让 LLM 引用具体时间戳。第五,效率未评估:每个候选都需跑视频编码与 LLM 前向,重排序场景要对 4–25 个候选打分。改进:蒸馏小型对齐打分器做粗筛,LLM 只复核边界样本。第六,数据封闭阻碍社区公平比较,可发布基于 MuAViC 与公开影视语料的复刻基准。
未来方向
作者明确提出两个方向:其一,用强化学习替代或叠加 SFT 训练推理器——作者引用的 RLVR/过程奖励/多模态 RL 系列工作表明 RL 能进一步增强 LLM 与多模态推理,把 Yes/No 的 logit 差作为可验证奖励做 RLHF 十分自然;其二,把 ATR 用作\u201c无需人工审核的自我改进系统\u201d中的自动评估信号,为 LLM 改写配音台词提供奖励,形成 sample-then-verify 的测试时扩展闭环(论文在重排序实验中已验证验证器角色)。基于本文成果可自然延伸:把对齐打分器接入语音合成闭环做推理时重排序的全自动配音流水线;从音素扩展到韵律、重音、语速等超音段特征的评判;系统化\u201c只重估两个校准常数的零资源新语言扩展\u201d路线并给出何时失效的理论刻画;把软 token 接口推广到其他需要显式时序接地的视频-LLM 任务,如深伪检测中的口型-语音一致性、视听同步定位;以及构建公开的多语言口型同步评测基准,把 corruption 协议标准化为社区基准。
复现评估
复现难度中偏高。有利条件:所有组件均开源可得——Auto-AVSR(视觉编码器)、XPhoneBERT(音素文本编码器)、Qwen3.5/LLaMA-3.1-8B/Mistral-7B 骨干、LoRA(rank 16, $\alpha=32$);7 种负样本构造除 dub 外都是确定性程序操作;附录 A 完整披露架构与超参(AdamW、lr $3\times10^{-4}$、weight decay 0.01、batch 32、两层 8 头 Transformer),附录 B 给出 prompt 模板,附录 D 提供三随机种子方差(9B 七语言 0.910±0.015)。主要障碍:约 5 万条多语言训练样本、2100 条七语言测试集、两个下游任务的真实专业配音台词均来自 Netflix 片源与内部数据,论文未宣布开源代码或数据。MuAViC 可公开获取,因此表 3 的零样本/重校准实验与表 6 右列两路匹配可以部分复现。算力上 2B–9B 骨干的 LoRA 微调约为单卡到少量 A100 量级,主要开销在视频特征预提取与对比训练。总体:方法可复现、核心数据不可得,忠实复现主表需以 MuAViC 加公开影视语料自建配音数据集并重建训练管线。
论文图表