LLM 推理能耗的 SIMPLE 定律 The SIMPLE Law for Energy Cost of LLM Inference
4系数闭式定律预测LLM推理每token能耗,误差较SOTA低3.1–3.5倍,无需逐模型校准
前置知识
KV-Cache(键值缓存)
Transformer 自回归解码时,每生成一个新 token 都要对全部历史 token 计算注意力。为避免重复计算,推理引擎把每层的 Key、Value 投影缓存下来,即 KV-Cache。它随上下文线性增长,每步解码都要把整个缓存从显存读一遍,使注意力 kernel 呈访存受限(memory-bound)特征,成为长上下文推理能耗的主要来源。
SIMPLE 定律中的 KV-cache 项正是对这笔访存成本的解析刻画,是理解 decode 能耗随上下文线性累积的关键。
MHA 与 GQA(多头/分组查询注意力)
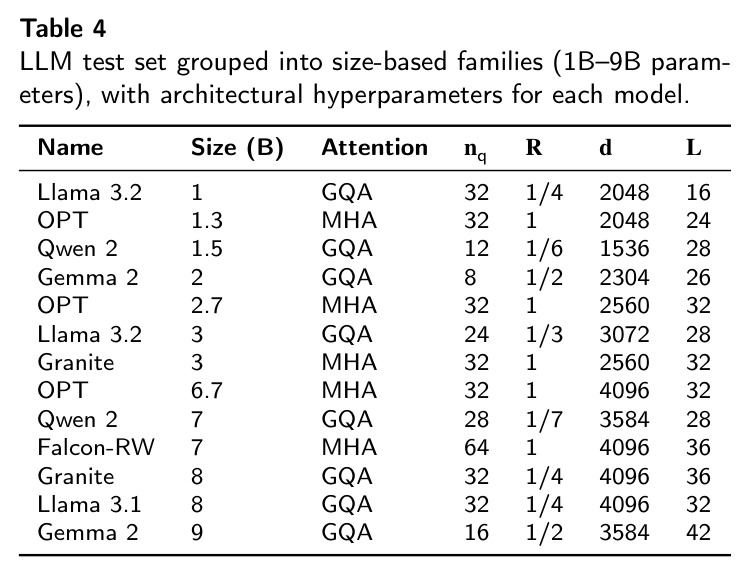
MHA 中每个查询头都有独立的 Key、Value 头,KV 头数等于查询头数($n_{kv}=n_q$)。GQA 让一组查询头共享一套 KV 投影($n_{kv}<n_q$),大幅缩小 KV-Cache 与访存量。本文用 KV 头与查询头之比 $R=n_{kv}/n_q$ 统一刻画:MHA 时 $R=1$,GQA 分组越激进 $R$ 越小(如 Qwen2-1.5B 为 1/7)。
$R$ 是 SIMPLE 定律中唯一携带注意力结构的参数,直接决定 KV-cache 项能耗大小。
Prefill 与 Decode 两阶段推理
LLM 推理分两阶段:prefill 把整个输入序列并行处理、初始化 KV-Cache,计算量以输入长度二次方的 attention 项为主;decode 逐个自回归生成输出 token,得益于缓存复用,每步成本只随上下文线性增长。长输出时 decode 通常占据大部分时间与能耗。
SIMPLE 的核心结构就是把总能耗显式拆成 prefill 与 decode 两项,这是全文推导的主线。
FLOPs 与 MemOPs(计算量与访存量)
FLOPs 是浮点运算次数:矩阵乘 $\mathbf{A}\in\mathbb{R}^{m\times k}$ 乘 $\mathbf{B}\in\mathbb{R}^{k\times n}$ 计 $F=2mnk$。MemOPs 是内存读写操作数,按『读 A、读 B、写结果』计 $M=mk+kn+mn$。GPU 能耗既来自计算也来自数据搬运,roofline 视角认为二者在不同瓶颈下轮流主导性能。
SIMPLE 由 FLOPs/MemOPs 复杂度逐 kernel 推导而来,理解这两个量才能看懂各项系数的物理含义。
Intelligence per Joule(IPJ,每焦耳智能)
IPJ = 任务准确率 / 每请求能耗(单位 %/J),把输出质量与能源开销放进同一个度量,用来评估『花这么多电换来了多少能力』。与 tokens-per-joule 等只算吞吐的指标不同,IPJ 能回答『多花推理预算买准确率是否划算』这一经济学问题。
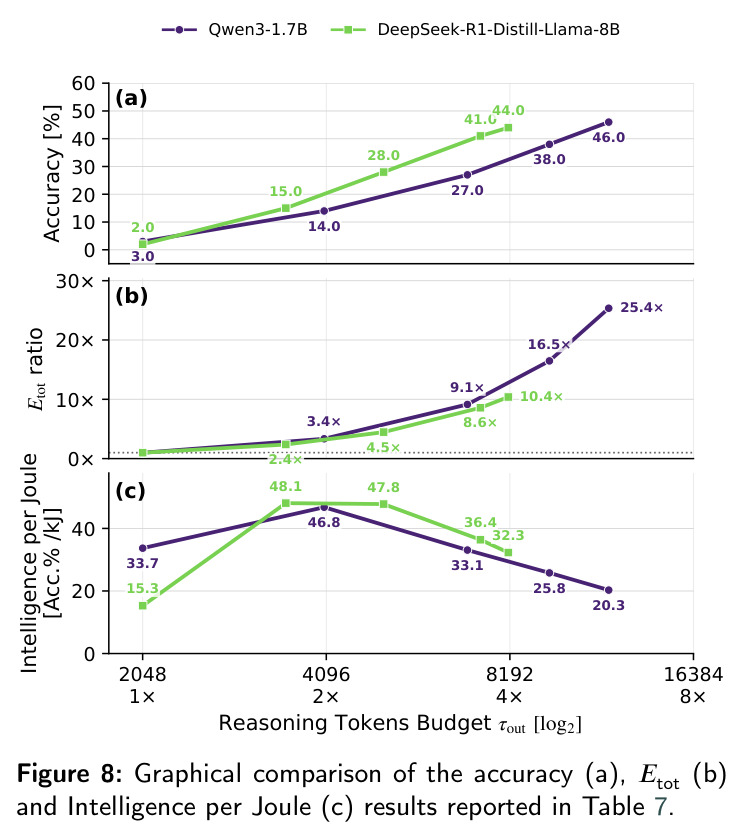
论文用 IPJ 分析推理 token 预算的回报递减现象,并解析导出 IPJ 峰值对应的中间预算。
研究动机
LLM 推理而非训练占据了模型生命周期中高达 90% 的能耗,而 token 作为计价单位,成本极不均匀:每个新 token 都会进入 KV-Cache,抬高后续所有 token 的成本,使能耗沿序列非线性增长。已有能耗模型分三类:纯经验拟合(线性、双线性、幂律)既非解析推导也需逐 LLM 拟合;最准的解析模型 SweetSpot 把 MAPE 从 30% 以上压到 2% 以下,但系数在单一 LLM 上辨识,层数 $L$、隐藏维度 $d$、注意力组织从未作为变量出现——本质是『拟合』而非『定律』,无法外推到没测过的架构;LLM-agnostic 替代品(Vartziotis et al.)误差约 20% 且表达式冗长;唯一注意力感知的 Niu et al. 只覆盖 decode 且需运行时测量。同时,agentic 工作流把中位 prompt 从 750–1050 推到 68K tokens,恰好落进 KV-Cache 主导的区间;按 token 计价甚至出现『标价更便宜的模型总成本高 28 倍』的价格倒挂。没有一条用架构超参数表达的能耗定律,效率只能被事后观测,无法被推导。
本文的目标是本文要建立一个『定律级』的 LLM 推理能耗模型:以架构自身的超参数——隐藏维度 $d$、层数 $L$、查询头数 $n_q$、KV 头数 $n_{kv}$(或其比值 $R=n_{kv}/n_q$)——作为显式自变量给出闭式表达,区分 prefill 与 decode 两阶段,并把 decode 进一步拆成 KV-Cache 访存成本与 next-token 计算成本。可量化目标包括:在 6 个家族 13 个 dense LLM(1B–9B:OPT、LLaMA、Gemma、Falcon、Qwen2、Granite)的 H100 + TensorRT-LLM 负载数据上,跨架构一次性拟合即达到接近逐模型拟合的精度($R^2>0.94$、MAPE 约 12%,误差比 SOTA 低 3 倍以上);用该定律解析导出每 token 能耗最小点(sweet spot)对应的输出长度闭式解;并定量解释模型规模、注意力机制、推理 token 预算与 agentic 负载对能耗的影响。
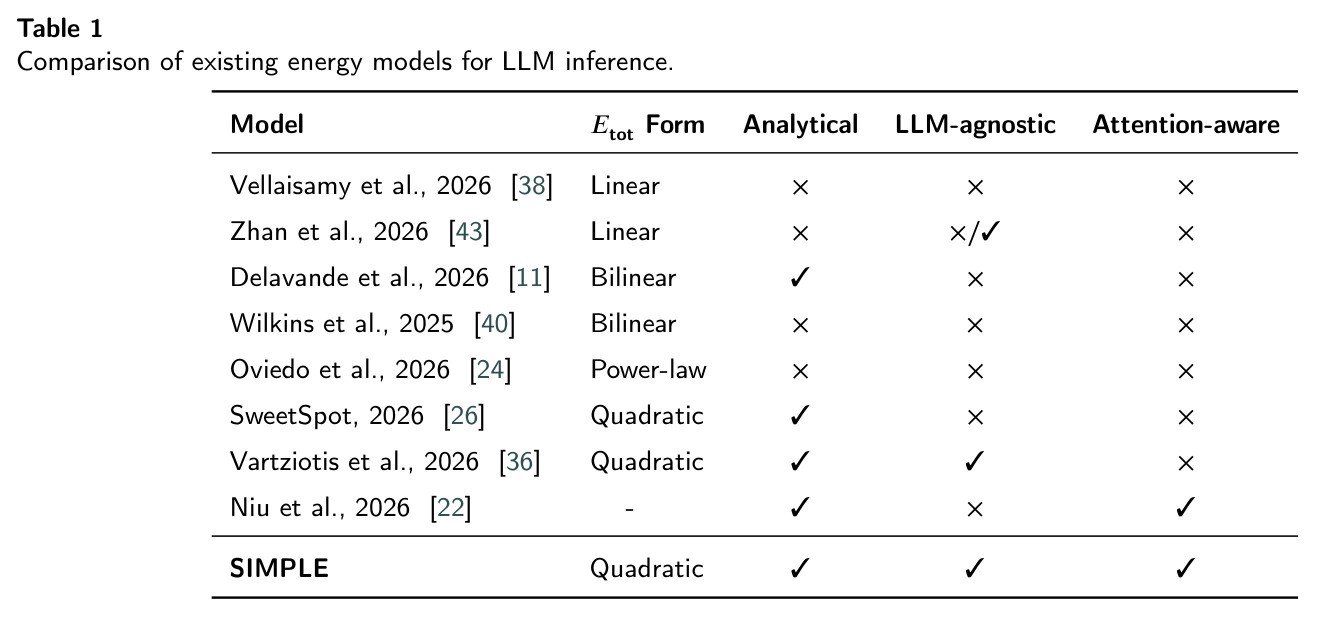
与已有工作不同的是,已有工作在三处留下空隙:实验表征研究只测不建模;经验模型(Vellaisamy、Zhan、Wilkins、Delavande、Oviedo)把架构隐式吸收进系数、逐模型拟合;解析模型中 SweetSpot 精度最高但 LLM-specific,Vartziotis et al. 虽 LLM-agnostic 却用 Kaplan 训练近似($C\approx 6N\tau$)代替推理 kernel 逐项清点,误差约 20% 且展开后超参数表达式冗长,且隐含 MHA 假设;Niu et al. 引入注意力参数却只建 decode、依赖运行时实测输入。本文的独特切入是双管齐下:一方面把 SweetSpot 的复杂度推导扩展到 GQA(引入 KV/查询头比 $R$),另一方面用『项消融 + 舍弃低阶项 + 重新分组』三步把解析表达式压缩成仅 4 个系数的紧凑定律,在保持物理可解释与注意力感知的同时实现跨架构泛化——Table 1 显示 SIMPLE 是首个同时满足解析推导、LLM-agnostic、注意力感知、覆盖完整推理管线四个条件的模型。
核心方法
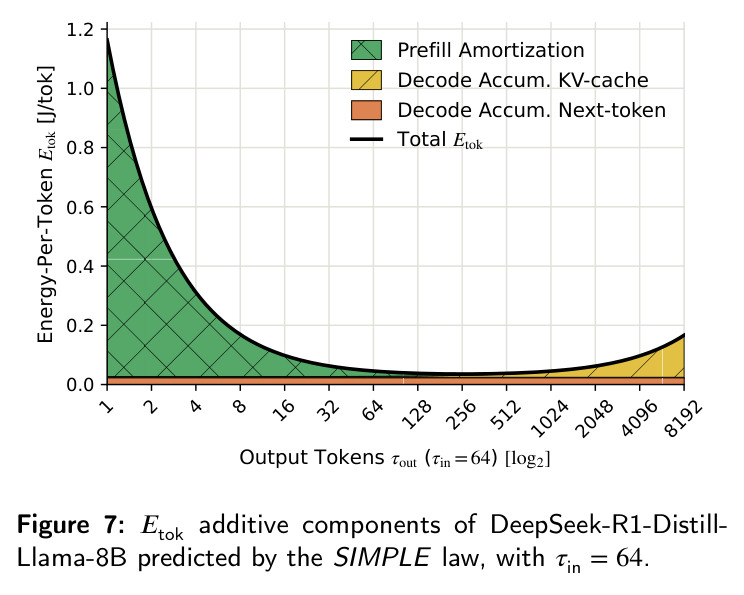
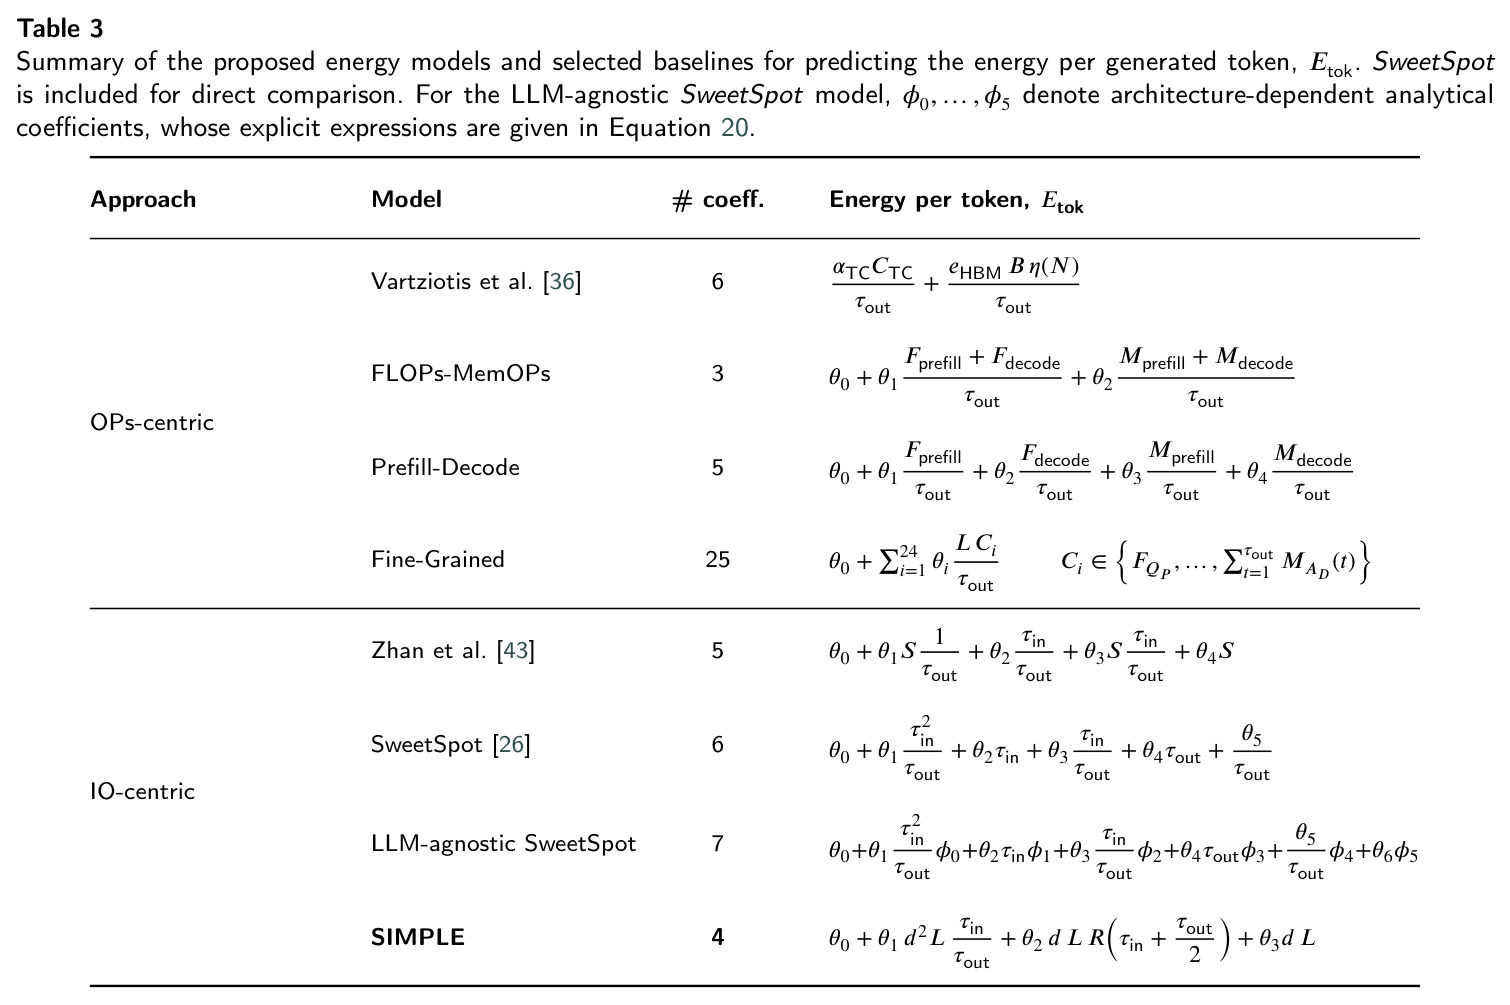
直觉上,一个输出 token 的能耗由三笔账构成:处理 prompt 的固定开销(prefill),要被所有输出 token 分摊,输出越长摊得越薄;每生成一个 token 都要把越来越长的 KV-Cache 从显存读一遍,随上下文线性累积;以及该 token 自身的前向计算(投影 + FFN),近似常数。SIMPLE 就是把这三笔账写成闭式公式。技术路线:首先按矩阵乘 $F=2mnk$、$M=mk+kn+mn$ 对 decoder-only Transformer 的每个 kernel 逐项推导 prefill 与 decode 的 FLOPs/MemOPs,并扩展到 GQA——把 KV 投影写成 $d\times dR$ 矩阵,用 $R=n_{kv}/n_q$ 统一 MHA 与各种 GQA 分组;然后把 24 个复杂度项按对 $(\tau_{in},\tau_{out})$ 的依赖分组(IO-centric),经统计显著性项消融、低阶项舍弃和重新分组压缩出 4 参数模型;最后在 13 个 LLM、49 种输入/输出长度组合(各 1000 请求)的数据上,用加权最小二乘(WLS,$w=1/y^2$,应对异方差)一次性拟合出全部系数。
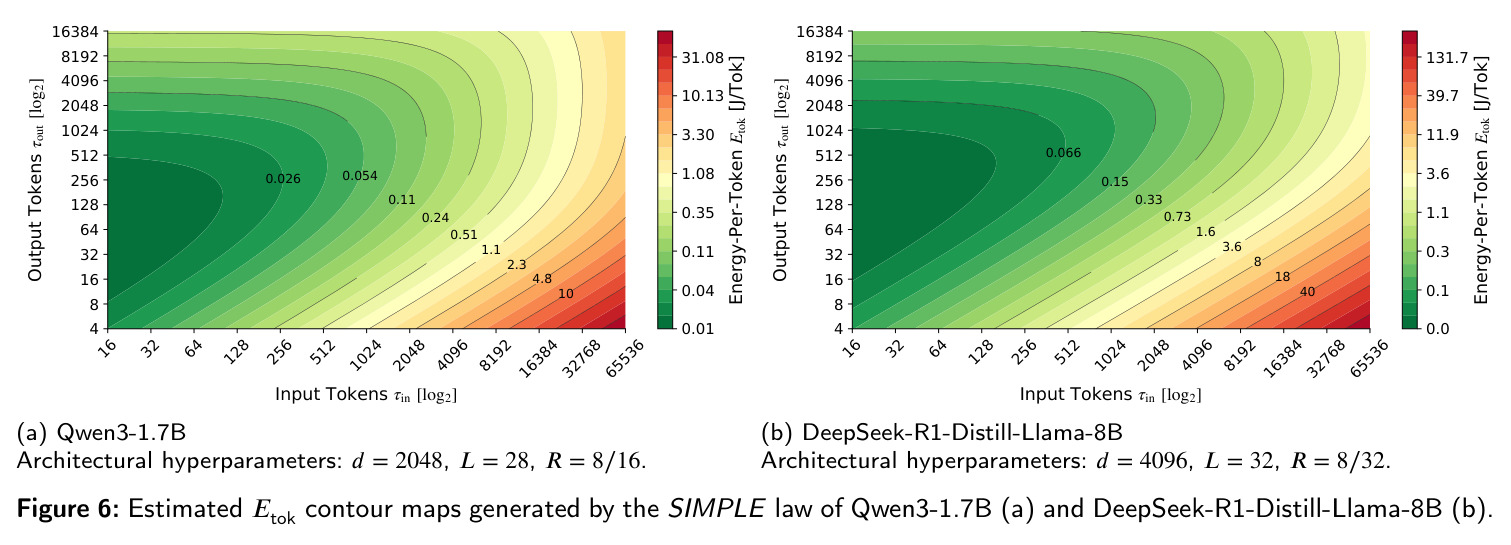
核心创新是把架构从『隐式吸收进系数』变成『显式写进自变量』。SweetSpot 的二次式 $E_{tot}\approx\theta_0+\ldots+\theta_5\tau_{out}^2$ 每个 LLM 单独拟合,问它『$d$ 和 $L$ 谁在驱动能耗』它答不出来,换个模型就要重测。SIMPLE 的形式是 $E_{tot}=\theta_1 d^2L\tau_{in}+\theta_2 dLR(\tau_{in}\tau_{out}+\tau_{out}^2/2)+(\theta_0+\theta_3 dL)\tau_{out}$:prefill 项随 $d$ 二次、随 $L$ 线性增长;KV-cache 项是唯一含 $R$ 的项,显式承载注意力机制的影响;next-token 项仿射于 $dL$。4 个系数跨 13 个架构只拟合一次。这一定律还可解:对 $E_{tok}$ 求导置零得能耗最小输出长度 $\tau^*_{out}=\sqrt{2\theta_1 d\tau_{in}/(\theta_2 R)}=\sqrt{2\theta_1 n_q d\tau_{in}/(\theta_2 n_{kv})}$,即 sweet spot 随 $\sqrt{\tau_{in}d}$ 增长、随 $\sqrt{R}$ 缩短——这是任何逐模型拟合公式都给不出的结构结论。
方法步骤详情
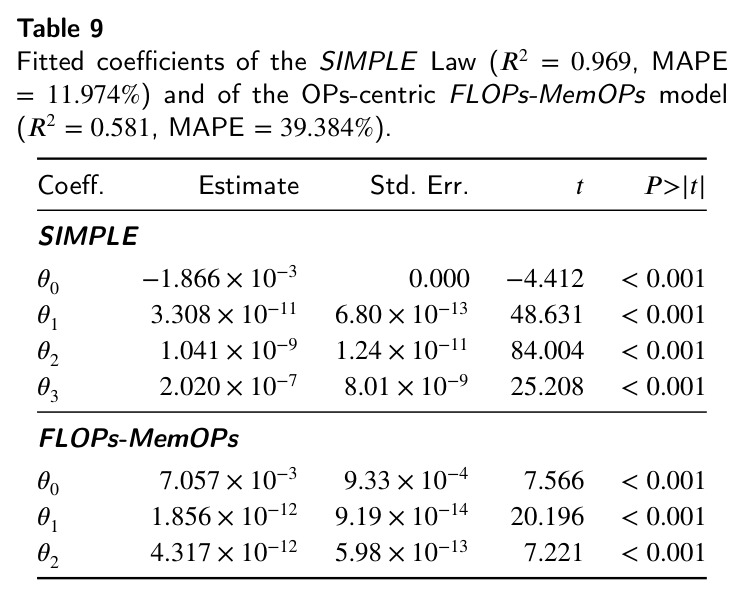
第一步,符号化与假设:dense decoder-only LLM,权重与 KV-Cache 均为 bf16 无量化,固定 batch,FFN 扩展因子取 4 倍,忽略 bias、LayerNorm、softmax 与 dropout 的开销。第二步,prefill 复杂度:逐一推导 Q/K/V/O 投影、注意力得分 $QK^T$、注意力输出 $SV$、FFN 矩阵乘的 FLOPs 与 MemOPs(式 1–8),汇总为 $F_{prefill}=L[4\tau_{in}d^2(5+R)+4\tau_{in}^2d]$ 等闭式。第三步,decode 复杂度:第 $t$ 步 KV-Cache 长 $\tau_{in}+t-1$,对 $\tau_{out}$ 步求和用等差数列闭式(式 9–16)。第四步,构造模型族:OPs-centric 三个(FLOPs-MemOPs 3 系数、Prefill-Decode 5 系数、Fine-Grained 25 系数)作基线;IO-centric 路线上先做 LLM-agnostic SweetSpot(7 系数),再压缩出 SIMPLE(4 系数)。第五步,简化:去除统计不显著的项、丢弃低阶小项、按 prefill/KV-cache/next-token 重新分组。第六步,拟合与验证:WLS($w=1/y^2$)在全量数据上一次性拟合,得 $\theta_0=-1.866\times10^{-3}$、$\theta_1=3.308\times10^{-11}$、$\theta_2=1.041\times10^{-9}$、$\theta_3=2.020\times10^{-7}$(均 $p<0.001$),并以 LOOCV、10 折交叉验证、全量拟合三协议评估。
技术新颖性
按 Table 1 的三个判据(解析性、LLM-agnostic、注意力感知)盘点,SIMPLE 是首个四条件齐备的模型。与 SweetSpot 的区别:后者系数按 LLM 辨识、隐含 MHA 假设(把所有 Q/K/V 投影当作同一维度 $d$);SIMPLE 通过 $R=n_{kv}/n_q$ 把 KV 投影写成 $d\times dR$,使 GQA 的 KV-Cache 节省首次进入总能耗定律,且 4 个系数全网通用。与 Vartziotis et al. 的区别:后者 FLOP 计数依赖 Kaplan 训练近似 $C\approx 6N\tau$ 而非推理 kernel 逐项清点,展开后表达式冗长、误差约 20%;SIMPLE 用 kernel 级推导加统计简化,MAPE 降到约 12% 且每项可解释。与 Niu et al. 的区别:后者只建单步 decode 能耗且需运行时实测输入;SIMPLE 覆盖 prefill+decode 全管线、输入只需架构超参数与序列长度。物理合理性还可交叉验证:OPs-centric 模型拟合出每 FLOP 能耗 $1.86\times10^{-12}$ J、每 MemOP $4.317\times10^{-12}$ J,与 NVIDIA Tensor Core/HBM 的皮焦级实测量级一致。
实验结果
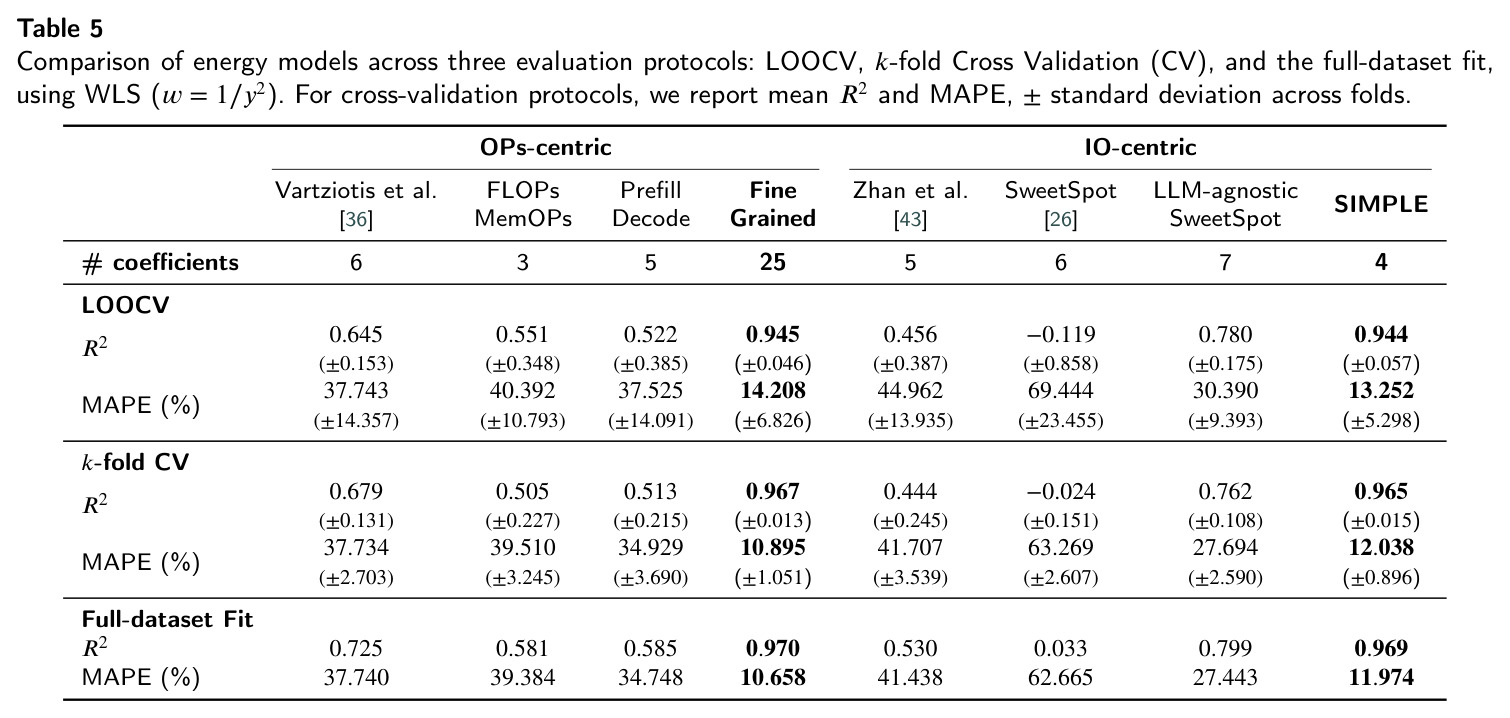
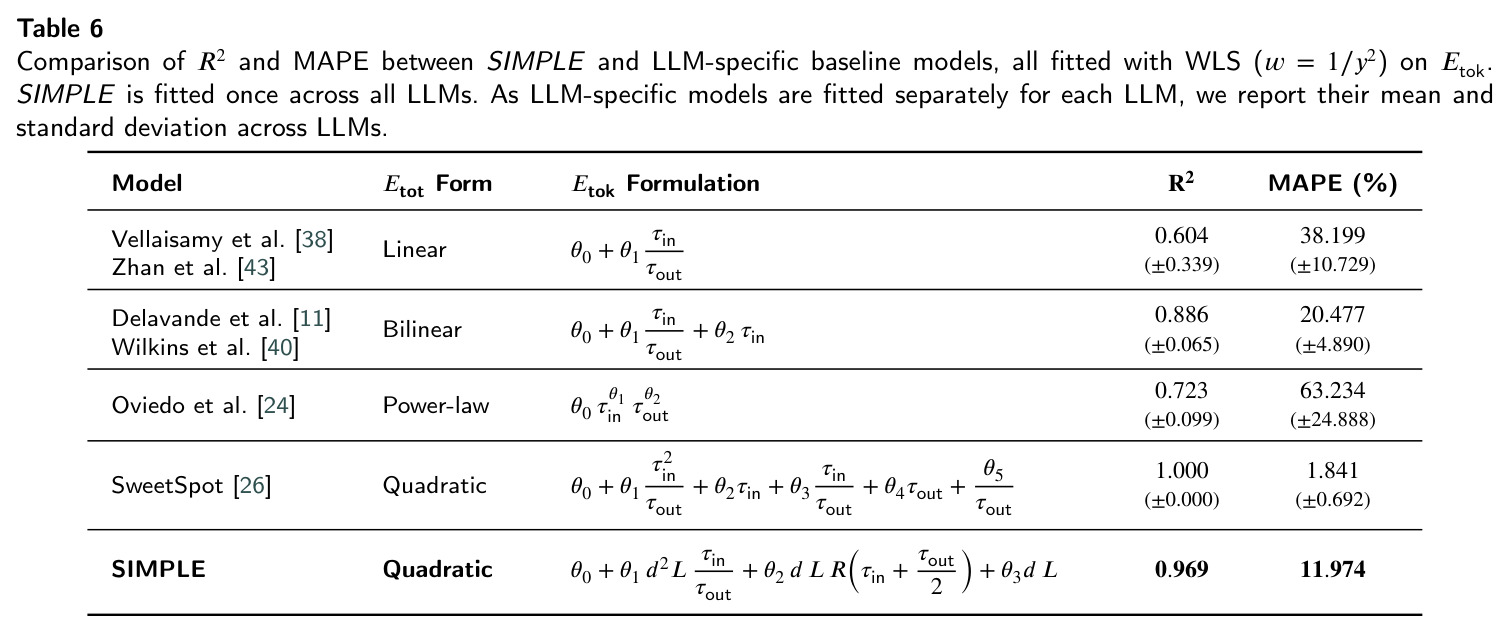
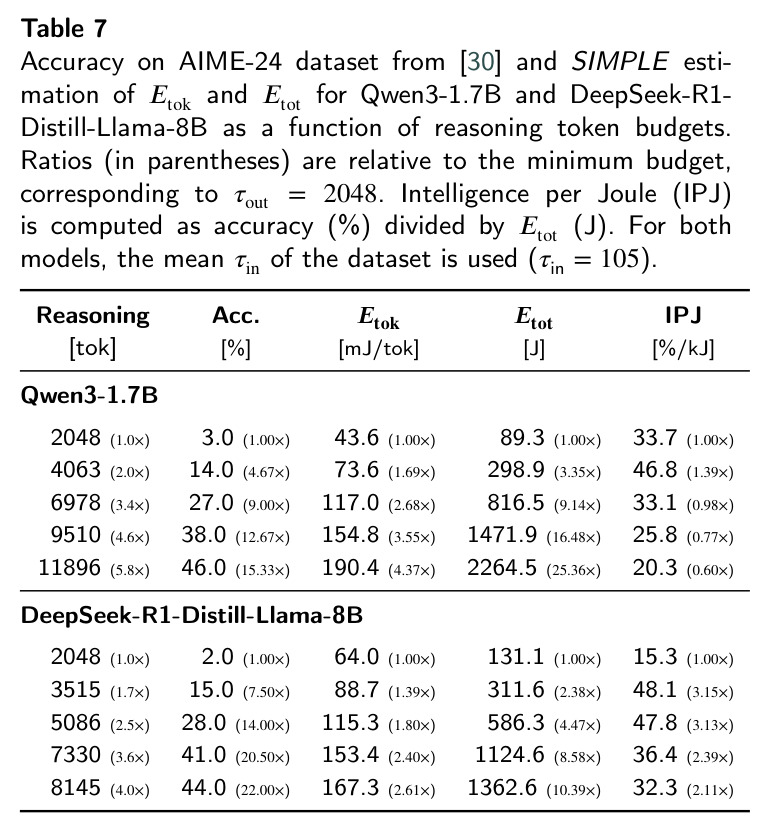
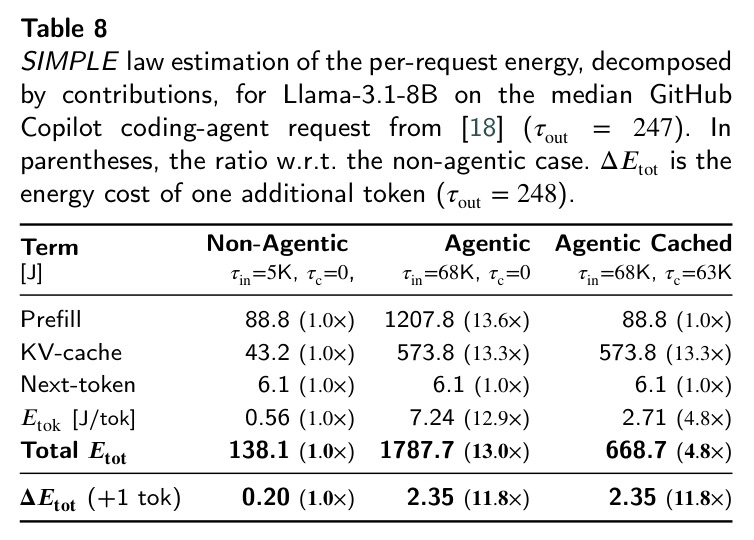
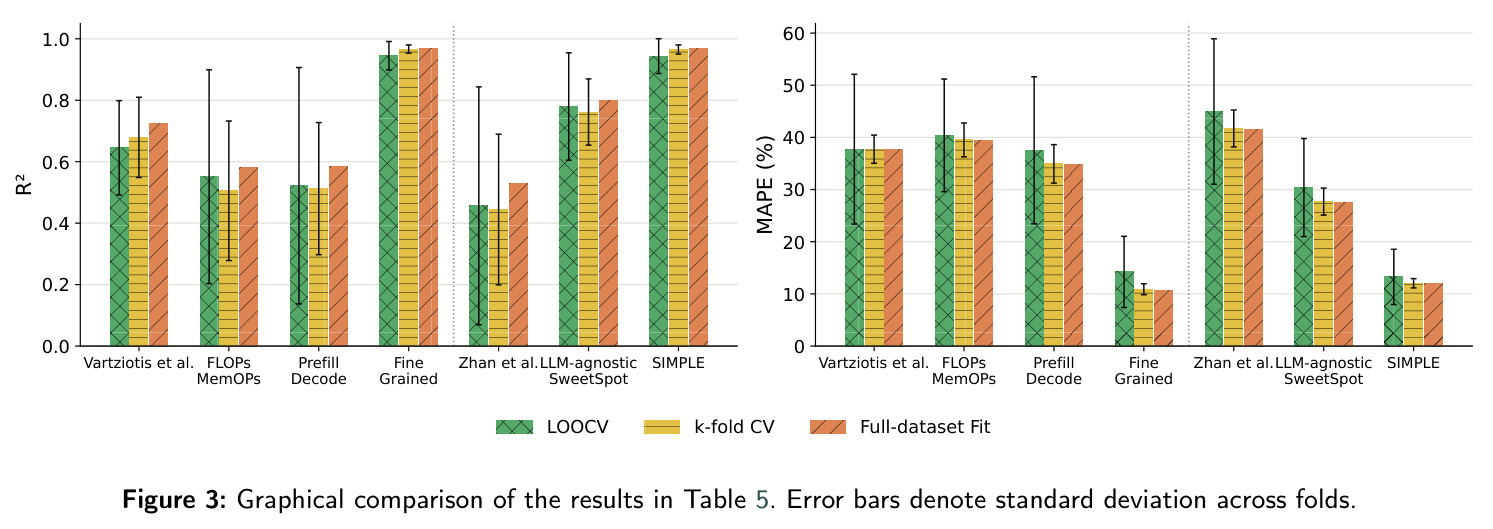
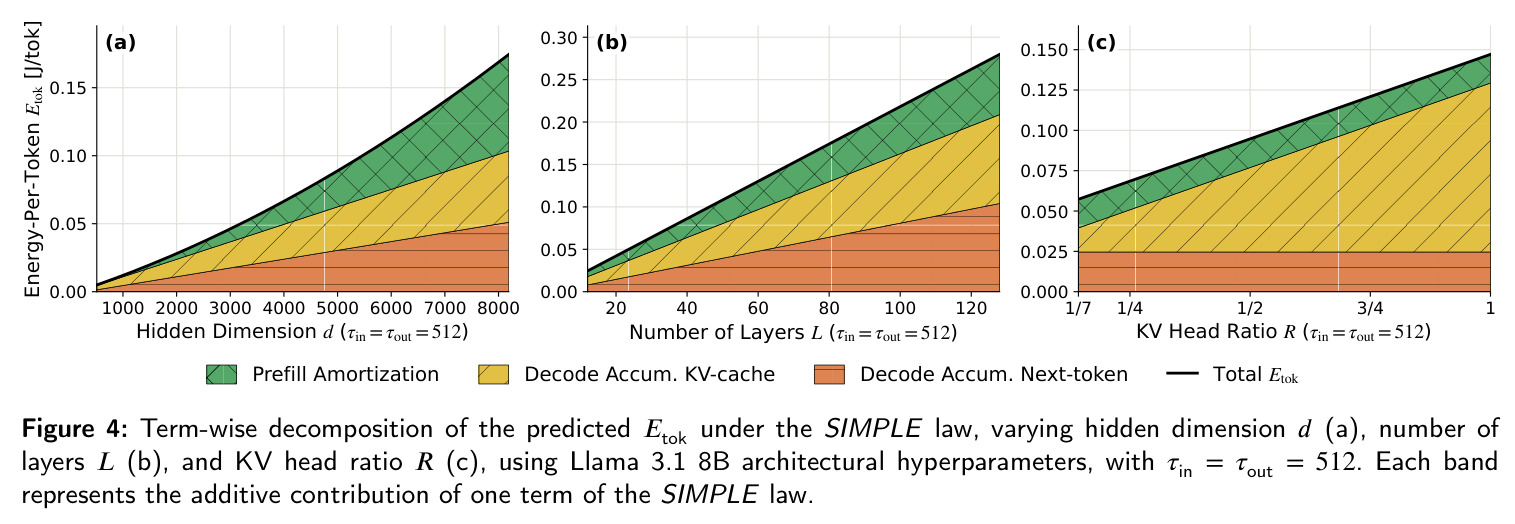
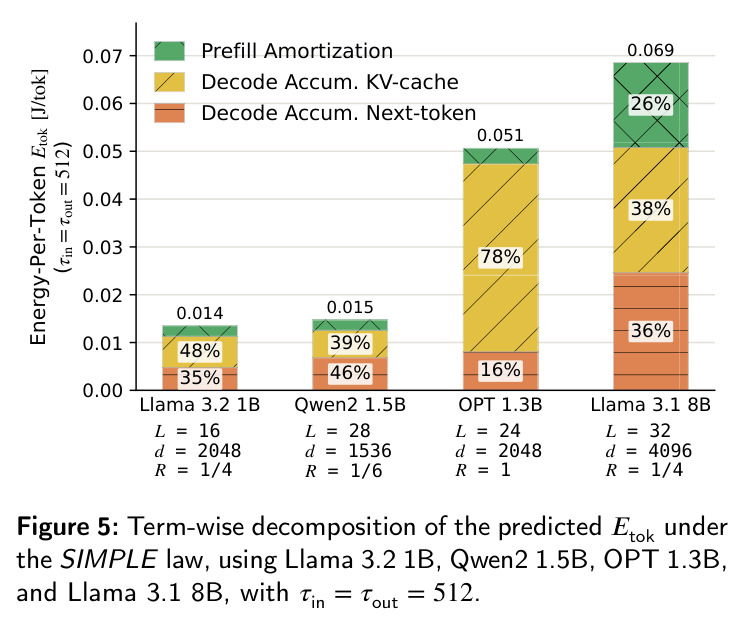
主实验覆盖 13 个 dense LLM(OPT/LLaMA/Gemma/Falcon/Qwen2/Granite,1B–9B)×49 种负载($\tau_{in},\tau_{out}$ 各取 64–4096 的 2 的幂、每组合 1000 请求,H100 + TensorRT-LLM)。SIMPLE 全量拟合 $R^2=0.969$、MAPE=11.97%,LOOCV $R^2=0.944$、MAPE=13.25%,10 折 CV $R^2=0.965$、MAPE=12.04%;LOOCV 下显著优于 SOTA(LLM-agnostic SweetSpot 30.39%、Vartziotis 37.74%、Zhan 44.96%),误差低 2.8–3.4 倍(全量口径即摘要的 3.1–3.5 倍)。与逐 LLM 拟合的 SweetSpot(mean $R^2=1.000$、MAPE=1.84%,精度上界)相比,SIMPLE 用一组系数损失约 10 个百分点换取完全泛化,且仍优于所有其他 LLM-specific 基线:比双线性(20.48%)低 41.5%,比线性与幂律模型分别低 3.2 与 5.3 倍;消融显示 Fine-Grained 用 25 个系数才达 LOOCV $R^2=0.945$/14.21%,SIMPLE 4 个系数几乎打平。定律解释力:prefill 随 $d$ 二次增长、$L$ 线性;$R=1/7$ 相对 MHA 把 $E_{tok}$ 从约 150 降至约 60 mJ/tok(3 倍);OPT-1.3B(MHA)KV 份额 78%、$E_{tok}$ 51 mJ/tok,对比 Llama-3.2-1B(GQA)48%、14 mJ/tok。推理分析:解析出 sweet spot(Qwen3-1.7B 约 165、DeepSeek-R1-Distill-8B 约 331 tokens),AIME-24 上 Qwen3-1.7B 预算 2048→11896 时准确率 3.0%→46.0% 但 $E_{tot}$ 膨胀 25.4 倍、IPJ 跌至 0.60 倍;IPJ 峰值在中间预算(两模型分别 +1.39 与 +3.15 倍),峰值与两端最大落差 3.14 倍。Agentic 分析(Llama-3.1-8B,Copilot 中位请求 68K/247):138.1→1787.7 J(13.0 倍);prefix 缓存消除 93% prefill 后仍 668.7 J(4.8 倍),因 KV 项 573.8 J(占 86%)不受缓存影响;边际 token 成本 0.20→2.35 J(11.8 倍)与缓存无关。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨架构能耗预测(LOOCV,13 个未见 LLM 架构) | MAPE (%) | 13.25(SIMPLE,4 系数一次拟合) | LLM-agnostic SweetSpot 30.39 / Vartziotis 37.74 / Zhan 44.96 | 误差降低 2.3–3.4 倍 |
| 跨架构能耗预测(LOOCV) | R² | 0.944 | LLM-agnostic SweetSpot 0.780 / Vartziotis 0.645 / Zhan 0.456 | +0.164 |
| 全量拟合(13 LLM × 49 负载 × 1000 请求) | MAPE (%) / R² | 11.97% / 0.969 | SOTA 解析模型 27.4–41.4% MAPE | MAPE 降低 3.1–3.5 倍(摘要口径) |
| 对比逐 LLM 拟合模型(Table 6) | MAPE (%) | 11.97(单一系数集覆盖全部架构) | SweetSpot 1.84(逐模型拟合上界);双线性 20.48;线性 38.20;幂律 63.23 | 优于除 SweetSpot 外所有基线(双线性低 41.5%,线性/幂律低 3.2/5.3 倍) |
| 注意力架构能效(RQ3,Llama 3.1 8B 超参,τin=τout=512) | E_tok (mJ/tok) | GQA R=1/7 时约 60 | MHA R=1 时约 150 | 约 3 倍降低 |
| Agentic 负载每请求能耗(RQ5,Llama-3.1-8B,68K 上下文/247 输出) | E_tot (J) | 无缓存 1787.7(13.0 倍);prefix 缓存后 668.7(4.8 倍) | 非 agentic 138.1 | 缓存仅回收 prefill(−93%),KV 项不受影响 |
局限与改进
作者明确承认三类限制:其一,评估限于 dense、单 GPU 的 LLM,不覆盖 MoE;注意力只验证了 MHA 与 GQA,MLA 等更新变体、更多规模与架构留待未来。其二,公式不显式建模 batch size 与并发请求数,而这些正是生产服务的关键变量。其三,参考数据全部来自 TensorRT-LLM + 单卡 H100(固定并发 1000、最大 batch 1024、序列上限 8192),系数绑定这一硬件-框架对,多卡部署的通信、张量/流水线并行与分布式 KV-Cache 成本不在模型内。我的补充观察:数据采集于吞吐模式(并发 1000),与延迟敏感的在线服务(连续批处理、投机解码、PagedAttention、KV 量化)的能耗结构不同,直接迁移可能有系统偏差;MAPE 约 12% 对科研对比够用,但用于逐请求计费或 SLA 承诺仍偏粗;WLS 权重 $w=1/y^2$ 未做敏感性分析;sweet spot 推导假设系数恒定,而频率调节、动态批处理会移动最优点;模型还假设 bf16 无量化,量化会同时改变计算与字节项。
独立分析的弱点
第一个弱点是硬件-框架绑定:$\theta_i$ 是在 H100+TensorRT-LLM 上拟合的常数,换 A100、AMD MI300 或 vLLM/SGLang 就要重建整个测量数据集,削弱『定律』的通用性;改进方向是借鉴 Vartziotis 把 $\theta$ 分解为硬件物理常数(pJ/FLOP、pJ/bit)乘效率因子,换硬件只需标定两个常数。第二个弱点是不建模批处理:高并发下 decode 可从访存受限转向计算受限,KV-cache 项被同批请求分摊,吞吐模式数据上拟合的系数用于其他并发场景会有系统偏差;改进方向是引入 batch 维度并用 roofline 在两个 regime 间插值。第三个弱点是注意力覆盖窄:MLA(DeepSeek)、滑动窗口注意力(Gemma/Mistral)、稀疏/线性注意力都不在推导内,而这恰是主流高效架构;改进方向是把 $R$ 推广为『有效 KV 令牌比』或为每类机制单独推导 KV 字节项。第四个弱点是精度分布不均:约 12% 的 MAPE 集中在短输出的小能耗区域,恰是交互式请求的主体;可用分段拟合或异方差感知损失改进。第五个弱点是 sweet spot 只管能量侧,准确率-预算关系需外接他人实测,IPJ 峰值粒度受外部测量限制。
未来方向
作者提出的延伸有三条:把 MoE 与多 GPU 部署纳入推导(路由激活、专家并行、通信与分布式 KV-Cache 能耗);显式引入 batch size/并发数作为公式变量;在更多注意力变体、模型规模、加速器与推理框架上校准系数。基于本文成果还可以延伸:把 $\tau^*_{out}$ 的闭式解做进推理引擎的自适应预算控制器,在解码过程中按 IPJ 动态决定何时停止思考(IPJ-aware decoding);用 SIMPLE 的 KV-cache 项为 prefix 缓存调度和上下文裁剪定价,回答『缓存多少才划算』;把定律用作能耗感知的模型路由与调度信号(同 SLA 下选 $d$、$L$、$R$ 组合最优的模型);在训练前用能耗感知的架构搜索(NAS)预测候选架构的部署能耗;以及把字节项推广到 KV 量化(INT8/INT4),量化评估其对每 token 能耗的真实收益。
复现评估
复现条件相当友好。模型本身是 4 系数闭式公式:输入任意 LLM 的 $d$、$L$、$n_q$、$n_{kv}$ 与 $\tau_{in},\tau_{out}$ 即可算出 $E_{tok}$/$E_{tot}$,论文附录 Table 9 给出全部系数($\theta_0=-1.866\times10^{-3}$、$\theta_1=3.308\times10^{-11}$、$\theta_2=1.041\times10^{-9}$、$\theta_3=2.020\times10^{-7}$),无需 GPU 就能在笔记本上复用。评测代码开源于 gitlab.com/ecs-lab/simple-law,测量数据集(13 LLM × 49 负载 × 1000 请求的 H100 功率轨迹)公开在 Zenodo(doi.org/10.5281/zenodo.18714476),另有交互式实现 ecs-lab/SIMPLE。若要从头重校准(如换硬件),需要 H100 级服务器 + TensorRT-LLM + pynvml 功率采样(每 500ms),按 49 种长度组合各跑 1000 请求,单卡即可,成本主要是 GPU 机时。综合评估:使用定律容易(入门级),重拟合中等(一块 H100 加数小时机时),扩展推导到新注意力机制则需系统能耗建模经验。
论文图表
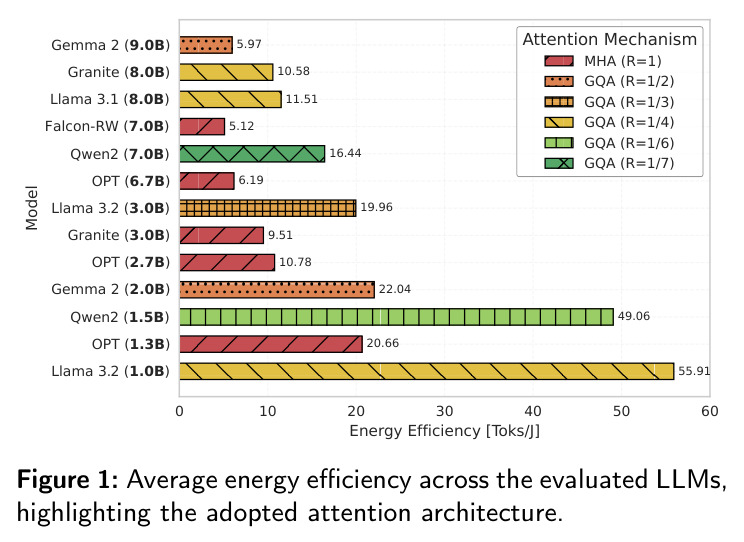
13 个评测 LLM 的平均能效条形图,按注意力架构标注:Llama 3.2 1B 最高 55.91 tok/J,Falcon-RW 7B 最低 5.12 tok/J;同为小模型的 Qwen2 1.5B(GQA R=1/7)达 49.06 tok/J,而 OPT 1.3B(MHA)只有 20.66 tok/J。
这是全文的经验出发点:规模相近的模型能效可差 2.4 倍,说明仅用模型大小无法刻画能耗,必须把注意力架构写进模型——直接支撑 RQ3 与 SIMPLE 的设计动机。
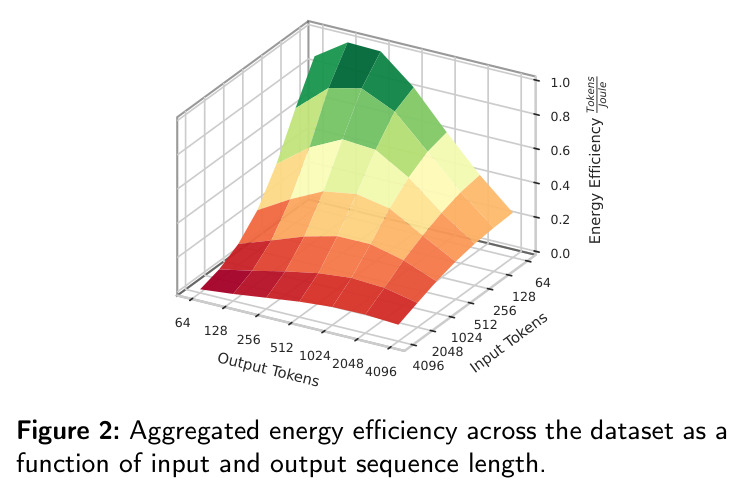
数据集聚合后的能效热图(横轴输入、纵轴输出长度,各为 64–4096 的 2 的幂,共 49 种组合)。能效在短输入(τin=64)与中短输出(τout≈128–256)处最高,长输入+短输出最差,最佳与最差配置相差 33.41±4.90 倍。
展示了非线性的『甜点』结构,正是 SIMPLE 要解析再现的实证模式,也是后文 sweet spot 概念的数据基础。