样本数量并不足够:候选生成策略决定LLM测试时扩展的能耗与性能 Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling
同一候选预算下,8次串行生成比1次批量调用多耗4.6倍以上GPU能量
前置知识
测试时扩展(Test-Time Scaling)
在推理阶段投入额外计算来提升输出质量、而不改变模型参数的技术总称。典型做法包括:对同一提示多次采样候选答案再投票(self-consistency)、生成N个候选后用验证器或奖励模型挑选(best-of-N)、延长或细化推理链等。其收益取决于题目难度、推理策略、停止规则与聚合方式。
本文研究的正是多候选型测试时扩展:这类方法通常只报告候选数N作为预算,而论文要论证的是N并不能完整描述其真实系统成本,理解测试时扩展的运作方式是读懂全文的前提。
自洽性(Self-Consistency)
Wang等人提出的方法:对同一提示用温度采样生成多条推理路径,各自抽取最终答案,选票数最高的答案作为预测(多数投票),候选之间相互独立、不使用验证器。GSM8K场景下答案抽取依赖定界符、boxed表达式、最后的数值行等规则,平票时取最先出现的候选。
本文所有候选生成采用自洽式独立采样加同一套多数投票规则,这是保证四种生成调度在语义上完全等价、可公平比较的关键实验控制。
生成调度(Candidate-Generation Schedule)
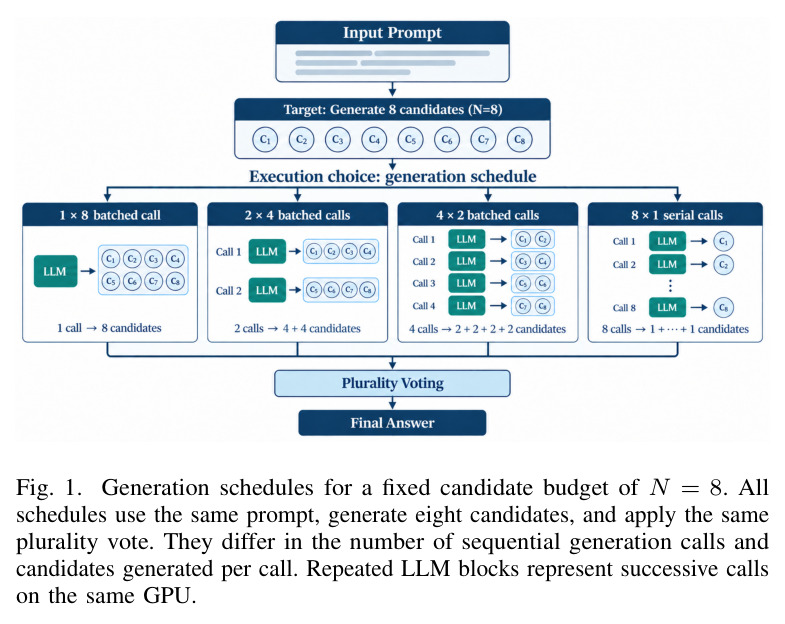
论文将多候选推理的执行方式形式化为 $S=(b_1,\dots,b_C)$,其中 $\sum_{c=1}^{C} b_c = N$,$C$ 为生成调用次数,$b_c$ 为第 $c$ 次调用的候选数;记号 $a\times b$ 表示 $a$ 次串行调用、每次生成 $b$ 个候选。$1\times8$ 与 $8\times1$ 的候选数相同,但执行结构完全不同。
生成调度是论文的核心研究对象,全部实验都围绕不同 $S$ 在固定 $N$ 下的延迟、吞吐、GPU小时数与能耗差异展开。
NVML与毛能耗(Gross GPU-Device Energy)
NVML是NVIDIA管理库,可读取GPU累计能耗计数器。论文的测量边界是:每次查询前做GPU同步并读取一次累计能耗,生成、抽取、投票结束后再次同步并读取,差值即 $E_{gross}=E_{NVML,end}-E_{NVML,start}$,涵盖提示处理、prefill、解码全过程,不扣除空闲功耗、不含整机其他部件。
论文所有能耗结论(如每查询631焦耳、串行多耗4.64倍)都建立在这一测量边界上,理解它才能正确解读数据,也才能明白作者为何强调报告的是毛能耗而非纯计算能耗。
分层配对自助法(Hierarchical Paired Bootstrap)
一种不确定性估计方法:先对重复(repetition)有放回重采样,再在选中的重复内对提示重采样,同时保持不同生成调度之间的提示级配对关系,共重采样10,000次,从经验分布取2.5%与97.5%分位数得到95%置信区间;P95延迟在每个自助样本中重新计算。
论文每个关键比值(如4.64倍、5.77倍)都附有该方法的置信区间,只有理解这一统计流程,才能判断调度效应的结论是否稳健、区间是否足够窄。
研究动机
基于采样的测试时扩展方法(自洽性、best-of-N、自适应采样等)几乎都用候选数量 $N$ 来概括推理预算,例如“每个提示生成8个候选”。但 $N$ 只说明生成了多少候选,不说明这些候选如何执行:同样的 $N=8$ 可以是一次批量生成调用($1\times8$),也可以是8次串行的单候选调用($8\times1$),两者候选数与投票规则完全相同,但生成调用次数和批大小不同,延迟、吞吐、GPU小时数、利用率和能耗可能相差数倍。作者对代表性研究做了报告实践审计(Table I):Self-Consistency、Adaptive-Consistency、Universal Self-Consistency、Large Language Monkeys、Scaling Test-Time Compute、Difficulty-Adaptive SC 这六项研究全部报告了候选预算,但没有一项报告每查询调用次数、每次调用候选数和实测能耗,多数连候选生成硬件都标为NR。这使系统层面的结果难以复现与比较。该问题在高性能计算(HPC)场景尤其突出:LLM推理常以有限批量作业而非持续服务运行,候选生成还可能因日志记录、确定性种子或中间分析被拆成多次小批量调用,执行差异被进一步放大。
本文的目标是本文的目标是把“候选数量”与“候选执行方式”解耦,系统量化后者对精度和系统成本的影响,并用实测数据填补报告缺口。具体回答三个问题:(1)当批量候选数 $N$ 从1增加到8时,推理精度和系统成本各自如何变化?(2)在固定 $N=8$ 的条件下,$1\times8$、$2\times4$、$4\times2$、$8\times1$ 四种调度对延迟、吞吐、GPU小时数、利用率和毛GPU能耗的影响有多大?(3)这些调度效应是否在不同GPU节点和短输出工作负载(SciQ/V100)下依然成立?最终论文希望产出两项可交付成果:一套多候选推理实验的最小报告标准(候选数、每查询调用数、每次调用候选数、硬件、能耗、测量边界),以及一条可操作实践的调度选择指南(在显存等约束下如何分组生成候选)。
与已有工作不同的是,已有研究分为互不交叉的两支:测试时扩展文献只关心生成多少候选、如何从候选中挑选(更大预算、自适应停止、验证器设计),从不涉及执行层面;推理系统文献(ORCA、vLLM、Sarathi-Serve及各类能耗研究)研究批处理与调度的一般机制,但不针对多候选测试时扩展这一具体负载。本文的独特切入是受控变量式的系统测量:固定候选预算 $N$、提示、解码设置、答案抽取与投票规则,只改变生成调用的分组结构,并用NVML实测每次查询的毛GPU设备能耗。论文还首次把调度形式化为 $S=(b_1,\dots,b_C)$、审计已有论文的报告缺口、用逻辑token量核算排除混淆因素,并把结论转化为 $b=\min(N,b_{max})$ 这样的可执行启发式。这种在固定预算下端到端度量调度成本的工作在测试时扩展文献中此前是缺失的。
核心方法
直觉上,候选数 $N$ 描述的是“做什么”(生成8个回答并投票),而生成调度描述的是“怎么做”(分几次调用、每次几个候选),后者决定了GPU每个时刻能暴露多少并行工作、要重复多少次调用开销和提示处理。技术路线上,论文把调度形式化为 $S=(b_1,\dots,b_C)$、$\sum_c b_c=N$,并设计三类实验:第一类是精度实验,Phi-3-mini-4k-instruct与Qwen2.5-1.5B-Instruct在500条GSM8K上每题生成8个候选(温度1.0、top-p 0.95),用前 $N$ 个候选($N\in\{1,2,3,4,8\}$)计算精度,仅用于精度分析;第二类是系统实验,100条GSM8K提示×3次重复,先测批量 $N\in\{1,2,4,8\}$ 的成本,再固定 $N=8$ 比较 $1\times8$、$2\times4$、$4\times2$、$8\times1$;第三类是鲁棒性实验,在另外两个A100节点重复两个端点调度,并在500×3的SciQ上用V100复现完整调度扫描。系统测量以单次查询为边界:起止各做一次GPU同步并读取NVML累计能耗,涵盖提示处理、prefill、解码、答案抽取与多数投票,排除模型加载、预热、计token和最终评分。
核心创新是“固定预算、只变执行”的受控实验设计:此前没有任何工作在候选数、提示、解码设置和聚合规则完全相同的条件下,只改变生成调用结构并实测GPU能耗。为保证可比性,论文还做了逻辑token量的核算:每条查询的逻辑输入token为 $T^{input}_{logical}(q)=N\,P_q$($P_q$ 为提示长度),逻辑生成token为 $T^{gen}_{logical}(q,S)=\sum_{c=1}^{C}\sum_{j=1}^{b_c} L_{q,c,j}$;固定 $N=8$ 时,各调度的逻辑生成token量差异仅0.8%(Phi-3)和1.0%(Qwen),排除了“串行调度恰好生成了更长回答”这一混淆解释。另一个关键洞察是平均功率会误导判断:$8\times1$ 调度的平均功率更低(Phi-3/A100从177.8W降到139.8W),但运行时长增加5.97倍,总能耗反而大幅上升——因此判断效率必须看总能耗而非瞬时或平均功率。这与服务系统研究中“批处理提升利用率”的结论对接,但首次落到了测试时扩展这一负载上。
方法步骤详情
第一步,精度分析:GSM8K测试集以种子42打乱取前500条,每题生成8个候选,对 $N\in\{1,2,3,4,8\}$ 用前 $N$ 个候选做数值答案抽取(检查定界符、boxed表达式、答案语句、末尾数值、最后非空行)和多数投票(平票选最先出现的候选),输出各 $N$ 的准确率与95%配对自助区间,并补充随机平票和以抽取成功为条件的诊断实验。第二步,批量扩展系统实验:100条提示×3次重复,$N\in\{1,2,4,8\}$ 单次批量调用,Phi-3跑在V100 32GB(250W),Qwen跑在A100 80GB(500W),输出每查询焦耳数、每token焦耳数、延迟和每千查询GPU小时。第三步,固定 $N=8$ 调度扫描:同一A100作业内顺序执行 $1\times8$、$2\times4$、$4\times2$、$8\times1$(两次正序、一次反序以减少顺序和热效应),跨调度独立采样,输出相对能耗、相对P95延迟和相对吞吐。第四步,跨节点检验:在另外两个A100节点每模型重复 $1\times8$ 与 $8\times1$,共得三个独立作业的比值区间。第五步,短输出验证:500条SciQ×3次重复在V100上完整复现调度扫描(生成上限64 token)。第六步,统计分析:系统指标报mean±SD,P95延迟在每次重复内计算后汇总;调度比值用分层配对自助法(先重采样重复、再重采样提示、保持调度配对)给出95%置信区间。
技术新颖性
技术新颖性体现在四点。其一,首次把候选生成执行结构形式化为调度 $S=(b_1,\dots,b_C)$ 并用实验证明候选数 $N$ 不足以描述一个多候选推理负载,这是一个概念层面的贡献。其二,Table I的报告实践审计显示六项代表性研究全部不报告每查询调用数、每次调用候选数和实测能耗,本文是唯一五项全报告的研究,并由此提出最小报告标准,具有规范社区实践的价值。其三,方法设计上同时控制了预算、语义与统计三个维度:固定 $N=8$、逻辑生成token量对齐到差异<1.1%、用分层配对自助法处理重复×提示的两层结构并保持调度间配对,这些细节保证了观察到的4.6倍能耗差确实来自调度本身。其四,把测量结论转化为可操作产物:调度选择启发式 $b=\min(N,b_{max})$、$C=\lceil N/b\rceil$($b_{max}$ 为显存与系统约束允许的最大每调用候选数),以及按场景(候选独立、有依赖、连续服务环境等)给出的调度建议表。
实验结果
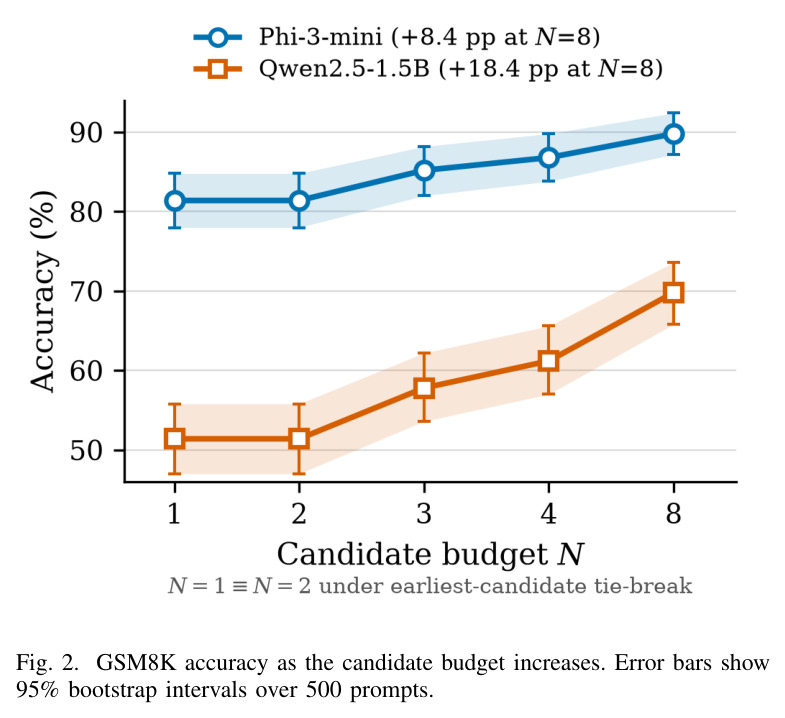
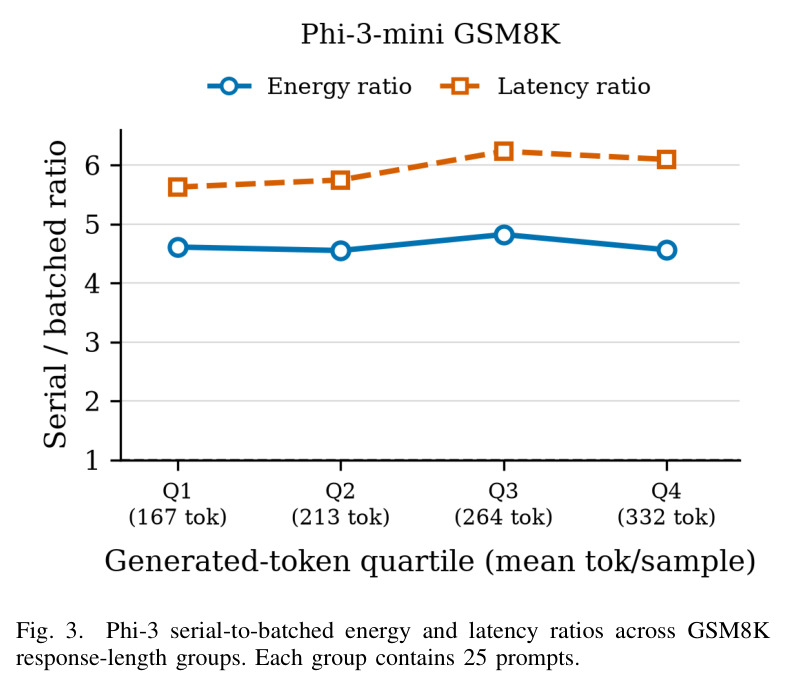
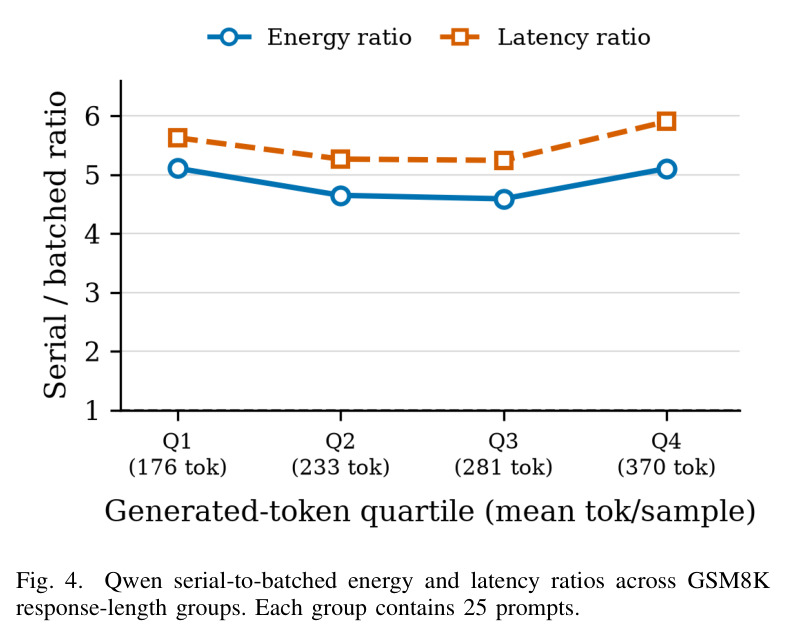
五个实验的核心数字如下。(1)精度随 $N$ 提升:Phi-3在GSM8K上从81.4%($N=1$)升至89.8%($N=8$),+8.4个百分点(95% CI [5.8, 11.2]);Qwen从51.4%升至69.8%,+18.4个百分点([14.8, 22.0])。$N=1$ 与 $N=2$ 精度相同源于平票规则——$N=2$ 时平票率高达25.0%(Phi-3)/63.0%(Qwen);随机平票或以抽取成功为条件最多改变1.4个百分点,说明精度结论对投票细节稳健。(2)批量 $N$ 从1增到8:Phi-3每查询能耗631→1286 J、每token能耗2.634→0.655 J、延迟5.06→8.91 s、每千查询GPU时间1.41→2.47小时;Qwen对应596→975 J、2.222→0.459 J/token、5.26→7.64 s、1.46→2.12小时——批处理提升单位效率,但生成更多候选仍让总成本上升。(3)固定 $N=8$ 调度扫描是主结果:$8\times1$ 相对 $1\times8$,Phi-3毛能耗4.64×([4.48, 4.79])、P95延迟5.77×([5.38, 5.99])、吞吐降到16.7%;Qwen为4.86×([4.71, 5.02])、6.12×([5.70, 6.75])、17.9%;中间调度呈单调渐变($2\times4$ 能耗1.63×/1.66×,$4\times2$ 为2.71×/2.86×),说明效应是渐进的。(4)跨节点稳健:三个独立A100作业的能耗比区间Phi-3为4.43–4.64、Qwen为4.85–4.88,串行吞吐始终只有批量的约17–18%;按响应长度分四组后能耗比Phi-3为4.40–4.77、Qwen为4.51–5.09,与输出长度无关。(5)SciQ/V100短输出验证:$8\times1$ 能耗2.57×(Phi-3)/3.34×(Qwen),延迟2.88×/4.42×,吞吐36%/23%。外推示意:100万查询从 $1\times8$ 改为 $8\times1$ 约多耗1.37 MWh、10,401 GPU小时(Phi-3),1.00 MWh、9,631 GPU小时(Qwen)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8K 数学题(精度扩展) | 准确率(500条提示,多数投票) | Phi-3:N=8 达 89.8%(95% CI [5.8, 11.2] pp 增益);Qwen:N=8 达 69.8% | N=1 单候选:Phi-3 81.4%、Qwen 51.4% | Phi-3 +8.4 pp,Qwen +18.4 pp |
| 固定 N=8 调度扫描(GSM8K/A100) | 毛GPU能耗比(8×1 / 1×8) | 1×8 单次批量调用为最优基准 | 1×8 = 1.00× | 8×1 耗能 4.64×(Phi-3)/ 4.86×(Qwen),即批量节省约4.6–4.9倍能耗 |
| 固定 N=8 调度扫描(GSM8K/A100) | P95延迟比与吞吐保持率 | 1×8 基准;2×4/4×2 呈中间值(延迟1.81–3.57×) | 1×8 P95 = 1.00×,吞吐100% | 8×1 P95达5.77×/6.12×,吞吐仅剩16.7%/17.9% |
| SciQ 短输出验证(V100) | 毛GPU能耗比与吞吐保持率(8×1 / 1×8) | 1×8 基准;效应在64 token短输出上复现 | 1×8 = 1.00×,吞吐100% | 8×1 能耗2.57×(Phi-3)/3.34×(Qwen),吞吐36%/23% |
局限与改进
作者明确承认的局限:实验只覆盖两个小模型(Phi-3-mini、Qwen2.5-1.5B)、两种GPU架构(A100-SXM4 80GB、V100 PCIe 32GB)和批处理式的Hugging Face generate流程,测得的比例不能假设原样适用于更大模型、其他GPU代际、连续批处理系统或多GPU推理;能耗是查询区间内的毛GPU设备能耗,不扣空闲功率、不含整机能耗;固定 $N$ 的各调度候选独立采样,虽然逻辑token量对齐到<1.1%,结果仍应解读为端到端调度成本——论文没有分离重复调用开销、提示重复处理、同步、批大小效应各自的贡献,这需要更细粒度的profiling;长度分层分析每组仅25条提示,且串行与批量调度独立采样,只能算描述性证据。我自己的补充观察:研究只测了自洽式多数投票,未覆盖候选间有依赖的best-of-N(验证器打分、剪枝);只在 $N=8$ 单一预算点实验,更大的 $N$(如Large Language Monkeys的数十至数百候选)下显存约束会成为主导因素,结论形态可能改变;系统实验只用100条GSM8K提示;固定GPU时钟(1275/1230 MHz)的做法与生产环境自动调频不符,可能放大或缩小比值;论文未提供开源代码。
独立分析的弱点
第一,模型规模太小削弱实用性:Phi-3-mini与Qwen2.5-1.5B的KV-cache和激活都很小,单卡一次装下8个候选毫无压力,所以 $1\times8$ 总是可行;但对70B级模型,8路候选可能本来就放不进一张卡,$1\times8$ 根本不可行,结论需要重新校准。改进方向:加入7B–70B模型,报告 $b_{max}$ 随模型规模的变化曲线。第二,推理栈过于简化:HF generate是静态批处理,没有continuous batching、chunked prefill和跨请求KV-cache复用,在线服务中重复处理提示的开销可被大幅摊薄,4.6倍的比值可能显著缩小。改进方向:在vLLM或SGLang上复测同样的调度扫描。第三,毛能耗混淆了机制:串行8次意味着对同一提示重复8次prefill,这部分浪费理论上可通过共享提示状态几乎完全消除,论文未量化重复prefill占总开销的比例,削弱了指导的精准度。改进方向:缓存提示KV后重测,并把调用开销、prefill、解码、利用率四项贡献分解开。第四,缺少真实服务负载:实验是离线批量执行,无并发请求与排队,P95延迟的含义与在线服务不同;此外固定GPU时钟便于控制变量但偏离生产环境。改进方向:补充在线负载(并发请求、到达间隔分布)下的调度实验。
未来方向
作者提出的方向包括:扩展到更大模型、连续批处理系统、量化、投机解码和多GPU执行;用更细粒度的profiling分离重复调用开销、提示处理、同步与批处理效应各自贡献;构建能预测各候选调度在能耗、延迟、显存上成本的通用调度器,在系统约束下自动选择最低成本配置。基于本文成果还可以延伸:把 $b=\min(N,b_{max})$ 启发式嵌入vLLM等框架处理 $n>1$ 采样请求的路径,直接落地为默认策略;研究依赖型候选(验证器剪枝、对比打分、束搜索类方法)下调度的最优结构,因为那时“候选独立”的前提不再成立;结合电网碳强度数据做碳感知调度——在低碳时段安排串行高能耗作业;把最小报告标准做成benchmark工具,自动采集调用数、批大小、NVML能耗,推动测试时扩展论文规范化报告;探索早停类自适应方法(如Adaptive-Consistency)与调度选择的联合优化,因为早停会动态改变有效候选数,调度应随之调整。
复现评估
复现材料高度可得:模型(Phi-3-mini-4k-instruct、Qwen2.5-1.5B-Instruct)与数据集(GSM8K、SciQ)全部公开;论文给出的配置极为详尽——GSM8K种子42取前100/500条、温度1.0、top-p 0.95、最大新token 512(GSM8K)/64(SciQ)、驱动580.159.04、CUDA 12.1、PyTorch 2.4.1、Transformers 4.57.6、A100 500W/1275MHz、V100 250W/1230MHz、每作业独占一卡、两次预热生成;能耗测量用标准NVML累计计数器,测量边界(含什么、排除什么)描述清晰,统计方法(10,000次分层配对自助)也写明。不足是正文未提供开源代码链接,需要自行实现生成循环、答案抽取与投票——抽取规则描述较细(定界符、boxed、末行数值等)但实现仍有细节空间。算力门槛中等:主实验是数千次小模型生成调用,一张A100 80GB(Qwen实验)或V100 32GB(Phi-3/SciQ)即可,估计单卡数小时到一天。总体复现难度中等:比值级结论应当可复现,绝对能耗可能随驱动和时钟设置略有漂移。
论文图表
审计表对比六项代表性研究(Self-Consistency、Adaptive-Consistency、Universal Self-Consistency、Large Language Monkeys、Scaling Test-Time Compute、Difficulty-Adaptive SC)与本文在五项信息上的报告情况:候选数N、每查询调用数、每次调用候选数、候选生成硬件、能耗。前六项研究几乎全是NR,只有本文五项全部报告。
这张表是论文动机的实证支撑:它具体展示了“报告缺口”的真实存在,也解释了为什么系统成本难以跨研究比较,是提出最小报告标准的依据。
总览五个实验的设计:精度扩展(GSM8K 500条,一个8候选池取前缀评估 $N\in\{1,2,3,4,8\}$)、批量扩展(100×3,批量 $N\in\{1,2,4,8\}$ 与串行 $N=8$)、调度扫描(100×3,固定 $N=8$ 的四种调度)、跨节点检验(另两个A100节点重复两端点)、短输出验证(SciQ 500×3 在V100完整扫描)。
它是全文实验设计的地图,读者可据此快速定位每个实验回答的问题、使用的数据规模和硬件,理解各实验之间的分工与递进关系。
列出批量扩展实验的具体配置:Phi-3用V100 32GB/250W,Qwen用A100 80GB/500W;驱动580.159.04、CUDA 12.1、PyTorch 2.4.1、Transformers 4.57.6;均为100条提示×3次重复、最大新token 512。
复现该实验所需的核心配置都在这张表里;同时它明确了两个模型使用不同GPU,提醒读者两组绝对值不可直接互比。
诊断表给出各 $N$ 下的平票率(Phi-3:$N=2$ 时25.0%、$N=8$ 时3.4%;Qwen:63.0%、18.2%)及三种投票处理下的准确率对比:随机平票和以抽取成功为条件最多改变1.4个百分点。
它验证了精度结论对投票细节的稳健性,并解释了 $N=1$ 与 $N=2$ 精度相同的表面异常,是正确解读Fig. 2的必要补充。
展示 $N\in\{1,2,4,8\}$ 批量调用下的能耗:Phi-3每查询631→795→974→1286 J、每token 2.634→0.655 J;Qwen每查询596→670→802→975 J、每token 2.222→0.459 J(mean±SD,3次重复)。
它刻画了“预算增大”维度的成本规律:单位token效率随批量改善但查询总能耗上升,是理解第二个实验(调度扫描)为何要固定 $N$ 的铺垫。
论文的主结果表:固定 $N=8$ 时四种调度相对 $1\times8$ 的能耗与P95延迟。相对能耗Phi-3为1.00/1.63/2.71/4.64、Qwen为1.00/1.66/2.86/4.86;相对P95延迟Phi-3为1.00/1.81/3.21/5.77、Qwen为1.00/1.97/3.57/6.12,呈单调渐变。
这是全文最核心的数据表,直接证明“同样的候选数,串行执行多耗4.6倍以上能量”,是论文标题论断的定量来源。
汇总三个独立调度的A100作业中 $8\times1/1\times8$ 的比值区间:毛能耗比Phi-3为4.43–4.64、Qwen为4.85–4.88;平均延迟5.85–5.97与5.50–5.53;P95延迟5.53–5.77与6.06–6.12;吞吐保持16.7–17.1%与17.9–18.0%。
它用区间形式证明调度效应跨节点高度稳定,排除了“结果只是某个特定作业的偶然现象”的质疑,是结论可信度的关键。
SciQ短输出工作负载(均值仅几个生成token)下的调度扫描:Phi-3的相对能耗/延迟/吞吐为1.00/1.00/1.00、1.29/1.37/0.74、1.75/1.97/0.51、2.57/2.88/0.36;Qwen为1.38/1.59/0.63、2.04/2.59/0.39、3.34/4.42/0.23。
它证明调度效应不是GSM8K长推理输出特有的:在均值仅1.71–3.46个token的极短输出上效应依然明显,显著扩展了结论的适用范围。
按场景给出调度建议:候选都能放进显存→用一次批量为 $N$ 的调用;显存限制批量→用最大可行批量加最少调用;候选依赖之前输出→可能需要串行调用;连续服务环境→与服务调度器协同;有额外延迟或资源限制→在可行方案中优先选调用更少的。
它把全部实验结论压缩成工程师可直接执行的决策表,是论文实用价值的集中体现,也是读者带走的最重要操作指南。