ATEST:面向大语言模型推理的自适应资源感知测试时扩展 ATEST: Adaptive Resource-Aware Test-Time Scaling for LLM Inference
在共享 GPU 上实时学习采样能耗,让测试时扩展既守预算又不拒答
前置知识
测试时扩展(Test-Time Scaling, TTS)
指在推理阶段投入更多计算来换取更好答案的技术:对同一问题让模型生成多条推理路径(多个样本),再用投票等聚合方式选答案。样本数 $B$ 越大通常越准,但 GPU 时间、能耗和延迟也随样本数近似线性增长。
ATEST 研究的正是 $B$ 该怎么选:理解 TTS 中“准确率随样本数上升、成本线性增长”这一基本权衡,是读懂全文的前提。
自一致性投票(Self-Consistency)
TTS 的主流实现:对同一问题采样 $B$ 条思维链,统计最终答案出现频次并返回多数(plurality)答案。其隐含假设是正确答案更容易被多次独立采样命中,因此票数分布的集中程度可当作无监督的置信度信号。
ATEST 推理端的决策信号——投票稳定性 $S(B)$ 与增益 $\Delta U$——完全建立在这个投票机制之上。
GPU 负载与 NVML 能耗计量
NVML 是 NVIDIA 的管理库,可实时读取 GPU 利用率与功率。本文采用 Eocc(占用能耗)计费:一个微批次运行期间 GPU 消耗的全部能量(功率×时长)都记到它头上;共享 GPU 上其他任务会让同一批次跑得更久、功率更高。
论文的核心观察(同一 4 样本查询 121.7 J → 455.6 J,最高 4.1×)和所有成本预测都依赖这套计量与负载控制方式。
递归最小二乘(RLS)
一种在线参数估计算法:每来一个新观测就用解析更新公式修正线性模型参数,可用遗忘因子 $\lambda \le 1$ 弱化旧数据。相比重新训练,每次更新只需几次小矩阵运算,无需预先收集训练集,从第一个样本起就能学习。
ATEST-Online 的核心组件——在线成本模型 $\hat{E}=\theta^\top\phi$——就是用 RLS 在服务过程中逐个步骤学习采样能耗的。
蒙特卡洛前瞻估计
通过随机模拟未来事件来估计概率的方法。本文中指:基于当前票数分布,随机补采样至 $B_{max}=8$ 多次,统计当前领先答案最终仍获胜的比例,以此估计投票稳定性 $S(B)$。
ATEST-Online 判断“再采样是否值得”依赖这个不需要真实答案的无监督信号,看懂它才能理解继续/停止规则。
研究动机
测试时扩展通常给每个查询固定采样预算 $B$,这忽略了两个事实。其一,问题难度不同:简单题一两个样本即可稳定命中,难题需要更多样本。其二,单样本成本不是常数:在与其他任务共享的 GPU 上,对计算单元、显存带宽和功耗额度的竞争会让同样的批次跑得更久、功率更高。作者在 A100 上实测,同一 4 样本查询的能耗从空闲时的 121.7 J 涨到高负载时的 455.6 J(最高 4.1×),GSM8K 上平均功率从 77 W 升至 431 W。现有自适应方法(Adaptive-Consistency、早停自一致性、难度自适应等)只回答“这个问题需要几个样本”,把样本成本当作固定值;离线拟合的成本模型预测误差随负载从 26% 恶化到 283%,即使加入实时 GPU 状态作输入,中等负载下误差仍达 130%。在这种“资源感知盲区”下,控制器要么在 GPU 繁忙时浪费能量,要么过早耗尽能量预算而被迫拒绝(defer)后续查询。
本文的目标是本文的目标是把共享 GPU 上的 TTS 从纯推理问题改造成运行时资源管理问题,让控制器同时回答两个问题:下一个样本对这个查询还有多大价值?它此刻在 GPU 上的真实成本是多少?具体设计目标有四条(G1–G4):把样本花在答案仍不确定的查询上;跟随实时成本而非剖析时刻的静态成本;避免昂贵的数据集级离线标定;在硬性能量预算 $\sum_i E_i \le E_{max}$ 内服务尽可能多的查询、尽量不拒绝任何查询。为此论文提出 ATEST 框架,含两种共享预算阶梯与 GPU 监控的模式:默认的 ATEST-Online 完全不做离线标定、边服务边在线学习成本模型;可选的 ATEST-Calibrated 为负载稳定、可复用剖析结果的部署提供一次建模、整批采样的低尾延迟方案。
与已有工作不同的是,论文的切入角度来自 Table I 揭示的研究空白:已有自适应 TTS 方法的成本单位要么是样本数、要么是离线模型估计的能耗,没有任何方法读取实时 GPU 状态;最接近的 Adaptive-Cal 也只用离线标定模型。另一侧的推理服务系统(Orca、vLLM、Llumnix、Bullet)与能耗管理研究(POLCA、DynamoLLM、throttLL‘eM、EnerTune)决定的是“给定的工作量如何运行”——请求放置、分批、调频——而不决定“每个查询应获得多少推理量”。作者指出这两类决策相互依赖:一个样本是否值得,取决于当前票局和它此刻的实时价格。ATEST 补上这缺失的系统侧决策,并可与上述服务系统叠加运行,这是它区别于两侧已有工作的独特定位。
核心方法
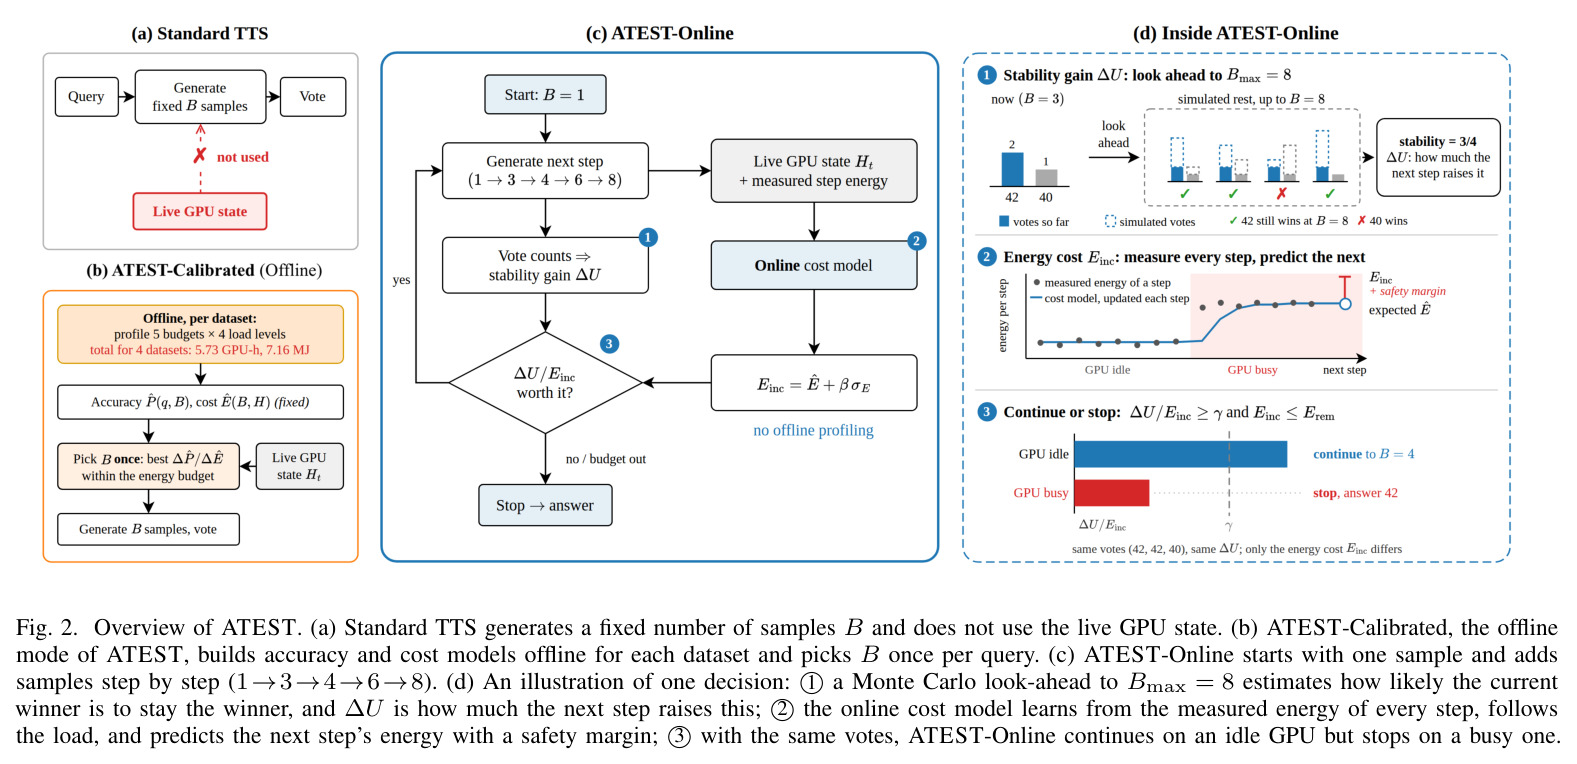
ATEST 的直觉是“按需加样、按价叫停”:从每个查询 1 个样本起步,沿预算阶梯 $\{1,3,4,6,8\}$ 逐级增加,每步先估“再采样带来多少稳定性提升”,再估“这一步此刻要多少焦耳”,性价比达标且预算装得下才继续。技术上它是闭环控制器:推理端用蒙特卡洛前瞻估计投票稳定性 $S(B)$(当前领先答案到 $B_{max}=8$ 仍获胜的概率),每步增益 $\Delta U=S_{after}-S_{now}$;资源端用线性模型 $\hat{E}=\theta^\top\phi$ 预测下一步能耗(特征含新增样本数与实时 GPU 状态),每执行一步就用实测能量 $e_t$ 做 RLS 更新,并加安全边际 $E_{inc}=\hat{E}+\beta\sigma_E$ 防止低估。继续条件是 $\Delta U/E_{inc}\ge\gamma$ 且 $E_{inc}\le E_{rem}$,否则立即返回当前多数答案。控制器跑在主机 CPU 上,每步只多一次 NVML 读取、一次蒙特卡洛模拟和一次 RLS 更新;主要代价是样本分成多个微批次生成。全流程无需离线标定,首个查询即开始学习。
核心创新是把“单个样本的成本”从常数升级为随时间变化、可在线学习的状态变量。与既有自适应 TTS 的本质区别有两点。第一,决策输入不同:过去的方法只看推理侧信号(票数一致性、题目难度、推理进度),ATEST 在每次决策中同时引入实时 GPU 状态与刚测得的能耗,用“每焦耳换取多少稳定性增益”($\Delta U/E_{inc}$)作为统一性价比度量。第二,反馈结构不同:每个执行过的步骤产生双重反馈——新样本更新票局从而改变 $\Delta U$,实测能耗更新 RLS 成本模型从而改变 $E_{inc}$——推理信号与成本信号在闭环中互相校准。受控消融证明,只要打开在线成本学习(noHW-State 变体),平均预算就会随负载移动;关闭它之后 ReasoningOnly-Strict 在所有负载下都用同样的 $B=3.12$。这说明负载适应的真正来源是运行时资源信号,而非预算逐渐耗尽的副作用。
方法步骤详情
算法 1(ATEST-Online)流程:输入查询、阶梯 $\{1,3,4,6,8\}$、剩余预算 $E_{rem}$ 与 RLS 状态。先准入检查:读 NVML 得 GPU 状态 $H$,若首步预测成本超过份额 $E_{rem}/N_{rem}$ 则直接 DEFER。否则生成 1 个样本并计票,实测能量、做一次 RLS 更新并扣减预算。主循环:取下一档 $B‘$,蒙特卡洛估稳定性增益 $\Delta U$,重读 $H$ 算含安全边际的步成本 $E_{inc}$;若性价比 $\Delta U/E_{inc}<\gamma$ 或 $E_{inc}>E_{rem}$ 则返回当前多数答案;否则只生成 $B'−B$ 个新样本(旧样本复用),更新票数、实测能量、RLS 更新、扣减预算;票局稳定或到 $B_{max}=8$ 也停。离线模式 ATEST-Calibrated 先每数据集剖析 500 条标定提示×5 档预算×4 负载(44,000 样本),拟合准确率与成本模型(后者功率×时长),在线时按升级性价比 $\Delta\hat{P}/\Delta\hat{E}$ 一次选出整档预算后一批生成。
技术新颖性
技术新颖性体现在三个层面。其一,问题层面的重新定义:论文把自适应 TTS 明确归类为运行时资源管理问题,并首次引入“实时 GPU 状态”这一 Table I 中此前无人使用的决策输入。其二,算法层面的极简在线学习:用带遗忘因子 $\lambda$ 的 RLS 在线拟合能耗,无需训练集、每步仅几次小矩阵运算,从第一个查询就开始学习;安全边际 $\beta\sigma_E$ 与小步长构成两级保险,使模型即使在高噪声的短任务上(MAPE 高达 134%)也不突破硬性能量预算。其三,评估方法学:通过在非约束预算、固定剩余能量信号下对比 Full-HW / noHW-State / ReasoningOnly-Strict 三个变体的受控消融,把“预算随负载变化”的因果归因从预算耗尽的混杂因素中剥离出来,干净地证明在线成本学习才是负载适应的来源。这种系统与算法的联合设计加归因式评估,在 TTS 文献中都很少见。
实验结果
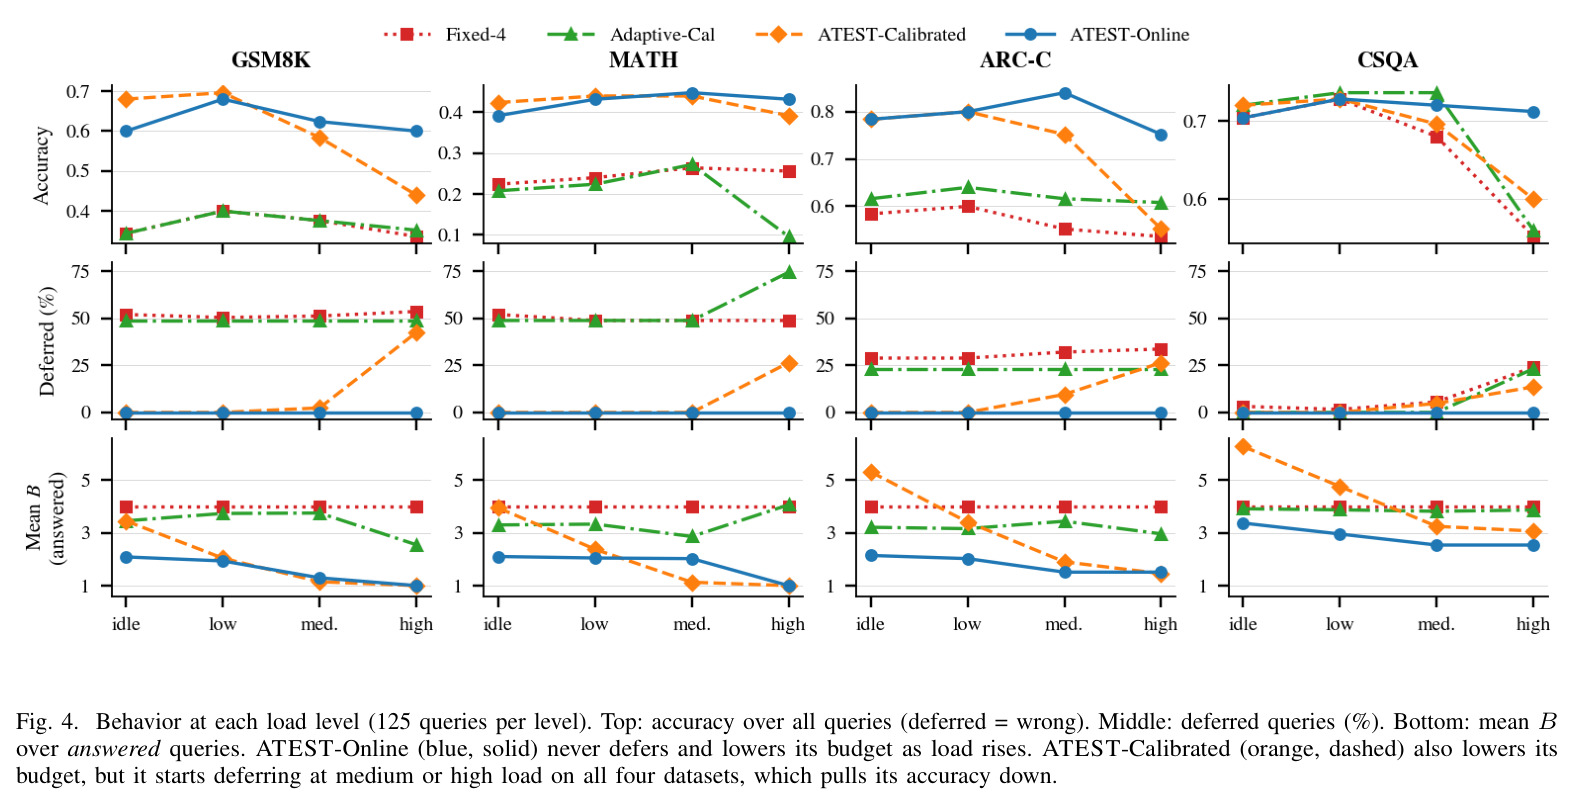
A100 主结果(Table III,500 查询/数据集):ATEST-Online 零拒绝,准确率全部最高或并列(GSM8K 0.626、MATH 0.426、ARC-C 0.794、CSQA 0.716),Fixed-4 则在 GSM8K/MATH 拒绝约半数。高负载更尖锐:GSM8K 上 Calibrated 拒绝 42.4%、准确率 44.0%,Online 全答达 60.0% 且能耗更低(175.8 J 对 206.4 J)。平均 $B$ 随负载降至 1.00、1.00、1.51、2.54。计入剖析(Table IV):Online 需 0.14 小时/0.153 MJ,Calibrated 需 5.87 小时/7.31 MJ,42×/48× 差距。消融(Table V)证实负载适应源自在线成本学习。代价是短任务开销:CSQA p95 延迟 0.180 s 对 0.086 s。稳定负载下离线模式更强(Table VIII:0.686 对 0.632)。泛化(Table VII):L40S 与 Qwen2.5-3B 行为不变,GSM8K 从 0.138 翻倍至 0.280。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8K(变负载调度,500 查询) | 准确率 / 拒绝率 / J per correct | ATEST-Online:0.626 / 0.0% / 191.9 J | Fixed-4:0.364 / 51.8% / 312.4 J | 准确率 +26.2 个百分点,能耗降 38.6%,且零拒绝 |
| MATH(变负载调度) | 准确率 | 0.426(零拒绝,371.2 J/正确答案) | Fixed-4 0.246;Adaptive-Cal 0.200 | +18.0 个百分点 |
| ARC-Challenge(变负载调度) | 准确率 | 0.794(零拒绝) | ATEST-Calibrated 0.722(拒绝 9.0%) | +7.2 个百分点,主要来自零拒绝 |
| CommonsenseQA(变负载调度) | 准确率 | 0.716(零拒绝) | Fixed-4 0.666;ATEST-Calibrated 0.686 | +5.0 / +3.0 个百分点 |
| GSM8K 高负载段(125 查询) | 准确率(拒绝计错) | 60.0%,175.8 J/查询 | ATEST-Calibrated 44.0%(拒绝 42.4%),206.4 J/查询 | +16 个百分点,能耗再省 15% |
| 2000 查询端到端总成本(含剖析) | GPU 时间 / 能耗 | 0.14 h / 0.153 MJ | ATEST-Calibrated 5.87 h / 7.31 MJ | 42× 更少 GPU 时间,48× 更少能耗 |
| Qwen2.5-3B on L40S,GSM8K | 准确率 / J per correct | 0.280 / 536 J | Fixed-4 0.138 / 1019 J | 准确率翻倍,能耗近乎减半;8 个新设置中 7 个 J/correct 更低 |
局限与改进
作者承认的限制包括:受算力约束,每数据集仅 500 条测试查询、两个开源模型、两种 GPU,单次运行准确率的 95% 置信区间约 ±4 个百分点,因此 3 分以内的领先(如 GSM8K、MATH、CSQA)应视为并列;逐步控制在短任务上带来更高尾延迟与更低吞吐;在线成本模型刻意保持线性,短任务上 MAPE 高达 112–134%,只是靠安全边际和小步长保住预算安全。我的补充观察:Eocc 计费把共享 GPU 期间的能耗全部记在当前微批次头上,反映“占用成本”而非真实边际能耗,与集群实际分账方式可能有出入;负载由占空比控制的稠密矩阵乘注入器合成,与真实共存作业的突发形态不同;各方法在高负载下实际采样到的利用率并不一致(ARC-C 68%、CSQA 45%),削弱跨方法可比性,作者也因此主要依赖 GSM8K/MATH 下高负载结论;预算阶梯 $\{1,3,4,6,8\}$ 较粗,且 $E_{max}$ 以 Fixed-4 的参考能耗设定,对预算松紧的敏感性未系统研究。
独立分析的弱点
独立来看,本文有几处可改进。第一,线性 RLS 成本模型难以刻画批次大小、上下文长度、KV 缓存占用等非线性因素,短任务单步能耗太小导致相对误差放大(MAPE 134%),可改用特征更丰富的在线模型或高斯过程、在线集成。第二,准入规则 $E_{inc} \le E_{rem}/N_{rem}$ 假设剩余查询成本均匀分布,未建模未来查询的难度与成本差异,容易在尾部误拒或过早放行,可换成带对偶价格/拉格朗日控制的在线预算分配。第三,GPU 利用率读数依赖方法自身的执行模式,若多个控制器共存可能互相干扰甚至振荡,需要平滑化或预测式负载估计。第四,逐查询微批次执行伤害吞吐,作者自己也指出可与生成重叠、跨查询合并决策。第五,把 deferred 查询计为错误虽然强调了覆盖率,但也使方法对比强依赖于 $E_{max}$ 的选取与均摊规则,换一种预算契约可能得到不同排名。
未来方向
作者提出的方向包括:把 ATEST 集成进 vLLM 等推理引擎,或与 GPU 频率控制(throttLL‘eM 类方法)联动,实现“给多少推理量”与“如何运行”的联合管理;设计更丰富的在线成本模型;把多个查询的决策步骤批量化、与生成重叠,以降低短任务的尾延迟与吞吐损失。基于其成果可自然延伸:混合模式——用 ATEST-Calibrated 的离线模型热启动 ATEST-Online 并持续在线修正(论文在讨论中已提及组合可能);把延迟 SLO 与覆盖率显式纳入目标,把“拒绝”改为进入延迟重试队列;扩展到树搜索、长思维链等其他 TTS 形式,并与 Llumnix 类多实例调度结合推广到多 GPU;给成本模型加入负载预测特征使其具备前瞻性;以及在真实集群共存负载下检验 Eocc 计费与实际分账的相关性。
复现评估
复现所需材料基本齐全,但代码开源情况在文中未见说明。模型(Phi-3-mini-4k-instruct、Qwen2.5-3B-Instruct)与数据集(GSM8K、MATH、ARC-Challenge、CommonsenseQA)全部公开;负载注入器(每 0.2 秒周期、占空比 0.25/0.55/0.85 的 FP16 稠密矩阵乘)、采样设置(温度 0.7、top-p 0.95、最多 512 token、固定种子 42)、能耗计量(NVML + Eocc 占用能耗)与实验协议描述详尽且声明冻结后未调参。硬件门槛是一块 A100 或 L40S;服务 2000 条查询约 0.14 小时,成本不高,但完整复现含消融、稳定负载与离线剖析会显著增加 GPU 时长(剖析阶段即需 5.73 小时)。控制器本身实现简单,RLS 与蒙特卡洛模拟各只需几十行代码;不过决策阈值 $\gamma$、安全系数 $\beta$、遗忘因子 $\lambda$ 的具体取值在正文文本中未明确列出,是主要复现摩擦点。总体难度中等。
论文图表
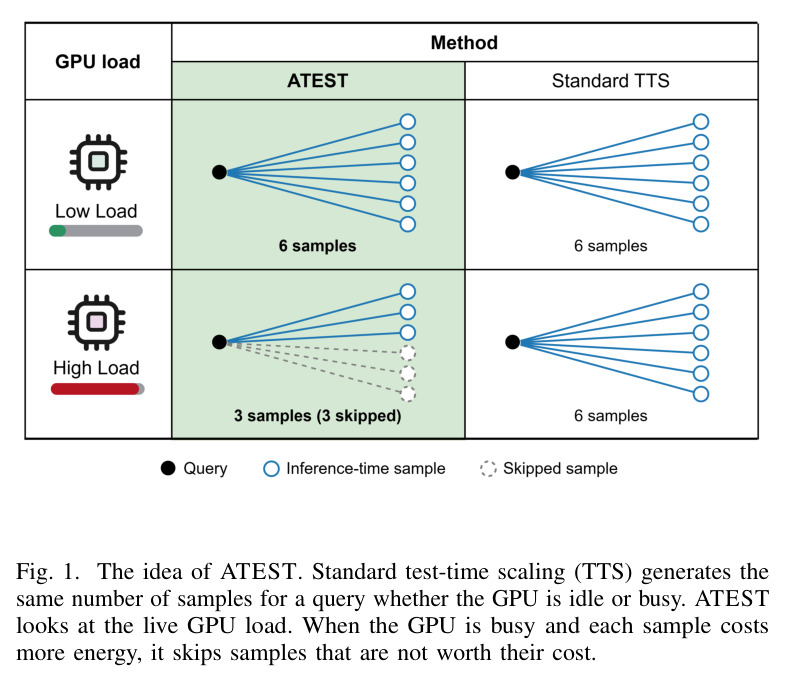
对比标准 TTS 与 ATEST:标准 TTS 无论 GPU 空闲还是繁忙都对查询生成同样数量(4 个)样本;ATEST 读取实时 GPU 负载,当 GPU 繁忙、每个样本能耗抬高时,跳过“不值其成本”的额外样本。
一图看懂论文核心思想——采样成本是随负载变化的实时量,资源感知意味着按当前价格决定要不要再采样。
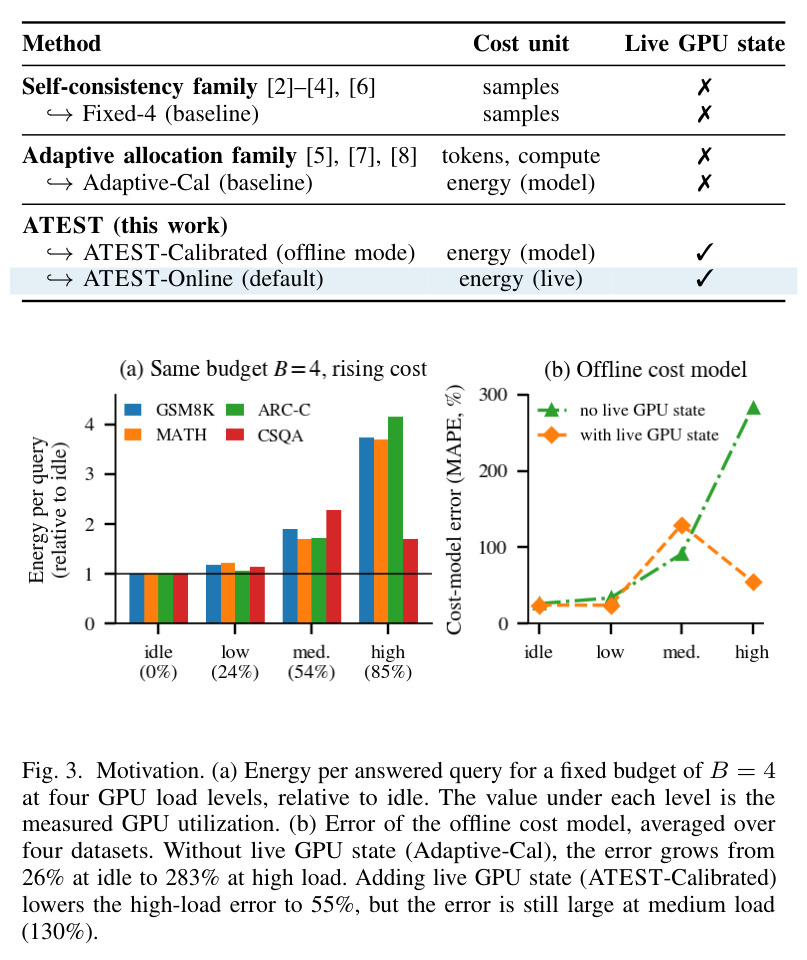
观察 1:固定预算 B=4 时每查询能耗随四级负载(GPU 利用率 0%/24%/54%/85%)相对空闲值上升,高负载下 GSM8K 与 MATH 为 3.7×、ARC-Challenge 达 4.1×。观察 2:离线成本模型预测误差从空闲 26% 恶化到高负载 283%;加入实时 GPU 状态后高负载降到 55%,但中负载仍有 130%。
整篇论文立论的两组关键数据,说明“成本固定”假设与离线成本模型为何在共享 GPU 上失效。
按成本单位与是否使用实时 GPU 状态对 TTS 方法分类:自一致性族用样本数、自适应分配族用 token/算力或离线能耗模型,均不读实时状态;只有 ATEST 两模式使用实时 GPU 状态,其中 ATEST-Online 还使用实时能耗。
一张表界定研究空白:实时 GPU 状态是此前无人使用的决策输入,凸显本文定位。
逐行对比两种模式:价值信号(离线精度模型 vs 实时票局稳定性)、成本模型(离线固定 vs RLS 在线学习)、是否用当前已生成样本、决策时机(采样前一次 vs 逐步)、是否需要数据集剖析、决策分数($\Delta\hat{P}/\Delta\hat{E}$ vs $\Delta U/E_{inc}$)。
两种模式设计取舍的浓缩对照表,直接对应“何时选哪种模式”的工程决策。
四个数据集上四种方法的准确率/拒绝率/平均 B/J per correct/预算使用率:ATEST-Online 全部零拒绝、预算使用 92–100%,准确率 0.626/0.426/0.794/0.716 全部最高或并列最高;Fixed-4 与 Adaptive-Cal 在长答案数据集上拒绝约半数查询,且各有一次预算超支。
论文主结果表,支撑 Q1 的全部核心结论,必须精读。
剖析阶段:ATEST-Calibrated 需 5.73 GPU 小时 / 7.16 MJ / 176,000 个样本,ATEST-Online 为 0。服务 2000 条查询两者都约 0.14 小时 / 0.15 MJ,但 Online 回答全部 2000 条、多 65 个正确答案。总计 42× GPU 时间、48× 能耗差距。
量化“免离线剖析”的实际价值,是 Q3 成本结论的核心证据。
三变体对比:Full-HW(GPU 状态 + 在线学习)有负载响应;noHW-State(隐藏 GPU 状态但保留在线学习)仍随负载调整预算;ReasoningOnly-Strict(两者皆无)在所有负载下固定平均 B=3.12、无负载响应。
因果归因实验:证明负载适应来自在线成本学习而非预算耗尽,是本文评估方法学的亮点。
ATEST-Online 的 p95 延迟在 GSM8K 为 1.081 s(对 Calibrated 0.509 s)、CSQA 0.180 s(对 0.086 s);吞吐在 CSQA 16.6 对 29.7 QPS;在线成本模型能耗 MAPE 分别为 GSM8K 23%、MATH 22%、ARC-C 134%、CSQA 112%。
诚实给出在线控制的价格与成本模型精度,理解方法代价与适用场景必看。
L40S+Phi-3 与 L40S+Qwen2.5-3B 上 ATEST-Online 对 Fixed-4:八个新设置全部零拒绝(预算 92–99.5%);Phi-3 GSM8K 0.638 对 0.506、MATH 0.448 对 0.380;Qwen2.5-3B GSM8K 0.280 对 0.138(翻倍)、CSQA 0.564 对 0.414;八个设置中七个 J/correct 更低。
泛化性验证:结论不依赖特定 GPU 型号或模型,支撑论文外部有效性。
无注入负载时:GSM8K 上 ATEST-Calibrated 0.686 高于 ATEST-Online 0.632,Fixed-4 也有 0.668 且在三个数据集上 J/correct 最低;两模式在 ARC-C 上接近(0.792 对 0.794)。
界定在线模式的优势边界:稳定负载下离线标定甚至固定预算仍难以打败,是 Q6 结论的证据。