Lab2Sim:将真实实验视频转化为可交互的虚拟实验 Lab2Sim: Turning Real-World Experiment Videos into Interactive Virtual Experiments
提出Lab2Sim基准与EduVideo2Code框架,把实验视频变成可交互的虚拟实验
前置知识
视频到代码生成
让多模态大模型观看截图、设计稿、界面录像或视频后直接产出可运行的前端网页代码。早期工作只复现静态外观,随后基准开始把生成的页面放进浏览器实际执行、模拟点击交互,用运行时行为检验功能正确性。它考察的不只是代码能否跑通,还包括页面在交互后呈现的状态是否符合输入所暗示的内容。
本文的直接对话对象:EduVideo2Code 就在这条技术线上,但把输入从界面录像换成了真实世界的实验视频,评测目标从界面转移换成了科学流程。
状态机
把系统行为形式化为三元组 $M = (S, A, \Phi)$:状态集合 $S$ 给每个被追踪对象的属性赋值(如 flask.solution.color = 红色);操作集合 $A$ 中每个操作实现一步实验;前置条件集合 $\Phi$ 规定操作 $a_k$ 只有在条件满足时才把实验从前置状态 $x^-_k$ 推到后置状态 $x^+_k$,不满足则阻断操作并向学习者反馈。
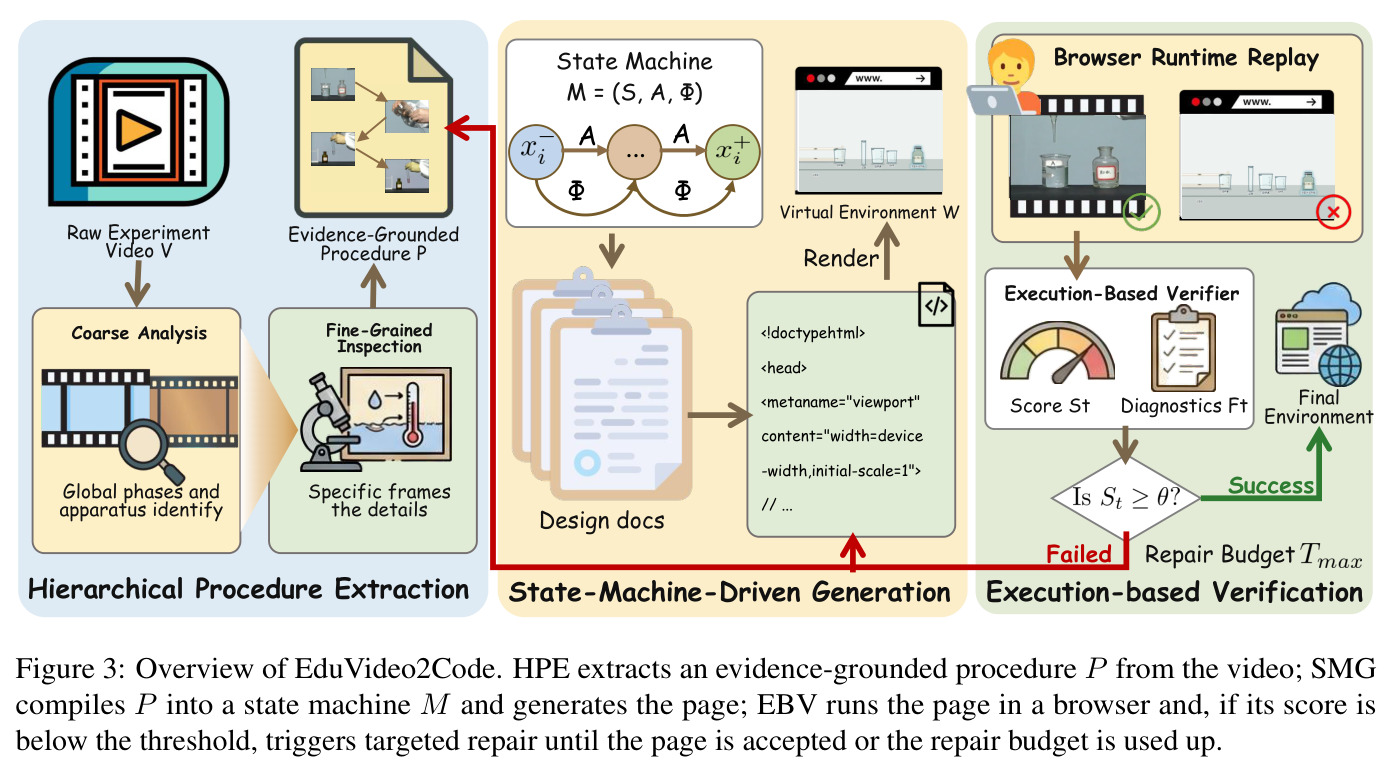
它是 EduVideo2Code 的核心中间表示:把从视频里抽出的实验逻辑显式化,让每一步、每个前置条件都成为可检查、可修复的独立单元。
基于执行的验证
不靠人工或静态检查,而是把生成的页面放进浏览器里真实运行:执行标注步骤、尝试违规操作、逐步截图对比,用运行时行为打分并产出诊断信息,再反馈给生成端做定向修复。典型形态是「生成-验证-修复」闭环,设一个分数阈值 $\theta$ 决定页面是否被接受。
论文用浏览器回放对照视频证据来检查保真度与可操作性,消融显示去掉这一步后 PCC 掉约 16 分、OFR 反而恶化,是分数提升的关键一环。
证据接地标注
给每条标注(装置、步骤、前置条件、状态转移)绑定可追溯的视频帧或时间段,并打上证据等级标签:video_visible 表示视频画面直接可见,apparatus_inferred 表示由可见装置和上下文推断,domain 表示来自教科书知识而画面未展示。没有视觉证据、又无正当推断或教材依据的声明会被直接丢弃。
保证基准里每条评分项都能回溯到画面证据,是 Lab2Sim 区别于「凭印象标注」的数据集、可信度的根本来源。
评分量规
把黄金规范里的装置、步骤、前置条件、状态转移用固定模板逐条转成可自动核验的检查项,另加违规探针(跳过前置步骤、打乱两步顺序、超剂量、对错误对象操作)来检验页面是否正确阻断违规操作。本文共 11,881 条,每条归属四个评测维度之一,并保留指向源字段和视频证据的指针。
读懂 AF/PE/PCC/STF 四个指标到底在测什么、怎么算分,必须先理解评分量规的构成和违规探针的设计。
研究动机
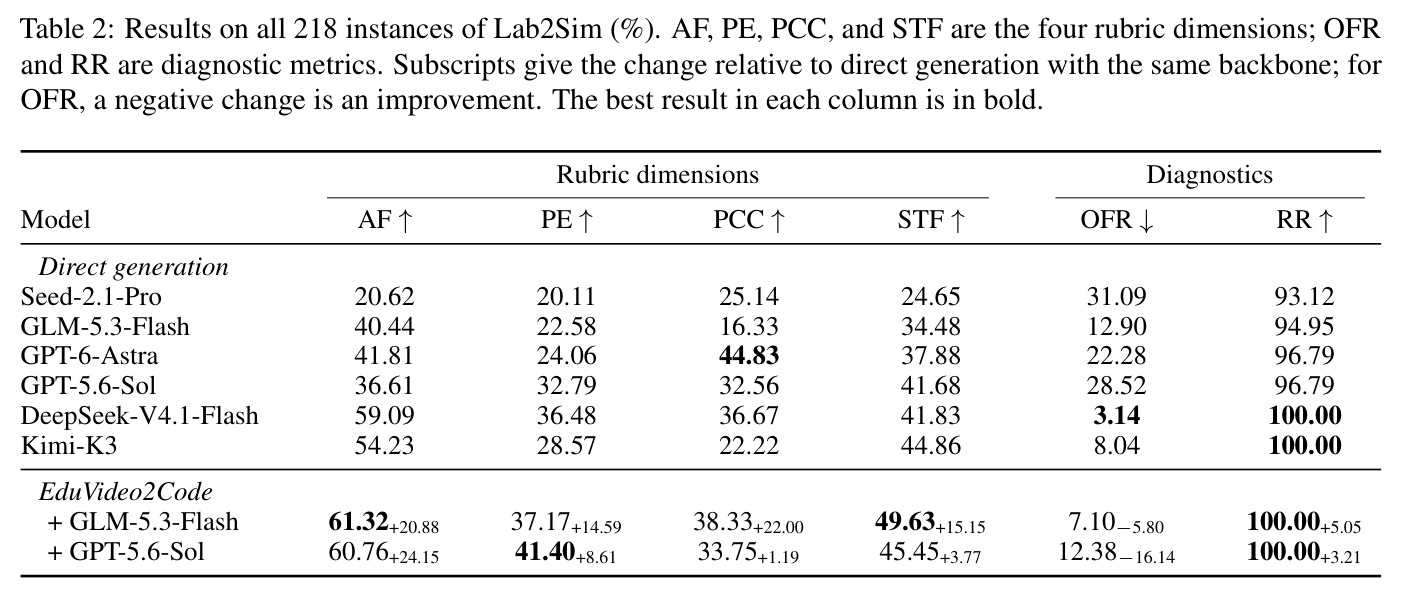
科学实验视频是最常见的实验学习材料,但学习者只能旁观、不能动手。把它自动转成浏览器里可操作的虚拟实验,需要同时满足两种能力:保真度(复现视频中的装置、步骤和可见状态变化)与可操作性(每一步能在正确前置条件下执行、并观察到预期结果)。现有工作各只解决了一半:前端代码生成方法能从截图、设计稿或界面录像重建可交互网页,近期基准也开始用浏览器执行检验功能正确性,但重建界面转移并不需要推断实验材料的物理状态,也不涉及实验室流程约束;科学视频理解方法能识别实验事件、推理现象,却只输出文本答案或解释,不产出可操作的环境。直接让多模态模型从视频生成页面时问题更明显:论文测了六个模型,虽然超过 93% 的页面都能运行,但没有一个模型的装置保真度(AF)达到 60%,最低的 Seed-2.1-Pro 只有 20.62 分。「页面能跑」和「实验忠实」之间存在巨大鸿沟,而这正是本文要解决的核心问题。
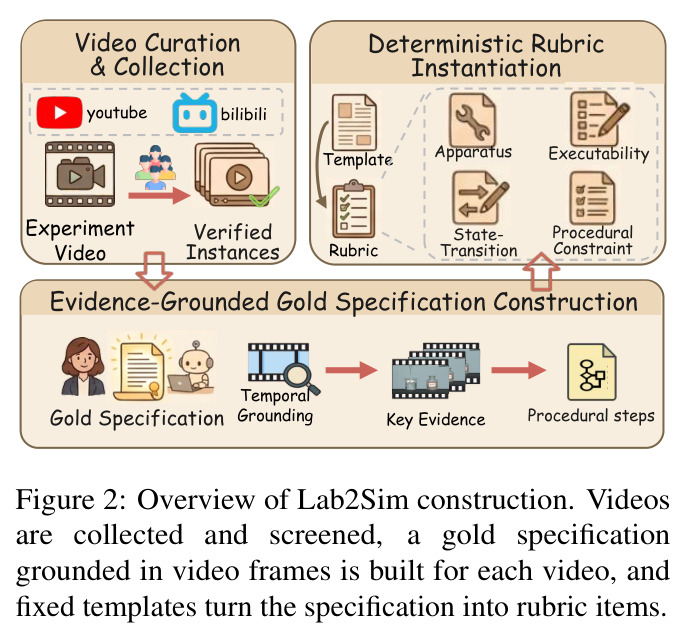
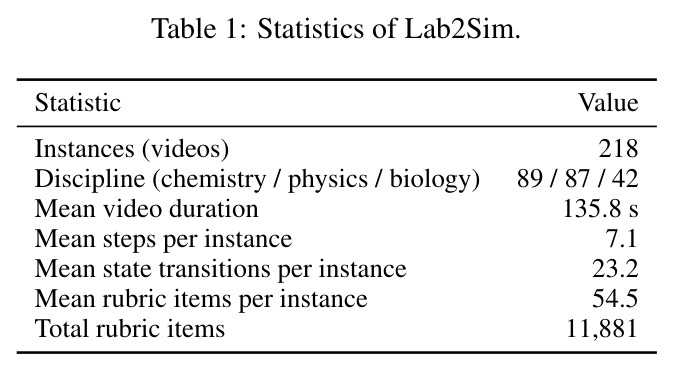
本文的目标是本文的目标是把「看实验视频」升级为「做虚拟实验」:给定一段真实的化学、物理或生物实验视频和一句生成指令,系统输出一个浏览器里可运行的网页——页面要包含视频中的装置、支持演示的每一步、强制执行各步的前置条件,并展示步骤导致的状态变化。为了客观衡量这个任务,作者构建了 Lab2Sim 基准:从 Bilibili 和 YouTube 的 500 多个候选中人工筛出 218 个实验视频,每个视频配一份逐帧核对过的证据接地的黄金规范,再用固定模板转成 11,881 条评分项(平均每个实例 54.5 条),从装置保真度(AF)、步骤执行(PE)、流程约束遵从(PCC)、状态转移保真度(STF)四个维度评分。在此基础上提出 EduVideo2Code 框架,目标是在两个骨干模型上都显著提升全部四个维度,尤其是把装置保真度拉高 20 分以上。
与已有工作不同的是,本文的独特切入有三个被忽视的点。第一,任务重定义:以往 video-to-code 类工作(从界面录像恢复状态、动作和转移)处理的是界面自身的行为,不需要理解物理世界;Lab2Sim 首次要求系统从物理演示中推断实验状态机,并把页面行为对照视频证据逐项检查。第二,中间表示:直接从视频生成代码会把实验逻辑、场景布局和交互代码混在一起,出错难以定位;作者主张先把流程编译成显式状态机 $M = (S, A, \Phi)$,让每一步的前置条件和状态转移成为独立可检查的对象,而不是隐含在代码里。第三,验证方式:不只问「页面能不能跑」,而是在浏览器里回放演示流程、尝试违规操作、逐步把截图和状态摘要与视频证据对比,用执行结果驱动定向修复。这个「编译-验证-修复」组合正是弥合可运行性与保真度之间鸿沟的关键切入点。
核心方法
直觉上,EduVideo2Code 像一条编译器流水线:把实验视频当作「源代码」,先解析出实验流程(词法/语法分析),再编译成状态机(中间表示),最后跑一遍生成的页面并对照视频证据修复(链接与调试)。具体分三个阶段。层级化流程抽取(HPE)对视频做由粗到细的两遍分析,输出每一步都引用支持帧的实验流程 $P$;状态机驱动生成(SMG)把 $P$ 编译成状态机 $M = (S, A, \Phi)$ 并生成网页,同时产出三份设计文档(科学文档、布局文档、素材清单);基于执行的验证(EBV)由一个独立于生成器的验证器在沙箱 Chromium(分辨率 2560×1440)里运行页面,返回分数 $s_t \in [0,1]$ 和诊断反馈 $F_t$,若 $s_t \geq \theta$(阈值 $\theta = 0.8$)则接受页面,否则按诊断做定向修复,修复预算 $T_{max} = 10$ 轮。实验中两个骨干模型下的页面平均经历 5.3 轮修复才被接受或耗尽预算,最终两个变体的可运行率都达到 100%。
核心创新是把实验逻辑从代码中剥离出来,变成显式、可验证、有视频证据支撑的状态机。状态 $S$ 给每个被追踪对象的属性赋值(例如 flask.solution.color),操作 $A$ 实现为直接操纵手势(拖拽、倾倒、点燃),前置条件 $\Phi$ 不满足时页面阻断操作并给学习者反馈——学习者是在「做实验」,而不是播放一段固定动画。与已有方法的本质区别有三:其一,直接生成方法一步从视频映射到代码,实验逻辑隐式散落在代码里,错了难以定位;本文的状态机让每一步、每个前置条件、每次状态转移都成为独立可检查、可修复的单元。其二,验证器与生成器使用同一骨干模型但在完全独立的会话中运行,只能看到页面的运行时行为(截图加状态摘要)和视频证据,看不到生成历史,以此降低自我一致性偏差。其三,流程 $P$ 中每一步都必须引用支持帧,视频里没出现的步骤很难被编造进流程。消融实验印证了三阶段相互依赖:去掉 SMG 后 STF 掉 12.13 分,去掉 HPE 或 EBV 后 PCC 各掉约 16 分,单项损失之和超过相对直接生成的总增益。
方法步骤详情
完整流水线分四步。第一步,视频采集与筛选:从 Bilibili/YouTube 收集 500 多个候选,人工保留 218 个(化学 89、物理 87、生物 42),标准是流程、装置和状态转移都能从画面可靠识别,排除重复、低于 720p 或只讲结果不演示过程的视频。第二步,证据接地的黄金规范标注:GLM-5.3 系列模型先粗看全片列出候选步骤与状态转移,再在歧义片段上用更密采样和高清帧精修事件边界;每步记录目标对象、固定词表中的类型(如 pour、heat)、时间段和前后状态;前置条件附脚本测试,状态转移记为对象属性更新(如 flask.solution.color);每条标注挂 video_visible、apparatus_inferred、domain 证据标签,人工约 13 分钟/视频核对。第三步,量规实例化:固定模板把规范转成装置身份、步骤执行、前置约束、状态转移四类检查项,另加跳步、乱序、超剂量、错对象四类违规探针,共 11,881 条。第四步,生成与评估:HPE→SMG→EBV 产出页面后,评估代理(Qwen-3.8-Max)读源码定位控件、执行步骤并以 30 FPS 录屏,裁判(Gemini-3.8-Flash)对照视频证据打分;裁判与盲评人在 50 个抽样案例上的 Cohen's $\kappa = 0.79$。
技术新颖性
与最近邻工作的差异体现在三处。相对前端代码生成基准(从截图、草图或界面录像重建页面,用浏览器执行评功能正确性):本文的输入是物理世界的实验演示,评测的不是界面转移而是科学流程约束——系统必须推断材料的物理状态并强制前置条件。相对科学视频理解基准(事件识别、问答、文本解释):本文要求输出可交互环境,学习者的操作能真实改变页面状态,而非产生文字答案。相对从物理演示合成程序或环境的机器人类工作:那类工作的目标行为要么直接由接口展示、要么不受科学流程支配,而 EduVideo2Code 从物理演示推断实验状态机,并用浏览器回放对照视频证据检查页面。评测协议上也有新意:每条量规项保留指向源字段和视频证据的指针,可完整回溯到画面;按证据标签区分主分数与参考分数——主分数只计 video_visible 元素和违规探针,apparatus_inferred 与 domain 类条目保留在发布的量规中但不计入主分数,避免把教科书知识当视频事实计分;AF/PE/PCC/STF 四维度分开报告,也是对以往单一总分评测的改进。
实验结果
论文给出三个主要发现。发现一:可运行率几乎不说明保真度。八个系统的可运行率 RR 全部超过 93%,DeepSeek-V4.1-Flash 和 Kimi-K3 达到 100%,但装置保真度 AF 从 20.62(Seed-2.1-Pro)到 61.32 差距巨大,没有直接生成模型达到 60%;PE 只有 20.11 到 41.40。发现二:画装置容易、跑流程难。所有系统的 AF 都高于 PE(如 GLM-5.3-Flash AF 40.44 而 PE 仅 22.58),且 OFR 与 PCC 解耦——Kimi-K3 的 OFR 低至 8.04% 但 PCC 只有 22.22%,GPT-6-Astra 的 PCC 最高 44.83% 却有 22.28% 的 OFR,说明「有可见反应」和「正确执行并强制前置条件」是两回事。发现三:EduVideo2Code 在两个骨干上全面改进。GLM-5.3-Flash 变体 AF 61.32(+20.88)、PE 37.17(+14.59)、PCC 38.33(+22.00)、STF 49.63(+15.15)、RR 100%、OFR 7.10(−5.80);GPT-5.6-Sol 变体 AF 60.76(+24.15)、PE 41.40(+8.61)、OFR 12.38(−16.14),但 PCC 仅 33.75(+1.19),仍落后直接生成的 GPT-6-Astra(44.83)。消融(GLM 骨干):去掉 HPE 掉分最狠(AF −13.08、PE −13.64、PCC −16.30);去掉 SMG 主要伤 STF(−12.13);去掉 EBV 后 OFR 升到 14.84,比直接生成的 12.90 还差。案例分析总结四种失败模式:空白渲染、实验替换(氨扩散被做成高锰酸钾扩散)、装置错配、操作不可执行。
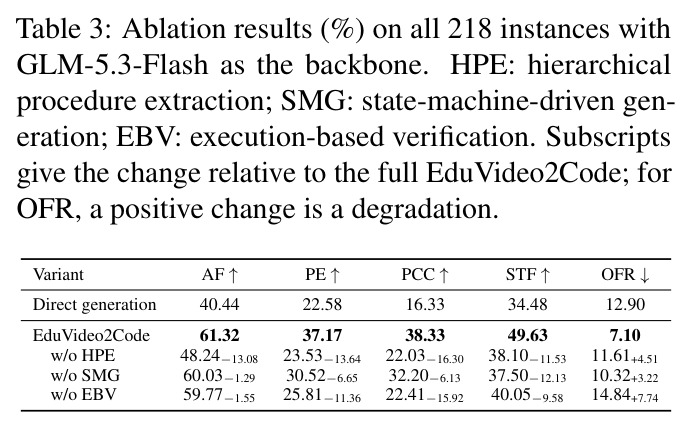
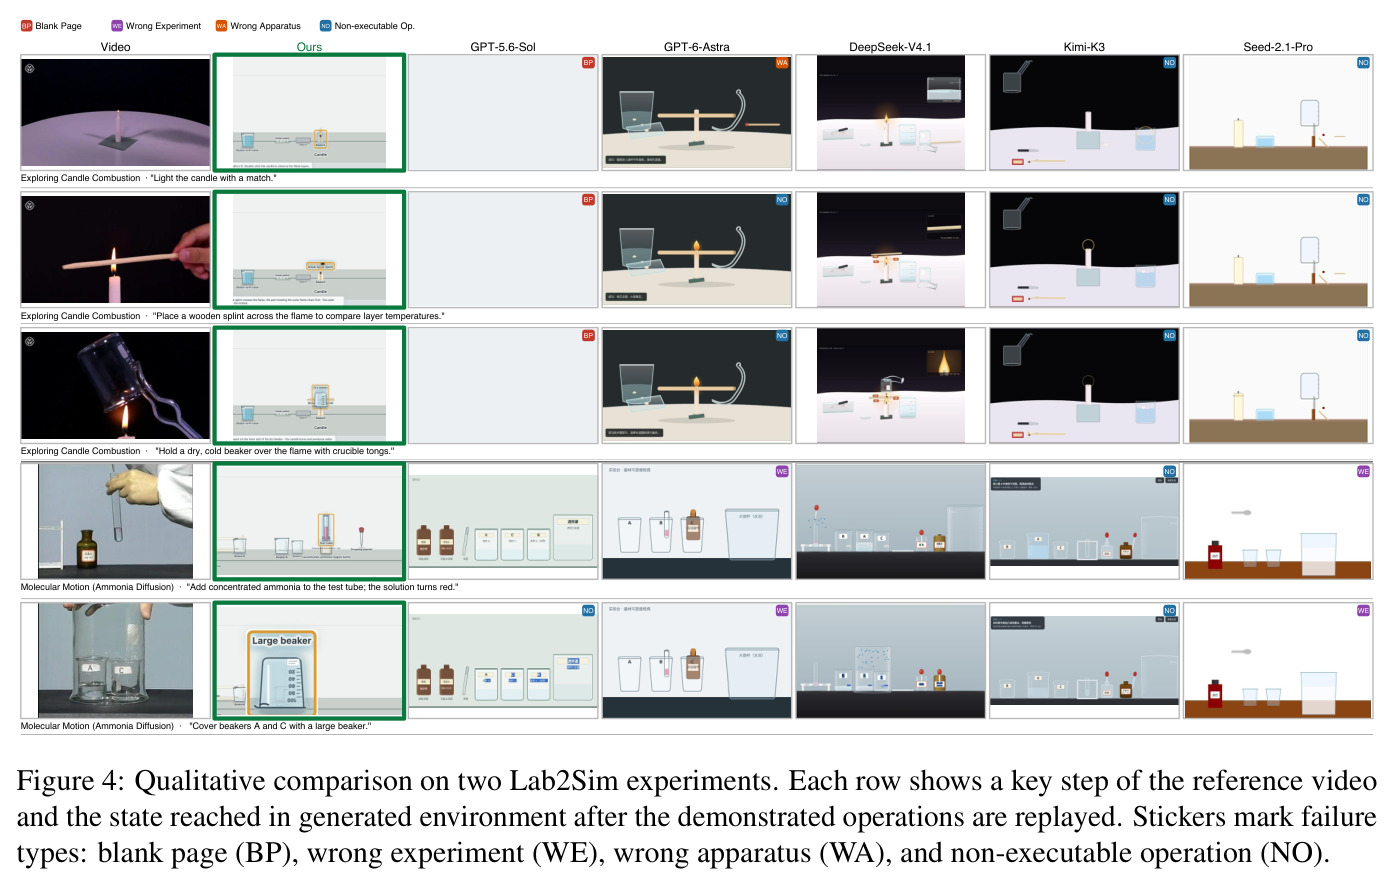
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 装置保真度(AF):页面是否呈现并正确识别实验装置 | 量规通过率(%) | 61.32(EduVideo2Code + GLM-5.3-Flash)/ 60.76(+ GPT-5.6-Sol) | 直接生成最佳 59.09(DeepSeek-V4.1-Flash);同骨干直接生成分别为 40.44 与 36.61 | 相对同骨干直接生成 +20.88 / +24.15,首次越过 60 分 |
| 步骤执行(PE):每个标注步骤能否在正确对象上执行并产生指定结果 | 量规通过率(%) | 41.40(+ GPT-5.6-Sol)/ 37.17(+ GLM-5.3-Flash) | 直接生成最佳 36.48(DeepSeek-V4.1-Flash);同骨干直接生成为 32.79 与 22.58 | 相对同骨干直接生成 +8.61 / +14.59 |
| 流程约束遵从(PCC):页面是否阻断前置条件不满足的操作并给出反馈 | 量规通过率(%,含违规探针) | 38.33(+ GLM-5.3-Flash)/ 33.75(+ GPT-5.6-Sol) | 直接生成最佳 44.83(GPT-6-Astra);同骨干直接生成为 16.33 与 32.56 | 相对同骨干直接生成 +22.00 / +1.19,收益最不稳定 |
| 状态转移保真度(STF):初始状态与每步后状态是否与视频一致 | 量规通过率(%) | 49.63(+ GLM-5.3-Flash)/ 45.45(+ GPT-5.6-Sol) | 直接生成最佳 44.86(Kimi-K3);同骨干直接生成为 34.48 与 41.68 | 相对同骨干直接生成 +15.15 / +3.77 |
| 操作失败率(OFR):评估代理执行标注步骤失败的比率(越低越好) | 失败步骤占比(%) | 7.10(+ GLM-5.3-Flash)/ 12.38(+ GPT-5.6-Sol) | 直接生成最低 3.14(DeepSeek-V4.1-Flash);同骨干直接生成为 12.90 与 28.52 | 相对同骨干直接生成 −5.80 / −16.14 |
| 可运行率(RR):页面能否在浏览器加载并响应交互 | 可运行页面占比(%) | 100.00(两个变体) | 直接生成 93.12–100.00(DeepSeek-V4.1-Flash 与 Kimi-K3 已达 100) | GLM 骨干 +5.05、GPT-5.6-Sol 骨干 +3.21,但所有系统 RR 均 ≥93%,说明 RR 区分度有限 |
局限与改进
作者承认的局限:评测只覆盖视频演示过的行为,科学上预期但视频未演示的行为不在评分范围内;部分打分依赖模型裁判,与人类的一致性只在 50 个抽样案例上测得 Cohen's $\kappa = 0.79$,未在全基准上验证;基准只有 218 个视频、三个学科、两个平台,不能代表所有语言、地区和实验室条件;EduVideo2Code 因验证修复轮次(平均 5.3 轮)比直接生成需要多得多的模型调用;只用自动指标评估,没有研究生成环境对学习者的实际效果,课堂使用前需要教师审核。我的补充观察:视频平均时长仅 135.8 秒,长流程、多装置的复杂实验未被覆盖;验证器与生成器共用同一骨干模型,可能放过同类风格的错误;状态摘要以文本对比为主,烧杯壁凝结这类微妙物理现象只能靠文字而非视觉呈现,STF 判定可能偏宽松;整个框架假定输出是单页 HTML 应用,无法处理需要跨页面或多窗口协作的复杂实验。
独立分析的弱点
第一,裁判与验证器可靠性:模型裁判与人类的一致性仅在 50 例上测得 $\kappa = 0.79$,且验证器与生成器共用同一骨干模型、以截图加状态摘要做判断,容易放过同类风格错误。改进方向:在全基准上做人工一致性校验,并用不同厂商模型交叉验证。第二,PCC 提升不稳定:GPT-5.6-Sol 骨干下 PCC 仅提升 1.19 分,甚至低于直接生成的 GPT-6-Astra(44.83);消融也显示状态机本身只贡献 6.13 分的 PCC,强制执行主要靠 HPE 和 EBV。改进方向:把前置条件直接编译成可执行的断言脚本,而非依赖模型在浏览器里主观判断。第三,成本高:平均 5.3 轮修复,每轮含视频、截图、浏览器交互的多次多模态调用,218 个实例就是数千次调用,大规模部署困难。改进方向:用轻量模型先做错误过滤,只对可疑页面调用大模型修复。第四,视觉保真度量的盲区:AF 明确不评空间布局,微妙现象靠文本兜底,页面可能「语义正确但视觉粗糙」。改进方向:引入像素级对比或可微渲染指标作为辅助。第五,单页假设限制了多工位、协作型复杂实验的表达,可考虑多页面或场景图中间表示。
未来方向
作者提出的方向包括:扩充基准的学科、语言与地区覆盖;把评估从自动指标扩展到对学习者学习效果的真实研究;在课堂使用前引入教师审核流程。基于本文成果可延伸的方向:把状态机与物理仿真引擎(流体、光学、反应动力学)结合,让凝结、焰色等微妙现象从文本描述升级为真实视觉渲染;研究生成与验证使用不同厂商模型的跨模型验证,能否进一步消除自我一致性偏差;把违规探针思路推广为自动生成的对抗性测试用例,检验页面在未见过的操作序列下的鲁棒性;将「视频→可交互环境」范式迁移到其他演示性任务,如编程演示、手术操作、乐器演奏;纳入语音讲解通道,把旁白中的领域知识也纳入证据体系并单独标注;结合学习者操作错误数据做个性化,动态调整实验难度与提示时机。
复现评估
论文承诺在项目页 https://black1948.github.io/lab2sim 开源数据集与代码,包括 218 个视频、证据接地的黄金规范和 11,881 条评分项(每条含指向源字段与视频证据的指针)。复现的主要依赖:一个多模态骨干模型 API(论文用 GLM-5.3-Flash 或 GPT-5.6-Sol)、沙箱 Chromium 浏览器(2560×1440)、评估代理 Qwen-3.8-Max 与裁判 Gemini-3.8-Flash 的 API。计算成本是 API 调用而非训练:每个页面平均 5.3 轮验证修复,218 个实例估算需数千次多模态请求。数据标注方面人工核对约 13 分钟/视频,218 个视频约需 47 小时人工投入,扩展到新学科需类似成本。工程难度中等:难点在浏览器自动化(控件定位、30 FPS 录屏)、帧采样与事件边界对齐、量规脚本断言的实现;三个阶段输入输出定义清晰,按论文复现可行,但评估协议细节(附录 D)对最终分数影响大,需仔细对齐。
论文图表
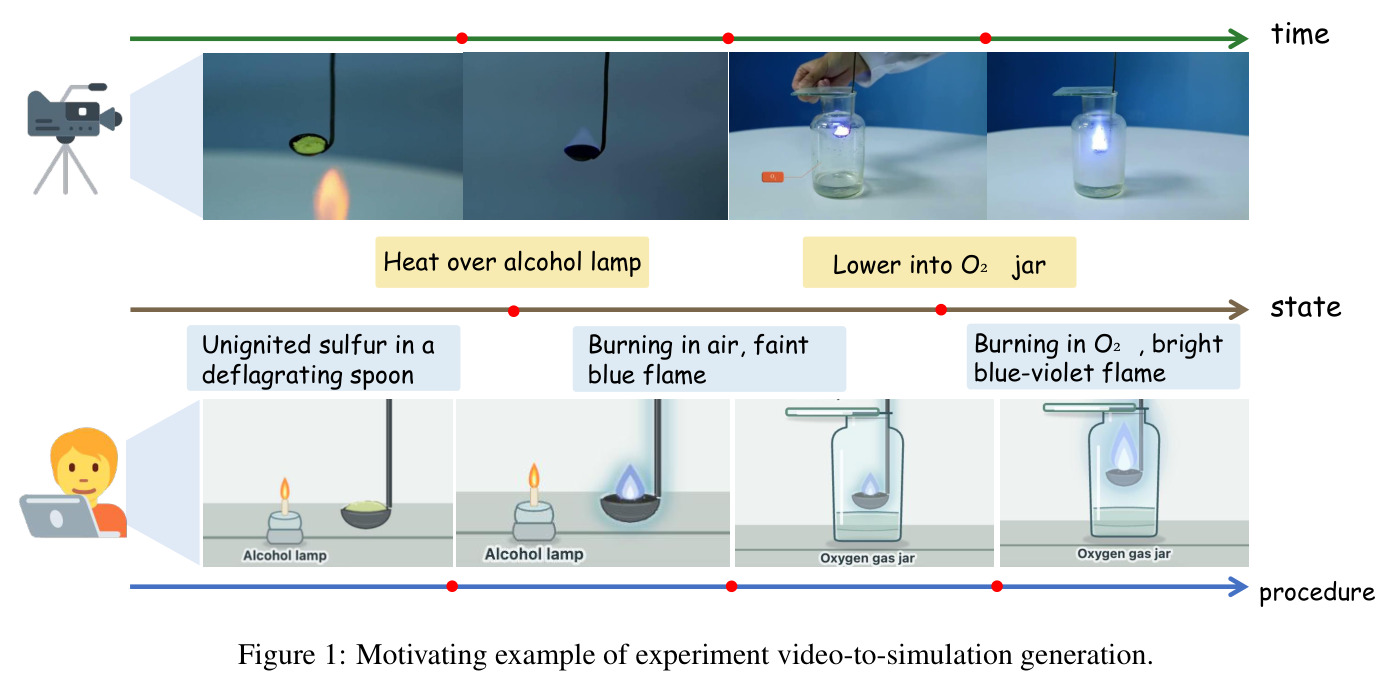
以硫的燃烧实验为例,沿时间轴展示三个状态:未点燃的硫置于燃烧匙中、在空气中燃烧发出淡蓝色火焰、伸入氧气瓶后发出明亮的蓝紫色火焰。图上标注了 time(时间)、state(状态)和 procedure(流程)三条线索。
一图定义任务:把实验视频变成虚拟实验不只是还原画面,而是要在可交互页面里复现带前置条件(先点燃、再伸入氧气瓶)的状态转移序列,这正是保真度加可操作性双重要求的直观呈现。