Code2Video-Compass:覆盖文本/图像/视频三种输入的通用代码生成视频评测基准 Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
统一评测 T2V/I2V/V2V 代码生视频:2104 任务、17 项指标、15 个 MLLM
前置知识
多模态大语言模型(MLLM)
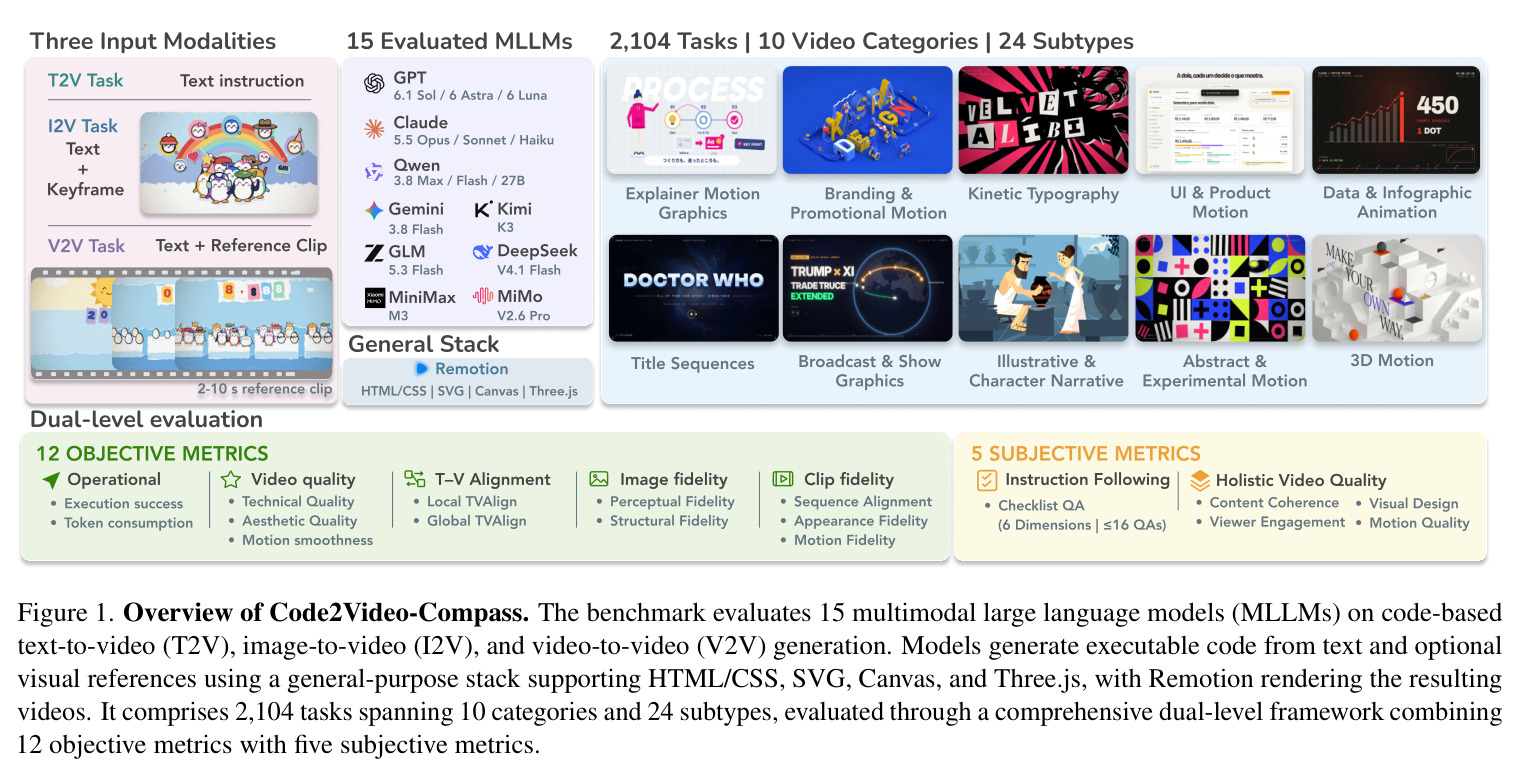
能同时处理文本、图像、视频等多种模态输入并生成文本或代码输出的大语言模型,如 GPT、Claude、Gemini 等。它们通过视觉编码器把图像或视频帧转成 token,与文本一起送入 Transformer,从而“看懂”参考图或片段并按要求写代码。本文评测 15 个模型,来自 9 个家族,覆盖专有与开源权重两类。
本文的全部被评测对象都是 MLLM,其视觉理解与长代码生成能力直接决定基准上的得分,读表前必须知道这些模型是什么。
代码生成视频与 Remotion 渲染
一种程序化视频生成范式:模型不直接输出像素,而是生成 HTML/CSS、SVG、Canvas、Three.js 等网页技术栈代码,由 Remotion(基于 React 的编程式视频渲染框架)逐帧渲染合成完整视频。相比扩散式直接生成,它支持精细控制、定点编辑和组件复用。
这是基准的核心任务形式。理解“模型要产出的是可执行的项目代码”这一点,才能理解执行成功率、token 消耗等操作性指标为何重要。
T2V / I2V / V2V 三种输入设定
T2V 仅凭自包含文本指令生成完整视频;I2V 额外给一张参考关键帧,模型要理解其视觉内容、决定出现时机并用代码重建整合;V2V 给 2–10 秒参考片段,要求把其外观、运动和事件序列重建进完整视频的合适位置,而非直接回放。
统一覆盖这三种模态正是本文相对已有基准的主要贡献,配对任务设计让三种设定的结果可以直接对照分析。
MLLM-as-a-Judge 主观评估
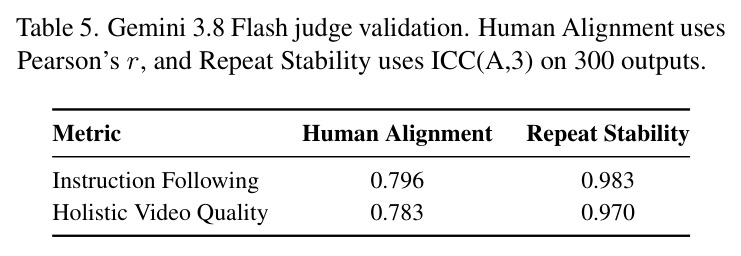
用一个多模态大模型(本文用 Gemini 3.8 Flash)代替人类给生成结果打分的评估协议。本文用它检查逐任务 QA 清单的通过率(IF),并对内容连贯性、视觉设计、运动质量、观众吸引力四维打 1–5 分。作者用 300 个输出、每个评 3 次验证:与三位人类评分者的 Pearson $r$ 达 0.796/0.783。
5 项主观指标全部来自该协议,理解它的校准方式和可信度证据,才能判断主榜上那些 3–4 分的数字意味着什么。
参考保真度量工具链(DINOv3 / SSIM / DTW / CoTracker3)
衡量生成视频是否忠实重建参考内容的一组工具:DINOv3 提取帧嵌入,用于在全视频中检索最近匹配帧和子序列动态时间规整(DTW)对齐;SSIM 与 DreamSim 分别测结构相似与外观相似;CoTracker3 追踪点轨迹,经时空归一化后双向最优匹配,比较位移方向与幅度得到运动保真 MF。
I2V/V2V 的核心指标 PF/SF/SA/AF/MF 全部建立在这些工具之上,是读懂主榜保真列数值的前提。
三维度复杂度体系
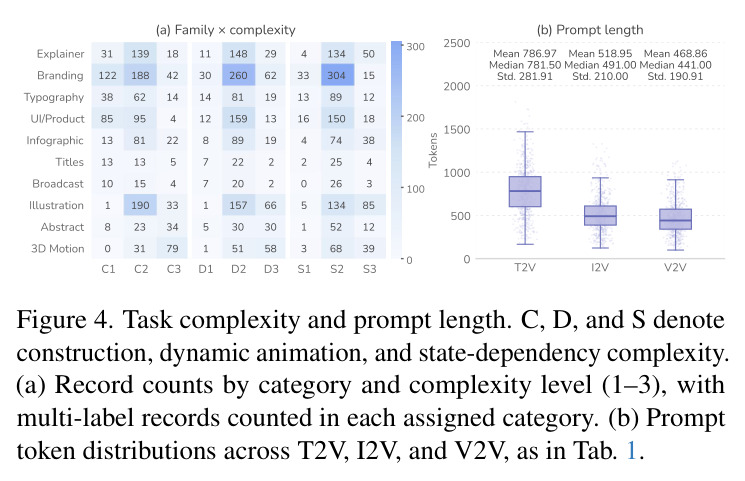
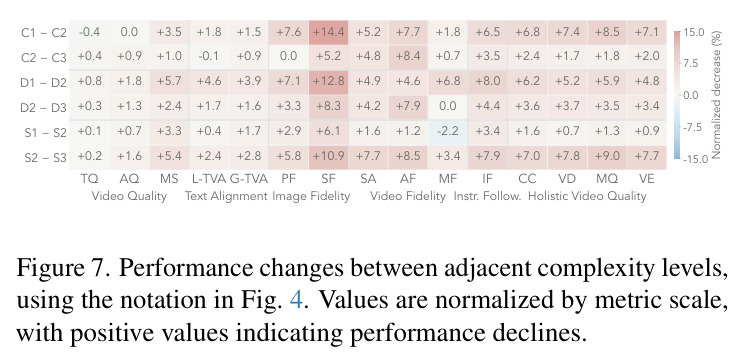
作者定义的三个互补难度维度,各分三级:构造复杂度(标准组件组合→自定义几何与细节结构→程序化/模拟系统)、动态动画复杂度(分阶段序列→跨元素跨场景协调→复杂并发运动)、状态依赖复杂度(相邻阶段一致→间隔阶段一致→跨多次变化的长程依赖)。
论文关于“复杂度越高表现越差”的核心分析结论(如 SF 从 L1 到 L2 下降 14.38%)都建立在这套标注上,不先理解它就看不懂 Figure 7。
研究动机
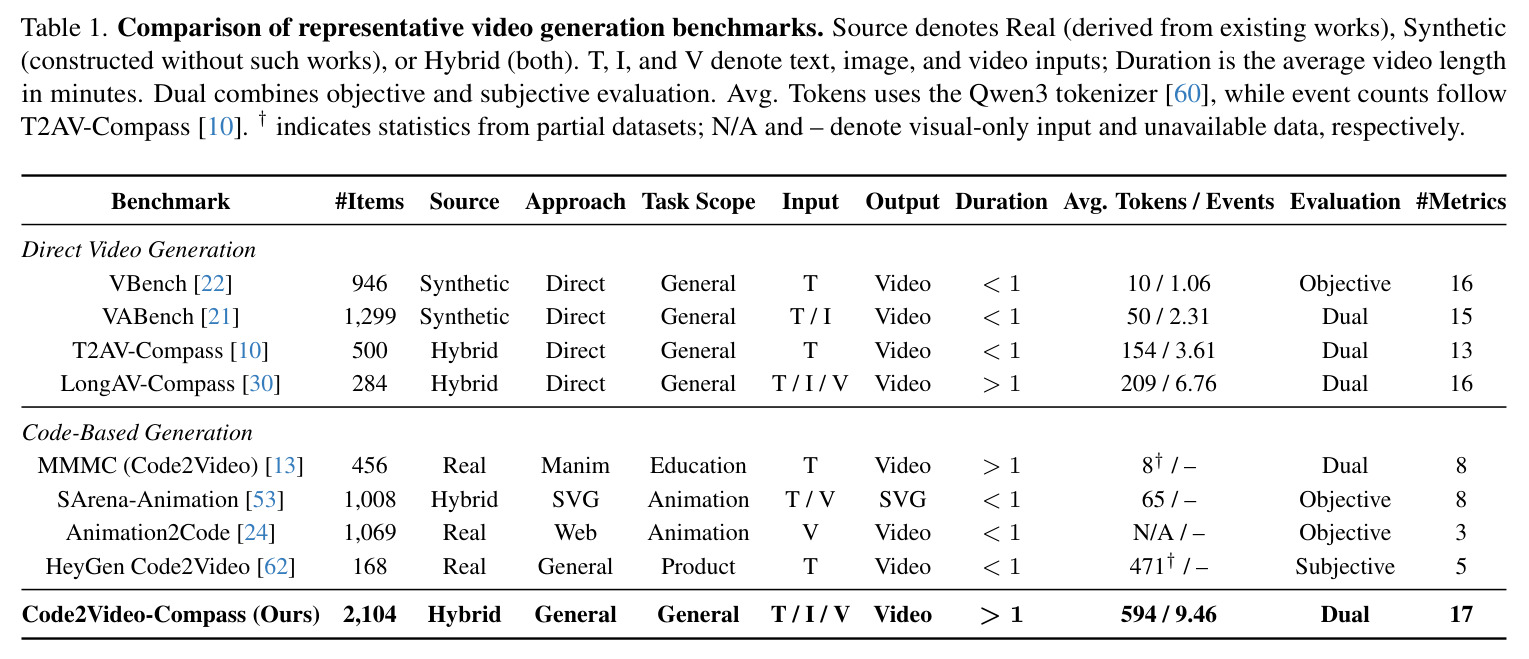
基于代码的视频生成要求 MLLM 把视觉与时间需求翻译成可执行程序,需要世界知识、空间推理、创意判断和复杂编程的综合能力,但现有评测严重缺位:MMMC 只覆盖 Manim 教育视频(456 题),SArena-Animation 只做 SVG 动画(1,008 题)且仅客观指标,Animation2Code 只接受视频输入、仅 3 个指标,HeyGen Code2Video Benchmark 只有 168 个短产品动效任务且只做主观评价。相比之下,直接视频生成基准(VBench 946 条、T2AV-Compass 500 条等)虽评估体系成熟,却完全不评代码执行可靠性。这导致“生成完整视频”这一真实能力横跨任务类型、输入模态与难度时究竟如何,缺乏可横向比较的量化证据。
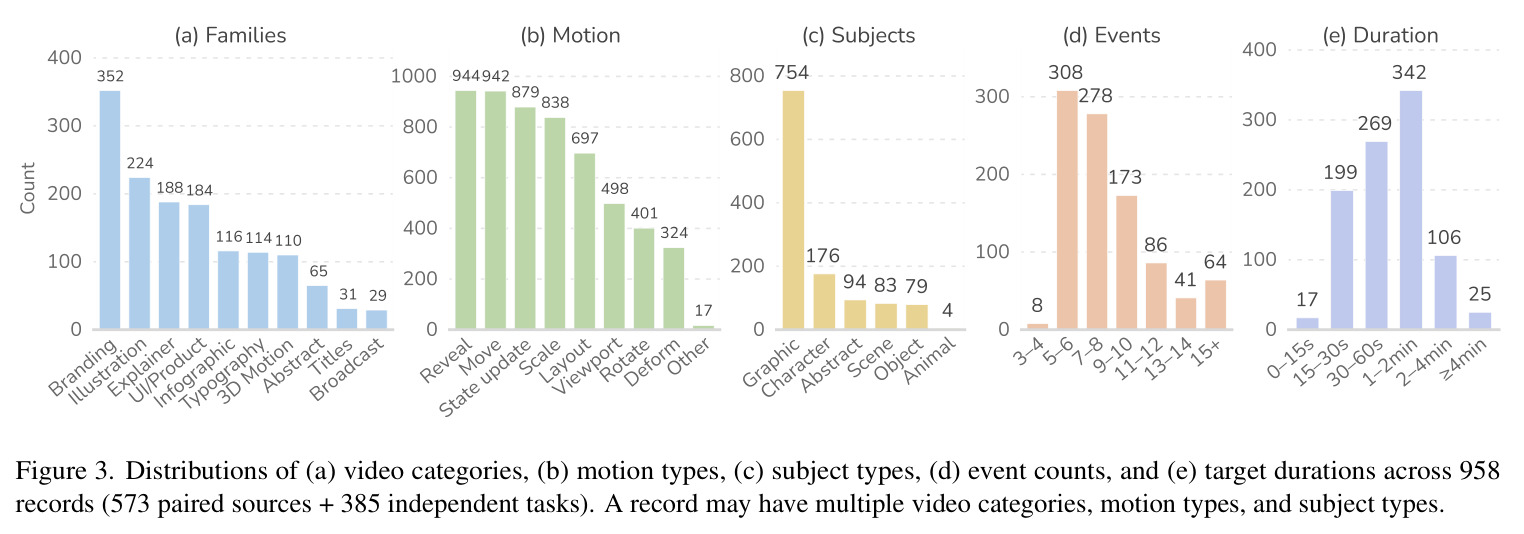
本文的目标是本文要构建一个通用的代码生成视频基准 Code2Video-Compass,统一覆盖 T2V、I2V、V2V 三种输入设定,要求模型把文本指令和可选视觉参考转化为可在 HTML/CSS、SVG、Canvas、Three.js 通用技术栈上执行、由 Remotion 渲染的完整视频项目。具体目标有三:其一,按运动设计实践建立 10 大类、24 子类分类体系和三个复杂度维度(构造、动态动画、状态依赖,各三级)标注的 2,104 个任务;其二,提出 12 项客观指标加 5 项主观指标的双层评估框架,覆盖执行可靠性、视频质量、文视频对齐、参考保真、指令遵循与整体质量;其三,系统评测 9 个家族 15 个 MLLM,在质量与可靠性、失败模式、复杂度、成本等维度给出可指导后续研究的深入分析。
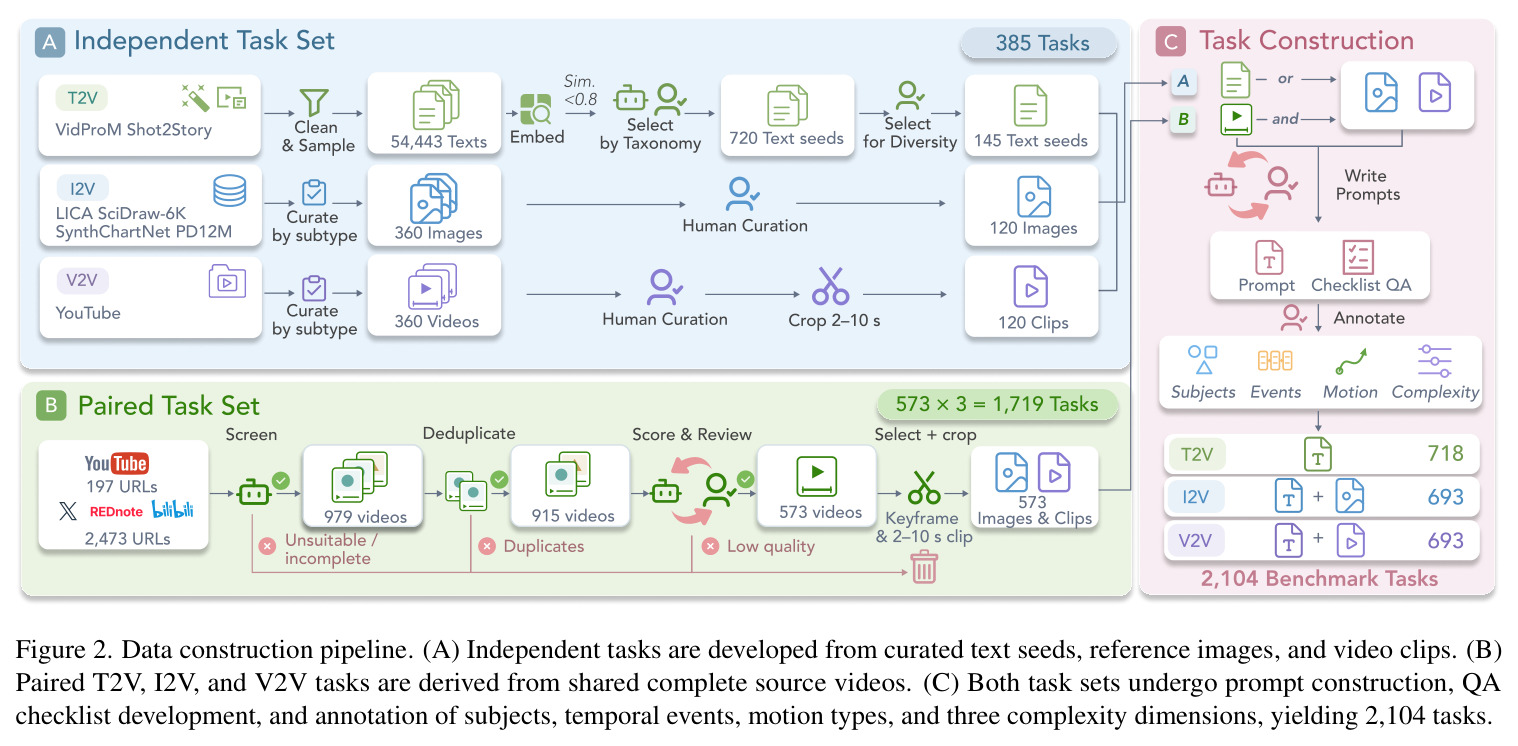
与已有工作不同的是,本文的独特切入角度有三点。第一,任务来源采用混合策略:既有独立构建的 385 个任务(从 VidProM/Shot2Story 的 54,443 条文本和 LICA 等图像库扩展),也有从 573 个完整专业/用户视频同时派生的 1,719 个配对任务(573×3),同一源视频的三种任务共享核心内容要求与事件进程,使 T2V/I2V/V2V 结果可直接对照——这是现有基准都没有的设计。第二,用运动设计分类学和三维度复杂度体系组织数据,使评估能精确定位模型在哪类创作、哪级难度上失效,而非只给一个总分。第三,评测设计专门针对代码生成范式的问题结构:不仅评视频好不好看,还评代码能不能跑(执行成功率)、生成代价多大(token 消耗),并为 V2V 首创序列/外观/运动三重保真度量,这些都是直接视频生成基准完全不具备的。
核心方法
直觉上,这份工作把“让 AI 做视频”重新定义为“让 AI 写出能渲染出完整视频的程序”。整体分三块:任务体系、数据构建、双层评估。任务形式上,模型接收文本指令和可选视觉参考(关键帧或 2–10 秒片段),单次 API 调用生成可执行项目代码,在支持 HTML/CSS、SVG、Canvas、Three.js 的通用栈上由 Remotion 渲染成完整视频,参考内容必须通过代码重建而非直接嵌入或回放。数据构建用两条互补策略:独立任务集(385 个)从文本种子和视觉参考出发保证创作多样性;配对任务集从 573 个完整视频为每个视频同时派生 T2V/I2V/V2V 三种任务(共 1,719 个),三种任务共享创意目标,从而支持跨模态比较。评估框架包含 12 项客观指标(ES、TC、TQ、AQ、MS、L-TVA、G-TVA、PF、SF、SA、AF、MF)和 5 项主观指标(IF、CC、VD、MQ、VE),主观部分由 Gemini 3.8 Flash 担任评委,并在 300 个样本上验证了与人的一致性(Pearson $r$ 为 0.796 与 0.783)。
核心创新是“配对任务 + 参考保真度量 + 双层评估”的组合,与已有工作的本质区别有三。第一,任务范围:MMMC 局限在 Manim 教育视频、HeyGen 只评产品动效片段,本文首次把跨 10 类创意场景的完整视频创作、三种输入模态统一进一个基准,573 个源视频同时派生三种任务使模态间可对照。第二,V2V 参考保真的度量设计是首创的:先用 DINOv3 帧嵌入上的子序列动态时间规整(DTW)在完整视频中定位参考片段的对应区间(序列对齐 SA),再在该区间内用 DreamSim 约束 DTW 测外观保真(AF)、用 CoTracker3 点轨迹双向匹配测运动保真(MF),衡量的是“把参考整合进完整视频”而非“复刻一段片段”,对时间轴伸缩和空间变换稳健。第三,把执行成功率、token 消耗等操作性指标纳入主榜,并用“失败即非操作性指标零分”的规则防止剔除困难任务后虚高平均分,从而首次系统性揭示代码生视频里质量与可靠性并不同步。
方法步骤详情
流程分四步。第一步,独立任务集:T2V 从 VidProM 和 Shot2Story 采样 54,443 条文本,经嵌入筛选与人工复核,收窄到 720 个候选、最终 145 个文本种子;I2V 从 LICA、SciDraw-6K、SynthChartNet、PD12M 每子类筛 15 选 5,得 120 张参考图;V2V 从 YouTube 同法得 120 段视频并各裁出 2–10 秒关键片段。第二步,配对任务集:从 YouTube 收 197 条记录、Bilibili/REDnote/X 收 2,473 个候选 URL,Gemini 3.8 Flash 辅助筛查得 979 个视频;经 URL 加 SHA-256 去重、SSCD 嵌入加 FAISS 查近重复剩 915 个;按质量评分并人工复核后保留 573 个完整视频,为每个视频选关键帧、裁 2–10 秒参考片段,派生三种任务共 1,719 个。第三步,为每个任务撰写自包含指令(视觉元素、空间关系、精确文字数据、运动与事件序列),标注主体、事件、运动类型与三维度复杂度,并构建最多 16 问的 QA 清单。第四步,评估:固定 1,054 任务子集(360/347/347,抽样经统计检验验证代表性),各模型单次调用生成代码、无执行反馈修复,渲染后按 17 项指标打分。
技术新颖性
技术新颖性集中体现在度量设计与任务结构的一一对应上。文视频对齐分两层:L-TVA 用 ViCLIP-L 对八帧滑窗与文本块计算窗口级对齐再聚合,捕捉事件级对应;G-TVA 用 Qwen3-VL-Embedding-8B 计算全指令与全视频嵌入的余弦相似度,捕捉整体语义。参考保真按模态分别设计:I2V 考虑到关键帧可出现在任意阶段,用 DINOv3 特征在全视频中检索最近帧计算感知保真 PF,并在同一帧上用 SSIM 计算结构保真 SF;V2V 的 SA 用子序列 DTW 对齐嵌入路径取平均余弦相似度,AF 用 DreamSim 距离的约束 DTW,MF 用 CoTracker3 点轨迹在时空归一化后比较位移方向与幅度并双向最优匹配——这是首个能在时间伸缩与空间变换下稳健衡量“运动模式是否被复现”的指标。运动平滑度用 AMT 插值中间帧、跳切处不计误差;技术质量取 DOVER++ 技术分支。主观侧的 IF 用逐任务 QA 清单(最多 16 问、六维度)把模糊的“遵循指令”变成可计算的通过率。这些设计都不是搬运视频生成基准的现成指标,而是围绕代码生成范式特有的失败模式定制的。
实验结果
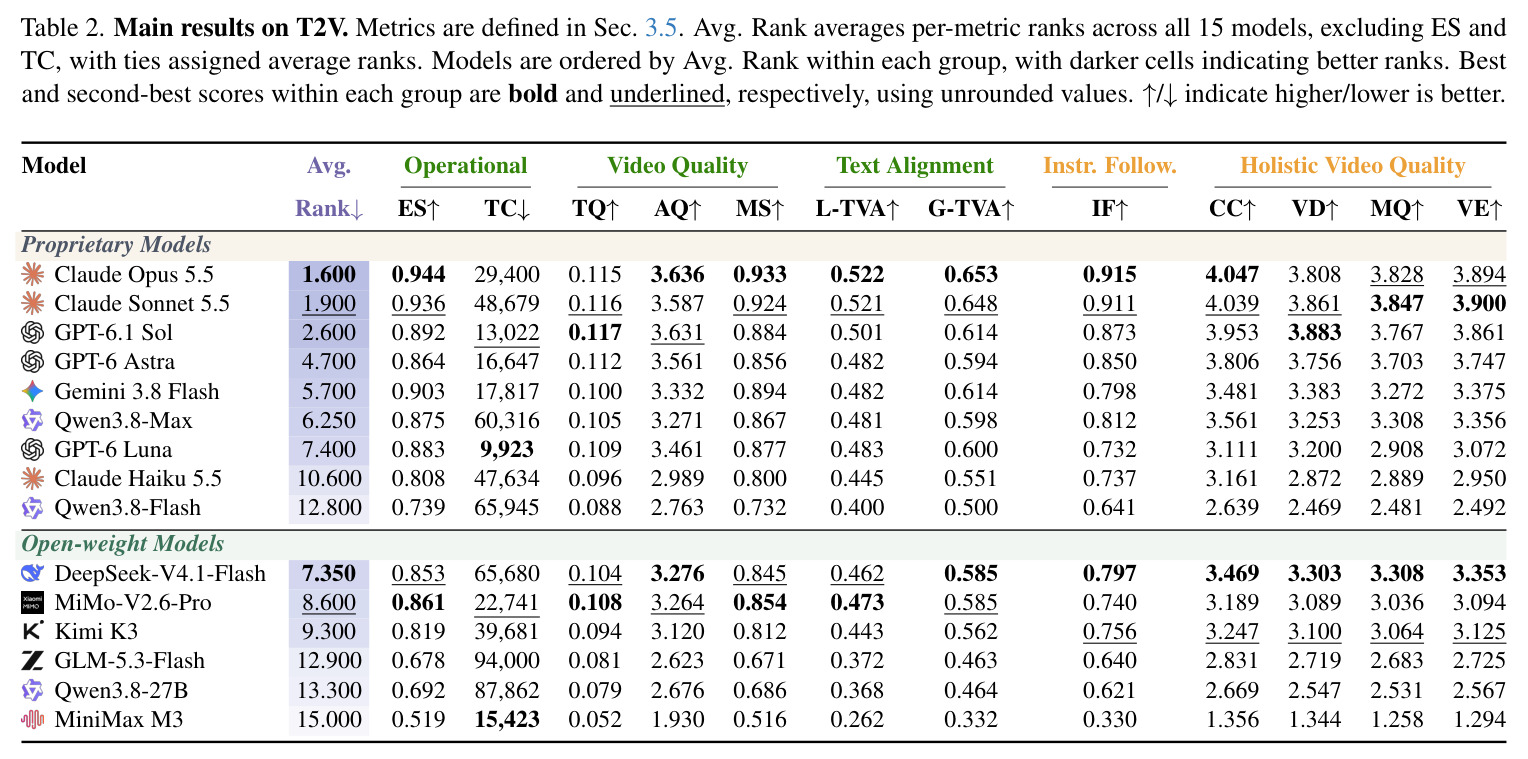
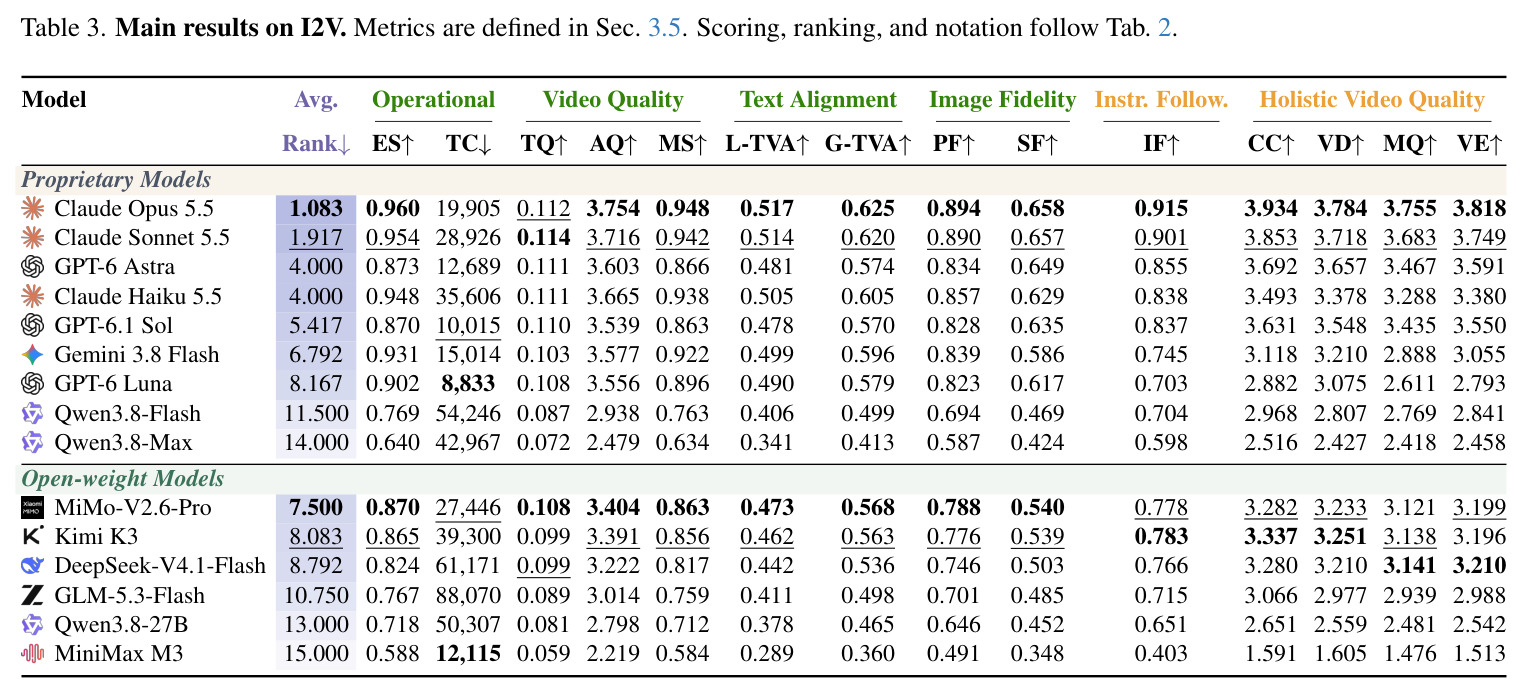
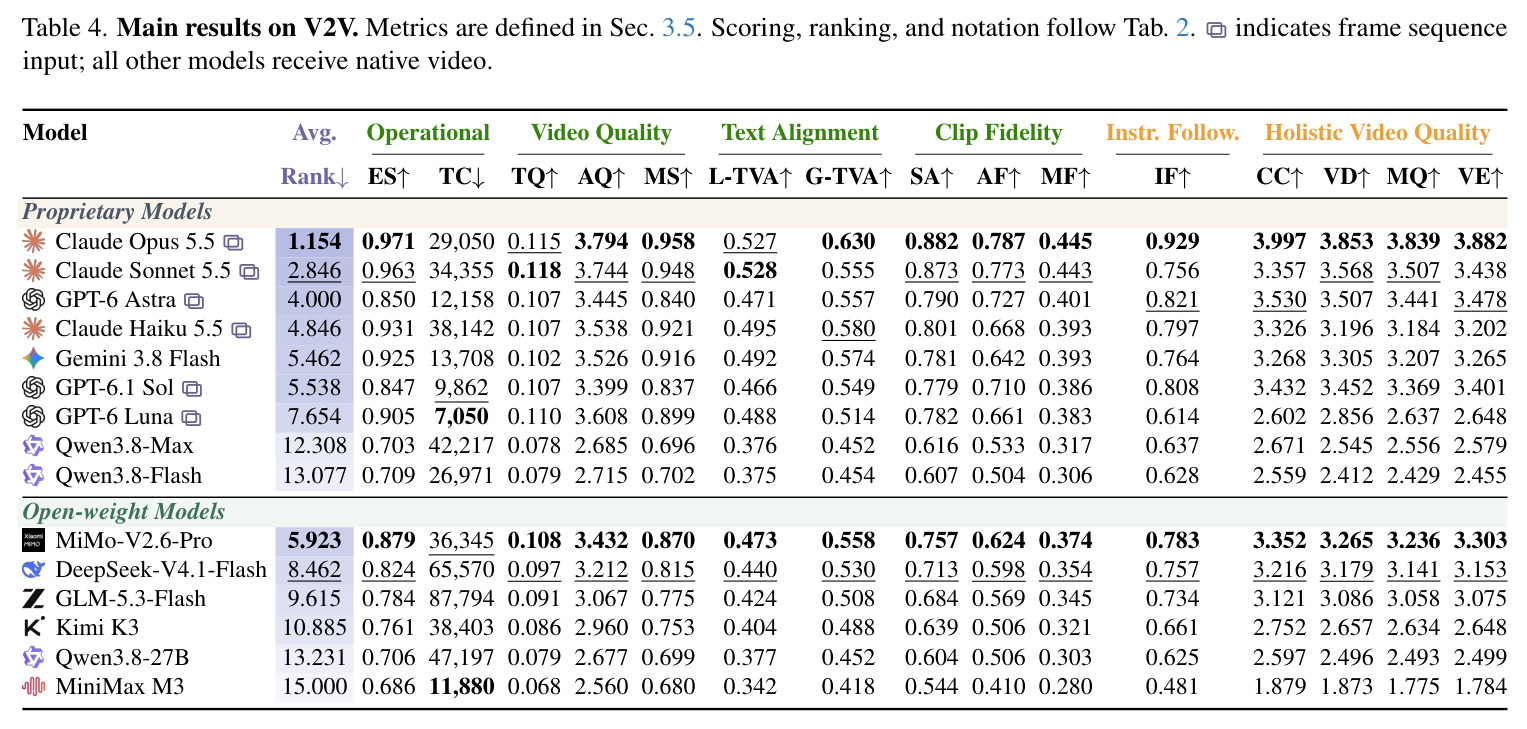
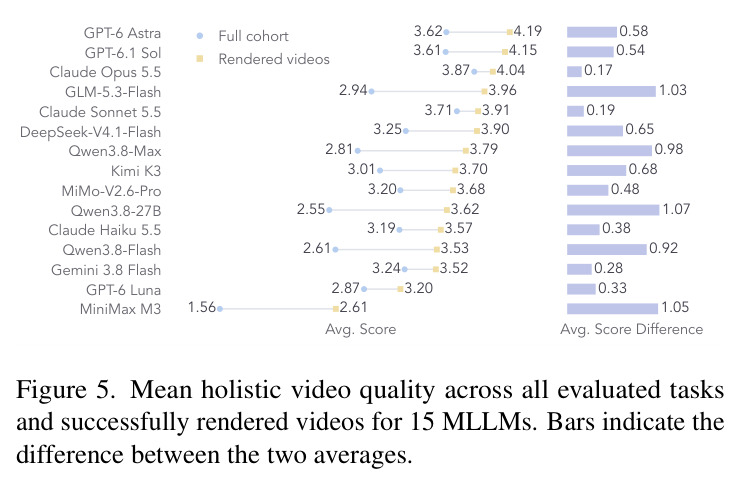
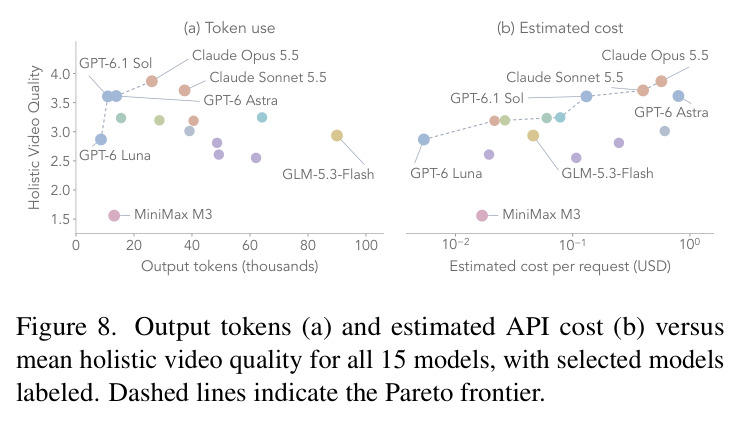
15 个模型、固定 1,054 任务子集上的核心发现:(1) Claude Opus 5.5 平均秩 1.60/1.08/1.15(T2V/I2V/V2V)居首,前三皆专有模型;开源最佳为 DeepSeek-V4.1-Flash(T2V)与 MiMo-V2.6-Pro(I2V/V2V)。(2) 执行成功率差异巨大:T2V 0.52–0.94,I2V 0.59–0.96,V2V 0.69–0.97。(3) 质量与可靠性不同步:GPT-6 Astra/Sol 成功渲染时质量最高(4.19/4.15),但全集均值跌到 3.62/3.61,低于 Claude Opus 5.5 的 3.87;保真也不等于遵循,I2V 上 GPT-6 两档模型保真接近而 IF 相差 0.86 对 0.70。(4) 复杂度越高表现越差:SF 从 L1 到 L2 在构造、动态动画维度分别下降 14.38% 和 12.82% 的量程;状态依赖维度在 L2→L3 时全部 15 项指标下滑。(5) 成本与质量不成正比:GLM-5.3-Flash 用 90.0k token 仅得 2.94 分;GPT-6.1 Sol 与 Astra 质量相当但成本差 6.1 倍。(6) V2V 运动保真全场最高仅 0.445;错误分析显示 GPT-6 Astra 83.4% 败于编译与缺依赖,Claude Opus 5.5 则 75.0% 败于运行时异常。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| T2V 综合能力 | 平均秩(15 模型内,越低越好) | Claude Opus 5.5:1.60 | 次优 Claude Sonnet 5.5:1.90;开源最佳 DeepSeek-V4.1-Flash:7.35 | 专有模型包揽前三;开源与专有仍有明显差距 |
| T2V 指令遵循 | IF(QA 清单通过率) | Claude Opus 5.5:0.915 | 最差 MiniMax M3:0.330;开源最佳 DeepSeek-V4.1-Flash:0.797 | 最强与最弱相差 0.585,模型间分化极大 |
| I2V 图像保真 | PF(DINOv3 感知相似度) | Claude Opus 5.5:0.894 | GPT-6 Astra:0.834;开源最佳 MiMo-V2.6-Pro:0.788 | 较次优专有模型 +0.06,较开源最佳 +0.106 |
| V2V 序列对齐 | SA(子序列 DTW 余弦相似度) | Claude Opus 5.5:0.882 | Claude Sonnet 5.5:0.873;开源最佳 MiMo-V2.6-Pro:0.757 | 顶级模型间差距小(0.009),但与开源差距达 0.125 |
| V2V 运动保真 | MF(CoTracker3 点轨迹双向匹配) | Claude Opus 5.5:0.445(全场最高) | 开源最佳 MiMo-V2.6-Pro:0.374;最差 MiniMax M3:0.280 | 绝对值普遍低于 0.5,运动复现是全场瓶颈而非某家短板 |
| 执行可靠性(T2V) | ES 执行成功率 | Claude Opus 5.5:0.944 | MiniMax M3:0.519;GLM-5.3-Flash:0.678 | 模型间差距高达 0.425,可靠性是最先分化的能力 |
| 整体质量(全集) | CC/VD/MQ/VE 四维均值 | Claude Opus 5.5:3.87 | GPT-6 Astra:3.62(成功渲染时 4.19) | +0.25,揭示高质量但低可靠性会被失败拖垮 |
| 生成效率 | 估算 API 成本(同等质量) | GPT-6.1 Sol:质量 3.61 | GPT-6 Astra:质量 3.62,成本约 6.1 倍 | 同等质量下成本可差一个数量级 |
局限与改进
作者承认的局限:主观评估依赖 Gemini 3.8 Flash 单一评委,虽有 300 样本的人一致性验证(Pearson $r$ 0.796/0.783,$\mathrm{ICC}(A,3)$ 大于 0.97),但评委与部分被评模型同源可能引入偏置;评测采用单次 API 调用、无执行反馈的协议,未覆盖 agent 式多轮修复的真实工作流;每任务只生成一次,未报告多次采样的方差。我的补充观察:其一,MF 全场最高仅 0.445,如此低的天花板可能部分源于点轨迹匹配对渲染风格差异的敏感性,指标本身的校准需要人工核对;其二,任务源自 YouTube/Bilibili/REDnote 等平台,不可避免偏重运动图形与动画类内容,对实拍、影视类创作覆盖有限;其三,数据构建由 GPT-6.1 Sol 与 Gemini 3.8 Flash 辅助、三位共同作者人工审核,指令可能存在系统性写作风格,模型可能对此过拟合;其四,技术栈限定 Web 前端,对 Manim、Blender 等其他程序化视频生态的结论外推性未知。
独立分析的弱点
独立分析的弱点与改进方向:(1) 无反馈单次生成低估实际可用性——真实工作流会执行代码、读报错、迭代修复,而 Claude Opus 5.5 的失败恰恰 75.0% 是最易被反馈循环修复的运行时异常,建议增加带执行反馈的 agentic 设置作为对照榜。(2) 评委同源风险:Gemini 3.8 Flash 既当评委又参与数据筛查,IF 清单由 GPT-6.1 Sol 辅助生成,建议引入多评委集成或扩大人类重评样本。(3) 参考定位的鲁棒性:I2V/V2V 先检索匹配帧或区间再算保真,若模型对参考做合理的风格化重绘,DINOv3/SSIM 类指标会误罚,可补充语义级保真度量。(4) “失败即零分”规则对平均分影响巨大(GPT-6 Astra 全集均值从 4.19 跌至 3.62),单一标量掩盖了“高质量但偶发失败”与“低质量但稳定”两种截然不同的模式,建议报告成功率-质量联合分布。(5) 1,054 子集约为全集一半,24 个子类级别的结论统计功效不足,可扩充评测规模或报告置信区间。(6) 成本分析只用 API 报告的输出 token 与标价估算,未计入 reasoning token 定价差异、缓存与批量折扣等真实成本结构,跨厂商比较需谨慎。
未来方向
作者展望:以该基准为诊断测试床,推动可靠、连贯、可控的代码生视频研究,重点在执行可靠性、指令遵循、参考保真和复杂度扩展。基于其成果可延伸的方向:(1) 从 benchmark 到 agent:引入执行反馈、自修复、多文件项目规划的 agent 框架,在配对任务上量化修复增益,尤其是针对运行时异常占主导的失败模式;(2) 状态依赖是全场最痛的维度(S2→S3 全部 15 项指标下滑),可研究显式状态机、时间线表示、跨场景变量绑定等代码结构先验;(3) 运动保真(MF 最高 0.445)表明模型难以复现运动模式,可探索从参考片段提取关键帧加缓动曲线的中间表示再生成代码;(4) 利用三维度复杂度标注做课程式训练或难度自适应推理,让复杂任务分配更多 token;(5) 扩展技术栈到 Manim、Blender、游戏引擎,乃至音频-视频联合生成;(6) 利用配对任务三模态同源的性质,定量分解视觉参考对模型行为的贡献,例如 I2V 相比 T2V 在哪些维度带来增益。
复现评估
复现评估:项目主页为 code2video-compass.github.io,论文未逐项说明代码与数据集的完整开源状态,实际可得性需以仓库发布为准。数据方面,任务源自公开数据集(VidProM、Shot2Story、LICA、SciDraw-6K、SynthChartNet、PD12M)与 YouTube/Bilibili 等平台视频,视频类参考的再分发可能受平台条款限制,自行重建数据管道工程量不小。评估管线依赖的工具与模型均为公开可得:Remotion 渲染、DOVER++、Aesthetic Predictor V2.5、AMT、ViCLIP-L、Qwen3-VL-Embedding-8B、DINOv3、SSIM、DreamSim、CoTracker3、SSCD 加 FAISS。主观评估需要 Gemini 3.8 Flash API;被测 15 个模型多为商业 API,完整复现 15 模型×1,054 任务需要可观预算——仅 Claude Opus 5.5 在 T2V 上平均每任务就消耗约 29.4k 输出 token。方法本身无需训练,复现门槛中等,主要成本在数据清洗工程与 API 费用;只复跑单模型单设定的评估则相对轻量。
论文图表
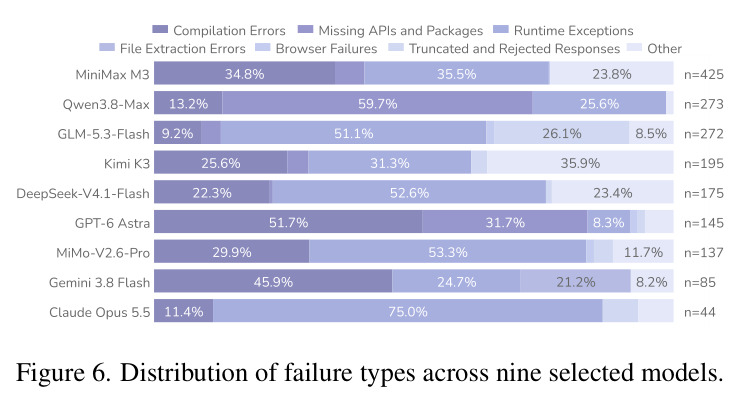
基于 2,756 个错误案例,按编译错误、缺失 API 与包、运行时异常、文件提取错误、浏览器失败等类型展示九个模型的失败构成:GPT-6 Astra 的失败中编译错误加缺依赖占 83.4%,Qwen3.8-Max 缺 API/包占 59.7%,Claude Opus 5.5 运行时异常占 75.0%(n=44,失败最少),GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiMo-V2.6-Pro 运行时异常过半,MiniMax M3 文件提取与截断/拒绝响应问题突出。
失败模式画像直接指明各模型的改进方向:GPT 系需加强依赖处理,Claude 系需提高运行时稳健性,对模型开发者最具 actionable 价值。