LabInstruct:面向实验室操作流程的情境化教学视频生成基准 LabInstruct: Benchmarking Situated Instructional Video Generation for Lab Procedures
首个真实实验室教学视频生成基准,揭示视觉逼真但流程不可靠的鸿沟
前置知识
图像到视频生成(I2V)
给定一张初始帧(这里是实验室工作台照片)和一段自然语言指令,视频生成模型(VGM)合成一段延续该画面的视频,形式化为 $f_{1:N} = G(f_0, T; \theta)$,其中 $f_0$ 是初始观测、$T$ 是指令。代表模型包括开源的 Wan、LTX、Cosmos3、MiniMax H3 和商业的 Seedance、Sora 等。
本文评估的对象就是 8 个 I2V 模型在实验室场景下的输出,理解输入-输出契约是理解基准设计的前提。
自主实验室(SDL)
Self-Driving Laboratory 指把从科学决策、实验规划到物理执行、闭环优化的完整实验循环自动化的系统。现有系统在假设生成、多步决策上进展快,但在真实实验室的物理执行上仍不可靠,因此人类仍是 AI 计划与物理实验之间的执行接口。
论文的出发点是给这个执行接口提供可靠的教学视频,理解 SDL 的瓶颈才能明白为什么评估对象是人类流程而非机器人轨迹。
程序性正确性(Procedural Correctness)
指生成视频是否正确执行了规定的流程:用对仪器、作用于正确对象、保持因果顺序、产生预期状态转换、可见地达成结果。它与视觉逼真度(画面是否连贯好看)正交——一段画面流畅的视频可能漏掉关键步骤或操作错误对象。
这是全文的核心概念,整篇论文的评估协议(检查表、完成度因子、闸门)都是为量化它而设计的。
VLM-as-a-Judge 检查表评估
把定性评估拆成大量可视觉验证的是非题(检查表),交给视觉语言模型逐项判决。本文每个判决是 YES/NO/UNJUDGEABLE 三值,核心维度上 NO 和 UNJUDGEABLE 都算负面证据,最后按维度聚合、几何平均、乘完成度因子和闸门得到总分。
论文实验部分的全部分数都由这套机制产出(GPT-5.6 Sol 以 4 FPS 采样帧逐项判决),不懂它就无法解读表格数字。
研究动机
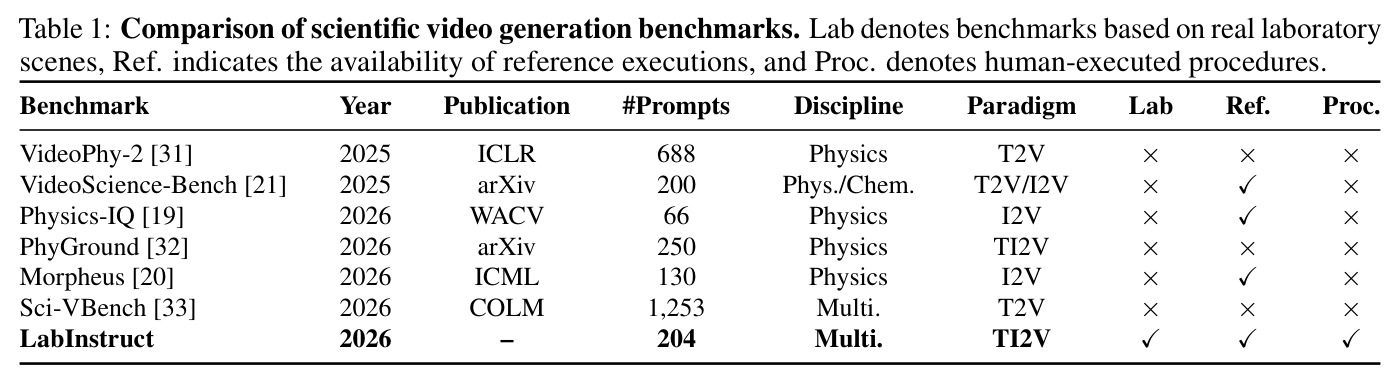
自主实验室(SDL)试图把从科学决策到物理执行的整个实验闭环自动化,但在真实开放世界的实验室里,可靠的物理执行依然困难:实验涉及细粒度操作、长时程流程,且任务与设备配置差异巨大,现有实验室机器人和科学智能体基准大多只覆盖受限仿真或软件工作流。因此人类仍是 AI 实验计划与物理实验之间的重要执行接口,而实验操作本质上是视觉、空间、动态的——仪器摆放、工具与物体的接触、中间状态、时序先后,纯文本常常说不清。新一代图像到视频模型已能从工作台初始图像加自然语言指令直接合成演示视频,但视觉逼真不等于指导可靠:生成视频可能漏掉关键动作、操作错误对象、打乱依赖步骤的顺序或提前终止。现有基准各有偏科:Physics-IQ 只有 66 个物理场景、Morpheus 130 个,VideoScience-Bench 的 200 个提示和 Sci-VBench 的 1253 个任务测的是科学推理;实验室与第一视角数据集只对已录制视频做识别与解析。没有任何基准系统回答:模型能否在真实实验室中生成人类可照做的正确流程视频。
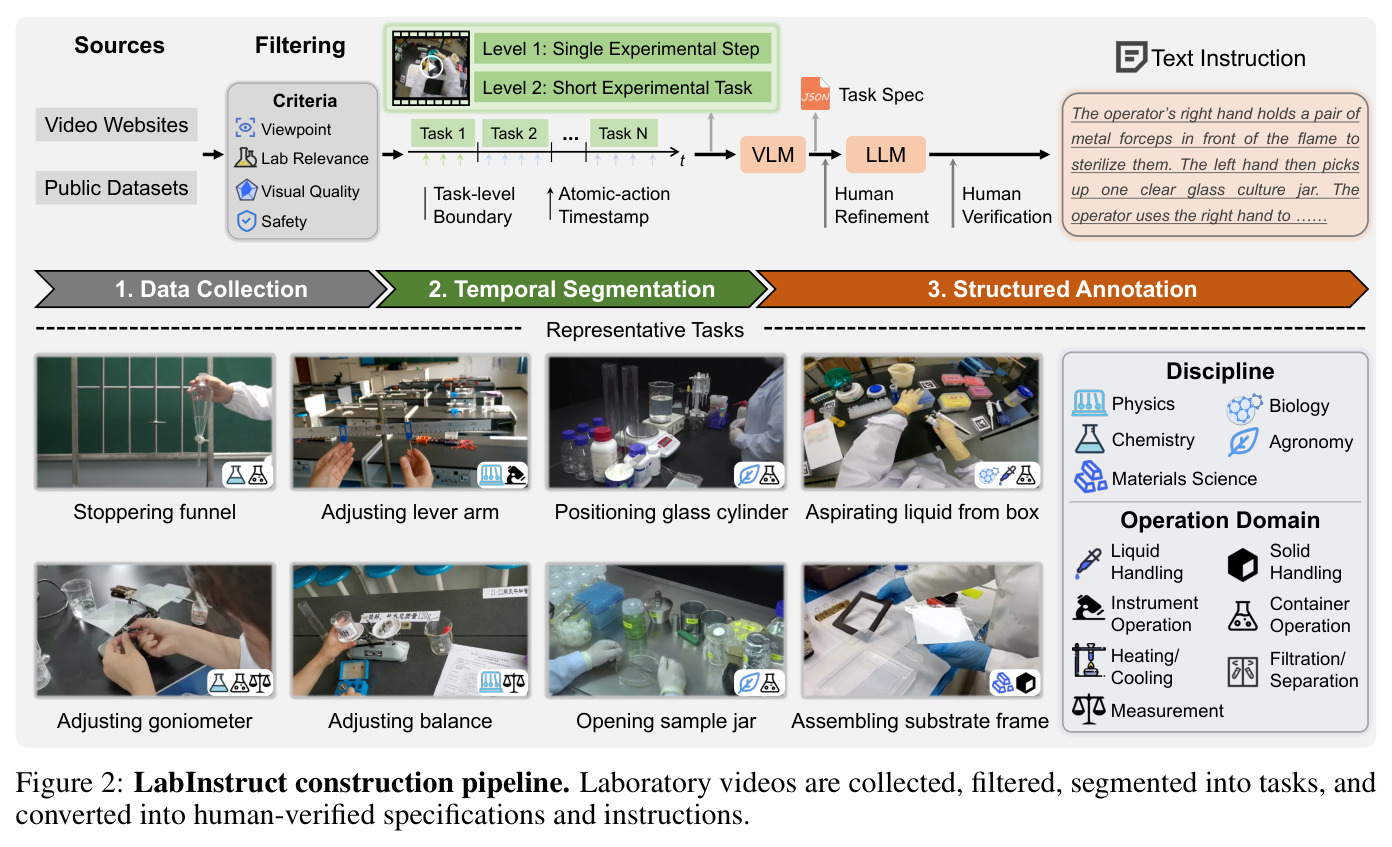
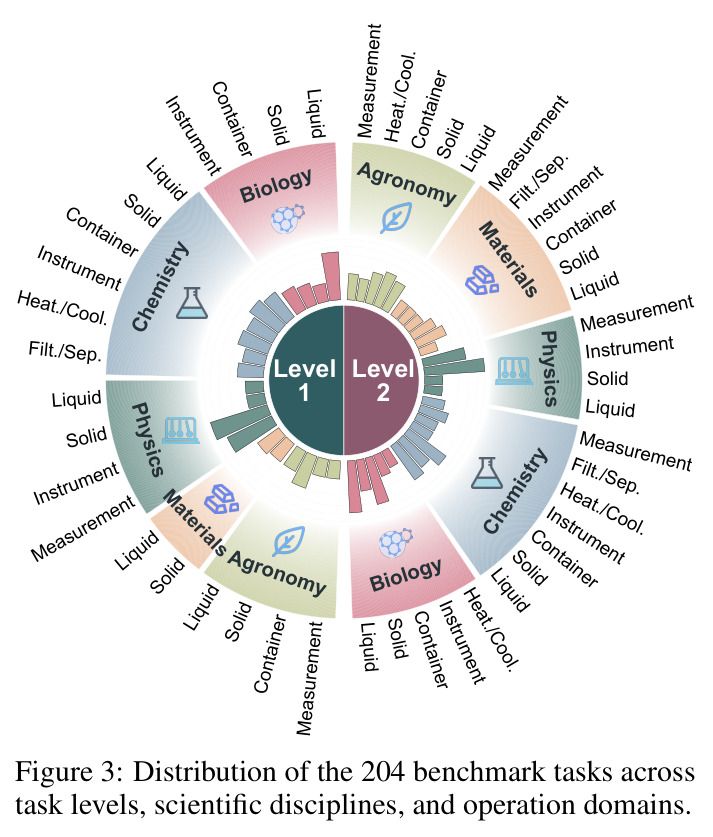
本文的目标是本文的目标是首次系统回答一个问题:视频生成模型能否产出可靠的实验教学视频?为此构建 LabInstruct——首个面向真实实验室情境化教学视频生成的基准,包含三项具体交付物。其一,204 个真实实验室任务,横跨物理、化学、生物、农学、材料 5 个学科和 7 个操作域(仪器操作、液体处理、固体处理、容器操作、加热/冷却、过滤/分离、测量),分为两个复杂度层级:Level 1 为单步实验操作(1–3 个原子动作,目标时长约 4 秒,101 个任务),Level 2 为含步骤间依赖的短流程(4–10 个原子动作,目标时长约 12 秒,103 个任务)。其二,每个任务附带同一工作台的真实参考执行视频,以及对象、动作、接触类型、状态转换的结构化标注。其三,一套流程感知的评估协议,把视觉逼真度与流程正确性解耦,并用它量化 8 个前沿 I2V 模型在视觉质量与端到端流程正确性之间的差距。
与已有工作不同的是,本文的独特切入是把实验室视频生成重新表述为面向人类的程序性沟通任务,而非视觉合成任务。与已有工作相比有三个被忽视的点。第一,评估对象从物理现象转向人类操作流程:已有基准问的是化学反应是否正确发生(VideoScience-Bench)、物理定律是否被遵守(PhyGround 的 13 条物理定律),本文问的是模型能否在指定工作台上按序完成人类操作。第二,场景条件化约束:生成视频必须保持工作台身份与空间几何,无法解释的视角切换、剪辑、运动不连续或丢失工作台都判为流程失败——这是 I2V 评测中首次出现的约束。第三,容忍替代执行路径:参考视频只被视为底层流程的一个有效实现而非唯一目标轨迹,评分聚焦必需动作、因果顺序、可观察状态转换与任务结果,只要满足程序要求,不必逐帧复现参考。表 1 显示 LabInstruct 是唯一同时具备真实实验室场景、参考执行和人类流程三个属性的基准。
核心方法
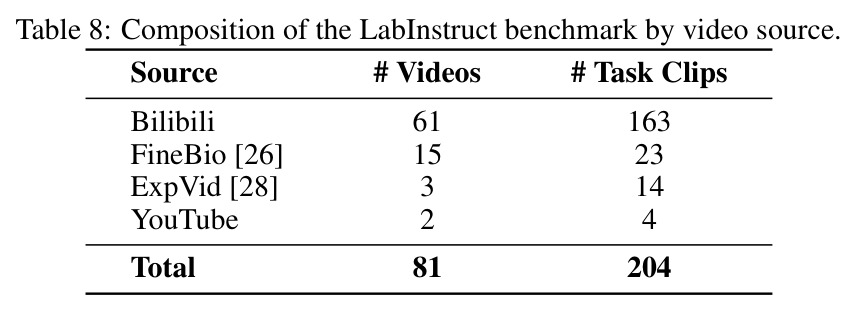
直觉上,评一个教学视频不该问画面好不好看,而该问照着做能不能把实验做对。技术路线分三段。第一段数据构建:从 Bilibili、YouTube、FineBio 和 ExpVid 收集真实实验室流程视频,人工按四条标准筛选(实验视角、实验室相关性、视觉质量、安全合规),再按两级时间标注切分成 Level 1(1–3 个原子动作,参考片段平均 4.5 秒)和 Level 2(4–10 个原子动作且至少一个步骤间依赖,平均 12.7 秒)任务,共 204 个、覆盖 5 学科 7 操作域。第二段任务标注:Qwen3.6-27B 辅助生成结构化任务规格草稿,人类标注者审核修正后冻结规格,再转换成自然语言指令。第三段评估协议:把评测解耦为三层——核心视觉质量(对象一致性、动作保真度、状态正确性、物理合理性四个维度取几何平均得 Score)、关键完成度因子、以及场景一致性与视觉安全两条二值闸门,总分 $S_{\text{overall}} = \mathrm{Score} \cdot C(n_c) \cdot G_{\text{scene}} \cdot G_{\text{safety}}$。评测由 3,229 条人工核验的检查表问答项驱动,GPT-5.6 Sol 以 4 FPS 采样帧逐项判决。
核心创新是把程序性正确性形式化为可打分、可问责的评估体系,而非依赖整体印象分。关键机制有三层。第一层是检查表拆解:由 DeepSeek-v4-flash 从结构化标注生成正向措辞、可视觉验证的问答项,经专家核验得到 3,229 条(Level 1 平均 13.0 条、Level 2 平均 18.6 条),每个判决是 YES/NO/UNJUDGEABLE 三值,且在四个核心维度上 NO 和 UNJUDGEABLE 都计为负面证据,杜绝看不清就算过的漏洞。第二层是关键完成度因子:$C(n_c)$ 在未通过的 Critical 项数 $n_c = 0, 1, \geq 2$ 时分别取 $1, 0.5, 0$——漏一个关键步骤得分腰斩,漏两个归零,精确对应教学视频漏一步就会误导执行者的实际后果。第三层是二值闸门:场景一致性或视觉安全只要有一项被明确判 NO 就整体否决,但 UNJUDGEABLE 单独不触发否决。这套设计把视觉逼真度、流程完整性和有效性约束三种性质不同的失败模式解耦计分,使总分为 0 的原因可诊断——这正是与已有基准按单一分数排名的本质区别。
方法步骤详情
完整流程五步。第一步数据收集与筛选:输入为视频网站与公开数据集的实验室流程视频,记录 URL/数据集标识与学科溯源;人工按实验视角(操作员中心,保留第一人称与近旁观察者)、实验室相关性(真实完整且步骤可视觉验证)、视觉质量(清晰连续、光照稳定、无持续遮挡)、安全合规四条标准筛选。第二步时间切分:两级独立标注,Level 1 区间划定单个实验步骤、Level 2 区间划定短流程,记录精确起止时间,关键操作与状态转换须全程清晰可见,据此切出 204 个片段。第三步结构化标注:Qwen3.6-27B 从片段加预定义模板生成草稿,人工审核修正;规格记录对象与角色、空间关系、有序动作(步骤索引、操作手、动作动词、目标对象、接触类型、动作前后可观察状态),并验证时间对齐、对象身份、动作完整性与排序、状态变化准确性。第四步指令生成:规格冻结后转换为预定义格式的自然语言指令,人工检查语义一致性;指令保留对象身份、动作顺序、交互与状态转换,抹去用哪只手、精确轨迹等参考特有细节。第五步生成与评测:8 个模型接收相同初始帧与指令各生成一个样本;GPT-5.6 Sol 以 4 FPS 帧加检查表逐项给出 YES/NO/UNJUDGEABLE 判决,按公式聚合出维度分与总分。
技术新颖性
与最近邻工作的技术区别在三点。其一,对物理类基准(Physics-IQ 的 66 个 I2V 场景、Morpheus、PhyGround):它们评估现象是否正确展开,输出是物理合理性分;LabInstruct 的输入-输出契约是初始工作台帧加指令到流程视频,评估的是过程而非现象,并首次把工作台身份与几何连续性作为硬约束。其二,对科学推理基准(VideoScience-Bench、Sci-VBench 的 1,253 个任务):它们用封闭式问答考推理,不要求模型执行有序的人类操作;LabInstruct 用结构化流程标注(绑定对象 ID 的动作序列、接触类型、前后状态)驱动检查表生成,让每条流程要求都可视觉验证、可追责。其三,对教学视频生成工作(GenHowTo、ShowHowTo 的图像序列、Seer/AID 的视频预测、PIE-V 的错误-纠正视频):它们提出任务但未系统评测流程正确性;LabInstruct 首次引入替代有效路径的处理——参考视频只是流程的一个实现,评分聚焦必需动作、因果顺序、状态转换与结果,避免惩罚合理的轨迹差异。
实验结果
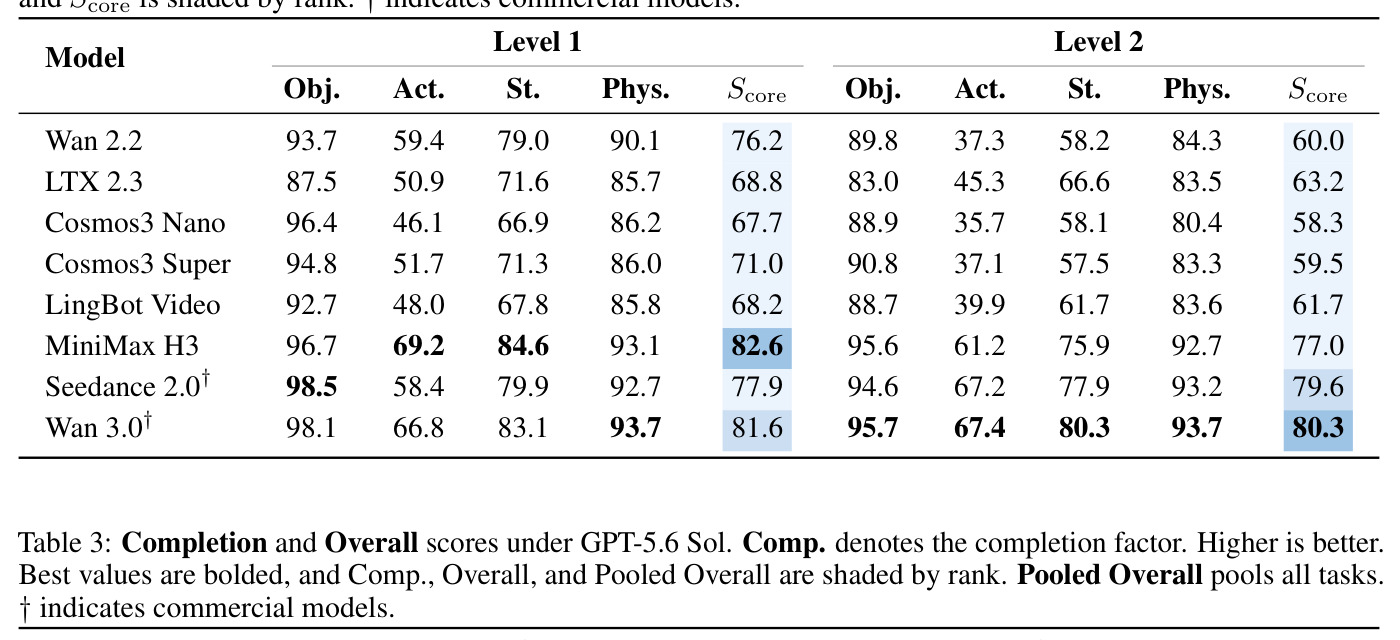
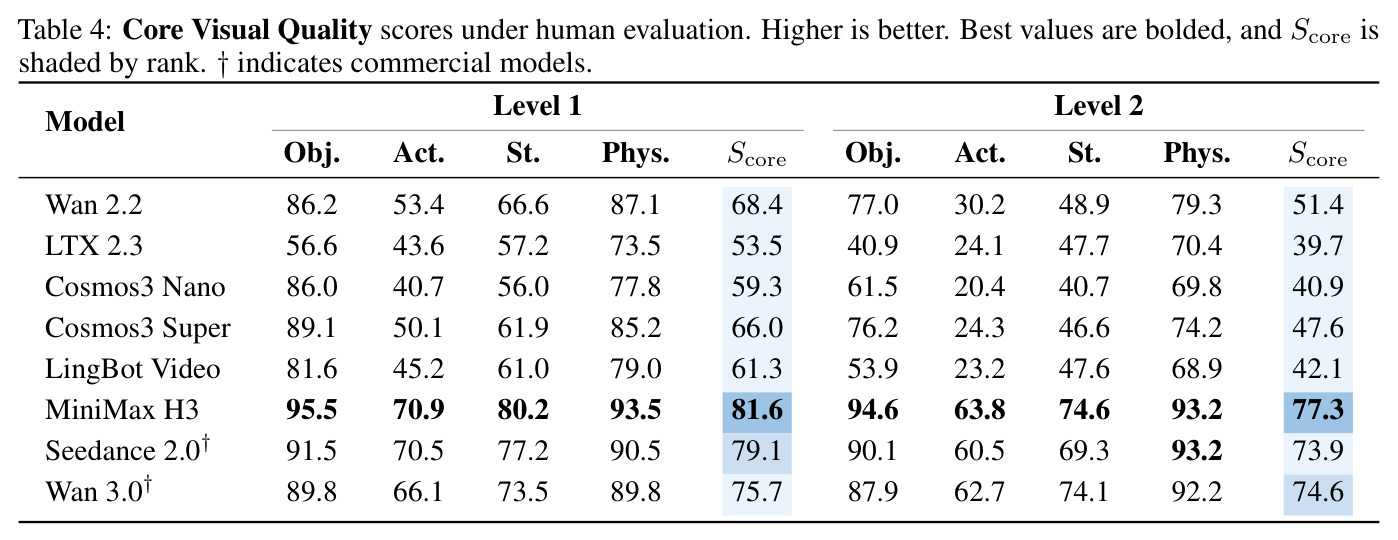
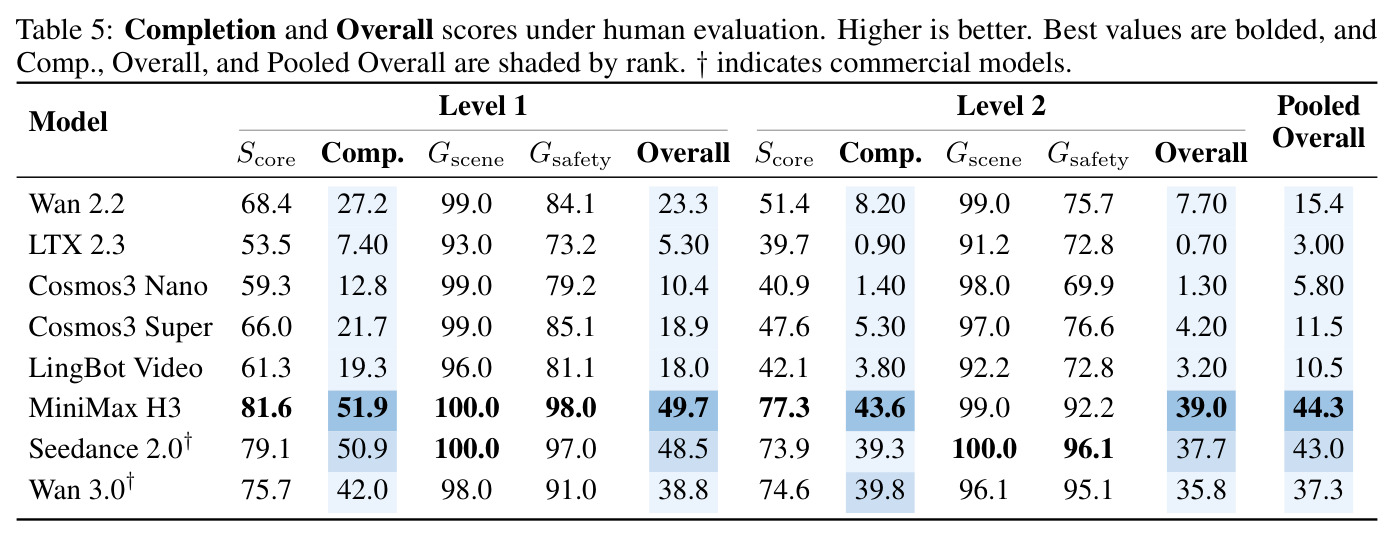
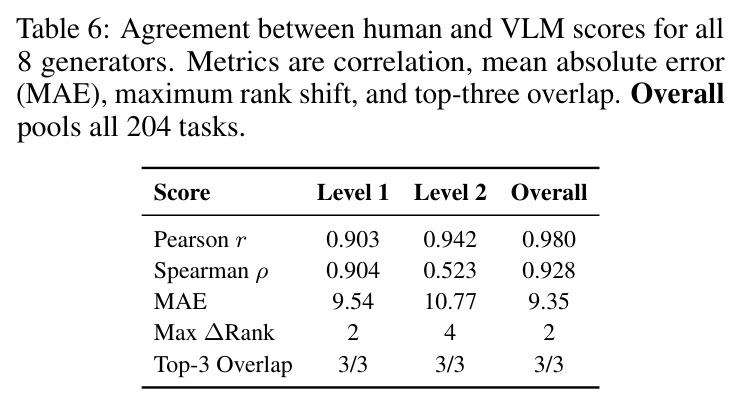
八个模型(开源:Wan 2.2、LTX 2.3、Cosmos3 Nano/Super、LingBot Video、MiniMax H3;商业:Seedance 2.0、Wan 3.0)在 VLM(GPT-5.6 Sol)评测下的核心结论是流程执行是主要瓶颈。对象一致性与物理合理性普遍很高(MiniMax H3 在 Level 1 达 96.7 与 93.1),但动作保真度与状态正确性在 Level 2 急剧下滑:Wan 2.2 动作分从 59.4 跌到 37.3,状态分从 79.0 跌到 58.2。Level 1 Overall 最高为 MiniMax H3 的 53.6(Wan 3.0 46.2),Level 2 Overall 最高为 Seedance 2.0 的 48.2,最弱模型在 Level 2 崩塌(LTX 2.3 仅 0.7、Cosmos3 Nano 1.3);Pooled Overall 前三为 MiniMax H3 46.3、Seedance 45.1、Wan 3.0 44.4,与 Wan 2.2 的 25.9 拉开断层。人工评测更严格且趋势一致:LTX 2.3 的 Pooled Overall 从 22.1 掉到 3.0,Level 2 完成度因子低至个位数百分比(Wan 2.2 8.2%、LTX 2.3 0.9%)。人机一致性上,Pearson 相关在 Level 1/2/Pooled 为 0.903/0.942/0.980,Pooled MAE 9.35、Top-3 重叠 3/3;共识分层确认前三名稳居 T0。领域分解显示头部模型能力互补:MiniMax H3 强于仪器操作、固体处理、农学与化学,Wan 3.0 领先液体处理、测量与物理,Seedance 2.0 擅长容器操作、加热/冷却与材料科学。失败归因上最常见的是流程遗漏与错序,其次是状态实现不完整与对象漂移。
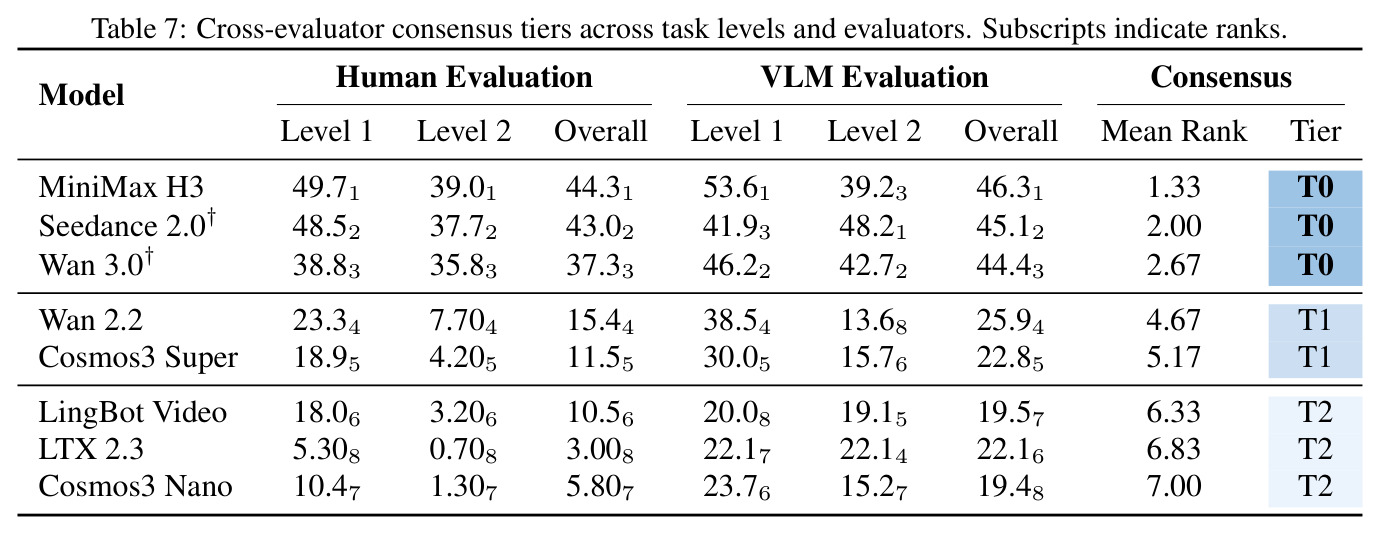
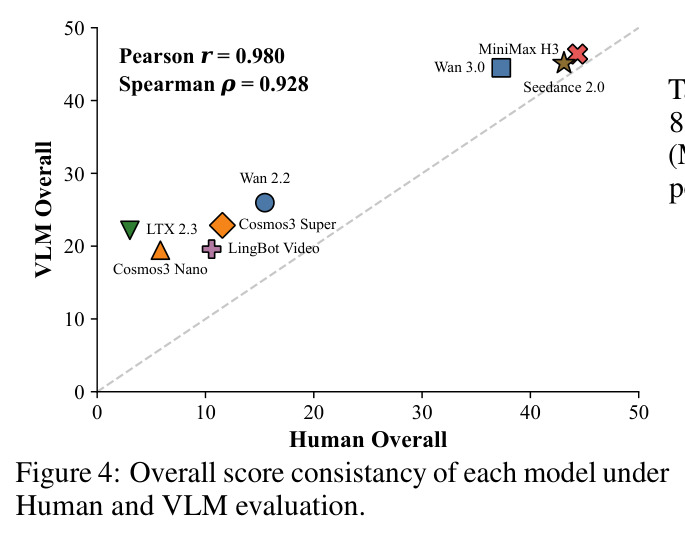
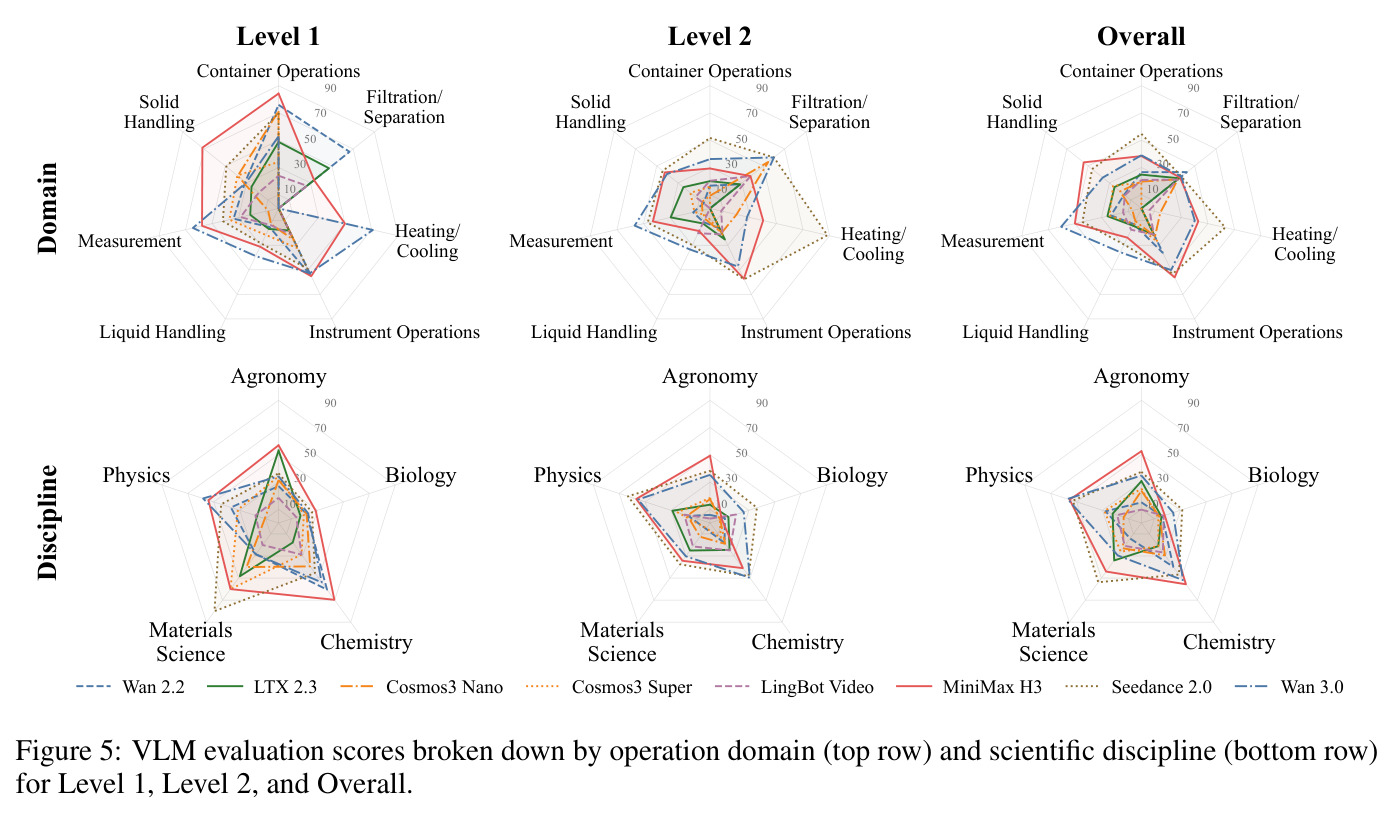
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Level 1 短流程教学视频生成(VLM 评测) | Overall(Score × 完成度 × 闸门) | 基准论文,无本文方法;最强模型 MiniMax H3 得 53.6 | 最弱开源模型 LingBot Video 仅 20.0 | 头部与尾部模型差距 2.7 倍,但绝对值远低于其视觉分 82.6 |
| Level 2 含依赖短流程生成(VLM 评测) | Overall | 最强 Seedance 2.0 仅 48.2 | LTX 2.3 低至 0.7、Cosmos3 Nano 1.3 | 复杂度提升导致全部模型大幅退化,最大跌幅超 90% |
| Pooled 全任务 Overall(VLM vs 人工) | Overall 分 | VLM 口径 MiniMax H3 46.3;人工口径降至 44.3 | LTX 2.3:VLM 22.1 vs 人工 3.0;Cosmos3 Nano:19.4 vs 5.8 | 自动评测系统性偏宽松,弱模型被高估 4–7 倍 |
| 人工-VLM 评审一致性 | Pearson r / MAE(Pooled) | r = 0.980,MAE = 9.35,Top-3 重叠 3/3 | 单层级 Spearman 仅 0.523(Level 2) | 任务聚合后排序高度可信,单层级存在最大 4 位名次偏移 |
局限与改进
作者承认的局限:T0 内部的精确排序会随生成随机性漂移(附录 C.4.4 的重采样分析),因此用六视图平均名次的共识分层替代精确排名;基准刻意聚焦短小、可观察、可验证的流程(4–12 秒),不试图覆盖所有实验室条件、设备配置与流程类型;每个模型-任务对只生成一个样本,以覆盖广度换取方差估计。我自己的观察:其一,检查表质量依赖 DeepSeek-v4-flash 生成加人工审核,3,229 项中仍可能残留主观项,且 UNJUDGEABLE 计为负面证据对快速细微状态变化可能不公平——4 FPS 采样本身会漏帧;其二,$C(n_c)$ 的三档阶梯函数较粗糙,一个关键失败和两个关键失败之间没有连续过渡,也不区分失败严重性;其三,VLM 评审明显比人类宽松(弱模型 Overall 差距达 4–7 倍),实际教学场景应以人工标准为准;其四,场景以台面式理化生操作为主,缺少需要仪器读数特写、多人协作或安全防护细节的复杂任务。
独立分析的弱点
独立分析的四个弱点。第一,单样本评测的方差风险:每个模型-任务对只生成一次,论文自己承认重采样会改变 T0 内排序,改进方向是每对采 3–5 个样本报告均值与置信区间,成本可控。第二,评审链路对时间细节不敏感:4 FPS 采样加整体帧判断容易漏掉液面变化、仪表读数这类瞬时状态,而状态正确性恰是低分维度,部分低分可能是测量问题而非生成问题;改进方向是引入变化点检测自动定位关键帧、对状态类检查项提高采样密度。第三,任务分布偏向台面手工操作:7 个操作域里没有称量精度、多设备联动、防护装备穿戴等安全敏感流程,而 SDL 场景里这些恰恰最需要可靠指导;改进方向是扩展安全合规子集并单独报告。第四,只评不改:论文给出了失败归因但没有探索任何提升流程正确性的手段,社区拿到的只是一把尺子;改进方向是把结构化标注用作生成端的控制条件,或将检查表判决转化为奖励信号做后训练,论文发布的数据完全可以支撑这类实验。
未来方向
作者方向:论文定位是把 LabInstruct 作为评估与诊断流程失败的系统性框架,隐含的直接延伸是推动模型在动作保真、状态正确性和完成度上逼近其自身的视觉质量。基于成果可延伸的方向:其一,流程条件化生成——把结构化任务规格(对象布局、动作序列、状态目标)作为显式控制信号注入视频扩散模型,类似布局条件生成,直接攻击漏步与错序;其二,检查表驱动的后训练——3,229 条可视觉验证的判决天然构成奖励模型,可对生成器做 RLHF/GRPO 式优化,以流程正确性为优化目标;其三,桥接具身智能——人类示教视频是机器人模仿学习的数据源,本基准可用于筛选高质量流程视频,或评估世界模型对操作后果的预测;其四,长时程与错误恢复——扩展到分钟级多阶段流程、跨镜头一致性,以及 PIE-V 式的错误-纠正视频生成;其五,与 SDL 闭环结合,形成生成指导、人类执行、结果反馈修正计划的完整回路。
复现评估
复现评估:论文给出了项目页(csu-jpg.github.io/LabInstruct.github.io),但正文未明确数据集与代码的开源状态,需以项目页为准。数据来源含 Bilibili、YouTube 视频与 FineBio、ExpVid 两个公开数据集,前者的再分发可能受版权限制。复现完整评测需要三类资源:生成侧,6 个开源权重模型(Wan 2.2 A14B、LTX 2.3、Cosmos3 Nano/Super、LingBot Video、MiniMax H3)需多卡 GPU 推理 204×6 个视频,2 个商业模型走 API;评审侧,GPT-5.6 Sol 需处理 204×8 个视频(4 FPS 采样)加每任务约 13–19 条检查表,API 成本中等;人力侧,视频筛选、时间切分、规格校对与检查表审核是主要成本,论文由多机构标注团队完成。总体判断:评估协议公式完整、附录给出筛选标准与生成配置,独立实现一个协议兼容的评测器难度中等;完整复刻数据集则需要标注团队与版权清理,个人复现建议直接使用官方发布数据(若开源)。
论文图表
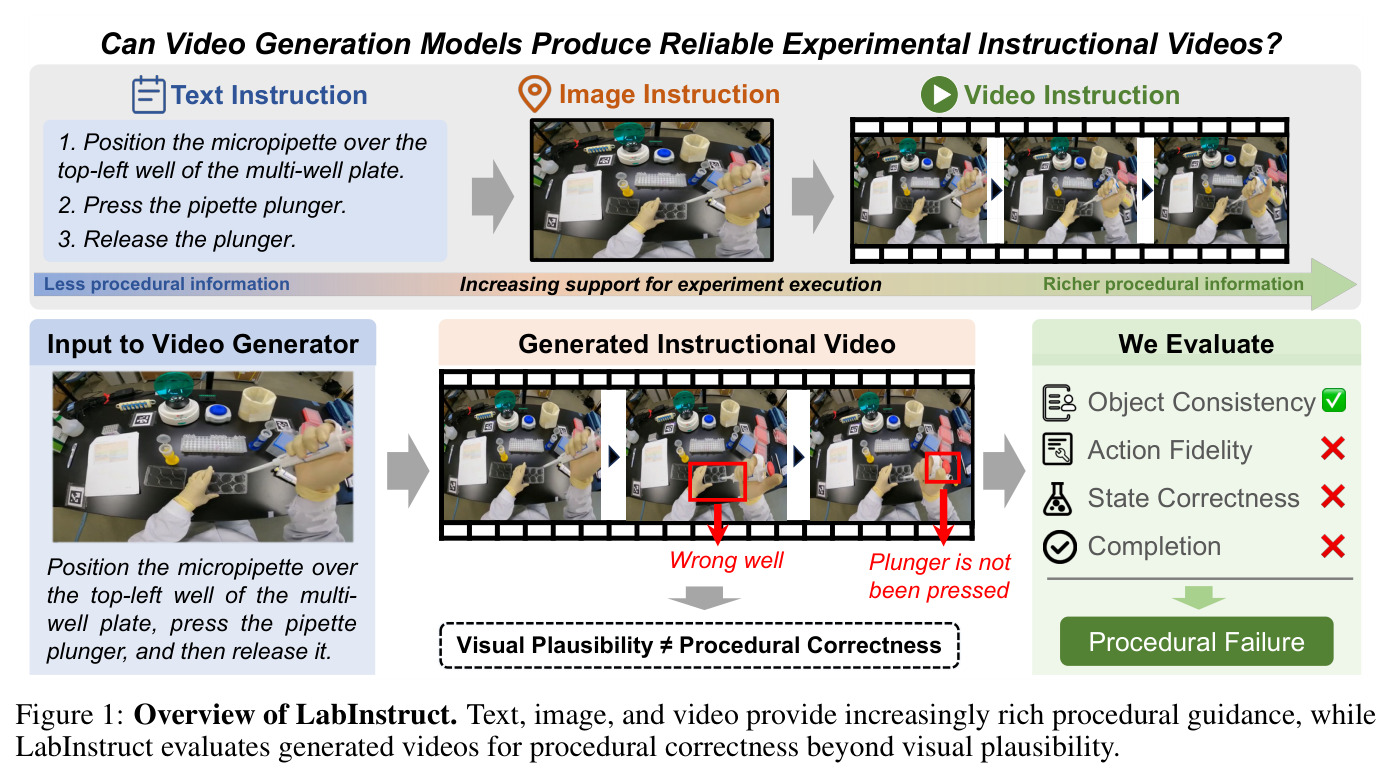
以微移液器任务为例:给定工作台图像和文本指令(对准左上孔位、按压柱塞、松开),生成视频在对象一致性上通过,但动作保真、状态正确性与完成度失败——移液器对准了错误的孔位、柱塞未被按压,点出「视觉合理性 ≠ 流程正确性」的主题。
一图看懂论文要回答的问题与评估哲学:判断标准不是画面好坏而是照做能否成功,是全文论点的浓缩。