FinForesight:面向金融深度研究系统的诊断式回测基准 FinForesight: A Diagnostic Backtesting Benchmark for Deep Research Systems in Financial Forecasting
用时序控制回测诊断金融深度研究系统的真实预测力,受控T2成绩可逼近实时成绩
前置知识
深度研究系统
指以大模型为大脑、能自主执行多步搜索、阅读与综合推理的 agent 系统,通常由「模型 + harness(框架/工具链)」两部分组成。它循环执行检索-阅读-思考,把分散在新闻、财报、行情里的证据整合成一份结论,如估值目标或事件方向判断。本文评测的不是裸模型,而是 22 个模型–harness 组合。
本文的评测对象正是这类系统,需要理解「harness 会显著改变模型表现」这一前提,才能读懂 Table 1 中同一模型在不同框架下分数差异巨大的现象。
知识截止日期(Knowledge Cutoff)
大模型预训练数据的时间下限,论文记作 $c_m$:截止日期之后发生的事件,模型参数里没有任何记忆。它是本文划分时序区间的锚点——截止前的事件(T1)模型可能背过答案,截止后已解决的事件(T2)和未解决的实时事件(T3)只能靠检索外部证据来预测。
T1/T2/T3 三区间的定义、模型特定的实例生成、回测到实时的迁移检验,全部建立在知识截止这个概念上,是全文的形式化基础。
回测与实时预测(Backtesting vs Live Forecasting)
回测在事后用已知历史数据评估预测系统,可立即打分但可能泄漏答案;实时预测在事件发生前记录预测、等结果落地后打分,无泄漏但反馈慢。过去cast(pastcasting)是回测的一种:重建历史时点的证据环境,让系统「回到过去」做已解决问题的预测,代表工作有 Bench to the Future。
论文的核心问题就是「回测分数能否可靠替代实时分数」,理解两种评测范式的利弊才能把握 T2–T3 对比实验的设计动机。
PIT 控制与时间泄漏
PIT(point-in-time)控制指检索时只允许返回预测日期 $t$ 之前公开的信息,通常靠时间戳与历史版本过滤实现。时间泄漏指评测证据里混入了 $t$ 之后才出现的内容——即使网页显示的时间戳较早,页面内容也可能事后被更新过,因此仅靠元数据过滤并不保险。
这是本文方法侧的核心防线:从无检查搜索到 PIT 控制再到页级 LLM 泄漏过滤器的三层递进,直接决定了 T2 回测分数的可信度。
预测评测指标
论文对不同任务使用不同指标:VAL 用相对截止价基线的误差缩减与回归期准确性;RANK 用归一化 Spearman 相关系数与 top-K 命中率衡量排序质量;EVT 用 Brier skill 评估带概率的方向预测(随机基线为 0,越接近 1 越好);FUND 用截断的逐实例效用;CALC 用容差化 Exact Match。
读懂 Table 1–4 中分数的含义、判断 Overall 0.7099 这类成绩的含金量,都需要先知道每个指标到底在衡量什么。
研究动机
评估金融预测能力面临一个根本性两难:历史回测可以立即打分,但模型可能在预训练中见过历史结局,把「背诵」当成「预测」——Didisheim 等人(2025)已证明 AI 对历史金融数据存在可预测的记忆效应;实时预测(ForecastBench、FutureX、金融领域的 FinDeepForecast)虽无泄漏,但反馈要等事件落地。更麻烦的是检索泄漏:即使给搜索加上日期过滤器,网页的实际内容仍可能在预测日期之后被更新过,显示时间戳并不可靠(Lahib et al., 2026)。随着 FinRobot、Fin-DR 等金融深度研究工作流被用于前瞻性投资分析,问题愈发紧迫;而聚合单一总分还会掩盖任务差异——估值、收益排序、事件方向、财务指标的预测难度完全不同,已有金融 agent 基准(FinTradeBench、DeepFund 等)各评一面却说不清分数来源。因此需要一个既能及时反馈、又能诊断「分数到底从哪来」的评测方案。
本文的目标是本文的核心问题是:历史回测能否可靠地评估面向金融预测的深度研究系统?为此作者构建 FinForesight——一个诊断式回测基准,覆盖中国、美国、香港三个市场,评估四个预测任务(估值 VAL、收益排序 RANK、事件方向 EVT、未来财务指标 FUND)和两个能力诊断任务(反事实推理 CF、金融计算 CALC)。基准针对每个模型的知识截止日期动态生成实例,利用截止后已解决的事件(T2)提供即时打分,并强制系统只能使用预测日期前可公开验证的信息。整个框架与多种深度研究 harness 兼容,共评测 22 个模型–框架组合、8 个大模型,并通过 T1/T2/T3 三时序对比、检索策略干预、prompt 改写和数值扰动,系统回答两个问题:系统能否真正预测?分数来自记忆、泄漏还是真实能力?
与已有工作不同的是,已有评测要么做实时预测(ForecastBench、FutureX),要么做过去cast(Wildman et al. 2025 的 Bench to the Future 用重建的历史证据评已解决问题),但都没有回答「受控回测的分数能否迁移到实时场景」。FinForesight 的独特切入是把这一迁移当作待检验的实证问题而非默认假设:通过匹配一周评估窗口,直接配对比较 T2 回测分与 T3 实时分。其次,它把时间有效性从「声明层面」推进到「内容层面」——不依赖时间戳或搜索过滤器,而是用页级 LLM 泄漏过滤器审计每条检索证据是否在预测日期 $t$ 前公开,含糊和不确定的内容一律拒绝。第三,它坚持分解评估:按任务、市场、时序区间分别报告分数,并把反事实推理与金融计算拆出来单独计分,避免推理能力与预测能力混为一谈。
核心方法
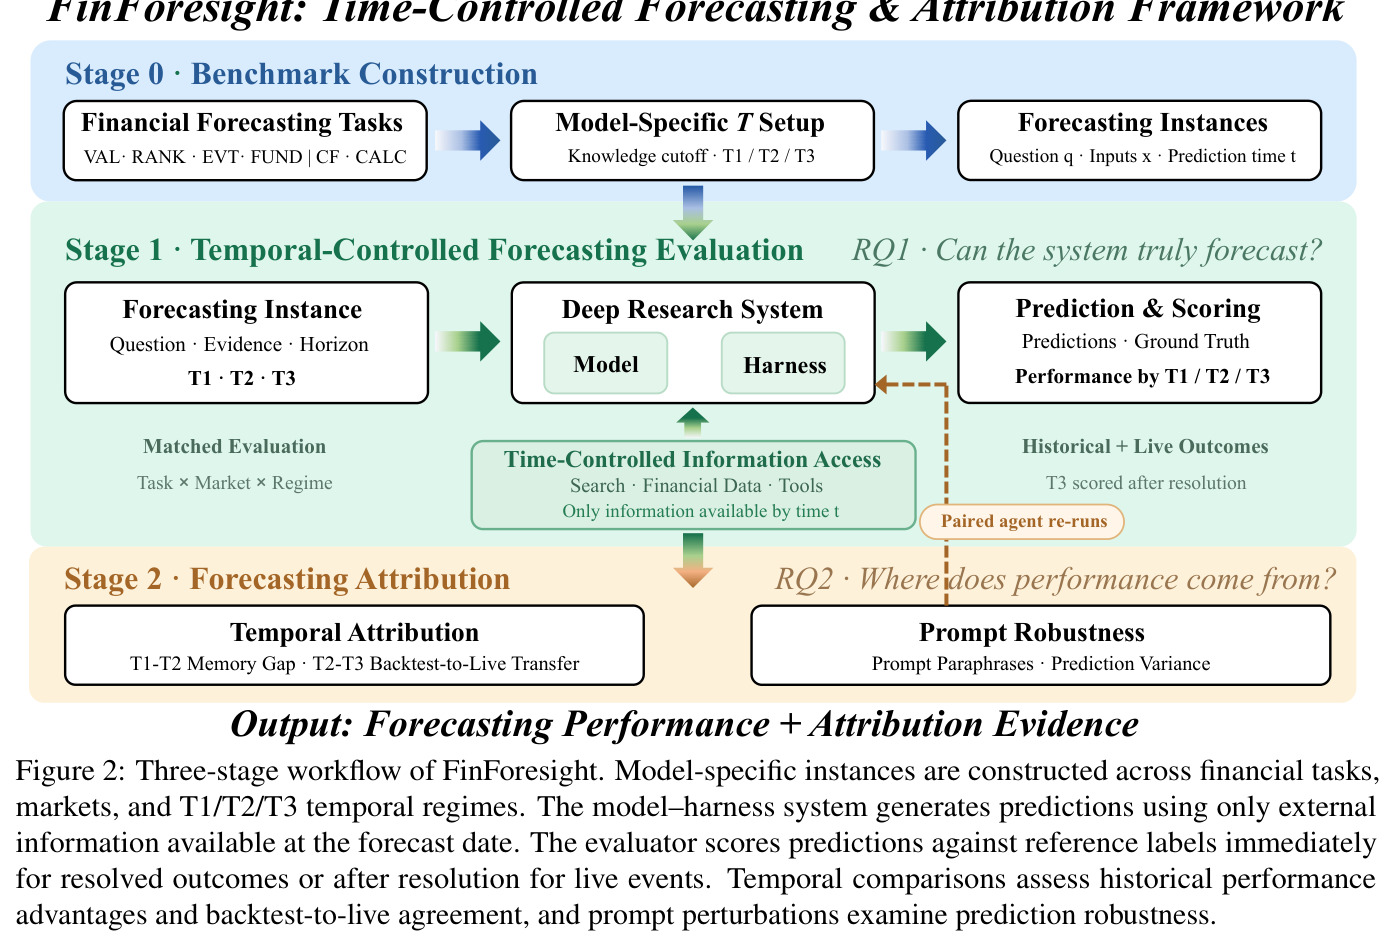
FinForesight 的工作流分三阶段(Stage 0 基准构建 → Stage 1 时序受控评估 → Stage 2 预测归因)。形式化地,记模型知识截止为 $c_m$,实例预测日期为 $t$,基准运行日期为 $r$,$\mathcal{I}_t$ 为 $t$ 之前可公开验证的信息集合。三个时序区间由此定义:T1 是预训练时代事件(预测与结局都在 $c_m$ 前,模型可能见过答案),T2 是截止后已解决事件($t > c_m$ 且结局在 $r$ 前落地,可即时打分),T3 是实时事件(预测时结局未知,需等解决后打分)。基准共 1,119 条记录:VAL 244、RANK 383、EVT 138、FUND 294、CF 30、CALC 30;T1 预测日期在 2024-06-01 之前,T2 在 2025-07-31 之后。系统在受控信息条件下生成预测,评估器用事后实现的市场结果或预定义规则打分,T3 标签在结局解决后才加入。
核心创新是「模型特定实例生成 + 页级检索审计 + 分解评估」三件套。与固定题库不同,任务模板针对每个模型的知识截止日期生成实例,使所有被评模型共享同一个 T2 窗口,从而保证 22 个配置可比——换新模型也只需用生成器滚动出新窗口,不必等待结局解决,直接回应了实时评测高延迟的痛点。与 Bench to the Future 等过去cast 基准的本质区别在于:本文不假设回测分数能代表实时表现,而是把它作为核心假设来检验,用匹配一周窗口直接对比 T2 与 T3。检索侧则把 PIT 控制升级为三层递进(无检查搜索 → PIT → PIT+LLM 过滤器),通过观察分数随检索策略的变化来定位泄漏来源——这是以往金融 agent 基准没有的归因维度,也让「回测分数的水分」第一次可以被定量测量。
方法步骤详情
Stage 0 用任务模板生成问题 $q$、输入 $x$ 与预测时间 $t$,只保留输入充分、标签规则可复现的候选,并逐一验证证据时间戳确保信息在 $t$ 前公开;价格来自 Yahoo Finance,财报来自 SEC EDGAR、CNINFO、沪深交易所与 HKEXnews,宏观事件来自中美港统计部门。Stage 1 中控制器为每个实例配置模型、harness 与检索策略;harness 经中介服务访问工具并全程留痕,支持三种检索策略:无时间检查的搜索、PIT 控制、PIT 加上基于 DeepSeek-V4-Flash(2026 年 4 月版)的 LLM 泄漏过滤器——过滤器以固定分类 prompt 审查每条检索内容,凡含 $t$ 后信息、时间证据模糊或响应无效一律拒绝。系统响应在评分前记录并锁定:T1/T2 与能力诊断即时评分,T3 待结局解决后评分。评分规则:VAL 用相对截止价基线的误差缩减,RANK 用归一化 Spearman 相关加 top-K 命中率,EVT 用 Brier skill,FUND 用截断逐实例效用,CF 检查对注入事件逻辑的依从性,CALC 用容差化 Exact Match。Stage 2 计算 $\Delta(T_1,T_2)=S_{T_1}-S_{T_2}$、$\Delta(T_2,T_3)=S_{T_2}-S_{T_3}$,以及 Prompt Change Rate、Perturb Change Rate 和 Score Delta 等归因指标。
技术新颖性
技术新颖性体现在三处。其一,可配置的数据集生成器把「评测集跟随模型知识截止滚动」工程化,解决了前沿模型快速迭代下基准过时的痛点:所有系统共享同一 T2 窗口保证可比,新模型出现时生成器即可产出新窗口而无需漫长等待。其二,页级 LLM 泄漏审计是检索时间有效性的新防线:已有工作(Lahib et al., 2026)指出时间戳过滤不可靠,本文进一步用固定 prompt、固定解码配置的过滤器在内容层面拦截 $t$ 后信息,并把「模糊/不确定」纳入拒绝范围,宁可牺牲召回也不放过泄漏。其三,归因被设计成可组合的诊断算子——时序差、检索策略干预、prompt 改写、数值扰动各自隔离一类混杂因素,使「分数从哪来」可以被定量分解而不是仅凭总分讲故事;22 个模型–框架配置的系统评测也提供了金融领域罕见的 harness 效应证据。
实验结果
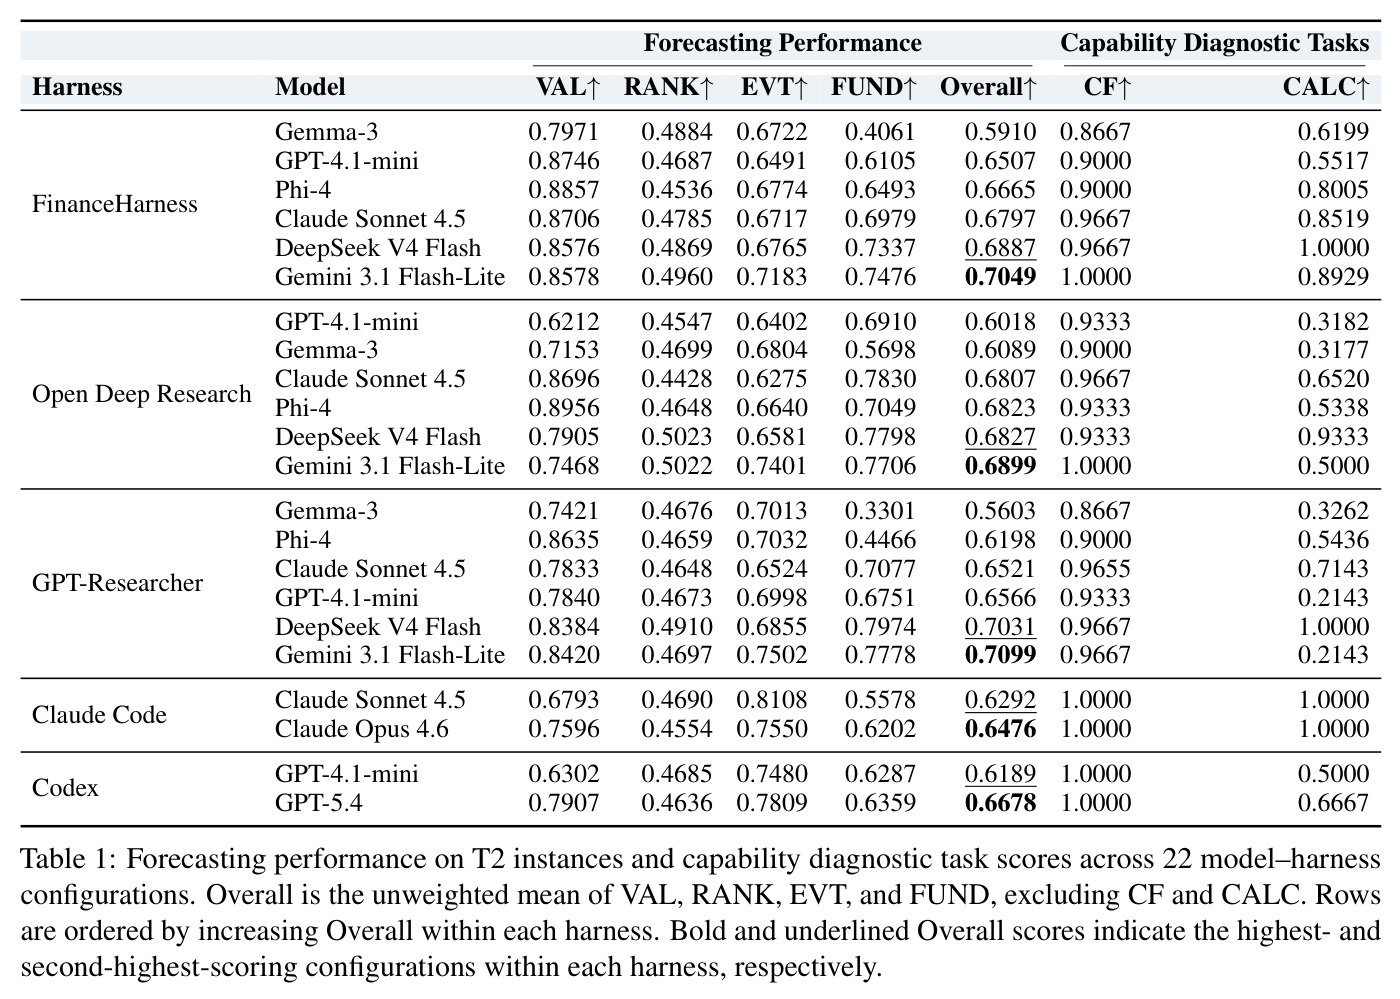
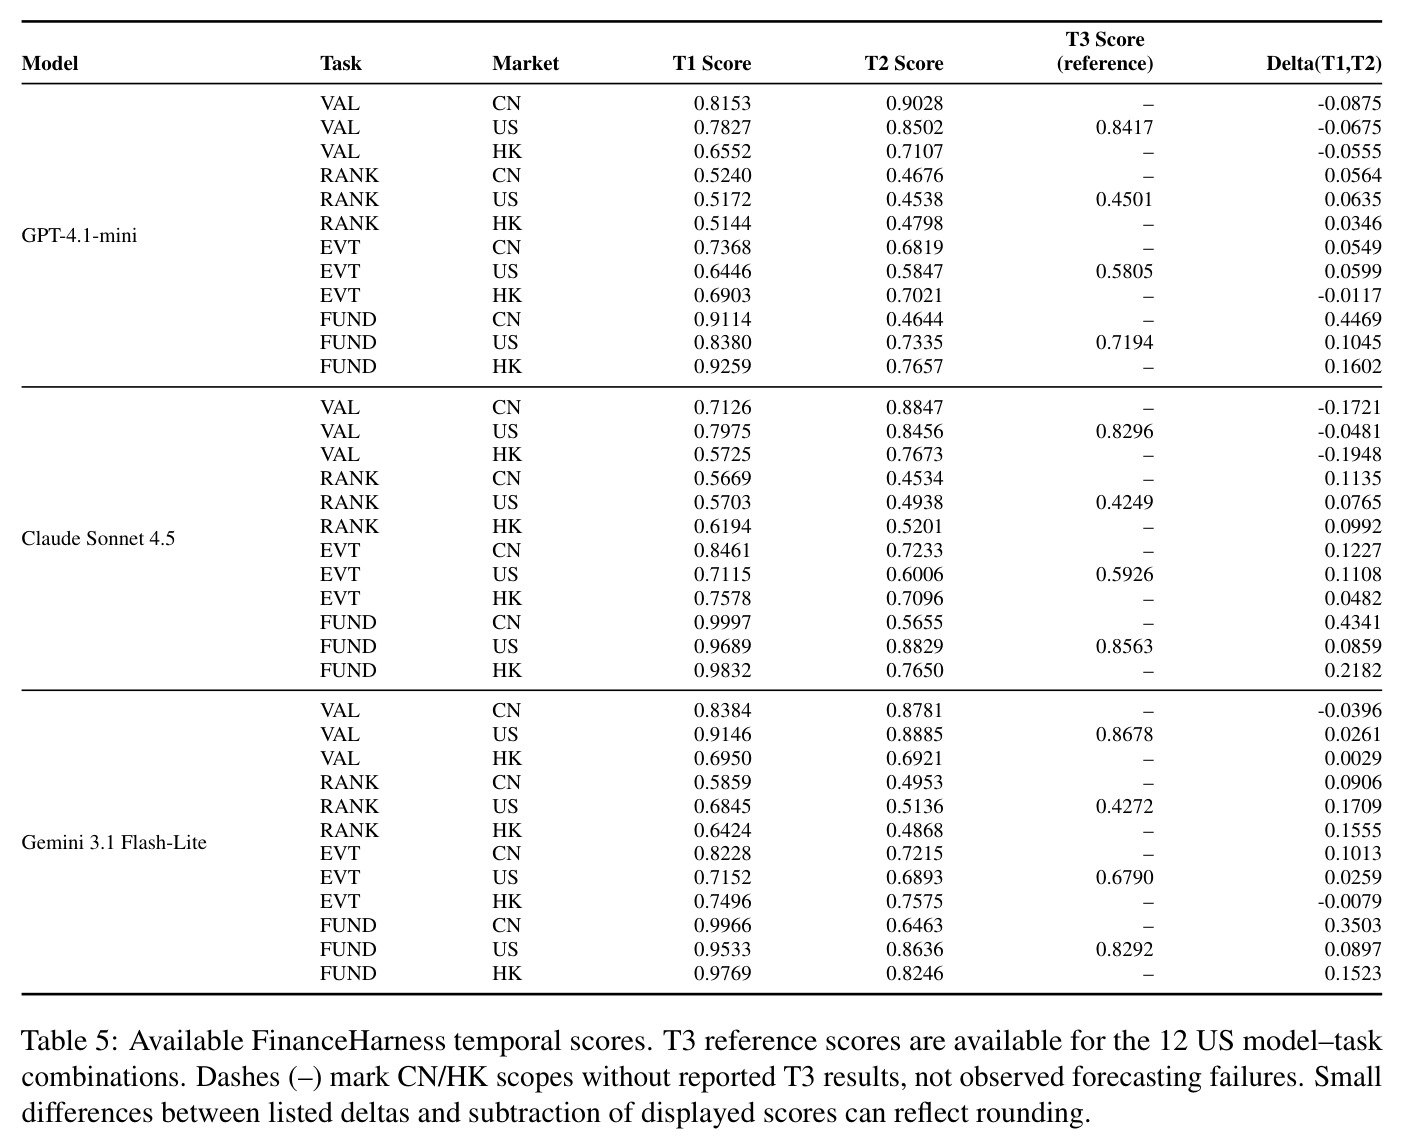
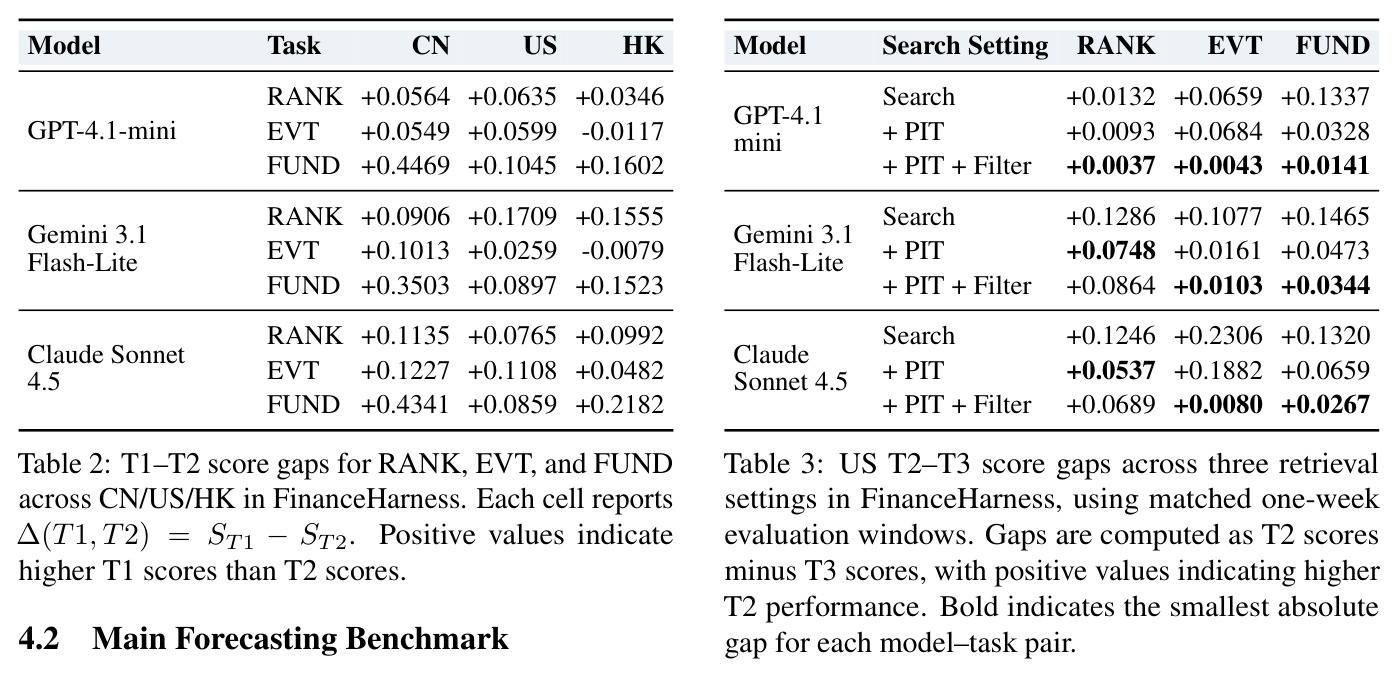
五组核心发现。第一,历史记忆效应普遍:FinanceHarness 的 27 组时序比较中 25 组 T1 高于 T2,RANK 与 FUND 全部为正,最大差距是 GPT-4.1-mini 的中国市场 FUND,$\Delta(T_1,T_2)=+0.4469$,Gemini 3.1 Flash-Lite 同项 +0.3503,说明预训练回测会让背诵伪装成预测。第二,检索控制显著改善回测-实时一致性:美区匹配一周窗口的 9 个模型–任务对上,仅搜索的平均绝对 T2–T3 差为 0.1203,加 PIT 降至 0.0618,再加 LLM 过滤器降至 0.0285(下降约 76%),且 9 组全部缩小。第三,框架效应明显但无绝对赢家:Overall 最高是 GPT-Researcher + Gemini 3.1 Flash-Lite(0.7099)与 FinanceHarness + Gemini(0.7049);Phi-4 在 Open Deep Research 中 VAL 最高(0.8956);Claude Sonnet 4.5 在 Claude Code 上 CF/CALC 满分 1.0000,Overall 却只有 0.6292,低于其 FinanceHarness 的 0.6797——推理强不等于预测强。第四,市场层面:六模型均在美区最高,但 DeepSeek V4 Flash 以 0.6825 领跑中国、Gemini 以 0.7480/0.6698 领跑美港,无模型通吃三市场。第五,鲁棒性与归因:Prompt Change Rate 16.83%–23.67% 高于数值扰动的 7.00%–9.17%,但平均 Score Delta 绝对值均低于 0.0026——个体预测会被措辞翻转,聚合分数却稳定;过滤后 T2–T3 差距仅 0.0043–0.0267,T3 实时分数 EVT 0.5805–0.5926、FUND 0.7194–0.8563,证明受控 T2 可作实时成绩的可靠近似。
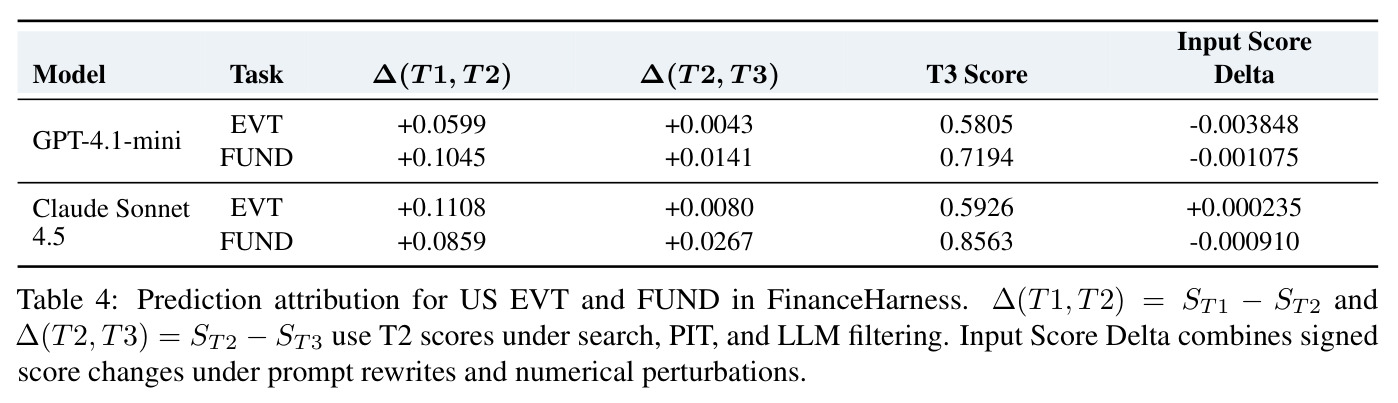
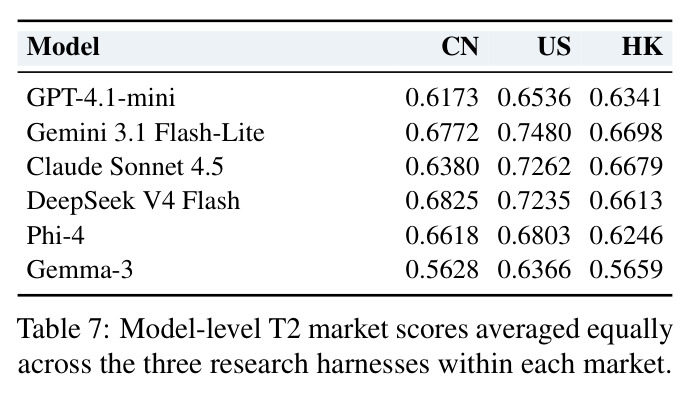
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 受控回测逼近实时成绩(美区匹配一周窗口,9 个模型–任务对) | 平均绝对 Δ(T2,T3) | 0.0285(PIT + LLM 泄漏过滤器) | 0.1203(仅搜索,无时间检查) | 差距缩小约 76%,且 9 组对比全部改善 |
| T2 综合预测 Overall(22 配置横评) | Overall(VAL/RANK/EVT/FUND 均值) | 0.7099(GPT-Researcher + Gemini 3.1 Flash-Lite);FinanceHarness + Gemini 0.7049 | 同榜最低 Open Deep Research + GPT-4.1-mini 0.6018 | 最好比最差高约 0.108,且无单一 harness 全面占优 |
| FUND 财务指标预测(FinanceHarness, T2) | FUND 分数(截断逐实例效用) | Gemini 3.1 Flash-Lite 0.7476;DeepSeek V4 Flash 0.7337 | 同框架最低 Gemma-3 0.4061 | 最强与最弱模型相差 0.3415,任务间能力分化显著 |
| 能力诊断 CF/CALC(Claude Code harness) | CF 依从率 / CALC Exact Match | Claude Sonnet 4.5 双满分 1.0000 | 其 Overall 预测分仅 0.6292,低于 FinanceHarness 的 0.6797 | 诊断与预测分数解耦,证明推理能力强不等于预测强 |
| T1 记忆效应(FinanceHarness,中国市场) | Δ(T1,T2) = S_T1 − S_T2 | GPT-4.1-mini FUND +0.4469(全表最大) | 若模型纯粹靠预测,差距应接近 0 | 25/27 组 T1>T2,实证预训练记忆污染历史回测 |
局限与改进
作者明确承认三点局限:point-in-time 重建只是近似——网页、元数据、快照未必等于当时投资者真正可见的信息;中、美、港三市场在披露规则、语言覆盖、数据供应商与信息发布节奏上差异很大,跨市场比较只能作为诊断稳定性证据,不能当作市场难度的因果估计;T2 是实用的回溯代理而非 T3 实时评测的替代品,二者的关系必须经验测量。我的补充观察:CF 与 CALC 各只有 30 条记录,满分 1.0000 很可能存在天花板效应,统计功效不足;LLM 泄漏过滤器本身依赖单一模型(DeepSeek-V4-Flash),其漏检与误杀没有独立校验,可能系统性影响分数;RANK 分数普遍停留在 0.44–0.50 区间(接近随机水平),要么任务过难、要么指标分辨率不足;VAL 因对短周期价格波动敏感被排除在时序分析之外,使其结论覆盖面打折扣;此外基准完全依赖公开信息,无法覆盖卖方研报等非公开信息流。
独立分析的弱点
独立分析可见四个弱点。其一,泄漏过滤是单点故障:整个时间有效性保障押在一个过滤器模型上,若其对中文财经文本或港股披露格式漏检,T2 分数会被高估,改进方向是多模型投票、人工抽检与网页存档(如 Wayback Machine)交叉比对。其二,诊断任务样本太小:CF/CALC 各 30 条,难以支撑「满分」结论,且 CF 的配对设计若被模型识破套路会虚高,应扩容并引入对抗性模板。其三,回测-实时迁移的验证范围窄:只在美区、匹配一周窗口、9 个模型–任务对上做了 T2 vs T3 对比,其他市场与更长预测期的迁移性未知,应滚动扩窗累积证据。其四,harness 内部机制是黑箱:Claude Code 推理满分但预测落后(0.6292 vs FinanceHarness 0.6797),论文只报告现象未分解原因——是搜索调用模式不同、prompt 组装不同还是工具选择不同?应做工具轨迹层面的消融分析,给出可操作的 harness 设计指南。
未来方向
作者提出的方向是检验「新鲜的 T2 反馈能否帮助 autoresearch 系统改进 T3 预测」,即在金融场景探索递归自我改进(RSI):让系统用回测反馈迭代自身策略,再用实时成绩验证改进是否真实。基于本文成果还可自然延伸:一是利用论文强调的可配置生成器,为未来前沿模型滚动生成新的共享 T2 窗口,形成持续评测的基础设施;二是把三市场扩展到更多司法辖区(欧洲、日本)与更多资产类别(债券、汇率、大宗商品),检验市场间结论的稳定性;三是把页级泄漏审计从评测工具升级为训练信号,微调 PIT-aware 的检索器或用检索策略干预构造 RL 奖惩;四是引入成本与延迟维度——当前 22 配置的分数未与 API 调用次数、Token 消耗挂钩,而实际部署中性价比同样是关键指标;五是深挖 harness 效应,建立「模型 × 框架 × 工具配置」的系统化消融,解释为何 Claude Code 推理满分却预测落后。
复现评估
复现条件较好。代码与基准数据论文声明公开可得;所有数据来自公开源——Yahoo Finance 行情、SEC EDGAR、CNINFO 与沪深交易所、HKEXnews 披露、美中港官方统计部门宏观数据,无付费数据壁垒。评测不涉及训练,算力需求主要是 LLM API 与搜索 API 的调用费用:22 个模型–框架配置乘以 1,119 条记录再乘多检索策略,外加 prompt 改写与数值扰动的配对重跑,推理开销可观但可按需裁剪子集。主要门槛有三:FinanceHarness(Xiao et al., 2026)并非本文出品,需另行获取;LLM 泄漏过滤器固定使用 DeepSeek-V4-Flash 的 2026 年 4 月版本,版本漂移会影响过滤行为;GPT-5.4、Claude Opus 4.6、Gemini 3.1 Flash-Lite 等商业模型的 API 访问有成本。T3 部分必须在事件解决后才能评分,实时复现受日历限制,建议先复现 T2 与诊断任务,再滚动积累 T3。总体属于中等难度、高确信度的复现。
论文图表
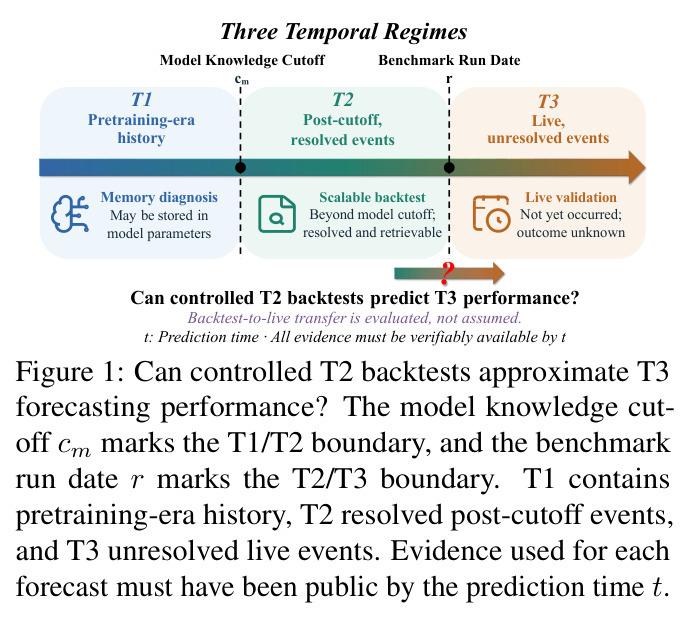
图把评测时间轴划分为三个区间:T1 预训练时代历史(预测日期与结局解决均在 $c_m$ 之前,模型参数可能记得答案)、T2 截止后已解决事件(预测在 $c_m$ 后、结局在运行日期 $r$ 前落地,可即时打分且无预训练暴露)、T3 实时未来事件(结局未知,需等解决后打分)。图侧还标注各区间证据可用性:T1 历史可检索但可能被记住,T2 已解决且可检索,T3 结局未知;核心问句是「受控 T2 回测能否预测 T3 表现」——回测到实时的迁移是被检验的对象,不是被假设的前提。
这张图定义了全文最重要的概念框架 T1/T2/T3,是理解所有实验设计(时序对比、检索控制、匹配窗口)的前提;不看懂三个区间的边界定义,就无法理解为什么 T1 分数偏高意味着记忆效应、T2–T3 差距小意味着回测可信。