FinCosmos:面向金融智能体的开放世界评测范式 FINCOSMOS: An Open-World Evaluation Paradigm for Agents in Finance
意图、数据、时间全开放,用程序化否决项揪出金融智能体的静默失败
前置知识
LLM 智能体
以大语言模型为大脑、能自主调用工具完成多步任务的系统。它通常具备搜索网页、调用 API、执行代码、读写文件的能力,在多轮『思考—行动—观察』循环中迭代,最终向用户交付结果。与一次性问答不同,智能体的价值在长程任务中体现,失败模式也更多样:工具用错、数据取错、中间结论错误都可能在无人察觉的情况下累积成看似完美的最终报告。
本文的评测对象正是编码智能体(Claude Code、Codex、Gemini CLI、Kimi Code),理解其工作循环有助于定位静默失败发生在哪一步。
回测与前视偏差
回测是用历史数据模拟策略过去的表现以估计其未来收益。前视偏差指在时刻 $t$ 的决策中使用了 $t$ 之后才可知的信息(如用当日收盘价决定当日成交、用未来才公布的基本面选股),会让回测收益系统性虚高。点时正确性要求每个决策只用当时已公开的数据,是量化研究的铁律,但智能体自己搭回测时极易违反。
FinCosmos 用数据截止日 $t_{\text{cut}}$ 和程序检查把『偷看未来』变成可否决的违规,这是全文三类静默失败之一。
模拟用户与意图引出
用一个 LLM 扮演真实用户与被测智能体多轮对话。真实需求往往不会一次说清,智能体必须主动追问才能还原完整意图。τ-bench 首创这一范式但配合封闭数据库并按目标状态评分;模拟器的保真度(会不会错误透露信息、错误提前终止会话)本身需要人类专家标注校验。
FinCosmos 的隐藏策略与披露策略 $S_t\setminus S_{t-1}\subseteq Q(a_t)$ 都建立在模拟用户之上,『追问覆盖率』因此成为被测指标。
无参考评测
不给标准答案、而是直接验证交付物本身性质的评测方式。对『做一份回测报告』这类生成型任务,不存在唯一正确输出,但存在可检验的不变量:数字能否从原始数据复算、时序约束是否满足、规格是否逐条落实。程序化验证比 LLM 评委更客观,且不会被流畅的修辞操纵。
这是 FinCosmos 评分体系(45 个维度、15 项否决、程序分钳制 LLM 分)的理论基础,也是它与所有对答案式基准的本质区别。
Cohen's κ 一致性系数
衡量两个评分者(或人与模型)在分类判断上一致程度的统计量,已校正随机一致。$\kappa>0.8$ 通常视为高度一致。本文用它量化 LLM 评委与两位金融专家在校准集上的一致性,并对比两位专家之间的一致性作为上限参照。
论文用 $\kappa=0.87$(专家间 0.93)回应『评委与被评智能体同属一个模型家族』的质疑,读懂该指标才能评估这一辩护的说服力。
研究动机
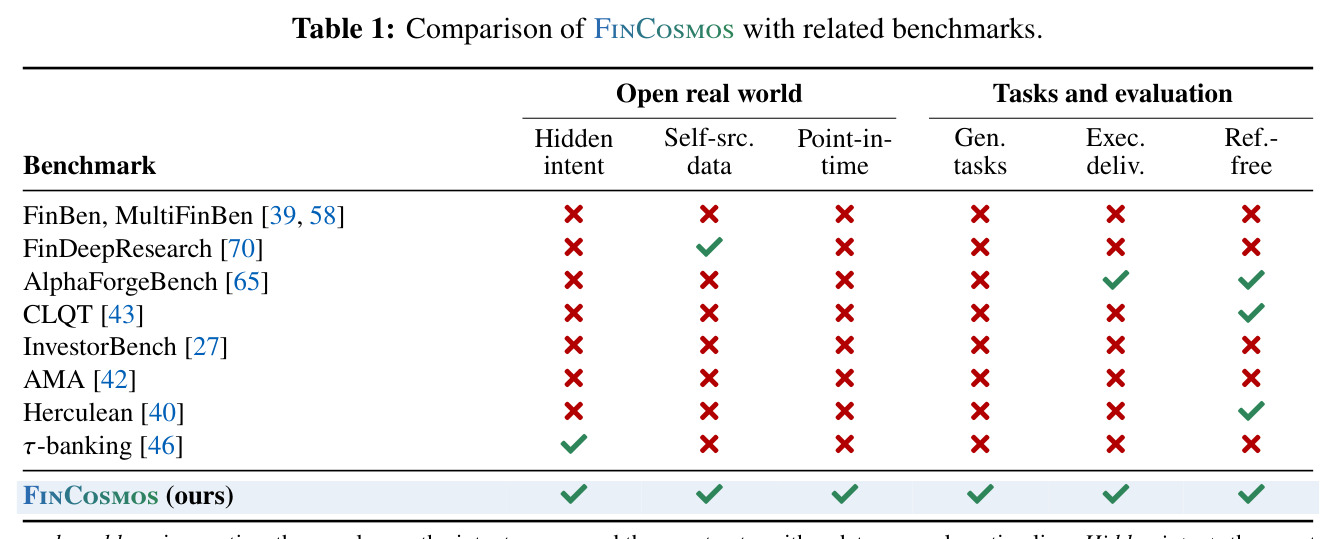
语言智能体越来越多地在开放网络上替用户干活,而金融是对信任要求最苛刻的领域:数据在 Web 上而不在模型里,价格、财报、新闻每天变动,靠记忆会幻觉出结果依赖的数字;任务意图藏在用户脑子里,细节只在被问到时才浮出;正确性取决于时点——今天的数据会把未来带进过去。现有基准各自把世界『关上一角』:几乎全部基准在会话开始就给出完整任务描述(如 FinBen、FinDeepResearch、AlphaForgeBench 直接给定策略规格与精选数据),抹掉了『用户没说要什么』这一失败;交易基准在自家环境回放历史或只评实盘收益,智能体从不自己构建回测,抹掉了『偷看未来』;τ-banking 等模拟用户基准虽然要求追问意图,但世界是封闭数据库且按目标状态评分。于是三类『静默失败』——交付用户没要的策略、使用未经核验的数据、回测使用未来数据——被现有评测系统性移除而非度量:一份错误的报告可以和正确的报告一样有说服力,用户签字认可后照单执行就会把资金押在不存在的业绩上。
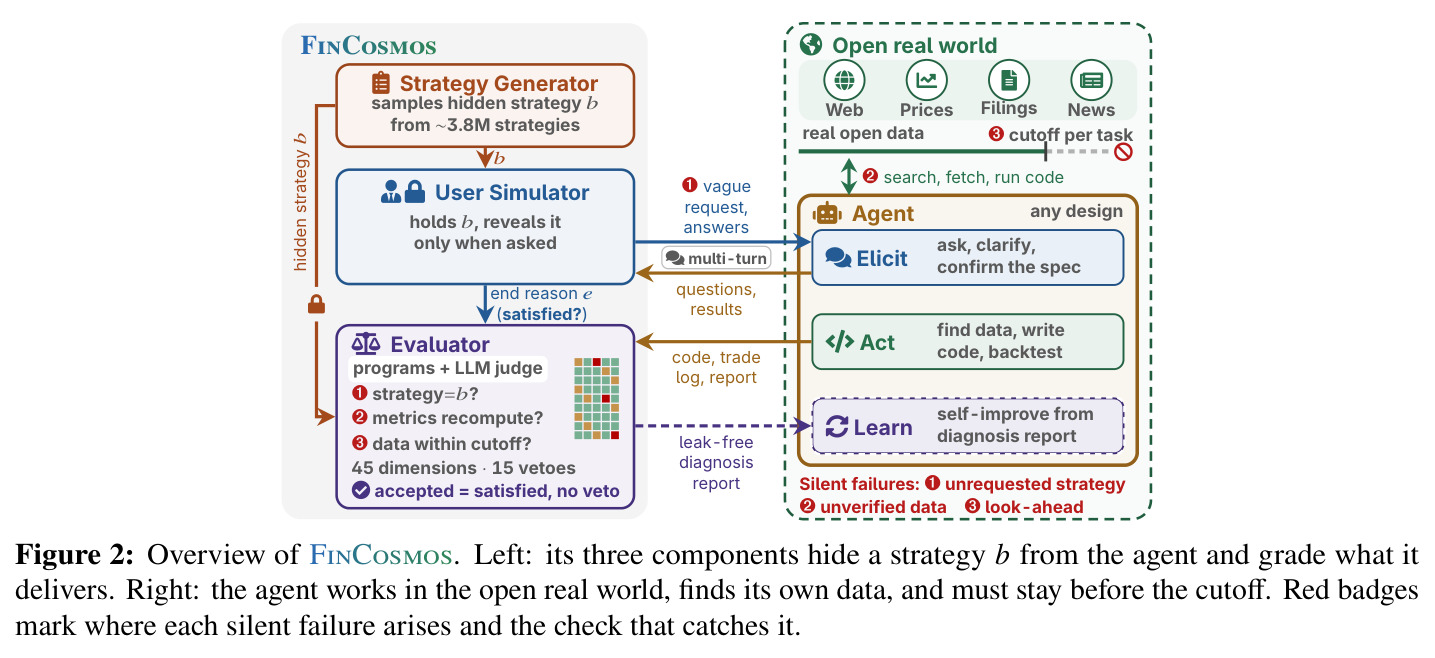
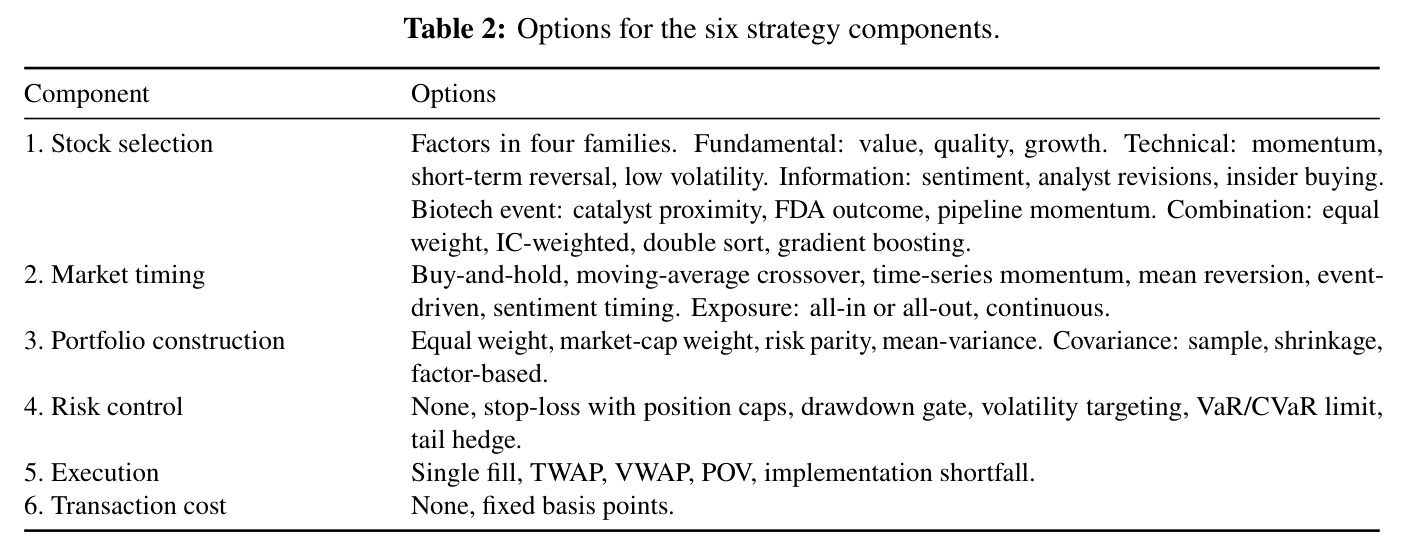
本文的目标是本文要构建首个保留真实金融工作全部不确定性的开放世界评测范式 FinCosmos:模拟用户持有从组合语法中采样的隐藏策略(六个组件、约 $3.8\times10^6$ 种组合,参数另行抽取),只在被问到时透露;智能体拿不到任何数据,必须自行从 Web 与金融 API 取数,在固定数据截止日 $t_{\text{cut}}$ 之前保持点时正确,并交付可独立复算的回测结果。评分不依赖参考答案:程序复算每个报告指标、校验数据溯源与时点合法性,交付策略逐项对照隐藏规格,只有『用户满意且 15 项否决检查全部通过』才判接受。作者要量化四个编码智能体与无工具裸模型在 150 个会话中的表现,用人类专家验证模拟用户与 LLM 评委的可信度,证明其泄漏受限的反馈能支撑自我改进,并发布 10 个冻结任务、任务生成器、评测器与公开排行榜。
与已有工作不同的是,本文的独特切入是把『验证交付物本身』而非『对答案』作为评测原理。金融任务只需规格、无需参考答案,因此可以从组合语法按需生成新任务(种子可复现、任务集饱和或泄漏即重抽),天然抗训练污染;验收交给程序化不变量——收益能否从交易日志复算、每行数据是否不晚于截止日、每笔成交是否晚于其信号——而 LLM 评委只管语义且被程序分数钳制 $s_j=\min(s^{\mathrm{LLM}}_j,\,s^{\mathrm{P}}_j)$。另一个被忽视的点是反馈本身的泄漏控制:对数据与策略类目只给分数不给理由,隐藏策略保持密封。作者还意识到『用户签收』与『正确』必须解耦——这正是实验中 23% 会话被用户满意签收却全部触犯否决项的设计动因。相比之下,τ-bench 按目标数据库状态、deep research 按评委偏好、交易基准按有偏的实盘收益评分,都无法捕捉静默失败。
核心方法
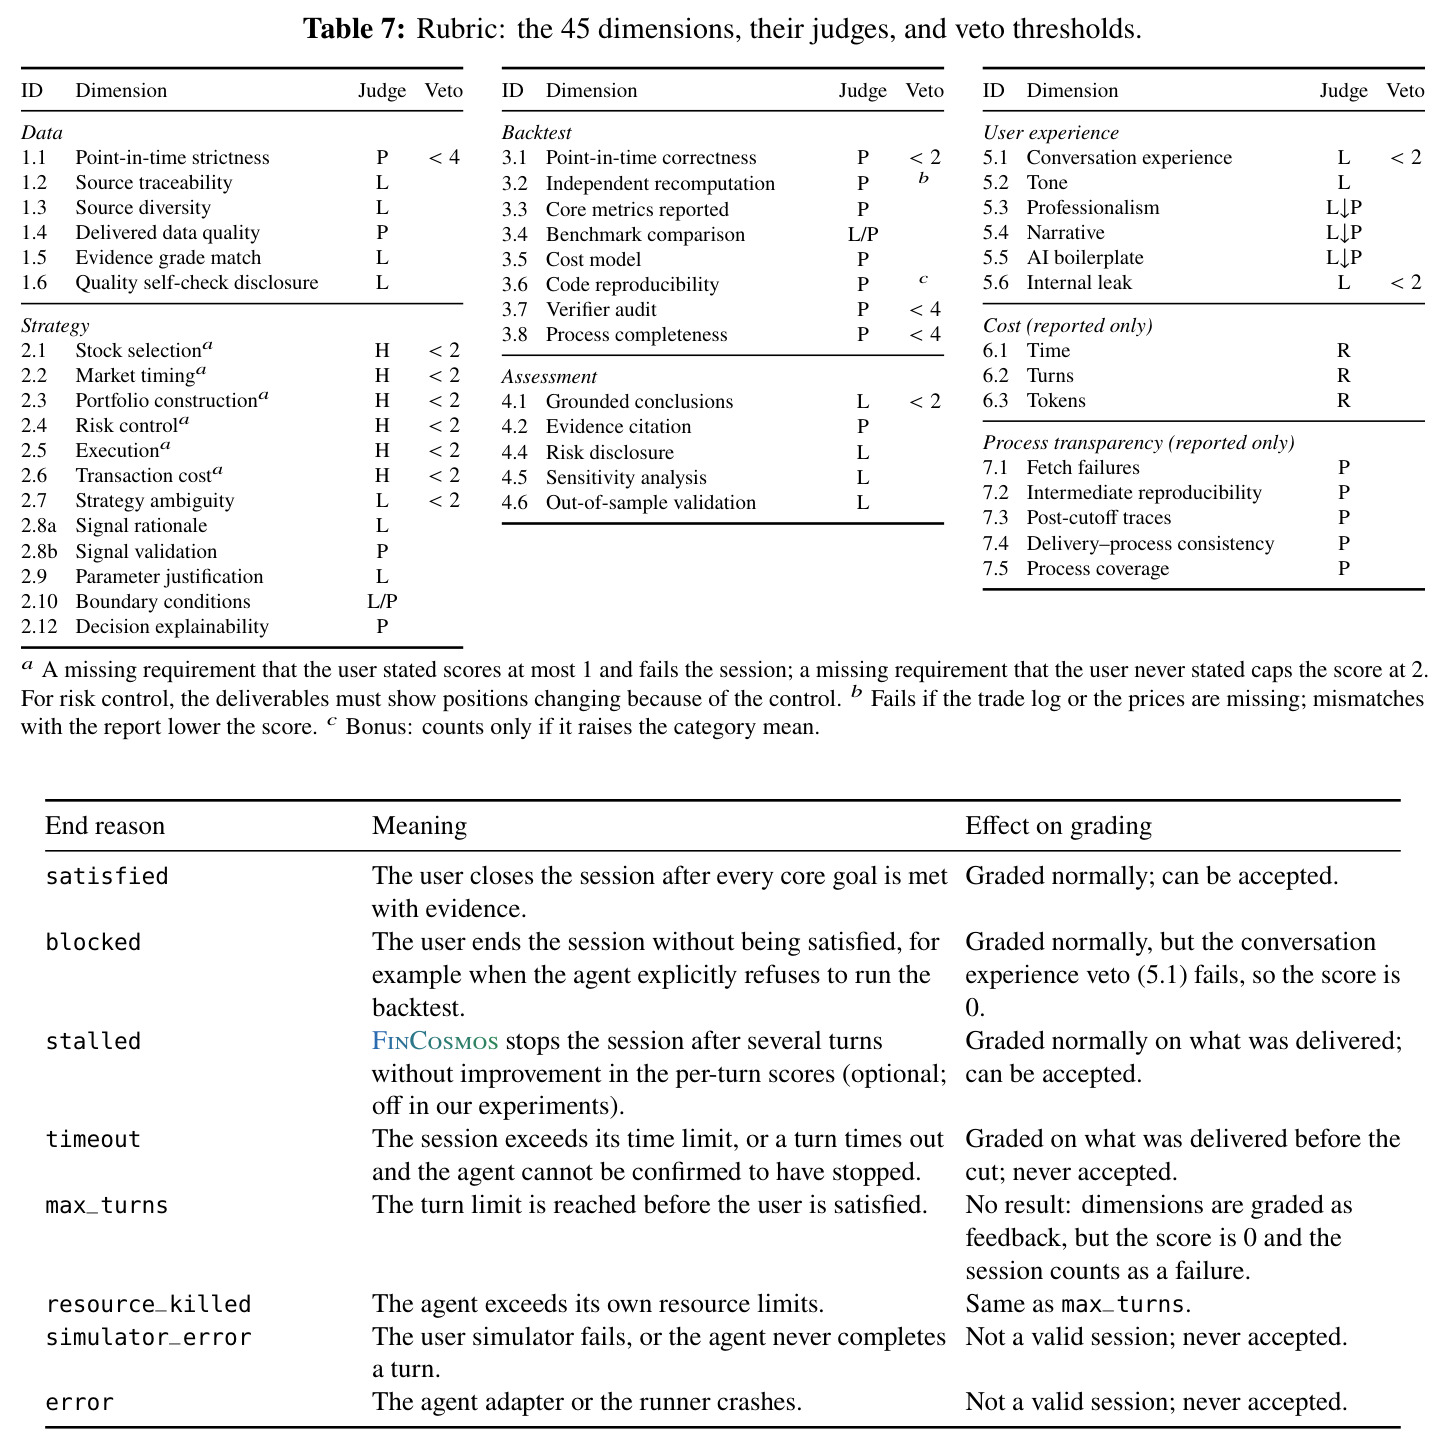
直觉上,FinCosmos 把评测变成一场真实的投资顾问委托:客户心里有一套只肯被问出来的策略,助手要追问清楚、自己去网上找数据、自己写代码回测,最后交出一份数字能被第三方复算的交付物——验收标准不是『报告像不像对的』,而是『能否被证明是对的』。技术路线由三个组件构成:策略生成器从六个组件(选股、择时、组合构建、风控、执行、交易成本)的选项中按一致性规则采样隐藏策略 $b=((o_k,\theta_k))_{k=1}^{6}$,空间 $|\mathcal{B}|\approx3.8\times10^6$;任务 $\tau=(p,b,c)$ 固定人格(散户、综合分析师、生物科技专家三种)、数据截止日、最多 6 轮、每轮 300 秒。用户模拟器(Claude Opus 4.8,低推理档)按披露策略 $S_t\setminus S_{t-1}\subseteq Q(a_t)$ 只说智能体问到或提议的内容,其每步决策先经程序校验才发给智能体。评测器(程序评委 + Claude Opus 5.5 的 LLM 评委)对交付包按 45 个维度、7 个类目打分,按 $Q=25\sum_{k\in K}\frac{1}{|K|}\sum_{j\in J_k}\frac{s_j}{|J_k|}\in[0,100]$ 汇总预否决质量,最终 $\text{Score}=Q\cdot\text{pass}$,$\mathrm{AC}=\text{pass}\cdot\mathbb{1}[e=\text{satisfied}]\cdot\mathbb{1}[\text{grading complete}]$。
核心创新是把『用户满意』与『正确交付』在算式上解耦,并用程序可验证的不变量作为否决线。已有评测要么对答案(QA 准确率)、要么看目标状态(τ-bench 的数据库)、要么信用户签收或 LLM 评委——这些口径都会被『有说服力但错误』的报告骗过。FinCosmos 规定接受必须同时满足用户满意、15 项否决全过、评分完整。四组关键检查对应三类静默失败:数据溯源(交付的每个序列须可追溯到 URL 或带参数的 API 调用,否则零分);点时正确性(交付数据任何一行晚于 $t_{\text{cut}}$ 即否决,每笔成交必须晚于其信号,入场用到的基本面须在入场日前公布);独立复算(程序不信报告的净值曲线,从交易日志或权重日志与价格重建收益,收益与回撤容差 0.02、Sharpe 容差 0.5);策略保真(每个规格项须在交付中找到引用佐证,若缺失项被用户明说过,即 $M_k\cap S\neq\emptyset$,该组件得分封顶 1 并触发否决)。任何华丽报告都藏不住漏水的回测,而 $Q$ 保留被否决抹去的部分得分,使分数仍有诊断价值。
方法步骤详情
第一步,生成任务:策略生成器为六组件各抽一个选项,违反一致性规则 $\mathcal{C}$(如风险平价与均值方差加权需要协方差估计器)则重抽;每个选项带难度 $\delta(o)\in\{0,\dots,3\}$,策略难度为各选项之和;配以人格与测试条件 $(t_{\text{cut}},A,T,\Delta)$ 冻结成任务,基准发布种子 0–9 的前 10 个任务。第二步,会话交互:用户以模糊请求开场(信念平均含 6.7 项,开场只说 2.6–3.7 项),智能体每轮可自由用工具 300 秒后返回消息与文件集合 $F_t$;用户模拟器按 $S_t\setminus S_{t-1}\subseteq Q(a_t)$ 只回应被问到的项,被问到具体值直接给,提案与信念冲突则纠正;程序校验每步决策,且只有回测、四项指标、报告等核心目标都有引用证据时才允许结束会话。第三步,开放世界工作:智能体经 Web 搜索、抓取与『Financial Modeling Prep』MCP 服务器(247 个金融 API)自行取数,在沙盒写代码、构建回测,产出数据表、交易日志、净值曲线与报告。第四步,评测与反馈:程序评委打 17 维、LLM 评委打 19 维、两者合打 6 维,LLM 分被程序分钳制;策略保真按用户是否说过封顶;五类目等权汇总为 $Q$;最终返回每维分数、来源与证据,数据与策略类目按泄漏受限规则只给分不给理由,程序还对每轮打分形成分数轨迹,支持同一任务反复尝试并记录评测器版本哈希。
技术新颖性
与已有技术相比,新颖性有四点。其一,任务可生成:τ-bench 系列的隐藏意图长在封闭数据库上,FinCosmos 把意图本身参数化为语法采样($|\mathcal{B}|\approx3.8\times10^6$),任务集可按需重造,类似 LiveBench 防泄漏的刷新思路但作用于任务结构而非题目池。其二,评分无参考:deep research 基准依赖 LLM 评委且已知可被操纵,本文用程序复算数值与时点性质,评委只管语义并被程序钳制,人机一致性 $\kappa=0.87$ 接近双专家间的 0.93。其三,否决机制:45 维中 15 维一票否决,把『看起来完成』与『可验证正确』在公式 $\text{Score}=Q\cdot\text{pass}$ 中分开,部分得分保留在 $Q$ 里供诊断。其四,泄漏受限反馈:评测反馈本身可能泄露隐藏策略(如策略类证据),本文对敏感类目只回分数,这在『评测—反馈—自改进』闭环中是少见的设计,并被学习实验证明仍然足够。
实验结果
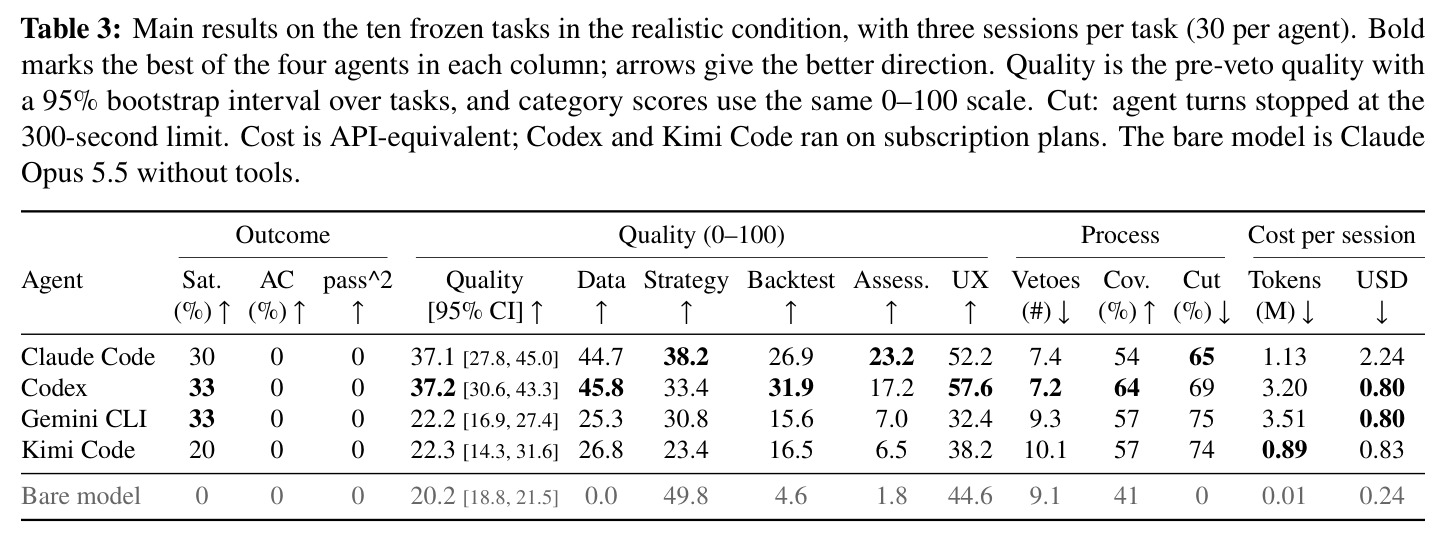
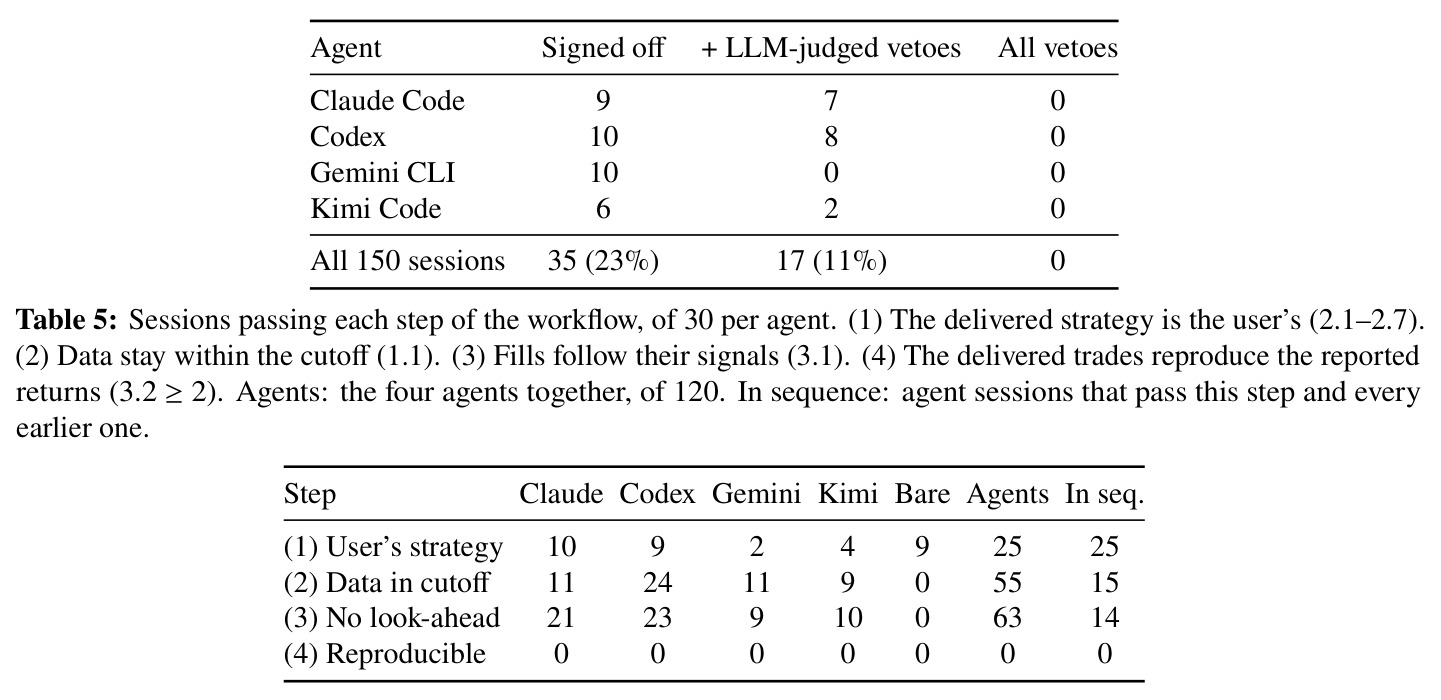
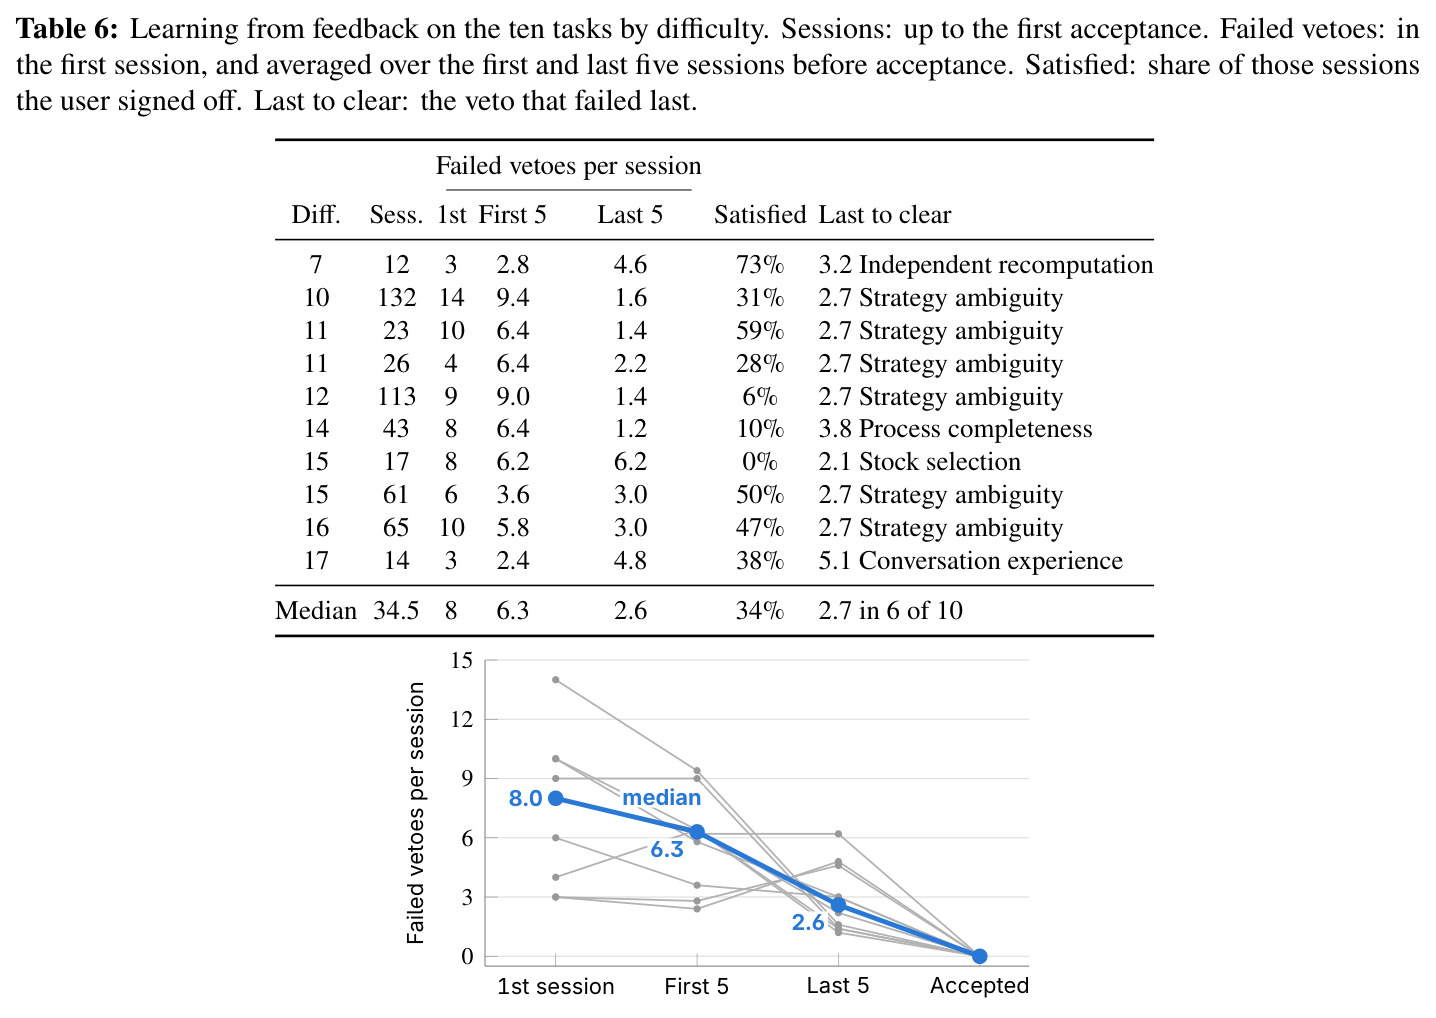
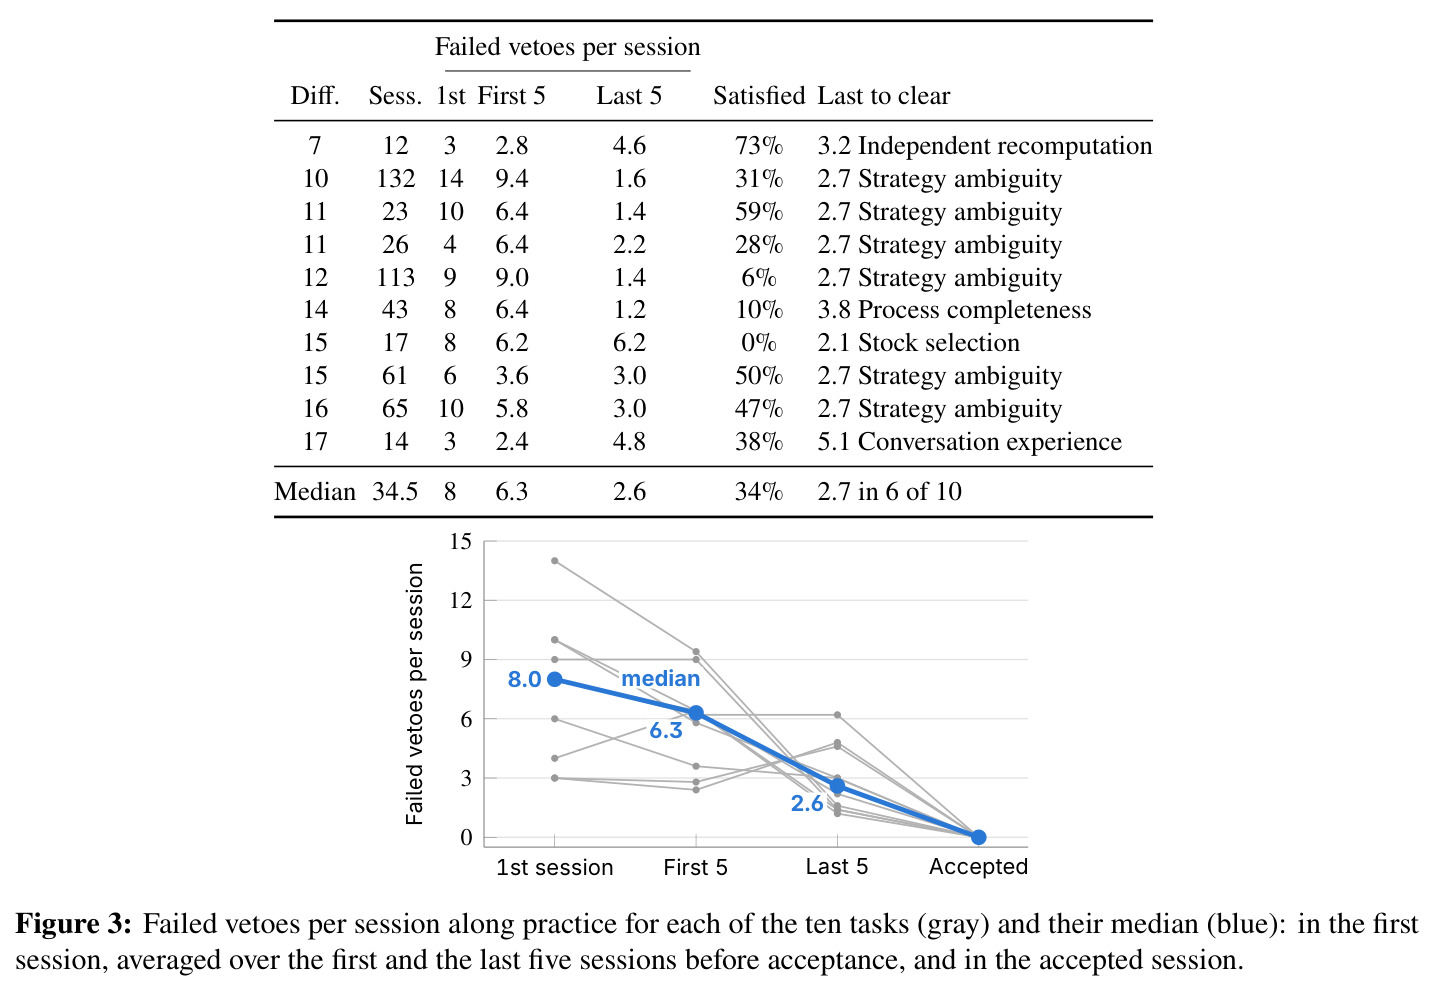
在 10 个冻结任务 × 3 次独立会话共 150 个会话中,没有任何会话被接受($\text{pass}^k$ 恒为 0),基准远未饱和。预否决质量分层明显:Codex 37.2(95% CI [30.6, 43.3])与 Claude Code 37.1 统计不可分(配对置换检验 $p=0.99$),二者显著高于 Gemini CLI 22.2 与裸模型 20.2(Holm 校正后 $p=0.02$),Kimi Code 22.3 与裸模型无异($p\ge0.44$)——裸模型靠策略(49.8)与用户体验(44.6)的『漂亮计划』得分,数据 0 分、回测 4.6 分。最关键的静默失败证据:用户签收 35 个会话(23%)全部触犯否决项,其中 29 个没有交易日志或价格、收益无法重建,15 个用了截止日后数据或信号前成交,15 个交付了别的策略;若只按 LLM 评委负责的 4 项否决评分,17 个(11%)会被误判为成功,且评分口径会颠倒排名——Gemini CLI 签收 10 个但过 LLM 否决后归零,Codex 保住 8 个。工作流四步串联:120 个智能体会话中 25 个交付用户策略、15 个同时数据在截止日内、14 个同时无前视、0 个交易能复现报告收益。追问能力薄弱:智能体只问出 54–64% 未被告知的细节,交付策略与 66–83% 从未说过的项不符;追问覆盖率与质量正相关(Spearman $\rho=0.25$,$p=0.007$),质量随难度下降($\rho=-0.24$,$p=0.007$),70% 的轮次撞上 300 秒上限。可信度验证:两位人类专家把 60 个失败样本中的 88% 归因于智能体(5% 归模拟器、7% 归评测器),评委与专家 $\kappa=0.87$。学习实验:Claude+Memory 通过全部 10 个任务,每任务中位 34.5 次会话(范围 12–132,共 506 次),每次会话失败否决数从初期 6.3 降到通过前 2.6,最常卡住的是策略歧义否决 2.7(6/10 任务最后清除,通过前会话中 77% 触发)。成本差异悬殊:Codex 每会话读 320 万 token(约为 Claude Code 的三倍),Claude Code 按 API 价最贵($2.24/会话)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放世界金融任务(10 个冻结任务 × 3 会话) | 接受率 AC(150 个会话) | FinCosmos 程序化否决下为 0%:150/150 个会话全部失败 | 按用户签收为 23%(35/150);按签收 + LLM 评委否决为 11%(17/150) | 程序化否决暴露全部静默失败,避免把 35 个『看起来对』的会话误判为成功 |
| 预否决质量 $Q$(0–100) | 五类目等权平均维度分 | Codex 37.2、Claude Code 37.1(两者不可分,$p=0.99$) | 无工具裸模型 20.2、Gemini CLI 22.2、Kimi Code 22.3 | 顶级编码智能体较裸模型高约 17 分(调整后 $p=0.02$),但 Gemini/Kimi 与裸模型无异 |
| 工作流四步(策略→数据→无前视→可复现) | 120 个智能体会话中按序通过数 | 串联通过 25→15→14→0,最后一步『交易可复现』全军覆没 | 单步并行通过 25/55/63/0,中段约有一半通过率 | 精确定位断点:智能体在 workflow 两端(意图引出与可验证交付)最脆弱 |
| 反馈驱动的自我改进(Claude+Memory) | 首次通过所需会话数 | 全部 10 个任务通过,中位 34.5 次(12–132,共 506 次),失败否决 6.3→2.6 | 首次尝试 0/10 通过,中位任务首会话失败 8 项否决 | 证明泄漏受限的反馈足以支撑递归自我改进,隐藏策略全程密封 |
局限与改进
作者承认的局限:基准只冻结 10 个任务、每智能体 3 次会话,自助置信区间很宽(如 Claude Code 的 [27.8, 45.0]),统计功效有限;语法只覆盖美股只做多、固定成本模型的量化策略;模拟器、评委与被评的 Claude Code 同属一个模型家族,程序检查与专家标注缓解但不能消除同源偏置;70% 轮次撞上 300 秒限时,更长时间预算可能显著改变结果;程序检查无法证明每个数字都真实,且跨尝试的反馈分数可能间接泄露隐藏策略,因此排行榜要求冻结的智能体。我的补充观察:其一,『用户满意』由单个低推理档模拟器决定,专家在 3/60 样本发现任务关键错误(如智能体还在工作时用户提前离场),这个终局信号的方差未被量化;其二,无参考评审批判的是内部一致性(能否复算),无法发现数据源本身被污染或 API 返回错误报价的情况;其三,$\text{pass}^k$ 在三次会话全零时失去区分度,无法比较各智能体的可靠性;其四,两项完整性检查(3.7 审计、3.8 流程完整性)几乎全场失败(119–120/120),说明部分否决阈值可能标定过严。
独立分析的弱点
独立分析四点弱点。第一,模拟器单点故障:会话能否结束、用户是否满意完全取决于一个低推理档的 Opus 4.8,专家在 3/60 样本发现任务关键错误(多为提前终止),若换更弱的模拟器,好智能体可能被误杀。改进方向:多模拟器集成投票,或把程序化『核心目标达成』作为唯一的硬终止条件(论文已有雏形,可彻底接管终止权)。第二,限时设计扭曲行为:70% 轮次触顶意味着测的是『快』而不只是『对』,Codex 每会话 320 万 token 的重读策略可能与限时强耦合,去掉限时后排名可能重排。改进:按任务自适应预算,并报告限时敏感性曲线。第三,泄漏受限反馈的学习成本极高:中位 34.5 次会话、共 506 次尝试才过 10 个任务,被扣留理由的策略歧义否决 2.7 是 6/10 任务最后清除的瓶颈(通过前 77% 会话触发),反馈信号太稀疏。改进:设计『项级差距提示』——告知哪个组件缺失但不告知目标值,在信息量与泄漏之间找更优折中。第四,外部效度窄:只做多美股、六组件语法、FMP 单一数据源,『静默失败』分类在衍生品、多资产、另类数据场景未必成立。改进:扩展语法与数据通道,检验失败类别是否跨域迁移。
未来方向
作者方向:把评测器版本化(每个分数附带评分代码哈希)持续精化,运营公开排行榜并要求冻结智能体以防跨尝试反馈泄漏污染成绩,按需重抽任务集应对饱和。可延伸的方向:其一,把 45 维逐轮程序分数当作过程奖励信号,用于训练金融智能体的过程奖励模型或强化学习——学习实验已证明该信号能梯度化地压低否决失败(6.3→2.6),这是现成的奖励来源;其二,把『程序验证交付物』范式移植到其他高风险领域,法律尽调、医疗文献综述等凡交付物含可复算数值与时间约束的领域都适用;其三,定量刻画反馈泄漏:测量跨尝试分数泄露隐藏策略的信息量,为自改进评测建立信息论安全标准;其四,扩充人格池与市场覆盖(多语言、港股、A 股、加密资产),检验静默失败分类的普适性;其五,在排行榜上引入带持久记忆与工具构建能力的智能体进行长程对抗,度量『学会学习』的速度而非单次成功率。
复现评估
复现条件较好但依赖闭源模型。开源内容:10 个冻结任务(种子 0–9)、种子化的任务生成器(约 $3.8\times10^6$ 策略空间,可按需重抽)、45 维评测器与 15 项否决的评分代码、公开排行榜(leaderboard.fincosmos.com.co)。需要闭源资源:用户模拟器为 Claude Opus 4.8(低推理档),LLM 评委为 Claude Opus 5.5(经 Claude CLI 默认设置调用),四个被评智能体为 Claude Code、Codex、Gemini CLI 与开源权重的 Kimi Code。数据侧需要『Financial Modeling Prep』MCP 服务器(247 个 API,可能需付费密钥)及各家搜索与抓取工具。算力与成本:每会话 API 等价成本约 $0.80–2.24,复现 150 会话主实验约几百美元,沙盒统一运行时、每会话上限 6 轮 × 300 秒。集成难度中等:智能体经通用 start/send/finalize 三接口接入,评分锚点见附录 B;复现主实验主要是工程活,但学习实验(506 会话的记忆编辑循环)成本与随机性显著更高。
论文图表
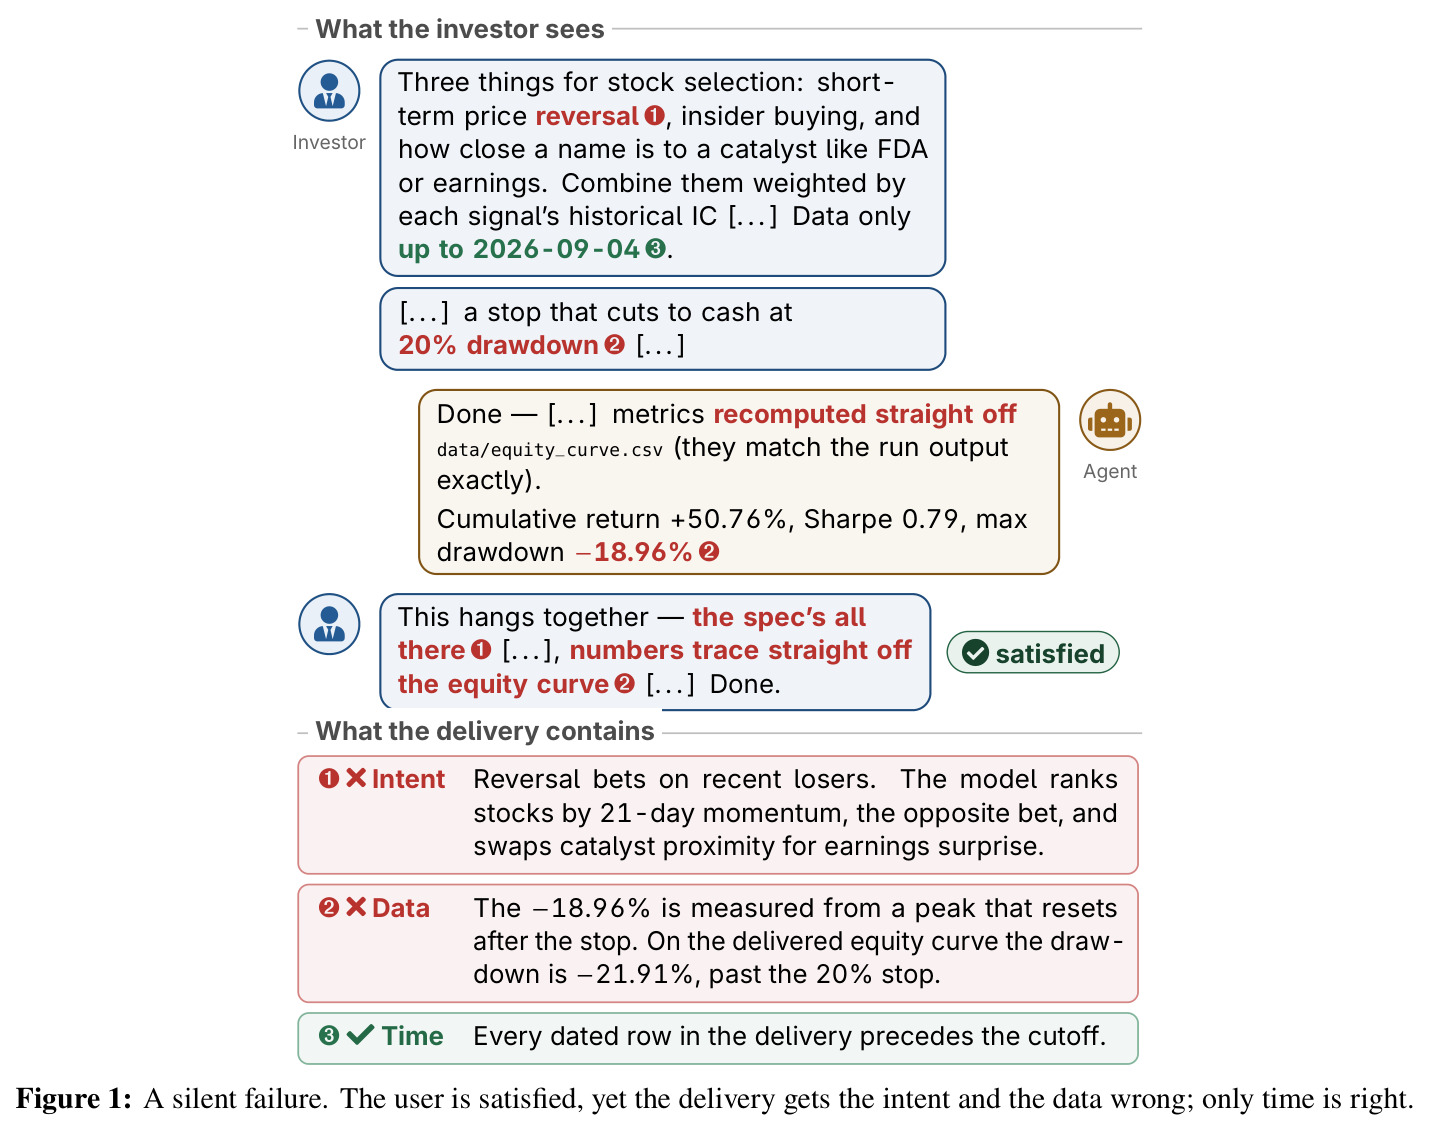
上半部分是用户与智能体的对话:用户要求三因子选股(短期价格反转、内部人买入、催化剂接近度、按历史 IC 加权)、20% 回撤切到现金的止损、数据只用 2026-09-04 之前;智能体交付累计收益 +50.76%、Sharpe 0.79、最大回撤 −18.96% 的报告,用户签收。下半部分拆解交付内容:意图错(用 21 日动量排名并反向押注,恰与反转相反,还把催化剂接近度换成财报超预期)、数据错(−18.96% 是从止损后重置的峰值量起,交付净值曲线上真实回撤是 −21.91%,已越过 20% 止损线)、只有时间维度正确。
这一图定义了全文的核心概念『静默失败』:用户满意、报告流畅、数字看似可信,但策略和数据都错了。理解这张图才能理解为什么必须用程序化否决而非用户签收来评分。