大模型并不知道它们知道什么:面向金融回测的时间性自我知识基准 FinDendro LLMs Don't Know What They Know: Benchmarking Temporal Self-Knowledge for Financial Backtesting
FinDendro证明LLM自报知识截止不可信:GPT-5答对76%却只认38%
前置知识
回测与前视泄漏(Look-ahead Leakage)
回测指让模型对历史时点做预测、再与真实结果比对以评估预测能力,是量化金融评估的标准做法。前视泄漏指模型训练数据中已含有该历史结果,因而所谓的预测其实是复述记忆而非推理,导致表现被系统性虚高。LLM 在这一点上尤其脆弱:互联网语料几乎收录了所有公开市场数据和财经新闻。
全文的问题意识都建立在泄漏会让回测失效之上,理解它才能理解为什么要审计那三道防线。
知识截止时间(Knowledge Cutoff)
厂商声明的训练数据截止日期,如 GPT-4o 为 2023 年 10 月、Llama-3.3-70B 为 2023 年 12 月。它描述的是训练语料的范围,而非模型实际记住的内容:Llama-3.3-70B 声明 2023 年 12 月,实测知识却在 2021 年第二季度后跌回随机水平;DeepSeek-V3.2 甚至没有公布截止。
论文的第一个检验对象就是声明截止是否等于行为意义上的知识边界,结论是不等于。
平衡准确率(Balanced Accuracy)
各类别等权平均的准确率,公式为 $\text{BalancedAcc}=\frac{1}{K}\sum_{k}\text{Acc}_k$。用于类别极不均衡的任务:美联储议息结果中维持不变占 78% 的月份,普通准确率会让永远猜不变的策略得 0.78 分,平衡化后只值约 0.33,从而暴露模型是否真能识别加息降息。
FinDendro 靠它加上持续性剔除把随机基线压到约 0.27,这是全部结论可信的前提。
时点模型(Point-in-time Models)
只用某个固定日期之前可得数据训练的模型,如 TiMaGPT、ChronoGPT、DatedGPT(1–1.5B 参数),训练集天然不含截止之后的结果,理论上可作为无泄漏回测的干净对照。但小模型连选择题格式都难以掌握,常固定选第一个选项。
论文检验了它们在截止前后是否表现出准确率落差,答案是落差不超过 0.041 且置信区间含零,尚不能当对照。
自我知识与校准(Self-knowledge / Calibration)
模型对自身知识状态的元认知:说我知道时是否真答得对、说不知道时是否真答不对。经典校准用置信度与正确率的一致性衡量(如 Kadavath 等的工作),本文改为用显式的知道/不知道选项声明来测,并首次把它放到时间轴上考察,问模型知不知道自己知识的终点在哪。
自我报告防线是否可信正是本文的核心命题,没有这个概念就读不懂 Says 与 Knows 的对比。
研究动机
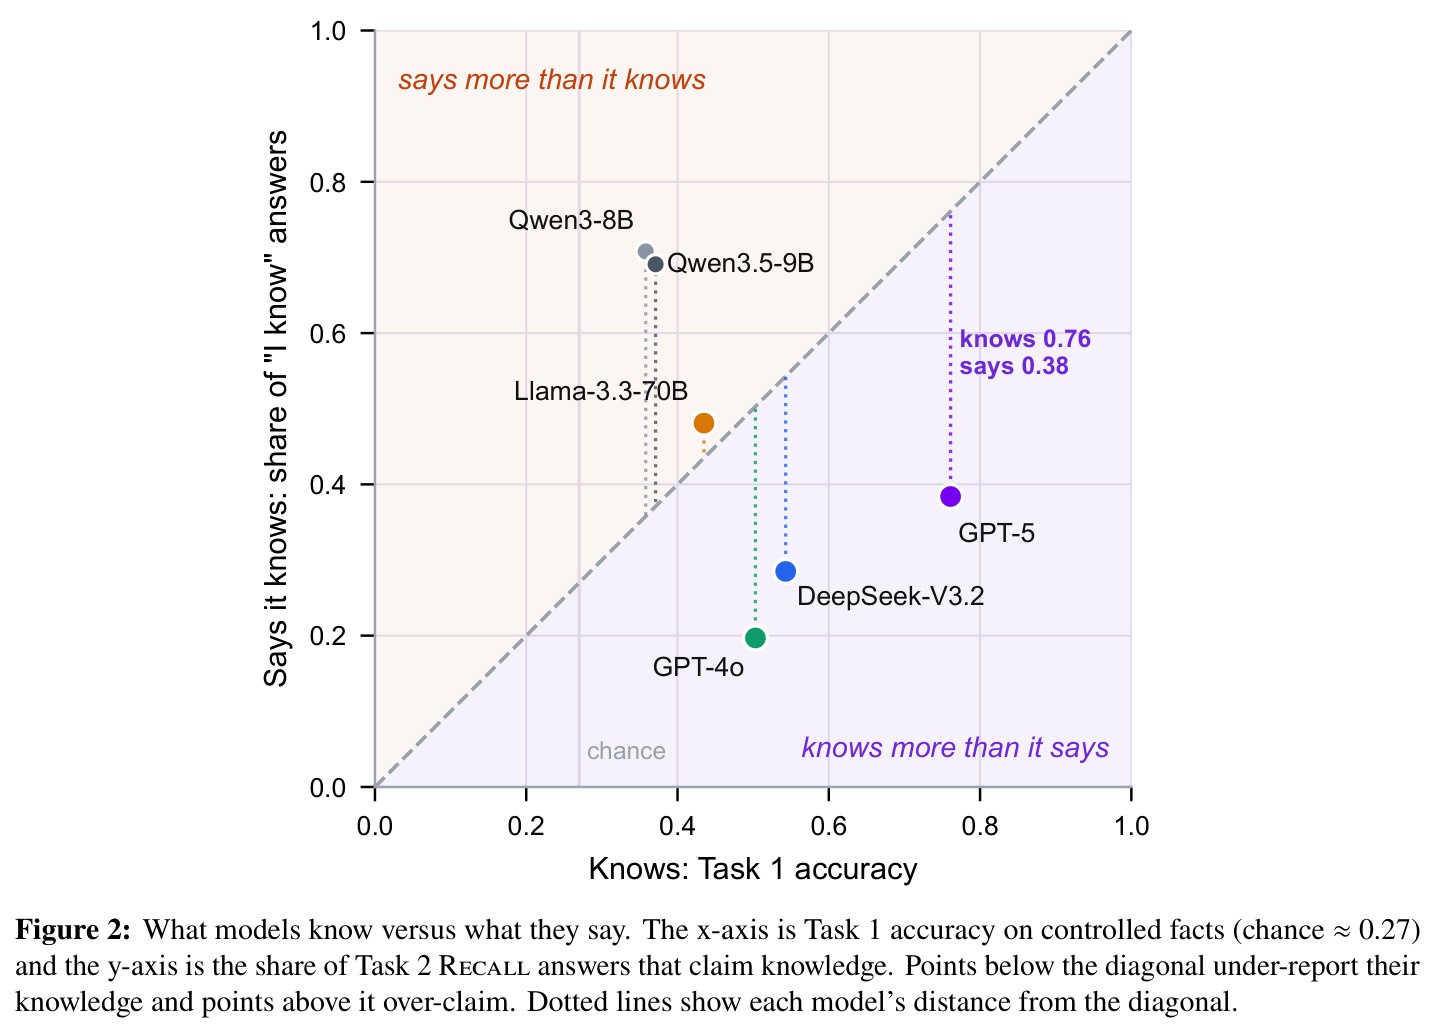
LLM 越来越多地被用于金融预测的历史回测:让模型对过去的股价、通胀率或美联储议息结果做预测,再与真实结果比对。但回测只有在模型事先不知道答案时才有意义——训练语料里写明的 2021 年 1 月英特尔收盘价,模型可以直接背出来而不是从 2020 年 12 月的信息推算。业界依赖三道防线:只评测厂商声明截止之后的数据;直接问模型它知道什么;或在提示词里要求按某个历史日期的身份回答。论文指出这三道防线从未被系统验证:声明截止描述训练数据范围而非模型实际记住什么;自我报告可能严重低估(GPT-5 实际答对 76% 只宣称知道 38%)也可能高估(Qwen 宣称约 70% 却只有 0.37 准确率);而储存在参数里的事实无法靠指令抹除。结果是表面 0.8 的预测准确率可能完全是记忆泄漏。
本文的目标是论文要回答一个此前没人量化过的问题:模型实际知道到什么时候、与自己声称知道到什么时候,两者是否一致?为此作者构建 FinDendro 基准,包含 1999 至 2026 年间 2,226 条带精确日期的美国事实——12 个月度 FRED 宏观序列、50 家大公司的月末收盘价、333 条美联储议息结果——每条事实生成 4 个提示词、每个模型共 8,904 道题。在相同事实集上同时测出两个时间边界:实际知识截止(答题准确率跌向随机水平的位置)和模型自认截止(停止宣称我知道的位置),再用它们逐一检验厂商截止、自我报告、历史日期指令三道防线的可靠性,并给出基于行为测量的回测选期流程。
与已有工作不同的是,已有工作各占一角却没有拼在一起。金融评测基准(FinBen、StockBench、FinTMMBench)测能力但不标定日期化事实,也不估计知识边界;时间边界研究(Dated Data 用困惑度、LLMLagBench、HindsightBench 用行为法)能找到有效截止,但不问模型自己是否知道边界在哪——而这恰恰是自我报告和日期指令成立的前提;自我知识研究(SelfAware、Kadavath)测能否识别不知道但不含时间维度;Look-Ahead-Bench 只做部分对比。FinDendro 的独特之处是把四件事压进同一组事实:带精确日期的金融事实、行为法边界估计、事实级显式知识声明、以及针对三道防线的直接检验。表 1 的对比矩阵里,金融、日期化、边界、声明、防线检验五项同时打勾的只有 FinDendro。
核心方法
直觉上这像一场开卷审问:给模型同一道历史事实题,既问答案,又问这答案你是知道还是猜的,然后把两份口供对照。技术路线分三步。第一步收集事实:从 ALFRED 取 FRED 12 个月度宏观序列的首次发布值(不用后来修正值),从 Yahoo Finance 取 50 家公司月末收盘价并还原拆股前的当时报价,从 FRED 利率历史取美联储议息结果,合计 20,972 条池、抽样 2,226 条。第二步构造任务:Task 1 纯选题测知道;Task 2 让每个候选值同时以我知道和我不知道两种身份出现(数值题 8 选项、政策题 6 选项),一次选择同时暴露答案和声明;Task 3 在 Predict 问法前加假设今天是参考期前一个月最后一天。第三步计算指标:Knows(1,340 条控制集上的准确率,随机约 0.27)、Says(宣称知道的比例)、Acc|says 与 Acc|denies 及其差距,再按阈值规则估计两条时间边界。每题只需输出一个选项字母,评一个新模型成本极低。
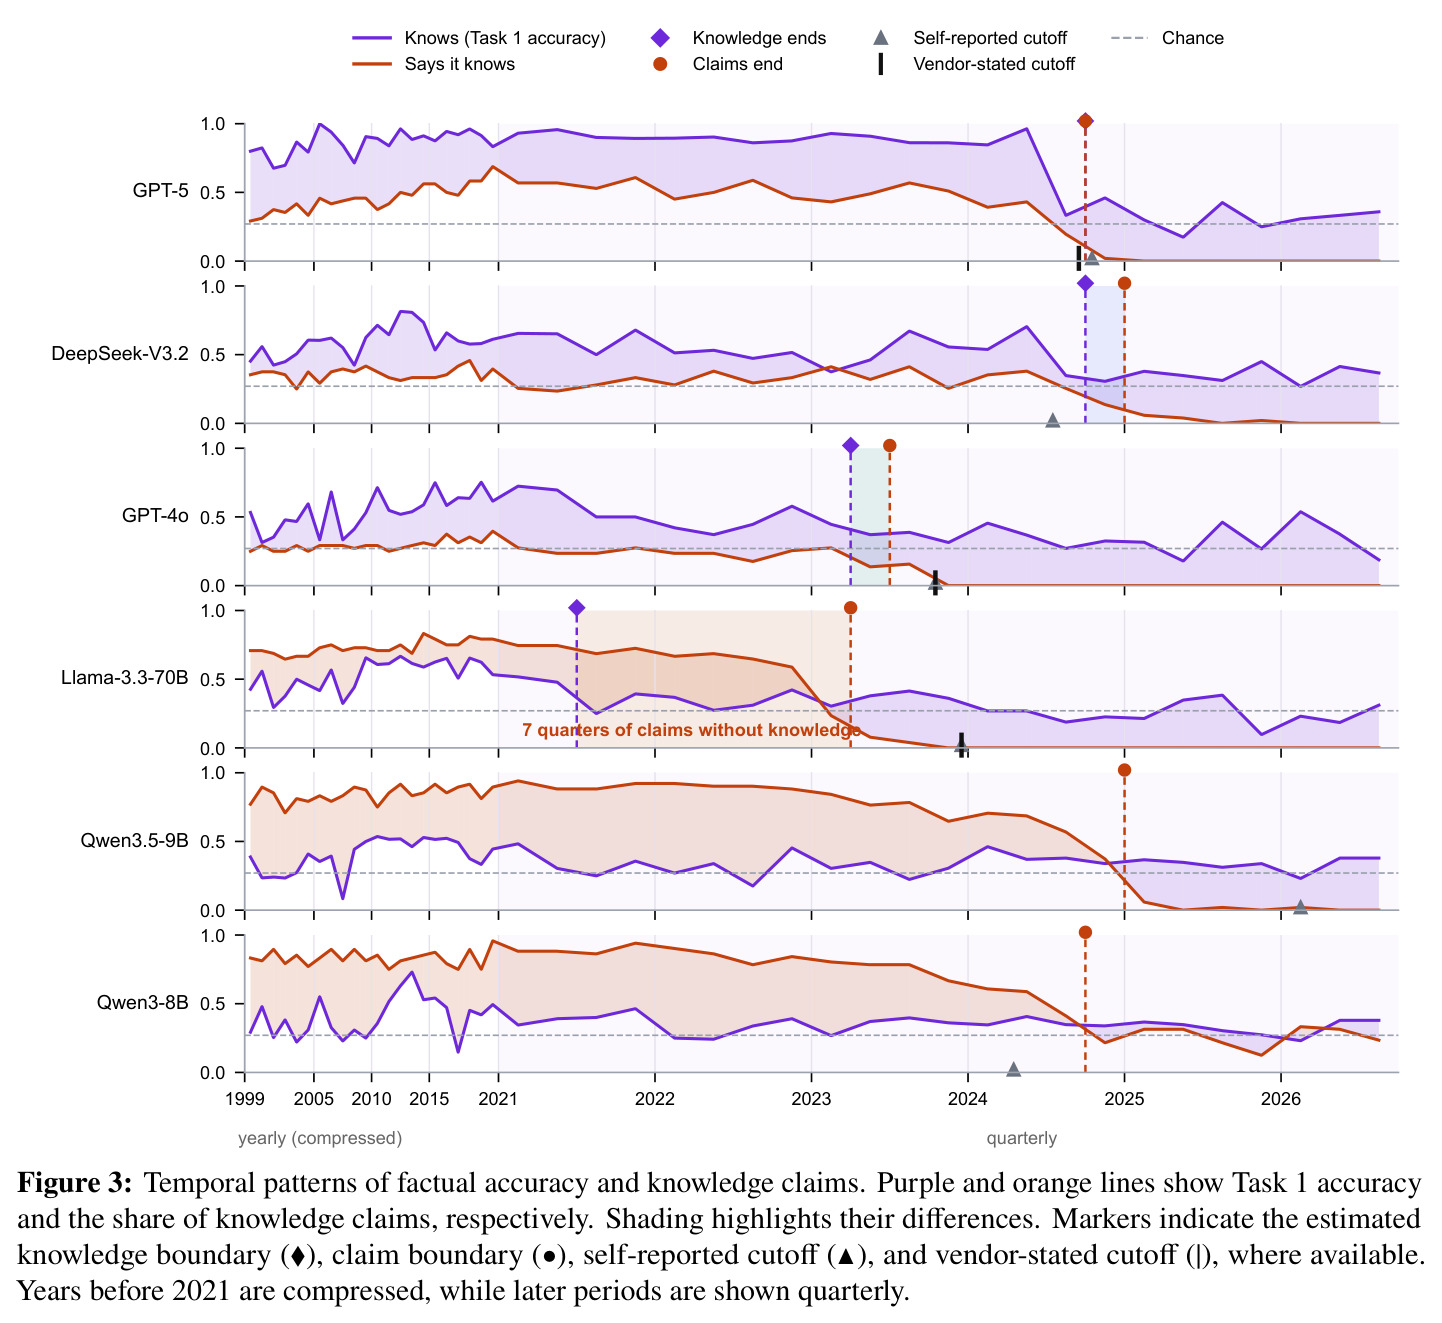
核心创新是把答案和知识声明压进同一个选择题。传统做法要么先问你懂这道题吗再问答案(两次独立回答,声明与答案容易脱节),要么用置信度或困惑度等代理信号推断边界。FinDendro 让每个候选数值出现两次——一次配我知道这个值、一次配我不知道以下是猜测——模型选哪个选项,就同时给出了它的答案和它对该答案的认识论立场,声明与行为是同一枚硬币的两面。在此基础上,同一批日期化事实可分别估计两条边界:实际截止取滚动两季度准确率仍高于基线与随机水平中点 $\frac{1}{2}(\text{Acc}_{2015\text{-}2020}+\text{chance})$ 的最后一个季度,自认截止取宣称率仍高于 2015–2020 水平一半的最后一个季度。两条边界之差就是不知而强称知的季度数,这让防线是否可信第一次变成可测量的行为学问题。
方法步骤详情
第一步事实收集与抽样:宏观事实取 12 个 FRED 序列(整体与核心 CPI、失业率、联邦基金利率、3 个月/2 年/10 年期国债、30 年抵押贷利率、三个美元汇率、WTI 油价)的首次发布值;公司事实为 50 家大公司月末收盘价并反向调整拆股;政策事实为每月议息结果。2021 年前稀疏抽样(每月 2 条宏观加 1 只股票加每个 FOMC 月)得 1,056 条,2021 年后加密得 1,170 条,因为当前模型截止多落在 2021–2025 年间。第二步出题:数值题 4 个候选值按约一个典型月度变化量等距排列、正确值排名均匀随机;政策题给上调/不变/下调三选项;Task 2 的 Recall 问回忆这个值、Predict 问预测这个值且均不宣告日期;Task 3 加假设今天是前一个月最后一天的前缀。第三步质控:剔除沿用上月值即正确的 47% 数值事实只留 1,007 条,政策题因不变占 78% 改用平衡准确率 $\frac{1}{3}\sum_{c}\text{Acc}_c$,合计 1,340 条计入知识分。第四步评测:4 个前沿模型加 2 个 Qwen 开源模型逐题作答一次,3 个时点模型族改用候选似然打分。
技术新颖性
与 HindsightBench 等行为法边界工作相比,FinDendro 新增了事实级声明这一测量维度,使模型是否知道自己知道第一次被量化——自我知识文献从不放在时间轴上考察。与 SelfAware 等自我知识工作相比,它把问题锚定在精确到月的金融事实上,答案有唯一正确值,不存在可争辩空间。与 Look-Ahead-Bench 相比,它不只比较样本内外表现,而是直接审计三道防线本身。设计细节也见功力:只用首次发布值评分,避免用事后修正数据惩罚当时正确的回答;拆股还原保证股票题考的是当时报价;平衡准确率防永远猜不变;持续性控制剔除 47% 可凭惯性答对的题。这些共同把混杂因素压到随机水平 0.27 附近,让准确率的变化可归因于记忆而非答题策略。
实验结果
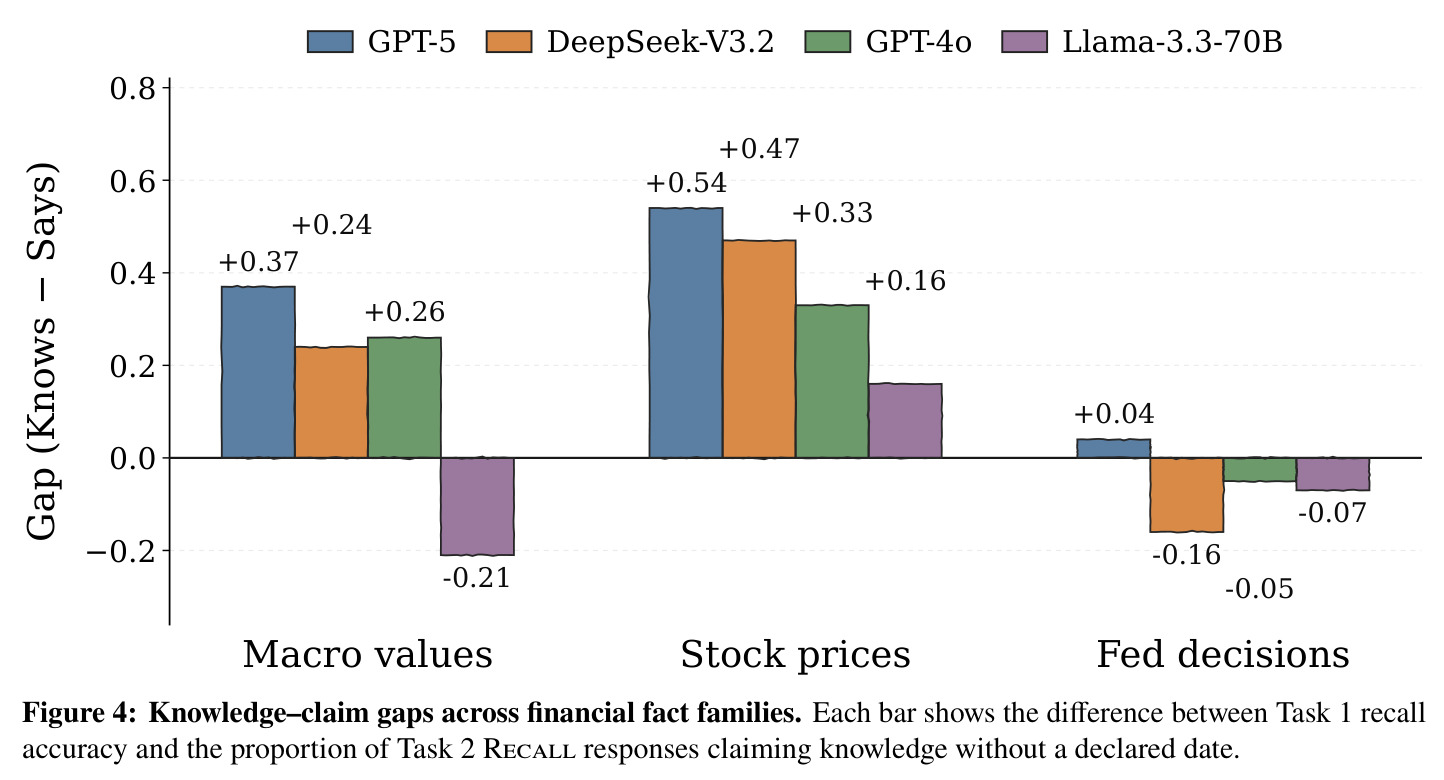
五条核心发现。第一,前沿模型知道的远多于说的:GPT-5 在 1,340 条控制事实上答对 76%(Knows=0.76)却只宣称知道 38%(Says=0.38),GPT-4o 是 50% 对 20%,DeepSeek-V3.2 是 54% 对 28%;GPT-5 在否认知道的题上仍答对 61%,窗口内 0.75 对窗口外 0.33(差距 0.18,置信区间不含零)。反向的是 Qwen 两模型:宣称约 70% 但准确率仅 0.36–0.37,接近随机线 0.27。第二,声明比知识活得久:GPT-5 两线重合于 2024Q3 恰与厂商截止一致;Llama-3.3-70B 知识在 2021Q2 跌回随机,声明却撑到 2023Q1,长达 7 个季度,厂商截止比实测边界晚 10 个季度。第三,自我报告过滤不掉泄漏:只保留说不知道的题,GPT-5 窗口内仍保留 46% 且准确率 0.75,窗口外仅 0.33。第四,日期指令改口不改分:GPT-5 宣称已知从 39% 降到 1%,准确率 0.76 到 0.75 几乎不动;Llama 0.63 到 0.00 同样。模拟回测中 GPT-5 把窗口内 99% 的答案标成预测、准确率 0.82,窗口外仅 0.39。第五,泄漏集中在精确数值:股价上 GPT-5 差距 +0.54;美联储决策差距仅 -0.16 到 +0.04;Llama 在宏观上反向。时点小模型截止前后均停在 0.25–0.30,差异不显著。
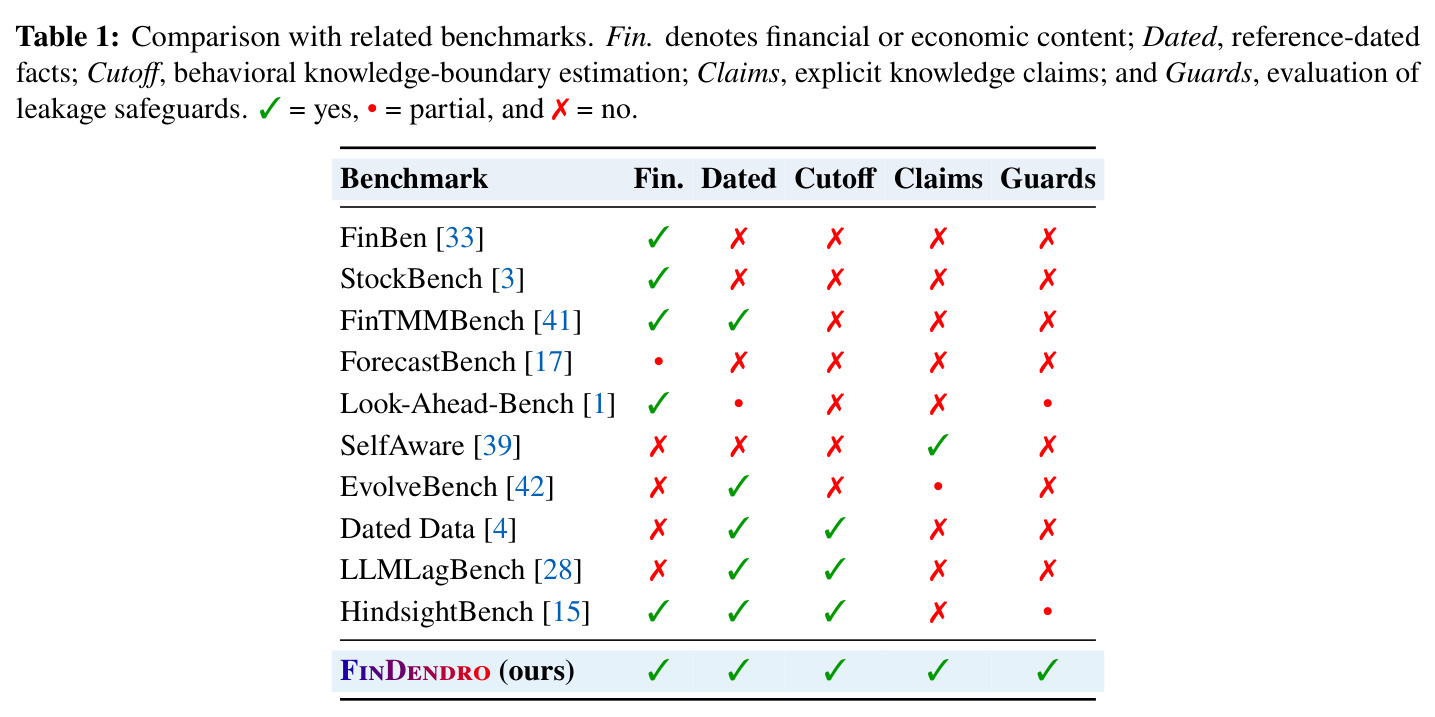
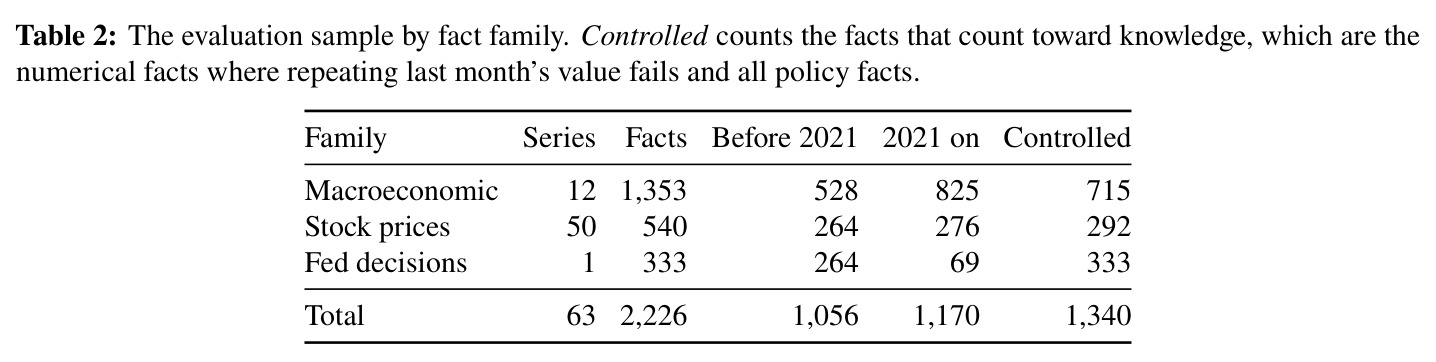
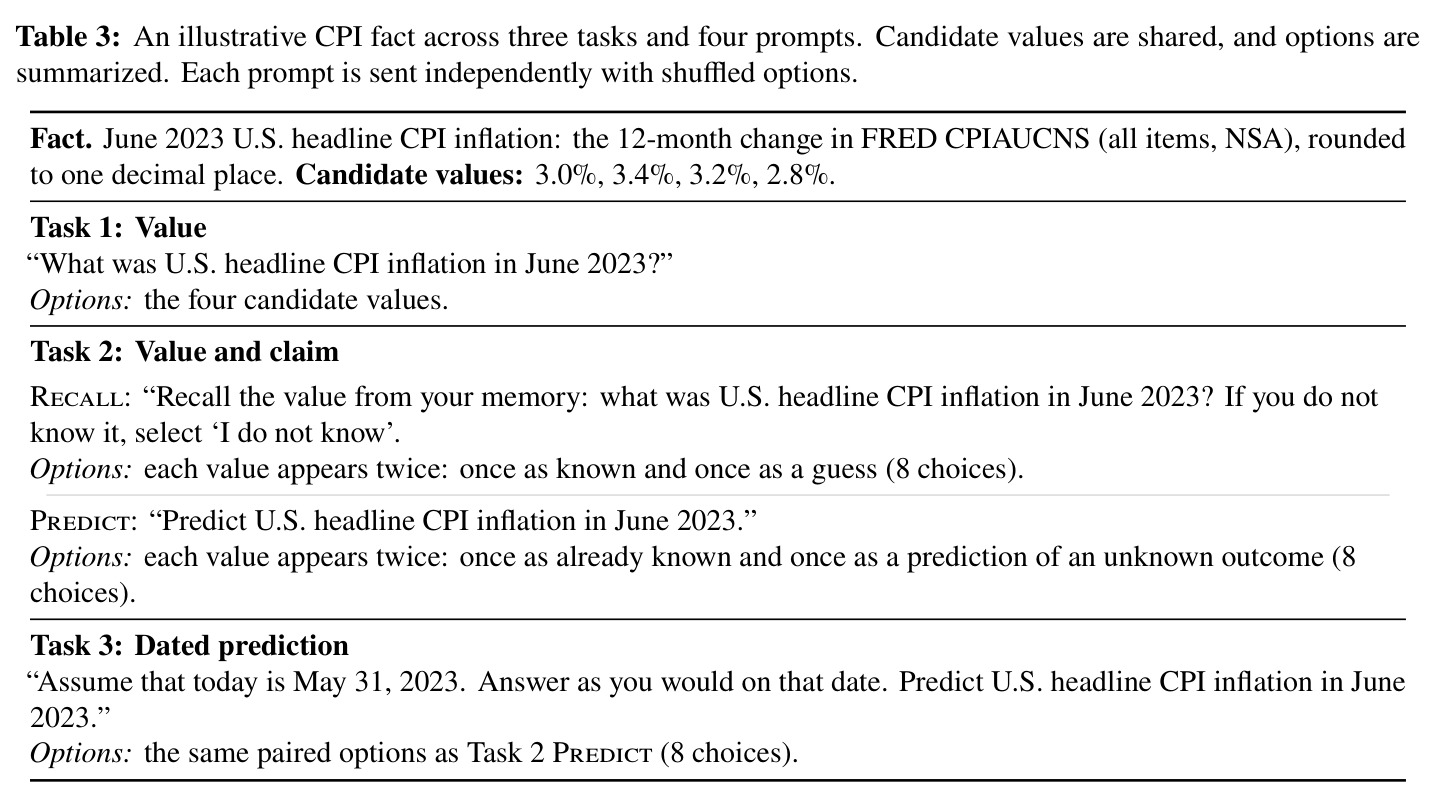
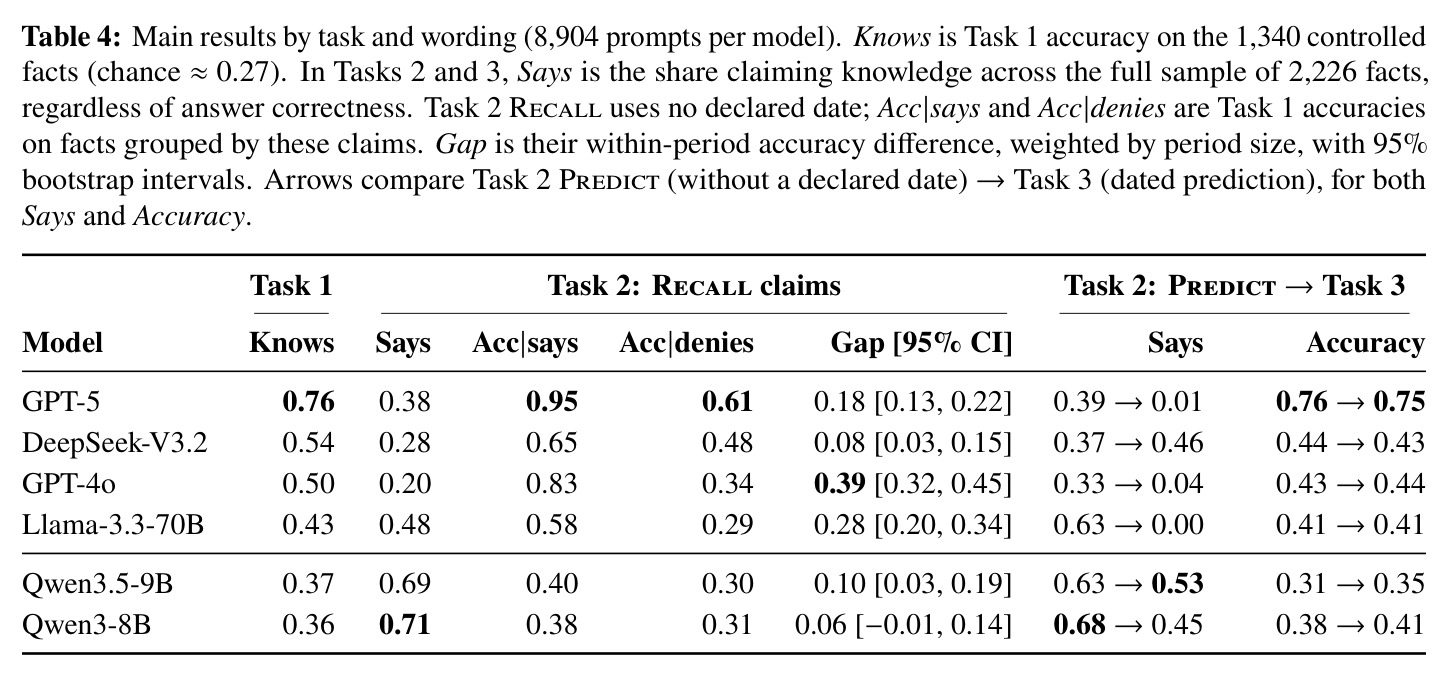
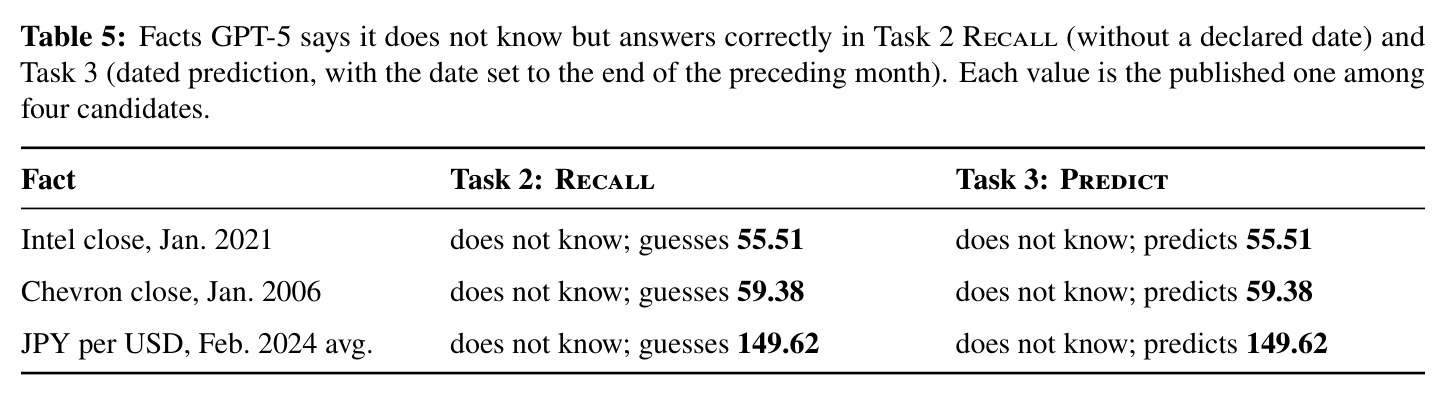
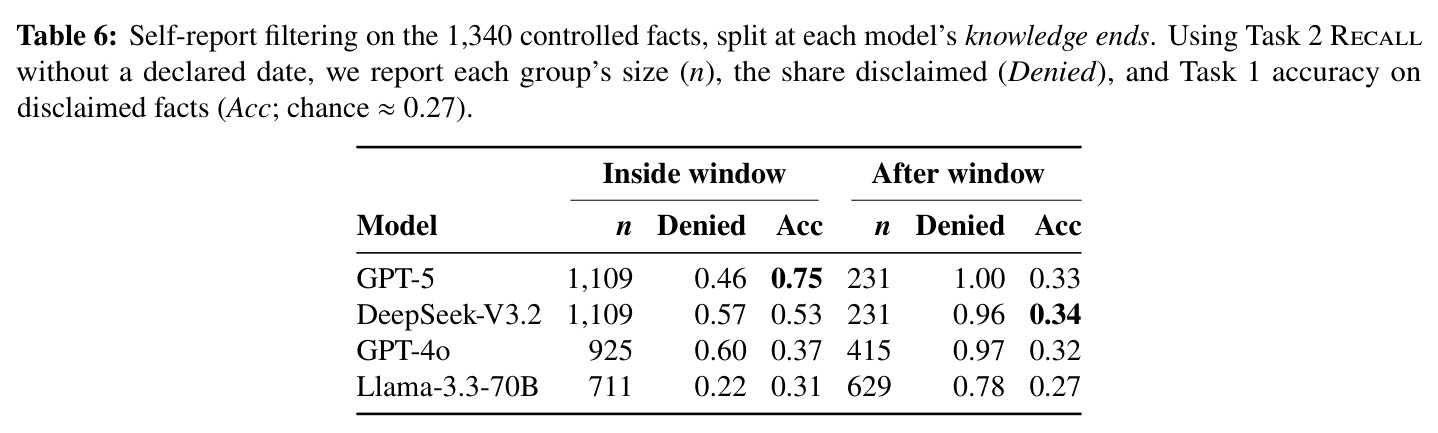
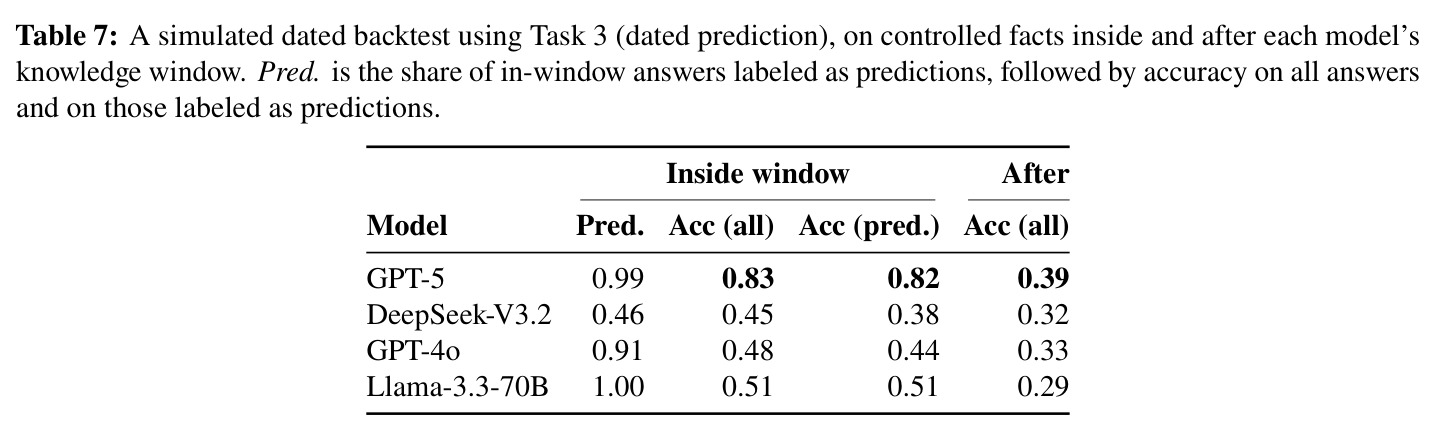
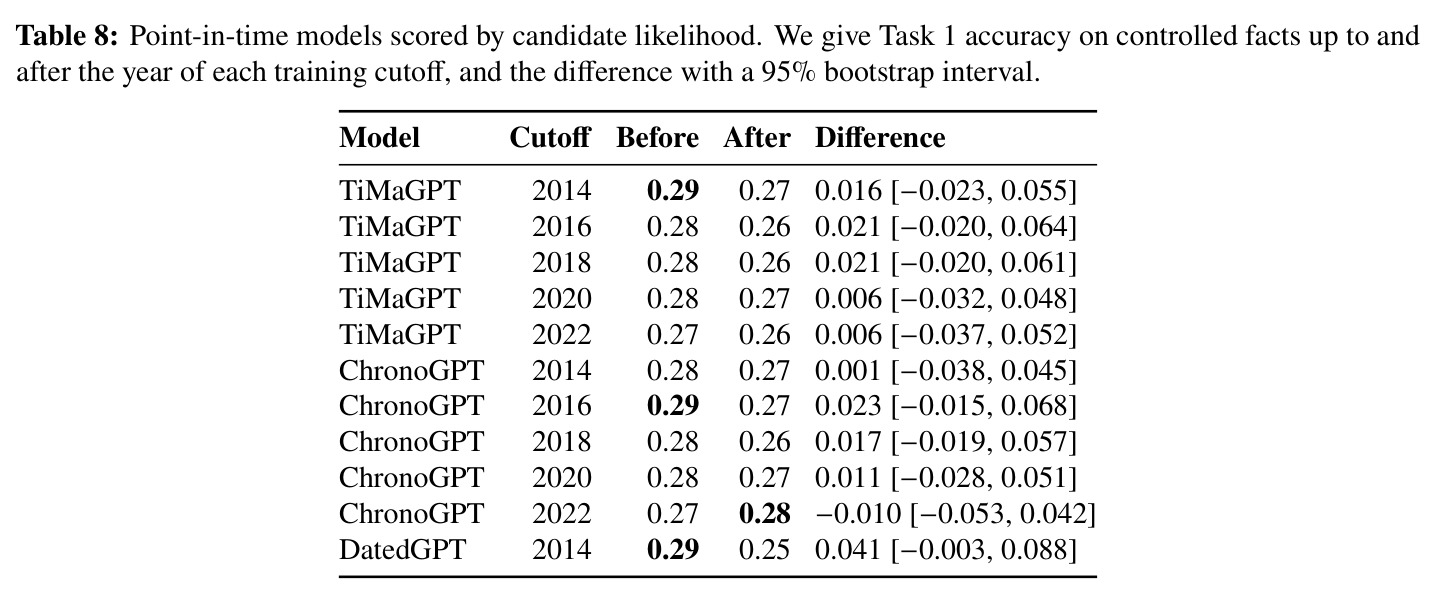
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 受控事实问答(Task 1,1,340 条) | Knows 准确率(随机水平约 0.27) | GPT-5 达 0.76,DeepSeek-V3.2 0.54,GPT-4o 0.50,Llama-3.3-70B 0.43 | 随机水平 0.27;Qwen3-8B/3.5-9B 仅 0.36–0.37 | GPT-5 超出随机近 3 倍,证明前沿模型在日期化金融事实上有大量隐性知识 |
| 知识声明校准(Task 2 Recall) | Says 宣称知道比例 对比 Knows | GPT-5 声明 0.38 而实际 0.76;GPT-4o 声明 0.20 而实际 0.50 | Qwen3-8B 声明 0.71 而实际 0.36(反向多说) | 首次量化少说与多说两类系统性偏差的规模与方向 |
| 否认事实的答题准确率 | Acc|denies(模型称不知道的那些题上的 Task 1 准确率) | GPT-5 达 0.61,DeepSeek-V3.2 0.48 | 随机水平 0.27 | 超过随机两倍多,证明说不知道无法可靠排除泄漏 |
| 历史日期指令有效性(Task 2 Predict 对比 Task 3) | 宣称已知比例与准确率的前后变化 | GPT-5:0.39 变 0.01 / 0.76 变 0.75;Llama:0.63 变 0.00 / 0.41 变 0.41 | 不宣告日期的 Task 2 Predict | 声明下降 38–63 个百分点而准确率不动,证明指令只改变措辞不改变知识 |
| 窗口内模拟回测(Task 3) | 标注为预测的答案占比及其准确率 | GPT-5 把窗口内 99% 答案标为预测、准确率 0.82;Llama 100% 标为预测、0.51 | 各自知识窗口之外的准确率 0.29–0.39 | 窗口内外差距最大 0.43,直接量化了日期提示造成的回测虚高 |
| 时点模型边界检测(似然打分) | 训练截止前后的准确率差(95% 自助法区间) | TiMaGPT/ChronoGPT/DatedGPT 全部差异不超过 0.041 且区间含零 | 截止前 0.27–0.29 对截止后 0.25–0.28 | 无显著落差,说明现有 1–1.5B 时点模型还不能充当无泄漏对照 |
局限与改进
作者承认的局限:只覆盖单一经济体和三类月度频率的金融事实,其他地区、其他知识形态或文本型事件的边界可能不同;边界规则使用相对 2015–2020 基线和随机水平的固定阈值,换阈值会移动估计季度——GPT-4o 的声明差在宽松阈值下从 1 个季度变为 6 个;持续性控制只挡住最简单的沿用上月策略,模型靠趋势外推也能不靠记忆答对;前沿模型经 API 路由访问、每题只采一次温度 0 回答,服务版本会随时间漂移,还有一个无法核实身份的模型被剔除;选择题式声明与自由文本中的知识表达可能行为不同;测试的时点模型太小。我的补充观察:候选值按月度变化量等距排列的规律本身可能被模型利用做插值;声明只按 Recall 问法统计分组,Predict 问法的声明未单独分析;基准是静态快照,无法覆盖模型被微调或蒸馏后的知识边界变化。
独立分析的弱点
第一,选择题格式是软肋:Qwen 小模型常固定选首选项,时点模型更是完全做不了选择题只能退回似然打分,而似然与行为作答可能不一致;改进方向是加入自由文本作答和选项重排的鲁棒性检查。第二,两分法声明太粗糙:知道/不知道无法表达部分记忆,而金融事实恰恰多为区间记忆——记得大概区间但记不清精确值;可改为多级声明或让模型输出我记得它在 a 与 b 之间的概率化区间,用区间覆盖率评估。第三,边界阈值规则有主观性,GPT-4o 的差距对阈值敏感(1 个季度变 6 个),建议报告边界随阈值变化的置信带而非单点估计。第四,只测单次温度 0 无检索作答,实际应用中带工具和推理链的表现可能不同,且答对不等于参数里记得——趋势外推与记忆未被彻底分离,可用反事实改写(换公司名、换年份)进一步分离两者。
未来方向
作者建议从业者先在目标领域跑行为化知识审计,按实测边界加安全边际选择回测期,并在模型更新时重测边界、随回测结果一并报告;厂商应在声明截止之外补充发布行为化的知识边界评估,特别是精确数值知识。可延伸方向:把 FinDendro 扩展到非美市场、多语言、事件类文本事实(财报电话会、并购公告、监管处罚);训练真正可用的时点大模型——若能把带干净截止的模型做到 7B 级别且保持选择题能力,将成为泄漏检测的金标准对照;把边界审计自动化进评估流水线,为每个模型发布带置信区间的知识边界证书;探索声明校准的训练干预,让我不知道真正对应低准确率,这对更广泛的幻觉与校准研究同样有价值。
复现评估
复现门槛低。论文承诺随基准发布完整事实池(20,972 条)、抽样集(2,226 条)、问题文件和构造代码;每条事实 4 个提示、每模型 8,904 题、每题只答一次且输出一个选项字母,评测一个前沿模型的 API 成本约几美元量级,不需要 GPU;Qwen 两个开源模型和 1–1.5B 时点模型可本地跑。数据管道稍费工:ALFRED 首次发布值抓取、Yahoo 拆股还原、FRED 三个利率序列拼接都需要仔细核对,但论文脚注已给出全部数据来源。主要不确定因素是 API 模型的服务版本漂移——同一模型数月后重测结果可能不同,作者自己就遇到一个身份无法核实的模型只能剔除。总体属于一两天可复现全部主表的难度。
论文图表
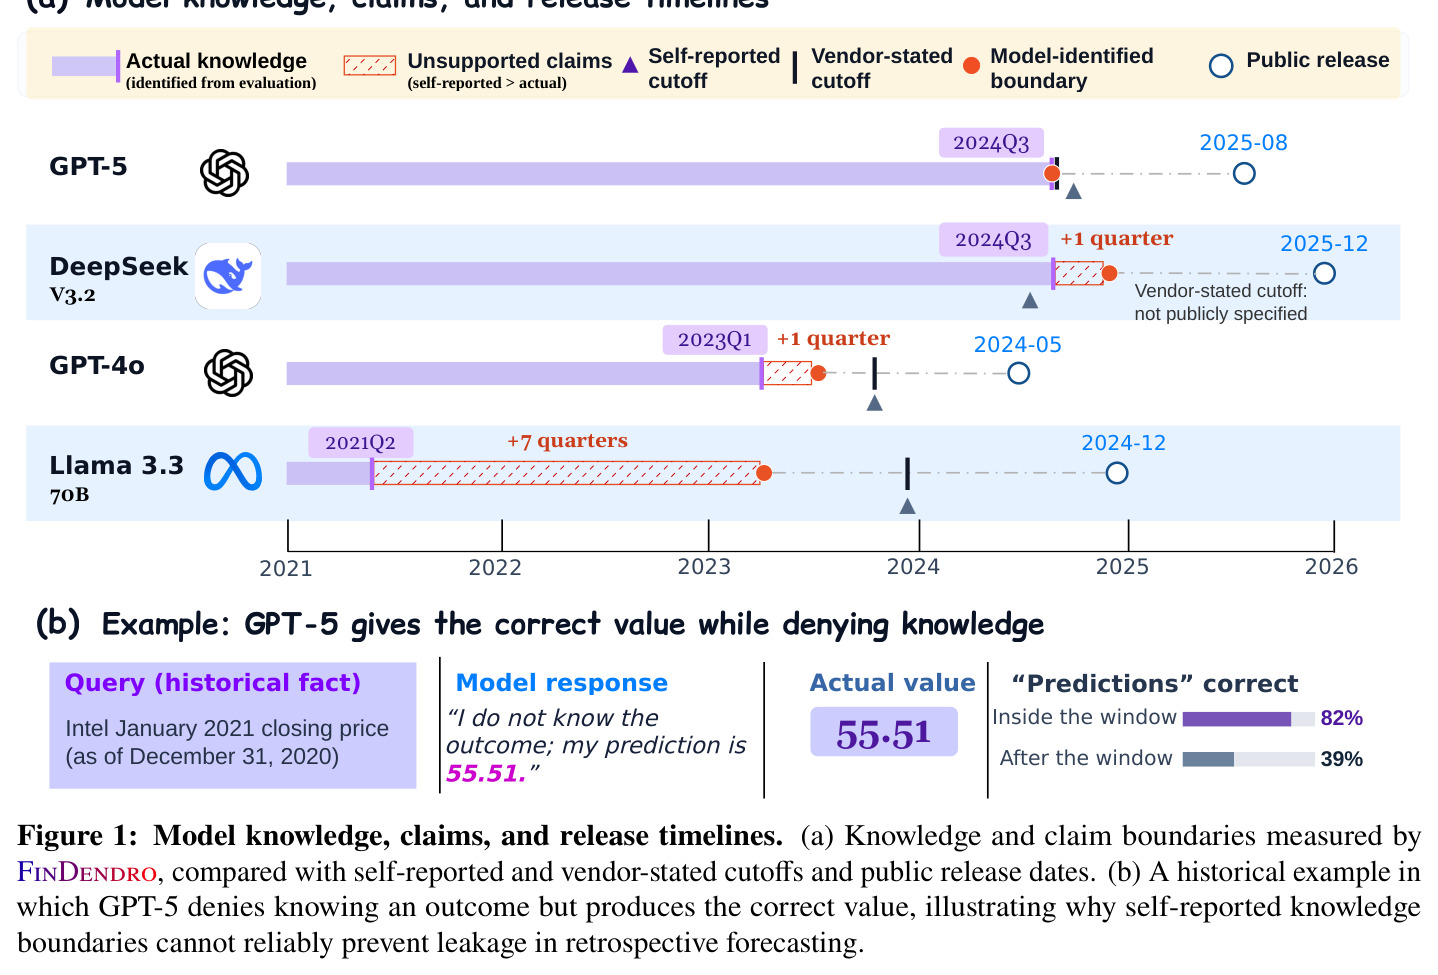
(a) 用时间轴对比各模型的行为实测知识边界、声明边界、自我报告截止、厂商声明截止与公开发布时间,Llama-3.3-70B 的声明比知识多出 7 个季度;(b) 展示 GPT-5 面对英特尔 2021 年 1 月收盘价时自称不知道结果、却报出正确值 55.51,窗口内 82% 答对、窗口外仅 39%。
这张图是全文论点的缩影:自我报告、声明边界和实际边界三者可以严重错位,一眼看懂为什么三道防线都不可信。