CausalWAM:学习世界动作模型中动作的成因 CausalWAM: Learning the Causes of Actions in World Action Models
用稀疏约束从演示中识别动作的因果潜变量,并在Cosmos 3上加稀疏路由提升机器人闭环成功率
前置知识
世界动作模型(WAM)
World Action Model 从观测(图像/视频 token)中提取潜变量,同时承担两个任务:预测场景未来的演化(视频生成),以及从这些潜变量生成机器人动作。代表工作如 Fast-WAM 与 NVIDIA Cosmos 3,后者用 Mixture-of-Transformers 生成器以整流流(rectified flow)目标联合去噪未来视频 latent 与动作 chunk。由于预测必须覆盖整个场景,潜变量天然会编码桌布、背景杂物等与动作无关的内容。
本文的全部问题都建立在 WAM 的双重职责上:预测需要全场景信息,而动作只由其中一小部分引起,两者如何分离正是全文核心。
非线性 ICA 与可识别性
独立成分分析试图从混合观测 $o=f(s)$ 中恢复隐含源 $s$。非线性 ICA 的经典结论是:不加额外假设时潜变量不可识别——两个模型可以产生完全相同的 $(o,a)$ 分布,但潜变量相差任意可逆变换。已有工作通过引入辅助变量(域/时间索引)、要求充分时间依赖、或已知干预目标来恢复可识别性;另一支路线用机制稀疏性等函数类约束。
论文的三个理论命题(Prop 1、Thm 1、Thm 2)都是可识别性命题,需要理解 identified up to permutation / invertible transformation 这类表述的精确含义。
雅可比矩阵的函数支撑(functional support)
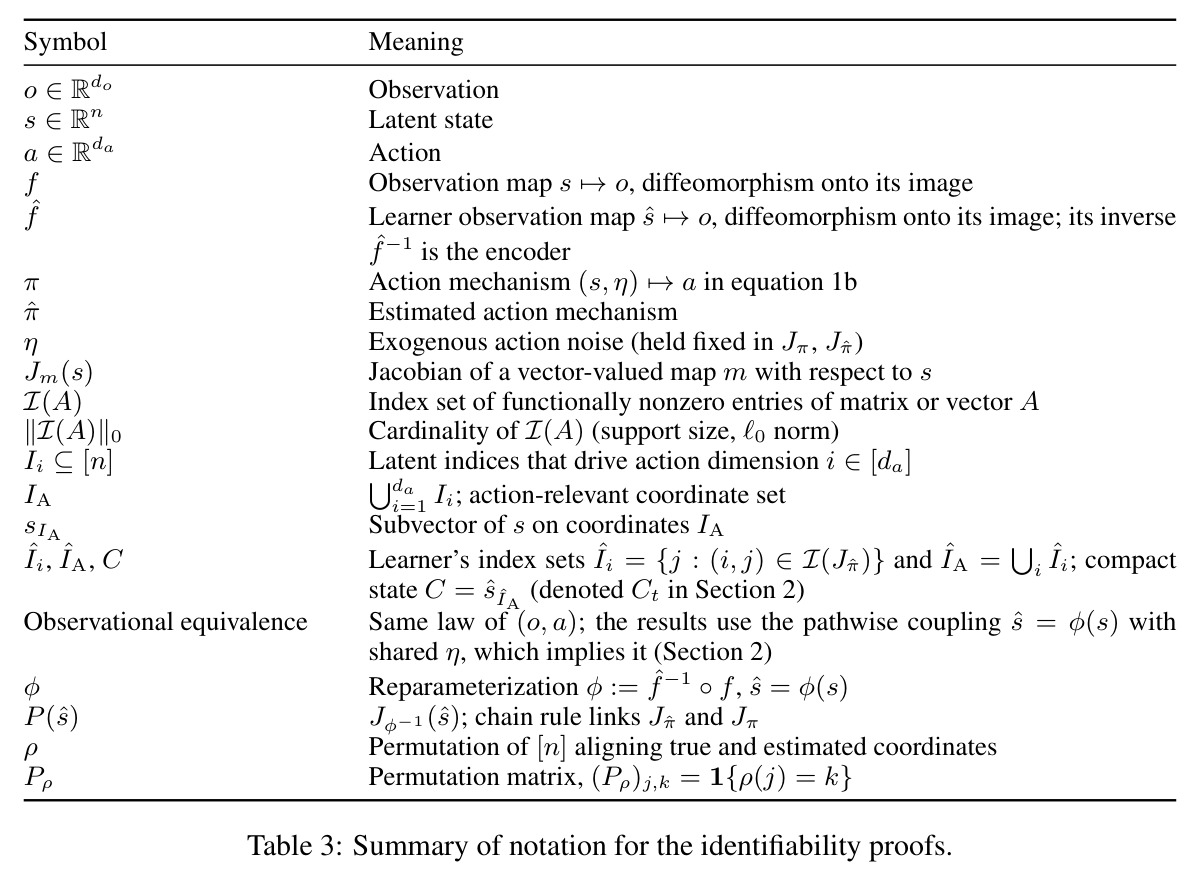
对可微映射 $m$,$J_m(s)=\partial m/\partial s$ 是其雅可比矩阵。函数支撑 $I(J_m)=\{(i,j):\Pr[J_m(s)_{ij}\neq 0]>0\}$ 记录哪些输入坐标在概率上确实影响输出坐标,$\|I(J_m)\|_0$ 是支撑基数($\ell_0$ 范数)。动作维度 $i$ 的支撑 $I_i$ 就是驱动它的潜坐标集合,其并集 $I_A$ 即动作相关潜变量。这是函数性的定义,与统计相关性无关。
整篇论文的定理都用支撑语言陈述:无约束时估计机制的支撑只会不小于真实支撑,加支撑稀疏约束后两者只差一个置换。
整流流与 WAM 后训练
Rectified flow 是一种流匹配生成范式:训练一个速度场把高斯噪声沿近似直线路径搬运到数据分布,推理时用 UniPC 等采样器迭代去噪。Cosmos 3 在此范式下联合对未来的视频 token 和动作 chunk 加噪、去噪。后训练指在公开预训练 checkpoint(Cosmos3-Nano)上用机器人演示数据继续训练,以适配具体具身任务。
CWAM 完全复用 Cosmos 3 的整流流联合训练损失,只在其上增加一条稀疏路由旁路,理解这一点才能分清方法里什么改了、什么没改。
观测等价性(observational equivalence)
若两个过程 $(f,\pi)$ 与 $(\hat{f},\hat{\pi})$ 诱导出相同的 $(o,a)$ 联合分布,则称它们观测等价。这是"仅凭数据无法区分它们"的形式化表述。理论上所有结论都在观测等价类内部讨论:你永远无法确定完整的潜状态,但可以确定动作依赖的结构与动作相关块。论文用的是路径耦合版本:两过程共享噪声、潜状态经 $\hat{s}=\phi(s)$ 相联。
它界定了理论保证的边界:本文不声称恢复全部潜变量,只声称在所有能拟合数据的模型中,加稀疏约束后动作侧的结构唯一确定。
研究动机
世界动作模型(WAM,如 Fast-WAM、NVIDIA Cosmos 3)从图像提取潜变量,既要预测整个场景的演化,又要生成机器人动作。以叠方块为例:动作只取决于两个方块的位置和夹爪是否持物,但画面中桌布的花纹、背景杂物同样会进入潜变量,因为视频预测必须重建整个场景。论文把导致演示动作的潜变量称为动作相关潜变量(action-relevant),其余称为干扰变量(nuisance)。问题在于:把演示拟合得再好,也不保证动作头真的从动作相关潜变量生成动作。写作 $o_t=f(s_t)$、$a_t=\pi(s_t,\eta_t)$ 时,两个模型可以给出完全相同的 $(o_t,a_t)$ 分布,而潜变量相差一个任意可逆变换——这个变换可以把干扰信息混进动作头读取的变量里,一个非常灵活的动作头照样能完美模仿演示。传统非线性 ICA 靠辅助变量、充分时间依赖或已知目标的干预来恢复可识别性,但这些假设在真实机器人演示中常常不成立:某些时间步可能完全独立,潜动态未必是 Markov 的,受控干预要么贵得离谱要么根本不可能。
本文的目标是本文的目标可以概括为:仅凭观测演示数据 $\{o_t,a_t\}_{t=1}^T$(不含任务、技能或片段标签,不做任何干预),回答"什么导致动作、什么只是预测需要",并把二者分开。具体拆成三个可检验的层次:第一,刻画不加约束时拟合的极限——证明估计动作机制的每个动作维度所依赖的潜变量个数只会不少于真实机制(Prop 1 的过覆盖单向界);第二,给出恰好让识别成立的归纳偏置——对潜状态到动作的依赖结构施加支撑稀疏约束 $\|I(J_{\hat{\pi}})\|_0 \le \|I(J_{\pi})\|_0$,证明依赖结构在置换意义下被精确识别(Thm 1);第三,证明部署时真正喂给动作头的紧凑状态 $C_t$ 是真实动作相关块 $s_{t,I_A}$ 的可逆函数(Thm 2)。工程上再把该原则落成 CWAM:在预训练 Cosmos 3 的动作头上加一条稀疏路由路径,在 RoboCasa365、LIBERO 与真实 Franka 机器人上验证闭环成功率提升。
与已有工作不同的是,已有可识别性工作的切入角度大多依赖"旁信息"来指定哪些潜变量重要:多视图方法用视图间共享的内容(von Kügelgen et al. 2021),域适应方法用跨域不变的成分(Kong et al. 2022),任务相关方法用任务标签(Zheng et al. 2026)。但机器人模仿学习里没有视图、域或任务标签能直接圈出"动作因果子集"——唯一的信息源就是动作本身。本文抓住了这一点:既然每个动作只由潜状态的一小部分生成,那么在动作侧约束依赖的数量(而不是像多数工作那样恢复全部潜变量),就能让"最小动作通路"成为识别的充分条件。这与两条主流路线都不同:时序/干预类方法要求充分时间依赖或受控干预,本文完全不要求,相邻步可以是 i.i.d.;函数类约束类方法(Kivva 2022、Zheng 2022、Lachapelle 2022)通常要求全部潜变量都满足条件,连机器人本可无视的干扰变量也不例外,本文只要求动作侧成立,干扰变量的动态和隐藏环境怎么变都不影响结论,甚至允许动作相关变量与干扰变量统计相关。
核心方法
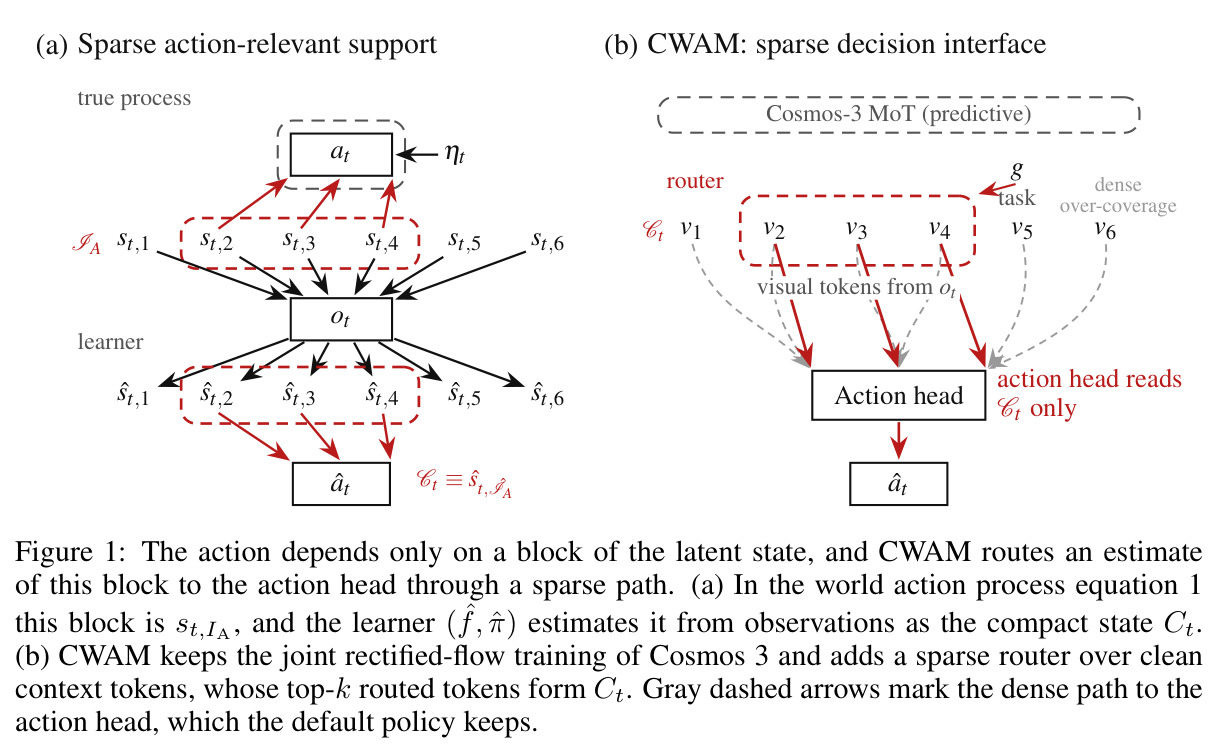
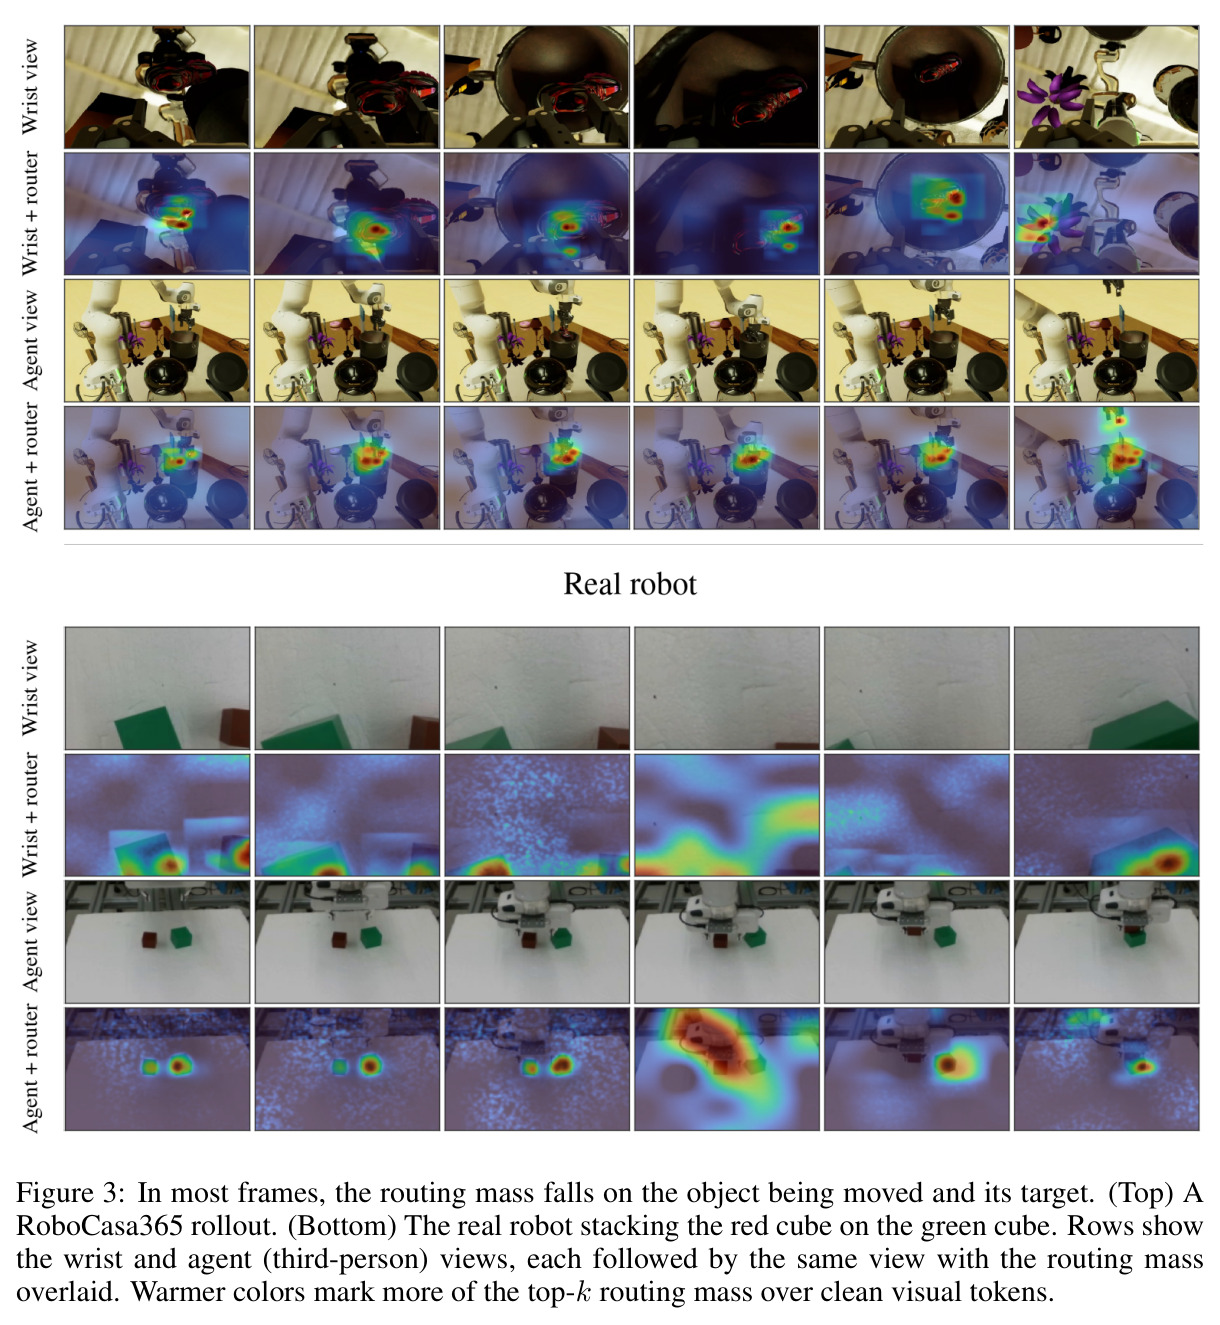
直觉上这是一个"预算钳制":真实机制 $\pi$ 的每个动作维度只依赖少数潜坐标,若把估计机制 $\hat{\pi}$ 的依赖总量限制在不超过真实总量,拟合所学到的依赖结构就既不能少(Prop 1 下界)也不能多(稀疏上界),只能等于真实结构在某个置换下的像——"夹逼"出因果结构。技术上,CWAM 保持 Cosmos 3 Nano 的整流流世界建模损失 $\mathcal{L}_{\text{WAM}}$ 不变,只在动作头前加一条稀疏路由旁路:动作隐状态 $h_i$ 对干净上下文 token(任务 + 未加噪视觉)做关系感知注意力路由,保留 top-$k{=}32$ 质量的 token 得 $\tilde{h}_i$,经小初值门控 $g$ 残差融合;训练时对路由 readout 加稀疏替代损失 $\mathcal{L}_{\text{sparse}}$($\lambda{=}0.01$),总损失为两者之和。稠密 MoT 视觉到动作路径默认保留,因此改动保守、增益可干净归因于稀疏路由本身。
核心创新是"约束动作侧、解放预测侧"的不对称设计与三定理识别链条。区别有三。其一,与需要辅助变量/时间依赖/干预的 ICA 传统(Khemakhem、Yao、Lippe 等)不同,保证纯粹来自观测演示:不要求充分时间依赖(相邻步可 i.i.d.),不假设潜动态 Markov,也不对未观测 regime 做假设。其二,与要求恢复全部潜变量的稀疏约束类工作(Kivva、Zheng、Lachapelle 等)不同,只识别动作相关块 $s_{t,I_A}$,干扰变量可任意耦合、非平稳。其三,允许动作相关变量与干扰变量统计相关(如桌布与方块位置相关):Thm 2 是函数性结论,$C_t$ 只依赖 $s_{t,I_A}$ 且决定它,与相关性无关。理论关键一步:无约束时观测等价只保证估计支撑不小于真实支撑(过覆盖),稀疏约束 $\|I(J_{\hat{\pi}})\|_0 \le \|I(J_{\pi})\|_0$ 把单向界变成等式,且重参数化 $\phi=\hat{f}^{-1}\circ f$ 的雅可比呈块三角,从而 $C_t=h(s_{t,I_A})$ 且 $h$ 可逆。
方法步骤详情
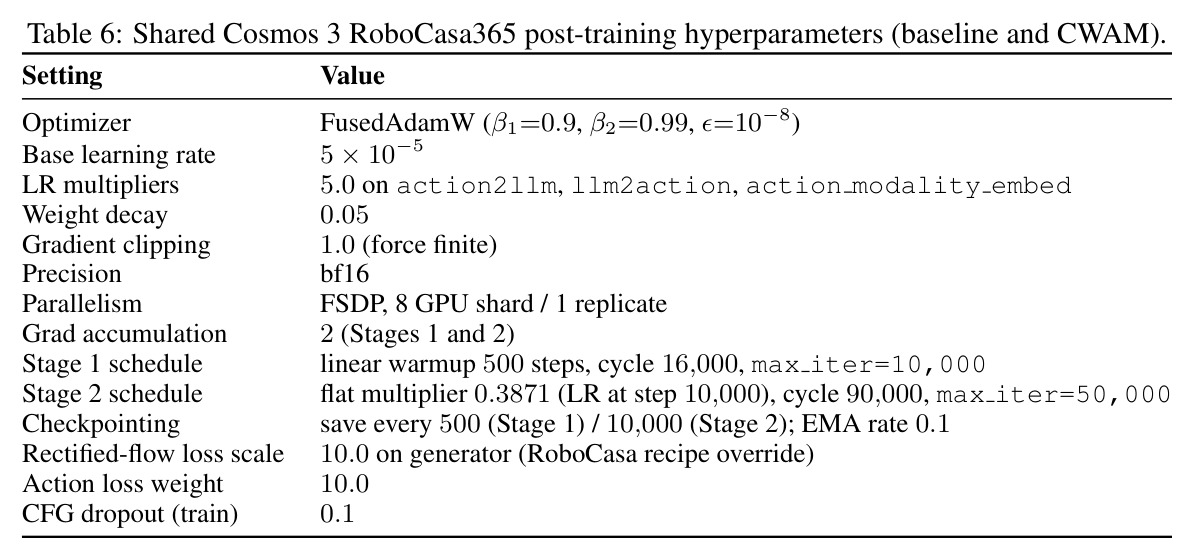
流程分四步。第一步,骨干与数据:以公开 nvidia/Cosmos3-Nano 为骨干,在 RoboCasa365 演示上后训练,窗口 16 帧、20 Hz,首帧观测、后续视频 token 加噪,动作为 10 维相对 rot6d。第二步,两阶段训练:Stage 1 训 10,000 步初始化路由器(base LR $5\times10^{-5}$);Stage 2 续训至 50,000 步(LR 平坦乘子 0.3871);匹配基线同配方但无路由器。第三步,稀疏路由前向:$h_i$ 对干净上下文计算 softmax 注意力 $w_{ij}$($d_r{=}512$、8 头),取 top-$k{=}32$ 得 $\tilde{h}_i$,经 $h_i \leftarrow h_i + g\,\tilde{h}_i$ 融合($g$ 初始 0.01);稀疏损失第 1,000 步激活、4,000 步退火。第四步,损失与部署:总损失 = 世界建模损失 + 稀疏损失(后者为动作 query 落在 top-$k$ token 上的注意力质量,$\lambda{=}0.01$),前者与基线逐字相同;部署时 $C_t$ 为被某动作 query 的 top-$k$ 质量覆盖的干净 token 集合,仅由观测算出。
技术新颖性
技术新颖性体现在三处。理论上是首个针对"动作因果子集"的部分可识别性结果:以动作机制的雅可比支撑为对象,证明了无约束拟合的过覆盖下界(Prop 1)、支撑稀疏下的结构识别(Thm 1)与紧凑状态的块级可逆恢复(Thm 2),且全部结论不依赖干预、时间结构或任何监督信号——证明只在一对 $(o,a)$ 内部进行,连跨时间步的信息都没用。工程上,"加旁路不动主干"的设计很克制:世界建模损失 $\mathcal{L}_{\text{WAM}}$ 与匹配基线完全一致,稀疏约束只作用于路由 readout,稠密 MoT 路径保留,因此性能提升可以干净地归因于稀疏路由本身(对照实验同数据、同配方、同优化)。概念上,它把"哪个潜变量重要"这个通常需要外部标签的问题,转化成了动作头对潜变量的依赖计数问题——用 $\ell_0$ 预算这种极轻量的归纳偏置换取识别性,比主流的对比学习、多视图对齐或数据增强路径都要直接。
实验结果
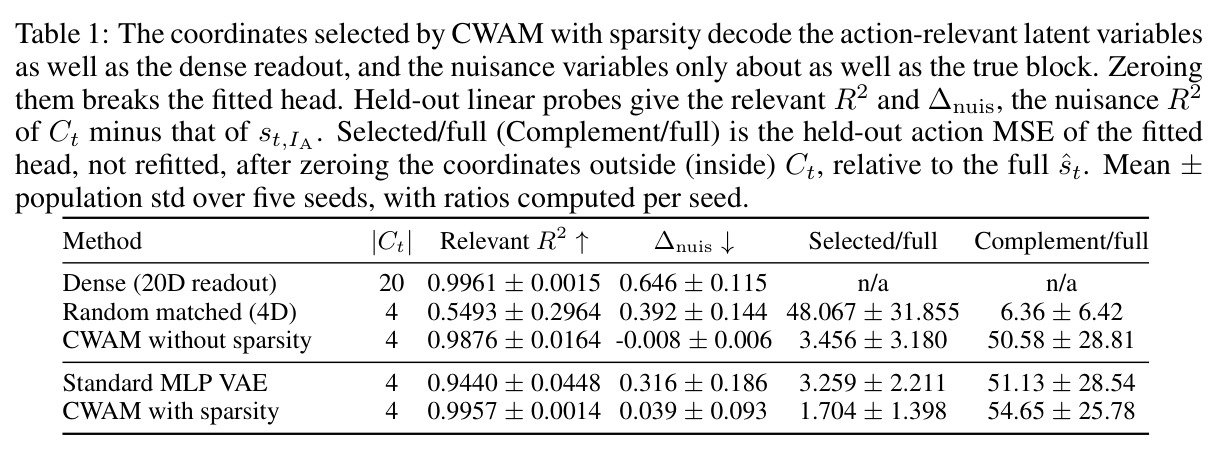
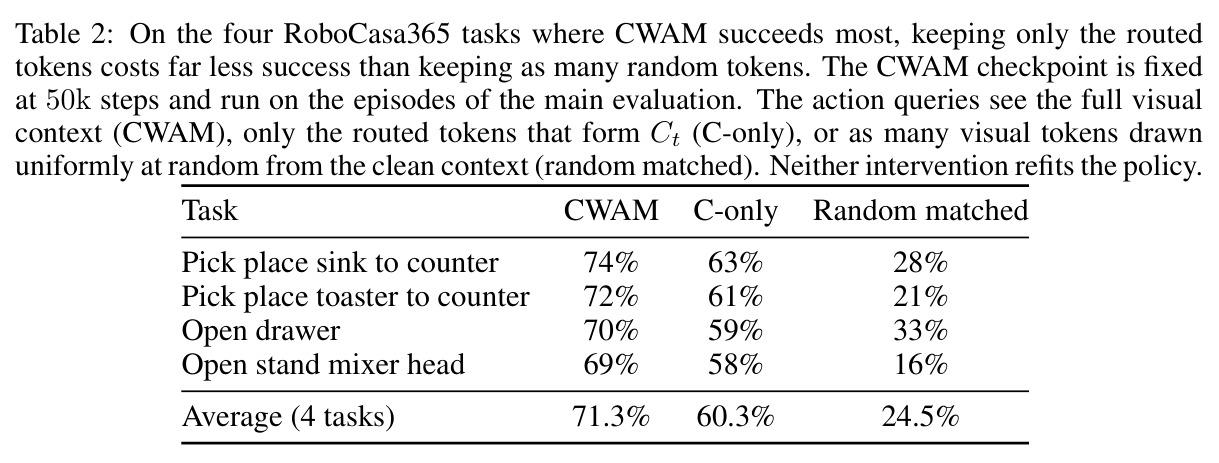
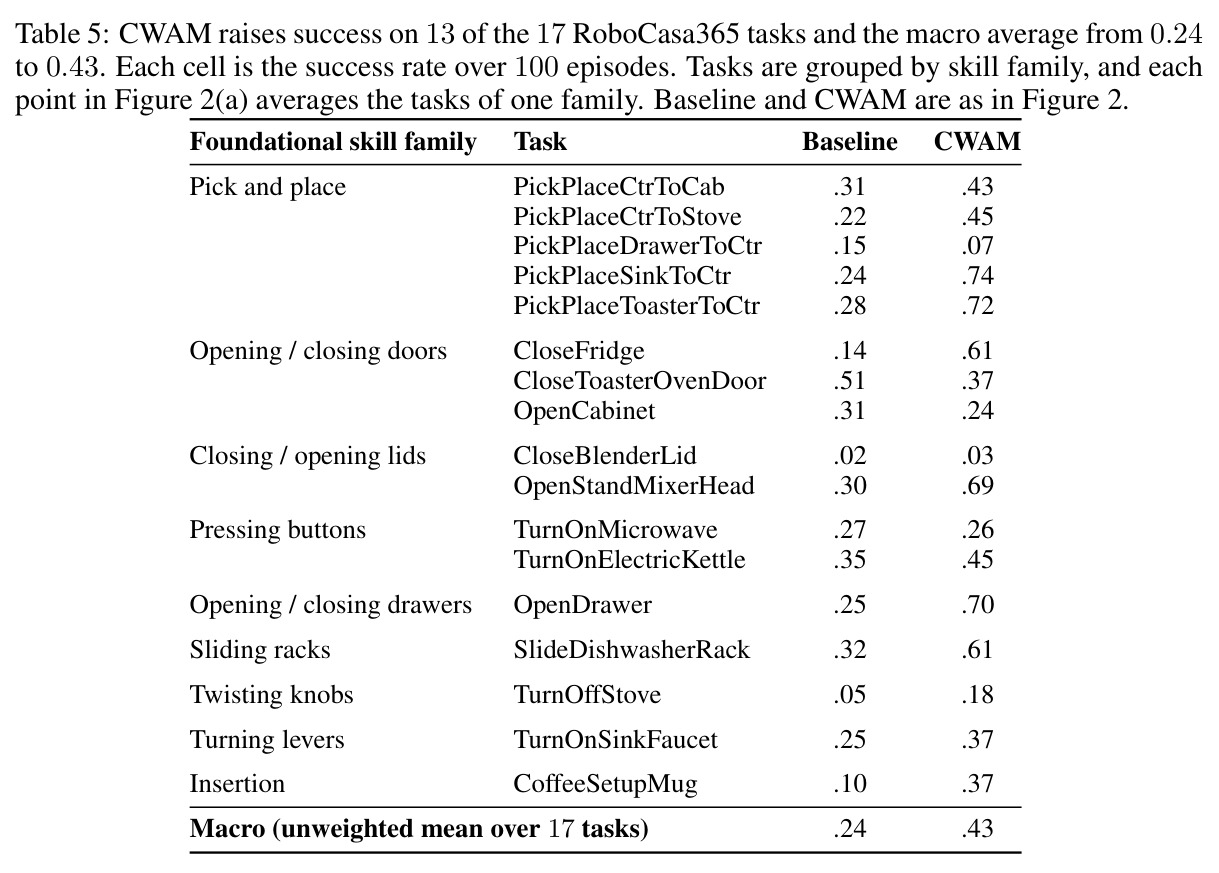
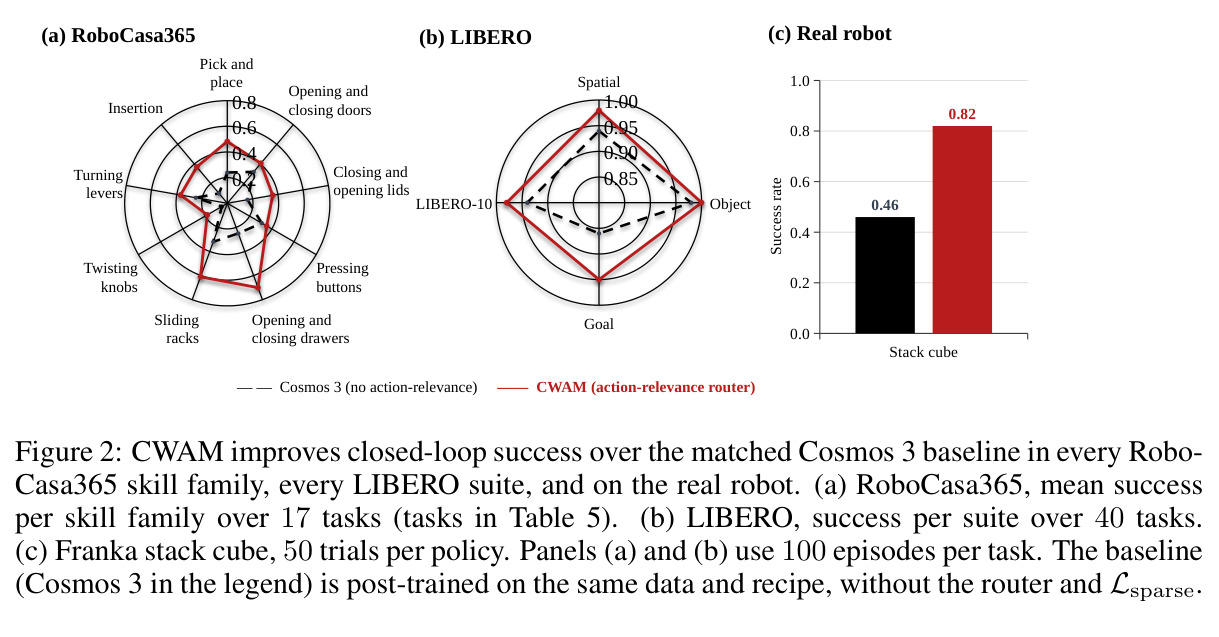
论文在合成与真实两层验证。合成实验($n{=}20$ 维潜变量、$|I_A|{=}4$ 维动作相关、线性动作头):加稀疏 CWAM 选出的 4 维 $C_t$ 对动作相关潜变量的 held-out 探针 $R^2=0.9957$,与 20 维稠密读出的 0.9961 持平;干扰超出量 $\Delta_{\text{nuis}}$ 仅 0.039,接近零,稠密读出高达 0.646。头消融:$C_t$ 置零误差升 1.704 倍、补集置零升 54.65 倍(随机匹配维度呈相反模式)。隐藏环境下块恢复不退化(Table 4)。机器人实验(每任务 100 episodes):RoboCasa365 的 17 任务宏平均从 0.24 升到 0.43,近乎翻倍,13/17 任务提升,最强如 PickPlaceSinkToCounter 74% vs 24%;LIBERO 四 suite 全部领先,LIBERO-10 约 1.00;真实 Franka R3 叠方块 82% vs 46%(各 50 次)。Table 2 干预实验:仅留路由 token(C-only)平均 60.3%,同数量随机 token 24.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboCasa365(17 个基础技能任务) | 宏平均闭环成功率(每任务 100 episodes) | 0.43 | 0.24(匹配后训练的 Cosmos 3,无路由器) | +0.19,近乎翻倍,13/17 任务提升 |
| LIBERO(40 任务,4 个 suite) | 分 suite 成功率(每任务 100 episodes) | 全部 suite 领先,LIBERO-10 约 1.00 | 匹配基线(各 suite 均略低,LIBERO-Goal 差距最大) | 四个 suite 一致提升,Goal suite 增益最大 |
| 真实 Franka R3 叠方块 | 成功率(每策略 50 次试跑) | 82% | 46% | +36 个百分点 |
| 合成块恢复(n=20,|I_A|=4) | held-out 线性探针 R²(动作相关变量) | 0.9957±0.0014(CWAM 加稀疏,4 维) | 0.9961±0.0015(20 维稠密读出);0.5493±0.2964(随机 4 维);0.9440±0.0448(MLP VAE) | 与稠密持平,但干扰变量泄漏 0.039 vs 0.646 |
| RoboCasa365 最强 4 任务的视觉上下文干预 | 固定 checkpoint 闭环成功率(不重训) | 仅保留路由 token(C-only)平均 60.3% | 同数量随机 token 平均 24.5%;完整 CWAM 71.3% | C-only 比随机 token 高 35.8 个百分点 |
局限与改进
作者承认的主要局限是缺少分量级可识别性:定理只保证 $C_t$ 是真实动作相关块 $s_{t,I_A}$ 的块级可逆函数(up to permutation),不能锁定单个潜变量,无法支持精确到分量的干预。我的独立观察有四点。其一,理论依赖非退化条件:每个动作维度的雅可比行需在 $|I_i|$ 个状态上线性独立,$\pi_i(s)=s_1+s_2$ 这类共线机制不满足,附录 B.1 承认这只是存在性假设。其二,token 级稀疏只是 $\ell_0$ 支撑约束的代理:约束对象是路由 readout,稠密路径保留,"动作只由 $C_t$ 生成"在实践中不完全成立(C-only 只保住 60.3%),理论与实践间有一道未量化的鸿沟。其三,RoboCasa365 有 4 个任务变差(如 PickPlaceDrawerToCtr 0.15→0.07、CloseToasterOvenDoor 0.51→0.37),稀疏路由并非普适增益,论文未解释负迁移成因。其四,合成验证规模小(20 维、线性头),理论到 Cosmos 3 的跨越靠路由启发式衔接,缺少中间尺度消融。
独立分析的弱点
弱点一:因果分离是部分的。默认策略保留稠密路径,$C_t$ 更像附加信息而非唯一动作依据,两路径冲突时无法保证动作从因果变量出发。改进方向:推理时对稠密路径做可微剪枝或蒸馏到 C-only 模式,或训练中加大门控权重使稠密路径退化。弱点二:非退化条件在共线机制下失效——$\pi_i(s)=g(s_1+s_2)$ 的雅可比行处处共线,Prop 1 下界不成立,识别结论悬空,而真实策略里对称/耦合动作维度并不罕见。改进方向:把支撑约束放宽到子空间级(识别 span 而非单个坐标)。弱点三:任务级负迁移缺乏机制解释——PickPlaceDrawerToCtr 为何掉 8 个百分点?论文未报告失败任务的路由质量分布。改进方向:补失败任务的路由可视化与 $C_t$ 覆盖率统计,引入 per-task 自适应 $\lambda$。弱点四:稀疏替代损失约束的是注意力权重而非真正的函数依赖,干扰信息仍可经非路由通道泄漏;C-only 与完整 CWAM 之间 11 个百分点的差距正暗示这种泄漏。改进方向:在编码器输出层施加坐标级 group lasso(如合成实验所做),或推理时做特征级消融校验。
未来方向
作者明确提出的方向是分量级可识别性——把块级恢复推进到能锁定单个潜变量,从而支持精确干预;并把因果工具应用到 WAM 的更多开放问题,本文自定位为"对动作的因果理解的第一步"。基于本文成果可以自然延伸的方向包括:其一,把支撑稀疏识别与主动学习结合,在演示收集中插入少量廉价干预(如随机化桌布位置),检验能否把 Thm 2 的块级结论升级成分量级;其二,把 $C_t$ 用于失败诊断与可解释性——路由质量何时集中、何时发散,可作为 rollout 失败的在线信号;其三,理论上扩展到 H-step chunk 与跨步机制:本文识别是逐动作坐标、逐步进行的,动作 chunk 与潜状态转移的联合结构识别仍是空白;其四,把同一"预算钳制"原则迁移到其他双职责架构,例如带语言规划的 VLA 模型,区分"导致动作的 token"与"仅支撑预测/解释的 token";其五,检验稀疏路由对分布偏移的鲁棒性——Thm 2 的函数性结论暗示 $C_t$ 在干扰变量变化时应该更稳,可在真实世界的隐藏环境式扰动中系统验证。
复现评估
复现门槛分化明显。合成部分极易复现:生成器(20 维潜变量、block-diagonal 观测映射、隐藏 regime)、估计器(MLP 编码器 + 线性动作头)、全部超参(Adam、batch 512、LR $10^{-3}$、160 epochs、惩罚权重 0.01、ridge $\alpha{=}1$)在附录 C 交代完整,单卡可复现 Table 1 与 Table 4。机器人部分门槛高:骨干是公开的 nvidia/Cosmos3-Nano,但后训练需要 8×H200 节点(FSDP shard 8、bf16)、两阶段共 5 万步,还要自建 Wan 2.2 视频 latent 管线;RoboCasa365 与 LIBERO 是公开基准,评估协议可复现。路由器细节完整($d_r{=}512$、8 头、top-$k{=}32$、门控 0.01、$\lambda{=}0.01$、1,000 步 ramp、4,000 步退火)。论文未声明代码开源,若无官方实现,机器人部分需数周工程量与一个 8 卡 H200 节点预算;建议先复现合成实验确认理论行为,再决定是否投入全量后训练。
论文图表