Long-WAM:扩展世界-动作模型的视觉上下文规模 Long-WAM: Scaling the Context of World-Action Models
先AR视频预训练再保留因果结构适配动作,19.2秒历史让GR-1成功率提升15.4点
前置知识
世界-动作模型(World-Action Model, WAM)
将视频生成与动作生成耦合进同一模型的机器人控制框架:模型一边根据观测历史预测场景未来的视觉演化,一边输出去噪得到的动作块(action chunk),供闭环控制执行。本文的 WAM 由一个因果视频专家和一个动作专家通过非对称联合注意力组成。
论文研究的核心对象就是 WAM 的『视觉上下文』——模型能回看多长的观测历史以及历史对动作的贡献,理解 WAM 的结构才能读懂上下文扩展实验的设计。
自回归(AR)视频预训练 vs 双向预训练
AR 预训练用块因果注意力按时间顺序从历史帧预测未来帧,配合 teacher forcing 可对每个噪声块并行监督;双向预训练(如 Wan2.2)允许任意帧互相注意,合成质量好但不建模『历史→未来』的因果分解。本文证明只有 AR 初始化才能让更长上下文兑换成成功率。
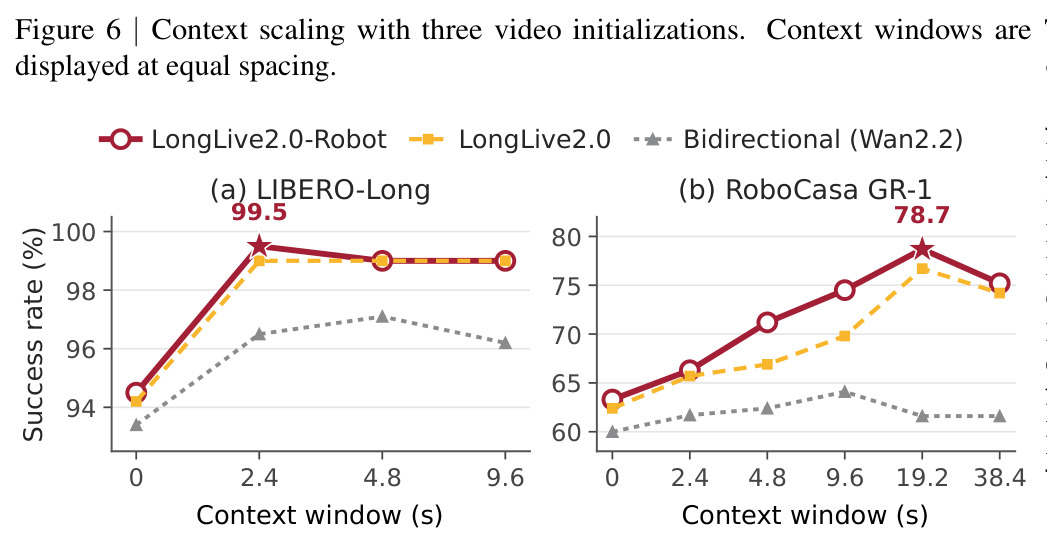
这是全文最核心的结论来源:『能访问历史』与『学会用历史』的区别正来自两种预训练目标的差异,Figure 6 的三组曲线全靠这个概念来解读。
流匹配与扩散去噪
生成模型通过多步迭代去噪产生数据。训练时速度预测器 $v_\theta$ 拟合 $(\bar{\epsilon}_i-\bar{z}_i)$,推理时从高斯噪声出发逐步去噪;$\sigma\in[0,1]$ 表示噪声水平。本文视频专家用 4 步、动作专家用 4 步(记作 V4/A4)。
论文的损失函数、IDM 的 $\sigma^\star=0.9$ 截断、以及 V4/A4 与 V2/A2 的延迟-精度权衡都建立在这一去噪框架上,不懂流匹配就看不懂方法一节。
逆动力学建模(IDM)与 KV 缓存复用
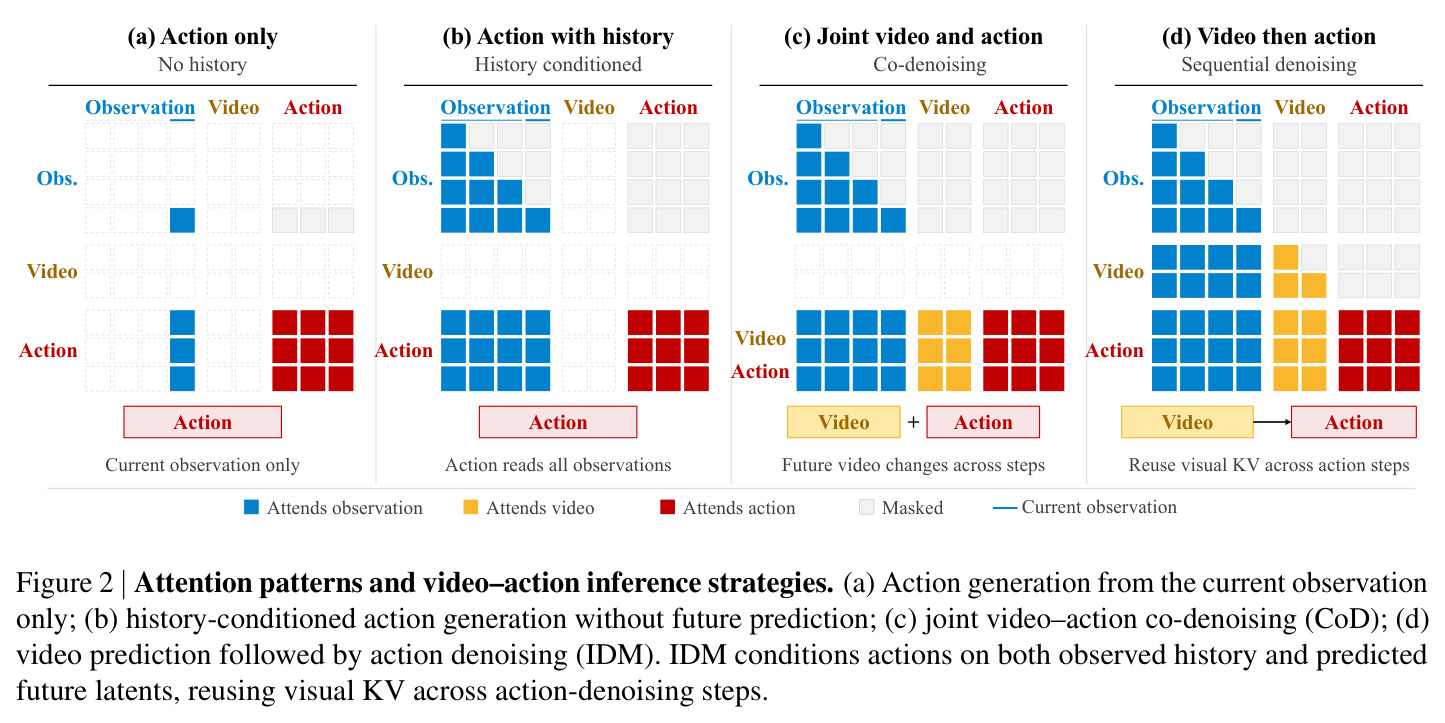
IDM 是『先想象再行动』的推理模式:视频专家先把未来 rollout 到噪声水平 $\sigma^\star=0.9$ 的部分去噪潜变量(不解码为像素),这些未来 token 的注意力 KV 缓存($\mathcal{K}_t$)在整个动作去噪过程中被复用,动作专家据此条件化去噪。
这是 Long-WAM 在 107.4 ms 内完成含未来预测的完整推理的关键设计,也是它相对 CoD(联合去噪)和无未来预测基线取得增益的来源。
异步执行与流式 VAE
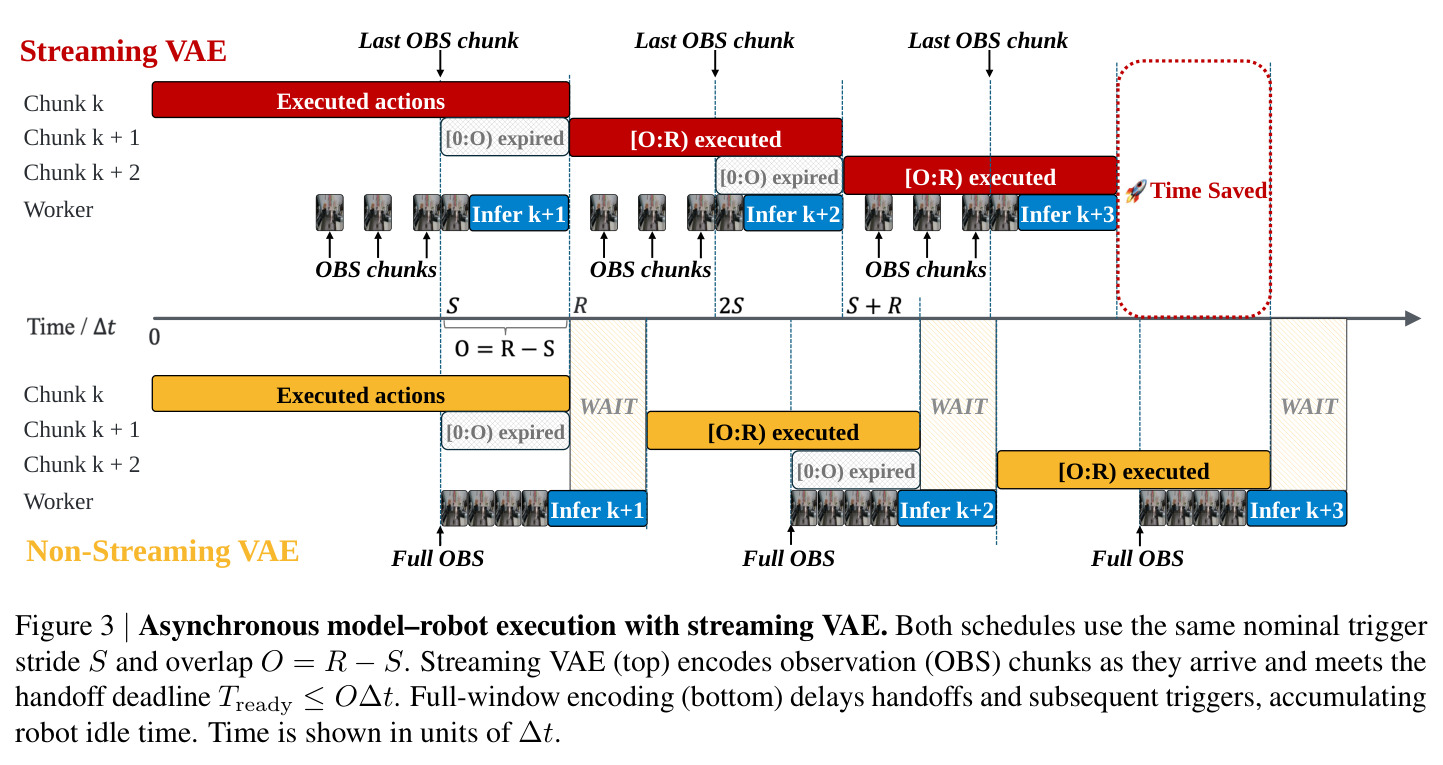
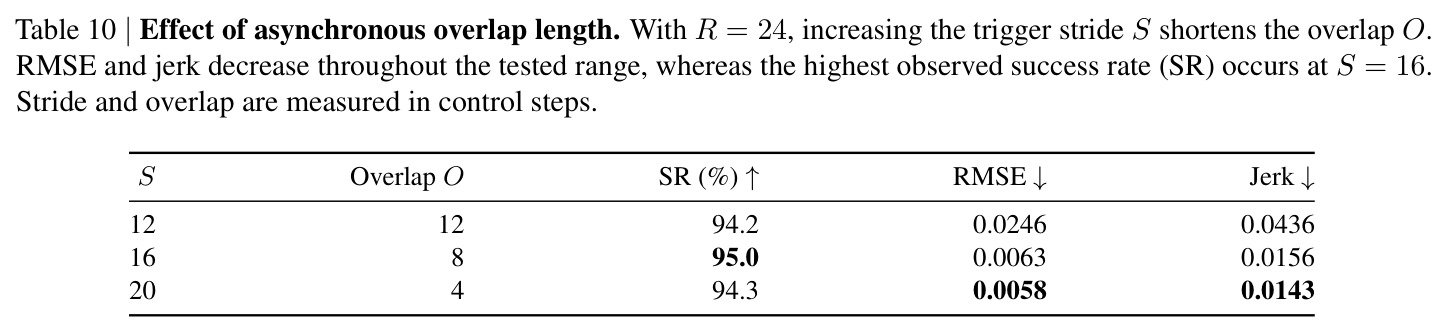
机器人执行当前动作块的同时后台推理下一块:触发间隔 $S$、执行前缀 $R$、重叠 $O=R-S$,交接 deadline 为 $T_{\text{ready}}\le O\Delta t$。流式因果 VAE 在帧到达时增量编码观测,而非触发后编码整窗,避免编码延迟挤占重叠窗口。
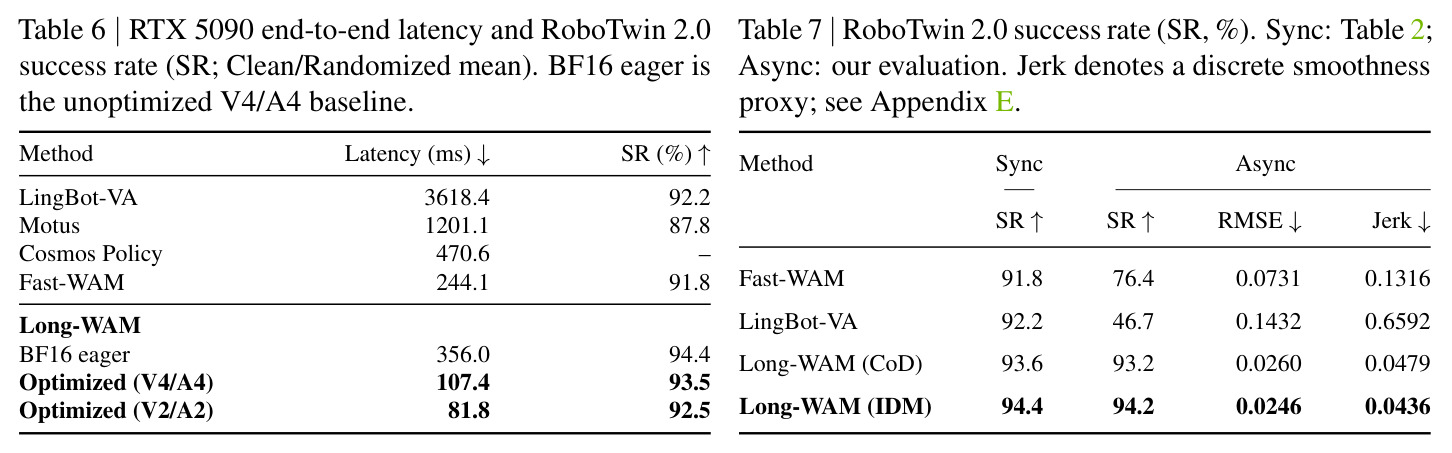
Long-WAM 展示了纯异步执行(无平滑混合、无前缀引导)只损失 0.2 个百分点,而 Fast-WAM、LingBot-VA 分别掉 15.4 和 45.5 点,理解该机制才能评价其系统贡献。
NVFP4 量化与 CUDA Graph
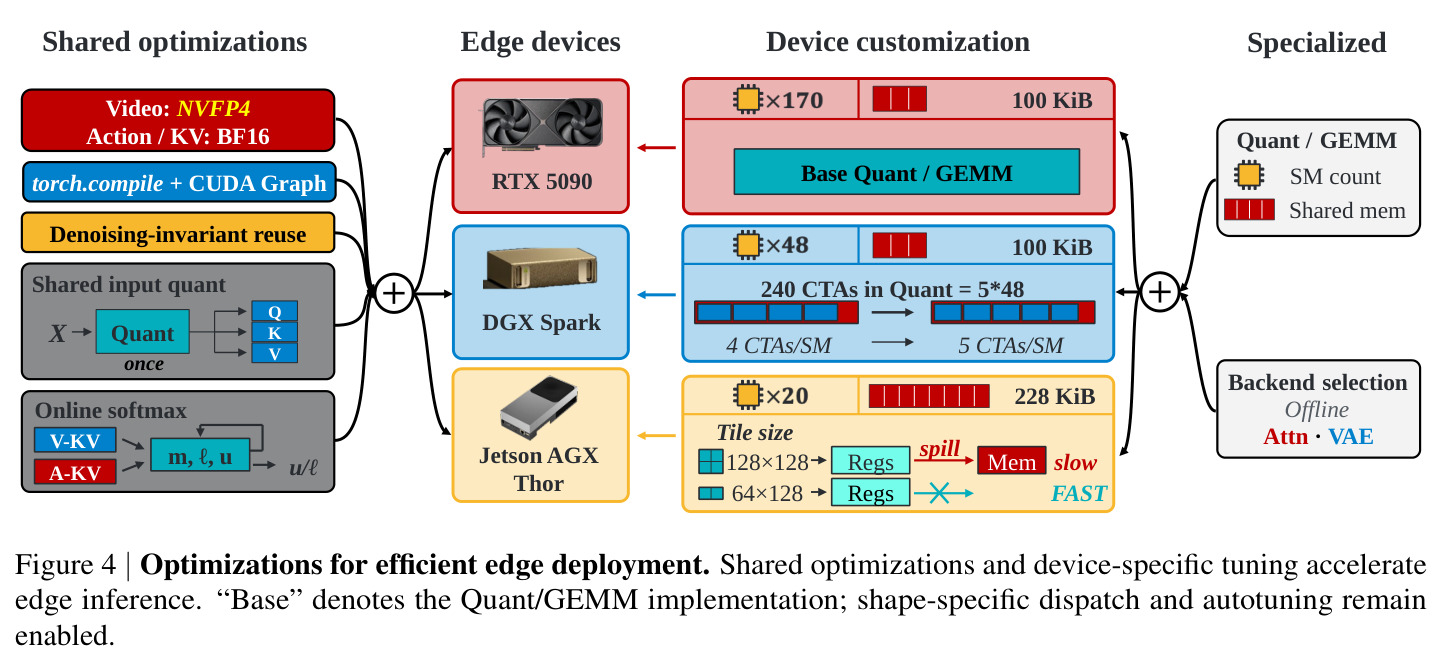
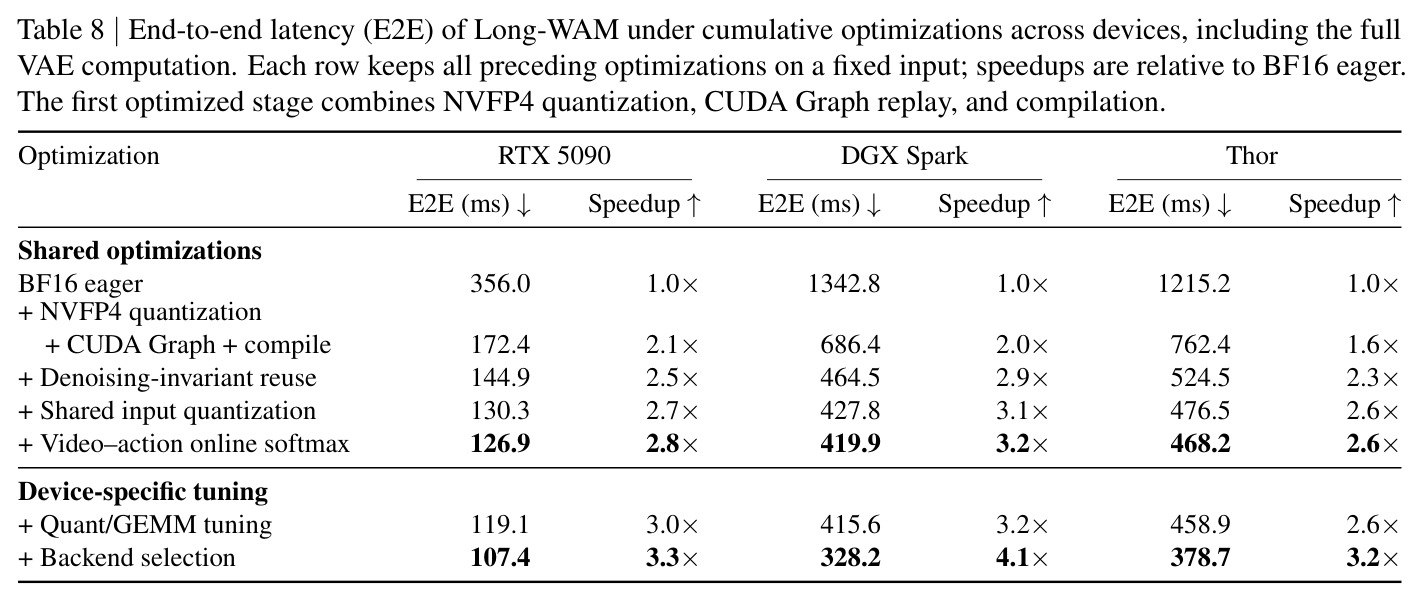
W4A4 指权重和激活都用 4 比特浮点(NVFP4),可大幅降低视频专家线性层的计算与存储,但会引入小内核的启动开销;CUDA Graph 重放与 torch.compile 通过消除 launch 开销和融合算子把它补回来。动作计算与 KV 存储保持 BF16 以保护控制精度。
论文报告的 3.2–4.1 倍端到端加速由这些工程优化叠加而成,Table 8 的逐行累计数据需要这套背景才能读懂。
研究动机
实时机器人控制要求系统理解场景正在如何变化:单张图像能告诉机械臂杯子在哪,却无法揭示杯子以什么速度移动、抓取进行到哪一步。世界-动作模型(WAM)把视频预测引入闭环控制,视觉历史因此成为动作决策的天然资源,但处理更长的历史又会拖慢响应,形成『看得越多、动得越慢』的矛盾。现有方法各有取舍:DreamZero、LingBot-VA 把双向预训练的视频生成器适配为因果视频-动作模型,LingBot-VA 2.0 则联合预训练因果视频与潜在动作;它们虽通过因果缓存保留了历史,却未必学会从历史中预测。与此同时,大型视频主干让在线控制开销居高不下——LingBot-VA 单个动作块推理需 3618.4 ms,Fast-WAM 也要 244.1 ms,而机器人控制要求在重叠窗口内完成推理。因此论文追问:WAM 控制如何随视觉上下文扩展?如何在实时约束下保住这些增益?
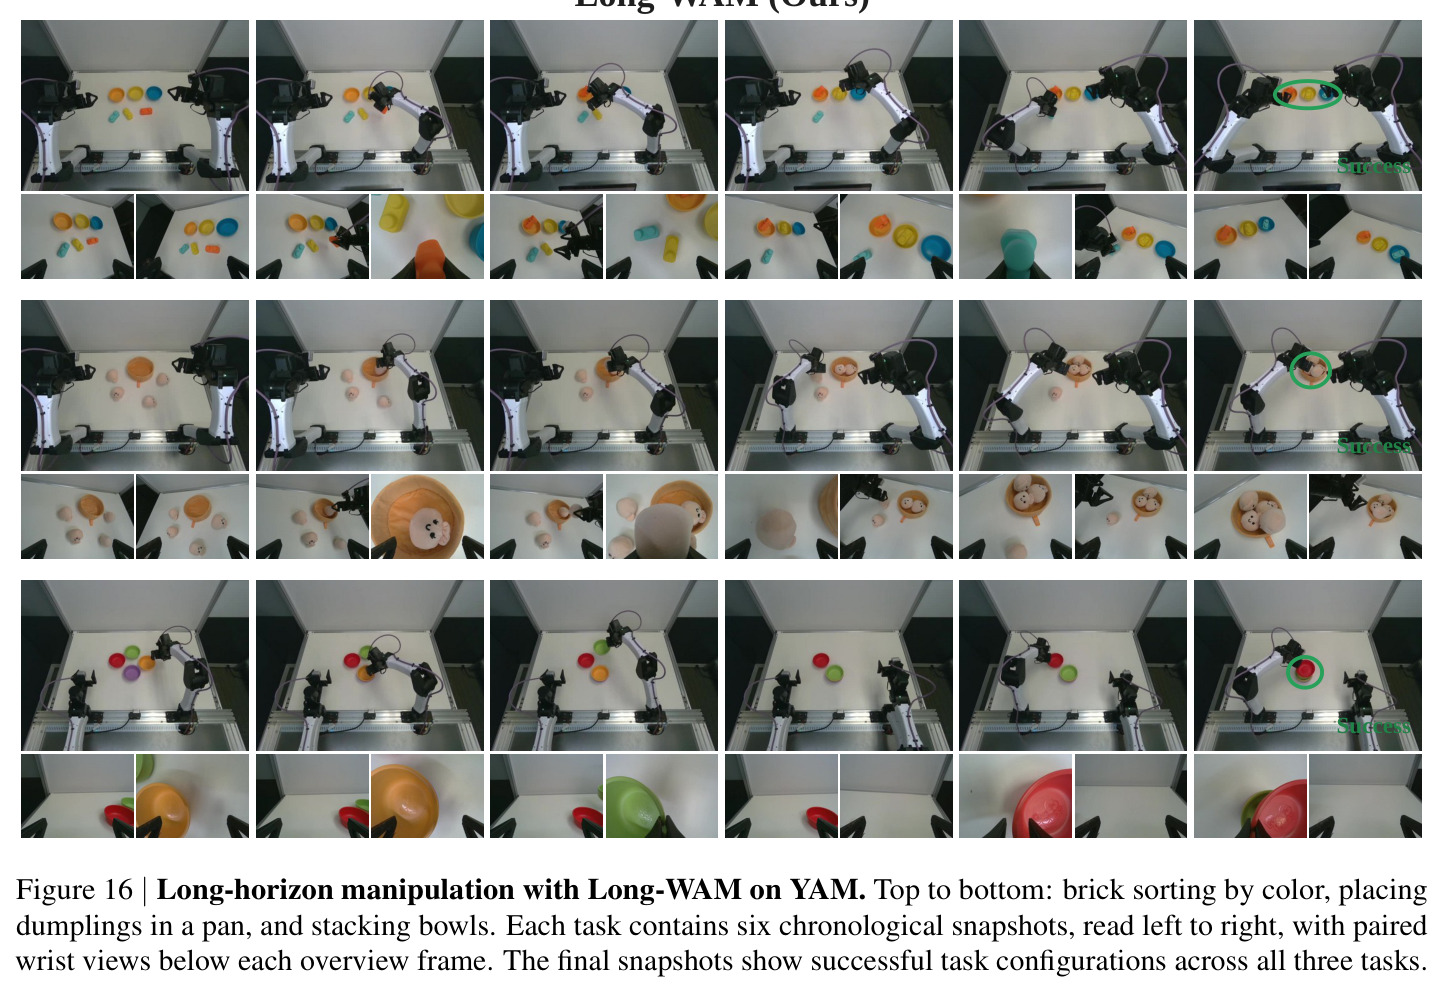
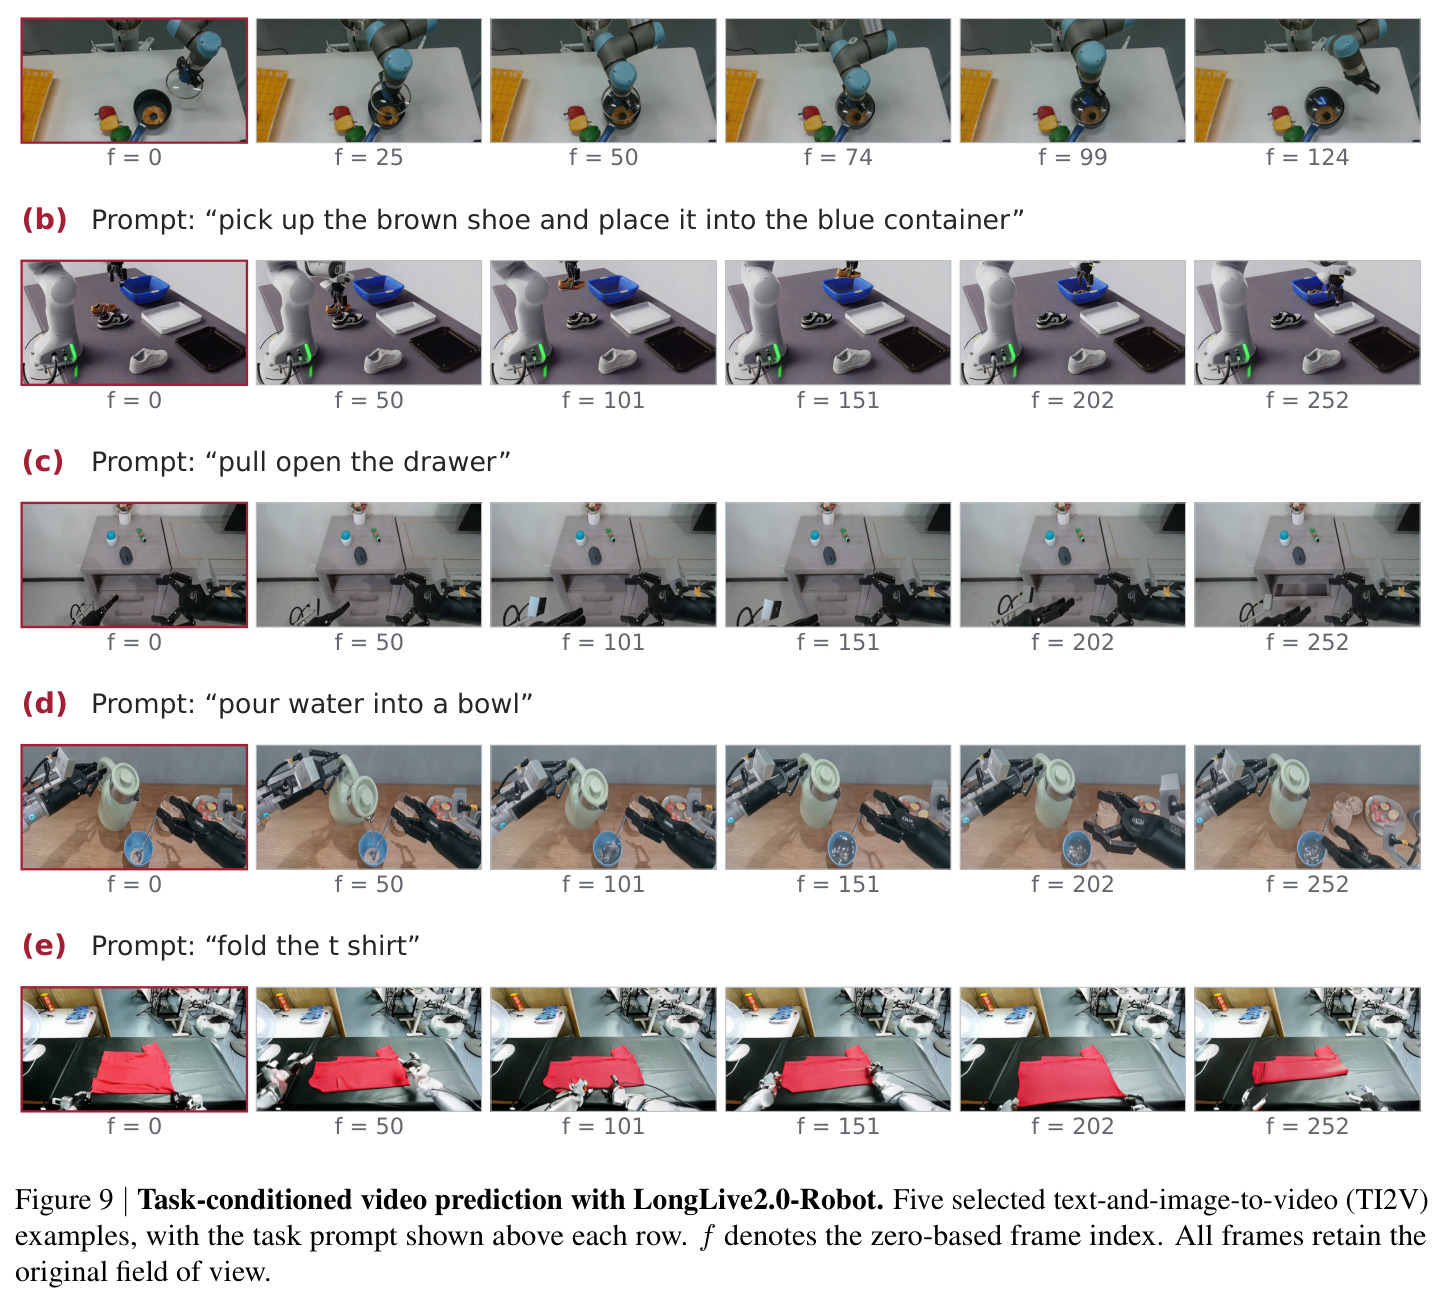
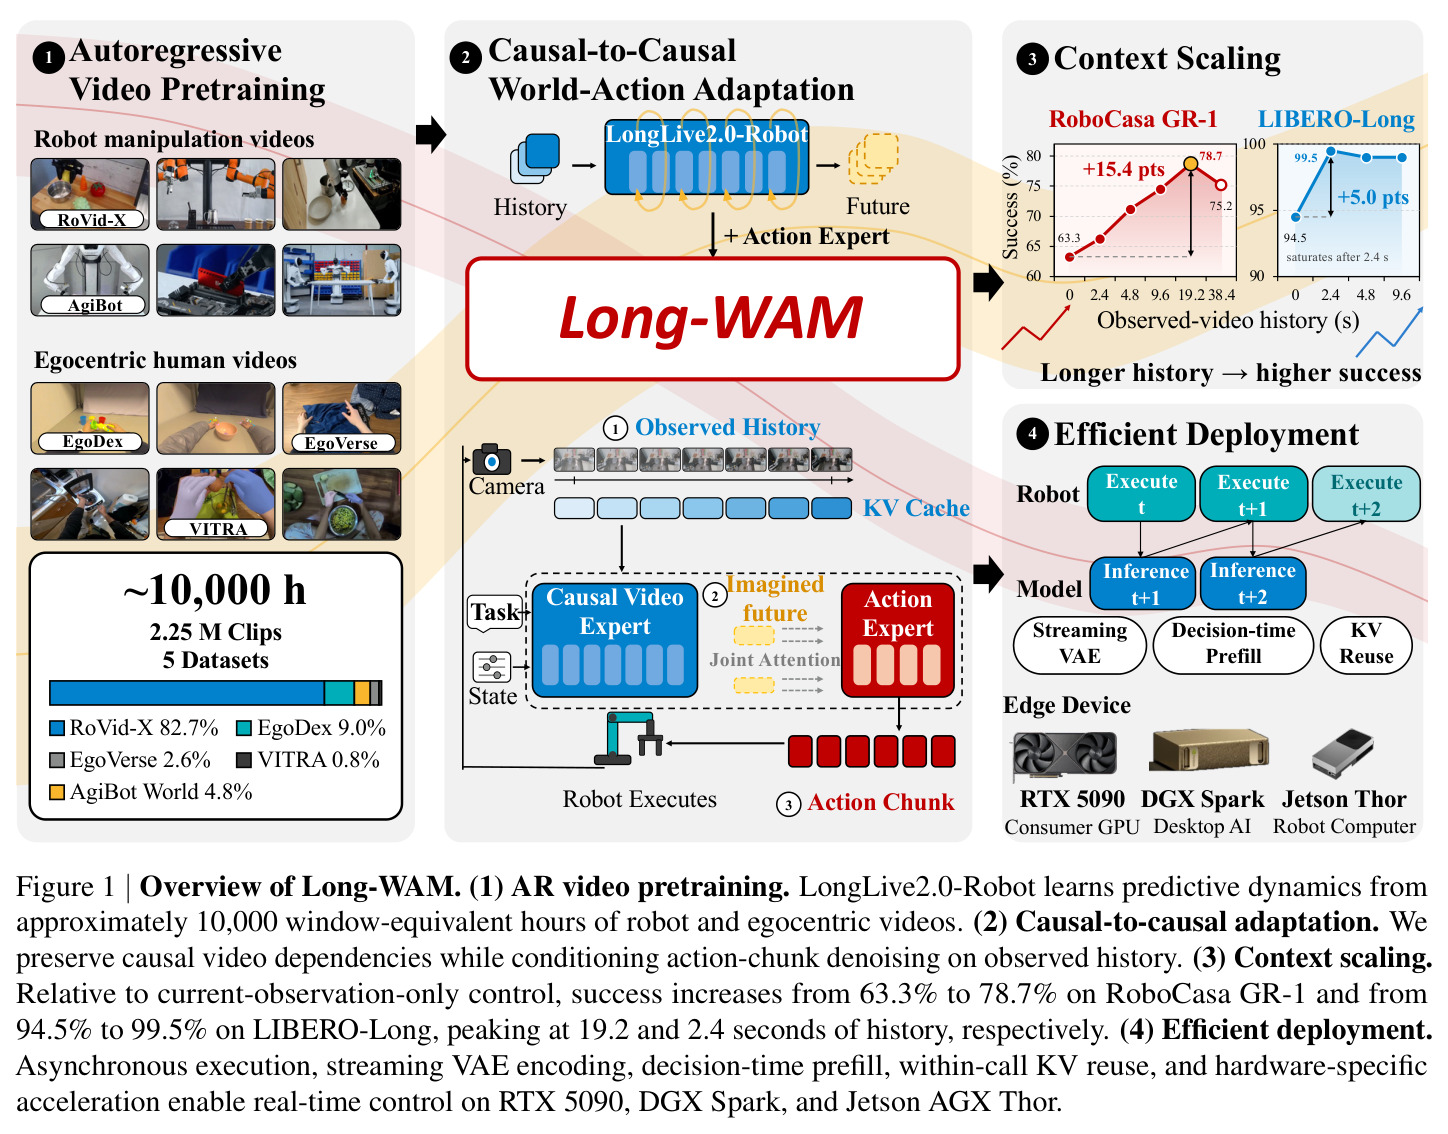
本文的目标是本文要构建一个模型-系统协同框架,在实时控制约束下系统性扩展因果世界-动作模型的上下文长度,并回答两个问题:更长视觉历史到底能兑换多少控制增益;兑现这些增益依赖什么前提条件。具体目标包括四个层面:(1) 训练机器人域自回归视频基础模型 LongLive2.0-Robot,在 LongLive-2.0 的 16 秒 AR 检查点之上,用约 10000 窗口等效小时(2.25M 视频片段)的机器人与第一人称视频学习预测动力学;(2) 在世界-动作适配中保留其历史到未来的因果结构,使动作同时条件化于观测历史与预期未来;(3) 在 RoboCasa GR-1、LIBERO、RoboTwin 2.0、DOMINO、RoboCasa365 及 Unitree G1/YAM 真机上验证上下文从 0 到 38.4 秒的收益曲线;(4) 通过流式 VAE、异步执行、NVFP4 量化与设备专属调优,把含未来视频预测的流水线压到 RTX 5090 上 107.4 ms/动作块,部署到消费级 GPU 与边缘设备。
与已有工作不同的是,论文的独特切入点是一个容易忽视的区分:能访问历史不等于会用历史。作者发现更长历史的价值取决于视频基础模型的预训练方式——只有先经过自回归(AR)预训练、内化历史到未来的因果时间分解,动作适配后扩展上下文才有净回报;双向初始化(Wan2.2)在 19.2 秒历史下成功率反而回落到 61.6%。这开辟了一条与 DreamZero/LingBot-VA(双向预训练后适配)和 LingBot-VA 2.0(联合预训练)都不同的分阶段路线:先在无动作标签的机器人与第一人称视频上做 AR 预训练,再在同样因果序下适配动作,从而把预测预训练与具身动作表征学习解耦。此外,作者把上下文当作一种执行资源来研究,同时权衡预测收益与响应时间,并证明纯异步执行(不做推理时引导、前缀条件训练或去噪时混合)配合时间连续的预测式条件即可维持动作连续性,是对『预训练-预测-动作-部署』全链路的系统性回答。
核心方法
Long-WAM 的整体思路是『先学会预测,再学会行动,最后让两者跑得够快』。直觉上,如果模型在预训练阶段就被迫从历史帧预测未来帧,它就内化了『过去如何决定未来』的时间结构;做动作适配时保留这个结构,历史观察就能通过预测表征真正影响控制决策。技术路线分四步:(1) 自回归视频预训练——在 LongLive-2.0 的 16 秒 AR 检查点上继续训练 LongLive2.0-Robot,用块因果注意力和 teacher forcing 从约 10000 小时机器人/第一人称视频学习长序列预测;(2) 因果到因果的世界-动作适配——通过非对称注意力接口耦合视频专家与动作专家,推理时采用 IDM 模式(先预测未来视频潜变量,再据此去噪动作块);(3) 上下文扩展实验——为 0 至 38.4 秒的每个历史窗口单独训练模型并在对应长度下评估,隔离『窗口长度』这一变量;(4) 实时部署基础设施——流式 VAE 编码、异步执行、NVFP4 W4A4 量化、CUDA Graph 重放、调用内 KV 复用与设备专属内核调优,把 RTX 5090 端到端延迟从 356.0 ms 压到 107.4 ms。
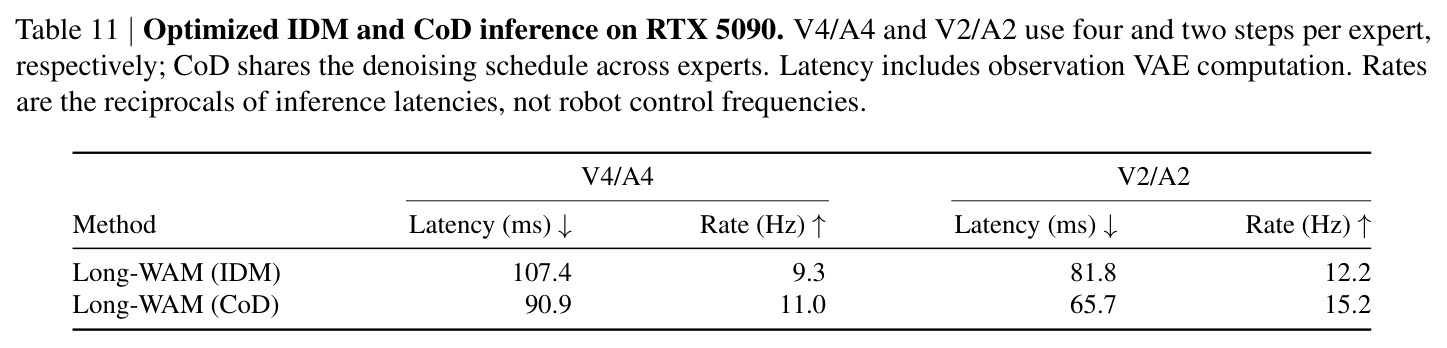
核心创新是『因果到因果』的适配范式及其背后的发现:AR 预训练学到的时间因果分解是长上下文增益的来源。具体地,视频查询只读自己及更早的视觉块、绝不读动作 token;动作查询读观测历史、部分去噪的未来视频潜变量和整个噪声动作块。这个非对称接口既保留预训练的因果视觉依赖,又让动作同时锚定过去与预期未来。与已有方法的本质区别在于:DreamZero、LingBot-VA 从双向视频生成器出发,因果预测和动作耦合都要在下游学习,实验显示其扩展上下文几乎无净增益(双向初始化在 GR-1 上 2.4s→19.2s 从 61.7% 回落到 61.6%);LingBot-VA 2.0 联合预训练视频与潜在动作,而 Long-WAM 把预测预训练与具身动作表征学习分成两阶段。另一个关键设计是 IDM:视频专家只用 4 步去噪到 $\sigma^\star=0.9$ 的粗糙未来潜变量、从不解码为像素,其 KV 缓存在动作去噪全程复用,使『先想象后行动』的路径在计算上可行——含未来预测仍比不含未来预测的 Fast-WAM 快 2.3 倍(107.4 ms 对 244.1 ms)。
方法步骤详情
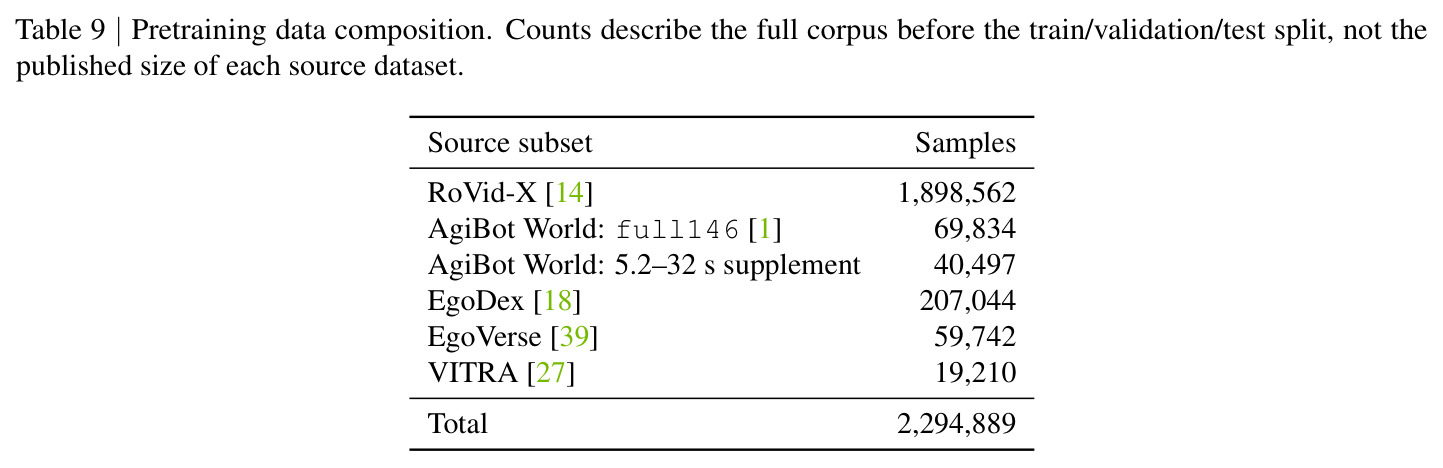
第一步,机器人域 AR 预训练:从 LongLive-2.0 的 16 秒检查点出发,在 RoVid-X(82.7%)、EgoDex(9.0%)、AgiBot World(4.8%)、EgoVerse 与 VITRA 共约 10000 窗口等效小时上继续训练,序列长达 30 秒并用序列并行跨 GPU 分片;teacher forcing 下块因果注意力并行监督每个噪声块,损失为 $\mathcal{L}_{\text{TF-AR}}=\mathbb{E}[w(\sigma_i)\lVert v_\theta(x_i^{\sigma_i},\sigma_i\mid h_{<i},c)-(\bar{\epsilon}_i-\bar{z}_i)\rVert_2^2]$,并保留源自 SVI 的误差回收。第二步,因果到因果适配:视频专家以观测潜变量 $Z_t^-$、状态 $q_t$、指令 $c$ 为条件 rollout 出未来潜变量 $\tilde{Z}_t^+$ 并 prefill 出视觉缓存 $\mathcal{K}_t$,动作专家据此去噪 $H$ 步动作块;训练分两个 pass——干净历史上的视频流匹配,以及以历史加前向加噪未来($\sigma^\star=0.9$)为条件的动作流匹配,后者对视觉缓存 detach。第三步,上下文扩展:为 0 至 38.4 秒每个窗口单独训练模型并在训练长度下评估,缺失早期历史则重复首帧。第四步,边缘部署:流式因果 VAE 让编码先于触发完成,异步执行满足 $T_{\text{ready}}\le O\Delta t=(R-S)\Delta t$;视频专家用 W4A4 NVFP4、动作与 KV 保持 BF16,叠加 CUDA Graph、torch.compile 与设备专属调优。
技术新颖性
技术新颖性体现在四个层面。第一,实证揭示预训练目标决定上下文可扩展性:同为因果 WAM 适配,AR 初始化相对双向初始化的领先从 0 历史时的 3.3 个百分点扩大到 19.2 秒时的 17.1 个百分点,此前工作未量化过这一关系。第二,IDM 推理模式把未来预测压缩为 $\sigma^\star=0.9$ 的部分去噪潜变量并复用其 KV 缓存,绕开像素级视频合成开销,使包含未来视频预测的完整流水线仍比不含未来预测的 Fast-WAM 快 2.3 倍(107.4 ms 对 244.1 ms)。第三,纯异步执行的可行性论证:依赖时间连续的预测式条件,相邻动作块在重叠区自然一致(IDM 重叠 RMSE 0.0246、jerk 0.0436,约为 Fast-WAM 的三分之一),无需推理时引导、前缀条件训练或去噪时混合,异步后仅损失 0.2 个百分点。第四,系统层贡献:流式 VAE 把观测编码前移、在线 softmax 免拼接 KV 缓冲区、共享输入量化复用 Q/K/V 投影的量化激活、针对三款设备的 tile 尺寸与后端调优,总加速 3.2–4.1 倍。
实验结果
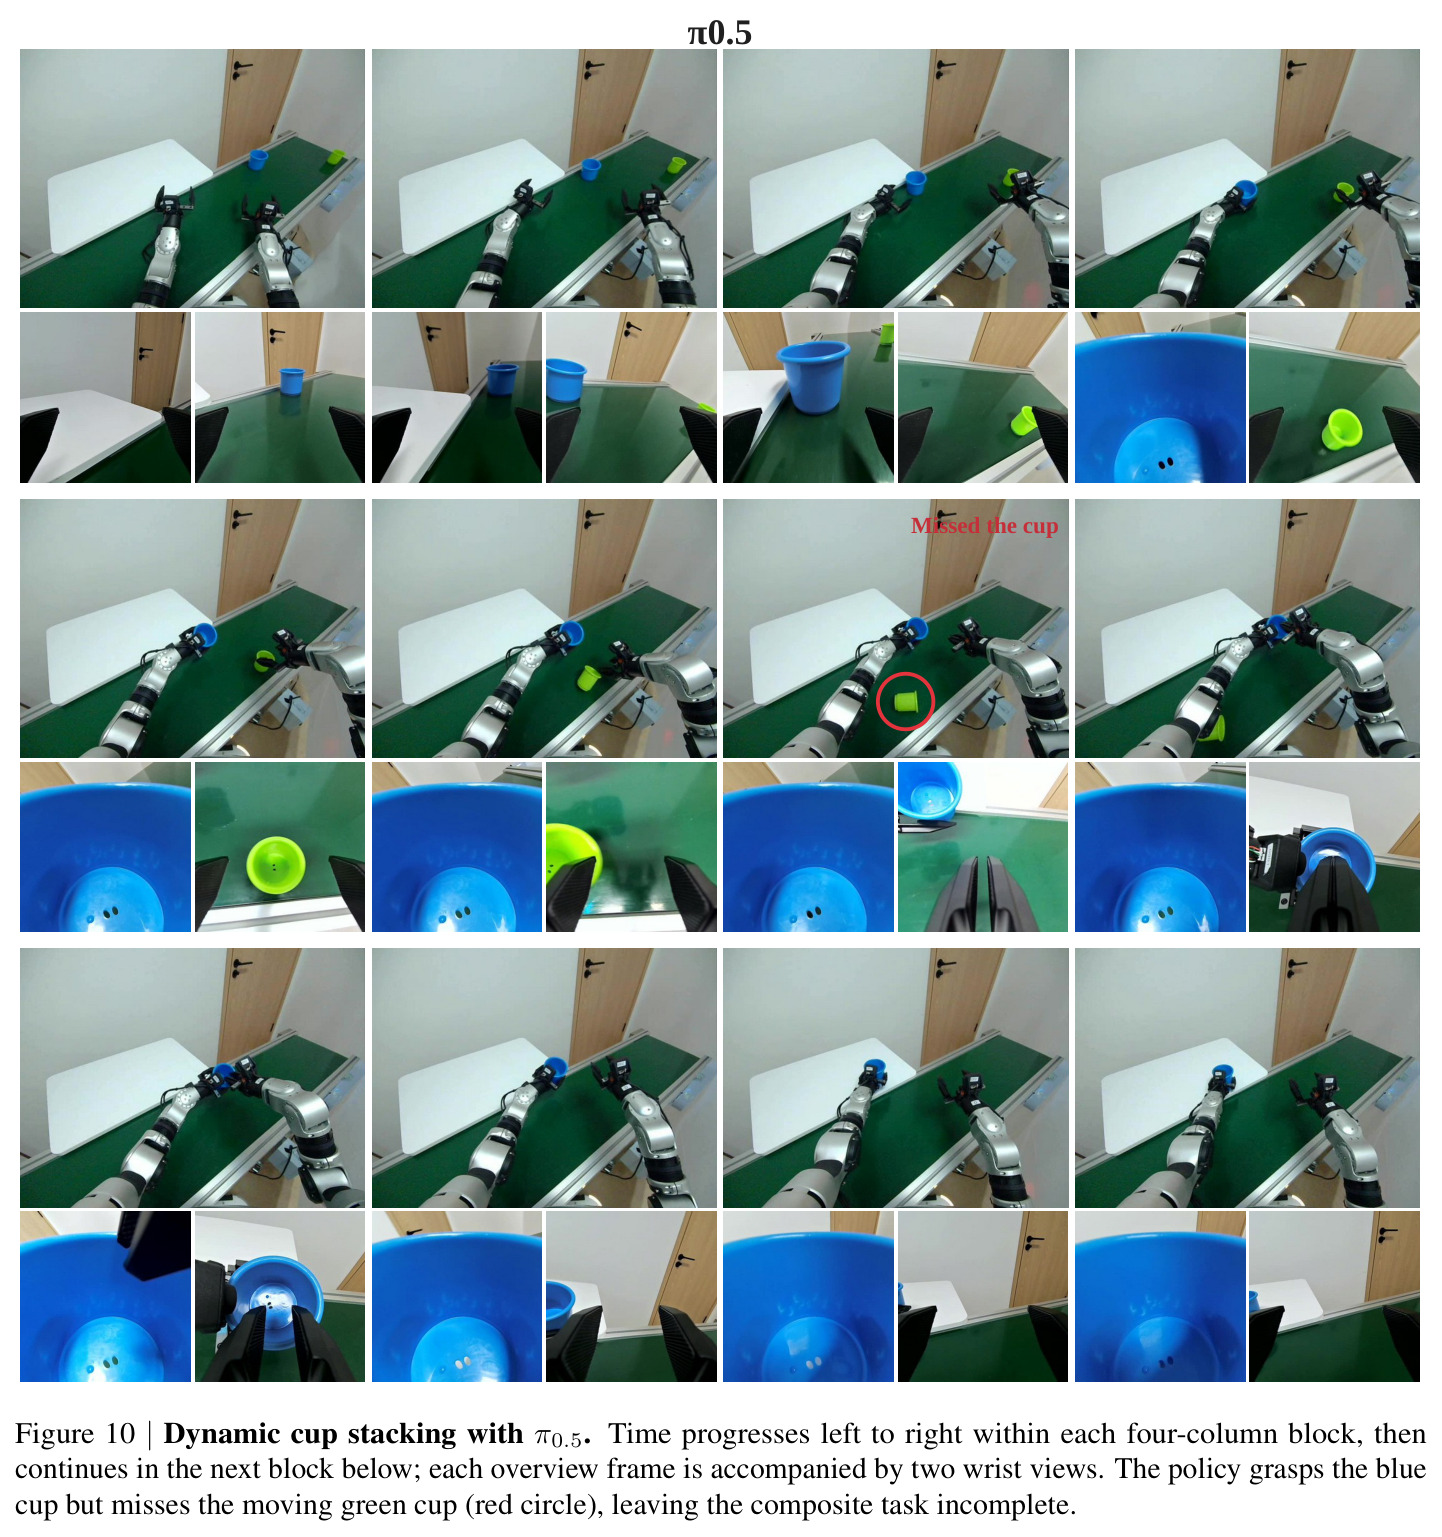
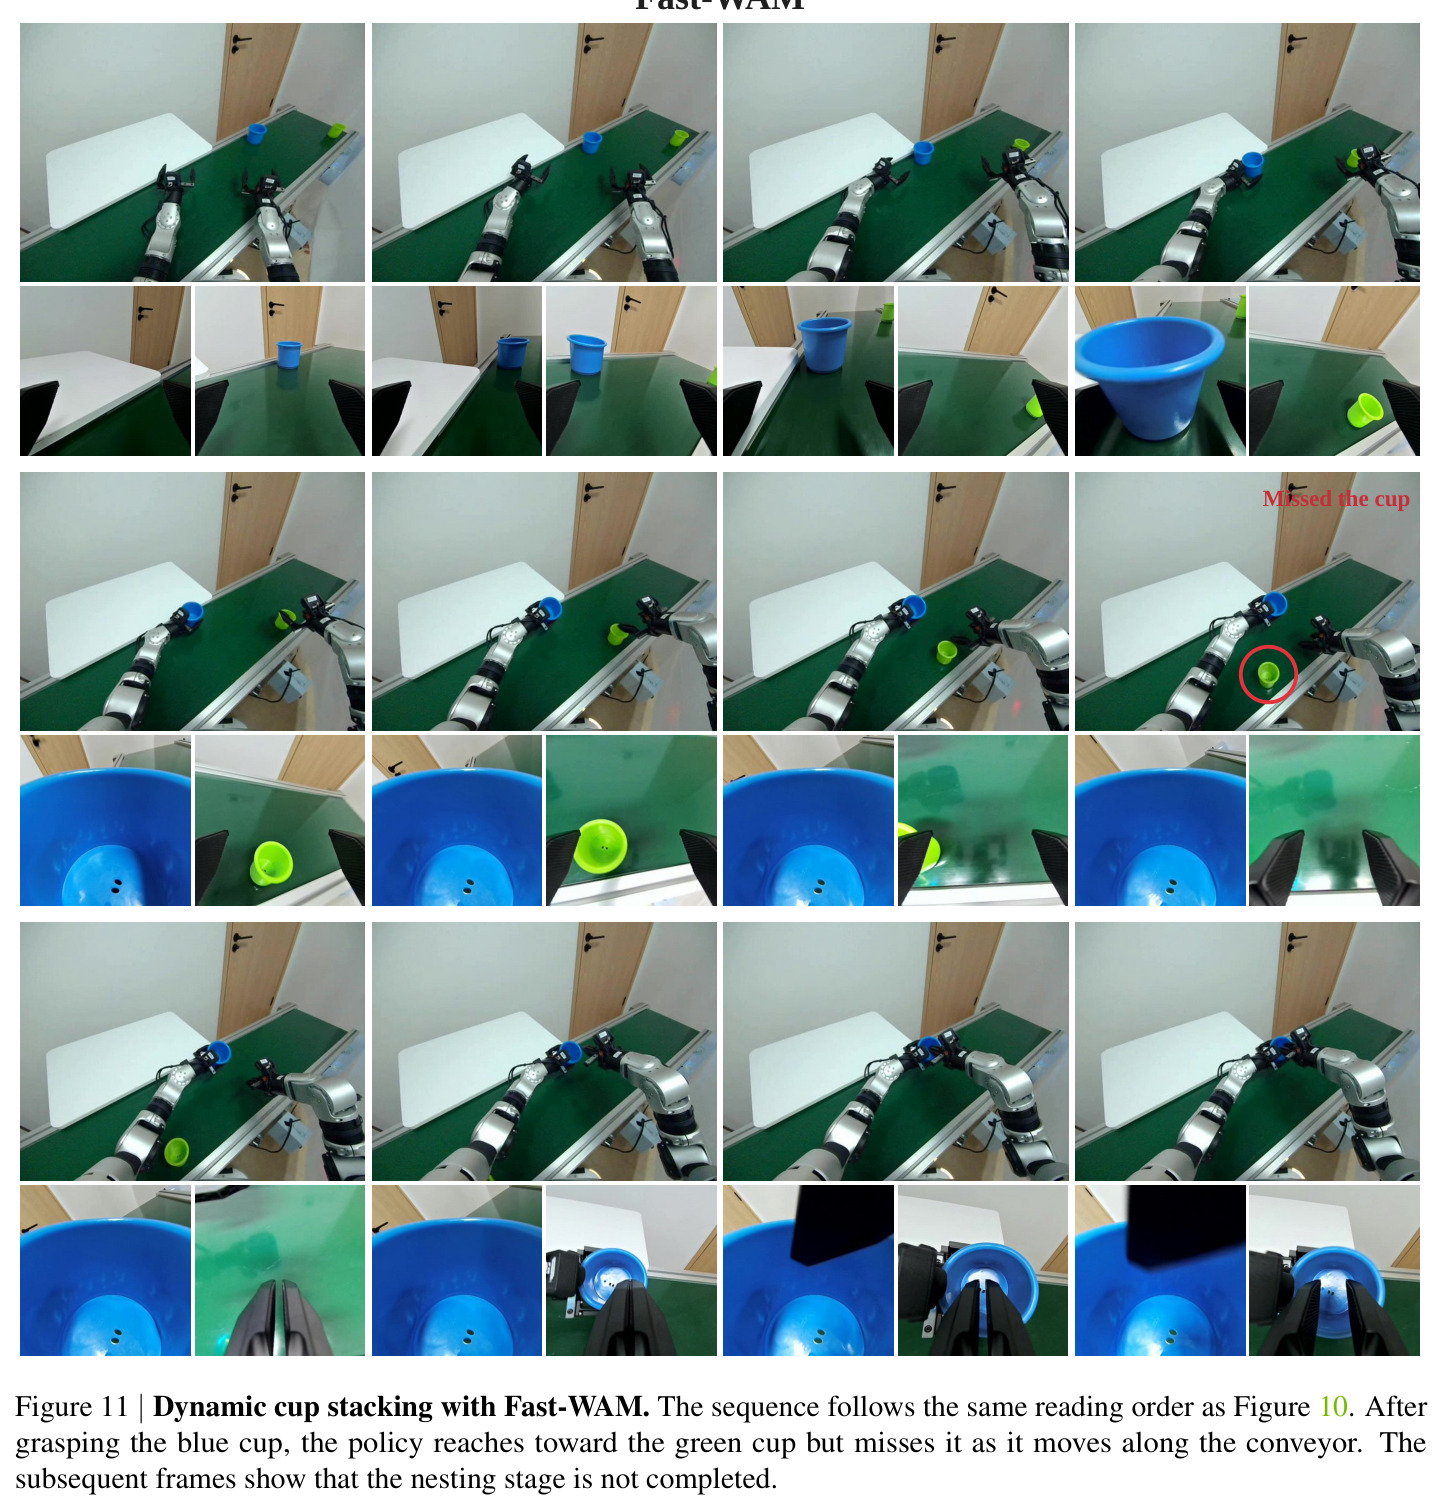
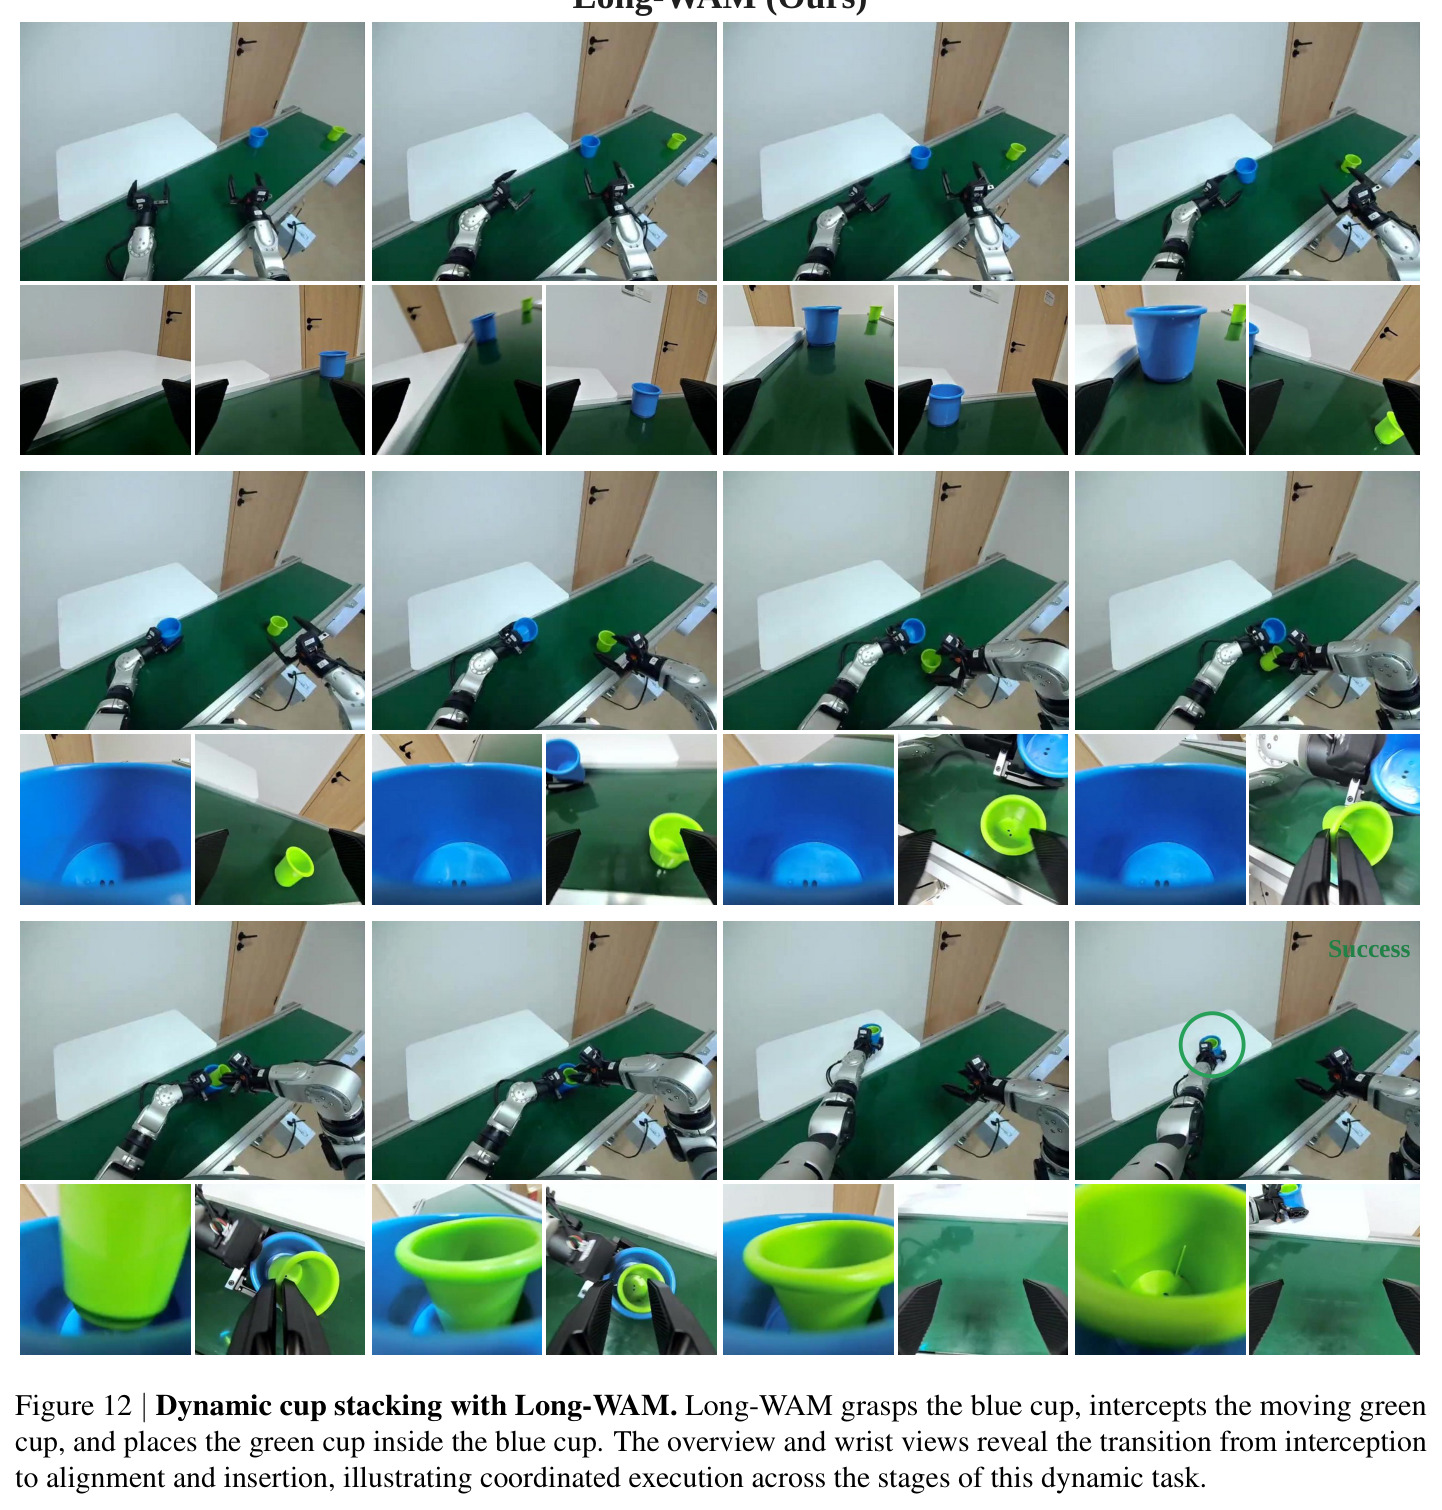
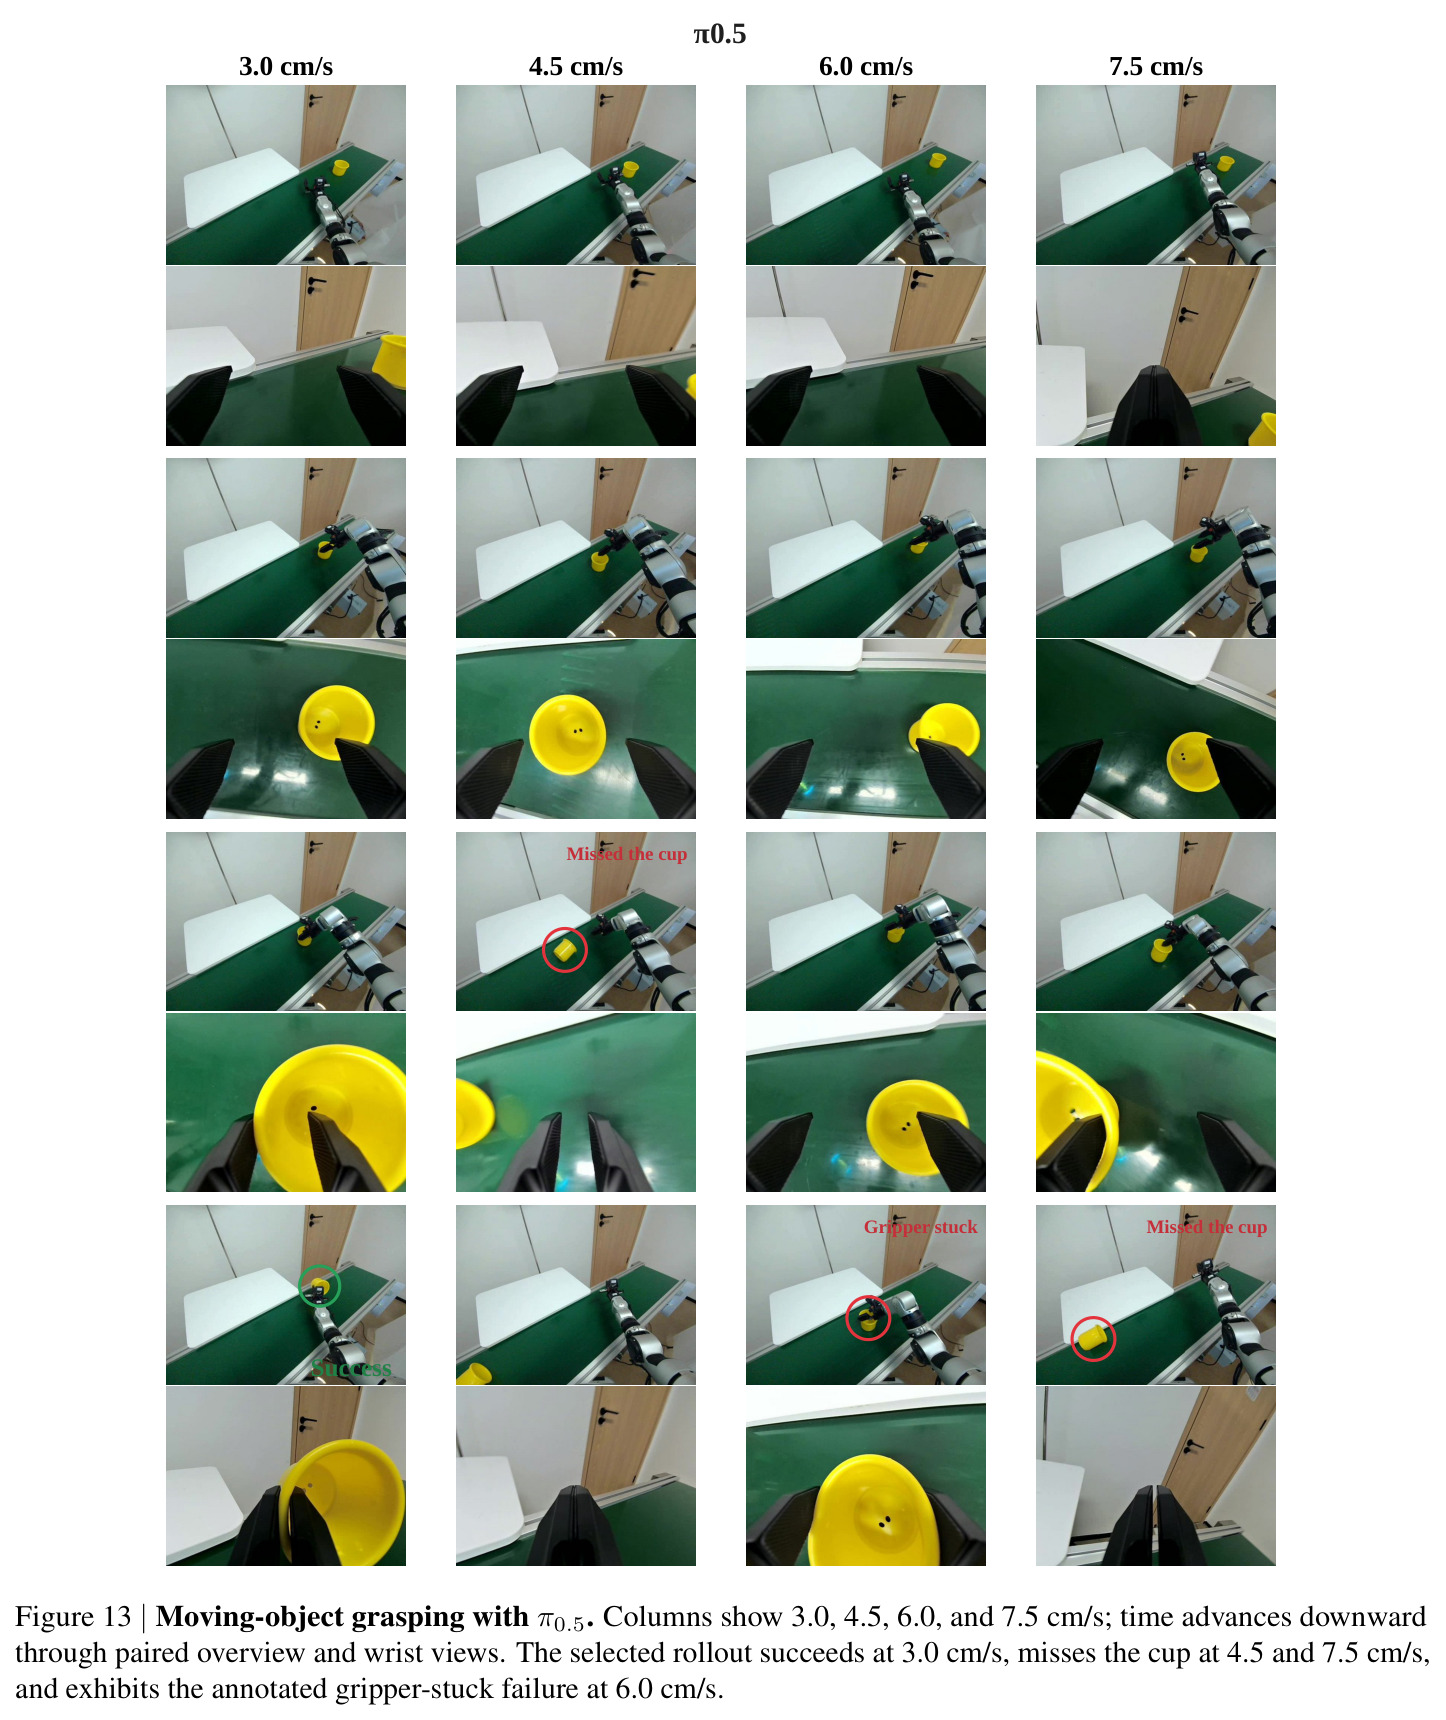
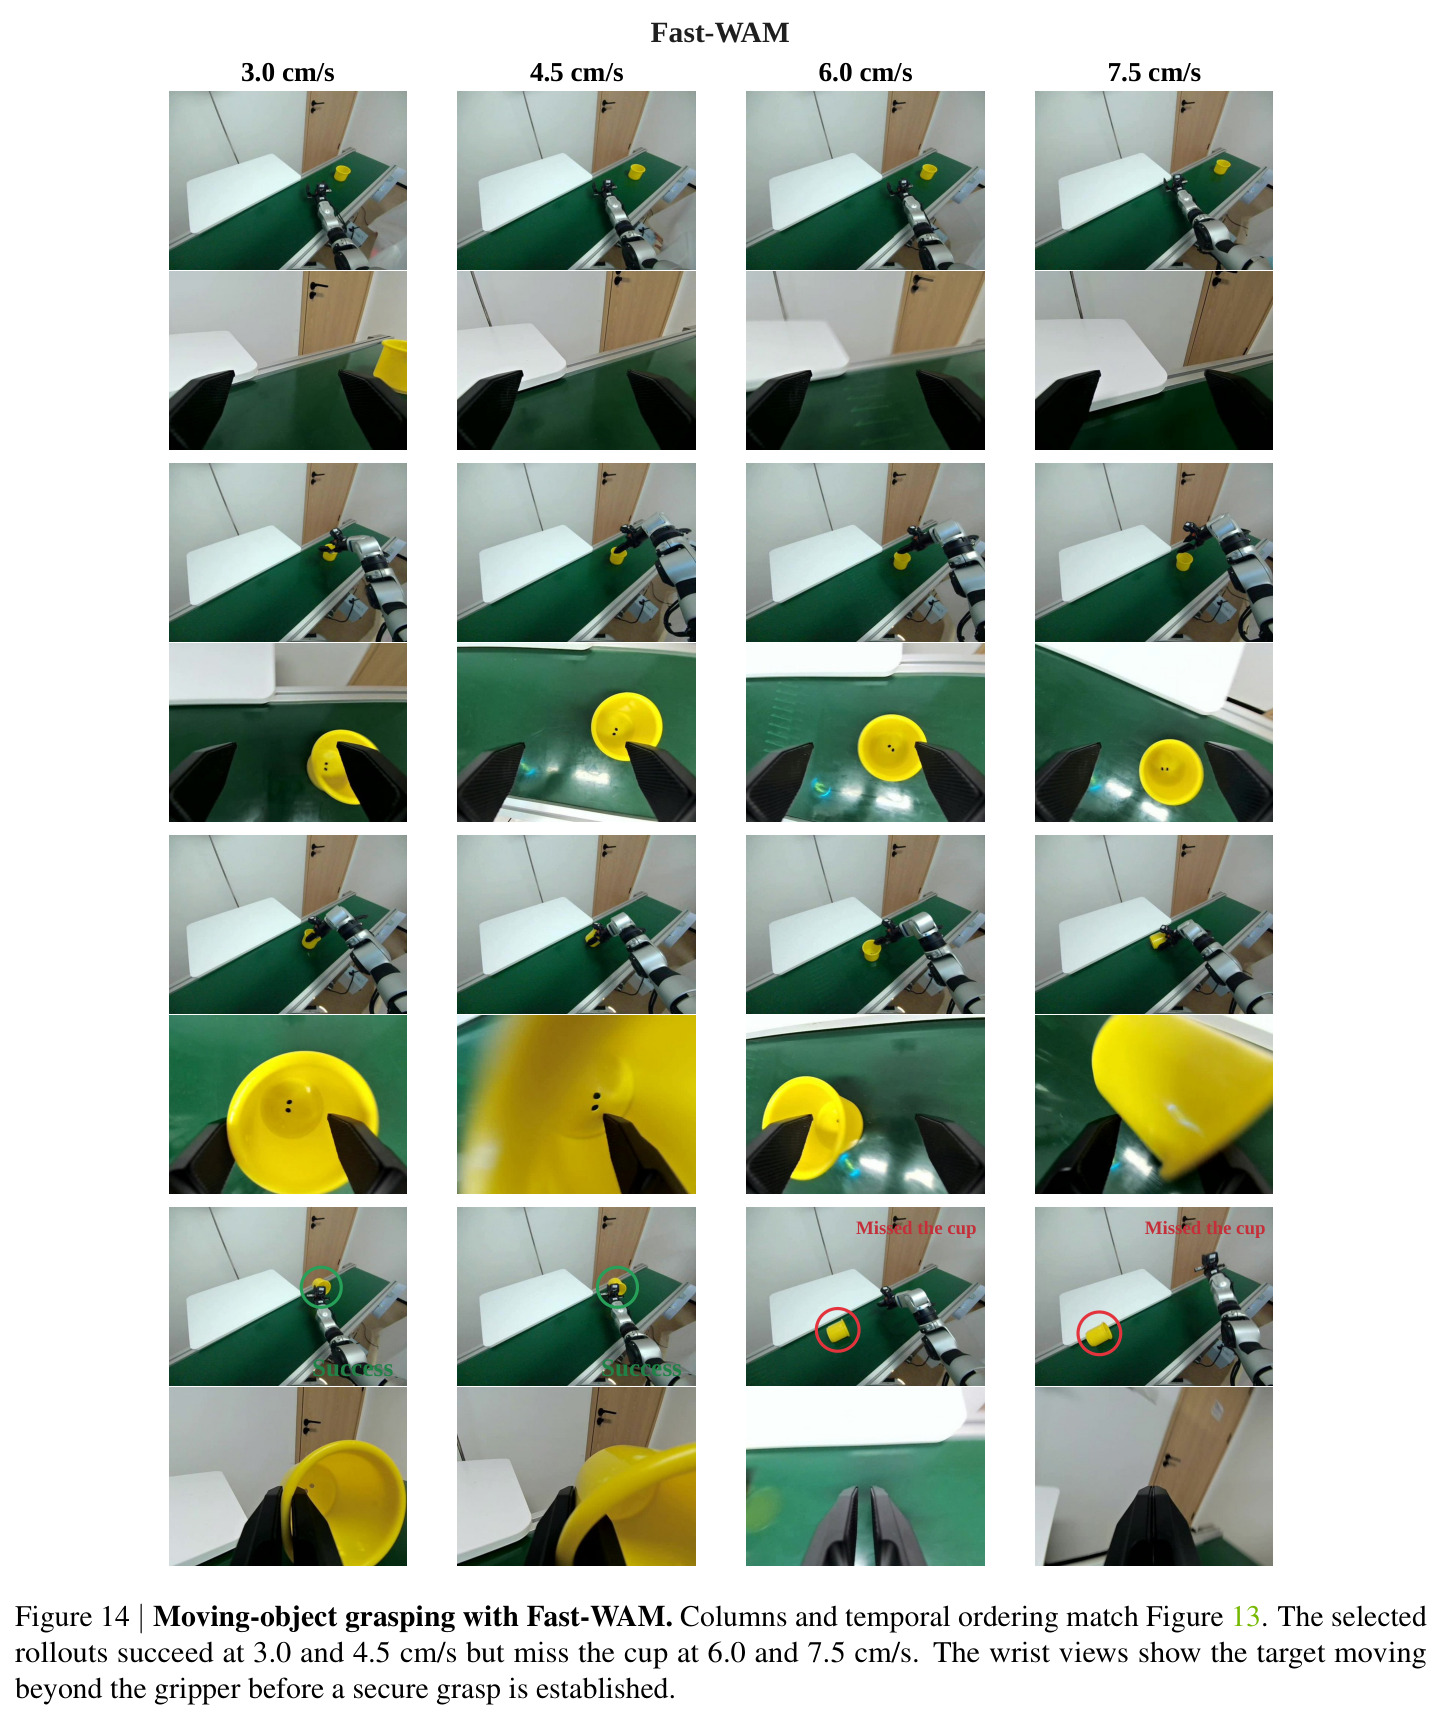
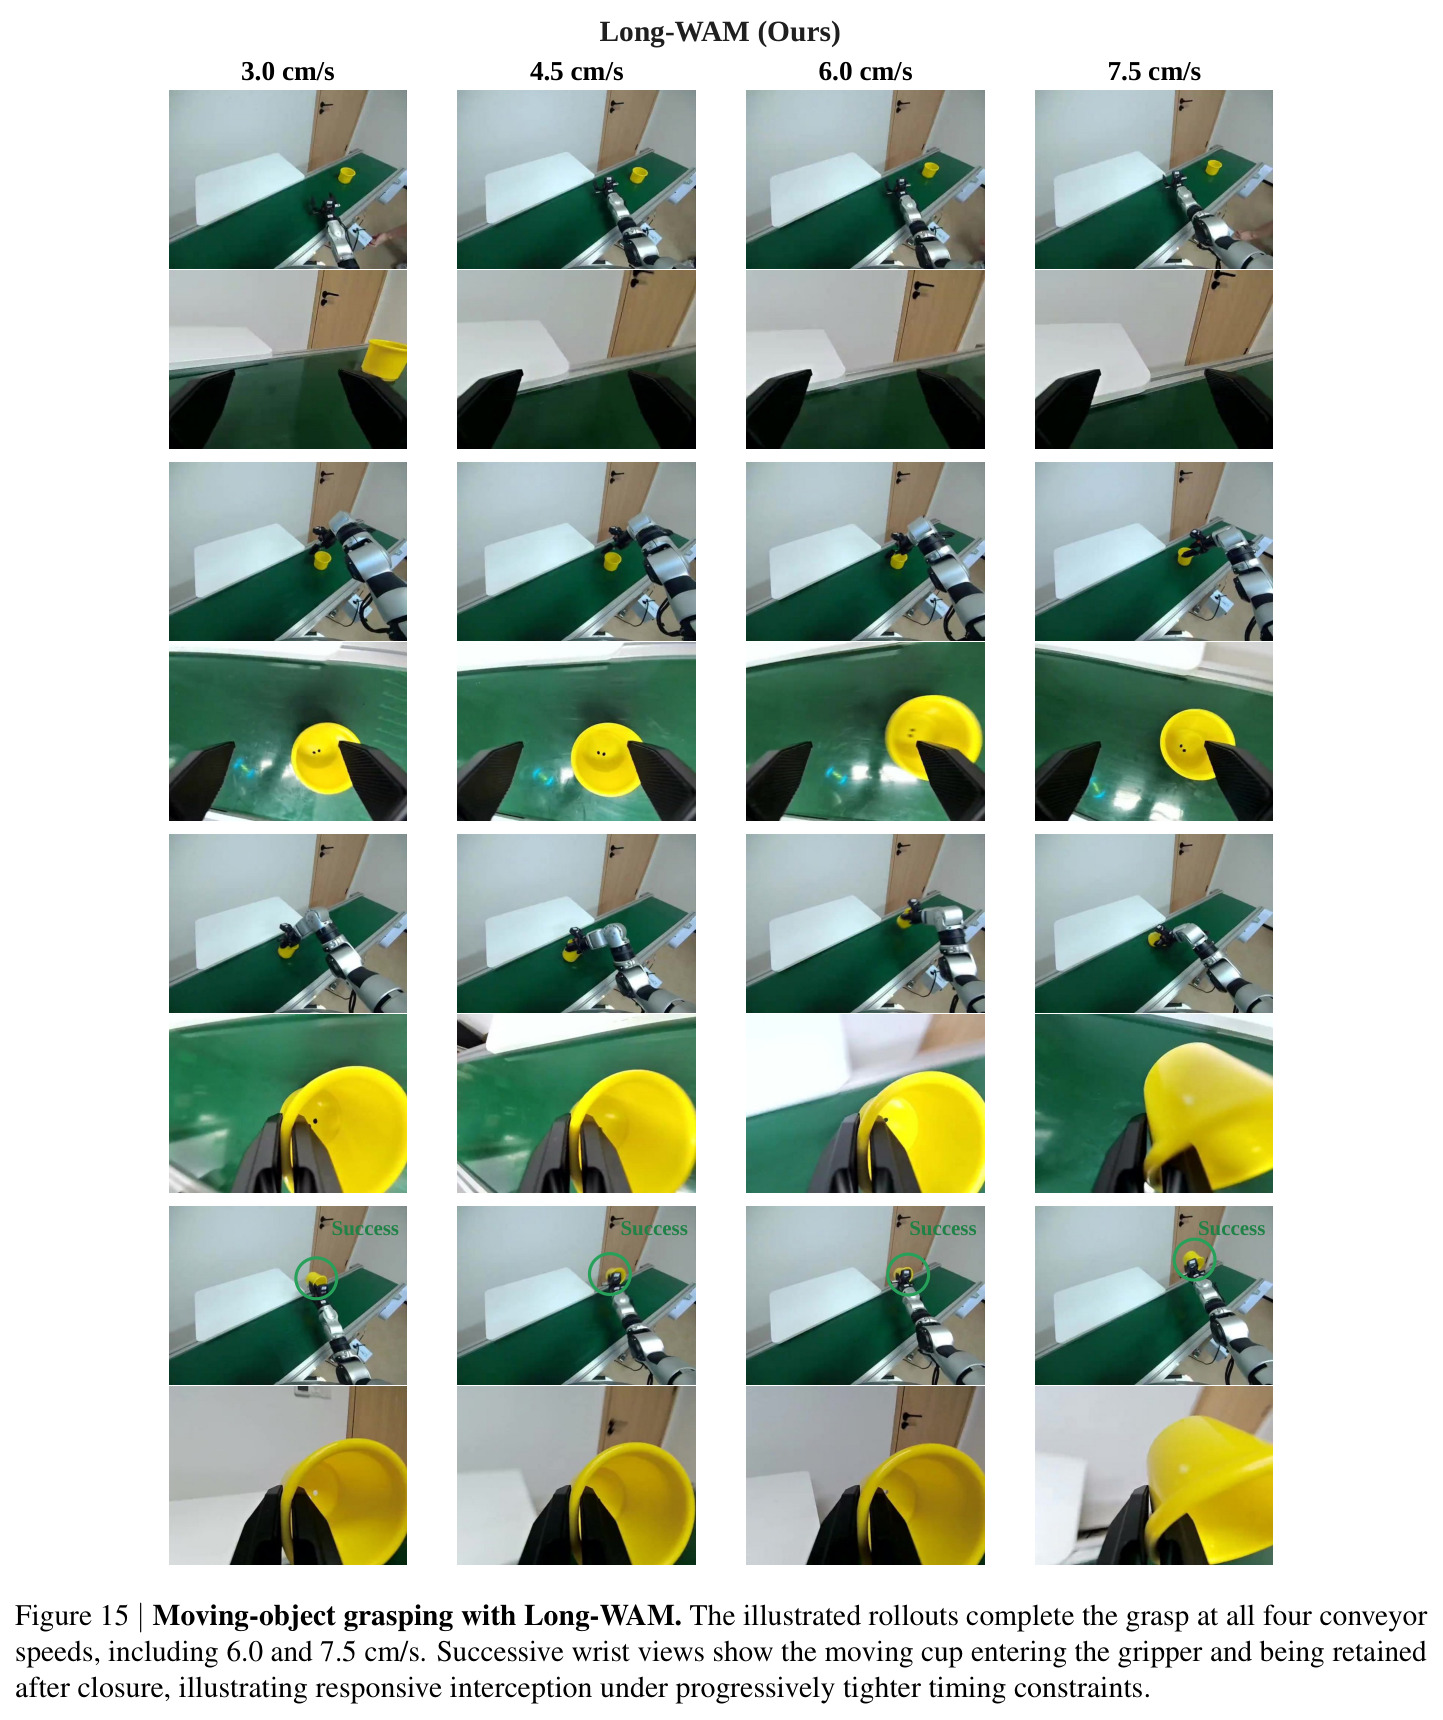
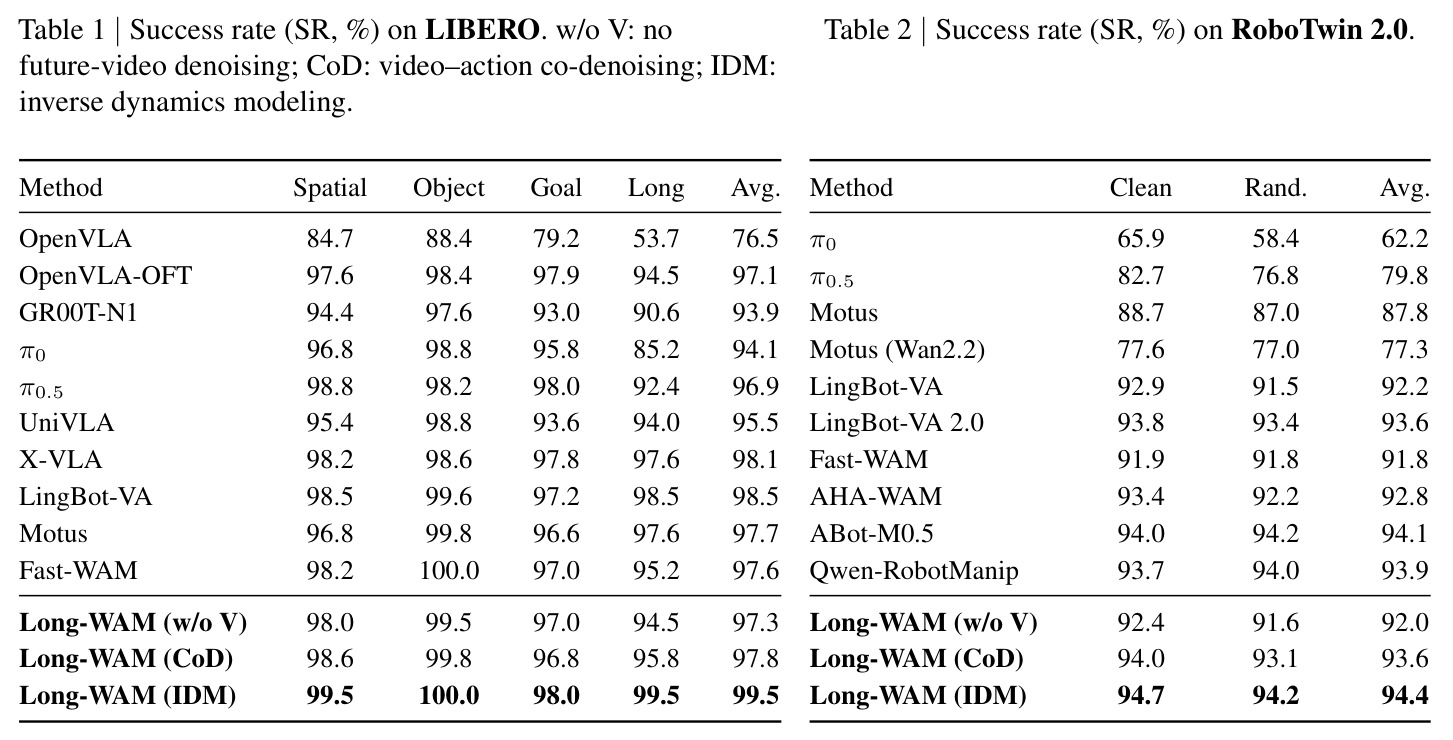
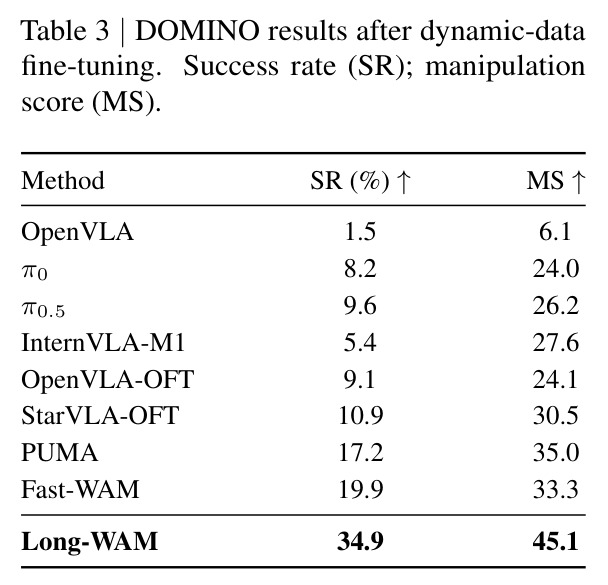
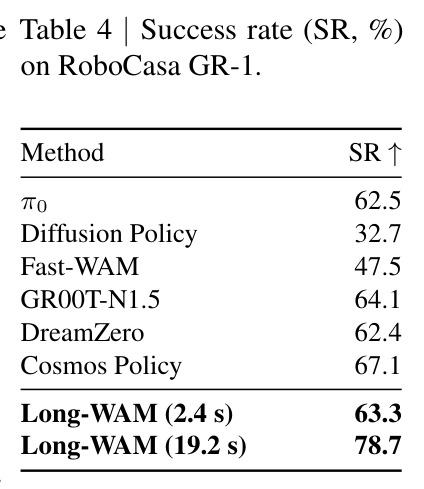
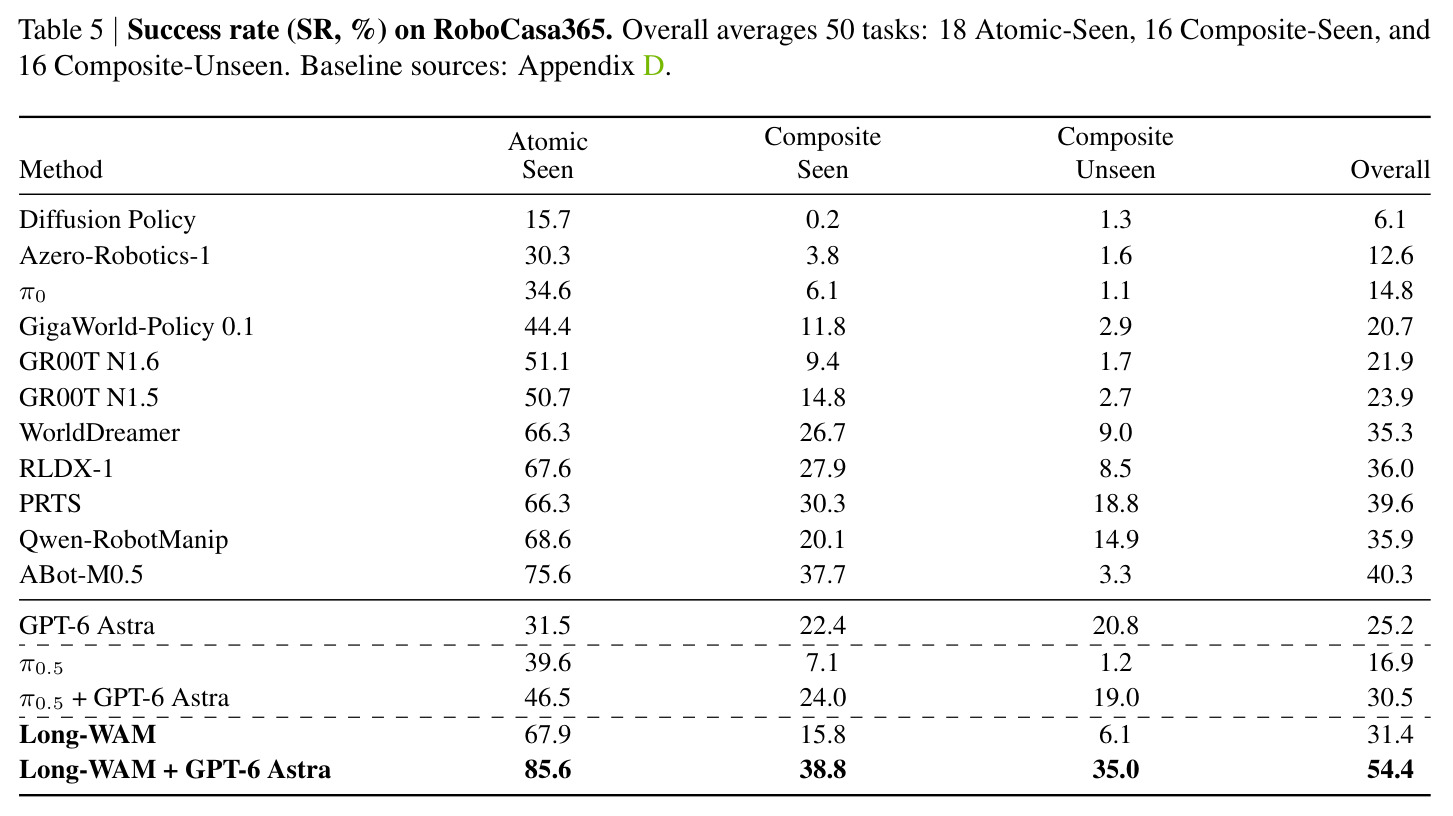
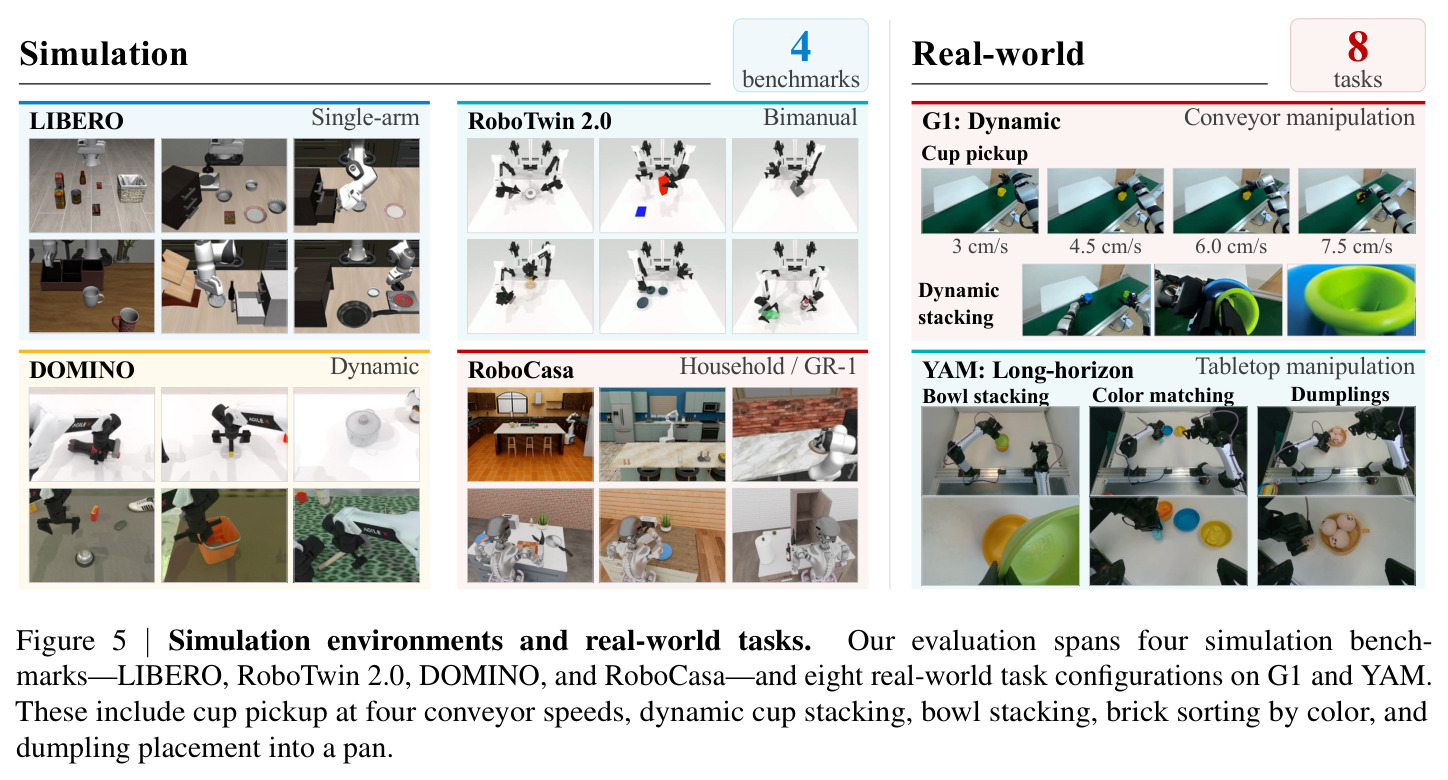
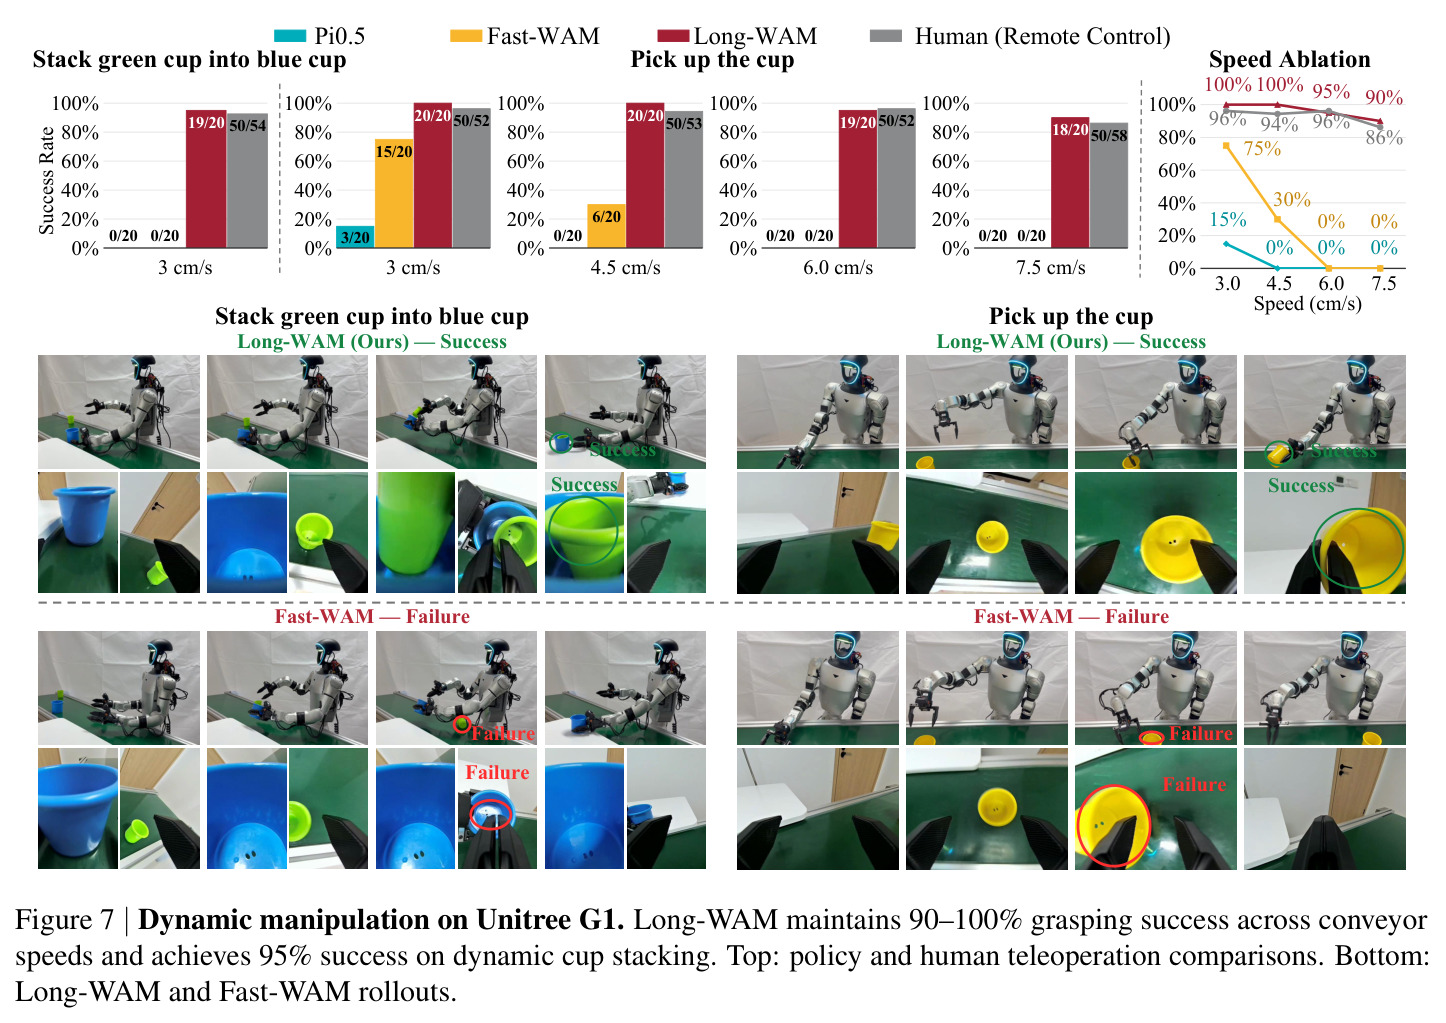
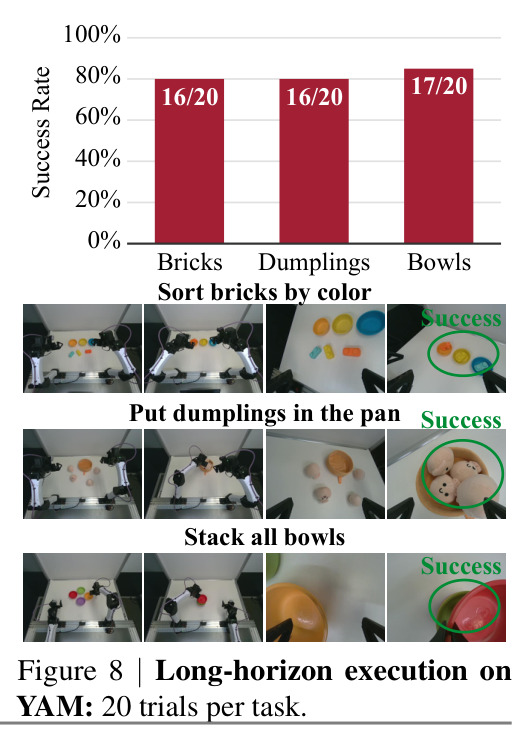
核心发现分三块。其一,上下文即资源但依赖预训练方式:GR-1 上 AR 初始化的 Long-WAM 随历史从 0.0 增至 19.2 秒,成功率从 63.3% 升至 78.7%(+15.4 点),超最强基线 GR00T-N1.5(64.1%)11.6 点;LIBERO-Long 上 2.4 秒历史即从 94.5% 升至 99.5%。双向(Wan2.2)初始化则从 61.7%(2.4s)到 64.1%(9.6s)再回落 61.6%(19.2s),无净增益,AR 领先从 3.3 扩大到 17.1 点;38.4 秒降至 75.2%/74.2%,归因于 80.4% 历史帧为填充。其二,基准全面领先:LIBERO 平均 99.5%(IDM);RoboTwin 2.0 平均 94.4%;DOMINO 达 34.9% SR/45.1 MS(超 Fast-WAM 15.0 SR 点);RoboCasa365 上加 GPT-6 Astra 规划器把总成功率从 31.4% 拉到 54.4%,规划器为 Long-WAM 带 23.0 点、为 π0.5 只带 13.6 点。真机上 G1 在 3.0–7.5 cm/s 传送带抓取保持 100/100/95/90%,动态叠杯 19/20,而 π0.5 与 Fast-WAM 均 0/20;YAM 长程任务平均 81.7%。其三,实时性:RTX 5090 端到端 107.4 ms(较 BF16 eager 356.0 ms 加速 3.3 倍),异步仅损失 0.2 点,而 Fast-WAM 和 LingBot-VA 分别掉 15.4 和 45.5 点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboCasa GR-1(上下文扩展研究) | 成功率 SR (%) | 78.7%(19.2 秒历史);2.4 秒时 63.3% | 同模型 0 历史为 63.3%;最强基线 GR00T-N1.5 为 64.1% | 对自身 +15.4 点;对最强基线 +11.6 点 |
| LIBERO(四套件平均 / LIBERO-Long) | 成功率 SR (%) | 平均 99.5%;Long 99.5%(IDM) | LingBot-VA 98.5/98.5;Fast-WAM 97.6/95.2;π0.5 96.9/92.4 | Long 上超 LingBot-VA 1.0 点、超 Fast-WAM 4.3 点 |
| RoboTwin 2.0 | 成功率 SR (%)(Clean/Randomized 平均) | 94.4(Clean 94.7 / Randomized 94.2) | ABot-M0.5 94.1;LingBot-VA 2.0 93.6;Fast-WAM 91.8;π0.5 79.8 | +0.3 点(对最强 ABot-M0.5),并追平最佳 Randomized 分数 |
| DOMINO(动态数据微调后) | 成功率 SR (%) / 操控分 MS | 34.9 / 45.1 | Fast-WAM 19.9 / 33.3;PUMA 17.2 / 35.0 | SR +15.0 点,MS +10.1 点 |
| RoboCasa365(分层系统) | 总成功率 SR (%)(18 Atomic-Seen + 16 Composite-Seen + 16 Composite-Unseen) | 54.4(Long-WAM + GPT-6 Astra);Unseen 组合 35.0 | Long-WAM 单独 31.4;π0.5+GPT-6 Astra 30.5;GPT-6 Astra 单独 25.2 | 对自身 +23.0 点(π0.5 仅 +13.6 点) |
| Unitree G1 动态传送带抓取(真机) | 成功率 (%)(传送带 3.0→7.5 cm/s) | 100 / 100 / 95 / 90;动态叠杯 19/20(95%) | Fast-WAM 75→0;π0.5 15→0;两者动态叠杯均 0/20 | 最高速段 90% 对 0%,动态叠杯 95% 对 0% |
| RTX 5090 端到端推理(含未来视频预测) | 延迟/动作块与 SR (%) | 107.4 ms、SR 93.5(V4/A4);81.8 ms、SR 92.5(V2/A2) | Fast-WAM 244.1 ms、SR 91.8;LingBot-VA 3618.4 ms;自身 BF16 eager 356.0 ms | 自加速 3.3 倍,比 Fast-WAM 快 2.3 倍且多预测未来视频 |
局限与改进
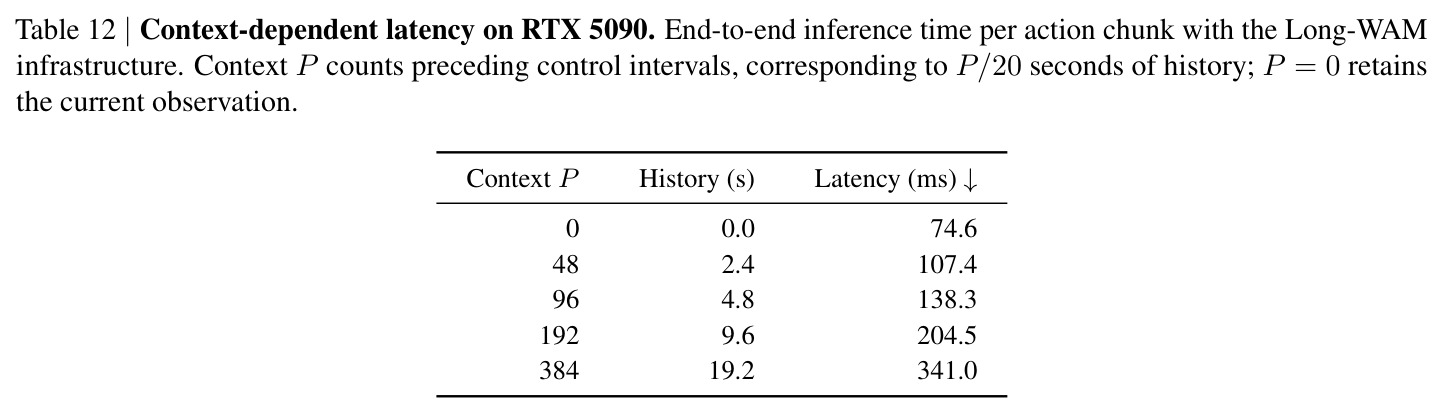
作者承认的局限:一是 38.4 秒长窗口反而掉点(GR-1 上降至 75.2%/74.2%),因为 80.4% 的历史帧是填充、窗口超出 12.1 秒平均轨迹长度 3 倍,说明当前增益受训练数据历史覆盖限制而非架构上限;二是上下文有代价——历史增加 8 倍使 RTX 5090 延迟增加 3.2 倍(107.4→341.0 ms);三是不同任务的最优历史长度不同(LIBERO-Long 在 2.4 秒饱和,GR-1 需要 19.2 秒),每个窗口都要单独训练模型,成本高且无法在线自适应;四是 V2/A2 模式用 1.0 点 SR 换 24% 延迟下降,精度-速度权衡仍存在。我自己的观察:预训练数据 82.7% 来自 RoVid-X,以大规模仿真/合成数据为主,真实长尾场景的泛化有待检验;双向对照仅基于 Wan2.2 一种主干,结论对不同双向基座的普适性未验证;分层实验依赖 GPT-6 Astra 这一特定黑箱规划器,增益可复现性存疑;未来视频潜变量从不解码为像素,模型『想象』的质量与可解释性缺乏直接评估;jerk 与 RMSE 只是平滑性的离散代理指标,真实接触密集任务上的安全性未讨论。
独立分析的弱点
独立分析三个弱点。第一,逐窗口单独训练无法在线调整记忆长度:每个上下文长度(0/2.4/4.8/9.6/19.2/38.4 秒)都是一个单独训练的模型,部署时若任务时间结构变化(如任务阶段突然变长),只能换模型而不能动态伸缩历史。改进方向是引入可压缩/可检索的外部记忆,或训练单一模型支持可变上下文,让『上下文作为资源』在运行时按需分配。第二,长窗口的数据瓶颈:38.4 秒窗口 80.4% 帧为填充,根本原因是约 10000 小时数据中超过 30 秒的连续交互轨迹稀缺,平均轨迹仅 12.1 秒。改进方向是构造专门的长程交互数据(拼接式长任务、时序增广、跨片段记忆桥接),或用记忆机制替代暴力扩展因果前缀。第三,异步稳健性依赖『预测时间连续』这一隐含假设:重叠 RMSE 低至 0.0246 建立在 LongLive2.0-Robot 预测之上,若基础模型预测漂移或语言指令突变,纯异步切换(无混合、无引导、无兜底)可能出现动作跳变,论文未给出失败时的降级策略。改进方向是轻量级一致性约束、重叠区快速检测或在置信度低时回退同步执行。
未来方向
作者方向上,附录 A 提出『代理规划 + 记忆知情执行』的分工框架:RoboCasa365 已验证 GPT-6 Astra + Long-WAM 达 54.4%(规划器单独 25.2%),未来可让规划器与执行器联合训练,把子指令粒度与执行前缀长度选择内生化;38.4 秒的性能下降暗示需要记忆压缩与事件检索(作者也指出与 Echo-Memory、WAM-TTT 等记忆工作互补),把『缓存全部历史』升级为『选择性记忆』。可延伸的方向:(1) 把『AR 预训练决定上下文可扩展性』推广到导航、人形全身控制等场景,检验该范式的一般性;(2) 研究上下文长度与任务时间尺度的匹配理论,自动选择窗口,替代逐长度训练;(3) 未来潜变量止步于 $\sigma^\star=0.9$ 的部分去噪,可解码低分辨率『想象图』用于人机交互解释、异常检测或规划器可视化反馈;(4) 部署栈若开源可推广为视频-动作模型通用边缘推理框架,扩展到 Jetson Orin 等廉价硬件;(5) 检验更长的连续交互数据能否把 GR-1 的 19.2 秒峰值继续右移。
复现评估
复现难度较高。论文页面提供 Code 与 Project Page 链接,但正文未明确权重与全部训练数据是否开放。数据由 RoVid-X(82.7%)、EgoDex(9.0%)、AgiBot World(4.8%)、EgoVerse(2.6%)、VITRA(0.8%)组合而成,部分为大规模专有/合成数据。算力门槛:预训练约 30720 GPU 小时(64 张 H100),下游 WAM 训练用 16 张 GB200,超出学术实验室常规配置。相对可行的路径:(1) 跳过预训练,从公开的 LongLive-2.0 检查点直接做因果到因果适配,验证上下文扩展的核心结论;(2) 仿真评估协议清晰——LIBERO/RoboTwin 2.0/DOMINO/RoboCasa 的表格与基线引用完整,主结果用不超过 2.4 秒上下文,单机可跑;真机部分需要 Unitree G1 与 YAM 平台、可调传送带等定制装置,普通团队难以复现。部署细节在正文与 Figure 4 中描述详尽,但完整复现 107.4 ms 延迟需要 NVIDIA 生态的深度调优经验,工程量大。
论文图表