InternW0-Δ:桥接预测动力学与动作、基于2万+小时开放数据的世界动作模型 InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
以20K+小时异构开放数据预训练世界动作模型,让视频预测表示直接转化为机器人动作能力
前置知识
世界动作模型(WAM)
WAM 是一类同时建模“世界如何演化”(视觉动态预测)与“机器人如何行动”(动作生成)的通用操作模型。它通常以视频生成/预测骨干为底座,把指令、多视角观测与本体感知映射为动作块输出,代表工作包括 DreamZero、Motus、Fast-WAM 等。与 VLA 的本质区别在于是否显式引入视频动态这一先验。
本文 InternW0-Δ 就是一个 WAM,理解它与 VLA 的差别(是否显式建模视觉动态、是否需要生成未来视频)是理解全文动机、架构与实验对比的基础。
流匹配(Flow Matching)
一种生成式训练范式:把干净目标 $y$ 与高斯噪声 $\epsilon$ 按插值 $y_\sigma=(1-\sigma)y+\sigma\epsilon$ 构成连续概率流,训练网络预测速度场 $\epsilon-y$,损失为 $\mathcal{L}_{FM}=\mathbb{E}\|f_\theta(y_\sigma,\sigma)-(\epsilon-y)\|_2^2$,推理时从噪声出发积分若干步得到样本。
本文的视频生成与动作生成共用同一流匹配目标:动作专家就是从高斯噪声出发,经 $N$ 步流积分去噪出 $32\times80$ 的动作块,这是理解训练目标与推理流程的前提。
Mixture-of-Transformers(MoT)
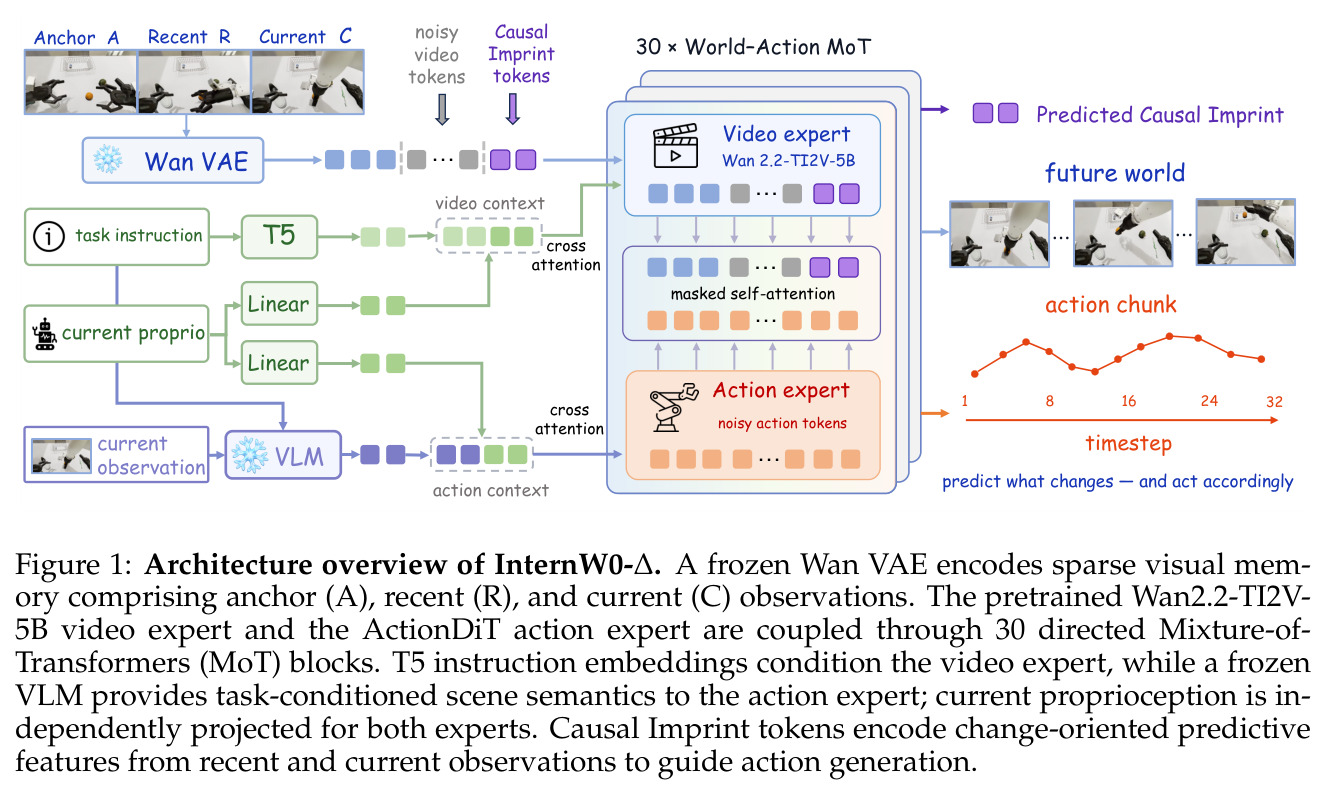
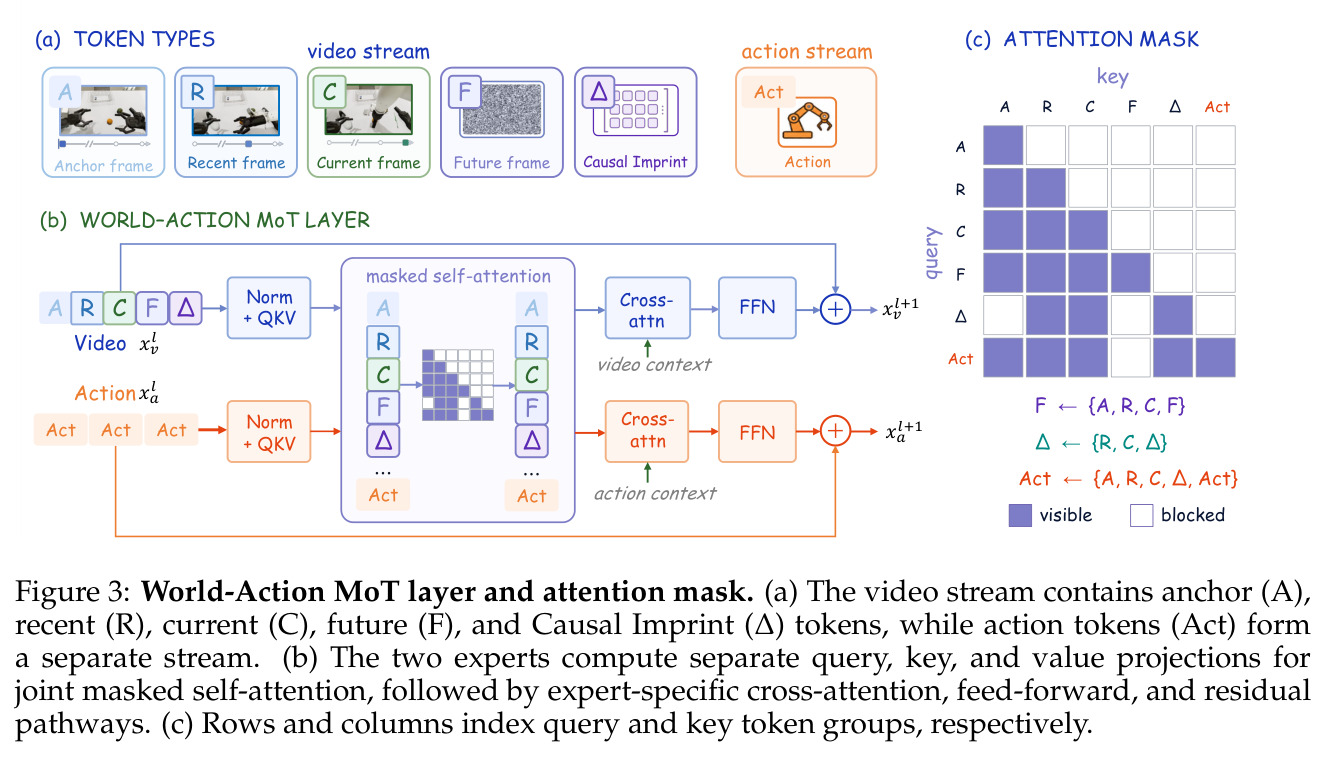
多模态混合 Transformer:不同模态(视频、动作)保留各自独立的 QKV 与 FFN 参数,但在每一层把两路 QKV 拼接后做一次联合注意力以交换信息,再把结果路由回各自数据流,兼顾模态专用容量与跨模态交互。
InternW0-Δ 的核心骨干就是 30 层 World-Action MoT,视频专家与动作专家借此耦合,再配合有向注意力掩码实现“未来只进训练监督、不进推理路径”的关键设计。
视频 VAE 潜空间(Wan VAE)
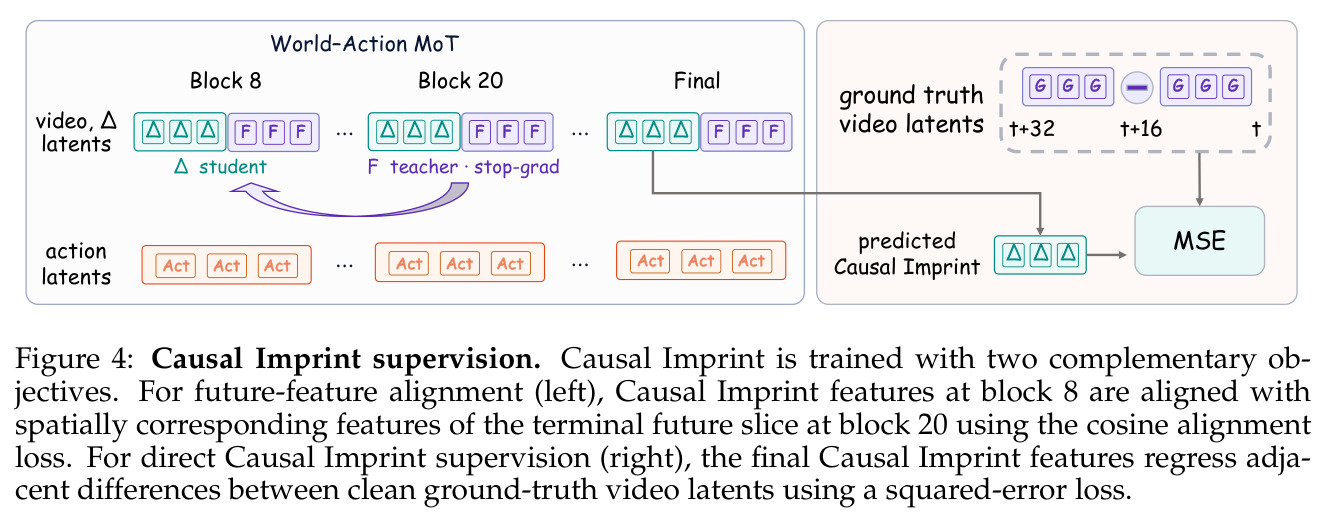
视频生成模型先将像素压缩到时空潜空间再建模。Wan2.2-TI2V-5B 自带的 Wan VAE 把多视角拼接画面编码为潜张量 $z_\tau=E_{VAE}(x_\tau)$;潜空间中相邻帧差 $\Delta z_{t,i}=z_{t+i\rho_v}-z_{t+(i-1)\rho_v}$ 可以作为“场景变化”的紧凑描述。
Causal Imprint 的直接监督目标正是在干净视频潜空间上定义的相邻差分,理解潜空间表示是理解其损失构造与信息流向的关键。
RTC 与动作分块执行
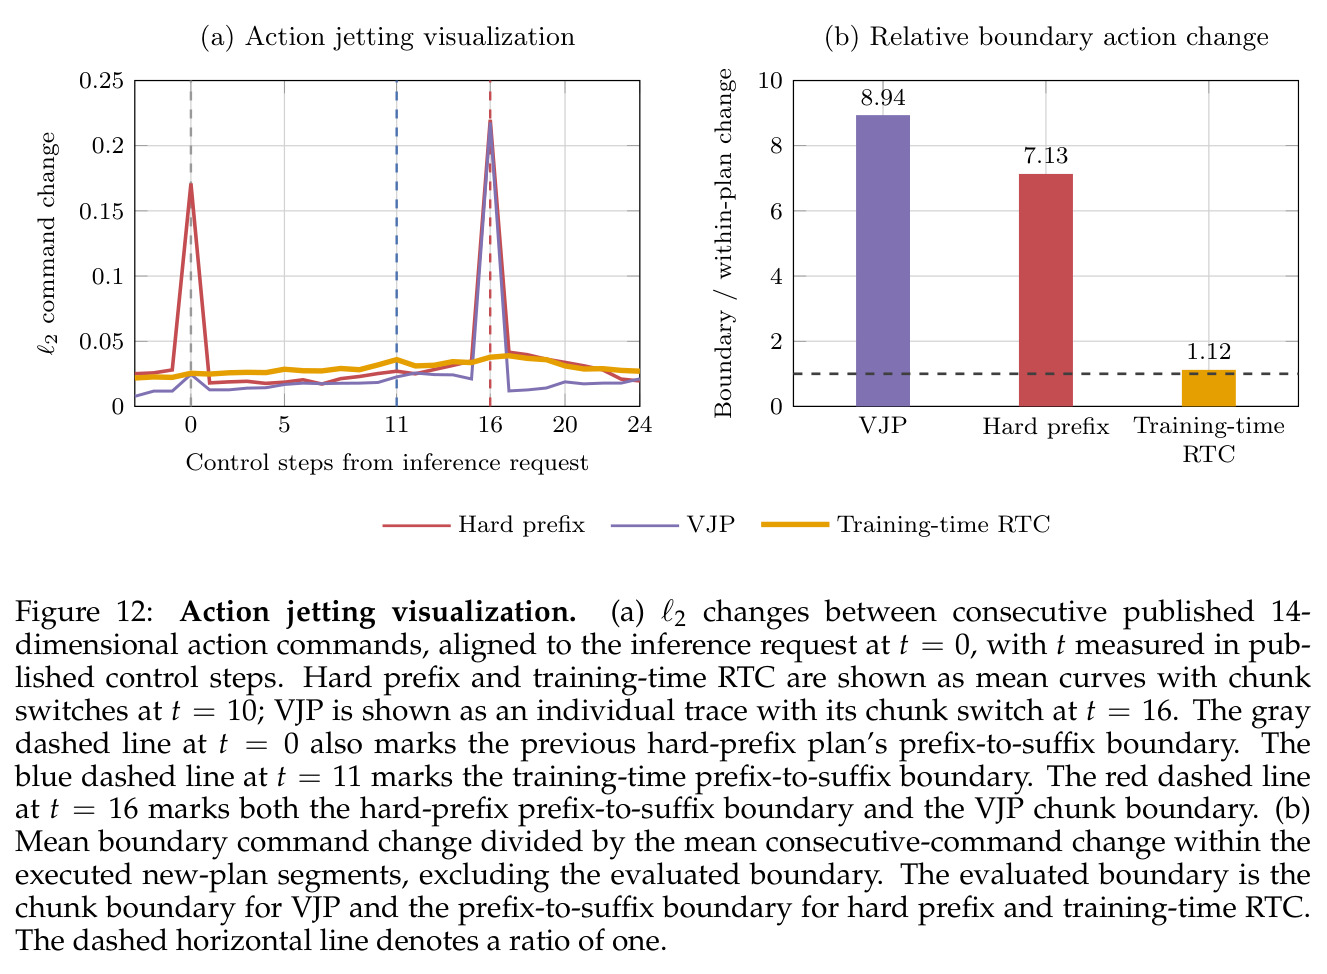
机器人以固定频率执行动作块,但策略推理存在延迟,新块与已提交动作可能在块边界发生跳变(action jetting)。RTC(Real-Time Chunking)类方法在训练时随机掩盖前若干步、推理时把已提交动作作为干净前缀注入并全程钳位,使新动作块与执行中动作无缝衔接。
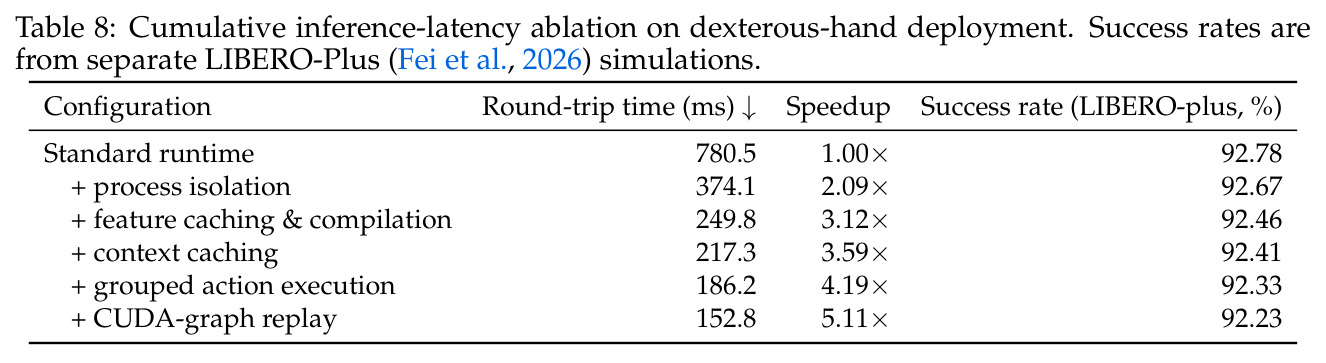
本文真机部署依赖训练时 RTC 前缀条件;Figure 12 的动作抖动对比与 Table 8 的延迟消融都围绕这一机制展开。
UMI 与 Ego2Robot 数据
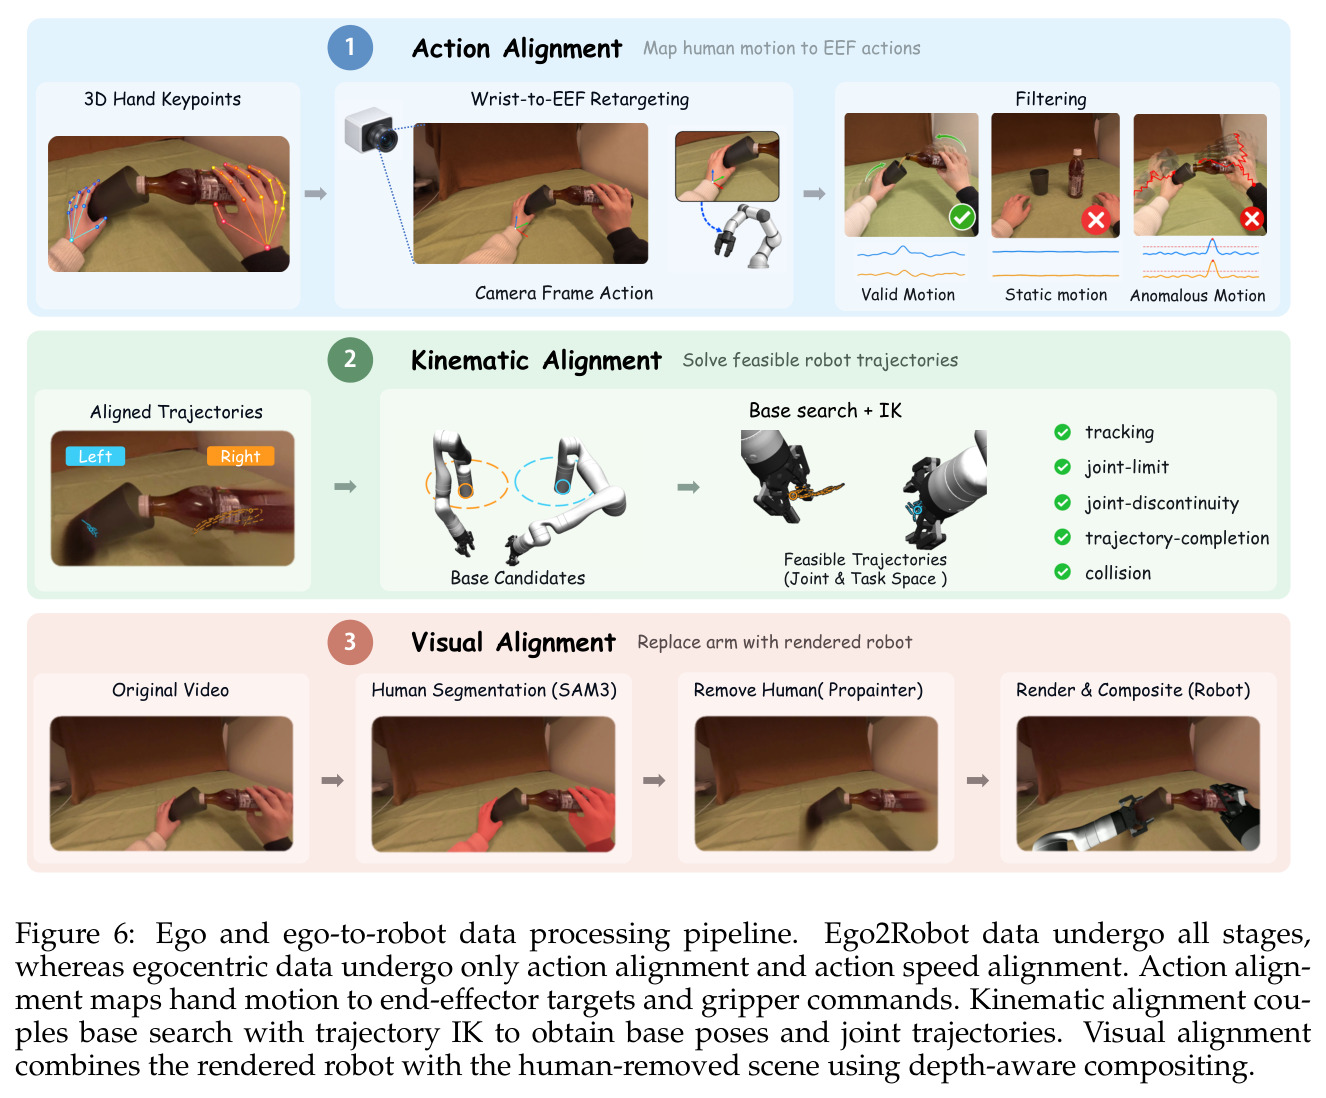
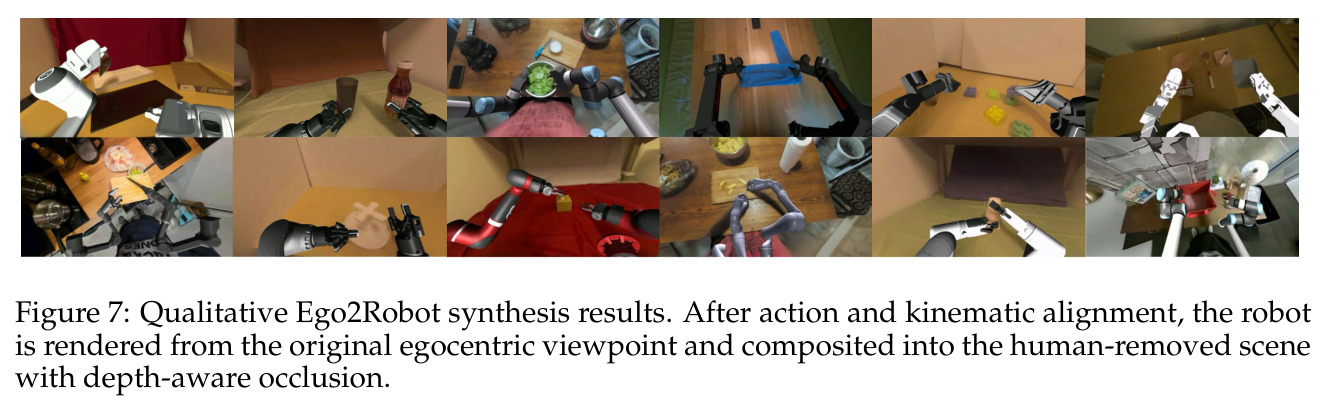
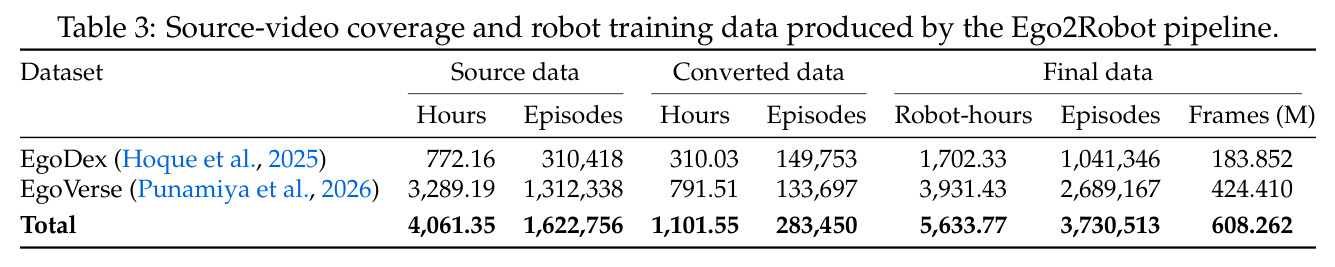
UMI(Universal Manipulation Interface)用手持夹爪采集数据,无需真机在场即可获得与机器人接口兼容的操作数据;Ego2Robot 则把人类第一视角视频经手腕重定向、逆运动学与视频合成(分割去人、渲染机器人并深度感知合成)转换为“看起来像机器人演示”的训练数据。
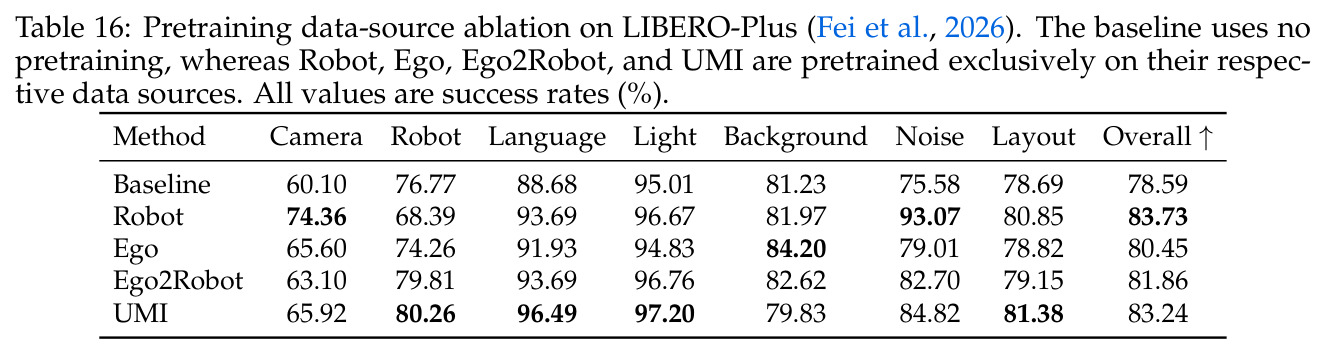
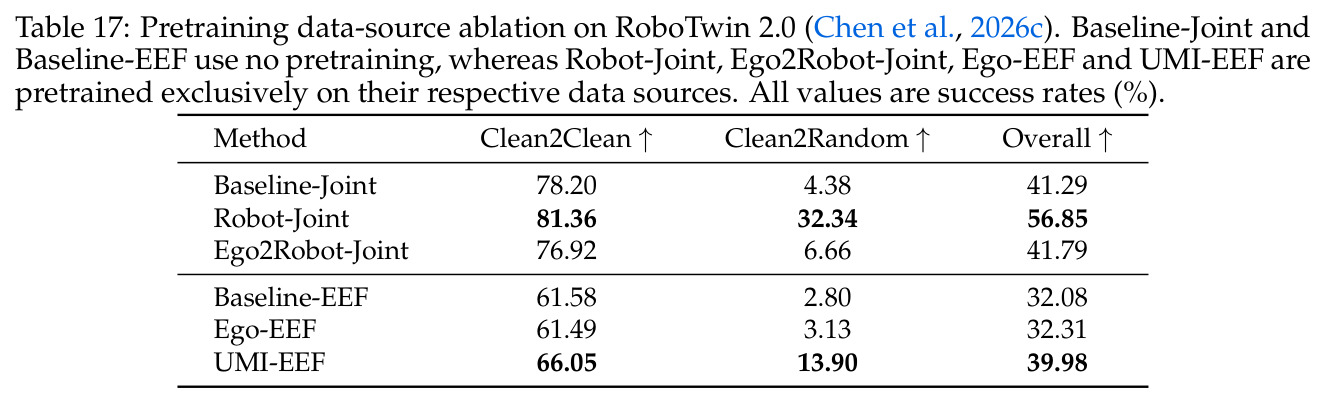
这是 20K+ 小时语料的关键扩容手段,也是本文数据消融(Table 16/17)的核心研究对象,直接关系到“人类数据何时对机器人学习有用”这一结论。
4D 感知蒸馏(Track4World)
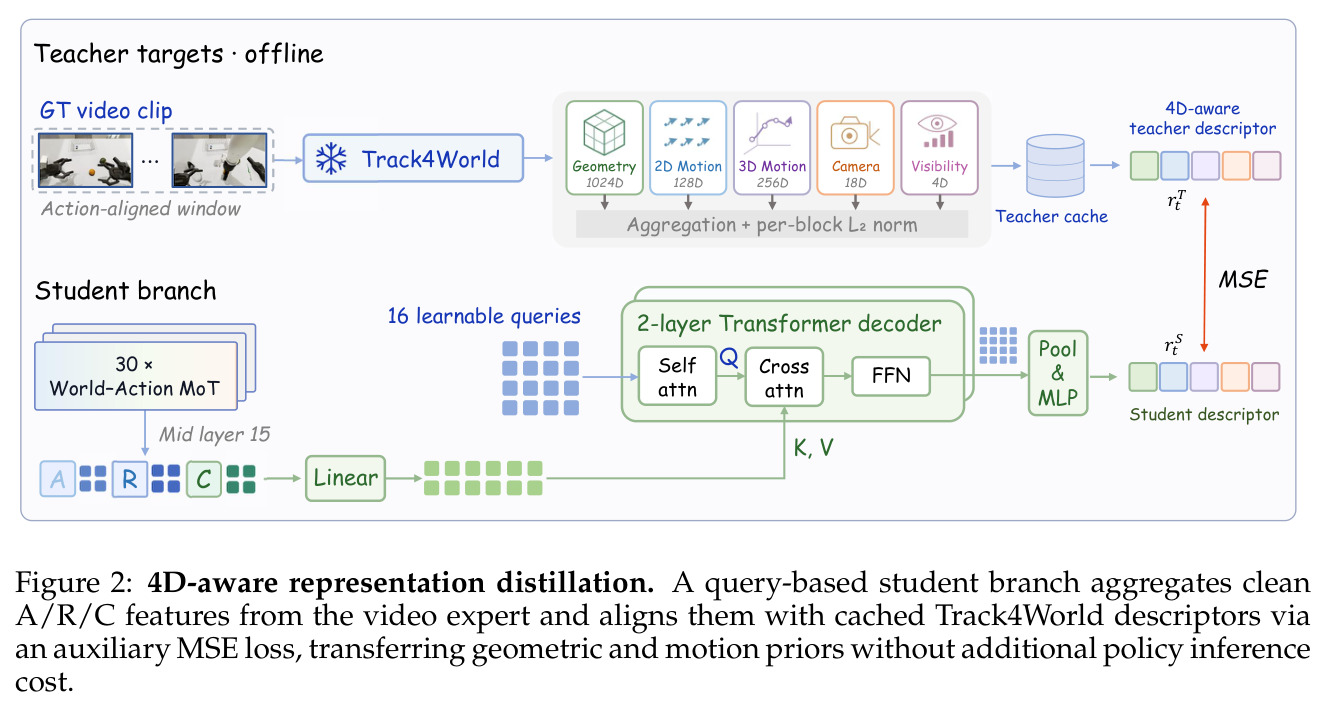
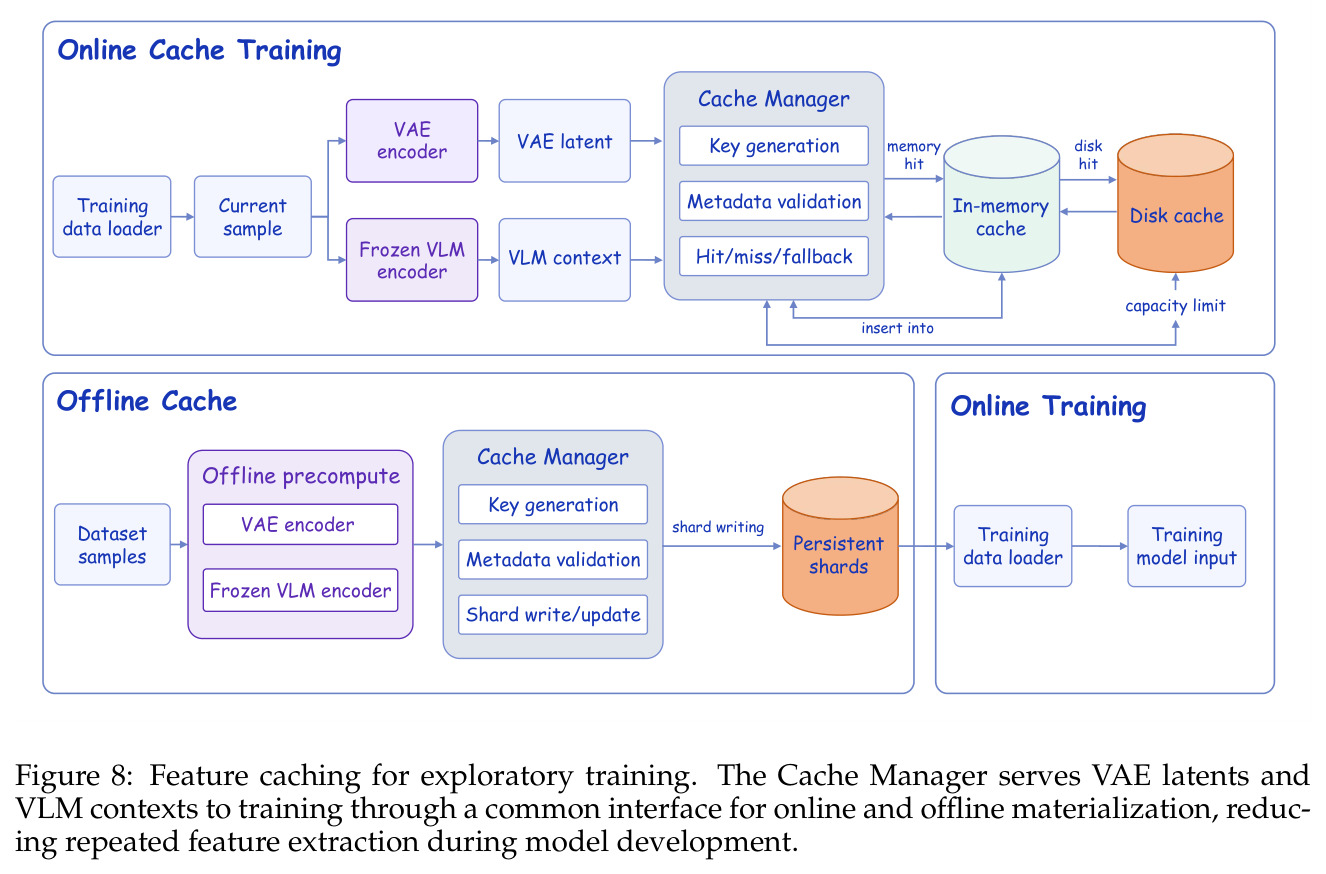
Track4World 是一个 4D 点轨迹基础模型,可输出几何、2D/3D 运动、相机运动与可见性信息。知识蒸馏让小模型(学生)模仿大模型(教师)的输出特征而非直接完成任务;教师描述符可离线缓存,推理时完全丢弃学生分支,实现零额外推理成本。
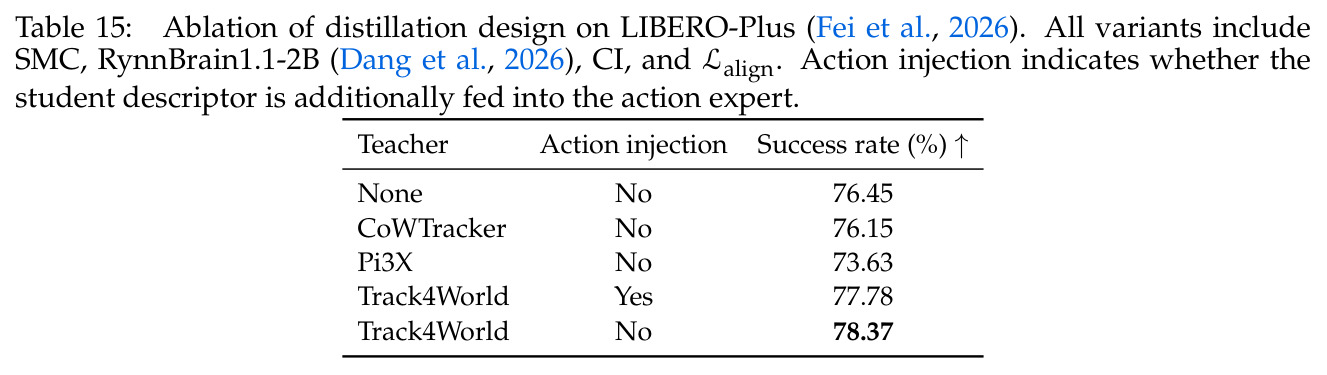
本文用 Track4World 作为训练时教师,把几何与运动先验注入视频专家,这是其三大表示学习机制之一,也是教师选型消融(Table 15)的对象。
研究动机
通用机器人操作正从 VLA 走向 WAM,但两条路线各有短板。VLA(如 RT-2、OpenVLA、π0)能继承视觉-语言模型的语义知识,却缺乏对“场景如何随时间演化”的预测能力;WAM 尝试用大规模视频预训练补上这块,但作者指出核心矛盾:能预测未来观测并不等于会控制机器人——动作生成还需要识别任务相关变化、理解物体几何与运动,并把这些线索对齐到当前指令与场景。更实际的问题是推理成本:不少 WAM 在在线控制时需要采样未来视频再从中提取信息,视频扩散的多步去噪与 VAE 解码使延迟难以满足实时控制。此外,机器人操作数据高度异构:不同数据集的本体、控制空间(关节/EEF)、相机配置与时间约定互不兼容,直接混合训练会给同一动作维度赋予不一致的物理含义,这限制了可用的预训练语料规模与多样性。
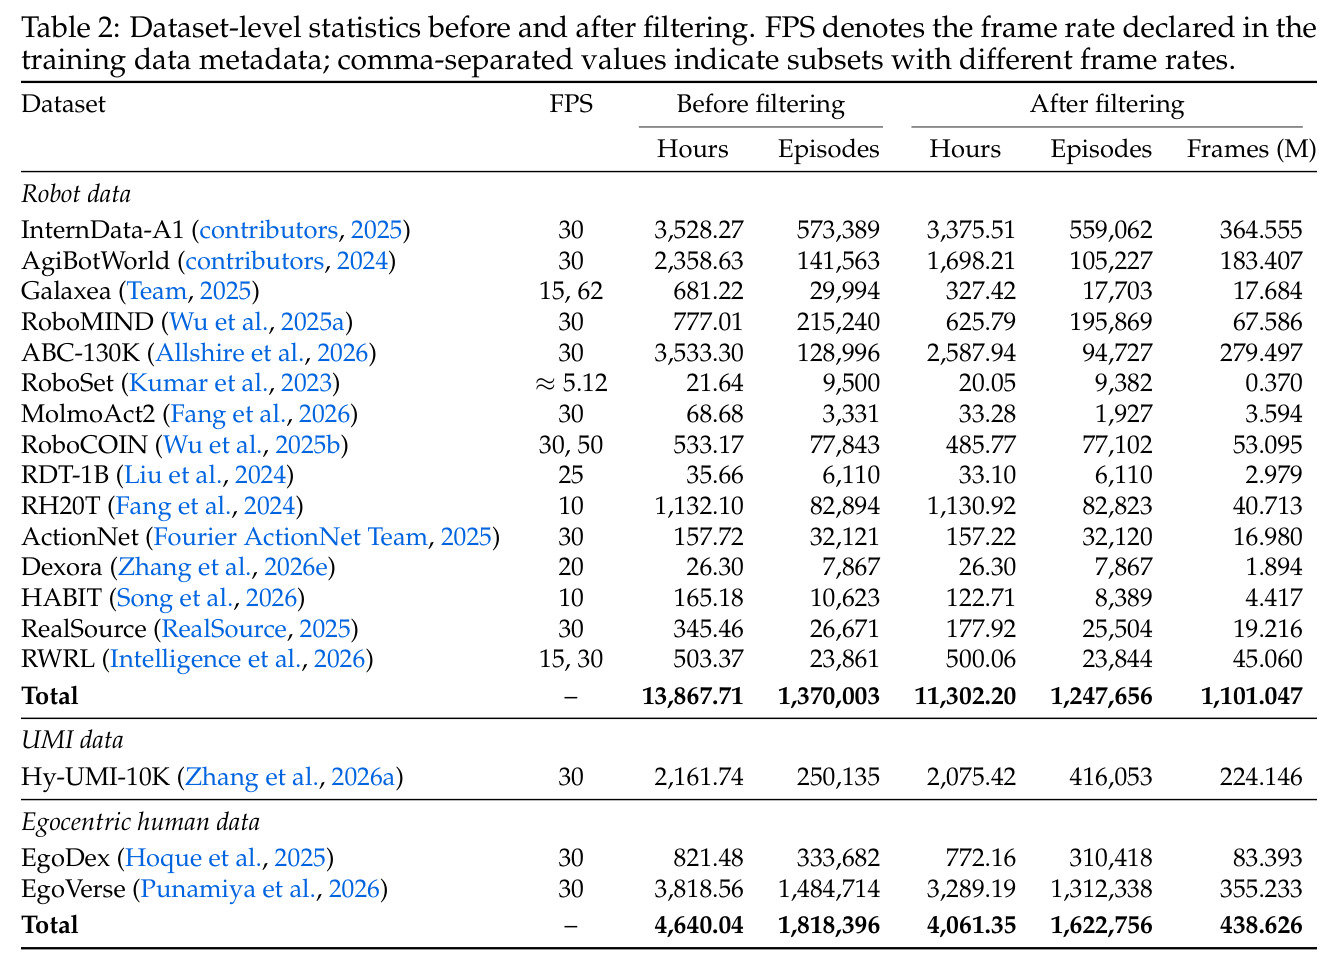
本文的目标是本文目标是构建统一的世界动作模型 InternW0-Δ,把四类互补先验——预训练视觉动态(Wan2.2-TI2V-5B 视频专家)、任务条件化场景语义(冻结 VLM)、4D 几何与运动先验(Track4World 教师)与动作生成(ActionDiT)——整合进一个有向 Mixture-of-Transformers 框架,并让“预测”真正可被动作生成利用:通过 Causal Imprint 在训练时用未来监督塑造表示,推理时无需生成未来视频。配套目标包括:把 15 个机器人数据集、UMI、自我中心人类数据(EgoDex/EgoVerse)与 Ego2Robot 转换数据统一到 80 维规范状态-动作表示下,构建约 23,072 小时(2 万+小时)的语料;建立预训练+后训练两阶段配方,使同一预训练检查点能适配夹爪与灵巧手等多种具身;并开源从数据到部署的全栈设施。
与已有工作不同的是,本文的独特切入是“有向信息流”的设计哲学:未来观测只在训练时充当监督信号,绝不通过前向激活路径进入动作推理。具体由三个互相配合的机制实现:Causal Imprint 令牌只能看见锚点/近期/当前观测,却被未来潜空间差分与中间层特征对齐双重监督,从而“携带”关于未来的预测信息供动作专家读取;4D 蒸馏只注入视频专家(消融显示注入动作专家反而从 78.37% 降到 77.78%);注意力掩码显式阻断 Δ 与动作令牌对未来帧的访问。相比 DreamZero 的联合视频-动作预测和 Fast-WAM 的“监督与推理分离”,本文进一步给出了“预测表示如何接口到动作专家”的具体机制。数据侧则用 Ego2Robot 管线(SAM3 分割 + ProPainter 修复 + 机器人渲染合成 + 耦合基座搜索 IK)把人类视频规模化转成机器人数据,并用统一 80 维规范动作空间对齐全部异构数据源,是相对同类的差异化贡献。
核心方法
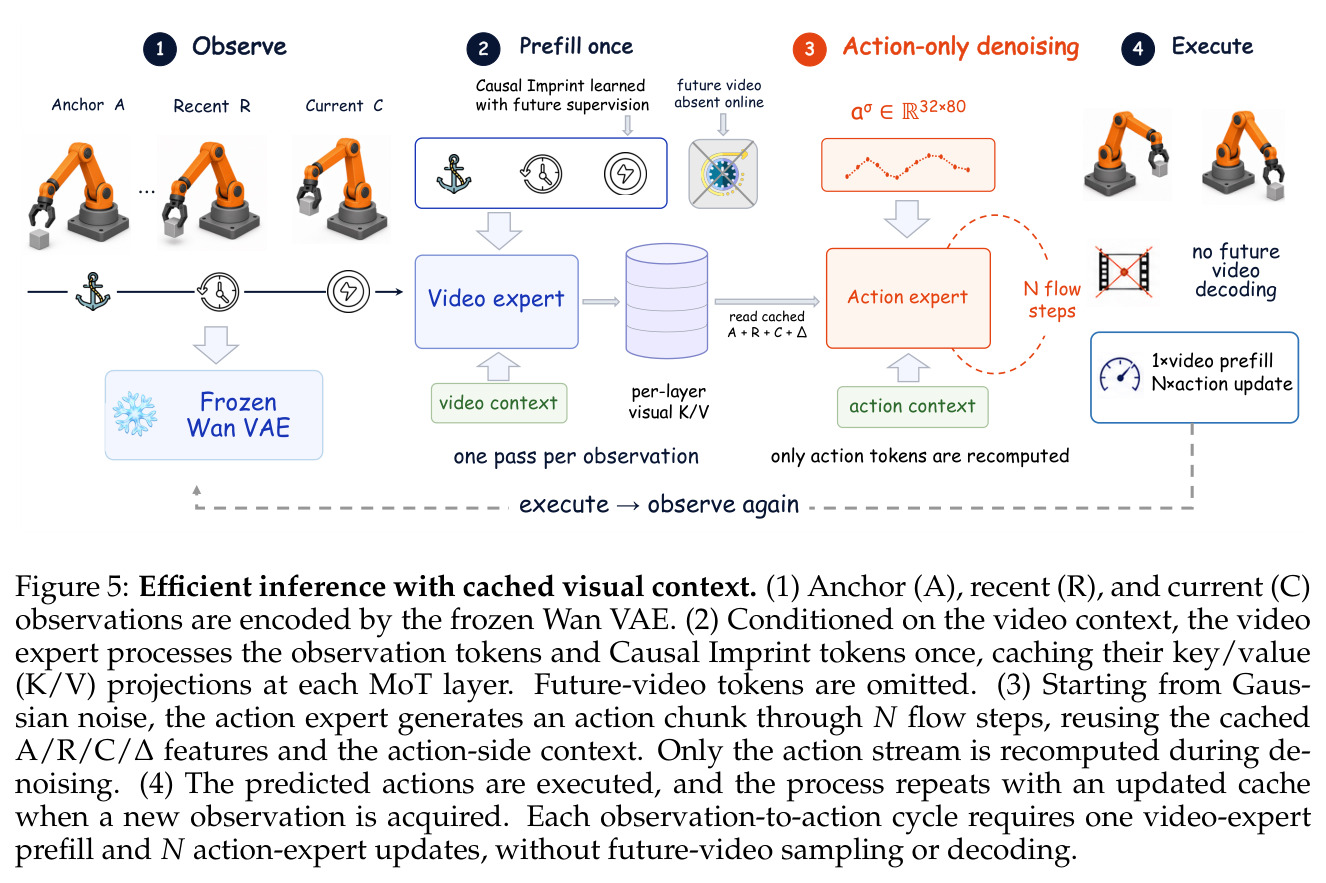
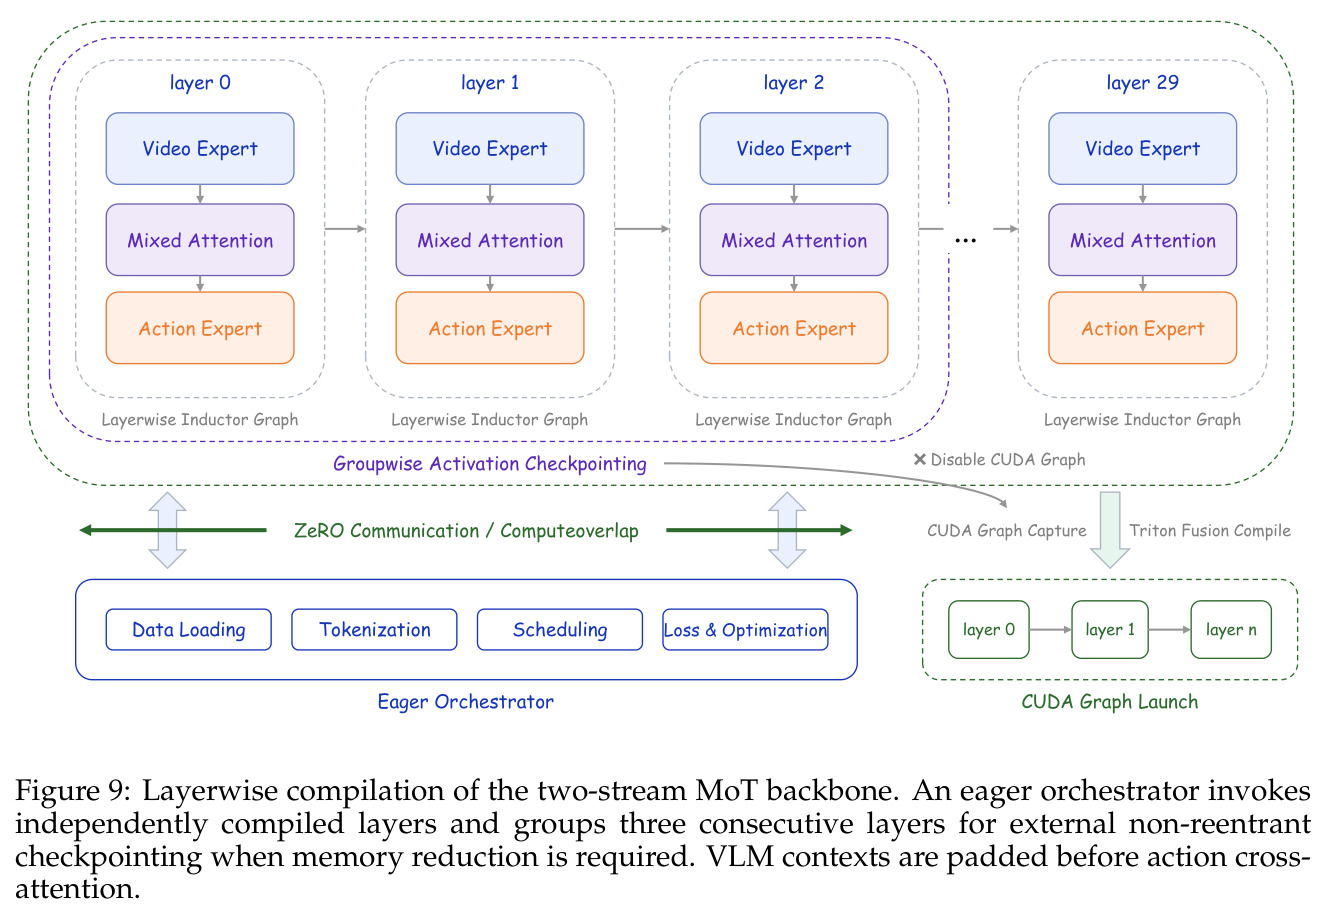
直觉上,InternW0-Δ 想让模型在训练时“偷看未来”,把“接下来场景会怎么变”压缩成可迁移的内部表示,推理时凭这些表示直接产出动作。技术路线分四步。第一步输入编码:多视角观测经拼版算子 $\Pi$ 组成 384×256 画布,冻结 Wan VAE 编码为潜张量;稀疏记忆只取三帧——回合起始锚点 $x_a$、上一动作块前的近期帧与当前帧 $x_t$。第二步双流耦合:30 层 World-Action MoT 中,预训练视频专家(Wan2.2-TI2V-5B)与随机初始化动作专家(ActionDiT)各持独立参数,通过拼接 QKV 的单次联合 masked 自注意力通信后分流;T5 编码指令供视频专家,冻结 VLM RynnBrain1.1-2B 联合当前视图与指令输出场景语义给动作专家,本体状态经两个独立线性层分别注入双流。第三步表示学习:Causal Imprint 令牌接受差分回归与特征对齐双重监督,Track4World 教师经 MSE 蒸馏注入几何运动先验。第四步训练推理:在约 23,072 小时语料上以流匹配联合训练 245K 步,推理时一次视频 prefill 缓存 K/V 后仅对动作流去噪。
核心创新是 Causal Imprint。一组可学习令牌植入视频专家的自注意力层,空间布局对齐当前视频潜张量;它们聚合近期与当前观测特征,捕捉对动作生成有用的运动、交互与状态转移信息。训练时给它两个互补监督:一是直接回归干净视频潜空间的相邻差分 $\Delta z_{t,i}=z_{t+i\rho_v}-z_{t+(i-1)\rho_v}$,即 $\mathcal{L}_\Delta=\|h^\Delta_t-\Delta Z_t\|_2^2$;二是把第 8 块的 Imprint 特征与终端未来切片在第 20 块的空间对应特征做带 stop-gradient 的余弦对齐 $\mathcal{L}_{align}$。与已有方法的本质区别在接口设计:未来帧 F 在注意力掩码下对 Imprint 与动作令牌不可见,未来信息只以“梯度”而非“输入”的形式影响动作路径,预训练的预测知识由此成为动作专家可直接读取的表征,推理既不采样未来视频也不跑蒸馏分支;消融显示两个目标叠加把 LIBERO-Plus 成功率从 69.08% 推到 76.45%(+7.37 点),其中特征对齐贡献 5.65 点。
方法步骤详情
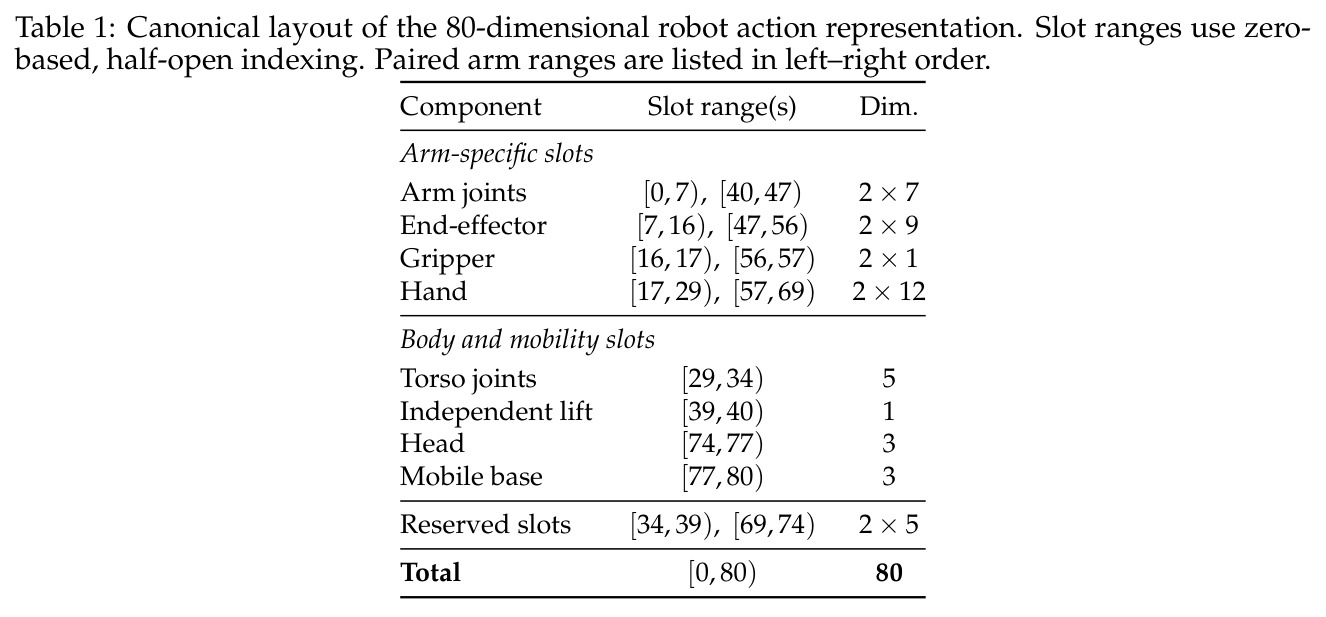
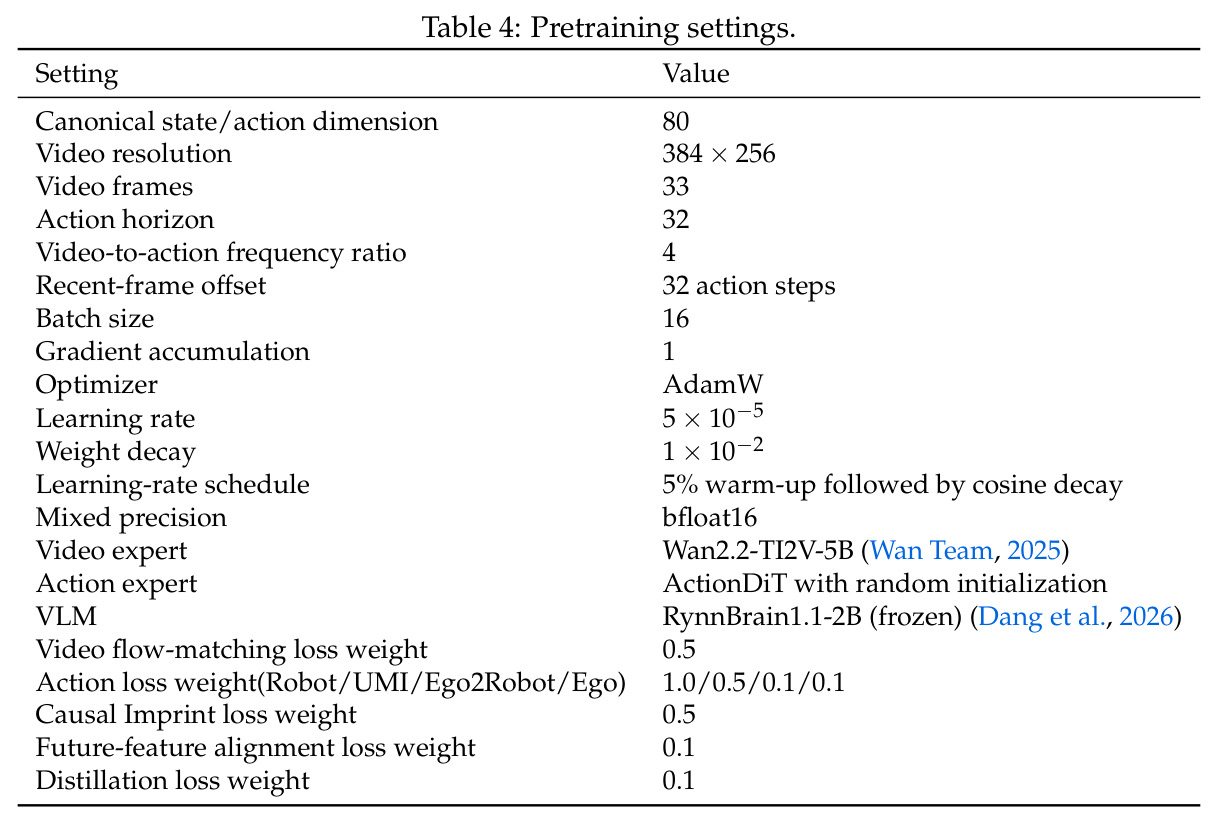
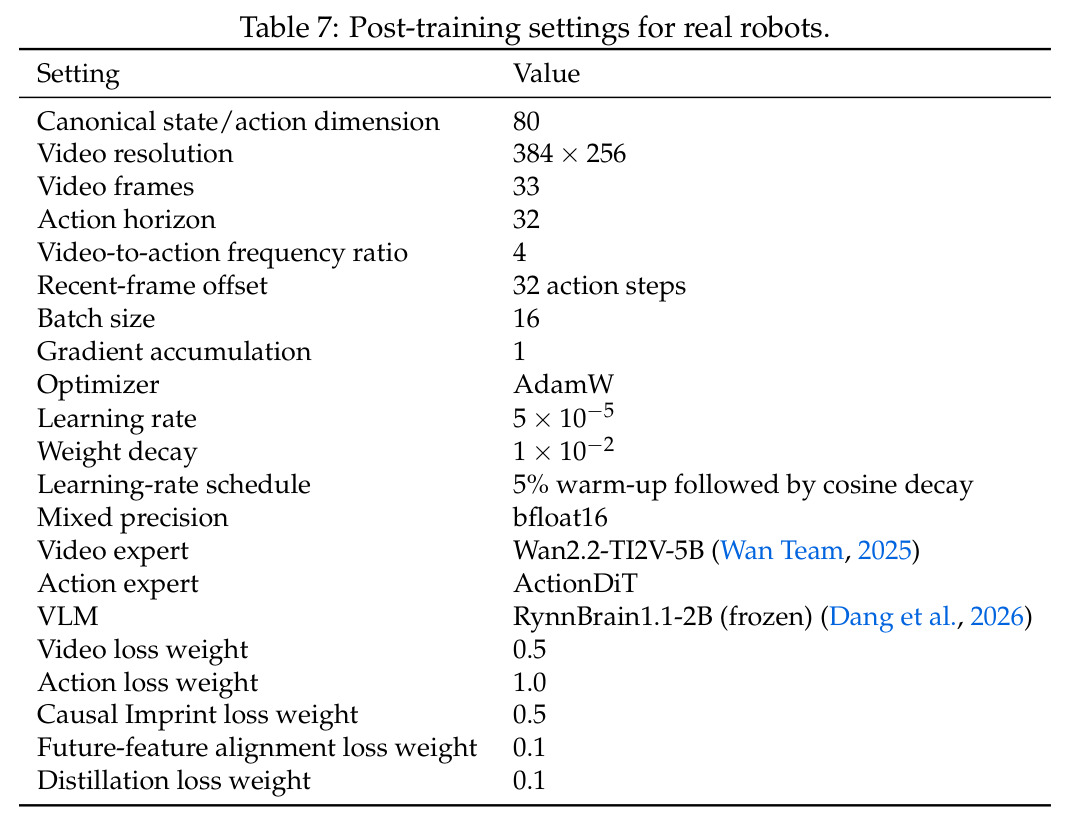
(1)编码:多视角观测(缺失视图用掩码标注)拼成 384×256 画布,由冻结 Wan VAE 编码;80 维本体状态经两个线性层分别投影进视频/动作专家嵌入空间。(2)语义条件:T5 编码指令供视频专家;VLM 联合当前视图与指令输出场景语义供动作专家,两者各拼上本体嵌入形成 $C_t^{v}$ 与 $C_t^{a}$。(3)MoT 前向:30 个耦合块双流独立算 QKV、拼接做一次掩码联合注意力后回流;掩码规定未来帧 F 可见 A/R/C,而 Δ 与 Act 不可见 F;末层动作特征映射为 80 维流速度。(4)训练:流匹配损失(视频+动作)加 $\mathcal{L}_\Delta$、$\mathcal{L}_{align}$、$\mathcal{L}_{4D}$,权重 0.5、1.0(Robot)/0.5(UMI)/0.1(其余)、0.5、0.1、0.1,共 245K 步(末 10K 步加蒸馏)。(5)推理:一次视频 prefill 缓存各层 K/V,$N$ 步仅动作流去噪得 32×80 动作块,RTC 前缀保持干净并钳位,每 16 步重规划。(6)数据侧:全部数据先转成 Table 1 的 80 维规范布局,再经信号一致性(阈值 0.65)、边界裁剪、视觉质量、动作幅度守卫(EEF 单步 >0.2 m / 0.5 rad)、LLM/VLM 一致性过滤与人工抽检。
技术新颖性
技术新颖性可从四点评估。架构上,有向 MoT + 注意力掩码把“未来监督”与“动作推理”在计算图层面分离,比 Fast-WAM 的目标分离更结构化,Causal Imprint 作为可学习的“预测接口”是全新设计。监督设计上,潜空间差分回归与中间层特征对齐互补——前者只给低层变化信号(+1.72 点),后者把视频 DiT 中间层的语义/时序表征迁移给 Imprint(+5.65 点),证明视频生成模型的中间特征本身就是可利用的知识源。蒸馏设计上,Track4World 教师描述符(几何 1024 维 + 2D/3D 运动 384 维 + 相机 18 维 + 可见性 4 维,各自 $\ell_2$ 归一化拼接成 1430 维)离线缓存;学生仅从第 15 个 VideoDiT 块取 token、用 16 个查询的两层解码器聚合,推理零开销;教师选型消融(CoWTracker 76.15%、Pi3X 73.63%)提供可复用经验。数据与系统上,80 维规范动作空间、Ego2Robot 三段式转换管线(动作/运动学/视觉对齐)与 5.11× 推理加速部署栈,共同构成超出单点模型创新的完整复现配方。
实验结果
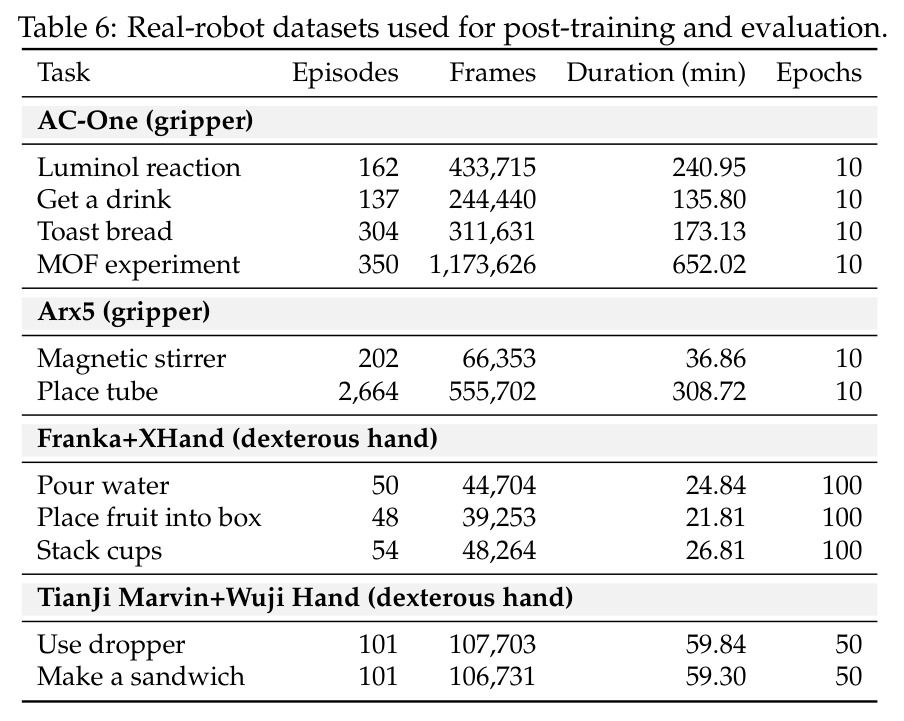
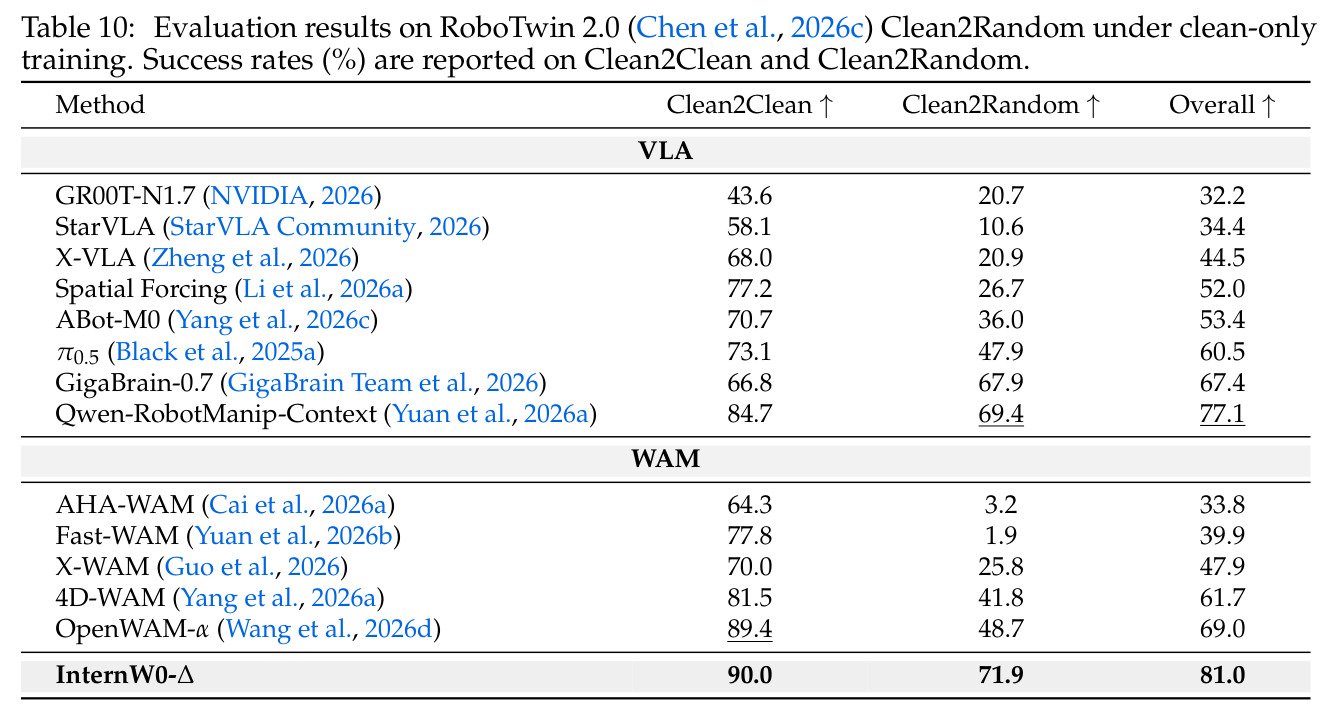
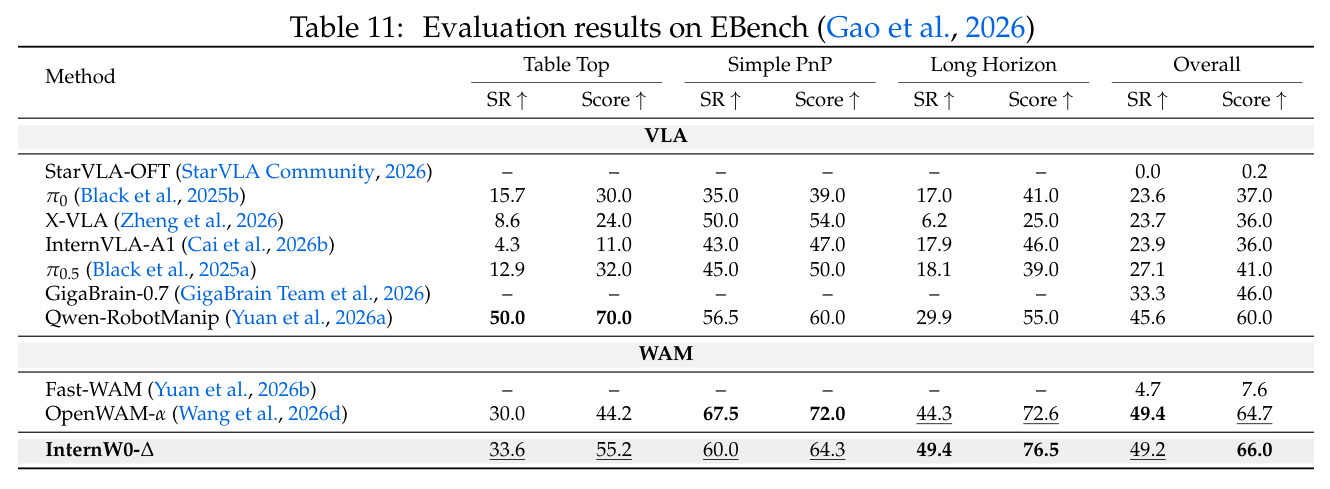
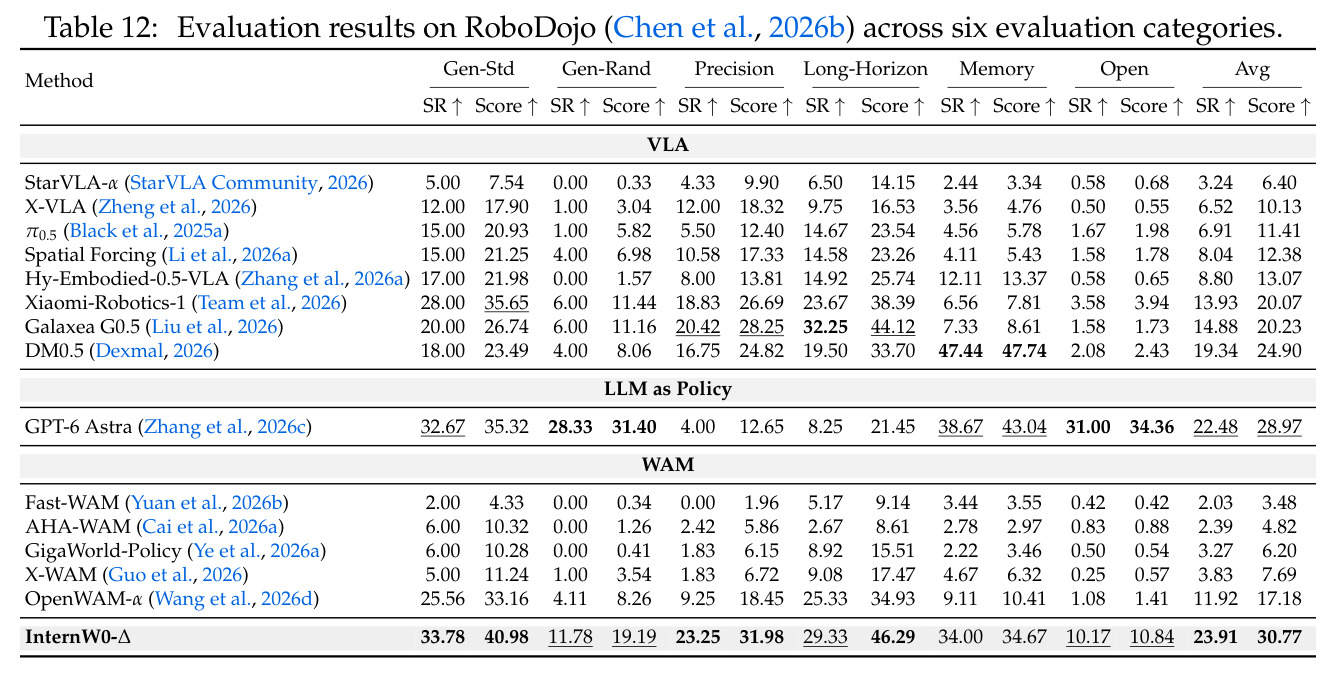
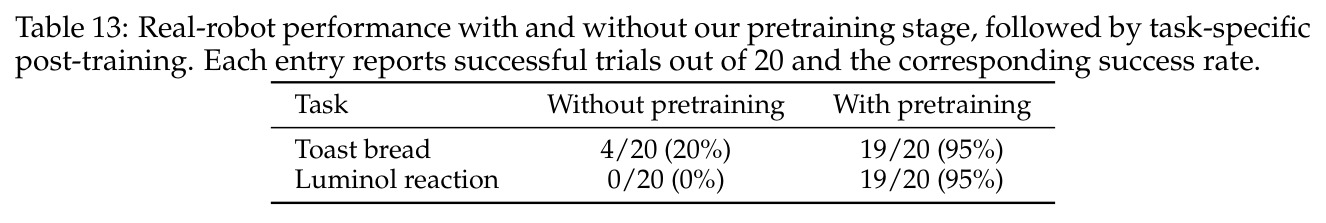
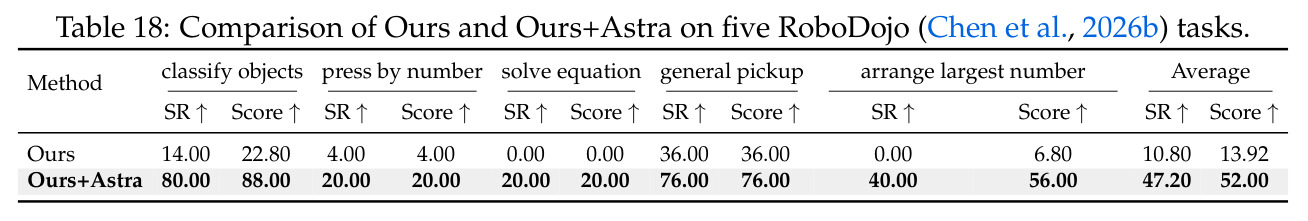
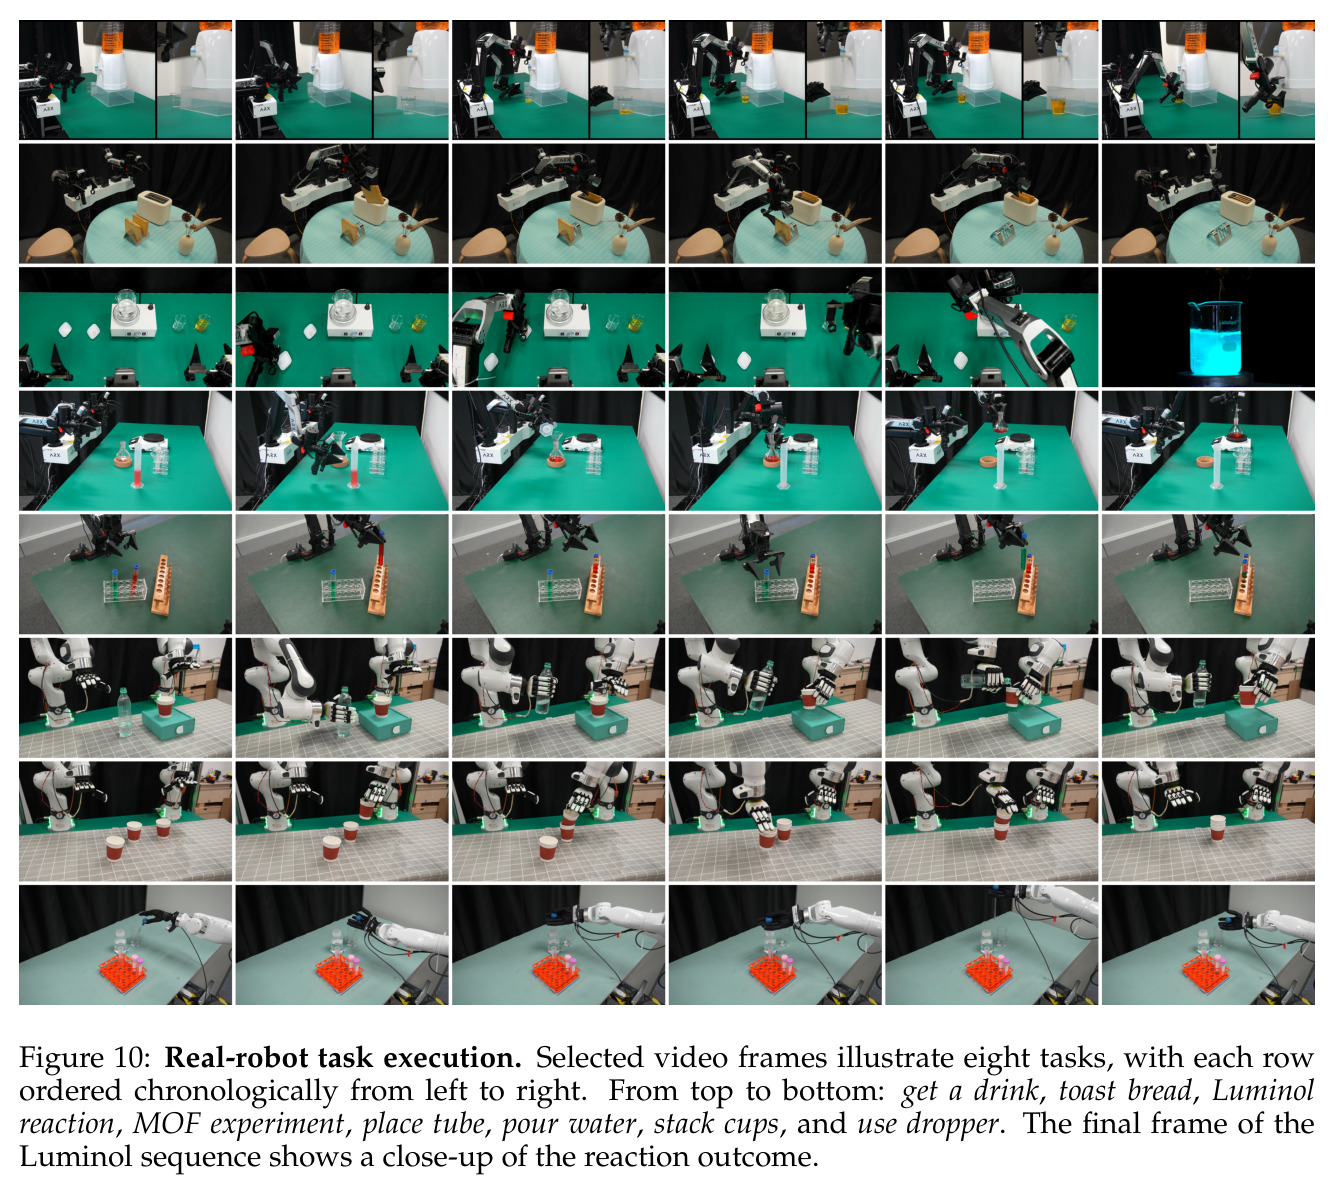
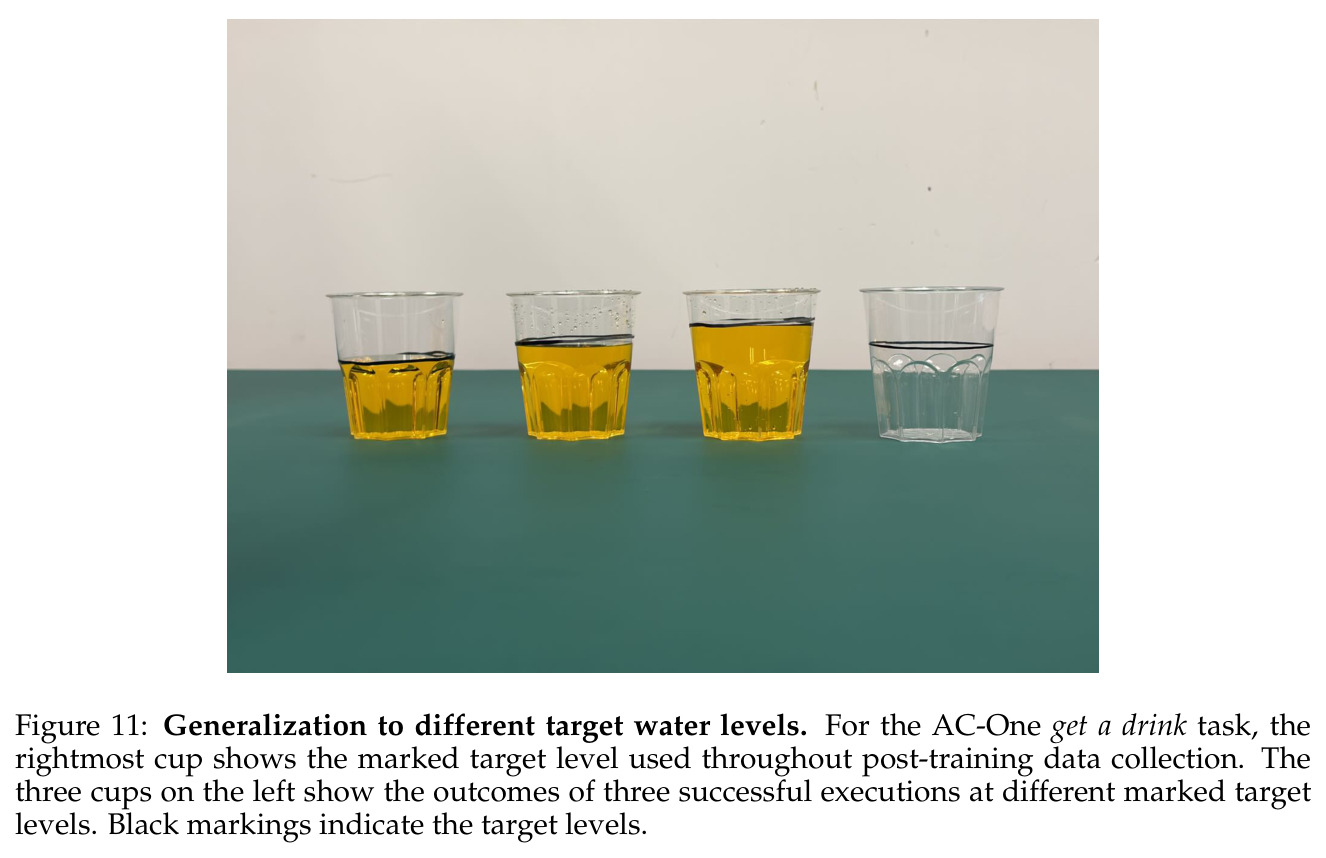
仿真四基准全面领先。LIBERO-Plus(零适应评估):总体 92.8%,超最强 VLA Qwen-RobotManip-Context 1.4 点、超最强 WAM Being-H0.7(84.8%)8.0 点,机器人扰动 91.1% vs 最佳 87.4%,相机/语言/背景达 90.6/92.9/99.4。RoboTwin 2.0:Clean2Clean 90.0%、Clean2Random 71.9%(OpenWAM-α 为 89.4%/48.7%),随机环境 +23.2 点且不损干净分布。EBench:总分 66.0、成功率 49.2% 均最高,长时程 49.4%/76.5 分领先。RoboDojo:平均 23.91%/30.77 分,约为 OpenWAM-α(11.92%)的两倍,也超 GPT-6 Astra(22.48%)。真机:同一检查点适配 4 平台 11 任务;预训练消融显示 toast bread 20%→95%、Luminol reaction 0%→95%,get a drink 可注水到训练未见的刻度;RTC 边界变化比仅 1.12(VJP 8.94、硬前缀 7.13)。组件消融(独立从头训):49.59%→78.37%,SMC +3.88、RynnBrain VLM +8.71、Imprint 双目标 +6.65、4D 蒸馏 +1.92。数据源消融:LIBERO-Plus 上 Robot +5.14 最强(UMI +4.65、Ego2Robot +3.27、Ego +1.86);RoboTwin Clean2Random 上 Robot 把 4.38%→32.34%(UMI 13.90%、Ego2Robot 6.66%)——人类数据与机器人空间对齐越好收益越大。部署延迟 780.5ms→152.8ms(5.11×)且精度几乎无损;GPT 协同把 5 个弱项任务从 10.8% 提到 47.2%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Plus 分布偏移鲁棒性(LIBERO 训练、零适应评估) | 总体成功率 | 92.8% | Qwen-RobotManip-Context 91.4%;此前最强 WAM Being-H0.7 84.8% | +1.4 / +8.0 个百分点 |
| LIBERO-Plus 机器人扰动维 | 成功率 | 91.1% | 此前最佳 ABot-M0.5 87.4% | +3.7 个百分点 |
| RoboTwin 2.0 Clean2Random(仅干净数据训练) | 成功率 | Clean2Random 71.9%,Clean2Clean 90.0%,总体 81.0% | OpenWAM-α 48.7% / 89.4% / 69.0%;最强 VLA Qwen-RobotManip-Context 69.4% | Clean2Random +23.2(对 OpenWAM-α)/ +2.5(对最强 VLA)个百分点 |
| EBench 移动双臂操作 | 总分 / 成功率 | 66.0 / 49.2%(长时程 76.5 / 49.4%) | OpenWAM-α 64.7 / 49.4%;Qwen-RobotManip 60.0 / 45.6% | 总分 +1.3,长时程成功率 +5.1 个百分点 |
| RoboDojo 六类任务(泛化/精度/长时程/记忆/开放) | 平均成功率 / 平均得分 | 23.91% / 30.77 | OpenWAM-α 11.92% / 17.18;GPT-6 Astra 22.48% / 28.97 | 成功率约为最强先验 WAM 的 2 倍(+11.99 点) |
| 真机 AC-One(预训练贡献消融,各 20 次试验) | 成功率 | toast bread 95%,Luminol reaction 95% | 无预训练仅任务后训练:20% 与 0% | +75 / +95 个百分点 |
| 灵巧手部署推理延迟(单张 RTX 5090) | 控制器观测往返延迟 | 152.8 ms | 标准 runtime 780.5 ms | 5.11× 加速(LIBERO-Plus 成功率仅降 0.55 点) |
| RoboDojo 五个弱项任务 + GPT-6 Astra 执行时纠错 | 平均成功率 / 平均得分 | 47.20% / 52.00 | 单独 InternW0-Δ:10.80% / 13.92 | +36.40 / +38.08 |
局限与改进
作者承认两点局限:对自我中心人类数据的贡献研究不充分(数据源、转换策略、预训练配比、监督形式均未系统扫描);agent 辅助控制只是小规模探索,未研究调用策略、长程规划与分层决策。我补充几点观察:其一,RoboDojo 绝对成功率仅 23.9%,记忆、精度与长时程任务对所有方法都困难,距通用操作仍有明显距离;其二,性能对 VLM 选型异常敏感——Qwen3.5-2B 60.37% vs RynnBrain1.1-2B 69.08%(差 8.71 点)且论文未解释原因,削弱了设计的可迁移性;其三,Causal Imprint 的直接差分监督贡献很小(+1.72 点),主要收益来自特征对齐(+5.65 点),核心叙事与实际消融之间有落差;其四,Ego2Robot 管线昂贵且低效——4,061 小时源数据仅 1,101.55 小时(约 27%)完成合成,且在 RoboTwin 上仅把 4.38% 提到 6.66%,投入产出比存疑;其五,评估基准与预训练数据多数以夹爪为主,灵巧手只有小规模真机验证;最后,预训练需 256 张 A800 训练 14 天,社区几乎无法从头复现。
独立分析的弱点
独立分析的弱点与改进方向:(1)预测表示的信息瓶颈——Causal Imprint 要把未来信息压进与当前潜张量同构的令牌中,且差分监督只覆盖相邻帧变化,对长时程后果与间接因果(如松手后物体滑动)可能表达不足;可引入多尺度差分目标或用世界模型隐状态做监督。(2)VLM 依赖黑箱——动作专家的条件质量完全由冻结 VLM 决定,换一个 2B VLM 就差 8.71 点,但缺乏对其所需能力的分析;可做层/token 级贡献分析或加轻量对齐适配器。(3)数据转换管线不可微且脆弱——Ego2Robot 依赖 IK 成功率与渲染合成质量,约 73% 源时长未能转化;可探索可学习 retargeting 或更强的视频编辑模型。(4)RTC 前缀长度上限固定为 16 且由保守延迟估计决定,延迟抖动场景可能失效;可做自适应前缀调度。(5)80 维规范空间对灵巧手表达受限(每手仅 12 维槽位),触觉模态完全缺席——而语料中 AgiBotWorld、RoboMIND 2.0 本就含触觉数据,是明显的未开发信号。(6)GPT 纠错实验仅 5 个任务,推理档位对比样本更少,结论尚不稳健。
未来方向
作者提出的方向:系统研究自我中心数据的利用——不同数据源、转换策略、预训练配比与监督形式如何影响下游性能;扩展 agent 辅助控制——调用策略、长程规划、分层决策以及外部 agent 与世界动作模型的更紧耦合。基于本文成果可延伸:其一,GPT-6 Astra 协同(10.8%→47.2%)证明测试时语义纠错的价值,可系统化为“置信度门控的分层 agent-策略框架”,研究何时交给 LLM、何时信任策略;其二,Causal Imprint 作为“训练时未来监督→推理时预测表示”的通用机制,可迁移到导航、人体行为预测等序列决策任务;其三,VLM 语义接口已为子任务描述、中间目标、持久记忆与执行反馈预留入口,可发展成 agentic WAM;其四,把 Ego2Robot 扩展到灵巧手重定向,并结合 HABIT 类人机共居数据研究人在环操作;其五,将 4D 蒸馏教师升级为在线可微几何模型或用可微渲染提供几何监督;其六,在更大规模或灵巧手任务上探索 ego/UMI 数据收益的转折点——作者承认“ego 收益有限”可能只是小规模夹爪设置下的结论。
复现评估
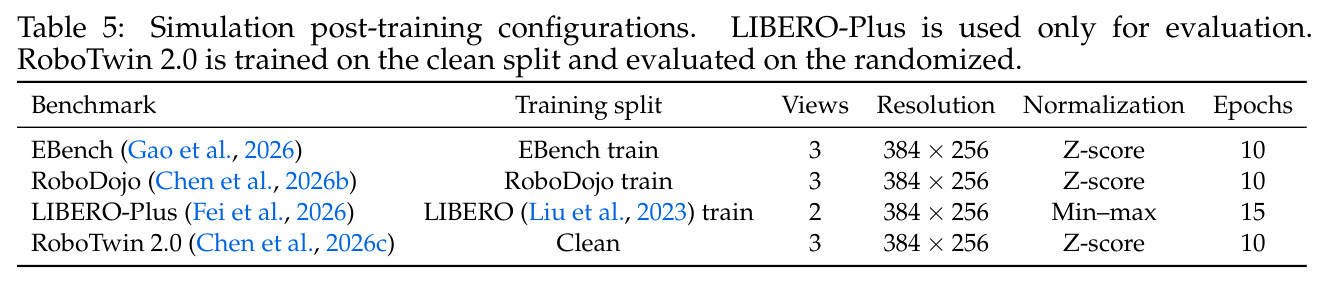
开源情况:论文承诺发布训练代码、模型权重、基础设施、数据处理管线与后训练/评估/部署工具,许可允许时共享处理后数据,并提供带版本号的过滤数据索引以记录过滤决策,透明度在同类工作中突出。数据:语料几乎全部来自公开数据集(15 个机器人数据集共 11,302 小时 + EgoDex/EgoVerse 4,061 小时 + Hy-UMI-10K 2,075 小时 + Ego2Robot 5,634 小时),过滤规则写得非常具体(方向一致阈值 0.65、EEF 单步平移 0.2 m / 旋转 0.5 rad 上限等),数据侧可复现性好。算力:预训练需 256 张 A800 训练 14 天(约 8.6 万 GPU 时),从头复现仅大型实验室可行;但两阶段配方意味着可下载预训练检查点做后训练——每基准 10–15 epoch、batch 16、lr 5e-5,单机 8 卡量级即可。部署需 32GB 级 GPU(论文用 RTX 5090)。难度评估:架构与超参文档完整(Table 4/5/7),但 Ego2Robot 数据管线与 MoT 训练基础设施工程复杂度高,整体属于“可用其检查点与工具链、难以完整复刻预训练”的中高难度。
论文图表
LIBERO-Plus 七维扰动下的成功率对比:InternW0-Δ 总体 92.8%,相机 90.6%、机器人 91.1%、语言 92.9%、光照 95.8%、背景 99.4%、噪声 94.0%、布局 88.4%;对比 10 个 VLA 与 10 个 WAM,VLA 最佳为 Qwen-RobotManip-Context 91.4%,WAM 最佳为 Being-H0.7 84.8%。
主结果表之一:在 7 个扰动维中几乎全面第一,机器人扰动维(91.1 vs 87.4)与总体对最强 WAM 的 +8.0 点优势凸显预测表示的价值。
组件累积消融(全部独立从头训练):基线 49.59% → +SMC 53.47% → +Qwen3.5-2B 60.37% → 换 RynnBrain1.1-2B 69.08% → +Causal Imprint 70.80% → +Lalign 76.45% → +L4D 78.37%。
量化每个组件贡献的关键表:SMC +3.88、VLM 选型 +8.71、Imprint 双目标 +6.65、4D 蒸馏 +1.92,方法叙事全靠它支撑。