只需动作模型:用预测式未来监督替代视觉生成的统一机器人策略框架 Vision-Language-Action or World-Action? Just Action Models
用冻结未来表征的预测损失替代视觉生成目标,训练后丢弃预判分支,性能更高且训练更省
前置知识
VLA(视觉-语言-动作模型)
以预训练视觉-语言模型(VLM)为骨干的机器人控制策略:骨干编码摄像头画面与语言指令,动作专家输出未来 16/32 步的动作块。代表如 OpenVLA(自回归动作 token)与 π0/π0.5(流匹配动作专家)。训练只用轨迹中的动作监督,录制的未来画面被丢弃。
本文核心问题之一是:不做任何视觉生成、只用 VLM 骨干,能否同样从未来观测中受益?JAM 的 Qwen3.5-2B 分支正是对这一假设的直接验证,理解 VLA 才能看懂被解耦的『骨干初始化』这一选择。
WAM(世界-动作模型)
从图像/视频生成模型(Wan2.2、Ovis-U1 的 Yak18、FLUX.2)初始化的机器人策略:除模仿动作外,还用生成损失去噪未来视频潜变量或编辑未来图像,隐式学习环境动力学。部分方法推理时需先生成未来画面;FastWAM/ImageWAM 已去掉测试时生成,但训练时生成损失仍在。
JAM 的两组 matched 对照基线正是 FastWAM 与 ImageWAM,全文要检验的命题是『WAM 的优势到底来自训练时的视觉生成目标,还是仅仅来自利用了未来观测』。
流匹配(Flow Matching)
学习速度场把高斯噪声沿概率流 ODE 连续输运到目标分布的生成方法,训练为速度回归,推理从噪声迭代采样。π0、FastWAM、ImageWAM 的动作专家都用流匹配生成连续动作块:动作 query 经交叉注意力读取骨干上下文,逐步去噪得到 $\hat{a}_{1:H}$。
JAM 刻意保留被比较基线的动作专家初始化与流匹配推理路径完全不变,只改训练目标;知道动作如何生成,才能确认『部署路径逐位一致』这一公平比较前提。
JEPA 与预测式表征监督
不在像素空间重建目标,而是预测目标在编码器特征空间中的表征,用余弦距离在潜空间施加损失,目标侧梯度截断防塌缩。本文前瞻损失即此思路:冻结『未来锚点』编码录制未来帧作为目标,训练当前观测特征去预测它。
JAM 的核心公式 $\mathcal{L}_F$ 是余弦距离形式的前瞻损失,理解『预测表征而非像素』为何可行,是读懂本文为什么能去掉生成器的关键。
LIBERO / LIBERO-Plus / RoboTwin 2.0 基准
LIBERO 含四套共 40 个操作任务,每任务 50 次 rollout 报成功率;LIBERO-Plus 加相机、初始状态、语言、光照、背景、噪声、布局七类扰动,本文用 1,506 任务子集各评一次;RoboTwin 2.0 为 50 个双臂任务的 Clean/Randomized 两设定。
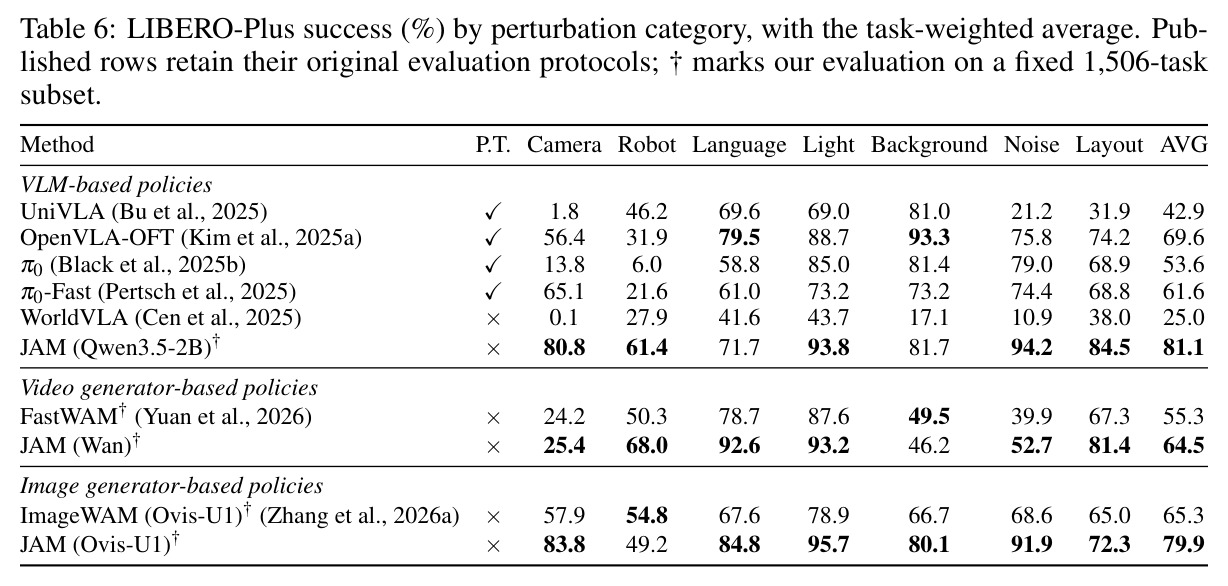
论文所有成功率都来自这三个基准,且 matched 比较与已发表结果使用不同评测协议(Table 6 中 † 标记),理解协议差异才能正确解读数字。
读取偏移(readout offset)与缓存目标
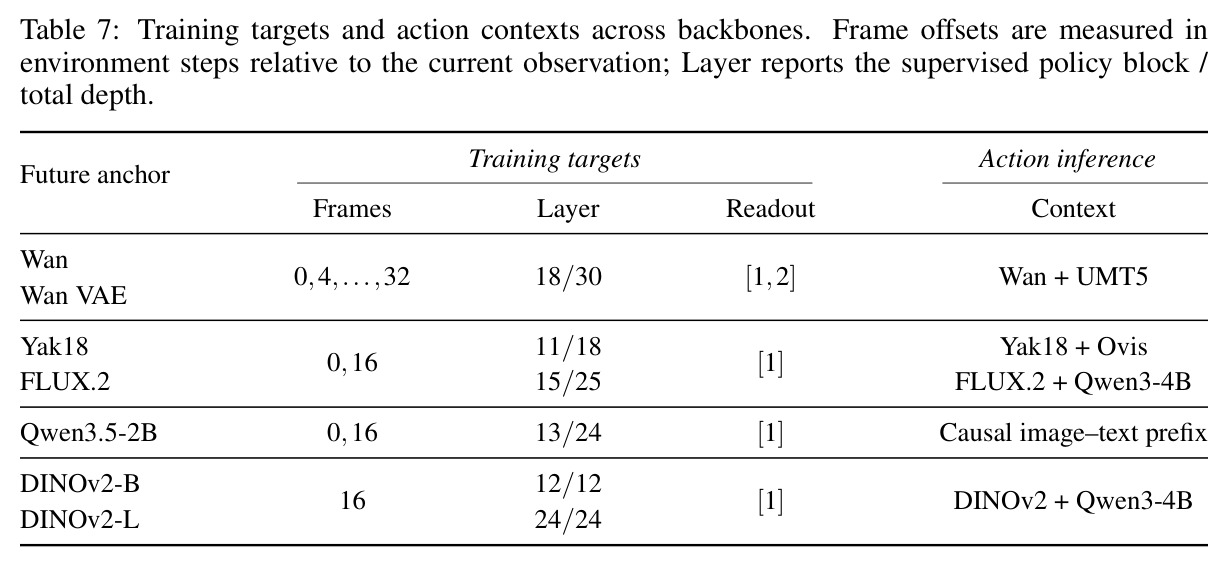
未来锚点按时间位置输出特征:$k=0$ 对应当前帧,$k\geq 1$ 对应录制未来帧(Wan 因果 VAE 每 4 帧合并为一潜位置,[1,2] 覆盖 4-16、20-32 步;Yak 系 [1] 为 16 步后单帧)。锚点冻结、条件固定时目标可离线缓存,训练在线只需前向当前帧。
偏移选择是本文最出乎意料的发现之一:只监督未来位置比只监督当前位置在 LIBERO-Plus 上高出约 11 个点,缓存目标则是 73% FLOPs 节省的来源。
研究动机
视觉-语言-动作模型(VLA)与世界-动作模型(WAM)之争把三件本可分开的设计选择捆在了一起:骨干用 VLM 还是视觉生成器初始化、是否对轨迹中录制的未来观测施加损失、以及施加该损失的模块在推理时是否保留。VLA(π0/π0.5、OpenVLA 等)只学动作,未来画面被丢弃;WAM(FastWAM、ImageWAM 等)额外用生成损失去噪未来视频潜变量或编辑未来图像,训练时必须加载解码/去噪路径,部分方法推理时还要先生成未来画面再执行。单比成功率无法分辨差异来自哪个选择:FastWAM 在 LIBERO/LIBERO-Plus 上为 97.0%/55.3%,ImageWAM(Ovis-U1)为 92.9%/65.3%,但二者骨干、目标、架构全都不同。更成问题的是,FastWAM 与 ImageWAM 在去掉测试时生成后,把 WAM 的优势归因于『训练时的视觉生成目标』,这一归因从未在受控实验中被检验过。
本文的目标是本文的目标是把上述三个纠缠的选择解耦,并回答一个更基本的问题:从录制的未来观测中学习,到底需不需要视觉生成目标?为此提出统一框架 JAM(Just Action Model):一个预训练视觉骨干加一个动作专家,用动作损失 $\mathcal{L}_{act}$ 加前瞻损失 $\mathcal{L}_F$ 训练——前瞻损失让当前观测特征去预测冻结编码器给出的未来表征,训练结束后整个前瞻分支(锚点与预测头)被丢弃,部署时没有生成、没有额外模块。具体目标有三:(1) 在固定策略架构、数据、优化器、训练预算与部署路径的前提下,把 FastWAM/ImageWAM 的生成目标换成前瞻目标,做严格 matched 比较;(2) 把同一目标推广到生成式、自监督、视觉-语言三类预训练骨干,检验配方普适性;(3) 量化去掉生成后的训练成本节省。
与已有工作不同的是,已有工作的切入角度各有局限:FastWAM 与 ImageWAM 只去掉了测试时生成,保留训练时生成损失,就把功劳记给生成目标,缺少『损失』这一变量的受控消融;JEPA-WAM 用冻结 V-JEPA 空间的稠密当前-未来联合目标,但绑定特定预训练 VLA 结构并保留部分预测通路;FLARE 把未来、状态、动作 token 混入动作 DiT 的自注意力,直接改变了动作计算路径;FRAPPE、VLAFlow、PFD 等在推理时保留对齐流或残差适配器。JAM 的独特之处有三:未来观测只以冻结目标的身份进入损失,前瞻分支训练后整体删除,部署结构与其对照基线逐位一致;目标空间按骨干逐个选择(而非固定在某个预训练表征空间);首次在生成式(Wan、Ovis-U1、FLUX.2)、自监督(DINOv2-B/L)、视觉-语言(Qwen3.5-2B)三类骨干上用同一个损失验证『未来监督不依赖视觉生成』。
核心方法
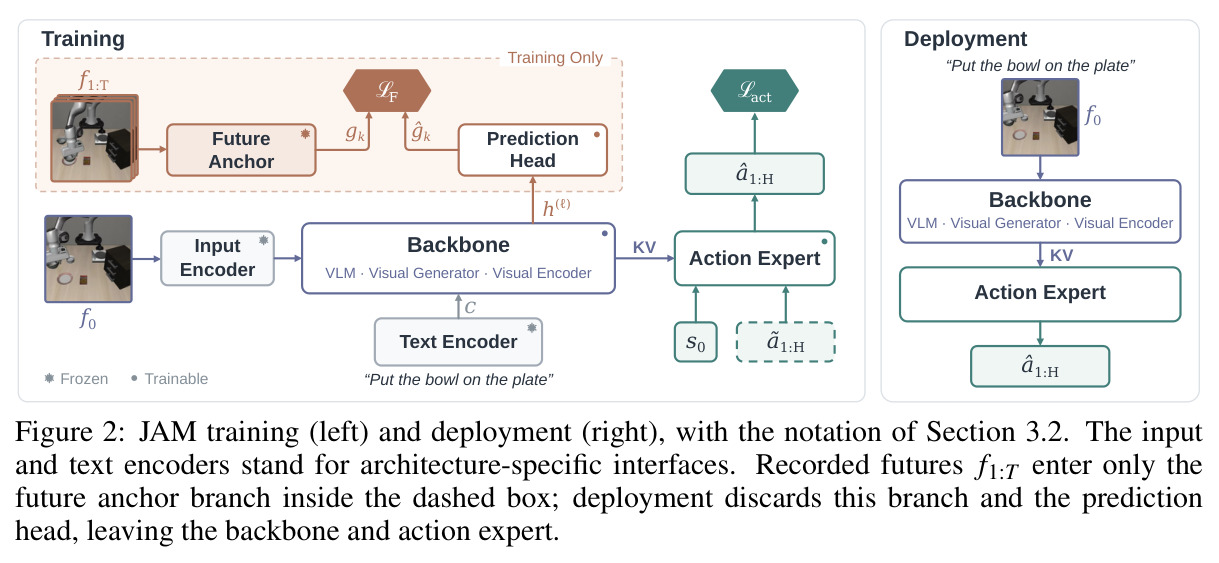
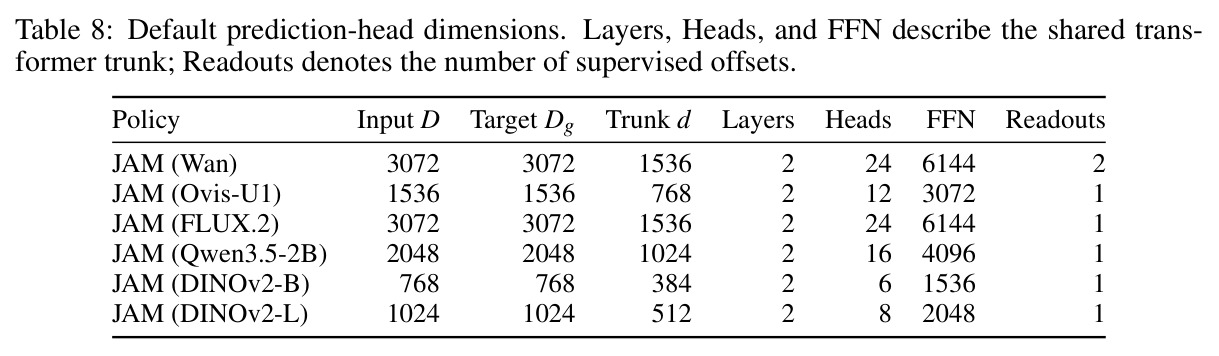
直觉上,JAM 主张『学预判、不做生成』:让策略的视觉特征里蕴含接下来会发生什么的信息,但不要求它真的画出未来画面。技术路线是:策略由预训练视觉骨干(编码当前观测 $f_0$,可条件化于指令 $c$)与动作专家(读取视觉上下文、文本、机器人状态 $s_0$ 与加噪动作块,经流匹配采样输出 $\hat{a}_{1:H}$)组成,这两者就是部署时的全部结构。训练时额外挂一个冻结『未来锚点』分支:锚点(预训练骨干副本、随机初始化副本、或策略自带的 VAE 分词器)编码录制未来 $f_{1:T}$ 得到目标特征 $g_k$;一个轻量预测头把骨干中间层的当前观测 token $h^{(\ell)}$ 映射到目标空间,与 $g_k$ 做余弦距离。总损失为 $\mathcal{L}_{JAM}=\mathcal{L}_{act}+\lambda_F\mathcal{L}_F$。训练结束后锚点与预测头整体删除,推理路径与被比较的 FastWAM/ImageWAM 完全相同:骨干编码一次 $f_0$ 与 $c$,动作专家在各流匹配步复用该上下文。
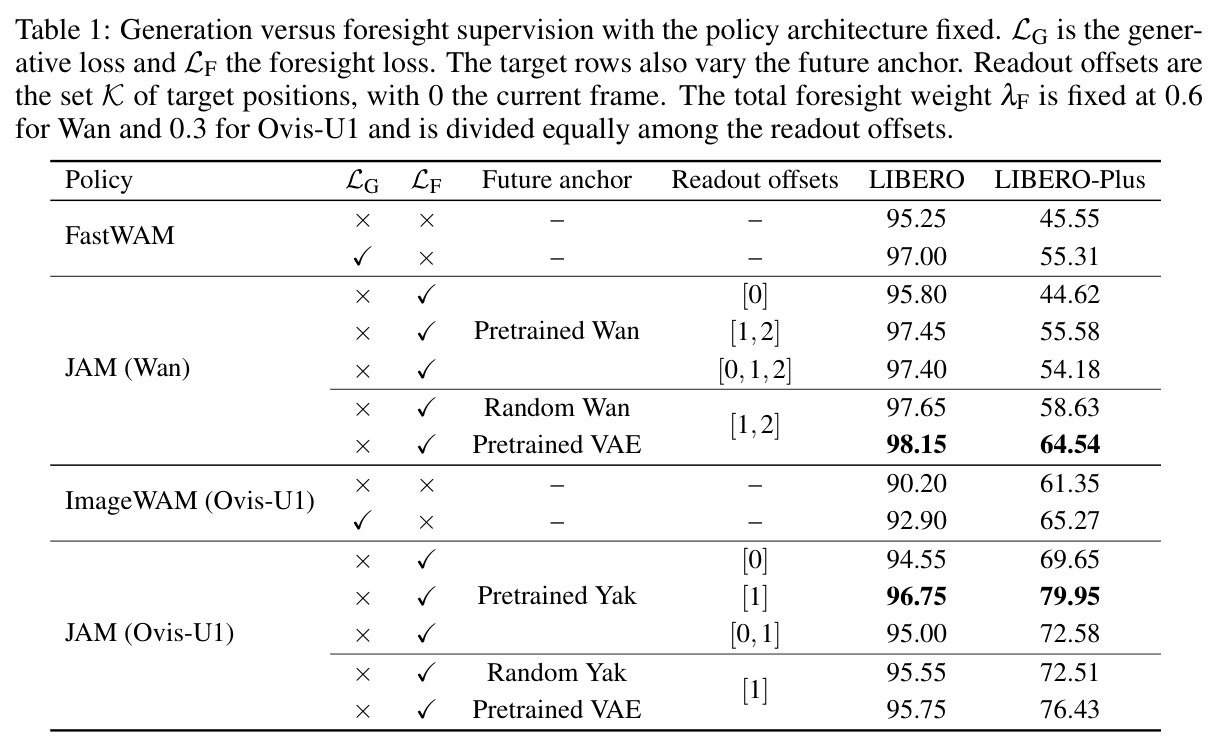
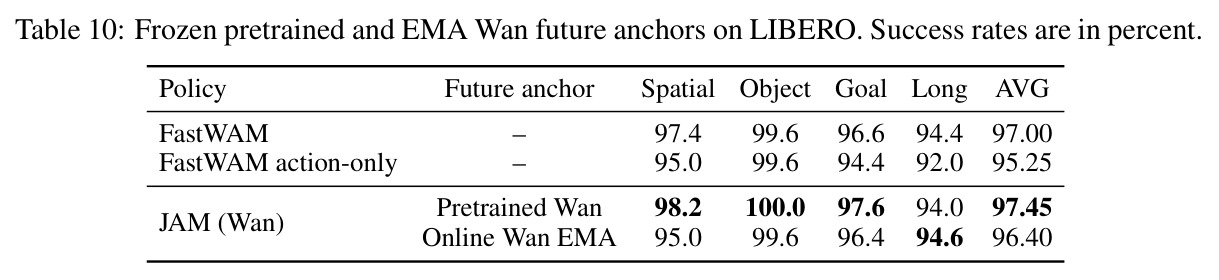
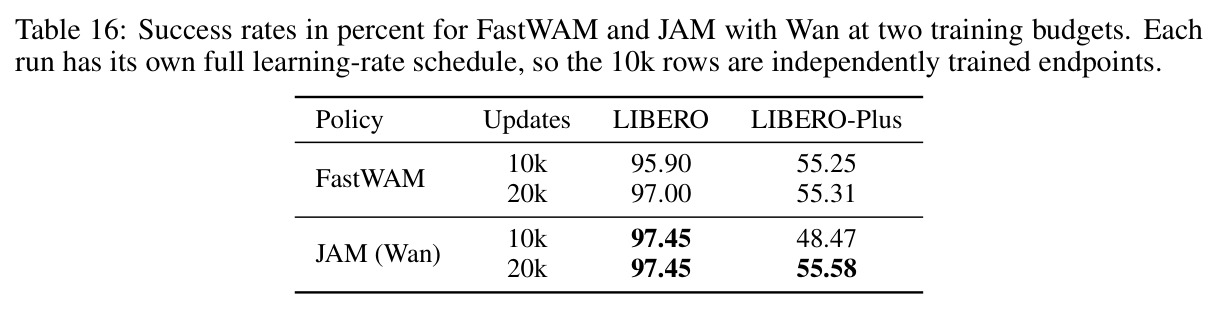
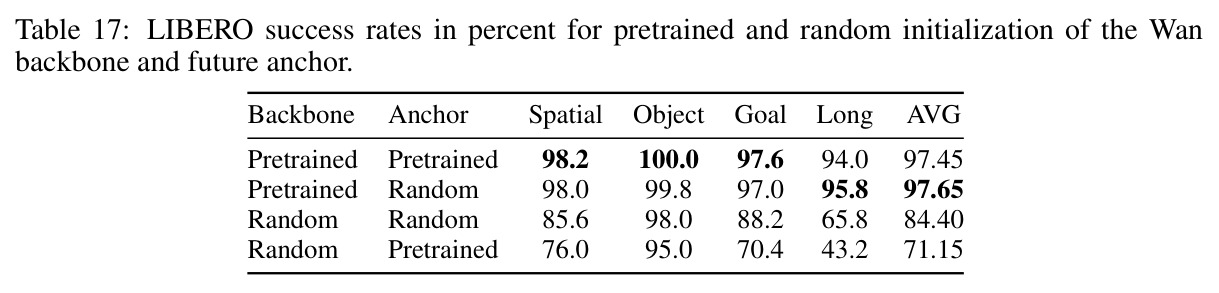
核心创新是把『未来』从输入或生成对象降格为纯粹的学习信号:未来观测只作为冻结目标的编码进入损失,梯度经预测头回流到策略骨干(目标侧 stop-gradient),永不进入动作路径。与 WAM 的本质区别是不再需要解码器/去噪路径,骨干因此可以自由选择;与 VLA 的本质区别是同样的轨迹数据被多利用了一次。两个经验发现支撑设计:其一,读取偏移比换目标本身更关键——对 Wan 骨干,只监督当前位置 [0] 时 LIBERO-Plus 仅 44.62%,换成未来位置 [1,2] 升至 55.58%,把当前位置加回 [0,1,2] 反而降到 54.18%(双向注意力下当前位置特征已隐含未来信息);其二,目标不需要与策略同源或预训练——Wan 骨干配冻结 VAE 潜变量目标最好(64.54%),随机 Wan 目标也有 58.63%,而 Ovis-U1 配预训练 Yak 目标最好(79.95%)。锚点只需提供稳定、依赖输入的特征,最优目标与架构相关。
方法步骤详情
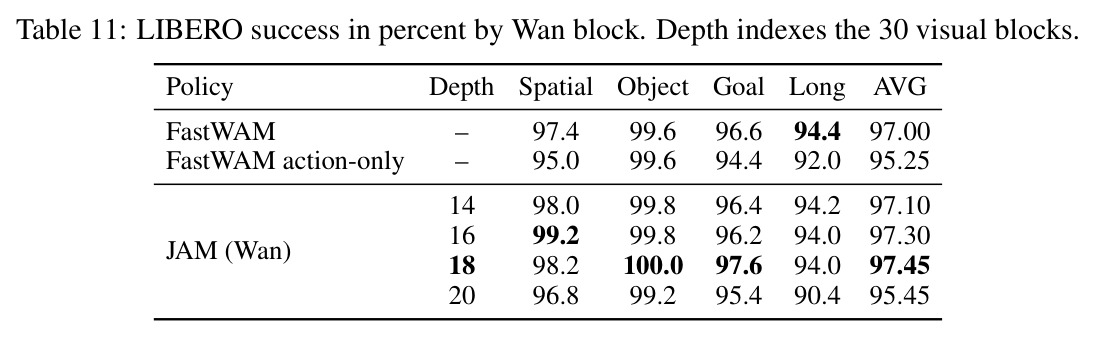
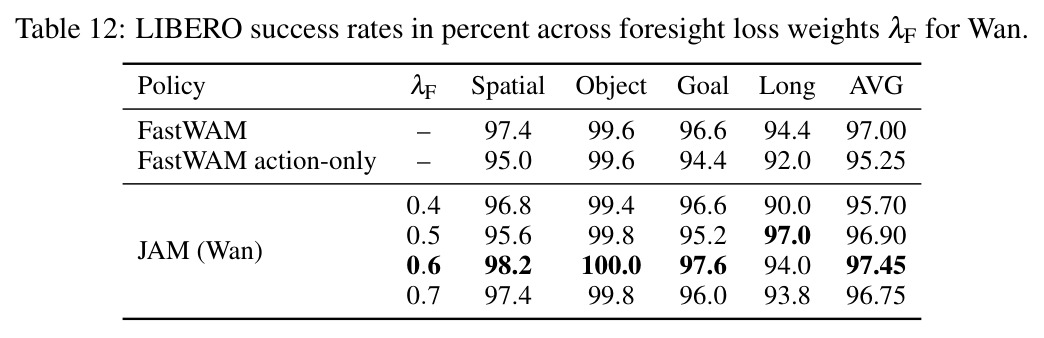
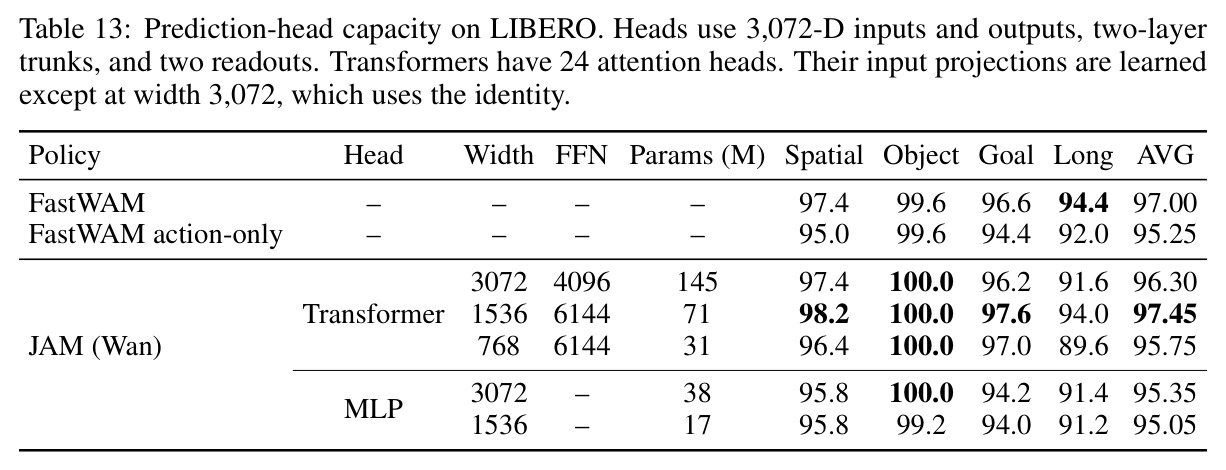
第一步,选定骨干与动作专家并沿用基线配方:FastWAM 用 Wan2.2-5B 加同深动作专家,ImageWAM 系用 Yak18/FLUX.2/DINOv2/Qwen3.5-2B 加匹配宽深的专家,动作块 32/16 步。第二步,构建前瞻目标:冻结锚点(骨干副本、随机网络或策略 VAE)读取当前帧、指令与未来帧(Wan 九帧窗口,其余单帧),在约 60% 深度取特征得 $g_k$;锚点固定,目标可离线缓存。第三步,算前瞻损失:预测头(两层 transformer)把 $h^{(\ell)}$ 映为 $\hat{g}_k$,$\mathcal{L}_F=\frac{1}{|K|}\sum_{k\in K}\mathbb{E}_n[1-\cos(\hat{g}_{k,n},sg[g_{k,n}])]$,权重 $\lambda_F$=0.6 或 0.3。第四步,按基线预算训练(LIBERO 20k-21.7k 更新),RoboTwin 五个 epoch。第五步,删除锚点与预测头部署:骨干编码一次 $f_0$ 与 $c$,动作专家复用上下文流匹配采样输出 $\hat{a}_{1:H}$。
技术新颖性
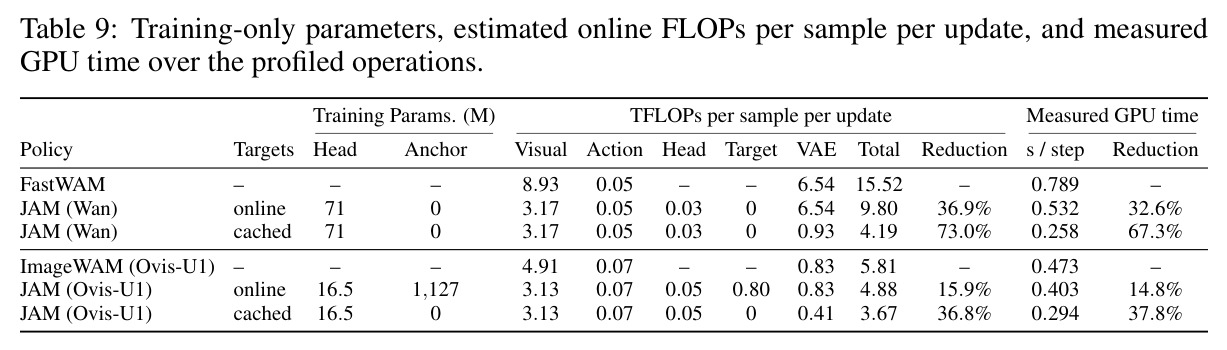
技术新颖性有三。其一,方法学上的解耦论证:不同于 FastWAM/ImageWAM 直接宣称生成目标有效,本文在架构、数据、优化器、预算、部署路径全部固定的 matched 比较中只动损失一项(Table 1),使『生成 vs 前瞻』的因果归因首次成立,并以 bootstrap 置信区间与 McNemar 检验(全部 $p<0.05$)背书。其二,『即插即弃』的前瞻分支:与 FLARE(未来 token 进入动作 DiT 注意力)、JEPA-WAM(联合目标、部署保留通路)、FRAPPE/VLAFlow/PFD(推理保留对齐流或残差适配器)不同,JAM 的预测头只监督既有骨干 token,动作计算逐位不变,训练后整体删除;目标可缓存使 Wan 在线 FLOPs 每样本每更新从 15.52 降至 4.19 TFLOPs(-73.0%)。其三,跨预训练家族的统一性:同一余弦前瞻损失同时适用于视频生成 DiT、图像编辑骨干、自监督编码器与 VLM,并给出『最优目标与架构相关』的新结论(Wan 配纯 VAE、Ovis-U1 配预训练 Yak)。
实验结果
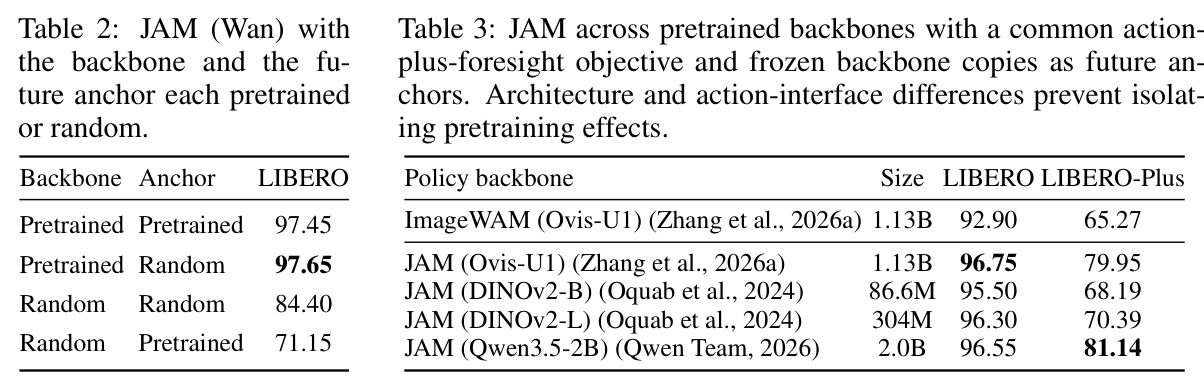
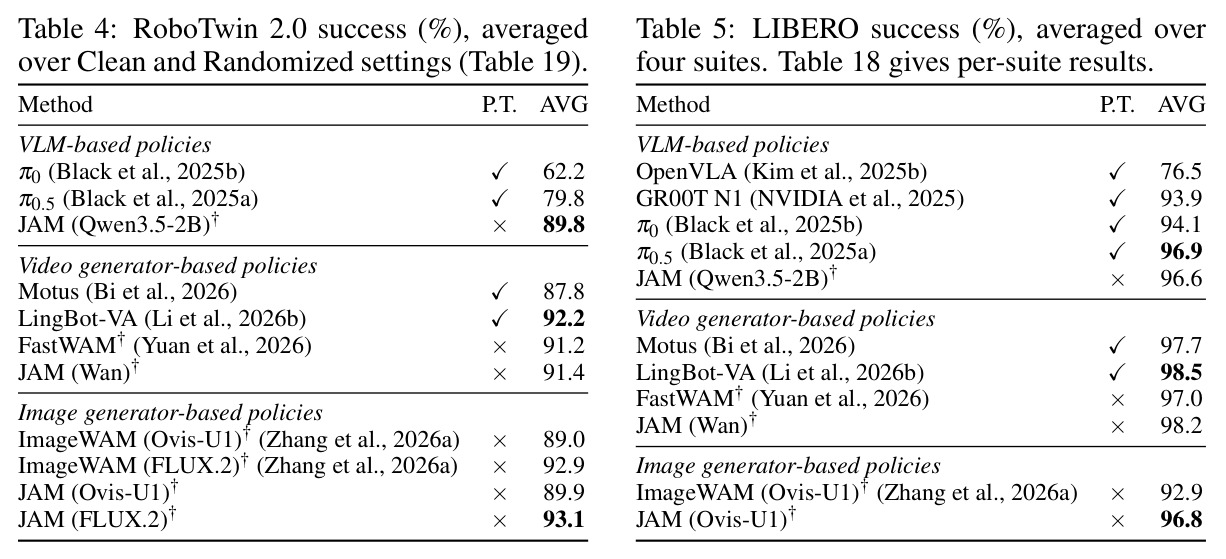
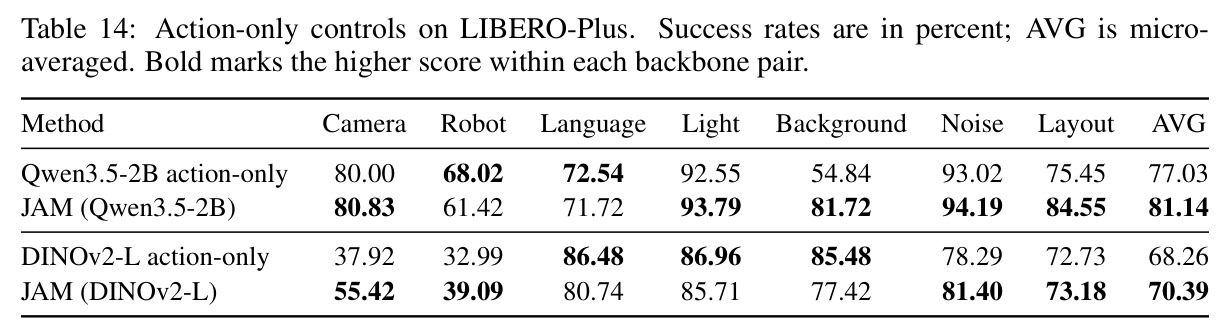
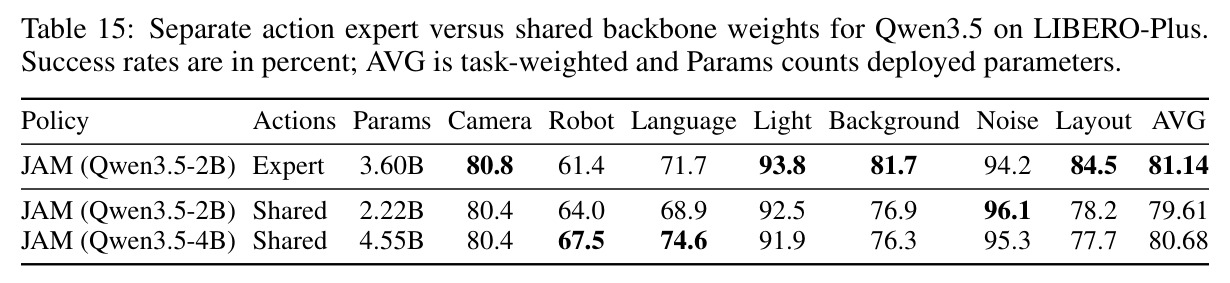
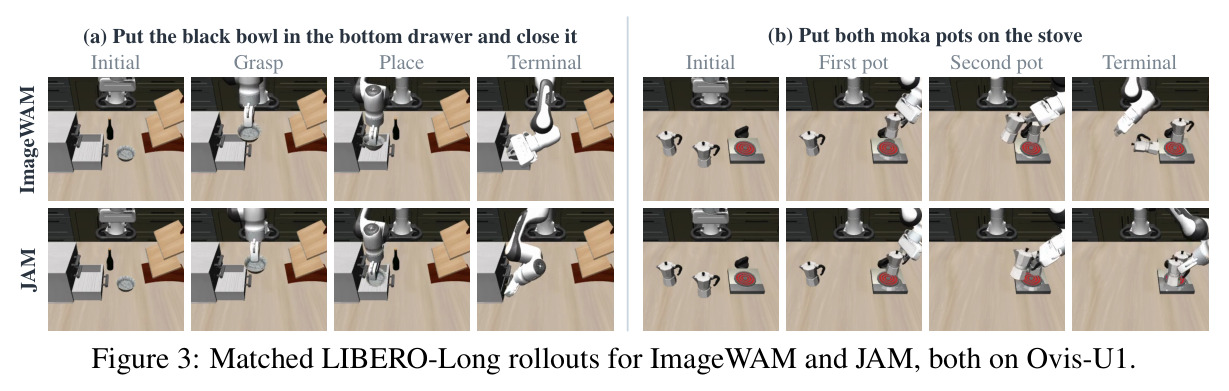
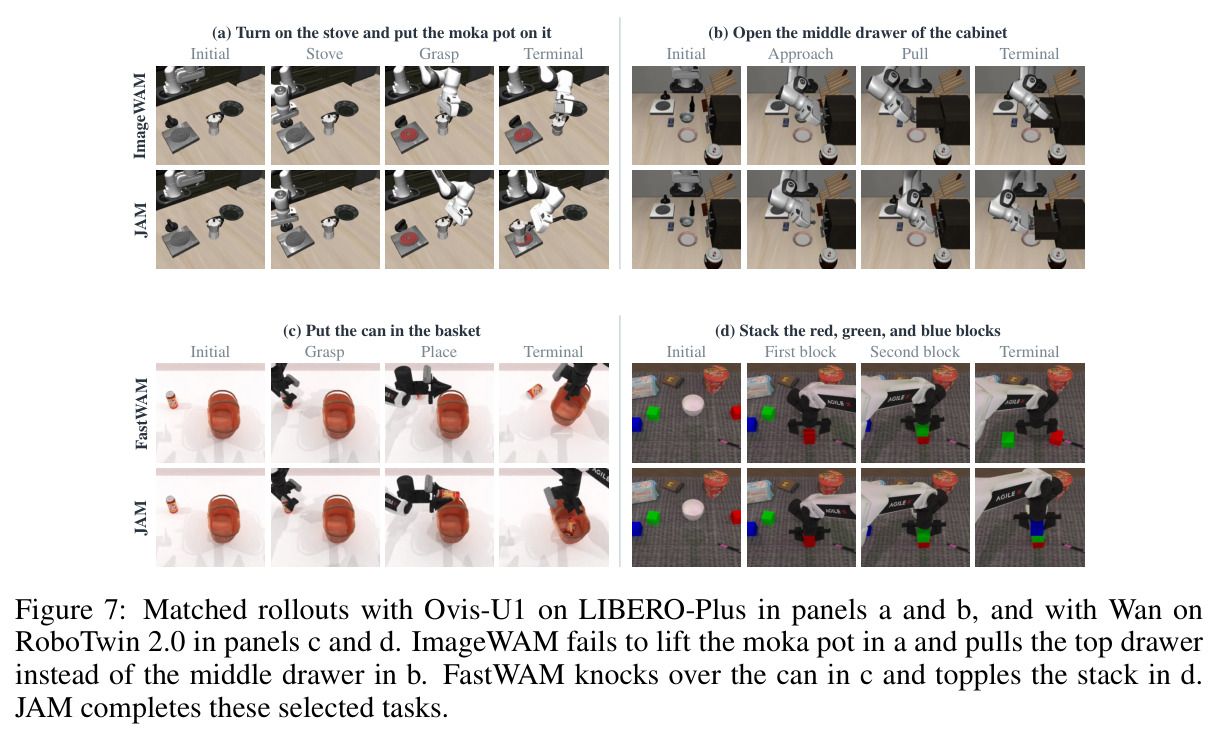
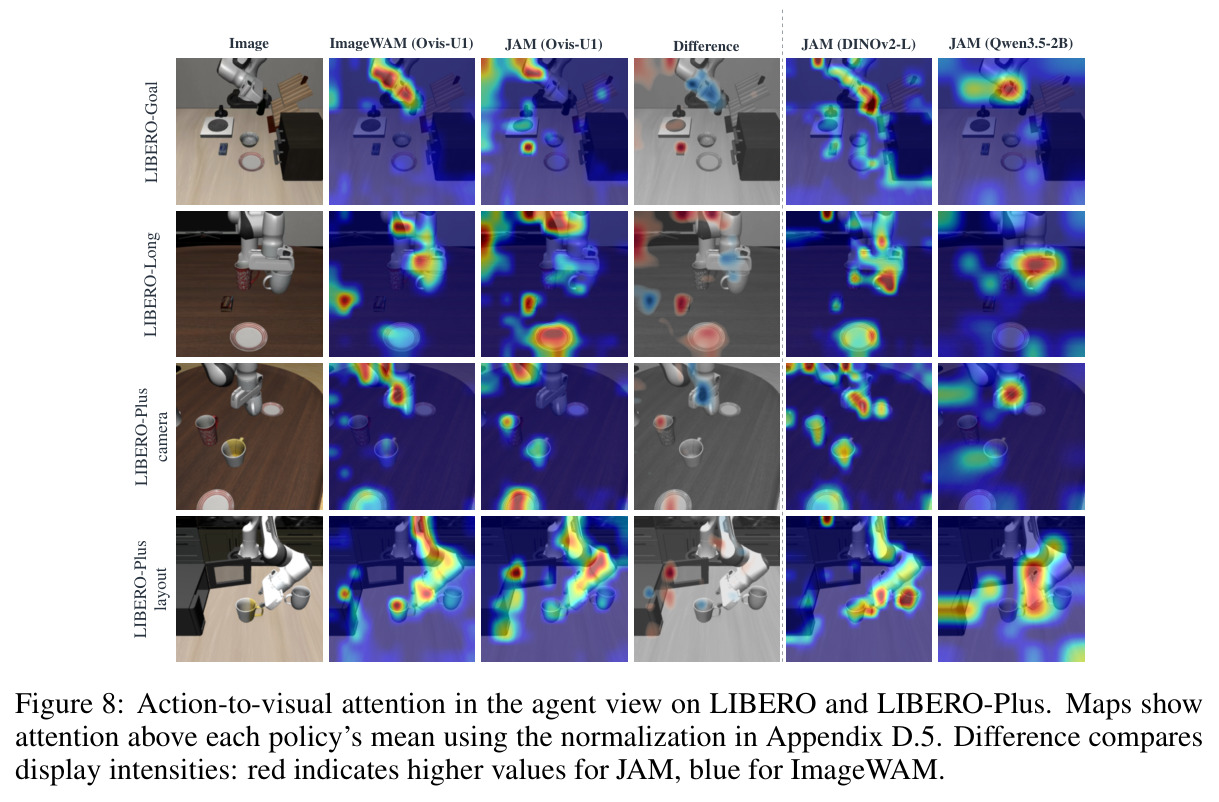
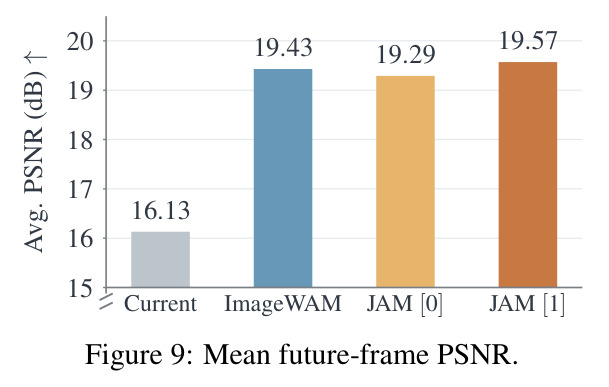
实验分两阶段。第一阶段(Table 1,固定架构只换损失):FastWAM 换前瞻后 LIBERO-Plus 55.31%→64.54%;ImageWAM 换 Yak 目标后 65.27%→79.95%;偏移 [0]→[1,2] 使 LIBERO-Plus 44.62%→55.58%。骨干消融:策略骨干必须预训练,锚点随机也有效。第二阶段(Table 3):JAM(Ovis-U1)79.95%、JAM(Qwen3.5-2B)81.14%、JAM(DINOv2-L)70.39%,均超 ImageWAM 的 65.27%;Qwen3.5 加前瞻 77.03%→81.14%。对外比较:LIBERO-Plus 上 JAM 三组均第一,超 FastWAM 9.2、ImageWAM 14.7 点;RoboTwin 上 JAM(FLUX.2)93.1% 最高。成本:缓存目标使在线 FLOPs 降 73.0%/36.8%。统计(Table 20):McNemar 全部 p<0.05,三次独立训练方差 ≤0.43 点。机制上(Figure 4/9):JAM[1] 特征的未来变化最易解码。
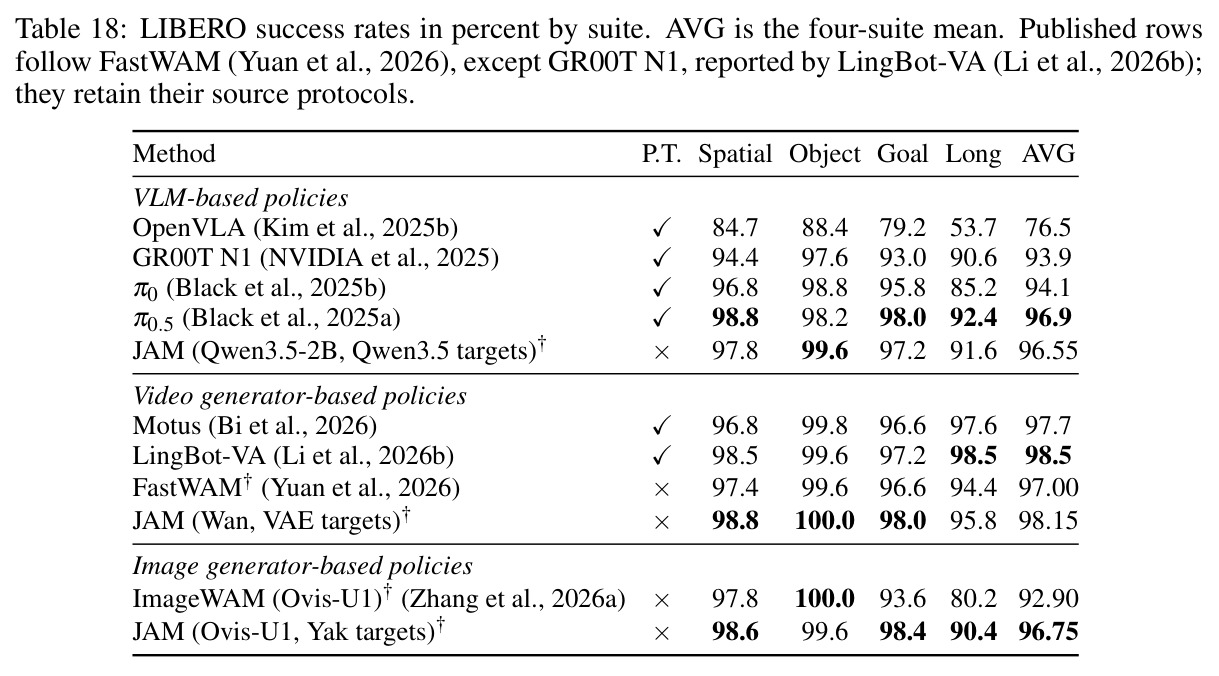
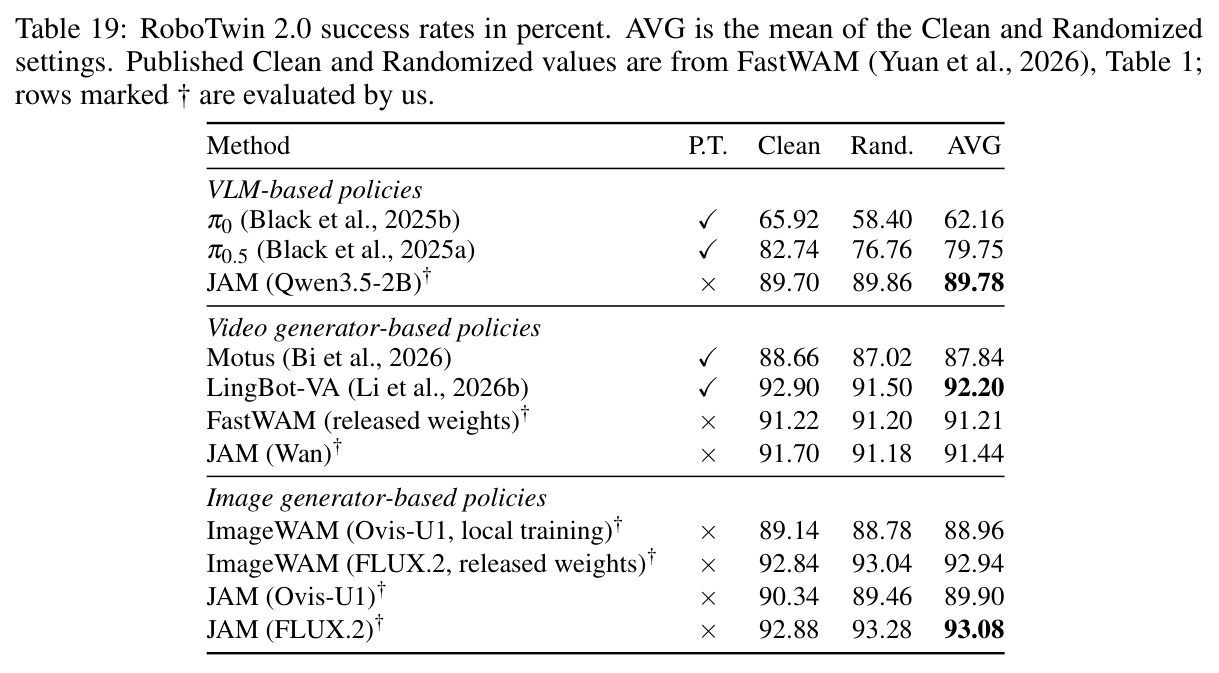
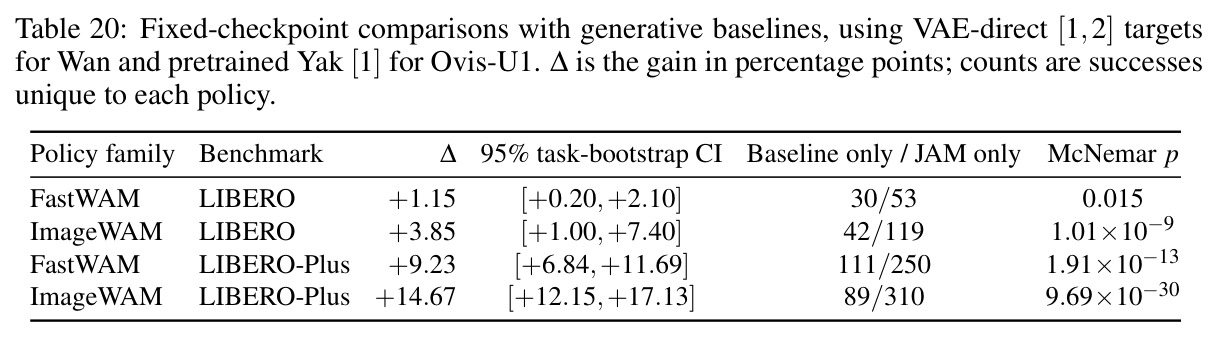
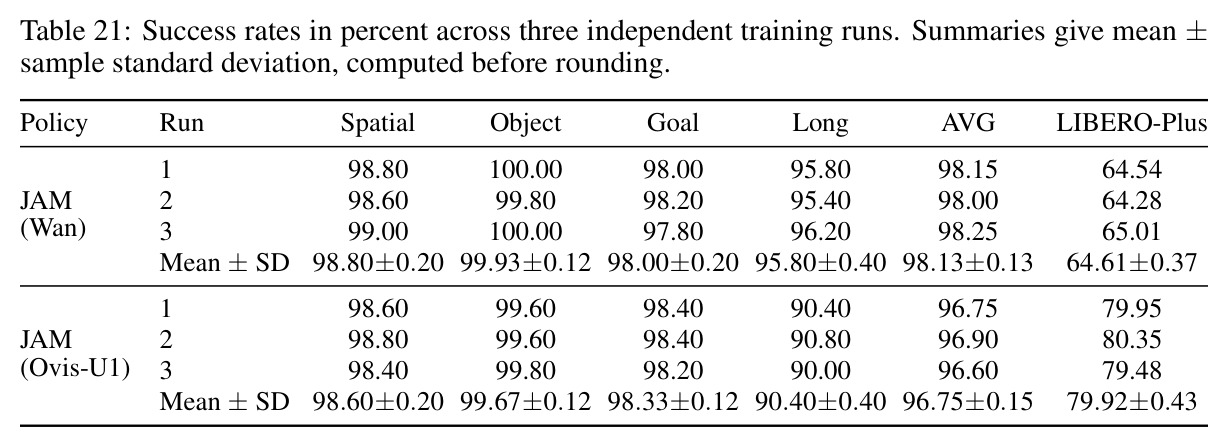
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO(四套件平均,Wan 系 matched 比较) | 成功率 % | JAM (Wan, VAE 目标 [1,2]) 98.15 | FastWAM(生成损失)97.00 | +1.15 点,McNemar p=0.015 |
| LIBERO(Ovis-U1 系 matched 比较) | 成功率 % | JAM (Ovis-U1, Yak 目标 [1]) 96.75 | ImageWAM (Ovis-U1) 92.90 | +3.85 点,p=1.01e-9 |
| LIBERO-Plus(1,506 扰动任务,Wan 系) | 成功率 % | JAM (Wan) 64.54 | FastWAM 55.31 | +9.23 点 [+6.84,+11.69] |
| LIBERO-Plus(Ovis-U1 系) | 成功率 % | JAM (Ovis-U1) 79.95 | ImageWAM (Ovis-U1) 65.27 | +14.67 点 [+12.15,+17.13] |
| LIBERO-Plus(VLM 系) | 成功率 % | JAM (Qwen3.5-2B) 81.14 | 同架构 action-only 77.03 / ImageWAM 65.27 | +4.11 点(对照)/+15.87 点(跨基线) |
| RoboTwin 2.0(Clean+Randomized 平均) | 成功率 % | JAM (FLUX.2) 93.1;JAM (Wan) 91.4;JAM (Qwen3.5-2B) 89.8 | ImageWAM (FLUX.2) 92.9;FastWAM 91.2;π0.5 79.8 | 各分组内最高或持平(+0.2~+10.0 点) |
| 在线训练成本(Wan 系,缓存目标) | TFLOPs / 样本 / 更新 | 4.19 | FastWAM 15.52 | -73.0%(GPU 实测时间 -67.3%) |
| 在线训练成本(Ovis-U1 系,缓存目标) | TFLOPs / 样本 / 更新 | 3.67 | ImageWAM 5.81 | -36.8%(GPU 实测时间 -37.8%) |
局限与改进
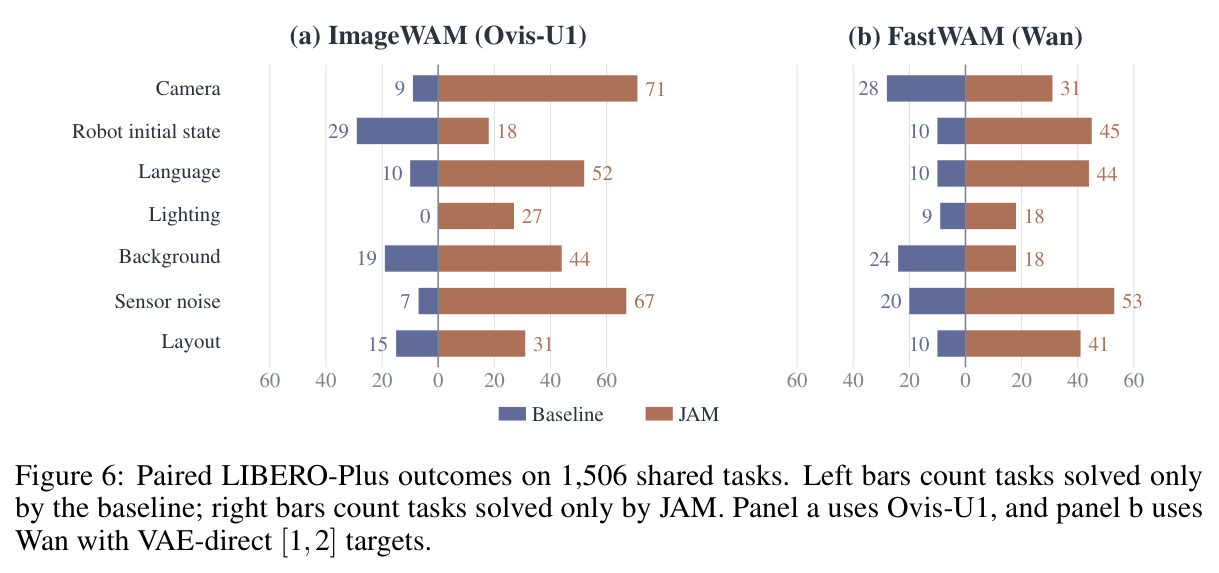
局限如下。其一,全部实验在仿真完成,无真机验证,sim-to-real 域差是最大未知数。其二,作者明确说明跨骨干比较(Table 3)无法分离预训练效应,因各骨干架构与动作接口不同——DINOv2 明显落后(LIBERO-Plus 70.39% vs Qwen3.5 的 81.14%)是预训练类型差异还是无语言输入的结构差异,无法断言。其三,读取偏移与锚点靠逐架构扫描(Wan [1,2]、Ovis 系 [1]、约 60% 深度),$\lambda_F$ 在 0.4-0.7 网格上挑,无普适选择原则。其四,LIBERO-Plus 用 1,506 任务子集且每任务仅一次 rollout,噪声比完整协议更大。其五,前瞻目标只是单帧或短窗口,无长时程或非视觉模态未来;缓存目标要求条件固定,限制数据增广。其六,分类别并非全面占优:Ovis-U1 系在 robot-state(49.2 vs 54.8)、Wan 系在 background(46.2 vs 49.5)仍劣于各自基线;RoboTwin 上 JAM (Qwen3.5-2B) 落后 JAM (FLUX.2) 3.30 点。
独立分析的弱点
独立分析几点弱点并给改进方向。(1) 目标选择无原则可循:Wan 偏好 VAE 潜变量(64.54%)、Ovis-U1 偏好预训练 Yak(79.95%),换新骨干仍需网格搜索——可按目标表征的时序互信息或探针可解码性自动选锚点与偏移。(2) 单一余弦损失容量有限:只约束方向不约束幅度,目标空间冻结,未来信息超出锚点表征容量即无法监督——可引入多锚点组合或轻量可学习目标空间。(3) 未来视界固定(16/32 步)与任务时长无关:LIBERO-Long 仍是各方法最弱套件(JAM (Ovis-U1) 90.4%),长程任务需要多尺度未来监督——可按动作块长度自适应设定偏移。(4) 自监督骨干的语言盲区:DINOv2 前瞻目标不含指令语义,LIBERO-Plus 语言扰动 80.74 分反低于 action-only 的 86.48——可配语言条件锚点。(5) 缓存与增广冲突:缓存依赖固定条件,强视觉增广会使目标失配,需在线重算或增广不变锚点,成本未讨论。(6) 缺真机与安全指标:前瞻特征是否降低碰撞、损坏等失败模式无度量。各点均可直接作为后续选题。
未来方向
作者方向与可延伸方向。作者已指出跨骨干比较未分离预训练效应,未来可在统一动作接口下做受控预训练消融,回答『VLM 预训练 vs 生成器预训练哪个更有用』这一被本文搁置的问题。基于其成果可延伸:(1) 真机部署与 sim-to-real 验证——LIBERO-Plus 相机扰动上 JAM-only 对 baseline-only 任务数为 71 对 9,这一鲁棒性增益是否迁移到真实视觉域差值得检验;(2) 把丢弃的预测头改造成在线监控器——部署时用『预测的未来表征 vs 实际观测编码』的偏差做异常检测、触发重规划或保守动作,零生成成本,是 JAM 框架的天然扩展;(3) 与具身预训练结合——Table 4/5 中带机器人数据预训练的 LingBot-VA、Motus 仍领先或持平,JAM 配大规模机器人轨迹预训练可能同时拿下两个基准;(4) 多模态与层次化未来目标(深度、触觉、近/中/远多尺度偏移);(5) 理论分析为何未来位置监督优于当前位置(双向注意力下 [0] 已含未来信息、加回 [0] 反而稀释梯度);(6) 用前瞻损失下降速度给轨迹打分,做数据筛选与课程学习。
复现评估
复现条件较好。代码与部分模型权重公开(项目页 https://y0uroy.github.io/JAM),实现基于公开的 FastWAM 与 ImageWAM 代码,基准数据全部公开。附录细节充分:架构与目标接口(Table 7)、预测头维度(Table 8)、FLOPs 核算与 GPU 实测方法(附录 B)、全部消融与 action-only 对照(附录 C)、评测协议含子集抽样、10 万次 bootstrap 置信区间、McNemar 检验与三次独立训练(附录 D)。算力门槛较高:所有训练用 8 块 NVIDIA GH200、bf16;单配置 LIBERO 训 20k-21.7k 次更新(全局批 128),RoboTwin 五个 epoch(批 384-1,024),覆盖六个骨干家族的完整复现成本不低。有利因素:结果方差小(LIBERO-Plus 三次运行 64.61±0.37% 与 79.92±0.43%)、锚点可用随机网络或 VAE,核心结论在单骨干上只需一次 20k 更新训练即可初步验证。综合评级:复现难度中等偏上,瓶颈在算力而非工程细节。
论文图表
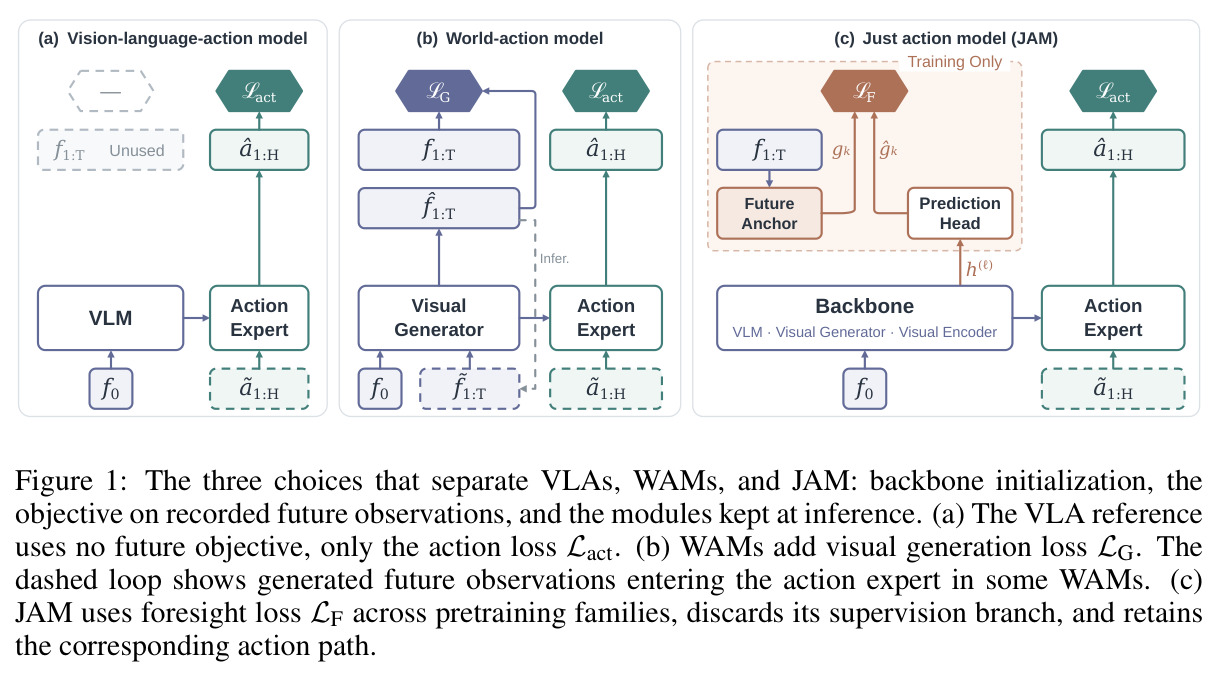
三栏对照图。(a) VLA 只用动作损失 $\mathcal{L}_{act}$,未来观测标注 Unused,骨干为 VLM;(b) WAM 加生成损失 $\mathcal{L}_G$,虚线回路表示部分 WAM 让生成的未来观测再进入动作专家,骨干为视觉生成器;(c) JAM 用前瞻损失 $\mathcal{L}_F$ 训练预测头 $g_k\to\hat{g}_k$ 对齐未来锚点特征,该分支标注 Training Only,骨干可为 VLM、视觉生成器或视觉编码器,部署时只保留骨干加动作专家输出 $\hat{a}_{1:H}$。
这张图是全文论点的浓缩:把 VLA/WAM 之争拆解为骨干初始化、未来目标、推理结构三个正交选择,读者看图即可理解 JAM 为何能桥接两派,以及前人比较为何无法归因。
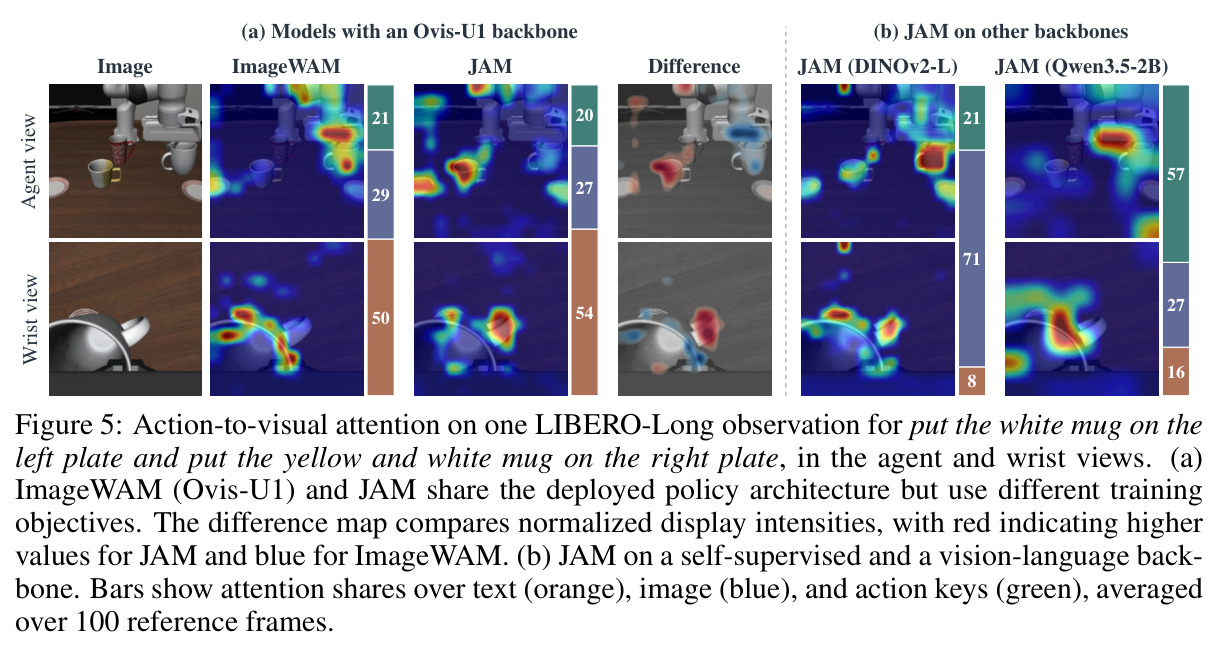
对『两只摩卡壶上灶』任务,在四个冻结策略上各训练两个 MLP 探针,从特征重建当前帧与 16 步后帧,将重建的带符号亮度差与真实变化对比:红=变亮、蓝=变暗。用偏移 [1] 训练的 JAM 特征解码出的未来变化(如壶放置区域的亮度变化)明显比 ImageWAM 和 JAM[0] 更清晰、更接近真实变化图。
提供机制层面的解释证据:未来位置监督确实让当前观测特征中蕴含更多可解码的未来信息,直接解释了 Table 1 中偏移 [1] 优于 [0] 的现象,是全文因果链的重要一环。
同一动作加前瞻目标下对比四个骨干家族:Ovis-U1 1.13B(LIBERO 96.75 / LIBERO-Plus 79.95)、DINOv2-B 86.6M(95.50/68.19)、DINOv2-L 304M(96.30/70.39)、Qwen3.5-2B 2.0B(96.55/81.14),全部超过生成基线 ImageWAM (Ovis-U1) 的 92.90/65.27。
第二阶段实验的主表:证明配方跨生成式、自监督、视觉-语言三类预训练家族通用;表注同时警示架构与动作接口差异使预训练效应无法被单独归因,界定了结论范围。
RoboTwin 2.0 上按骨干家族分组的成功率:VLM 组 JAM (Qwen3.5-2B) 89.8 超 π0.5 的 79.8;图像生成组 JAM (FLUX.2) 93.1 为全表最高,超 ImageWAM (FLUX.2) 的 92.9;视频生成组 JAM (Wan) 91.4 略超 FastWAM 的 91.2,带具身预训练的 LingBot-VA 92.2 仍居组内第一。
展示 JAM 在双臂、域随机化更强的基准上与基线持平或略升——本文的主要增益来自鲁棒性而非双边任务本身;同时诚实呈现与具身预训练系统约 0.8 点的差距。