混合计算机使用:面向通用智能体的程序化、语义与视觉统一交互界面 Hybrid Computer Use: A Unified Programmatic, Semantic, and Visual Interface for General Agents
统一代码、无障碍树与GUI三通道供模型自选,性能与效率双优
前置知识
计算机使用智能体(Computer-Use Agent)
一种通过操作真实软件来完成用户任务的 LLM 智能体:它截取屏幕截图作为观察,通过模拟鼠标点击、拖拽和键盘输入来执行动作,在“观察—思考—行动”循环中推进任务。主流实现(如各家 OSWorld 排行榜系统)完全依赖这条视觉-坐标通路,需要用视觉定位(grounding)技术把“点击提交按钮”这类指令换算成屏幕像素坐标。
本文的全部论点建立在对这条“人类式交互通路”的反思之上:理解它为什么低效(反复截屏、坐标定位、逐条动作),才能理解 HCU 为什么要引入程序化和语义通道来补充甚至替代它。
无障碍树(Accessibility Tree,AX)
操作系统为读屏器等辅助技术维护的结构化界面表示:每个控件是一个元素节点,带有角色(按钮/文本框/复选框)、名称、当前值、状态(是否选中/失效)和支持的操作(点击/设值等)。它把“界面上有什么、能做什么”以文本形式暴露出来,AT-SPI(Linux)、AXUIElement(macOS)、UIA3/Win32(Windows)是三大平台的具体实现。
AX 是本文“语义通道”的载体,也是相对于纯视觉方法的核心增益来源。文中 AX 工具的紧凑视图、目标引用、批量动作、AX diff 等设计全部围绕 AX 树的特性(覆盖不全、目标会漂移、调用不保证生效)展开。
模型上下文协议(Model Context Protocol,MCP)
一个开放标准,允许把外部工具以统一 schema 暴露给 LLM 应用:工具以服务器形式提供“观察/动作”接口,模型通过结构化调用(JSON 参数)使用它们,返回结果进入同一对话上下文。HCU 用 MCP 把 AX 和 GUI 两个桌面工具挂到 Codex、Claude Code、Gemini CLI、Grok Build 等现成 agent harness 上。
HCU 的“不训练模型、不加 planner,纯接口层增强”路线正是靠 MCP 实现的:理解 MCP 才能明白为什么同一接口可以即插即用地接到四种不同 harness 并做严格的同条件对比。
OSWorld 基准(1.0 与 2.0)
真实桌面环境中的计算机使用评测:OSWorld 1.0 包含 361 个日常桌面任务(LibreOffice、Chrome、GIMP、VLC 等),在 Linux 虚拟机里运行并用脚本检查最终状态打分;OSWorld 2.0(0808 release,108 任务)升级为长程专业工作流,计分分 Partial(平均任务分 $Q_{\text{mean}}=\frac{100}{N}\sum_i s_i$)和 Binary(满分率)。
它是本文的主战场:论文报告的 Partial/Binary/成本等指标都与该基准绑定,且与官方排行榜、StateAct、CUA Driver 等已报告结果直接对比,不熟悉计分方式就无法解读那些 72.37%、35.19% 的数字。
陈旧状态问题(Stale State)与动作守卫
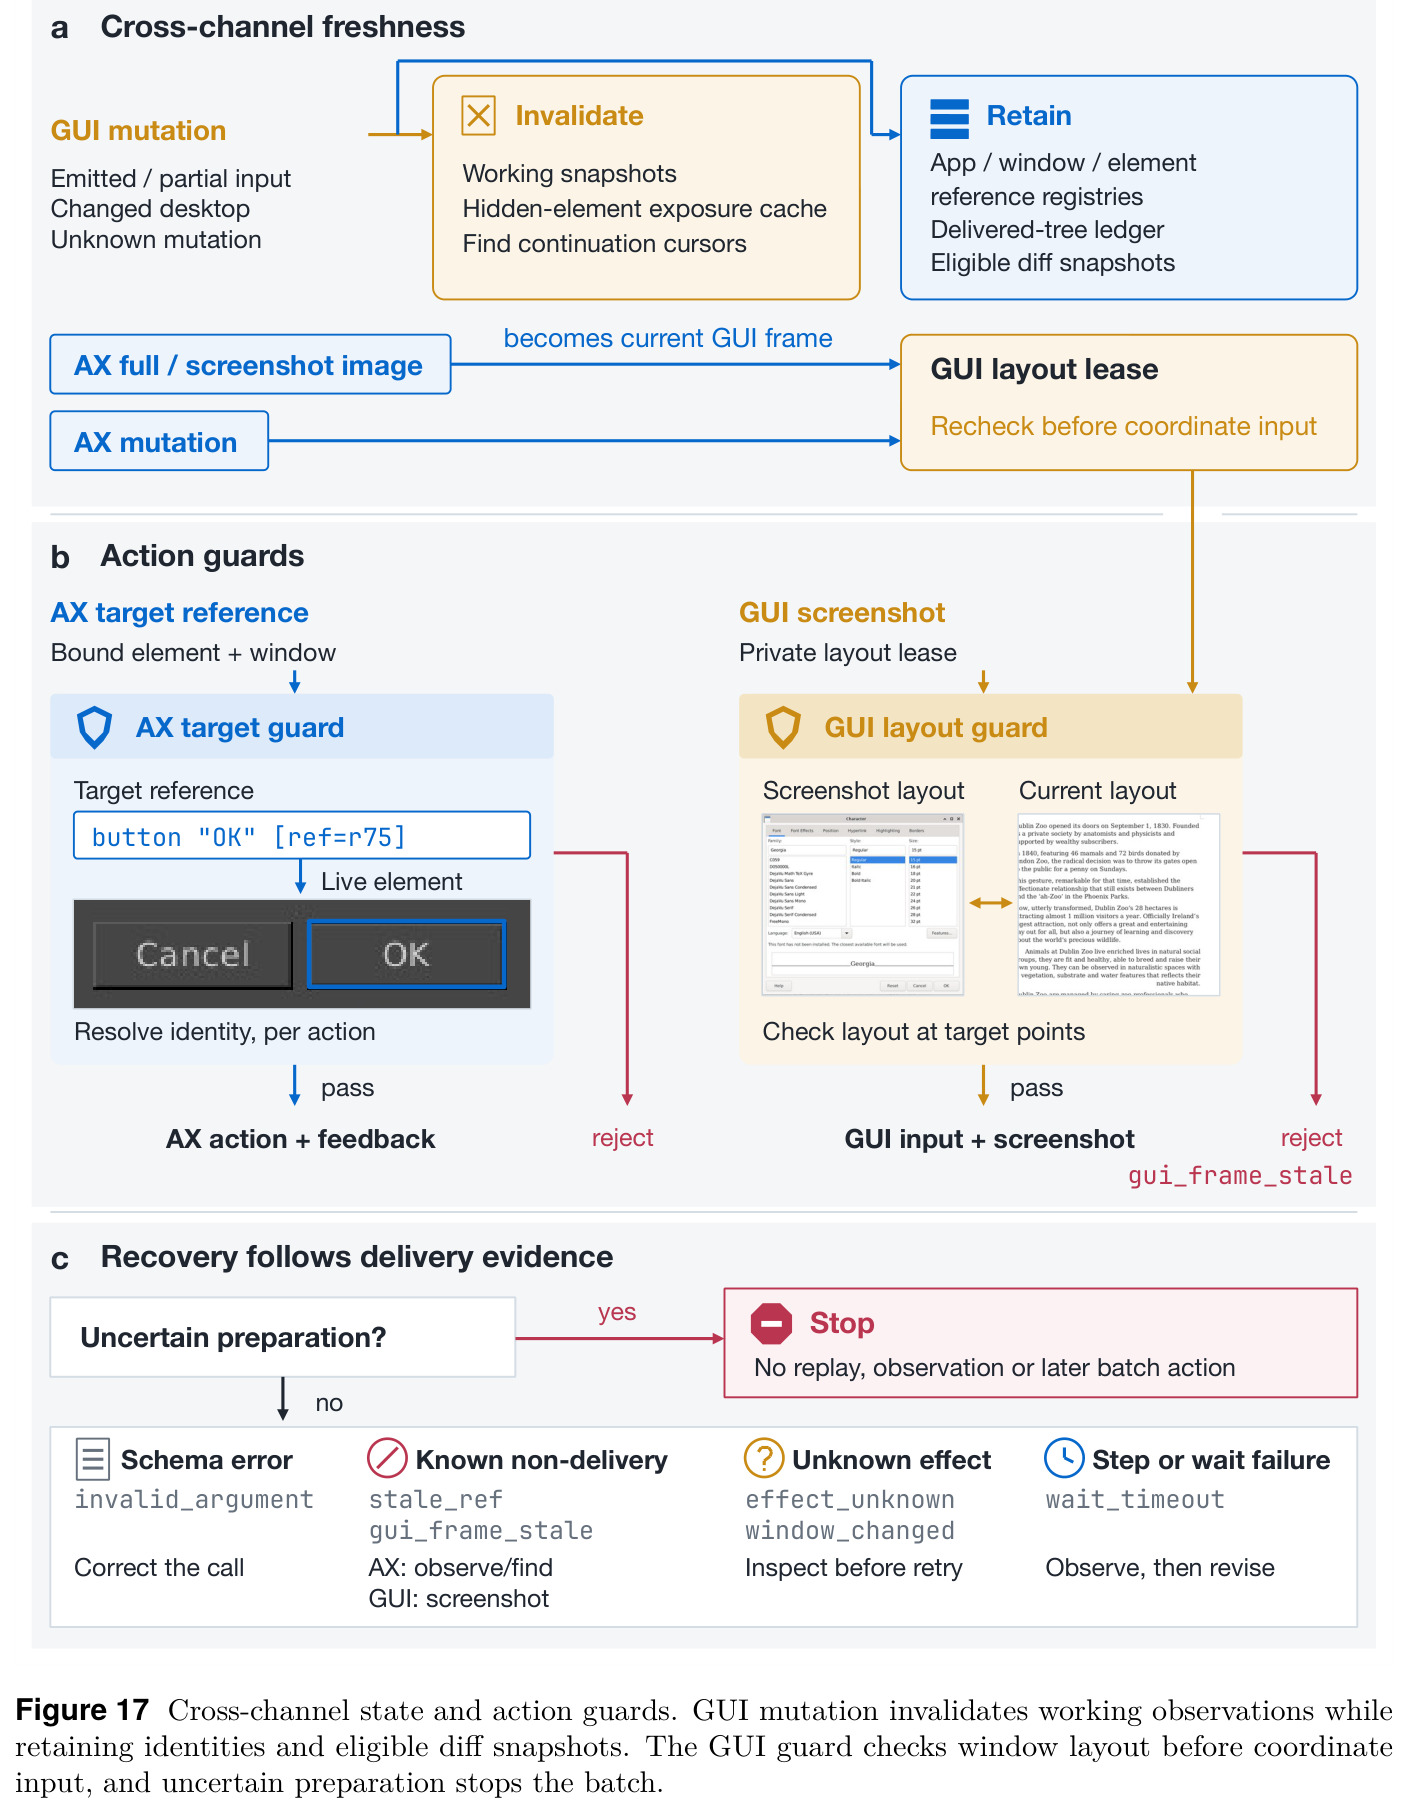
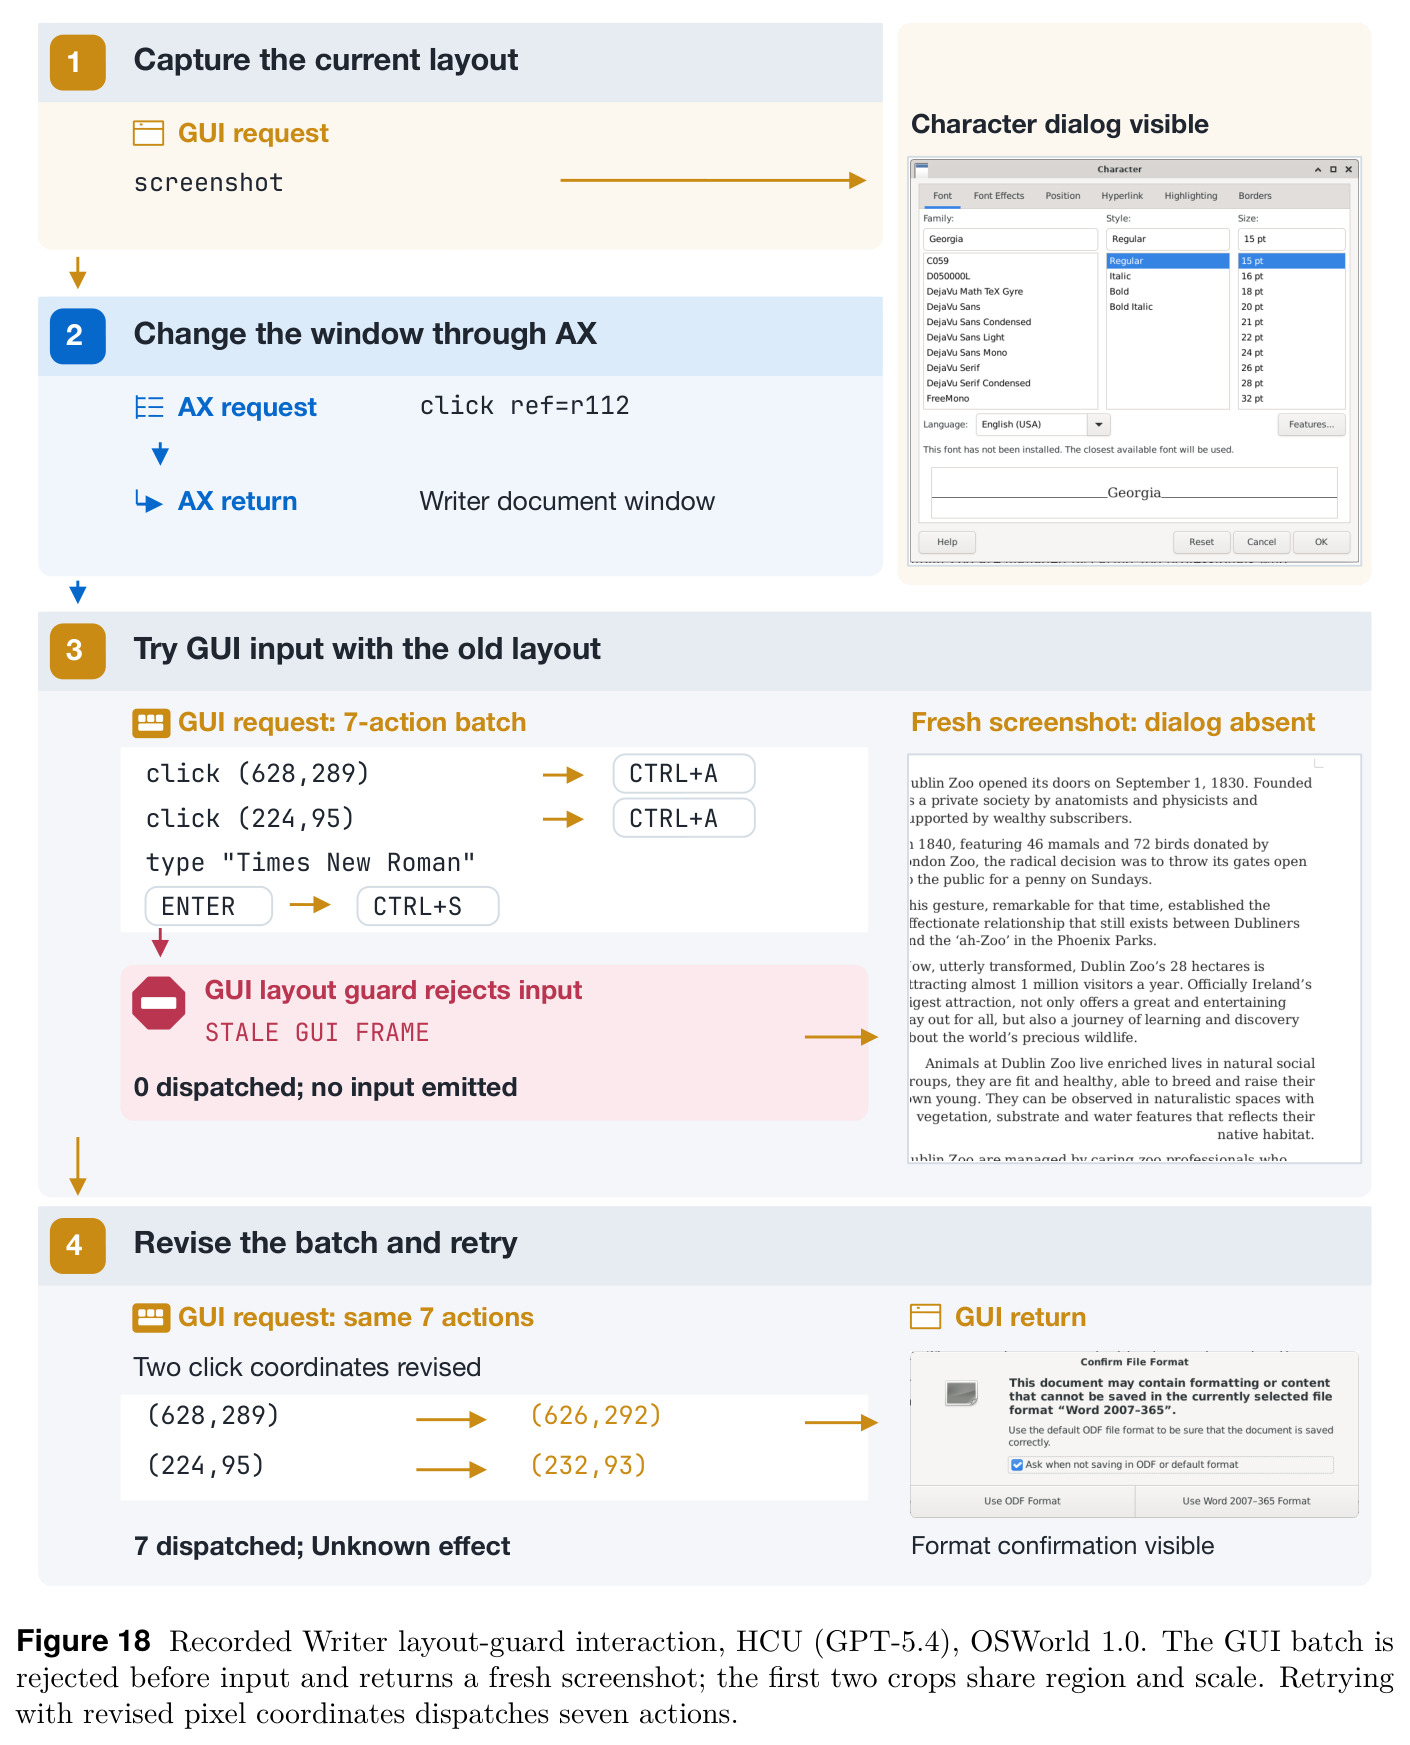
智能体看到的是离散的工具输出(某时刻的截图或 AX 树),而非桌面的连续视图。一旦某个动作改变了桌面(弹出新对话框、替换控件),先前观察中的坐标或元素引用就可能失效,继续使用会把输入送错目标。守卫指在每次输入前对照实时状态重新校验:AX 引用要解析到身份一致的活元素,GUI 坐标要求窗口布局与截图时一致。
这是 HCU 允许模型在三个通道间自由切换的前提——通道越多、陈旧风险越大。论文的跨通道动作守卫(AX target guard 与 GUI layout guard)是保证混合接口安全性的关键机制。
研究动机
现有计算机使用智能体的界面几乎都在模仿人类的操作方式:截屏、用视觉定位找到控件、再发鼠标键盘动作。这给前沿 LLM 强加了“人类交互先验”,带来两类具体浪费:其一,应用明明通过无障碍数据暴露了某字段的身份和值,agent 却要靠反复解释屏幕像素去精确定位它;其二,一段代码就能直接批量处理的数据,agent 却要通过连续的点击-拖拽完成。随着任务从 OSWorld 1.0 的日常桌面操作扩展到 OSWorld 2.0 的长程专业工作流(108 个全量任务,500 步限制,Claude Opus 5 官方配置平均每任务 113.95 分钟、$28.43),智能体必须在几十上百次操作中维持进度,交互效率与任务成功率变得同等重要。论文的对照数据很直观:同底座模型下,只走“截图+鼠标键盘”计算机使用循环的方法(Claude Opus 5 官方成绩 68.31% Partial、$28.43/任务)明显落后于能利用系统其他通道的方法,说明人类式界面对性能与成本都是负担。
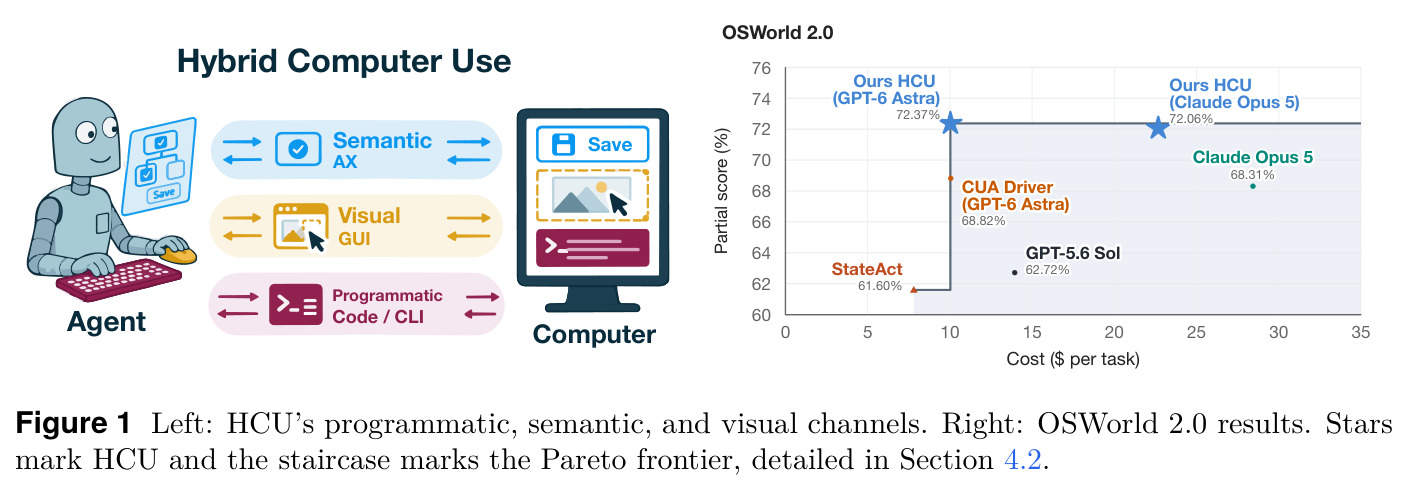
本文的目标是本文的目标是构建 HCU(Hybrid Computer Use):一个面向通用智能体的统一计算机交互界面,把现代计算机已有的三类互补通道同时暴露给模型——程序化通道(agent 自带的代码、Shell、文件工具)、语义通道(无障碍 AX 树的读写)、视觉通道(GUI 截图与鼠标键盘输入),并让模型自主选择和组合,而非由系统硬性规定分工。具体工程目标有三:一是设计“执行为中心”的 AX 工具(紧凑观察视图、单次调用批量执行动作并可插入等待步骤、动作后默认返回 AX diff 反馈),减少观察-行动往返次数;二是用跨通道动作守卫防止通道切换时的陈旧状态误操作,例如对着过期截图的坐标点击或点击已被替换的 AX 引用;三是附带一份 HCU skill,从开发轨迹中的高频错误蒸馏使用规则,指导模型遵守调用与反馈契约。最终评估目标是:不训练模型、不添加 planner 或子智能体,仅在接口层面取得 OSWorld 2.0 对比系统中最高的 Partial 与 Binary 成绩,并在多个基准、多个底座模型上同时改善性能与效率(步数、token、时间、成本)。
与已有工作不同的是,已有工作只走了这条路的若干片段。纯视觉路线(OSWorld set-of-marks 及多数排行榜系统)只优化截图循环;混合路线中,ALE 与 WeaveBench 的 GUI-as-tool 把截图和鼠标键盘作为工具与程序化工具并列,但没有语义通道;CoAct-1 与 StateAct 构建编排器/子智能体的分层委派系统;UFO2 组合 UI Automation 与应用 API;Tactile 在语义动作旁配 OCR 与视觉回退;CUA Driver 虽支持全部三通道,却奉行 best-effort 后台输入优先保护用户当前桌面,并把动作验证与重新观察拆成独立操作。HCU 的独特切入在于三点:三通道在同一通用 agent 的上下文中平权并列、通道选择完全交给模型;AX 被重新设计为执行中心接口——目标引用在视图压缩前绑定、批内 wait 步骤完成状态验证、默认 AX diff 免除单独观察调用;再以跨通道守卫和蒸馏 skill 保障可靠性。作者把这一立场上升到“苦涩教训”:把人类使用方式强加给越来越强的模型,会限制模型本可发挥的能力。
核心方法
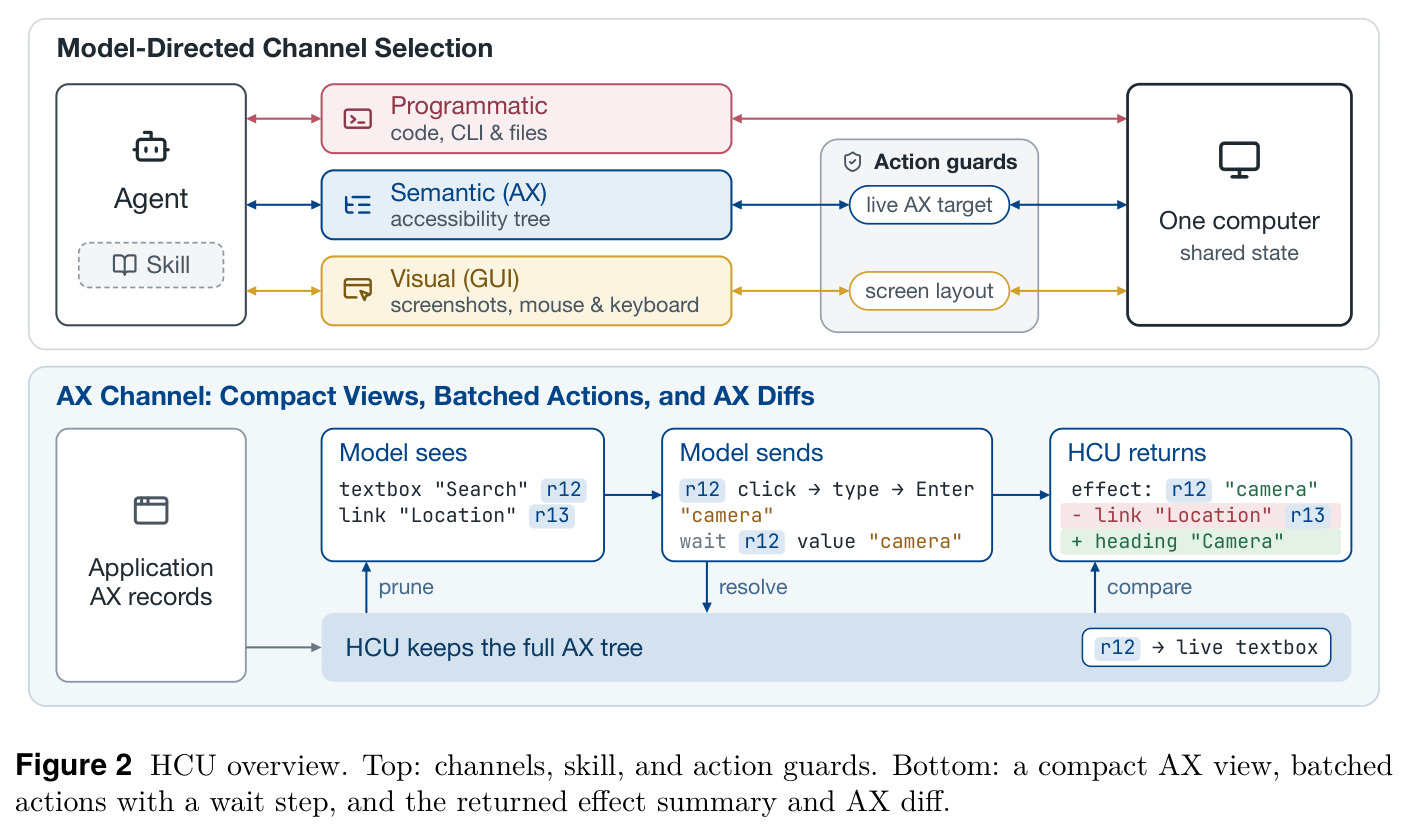
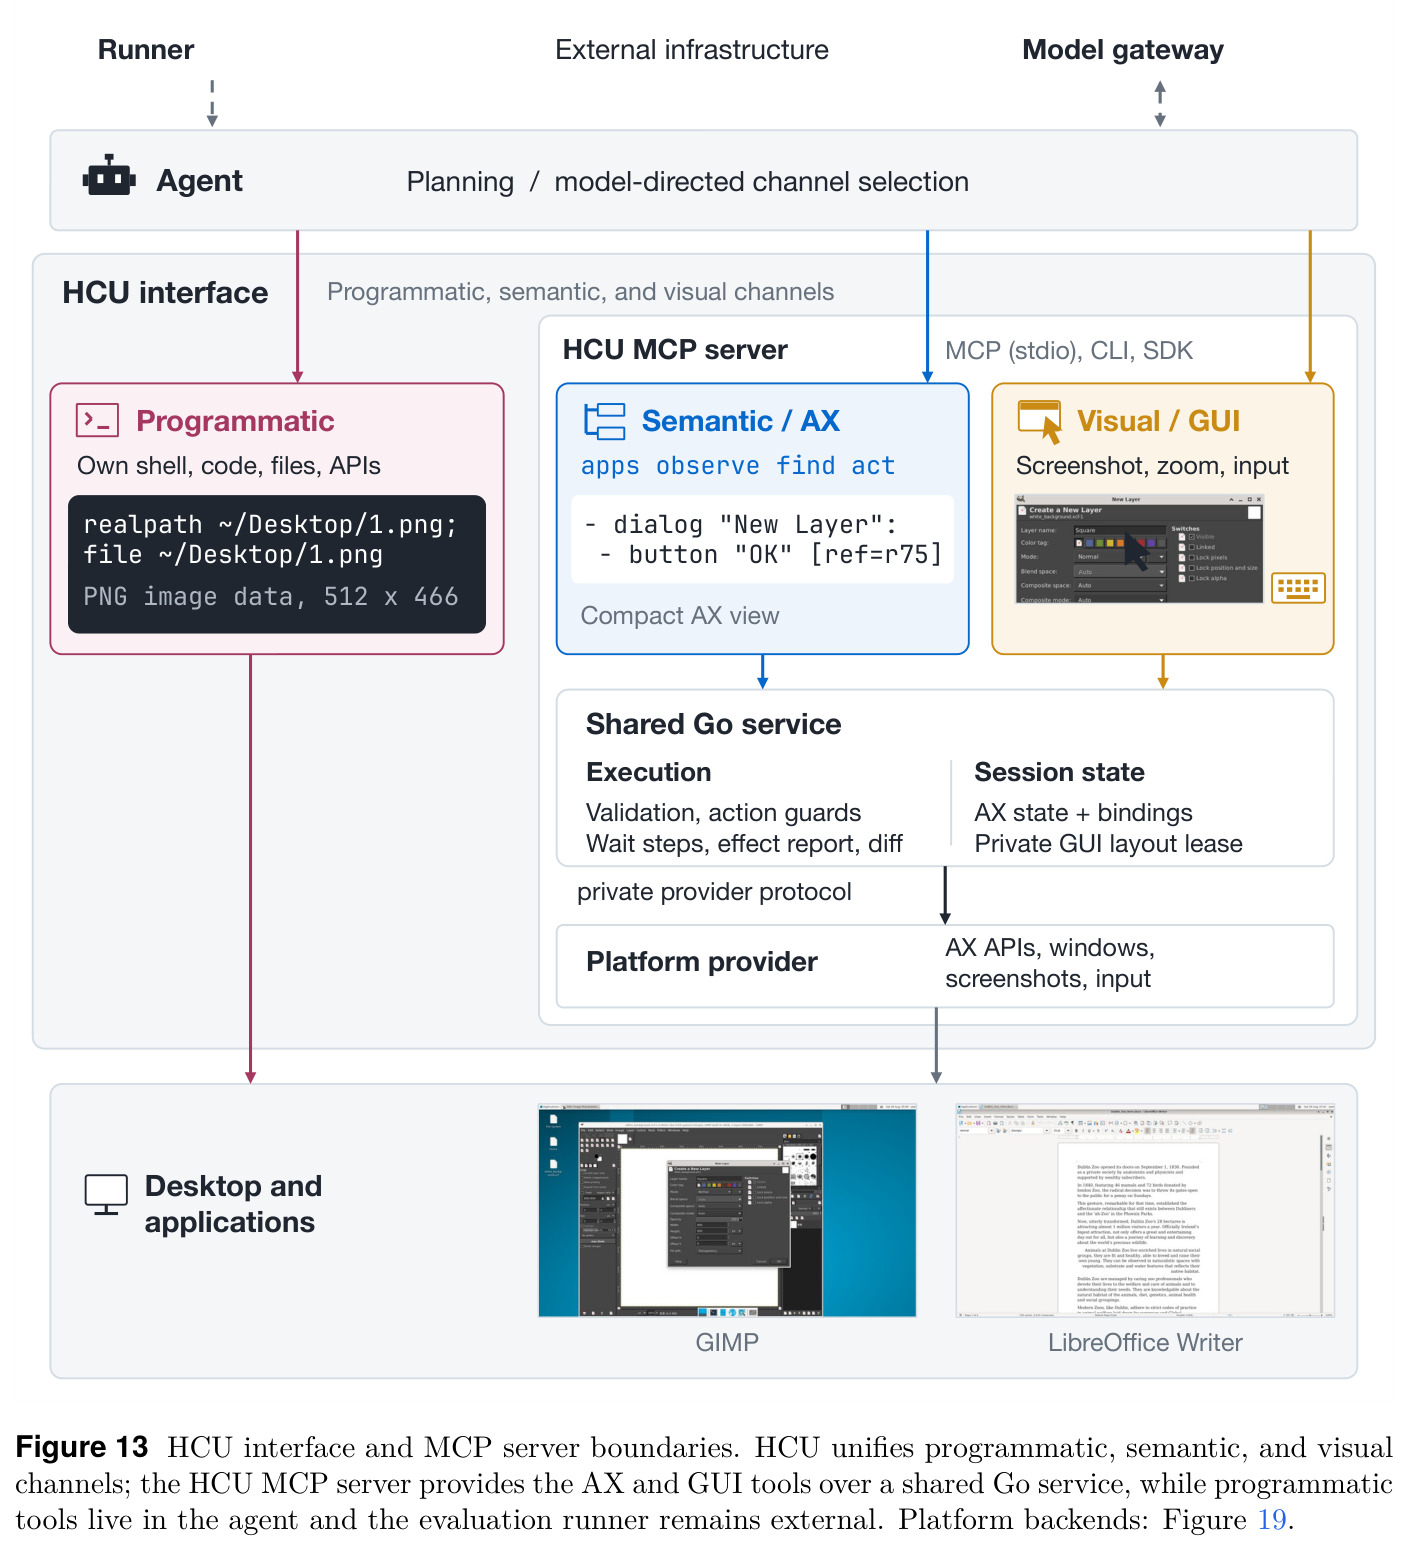
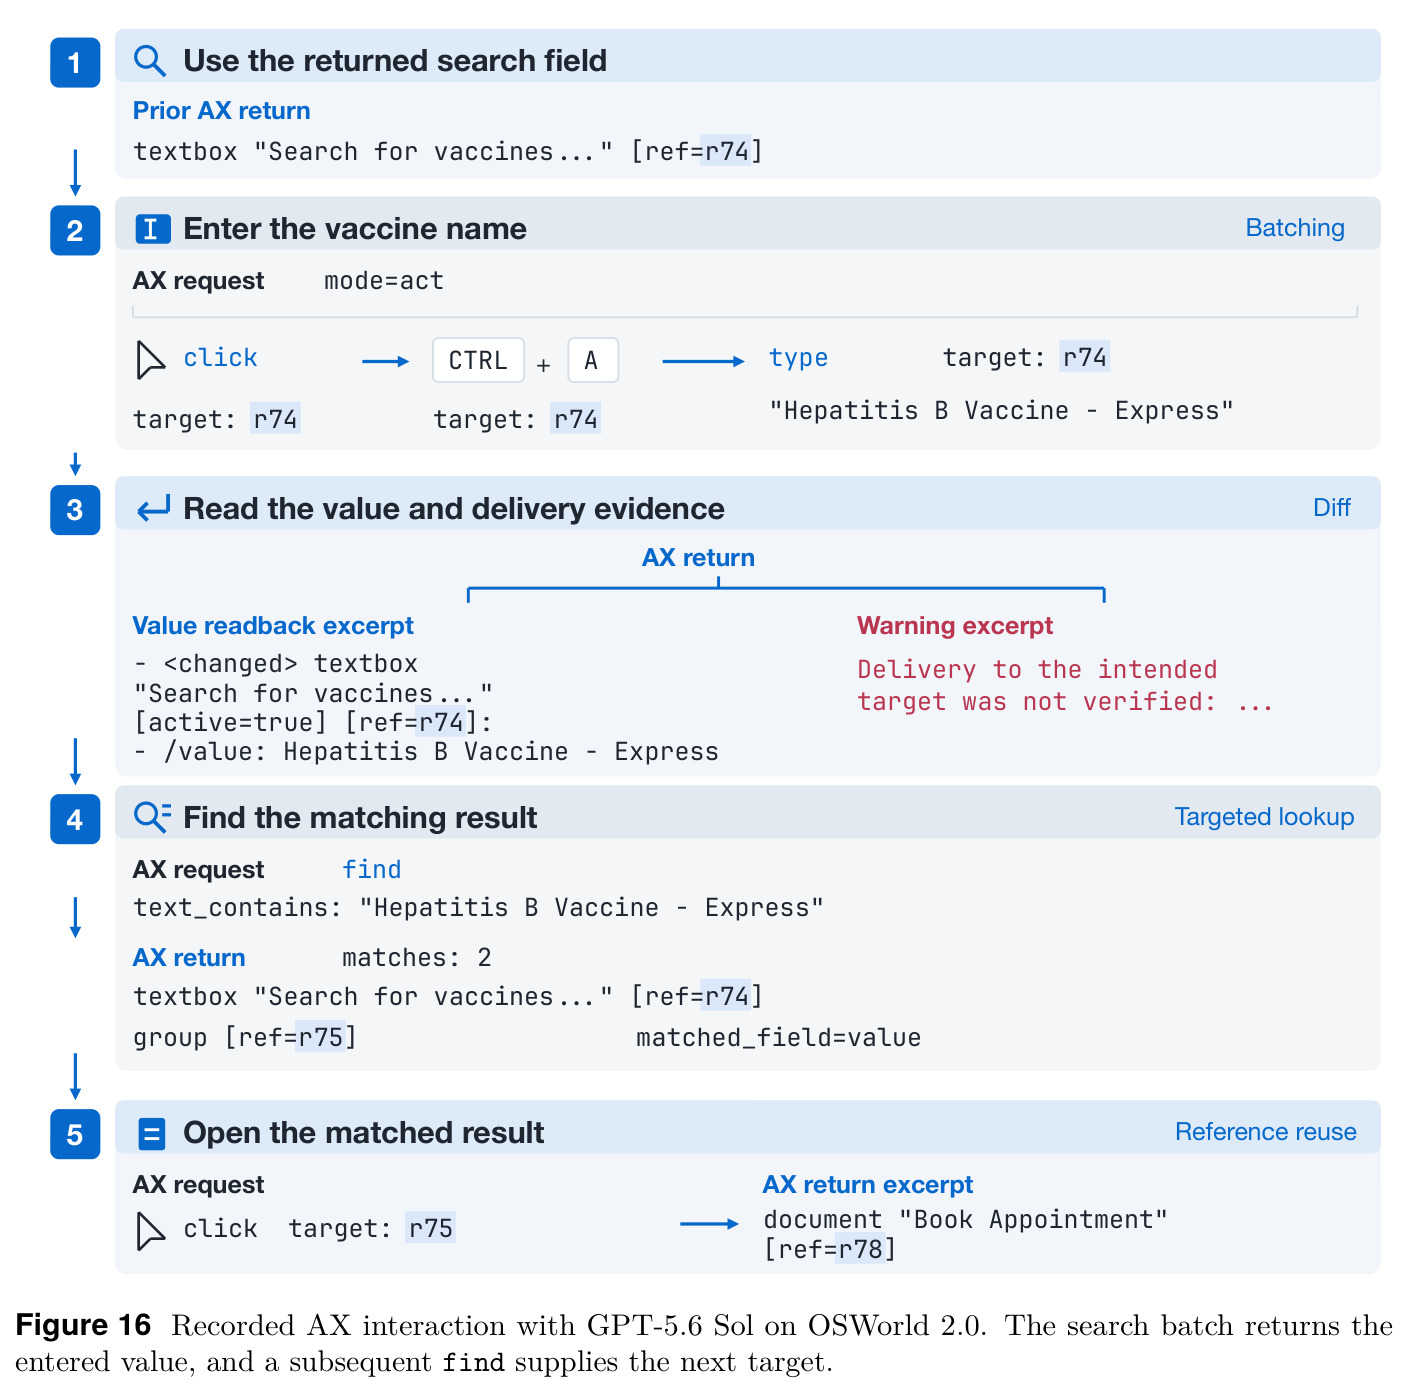
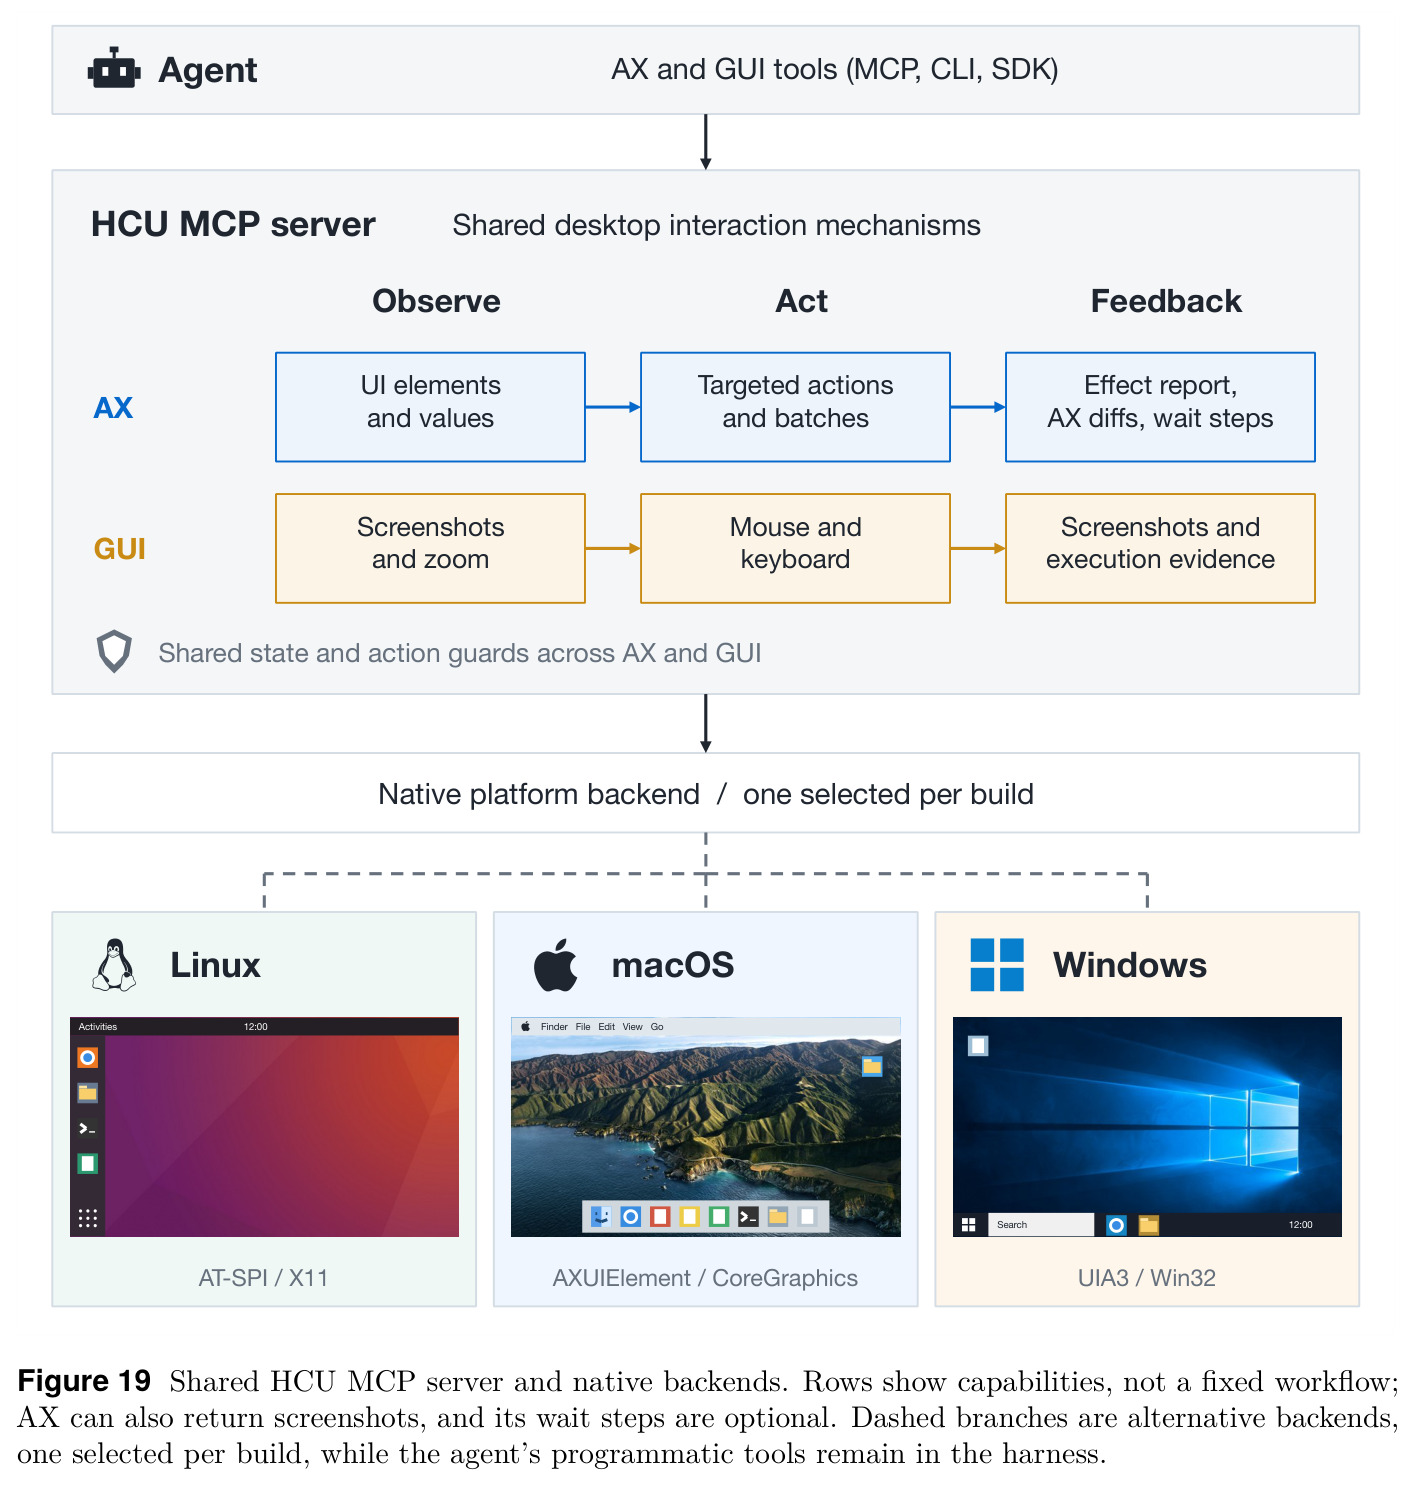
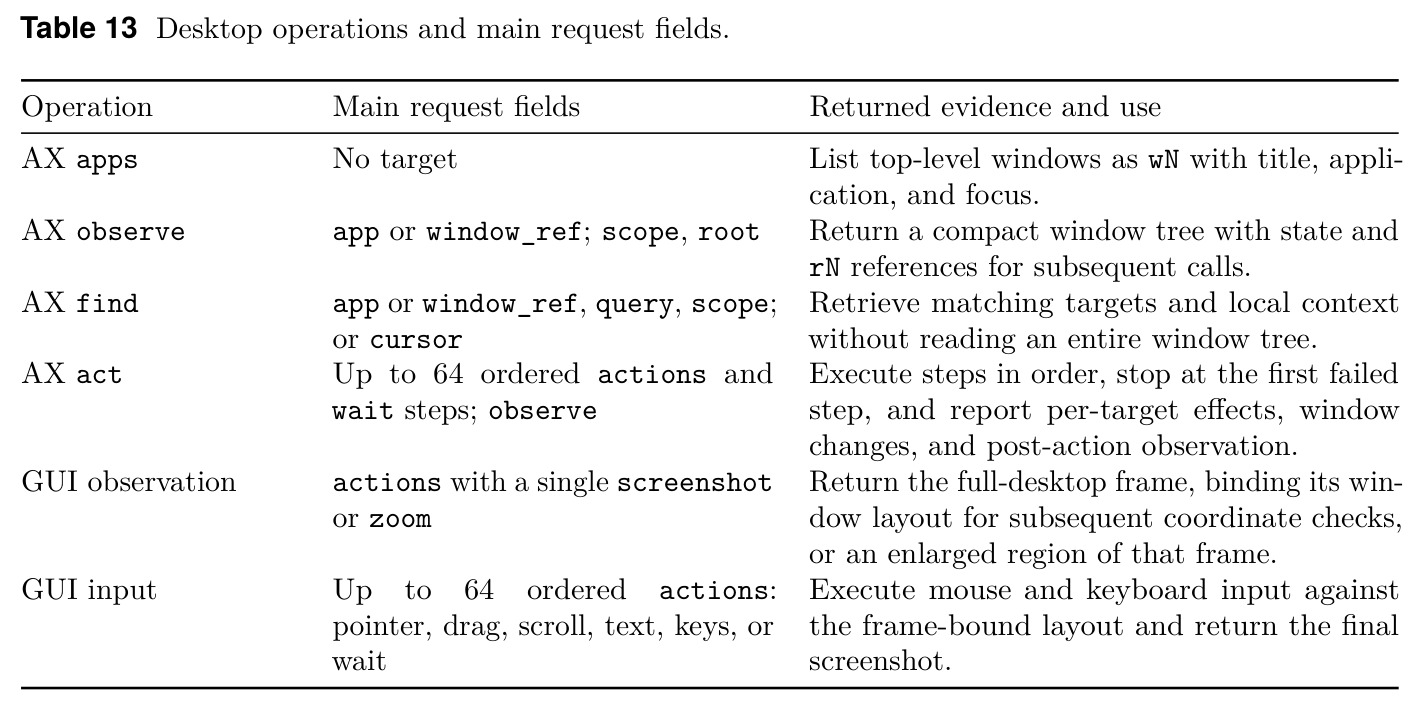
直觉:让智能体像熟悉系统的工程师操作电脑,而非模仿普通用户——结构化数据写脚本、命名控件走无障碍、画布拖拽才动鼠标。技术上,HCU 不改 agent 的观察-行动循环,只经 MCP 附加两个桌面工具:AX 工具(apps/observe/find/act,返回带 $r_N$ 引用的紧凑控件树并执行引用寻址动作)与 GUI 工具(截图/zoom 与最多 64 步有序鼠标键盘输入);程序化工具(shell、代码、文件)留在 harness 内。三通道作用于同一台电脑,共享状态由一个 Go 服务维护(AX 快照、引用注册表、find 游标、GUI 布局租约),平台后端为 Linux 的 AT-SPI/X11、macOS 的 AXUIElement、Windows 的 UIA3/Win32。每次动作前由守卫对照实时状态校验,动作后默认返回效果摘要与 AX diff;一份 skill 文本指导通道选择与错误恢复。系统无自有 planner,可原样挂到 Codex、Claude Code、Gemini CLI、Grok Build。
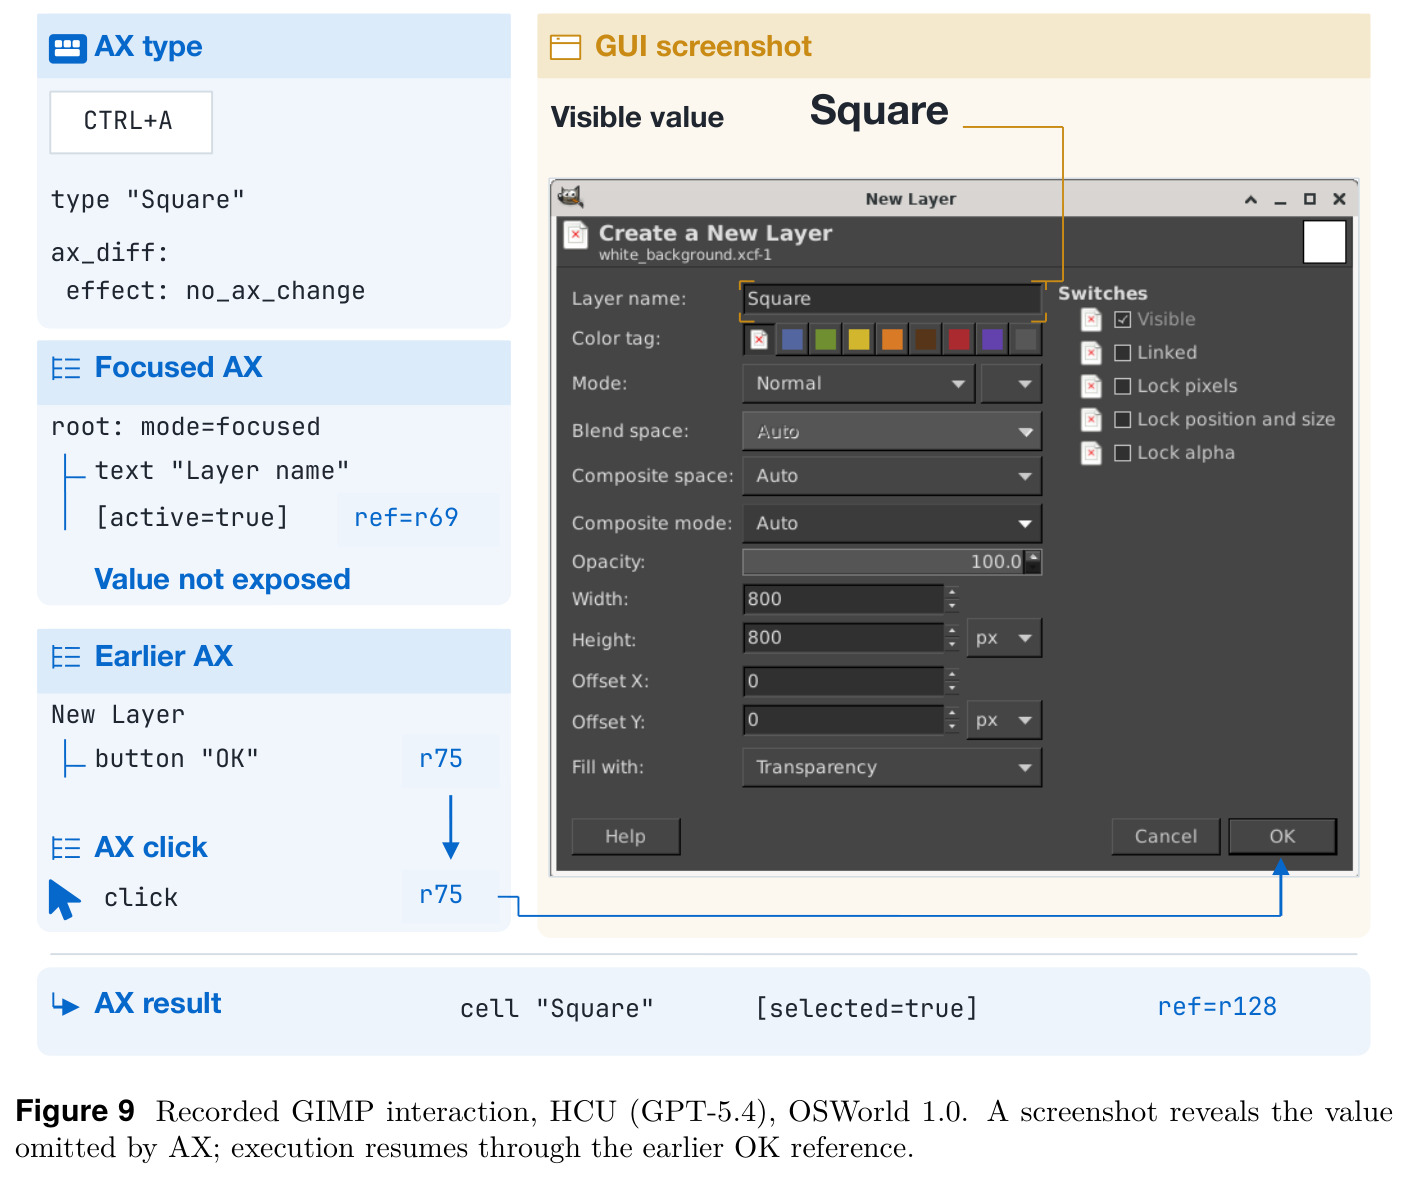
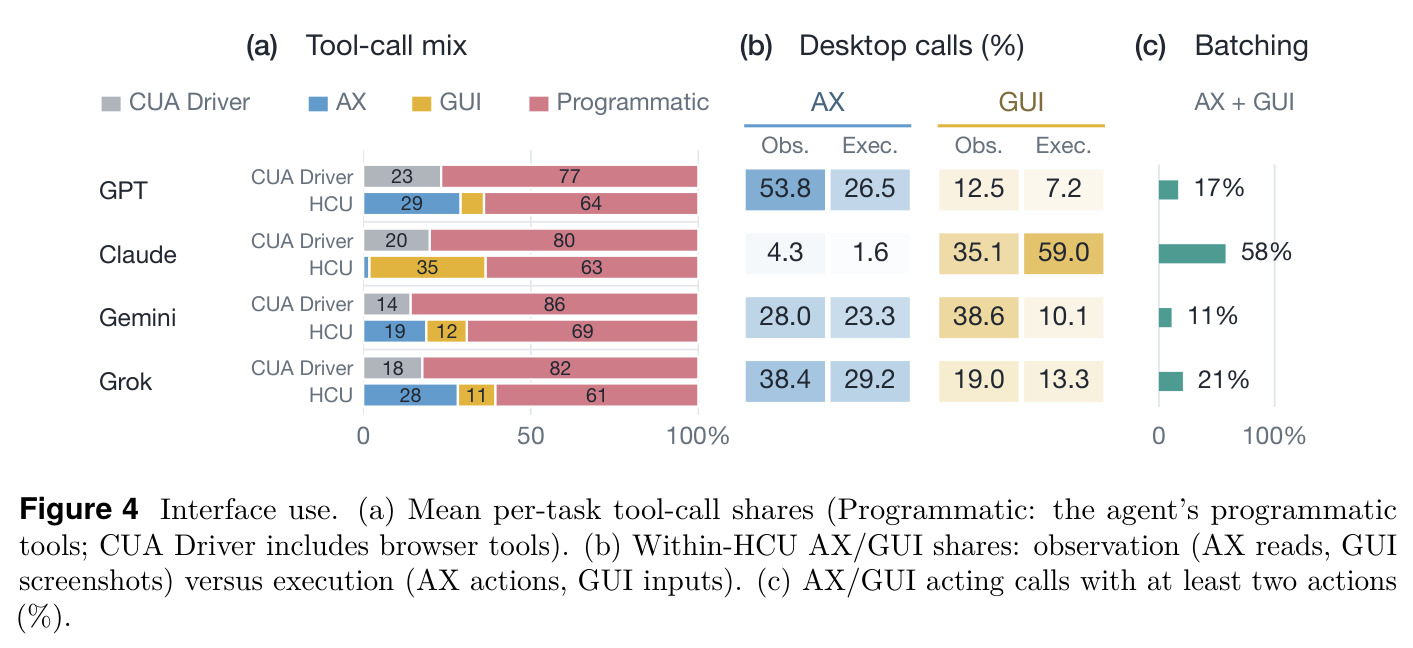
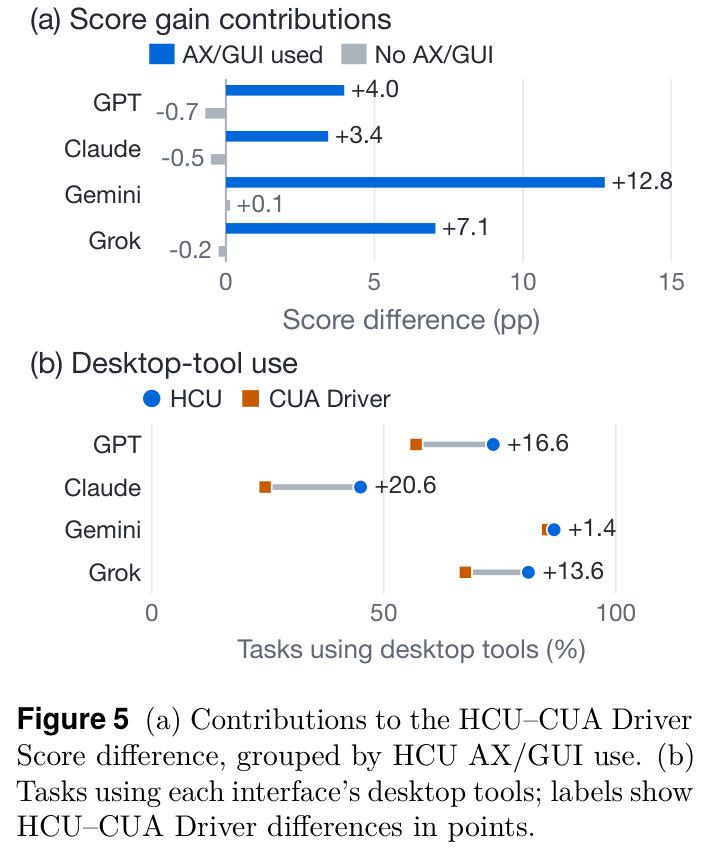
核心创新有三点。第一,语义通道一等公民化与“模型主导选择”:不同于 OSWorld 早期仅用 AX 定位再映射坐标,也不同于 CUA Driver 的 AX 优先后台策略,HCU 让模型每次决策自由选择观察与执行通道;轨迹显示 GPT/Gemini/Grok 在约 29–31% 的 GUI 任务上只截屏、动作全走 AX。第二,执行为中心的 AX 设计:一次 act 调用组合最多 64 个有序动作与可选 wait 步骤,每个目标输入前由 target guard 对照活元素校验身份,失败即停并报告进度;调用默认返回逐目标 effect(如 r12 checkbox false→true)与结构化 AX diff,免除单独观察调用——与 CUA Driver 把验证和重新观察拆成独立操作形成本质区别。第三,跨通道守卫:GUI 坐标输入前,layout guard 把桌面边界、顶层窗口、叠放次序、活动窗口与目标点布局,与截图绑定的布局租约逐项比对,不匹配即零输入拒绝并回传新截图,杜绝“对着过期截图点击”。
方法步骤详情
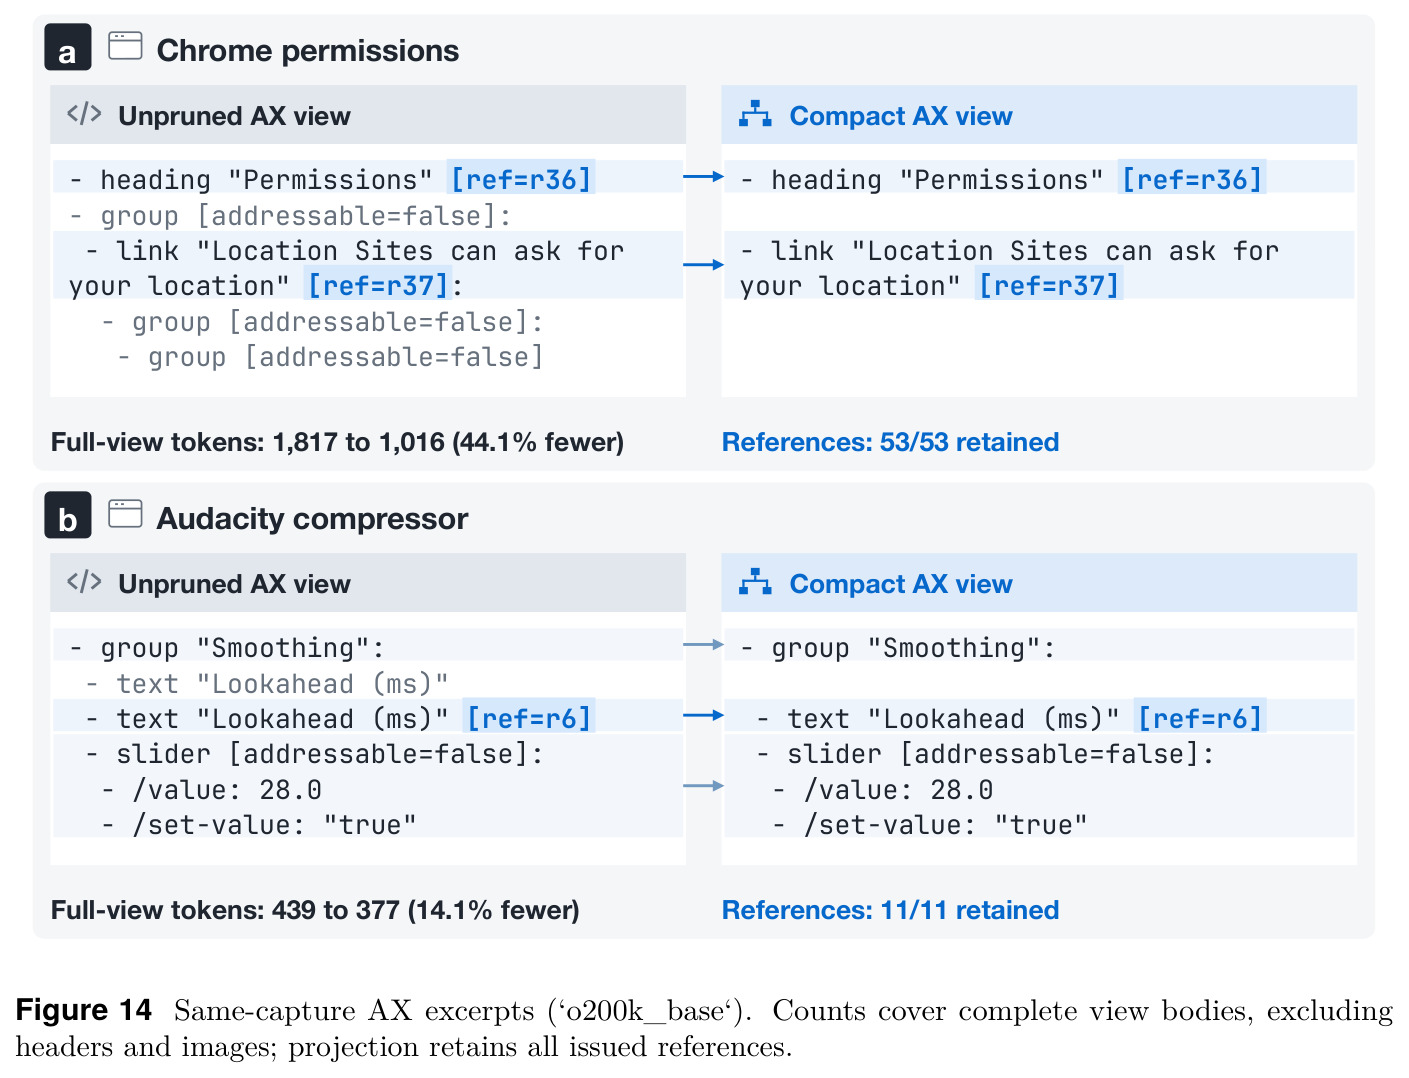
第一步,模型选观察通道:读文件跑命令(程序化)、AX observe(返回带 $r_N$ 引用的紧凑树,find 可按查询检索)或 GUI screenshot(绑定布局租约)。第二步,目标引用在视图投影压缩前绑定到真实元素,裁剪显示不改变指向,被裁剪子树仍可 find 检索;投影可省约四成 token 且引用全保留(Chrome 视图 1817→1016)。第三步,批量执行:act 调用含最多 64 步有序动作与 wait 步骤(等窗口、元素值或 UI 稳定),每步前 target guard 解析引用校验身份,任一步失败、超时或窗口变化即停并报告进度;wait 放批末可验证终态。第四步,反馈:默认返回逐目标 effect(如 r12 checkbox false→true)、windows 行与相对上次快照的 AX diff;错误带 JSON evidence 行、公共错误码(如 stale_ref、wait_timeout)与 input_emitted 标志。第五步,GUI 坐标输入前 layout guard 比对布局租约,失败零输入拒绝并附新截图。第六步,skill 指导按“状态在哪里就改哪里”路由并按错误码恢复。
技术新颖性
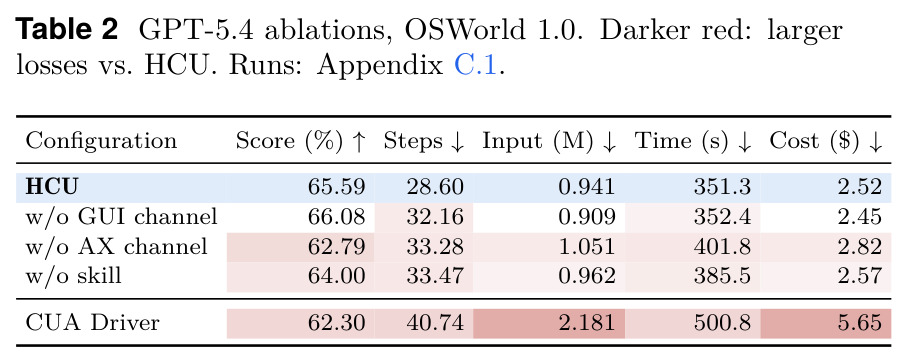
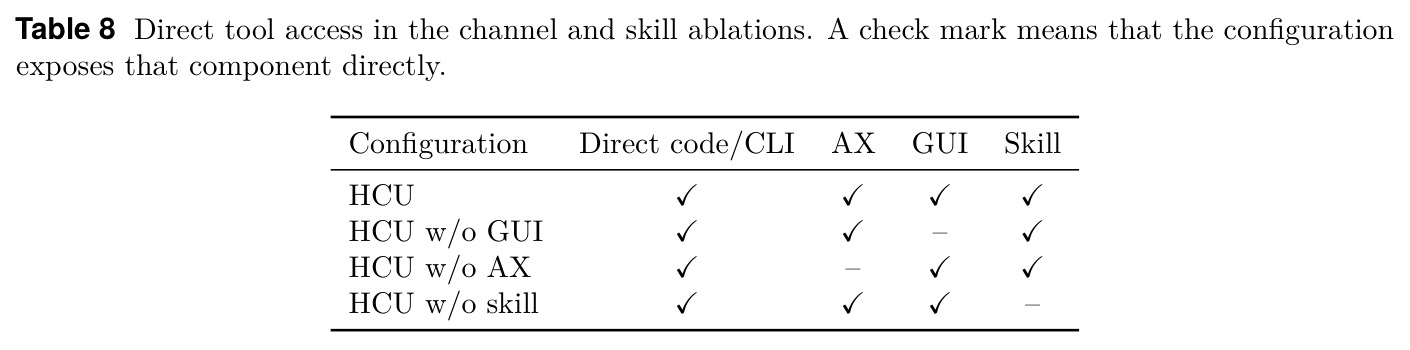
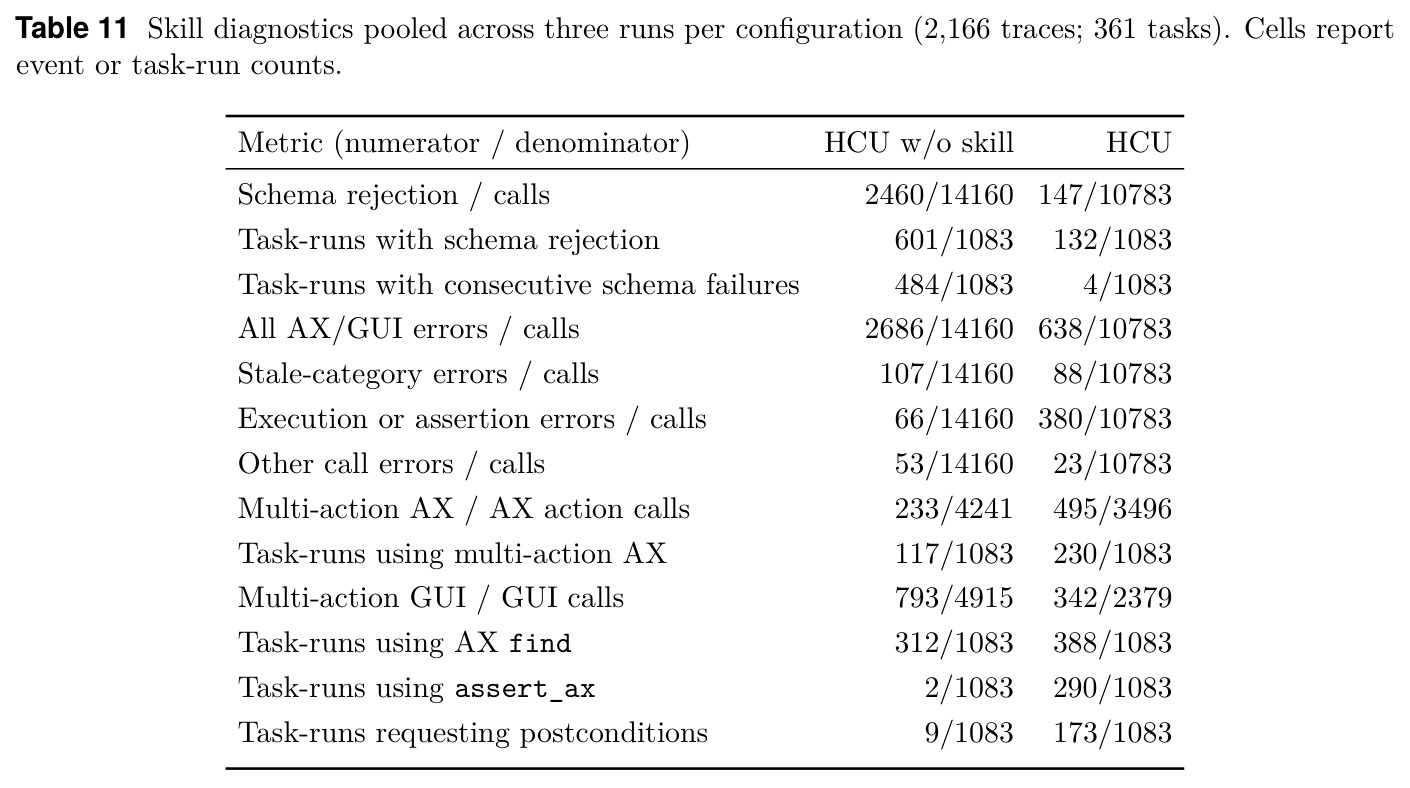
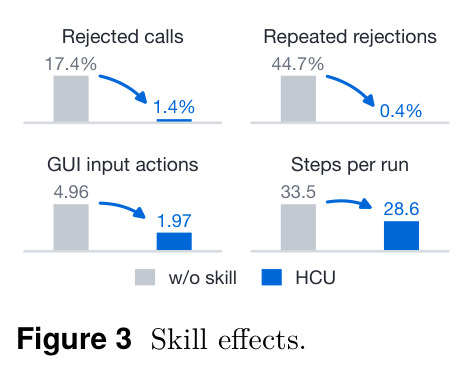
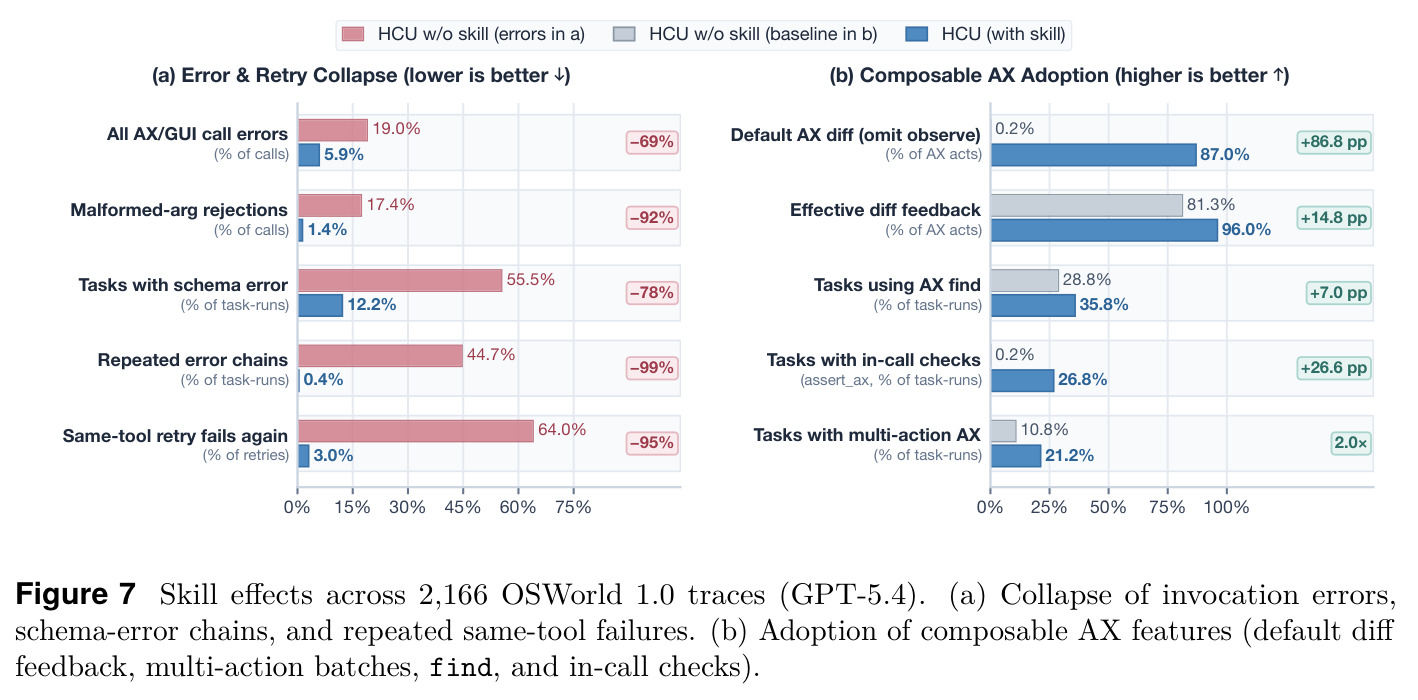
与最接近系统逐项对比:对 CUA Driver(同支持三通道的主要基线),HCU 放弃 best-effort 后台输入优先策略、改为优先完成任务,把守卫、等待、反馈内嵌进 act 调用而非拆成独立操作,目标引用独立于显示视图绑定并逐动作实时解析、不依赖刷新索引;对 Playwright MCP,HCU 把浏览器式 AX 快照+引用推广到桌面,并新增批内 wait 与 AX diff 后验反馈;对 StateAct/CoAct-1 的分层委派,HCU 不设 planner、子智能体或自有循环,通道选择全在模型一次工具调用内完成,故可零成本接入四种 harness;对 UFO2/Tactile,HCU 的视图压缩与引用绑定解耦,同捕获统计证明收益(Obsidian 对官方 XML 从 30526 降至 1237 token)。消融拆分贡献:AX 贡献最大(Score +2.79pp、Steps −14.08%、成本 −10.64%),GUI 主要省步数(−12.45%),skill 把畸形参数拒绝率 17.37%→1.36%、重复错误链 44.69%→0.37%。
实验结果
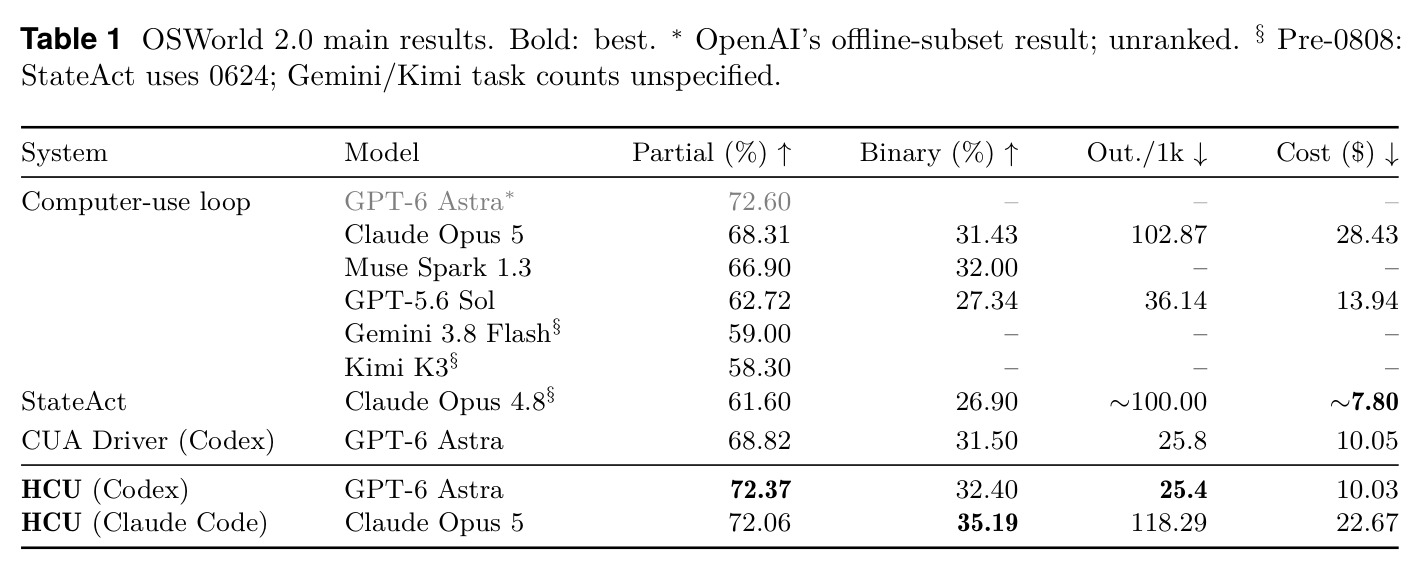
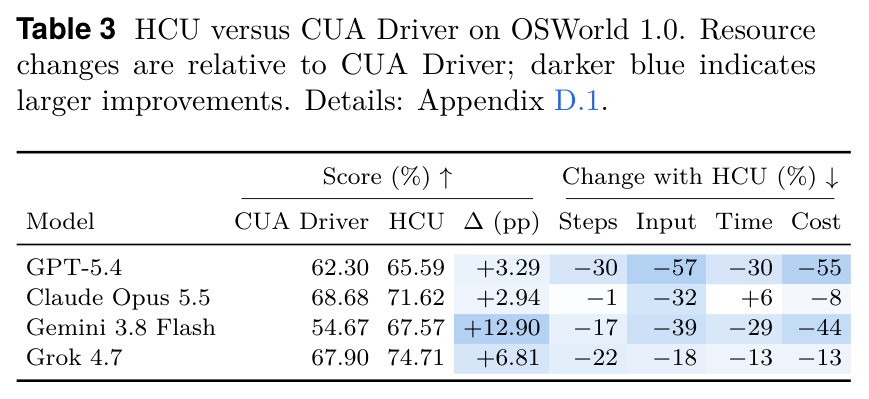
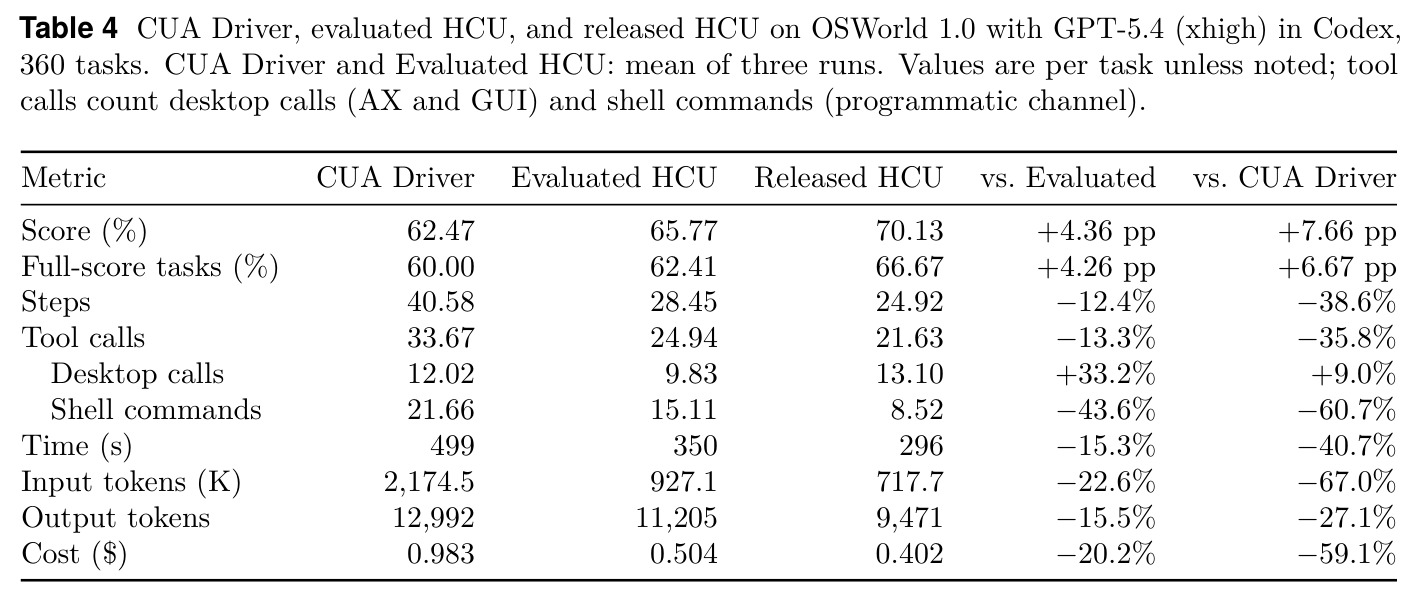
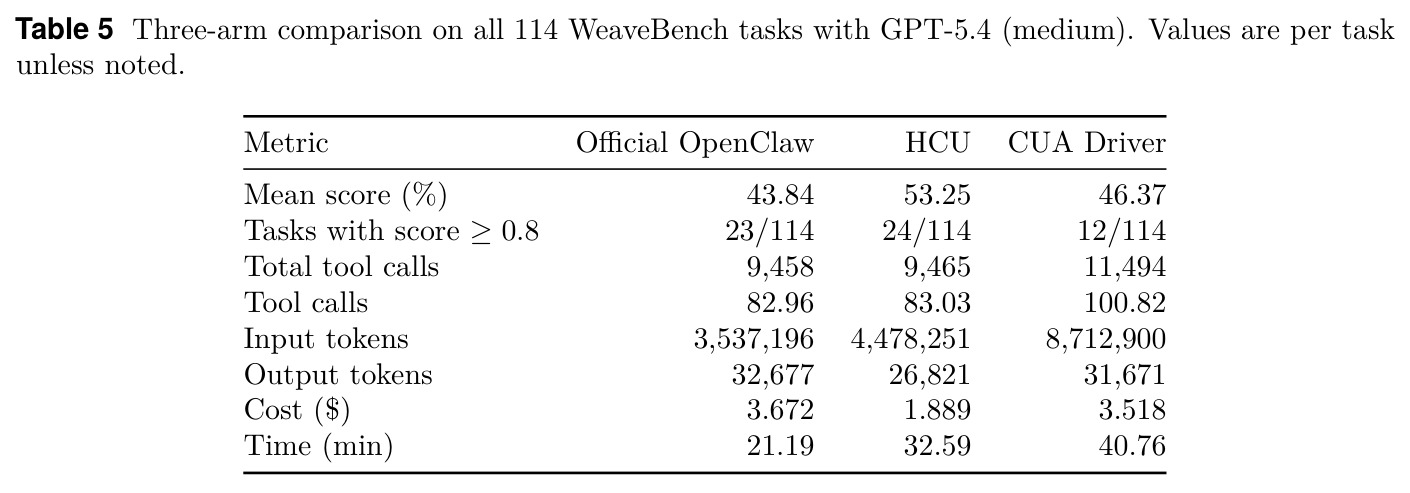
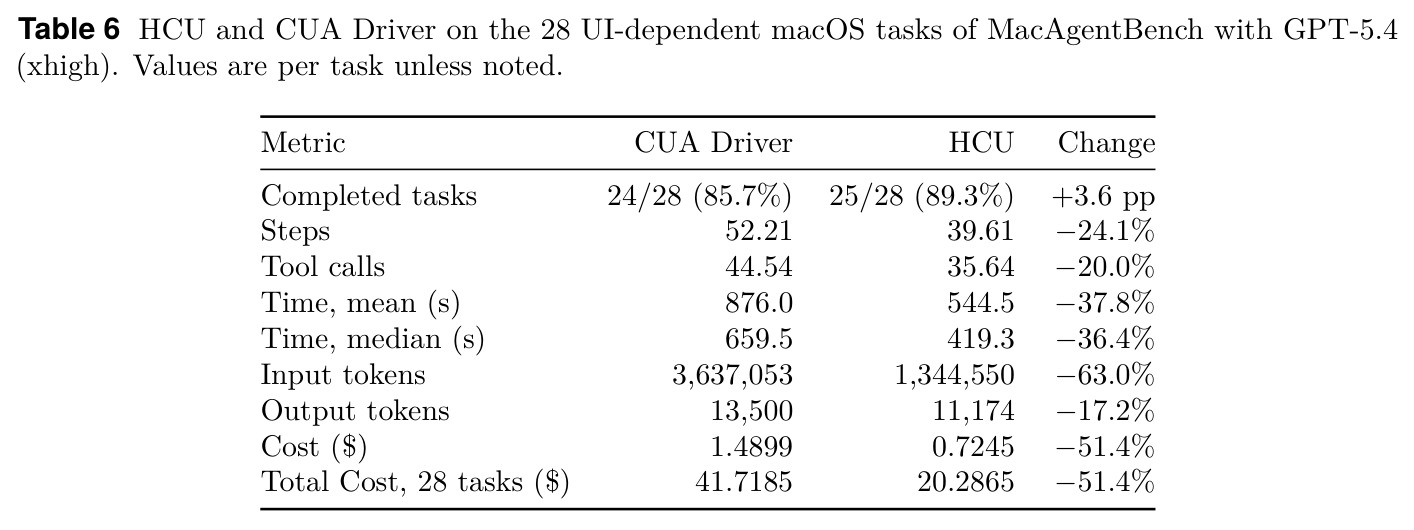
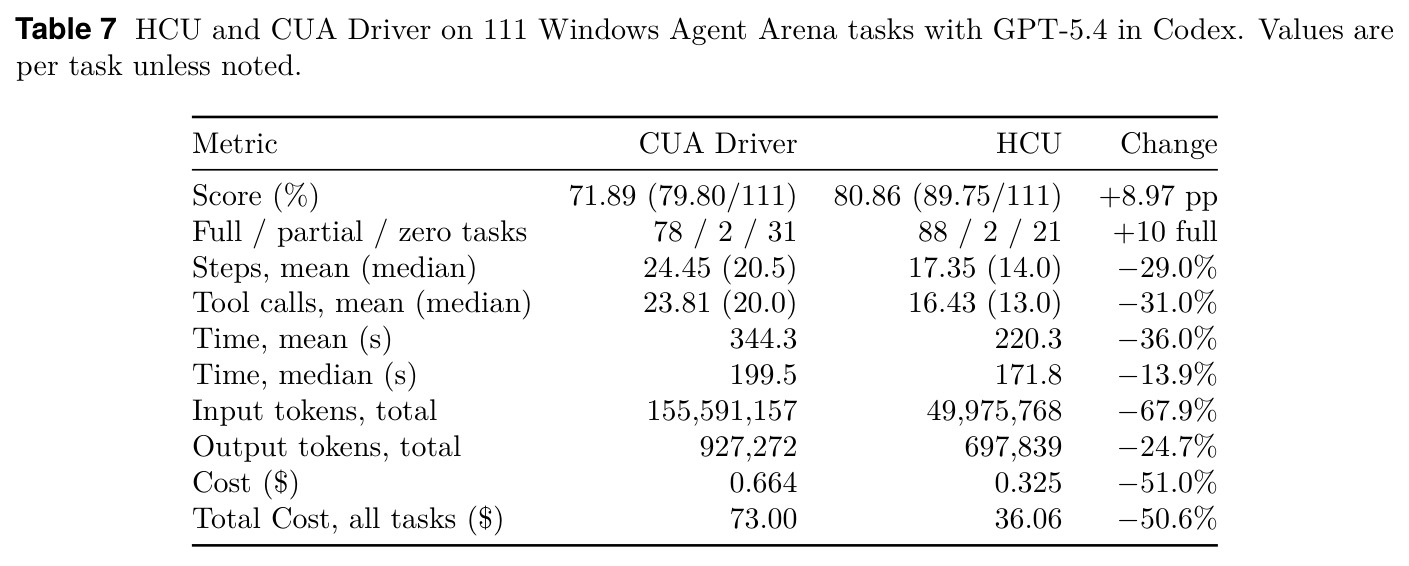
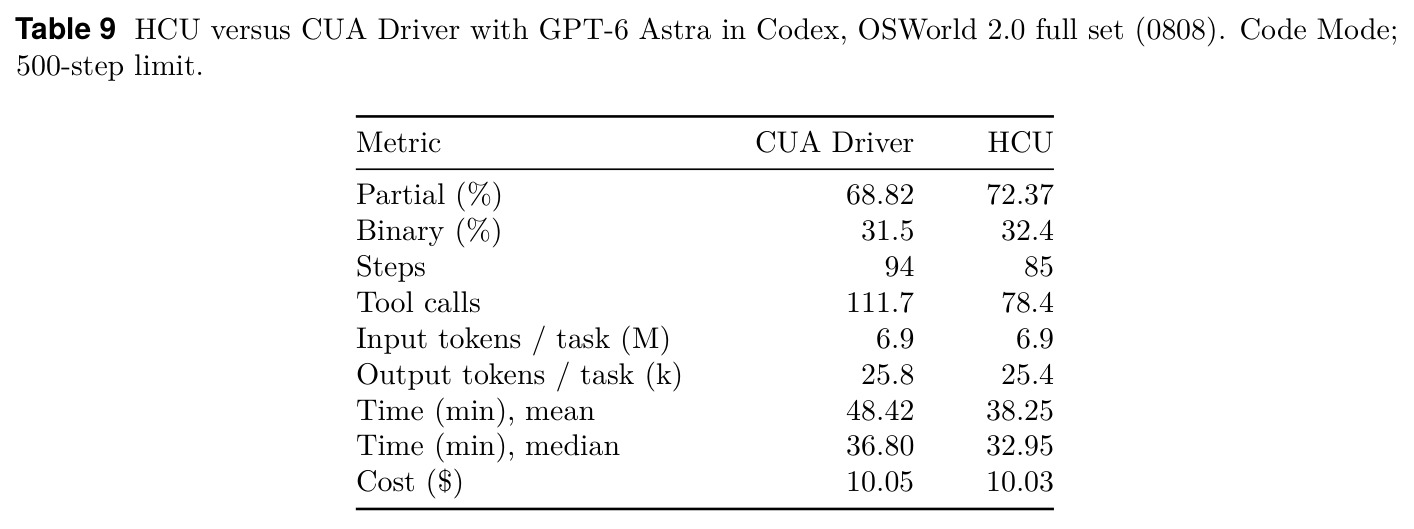
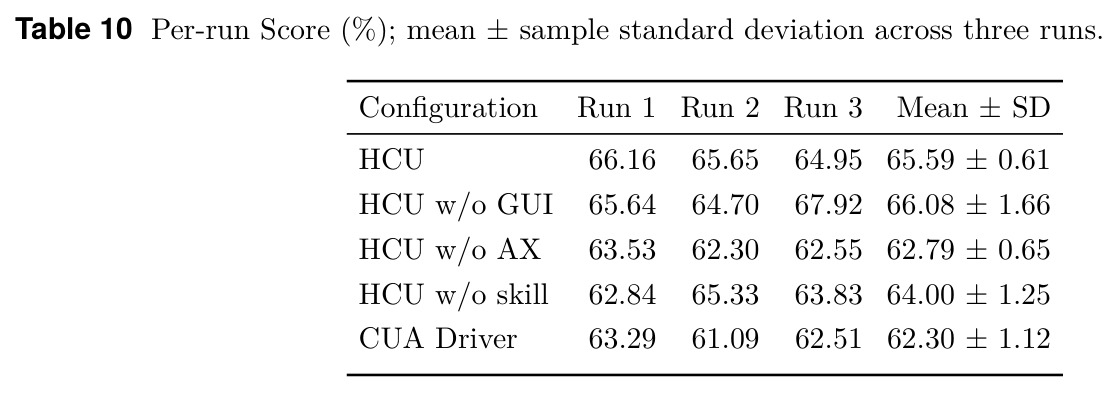
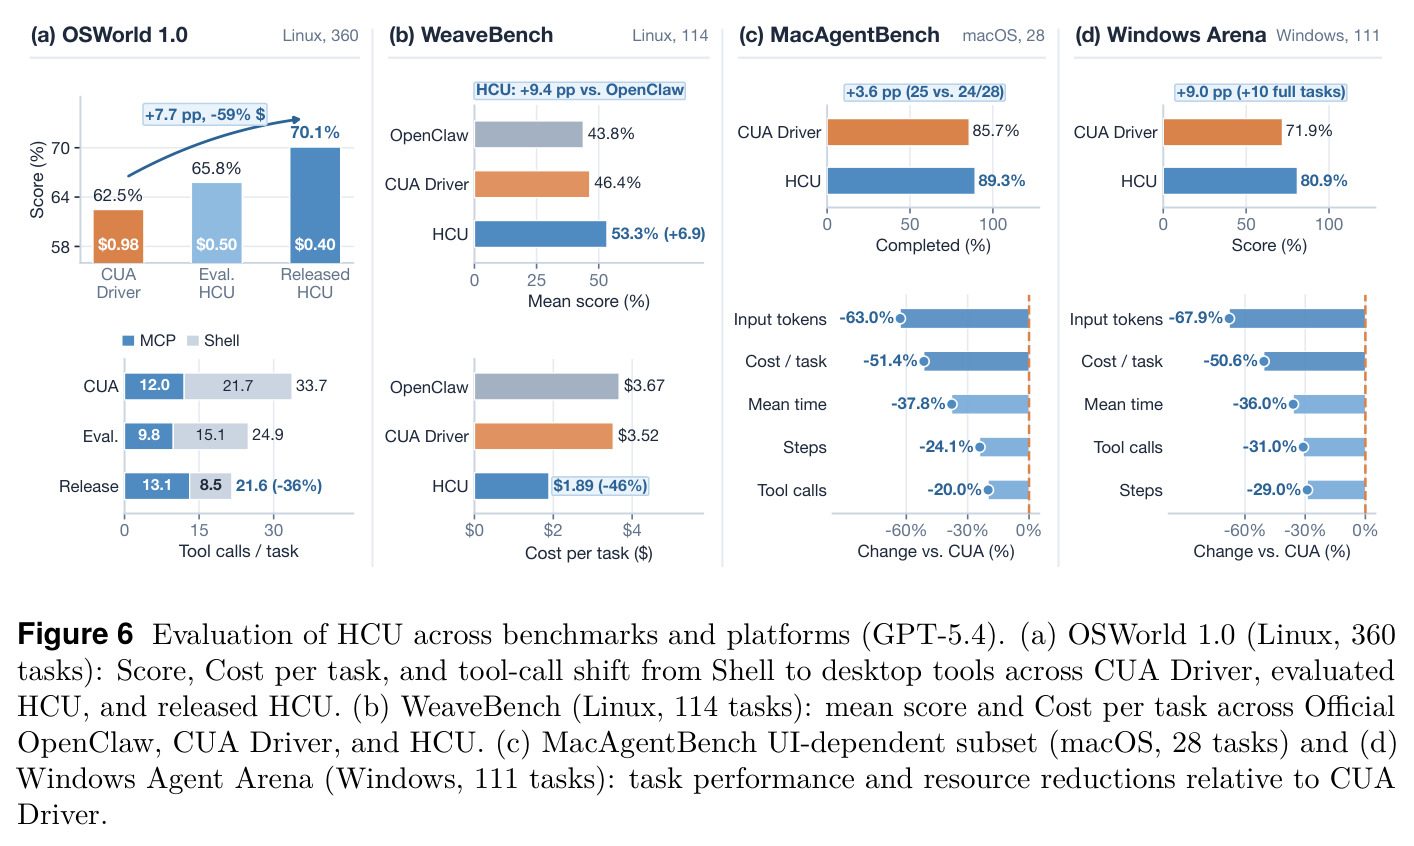
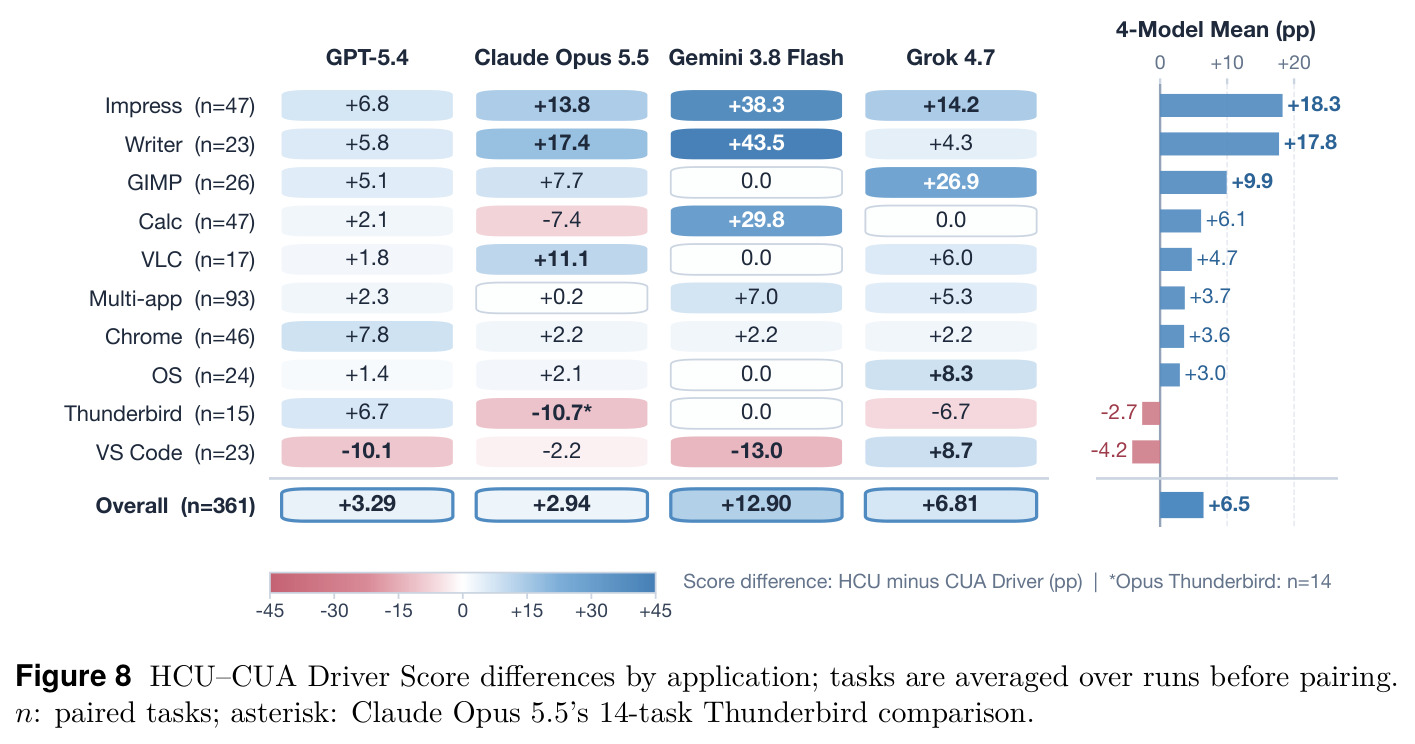
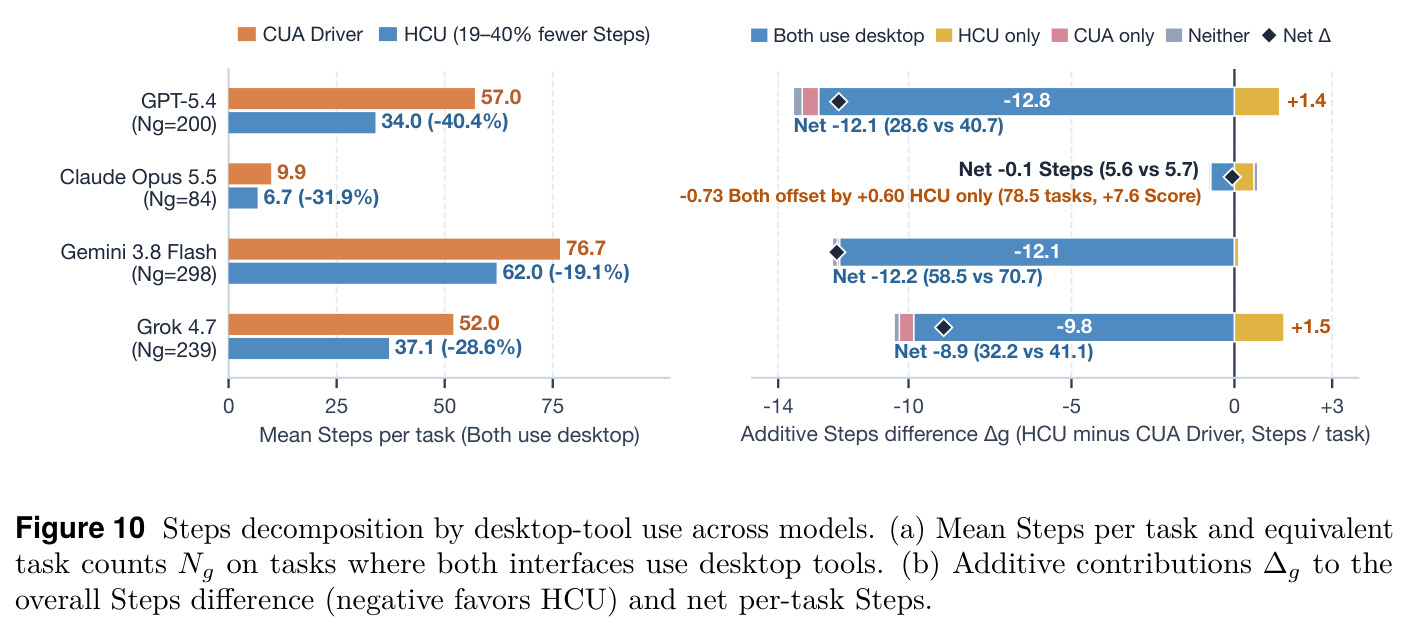
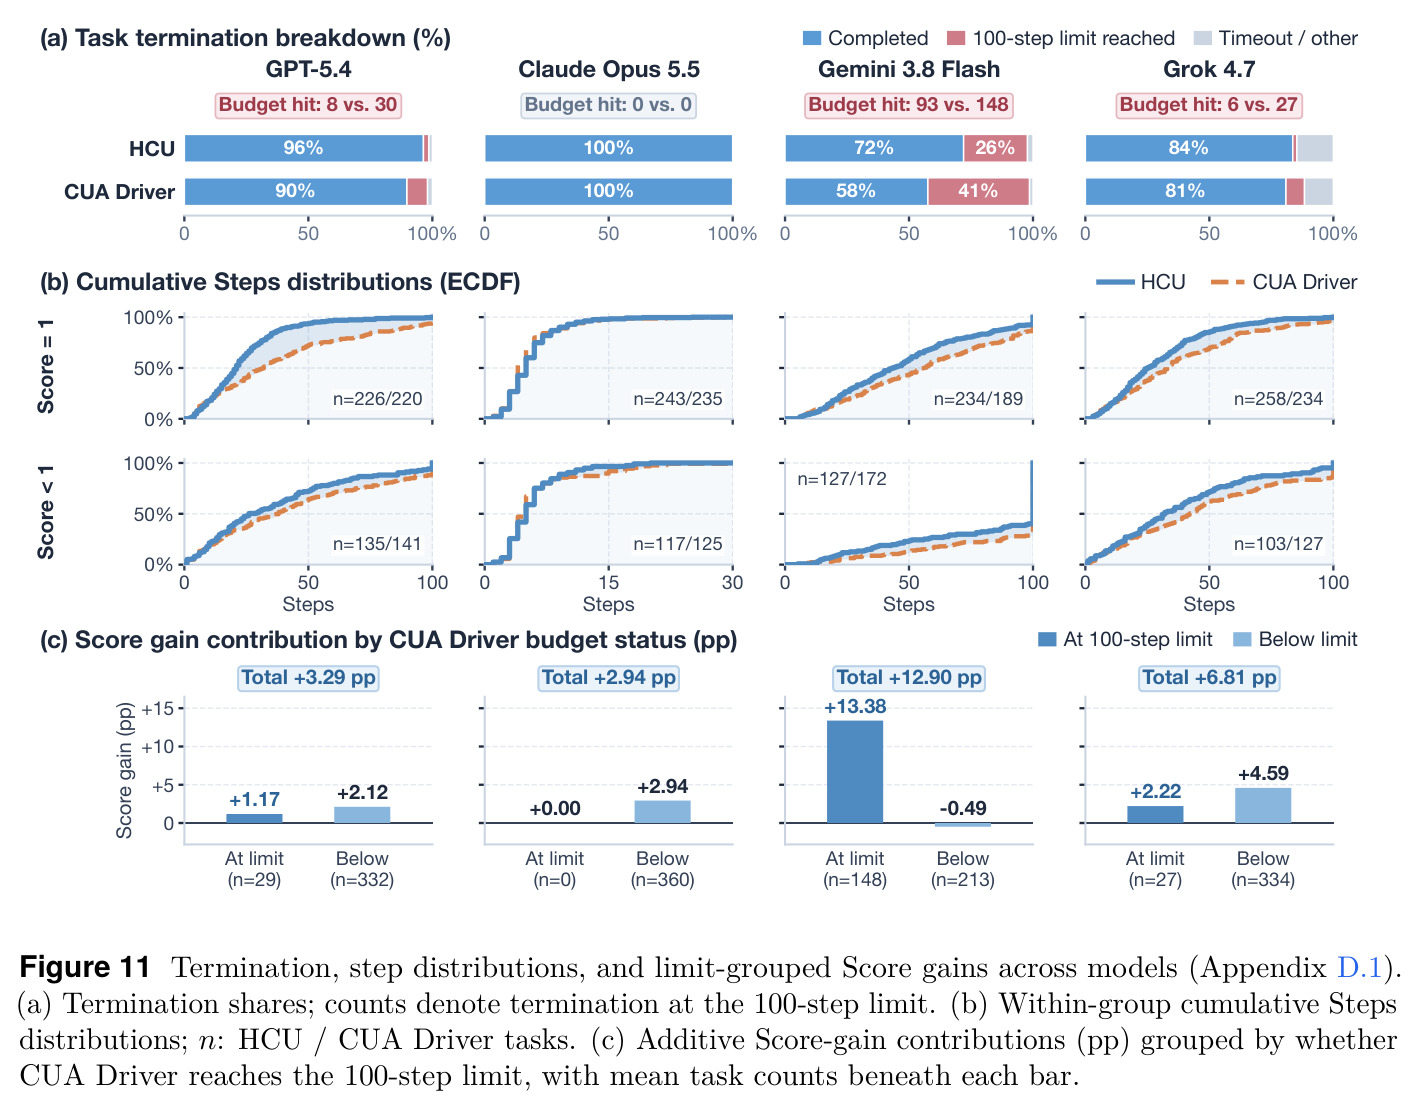
OSWorld 2.0(108 任务):HCU(GPT-6 Astra)72.37% Partial/32.4% Binary/$10.03;HCU(Claude Opus 5)72.06%/35.19%/$22.67,分列最高 Partial 与 Binary。较官方 Claude 榜:+3.75pp/+3.76pp、成本 −20.26%;同 harness 对比 CUA Driver:Partial +3.55pp、工具调用 −29.81%、时间 −21%、成本持平;Pareto 前沿由 StateAct(61.60%/$7.80)与 HCU 构成。消融(OSWorld 1.0×3 runs):HCU 65.59% vs 62.30%(+3.29pp),Steps −29.8%、输入 −56.9%、成本 −55.4%;去 AX 降至 62.79%,去 skill 64.00%,去 GUI 66.08% 但在 run 间波动内且 Steps +12.45%。跨模型:四模型全部 +2.94 至 +12.90pp、成本省 8–55%,Gemini 增益最大(54.67→67.57),主要来自基线撞 100 步限制的任务。跨平台:OSWorld 1.0 70.13%(+7.66pp、成本 −59.1%)、WeaveBench 53.25% vs 46.37%、MacAgentBench 25/28 vs 24/28、Windows Arena 80.86% vs 71.89%,成本降 46–59%;skill 使 AX/GUI 错误率 18.97%→5.92%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 2.0 全量(108 任务)长程桌面工作流 | Partial(平均任务分) | 72.37%(HCU + GPT-6 Astra) | 68.82%(CUA Driver + GPT-6 Astra,同 harness 匹配对比) | +3.55 个百分点,Binary +0.90pp,工具调用 −29.81%,成本持平($10.03 vs $10.05) |
| OSWorld 2.0 | Binary(满分率) | 35.19%(HCU + Claude Opus 5) | 31.43%(Claude Opus 5 官方排行榜) | +3.76 个百分点,同时 Partial +3.75pp、成本 −20.26%($22.67 vs $28.43) |
| OSWorld 1.0(361 任务) | Score | 65.59%(GPT-5.4 xhigh,三 run 均值) | 62.30%(CUA Driver) | +3.29pp;Steps −29.8%、输入 token −56.9%、时间 −29.9%、成本 −55.4%($2.52 vs $5.65) |
| OSWorld 1.0(360 任务,released HCU) | Score | 70.13%(满分任务率 66.67%) | 62.47%(CUA Driver) | +7.66pp;每任务成本 $0.402 vs $0.983(−59.1%),输入 token −67.0% |
| WeaveBench 长程混合工作流(114 任务) | Mean score(agent-as-judge) | 53.25%(≥0.8 分任务 24/114) | 46.37%(CUA Driver);43.84%(官方 OpenClaw) | +6.88pp / +9.41pp;成本 $1.889 vs $3.518/$3.672(−46.3%/−48.6%) |
| Windows Agent Arena(111 任务,Windows) | Score | 80.86%(89.75/111,满分任务 88) | 71.89%(79.80/111,满分任务 78,CUA Driver) | +8.97pp;总成本 −50.6%($36.06 vs $73.00),总输入 token −67.9% |
| MacAgentBench UI 依赖子集(28 任务,macOS) | 完成率 | 89.3%(25/28) | 85.7%(24/28,CUA Driver) | +3.6pp;成本 −51.4%($0.72 vs $1.49/任务)、平均时间 −37.8% |
| OSWorld 1.0 跨模型(Gemini 3.8 Flash) | Score | 67.57%(HCU) | 54.67%(CUA Driver) | +12.90pp(四模型中最大);输入 token −39%、成本 −44%、Steps −17% |
局限与改进
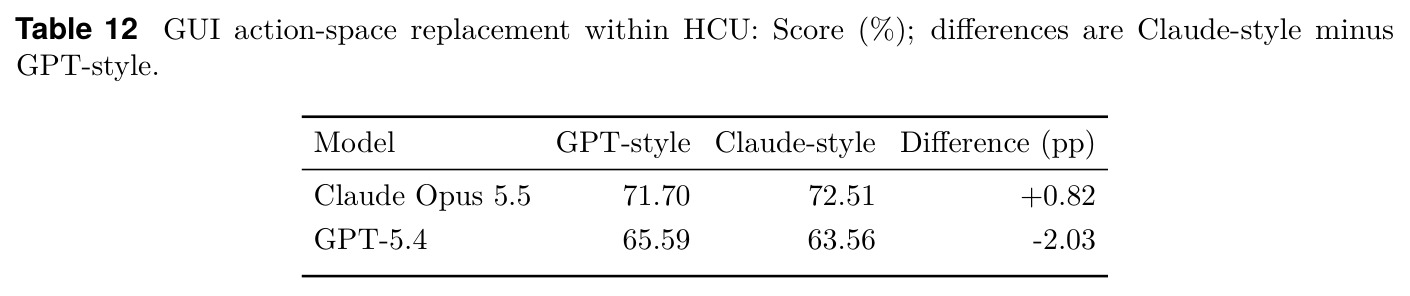
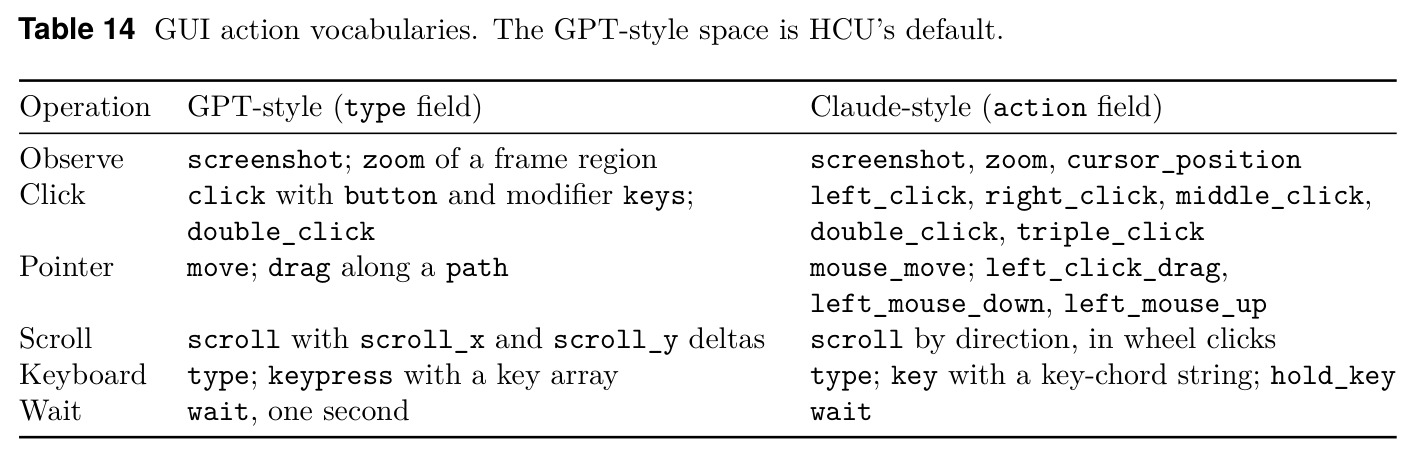
作者承认:AX 覆盖取决于应用暴露什么——自绘内容可能无 AX 元素、虚拟化项渲染前缺失,语义通道不完整需 GUI 兜底;GUI 通道对 Score 贡献不显著(去掉后 66.08% vs 65.59%,在 run 间波动内),价值主要在效率;Claude Opus 5.5 的 Steps 几乎不变且 Time +6%,因“仅 HCU 用桌面工具”任务组步数上升抵消节省;部分应用负增益(VS Code −4.2pp、Thunderbird −2.7pp);GPT-6 Astra 官方 72.60% 为内部子集结果。此外:成本仍高(每任务 $10.03–22.67、Claude 配置输入约 8.16M token),StateAct 以 $7.80 得 61.60% 说明廉价方案有空间;skill 为手工蒸馏静态文本,换 GUI 词表使 GPT-5.4 掉 2.03pp、Claude 升 0.82pp,接口与模型习惯强耦合;每配置仅 2–3 runs,w/o GUI 结论在 run 间翻转;Gemini 大增益主要衡量“避免预算耗尽”而非纯交互质量。
独立分析的弱点
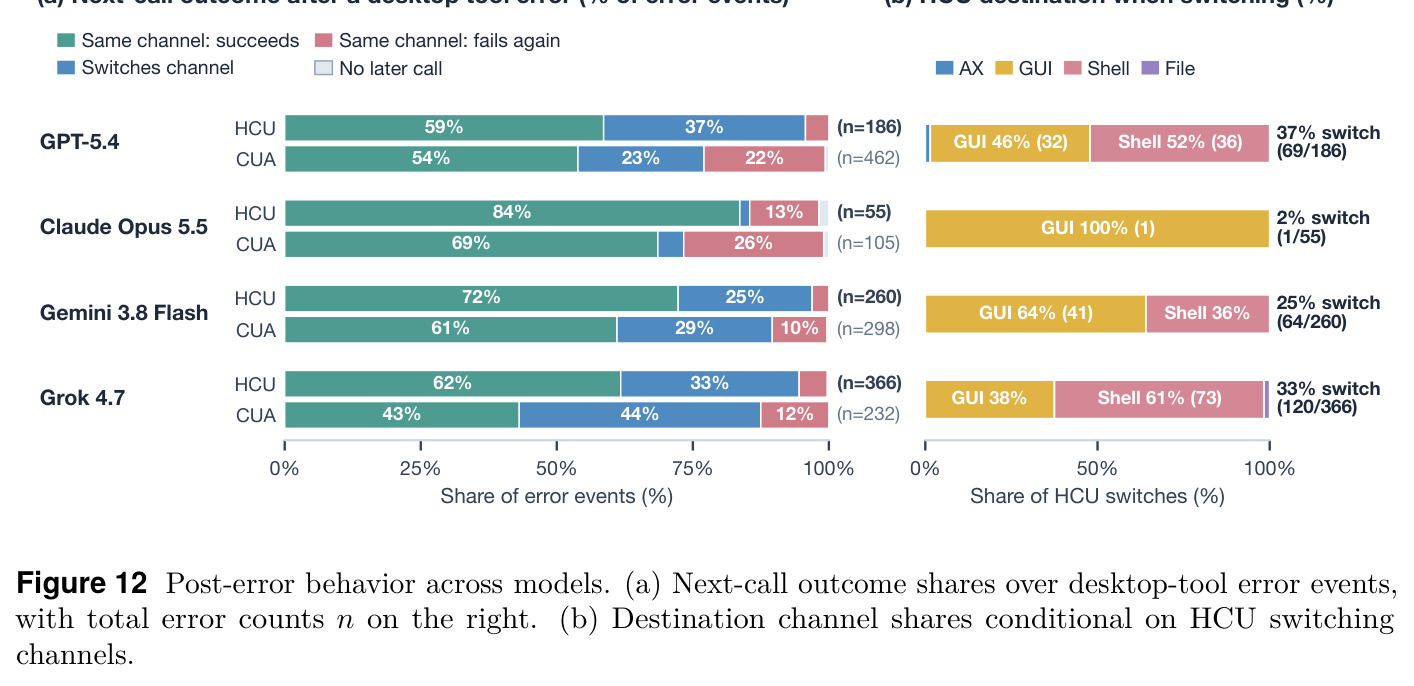
弱点一:对 AX 覆盖差的应用(画布、游戏、自绘 UI)只能退化为 GUI 坐标操作,脆弱且贵,缺 AX 覆盖率先验探测——可训练轻量模型预测“此窗口 AX 可用性”预路由通道。弱点二:skill 静态且手工蒸馏,应用迭代或换模型后规则可能失效(不同模型惯例错误率相差约 4 倍:92.49 vs 48.14/千次调用)——可从在线轨迹自动蒸馏并按模型适配。弱点三:批处理在首个失败步即停,续接全靠模型理解;wait 依赖固定超时与 settle 检测,慢应用可能误判——可引入自适应超时与部分回滚。弱点四:成本结构未优化——AX diff 默认全量返回,长任务输入累计数百万 token(WeaveBench 上 4.48M/任务),可做增量 diff 或层级摘要;通道选择全靠模型直觉,缺廉价路由器。弱点五:安全性靠 base policy 文本约束,守卫只防“状态陈旧”,无法阻止引用有效但语义错误的选择或破坏性 shell 命令——可为删除/覆盖/发布类动作加确认门槛或沙箱预演。弱点六:每配置 2–3 runs 难以支撑 ±1pp 级结论,应报告更多 run 与显著性检验。
未来方向
作者方向:把桌面当作可编程环境——AX 暴露的元素状态代码可读可写,批量动作+wait 步骤正好构成程序化组合的基底,未来可把桌面工作统一进代码执行与工具调用框架;并呼吁设计“充分暴露计算机已有能力”的界面,而非强加人类交互先验。延伸方向:其一,训练侧结合——用 HCU 轨迹做界面感知的模仿学习或强化学习(Mage-VL-Cowork 已从训练侧探索混合使用),让小模型学会通道选择,把每任务成本从 $10+ 压到可部署水平;其二,自动化 skill——从跨模型轨迹持续蒸馏界面使用规则,按模型在线适配 GUI 动作词表(词表匹配价值 ±0.8–2pp);其三,AX 质量增强——应用 AX 覆盖差时自动生成/注入无障碍标注,提升语义通道覆盖率;其四,安全与可信——为写操作建立类型化效果声明与事务回滚,把守卫从“状态新鲜”扩展到“语义正确”;其五,跨端统一——把同一 AX/GUI 契约推广到移动端与 Web,并用 AX diff 匹配度、守卫拒绝率等中间信号构建可验证奖励用于 RL 训练;其六,效率自适应——按守卫拒绝率与批成功率在线调节批量大小与 wait 超时。
复现评估
开源情况良好:代码在 github.com/microsoft/Hybrid-Computer-Use 完全开放;附录给出 MCP 工具 schema、base policy 与 hybrid skill 全文、两套 GUI 词表和公共错误码定义,接口契约明确,复刻门槛低。数据全部公开:OSWorld 2.0(108 任务)、OSWorld 1.0(361)、WeaveBench(114)、MacAgentBench 子集(28)、Windows Agent Arena(111),无私有数据。算力与成本:无需训练,但推理预算可观——OSWorld 2.0 一轮约 $1,083–2,448(视模型),OSWorld 1.0 消融共 5,415 task-runs 约需数千美元;还需维护 Linux/macOS/Windows 桌面环境(依赖 AT-SPI、AXUIElement、UIA3)。难度评估:环境搭建与多模型 API 接入是主要门槛;复现单配置需数天,完整复现全部表格约需数千美元与数周工程时间。综合:中等偏低难度、透明度高。
论文图表
同一 Obsidian 窗口的三种表示对比:(a) 截图与跨收集器对比——官方 OSWorld 2.0 的 /accessibility XML 30526 token,HCU 返回文本 1237 token;(b) stock XML 片段显示冗长属性(st:enabled、cp:screencoord、act:click_desc 等);(c) 同捕获内投影 1374→1201 token(−12.6%)。
给出 AX 观察压缩收益的上限参照:相比基准自带的原始 XML,HCU 表示小约 25 倍,直接决定上下文成本。