HybridCUA:学习编排GUI与CLI的计算机操作智能体 HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
用GUI-CLI混合轨迹与CLI感知奖励训练智能体,学会何时及如何使用命令行
前置知识
Computer-Use Agent (CUA)
基于多模态大语言模型的计算机操作智能体:观察屏幕截图,模拟人类的点击、键入、滚动等原子操作来完成数字任务(整理文件、编辑文档、配置软件等)。它把「操作电脑」建模为感知-行动循环,每步接收一张截图、输出一个底层操作,效果靠长动作序列累积。
本文的研究对象就是CUA。理解其截图-动作循环,才能理解为什么纯GUI路径冗长易错,以及为什么引入CLI这条第二执行通道能显著压缩轨迹、但也带来新的学习难题。
POMDP(部分可观测马尔可夫决策过程)
强化学习的标准建模范式,由状态空间 $S$、动作空间 $A$、转移概率 $P$、奖励 $R$、观测空间 $\Omega$、观测函数 $O$ 和折扣因子 $\gamma$ 组成。「部分可观测」指智能体看不到环境的完整内部状态,只能通过观测函数获得局部信息——例如本文中智能体只能看到截图,而非电脑的全部进程与文件系统状态。
论文3.1节把计算机操作形式化为POMDP $M=\langle S,A,P,R,\Omega,O,\gamma\rangle$,观测定义为截图与上一条CLI命令输出的组合,这是理解统一动作空间与信息回传设计的基础。
SFT(监督微调)
用标注好的输入-输出对训练语言模型的标准方法,通过最大化目标序列的对数似然(下一词元预测损失 $\mathcal{L}_{SFT}=-\mathbb{E}[\sum_t \log \pi_\theta(a_t|x,h_t)]$)让模型模仿示范行为。在智能体场景下,SFT在轨迹数据上进行,教模型在特定观测历史下复现正确动作。
本文第一阶段就是在5023条混合轨迹上做SFT。理解SFT「只能模仿示范、无法优化接口选择」的局限,是理解为什么还需要第二阶段带CLI感知奖励的强化学习的关键。
RLVR(可验证奖励强化学习)
用程序化验证器(而非神经网络打分的奖励模型)判断任务是否完成的强化学习范式:验证器检查环境的最终状态是否满足目标(如文件内容、设置值是否正确),返回二元奖励,从而避免奖励模型被钻空子,让大规模在线RL可靠可行。
本文第二阶段在3000个带可执行验证器的任务上做RLVR,并在标准结果奖励之上叠加了两项CLI感知奖励。可验证性是这套奖励能精确归因到「接口选择」与「命令执行」的前提。
GRPO(组相对策略优化)
一种在线RL算法:对同一任务采样一组rollout(本文为8条),用组内奖励的均值 $\mu_G$ 和标准差 $\sigma_G$ 把每条轨迹奖励归一化为相对优势 $\hat{A}=(R-\mu_G)/(\sigma_G+\epsilon)$,据此更新策略,省去训练独立的价值网络。
本文RL阶段基于GRPO并做了关键改动:步骤级执行惩罚 $r^{exec}_t$ 是在组归一化之后、按发出命令的动作词元叠加的(公式7)。不懂GRPO就无法看懂这个信用分配设计的巧妙之处。
pyautogui 与 Python heredoc
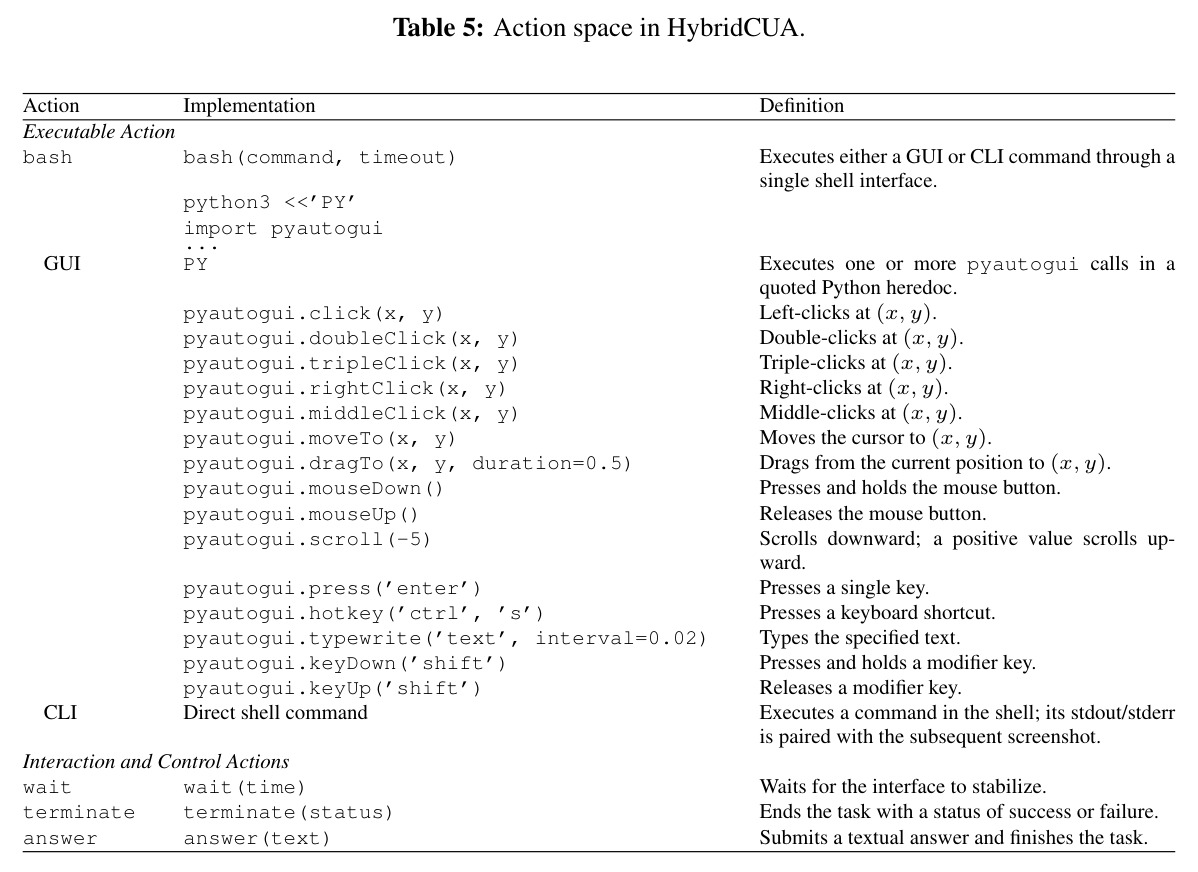
pyautogui是Python的GUI自动化库,提供click、typewrite、hotkey、scroll等函数以编程方式控制鼠标键盘。heredoc是在一条shell命令里内嵌多行Python代码的写法(python3 <<'PY' ... PY)。本文把所有GUI操作统一表达为bash动作内包裹的pyautogui heredoc。
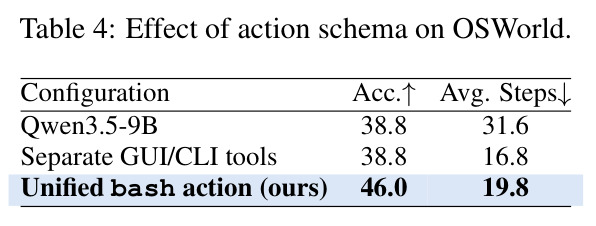
GUI操作以heredoc形式、CLI命令以纯shell形式共用同一个bash动作接口,这是本文「统一动作模式」创新(比分离双工具高7.2个百分点)的技术载体,不理解它就看不懂动作空间设计。
研究动机
现有计算机操作智能体几乎完全依赖GUI交互:通过截图感知屏幕,用点击、键入等原子操作完成任务。这种方式虽然通用,但效率低下且容易产生级联错误——例如「把演示文稿中特定几张幻灯片背景改色」这类任务,走GUI要经历打开菜单、逐张选中、逐项设置等十余步操作,任何一步坐标偏差都可能失败。为提速而引入应用专属API或MCP工具的做法又牺牲了通用性:每个应用都要单独开发接口,难以跨应用规模化。更关键的发现是,直接给现有模型开放命令行(CLI)接口不但无益反而有害:在OSWorld上,四个代表性智能体接入CLI后准确率集体下降2.5至11.5个百分点;基础模型Qwen3.5-9B从GUI-only的38.8%暴跌至GUI+CLI的18.4%。根源在于模型根本不会用CLI:Qwen3.5-27B和EvoCUA-32B分别只有15.0%和0.15%的步骤通过CLI执行,宁可爬完冗长的GUI序列也不用一条命令替代。论文把这一缺陷追溯到训练层面的两个缺口:其一,数据从未展示混合行为的样子——CUA数据集几乎只含GUI动作,而终端/代码语料又缺少发出命令时的GUI上下文,两类语料彼此割裂;其二,监督信号对接口选择视而不见——步级模仿只奖励局部合理的动作,结果奖励只检查任务是否完成,两者都无法区分「选对了接口」与「碰巧成功但路径低效」。
本文的目标是本文的目标是构建能可靠编排GUI与CLI的新一代计算机操作智能体,教会它现有模型缺失的两种能力:何时该用CLI(接口路由),以及如何把CLI命令执行可靠(命令质量)。具体目标分解为三点。第一,建立可规模化的数据生成管线,产出覆盖GUI-only、CLI-only、GUI-CLI交错三种执行模式的监督轨迹,以及带「CLI是否具有明确执行优势」二元标注的可验证RL任务,合成HybridCUA-8K数据集(5023条轨迹+3000个RLVR任务)。第二,设计两阶段训练框架:先用SFT在统一动作格式下教会模型GUI控制、shell命令与接口切换的基础能力,再用带CLI感知奖励的GRPO在线强化学习,分别针对性优化路由决策与命令执行可靠性。第三,训练出HybridCUA-9B模型,在OSWorld上大幅超越基础模型(目标从38.8%提升至50%以上)并成为同规模最优,同时在OSWorld-MCP与WindowsAgentArena上验证跨接口生态、跨操作系统的泛化能力,证明混合范式优于纯GUI与应用专属API两条既有路线。
与已有工作不同的是,本文最独特的切入角度是一个关键观察:混合监督数据不必从零收集,因为许多GUI动作序列天然存在等价的shell命令。基于此,论文设计了「GUI轨迹改写为CLI」的语义保持变换——识别在终端里逐字键入命令的多个GUI动作(如输入mkdir -p /tmp/proj再按回车),把整条命令折叠为一条直接CLI动作,重放后仅保留成功的改写结果,使交错轨迹的获取成本大幅降低。与最接近的两项工作相比,差异清晰地落在监督信号上:CUA-Universe虽然大规模合成混合任务并收集引导轨迹,但用VLM打分而非任务专属的程序化验证,反馈太粗糙、无法支撑在线训练;RecreationWorld虽提供可验证的环境,却只用任务结果做监督,接口选择仍然隐式地藏在轨迹模仿里、从未成为学习信号的一部分。HybridCUA则首次把「接口选择」本身变成显式训练信号:为每个RL任务标注二元标签 $b^\star$(CLI是否具明确优势),配合任务级 $R_{CLI}$ 与步级 $r^{exec}$ 两个奖励,分别监督「何时」与「如何」使用CLI。此外,把GUI与CLI统一进单一bash动作语法(而非暴露为分离工具)也是独有且被消融验证有效的设计选择。
核心方法
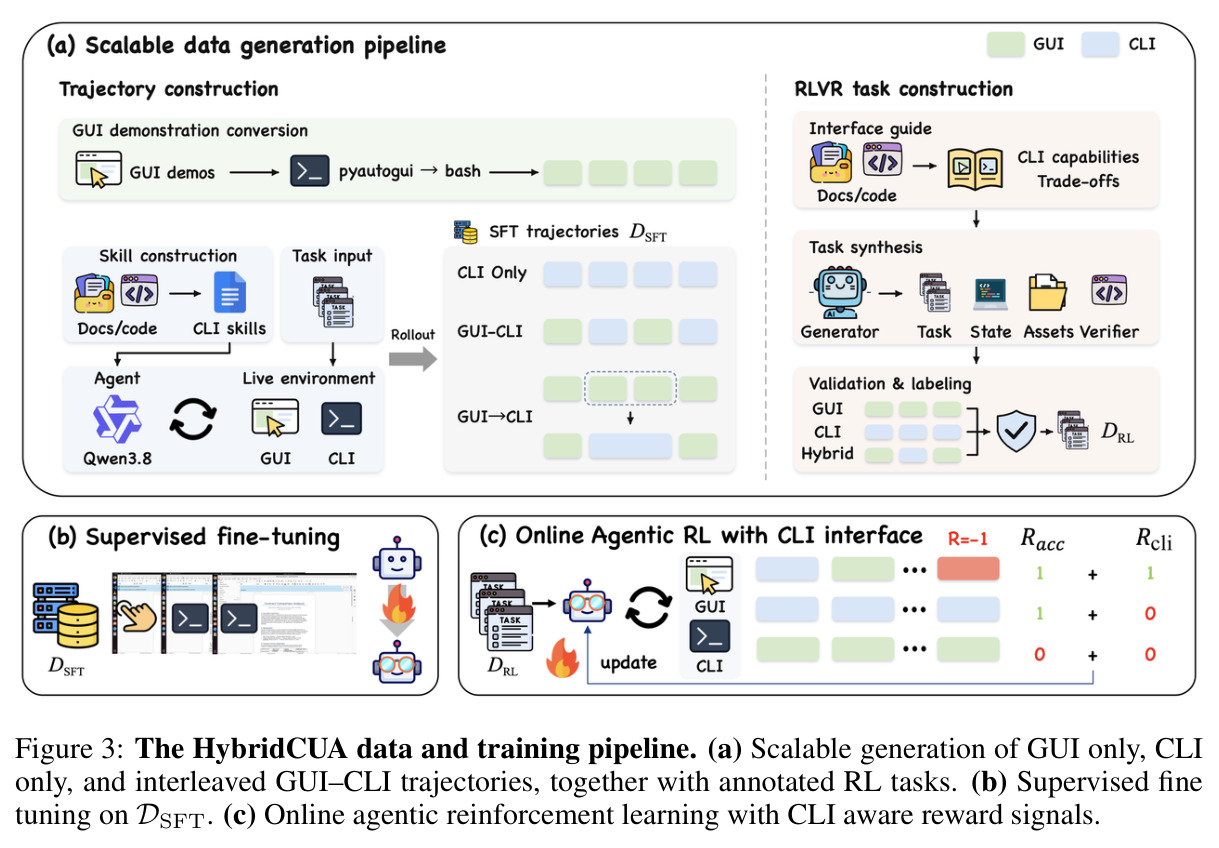
直觉上,人在操作电脑时会自然混用两种通道:看得见摸得着的图形界面适合视觉定位与状态确认,命令行适合批量文件操作、文本编辑与状态检查,二者互补而非替代。HybridCUA把这个直觉工程化为「数据+训练」的完整方案。技术路线上,作者首先把计算机操作形式化为POMDP $M=\langle S,A,P,R,\Omega,O,\gamma\rangle$:智能体在时刻 $t$ 的观测为 $o_t=(I_t,\tilde{y}_{t-1})$,即当前截图 $I_t$ 加上上一条CLI动作的stdout/stderr $\tilde{y}_{t-1}$(若无则为空)。动作空间统一为 $A=\{\text{bash}(c,\delta)\mid c\in\mathcal{C}^{CLI}\cup\mathcal{C}^{GUI}\}\cup\{\text{wait},\text{terminate},\text{answer}\}$——GUI操作写成bash内包裹的pyautogui Python heredoc,CLI操作直接写shell命令,二者共用同一个bash接口,$\delta$ 为可选超时。数据层面,管线生成三种轨迹共5023条:GUI-only从开源UI-MOPD转换而来,CLI-only由Qwen3.8-27B配CLI技能在CUA-Gym中采样成功rollout,交错轨迹来自自由接口切换或GUI改写;另构建3000个带 $b^\star$ 标签的已验证RLVR任务。训练分两阶段:先在混合轨迹上做2个epoch的SFT(46876个步级样本、366次更新),再用GRPO在1000个采样任务上做在线RL,轨迹奖励为结果奖励叠加CLI偏好信号,步级再叠加命令执行惩罚。
核心创新有二。第一是统一bash动作语法:与以往把GUI和CLI暴露为两个独立工具(computer_use与cli)的做法不同,HybridCUA让所有可执行交互都通过同一个 $\text{bash}(command, timeout)$ 动作发出——GUI是heredoc包裹的pyautogui代码,CLI是直接shell命令。消融显示这一设计带来7.2个百分点的收益(统一语法46.0%对分离工具38.8%),因为共享语法让模型在同一个生成空间里做接口路由,切换接口无需切换工具调用格式。第二是CLI感知奖励的「何时/如何」分解:任务级奖励 $R_{CLI}=\mathbb{I}[\text{Success}(\tau)]\cdot\mathbb{I}[b(\tau)=b^\star]$ 只在任务成功且CLI使用模式与标签 $b^\star$ 一致时给分,教会模型按任务属性决定是否启用CLI;步级奖励在命令发生shell级执行失败时置 $r^{exec}_t=-1$(否则为0),把失败精确归因到发出命令的动作词元,教会模型写出可靠的命令。这与已有方法的本质区别在于:标准结局奖励 $R_{acc}$ 对「成功但不必要地切换接口」和「中途命令失败但最终补救」的轨迹一视同仁,而HybridCUA把接口选择与命令可靠性变成可区分、可优化的显式信号。$b^\star$ 标签本身也颇具巧思——通过在GUI-only、CLI-only、GUI-CLI三种模式下各采样16条rollout、按成功率排名来经验性地测定每个任务的CLI优势,而非依赖人工规则。
方法步骤详情
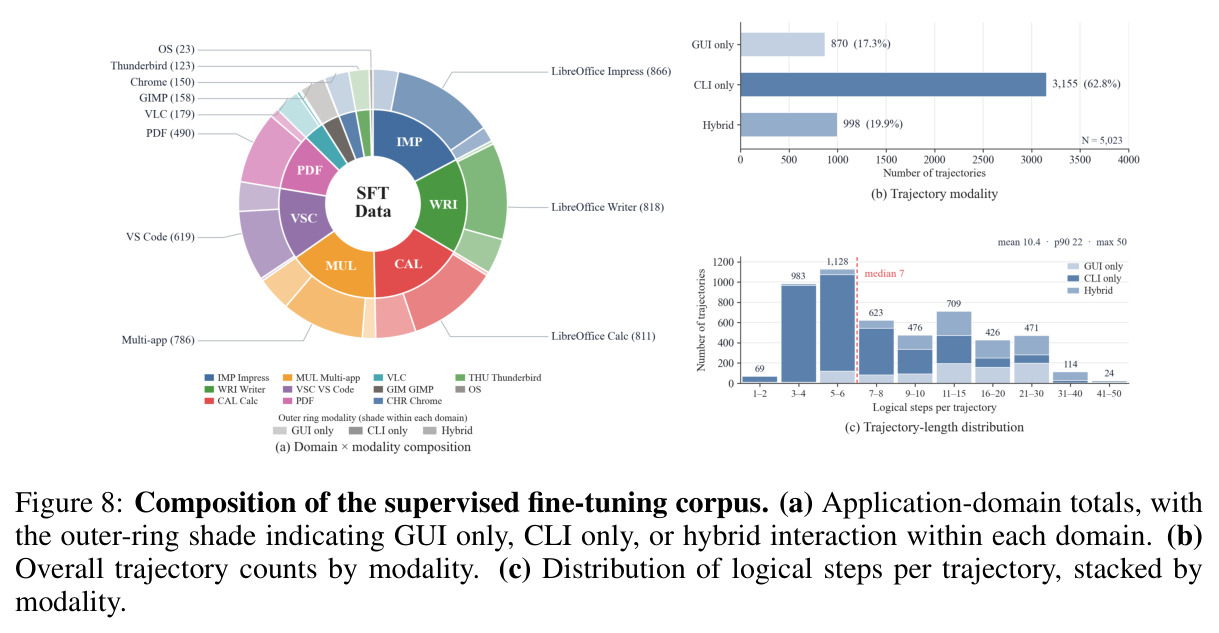
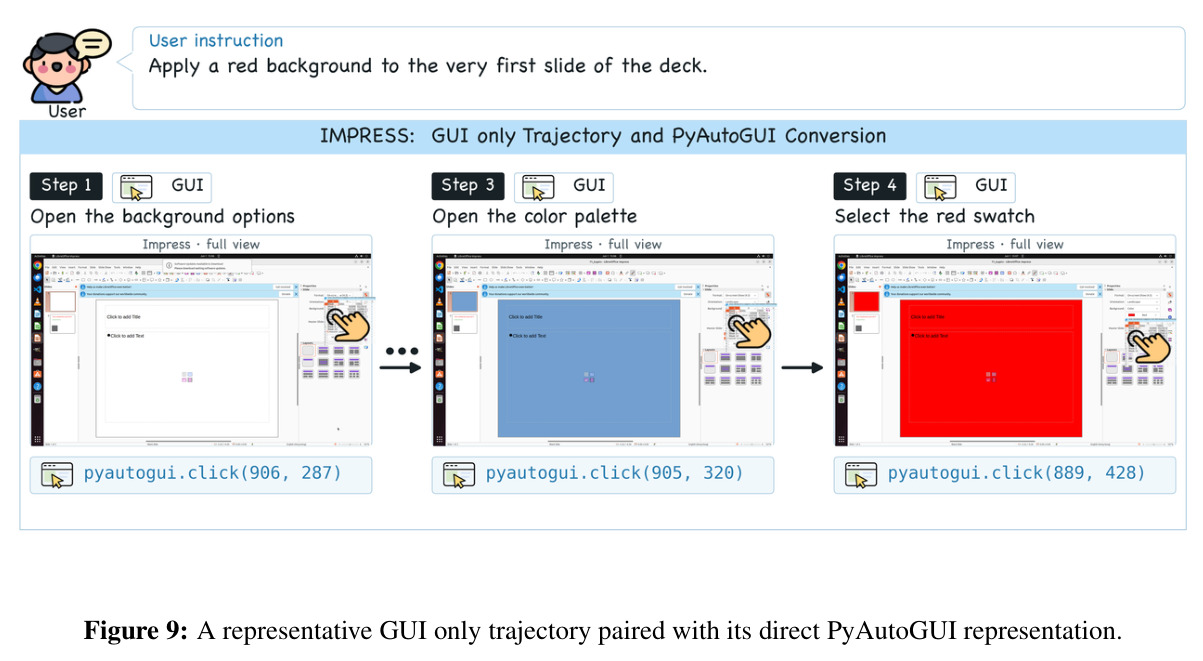
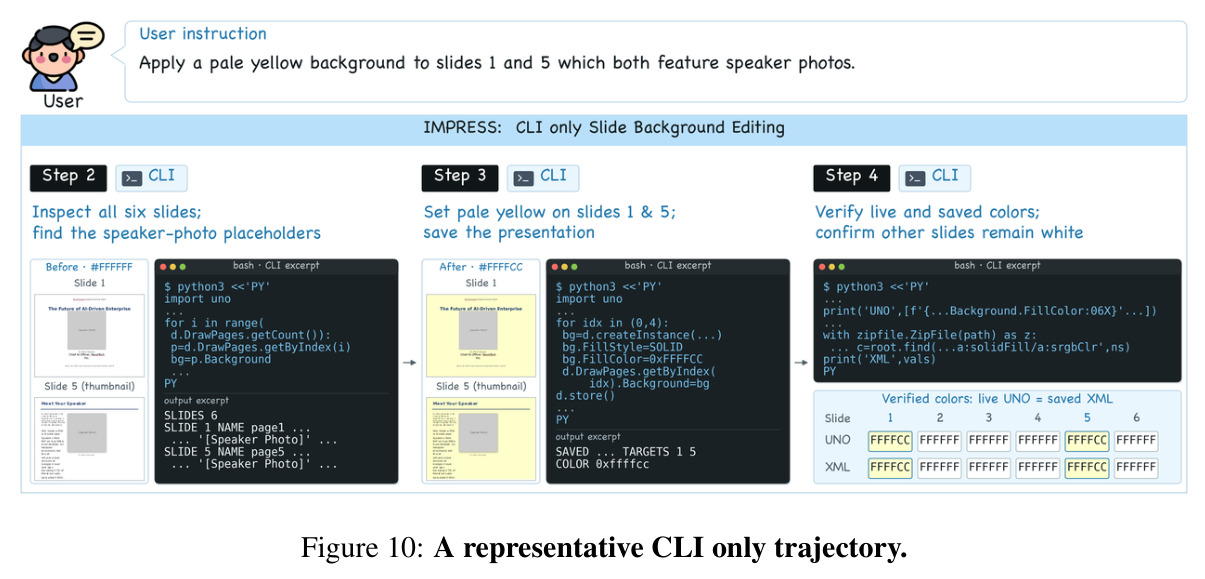
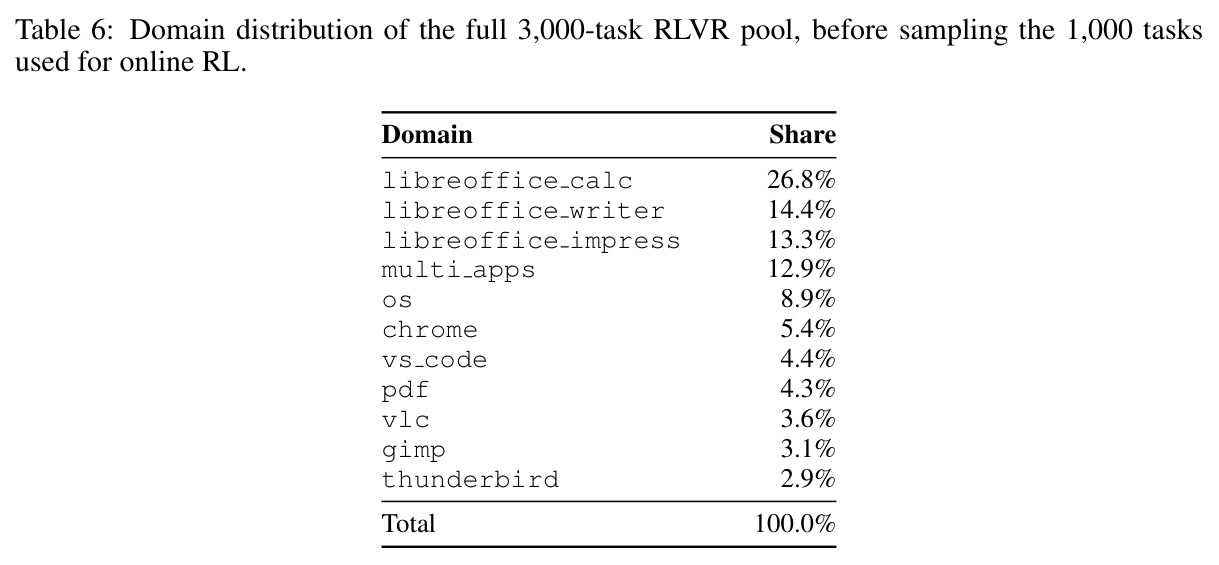
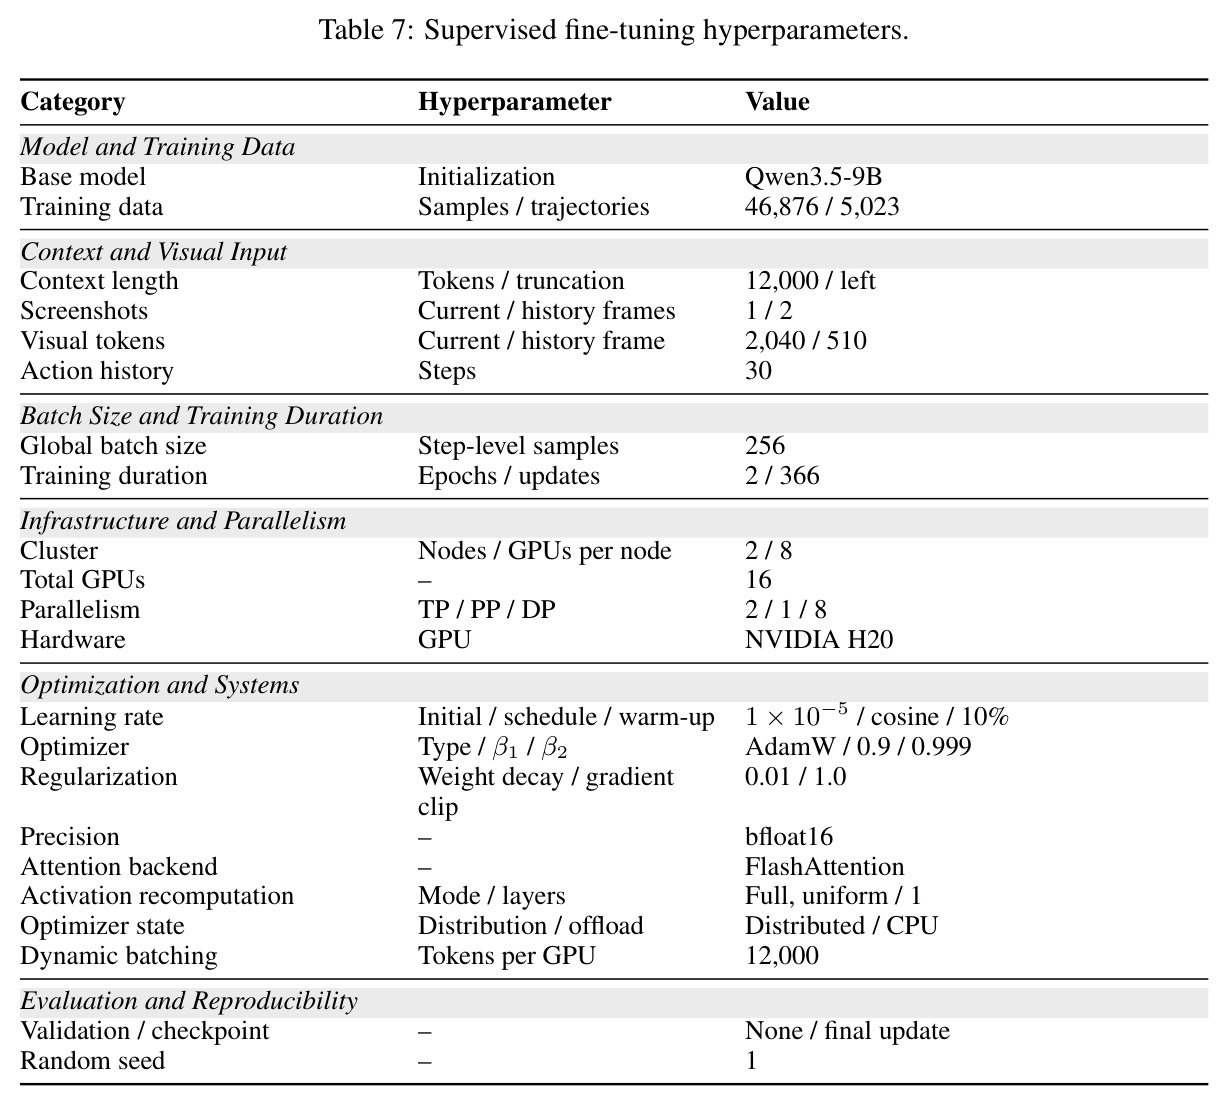
整个方法分数据构建与两阶段训练共六步。第一步,构建GUI-only轨迹:将开源UI-MOPD轨迹的每个GUI动作(点击、拖拽、滚动、快捷键、文本输入)转写为等价pyautogui调用,坐标在1000×1000共享空间做视觉定位后映射到环境显示坐标,序列化为bash包裹的Python heredoc。第二步,构建CLI-only轨迹:为每个应用从在线文档和参考代码蒸馏出应用专属CLI技能清单(仅用于数据采集,学生模型训练测试时均不可见),让Qwen3.8-27B配备技能与Claude Code harness、仅用CLI接口在CUA-Gym中解题,保留成功rollout。第三步,构建交错轨迹:路线一让Qwen3.8-27B同时接触GUI与CLI自由选择;路线二对GUI-only轨迹做语义保持改写——识别终端中逐字键入命令的动作(含heredoc逐行输入),把多个动作折叠为一条CLI命令,删除开启终端的快捷键与提交回车,保留真正的GUI交互,重放后只保留成功者。三步共得5023条轨迹(跨11个应用域,Impress 866条、Writer 818条、Calc 811条、multi apps 786条),展开为52227个步级样本,过滤至12000 token内剩46876个。第四步,RLVR任务构建与标注:基于CUA-Gym管线合成3000个带可执行验证器与可达目标状态的任务(Calc占26.8%、Writer 14.4%、Impress 13.3%、multi apps 12.9%等);每个任务用Qwen3.8-27B在三种模式下各采样16条rollout,按成功率排名(5个百分点内平局按成功rollout的中位步数),若最优模式为CLI-only、或为GUI-CLI且过半成功rollout含直接CLI命令,则标 $b^\star=1$。第五步,SFT:2个epoch、全局批256、366次更新、16张H20,损失为 $\mathcal{L}_{SFT}=-\mathbb{E}_{\tau\sim D_{SFT}}[\sum_{t=0}^{T}\log\pi_\theta(a_t|x,h_t)]$,只对每步的助手响应计损失,保留推理块。第六步,在线RL:从SFT检查点出发,在1000个采样任务上用GRPO训练(slime+Megatron-LM+SGLang,24张H20,每提示8条rollout):轨迹奖励 $R(\tau)=R_{acc}+\lambda_{CLI}R_{CLI}$($\lambda_{CLI}=0.1$)先组内归一化得优势 $\hat{A}_{t,j}=(R(\tau)-\mu_G)/(\sigma_G+\epsilon)$,再对命令动作的词元叠加 $\lambda_{exec}r^{exec}_t$($\lambda_{exec}=0.3$);同时过滤无组内信号的组、丢弃策略版本滞后超过2次更新的组。
技术新颖性
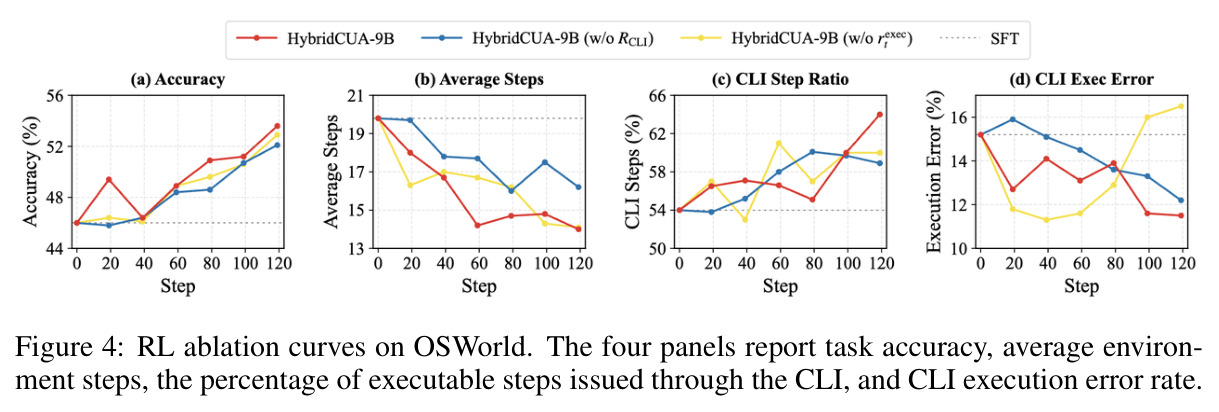
技术新颖性体现在四个层面。其一,问题诊断的新量化:论文首次系统性量化「给模型shell却不会用」的现象——接入CLI使四个代表模型掉2.5-11.5个百分点,Qwen3.5-27B与EvoCUA-32B的CLI步骤占比仅15.0%和0.15%,并把根因定位到数据缺口与监督盲区,而非模型能力不足。其二,数据管线的低成本混合监督:GUI-to-CLI语义保持改写利用「许多GUI序列有等价shell命令」的观察,通过重放验证保证改写后的应用状态一致性(只允许折叠多动作为一命令、绝不拆分),相比从头采集混合轨迹成本低得多,是新颖的数据增强思路。其三,奖励设计的双粒度分解:$b^\star$ 标签用三模式×16 rollout的经验对比自动测定CLI优势,把模糊的「该不该用CLI」变成每个任务的二元校准信号;消融证明 $R_{CLI}$ 与 $r^{exec}$ 确实各管一件事——去掉 $R_{CLI}$ 后CLI使用率只达58.9%(完整模型64.0%)、轨迹缩短仅18.2%(完整29.3%),去掉 $r^{exec}$ 后执行错误率回升至16.5%(完整模型稳定在11.5%)。这种「路由与执行分开监督」的设计在以往混合CUA工作中(CUA-Universe的VLM打分、RecreationWorld的结果奖励)均不存在。其四,接口表达的统一化:统一bash语法让GUI与CLI共享生成空间与解析路径,7.2个百分点的消融差距证明动作模式本身就是影响学习的变量,这一发现对后续智能体接口设计有普遍参考价值。
实验结果
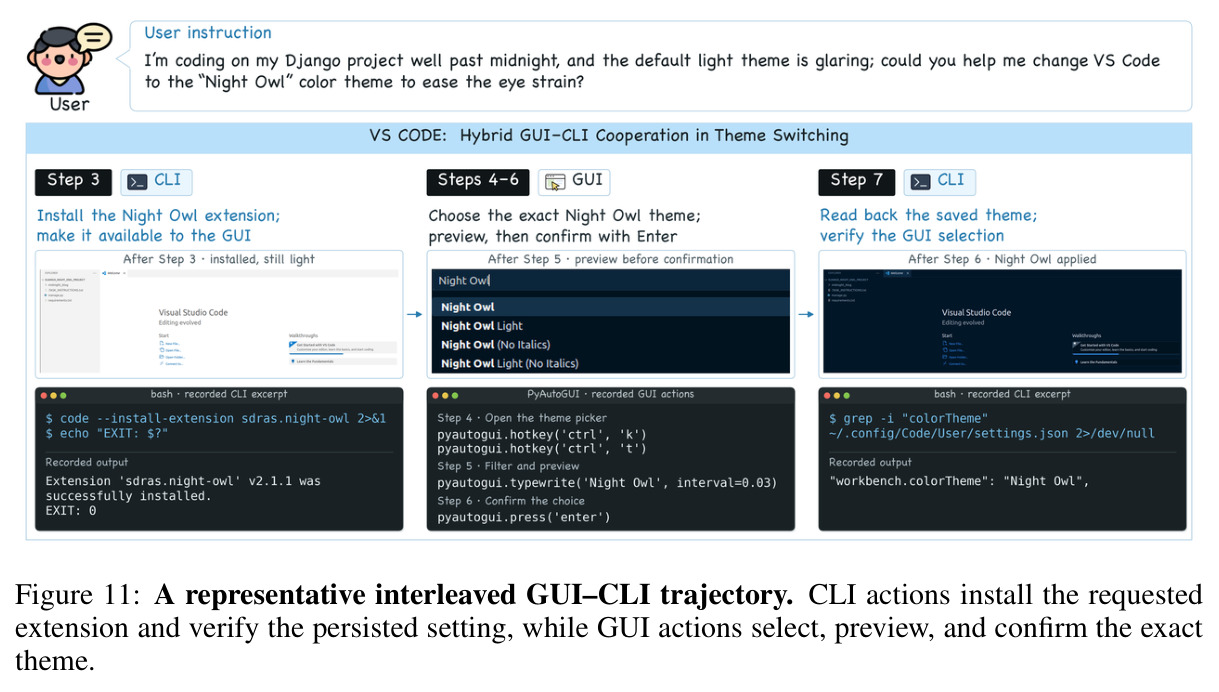
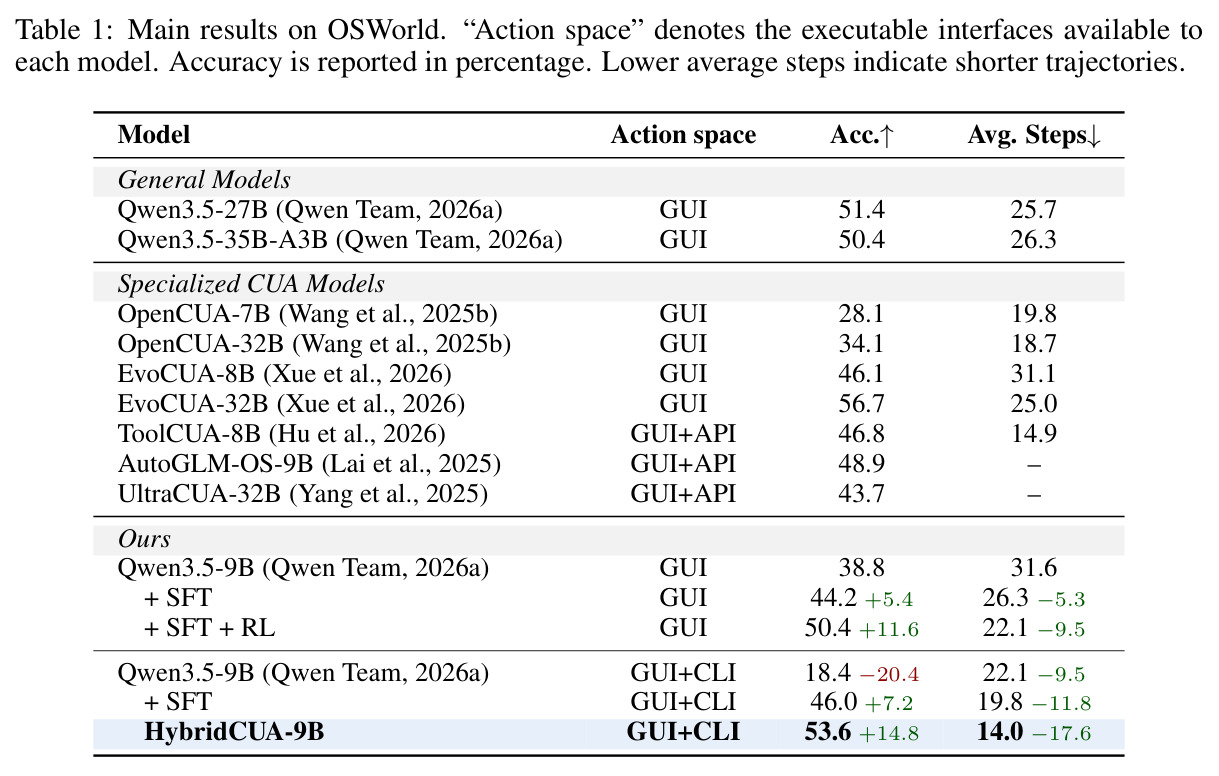
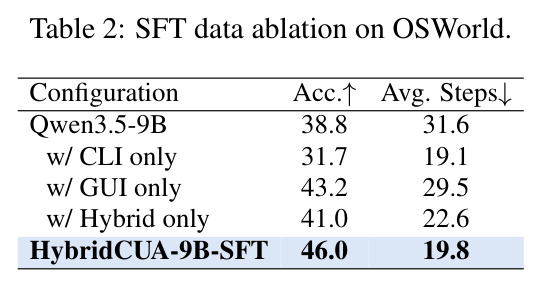
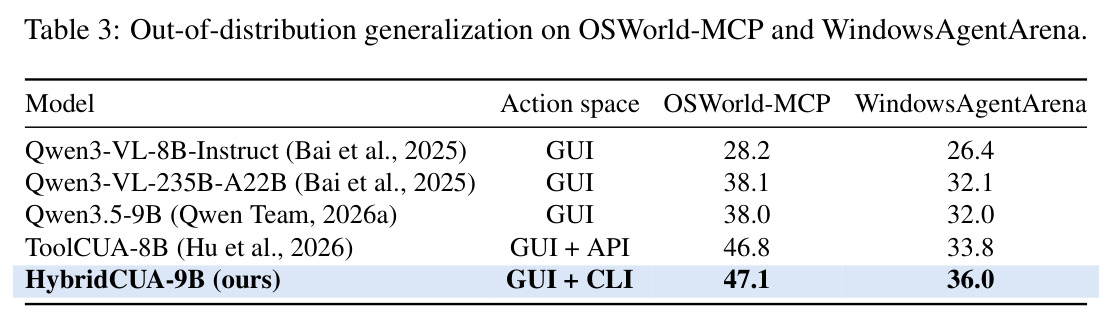
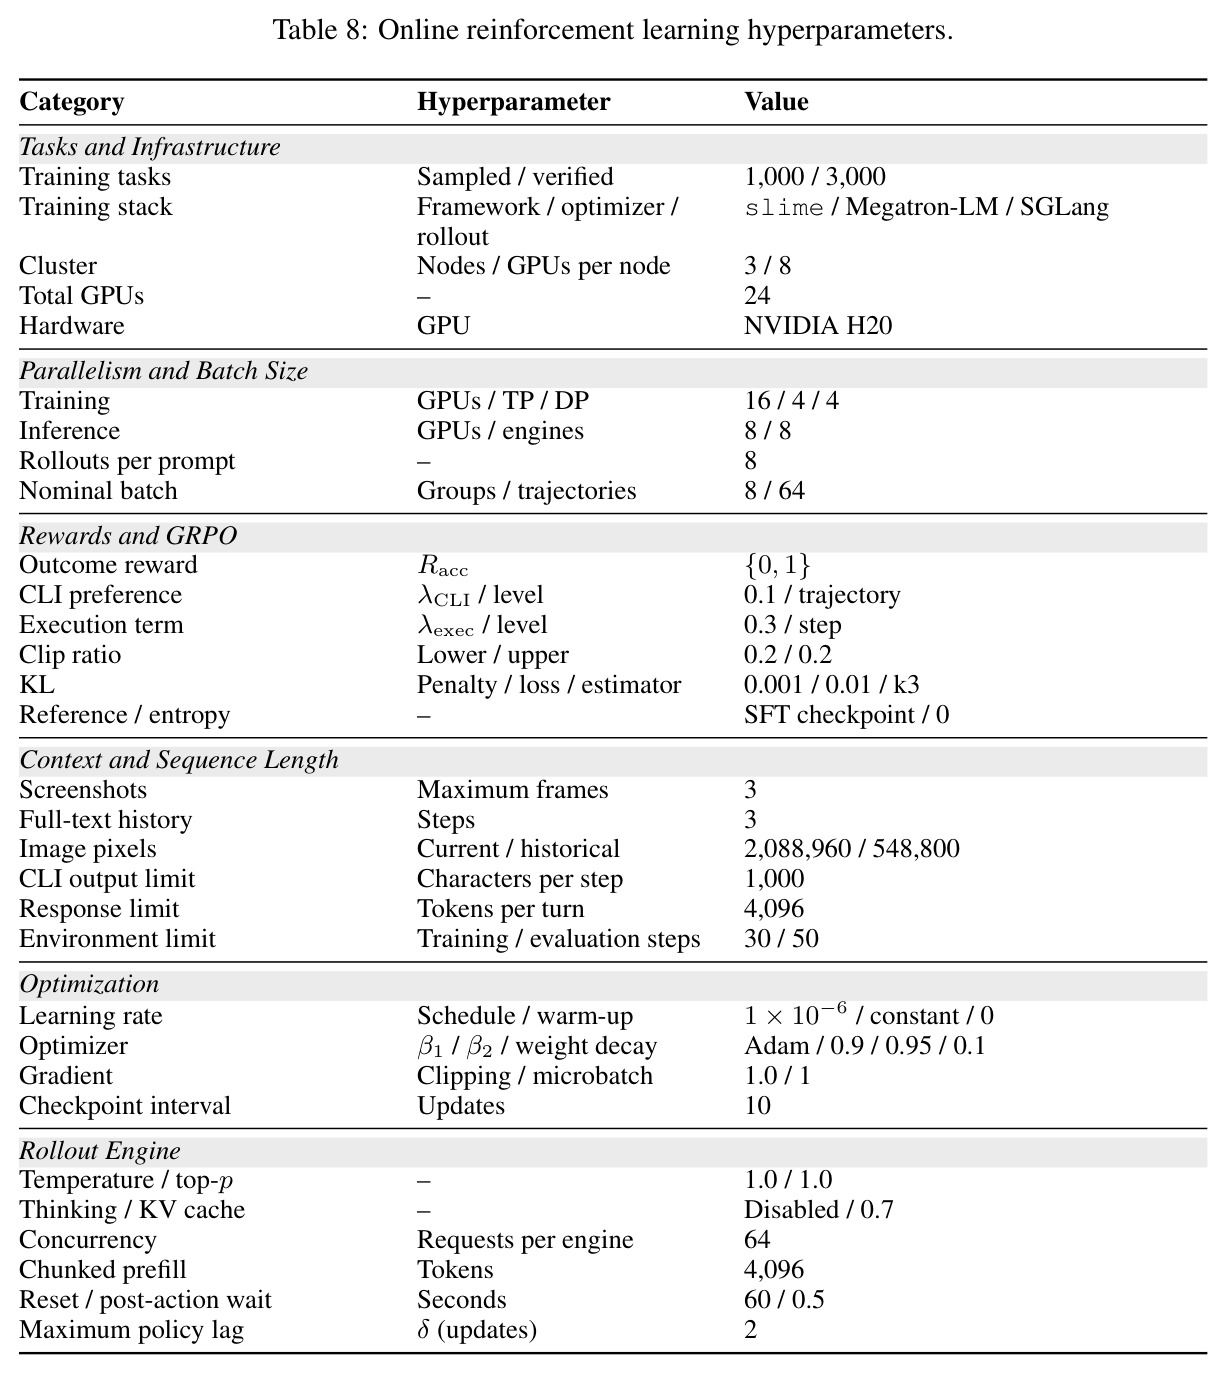
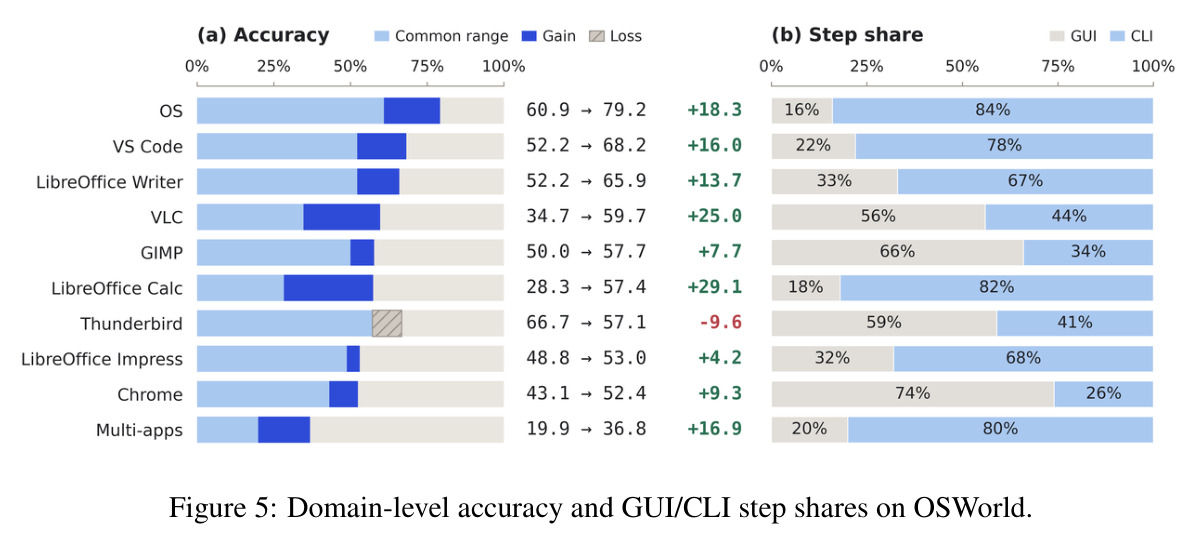
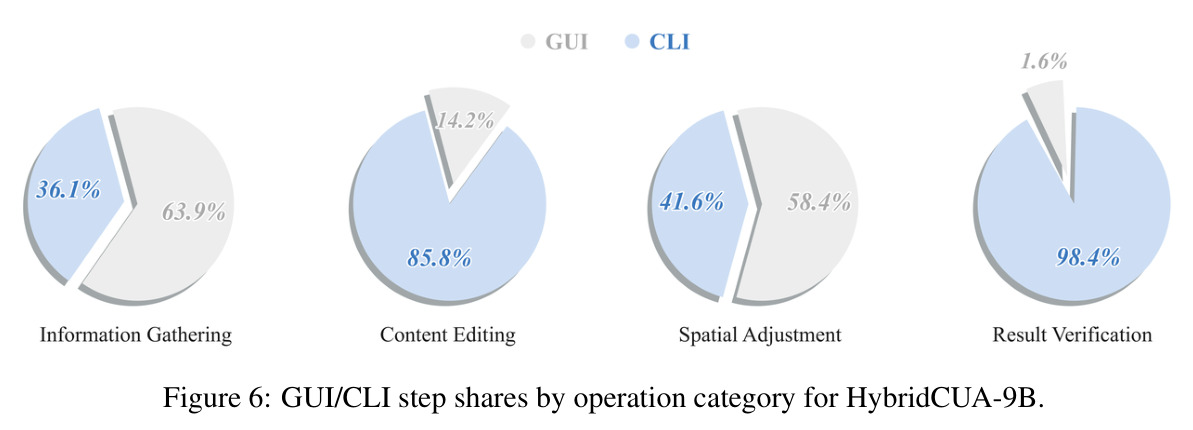
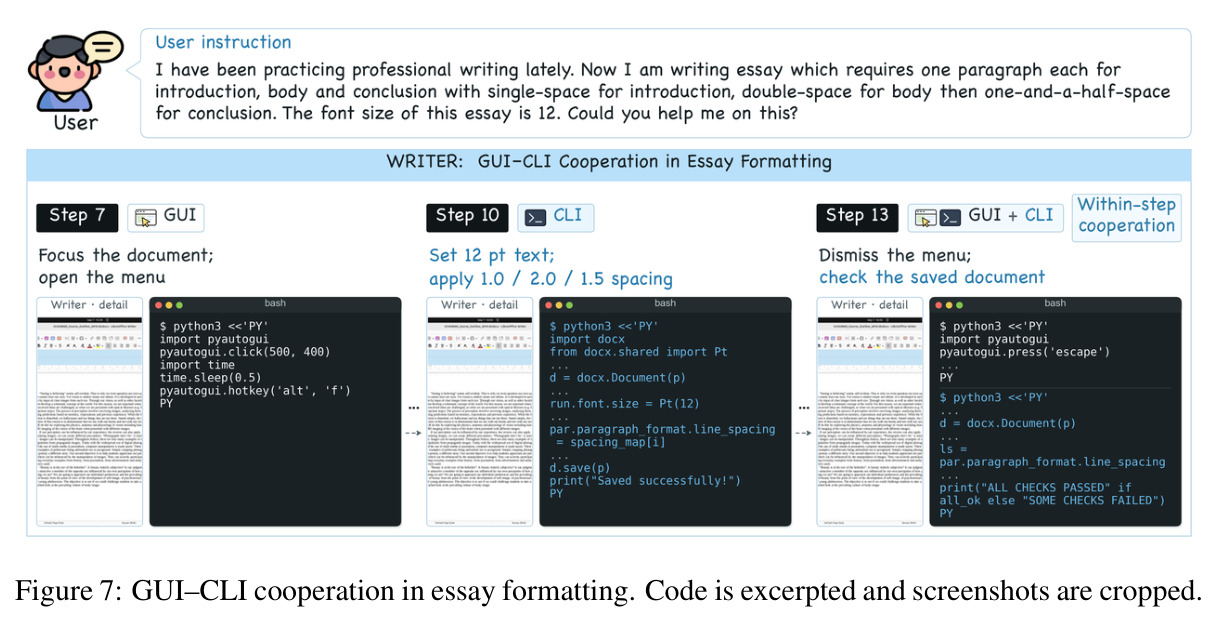
主实验在OSWorld全部361个任务上进行(每任务最多50步,报告评估器分数均值与全任务平均步数)。HybridCUA-9B达到53.6%准确率与14.0平均步数,在同规模模型中两项均最优:较基础模型Qwen3.5-9B(GUI-only 38.8%、31.6步)提升14.8个百分点、步数减少17.6步;超过Qwen3.5-27B(51.4%)与Qwen3.5-35B-A3B(50.4%),仅次于参数量四倍于它的EvoCUA-32B(56.7%)。最关键的是同基座消融对照:同一基础模型配GUI-only动作空间经SFT+RL达到50.4%/22.1步,而GUI+CLI分支达到53.6%/14.0步,证明第二接口在训练后带来净收益;反照组是未经训练直接暴露CLI,准确率从38.8%暴跌至18.4%——此时步数虽降至22.1,但缩短源于早失败而非效率。与GUI-API智能体相比,HybridCUA-9B超AutoGLM-OS-9B(48.9%)4.7个百分点、超ToolCUA-8B(46.8%)6.8个百分点、超UltraCUA-32B(43.7%)9.9个百分点,且比ToolCUA-8B还少0.9步;而它模型的CLI使用率为64.0%,与最重度使用CLI的基线相当,但增益方向相反(Figure 2),印证收益来自「会用」而非「用得多」。SFT数据消融(Table 2)显示三种轨迹混训46.0%,优于GUI-only(43.2%)、CLI-only(31.7%)和仅交错(41.0%),说明单接口示范与混合轨迹提供互补监督。RL在SFT基础上再涨7.6个百分点、步数再降29.3%。奖励消融(Figure 4)证明两个信号各司其职:去掉任务级 $R_{CLI}$ 准确率几乎不掉但效率增益停滞,去掉步级 $r^{exec}$ 准确率步数几乎不变但执行错误率升至16.5%。OOD泛化(Table 3):OSWorld-MCP上47.1%,超Qwen3.5-9B 9.1个百分点、与ToolCUA-8B持平;WindowsAgentArena上36.0%,超基础模型4.0、超ToolCUA-8B 2.2个百分点——值得注意的是模型只见过Linux shell,却能在Windows上发出PowerShell命令,说明迁移的是「何时委派给shell」的知识而非记忆的命令。接口选择分析(Figure 5-6)显示模型按领域理性分工:OS任务84%用CLI、Chrome任务74%用GUI;内容编辑85.8%和结果验证98.4%走CLI,空间调整58.4%走GUI。动作模式消融(Table 4):统一bash语法46.0%对分离工具38.8%。案例研究(Figure 7及附录F)展示了多种混合模式:essay排版任务中GUI聚焦Writer窗口与菜单、CLI用python-docx对引言/正文/结论分别设12磅字号与单倍/双倍/1.5倍行距,单个bash步内先用pyautogui关菜单再用CLI读回文件验证字体与行距。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 计算机操作任务(361个任务,每任务最多50步) | 任务准确率 (%) | 53.6 (HybridCUA-9B, GUI+CLI) | 38.8 (Qwen3.5-9B 基础模型, GUI-only) | +14.8 个百分点 |
| OSWorld 交互效率 | 平均环境步数 | 14.0 | 31.6 (基础模型) | -17.6 步(缩短约 55.7%) |
| OSWorld 对比 GUI-API 混合智能体 | 任务准确率 (%) | 53.6 | 46.8 (ToolCUA-8B) / 48.9 (AutoGLM-OS-9B) / 43.7 (UltraCUA-32B) | +6.8 / +4.7 / +9.9 个百分点 |
| OSWorld-MCP(MCP 环境迁移,361 任务) | 任务准确率 (%) | 47.1 | 38.0 (Qwen3.5-9B) / 46.8 (ToolCUA-8B) | +9.1 个百分点;与 ToolCUA-8B 持平 |
| WindowsAgentArena(跨操作系统迁移,154 任务) | 任务准确率 (%) | 36.0 | 32.0 (Qwen3.5-9B) / 33.8 (ToolCUA-8B) | +4.0 / +2.2 个百分点 |
| SFT 数据消融(三种轨迹混训 vs 单一类型) | OSWorld 准确率 (%) | 46.0(GUI-only + CLI-only + 交错混训) | 43.2 (仅GUI-only) / 31.7 (仅CLI-only) / 41.0 (仅交错) | +2.8 / +14.3 / +5.0 个百分点 |
| 动作模式消融(同一基座、同一数据) | OSWorld 准确率 (%) | 46.0(统一 bash 动作,19.8 步) | 38.8(分离 GUI/CLI 双工具,16.8 步) | +7.2 个百分点(代价为多 3.0 步) |
局限与改进
作者在附录A中承认两点局限。第一,方法收益依赖于CLI的可用性与稳定性:没有可用CLI的应用、受限shell环境或操作系统专属命令语义,可能需要截然不同的接口路由行为;OSWorld-MCP与WindowsAgentArena虽有覆盖,但远未涵盖应用、操作系统、权限设置与长程工作流的全部多样性。第二,数据构建目前主要聚焦OSWorld包含的应用,不能代表领域专属应用和真实使用中的分布外环境。我自己的观察补充如下。其一,$b^\star$ 标签的质量依赖教师模型Qwen3.8-27B在三种模式下各16条rollout的采样统计,在教师能力弱的领域(如GIMP在RLVR池中仅占3.1%)标签噪声可能更大,且标签在RL训练全程固定,无法随策略进步重新校准。其二,$r^{exec}$ 只惩罚shell级执行失败(命令报错),无法捕捉「执行成功但语义错误」的命令,这类错误仍要靠稀疏的最终结果奖励间接学习。其三,OSWorld报告的是评估器分数均值(部分验证器返回分数而非严格0/1),是严格成功率的上界,跨论文数字比较需谨慎;且每个基准只跑一次单次评估,未报告方差。其四,训练与评估都在沙箱虚拟机内,shell会放大单步动作的破坏力,论文也明确承认真实部署的安全行为超出研究范围。其五,RL后CLI执行错误率仍有11.5%,命令可靠性有改进空间。其六,Windows上36.0%的绝对水平仍低,跨系统迁移更多是方向性验证而非成熟能力。
独立分析的弱点
独立分析三个值得关注的弱点。第一,教师依赖与数据多样性上限:CLI-only与部分交错轨迹由Qwen3.8-27B配合「应用专属CLI技能清单」(内含openpyxl、python-pptx、ffmpeg、Script-Fu等具体命令配方)采集,学生模型虽然训练与测试时都看不到技能文档,但学到的命令模式实质上是教师模型+人工蒸馏技能的组合输出——数据多样性受限于教师的命令覆盖面,遇到教师不熟悉的库、冷门应用或版本变更时无能为力。改进方向:引入多教师交叉采样提升命令多样性,或让管线自动从应用源码、帮助文档中挖掘CLI接口,减少对人工技能清单的依赖。第二,$b^\star$ 标签静态且二值过粗:任务被硬性标注为「CLI有明确优势」或「没有」,但真实任务常是混合情形(部分子步骤适合CLI、部分适合GUI),二值任务级标签会惩罚合理的细粒度混合策略;16条rollout对成功率接近的模式区分力也有限(5个百分点平局带较宽)。改进方向:把 $b^\star$ 从任务级细化到步骤级或子目标级路由标签,或随训练进程周期性重采样校准。第三,效率证据的呈现方式:平均步数把失败任务也计入,暴露CLI后准确率暴跌时步数反而更少,说明步数单独不能作为效率证据;论文以准确率+步数联合呈现部分缓解了误导,但未来可引入「单位成功成本」或「成功任务步数中位数」等更稳健的指标,并对VM环境随机性做多次评估取均值。
未来方向
作者在附录A提出的方向:把数据构建管线扩展到更广泛的专用应用,合成更多样的OOD环境用于训练,从而提升对未见应用、工作流与接口配置的泛化。基于本文成果可以自然延伸的方向还有五个。其一,接口路由精细化:把路由标签从任务级 $b^\star$ 细化到步骤级或子目标级,让「GUI探查→CLI执行→GUI确认」这类混合模式成为显式优化对象——Figure 7的案例(GUI聚焦Writer窗口与菜单,CLI用python-docx设置12磅字号和三种行距,单步内先pyautogui关菜单再CLI读回文件验证)已展示细粒度协作的价值。其二,多操作系统与设备形态:Linux-only训练都能零样本发出PowerShell命令,说明「何时委派给shell」可跨系统迁移;加入Windows/macOS原生训练数据可能进一步放大跨平台能力,移动端(Android)与浏览器深度整合也值得探索。其三,与MCP/工具生态融合:OSWorld-MCP上47.1%的表现说明GUI-CLI编排能力可迁移到MCP环境,未来可让模型在shell、MCP工具、应用API之间做三方路由,按覆盖面与可靠性动态选择。其四,安全与权限:shell放大单步动作的威力,研究带权限分级、命令审计、危险命令拦截与状态回滚机制的混合智能体是部署前的必答题,尤其rm -rf、sudo这类不可逆操作。其五,长程任务与自我改进:当前轨迹平均仅10.4个逻辑步,把混合编排延伸到小时级跨应用长程工作流(如WeaveBench类基准)是下一步挑战;用策略自身的rollout替代教师采样来动态更新 $b^\star$,可形成路由知识的自我进化闭环。
复现评估
复现条件较为友好但门槛不低。开源方面:作者明确承诺发布轨迹数据、RLVR任务、数据生成与训练管线以及HybridCUA-9B模型(论文为preprint,需关注实际放出情况);附录详尽是显著加分项——动作空间与交互协议(附录B含Table 5)、轨迹构建细节与标签判定阈值(附录C)、SFT与RL全部超参数(附录D的Table 7/8)、评测协议与指标定义(附录E)、评估与数据构建用的完整系统提示词(附录G,含分离双工具对照prompt与八个域的CLI技能全文)都写了出来,透明度很高。算力方面:SFT用16张NVIDIA H20(2节点×8卡,2个epoch、366次更新、全局批256、TP2/PP1/DP8);RL用24张H20(3节点×8卡,16卡训练TP4/DP4、8卡推理),对学术实验室是不小的投入,但9B规模+约47000步级样本的数据量在RL工作中已算克制。数据构建依赖Qwen3.8-27B(开源权重)+Claude Code harness+CUA-Gym环境,其中Claude Code是闭源商业工具,CLI-only轨迹采集依赖它,复现者可能需替换为开源agent harness(可能引入轨迹质量差异)。评测方面:OSWorld/OSWorld-MCP/WindowsAgentArena均为公开基准(361+361+154任务),沙箱VM可重置。综合评估:若数据与模型如期开源,复现评测门槛低(下载模型按附录E/G跑即可);完整复现训练需中等偏高门槛(多节点H20集群+虚拟机农场+教师采样管线)。
论文图表
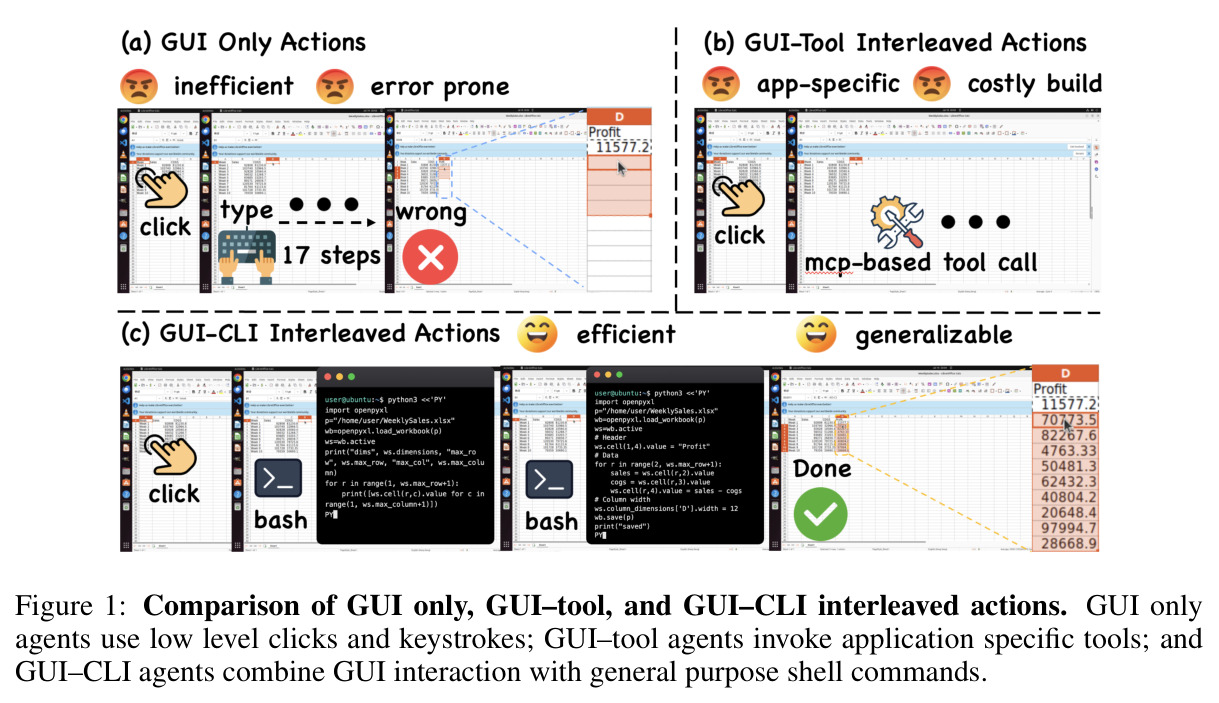
并排对比三种智能体动作范式完成同一任务的方式:GUI-only智能体用底层点击和按键逐步操作;GUI-工具智能体调用应用专属工具/API;GUI-CLI智能体把GUI交互与通用shell命令交错使用,用一条命令替代长GUI序列。
这是全文的问题定义图:三种范式的对比直观呈现了论文的核心主张——GUI的通用性与CLI的效率应当结合,而非二选一。读者可据此理解为什么混合范式在结构上优于既有两条路线。
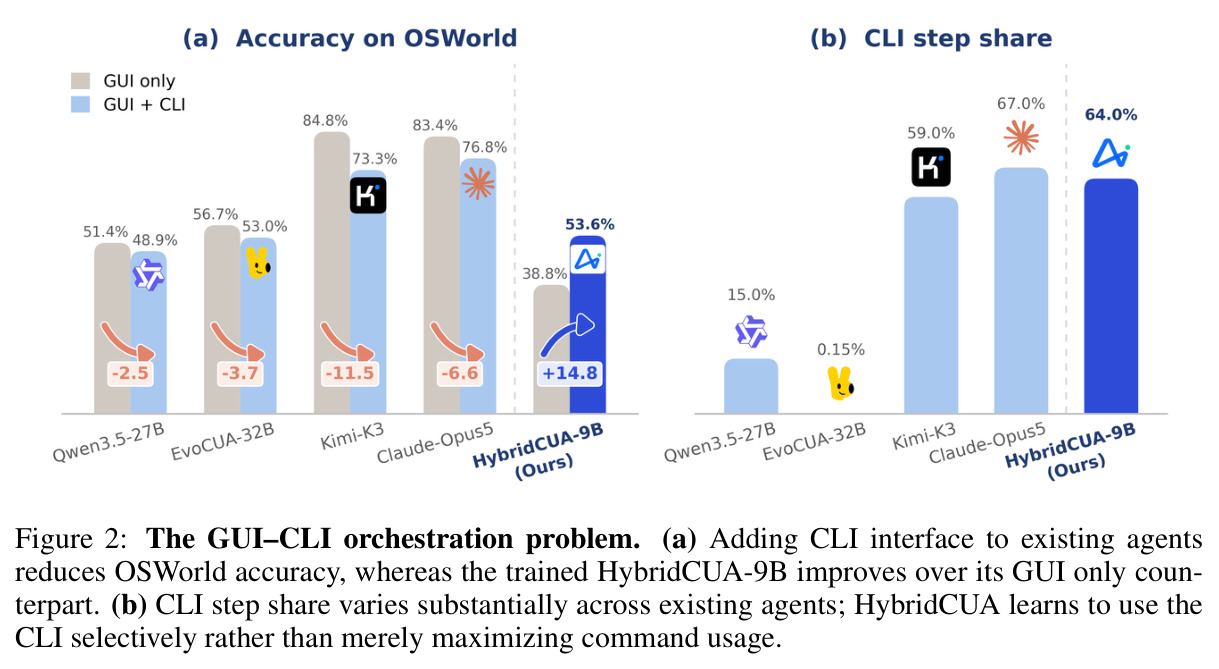
(a) 柱状图显示给四个代表性智能体开放CLI接口后OSWorld准确率均下降2.5-11.5个百分点,而训练后的HybridCUA-9B反而比其GUI-only对应版本提升;(b) 各智能体的CLI步骤占比差异巨大(Qwen3.5-27B仅15.0%、EvoCUA-32B仅0.15%),HybridCUA达到64.0%。
这是动机的核心证据图:它同时证明了「直接给shell会伤害性能」这一反直觉现象和「瓶颈在于何时/如何用CLI而非能否访问CLI」的问题定位,是理解论文立论的必看图表。