Mage-VL-Cowork:从进化脚手架中学习混合计算机操作的完整训练配方 Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
4B 混合 CUA 经五阶段课程与进化脚手架,OSWorld-Verified 达 66.0%。
前置知识
计算机使用代理(Computer-Use Agent, CUA)
通过截图感知桌面、用鼠标键盘坐标动作操作图形界面的智能体。本文提出的混合 CUA 还有第二条动作通道:一个持久 shell 终端,可运行代码、调用命令行工具和应用库(如 python-pptx)。策略需要在回合内部自己决定每个操作走 GUI 还是终端,这被称为混合执行策略。
全文的核心对象就是这种双通道策略:数据合成、五阶段课程、RL 奖励设计全部围绕'教会模型何时用像素、何时用命令'展开,不先理解通道概念就无法理解训练目标。
OSWorld-Verified 基准
端到端桌面任务完成度评测,覆盖文档、表格、演示文稿、浏览器、图像编辑和操作系统操作。Verified 版本对任务和判分做了核验。本文在 361 个 held-out 任务上评估,50 步预算,排除 Google Drive,总分 $\frac{1}{N}\sum_i s_i$,报告两次运行的平均值。
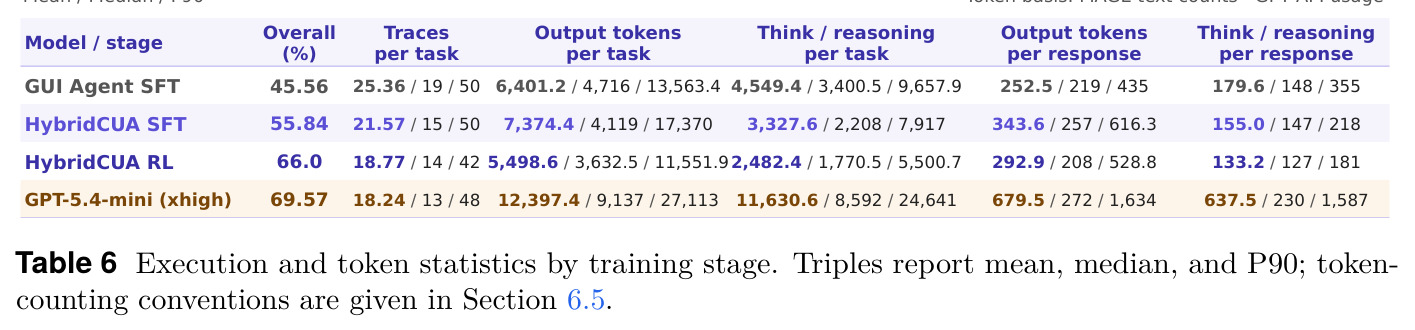
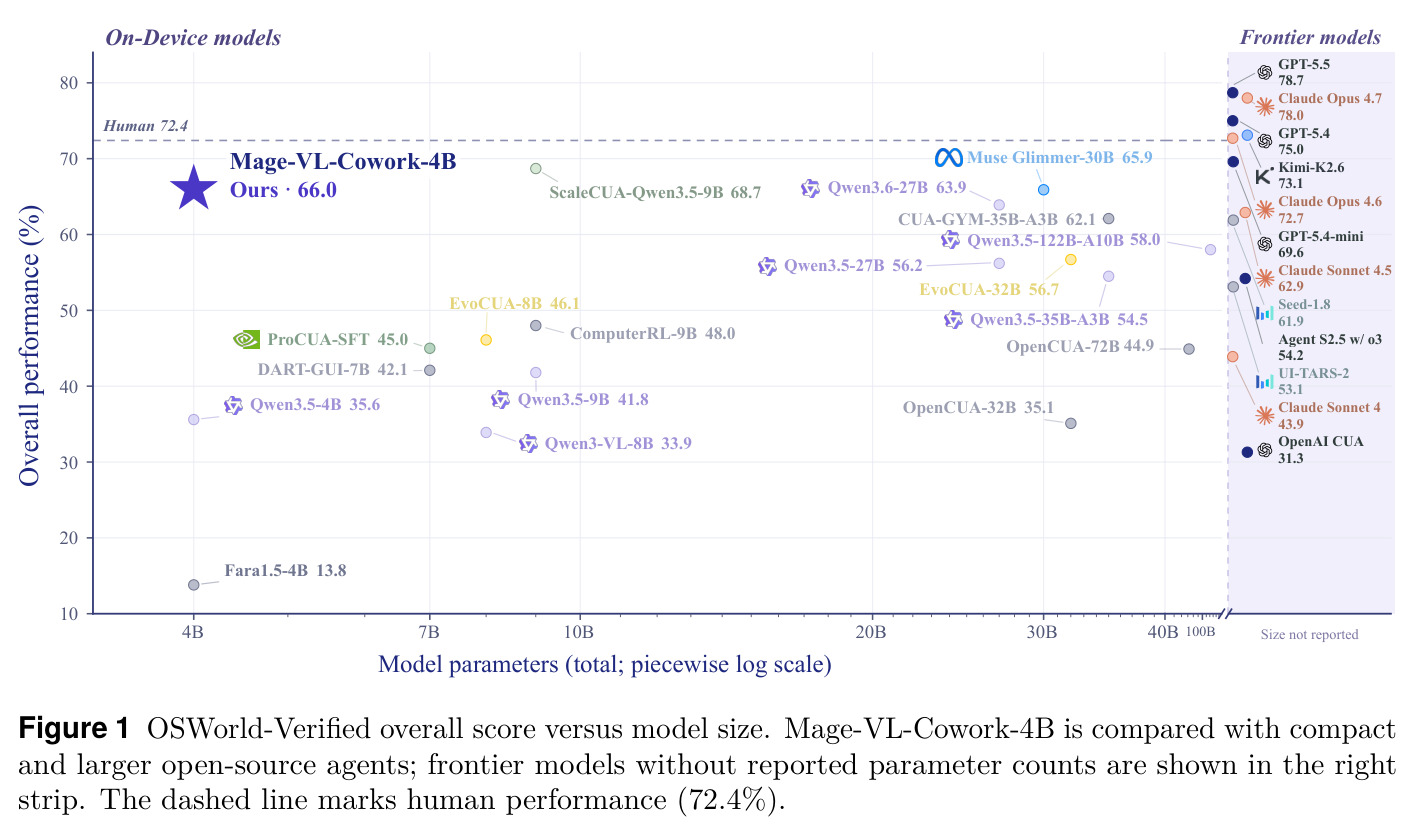
它是论文的主战场指标(66.0%),训练各阶段的进展(45.56%→55.84%→66.0%)和与所有基线的对比都在这个基准上展开。
轨迹蒸馏与 SFT
让前沿 teacher 模型在沙箱里执行任务,记录其截图、推理、工具调用序列形成轨迹数据集 $\mathcal{D}$,再对学生模型做监督微调(SFT),使小模型模仿 teacher 的完整决策过程。轨迹质量(通道选择是否干净、步骤是否紧凑)直接决定学生上限。
本文的论文题眼正是'轨迹质量由 harness 决定':同一 teacher 换不同 harness 蒸馏出的学生差 12.5 个百分点,理解蒸馏才能读懂 harness 进化的动机。
Harness(脚手架/工具环境)
包裹模型权重的外部执行框架,本文形式化为 $\mathcal{H} = (\mathcal{F}, \mathcal{T}, \mathcal{P}, \mathcal{E})$:脚手架 $\mathcal{F}$ 管执行循环与上下文处理,工具接口 $\mathcal{T}$ 定义 GUI/终端动作及参数模式,提示 $\mathcal{P}$ 是系统提示,终端环境 $\mathcal{E}$ 是沙箱内预装的命令行工具与库。完整 teacher 为 $A_T = (\mathcal{M}_T, \mathcal{H})$。
本文最大创新是在冻结 teacher 权重的前提下进化 $\mathcal{F},\mathcal{T},\mathcal{P},\mathcal{E}$ 四个组件,'harness 不是中立容器'是全文立论基础。
GRPO 与异步在线 RL
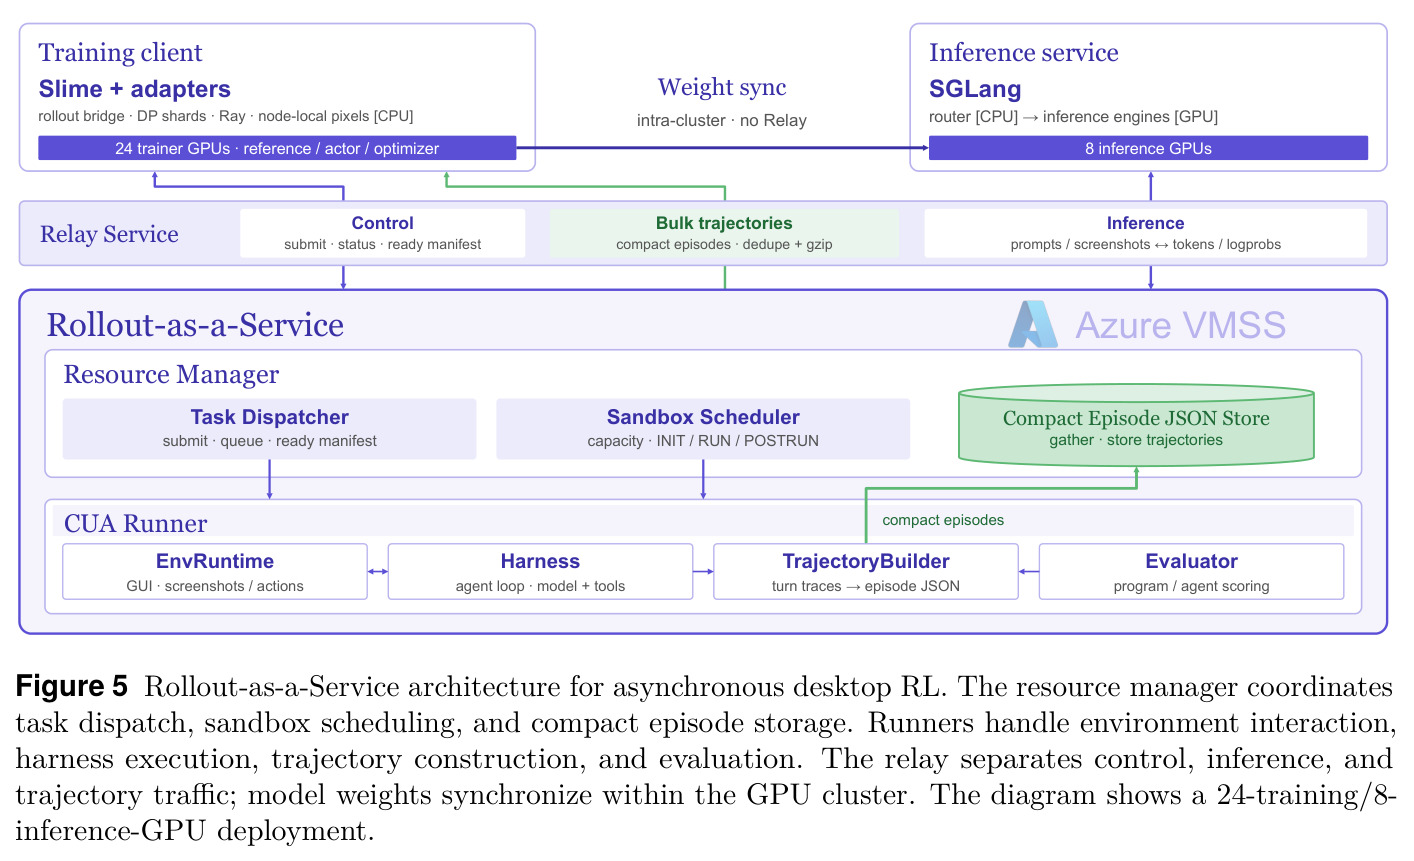
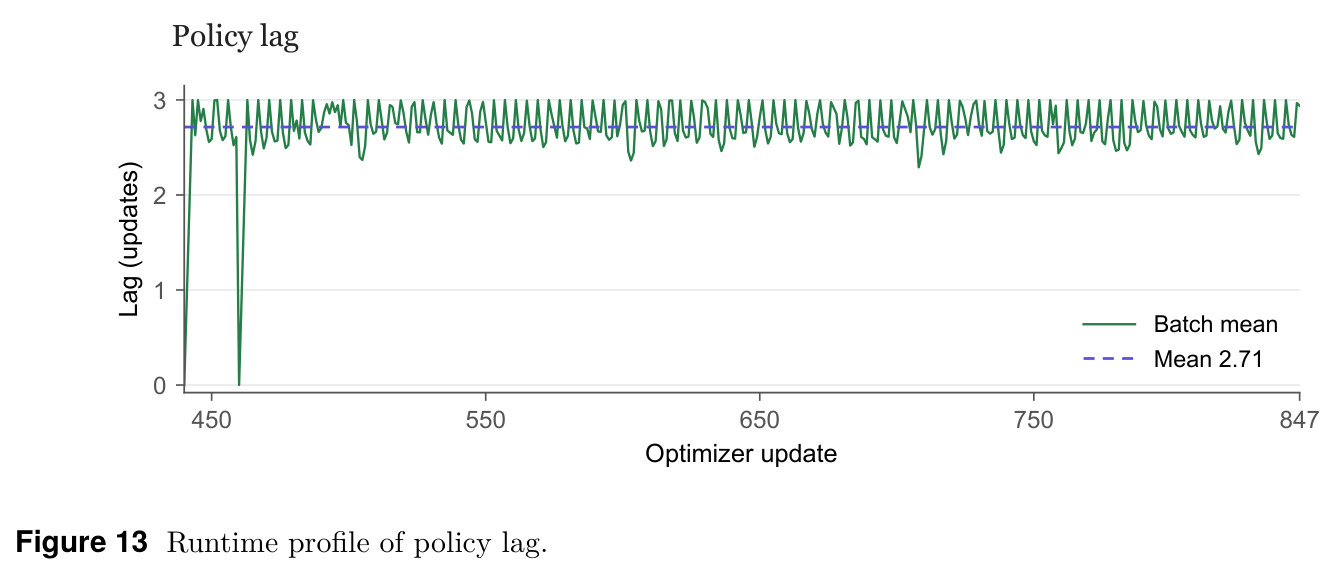
GRPO(Group Relative Policy Optimization)对每个任务采样一组 rollout,用组内相对优势替代价值网络。桌面 rollout 单集可超 40 分钟,故采用异步采集:4-batch 准入窗口、策略滞后上限 3 次更新,配合截断重要性采样(TIS,权重上限 2.0)修正 rollout 策略与训练策略的版本错配。
Stage 5 贡献了从 55.84% 到 66.0% 的最后 10.16 个百分点,且论文花了整整一章(含附录 C)讲支撑这套异步 RL 的基础设施。
Midtraining(中期训练)
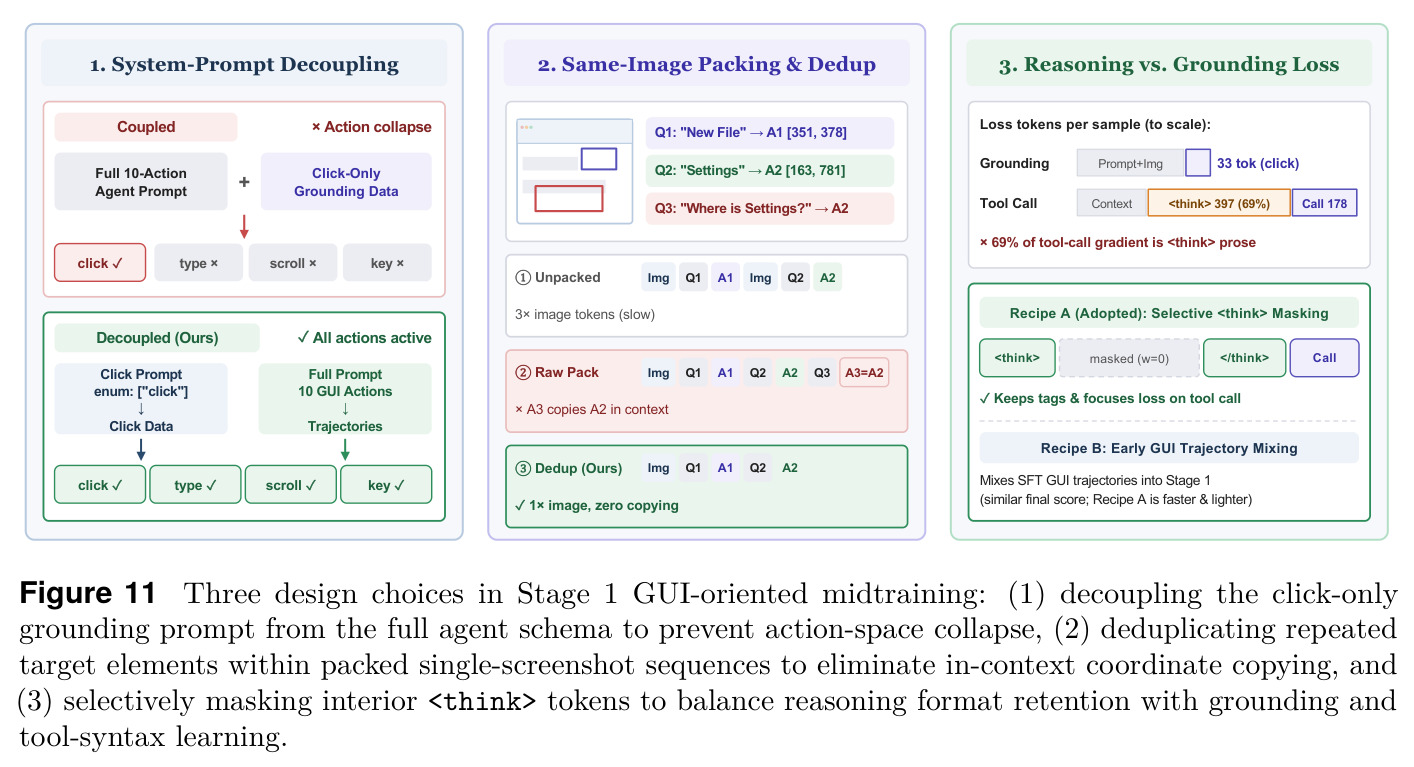
介于预训练与后训练之间的阶段:从通用多模态 checkpoint 出发,用 GUI grounding、工具调用格式和思维链数据把答案机倾向纠正为'先推理再调工具'的行为,为多步轨迹训练打底。本文还构建了 Single Step Cowork Bench(342 个真实桌面交互步)做快速诊断。
Stage 1 是'从通用底座而非专用底座起步'这一卖点的关键,论文详细讨论了其中三个反直觉设计(提示解耦、目标去重、 掩码)。
研究动机
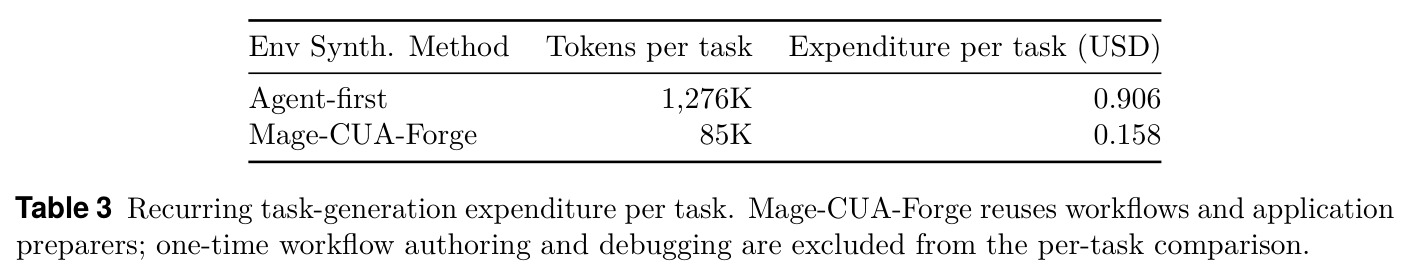
现有计算机使用代理(CUA)几乎都把动作通道限定在图形界面上:模型看截图、输出鼠标键盘坐标动作。这条通道虽然普适但昂贵——一张高分辨率截图动辄数千 token,长程任务的上下文与推理成本迅速膨胀;更本质的是它强迫模型用像素去'重新推导'一条 shell 命令就能完成的工作(例如用几十次点击更新电子表格),同时切断了模型核对自身工作的最可靠信道(读文件确认对话框声称的保存是否属实)。而单纯给模型加上终端工具并不等于混合能力:已有工作(OSWorld-MCP、受控截图/工具对比实验)表明同一套工具对不同模型效果迥异,即便前沿 teacher 在朴素设置下也表现出次优的通道习惯——要么靠反复点击做重复的文件编辑,要么在运行中的应用把文件缓存于内存、退出时覆写磁盘的情况下直接改磁盘文件导致编辑丢失。数据侧同样昂贵:以 agent-first 方式为每个任务从零构建环境的合成流水线,平均每任务要消耗约 0.906 美元、127.6 万 token。此外,ProCUA、ScaleCUA 等主流后训练工作默认从已具备强 grounding、coding 与 agent 能力的专用 checkpoint 出发,学界缺少一条从通用多模态底座到混合 CUA 的完整端到端配方。
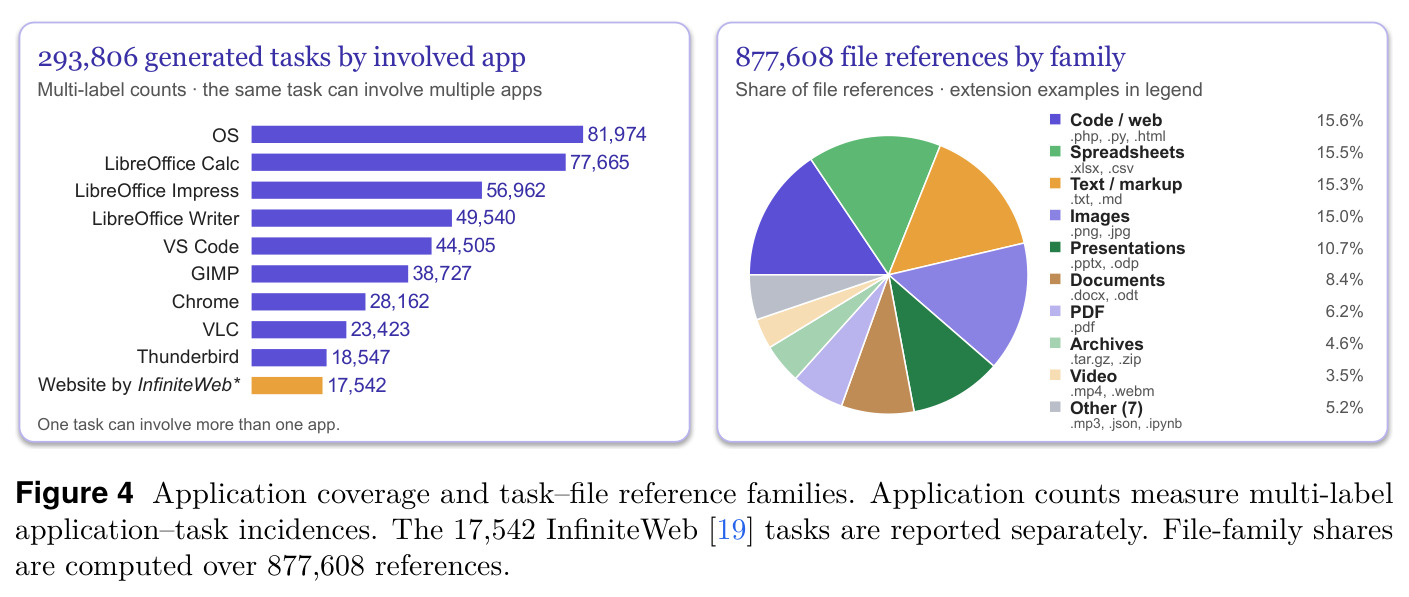
本文的目标是本文要端到端训练一个 40 亿参数的混合 CUA——Mage-VL-Cowork:单一策略既能观察全桌面截图、发出坐标级鼠标键盘动作,也能在同一回合内切换到终端,运行代码、调用命令行工具与 python-pptx 之类的应用库,让'哪个操作走哪条通道'的路由决策内化在策略内部而非外部编排器。为此需要回答三个子问题:(1) 当前沿 teacher(GPT-5.4 级)的默认通道路由本身不完美时,如何仍采得干净的混合示范轨迹;(2) 如何以高一致性、低边际成本合成覆盖桌面与浏览器的海量可验证任务与环境(最终规模为 293,806 个任务、6,915 个原子技能);(3) 如何从一个通用的多模态对齐 checkpoint 出发设计渐进式课程,最终在 OSWorld-Verified 上以 50 步预算逼近甚至超过 27B–30B 级开源 agent,把可用智能推进到端侧设备。
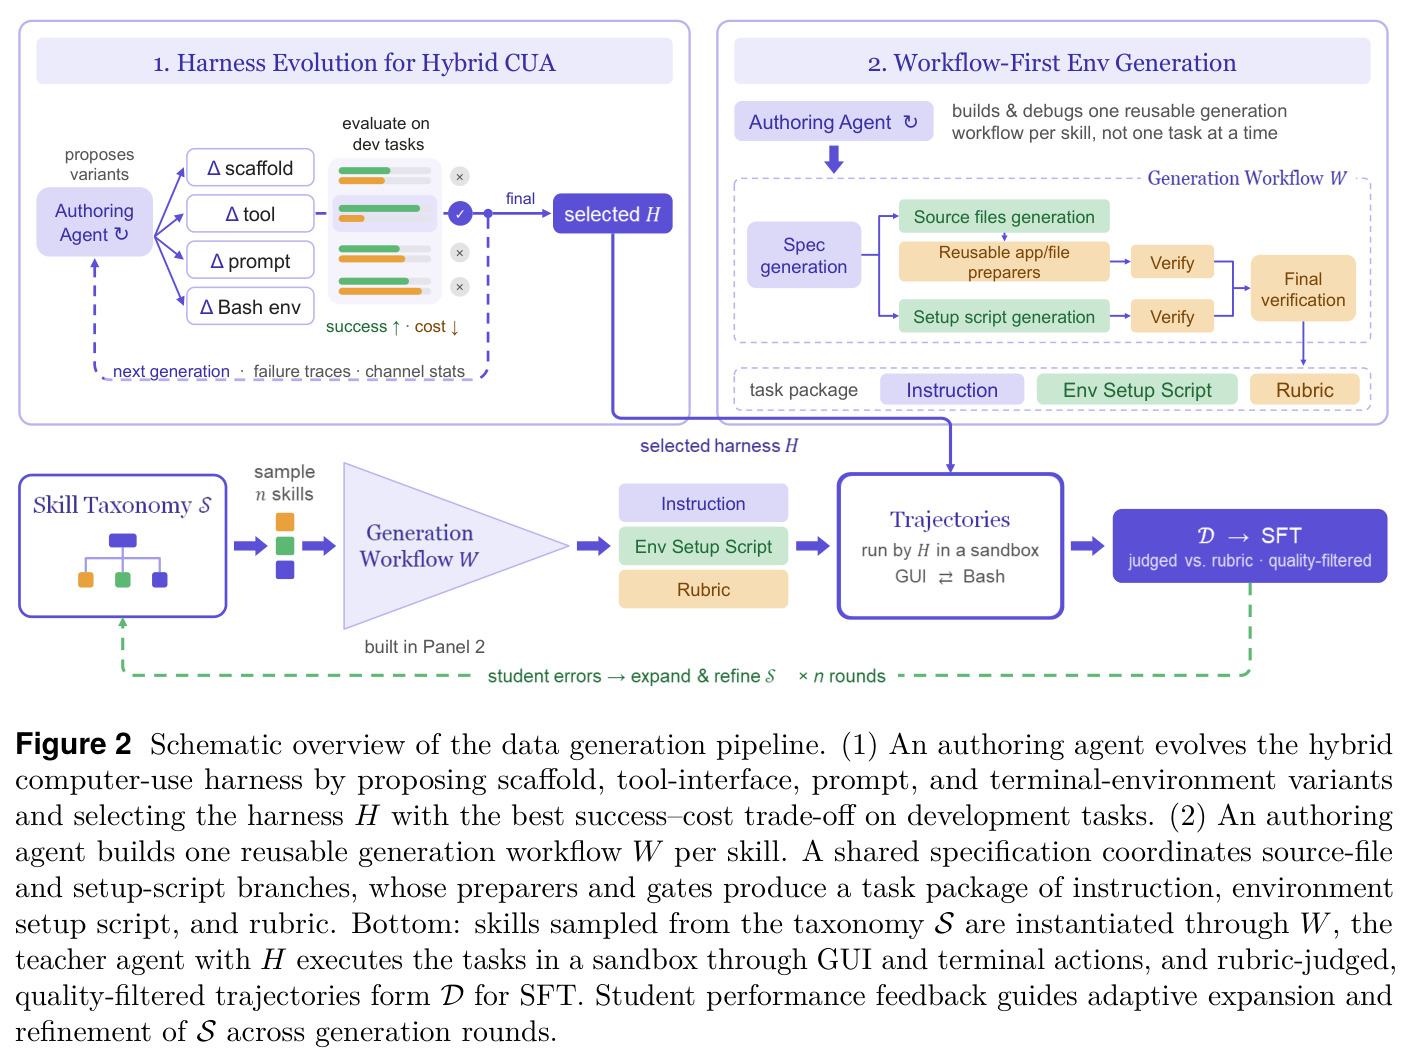
与已有工作不同的是,三个独特切入角度。其一,把 harness 当成一等公民来优化:作者指出脚手架不是中立容器,其工具接口、上下文处理与提示会系统性地改变同一 teacher 的行为,因此在大规模 rollout 之前,先用一个 authoring agent 基于成功率、每任务 token 成本和通道统计在开发集上迭代进化 harness——而且进化'既是生长也是修剪':删掉 xdotool 这类与原生 GUI 动作重复的工具避免监督分裂,加入 python-pptx 让 teacher 直接操作形状与文本,这与只做加法的 skill-library 路线本质不同。其二,workflow-first 的任务与环境合成:agent 精力花在'每个原子技能一次'而非'每个任务一次',为每个技能构建可复用生成工作流和应用专属 preparer,把每任务边际开销从 0.906 美元压到 0.158 美元。其三,specialize-then-unify 的五阶段课程:不同于 ProCUA/ScaleCUA 直接后训练专用底座,本文从通用 Mage-VL checkpoint 起步,先分别建立 GUI 与 coding 两条腿的独立能力,再合并教通道路由,最后在线 RL 收尾。
核心方法
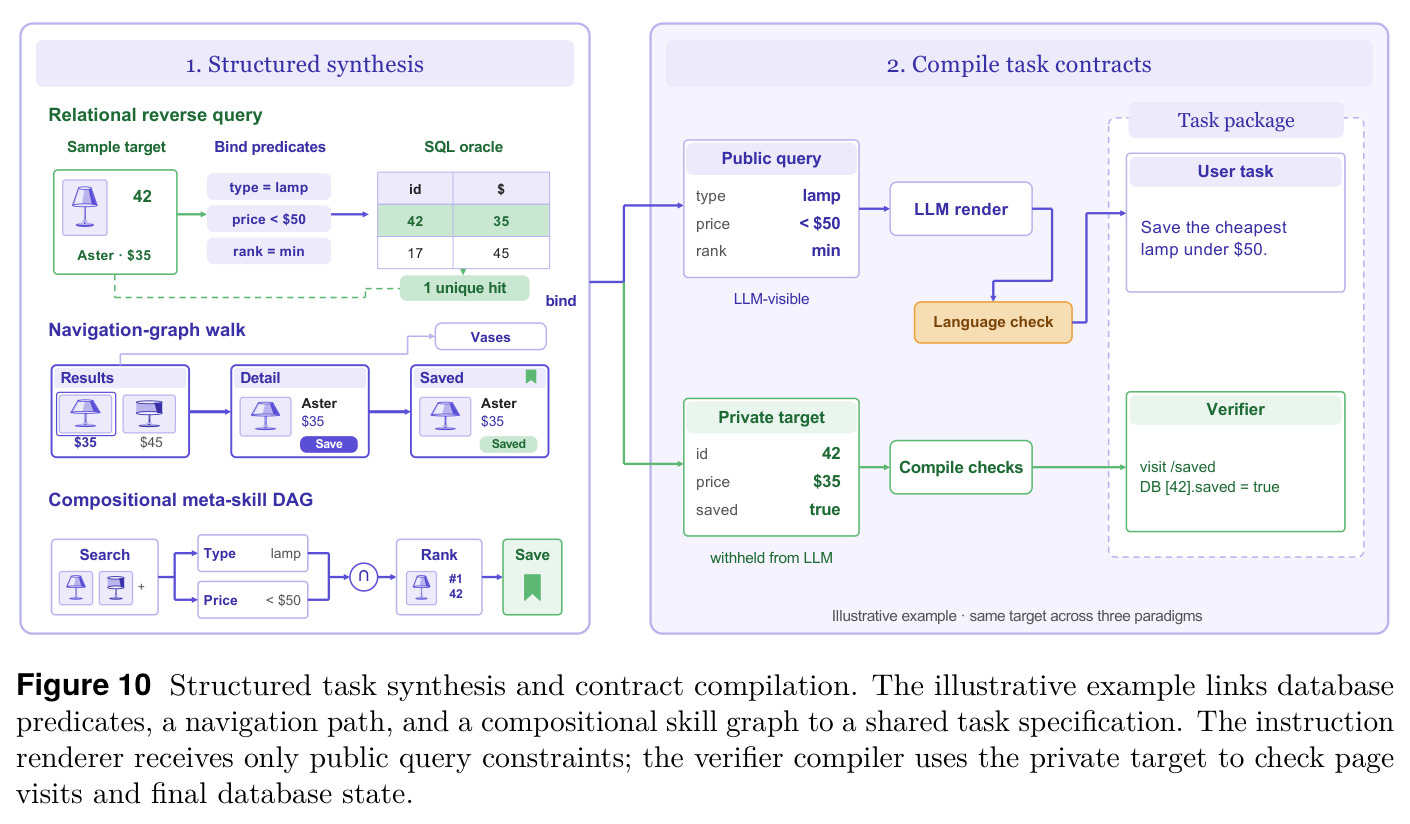
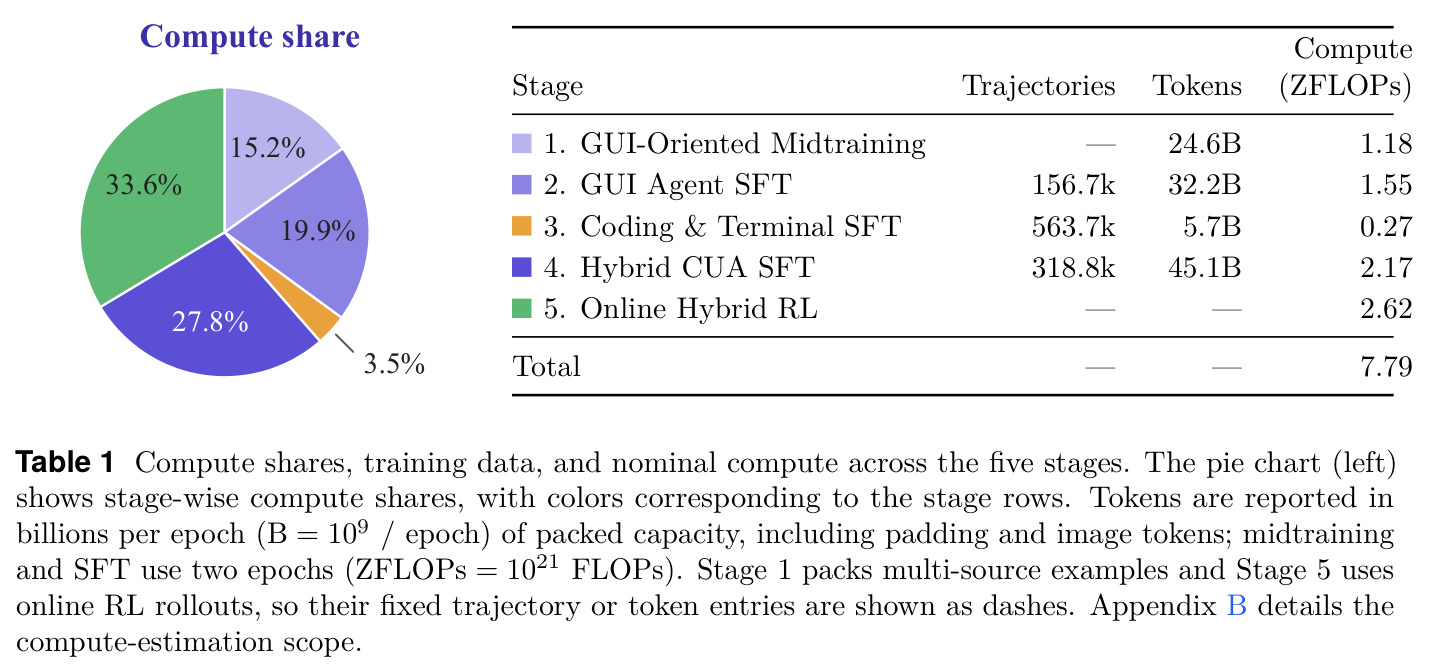
直觉上,论文把'教会一个小模型用电脑'拆成三件事:先造一条能批量生产可验证练习题的流水线,再为出题人(teacher)配一套调教好的工具台,最后按'先分科、再综合、后实战'的顺序训练学生。技术上分三块。(1) Mage-CUA-Forge 数据合成:探索 agent 遍历桌面应用建立技能分类学 $\mathcal{S}$(6,915 个原子技能),authoring agent 为每个技能构建一条可复用生成工作流,LLM 节点与应用专属 preparer 组合产出任务三件套——指令、环境搭建脚本、评分 rubric;从 $\mathcal{S}$ 采样技能组合成复合任务,teacher 用进化后的 harness $\mathcal{H}$ 在沙箱执行,经 gpt-5.6-terra rubric 判卷与质量过滤得到 318,837 条轨迹 $\mathcal{D}$,学生反馈再驱动 $\mathcal{S}$ 三轮迭代扩充。(2) 五阶段训练:从中间版 4B Mage-VL checkpoint 依次经过 GUI 导向 midtraining(24.6B token)、GUI Agent SFT(156.7k 轨迹)、Coding & Terminal SFT(563.7k)、Hybrid CUA SFT(318.8k 轨迹、1,377,805 个 32,768-token 打包 bin)、在线混合 RL(GRPO,1,988 个 ScaleCUA 可验证任务),名义计算总量 7.79 ZFLOPs。(3) Rollout-as-a-Service 异步 RL 基础设施:70 台 CPU 主机跑 1,120 个桌面沙箱槽位,32 张 B200 按 24 训练/8 推理分配,用 4-batch 准入窗口把策略滞后压在 3 次更新内,TIS 上限 2.0。
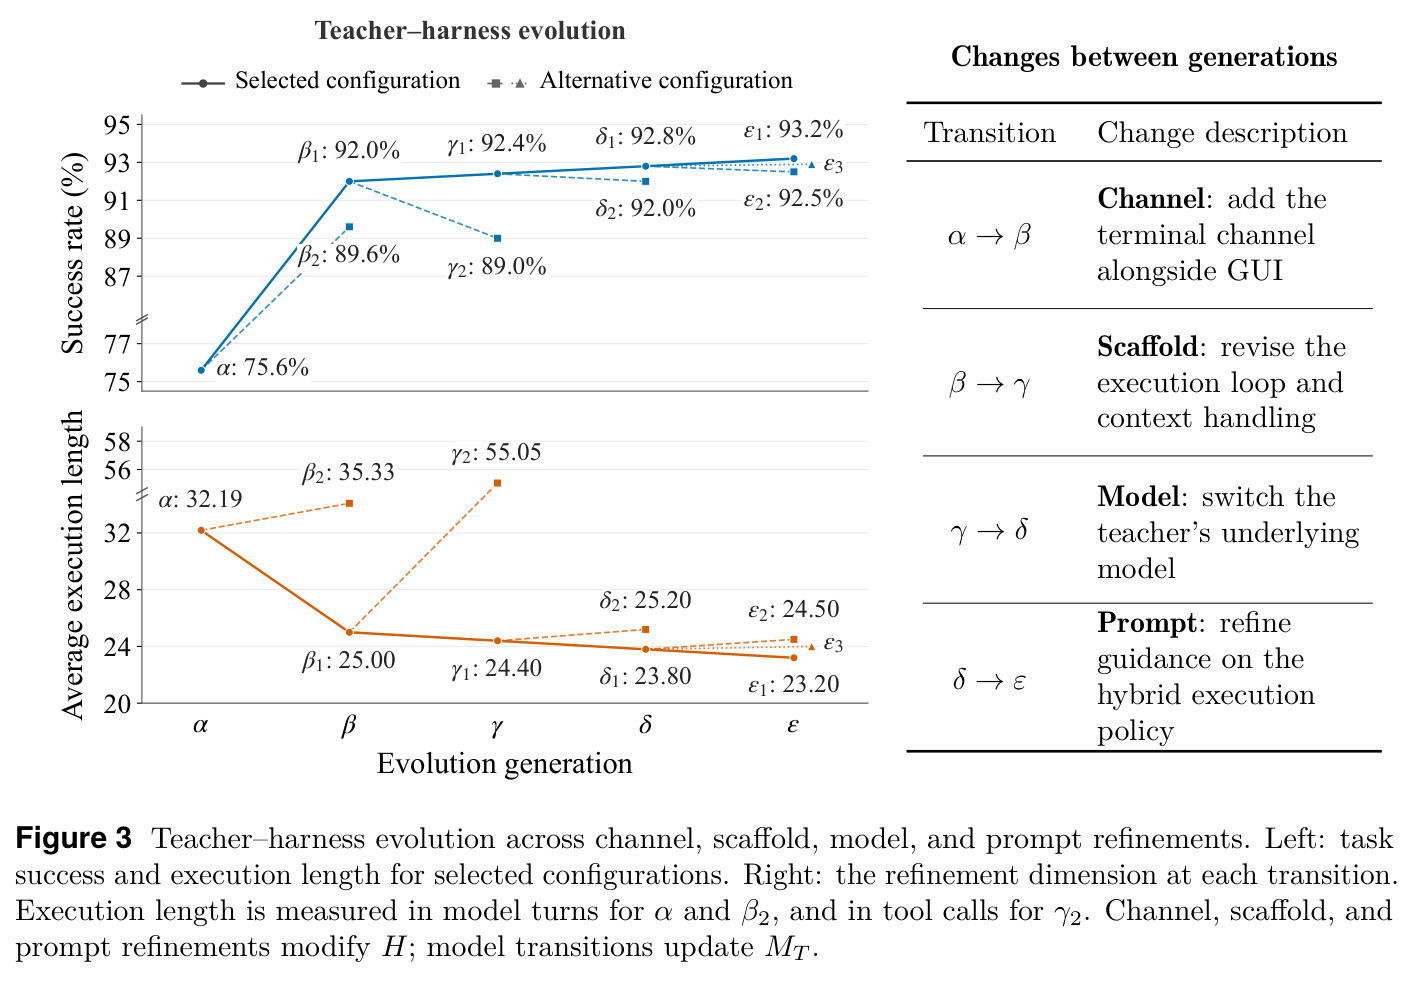
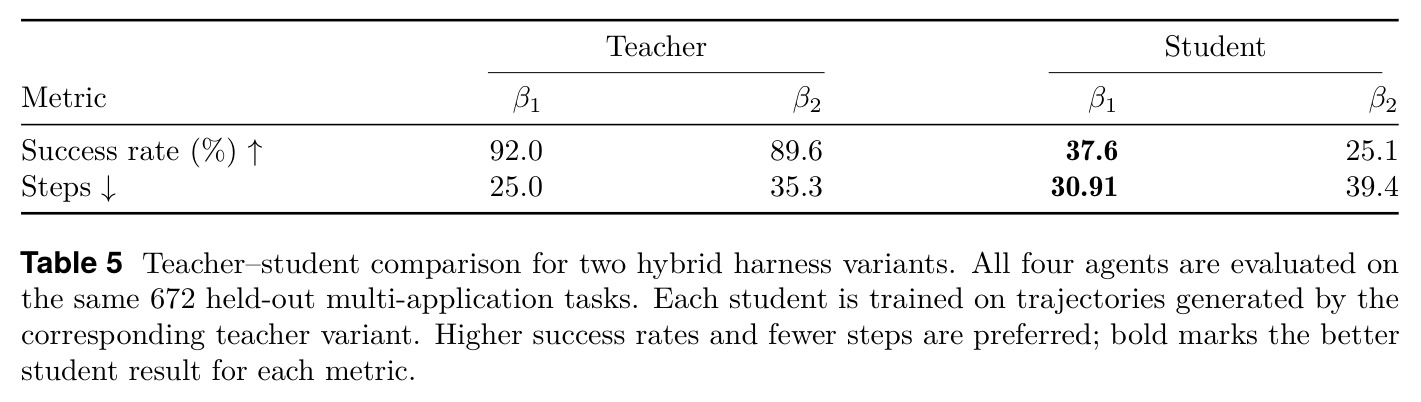
核心创新有两点,都围绕'监督质量决定小模型上限'。第一是 evolved harness:把 teacher 形式化为 $A_T = (\mathcal{M}_T, \mathcal{H})$,其中 $\mathcal{H} = (\mathcal{F}, \mathcal{T}, \mathcal{P}, \mathcal{E})$ 分别是脚手架、工具接口、系统提示和终端执行环境;冻结 $\mathcal{M}_T$ 权重,让 authoring agent 基于开发集上的成功-成本权衡迭代这四个组件。关键洞察是进化既是加法也是减法:移除 xdotool 避免同一鼠标键盘动作出现双路由和脆弱的窗口焦点处理,引入 python-pptx 等领域库让 teacher 直接操作幻灯片对象。最有说服力的证据是 Table 5 的对照实验:同为 GPT-5.4,β1(GUI+coding 双通道)比 β2(GUI+coding+AX 无障碍三通道)的 teacher 成功率只高 2.4 个百分点(92.0% vs 89.6%)、步数少 29.2%(25.0 vs 35.3),但各自蒸馏出的 4B 学生差距被放大到 12.5 个百分点(37.6% vs 25.1%)——前沿模型能靠多走几步吸收冗余通道,4B 学生对含糊路由则极度敏感。第二是 workflow-first 合成:每个技能构建一次可复用工作流与 preparer,同一任务包由共享规格协调源文件与环境脚本两条分支,边际成本降 82.6%($0.906→$0.158)、token 降 93.3%(1,276K→85K)。
方法步骤详情
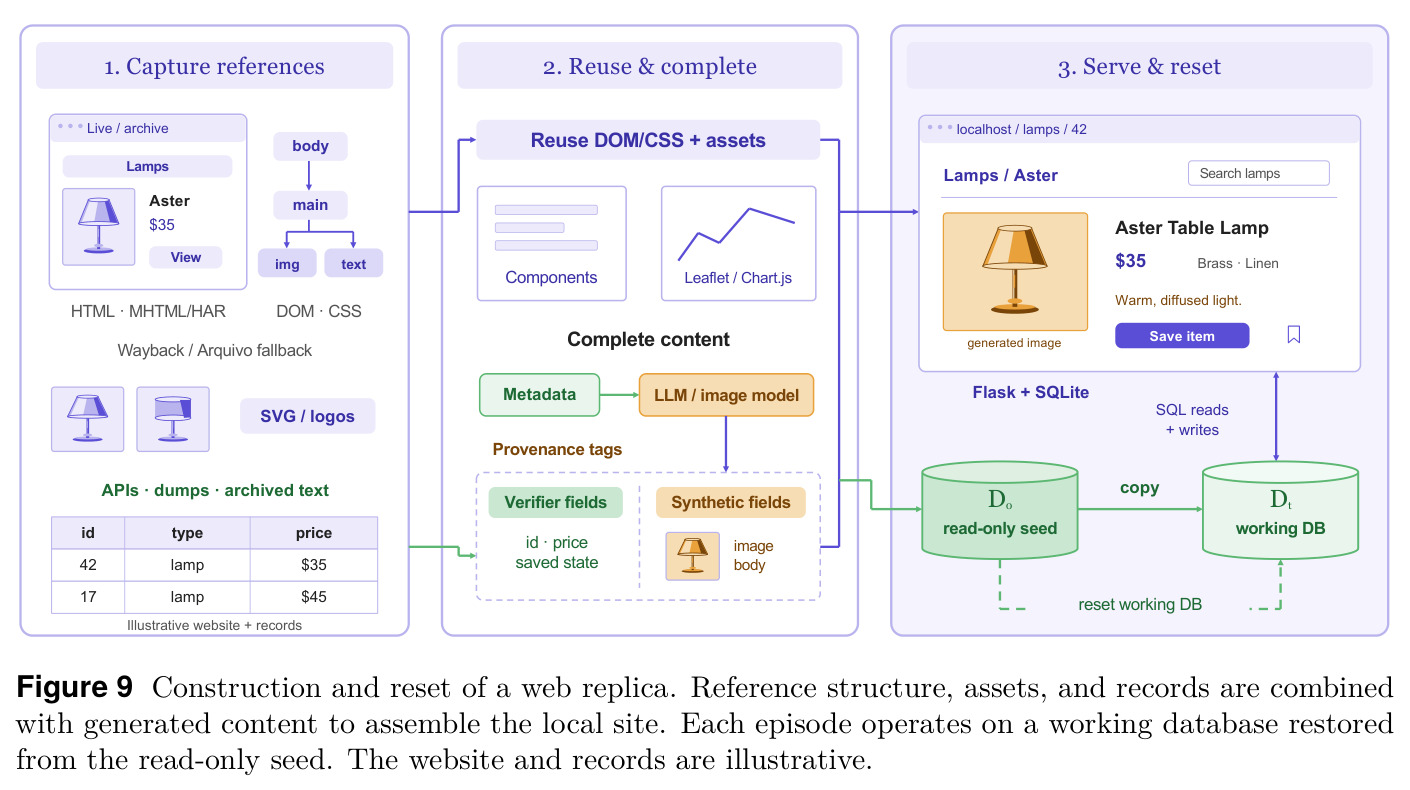
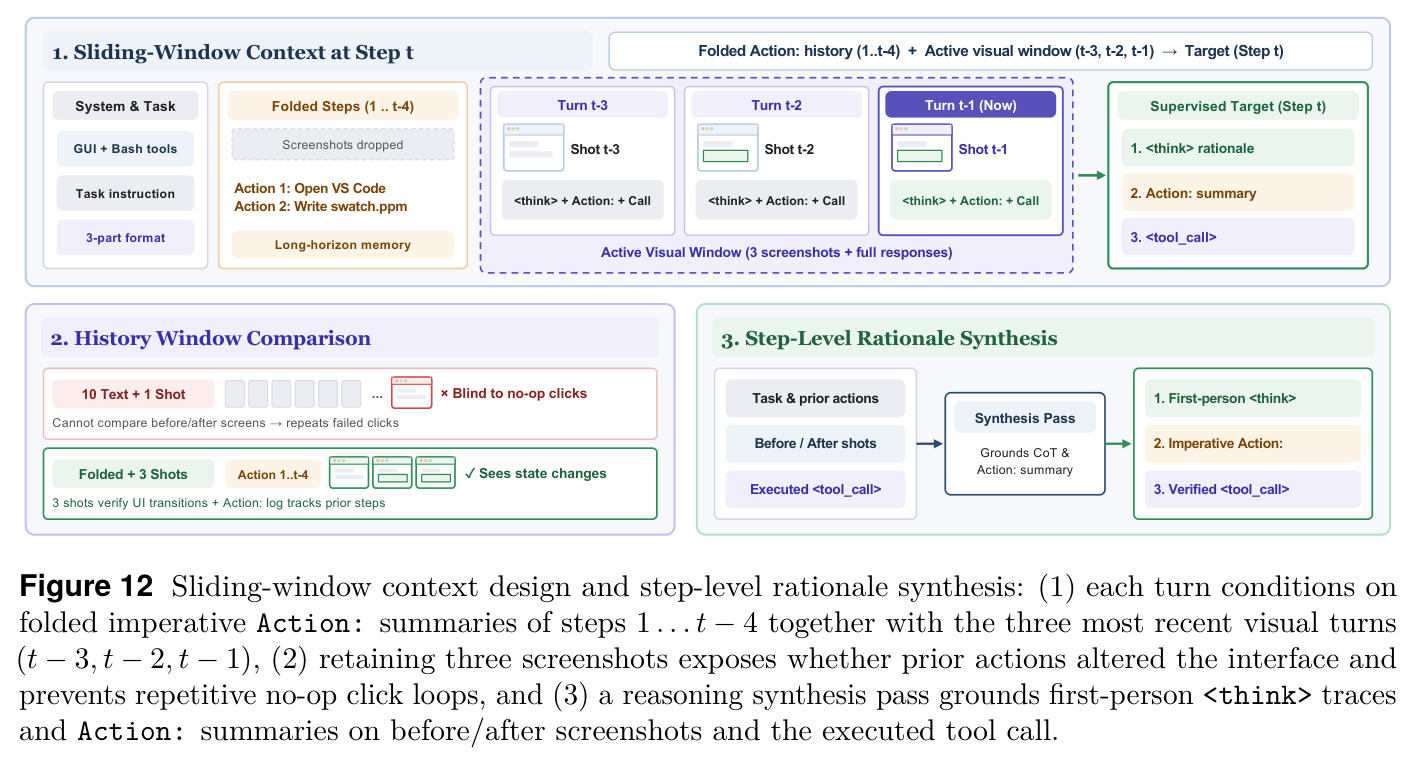
完整流程如下。(1) 技能分类学构建:探索 agent 遍历 OS、LibreOffice Calc/Writer/Impress、VS Code、GIMP、Chrome、VLC、Thunderbird 等应用记录原子技能,形成 $\mathcal{S}$。(2) 工作流构建与任务实例化:authoring agent 为每个技能构建并调试生成工作流——LLM 节点生成源文件内容,应用专属 preparer 物化输入工件(如 Calc 工作簿、带邮件库的 Thunderbird profile),文件级 gate 与包级 gate 校验指令-环境-rubric 一致性;浏览器与跨应用任务配自托管、每集从种子库复位的 Flask+SQLite 网站复刻。同一批任务分别在 GUI harness、terminal harness 与进化混合 harness 下 rollout,得到强调不同能力的轨迹(混合数据中 GUI 与终端工具调用占 68.19% 与 31.81%),再由 GPT-5.4-mini 多阶段标注步级推理。(3) Stage 1 GUI 导向 midtraining:用 UI-E2I-Synth、UGround、OS-Atlas 等 720p–1080p 桌面截图数据,坐标归一到 [0,999] 并格式化为 computer_use click 调用,采用点击提示解耦、同截图目标去重、 内部 token 选择性掩码三项设计,同时混入工具调用与轨迹数据。(4) Stage 2 GUI Agent SFT:156.7k 条 GUI-only teacher 轨迹把定位能力升级为多步 GUI 执行策略。(5) Stage 3 Coding & Terminal SFT:terminal-only teacher 在同一批桌面任务上的成功轨迹,加 Terminal-Bench/SWE-bench 风格数据共 563.7k 条,教模型用代码操作工作簿、文档、演示文稿。(6) Stage 4 Hybrid CUA SFT:318,837 条混合轨迹教回合级通道路由,上下文为滑动窗口(保留最近 3 张截图与 4 条完整回复,更早步骤折叠成命令式 Action: 摘要),每步目标为 理由 + Action: 摘要 + 。(7) Stage 5 在线混合 RL:GRPO 优化 1,988 个 ScaleCUA 任务,frontier sampling 按预跑成功率分配 rollout,每次更新 96 个任务组×8 个槽位。midtraining/SFT 均为 2 epoch。
技术新颖性
与已有工作的本质区别体现在四个维度。数据合成上,OS-Genesis、CUA-Gym 等对每个任务重复开放式 agent 构建循环,Mage-CUA-Forge 则把构建成本一次性摊入可复用工作流与 preparer,每任务边际开销从 0.906 美元降至 0.158 美元;且在完整桌面上'环境'是应用状态而非容器文件系统,preparer 的价值正在于物化 Calc 工作簿、Thunderbird 邮件库这类应用态,浏览器侧用可复位复刻(扩展 WebHarbor)加 InfiniteWeb 合成站保证可验证性——这是对'桌面环境合成'问题的重新定义。teacher 利用上,ProCUA/ScaleCUA 隐含假设 teacher 默认 rollout 可直接蒸馏,本文首次量化了 harness 对监督质量的放大效应(teacher +2.4pp → student +12.5pp),并把'harness 进化'从工程直觉提升为有消融支撑的方法论。系统设计上,CoAct-1 等在 orchestrator 层做 GUI/coding 路由,本文把通道选择内化进单一策略,路由本身成为训练数据必须教授的能力。训练范围上,MolmoWeb 局限于浏览器、多数流水线依赖专用底座,本文给出从通用多模态 checkpoint 到混合桌面 CUA 的完整五阶段配方,并把 RL 基建(RaaS、滞后控制、每更新 570.3 秒、滞后均值 2.71)作为一等贡献披露。
实验结果
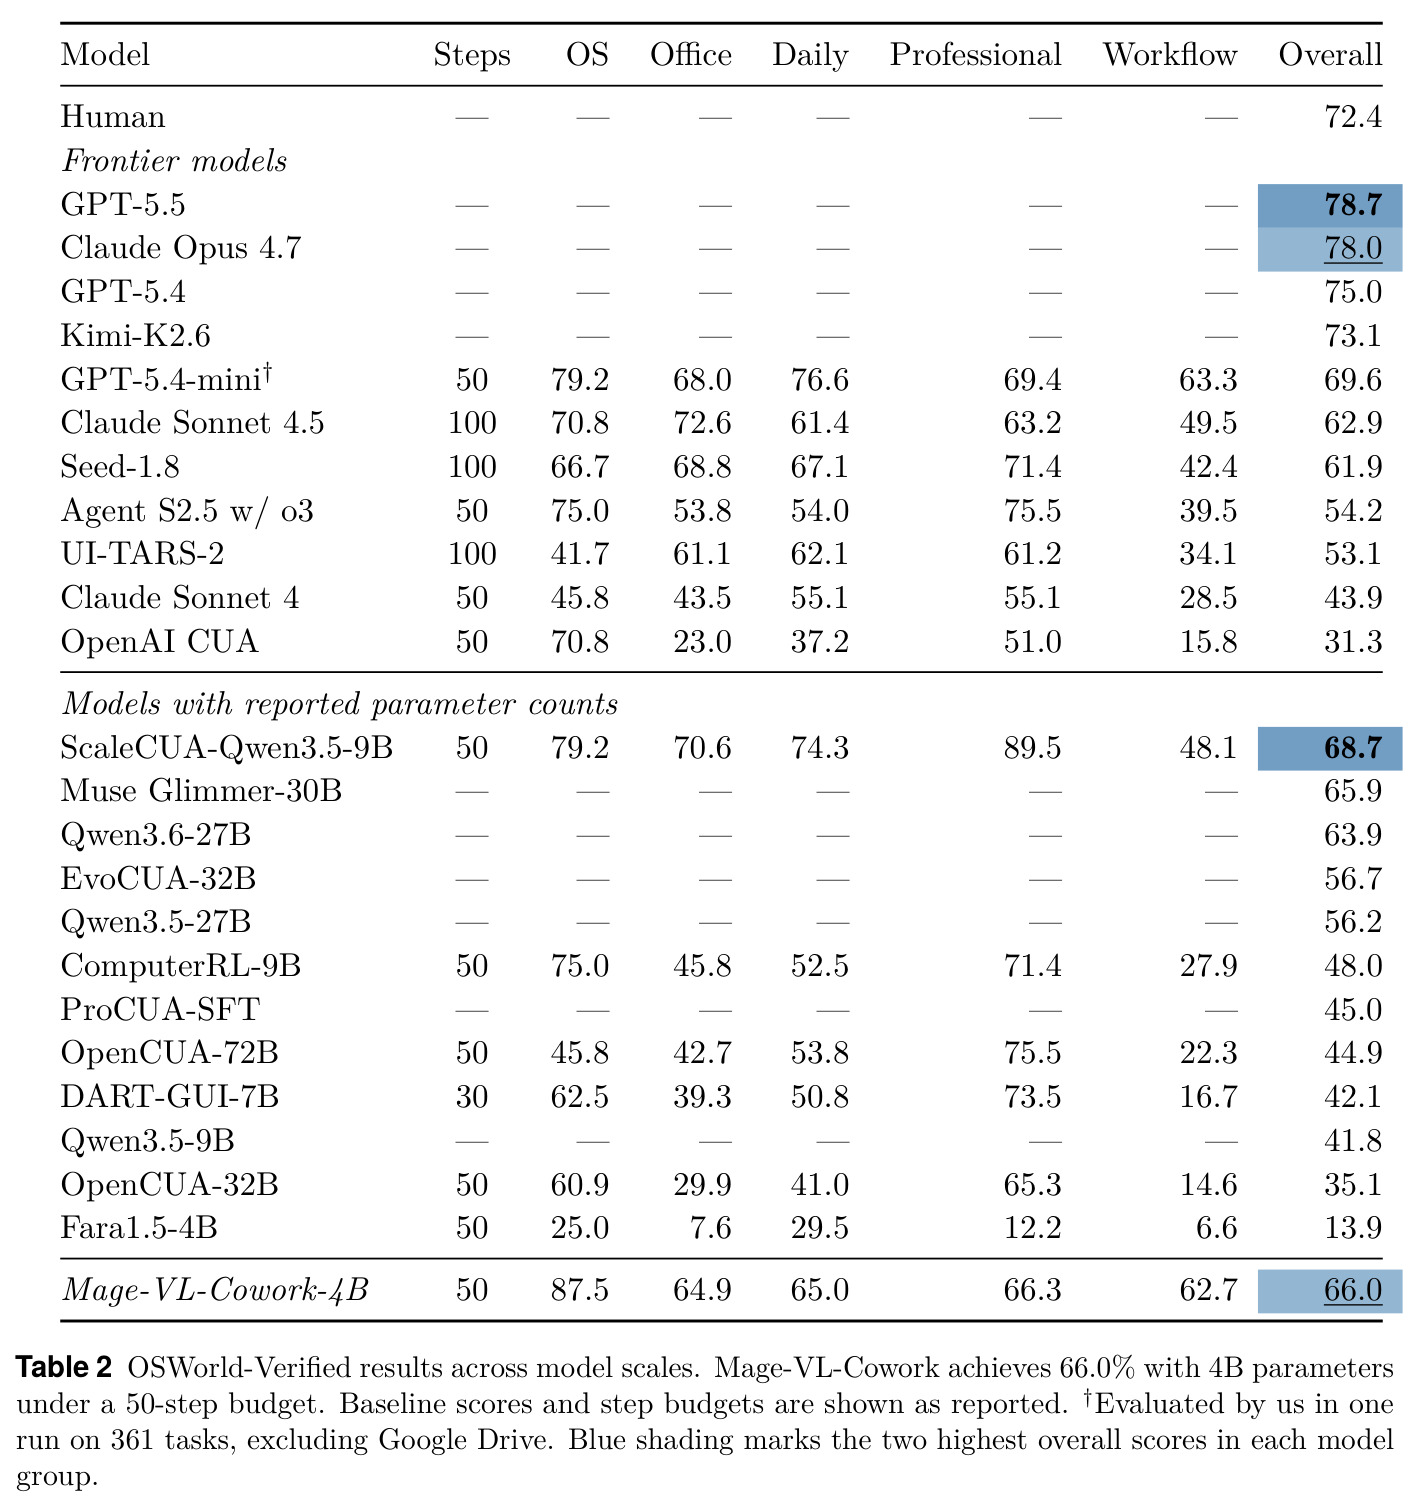
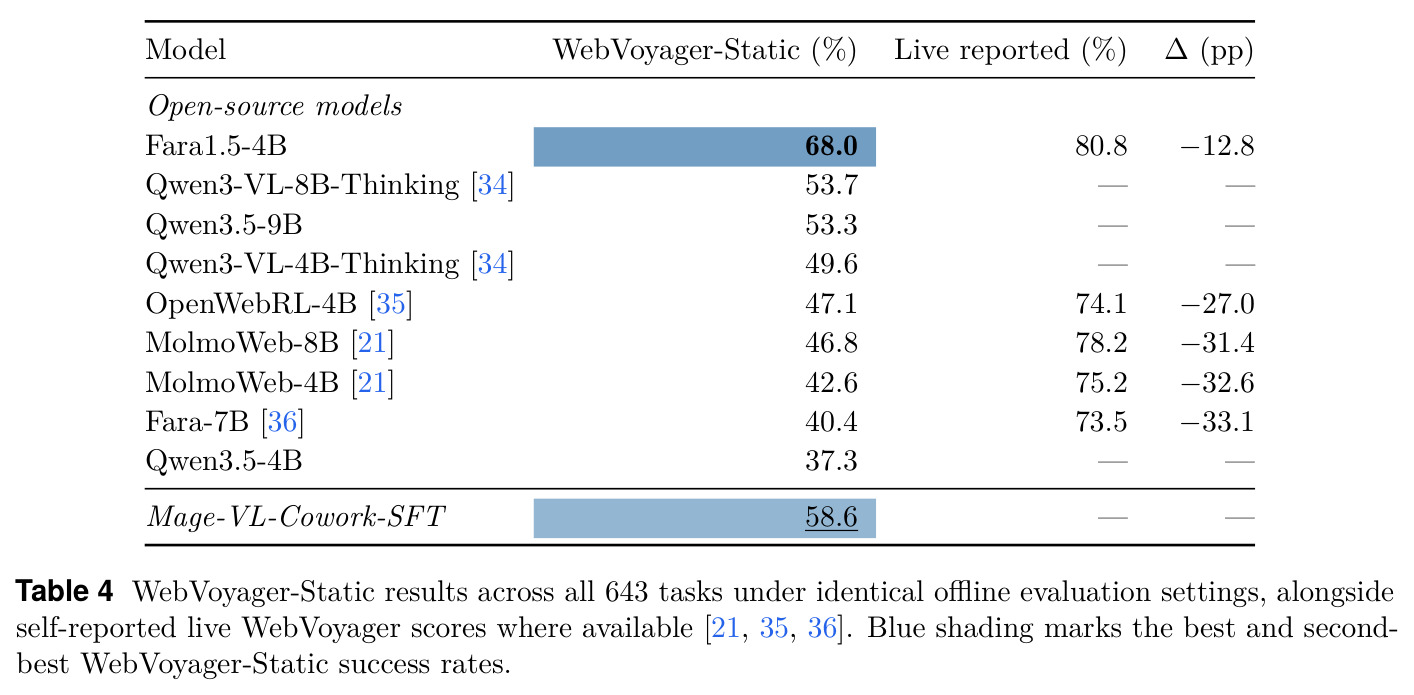
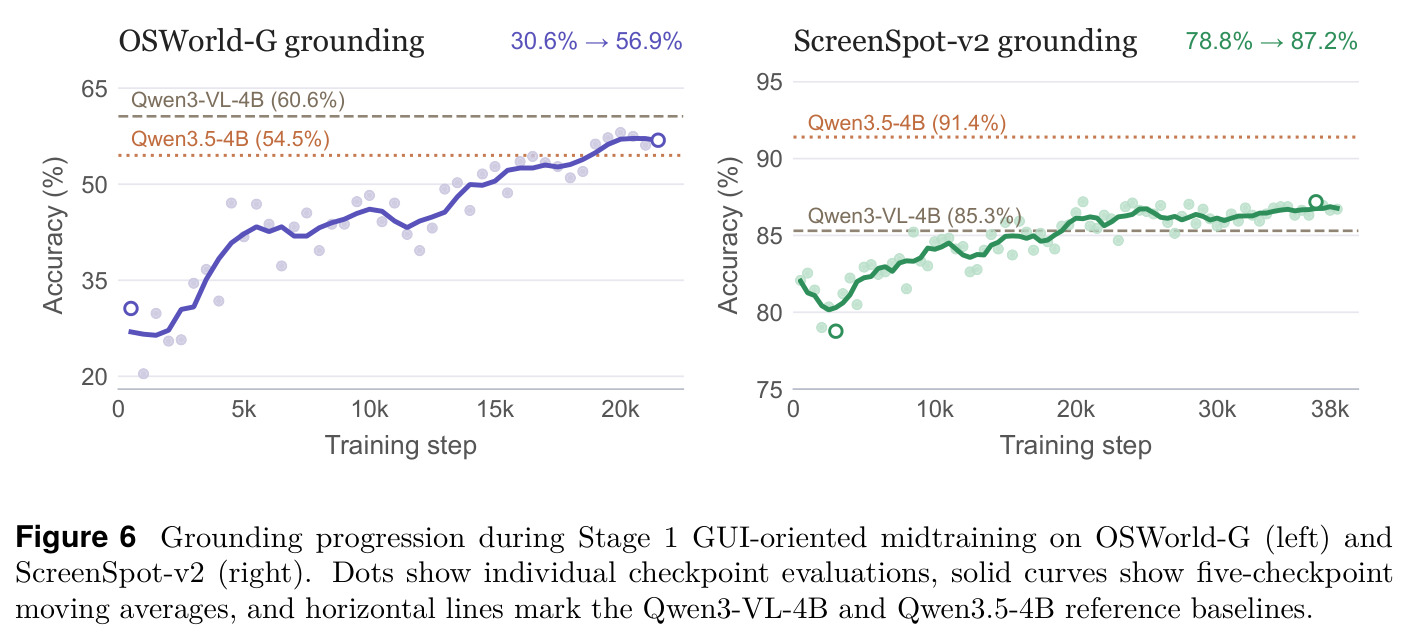
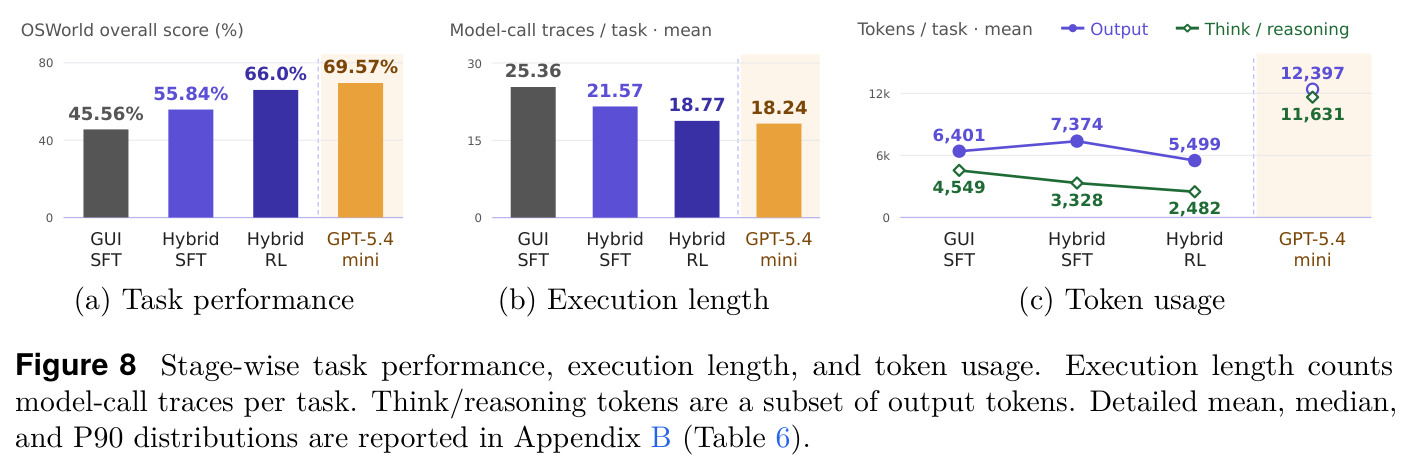
最终模型在 OSWorld-Verified(361 个 held-out 任务、50 步预算、两次运行平均、排除 Google Drive)取得 66.0%:分类别为 OS 87.5%(全表最高)、Office 64.9%、Daily 65.0%、Professional 66.3%、Workflow 62.7%。以 4B 参数超过 7.5–18 倍大的开源 agent:Muse Glimmer-30B 65.9%、Qwen3.6-27B 63.9%、EvoCUA-32B 56.7%、OpenCUA-72B 44.9%;较同尺寸 Fara1.5-4B(13.9%)高 52.1 个百分点,Workflow 上比 ScaleCUA-Qwen3.5-9B(48.1%)高 14.6 个百分点。训练进程上,OSWorld 分数从 GUI SFT 的 45.56% 经 Hybrid SFT 的 55.84%(+10.28pp)到 RL 的 66.0%(+10.16pp),累计 +20.44pp;效率同步改善:平均模型调用从 25.36 降至 21.57 再到 18.77(接近 GPT-5.4-mini 的 18.24),RL 使每任务输出 token 从 7,374 降到 5,499、think token 降约 25.4%,而 GPT-5.4-mini(xhigh)每任务需 12,397 个输出 token 才拿到 69.57%。Stage 1 中 OSWorld-G 定位从 30.6% 升至 56.9%(超 Qwen3.5-4B 的 54.5%),ScreenSpot-v2 从 78.8% 升至 87.2%(超 Qwen3-VL-4B 的 85.3%)。浏览器侧,自建 WebVoyager-Static(643 任务,同时核验访问轨迹、答案与后端数据库状态)上 SFT 模型得 58.6%(377/643),仅次于专用浏览器 agent Fara1.5-4B 的 68.0%,超过 Qwen3-VL-8B-Thinking(53.7%)等更大模型;该基准还揭示五款模型自报的 live 成绩虚高 12.8–33.1 个百分点。成本上,workflow-first 使每任务生成开销降 82.6%($0.906→$0.158)。harness 消融上,β1 学生比 β2 学生高 12.5pp 且步数少 21.5%(30.91 vs 39.4)。
局限与改进
作者承认或暗示的限制:66.0% 仍低于自家评估的 GPT-5.4-mini(69.57%)、GPT-5.5(78.7%)和人类水平(72.4%);评估排除了 Google Drive 任务;GPT-5.4-mini 结果为作者单次自评;WebVoyager-Static 是自建离线基准,虽更严格但切断了与 live web 分数的直接可比性;RL 阶段只用了 ScaleCUA 已发布的 1,988 个任务,奖励空间受限于其可验证合同;teacher、rubric 判卷(gpt-5.6-terra)与推理标注(GPT-5.4-mini)全部依赖闭源前沿 API。我的补充观察:(1) 对 Muse Glimmer-30B 的领先仅 0.1 个百分点,且对方步数预算未报告,这一量级优势的显著性存疑;(2) Table 2 中各基线 step budget(30/50/100 步)不一,跨行比较并非严格等价;(3) 任务分布由技能分类学与学生反馈驱动,可能系统性偏向 teacher 擅长、rubric 可判定的任务,真实世界长尾(非主流应用、异常弹窗、崩溃恢复)覆盖未知;(4) 终端通道的安全模型只有一句'需要显式授权和沙箱隔离',缺少对提示注入等威胁的评估;(5) WebVoyager-Static 上报告的是 SFT 模型而非最终 RL 模型,RL 对浏览器能力的贡献未单独量化。
独立分析的弱点
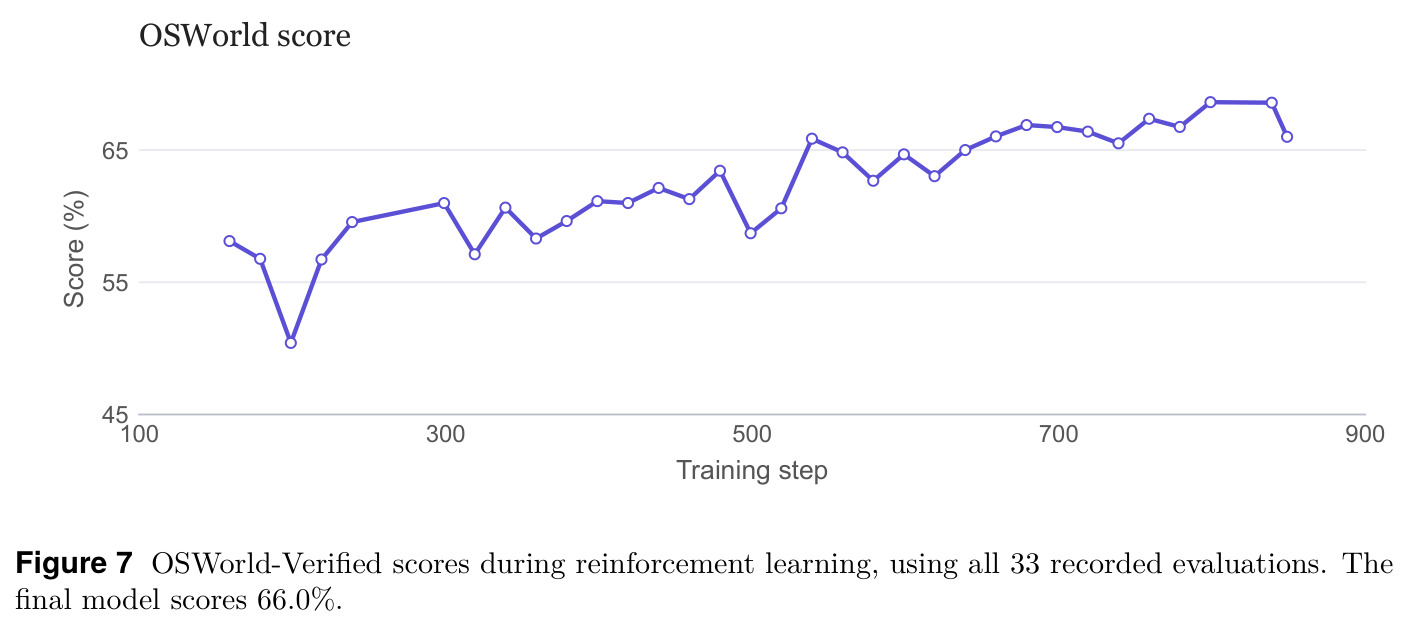
独立分析四个弱点。其一,对闭源 teacher 的深度依赖:harness 进化、蒸馏与推理标注全部绑定 GPT 系模型,API 变更或涨价会让整条管线失效;改进方向是用开源前沿 VLM 复刻 β1 配置,验证 harness 进化结论的模型无关性。其二,rubric 判卷的潜在偏置:判卷模型 gpt-5.6-terra 与 teacher 同源,可能对 teacher 风格的行为更宽容,学生学到的'成功'定义带有噪声;改进方向是程序化验证优先、LLM 判卷兜底的分层评审,并对判卷模型与生成模型做交叉消融(用不同厂商模型互判)。其三,通道路由失败模式缺乏分析:论文报告了 GUI/终端调用占比(68.19%/31.81%)却没有给出路由错误案例——何时学生该切终端而没切、何时误用终端改缓存文件;改进方向是建立路由错误分类学,并把路由正确性作为 RL 奖励的整形项。其四,安全性评估缺位:终端通道可执行任意代码,真实桌面场景下面网页内容中的提示注入可能诱导危险命令,论文未做任何对抗测试;改进方向是在合成任务中系统性注入对抗性网页/邮件内容,度量混合 CUA 的注入鲁棒性并设计权限分级。另外 RL 数据仅 1,988 个任务、训练曲线只给出 33 次评估记录,超参敏感性与收敛行为的披露有限,难以判断结论的稳健性。
未来方向
作者提出的方向:(1) 把 workflow-first 合成扩展到更多应用族与平台,让技能分类学的自动扩展贯穿模型全生命周期(当前为三轮);(2) 用程序化可验证奖励扩展 RL 任务池,突破 1,988 个 ScaleCUA 任务的限制;(3) RL 基建向更大策略模型与更大环境机群扩展(当前 24+8 张 B200、平均更新 570.3 秒、策略滞后均值 2.71,已接近 3 次更新的上限)。基于成果可延伸的方向:(1) 把通道路由当作显式研究对象——为每步的通道选择建独立评估,分析路由准确率与任务成功率的相关性,可能催生路由感知的课程设计;(2) 自我改进飞轮:用最终 4B 模型在进化 harness 下作为低成本 teacher 继续自举,降低对闭源 API 的依赖;(3) 把 WebVoyager-Static 式'轨迹+数据库状态'双重核验推广为社区标准 CUA 基准——live 判卷虚高 12.8–33.1 个百分点的发现本身就值得单独成文;(4) 端侧部署研究:4B 模型加本地沙箱终端在消费级 PC/NPU 上的延迟-成功率权衡;(5) 混合 CUA 的权限模型与提示注入防御,这是终端通道走出沙箱、落上真实用户桌面的前置条件。
复现评估
复现条件中等偏难,但透明度较高。代码在 GitHub(microsoft/Mage),模型在 Hugging Face microsoft/mage collection 发布;训练与 RL 基建(RaaS、Slime、SGLang、Azure VMSS/Relay)、部署规模(70 台 D64d_v5 CPU 主机、每台 16 个 GUI 槽位共 1,120 槽、32 张 B200 按 24 训练+8 推理分配)、运行画像(平均更新 570.3 秒、每更新约 18.4k 序列/136.49M token、压缩轨迹 2.44 GB、策略滞后均值 2.71)均有量化披露;附录 B 给出各阶段 token 量与 FLOPs 记账,总名义计算 7.787×10^21 FLOPs,按 $C \approx 6 N_{\mathrm{LM}} T$($N_{\mathrm{LM}} = 4\times10^9$)估算。主要障碍:(1) 293,806 个合成任务与 318,837 条轨迹是否随代码开放未明确,自建 Mage-CUA-Forge 需大量 GPT-5.4、gpt-5.6-terra、GPT-5.4-mini API 费用(即便每任务 0.158 美元,29 万任务也约 4.6 万美元,且不含一次性工作流构建);(2) RL 需要 70 台 CPU 主机加 B200 集群的云预算;(3) 起点 checkpoint 是内部'Mage-VL 中间版 4B',外部研究者拿不到完全相同的底座;(4) OSWorld-Verified 评估需两次运行取平均。学术实验室可行的降级路径:只复现 Stage 1–4(合计约 5.17 ZFLOPs,单节点 8×B200 数天量级),用公开 OpenCUA/UGround 数据替代合成数据验证课程结构增益。
论文图表