CUA-Master:通过开放世界递归改进扩展计算机操作智能体 CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements
双循环飞轮从视频挖种子、按原语合成任务并快照回滚采轨迹,27B 模型四大基准比肩闭源旗舰
前置知识
计算机操作智能体(CUA)
指能像人一样操作电脑完成任务的智能体:接收自然语言指令,通过截图等观测感知屏幕状态,逐步执行点击、输入、滚动等动作,直至完成目标并由任务验证器判定成败。早期 CUA 只会点 GUI,后来扩展出命令行(CLI)与工具调用能力,可执行文件批处理、结构化计算等高效操作。
全文的对象就是 CUA,所有数据构造、动作空间设计与基准评测都围绕它展开,不理解 CUA 的工作循环(观测→动作→验证)就读不懂方法与实验。
SFT 与强化学习(GRPO)
SFT(监督微调)让模型模仿标注好的轨迹,逐步学到多样技能;RL 则让模型在环境中自己采样、依据任务验证器的成败奖励优化策略上限。GRPO 是一类在线 RL 算法:对同一任务采样一组轨迹,用组内相对优势替代价值网络来估计优势函数,省去价值模型。本文用多轮累积 SFT 打底、最后一轮 GRPO 式 RL 冲击上限。
CUA-Master 的训练配方正是「三轮 SFT + 一轮 RL」,且 RL 奖励直接来自合成任务自带的验证器,这是理解 2.5 节与迭代实验的前提。
递归自我改进与数据飞轮
指「生成数据→训练模型→根据模型弱点再生成数据」的迭代闭环。封闭世界版本只靠模型自生成经验,易受既有能力束缚、分布收窄、收益递减;开放世界版本则持续引入外部真实知识(本文是网络教学视频)作为新燃料,并用模型弱点反馈指导探索方向,形成世界-数据-模型飞轮。
这是论文的总体框架:外层世界-数据-模型飞轮与内层数据飞轮的分工,以及 Figure 8 持续增益实验,都建立在递归改进概念之上。
能力原语(ability primitive)
最小的、独立有意义且用户可见的状态转换,可包含多次点击或输入,但既不是孤立机械动作也不是整条工作流。本文将其形式化为五元组 $p_i=(u_i,a_i,P_i,E_i,V_i)$:应用、能力、执行前置条件、环境要求、验证器规格,存入按应用索引的原语库供组合复用。
原语化是自催化繁殖的核心:任务复杂度由原语数 $K$ 与应用数 $N$ 显式控制,验证器由原语规格合并而来,理解它才能看懂任务合成与 RL 奖励来源。
混合动作空间(GUI+CLI)
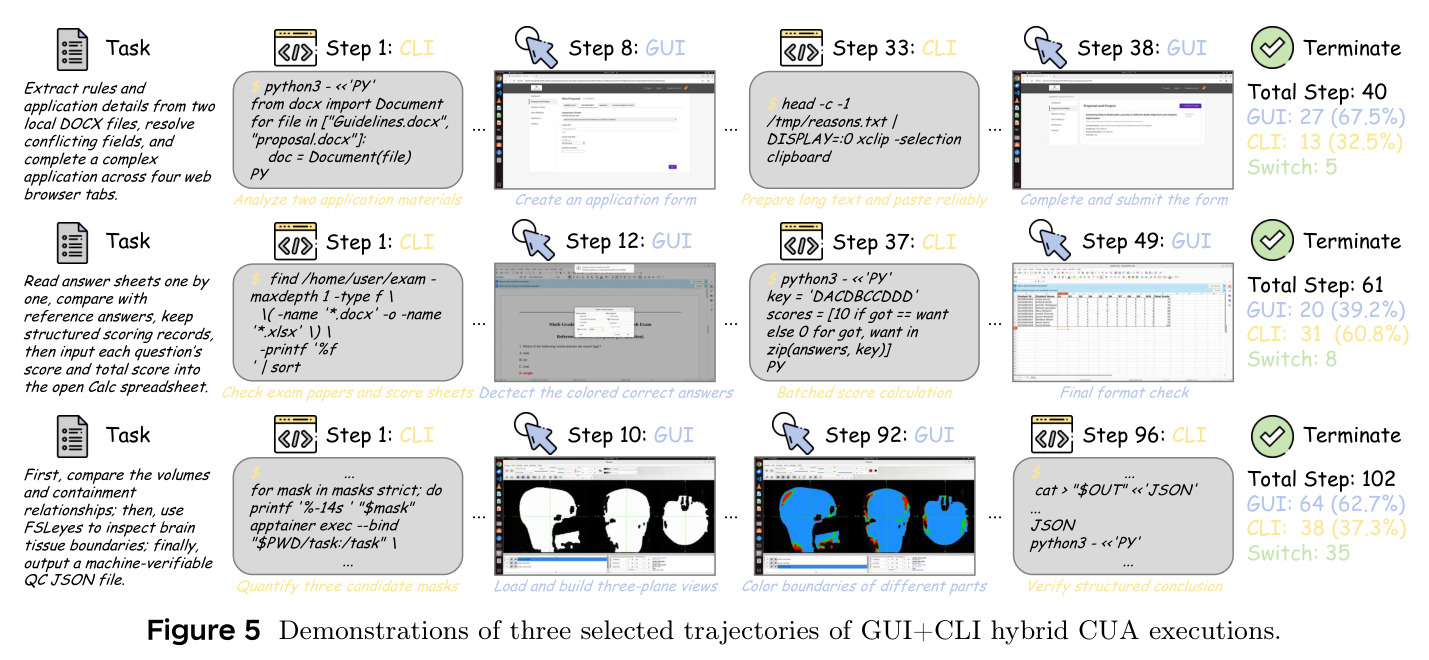
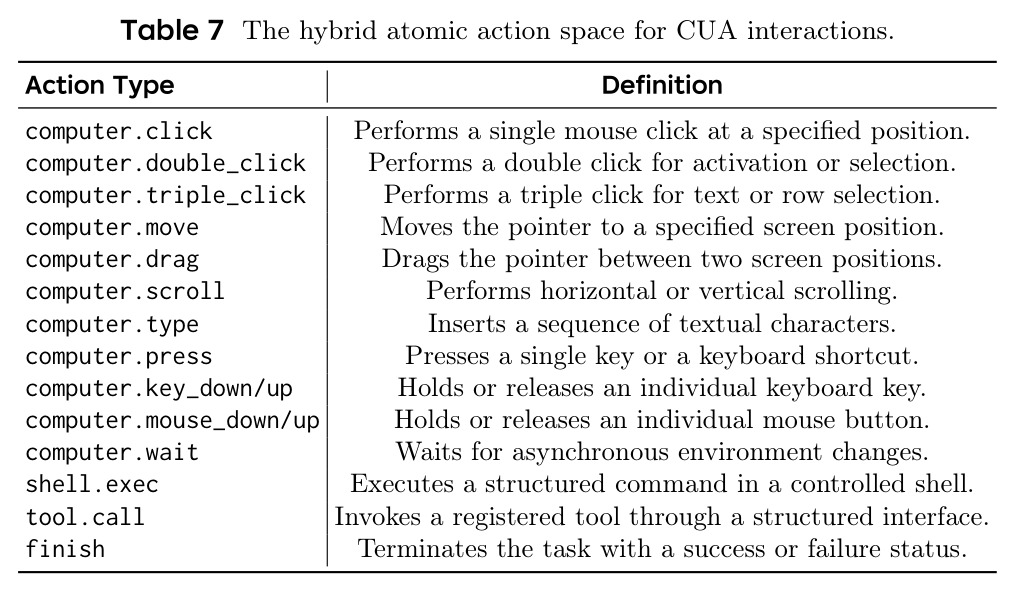
统一的原子动作空间:GUI 侧是 computer.click/scroll/type 等鼠标键盘操作,以截图为观测;CLI 侧是 shell.exec 结构化命令,以标准化 shell 输出为观测;两者可在同一条轨迹中自由穿插,并兼容 tool.call 工具调用。坐标统一为 $[0,1000]$ 归一化表示,与屏幕分辨率无关。
这是本文最大的单项增益来源(WeaveBench 混合 43.9 vs GUI-only 6.6),评测也分 GUI-only 与混合两类基准,不懂动作空间就看不懂主表与消融。
VM 快照与回滚
虚拟机在某一时刻的完整状态存档即快照;回滚指把环境恢复到先前快照。本文在轨迹的「稳定边界」建立带轻量状态签名(活动应用、窗口布局、相关文件、控制器元数据)的增量快照,失败时先定位最早分歧步,再恢复其前最近的快照,保留有效前缀只重做后缀。
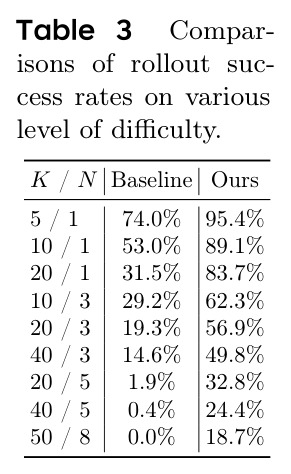
快照回滚重试是韧性轨迹采集的核心机制,Table 3 中 49.8% 对 14.6% 的成功率提升直接由它贡献。
研究动机
尽管 GPT-5.6、Claude-Opus-5、Kimi-K3 等基础模型与 OpenCUA、UI-Mate 等专用智能体显著提升了 CUA 能力,高质量交互数据的获取始终是根本瓶颈。人工标注轨迹质量高但成本昂贵、应用覆盖有限,难以规模化;合成数据则面临三个交织难题:其一是多样性不足——任务来源受限且彼此相似,能力覆盖不够,数据量增大后提升迅速饱和;其二是可控性差——直接改写指令或模板化生成无法精细控制操作能力、任务复杂度和跨应用依赖,难以构造长程跨应用工作流;其三是可靠性低——随任务复杂度上升,真实环境中的轨迹采集成功率急剧下降,论文基线环境在合成 $K=40$ 个原语、跨 $N=3$ 个应用的任务时成功率仅 14.6%,$K/N=50/8$ 时为 0.0%。更深层的问题在于数据构造与模型优化单向耦合:传统流水线「先生成后训练」,数据构造无法感知模型演化中的薄弱环节,补数据可能只带来偏侧收益;而已有递归自我改进方法(如 WebRL、Self-Challenging)依赖模型自生成经验,属于封闭世界优化,受既有能力束缚,易放大分布偏差、收益递减。
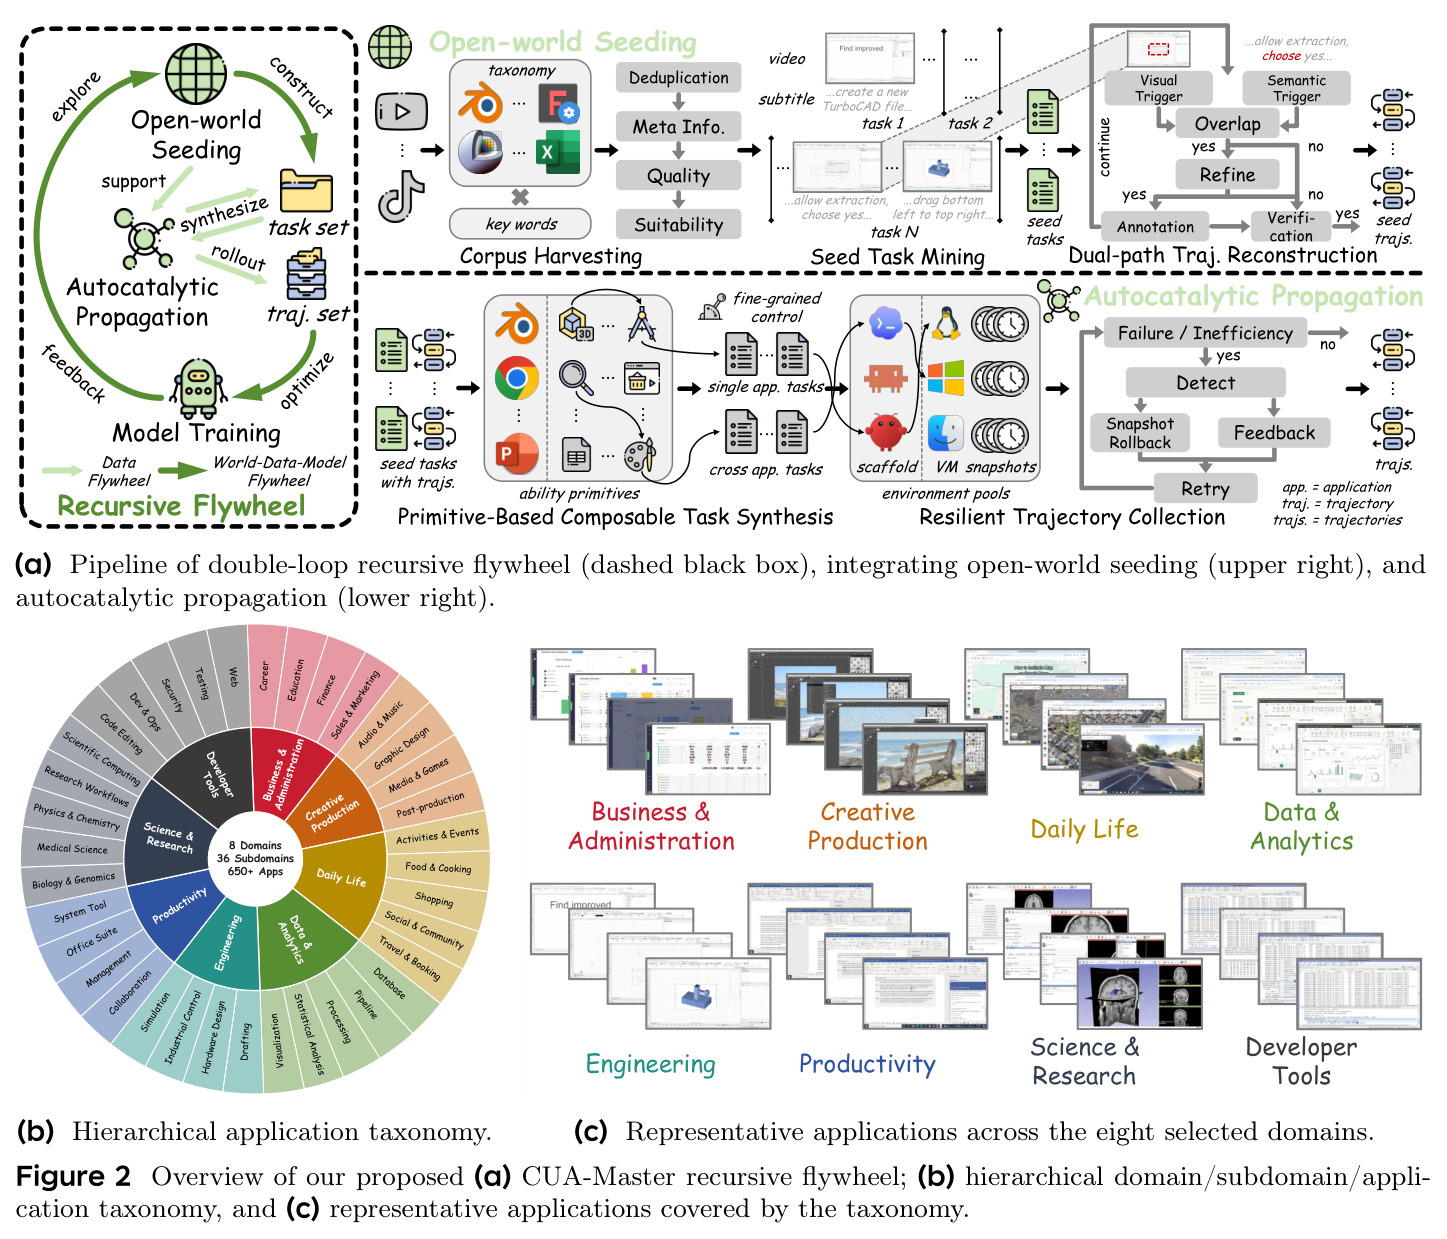
本文的目标是本文目标是构建一个能持续从开放世界获取新知识、系统性扩展性能边界的递归改进系统。具体拆成三层:在系统层面,建立「世界-数据-模型」外飞轮,把开放世界探索、数据构造与模型优化闭环起来,用模型当前的能力短板(领域级、应用级失败案例与 rollout 成功率分析)指导下一轮数据采集与探索方向;在数据层面,建立内层数据飞轮,通过「开放世界播种 + 自催化繁殖」两条互补路径,实现兼具多样性、可控性与可验证性的大规模任务合成——从 YouTube、TikTok、Bilibili 的软件教学视频中挖掘真实工作流作为种子任务,再分解为可复用原语并受控组合成可验证新任务;在采集层面,用反馈引导的快照回滚重试机制提升真实环境 rollout 的成功率与效率。最终验证:仅 27B 参数的模型能否在 GUI-only 与 GUI+CLI 混合基准上达到与远大于自身或闭源模型相当的性能,并在递归迭代中持续增益。
与已有工作不同的是,本文的独特切入角度有三点。第一,重新定位视频数据的作用:以往工作(AgentTrek、TongUI、VideoCUA、WildGUI)把网络教程视频当作直接的轨迹生成来源,本文则将其视为「种子任务收集」——种子提供真实世界多样性与操作知识,再经自催化繁殖放大覆盖与规模,避免视频标注噪声直接进入训练数据。第二,用「能力原语 + 受约束组合」取代指令改写:把每个种子轨迹分解为五元组原语 $p_i=(u_i,a_i,P_i,E_i,V_i)$,通过原语数量 $K$ 与应用数 $N$ 两个维度显式控制任务复杂度,验证器由原语级规格自动合并,任务天然可验证。第三,在采集层面用「反馈引导的快照回滚重试」取代失败即从头重来:定位最早状态分歧步 $\hat{s}$,恢复最近的稳定快照,保留有效前缀只重试后缀,把重试变成轻量分支搜索。系统层面则以模型弱点反馈引导开放世界探索,区别于封闭世界自我改进的分布收窄。
核心方法
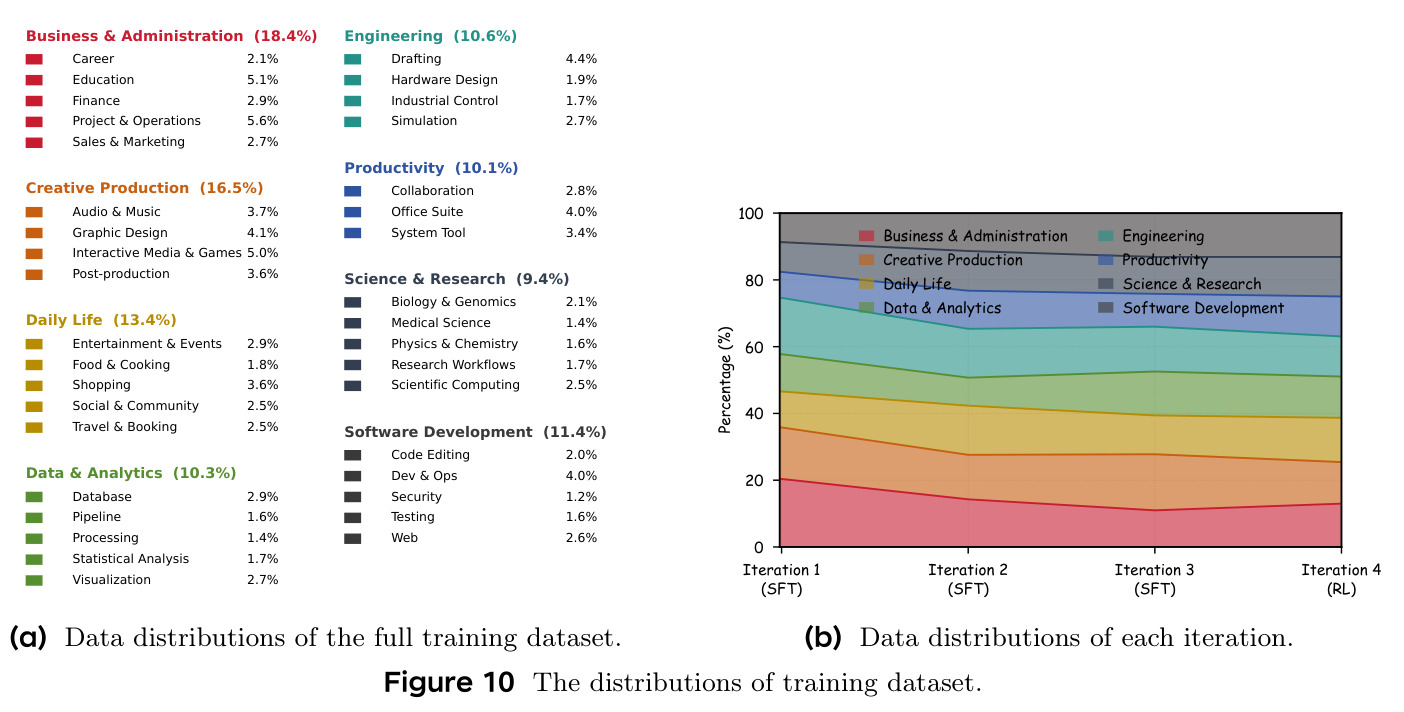
直觉上,这像一个「因材施教」的教学系统:老师(数据流水线)不断观察学生(模型)哪里薄弱,去真实世界找对应的新教材(教学视频),而不是让学生自己出题给自己练。技术上,CUA-Master 是嵌套双循环框架。外层是「世界-数据-模型」飞轮:每轮训练后通过领域级、应用级的失败案例与成功率分析定位短板,据此调整下一轮开放世界探索与数据配比(训练数据分布随迭代从 Business & Administration 18.4% 的初期集中,逐步向 Software Development、Science & Research、Productivity 倾斜);SFT 收益饱和后转入 RL 冲击能力上限。内层数据飞轮由两个力驱动:开放世界播种(语料采集→种子任务挖掘→视觉-语义双路轨迹重建)持续注入真实世界多样性,自催化繁殖(原语提取→可组合任务合成→韧性轨迹采集)系统性放大覆盖、复杂度与规模。所有任务形式化为 $T=(I,E,V)$(指令、环境、验证器);智能体在混合动作空间中执行:GUI 动作(computer.click/scroll 等)以截图为观测,CLI 动作(shell.exec)以标准化 shell 输出为观测,坐标统一到 $[0,1000]$ 归一化坐标系,兼容 tool.call。基础设施是后端无关、profile 驱动的编排层,覆盖 Linux/Windows/macOS,支持 100+ 种 CUA 环境与 2000+ 并发 VM。
核心创新是把「真实世界的软件操作」当作可组合的原语,而非一次性轨迹。每个种子任务及其轨迹被注解器分解为五元组原语序列 $p_i=(u_i,a_i,P_i,E_i,V_i)$:所属应用 $u$、可复用能力 $a$、执行前置条件 $P$、环境要求 $E$、验证器规格 $V$,汇入按应用索引的原语库 $\mathcal{B}$。任务合成因此变成「受约束的原语组合」:给定复杂度预算 $K$(组合原语数)与应用集 $\{u_1,...,u_N\}$,先检查前置条件与环境要求兼容性(冲突者不可组合),再由注解器实例化出连贯指令 $I^{syn}$、可执行环境规格 $E^{syn}$ 与任务级验证器 $V^{syn}$。这与已有方法的本质区别在于:任务复杂度不再依赖不可控的语言改写,而是由 $(K,N)$ 显式编程;验证器由原语级验证规格自动合并而来,无需人工奖励标注即可直接支撑 RL 的结果奖励。再配合双路触发(转写语义触发与画面变化视觉触发时间对齐)保证种子轨迹精度,配合快照回滚保证复杂任务也能产出成功轨迹,三者共同构成可放大、可控、可靠的数据引擎。
方法步骤详情
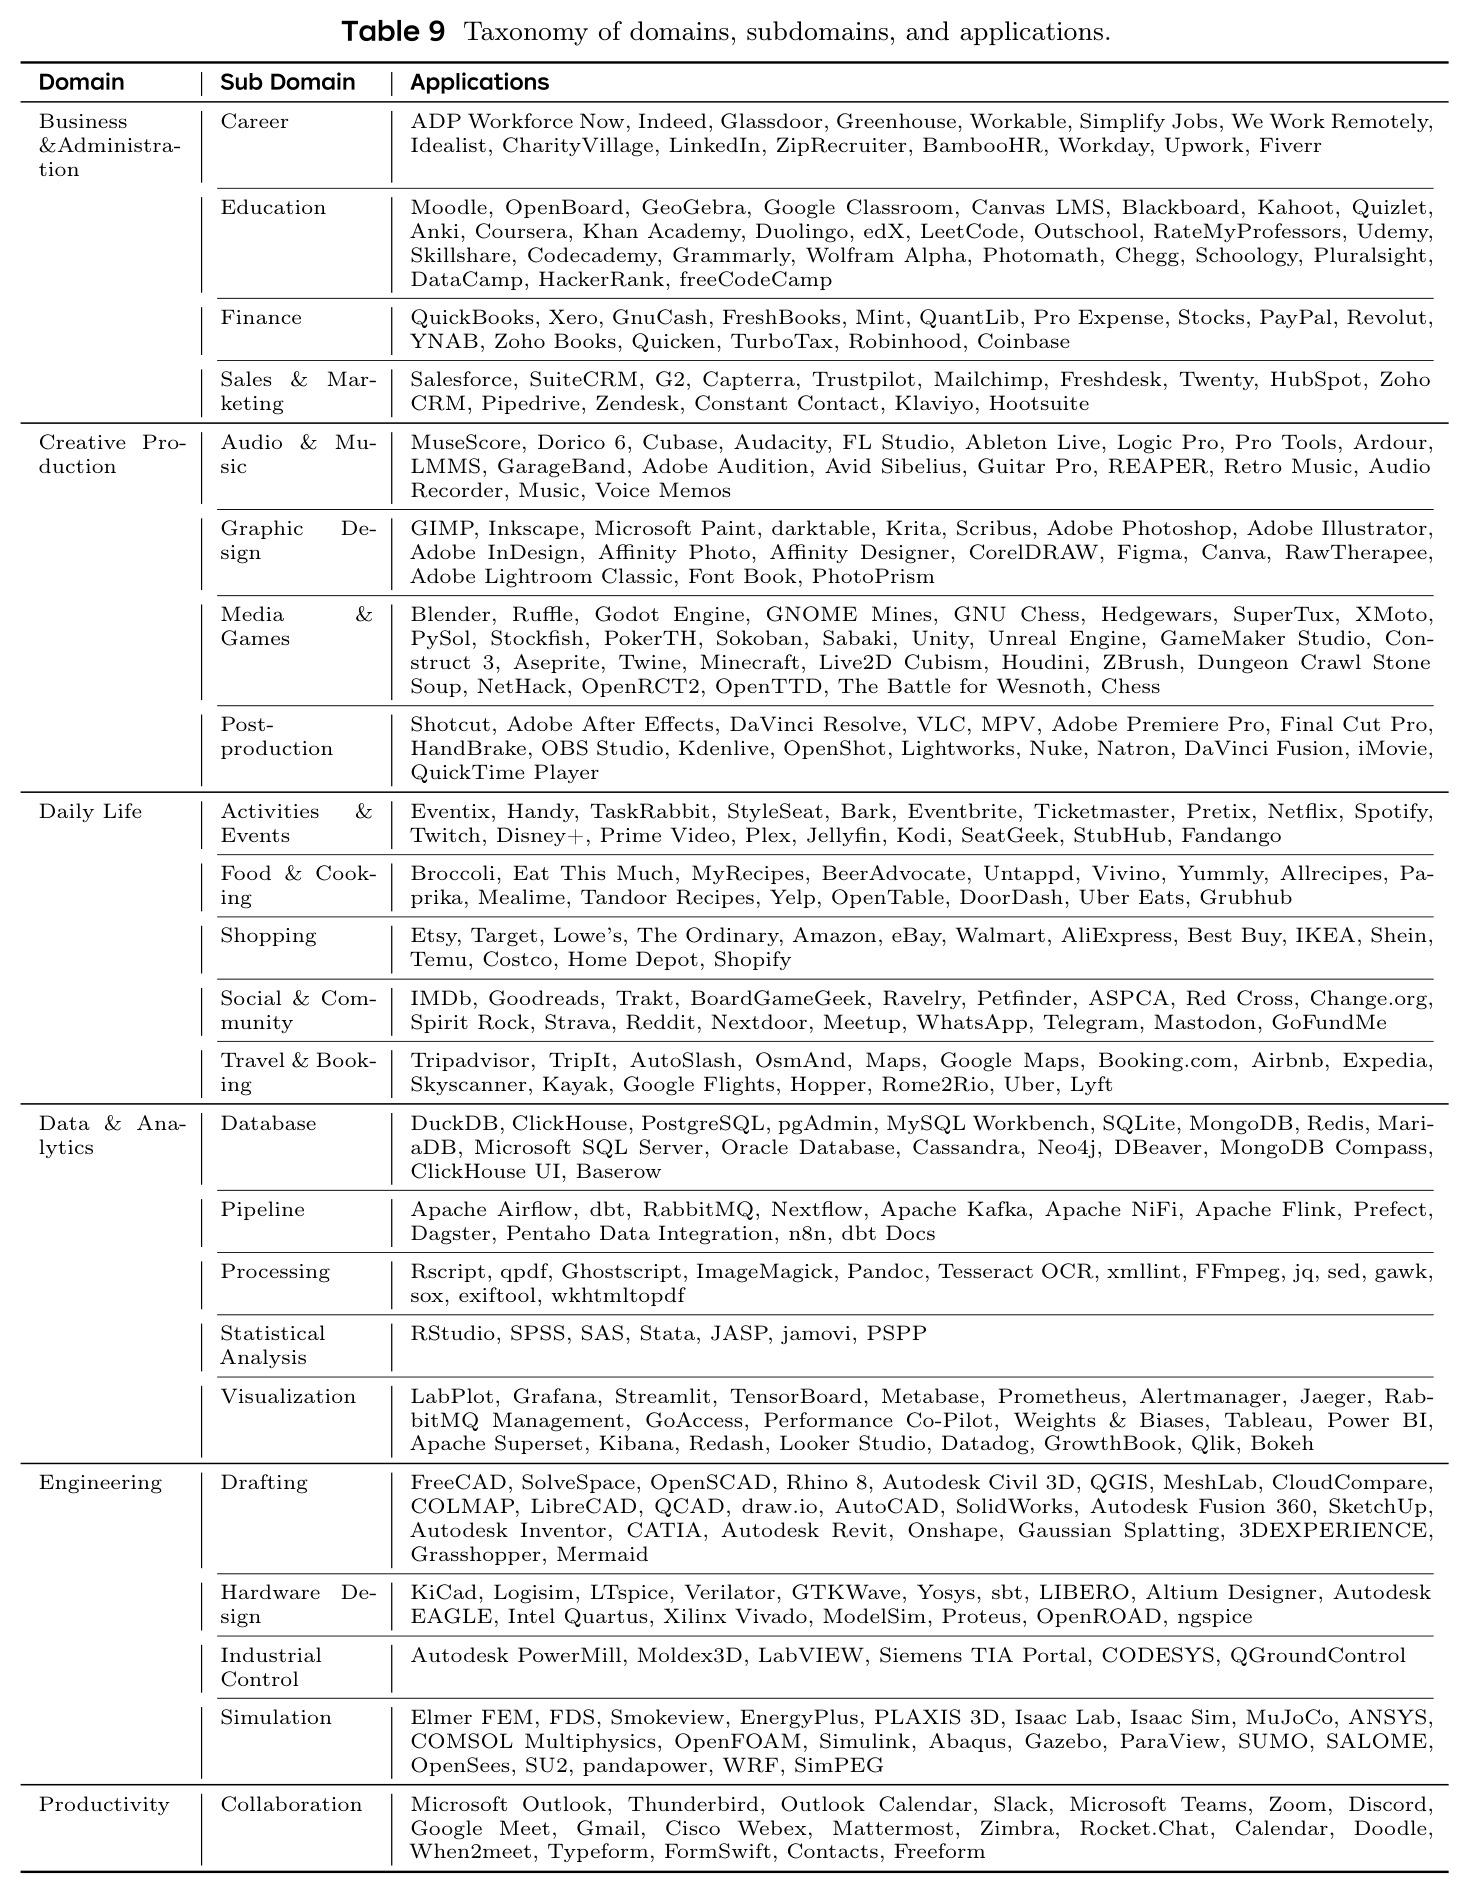
完整流程分七步。①语料采集:按 8 域/36 子域/650+ 应用分类学加「tutorial/how to」等关键词,从 YouTube、TikTok、Bilibili 检索视频;去重、元数据门控与噪声过滤后,用 Faster-Whisper(Whisper-Large-v3)生成带时间戳转写,注解器打 CUA 适配分 $\sigma\in\{0,...,5\}$。②种子任务挖掘:把多模态时序片段发现形式化为 $\{\hat{f}_1,...,\hat{f}_n\}\mapsto\{(t_i^s,t_i^e,T_i)\}_{i=1}^M$,一条视频切出多个可独立执行任务。③双路轨迹重建:语义路径从转写中取「click/press/scroll/drag」等动作子句为触发 $C^{sem}$,视觉路径用 FFmpeg 帧差超阈值作触发 $C^{vis}$,在窗口 $\mathcal{T}$ 内求交成候选格 $C=\{(t_i^{sem},t_j^{vis})\mid|t_i^{sem}-t_j^{vis}|\le\mathcal{T}\}$,注解器复核边界、批量标注原子动作、轨迹级验证过滤。④原语化:$(T^{seed},X^{seed})\mapsto\{p_1,...,p_n\}$,等价原语规范化去重后入库。⑤任务合成:$(\mathcal{B}(\{u_1,...,u_N\}),K)\mapsto T^{syn}=(I^{syn},E^{syn},V^{syn})$,合并兼容前置条件与验证规格。⑥韧性采集:检测器 $(T,X,E)\mapsto_{\mathcal{A}}(\hat{s},F)$ 定位最早分歧步并生成不含特权解法的诊断反馈,回滚到其前最近的增量快照、保留有效前缀重试,直至验证通过或预算耗尽,只保留最高效的成功分支。⑦训练:从 Qwen-3.5-27B 出发做三轮累积 SFT(每轮分别加入 63K/38K/14K 任务,累计约 115K;AdamW 峰值学习率 $5\times10^{-6}$、cosine、warmup 0.03、batch 128,每轮回到同一基座检查点),最后对 12K 高质量任务做 GRPO 式在线 RL(每任务采 8 条轨迹,学习率 $1\times10^{-6}$,batch 64 即最多 512 条轨迹)。
技术新颖性
技术新颖性体现在四个层面。系统层面:把递归自我改进锚定在持续刷新的开放世界知识上,用模型弱点反馈引导探索方向,规避了纯自生成数据的分布收窄与合成误差累积——Re-ReST、WebRL、Self-Challenging、Agent-R 等均为封闭世界方案。数据层面:视频挖掘线(OpenCUA、VideoCUA、AgentTrek、TongUI)止步于「视频→轨迹」,本文引入视觉-语义双路触发对齐提高重建精度,并把输出定位为可继续繁殖的种子;环境交互线(OS-Genesis 反向任务合成、AutoPlay 探索)受限于环境内已有知识,本文的原语组合则能跨应用、跨复杂度地系统性外推。采集层面:快照回滚并非全新概念,但把「分歧步定位 + 无特权解法反馈 + 稳定边界增量快照」组合成轻量分支搜索是新的工程设计,使 $K/N=50/8$ 的极端任务成功率从 0.0% 提到 18.7%。训练层面:三轮 SFT 均从同一基座重启、累积数据,避免多轮 SFT 的优化漂移;原语化任务为 RL 提供原生难度分级与可验证奖励,无需额外人工奖励设计。
实验结果
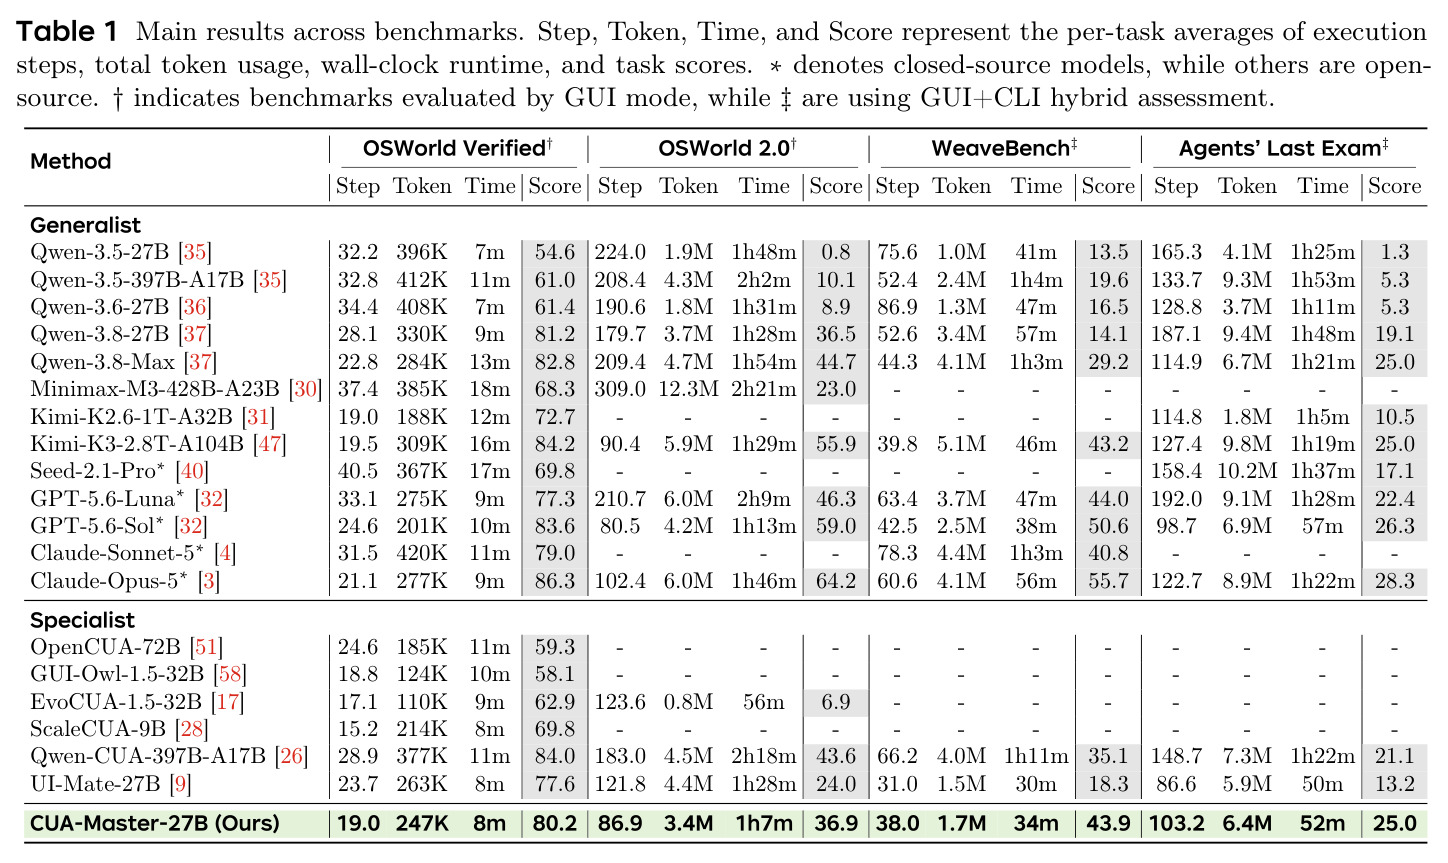
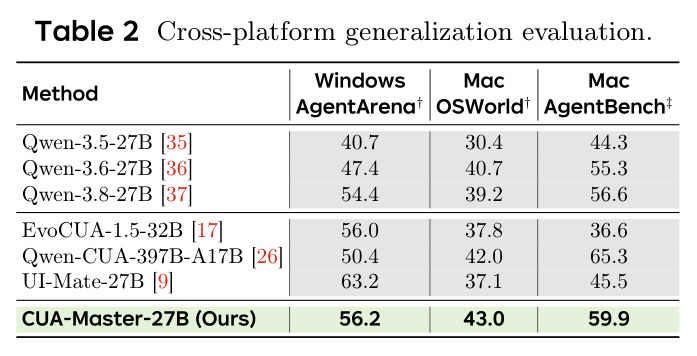
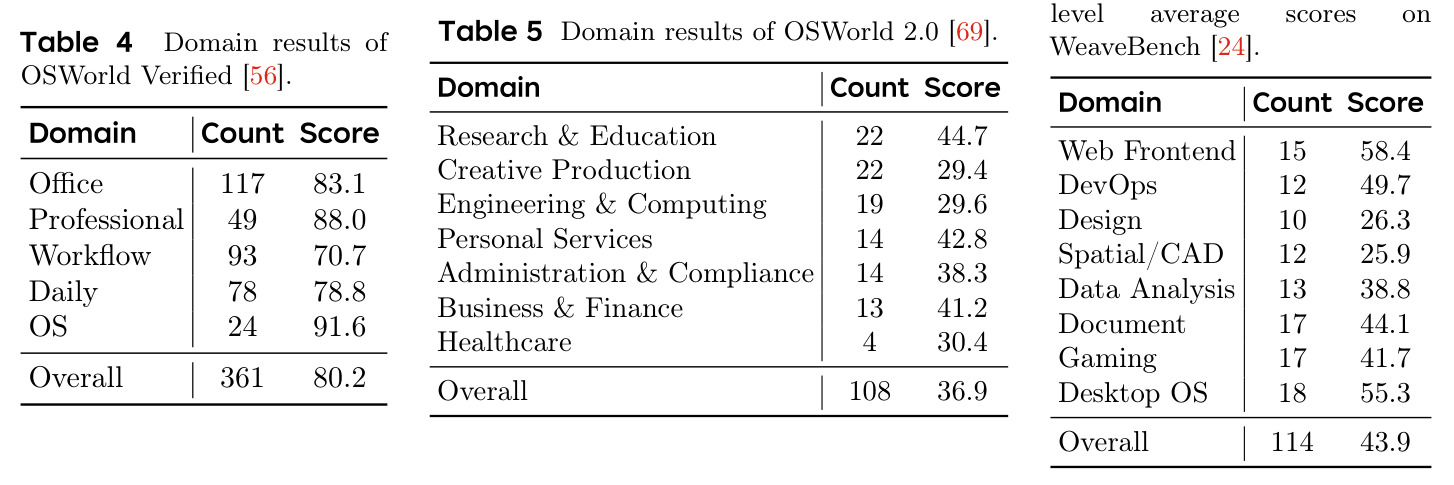
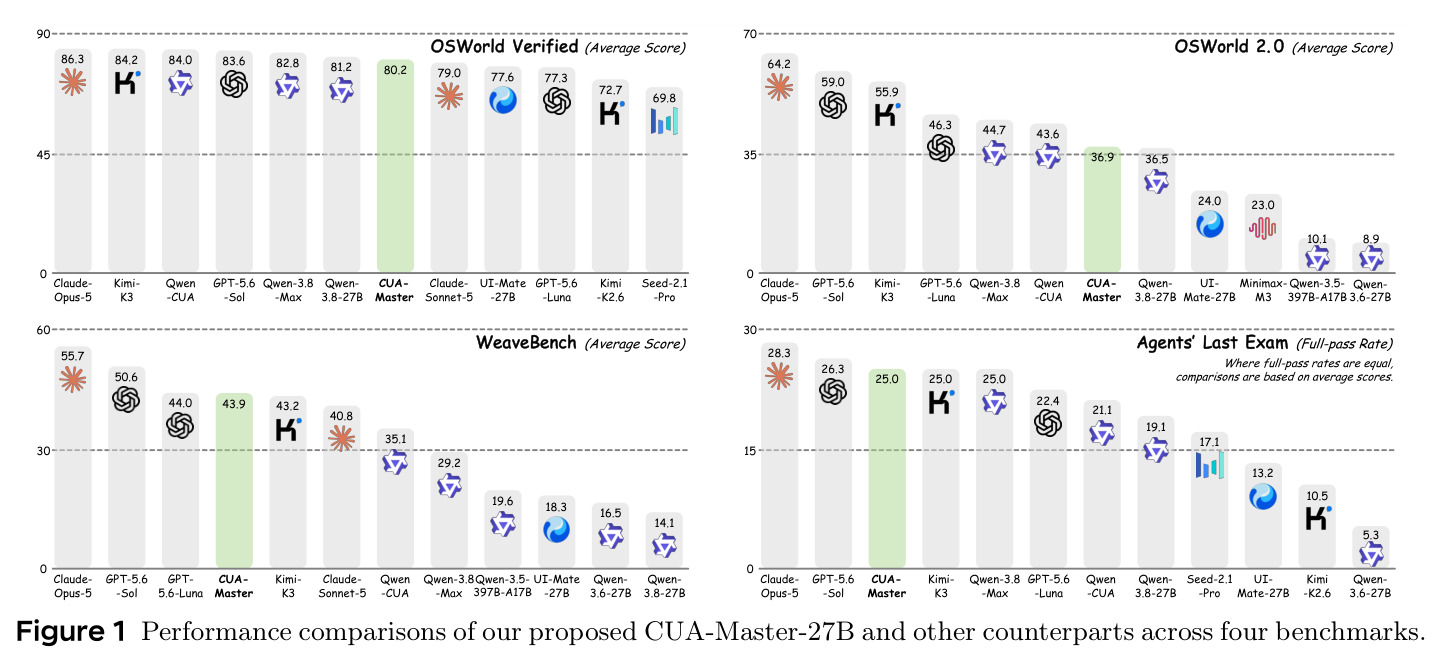
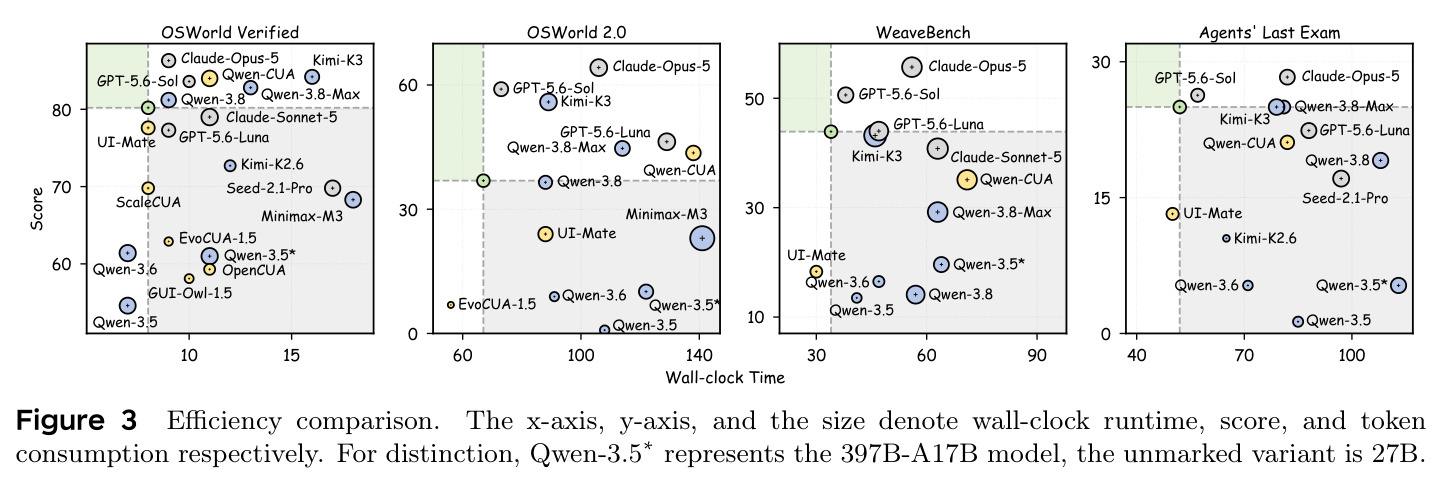
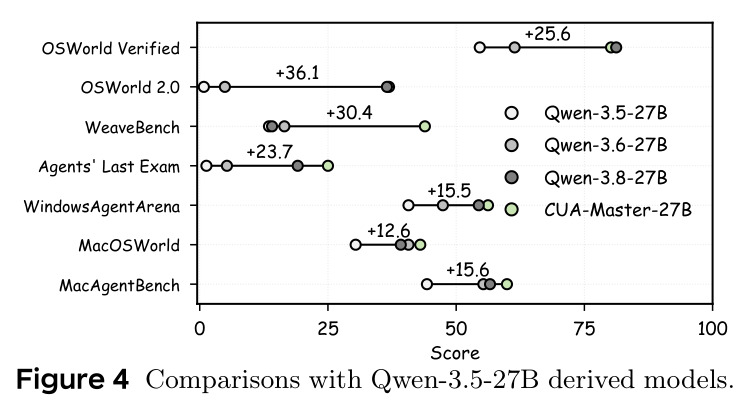
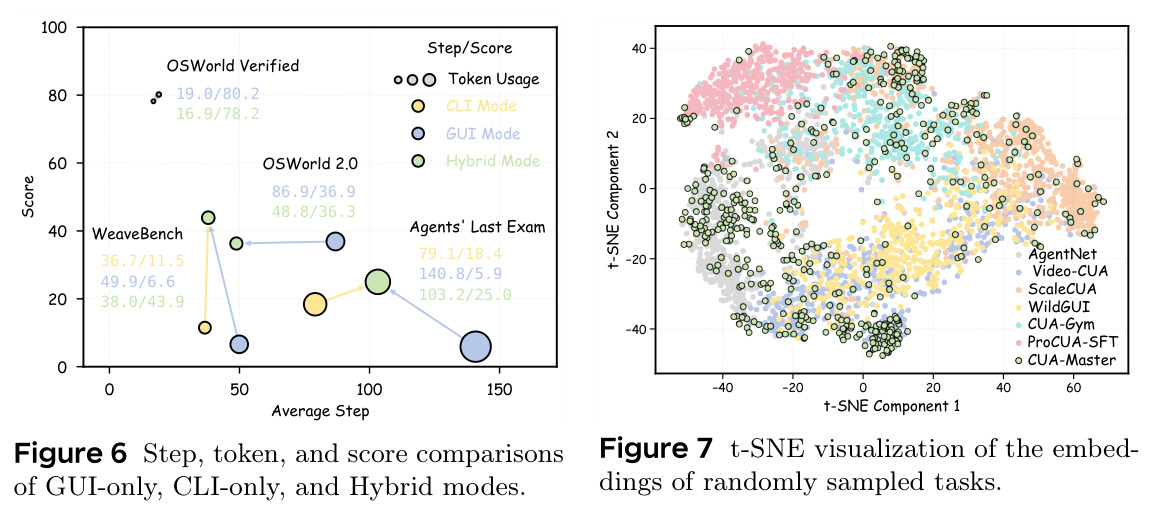
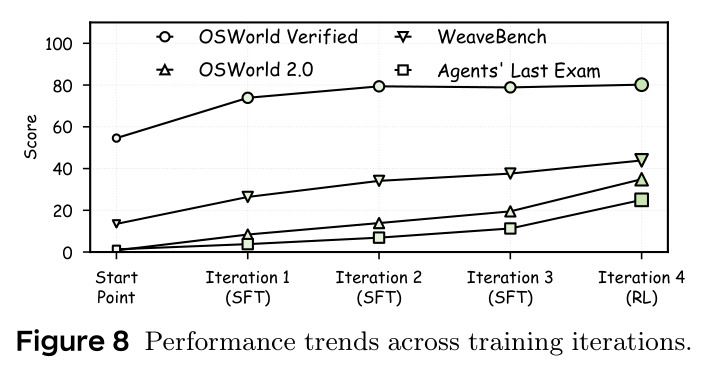
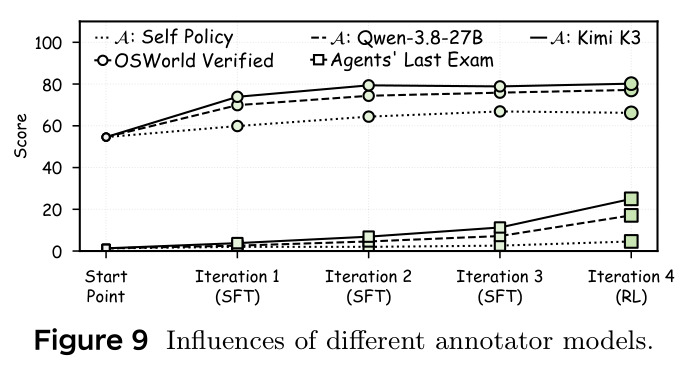
主实验(Table 1):CUA-Master-27B 在 OSWorld Verified 得 80.2(每任务约 8 分钟)、OSWorld 2.0 得 36.9、WeaveBench 得 43.9、Agents' Last Exam 全通过率 25.0。与同量级专用模型 UI-Mate-27B 相比分别提升 2.6、12.9、25.6、11.8 分;与 397B 参数的 Qwen-CUA-397B-A17B 相比,GUI-only 基准接近(80.2 vs 84.0),混合基准反超(43.9 vs 35.1、25.0 vs 21.1);在最难的 Agents' Last Exam 上仅次于 GPT-5.6-Sol(26.3)与 Claude-Opus-5(28.3)。效率(Figure 3):OSWorld 2.0 上以 1h07m 超过 Qwen-3.8-27B(36.9 vs 36.5)且用时少 24%;WeaveBench 上以 34 分钟追平 GPT-5.6-Luna(44.0)且少 28% 时间;Agents' Last Exam 上与 Kimi-K3、Qwen-3.8-Max 同为 25.0 但省 34–36% 时间。消融(Figure 6):混合动作空间在 WeaveBench 得 43.9,比 GUI-only(6.6)和 CLI-only(11.5)高 37.3 和 32.4 分且步数少 23.8%;Agents' Last Exam 从 5.9 提到 25.0 且步数少 26.7%;OSWorld 2.0 步数少 43.8%。数据飞轮(Figure 7/Table 3):t-SNE 显示合成任务覆盖并延伸出 AgentNet、VideoCUA、ScaleCUA、WildGUI、CUA-Gym、ProCUA-SFT 六个数据集的分布;$K/N=40/3$ 任务成功率 49.8% 对基线 14.6%,$K/N=50/8$ 时 18.7% 对 0.0%。迭代(Figure 8/9):OSWorld Verified 与 WeaveBench 经四轮迭代累计提升超 25 分,最后 RL 阶段使 OSWorld 2.0 与 Agents' Last Exam 各再提升约 15 分;注解器越强收益越大,自策略注解收益有限。跨平台(Table 2):WindowsAgentArena 56.2、MacOSWorld 43.0、MacAgentBench 59.9,较基座 Qwen-3.5-27B 分别 +15.5/+12.6/+15.6。短板:WeaveBench 上 Spatial/CAD 仅 25.9、Design 26.3、Healthcare 30.4。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld Verified(GUI-only 桌面任务) | 平均得分 Score | 80.2(8 分钟/任务,19.0 步) | UI-Mate-27B 77.6;Claude-Opus-5 86.3;Qwen-CUA-397B-A17B 84.0 | 较同级 27B 专用模型 +2.6;距最强闭源模型 -6.1 |
| OSWorld 2.0(更难的新版桌面任务) | 平均得分 Score | 36.9(1h07m,86.9 步) | UI-Mate-27B 24.0;Qwen-3.8-27B 36.5;Claude-Opus-5 64.2 | 较 UI-Mate-27B +12.9;以少 24% 的时间险胜 Qwen-3.8-27B |
| WeaveBench(GUI+CLI 混合) | 平均得分 Score | 43.9(34 分钟,38.0 步) | UI-Mate-27B 18.3;GPT-5.6-Luna 44.0;Qwen-CUA-397B-A17B 35.1 | 较 UI-Mate-27B +25.6;与 GPT-5.6-Luna 持平且用时少 28% |
| Agents' Last Exam(最难长程混合任务) | 全通过率 Full-pass Rate | 25.0(52 分钟,103.2 步) | UI-Mate-27B 13.2;Kimi-K3 25.0;GPT-5.6-Sol 26.3;Claude-Opus-5 28.3 | 较 UI-Mate-27B +11.8;与 Kimi-K3 持平但省 34–36% 时间,仅次于两个闭源旗舰 |
| WindowsAgentArena(跨平台泛化) | 平均得分 Score | 56.2 | 基座 Qwen-3.5-27B 40.7;Qwen-3.8-27B 54.4 | 较基座 +15.5,超过 Qwen-3.8-27B |
| MacOSWorld(跨平台泛化) | 平均得分 Score | 43.0 | 基座 Qwen-3.5-27B 30.4;UI-Mate-27B 37.1;Qwen-CUA-397B 42.0 | 较基座 +12.6,超过所有对比模型 |
| MacAgentBench(跨平台泛化) | 平均得分 Score | 59.9 | 基座 Qwen-3.5-27B 44.3;Qwen-CUA-397B 65.3 | 较基座 +15.6,但低于 397B 的 Qwen-CUA |
| 复杂任务 rollout 成功率($K/N=40/3$,近似 Agents' Last Exam 平均难度) | 成功率 | 49.8%(快照回滚重试) | 14.6%(基线环境从头重试) | +35.2 个百分点 |
| 极端任务 rollout 成功率($K/N=50/8$) | 成功率 | 18.7% | 0.0% | 基线完全失败时仍保有近两成成功率 |
| WeaveBench 混合 vs 单一模式消融 | 平均得分 Score | 43.9(混合模式) | GUI-only 6.6;CLI-only 11.5 | +37.3 / +32.4,步数较 GUI-only 少 23.8% |
局限与改进
作者承认两条局限:其一,递归流水线的计算与基础设施开销巨大——大规模环境交互、轨迹采集与迭代优化都依赖 VM 池(100+ 环境、2000+ 并发 VM),快照回滚虽省 rollout 时间,却要求大规模 VM 部署能力;其二,合成数据质量上限受制于注解器模型,越强的注解器收益越大(Figure 9),这引入额外推理成本,且在强注解器不可得时框架可用性受限。我的补充观察:第一,注解器 $\mathcal{A}$ 的具体型号未披露,若为闭源前沿模型,第三方难以复现同等数据质量;第二,开放世界视频与评测任务可能存在分布交叠(OSWorld 涉及的 LibreOffice、Chrome、VLC 等在分类学中大量出现),存在隐性评测污染风险,论文未说明去污染协议;第三,混合动作空间的巨大增益部分来自执行脚手架(harness 可引导 Codex/Claude Code 等),并非全部归功于模型本身;第四,即便有回滚机制,$K/N=50/8$ 成功率也仅 18.7%,极端长程任务仍是硬骨头;第五,验证器只给结果奖励且由 LLM 合并生成,存在被 reward hacking 的风险,论文未报告对作弊轨迹的审计。
独立分析的弱点
独立分析出的弱点及改进方向:(1)注解器单点瓶颈——整条流水线的质量上限由外部强模型决定,八个角色共用同一模型,一次迭代的数据成本随注解调用量线性增长;改进方向是把每轮训好的模型蒸馏成下一轮的领域专用注解器,配合真实执行验证做「生成-执行」双校验,逐步降低对闭源前沿模型的依赖。(2)视频坐标标注噪声——从教学视频画面推断点击坐标天然不精确,光标遮挡、界面缩放、分辨率差异都会引入系统性偏差;改进方向是引入光标检测或 GUI 元素锚点对齐(把坐标 snap 到检测出的按钮/菜单元素),并在目标环境执行时用状态差分验证坐标有效性。(3)评测污染风险未量化——开放世界语料天然包含评测基准常用应用与流程;改进方向是发布种子任务与评测任务的应用级重叠度审计,或对评测相关检索词做屏蔽。(4)极端难度成功率天花板——$K/N=50/8$ 仅 18.7%,说明线性回滚搜索对深层依赖任务不足;改进方向是把分支搜索升级为树搜索/束搜索,或学习环境动力学(世界模型)在想象中预演动作后果以减少真实重试。(5)基础设施门槛——2000+ 并发 VM 的需求使中小团队无法复现;改进方向是用轻量容器或微 VM(Firecracker 类)替代完整 VM,并把快照签名与恢复做成跨后端标准。(6)奖励 hacking 审计缺失——LLM 合并的验证器可能有可绕过的检查;改进方向是对抗性验证器压力测试与轨迹过程审计。
未来方向
作者提出的方向:继续沿飞轮迭代扩展能力前沿,随注解器增强而提升数据质量,并进一步优化 RL 阶段以突破长程任务上限。基于本文成果可延伸的研究:(1)自注解闭环——用 CUA-Master 自身(或其蒸馏版)逐步接管八个注解角色,形成完全自主的递归改进,检验自举的天花板在哪里;(2)世界模型辅助 rollout——在快照回滚之上学习环境动力学,先在想象中评估候选动作再真实执行,把 $K/N=50/8$ 的 18.7% 成功率进一步抬高;(3)过程奖励与验证器硬化——在结果奖励之外引入可验证的中间状态检查,抑制 reward hacking;(4)跨设备与跨形态扩展——把分类学与原语库推广到移动端、浏览器扩展与企业级软件(SAP、Salesforce 深度工作流);(5)原语库作为可迁移记忆——研究原语在新应用、新任务上的零样本组合泛化能力;(6)安全与审计——CLI 权限沙箱、危险命令检测与轨迹审计日志,使智能体可在企业环境中可靠部署。
复现评估
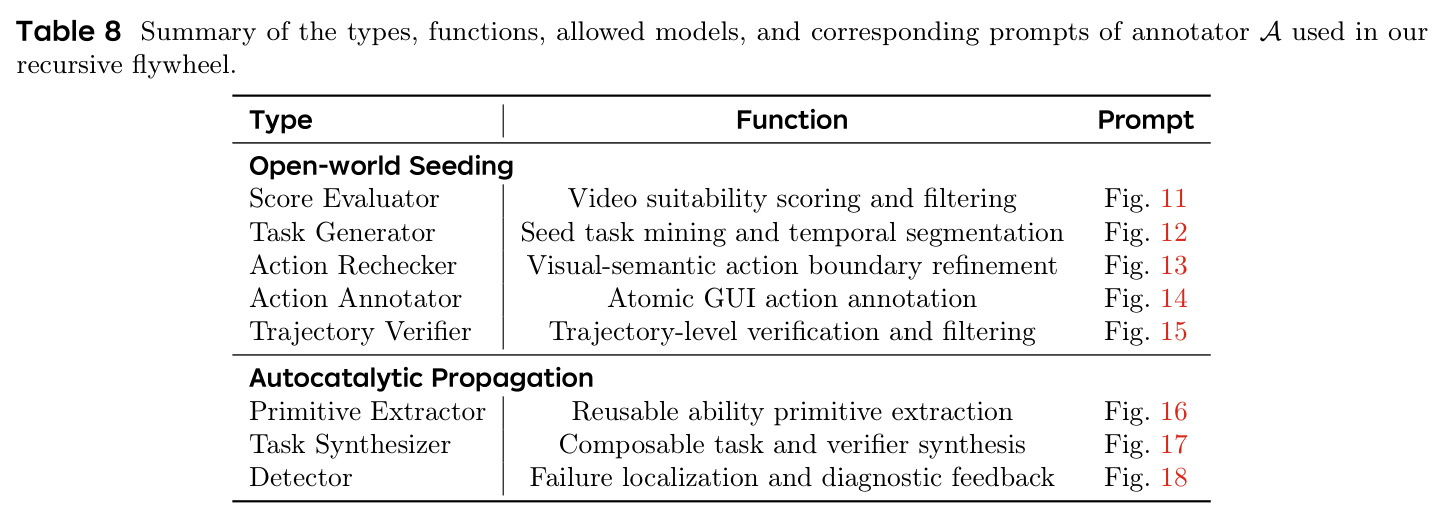
复现评估:论文页眉给出 Project/Code/Model 链接,方法细节披露相当充分——八个注解器角色的完整 prompt 全部公开(Figures 11–18),动作空间(Table 7)、分类学与应用清单(Table 9,8 域/36 子域/650+ 应用)、各域成绩(Tables 4–6)与训练超参(SFT 峰值学习率 $5\times10^{-6}$、cosine、warmup 0.03、batch 128;RL 学习率 $1\times10^{-6}$、batch 64、每任务 8 轨迹)均有说明,数据规模明确(127K 样本 = 115K SFT + 12K RL),基座为开源的 Qwen-3.5-27B。但复现门槛很高:训练用 16 节点 × 8 张 H200-141GB(共 128 卡);rollout 基础设施需支持 100+ 环境、2000+ 并发 VM 的镜像目录与资源感知调度;最关键的是注解器 $\mathcal{A}$ 的具体型号未说明——若依赖闭源前沿模型,第三方要么支付高额 API 成本,要么接受数据质量下降(Figure 9 显示自策略注解收益明显更弱)。综合判断:读懂方法、用小规模数据验证思路属于中等难度;完整复现 27B 模型的数据引擎与训练属于高难度,基本只有具备大算力与大规模 VM 编排能力的工业界实验室可承担。
论文图表
同一模型在 GUI-only、CLI-only、混合三种执行模式下的步数/token/得分对比:WeaveBench 混合 43.9 远超 GUI-only 6.6 与 CLI-only 11.5,步数比 GUI-only 少 23.8%;Agents' Last Exam 从 5.9 提至 25.0 且步数少 26.7%;OSWorld 2.0 得分相近但步数少 43.8%。
证明 GUI+CLI 互补性是性能跃升的直接来源,支撑混合动作空间这一核心设计决策。
语料筛选角色的完整 prompt:输入均匀采样帧与转写,输出 0–5 整数 CUA 适配分及 is_cua/has_trajectory/clarity 结构化字段,用于剔除游戏录像、纯口播、音乐录影带等无软件操作内容的视频。
复现语料采集环节的第一道质量闸门,5/3–4/1–2/0 的评分标准清晰可循。
任务切分角色的 prompt:要求选出最长连续工作流作为主片段,同时列出其他可导出片段(episode_segments)并排除片头、广告、纯幻灯片、口播段,输出起止时间、任务描述与置信度的 JSON。
「一条视频→多个种子任务」的关键实现,直接决定种子任务的质量与数量。
动作边界复核角色的 prompt:删除仅讲解的候选、补齐缺失的可见操作(菜单打开、输入前聚焦点击、提交/保存、等待导航)、拆分多动作候选、合并重复候选;规定 shell.exec 只用于已提交的完整命令,未提交的终端文本用 computer.type,输出结构化动作列表与误报/合并处理。
双路触发候选如何变成精确原子动作的核心逻辑,是轨迹重建精度的关键。
原子动作标注角色的 prompt:逐步把状态帧转换标注为动作对象,坐标归一化到 0–1000 屏幕空间,保留相邻转换作为上下文但每步独立输出,非操作转换标记 is_action=false,改动动作类型需给出视觉证据。
训练标签的直接来源,决定坐标与动作类型的正确性,直接影响可学习性。
轨迹验证角色的 prompt:判断所选步骤是否构成连贯可训练的轨迹或自洽子任务,拒绝拼接无关应用/网站/示例、任务与步骤不匹配的片段;区分 trajectory_valid(片段可用)与 exportable_for_training(可作为完整工作流导出),不以长度论优劣。
过滤噪声轨迹的质量闸门,解释了种子数据为何足够可靠地用于训练与原语提取。
原语提取角色的 prompt:把轨迹分解为有序原语序列,每个原语含能力名/意图/输入/效果、前置条件(可用 requires:<effect> 引用先前原语)、环境要求(VM 能力/文件/配置依赖)、验证覆盖(full/partial/none)及支撑轨迹步区间引用,禁止跨缺失状态转换推断操作。
自催化繁殖的起点——五元组原语 $p_i=(u_i,a_i,P_i,E_i,V_i)$ 的具体格式全在此定义。
任务合成角色的 prompt:从原语库选恰好 K 个兼容原语、按依赖排序、跨应用任务需有显式交接产物或共享状态、生成不暴露原语标识与底层步骤的连贯指令,合并环境规格与任务级验证器(每项检查须对应指令中的可观测结果),无有效组合时返回 valid=false。
受约束组合如何变成可执行、可验证任务的落地细节,决定了合成任务的可训练性与可靠性。
失败定位角色的 prompt:给定任务、验证器残差、轨迹与快照签名,找出最早与任务目标分歧的动作步(而非最后失败步)并选择其前最新快照,生成不泄露特权解法(未来动作、点击坐标、shell 命令)的执行依据型反馈,并标注失败来源(agent/environment/verifier/inconclusive)。
快照回滚机制的「大脑」,是理解 Table 3 中 49.8% 对 14.6% 成功率提升的关键。
OSWorld Verified 分域得分:OS 91.6(24 题)、Professional 88.0(49 题)、Daily 78.8(78 题)、Workflow 70.7(93 题),总体 80.2(361 题)。
展示优势域分布,同时指出相对薄弱的 Workflow 域(多步办公流程)。
WeaveBench 分域得分:Office 83.1、Web Frontend 58.4、Desktop OS 55.3、DevOps 49.7、Document 44.1、Data Analysis 38.8、Healthcare 30.4、Design 26.3、Spatial/CAD 25.9,总体 43.9(114 题)。
揭示专业软件(CAD、设计、医疗影像)仍是主要短板,指明下一轮飞轮的探索方向。